PostgreSQL 18 内参
PostgreSQL 18 内参
Egor Rogov 著
简体中文译本 · PostgreSQL 18 · 基于 2026 年俄文版
内容
插图
- 图 publication.1 — ДМК Пресс 出版社标志
- 图 1.1 — 数据库
- 图 1.2 — 表空间
- 图 1.3 — 分支与文件
- 图 1.4 — 进程与内存
- 图 3.1 — 页头
- 图 4.1 — 什么是数据快照
- 图 4.2 — 快照中的行版本可见性
- 图 4.3 — 快照由什么组成
- 图 4.4 — 快照由什么组成
- 图 4.5 — 事务视界
- 图 6.1 — 事务计数器回卷
- 图 6.2 — 行版本冻结与可见性规则
- 图 7.1 — 自动清理紧急触发的年龄
- 图 9.1 — 缓冲区缓存的结构
- 图 9.2 — 缓存命中
- 图 9.3 — 缓冲区查找与驱逐
- 图 10.1 — 检查点
- 图 10.2 — 检查点
- 图 10.3 — 检查点配置
- 图 12.1 — 等待队列
- 图 13.1 — 互斥模式
- 图 13.2 — 独占模式
- 图 13.3 — 独占模式
- 图 13.4 — 共享模式
- 图 13.5 — 共享模式
- 图 13.6 — 死锁
- 图 15.1 — 缓冲区缓存
- 图 15.2 — 预写日志缓冲区
- 图 15.3 — SLRU 缓存
- 图 16.1 — 演示数据库
- 图 16.2 — 解析
- 图 16.3 — 转换
- 图 16.4 — 规划
- 图 16.5 — 计划
- 图 16.6 — 计划
- 图 16.7 — 计划
- 图 16.8 — 计划
- 图 16.9 — 计划
- 图 16.10 — 计划
- 图 16.11 — 执行
- 图 17.1 — 唯一值
- 图 17.2 — 最频繁值
- 图 17.3 — 直方图
- 图 17.4 — 直方图
- 图 18.1 — 顺序扫描
- 图 18.2 — 并行执行计划
- 图 19.1 — 索引与可扩展性
- 图 20.1 — 理想情况:高相关性
- 图 20.2 — 糟糕情况:低相关性
- 图 20.3 — 糟糕情况:低相关性
- 图 20.4 — 成本估算
- 图 20.5 — 成本估算
- 图 20.6 — 访问方法比较
- 图 22.1 — 单次遍历哈希连接
- 图 22.2 — 单次遍历哈希连接
- 图 22.3 — 双次遍历哈希连接
- 图 22.4 — 双次遍历哈希连接
- 图 22.5 — 两阶段哈希连接
- 图 22.6 — 并行单阶段哈希连接
- 图 22.7 — 并行单阶段哈希连接
- 图 22.8 — 并行两阶段哈希连接
- 图 22.9 — 并行两阶段哈希连接
- 图 22.10 — 并行两阶段哈希连接
- 图 22.11 — 并行两阶段哈希连接
- 图 23.1 — 外部排序
- 图 23.2 — 外部排序
- 图 23.3 — 外部排序
- 图 23.4 — 外部排序
- 图 23.5 — 外部排序
- 图 23.6 — 连接方式比较
- 图 24.1 — 页面组织
- 图 24.2 — 页面组织
- 图 24.3 — 页面组织
- 图 24.4 — 页面组织
- 图 25.1 — 通用原理
- 图 25.2 — 等值查找
- 图 25.3 — 不等式查找
- 图 25.4 — 范围查找
- 图 25.5 — 插入
- 图 25.6 — 页面组织结构
- 图 25.7 — 跳过扫描优化
- 图 25.8 — 跳过扫描优化
- 图 25.9 — 跳过扫描优化
- 图 25.10 — 跳过扫描优化
- 图 25.11 — 跳过扫描优化
- 图 25.12 — 跳过扫描优化
- 图 26.1 — 点的 R-树
- 图 26.2 — 点的 R-树
- 图 26.3 — 点的 R-树
- 图 26.4 — 区域包含搜索
- 图 26.5 — 区域包含搜索
- 图 26.6 — 区域包含搜索
- 图 26.7 — 最近邻搜索
- 图 26.8 — 最近邻搜索
- 图 26.9 — 最近邻搜索
- 图 26.10 — 最近邻搜索
- 图 26.11 — 插入
- 图 26.12 — 插入
- 图 26.13 — tsvector 索引
- 图 26.14 — tsvector 索引
- 图 26.15 — tsvector 索引
- 图 26.16 — tsvector 索引
- 图 27.1 — 点的四叉树
- 图 27.2 — 点的四叉树
- 图 27.3 — 点的四叉树
- 图 27.4 — 操作符类
- 图 27.5 — 操作符类
- 图 27.6 — 页面组织
- 图 27.7 — 查找
- 图 27.8 — 查找
- 图 27.9 — 插入
- 图 27.10 — 插入
- 图 27.11 — 插入
- 图 27.12 — 插入
- 图 27.13 — 点的 K-维树
- 图 27.14 — 点的 K-维树
- 图 27.15 — 点的 k-维树
- 图 27.16 — 字符串的前缀树
- 图 27.17 — 搜索
- 图 27.18 — 插入
- 图 27.19 — 插入
- 图 28.1 — 全文搜索索引
- 图 28.2 — 搜索
- 图 28.3 — 频繁词和稀有词
- 图 28.4 — 插入
- 图 28.5 — 操作符类 jsonb_ops
- 图 28.6 — 操作符类 jsonb_path_ops
- 图 29.1 — 页面组织结构
- 图 29.2 — 插入值
- 图 29.3 — 区域大小与查找效率
- 图 29.4 — 多范围值(minmax-multi)
- 图 29.5 — 多范围值(minmax-multi)
- 图 29.6 — 布隆过滤器(bloom)
表格
- 表 2.1 — SQL 标准中的隔离级别与异常
- 表 2.2 — PostgreSQL 中的隔离级别与异常
- 表 12.1 — 锁模式冲突矩阵:Shared 与 Exclusive
- 表 12.2 — 关系锁冲突矩阵
- 表 13.1 — 行锁冲突矩阵
- 表 18.1 — 表大小与进程数量
- 表 26.1 — 词素的签名
- 表 26.2 — 文档的签名
- 表 28.1 — 一致性函数:「стоя」或「кудряв」
- 表 28.2 — 一致性函数:必需词和可选词
关于这个版本
本译本根据 Egor Rogov 的《PostgreSQL 18 изнутри》俄文原版制作,保留原书的章节顺序、示例、插图、代码、脚注、页码锚点和出版信息。页码指向 2026 年俄文印刷版;图表编号用于本站导航。
原书版权归 ООО «ППГ» 和 ДМК Пресс 所有,2026 年。本站提供的是 PostgreSQL 18 俄文原版的简体中文阅读版。
俄文 PG18 原版 · 扉页与出版信息 · 版权与出版信息
扉页与出版信息
Postgres Professional 公司
Egor Rogov 著《PostgreSQL 18 内参》

莫斯科,2026 年
УДК 004.65 ББК 32.972.134 Р59
Рогов Е. В.
Р59 《PostgreSQL 18 内参》。——莫斯科:ДМК Пресс,2026 年。——682 页。
ISBN 978-5-93700-499-4
本书介绍 PostgreSQL 数据库管理系统的内部结构:多版本机制和基于数据快照的隔离机制的实现细节,包括清理过期行版本的过程;缓冲区缓存与预写式日志;各个层级的锁的使用;SQL 查询的规划与执行;可扩展性原理以及现有索引访问方法的特点。书中还着重介绍了可用于自行探索 PostgreSQL 运行机制的各种手段。
本版吸收了读者的意见,修正了印刷错误,并反映了 PostgreSQL 18 版本中的变化。
本书网站:https://postgrespro.ru/education/books/internals。
本书面向数据库管理员和程序员。
УДК 004.65 ББК 32.972.134
封面采用了 Edward Topsell 的著作 The History of Four-footed Beasts and Serpents 中的一幅版画局部。该书于 1658 年在伦敦出版。
ISBN 978-5-93700-499-4 © 文字、设计:ООО «ППГ»,2026 年 © 出版:ДМК Пресс,2026 年
关于此书
“原来一切都这么简单!”什蓬季克(Шпунтик)叫道,“可我好像在哪儿读过,作家得有点想象,有点构思……”
“嗨,构思!”斯梅卡伊洛(Смекайло)不耐烦地打断了他,“只有书里才说要有构思。可你试着构思点什么吧,人家早就把什么都想过了!无论你想写什么,全都有人写过。”尼古拉·诺索夫,《小无知和他的朋友们历险记》
本书适合哪些人
本书适合那些不愿把数据库当作黑箱来使用的人。如果你充满好奇,不满足于权威人士的建议,想亲自弄清一切,那么我们就同路了。
我假设读者已经有一定的 PostgreSQL 使用经验,至少大致了解它是怎么回事。对完全没有经验的新手来说,本书可能有些难。例如,我不会介绍如何安装服务器、在 psql 中输入命令或修改配置参数。
我希望这本书对那些熟悉其他数据库系统的内部结构,但想转而使用 PostgreSQL 并希望了解两者之间差异的人也有所帮助。几年前,如果有这样一本书,我本可以节省很多时间。这也正是我最终写下这本书的原因。
本书不提供的内容
本书不是一本现成方案集。我们不可能为所有情况准备好解决方案,但理解复杂系统的内部机制,就能批判性地重新审视他人的经验,得出自己的结论。这正是我介绍那些乍看似乎没有实际用处的内部细节的原因。
本书也不是一本教材。它深入讨论了某些领域(也就是我自己更感兴趣的领域),却绕过了另一些领域。如果你正在学习 SQL,可以看看叶夫根尼·莫尔古诺夫(Евгений Моргунов)的教材 《PostgreSQL:SQL 语言基础》1;而鲍里斯·诺维科夫(Борис Новиков)的 《数据库技术基础》2 则能提供必要的理论基础。
本书也无意充当参考手册。我力求准确,但没有打算用它替代文档,因此会略去一些在我看来无关紧要的细节。遇到任何不明白的地方,请阅读文档。
本书不会教你如何开发 PostgreSQL 内核。我不要求读者掌握 C 语言,而是面向管理员和应用开发者。不过,我会经常引用源代码,从中你可以了解到任意多的细节,甚至比你想知道的还多。
本书提供的内容
在绪论中,我会简要介绍后文所依赖的基本概念。我想你几乎不会从这一章学到什么新东西,但为了让全书内容完整,还是把它放了进来。此外,它也可能对从其他数据库管理系统转来的读者有所帮助。
第一部分讨论一致性与隔离性。我先从用户的角度介绍这些问题(有哪些隔离级别,它们会带来什么影响),然后转向内部实现。为此,需要深入介绍多版本机制和基于数据快照的隔离机制的实现细节。其中,清理过期行版本的过程尤其需要仔细讨论。
第二部分介绍缓冲区缓存,以及能够在故障后恢复一致性的机制——预写式日志。
第三部分详细介绍各个层级的锁的结构和使用:用于内存的轻量级锁、用于关系的重量级锁,以及表中的行级锁。
第四部分解释服务器如何规划和执行 SQL 查询。我会介绍有哪些数据访问方式、采用了哪些连接方法,以及如何使用统计信息。
第五部分把此前局限于 B-树(B-tree)的索引讨论扩展到其他访问方法。我首先介绍可扩展性的一般原理,它们界定了索引系统核心、索引访问方法和数据类型之间的边界(为此需要引入操作符类的概念),然后详细介绍每种现有方法的特点。
PostgreSQL 自带了大量“自省”扩展,日常工作并不需要它们,但它们让我们能够窥见服务器内部的运行情况。本书使用了其中的许多扩展。除了帮助我们深入了解服务器的内部结构,这些扩展也能使复杂情况下的诊断更容易。
约定
写作时,我尽量让这本书能够按顺序逐页阅读。但很难一次把所有事情讲清楚,所以同一话题不得不反复出现。如果每次都写“后面还会讨论”,书就会厚上许多。因此,遇到这种情况,我会在页边标出继续讨论该话题的页码。同样,指向前文的页码表示前面已有相关讨论。(第 19 页)
本书正文和全部示例均适用于 PostgreSQL 18。有些段落在页边标注了版本号,表示该段内容从所标注的 PostgreSQL 版本起成立,而更早的版本要么没有所述功能,要么采用了不同的实现。这些标记可能对尚未升级到最新版本的读者有用。(v. 18)
页边还会标出所讨论参数的默认值。参数名(包括普通参数和存储参数)以斜体表示:work_mem。(默认值: 4MB)
我在脚注中经常引用一手资料。这类资料有好几种,首先是蕴含丰富信息的文档3。文档是项目的有机组成部分,始终由开发者亲自维护更新。不过,最根本的资料无疑是源代码4。即使不懂 C 语言,仅从注释和 README 文件中就能找到如此多问题的答案,实在令人惊叹。我偶尔也会引用 commitfest 条目5:在 pgsql-hackers 的通信中,总能追溯变更的历史,理解开发者作出决定的思路,代价则是需要阅读海量讨论。
有些题外话和说明可能让人偏离主线,但我还是忍不住把它们写进书里。这些内容会采用这样的形式标出,方便读者跳过。
当然,本书有很多代码片段,主要使用 SQL。代码以 => 作为提示符;必要时,后面还会给出服务器的响应:
如果在 PostgreSQL 18 中仔细执行书中的所有命令,应该能得到相同的结果(当然,事务编号等无关紧要的细节可能不同)。至少,本书中的所有代码都是执行一个脚本所得的结果,而该脚本包含的正是这些命令。
需要展示多个事务同时运行时,在另一会话中执行的代码会以缩进和竖线标出:
要重现这些命令,打开两个 psql 终端会很方便(和任何实验一样,这对自学很有帮助)。
单独提到的命令和各类数据库对象名称(如表、列、函数和扩展)采用等宽字体:UPDATE、pg_class。
从操作系统调用工具时,使用以 $ 结尾的提示符:
我使用 Linux,但没有涉及它的特有功能;掌握最基本的知识就足够了。
致谢
一个人无法独力完成一本书,这正是向那些热心人道谢的好机会。
感谢 Pavel Luzanov,他在恰当的时候建议我做一点真正有价值的事。
感谢 Postgres Professional 公司,让我不必只在业余时间写作这本书。公司是由人组成的,我尤其要感谢 Oleg Bartunov 源源不断的精力和想法,也要感谢 Ivan Panchenko 的全面支持和 LATEX。
感谢教育部门的同事们营造的创作氛围,以及大家的讨论。培训课程的内容和讲授方式正是在这些讨论中逐渐形成的,也体现在了本书中。感谢 Pavel Tolmachev 对草稿的仔细审读。
本书许多章节最初以文章形式发表于 Habr6,感谢读者的意见和反馈。这些反馈让我看到了这项工作的必要性,发现自己知识中的空白,也让书稿得以改进。
感谢 Liudmila Mantrova,她为打磨本书的语言付出了大量心血。如果你读起来不至于每隔一句就磕绊一次,那都是她的功劳。
书中没有逐一提到这些人的名字,但我介绍的每个函数和每项功能背后,都有具体的人为之付出了多年的劳动。我敬佩 PostgreSQL 的开发者,也格外荣幸能称其中许多人为我的同事。
1 绪论
1.1. 数据组织
数据库
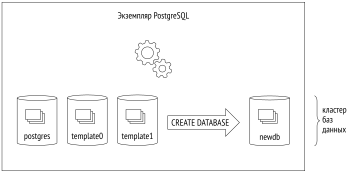
PostgreSQL 是一款数据库管理系统软件。程序运行时,我们称之为 PostgreSQL 服务器,或服务器实例。
PostgreSQL 管理的数据存储在数据库1中。一个 PostgreSQL 实例可以同时管理多个数据库,它们合称为数据库集簇。
使用集簇之前,必须先对其进行初始化2(创建)。存放集簇所有文件的目录通常称为 PGDATA,这个名称来自指向该目录的环境变量。
通过软件包安装时,可能会在 PostgreSQL 自带机制之上加入自己的“抽象层”,显式指定工具所需的全部参数。这时数据库服务器表现为操作系统服务,你可能从来不会直接遇到 PGDATA 变量。不过,这个术语已经约定俗成,本书仍会使用它。
初始化时,会在 PGDATA 中创建三个相同的数据库:
template0 用于从逻辑备份恢复数据、创建采用其他编码的数据库等场合,绝不能修改; (第 631 页)
template1 是用户在此集簇中创建其他数据库时使用的模板;
postgres 是一个普通数据库,可以按自己的需要使用。
系统目录
集簇内所有对象(如表、索引、数据类型或函数)的元数据,都存储在系统目录3的表中。每个数据库都有自己的一组表和视图,用来描述该数据库的对象。此外,还有几个系统目录表为整个集簇所共有,不属于任何特定数据库(形式上使用一个标识符为零的虚拟数据库),但在任意数据库中都能访问。
可以使用普通 SQL 查询访问系统目录,而系统目录的变更由 DDL 命令触发。psql 客户端还提供了一系列查看系统目录的专用命令。
所有系统目录表的名称都以 pg_ 为前缀,例如 pg_database。列名以三个字母的代码开头,通常与表名对应,例如 datname。
在所有系统目录表中,主键列都名为 oid,类型也是 oid(object identifier,对象标识符),即一个 32 位整数。
oid 对象标识符机制本质上类似于序列,但比序列早得多。它的特点是,由同一个计数器分配的唯一编号会用于不同的系统目录表。已分配的编号超出取值范围时,计数器会归零。为保证某个表内的值唯一,下一个 oid 值会通过唯一索引检查;如果该表已在使用这个值,就增加计数器并再次检查4。
模式
模式5是数据库中所有对象的命名空间。除了用户模式,还有几个特殊的系统模式:
public 是用户对象的默认模式,除非另行配置;
pg_catalog 用于系统目录表;
information_schema 提供 SQL 标准规定的另一种系统目录视图;
pg_toast 用于与 TOAST 有关的对象; (第 33 页)
pg_temp 用于临时表(不同用户的临时表虽然建立在各自的 pg_temp_N 模式中,但每个用户都使用 pg_temp 这个名称访问自己的对象)。
模式存在于数据库内部,数据库中的所有对象都属于某个模式。
访问对象时,如果没有显式指定模式,就会从搜索路径中列出的模式里选择第一个合适的模式。搜索路径基于 search_path 参数的值形成,并会隐式加入 pg_catalog 和必要时的 pg_temp 等模式。因此,不同模式可以包含同名对象。
表空间
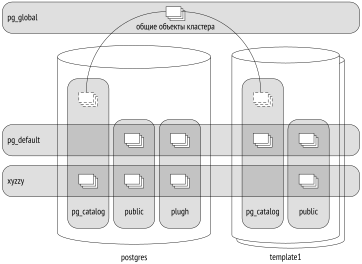
数据库和模式决定对象的逻辑分布,表空间则决定数据的物理位置。实际上,表空间就是文件系统中的一个目录。例如,可以用表空间把归档数据放在较慢的存储介质上,而把经常使用的数据放在较快的介质上。
同一个表空间可以由多个数据库使用,一个数据库也可以把数据存储在多个表空间中。也就是说,逻辑结构与物理结构相互独立。
每个数据库都有一个所谓的默认表空间。除非显式指定其他位置,所有对象都会在这里创建。系统目录对象也存储在这个表空间中。
初始化集簇时会创建两个表空间:
pg_default 位于 PGDATA/base 目录中。如果没有显式选择其他表空间,它就是默认表空间;
pg_global 位于 PGDATA/global 目录中,用来存储整个集簇共有的系统目录对象。
创建用户表空间时可以指定任意目录;PostgreSQL 会在 PGDATA/pg_tblspc 目录中建立指向它的符号链接。实际上,PostgreSQL 中的所有路径都是相对路径,以数据目录 PGDATA 为起点。因此,可以把 PGDATA 移到其他位置(当然,要先停止服务器)。
下图把数据库、模式和表空间放在了一起。数据库 postgres 的默认表空间是 xyzzy,而 template1 的默认表空间是 pg_default。表空间与模式的交叉处是各种数据库对象:
关系
数据库中最重要的对象——表和索引——虽然有许多差异,却有一个共同点:它们都由行组成。对表来说,这一点显而易见;B-树(B-tree)的节点也由行组成,每行包含被索引的值,以及指向其他节点或表行的引用。 (第 523 页)
还有一些对象的结构与此类似:序列本质上是只有一行的表,物化视图本质上是记住了查询的表。另外还有普通视图,它们本身不存储数据,但在其他方面都与表相似。
在 PostgreSQL 中,这些对象统称为关系(relation)。
我认为这个词选得不太好,因为它把数据库中的表与关系理论中真正的关系混在了一起。这体现了项目的大学背景,以及创始人 Michael Stonebraker 把一切都看成关系的倾向。在一篇论文中,他甚至引入了“有序关系”(ordered relation)的概念,用来表示行的顺序由索引决定的表。
关系的系统目录表最初名为 pg_relation,但很快便随着面向对象的热潮,改名为今天熟悉的 pg_class。不过,它的列名仍以 rel 为前缀。
分支与文件
与关系有关的信息按类型组织为多个分支6(fork),每个分支包含一种特定的数据。
起初,一个分支只有一个文件。文件名由数字标识符(oid)组成,还可能加上表示分支类型的后缀。
文件会逐渐增长,达到 1 GB 时,就会为同一分支创建下一个文件(这类文件有时称为段)。段的序号会添加到文件名末尾。
1 GB 的文件大小限制源于历史上的文件系统兼容性需求,因为有些文件系统不能处理大文件。可以在编译 PostgreSQL 时修改这一限制(./configure --with-segsize)。
因此,一个关系在磁盘上可能对应多个文件。即使是一张没有索引的小表,也至少会有三个文件,分别对应必需的三个分支。
每个表空间目录(pg_global 除外)中都会为各个数据库创建子目录。属于同一表空间、同一数据库的所有对象文件,都放在同一个子目录中。需要考虑这一点,因为文件系统处理单个目录中大量文件的效率通常不高。
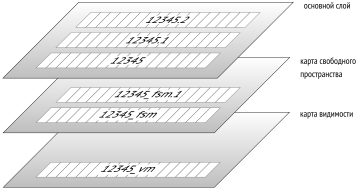
标准分支类型有以下几种。
主分支(main fork)存储实际数据,也就是表行或索引行。所有关系都有主分支,不存储数据的视图除外。
主分支的文件名只有数字标识符,其值等于 pg_class 表中 relfilenode 列的值。
来看一个例子:在 pg_default 表空间中创建一张表,查看它的文件路径:
base 目录对应 pg_default 表空间,下一级子目录对应数据库,而我们要找的文件就在其中:
下面是文件系统中对应的文件:
初始化分支(init fork)7只存在于无日志表(使用 UNLOGGED 创建的表)及其索引中。这类对象与普通对象的唯一区别在于,对它们执行的操作不会写入预写式日志。因此,操作会更快,但发生故障时就无法把数据恢复到一致状态。恢复时,PostgreSQL 会直接删除这些对象的所有分支,再用初始化分支替代主分支,得到一个“空壳”。 (第 211 页)
表 t 创建为无日志表,因此有初始化分支。它与主分支同名,但带有 _init 后缀:
空闲空间映射(free space map)8这个分支记录页面内空闲空间的大致大小。空闲空间一直在变化:加入新的行版本时会减少,清理时则会增加。插入新行版本时,可以借助空闲空间映射迅速找到能容纳这些数据的页面。
空闲空间映射文件带有 _fsm 后缀。不过,这些文件不会立即创建,而是等到需要时才出现。让它们出现的最简单方法就是清理表: (第 133 页)
为了加快查找,空闲空间映射采用树形结构,至少占用三个页面。这也解释了为什么一张几乎为空的表,其映射分支文件仍有这样的大小。
表和索引都有空闲空间映射。不过,索引行不能添加到任意页面(例如,B-树的插入位置由排序顺序决定),因此索引的映射只记录那些已经完全清空、可以在索引结构中重新使用的页面。
可见性映射(visibility map)9这个分支能帮助我们迅速判断页面是否需要清理或冻结。为此,它为每个堆页面分配了两个比特。
其中一个比特标记只包含有效行版本的页面。清理过程会跳过这样的页面,因为没有需要清理的内容。而且,事务从这样的页面读取行时,可以不再检查行的可见性,这就使仅索引扫描成为可能。 (第 131 页) (第 422 页)
另一个比特标记所有行版本都已冻结的页面。我把这个分支的这一部分称为冻结映射。 (第 134 页)
可见性映射文件带有 _vm 后缀,通常是最小的分支文件:
表有可见性映射,索引则没有。 (第 89 页)
页面
为便于组织 I/O,文件在逻辑上被分为页面(或块),这是读写数据的最小单位。因此,PostgreSQL 的许多内部算法都以页面为操作单位。 (第 75 页)
页面通常为 8 KB,可以在一定范围内调整,最大为 32 KB,但只能在编译时指定(./configure --with-blocksize),通常也没有人这样做。编译并启动之后,一个实例只能处理同一种大小的页面,不能创建页面大小各异的表空间。
无论文件属于哪个分支,服务器处理它们的方式都大致相同。页面先进入缓冲区缓存,供各个进程读取和修改,然后在需要时被逐出、写回磁盘。 (第 183 页)
TOAST
每一行都必须完整地放在一个页面内,不能把一行“接着”存到下一个页面。对于很长的行,PostgreSQL 使用 TOAST10(The Oversized Attributes Storage Technique,超长属性存储技术)。
TOAST 有几种策略。可以先把较长的属性值切成小片段,像切“吐司”一样,再放到一张单独的辅助表中;也可以压缩长值,使整行仍能放进一个页面;还可以把两者结合起来,先压缩,再切分并存入辅助表。
如果主表包含可能很长的属性,就会立即为它创建一张单独的 TOAST 表,供所有属性共用。例如,只要表中有 numeric 或 text 类型的列,就会创建 TOAST 表,即使这些列从来不会存储长值。
对索引而言,TOAST 只提供压缩功能,不支持把属性移到单独的表中。这就限制了索引键的大小,具体如何实施这一限制取决于操作符类。 (第 397 页)
策略通常由列的数据类型决定。查看策略最简单的方法是使用 psql 的 \d+ 命令,不过为了缩短输出,这里改用系统目录查询:(psql:\d+)
各个策略的含义如下:
plain:不使用 TOAST,适用于已知较“短”的数据类型,例如 integer;
extended:允许压缩,也允许存到单独的 TOAST 表中;
external:将长值不经压缩地存到 TOAST 表中;
main:优先压缩长值,只有压缩仍不足以解决问题时,才把它们存到 TOAST 表中。
算法大致如下11。PostgreSQL 力求让每个页面至少容纳四行。因此,如果一行的大小超过页面大小的四分之一再减去头部开销(标准页面约为 2000 字节),就需要对部分属性值应用 TOAST。按以下顺序处理,一旦行长不再超过阈值,就立即停止。
首先从最长的属性开始,按从长到短的顺序处理使用 external 和 extended 策略的属性。extended 属性先压缩;如果压缩后的值本身(不计其他属性)仍超过页面的四分之一,就立即将它移到 TOAST 表中。external 属性的处理方式相同,只是不进行压缩。
如果第一轮处理后整行仍放不下,就把剩余采用 external 和 extended 策略的属性逐一移到 TOAST 表中。
如果这仍不够,就尝试压缩采用 main 策略的属性,同时将它们保留在堆页面中。
如果整行仍不够短,就把 main 属性移到 TOAST 表中。
这个阈值仍是 2000 字节,但可以通过表级存储参数 toast_tuple_target 重新设置。
有时,改变某些列的策略会有帮助。如果事先知道列中的数据无法压缩(例如存储 JPEG 图像的列),就可以把它设为 external 策略,省去徒劳的压缩尝试。既可以在建表时通过 CREATE TABLE 命令的 STORAGE 子句指定策略,也可以在之后修改:(v. 16)
再次执行查询,得到:
可用的压缩算法有两种:传统的 PGLZ 和较新的 LZ4,两者都是 Lempel–Ziv 字典压缩算法的变体。默认采用 default_toast_compression 参数指定的算法,也可以用 COMPRESSION 子句为单个列指定算法。基准测试表明,在压缩率与 PGLZ 相近的情况下,LZ4 消耗的 CPU 资源更少。(v. 15)(默认值: pglz)
TOAST 表位于独立的 pg_toast 模式中。该模式不在搜索路径内,因此通常看不到这些表。临时表则使用 pg_toast_temp_N 模式,与普通临时表的 pg_temp_N 模式类似。
当然,只要愿意,总能看看这个过程的内部机制。比如,表 t 有三个可能很长的属性,因此一定存在对应的 TOAST 表。它就在这里:
行被切成的“吐司”片段采用 plain 策略,这是合理的:并不存在第二层 TOAST。
创建 TOAST 表时,还会在同一模式中创建一个索引,访问属性值片段时总是使用这个索引。上面的命令输出中可以看到索引名称,也可以通过查询找到它:
因此,TOAST 表把存储一张表所需的最少文件数增加到了八个:主表的三个分支、TOAST 表的三个分支,以及 TOAST 索引的两个分支。
列 c 使用 extended 策略,它的值会被压缩:
TOAST 表是空的:这些重复字符经 PGLZ 压缩后,已经能放进普通堆页面中。
现在构造一个由随机字符组成的值:
这样的字符序列无法压缩。表行中保存的是 chunk_id 标识符:
值本身则存入 TOAST 表:
可以看到,数据被切成了若干片段。片段大小的选择要使 TOAST 表的一个页面能够容纳四行。随着页面头部大小的变化,这个值在不同版本间可能略有不同。
访问“长”属性时,PostgreSQL 会自动还原原始值并返回给客户端,这个过程对应用完全透明。如果查询没有用到这些属性,就不会读取 TOAST 表。这也是生产代码中不宜使用“星号”的原因之一。
如果客户端只请求长值的开头部分,就只会读取所需的片段,即使该值以压缩形式存储也是如此。(v. 13)
不过,压缩、切分以及之后的还原都会消耗相当多的资源。因此,把大块数据存入 PostgreSQL 并不是个好主意,尤其是数据经常被使用、又不需要事务逻辑时,例如扫描的会计凭证原件。一个可能更划算的选择是把这些数据存入文件系统,而在数据库中只保存相应的文件名。不过,这样一来,数据库管理系统就无法保证数据的一致性了。
使用带有 analyze 和 serialize 参数的 EXPLAIN 命令,可以估算还原经 TOAST 处理的值所需的开销。(v. 17)
1.2. 进程与内存
PostgreSQL 服务器实例由多个相互协作的进程组成。
服务器启动时,首先启动 postgres 进程,习惯上称为 postmaster。它负责启动所有其他进程(类 Unix 系统通过 fork 系统调用实现),并“照看”它们。如果某个进程异常退出,postmaster 就会重启它;如果认为该进程可能破坏了共享数据,则会重启整个服务器。
由于进程模型简单,PostgreSQL 从项目诞生时起就采用了这一模型,关于改用线程的讨论也从未停止。
当前模型有一些缺点:静态分配的共享内存使缓冲区缓存等结构无法在运行时调整大小;并行算法实现复杂,效率也低于本来可能达到的水平;会话与进程紧密绑定。改用线程看起来很有前景,但也会带来隔离性、操作系统兼容性和资源管理方面的难题。更不用说,这需要对代码作出根本性修改,耗费多年工作。目前仍是保守观点占上风,在近期看不到改变的迹象。
服务器的运行由一组辅助进程支撑,主要包括:
startup:在故障后恢复系统; (第 223 页)
autovacuum:清理表和索引中的失效数据; (第 138 页)
wal writer:把日志记录写入磁盘; (第 236 页)
checkpointer:执行检查点; (第 219 页)
writer:把脏页面写入磁盘; (第 226 页)
wal sender:把日志记录发送给副本;
wal receiver:在副本上接收日志记录。
其中一些进程在完成任务后便会退出,一些始终在后台运行,还有一些可以禁用。
每个进程都由配置参数控制,有时涉及数十个参数。要合理配置服务器,就必须充分了解其内部结构。不过,仅凭一般原理只能选择合适的初始值,之后仍需根据监控反馈不断调整。
为了让进程能够交换信息,postmaster 会分配所有进程都能访问的共享内存。
磁盘的速度远低于内存,HDD 尤其如此,SSD 也不例外,因此需要使用缓存:在共享内存中留出空间存放最近读取的页面,希望它们还会被多次使用,从而省去重复访问磁盘的开销。修改后的数据也不会立即写入磁盘,而是过一段时间再写入。 (第 183 页)
缓冲区缓存占用了共享内存的大部分空间。此外,共享内存中还有其他缓冲区,用来加快服务器的磁盘访问。
操作系统也有自己的缓存。PostgreSQL 几乎不使用绕过操作系统机制的直接 I/O,因此形成了双重缓存。
发生故障时,例如意外断电或操作系统崩溃,内存中的内容都会丢失,包括缓冲区缓存。磁盘上留下的文件,其页面是在不同时间写入的。
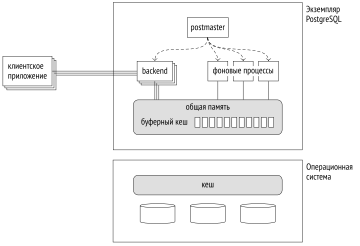
为了能够恢复数据的一致性,PostgreSQL 在运行过程中维护预写式日志(WAL),必要时可以据此重新执行丢失的操作。 (第 211 页)
1.3. 客户端与客户端/服务器协议
postmaster 进程的另一项任务是监听传入连接。有新客户端到来时,postmaster 会为它创建一个后端进程12(backend)。客户端建立连接,开始与自己的服务器进程进行会话。会话一直持续到客户端主动断开,或连接中断为止。
服务器会为每个客户端创建一个独立的后端进程。连接过多可能带来一些问题:
每个进程都需要内存来存放系统目录缓存、预备语句、执行查询时的中间结果,以及其他数据。打开的连接越多,需要的可用内存就越多。 (第 340 页) (第 338 页)
如果频繁建立连接,而会话又很短(客户端执行一个小查询便断开),建立连接、创建新进程以及无谓地填充本地缓存就会消耗过多资源。
启动的进程越多,遍历进程列表所需的时间就越长,而这项操作会被频繁执行。因此,随着客户端数量增加,性能可能下降。 (第 99 页)
这时可以使用连接池来限制后端进程数量。PostgreSQL 没有内置连接池,因此需要第三方方案:集成在应用服务器中的连接池管理器,或 PgBouncer13、Odyssey14 这样的外部程序。通常,服务器上的同一个进程会依次执行不同客户端的事务。这给应用开发带来了一定限制:可以使用局限于事务范围的功能,却不能依赖会话范围的功能。
客户端与服务器要相互理解,就必须使用同一种通信协议15。通常通过自带的 libpq 库实现这一协议,但也有独立实现。
概括地说,这个协议允许客户端连接服务器并执行 SQL 查询。
连接总是以某个角色(用户)的身份建立,并指向一个具体的数据库。虽然服务器管理的是整个数据库集簇,但应用若要同时使用多个数据库,就必须分别连接到每个数据库。连接时会进行身份验证:后端进程确认用户确实是其声称的身份,例如通过询问密码;同时还会检查该用户是否有权连接服务器和选定的数据库。
SQL 查询以文本形式传给后端进程。后端进程解析文本、优化查询、执行查询,然后把结果返回给客户端。
第一部分:隔离与多版本
2 隔离
2.1 一致性
关系型数据库管理系统的重要特征之一,是保证数据的一致性(consistency),也就是数据的正确性。
众所周知,在数据库层面可以创建完整性约束(integrity constraints),例如 NOT NULL 或 UNIQUE。数据库系统确保这些约束永远不会被破坏,从而保证数据的完整性。
如果所有需要的约束都能在数据库层面上制定,那么一致性就能得到保证。但有些条件过于复杂,无法通过数据库层面的约束来实现,例如,它们可能一次涉及多个表。而且即使某个约束可以在数据库中定义,但由于某些原因没有被定义,也并不意味着这个约束条件可以被违反。
因此,数据的一致性比完整性更严格,但是数据库系统并不清楚“一致性”具体意味着什么。如果应用程序在不破坏完整性的情况下破坏了一致性,那么数据库系统是没有办法发现的。因此,一致性实际上由应用程序担保,我们只能相信它编写得正确,且永远不会出错。
但是,如果应用程序始终只执行正确的语句序列,那么数据库系统的作用何在呢?
首先,正确的语句序列可以暂时破坏数据一致性,并且 — 虽然这听起来可能很奇怪 — 这是完全正常的。
一个老套但浅显易懂的例子是将资金从一个账户转移到另一个账户。一致性规则可能是这样的:资金转移绝不能改变受影响账户的总余额。将此规则表述为 SQL 中的完整性约束是相当困难的 (尽管可能),因此让我们假设它是在应用程序层面定义的,并且对数据库系统保持不透明。转账包括两个操作:第一个操作从其中一个账户中提取一些钱,而第二个操作将这笔钱添加到另一个账户。第一个操作破坏了数据的一致性,但第二个操作恢复了一致性。
如果第一个操作成功了,但第二个操作失败了 (因为一些故障),数据一致性将被打破。这种情况是无法接受的,但是在应用程序层面检测和解决它们需要付出很大的努力。幸运的是,这并不是必要的 — 如果数据库系统知道这两个操作构成一个不可分割的整体,即一个事务,那么这个问题完全可以由数据库系统本身解决。
但这里还有一个更微妙的方面。事务本身是绝对正确的,但当并行运行时,事务可能会开始不正确地运行。这是因为属于不同事务的操作经常会被混合在一起。如果数据库系统先完成一个事务的所有操作,然后再进行下一个事务,就不会出现此类问题,但顺序执行的性能会低得令人难以置信。
真正同时执行事务,只能在硬件允许的系统中实现,例如使用多核处理器、磁盘阵列等。但同样的推理也适用于以分时方式顺序执行命令的服务器。为便于概括,这两种情况有时统称为并发执行。
原本正确的事务在并发执行时出现不正确行为,这种情况称为并发执行异常。
此处是一个简单的例子。为了从数据库中获取一致的数据,应用程序至少不能看到其他未提交事务所做的任何更改。否则 (如果某些事务回滚),它将看到从未存在过的数据库状态。这种异常称为脏读,还有很多其他更为复杂的异常。
当并发运行事务时,数据库必须保证这种执行的结果与某种可能的顺序执行结果相同。换句话说,它必须将事务彼此隔离,从而处理任何可能的异常。
总而言之,事务是一组将数据库从一个正确状态转变到另一个正确状态 (一致性) 的操作,前提是它完全执行 (原子性) 并且不受其他事务的影响 (隔离性)。这个定义涵盖了 ACID 缩写中前三个字母所代表的要求:原子性(Atomicity)、一致性(Consistency)和隔离性(Isolation)。它们紧密相关,分别讨论并没有意义。事实上,持久性(Durability)要求也很难与它们分开:在系统崩溃之后,系统中可能仍然包含一些由未提交事务所做的更改,你必须采取措施来恢复数据的一致性。 (第 211 页)
因此,即使数据库系统对隐含的一致性规则一无所知,它也通过考虑事务边界来帮助应用程序维护数据一致性。
不幸的是,完全隔离很难实现,并且会对性能产生负面影响。大多数实际系统使用较弱的隔离级别,这可以防止一些异常,但并非全部。这意味着维护数据一致性的部分工作落在了应用程序上。因此,必须了解系统使用的隔离级别提供哪些保证、不提供哪些保证,以及如何在这些条件下编写正确的代码。
2.2 SQL 标准中的隔离级别与异常
SQL 标准定义了四种隔离级别 1。这些级别由并发事务执行期间可能发生或不发生的异常所定义。因此,在谈论隔离级别时,我们需要从异常开始讲起。
需要记住的是,标准是一种理论概念:它影响了实践,但实践在许多方面与之不同。这就是为什么此处所有的例子都是假设性的。虽然这些例子处理的是银行账户上的事务,它们非常直观,但我必须承认,它们与实际的银行操作无关。
有趣的是,实际的数据库理论也与标准有所偏离:它是在标准被采纳之后发展起来的,而实践已经领先很多。 2
更新丢失
当两个事务读取同一行表数据,然后其中一个事务更新该行,最后另一个事务在不考虑第一个事务所做的任何更改的情况下更新同一行时,就会发生更新丢失(lost update)异常。
假设有两个事务打算使同一账户的余额增加 100 ₽。第一个事务读取了当前值 (1000 ₽),然后第二个事务读取了相同的值。第一个事务增加了余额 (使余额变为 1100 ₽),并将新值写入数据库中。第二个事务也是如此:在增加余额后获得 1100 ₽,并写入该值。结果,客户损失了 100 ₽。
在所有隔离级别下,SQL 标准都禁止更新丢失。
脏读与 Read Uncommitted
当一个事务读取了另一个事务所做的未提交的更改时,就会发生脏读(dirty read)异常。
例如,第一个事务将 100 ₽ 转移到一个空账户,但没有提交此更改。另一个事务读取了账户的状态 (已被更新但还未提交),并允许客户提取这笔钱 — 即使第一个事务中断并且其更改被回滚,所以账户其实是空的。
SQL 标准允许在读未提交隔离级别下发生脏读。
不可重复读与 Read Committed
当一个事务两次读取同一行数据,而在这两次读取之间,另一个事务更新 (或删除) 了这一行并提交了更改时,就会发生不可重复读(non-repeatable read)异常。最终,第一个事务得到了不同的结果。
例如,假设有一条一致性规则,禁止银行账户中出现负余额。第一个事务准备使账户余额减少 100 ₽。它检查当前值,得到 1000 ₽,因此认定此操作是可行的。同时,另一个事务从该账户中取出了所有钱并提交更改。如果第一个事务在此时再次检查余额,它会得到 0 ₽ (但取钱的决定已经做出,那么这个操作会导致透支)。
SQL 标准允许在读未提交和读已提交隔离级别下发生不可重复读。
幻读与 Repeatable Read
当同一个事务执行两次相同的查询,返回一组满足特定条件的行,而在这两次查询期间,另一个事务添加了一些满足此条件的其他行,并提交了此更改,就会出现幻读(phantom read)异常。最终,第一个事务获得了两组不同的行。
例如,假设有一个一致性规则,禁止客户拥有三个以上的账户。第一个事务打算开一个新账户,因此它检查当前有多少个账户可用 (假设有两个),并认定此操作是可行的。此时,第二个事务也为该客户开了一个新账户并提交了更改。如果第一个事务再次检查打开的账户数量,它会得到三个 (但它已经在开另一个账户,客户最终拥有了四个账户)。
SQL 标准允许在读未提交、读已提交和可重复读隔离级别下发生幻读。
无异常与 Serializable
SQL 标准还定义了可串行化隔离级别,该级别不允许任何异常。这与禁止更新丢失、脏读、不可重复读和幻读不同。事实上,已知异常的数量远远超过标准定义的数量,还有未知数量的未知异常。
可串行化隔离级别必须防止任何异常。这意味着应用程序开发人员不必考虑隔离问题。如果事务在单独运行时执行正确的语句序列,那么并发执行也不能破坏数据的一致性。
为了阐述这个概念,我将使用标准中提供的一个众所周知的表格;为清晰起见,此处还添加了最后一列:
| 隔离级别 | 更新丢失 | 脏读 | 不可重复读 | 幻读 | 其他异常 |
|---|---|---|---|---|---|
| Read Uncommitted | — | 是 | 是 | 是 | 是 |
| Read Committed | — | — | 是 | 是 | 是 |
| Repeatable Read | — | — | — | 是 | 是 |
| Serializable | — | — | — | — | — |
为什么是这些异常?
为什么标准只提到了某些可能的异常,而且为什么是这些异常呢?
似乎没有人确切知道。但也可能是在制定最初版本的标准时,其他异常根本未被考虑,因为那时理论远远落后于实践。
此外,当时的假设是隔离必须基于锁。广泛使用的两阶段锁定协议 (2PL) 要求事务在执行期间锁定受影响的行,并在完成时释放锁。简单来说,事务获取的锁越多,它与其他事务的隔离程度就越好。相应地,系统的性能就越差,因为事务开始排队访问同一行,而不是并发运行。
我相信,在很大程度上,标准隔离级别之间的区别是由实现它们所需的锁数量来定义的。
如果要更新的行对写入锁定但对读取不锁定,我们便会得到读未提交隔离级别,允许在提交前读取数据。
如果要更新的行对读取和写入都锁定,我们便会得到读已提交隔离级别:禁止读取未提交的数据,但如果查询多次运行,可能返回不同的值 (不可重复读)。
在所有操作中锁定要读取和更新的行,我们便会得到可重复读隔离级别:重复读取同一行会得到相同的值。
然而,可串行化隔离级别带来了一个问题:无法锁定尚不存在的行。这为幻读的发生留下了可能性:一个事务可以添加满足先前查询条件的行,并且这一行将出现在下一个查询结果中。
因此,常规的锁无法提供完全隔离:要实现这一点,我们必须锁定条件 (谓词) 而不是行。谓词锁早在 1976 年 System R 开发时就被引入了;然而,它们的实际适用范围有限,只适用于那些很容易判断两个不同谓词是否可能冲突的简单条件。据我所知,在任何系统中从未实现过预期形式的谓词锁。 (第 298 页)
2.3 PostgreSQL 中的隔离级别
随着时间的推移,基于锁的事务管理协议被快照隔离(Snapshot Isolation,SI)协议所取代。这种方法的思想是,每个事务访问的是在特定时间点呈现的数据一致性快照。这个快照包括在快照生成之前提交的所有当前更改。
快照隔离最大限度地减少了所需的锁数量。实际上,只有在尝试并发更新时,行才会被锁定。在所有其他情况下,操作均可以并发执行:写操作不会锁定读操作,读操作也永远不会锁定任何东西。 (第 268 页)
PostgreSQL 使用了 SI 协议的多版本形式。多版本并发控制意味着,在任何时候数据库系统都可以包含同一行的多个版本,因此 PostgreSQL 可以将适当的版本包含在快照中,而不是中止尝试读取老版本数据的事务。
基于快照,PostgreSQL 的隔离级别与标准中指定的要求有所不同 — 总体上更加严格。脏读从设计上是禁止的。技术上,你可以指定读未提交级别,但其行为与读已提交相同,因此我将不再提及这个级别。可重复读既不允许不可重复读,也不允许幻读 (尽管它不保证完全隔离)。但在某些情况下,读已提交隔离级别存在更新丢失的风险。 (第 161 页)
| 隔离级别 | 更新丢失 | 脏读 | 不可重复读 | 幻读 | 其他异常 |
|---|---|---|---|---|---|
| Read Committed | 是 | — | 是 | 是 | 是 |
| Repeatable Read | — | — | — | — | 是 |
| Serializable | — | — | — | — | — |
在探讨隔离的内部机制之前,让我们从用户的角度分别讨论这三个隔离级别。 (第 97 页)
为此,我们将创建一个账户表;Alice 和 Bob 分别拥有 1000 ₽,但 Bob 拥有两个账户:
Read Committed
不会脏读。很容易验证无法读取脏数据。让我们开启一个事务。默认情况下,它使用读已提交 3 隔离级别:
更确切地说,默认级别由以下参数设置,可以按需修改:
已开启的事务从客户账户中提取一些资金,但尚未提交这些更改。它会看到自己的更改,因为这总是被允许的:
在第二个会话中,我们启动另一个事务,此事务也在读已提交级别下运行:
可以预见的是,第二个事务看不到任何未提交的更改 — 因为脏读是被禁止的。
不可重复读。现在提交第一个事务的更改。然后第二个事务执行相同的查询:
查询接收到的是更新后的数据版本 — 这正是在读已提交级别下允许的不可重复读异常。
一个实用的见解是:在事务中,你不能基于之前语句读取的数据做出任何决策,因为中间的一切都可能发生变化。这里有一个例子,其变体经常出现在应用程序代码中,可以被认为是一个经典的反模式:
在检查与更新之间,其他事务可能任意改变账户的状态,因此这样的“检查”并不能提供保护。可以设想,其他事务的任意语句都可能“插入”当前事务的语句之间。例如,像这样:
如果一旦重新排列语句就出现了问题,代码便是不正确的。不要自欺欺人地认为永远不会遇到这种麻烦:任何可能出错的事情都会出错。这类错误很难复现,因此,修复它们是一项真正的挑战。
你该如何修正此代码?有几个选项:
用声明式代码替换过程式代码。
例如,在这个特定案例中,很容易将 IF 语句转换为 CHECK 约束:
现在你不需要在代码中进行任何检查:只需简单地运行命令,并处理在尝试违反完整性约束时引发的异常就足够了。
使用单个 SQL 语句。
如果一个事务在另一个事务的语句之间的时间间隙内提交,那么数据一致性可能会受到影响,从而改变数据的可见性。如果只有一个语句,则不存在这样的间隙。
PostgreSQL 提供了足够的能力,可以用一个 SQL 语句解决复杂任务。特别是,它提供了可以包含 INSERT、UPDATE、DELETE、MERGE 等语句的通用表表达式(CTE),以及以原子方式实现“如果行不存在则插入,否则更新”逻辑的 INSERT ON CONFLICT 语句。(v. 15)
- 使用显式锁定。
最后的手段是手动对所有需要的行(SELECT FOR UPDATE)甚至整张表(LOCK TABLE)设置排他锁。这种方法总是有效,但会抵消 MVCC 的所有优势:一些本来可以并发执行的操作将改为串行执行。 (第 268 页) (第 261 页)
不一致读。然而,事情并非总是那么简单。PostgreSQL 的实现方式允许一些其他鲜为人知的异常,这些异常并不受标准约束。
假设第一个事务已经开始在 Bob 的账户之间转移资金:
与此同时,另一个事务开始遍历 Bob 所有的账户以计算它们的总余额。它从第一个账户开始 (当然,查看的是它之前的状态):
此时,第一个事务成功完成:
第二个事务读取第二个账户的状态 (并且看到已经更新的值):
结果,第二个事务得到了 1100 ₽,因为它读取了不正确的数据。这种异常称为不一致读(read skew)。
在读已提交级别该如何避免这种异常?答案很明显:使用单个语句。例如,像这样:
到目前为止,我一直在强调数据的可见性只能在语句之间发生变化,但事实真的如此吗?如果查询运行了很长时间呢?在这种情况下,它能否看到处于不同状态的数据的不同部分?
让我们试试。一种便捷的方式是通过调用 pg_sleep 函数为语句添加延迟。然后立即读取第一行,但第二行将不得不等待两秒钟:
在执行这条语句时,让我们开启另一个事务将钱转回去:
结果表明,语句看到的所有数据都处于其执行开始时的状态,这当然是正确的:
但情况也并非那么简单。如果查询中包含一个声明为 VOLATILE 的函数,而这个函数执行了另一个查询,那么这个嵌套查询看到的数据将与主查询看到的数据不一致。
让我们使用以下函数检查 Bob 账户中的余额:
我们将在延迟查询执行时,再次在账户之间转移资金:
在这种情况下,我们将获得不一致的数据 — 100 ₽ 丢失了:
需要强调的是,这种情况只可能发生在读已提交隔离级别下,而且函数必须被声明为 VOLATILE。问题在于,PostgreSQL 默认使用的恰好就是这种隔离级别和易变性类别。因此,我们不得不承认,这个陷阱设置得非常狡猾。
不一致读而不是更新丢失。 在同一个语句内,也可能发生不一致读异常,即使发生方式有些出人意料。
让我们看看如果两个事务试图修改同一行时会发生什么。目前 Bob 的两个账户中总共有 1000 ₽:
开启一个事务,减少 Bob 的余额:
同时,另一笔事务将计算总余额为 1000 ₽ 或者更多的所有客户账户的利息:
执行 UPDATE 语句实际上包含两个阶段。首先实际执行 SELECT 语句,根据条件选择要更新的行。由于第一个事务的修改尚未提交,第二个事务看不到它,因此它不会影响用于计算利息的行选择。这样,Bob 的账户满足条件,操作完成后余额应增加 10 ₽。
在第二阶段,逐个更新所选行。第二个事务必须等待,因为 id = 3 的行被锁定:它正在被第一个事务更新。
与此同时,第一个事务提交了它的更改:
一方面,UPDATE 命令不应看到另一个事务所做的修改;但另一方面,也不应丢失另一个事务已提交的修改。
一旦锁被释放,UPDATE 语句重新读取要更新的行 (但仅限这一行!)。结果,基于总额 900 ₽,Bob 获得了 9 ₽ 的利息。但如果他有 900 ₽,他的账户本就不应该包含在查询结果中。 (第 279 页)
因此,这个事务读到了不正确的数据:有些行处于一个时间点的状态,另一些行却处于另一个时间点的状态。我们再次观察到不一致读异常,而不是更新丢失。
更新丢失。但是,如果数据被不同的 SQL 语句修改,那么重新读取锁定行的技巧将无法防止更新丢失。
此处是一个我们已经见过的例子。应用程序读取并记录 (在数据库外) Alice 账户的当前余额: (第 50 页)
同时,另一个事务也做同样的事情:
第一个事务将先前记录的值增加了 100 ₽,并提交了这个更改:
第二个事务也做同样的事情:
不幸的是,Alice 丢失了 100 ₽。数据库系统不知道记录的 800 ₽ 值与 accounts.amount 有某种关联,因此无法防止更新丢失异常。在读已提交隔离级别下,这段代码是不正确的。
Repeatable Read
不会出现不可重复读和幻读。顾名思义,可重复读隔离 4 级别必须保证可重复读取。让我们确认一下,确保幻读也不会发生。为此,我们开启一个事务,将 Bob 的账户恢复到之前的状态,并为 Charlie 创建一个新账户:
在第二个会话中,让我们开启另一个事务,在 BEGIN 命令中明确指定可重复读级别 (第一个事务的隔离级别并不重要):
现在,第一个事务提交其更改,第二个事务重复相同的查询:
第二个事务仍然看到和之前相同的数据:新行与更新的行都不可见。在这个隔离级别下,你不必担心在语句之间会发生某些变化。
序列化失败而不是更新丢失。 正如我们已经看到的,在 Read Committed 隔离级别下,两个事务更新同一行可能导致不一致读异常:等待的事务必须重新读取锁定的行,因此它看到该行的状态与其他行相比处于不同的时间点。 (第 61 页)
在可重复读隔离级别下,不允许出现这种异常,如果确实发生了,事务只能因序列化失败而中止。我们可以通过重复带利息计算的场景来确认这一点:
数据保持一致:
对同一行的任何其他并发修改,即使没有涉及我们关注的列,也会引发同样的错误。
如果我们尝试基于之前存储的值更新余额,我们也会遇到这个错误:
一个实用的见解是:如果你的应用程序对写事务使用可重复读隔离级别,那么必须准备好重试那些由于序列化失败而结束的事务。对于只读事务,这种结果是不会发生的。
不一致写入。 正如我们已经看到的,PostgreSQL 在 Repeatable Read 隔离级别的实现可以防止标准中描述的所有异常,但并不是所有可能的异常——没有人知道异常究竟有多少。不过,有一个重要事实已经得到证明:无论还有多少其他异常,快照隔离都恰好留下两种异常。
其中第一种异常是不一致写入(write skew)。
假设有这样一条一致性规则:只要同一客户所有账户的总余额非负,就允许该客户的个别账户余额为负。
第一个事务获取 Bob 账户的总余额:
第二个事务获得了相同的余额:
第一个事务合理地假设它可以从其中一个账户中扣除 600 ₽:
第二个事务也得出相同的结论,但是从另外一个账户中扣除了资金:
Bob 的总余额现在是负数,尽管如果两个事务分开运行,都是正确的。
只读事务异常。 只读事务异常是 Repeatable Read 隔离级别允许的第二种、也是最后一种异常。要演示它,需要运行三个事务,其中两个事务更新数据,第三个事务只读。
首先让我们先恢复 Bob 的余额:
第一个事务计算 Bob 总余额应累积的利息,并将此金额添加到他的一个账户中:
然后第二个事务从 Bob 的其他账户中取出一些钱并提交此更改:
如果第一个事务在此时提交,就不会出现异常:我们可以认为先执行了第一个事务,再执行第二个事务(但反过来不行,因为第一个事务看到的是第二个事务修改前的 id = 3 账户状态)。
不过,设想此时启动第三个(只读)事务,查询 Bob 各账户的余额。它可以看到第二个事务(已经提交)的更改,但看不到第一个事务(尚未提交)的更改:
另一方面,我们此前已经确定,第二个事务应当被视为在第一个事务之后启动。这个异常的后果要到第一个事务完成后才会显现:
此时,Bob 的账户总余额是 900 ₽(这是只读事务看到的结果),但利息却是按 1000 ₽ 的总额计算的:
Serializable
在 Serializable 5 隔离级别下,所有可能的异常都会被防止。Serializable 实际上是在快照隔离之上构建的。Repeatable Read 下不会发生的异常(例如脏读、不可重复读和幻读)在 Serializable 下同样不会发生。而 Repeatable Read 下确实可能发生的两种异常(不一致写入和只读事务异常)会被特殊检测,并在这种情况下中止事务,从而产生我们熟悉的序列化失败。
没有异常。 让我们确认不一致写入场景最终会以序列化失败结束: (第 67 页)
只读事务异常的场景也将导致同样的错误。
延迟只读事务。为了使只读事务既不会引发异常,也不会受到异常的影响,PostgreSQL 提供了一个有趣的解决方案:可以推迟此事务,直到其执行变得安全。这是 SELECT 语句唯一可能被更新阻塞的情况。
我们将通过重复演示只读事务异常的场景来确认这一点:
让我们明确声明第三个事务为 READ ONLY 和 DEFERRABLE:
尝试运行查询会阻塞事务 — 否则,它将导致异常。
只有当第一个事务提交后,第三个事务才能继续执行:
因此,如果应用程序使用可串行化隔离级别,那么必须准备好重试那些由于序列化失败而结束的事务。(可重复读级别也需要相同的方式,除非应用程序仅限于只读事务。)
Serializable 隔离级别简化了编程,但代价是检测异常和强制中止部分事务的开销。声明只读事务时显式使用 READ ONLY,可以降低这种影响。但真正的问题当然是被中止事务的比例有多大,因为这些事务必须重试。如果 PostgreSQL 只中止那些确实在数据上发生不兼容交叉的事务,情况就会好得多。然而,这种实现不可避免地会消耗过多资源,因为它必须跟踪每一行上的操作。
当前的实现允许误判:PostgreSQL 可以中止一些绝对安全的事务,这些事务仅仅是运气不佳。它们的“运气”取决于许多因素,例如是否存在适当的索引或可用的 RAM 量,因此很难提前预测实际行为。 (第 298 页)
如果使用 Serializable 隔离级别,它必须应用于应用程序的所有事务。把不同隔离级别的事务混用时,Serializable 会在不发出任何警告的情况下表现为 Repeatable Read。因此,使用 Serializable 时,最好修改参数 default_transaction_isolation 的值(默认值: read committed),当然,仍然可以显式指定错误的级别。
实现还有其他限制,例如,在 Serializable 隔离级别运行的查询不能在副本上执行。尽管这一功能仍在不断改进,但当前的限制和开销降低了这个隔离级别的吸引力。(v. 12)
2.4 该使用哪种隔离级别?
PostgreSQL 中的默认隔离级别是读已提交,显然绝大多数的应用程序都使用该级别。这个级别很方便,因为它只允许在失败的情况下中止事务;它不会为了保持数据一致性而中止任何事务。换句话说,不会发生序列化失败,因此你无需关心事务重试。
这个级别的缺点是可能发生大量异常,这在上面已经详细讨论过。开发人员必须始终牢记这些异常,并以防止它们发生的方式编写代码。如果无法在单个 SQL 语句中定义所有需要的操作,那么你必须使用显式锁定。最困难的部分是,代码很难测试与数据不一致相关的错误;这些错误可能以不可预测且几乎无法重现的方式出现,因此也很难修复。
可重复读隔离级别消除了一些不一致问题,但遗憾的是,并非全部。因此,你不仅要谨记剩余的异常,还要修改应用程序以正确处理序列化失败,这当然很不方便。但是,对于只读事务,此级别是对读已提交的完美补充;它对于生成涉及多个 SQL 查询的报告等场景非常有用。
最后,可串行化隔离级别使你完全不用担心数据一致性,这在很大程度上简化了代码的编写。应用程序唯一需要做的是能够重试因序列化失败而中止的任何事务。然而,被中止事务的数量和相关开销可能显著降低系统吞吐量。同时你还应该记住,备库上不支持可串行化隔离级别,并且不能与其他隔离级别结合使用。
3 页面与行版本
3.1 页面结构
每个页面都有特定的内部布局,通常由以下部分组成1:
页头;
指向行版本的项指针数组;
空闲空间;
行版本;
特殊空间。
页头
页头位于地址的最低处,其大小固定。它存储着关于页面的各种信息,比如校验和以及页面其他所有部分的大小。(第 127 页)
这些大小可以通过 pageinspect 扩展查看。让我们看一下表的第一个页面,页号从零开始2:
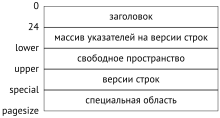
图中文字(从上到下):页头、行版本指针数组、空闲空间、行版本、特殊空间。左侧边界标记依次为 0、24、lower、upper、special、pagesize。
特殊空间
特殊空间位于页面的另一端,占据最高地址。某些类型的索引用它来存储辅助信息;其他情况下,包括堆页面在内,这个空间的大小为零。
总体上,索引页面的布局更加多样,具体内容取决于索引类型。即使同一种索引也可以有不同种类的页面:例如,B-树(B-tree)有一个特殊结构的元数据页面(第零页),以及按照堆页面方式组织的“普通”页面。(第 529 页)
行版本
行(rows)位于特殊空间之前,其中包含存储在数据库中的实际数据,以及一些管理信息。
对于表,我们讨论的不只是行,而是行版本(row versions,tuples),因为多版本机制允许同一行存在多个版本。多版本机制不用于索引;索引会引用表中所有可能的行版本,再根据可见性规则从中选出合适的版本。
tuple 这个术语来自关系理论,译为元组。这也是 PostgreSQL 学术历史留下的一项遗产。为避免混淆理论与数据库管理系统的内部实现,我会采用行版本这一说法;在不会造成歧义时,有时会简称为行。
项指针
指向行版本的指针数组充当页面的目录,紧接在页头之后。
索引条目必须以某种方式引用表中的行版本。为此,PostgreSQL 使用六字节的行版本标识符(tuple id,tid)。标识符包含主分支文件中的页号,还必须包含对该页面内特定行版本的引用。(第 29 页)
这种引用本来可以使用行版本相对于页面起始位置的偏移量。但这样一来,移动页面内的行版本就会破坏索引中的引用,进而造成页内空间碎片和其他问题。
因此,这里使用间接寻址:行版本标识符引用指针编号,再由指针指向行版本在页面中的当前位置。移动行版本时,其标识符保持不变,只需修改位于同一页面中的指针即可。
每个指针恰好占四个字节,包含以下信息:
行版本相对于页面起始位置的偏移量;
行版本长度;
定义行版本状态的若干位。
空闲空间
指针与行版本之间可能留有空闲空间,这些空间会记录在空闲空间映射中。页面内部不会有碎片,所有空闲空间始终聚集成一个连续区域3。(第 31 页)
3.2 行版本结构
每个行版本都包含一个行头,后面跟着实际的数据。行头由多个字段组成,包括以下内容:
xmin、xmax:事务 ID,用于区分同一行的这个版本与其他版本;
infomask:一组定义行版本属性的信息位;
ctid:指向同一行的下一个更新版本的引用;
空值位图:标记允许包含空值(NULL)的列的位数组。
因此,行头相当大:每个行版本至少需要 23 字节,而且由于空值位图以及数据起始位置必须对齐,通常还会更大。在“窄”表中,管理信息占用的空间完全可能超过有效数据。
磁盘上的数据格式与内存中的表示完全一致。页面及其中的行版本按原样读入缓冲区缓存,无需任何转换。因此,一个平台的数据文件与其他平台并不兼容4。
不兼容的原因之一是字节序。例如,x86 架构采用从低位到高位的小端序(little-endian),z/Architecture 采用相反的大端序(big-endian),而 ARM 的字节序可以切换。
另一个原因是许多架构要求数据按机器字边界对齐。例如,在 32 位 x86 系统中,整数(integer 类型,占四字节)按四字节字边界对齐,双精度浮点数(double precision 类型,占八字节)也是如此。而在 64 位系统中,double 值按八字节字边界对齐。
由于需要对齐,表中行的大小取决于字段的排列顺序。通常这种影响不太明显,但有时可能使行的大小显著增加。例如:
这里使用的 heap_page_items 函数由 pageinspect 扩展提供,可以获取指针和行版本的信息。
PostgreSQL 用 heap(堆)来指代表。这又是一个不太直观的用法,暗示为行版本分配空间的机制与动态内存分配相似。当然,两者有一定相似之处,但管理表所用的算法完全不同。也可以把这个词理解为“全都堆在一起”,以强调它与有序索引的区别。
这一行占 56 字节,其中行头占 24 字节,两个 float 列各占 8 字节,两个 boolean 列各占 1 字节。合计为 42 字节,另外 14 字节浪费在 float 的八字节字边界对齐上。重建表可以更有效地利用空间:
但还要考虑到,页面中的行版本本身也需要对齐。正如预期,行的大小变成了 42 字节,但行与行之间仍然会浪费 6 字节:
另一种可能的微优化,是把所有长度固定且不允许空值的列放到表的开头。这样可以缓存字段相对于行版本起始位置的偏移量,从而提高访问这些字段的效率5。
3.3 行版本操作
为了区分同一行的不同版本,每个行版本都有两个标记来定义其“有效时间”:xmin 和 xmax。不过,这里使用的并非实际时间,而是不断递增的事务 ID 计数器。(第 134 页)
创建一行时,其 xmin 值被设置为执行 INSERT 命令的事务 ID。
删除一行时,其当前版本的 xmax 值被设置为执行 DELETE 命令的事务 ID。
在一定程度上,可以把 UPDATE 命令看成 DELETE 和 INSERT 两个操作。先将当前行版本的 xmax 设置为执行 UPDATE 的事务 ID,再为同一行创建新版本;新版本的 xmin 与前一个版本的 xmax 相同。同样,MERGE 命令也可以“拆解”为基本的插入和删除操作。(v. 15)
接下来,我将详细展示各种行版本操作在底层是如何执行的6。
对于这些实验,我们需要一个含有两列的表,并在其中一列上创建索引:
插入
开启一个事务并插入一行:
这是当前的事务 ID:
PostgreSQL 常用 xact 作为事务的缩写,在函数名和代码中都能看到它。因此,事务 ID 会写成 xact id、txid,甚至直接写作 xid。后面还会多次遇到这些名称。
让我们看一下页面内容。heap_page_items 函数可以提供所需的全部信息,但它按原样显示数据,格式不太容易理解:
为了看得更清楚,我们只保留一部分信息,并解释其中几列的含义:
此查询完成了以下操作:
将指针
lp转换为行版本标识符的常用形式:(页号,指针编号)。解释指针状态
lp_flags。这里的值为 normal,表示该指针确实指向一个行版本。暂时只选出所有信息位中的两对。
xmin_committed和xmin_aborted表示编号为xmin的事务是否已提交或已中止。对于xmax事务,xmax_committed和xmax_aborted则提供相应信息。
pageinspect 扩展提供了 heap_tuple_infomask_flags 函数,可以解释所有信息位。但这里仅以更紧凑的形式输出当前需要的信息位。(v. 13)
插入行后,堆页面中出现了编号为 1 的指针,它引用第一个行版本,也是目前唯一的行版本。
行版本的 xmin 字段被设置为当前事务 ID。该事务仍处于活动状态,因此 xmin_committed 和 xmin_aborted 位均未设置。
xmax 字段填入的是占位编号 0,因为这个行版本没有被删除,仍然有效。由于 xmax_aborted 位已经设置,事务不会理会这个编号。
为一个根本没有发生过的事务设置“已中止”位,似乎有些奇怪。但从隔离性的角度看,两者是一样的:中止的事务不留下痕迹,因此就相当于没有发生过。
这个查询还会用到多次,因此我将它封装成一个函数。同时,为了让输出更紧凑,去掉信息位所在的列,把事务状态附在事务 ID 后面:
现在,行版本头部的情况就清楚多了:
使用 xmin 和 xmax 伪列,也可以从表本身获得类似但远不如它详细的信息:
提交
事务成功完成后,需要记下它的状态,标明它已经提交。为此,PostgreSQL 使用名为 clog(commit log,提交日志)的结构。它并非系统目录表,而是 PGDATA/pg_xact 目录中的专用文件7。
clog 被拆成多个文件只是为了方便。这些文件通过服务器共享内存中的缓冲区逐页访问。clog 缓存的大小由 transaction_buffers 参数设置,默认是缓冲区缓存大小的 。(v. 17)(第 309 页)
与行版本头部一样,clog 为每个事务分配两个位:committed 和 aborted。
因此,事务提交时,会在 clog 中设置该事务的 committed 位。其他事务访问我们的堆页面时,必须回答一个问题:编号为 xmin 的事务是否已经结束?
- 如果还没有结束,创建的行版本就不应该可见。
要检查事务是否仍在运行,需要查看另一个位于实例共享内存中的结构:ProcArray。它列出了所有活动进程,并为每个进程记录其当前的活动事务 ID。
- 如果已经结束,是提交还是中止?如果是中止,该行版本同样不应该可见。
这项检查需要使用 clog。尽管最新的 clog 页面保存在内存缓冲区中,每次都进行这种检查仍有不小的开销。因此,事务状态一经查明,就会写入行版本头部的 xmin_committed 和 xmin_aborted 信息位;这些位也称为提示位(hint bits)。只要其中一个位已设置,xmin 事务的状态就被视为已知,下一个事务便无需再访问 clog 或 ProcArray。
为什么不由插入行的事务设置这些位?因为在插入时,它还不知道自己能否成功完成。而到了提交时,又已经不清楚究竟修改了哪些页面中的哪些行。涉及的页面可能很多,记住它们并不划算。而且,一些页面可能已经从缓冲区缓存逐出到磁盘;仅仅为了修改这些位而重新读取它们,会显著拖慢提交。
这种节省也有代价:任何事务,即使只是执行简单读取的 SELECT,也可能设置数据页面中的信息位。这样一来,缓冲区缓存中的这些页面自然就变成了脏页。
现在,终于可以提交事务最开始执行的那次行插入了:
页面中没有任何变化,但我们知道,事务状态已经写入 clog:
接下来,第一个以“正常”方式访问页面、而非通过 pageinspect 访问的事务,必须确定 xmin 事务的状态,并将它写入信息位:
删除
删除一行时,会把执行删除的事务 ID 写入当前行版本的 xmax 字段,并清除 xmax_aborted 位。(第 268 页)
当 xmax 对应一个活动事务时,这个值也起着行锁的作用。如果另一个事务打算更新或删除该行,就必须等到 xmax 事务结束。
让我们删除一行:
事务 ID 已写入 xmax 字段,但信息位尚未设置:
中止
中止更改的机制与提交相似,速度也同样快,只不过在 clog 中设置的是 aborted 位而非 committed 位。尽管命令名为 ROLLBACK,实际上并不回滚更改:事务在数据页面中已经做出的所有修改都保留在原处。
访问页面时,会检查事务状态,并在行版本中设置 xmax_aborted 提示位。xmax 编号本身仍保留在页面中,但之后不会再被理会:
更新
更新的执行方式,就像先删除当前行版本,再插入一个新版本:
查询返回一行,即新版本:
但页面中保留了两个版本:
先前被删除的行版本,其 xmax 字段现在被标记为当前事务 ID。由于之前的事务已经中止,这个值会覆盖原值。同时,xmax_aborted 位被清除,因为当前事务的状态尚不明确。
最后,提交事务。
3.4 索引
任何类型的索引都不会为其条目维护多个版本,每个索引条目都只有一份。换句话说,索引条目的头部没有 xmin 和 xmax 字段。索引会引用表中的所有行版本;事务必须访问表,才能确定哪个版本对它可见,除非该页面已在可见性映射中标记。(第 115 页)
为方便起见,让我们创建一个简单的函数,使用 pageinspect 扩展显示页面中的所有索引条目。在 B-树的一个页面内部,条目以扁平列表的形式排列。(第 523 页)
可以看到,索引页面引用了表中两个行版本,既有当前版本,也有旧版本:
由于 BAR < FOO,指向第二个行版本的指针在索引中排在第一位。
3.5 TOAST
TOAST 表本质上是一张普通表,维护着自己的多版本机制:“toast”的版本与主表的行版本并不关联。不过,TOAST 表的内部操作方式决定了其中的行从不更新,只会添加或删除,因此这里的多版本机制是一种退化形式。(第 33 页)
数据发生变化时,主表总会创建一个新行版本。但如果更新没有涉及存储在 TOAST 中的“长”值,新行版本仍会引用 TOAST 表中原来的值。只有当更新改变了这个长值时,才会同时创建主表的新行版本和新的“toast”。
3.6 虚拟事务
PostgreSQL 使用了一种可以“节约”事务 ID 的优化。
如果事务只读取数据,就不会影响行版本的可见性。因此,后端进程最初只为事务分配一个虚拟事务 ID(virtual xid),由后端进程标识符和一个序号组成。分配这个编号不需要所有进程之间的同步,因此速度很快。此时,事务还没有真正的事务 ID8:(第 259 页)
在不同时间,系统中的虚拟事务完全可以使用曾经用过的编号。这没有问题,因为虚拟编号仅在事务活动期间存在于内存中,既不会写入数据页面,也不会落盘。
一旦事务开始修改数据,就会为它分配一个真正且唯一的事务 ID:
3.7 子事务
保存点
SQL 定义了保存点(savepoint),允许撤销事务中的一部分操作,而不中止整个事务。但这不符合前面介绍的机制:一个事务的所有修改只有一个共同状态,而且数据本身并不会物理回滚。
为了实现这一功能,带有保存点的事务被拆成若干个子事务(subtransaction),各自的状态可以单独管理9。
子事务拥有自己的事务 ID,大于主事务的 ID。其状态照常写入 clog,但已提交的子事务会同时设置 committed 和 aborted 两个位。最终状态取决于主事务:如果主事务中止,它的所有子事务也都被视为已经中止。
事务嵌套关系保存在 PGDATA/pg_subtrans 目录的文件中,通过 SLRU 缓存访问这些文件的页面。缓存大小由 subtransaction_buffers 参数设置,默认是缓冲区缓存大小的 。(第 309 页)
不要把子事务与自治事务混为一谈。与子事务不同,自治事务彼此完全独立。原生 PostgreSQL 没有自治事务,这或许是好事:真正需要它们的场合极少,而其他数据库管理系统提供了这项功能,反而容易招致滥用,让所有人受累。
让我们清空表,开启一个事务并插入一行:
现在创建一个保存点,并插入另一行:
注意,pg_current_xact_id 函数返回的是主事务 ID,而不是子事务 ID。
让我们回滚到保存点,并插入第三行:
在页面中,仍然可以看到已经中止的子事务添加的行。
提交更改:
现在可以清楚地看到,每个子事务都有自己的状态。
不能在 SQL 中直接使用子事务,也就是说,不能在当前事务结束前再开始一个新事务:
这个机制会在使用保存点、处理 PL/pgSQL 异常,以及其他一些更少见的场景中隐式启用。
错误与操作的原子性
执行操作时发生错误,会怎样?
例如:
发生错误后,事务被视为已经中止,不能再执行任何操作:
即使尝试提交更改,PostgreSQL 也会报告事务已经中止:
为什么发生错误后不能继续执行事务?因为已经完成的操作从不物理回滚,继续执行就能访问出错前完成的部分修改。这不仅会破坏事务的原子性,甚至连单条语句的原子性都无法保证。
正如本例中,语句在出错前已经更新了两行中的一行:
顺便说一下,psql 有一种模式,允许事务在发生错误后继续执行,就好像出错语句的操作已经回滚一样:
不难猜到,在这种模式下,psql 实际上会在每条命令前隐式设置保存点,发生错误时就回滚到该保存点。默认不启用这种模式,因为设置保存点,即使不回滚到它,也会带来显著开销。
postgrespro.ru/docs/postgresql/18/storage-page-layout; include/storage/bufpage.h. ↩︎
backend/storage/page/bufpage.c, 函数 PageRepairFragmentation. ↩︎
backend/access/common/heaptuple.c, 函数 heap_deform_tuple. ↩︎
postgrespro.ru/docs/postgresql/18/transaction-id; backend/access/transam/xact.c. ↩︎
postgrespro.ru/docs/postgresql/18/subxacts; backend/access/transam/subtrans.c. ↩︎
4 数据快照
4.1 什么是数据快照
数据页面在物理上可能包含同一行的多个版本,但每个事务最多只能看到其中一个。事务所看到的不同数据行的所有版本合在一起,构成一个数据快照(snapshot)。快照提供特定时刻的一致(在 ACID 意义上)数据视图,其中只包含创建快照时已经提交的最新数据。(第 54 页)
为了实现隔离,每个事务都使用自己的快照。因此,不同事务看到的数据可能不同,来自不同的时间点,但仍然保持一致。
在 Read Committed 隔离级别下,快照在事务每条语句开始时创建,并在该语句执行期间保持有效。
在 Repeatable Read 和 Serializable 隔离级别下,快照在事务第一条语句开始时创建一次,并一直保持有效,直到事务结束。
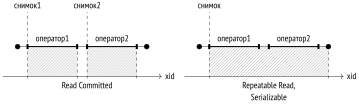
图中文字(从左到右):快照1、快照2、快照;操作1、操作2、操作1、操作2;xid;Read Committed;Repeatable Read、Serializable。
4.2 快照中的行版本可见性
当然,数据快照并不是所有所需行版本的物理副本。实际上,快照由几个数字定义,而快照中的行版本可见性则由规则决定。
某个行版本是否在快照中可见,取决于其头部的 xmin 和 xmax 字段(也就是创建它和删除它的事务编号)以及对应的信息位。xmin–xmax 区间不会相交,因此在任何快照中,每行最多由自己的一个版本表示。
精确的可见性规则1相当复杂,还要考虑许多不同的情况和边界条件。简单地说,当 xmin 事务所做的更改在快照中可见,而 xmax 事务所做的更改不可见时,这个行版本就是可见的(换句话说,该行版本已经出现,但还没有被删除)。
相应地,如果事务在创建快照之前已提交,那么该事务的更改在快照中可见。还有一个例外:事务在快照中可以看到自己尚未提交的更改。中止事务的更改当然不会在任何快照中可见。
下面看一个简单例子。图中用线段表示事务(从开始到提交):
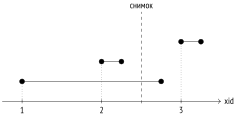
这里:
事务 2 的更改可见,因为它在快照创建之前已结束;
事务 1 的更改不可见,因为创建快照时它仍处于活动状态;
事务 3 的更改不可见,因为它在快照创建之后才开始(无论它是否已结束都不重要)。
4.3 快照由什么组成
遗憾的是,PostgreSQL 实际看到的情况与图中所示完全不同2。原因在于系统不知道事务何时提交。它只知道事务何时开始(由事务编号确定),而事务结束这一事实不会记录在任何地方。(默认为: off)
提交时间会在启用参数 track_commit_timestamp 时被跟踪3,但它完全不参与可见性检查(不过可能有用,例如用于第三方复制方案)。
此外,PostgreSQL 总会在相应的日志记录中保存事务的提交时间和中止时间,但只会在恢复到目标时间点时使用这些信息。
只能知道事务的当前状态。这些信息位于服务器共享内存的 ProcArray 结构中,其中包含所有活动会话及其事务的列表。但事后无法判断某个事务在快照创建时是否处于活动状态。(第 211 页)
因此,创建快照时仅保存创建时刻还不够:还必须记住该时刻每个事务的状态。没有这些状态信息,之后就无法判断哪些行版本应在快照中可见,哪些不应可见。
请比较一下,在快照创建时和一段时间之后,系统分别能获得哪些信息(白色圆圈表示活动事务,黑色圆圈表示已结束事务):
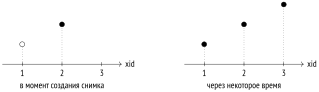
图中文字(从左到右):创建快照时;一段时间后;xid,以及事务编号 1、2、3。
如果不记住创建快照时第一个事务仍在执行,而第三个事务还不存在,就无法把它们与当时已经提交的第二个事务区分开,也就无法将它们排除在外。
因此,PostgreSQL 无法创建一个显示过去某个时刻一致数据状态的快照,即使表页面中存在所有所需的行版本。因此也无法实现回溯查询(也称时态查询或 flashback 查询)。
有意思的是,这项功能曾被列为 Postgres 的目标之一,并且从一开始就已实现;但项目转由社区维护后,它被从数据库系统中移除了4。
所以,数据快照由创建时保存的几个值组成5:
快照的下边界 xmin:最老的活动事务编号。
编号小于它的所有事务要么已提交,此时它们的更改在快照中可见;要么已中止,此时这些更改会被忽略。(第 134 页)
快照的上边界 xmax:它取最近一次已提交事务编号加一的值。上边界定义了快照创建的时刻。
编号大于或等于 xmax 的所有事务要么尚未结束,要么并不存在,因此这些事务的更改绝不会可见。
活动事务列表 xip_list(xid-in-progress list)包含所有活动事务的编号(小于 xmax),但不包括完全不影响可见性的虚拟事务。(第 91 页)
快照中还会保存几个其他参数,不过现在还不重要。
从图形上看,可以把快照表示为一个覆盖 xmin 到 xmax 之间事务的矩形:
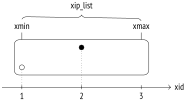
为了看看快照如何决定可见性,我们在 accounts 表上重现上面场景。
第一个事务向表中插入第一行,并保持活动状态:
第二个事务插入第二行并立即提交:
此时,在另一个会话中创建新快照。为此执行任意查询就足够了,但我们直接使用专用函数查看该快照:
该函数用冒号分隔输出快照的三个组成部分:xmin、xmax 和 xip_list(本例中只包含一个编号)。
快照创建后,提交第一个事务:
第三个事务在快照创建后开始执行,并修改第二行。于是出现了新版本:
创建的快照中只有一个版本可见:
但表中有三个版本:
那么 PostgreSQL 如何判断要显示哪些版本?按照上面的规则,只有以下已提交事务的更改会出现在快照中:
编号
xid<xmin的事务:其更改无条件可见(例如创建accounts表的事务);xmin⩽xid<xmax的事务:其更改可见,但位于xip_list中的除外。
第一行(0,1)不可见,因为创建它的事务编号位于活动事务列表中(虽然它也位于快照范围内)。
第二行的最后一个版本(0,3)不可见,因为创建它的事务编号超出了快照的上边界。
不过,第二行的第一个版本(0,2)可见:创建它的事务编号落在快照范围内但不在活动事务列表中(插入可见),而删除它的事务编号超出了快照的上边界(删除不可见)。
4.4 事务自身更改的可见性
确定事务自身更改的可见性时,情况会更复杂,因为有时只应看到其中一部分。例如,在某个时刻打开的游标,无论隔离级别如何,都不能看到之后发生的更改。
为此,行版本头部包含一个特殊字段(显示为伪列 cmin 和 cmax),用于表示事务内操作的序号。cmin 表示插入操作的编号,cmax 表示删除操作的编号;不过为节省行版本头部的空间,实际上它们共用一个字段,而不是两个不同字段。一般认为,在同一个事务中插入并删除同一行的情况很少。(如果确实发生了,系统会在同一个字段中写入一个特殊的“组合编号”,后台进程会为它记录真实的 cmin 和 cmax6。)
举个例子,先开启事务并向表中插入一行:
现在打开一个游标,用于执行返回表中行数的查询:
然后再插入一行:
现在显示表的内容,并增加一列 cmin,只为本事务插入的行显示该值(对其他行来说,这个值没有意义):
游标查询会得到三行而不是四行——游标打开后插入的行不会进入快照,因为快照只考虑满足 cmin < 1 的行版本:
当然,这个 cmin 编号也会保存在快照中,但无法通过 SQL 显示。
4.5 事务视界
快照的下边界(创建快照时处于活动状态的最老事务的 xmin 编号)具有重要含义——它定义了使用该快照的事务的视界。
没有活动快照的事务(例如,Read Committed 隔离级别下两条语句执行之间的事务)的视界由其自身编号决定,前提是它已经分配到编号。
位于视界之外的所有事务(即编号 xid < xmin 的事务)都已经确定提交。这意味着,在自己的视界之外,事务总是只能看到当前的行版本。
这个名称当然来自物理学中的事件视界概念。
PostgreSQL 跟踪所有进程当前的事务视界;事务可以在 pg_stat_activity 表中查看自己的视界:
虚拟事务虽然没有真正的编号,但也像普通事务一样使用快照,因此同样拥有自己的视界。例外是没有活动快照的虚拟事务:对它们而言,视界这个概念没有意义;从数据快照和可见性的角度看,它们对系统完全“透明”(即使 pg_stat_activity.backend_xmin 中可能还保留着旧快照的编号)。
类似地,可以定义数据库视界。为此,取在该数据库中运行的所有事务的视界,找出其中“最远”的一个,即 xmin 最老的那个7。这就是数据库视界:在它之外,该数据库中的任何事务都不可能再看到过期的行版本。这些行版本可以由清理安全删除——这就是视界概念在实践中如此重要的原因。
由此可以得出:
如果处于 Repeatable Read 或 Serializable 隔离级别的事务(无论是真实事务还是虚拟事务)长时间运行,它就会保持数据库视界,从而阻碍清理;
Read Committed 隔离级别下的真实事务同样会保持数据库视界,无论它是在执行语句,还是只是处于空闲状态(idle in transaction);
Read Committed 隔离级别下的虚拟事务只在执行语句期间保持视界。
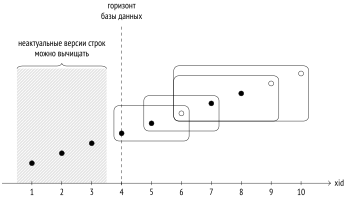
图中文字:数据库视界、过期行版本、可以清理、xid,以及事务编号 1 至 10。
不过,整个数据库只有一个视界;如果某个事务持有这个视界,它就不允许清理该视界以内的数据,即使事务从未访问过这些数据。
对于集群范围的系统目录表,会使用一个单独的视界,该视界会考虑所有数据库中的事务。相反,对于临时表,除了当前进程中正在执行的事务外,无需考虑任何事务。
继续这个例子。第一个会话中的事务仍在执行,并继续持有视界;可以通过增加事务计数器来验证:
只有在事务结束后,视界才会向前推进,清理才能删除过期的行版本:
理想情况下,不应把产生新行版本的更新操作与长事务结合起来,因为这会导致表和索引膨胀。(第 178 页)
4.6 系统目录的快照
虽然系统目录也是由普通表组成的,但访问它们时不能使用事务或语句所用的同一个数据快照。快照必须足够“新”,能够包含所有最新更改,否则事务可能看到已经过时的表列定义,或错过新建的完整性约束。
下面是一个简单例子:
INSERT 命令“看到了”在事务快照创建后才出现的完整性约束。看起来这种行为似乎破坏了隔离性,但如果事务已经访问了 accounts 表,ALTER TABLE 命令就会一直阻塞到该事务结束。(第 261 页)
总的来说,系统的行为就像为每次访问系统目录都创建一个新快照。不过,实现当然更复杂8,因为不断创建新快照会影响性能;此外还要考虑许多系统目录对象都被缓存这一事实。
4.7 导出数据快照
有时,多个并行事务必须确保看到完全相同的数据视图。例如,pg_dump 工具可以以并行模式运行:所有工作进程都必须看到数据库的同一状态,才能生成一致的备份。
当然,不能只因为事务“同时”启动,就指望它们的视图相同。快照导出和导入机制可以提供这样的保证。
函数 pg_export_snapshot 返回一个快照 ID,可以通过数据库系统外部的手段传递给另一个事务:
在执行第一条语句之前,另一个事务可以通过执行 SET TRANSACTION SNAPSHOT 命令导入这个快照。必须先将隔离级别设置为 Repeatable Read 或 Serializable,因为在 Read Committed 级别下,每条语句都会使用自己的快照:
现在第二个事务会使用第一个事务的快照,因此它会看到四行(而不是零行):
显然,第一个事务在导出快照后所做的更改不会被第二个事务看到,反之亦然:仍然遵循通常的可见性规则。
导出快照的生命周期与导出它的事务相同。
Joseph Hellerstein. 回顾 Postgres // habr.com/ru/company/postgrespro/blog/ 438890. ↩︎
backend/storage/ipc/procarray.c, 函数 GetSnapshotData. ↩︎
backend/storage/ipc/procarray.c, 函数 ComputeXidHorizons. ↩︎
backend/utils/time/snapmgr.c, 函数 GetCatalogSnapshot. ↩︎
5 页内剪枝与 HOT 更新
5.1 页内剪枝
在访问堆页面时,无论是更新还是普通读取,都可能执行快速的页内剪枝1。这种情况会在以下三种情形之一出现:
之前的
UPDATE没有找到足够空间,无法把新的行版本放在同一个页面中。这一情况会记录在页面头部。表页面的填充率超过 90%。
表页面的填充率超过存储参数 fillfactor 的值。
只有当页面的填充率低于存储参数 fillfactor 指定的百分比时,PostgreSQL 才会把新行插入(INSERT)该页面。其余空间会为更新(UPDATE)产生的新行版本预留。使用默认值时,表中不会预留空间。(默认值: 100)
页内剪枝会从页面中移除在任何快照中都不再可见的行版本(也就是已经位于数据库视界之外的行版本)。它不会越过单个堆页面,但执行速度很快。被剪掉的行版本对应的项指针不会释放,因为索引可能仍然引用它们,而索引位于另一个页面。出于同样的原因,可见性映射和空闲空间映射也不会更新(因此释放的空间用于更新,而不是插入)。(第 106 页)
页面可以在读取时被剪枝,这意味着 SELECT 语句也可能导致页面发生修改。这是除了延迟设置提示位之外的另一种情况。(第 86 页)
下面通过一个例子看看页内剪枝如何工作。我们创建一个包含两列的表,并在每列上创建一个索引:
如果 s 列只存储拉丁字母,那么每个行版本的大小固定为 2004 字节,另加 24 字节的头部。存储参数 fillfactor 设置为 75%。这意味着页面有足够空间容纳四个行版本,但只能插入三个。
现在插入一行,并多次更新它:
此时页面中有四个行版本:
正如预期,我们刚刚超过了 fillfactor。从 pagesize 和 upper 的差值可以看出这一点:该差值超过页面大小的 75%,也就是 6144 字节。(第 75 页)
下一次访问页面时会触发页内剪枝,移除所有过期行版本。随后,释放出的空间足以容纳新的行版本(0,5):
剪枝后留下的行版本会在物理上向页面地址较高的一侧移动,使所有空闲空间汇聚成一个连续片段。项指针也会相应修改。因此,页面中不会出现空闲空间碎片。
被剪枝行版本对应的项指针暂时不能释放,因为索引页面仍然引用它们;PostgreSQL 会把这些指针的状态从 normal 改为 dead(“死”)。下面查看 hot_s 索引的第一页(第 0 页用于存储元数据):(第 529 页)
在另一个索引中也能看到相同的情况:
进行索引访问时,服务器可能得到 (0,1)、(0,2) 或 (0,3) 作为元组标识符。随后它会尝试从表页面读取对应的元组,却发现项指针处于 dead 状态,也就是该元组已经不存在,应当忽略它。同时,服务器还会修改索引页面中的指针状态,避免以后重复访问表页面2。
扩展用于查看索引页面的函数,增加“死”指针标志:(v. 13)
目前索引页面上的所有指针都处于活动状态。但第一次通过索引访问表后,指针状态就会改变:
虽然第四个指针所引用的表行还没有被剪枝,状态仍为 normal,但它已经位于数据库视界之外。因此,索引中的第四个指针也被标记为 dead。
5.2 HOT 更新
在索引中保存每个行版本的引用效率很低。
首先,每次修改行都必须更新表上创建的所有索引:一旦出现新的行版本,每个索引都必须包含指向它的引用,即使被修改的字段没有被索引。
其次,索引会积累指向历史行版本的引用,之后必须和这些行版本一起清理。(第 125 页)
当然,在表上创建的索引越多,问题就越严重。
但是,如果更新只修改了不属于任何索引的列,就没有必要在索引中创建包含相同值的额外条目。
PostgreSQL 用一种称为 HOT 更新 3(Heap-Only Tuple update)的优化来避免多余的索引条目。这种更新可以在以下三种情况下进行:
表上没有创建任何索引(这种情况下,任何更新都是 HOT 更新);
表上存在索引,但被更新的列没有被任何索引使用;
被更新的列被某个索引使用,但其值没有发生变化。
如果某列以任何方式出现在 CREATE INDEX 命令中,就认为该列被索引使用:索引可以直接建立在该列上,也可以建立在包含该列的表达式上,或者该列作为非键列出现在 INCLUDE 索引中。唯一的例外是 BRIN 索引:其中没有指向表行的引用,因此不会妨碍 HOT 更新。(v. 16)(第 642 页)
执行 HOT 更新时,索引页面中只有一个条目,它指向表行的第一个版本。同一行的其他版本如果仍位于这个表页面中,则通过各版本头部的 ctid 指针连接成一条链。
不被任何索引引用的行版本会标记 Heap-Only Tuple 位。如果某个行版本位于这条链中,则会标记 Heap Hot Updated 位。
如果索引扫描访问表页面时发现某个行版本带有 Heap Hot Updated 标志,就知道不能停在这里,而要沿着更新链继续向后遍历。当然,在把结果返回给客户端之前,服务器会检查这样读到的所有行版本的可见性。
下面删除一个索引并清空表,看看 HOT 更新如何工作。
为方便起见,我们重新定义 heap_page 函数,在输出中增加三个字段:ctid 以及与 HOT 更新有关的两个位:
重复执行插入和更新操作:
页面中出现了一条 HOT 更新链:
Heap Hot Updated 位(
hhu)表示需要沿着ctid链继续前进;Heap Only Tuple 位(
hot)表示没有索引引用这个行版本。
继续更新时,这条链会增长,但只能在页面范围内增长:
此时索引中仍然只有一个引用,它指向这条链的头部:
HOT 更新链不会越过页面边界,因此遍历整条链不需要访问其他页面,也不会降低性能。
表的使用统计会跟踪更新类型。在这个例子中,7 次 UPDATE 操作中有 3 次是 HOT 更新:
5.3 HOT 更新中的页内剪枝
HOT 更新中的页内剪枝是一个特殊但很重要的情况。
在前面的例子中,已经超过了 fillfactor 阈值,因此下一次更新应当触发页内剪枝。但这一次页面中包含一条 HOT 更新链。由于索引引用着链头,链头必须始终留在原位;其他指针则可以释放,因为可以确定没有外部引用。
为了不移动链头,PostgreSQL 使用双重寻址:索引所引用的指针(本例中为 (0,1))会获得 redirect 状态,并指向当前作为链头的行版本:
这里,(0,1)、(0,2) 和 (0,3) 这些行版本已经被剪掉;链头指针 1 保留下来用于重定向,而指针 2 和 3 因为可以确定没有索引引用,已经被释放(状态变为 unused)。新的行版本写入释放出的空间,位置为 (0,2)。
再进行几次更新:
HOT 链增长了:
下一次更新又会触发页内剪枝:
部分行版本被剪掉,指向链头的指针也相应移动。如果继续更新,在这个精心安排的例子中,所有行版本都能一直在同一个页面内循环使用。
5.4 HOT 链断裂
如果页面没有足够的空闲空间容纳新的行版本,链就会断开。位于另一个页面中的行版本需要在索引中增加单独的引用。
为了观察这种情况,我们启动一个并发事务,并在其中创建一个阻止页内剪枝的数据快照:
现在在第一个会话中执行几次更新:
此时所有行版本都还能放在同一个页面中:
下一次更新时,页面将没有足够空间,而页内剪枝也无法释放任何空间:
在版本 (0,5) 中可以看到指向页面 1 的引用 (1,1):
不过,这个引用不会被使用,因为版本 (0,5) 没有设置 Heap Hot Updated 位。至于版本 (1,1),现在可以从包含两个条目的索引访问它。两个条目分别指向各自 HOT 链的头部:
HOT 链断裂会单独记录在统计信息中:(v. 16)
这里,15 次 UPDATE 操作中有 11 次是 HOT 更新:其中 10 次在页面内完成,另 1 次因为空间不足导致链断裂。
如果经常更新不属于索引的列,可以考虑降低 fillfactor,为页面中的更新预留足够空间。当然还要记住,fillfactor 越低,页面中留下的空闲空间越多,表的物理大小也会相应增加。
5.5 索引的页内剪枝
前面说过,页内剪枝只处理一个表页面,不会触碰索引。不过,索引也有自己的剪枝机制4,同样只清理一个页面,这里清理的是索引页面。
当向 B-树插入行即将导致索引页面分裂时,就会发生这种清理,因为原页面已经没有足够空间。问题在于,即使之后删除了一些索引条目,两个索引页面也不会重新合并成一个。这会导致索引膨胀;索引一旦膨胀,即便删除了大量数据,大小也可能无法缩小。但如果页内剪枝能够删除一部分条目,就可以推迟页面分裂。
页内剪枝可以从索引中删除两类条目。
首先,PostgreSQL 会清理此前标记为 dead 的条目5。如前所述,当索引扫描发现某个索引条目指向一个在任何快照中都不再可见、或已经不存在的行版本时,就会设置这个标志。
如果没有找到已知为 dead 的条目,PostgreSQL 会检查那些指向同一个表行的不同版本的索引条目6。由于多版本机制,更新操作可能产生大量行版本,其中许多很可能很快就会越过数据库视界。HOT 更新可以缓解这种影响,但并不总是适用:如果被更新的列属于某个索引,对应的引用就会传播到所有索引。在页面分裂之前,检查那些尚未标记为 dead、但已经可以清理的条目是有意义的。为此,必须检查相应行版本的可见性,而检查需要访问表页面。因此,只有那些“有希望”的索引条目才会被检查;这些条目是在多版本机制下作为现有条目的副本创建的。执行这种检查的代价低于允许一次多余的页面分裂。(v. 14)
backend/access/heap/pruneheap.c, 函数 heap_page_prune_opt. ↩︎
backend/access/index/indexam.c, 函数 index_fetch_heap. ↩︎
backend/access/nbtree/README, Simple deletion 部分. ↩︎
backend/access/nbtree/README, Bottom-Up deletion 部分; include/access/tableam.h. ↩︎
6 清理与冻结
6.1 清理
页内剪枝执行得很快,但只能释放一部分空间。它只在一个表页面内工作,不会触碰索引;反过来,索引的页内剪枝也只在一个索引页面内工作,不会触碰表。
主要的常规清理1由 VACUUM 命令执行2。它会完整处理表,不仅清除无用的行版本,还会从所有索引中清除指向这些行版本的引用。
清理与系统中的其他活动并行进行。执行清理时,表和索引仍可正常读写(但不能同时执行 CREATE INDEX、ALTER TABLE 等命令)。(第 261 页)
为了避免扫描多余的页面,清理会使用可见性映射。映射中已标记的页面会被跳过,因为它们保证只包含有效行版本;其他页面则可能包含可以清除的版本。如果处理后页面中只剩下位于数据库视界之外的行版本,清理就会更新可见性映射。(第 32 页)
清理还会更新空闲空间映射,反映页面中新增的空闲空间。
创建一个表和一个索引:
这里通过存储参数 autovacuum_enabled 禁用自动清理,以便只为实验目的精确控制清理时机。
插入一行,并执行两次更新:
此时表中有三个行版本:
索引中有指向每个行版本的引用:
清理后,死行版本消失,只剩下一个有效版本:
此时,指向被清除版本的前两个项指针状态变为 unused,而不是页内剪枝时的 dead,因为索引中已经没有指向它们的条目:
状态为 unused 的项指针被视为空闲,可以用于新的行版本。
现在,该页面已在可见性映射中标记出来。我们可以通过 pg_visibility 扩展查看该映射:
页面上所有行版本在所有数据快照中都可见,这一点也记录在表页面的页头中:
6.2 再谈数据库视界
清理根据数据库视界判断哪些行版本应视为死版本。这个概念非常重要,值得再回顾一次。
从头重复前面的实验:
不过,在再次更新这一行之前,我们先启动第二个事务,让它持有数据库视界(几乎任何事务都可以,只有以 Read Committed 隔离级别执行的虚拟事务例外)。例如,让这个事务修改另一个表中的某些内容。(第 106 页)
现在表中有三个行版本,索引中有三个引用。清理后会发生什么?
上一次清理后表中只剩一个行版本,而这一次却剩下两个:清理判断版本 (0,2) 还不能删除。原因当然是数据库视界;在这个例子中,视界由尚未结束的事务决定:
可以指定 VERBOSE 子句,让清理报告发生了什么:
这里可以看到:
表中没有发现可以删除的行版本(
tuples: 0 removed);找到两个不能删除的行版本(
2 remain);两个不能删除的版本中有一个是死版本(
1 are dead but not yet removable),另一个是有效版本;当前清理视界(
removable cutoff)与打开事务的视界相同。
结束打开的事务后,数据库视界向前推进,清理也就可以继续:
清理发现一个死行版本已经越过更新后的视界,于是将其删除;页面中只剩下最后一个有效版本:
索引中也只剩一个条目:
6.3 清理的执行阶段
清理的工作看起来并不复杂,但这种简单只是表象。表和索引必须同时处理,同时还不能阻塞其他进程。为此,每个表的清理都分为多个阶段3。
首先扫描表以寻找死行版本;找到的版本先从索引中清除,再从表中清除。如果死版本太多,这个过程可能重复进行。最后,表还会在可能的情况下被截断。
下面详细介绍这些阶段。
表扫描
一切从表扫描开始4,扫描时会考虑可见性映射:映射中标记的页面会跳过,因为它们保证只包含有效行版本。对于从已读取页面中发现的、已经越过视界且不再需要的行版本,会把它们的标识符(tid)写入内存中的专用存储。不能立即删除这些行版本,因为索引可能仍然引用它们。(v. 17)
这个存储采用前缀树5。页面编号是树的键,节点中存放行版本的位图。结构大小受 maintenance_work_mem 参数限制,内存按需分配。(第 605 页)(第 427 页)(默认值: 64MB)
与 PostgreSQL 17 之前使用的普通数组相比,前缀树存储标识符时节省了一个数量级的空间,而且其总大小可以超过 1 GB——一次分配的内存片段的最大大小。
索引清理
接下来有两种可能:要么扫描到达表的末尾,要么用于保存标识符的内存耗尽。无论哪种情况,都会开始索引清理阶段6。为了从索引页面中清除指向已记录行版本的条目,表上创建的每一个索引都必须被完整扫描。
如果知道索引键,索引可以快速找到行版本;但没有办法根据表行版本的标识符快速找到索引条目。针对 B-树的这项工作目前还没有成功7。
对于大小超过 min_parallel_index_scan_size 的每个索引,都可能启动一个独立的工作进程;这样,多个索引就可以并行清理。可以在 VACUUM (parallel N) 命令中指定所需的清理进程数。实际启动的进程数不会超过空闲后台进程数8和符合条件的索引数(因为一个索引不能由多个进程同时处理)。(v. 13)(默认值: 512kB)
索引清理阶段还会维护空闲空间映射,并计算清理统计信息。但如果表中只有新增行(既没有删除也没有更新),就会跳过这一阶段,因为表中不会有死行版本。此时,索引清理会在最后强制执行一次,这称为索引规整9。
索引清理阶段结束后,索引中已经没有指向无用行版本的引用,但这些版本仍然存在于表中。这是正常情况:索引访问已经无法到达它们,而顺序扫描表时,可见性检查会将死版本排除。
表清理
随后开始表清理阶段10。表会再次扫描,以便从页面中清除先前记录的行版本并释放项指针。现在索引已经不再引用这些版本,因此可以安全地这样做。
清理释放的空间会记录到空闲空间映射中;只剩下在所有快照中都可见的有效版本的页面,则会在可见性映射中标记出来。
如果表扫描阶段没有读完整张表,就会清空 tid 存储,并从上次扫描停止的位置继续重复整个过程。
表截断
清理后,表页面中会出现空闲空间;有时还可能恰好释放出完整页面。如果文件末尾形成了一些空页面,清理就可以在最后的表截断阶段11“切掉”文件尾部,并把空间归还给操作系统。
截断需要短暂地获取表的排他锁。获取锁的尝试不会持续超过五秒,以免长时间停止其他进程。(第 261 页)
由于需要锁住表,只有在空页面足够多时才会执行截断:至少占文件的 ,或者对于大表至少 1000 个页面(这些阈值不能配置)。
如果锁仍然造成问题,可以通过几种方式彻底禁用截断:
执行
VACUUM命令,并指定truncate off;(v. 12)关闭存储参数 vacuum_truncate 和 toast.vacuum_truncate;(v. 12)
关闭配置参数 vacuum_truncate。(v. 18)
6.4 冻结
事务计数器回卷
PostgreSQL 为事务编号分配了 32 位。40 亿看起来是一个很大的数字,但在高负载下可能很快耗尽。例如,在每秒 1000 个事务(不包括虚拟事务)的负载下,连续运行一个半月就会耗尽。
位数耗尽后,计数器必须归零并重新开始下一轮计数;英语称之为 wraparound。但只有在编号持续递增时,才能认为编号较小的事务早于编号较大的事务。因此,不能简单地把计数器归零并重新开始编号。
为什么不为事务编号分配 64 位,这样不就能彻底排除这个问题了吗?原因在于,每个行版本的头部都保存两个事务编号:xmin 和 xmax。头部已经相当大(考虑对齐后至少 24 字节),增加位数还会额外占用 8 字节。(第 75 页)
64 位事务编号也会使用12,它们在普通 32 位编号的基础上增加一个 32 位“纪元”,但只用于内部目的,从不会出现在数据页面中。
要正确处理计数器回卷,不能比较事务编号,而要比较事务年龄(即从该事务出现以来启动的事务数量)。因此,不再使用“小于”和“大于”,而使用“先于”(“更老”)和“后于”(“更年轻”)。
在代码中,这自然通过 32 位算术实现:求两个 32 位事务编号的差,再将结果与零比较13。
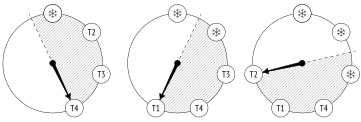
可以把事务编号想象成一个环。对于任意事务,逆时针方向的一半编号更老(在过去),顺时针方向的一半编号更年轻(在未来)。
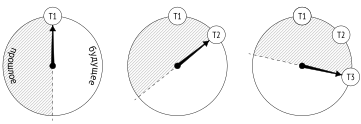
但这种环形方案会产生一个令人不快的情况。对于新的事务,旧事务 T1 位于很久以前;可是过一段时间后,对某个新事务来说,T1 会落入属于未来的那一半圆。如果真的发生这种情况,后果将是灾难性的:很久以前由 T1 做出的更改会对新事务不可见。
行版本冻结与可见性规则
为了避免这种“时间旅行”,清理进程除了释放页面空间外,还要执行另一项任务14:寻找位于数据库视界之外的行版本(因此它们在所有快照中都可见),并以特殊方式标记它们,即冻结这些行版本。(第 274 页)
冻结的行版本不考虑事务编号 xmin,在所有数据快照中都可见,因此这个编号可以安全地重新使用。
可以认为,冻结行版本中的 xmin 被替换成一个约定的“负无穷”(图中用雪花表示),这表明创建该版本的事务早已结束,具体编号已经不重要。实际上,xmin 并不会改变;系统会同时设置提交提示位和中止提示位,作为冻结标志。
许多资料(包括文档)都会提到特殊的事务编号 FrozenTransactionId = 2。这就是 9.4 版本以前用来替换 xmin 的那个“负无穷”。现在使用的提示位可以在行版本中保留原始事务编号,便于维护和调试。不过,在升级到最新版本的旧系统数据页面中,仍然可能遇到事务编号 2。
事务编号 xmax 完全不参与冻结。它只出现在无效行版本中;当这些版本不再对任何快照可见(也就是编号越过数据库视界)时,就会由清理删除。
手动冻结通过 VACUUM FREEZE 命令执行。在这个例子中,它冻结唯一的有效行版本:
现在,这个页面不仅在可见性映射中被标记,也在冻结映射中被标记:
6.5 分析
除了清理之外,还有一项与清理没有正式关系的任务:分析15,也就是收集统计信息。大部分统计信息供查询规划器使用,包括关系中的行数(pg_class.reltuples)和页面数(pg_class.relpages)、表列中的数据分布以及其他信息。可见性映射(pg_class.relallvisible)和冻结映射(pg_class.relallfrozen)中标记的页面数不会被规划器使用,但清理和分析本身需要用它们来管理工作。(第 346 页)
可以单独执行 ANALYZE 命令来手动分析16,也可以把它和清理合并为 VACUUM ANALYZE。不过,这时清理和分析仍然依次执行,并不会节省时间。
从历史上看,VACUUM ANALYZE 这一形式最早出现于 6.1 版,而独立的 ANALYZE 命令直到 7.2 版才出现。更早的版本通过 TCL 脚本更新统计信息。
postgrespro.ru/docs/postgresql/18/sql-vacuum; backend/commands/vacuum.c. ↩︎
backend/access/heap/vacuumlazy.c, 函数 heap_vacuum_rel. ↩︎
backend/access/heap/vacuumlazy.c, 函数 lazy_scan_heap. ↩︎
backend/access/heap/vacuumlazy.c, 函数 lazy_vacuum_all_indexes. ↩︎
backend/access/heap/vacuumlazy.c, 函数 lazy_cleanup_all_indexes; backend/access/nbtree/nbtree.c, 函数 btvacuumcleanup. ↩︎
backend/access/heap/vacuumlazy.c, 函数 lazy_vacuum_heap. ↩︎
backend/access/heap/vacuumlazy.c, 函数 lazy_truncate_heap. ↩︎
include/access/transam.h, 类型 FullTransactionId. ↩︎
backend/access/transam/transam.c, 函数 TransactionIdPrecedes. ↩︎
postgrespro.ru/docs/postgresql/18/routine-vacuuming#VACUUM-FOR-WRAPAROUND. ↩︎
postgrespro.ru/docs/postgresql/18/routine-vacuuming#VACUUM-FOR-STATISTICS. ↩︎
7 自动清理
7.1. 自动清理和分析
只要数据库视界定期向前推进,常规清理就能完成自己的工作。问题在于,应该多久调用一次。
如果对经常变化的表清理得太少,它会膨胀到不希望的大小。此外,表中可能积累太多变化,下一次清理就不得不多次扫描索引。
如果清理过于频繁,服务器就会一直忙于维护,而不是做有用的工作。
工作负载还会随时间变化,所以按固定时间表启动清理无论如何都不合适:表更新越频繁,清理也应越频繁。
这个问题由自动清理1解决:它根据表的变化速度调整清理和分析的触发频率。
自动清理的工作机制
启用自动清理(配置参数 autovacuum)后,系统中始终有一个负责调度的 autovacuum launcher 进程。它依据使用统计维护一个包含活动数据库的列表。这些统计信息由 track_counts 参数启用时收集。不要关闭这两个参数,否则自动清理将无法工作。(默认值: on)(默认值: on)
每隔 autovacuum_naptime 个时间单位,autovacuum launcher(照例通过 postmaster)会为列表中每个“活跃”数据库启动一个 autovacuum worker2。因此,如果集群中使用了 N 个数据库,那么在一个 autovacuum_naptime 间隔内会启动 N 个工作进程。不过,同时运行的工作进程总数受 autovacuum_max_workers 参数限制。(默认值: 1min)(默认值: 3)
工作进程数量上限可以在线调整,但只能在 autovacuum_worker_slots 范围内。调整槽位数量则需要重启服务器,因为这会为共享内存预留空间。(v. 18)(默认值: 16)(第 379 页)
自动清理工作进程与后台工作进程很相似,但早在通用任务机制创建前就已出现。自动清理进程的实现没有改变,因此它们不会占用 max_worker_processes 的槽位。
工作进程启动后会连接指定的数据库,先建立两个列表:
需要清理的全部表、物化视图和 TOAST 表;
需要分析的全部表和物化视图(TOAST 表不分析,因为它们总是通过索引访问)。
随后,工作进程依次清理或分析选中的对象(也可能两种操作都执行),完成后退出。
每个表的清理方式与手动执行 VACUUM 命令相同,但有一些差异:
- 手动清理使用大小为 maintenance_work_mem 的内存片段来累积行版本标识符。
自动清理可能同时运行多个工作进程,每个进程都需要内存。因此,自动清理使用单独的 autovacuum_work_mem 参数。默认情况下它采用普通的 maintenance_work_mem 限制;如果配置中有较多工作进程(autovacuum_max_workers),通常需要相应调整这个值。(默认值: -1)
- 手动清理可以并行处理同一张表上的多个索引,而自动清理不行,否则可能同时启动过多进程。
如果某个工作进程没能在 autovacuum_naptime 间隔内完成预定任务,autovacuum launcher 会向同一个数据库再派出一个工作进程,让它们并行工作。第二个进程会建立自己的待清理和待分析对象列表并开始处理。只有不同的表可以并行处理;同一张表没有并行性。
哪些表需要清理
可以在单个表的层面禁用自动清理,尽管很难想到这样做的理由。为此有两个存储参数,一个用于普通表,另一个用于 TOAST 表:
autovacuum_enabled;
toast.autovacuum_enabled。
通常,自动清理会在死行版本或新行积累到一定数量时触发。(第 153 页)
死行版本。 死行版本的近似数量会持续跟踪,并可在 pg_stat_all_tables 表中查看。
当死行版本数量超过由以下三个参数确定的阈值时,就认为需要清理:
autovacuum_vacuum_threshold:绝对值(数量);(默认值:
50)autovacuum_vacuum_scale_factor:表中行的比例;(默认值:
0.2)autovacuum_vacuum_max_threshold:针对超大表的额外阈值上限。(默认值:
1 亿)(v. 18)
公式如下:当满足以下条件时,需要清理死行版本:
或者(v. 18)
对于大表(潜在问题主要出现在大表上),公式第一部分中的 autovacuum_vacuum_scale_factor 很重要。默认值 20% 似乎高得离谱,很可能需要大幅降低。如果这样得到的阈值对超大表仍然过高,还可以用公式第二部分的参数为它设定上限。
如果无法找到一组适用于所有表的参数值,可以用同名存储参数为特定表覆盖它们(autovacuum_vacuum_threshold、autovacuum_vacuum_scale_factor、autovacuum_vacuum_max_threshold)。带有 toast 前缀的相应存储参数则决定 TOAST 表的设置。
插入的行。 数据仓库常见一种情况:行不断插入,却从不删除或更新。此时表中不会产生死行版本,前面的触发条件也不会满足。但这类表同样需要清理,以便提前冻结行版本并更新可见性映射(从而允许只扫描索引)。因此又增加了一个触发条件。(v. 13)(第 422 页)
如果自上次清理以来插入的行数超过由以下两个参数确定的阈值,就会执行清理:
autovacuum_vacuum_insert_threshold;(默认值:
1000)autovacuum_vacuum_insert_scale_factor。(默认值:
0.2)
与死行版本数量一样,插入行数也作为表使用统计的一部分进行跟踪。
公式如下:
第一个加数只是绝对值,这一点很清楚;第二个加数则需要解释。它计算的不是全部行的比例,而是未冻结行的比例;表中相应部分用完全冻结页面数(relallfrozen)与页面总数(relpages)的比值来估算。原因在于,表不断增大,行数越来越多;没有这个系数,清理的触发频率就会越来越低。而未冻结行的数量会周期性减少,因此触发频率不会增加,这是一件好事。(v. 18)
和前一种情况一样,也可以使用同名存储参数(autovacuum_vacuum_insert_threshold、autovacuum_vacuum_insert_scale_factor)及其 TOAST 对应参数,为单独的表覆盖这些值。
哪些表需要分析
自动分析比清理简单,因为它只考虑发生过变化的行。
如果自上次分析以来修改的行数超过由以下两个参数确定的阈值,就认为需要分析该表:
autovacuum_analyze_threshold;(默认值:
50)autovacuum_analyze_scale_factor。(默认值:
0.1)
自动分析的触发公式为:
也可以使用同名存储参数(autovacuum_analyze_threshold 和 autovacuum_analyze_scale_factor)在表级别覆盖自动分析设置。TOAST 表不参与分析,因此没有对应参数。
自动清理实战
先写一个返回参数当前值的函数:
我们将在视图中使用这个函数,以显示当前哪些表需要清理和分析3。这些视图会用于后面的示例,同时也把本节前面的说明形式化。
清理视图可以这样写:
列 max_dead_tup 显示因死行版本触发自动清理的阈值,列 max_ins_tup 显示因插入新行触发清理的阈值。
下面是相应的分析视图:
列 max_mod_tup 显示触发自动分析的阈值。
为了不长时间等待自动清理,实验中让该进程每秒运行一次:
清空表 vac,再向其中插入 1000 行。提醒一下,表级别的自动清理仍处于关闭状态。
清理视图会显示:
阈值 max_dead_tup = 50,虽然上面的公式给出的结果应该是 50 + 0.2 × 1000 = 250。这是因为表的统计信息还不存在,单独执行 INSERT 不会更新统计信息:
pg_class.reltuples 的特殊常量 −1 用于区分没有统计信息的表和已经分析过、但确实为空的表;后者的这个列值为零。计算时会把负值当作零,因此得到 50 + 0.2 × 0 = 50。(v. 14)
同理,max_ins_tup = 1000 与计算得到的 1200 不同。
再看一下分析视图:
我们修改了 1000 行(这里是插入),这超过了当前按未知表大小计算出的 50 行阈值。因此,自动分析应该会触发。
现在重新启用自动清理:
短暂等待后,表已经完成分析,阈值也修正为正确的 150 行:
回到自动清理:
根据分析过程中得到的表大小,max_dead_tup 和 max_ins_tup 的值也修正了。
现在,清理会在以下两种情况之一发生时执行:
产生超过 250 个死行版本;
向表中插入超过 200 行。(v. 13)
再次关闭自动清理,并更新 251 行,比阈值多一行:
现在触发条件已经满足。启用自动清理,短暂等待后可以看到表已处理,使用统计也已重置:
7.2. 冻结
创建一张新表来实验冻结。把 fillfactor 设为最小值,使每个页面只能容纳两行,这样更容易观察过程。和前面一样,关闭自动清理,以便自行控制清理时机。
再写一个使用 pageinspect 扩展查看页面的函数版本。它会显示一段页面范围,解码冻结标志(f),并显示事务 xmin 的年龄(为此要调用系统函数 age;年龄本身当然不会存储在数据页面中):
向表中插入一些行,并立即执行清理,以便创建可见性映射:
通过 pg_visibility 扩展观察前两个页面。清理完成后,这两个页面都会在可见性映射中标记为 all_visible,但不会标记为 all_frozen,因为其中仍有未冻结的行版本:
创建这些行的事务的 xmin_age 为 1,因为它是系统中最近执行的事务:
7.3. 管理冻结
冻结由四个主要配置参数控制。这四个参数都表示事务年龄,并确定从什么时候开始发生以下事件:
行版本开始冻结:vacuum_freeze_min_age;
执行激进冻结:vacuum_freeze_table_age;
冻结紧急触发:autovacuum_freeze_max_age;
冻结进入优先模式:vacuum_failsafe_age。(v. 14)
冻结的最小年龄
xmin 事务的最小年龄由 vacuum_freeze_min_age 参数确定,只有达到这个年龄,行版本才可以冻结。值越小,开销可能越大:如果一行很“热”并且频繁变化,那么冻结它不断产生的新版本就会白费力气。把参数设得相对大一些,可以先等待一段时间。(默认值: 5000 万)
如果手动调用 VACUUM FREEZE,所有行版本都会被冻结,不考虑事务年龄,就好像 vacuum_freeze_min_age = 0 一样。这正是前面示例中连刚刚创建的行版本也被冻结的原因。
为了观察冻结过程,把它的值降为 1:(第 136 页)
现在更新第 0 页上的一行。由于 fillfactor 值很小,新的行版本会进入同一个页面:
事务年龄增加了 1。现在表页面如下:
现在,年龄大于 vacuum_freeze_min_age = 1 的行版本可以冻结。但清理只处理未在可见性映射中标记的页面:(第 131 页)
只有在连续至少有 32 个页面都被可见性映射标记时,清理才会跳过这些页面4。如果标志交替出现得更频繁,清理就会忽略可见性映射:跳过单独的页面没有多大意义,因为预取会让它们无论如何进入内存。因此,虽然实验只关注两个页面,tfreeze 表仍然创建得足够大。
前面的 UPDATE 命令清除了第 0 页的可见性位,而第 1 页会被清理跳过:
注意,第 0 页上的两个行版本都被冻结了,虽然第二个版本的事务 xmin 年龄没有超过 vacuum_freeze_min_age。既然页面本来就必须修改,位于数据库视界之外的所有行版本都会在该页面上被冻结;这几乎不会增加操作成本,却可能为将来省下工作。(v. 16)
现在两个页面又都在可见性映射中标记了。虽然第 1 页包含未冻结的行版本,但只要它没有发生变化,清理就会跳过它:
激进冻结的年龄
由此可见,如果页面中只剩下在所有快照中都可见的当前行版本,清理就不会冻结它们。vacuum_freeze_table_age 参数可以解决这个问题:当事务年龄达到该值时,清理会忽略可见性映射并冻结所有页面,从而避免事务计数器回卷的后果。这种清理模式称为激进清理;由于它的主要任务是冻结,我也会使用“激进冻结”这个术语。(默认值: 1.5 亿)(第 134 页)
系统目录为每张表保存一个事务编号,并且已知所有早于该事务的事务都已经保证冻结:
清理会将这个已保存事务的年龄与 vacuum_freeze_table_age 的值比较,以决定是否进行激进冻结。
有了冻结映射,清理时就不必扫描整张表,只需检查尚未在映射中标记的页面。冻结映射不仅显著减少工作量,还能抵御中断:如果清理进程停止后重新开始,就不必返回上一次已经处理并在映射中标记的页面。
要冻结整张表,把 vacuum_freeze_table_age 降到 2,使激进冻结条件成立:
执行清理:
现在,激进清理会检查整张表,因此可以推进冻结事务编号:页面中已经保证不存在更老的未冻结事务。
当然,第 1 页上的所有行版本现在都已冻结:
此外,第 1 页也已经在冻结映射中标记:
整张表的激进冻结执行频率不会高于每 vacuum_freeze_table_age − vacuum_freeze_min_age 个事务一次(参数取默认值时为每 1 亿个事务一次)。如果非激进清理也能推进 relfrozenxid,它的实际触发频率还会更低5。无论如何都要注意,vacuum_freeze_min_age 设得过大,可能导致激进冻结过度触发并增加开销,反而达不到节省的目的。(v. 15)
自动清理紧急触发的年龄
有时,前面两个参数仍不足以让行版本及时冻结。可以关闭自动清理,也可以完全不运行常规清理(这当然不应该做,但技术上可行)。此外,还可能有表没有进入自动清理队列,或者存在自动清理根本不会访问的不活跃数据库(例如 template0)。为此,PostgreSQL 提供了以激进模式紧急触发自动清理的机制,可以避免事务计数器回卷。(第 139 页)
当数据库中某个未冻结事务的年龄可能超过 autovacuum_freeze_max_age 时,数据库级激进清理会紧急启动6。即使关闭自动清理,它也会启动,只是不是立刻,而是在第一次手动执行清理或重启服务器时启动。(默认值: 2 亿)
决定是否紧急触发的是数据库中所有表的 pg_class.relfrozenxid 中最老事务的年龄,因为所有更老的事务都已经保证冻结。该事务编号会记录在系统目录中:
datfrozenxid
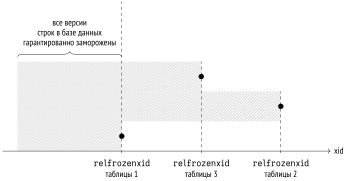
autovacuum_freeze_max_age 的上限是 20 亿个事务(略小于圆的一半),默认值小十倍。这样做是有道理的:值过大,会增加这样的风险——在计数器回卷前剩余的时间内,自动清理来不及冻结所有必要的行版本。此时 PostgreSQL 会为避免问题而紧急停止,之后需要管理员介入才能启动。
此外,这个参数还限制了 clog 结构的大小。整个集群中不可能残留比所有数据库中最老的 datfrozenxid 更老的未冻结事务,而冻结事务不需要保存状态。多余的 clog 文件段会由自动清理删除7。(第 85 页)
修改 autovacuum_freeze_max_age 需要重启服务器。不过,前面讨论的冻结控制参数都可以通过表级存储参数覆盖。注意,这些参数的名称都以“auto”开头:autovacuum_freeze_min_age、autovacuum_freeze_table_age 和 autovacuum_freeze_max_age。
优先冻结模式的年龄
如果自动清理已经在努力防止事务计数器回卷,却明显来不及,就会触发“保险丝”:自动清理不再考虑 autovacuum_vacuum_cost_delay(vacuum_cost_delay)造成的延迟,也停止清理索引,以尽快冻结行版本。(v. 14)
如果数据库中某个未冻结事务的年龄可能超过 vacuum_failsafe_age,就会启用优先冻结模式8。一般认为这个参数应当高于 autovacuum_freeze_max_age。(默认值: 16 亿)
手动调用清理时,如果目标不是释放数据页面空间,而是尽快完成冻结,那么也可以禁用索引清理。可以直接执行 VACUUM (freeze,
index_cleanup false),也可以使用 vacuum_index_cleanup 存储参数。(v. 12)
7.4. 积极扫描
当清理不进行激进冻结时,会跳过在可见性映射中标记的页面,因为这些页面没有需要清除的内容。但这条规则有例外。(v. 18)
前面已经顺带提到一个例外:如果连续的页面不足 32 个,清理就必须扫描那些在可见性映射中标记的页面。跳过这样的小片段不但没有用,反而有害:它可能扰乱操作系统负责页面预取的算法。
另一个例外更有意思。清理可以有意扫描一部分已在可见性映射中标记、但未在冻结映射中标记的页面。这种扫描称为“积极扫描”(eager scanning)。
在这两种情况下,读取到的页面都会应用普通的冻结规则,因此有机会冻结页面上的所有行版本、在冻结映射中标记页面,从而减少激进模式下的工作量。另一方面,读取额外页面会增加负载,不应妨碍主要工作。
如果连续几个页面都无法冻结,很可能说明表的这一片段中所有行版本都还不够老,继续尝试没有意义。片段大小固定为 4096 个页面,失败尝试的比例由 vacuum_max_eager_freeze_failure_rate 参数(或同名存储参数)限制。默认设置允许失败 122 次,随后停止扫描当前片段。(默认值: 0.03)
但表的其他位置可能情况不同,因此进入下一个片段时会重置失败计数,积极扫描也会继续。
所以在最坏情况下,积极扫描会白白读取的页面数,最多相当于那些已在可见性映射中标记但未在冻结映射中标记的页面数乘以 vacuum_max_eager_freeze_failure_rate。将该参数设为 0,实际上就禁用了积极扫描。
即使条件理想,也不应一次冻结太多页面,以免显著延长运行时间,把普通清理变成激进清理。因此成功尝试的数量同样受限,不能超过已在可见性映射中标记但未在冻结映射中标记的页面数的 20%。
为了观察积极扫描中的冻结,把激进冻结年龄恢复为原值,但保留之前设置的普通清理最小触发年龄。
积极扫描并非总会发生;条件之一是表不能太小,至少要有 8192 个页面。因此重新向 tfreeze 填充足够多的行(提醒一下,每个页面能容纳两个行版本):
然后清理这张表,使所有页面都在可见性映射中标记。最后再做一个准备步骤:执行一个事务,让所有行版本的年龄增加 1;现在它们满足冻结条件。
最后一切就绪,用 verbose 参数启动清理:
可以看到,积极扫描在成功冻结 1638 个页面后中断了,这正好是 8192 的 20%。注意,下面几行还显示总共冻结了 1640 个页面:正如前面所说,积极扫描并不是普通清理读取可见性映射页面的唯一情况。例如,最后一个页面总会扫描;如果其中有行版本,清理就不会尝试截断表,以免白白获取排他锁。(第 133 页)
7.5. 加载时冻结
不应再变化的数据可以在初始加载时立即冻结。为此,要使用带有 FREEZE 参数的 COPY 命令。
只有在同一个事务中创建或清空(使用 TRUNCATE)的表,才能在加载时冻结数据。这两个操作都会对表加排他锁。这个限制是必要的,因为冻结行版本无论隔离级别如何,都被视为在所有数据快照中可见;否则,其他事务会在数据加载过程中突然看到刚刚冻结的行版本。但表一旦被锁住,其他事务就无法访问它。(第 261 页)
不过,从形式上说,隔离仍然可能被破坏。在另一个会话中,以 Repeatable Read 隔离级别启动事务:
清空表 tfreeze,并在同一个事务中向它加载新行。(如果读事务已经访问过 tfreeze,TRUNCATE 命令就会被阻塞。)
现在,读事务看到了新数据,隔离性因此被破坏:
不过,数据加载不太可能经常发生,所以在大多数情况下这不会造成问题。
加载时冻结会立即创建可见性映射,并在页头中设置可见性标志:(v. 14)(第 127 页)
因此,加载时冻结后,清理就不会再处理这张表(当然,前提是其中的数据保持不变)。遗憾的是,TOAST 表目前还不支持这一功能:如果加载了较长的值,清理就必须额外重写整个 TOAST 表,才能在所有页头中设置可见性标志。(v. 14)
7.6. 负载调节和监控
清理按页面工作,因此不会阻塞其他进程;但它仍然会给系统增加负载,并可能明显影响性能。
跟踪清理进度,可以发现进程活动过度或效率低下的情况,例如无法处理那些未清理且未冻结、像滚雪球一样不断增加的行版本。
手动清理
清理大约执行 vacuum_cost_limit 个工作单位,然后休眠 vacuum_cost_delay 个时间单位。工作与等待交替进行,可以比较均匀地把清理对系统的影响摊开,避免负载出现峰值。(默认值: 200)(默认值: 0)
vacuum_cost_delay 的默认值为 0,实际上意味着手动清理完全不会休眠,因此 vacuum_cost_limit 的具体值没有作用。这样设定是因为,既然管理员不得不手动启动清理,就很可能希望它尽快完成。
不过,如果设置了休眠时间,那么 vacuum_cost_limit 指定的工作量就由缓冲区缓存中页面操作的成本组成。如果页面在缓冲区缓存中找到,每次读取页面计为 vacuum_cost_page_hit 个单位;如果没有找到,则计为 vacuum_cost_page_miss 个单位9。如果页面原本是干净的,而清理操作又修改了它,还要额外计 vacuum_cost_page_dirty 个单位10。(第 183 页)(默认值: 1)(默认值: 2)(默认值: 20)
如果保持 vacuum_cost_limit 的默认值,清理每个周期最多可以处理 200 个页面(最佳情况:页面都已缓存,且没有新页面变脏),最少只能处理 9 个页面(最坏情况:所有页面都从磁盘读取并变脏)。
带有 VERBOSE 的 VACUUM 命令会执行清理并输出工作报告,而 pg_stat_progress_vacuum 视图会显示已经启动的清理进程的状态。
分析也有类似的视图(pg_stat_progress_analyze),虽然分析执行得很快,通常不会带来问题。(v. 13)
向表中插入更多行并全部更新,使清理能够持续足够长的时间:
为了演示,把用于存储标识符的内存大小降到一个荒谬的小值:
启动清理,并在它运行期间多次查询 pg_stat_progress_vacuum 视图:
该视图还会显示以下信息:(v. 17)
phase:当前清理阶段(前面介绍了主要阶段,但实际上还有更多阶段11);heap_blks_total:表的页面总数;heap_blks_scanned:已扫描的页面数;heap_blks_vacuumed:已经清理的页面数;index_vacuum_count:索引扫描次数;dead_tuple_bytes和num_dead_item_ids:本次扫描收集的死版本大小和数量。
清理的总体进度由 heap_blks_vacuumed 与 heap_blks_total 的比值确定,但要注意,由于索引扫描,这个值会跳跃式变化。
需要重点关注清理循环的次数(字段 index_vacuum_count):如果该值大于 1,说明分配的内存不足以在一次索引扫描中完成清理。不过,只要 maintenance_work_mem 设置合理,出现这种情况的概率很低。还可以用 dead_tuple_bytes 与 num_dead_item_ids 的比值评估存储效率;在这个例子中,每个 tid 大约占用半个字节。
启用 track_cost_delay_timing 后,字段 delay_time 会显示实际休眠时间。需要注意,在某些平台上,跟踪时间可能显著拖慢执行,因此应谨慎使用这个功能。(默认值: off)(v. 18)
此时已经完成的 VACUUM VERBOSE 命令输出了整体情况:
在这个例子中,清理总共需要扫描索引三次。
自动清理
自动清理的负载调节12与普通清理大致相同。但为了让两者能够以不同强度运行,自动清理有自己的一组参数:
autovacuum_vacuum_cost_limit;(默认值:
-1)autovacuum_vacuum_cost_delay。(默认值:
2ms)
如果这些参数中有一个等于 −1,就使用普通清理对应参数的值。也就是说,默认情况下,autovacuum_vacuum_cost_limit 使用 vacuum_cost_limit 的值。
一个周期内受 autovacuum_vacuum_cost_limit 限制的自动清理工作单位由所有工作进程共享,因此无论工作进程数量是多少,系统总负载都大致相同。所以,如果要加快自动清理,增加 autovacuum_max_workers 的同时,也应按比例增加 autovacuum_vacuum_cost_limit。
如有需要,可以通过存储参数(autovacuum_vacuum_cost_limit 和 autovacuum_vacuum_cost_delay)及其 TOAST 对应参数,为不同的表设置各自的值。
前面已经介绍过的 need_vacuum 和 need_analyze 视图,可以用来跟踪需要清理和分析的表的列表。如果列表变长,说明自动清理跟不上,需要通过缩短暂停时间(autovacuum_vacuum_cost_delay)或增加两次暂停之间的工作量(autovacuum_vacuum_cost_limit)来加快它。也可能还需要提高并行度(autovacuum_max_workers)。
除了查询之外,监控自动清理还有一种标准方法:把与 VACUUM VERBOSE 输出类似的信息写入服务器消息日志,以便后续分析。
把 log_autovacuum_min_duration 设为 0,这样日志会记录自动清理的每次运行:(默认值: -1)
同时开启清理休眠时间的跟踪。手动清理默认不休眠,跟踪它没有太大信息量;但对自动清理来说,这可能提供值得分析的信息。(v. 18)
再次更新表中的所有行,让自动清理有事可做:
从日志可以看出,自动清理大部分时间都在等待,因此还有足够余量来提高速度。
清理和分析表所花费的总时间(毫秒)可以从系统统计中获得:(v. 18)
postgrespro.ru/docs/postgresql/18/routine-vacuuming#AUTOVACUUM。 ↩︎
backend/postmaster/autovacuum.c,函数 relation_needs_vacanalyze。 ↩︎
backend/access/heap/vacuumlazy.c,函数 heap_vac_scan_next_block。 ↩︎
backend/access/transam/varsup.c,函数 SetTransactionIdLimit。 ↩︎
backend/commands/vacuum.c,函数 vac_truncate_clog。 ↩︎
backend/access/heap/vacuumlazy.c,函数 lazy_check_wraparound_failsafe。 ↩︎
backend/storage/buffer/bufmgr.c,函数 ReadBuffer_common。 ↩︎
backend/storage/buffer/bufmgr.c,函数 MarkBufferDirty。 ↩︎
postgrespro.ru/docs/postgresql/18/progress-reporting#VACUUM-PHASES。 ↩︎
backend/postmaster/autovacuum.c,函数 autovac_balance_cost。 ↩︎
8 重建表与索引
8.1. 完全清理
为什么需要完全清理
常规清理释放的空间比页内剪枝更多,但即使如此,也不一定能完全解决问题。
如果表或索引文件因某种原因大幅膨胀,常规清理可以释放现有页面中的空间,但大多数情况下无法减少页面数量。只有在文件末尾形成完全空的页面时,清理才能把空间返还给操作系统,而这种情况并不常见。(第 133 页)
空间过大会带来一些令人不快的后果:
全表(或全索引)扫描会变慢;
可能需要更大的缓冲区缓存(缓存的是页面,而页面中有用信息的密度会下降);
B-树中可能出现额外层级,从而减慢索引访问;
磁盘和备份中的空间使用不够合理。
如果文件中有用信息的比例降到某个合理阈值以下,管理员可以执行完全清理1,运行 VACUUM FULL 命令。它会先重建表,再从头重建表的所有索引,并尽可能紧凑地组织数据(考虑 fillfactor 参数)。重建对象期间,磁盘上会同时保存旧文件和新文件2,因此完全清理可能需要相当多的可用空间。(第 111 页)
需要注意,整个重建期间,表都会被完全锁定,既不能写入,也不能读取。
评估信息密度
为了举例说明,我们先关闭自动清理,再向表中插入一些行:
可以使用专门的 pgstattuple 扩展方便地评估信息密度:
该函数会读取整张表,并输出文件中空间分布的统计信息。tuple_percent 字段显示有用数据(行版本)占用的空间比例。由于页面内部的管理信息会产生开销,这个值必然小于 100%,但在本例中仍然相当高。
索引输出的信息有所不同,但 avg_leaf_density 字段的含义相同:它表示有用信息在叶页面中所占的比例。
前面使用的 pgstattuple 扩展函数会完整读取表或索引,以获得精确的信息。对于大型对象,这可能代价太高,因此扩展还提供了 pgstattuple_approx 函数;它会跳过可见性映射中标记的页面,并给出近似数值。
一种更快但精度更低的方法,是根据系统目录粗略估算数据量与文件大小的比例3。
下面是表和索引占用的空间:
现在删除全部行的 90%:
执行常规清理后,文件大小没有变化,因为文件末尾没有空页面:
但信息密度大约降低了十倍:
现在,表和索引分别位于以下文件中:
现在检查完全清理后的结果。
命令运行期间,可以在 pg_stat_progress_cluster 视图中跟踪执行进度;该视图与普通清理使用的 pg_stat_progress_vacuum 视图类似。(v. 12)
当然,完全清理的执行阶段4与常规清理不同。
完全清理后,文件已经换成了新的文件:
表和索引的大小都明显减小了:
因此,信息密度也提高了,而且索引中的密度甚至高于最初的水平。对于已有数据,从头创建 B-树索引通常比把数据逐行插入现有索引更划算:
冻结
重建表时,行版本会被冻结,因为与其余工作量相比,这几乎不增加成本:
不过,页面既不会在可见性映射中标记,也不会在冻结映射中标记,页头中也不会设置可见性标志(使用带 FREEZE 参数的 COPY 命令时会设置该标志):(第 161 页)
只有执行 VACUUM 命令(或触发自动清理)后,情况才会得到修正:
这实际上意味着,即使重建时表页面中的所有行版本都已经位于数据库视界之外,这样的页面仍然需要再次重写。
8.2. 其他重建方式
完全清理的替代方式
除完全清理外,还有几条命令可以完整重建表和索引。它们都会以独占方式锁定表上的操作,也都会删除旧数据文件并创建新文件。
CLUSTER 命令与 VACUUM FULL 基本相同,但还会根据现有索引之一对文件中的行版本重新排序。这使规划器在某些情况下能够更高效地使用索引访问。不过必须明白,聚簇效果不会持续维护:表后续发生修改后,行版本的物理顺序就会被破坏。(第 409 页)(第 415 页)
从代码实现看,VACUUM FULL 只是 CLUSTER 的一个特例,不需要重新排列行版本5。
REINDEX 命令用于重建一个或多个索引6。VACUUM FULL 和 CLUSTER 在处理完表、转而处理索引时,实际上会使用这条命令的机制。
TRUNCATE 命令7会删除表中的所有行,在逻辑上相当于执行不带 WHERE 条件的 DELETE。但 DELETE 只是把行版本标记为已删除,后续还需要清理;而 TRUNCATE 会直接创建一个新的空文件,通常快得多。(第 87 页)
无需长时间锁定的重建
完全清理不适合定期使用,因为它在整个运行期间都会完全阻塞对表的访问(包括执行查询)。对于高可用系统,这通常无法接受。(第 261 页)
有一些扩展(例如 pg_repack8)可以在几乎不中断服务的情况下重建表和索引。表的独占锁仍然不可避免,但只需在开始和结束时短暂持有。其实现更加复杂:重建期间,触发器会保存对原表的数据修改;随后,工具将这些修改应用到新表,并在系统目录中用新表替换原表。
pgcompacttable 工具9提供了一种有意思的解决方案。它反复对表中的行执行不改变数据的伪更新,使当前行版本逐渐在文件内向前移动。每轮更新之间都会运行清理,删除过期行版本并逐步截断文件。这种方法耗时和耗费资源都多得多,但不需要额外空间重建表,也不会造成负载峰值。截断表时同样会短暂获取独占锁,但清理对这种锁的处理相当温和。(第 133 页)
8.3. 预防措施
只读查询
文件膨胀的原因之一,是长时间运行的事务在数据持续更新的同时保持着数据库视界。(第 106 页)
长时间运行的(只读)事务本身不会造成问题。因此,常见的做法是把负载分配到不同的机器上:在副本上执行 OLAP 事务,把快速的 OLTP 事务留在主服务器上。当然,这会让系统更复杂、更昂贵,但有时可能是必要的。
有时,长时间运行的事务并非出于必要,而是应用程序或驱动程序的错误所致。如果无法妥善解决问题,管理员可以使用两个参数:idle_in_transaction_session_timeout 用于限制空闲事务的最长生存时间,transaction_timeout 用于限制事务的总持续时间。经过指定的时间后(如果该值不为零),事务就会被中止。(默认值: 0ms)(默认值: 0ms)(v. 17)
数据更新
膨胀的另一个原因,是一次性修改大量行。更新表中的所有行可能使行版本数量增加一倍,而清理来不及介入。页内剪枝可以缓解这个问题,但也仅此而已。
向表中添加 processed 列,用它标记已经处理的行:
更新所有行后,表的大小大约增加了一倍:
解决办法是减少单个事务中执行的修改量,并把修改分散到一段时间内,以便清理能够删除不需要的行版本,并在现有页面中为新行版本腾出空间。如果假定每一行的更新都可以单独提交,就可以使用下面这个查询作为模板,从表中选出指定大小的一批行:
这段代码会选出不超过指定大小的一组行,并立即将它们锁定。已经被其他事务锁定的行会被跳过,下次会进入另一批。这个方法相当通用且方便,可以轻松调整批大小,并在发生故障时重新处理。现在重置处理标志,并执行完全清理,以恢复表的原始大小:(第 285 页)
更新第一批后,表的大小会略有增加:
但之后大小几乎不再增长,因为新的行版本会添加到已清理行版本留下的位置。
第二部分:缓冲区缓存与预写日志
9 缓冲区缓存
9.1. 输入输出与缓存
一般考虑
输入输出操作可以分为直接输入输出和缓冲输入输出。
直接输入输出(Direct I/O)在用户进程内存与磁盘之间直接传输数据。如果支持直接内存访问(DMA),这种操作甚至不会占用处理器。
缓冲输入输出会使用操作系统及其缓存。用户进程通过系统调用请求数据。如果所需数据在缓存中,操作系统会立即返回结果;否则会先从磁盘读取数据。无论哪种情况,数据都会先(可能提前)放入操作系统内核内存中的缓存,然后再复制到用户进程内存中;在这里,后者就是 PostgreSQL 的缓冲区缓存。
虽然这里讨论的是内存和磁盘,但同样的缓存思想也用于弥补任意两种内存之间的性能差异:一种更快、更昂贵、容量更小,另一种更慢、更便宜、容量更大。快速内存不可能容纳慢速内存中的全部数据。但在大多数情况下,同时活跃处理的只是一个很小的子集,因此拿出一部分快速内存保存“热”数据,就能显著减少访问慢速设备的次数。在现代计算系统中,缓存无处不在,既存在于软件层面,也存在于硬件层面。仅处理器本身就可以有三四级缓存;磁盘阵列控制器和磁盘自身也可能有缓存。
输入输出操作也可以用另一种方式分类。
执行同步输入输出时,进程发送命令后会阻塞。操作执行期间,进程只能空闲等待它完成。
执行异步输入输出(Async I/O)时,进程创建并发送任务,然后继续工作。它会在方便的时候稍后回来获取结果。如果操作已经完成,进程会立即得到结果;否则会像同步输入输出一样阻塞,直到操作完成。
很明显,直接输入输出可以提供更高的吞吐量和更低的数据获取延迟,而异步输入输出可以减少空闲时间并完成更多有用工作。但从编程角度看,普通的同步缓冲输入输出要简单得多,性能损失也远没有想象中那么大。PostgreSQL 使用同步缓冲输入输出已经三十年了。这是因为,虽然数据库系统代码按顺序运行,输入输出实际上是异步执行的:操作系统经常会预测读取顺序,并在数据库系统后台提前把所需数据读入自己的缓存。数据预取和脏页延迟写入的工作都交给了操作系统。
自行实现异步输入输出的动机,是减少对操作系统的依赖:不同系统执行预取的效果并不相同,而数据库系统无论如何都更清楚自己何时需要哪些页面。此外,还可以异步地把数据同步到磁盘(fsync)。
切换到直接输入输出也有好处:可以消除双重缓存(操作系统缓存和 PostgreSQL 缓冲区缓存),并有可能显著提高性能。但这样也会失去操作系统提供的全部支持。我们必须根据访问方法的特点自行实现数据预取,并自行把脏页刷到磁盘上,均匀分摊写入负载;还需要把小型输入输出请求合并为大型请求的算法。缺少这些机制时,直接输入输出只会让系统变慢。
当前状态
让 PostgreSQL 摆脱文件系统的工作已经进行了几年。(v. 18)
直接输入输出由 debug_io_direct 参数启用,但在所需功能尚未全部实现之前,这个设置只对内核开发者有意义。(默认值: off)(v. 16)
异步输入输出1目前只支持读取;写入和同步仍然是同步的。现在有几种输入输出实现,其中一种由 io_method 参数指定:可以选择当前平台支持、并且在具体系统中表现最好的方法。(默认值: worker)
- 当值为
worker时,输入输出由独立的工作进程执行2。这种方法适用于所有平台,也是默认选择。
为了读取一个页面或连续的几个页面,服务进程或系统进程会把请求放入所有工作进程共享的队列。随后,其中一个工作进程会执行请求的操作,例如把所需页面读入缓冲区缓存。
工作进程数量固定,由 io_workers 参数决定。在核心数较多的服务器上,可以适当增大这个值(最大值为 32)。(默认值: 3)
- 当值为
io_uring时,进程本身通过 Linux 内核的同名接口执行输入输出,因此只能在 Linux 上工作3。
io_uring 接口在用户进程内存中使用两个环形缓冲区(因此得名 user-space ring):一个用于输入输出请求,另一个用于获取这些请求的结果。由于缓冲区位于进程内存中,与接口交互时无需系统调用,也不会发生上下文切换。
- 当值为
sync时,使用普通的同步输入输出。
io_uring 接口的潜在效率高于工作进程,但也有一些细节需要注意。除了实际输入输出外,还需要检查已读页面的校验和;在输入输出仍然采用缓冲方式时,还需要把读取的数据从操作系统缓存复制到 PostgreSQL 缓冲区缓存。选择 io_uring 时,这些工作由当前进程执行;选择 worker 时,则由工作进程分担。因此,只有一个进程进行密集读取时,worker 很可能更有优势,尤其是在工作进程数量足够时;相反,如果有许多读取进程产生大量细小的单页请求,就可能受限于工作进程池的规模。
从本质上说,异步输入输出由两个数值调节:可以同时执行的异步输入输出操作数,以及一次操作读取的连续页面数。不过,相关参数不止两个。
io_max_concurrency 参数设置每个进程最多可以执行的异步操作数。实例启动时在共享内存中为异步输入输出创建的数据结构,其大小取决于这个值与系统中最大进程数(包括服务进程)的乘积。使用默认值时,数量会根据缓冲区缓存大小自动选择,但不会超过 644。(默认值: -1)
io_max_concurrency 本身并不限制单个进程的操作数。这个限制由另外两个参数设置:effective_io_concurrency 用于表数据的常规读取,maintenance_io_concurrency 用于清理等维护任务。将这两个参数设为零,实际上会禁用异步输入输出。由于并行度取决于输入输出设备的能力,这些参数也可以在表空间级别设置。(默认值: 16)(默认值: 16)
一次输入输出操作最多可以读取多少数据,由 io_combine_limit 参数设置;默认值相当于 16 个标准的 8 KB 页面。如果操作系统支持更大的操作,增大该值可能有利于经常完整扫描大表的 OLAP 系统。(默认值: 128 kB)
io_combine_limit 参数可以在线修改,但不能超过另一个参数 io_max_combine_limit 设定的范围;修改后者需要重启服务器。(默认值: 128 kB)
目前只有以下操作会异步执行:
顺序读取(Seq Scan);(第 374 页)
位图扫描(Bitmap Heap Scan);(第 427 页)
清理和分析表,以及清理 B-树、GiST 和 SP-GiST 索引;(第 125 页)
预热缓冲区缓存(扩展
pg_prewarm);检查关系完整性(
amcheck扩展的verify_heapam函数)。
如果禁用了异步输入输出,PostgreSQL 会在执行这些操作时,根据 effective_io_concurrency 或 maintenance_io_concurrency 的值,尝试向操作系统提示所需的预取深度。还有两种目前尚未使用异步输入输出、但同样会发起预取的操作:
视图 pg_aios 显示异步输入输出描述符;这些描述符确定操作,并在操作执行期间保存其状态。不过,该视图主要面向内核开发者,而不是用于日常监控。
9.2. 缓冲区缓存的结构
PostgreSQL 缓冲区缓存7保存关系页面,用来弥合内存访问时间(纳秒)与磁盘访问时间(毫秒)之间的差异。
缓冲区缓存位于服务器共享内存中,所有进程都可以访问。它占据大部分共享内存,是最重要、最复杂的数据结构之一。理解缓存的工作原理本身就很重要;此外,许多其他结构(例如嵌套事务、clog 事务状态和日志记录)也使用类似但更简单的缓存机制。
之所以称为缓冲区缓存,是因为它由一组缓冲区组成。每个缓冲区都会预留一段足以容纳一个数据页面及其对应缓冲区头部的内存8。
缓冲区头部包含缓冲区和其中已加载页面的信息,例如:
页面的物理位置(关系文件标识符、层和层内的块号);
表示页面数据已经改变、迟早需要写回磁盘的标志(这样的页面称为脏页);
缓冲区访问次数(usage count);
缓冲区钉住计数(pin count 或 reference count)。
要访问关系的数据页面,进程会向缓冲区管理器9请求页面,并得到包含该页面的缓冲区编号。进程从缓存中的页面读取数据,也可以直接在那里修改数据。在处理页面期间,缓冲区会被钉住,使管理器不能用其他页面替换它。每次钉住都会增加页面的访问计数。除了钉住之外,还会使用其他锁。(第 306 页)
页面位于缓冲区缓存中时,对它的操作不会产生文件操作。
可以使用 pg_buffercache 扩展查看缓冲区缓存:
创建一张表,并向其中插入一行:
现在,缓冲区缓存中有一个包含刚插入行的表页面。可以筛选出属于特定表的缓冲区来确认这一点。后面还会用到这个查询,因此把它封装成一个函数:
页面是脏的(isdirty),因为它已经被修改但还没有写入磁盘。访问计数(usagecount)为 1。
9.3. 缓存命中
当缓冲区管理器需要读取页面10时,会先尝试在缓冲区缓存中查找页面。为了快速找到所需缓冲区,系统使用保存缓冲区编号的哈希表11。
许多现代编程语言都把哈希表作为基本数据类型之一。它们通常称为关联数组。从用户角度看,关联数组确实像数组,但作为索引(称为哈希键)可以使用任意数据类型,例如文本字符串,而不只是整数。
哈希键的可能取值范围可以非常大,但哈希表同时保存的值并不多。哈希的思想是通过哈希函数把键值映射为某个整数,再把这个数或其中的一部分位用作普通数组的索引。这样的数组元素称为哈希表的桶。
好的哈希函数会把键均匀分布到各个桶中,但仍可能为不同的键产生相同的数,从而把它们放入同一个桶;这称为冲突。因此,桶中除了值还会保存哈希键;按键读取值时,还要重新检查落入同一个桶的所有键。
哈希表有许多实现方式。缓冲区缓存使用可动态扩展、通过链解决哈希冲突的哈希表12。
哈希键由关系文件标识符、层类型以及该层文件中的页面编号组成。因此,只要知道页面,就可以快速找到包含它的缓冲区,或者确认该页面不在缓存中。
长期以来,哈希表一直受到批评。这种结构无法帮助查找某个关系的所有页面占用的缓冲区。而在执行 DROP、清空(TRUNCATE)或清理期间截断表尾时,正需要这样查找,以便从缓存中移除相应页面13。但目前还没有人提出好的替代方案。
如果在哈希表中找到了缓冲区编号,管理器就会钉住该缓冲区,并把编号返回给进程。此后,进程可以在缓冲区缓存中处理页面,而不会发生输入输出。(第 133 页)
要钉住缓冲区,需要增加其缓冲区头部中的 pin count;同一个缓冲区可以同时被多个进程钉住。
只要缓冲区处于钉住状态(即计数器大于零),就认为它正在使用中,其内容不应发生“根本性”变化。例如,页面中可以出现新的行版本(根据可见性规则,它不会可见),但页面不能被另一个页面替换。
带有 analyze 和 buffers 参数的 EXPLAIN 命令不只是显示查询计划,还会执行查询,并输出使用的缓冲区数量:
hit=1 表示需要读取的一个页面已经在缓存中找到。
钉住缓冲区使访问计数增加了 1:
现在更新这一行,使页面中出现两个版本:一个是当前版本,另一个是死版本。稍后会用到这个状态。
打开游标的好处在于钉住状态会保持,因此可以快速取得结果集的下一行。这样就能在查询执行期间观察钉住状态:
有时进程确实需要一个已经钉住的缓冲区,此时它会排队并休眠,直到能够独占访问该缓冲区。例如,冻结操作就是如此14。(第 134 页)
但通常情况下,如果钉住状态妨碍进程继续工作,进程会直接跳过这个缓冲区并选择另一个。表清理就是一个例子。这里会跳过页面,因为另一个进程设置的钉住状态阻止了死版本的物理删除:
游标移动到另一个页面或关闭后,钉住状态就会解除。在本例中,这与事务结束同时发生:
修改页面时,钉住机制也以同样方式工作。例如,再向表中插入一行(它会进入同一个页面):
页面不会立即写入磁盘,而是继续在缓冲区缓存中保持脏状态:这样读取和写入都可以节省开销。
9.4. 缓存未命中
如果哈希表中没有与页面对应的记录,就说明页面不在缓冲区缓存中。此时会为页面选择一个新的缓冲区并立即钉住它,把页面读入该缓冲区,同时相应修改哈希表中的引用。
移除缓冲区中的页面(也可以重启实例,以此清空整个缓冲区缓存):(v. 17)
尝试读取页面会造成缓存未命中,页面会被加载到新为它分配的缓冲区中:
这次命令显示的是 read,而不是 hit,表示发生了缓存未命中。查询还让页面变脏(dirtied),因为查询修改了页面上的提示位。(第 86 页)
查询缓冲区缓存可以看到,刚加载页面的使用计数为 1:
可以从 pg_statio_all_tables 视图获得表的缓冲区缓存使用汇总统计:
索引和序列也有相应的视图。
缓冲区查找与驱逐
寻找合适的缓冲区15并不容易。可能出现两种情况。
- 服务器刚启动时,缓存中只有空的空闲缓冲区,它们都连接在同一个列表中。
只要还有空闲缓冲区,列表中的第一个就适合使用,并会从列表中移除。
只有在页面消失而不是被另一个页面替换时,缓冲区才会回到空闲缓冲区列表16。这发生在 DROP、TRUNCATE 或清理期间截断表的尾部时。(第 133 页)
- 迟早会用完空闲缓冲区(因为数据库大小通常超过为缓存分配的内存),此时管理器必须选择一个已占用的缓冲区并驱逐其中的页面。为此使用“时钟”算法(clock sweep):有一个“时钟指针”指向某个缓冲区,指针会循环遍历缓冲区缓存,把页面访问计数减 1。当指针到达一个未钉住且计数为零的缓冲区时,搜索结束。
一方面,每次使用(钉住)缓冲区时,访问计数都会增加;另一方面,为驱逐而查找缓冲区时,访问计数会减少。因此,最近较少访问的页面会优先被驱逐,而频繁使用的页面会留在缓存中。
可以看到,如果所有缓冲区的访问计数都不为零,“时钟指针”就必须转过一圈以上,不断降低计数,直到某个计数终于变成零。为避免长时间“绕圈”,访问计数的最大值被限制为 5。
找到缓冲区后,需要从哈希表中删除仍位于该缓冲区内的旧页面的引用。
但如果缓冲区是脏的,也就是包含已修改的数据,就不能直接丢弃旧页面;缓冲区管理器必须先把它保存到磁盘。(第 226 页)
无论找到的是空闲缓冲区还是已占用缓冲区,缓冲区管理器都会把新页面读入其中。这里使用的是缓冲输入输出,因此只有在操作系统自己的缓存中找不到页面时,才会从磁盘读取页面。
使用直接输入输出且不依赖操作系统缓存的数据库系统,会区分逻辑读取(从内存,也就是缓冲区缓存读取)和物理读取(从磁盘读取)。从 PostgreSQL 的角度看,页面要么从缓冲区缓存读取,要么向操作系统请求;但数据库系统无法知道后一种情况下页面是从内存中找到的,还是从磁盘读取的。
新页面的引用会放入哈希表,缓冲区也会被钉住。这会使访问计数增加,也就是把它设为 1。这样,在“时钟指针”绕缓冲区缓存转圈时,缓冲区就有时间逐步增加自己的访问计数。
9.5. 批量驱逐
执行大量读取或写入的操作可能会用“一次性”数据迅速驱逐缓冲区缓存中的有用页面。
为避免这种情况,缓冲区缓存会为批量操作使用相对较小的缓冲区环(buffer ring),驱逐只在环内进行,不影响其他缓冲区。
代码中除了“buffer ring”还使用“ring buffer”,也就是“环形缓冲区”。但这样翻译会造成混淆,因为这个(环形)缓冲区本身由缓冲区(缓冲区缓存)组成。“环”这个译法没有这个问题。
指定大小的缓冲区环是一个缓冲区数组,缓冲区会依次循环使用。开始时缓冲区环为空,缓冲区按普通方式从缓冲区缓存中加入环;之后驱逐开始生效,但只在环内进行17。
环中的缓冲区并不会从缓冲区缓存中移除,原则上也可以被其他操作使用。因此,如果下一个缓冲区处于钉住状态或访问计数大于 1,它就会从缓冲区环中移除,并换成另一个缓冲区。
一共有三种驱逐策略18。
**批量读取策略(bulkread)**用于顺序扫描大型表,前提是表大小超过缓冲区缓存的四分之一。(第 374 页)
使用该策略时,不会为了释放缓冲区而把脏页写入磁盘;相反,缓冲区会从环中移除并换成另一个缓冲区。这样读取无需等待写入,可以更快完成。
如果进程开始扫描表时发现该表已经在被扫描,就会加入已有的缓冲区环,从而在不产生多余输入输出的情况下获得表的一部分19。第一个进程完成扫描后,第二个进程会单独读取之前漏掉的表开头部分。
环必须足够大,使缓冲区在再次需要之前有时间释放;同时又要在环中停留足够长的时间,让多个读取进程能够同步。启用异步输入输出时,可以同时执行 effective_io_concurrency 个操作,每个操作可以读取 io_combine_limit 字节,这决定了所需的大小。此外,还要加上 256 KB(32 个标准页面);如果禁用了异步输入输出,前面的乘积就会变为零。但为了避免环过大,其大小还受缓冲区缓存容量与系统最大进程数之比限制:缓存必须够所有进程使用。(v. 18)(第 183 页)(默认值: 16)(默认值: 128K)
因此,在默认设置下,如果缓冲区缓存足够大,缓冲区环的大小为 32 + 16 × 16 = 288 个缓冲区。
**批量写入策略(bulkwrite)**用于 COPY FROM、CREATE TABLE AS SELECT、CREATE MATERIALIZED VIEW,以及会重写表的某些 ALTER TABLE 操作。它会分配一个相当大的缓冲区环,大小为 16 MB(2048 个标准页面),但不会超过整个缓冲区缓存的 。
**清理策略(vacuum)**由清理和分析进程在不考虑可见性映射、完整扫描表时使用。缓冲区环的大小由 vacuum_buffer_usage_limit 参数决定,也可以在 VACUUM 或 ANALYZE 命令中覆盖。(默认值: 2MB)(v. 16)
缓冲区环并不总能防止不必要的驱逐。使用 UPDATE 或 DELETE 修改大量行时,表会采用批量读取策略进行扫描;但由于页面会被修改,缓冲区环会退化,实际上无法发挥作用。
另一个重要情况是数据库中存储使用 TOAST 的大值。尽管读取的数据量可能很大,访问 TOAST 表时总是通过索引进行,因此不会使用缓冲区环。(第 33 页)
现在观察批量读取策略。为简化计算,我们创建一张表,使插入时每一行占据一个完整页面。默认缓冲区缓存大小为 16,384 个 8 KB 页面。因此,要让表扫描使用缓冲区环,表必须超过 4096 个页面。
分析这张表:
清除分析期间读取的表页面,然后读取整张表:(v. 18)
由于缓冲区缓存较小,缓冲区环的大小受到限制:表页面只占用了 94 个缓冲区,而不是预期的 288 个:
如果使用索引读取表,就不会使用缓冲区环:
结果是,整张表和整个索引都进入了缓冲区缓存:
9.6. 缓冲区缓存大小设置
缓冲区缓存的大小由 shared_buffers 参数决定。默认值明显偏小,因此安装 PostgreSQL 后就适合立即增大该值。修改该参数需要重启,因为共享内存在服务器启动时为缓存分配。(默认值: 128MB)
应该根据什么来选择合适的值?
即使是最大的数据库,在任一时刻实际活跃使用的“热”数据也只有有限的一部分。理想情况下,这部分数据应该能放入缓冲区缓存(当然还要为不可避免的“一次性”数据预留空间)。如果缓存太小,活跃页面会不断相互驱逐,产生多余的输入输出。但盲目增大缓存也不对,因为维护缓存会增加开销,而内存还要满足其他需求。
不同系统的最佳缓冲区缓存大小也不同:它取决于可用内存总量、数据和负载特征。遗憾的是,不存在一个对所有系统都同样合适的神奇数值,甚至也不存在这样的公式。
还要注意,只要没有启用直接输入输出,PostgreSQL 的缓存未命中就不一定会导致物理输入输出。缓冲区缓存较小时,空闲内存会被操作系统缓存利用,在一定程度上缓解问题。但操作系统不像数据库系统那样了解已读取数据的含义,因此会采用不同的驱逐策略。
通常建议先取物理内存的 作为初始值,然后根据实际情况调整。
最好的方法是做实验:增大或减小缓存大小,并比较系统性能。当然,这需要有一个与生产系统相似的测试环境,并且能够重现典型负载。
不过,仍然可以做一些分析。
首先,可以使用熟悉的 pg_buffercache 扩展从不同角度查看缓存的当前状态。例如,研究缓冲区按使用程度的分布:
计数器为空表示空闲缓冲区。在本例中这并不奇怪,因为服务器几乎处于空闲状态。大多数已占用缓冲区包含系统表页面;服务进程读取这些页面,是为了填充自己的系统目录缓存和执行查询。
还可以查看每个关系有多少内容被缓存,以及这些数据的使用活跃程度(在这个查询中,使用计数大于 1 的页面被视为活跃页面):
可以看到,表 big 和它的索引都已完全缓存,但它们的页面并没有被积极使用。
需要注意,对 pg_buffercache 的查询:
应重复执行几次,因为数值会在一定范围内变化;
不应连续执行,因为视图会锁定正在查看的缓冲区,虽然锁定时间很短。
因此,监控时最好使用扩展的另外两个函数:pg_buffercache_summary 和 pg_buffercache_usage_counts。它们需要的锁更少,因此可以快速评估整体情况(虽然结果可能略有不一致)。(v. 16)
其次,pg_stat_io 视图会收集经过缓冲区缓存的输入输出详细信息。例如,可以按缓冲区环使用策略查看输入输出操作数(normal 上下文对应不使用缓冲区环的普通操作):(v. 16)
该查询还显示缓存命中数(hits)和缓存驱逐数:“普通”驱逐计入 evictions 字段,而缓冲区环中的页面驱逐计入 reuses 字段。根据这些数字,可以对缓存的使用方式得出一些结论。
除了读取和写入操作数(reads 和 writes),视图还可以提供输入输出量(read\_bytes 和 write\_bytes,单位为字节):(v. 18)
可以看到,清理和顺序扫描每次输入输出都会读取多个页面,而写入目前始终是单页的。
启用 track_io_timing 后,同一个视图还会跟踪输入输出耗时。不过,正如前面所说,在某些平台上,这种跟踪可能带来很大的开销。(第 166 页)
pg_stat_io 视图按进程类型对数据分组。函数 pg_stat_get_backend_io 可以进一步查看某个服务进程(只要它仍在运行)的详细信息;该函数返回包含同一组字段的表。(v. 18)
从不同角度研究 pg_buffercache 和 pg_stat_io 的数据,可以得到有用的线索。
9.7. 缓存预热
服务器重启后,需要经过一段时间,缓存才会“预热”,也就是积累起当前活跃使用的数据。有时,立即把某些表的数据读入缓存会很有用,这正是 pg_prewarm 扩展的用途:
除了把表正常读入缓冲区缓存(或只读入操作系统缓存),该扩展还可以把缓存的当前状态保存到磁盘,并在服务器重启后恢复。为此,需要把扩展库加入 shared_preload_libraries 参数,然后重启服务器:
重启后,如果 pg_prewarm.autoprewarm 的值没有变化,系统会自动启动 autoprewarm leader 后台进程。它每隔 pg_prewarm.autoprewarm_interval 个时间单位把缓存中的页面列表刷到磁盘(该进程使用 max_parallel_processes 的一个槽位)。(默认值: on)(默认值: 300s)
这个进程最初名为 autoprewarm master,但在第 13 版中也改名为 autoprewarm leader。
现在重启后,表 big 不在缓存中:
如果有充分理由认为表的全部内容都会被积极使用,而访问磁盘会把查询响应时间拉长到不可接受的水平,就可以提前把表读入缓冲区缓存:
页面列表会写入 PGDATA/autoprewarm.blocks 文件。可以等待 autoprewarm leader 第一次运行,但这里手动触发写入:
刷出的页面数大于 4097,因为其中包含所有已占用的缓冲区。文件使用文本格式写入,其中包含数据库、表空间和文件的标识符,以及层号和块号:
现在再次重启服务器。
表立即出现在缓存中:
这同样由 autoprewarm leader 进程完成:它读取文件,按数据库划分页面并排序(使磁盘读取尽可能连续),然后把页面交给单独的 autoprewarm worker 工作进程处理。
9.8. 本地缓存
临时表是一般规则的例外。由于临时数据只对一个进程可见,它们不应放入共享缓冲区缓存。因此,临时数据使用拥有该表的进程本地内存中的缓存20。
总的来说,本地缓冲区缓存的结构与共享缓存相同:
使用自己的哈希表查找页面;
按普通算法驱逐页面(但不使用缓冲区环);
可以钉住页面,以避免页面被驱逐。
不过,它的实现大大简化了,因为不再需要内存锁(只有一个进程访问缓冲区),也不需要防止崩溃导致的数据丢失(数据无论如何最多只存在到会话结束)。(第 306 页)(第 211 页)
本地缓存的内存会按需逐步分配,因为临时表并非在所有会话中使用。单个会话的缓存最大容量由 temp_buffers 参数限制。(默认值: 8MB)
名称相近的 temp_file_limit 参数针对的不是临时表,而是查询执行过程中为临时保存中间数据而创建的文件。
在 EXPLAIN 命令的输出中,对本地缓冲区缓存的访问标记为 local,而不是 shared:
熟悉的 pg_stat_io 视图可以提供进程本地缓存页面的输入输出数据:(v. 16)
backend/storage/aio/aio_init.c,函数 AioChooseMaxConcurrency。 ↩︎
backend/access/heap/heapam.c,函数 index_delete_prefetch_buffer。 ↩︎
backend/storage/buffer/bufmgr.c,函数 ReadBuffer_common。 ↩︎
backend/storage/buffer/bufmgr.c,函数 DropRelFileNodeBuffers。 ↩︎
backend/storage/buffer/bufmgr.c,函数 LockBufferForCleanup。 ↩︎
backend/storage/buffer/freelist.c,函数 StrategyGetBuffer。 ↩︎
backend/storage/buffer/freelist.c,函数 StrategyFreeBuffer。 ↩︎
backend/storage/buffer/freelist.c,函数 GetBufferFromRing。 ↩︎
backend/storage/buffer/freelist.c,函数 GetAccessStrategy。 ↩︎
10 预写式日志
10.1. 日志记录
发生故障时,例如断电、数据库管理系统或操作系统发生故障,内存中的全部内容都会丢失;只有已经写入磁盘的信息会保留下来。要让服务器在故障后启动,就必须恢复数据的一致性。如果磁盘本身受损,从备份恢复时也需要解决同样的一致性问题。
一种理论上可行的方法,是始终保持磁盘上的数据一致。实际上,这意味着必须不断把单个页面写入磁盘(随机写入的代价高于顺序写入),而且写入顺序还必须保证一致性在任何时刻都不被破坏(这很难,尤其是索引组织复杂时)。
PostgreSQL 和大多数数据库管理系统一样,采用了另一种方法。
运行过程中,一部分最新数据只保存在内存中,延迟写入磁盘(或其他非易失性存储)。因此,在服务器运行期间,磁盘上的数据始终处于不一致状态:不同页面反映的是不同时间点的状态。不过,内存中的每个操作(例如修改缓冲区缓存中的页面)都会被记录:系统会创建日志记录并保存到磁盘,其中包含必要时重复执行同一操作所需的最少信息1。
页面修改的日志记录必须先于修改后的页面写入磁盘。这就是它被称为预写式日志(write-ahead log)的原因。这样发生故障时,就可以从磁盘读取日志,重复执行故障前已经完成、但结果尚未从内存写入磁盘而丢失的操作。
通常,记录日志比写入单个页面更高效。日志是连续的数据流,即使 HDD 也能较好地处理;而且一条日志记录可能比一个页面小。
所有在故障时可能导致磁盘上数据不一致的操作都必须记录。具体来说,日志中会记录以下操作:
修改缓冲区缓存中的关系页面——修改后的页面会延迟写入磁盘;
提交和中止事务——状态变化发生在 clog 缓冲区中,也不会立即写入磁盘;
文件操作(例如创建表时创建和删除文件、目录)——这些操作必须与数据修改同步。
日志中不会记录:
对无日志表(
UNLOGGED)的操作;对无日志序列的操作(通常属于无日志表);(v. 15)
对临时表和序列的操作——这些对象的生命周期无论如何都不会超过创建它们的会话生命周期。
日志不仅用于故障恢复,也用于从备份恢复到任意时间点,以及用于复制。
10.2. 日志的结构
逻辑结构
从逻辑结构看,日志2可以表示为一系列长度不同的记录。每条记录包含某个操作的数据,前面有一个标准的头部3。头部还包含以下信息:
记录所属事务的编号;
负责解释该记录的资源管理器4;
用于检测数据损坏的校验和;
记录长度;
指向上一条日志记录的引用。
通常日志按正向读取,不过例如 pg_rewind 工具就会反向扫描。
数据本身的格式和含义各不相同。例如,它可以是一个页面片段,需要在指定偏移处覆盖页面的一部分。相应的资源管理器“知道”如何解析和重放这条记录。表、每种索引类型、事务状态及其他实体各有自己的资源管理器。完整列表可用命令 pg_waldump -r list 获取。
服务器共享内存中为日志分配了专用缓冲区。日志缓存大小由 wal_buffers 参数设置。默认值表示自动设置:分配 16 MB(一个日志段的大小);如果缓冲区缓存非常小,则分配更少。(默认值: -1)(第 216 页)
日志缓存的结构与缓冲区缓存相似,但主要以环形缓冲区方式工作:记录添加到“头部”,从“尾部”开始写入磁盘。日志缓存太小会导致与磁盘同步的频率高于必要程度。
在负载很低的系统中,已经保存到磁盘的记录位置(缓冲区“尾部”)与插入位置(缓冲区“头部”)几乎总是相同:
要引用某条记录,可以使用 pg_lsn 数据类型(log sequence number,LSN)。它表示相对于日志开头、到该日志记录为止的 64 位字节偏移量。LSN 以两个用斜线分隔的 32 位十六进制数字显示。
创建一张表:
开始一个事务,并记下日志插入位置:
现在执行某个操作,例如更新一行:
修改在内存中的缓冲区缓存页面上执行。修改信息也会保存到内存中的日志页面。因此,插入位置会向前移动:
为了保证修改后的数据页面严格晚于相应日志记录写入磁盘,页头会保存与该页面相关的最后一条日志记录的 LSN。可以使用 pageinspect 扩展检查这个位置:
整个数据库集簇共用一个日志,新的记录会不断追加。因此,页面中的 LSN 可能小于函数 pg_current_wal_insert_lsn 刚才返回的值。不过,在系统没有发生任何事情时,这两个数字会相同。
现在提交事务:
提交记录也会写入日志,插入位置再次发生变化:
提交会改变 SLRU 缓存中 clog 页面里的事务状态。为了防止 clog 页面早于相应日志记录被写入磁盘,也会跟踪 clog 页面对应的最后一条日志记录的 LSN。不过,这个信息不存储在页面本身,而是保存在内存中。(第 85 页)(第 309 页)
某个时刻,创建的日志记录会写入磁盘。之后,数据页面和 clog 页面就可以从缓存中逐出。如果必须提前逐出,系统会检测到这一点,并先强制把日志记录写入磁盘5。(第 235 页)
知道两个 LSN 位置后,只需用一个位置减去另一个位置,就可以得到它们之间日志记录的大小(字节)。只需先将位置转换为 pg_lsn 类型:
在这个例子中,更新行和提交事务约占用日志中的一百字节。
同样,可以估算特定负载下服务器每单位时间生成的日志量。这一信息用于设置检查点。
物理结构
在磁盘上,日志以段文件形式存储在 PGDATA/pg_wal 目录中。只读参数 wal_segment_size 显示段大小。(默认值: 16MB)
对于高负载系统,增大段大小可能降低开销,但只能在初始化集簇时设置(initdb --wal-segsize)。
日志记录写入当前文件;文件写满后开始使用下一个文件。
可以知道某个位置位于哪个文件,以及它相对于文件开头的偏移量:
文件名由两部分组成。前八个十六进制位表示从备份恢复时使用的时间线编号,其余部分对应 LSN 的高位(LSN 的低位由 file_offset 字段显示)。
可以使用专门的函数查看日志文件:
可以使用 pg_waldump 工具或 pg_walinspect 扩展查看已创建日志记录的头部:(v. 15)
这里可以看到两条记录的头部。
第一条是由 Heap 资源管理器处理的 HOT_UPDATE 操作。block_ref 列显示更新后的表页面的文件名和页号:(第 115 页)
第二条是由 Transaction 资源管理器处理的 COMMIT 操作。
10.3. 检查点
为了在故障后恢复一致性,必须依次读取日志,并把涉及丢失修改的记录应用到相应页面。要找出这些记录,需要比较磁盘上页面的 LSN 与日志记录的 LSN。不过,仍然不清楚应该从哪条记录开始恢复。如果开始得太晚,在这一时刻之前写入磁盘的页面就不会得到全部修改,从而导致不可逆的数据损坏。但从最开始恢复也不现实:既无法保存如此巨量的数据,也无法接受同样巨大的恢复时间。因此需要一个逐渐向前推进的检查点,从这里安全地开始恢复;检查点之前的日志记录则可以删除。
获得检查点最简单的方法,是定期暂停系统工作,把缓冲区缓存和其他缓存中的所有脏页写入磁盘。当然,这种方法完全不可行,因为系统会在这些时刻停顿一段不确定但相当长的时间。
因此在实践中,检查点会随时间展开,实际上成为一个时间段。检查点由名为 checkpointer 的专用后台进程执行6。
检查点开始。 首先,检查点进程将那些由于体积小而可以一次性写入的结构刷到磁盘。这包括 SLRU 缓存中的对象(例如 clog 事务状态和嵌套事务)以及其他一些结构。(第 309 页)
执行检查点。 检查点执行的大部分时间用于写入缓冲区缓存中的脏页7。
首先,在检查点开始时为所有当时脏的缓冲区头部设置一个特殊标志。这个过程很快,因为不涉及输入输出。
然后,检查点进程逐步遍历所有缓冲区,把带标记的缓冲区刷到磁盘。页面不会从缓存中逐出,只是写入,因此无需关注缓冲区的访问计数或钉住状态。
页面按编号顺序刷写,使写入尽可能连续而不是随机。同时,不同表空间(它们可能对应不同的物理设备)交替写入,以均匀分摊负载。(第 26 页)
带标记的缓冲区也可能由服务进程写入,取决于谁先到达该缓冲区。无论谁执行写入,都会清除此前设置的标志,因此就检查点而言每个缓冲区只会写入一次。
检查点执行期间,缓冲区缓存中的页面当然还会继续变化。但新变脏的缓冲区没有设置标志,检查点进程不会写入它们。
检查点完成。 当检查点开始时已经脏的所有缓冲区都写完后,检查点就算完成。此时(不能更早)检查点的开始时刻会被用作恢复起点。之前的所有日志记录都不再需要。
进程结束时会创建一条表示检查点结束的日志记录,并写入检查点开始时刻的 LSN。
此外,PGDATA/global/pg_control 文件会更新为指向最近完成的检查点。(进程完成前,pg_control 仍指向前一个检查点。)
为了彻底弄清楚各个位置之间的指向关系,我们看一个小例子。
使缓冲区缓存中的一些页面变脏:
记下当前日志位置:
现在手动执行检查点。所有脏页都会写入磁盘;由于系统没有其他活动,不会出现新的脏页:
查看检查点如何反映在日志中。CHECKPOINT_REDO 记录检查点的开始,CHECKPOINT_ONLINE 记录检查点的结束:(v. 17)
这两个位置之间会有服务器继续工作产生的其他记录。
在 PostgreSQL 10 之前,预写式日志通常使用 XLOG(transaction log)这个缩写。这个名称的痕迹不仅留在资源管理器名称中,也留在源代码里。
在控制文件中也可以找到相同的信息:
10.4. 恢复
服务器启动时,首先启动 postmaster 进程。它随后启动 startup 进程8,其任务是在发生故障时执行恢复。
startup 读取控制文件 pg_control 并检查集簇状态,以确定是否需要恢复。pg_controldata 工具可以查看该文件的内容:
干净停止的服务器状态是“shut down”。未运行的服务器却显示“in production”,说明发生了故障。此时 startup 会从同一个 pg_control 文件中记录的最后完成检查点的起点开始自动恢复。
如果 PGDATA 目录中存在备份中的 backup_label 文件,恢复起点会从该文件读取。
进程从找到的起点开始依次读取日志;如果页面 LSN 小于日志记录的 LSN,就将记录应用到数据页。如果页面 LSN 更大,就不应、准确地说不能应用这条记录,因为记录必须严格按顺序应用。
不过,有些记录是整页镜像(full page image,FPI)。整页镜像可以应用于页面的任何状态,因为页面内容无论如何都会被覆盖。这类修改称为幂等。另一个幂等操作是记录事务状态的变化:每个事务在 clog 中对应固定的若干位,设置这些位不依赖它们原来的值。因此,clog 页面中无需保存最后一次修改的 LSN。
日志记录应用于缓冲区缓存中的页面,和正常工作时一样。
同样,日志记录也应用于文件:例如,如果记录表明某个文件必须存在,而它不存在,就会创建该文件。
恢复结束后,所有无日志关系都会使用 init 文件中的镜像重写。(第 30 页)
最后执行检查点,把恢复后的状态固定到磁盘。
至此 startup 进程的工作结束。
传统上,恢复过程分为两个阶段。第一阶段(roll forward)重放日志记录,服务器重复故障时丢失的工作。第二阶段(roll back)回滚故障时尚未提交的事务。
PostgreSQL 不需要第二阶段。恢复后,clog 中既不会设置提交位,也不会设置中止位(从形式上看,这对应于正在执行的事务);但由于可以确定该事务已经不再运行,它会被视为已中止9。
可以通过以 immediate 模式强制停止服务器来模拟故障:
检查集簇状态:
启动服务器时,startup 发现发生了故障,于是启动恢复:
正常停止时,postmaster 会断开所有客户端,然后执行最后检查点,把脏页面写入磁盘。
记下当前日志位置:
现在正常停止服务器:
检查集簇状态:
查看日志,会在末尾发现最后检查点的记录(CHECKPOINT_SHUTDOWN):
pg_waldump 的最后一条消息表示该工具已经读到日志末尾。
再次启动实例:
10.5. 后台写入
如果服务进程需要从缓冲区逐出脏页,就必须自己把它写到磁盘。这种情况并不理想,因为会导致等待;最好让写入异步地在后台进行。
检查点进程承担一部分脏页刷写工作,但还不够。
因此还有后台写入进程 bgwriter10。它使用与逐出机制相同的缓冲区查找算法,但有两个区别:
使用自己的“时钟指针”,可以领先于逐出时钟指针,但绝不落后于它;
遍历缓冲区时不减少访问计数。
如果缓冲区未被钉住且访问计数为零,脏页就会写入磁盘。这样,后台写入进程走在逐出之前,预先写入很可能很快被逐出的缓冲区。
这提高了逐出选中的缓冲区不是脏页的概率。
10.6. 配置
检查点配置
检查点的持续时间(更准确地说,是写入脏缓冲区这一阶段的持续时间)由 checkpoint_completion_target 参数决定。它表示两个相邻检查点开始时刻之间,有多大比例的时间用于写入。不建议把它增大到 1,因为下一次检查点可能在上一次完全结束之前就必须开始。不会发生灾难,因为任何时刻都只执行一个检查点,但正常的工作节奏可能被打乱。(默认值: 0.9)(v. 14)
可以按如下方式配置其他参数。首先确定两个连续检查点之间允许保留的日志文件量。容量越大,开销越小,但这个值始终受可用空间和可接受恢复时间的限制。
可以计算在正常负载下生成这部分日志需要多长时间。为此,记下日志的初始插入位置,并定期检查当前位置与记住的位置之间的差值。
把得到的时间视为通常的检查点间隔,并将其写入 checkpoint_timeout 参数。默认值很可能太小;通常会把时间增加到例如半小时。(默认值: 5min)(第 245 页)
不过,有时(甚至很可能)负载会更高,在参数规定的时间内生成过多的日志记录。在这种情况下,检查点必须更频繁地执行。因此,可以用 max_wal_size 参数限制恢复所需的日志文件量。超过这个上限后11,服务器会发起一次计划外检查点。(默认值: 1GB)
恢复所需的日志文件既包含上一轮已完成检查点期间的记录,也包含当前尚未完成检查点期间的记录。因此,要估算总量,就要把已知的检查点间日志量乘以(1 + checkpoint_completion_target)。
按这种方式配置后,大多数检查点会按计划每隔 checkpoint_timeout 个时间单位执行一次。但负载升高时,达到 max_wal_size 的日志量后,检查点会更频繁地执行。
检查点进程会持续把实际进度与预期进度进行比较12:
实际进度由已经遍历的缓冲区缓存页面所占比例决定;
按时间计算的预期进度由已经消耗的时间比例决定,前提是检查点应在 checkpoint_timeout × checkpoint_completion_target 这一时间间隔内完成;
按容量计算的预期进度由已经填满的日志文件所占比例决定,计划使用的日志文件数量根据 max_wal_size × checkpoint_completion_target 计算。
如果脏页写入领先于计划,写入就会暂停;如果在两个参数中的至少一个方面落后,就会无延迟地追赶13。同时考虑时间和容量,就可以用同一种方式控制按计划和按需执行的检查点速度。
检查点完成后,服务器会清理恢复(以及其他任务)不再需要的日志记录14。其中一部分文件会被删除,其他文件会被重命名并重新使用。文件数量取决于日志记录的生成速率,但无论如何,PGDATA/pg_wal 中都会保留总量不少于 min_wal_size 的日志文件15。(默认值: 80MB)
通常,重命名可以避免不断创建和删除文件,从而节省开销;如有需要,也可以通过 wal_recycle 参数禁用这种行为。(v. 12)(默认值: on)
图中展示了正常条件下服务器所需日志文件量的变化。
需要理解的是,服务器上的日志文件实际总量可能更大,在某些情况下甚至可能超过 max_wal_size:
max_wal_size 参数提供目标值,但不是硬限制。如果负载增加,写入可能落后于计划。
服务器无权删除尚未通过复制槽传送出去的日志文件,以及持续归档中尚未归档的日志文件。这个功能需要持续监控,因为服务器磁盘很容易因此被填满。
管理员可以通过 wal_keep_size 参数保留一定数量的文件。(v. 12)(默认值:
0MB)
后台写入配置
后台写入进程应在检查点配置之后进行配置。两个进程必须共同确保在服务进程需要这些缓冲区之前写完脏缓冲区。
后台写入进程按周期工作,在两个周期之间休眠 bgwriter_delay 指定的时长。(默认值: 200ms)
每个周期要写入的页面数量,根据服务进程自上次运行以来请求的缓冲区平均数量确定(使用移动平均来平滑各次运行之间的不均匀性,同时不受久远历史的影响)。计算出的数量还会乘以 bgwriter_lru_multiplier 系数。但无论如何,每个周期写入的页面数都不会超过 bgwriter_lru_maxpages。(默认值: 2)(默认值: 100)
如果进程没有发现任何脏缓冲区(也就是系统中没有发生任何事情),它就会“进入睡眠”。服务器进程第一次请求缓冲区后,它会醒来并继续正常工作。
监控
可以、也应该根据监控反馈调整检查点和后台写入的配置。
如果因日志文件量超过限制而触发的检查点,比 checkpoint_warning 参数指定的频率更高,消息日志中就会输出警告。应根据预计的峰值负载调整该参数。(默认值: 30s)
启用 log_checkpoints 参数后,服务器消息日志会输出检查点执行过程的详细信息。(默认值: on)
修改一些数据并发起检查点:
在消息日志中可以看到写入的缓冲区数量、检查点后日志文件组成的变化、检查点耗时,以及相邻检查点起点之间的距离(以字节计):
不过,对于配置来说,最有用的信息是 pg_stat_checkpointer 视图中检查点进程的工作统计。(v. 17)
在 PostgreSQL 17 之前,检查点和后台写入共用一个 pg_stat_bgwriter 视图,因为过去这两项工作都由后台写入进程执行;在 9.2 版中,检查点被拆分为独立进程,但视图长期保持共用。
该视图还会显示已完成的检查点数量:
num_timed——按计划执行(时间间隔 checkpoint_timeout 到期);num_requested——按需执行(包括日志量达到 max_wal_size 时触发的检查点)。
如果 num_requested 列的值相对于 num_timed 很大,说明实际检查点发生得比预期更频繁。
以 restartpoints 开头的字段只对副本有意义。
视图 pg_stat_bgwriter 显示后台写入的统计信息:
对于配置来说,maxwritten_clean 的值很有用:它表示后台写入进程因超过 bgwriter_lru_maxpages 而停止工作周期的次数。
在配置良好的系统中,服务进程几乎不执行写入;写入的主要部分由检查点进程(buffers_written)和后台写入进程(buffers_clean)完成。
除了检查点和后台写入的详细信息,还需要了解预写式日志的整体情况。日志记录数量、整页镜像数量及其占用空间等最基本的统计信息,可以从 pg_stat_wal 视图获得:(v. 14)
与日志相关的输入输出信息中,最详细的部分(包括按进程类型划分的信息,本文不展开)位于熟悉的 pg_stat_io 视图中:(v. 18)(第 204 页)
对于日志,context 字段可以取以下值:
init——初始化 WAL 段(如果设置了 wal_init_zero,还会把段填零;因此每次操作写入 16 MB 数据);(默认值:on)normal——对已有段执行操作。
可以使用 pg_stat_get_backend_wal 函数获取单个服务进程运行期间的统计信息。(v. 18)
postgrespro.ru/docs/postgresql/18/wal-internals;backend/access/transam/README。 ↩︎
backend/storage/buffer/bufmgr.c,函数 FlushBuffer。 ↩︎
backend/postmaster/checkpointer.c;backend/access/transam/xlog.c,函数 CreateCheckPoint。 ↩︎
backend/storage/buffer/bufmgr.c,函数 BufferSync。 ↩︎
backend/postmaster/startup.c;backend/access/transam/xlog.c,函数 StartupXLOG。 ↩︎
backend/access/heap/heapam_visibility.c,函数 HeapTupleSatisfiesMVCC。 ↩︎
backend/access/transam/xlog.c,函数 XLogCheckpointNeeded 和 CalculateCheckpointSegments。 ↩︎
backend/postmaster/checkpointer.c,函数 IsCheckpointOnSchedule。 ↩︎
backend/postmaster/checkpointer.c,函数 CheckpointWriteDelay。 ↩︎
backend/access/transam/xlog.c,函数 RemoveOldXlogFiles。 ↩︎
backend/access/transam/xlog.c,函数 XLOGfileslop。 ↩︎
11 日志模式
11.1. 性能
服务器正常运行时,会持续顺序写入日志文件。由于几乎不存在随机访问,HDD 也完全可以应付这项工作。但这种负载特征与数据文件的访问方式有很大差异。因此,把日志放在单独的物理存储上可能更有利:可以将 PGDATA/pg_wal 目录替换为指向已挂载文件系统目录的符号链接。(v. 17)
日志写入有两种模式:
同步模式——提交事务时,只有等该事务的所有日志记录都写入磁盘后,才能继续工作;
异步模式——事务立即完成,日志在后台写入。
该模式由 synchronous_commit 参数设置。(默认值: on)
同步模式。 要可靠地保存提交这一事实,仅仅把日志记录交给操作系统还不够;还必须确保它们已经与磁盘完成同步。由于同步涉及实际的(也就是缓慢的)输入输出,因此应尽量少执行同步。
为此,负责完成事务并写入日志的服务进程可以按照 commit_delay 参数指定的时间短暂暂停。不过,只有系统中至少有 commit_siblings 个活跃事务时才会这样做3:等待期间,其中一些事务可能完成,这样服务器就能一次性同步所有日志记录。这很像扶住电梯门,让别人也能赶上。(默认值: 0s) (默认值: 5)
使用默认值时不会发生暂停。只有在系统执行大量短 OLTP 事务时,修改 commit_delay 参数才有意义。
可能的暂停结束后,负责完成事务的进程会把积累的所有日志记录刷到磁盘,并执行同步(重要的是,磁盘上必须有提交记录以及此前与该事务有关的所有记录;其余记录被写入,只是因为这样不会增加成本)。
从这一刻起,事务就被视为可靠完成4,并保证满足 ACID 要求中的持久性(Durability)。因此,同步模式默认启用。
同步写入的代价是响应时间变长(COMMIT 命令要等同步结束才会返回控制权),系统吞吐量降低,尤其是在 OLTP 负载下。
异步模式。 要启用异步写入5,需要把 synchronous_commit 参数设置为 off。
在异步模式下,日志记录由 walwriter 进程写入磁盘6;该进程在工作周期和等待之间交替运行。暂停时长由 wal_writer_delay 参数设置。(默认值: 200ms)
每次暂停后醒来时,进程都会检查缓存中是否出现了新的完全填满的 WAL 页面。如果出现了,就把这些页面写入磁盘,跳过当前页面。如果从上次运行以来没有任何日志页面完全填满,进程就写入当前尚未填满的页面,毕竟它已经醒来了7。
这个算法的目标是尽量避免多次刷写同一个页面;在修改量很大的负载下,这一点很重要。
虽然日志缓存采用环形缓冲区,但写入到达缓存最后一个页面时就会停止;暂停后,下一轮写入从第一个页面开始。因此在最坏情况下,walwriter 要到第三轮才能处理某条日志记录:先刷写位于缓存末尾的所有已填满页面,再回到开头,最后处理包含目标记录的未填满页面。不过,大多数情况下一到两轮就够了。
每写入 wal_writer_flush_after MB 数据后都会同步一次,并在写入周期结束时再同步一次。(默认值: 1MB)
异步写入比同步写入更高效,因为提交不必等待物理写入磁盘。但可靠性会降低:如果故障发生在提交后不到 3 × wal_writer_delay 个时间单位之内,已经提交的数据可能会丢失;按默认设置,这段时间为 0.6 秒。
实际情况是,这两种模式相互补充。即使采用同步提交,长事务的日志记录也可以异步写入,以释放 WAL 缓冲区。反过来,如果从缓冲区缓存逐出页面时发现相应日志记录还没有写入磁盘,那么即使处于异步模式,也会立即刷写该记录,否则系统无法继续工作。
不过,系统设计者通常仍然要在效率和持久性之间做出艰难选择。
synchronous_commit 参数也可以针对单个事务设置。如果应用层能够把事务分为绝对关键的事务(例如处理财务数据的事务)和不太重要的事务,就可以只牺牲部分事务的可靠性来提高性能。
为了大致了解异步提交带来的收益,我们使用 pgbench 基准测试8比较两种模式下的响应时间和吞吐量。
初始化所需的表,并在同步模式下运行 30 秒测试:
然后在异步模式下运行相同的测试:
在这个简单测试中,异步提交显著降低了响应时间(latency),并提高了吞吐量(tps)。当然,具体系统在具体负载下会得到不同的比例,但可以看出,对短 OLTP 事务来说,效果可能非常明显。
恢复参数的默认值:
11.2. 可靠性
显然,日志机制必须保证在各种情况下都能从故障中恢复(当然不包括存储介质本身被毁坏的情况)。有许多因素会影响数据一致性,其中最重要的是缓存、数据损坏和写入非原子性9。
缓存
数据到达非易失性存储(例如硬盘盘片)之前,会经过多层缓存。
向磁盘写入的系统调用只会让操作系统把数据移入自己的缓存(这个缓存也位于运行内存中,同样容易因故障丢失)。真正的写入会根据操作系统输入输出调度器的设置异步进行。
调度器决定写入数据后,数据会进入存储设备(硬盘)的缓存。存储设备的电子部件也可能推迟写入,例如把适合同时写入的数据收集成一组。RAID 控制器又在操作系统和磁盘之间增加了一层缓存。
如果不采取特殊措施,就无法知道数据何时可靠地保存下来。通常这并不重要,因为我们有日志;但日志记录本身必须立即可靠地保存10。异步模式也一样,否则无法保证日志记录先于修改后的数据写入磁盘。
检查点也必须可靠地保存数据,确保脏页真正刷到磁盘,而不是留在操作系统缓存中。此外,检查点还要同步此前由其他进程执行的所有文件操作(例如写入页面或删除文件):检查点完成时,这些操作的结果也必须已经可靠地写入磁盘11。
还有一些情况也要求可靠写入,例如在日志级别 minimal 下执行无日志操作。
操作系统提供了多种手段,用来保证数据立即写入非易失性存储。
这些手段可以归结为两类:写入之后执行单独的同步命令(fsync、fdatasync),或者在打开文件或向文件写入时指定同步要求(甚至指定绕过操作系统缓存直接写入)。
pg_test_fsync 工具可以帮助确定特定操作系统和文件系统最合适的日志同步方式;选定的方式由 wal_sync_method 参数指定。其他情况会自动选择同步方式12。
选择方法时还要考虑硬件特性,这是一个容易被忽略的细节。例如,如果使用带备用电池的控制器,就没有理由不用它的缓存,因为电池可以在断电时保护数据。
异步提交和不进行同步是两个完全不同的模式。关闭同步(设置 fsync 参数)会进一步提高系统速度,但任何故障都会导致集簇中的全部数据永久丢失。异步模式可以保证故障后恢复到一致的数据状态,但恢复后的状态中可能缺少最近的一部分事务。(默认值: on)
数据损坏
硬件并不完美,数据可能在内存或存储介质中损坏,也可能在接口电缆传输过程中发生变化。这些错误有一部分由硬件层处理,但并非全部如此。
为了及时发现问题,日志记录总是附带校验和。
数据页面也可以使用校验和保护13。既可以在初始化集簇时启用,也可以在服务器停止后使用 pg_checksums 工具14启用15。(v. 12)
在生产环境中必须启用校验和,尽管计算和检查校验和会带来少量开销。这会提高及时发现故障的机会,但不能提供完整保证:
只有访问页面时才会检查校验和,因此数据损坏可能长时间不被发现,甚至进入所有备份,最终不再留下任何正确数据的来源;
填零的页面会被视为正确页面,因此如果文件系统错误地把文件清零,检查也不会发现问题;
校验和只保护关系的主分支,其他分支和所有其他文件(例如 clog 中的事务状态)都不受保护。
通过检查只读参数 data_checksums 的值,确认校验和已经启用:
停止服务器,并把表的主分支的第 0 页中的几个字节清零:
再次启动服务器:
实际上也可以不停止服务器。只要页面被写入磁盘并从缓存中逐出即可(否则服务器会继续使用缓存中的页面)。不过,这种情形更难复现。
现在尝试读取该表:
如果无法从备份恢复数据,至少可以尝试读取损坏的页面(当然有得到失真信息的风险)。为此,需要设置 ignore_checksum_failure 参数:(默认值: off)
本例之所以成功,是因为损坏的是页头中不重要的部分(最后一条日志记录的 LSN),而不是数据本身。
写入非原子性
数据库页面通常占用 8 KB,但底层写入按块进行,而块在多数情况下更小(通常是 512 字节或 4 KB)。因此发生故障时,数据页面可能只被部分写入。恢复时,对这样的损坏页面应用普通日志记录没有意义。
为了防止部分写入,PostgreSQL 会在检查点开始后第一次修改页面时把整页镜像(full page image,FPI)保存到日志中。(第 223 页)
这一行为由 full_page_writes 参数控制。关闭整页镜像可能导致无法修复的数据损坏,但即使关闭该参数,提示位变化也可能让日志中出现整页镜像。提示位的变化本身被认为不重要,因此不会单独记录;访问页面的第一个查询会重新设置所需的位。然而,任何位(即使是不重要的位)发生变化都会改变校验和。因此,启用校验和(或设置 wal_log_hints 参数)时,检查点之后第一次修改提示位会记录整页镜像16,不受 full_page_writes 的值影响。(默认值: on)(*第 86 页)(默认值: off)
恢复时如果在日志中遇到整页镜像,就会无条件地(不检查 LSN)将它写入磁盘,因为它和所有日志记录一样受到校验和保护,不可能在不被发现的情况下损坏。然后,普通日志记录会应用到这个已经确定正确的镜像上。
整页镜像会显著增加生成的日志量,尽管日志机制会从镜像中排除页面内部的空闲空间17。可以通过 wal_compression 参数启用整页镜像压缩,从而大幅改善这一情况。(默认值: off)
使用 pgbench 工具做一个简单实验。执行检查点,然后立即运行一个事务数量固定的测试:
日志记录大小:
本例中整页镜像占生成总量的很大一部分,可以通过 pg_waldump 工具的 --stats 选项或 pg_walinspect 扩展的 pg_get_wal_stats 函数查看统计信息。(v. 15)
表中列出了每种资源类型(Type)的日志记录数量(N)、普通记录大小(Record size)和整页镜像大小(FPI size):
如果页面能在两次检查点之间多次发生变化,这个比例就会降低。这也是不要过于频繁执行检查点的另一个理由。
现在仍以这个例子看看压缩能带来什么帮助:
压缩后的日志记录大小:
除了传统的 PGLZ 压缩算法外,还有两种算法可用:LZ4 和 Zstandard。LZ4 通常占用较少的 CPU 资源,但压缩率大致相同。Zstandard 把字典压缩与熵编码结合起来;它对 CPU 的负担更重,但压缩效果更好。(v. 15)
使用 Zstandard 压缩后的日志记录大小:
结论是:当页面整页镜像很多时(由于启用了校验和或 full_page_writes,这几乎总是如此),使用压缩很有意义。多种算法可以让我们在额外 CPU 负载和日志量减少之间找到折中。
11.3. 日志级别
预写式日志的主要任务是保证故障恢复。但扩大日志记录的范围后,日志还可以用于其他任务。日志级别有 minimal、replica 和 logical 三种。每个更高的级别都包含前一级别写入日志的全部内容,并增加一些新信息。
使用的级别由 wal_level 参数设置;修改该参数需要重启服务器。(默认值: replica)
Minimal
最低级别 minimal 只保证故障恢复。为了节省空间,如果当前事务中创建或清空的关系涉及大量数据插入,就不会记录相关操作(特别是 CREATE TABLE AS SELECT 和 CREATE INDEX 这类命令)18。系统不会记录这些操作,而是立即把所需数据刷到磁盘;系统目录的变化会在事务提交时变得可见。
如果操作执行过程中发生故障,已经写入磁盘的数据仍然不可见,不会破坏一致性。如果操作完成后才发生故障,那么应用后续日志记录所需的全部数据已经在磁盘上。
要让这种优化对刚创建的关系生效,需要写入的数据量由 wal_skip_threshold 参数决定。(v. 13)(默认值: 2MB)
看看 minimal 级别会写入哪些内容。
默认使用更高的 replica 级别来支持复制。设置 minimal 级别时,还必须把 max_wal_senders 参数清零;该参数决定允许多少个 walsender 进程:(默认值: 10)
修改参数需要重启服务器:
记下当前日志位置:
清空表,并在同一个事务中插入新行,使其超过 wal_skip_threshold 的限制:
我使用 TRUNCATE 命令,而不是创建单独的表,因为这样生成的日志记录更少。
使用熟悉的 pg_walinspect 扩展查看日志内容。(v. 15)
第一条记录(CREATE)表示为关系创建了一个新文件(因为清空表实际上会重写该表)。(第 177 页)
接下来是几条与系统目录有关的记录。它们反映了 pg_class 表的变化(UPDATE),以及向该表上三个索引中添加记录(INSERT_LEAF)。把 rel 列显示的文件路径与关系名称对应起来,就可以验证这一点。(第 30 页)
最后是事务提交记录。向表中插入数据不会被记录到日志。
Replica
系统发生故障后恢复时,会通过日志记录把磁盘上的数据更新到一致状态。从备份恢复时也是如此。但在这种情况下,还可以使用归档日志,把数据状态推进到目标恢复点,而不只是恢复一致性。这些记录的数量可能很大(例如覆盖数天),恢复期间会经过多个检查点,而不是一个。因此 minimal 日志级别不够:没有记录的操作无法重放。要支持从备份恢复,日志中必须包含所有操作。
复制也是如此:没有记录到日志中的内容不会传送到副本,也不会在副本上重放。
如果副本还要用于执行查询,事情会更加复杂。首先,需要知道主服务器上出现的排他锁,因为它们可能与副本上的查询冲突。其次,需要能够构建数据快照,这需要知道正在运行的事务。对副本来说,不仅要考虑本地事务,还要考虑主服务器上的事务。(*第 261 页)(*第 97 页)
把这些信息传给副本的唯一方式,是定期将其写入日志19。这项工作由后台写入进程 bgwriter 负责20:系统有活动时,它每 15 秒(间隔不可配置)创建一条 RUNNING_XACTS 类型的记录。
从备份恢复数据和使用物理复制的能力由 replica 日志级别保证。
默认使用的正是这个级别,因此只需重置上面设置的参数并重新加载服务器:
重复上一次的操作顺序(但只插入一行,以免输出过长):
现在检查日志记录。
minimal 级别会出现的记录之外,还增加了以下记录:
与复制有关的
Standby资源管理器记录:LOCK(锁)和RUNNING_XACTS(活跃事务);初始化新页面并同时向其中插入一行的记录
INSERT+INIT。
Logical
最后,最高级别 logical 提供逻辑解码和逻辑复制能力。发布服务器必须启用这个级别。
从日志记录的角度看,这个级别与 replica 几乎没有区别:现有记录中会加入行标识符21;还会出现与复制来源和缓存失效有关的记录,以及应用可以添加的任意逻辑记录。不过,逻辑解码主要依赖正在运行的事务信息(RUNNING_XACTS):这些信息用于构建数据快照,以跟踪系统目录的变化。
backend/access/transam/xlog.c, 函数 WALReadFromBuffers. ↩︎
backend/access/transam/xlog.c, 函数 XLogFlush. ↩︎
backend/access/transam/xlog.c, 函数 RecordTransactionCommit. ↩︎
backend/access/transam/xlog.c, 函数 XLogBackgroundFlush. ↩︎
backend/access/transam/xlog.c, 函数 issue_xlog_fsync. ↩︎
backend/storage/file/fd.c, 函数 pg_fsync. ↩︎
backend/storage/buffer/bufmgr.c, 函数 MarkBufferDirtyHint. ↩︎
backend/access/transam/xloginsert.c, 函数 XLogRecordAssemble. ↩︎
include/utils/rel.h, 宏 RelationNeedsWAL. ↩︎
backend/storage/ipc/standby, 函数 LogStandbySnapshot. ↩︎
postgrespro.ru/docs/postgresql/18/sql-altertable#SQL-ALTERTABLE-REPLICA-IDENTITY. ↩︎
第三部分:锁
12 关系级锁
12.1. 关于锁
锁(locks),也称为 锁,用于协调对共享资源的并发访问。
并发访问指的是多个进程同时访问某个资源。这些进程可以并行执行(如果硬件允许),也可以在时间分片模式下顺序执行——这并不重要。如果没有竞争,就不需要锁(例如,共享缓冲区缓存需要锁,而本地缓存则不需要)。
在访问资源之前,进程必须 获取(acquire)与该资源关联的锁,而在完成工作后必须 释放(release)它,以便其他进程可以使用该资源。当锁由数据库管理系统(DBMS)管理时,这种顺序会自动维护;如果锁由应用程序设置,则必须由应用程序自身遵守规则。
在底层,锁表现为共享内存中的一段区域,其中以某种方式标记锁的状态(空闲或已被获取),并可能包含额外信息(如进程号和获取时间)。
可以注意到,这段共享内存本身也是一个资源。对它的并发访问通过操作系统提供的特殊同步原语(如信号量或互斥锁)来协调。这些原语确保访问共享资源的代码严格按顺序执行。在最低层,这些原语
是基于处理器的原子指令(如 test-and-set 或 compare-and-swap)实现的。
原则上,任何可以唯一标识并映射到锁地址的资源都可以作为受保护的资源。
例如,资源可以是数据库正在操作的对象,如表(通过系统目录中的 oid 标识)、数据页面(通过文件名和文件内位置标识)、行版本(通过页面和页面内偏移标识)。资源也可以是内存中的结构,如哈希表或缓冲区(通过预先分配的编号标识)。有时甚至方便使用没有实际物理意义的抽象资源。
锁的获取并非总是可行:资源可能已被其他进程占用。此时,进程要么进入队列(如果锁机制支持),要么在一段时间后重试获取。无论如何,这都会导致进程必须等待资源释放。
我将强调两个显著影响锁效率的因素。
粒度——锁的细化程度。当资源具有层次结构时,粒度尤为重要。
例如,表由页组成,页包含行版本。这些对象都可以作为资源。如果在表级别设置锁(粗粒度),即使多个进程访问不同的页或行,也无法同时工作。
行级锁(细粒度)没有这一缺点,但锁的数量会显著增加。为了防止这些信息占用过多内存,可以采用各种方法,例如 升级(escalation):当低级别、细粒度锁的数量超过某个阈值时,它们会被一个更高级别的锁所替代。
锁模式集合,即锁可以被获取的模式。
通常只使用两种模式。排他(exclusive)或 独占 模式与任何其他模式(包括自身)都不兼容。共享(shared)模式允许多个进程同时获取锁。共享模式通常用于读取资源,而排他模式用于修改资源。
一般情况下,模式可以更多。模式名称本身并不重要,重要的是它们之间的兼容性矩阵。
粒度越细、可兼容的模式越多,就越能实现并行化。
锁可以根据使用时间进行分类。
长期锁可能持有很长时间(通常直到事务结束),通常用于关系和行等资源。数据库系统通常自动管理这些锁,但用户仍可在某种程度上控制该过程。
长期锁具有较多模式,允许对数据执行多种并发操作。通常这类锁配有完善的基础设施(等待队列、死锁检测、监控),因为维护这些机制的成本远低于保护数据的操作成本。
短期锁持有时间仅为几毫秒(通常仅为执行几条处理器指令的时间),通常用于共享内存中的数据结构。数据库系统完全自动管理这些锁。
短期锁的特点是模式最少,基础设施简单,甚至可能没有监控机制。
PostgreSQL 使用多种类型的锁1。长期锁包括 重锁(在关系及其他对象级别);单独列出 行级锁。短期锁包括各种 内存结构上的锁。特别的是 谓词锁,尽管名称如此,但它们并非真正的锁。(参见 268)(参见 305)(参见 298)
12.2. 重锁
重锁(heavyweight)属于长期锁。它们在 对象 级别设置:主要是关系,但也包括其他一些对象。这些锁通常用于防止对象被同时修改或在重组期间被使用,但也可能用于其他用途。这种模糊的定义源于这些锁被用于各种不同目的,而它们的共同点仅在于其结构方式。
通常,当未明确说明时,“锁”指的就是这种重锁。
重锁位于服务器的共享内存中 2,可通过 pg_locks 视图查看。其数量受限于两个服务器参数值的乘积:max_locks_per_transaction 和 max_connections。(默认值:64)(默认值:100)
锁池对所有事务共享,即一个事务可以获取超过 max_locks_per_transaction 数量的锁。重要的是系统中锁的总数不超过设定上限。锁池在服务器启动时创建,因此修改任一参数都需要重启服务器。
如果资源已被不兼容模式的锁占用,试图获取锁的进程将被放入队列。等待的进程不消耗 CPU 时间:它们休眠,并在资源释放时由操作系统唤醒。
可能发生 死锁(deadlock),即两个事务陷入 僵局,其中第一个事务需要第二个事务占用的资源,而第二个事务又需要第一个事务占用的资源。这是最简单的情况;多个事务也可能陷入僵局。由于死锁会导致无限等待,PostgreSQL 会自动检测僵局并强制中止其中一个事务,以使其他事务得以继续执行。(参见 286)
由于不同类型的重锁服务于不同目的,保护不同的资源,并具有不同的模式,因此每种类型都需单独讨论。
以下列表中的名称对应 pg_locks 视图中 locktype 列的值:
transactionid 和 virtualxid —— 事务编号锁;(参见 259)
relation —— 关系锁;(参见 261)
tuple —— 行版本锁;(参见 275)
object —— 非关系对象的锁;(参见 293)
extend —— 在向关系文件添加新页面时的文件锁;(参见 295)
page —— 页面锁(某些索引类型使用);(参见 296)
advisory —— 建议性锁。(参见 296)
几乎所有重锁都是在需要时自动设置,并在事务结束时自动释放。例外情况包括:关系锁可以显式请求,而建议性锁的管理完全由用户控制。
12.3. 事务 ID 上的锁
每个事务始终持有其自身编号(虚拟和真实,若存在)的排他锁。(参见 91)
使用两种锁模式:排他和共享。冲突矩阵非常简单:共享模式与自身兼容;排他模式与任何模式都不兼容。
| 模式 | Shared | Exclusive |
|---|---|---|
| Shared | × | |
| Exclusive | × | × |
要等待某个事务结束,只需请求其编号的锁(任意模式)。由于该事务本身已持有其编号的排他锁,因此无法获取。请求进程将进入队列并休眠。当事务结束时,锁被释放,等待的进程将被唤醒。当然,它无法获取所请求的锁——资源已不存在。但这并非必需。
在独立会话中启动一个事务并获取其服务进程编号:
刚刚启动的事务持有其自身虚拟编号的排他锁:
此处 locktype 为锁类型,virtualxid 为事务的虚拟编号(标识资源),mode 为模式(此处为排他)。granted 标志显示是否成功获取了请求的锁。
当事务获得真实编号时,其锁也会被添加到列表中:
现在事务持有其两个编号的排他锁。
12.4. 关系级锁
关系锁定义了八种不同的模式3。如此多的模式是为了尽可能让针对同一关系(表、索引或其他对象)的多种命令能够并发执行。
下图展示了冲突矩阵,并附有需要相应锁模式的命令示例。没有必要试图记忆这些模式或在它们的名称中寻找逻辑。但仔细研究这张表,得出一般性结论,并在需要时查阅——毫无疑问,这是值得的。
| 模式 | AS | RS | RE | SUE | S | SRE | E | AE | 命令 |
|---|---|---|---|---|---|---|---|---|---|
| Access Share | × | SELECT | |||||||
| Row Share | × | × | SELECT FOR UPDATE/SHARE | ||||||
| Row Exclusive | × | × | × | × | INSERT, UPDATE, DELETE | ||||
| Share Update Exclusive | × | × | × | × | × | VACUUM, CREATE INDEX CONCURRENTLY | |||
| Share | × | × | × | × | × | CREATE INDEX | |||
| Share Row Exclusive | × | × | × | × | × | × | CREATE TRIGGER | ||
| Exclusive | × | × | × | × | × | × | × | REFRESH MAT. VIEW CONCURRENTLY | |
| Access Exclusive | × | × | × | × | × | × | × | × | DROP, TRUNCATE, VACUUM FULL, LOCK TABLE, REFRESH MAT. VIEW |
第一个模式 Access Share 是最弱的。它与除最后一个模式 Access Exclusive 外的任何其他模式都兼容。因此,SELECT 命令几乎不会妨碍其他命令的执行,但例如,它不会允许删除正在被查询访问的表。相反,Access Exclusive 模式是最严格的:它与任何其他模式都不兼容,即具有排他性。
前四种模式允许同时对表中的数据进行修改,而后四种模式则不允许。例如,CREATE INDEX 命令使用 Share 模式。该模式与自身兼容(即可以同时为同一张表创建多个索引),也与读取类命令的模式兼容。因此,SELECT 命令可以执行,但 INSERT、UPDATE 和 DELETE 命令将被阻塞。
相反,正在修改表中数据的未完成事务将阻塞 CREATE INDEX 命令的执行。因此,存在 CREATE INDEX CONCURRENTLY 选项,它使用较弱的 Share Update Exclusive 模式:该命令创建索引的时间比普通命令更长(甚至可能失败),但允许同时进行数据修改。
ALTER TABLE 命令有多种变体,需要不同的锁模式(Share Update Exclusive、Share Row Exclusive、Access Exclusive)。当然,所有模式都在文档中都有描述4。
本章中的示例将使用我们已熟悉的账户表:
查询锁表的操作还会多次用到,因此我们为它创建一个视图,将所有标识符合并为一个简短输出的通用列:
第一个会话中的事务(尚未结束)正在更新一行。与表一起,该表的所有索引也被锁定,因此出现了两个类型为 relation、模式为 Row Exclusive 的新锁:
12.5. 等待队列
重锁提供“公平”的等待队列5。如果一个进程试图获取与已持有锁的模式不兼容,或与队列中已有等待进程的模式不兼容的锁,它就会进入等待队列。
当第一个会话中的事务正在执行更新时,尝试在另一个会话中为该表创建索引:
该命令“挂起”以等待资源释放。事务试图以 Share 模式获取表锁,但无法成功:
现在,假设在第三个会话中启动了 VACUUM FULL 命令。它也会进入队列,因为其所需的 Access Exclusive 模式与任何其他模式都不兼容:
现在,所有后续请求者都将进入队列,无论其锁模式如何。即使普通的 SELECT 查询也会诚实地排在 VACUUM FULL 之后,尽管它们与第一个会话中执行 UPDATE 命令所持有的 Row Exclusive 锁是兼容的。
函数 pg_blocking_pids 可以提供等待情况的总体视图。它显示了在指定进程之前排队的进程编号,这些进程要么持有不兼容的锁,要么正在请求不兼容的锁:
更详细的视图可以通过仔细分析 pg_locks 表的内容获得6。
当事务结束(无论通过提交还是回滚)时,其所有锁都会被释放7。队列中的第一个进程将获得所需的锁并被唤醒。
一个不明显的情况是,当回滚到保存点(通过 ROLLBACK TO SAVEPOINT 命令或进入 PL/pgSQL 块的 EXCEPTION 部分)时,事务自该保存点以来获取的所有锁都会被释放。这是由于嵌套事务的回滚及其锁的释放所致。
在我们的示例中,第一个会话中事务的结束将导致队列中所有查询的依次执行:(参见 92)
postgrespro.ru/docs/postgresql/18/explicit-locking#LOCKING-TABLES. ↩︎
backend/storage/lmgr/lock.c, 函数 LockAcquire. ↩︎
backend/storage/lmgr/lock.c, 函数 LockReleaseAll 和 LockRelease. ↩︎
13 行级锁
13.1. 锁设计
由于基于快照的隔离,读取表中的行时无需锁定。但不能允许两个事务同时修改同一行。需要对行进行锁定,然而重锁并不适合此用途:每把重锁都会占用服务器共享内存中的空间(数百字节,还不包括辅助基础设施),且内部机制并未设计用于处理大量同时存在的锁。
在某些数据库系统中,该问题通过提升锁级别来解决:当行级锁数量过多时,它们会被一个更通用的锁(例如页级或表级锁)所替代。这简化了实现,但可能导致效率显著下降。
在 PostgreSQL 中,关于某行被锁定的信息仅存储在行版本的头部。实际上,这仅仅是数据页面中的标志位,而非真正的锁——这些标志在内存中不会体现。
通常在修改或删除行时会锁定该行。在这两种情况下,当前行版本都会被标记为已删除。其标志是 xmax 字段中的事务号,而该事务号(结合额外的信息位)也表明该行已被锁定。当某个事务试图修改一行,但发现当前版本的 xmax 字段中包含一个未完成的事务号时,它必须等待该事务完成。之后所有锁都将被释放,等待的事务便可继续对行执行操作。(参见 87)
这种方案允许锁定任意数量的行,且不消耗任何资源。
其缺点在于,由于内存中没有锁信息,其他进程无法排队等待。因此,仍不得不使用常规的重锁。等待行被释放意味着等待阻塞事务的结束,而为此必须请求该事务号的锁。因此,所使用的重锁数量与同时运行的进程数成正比,而非与被修改的行数成正比。
13.2. 行级锁模式
存在四种可以锁定行的模式1。其中两种为互斥锁,同一时间只能由一个事务持有;另外两种为共享锁,可被多个事务同时持有。
冲突矩阵如下所示:
| 模式 | Key Share | Share | No Key Update | Update |
|---|---|---|---|---|
| Key Share | × | |||
| Share | × | × | ||
| No Key Update | × | × | × | |
| Update | × | × | × | × |
独占模式
Update 模式表示修改行的任意字段或删除该行;No Key Update 模式表示仅修改不涉及唯一索引的字段(即不会影响外键的修改)。
UPDATE 命令会自行选择最合适的锁模式;由于键通常不会改变,因此大多数情况下行是以 No Key Update 模式被锁定的。 UPDATE
创建一个函数,利用 pageinspect 扩展来显示我们关心的行版本信息,特别是 xmax 字段和一些信息位:
启动一个事务,并更新 accounts 表中第一个账户的金额(键未改变)和第二个账户的编号(键被改变):
查看页面内容:
锁模式由信息位 keys_updated 决定。
同一 xmax 字段也用于 SELECT FOR 命令的锁标志,但此时会设置额外的信息位 xmax_lock_only。该位表示行版本仅被锁定,尚未被删除,且仍为当前有效版本:
共享模式
Share 模式确保读取的行不会被其他事务修改。Key Share 模式允许修改行的任意字段,但不能修改键字段。
在共享模式中,PostgreSQL 核心仅在检查外键时使用 Key Share 模式。它与 No Key Update 互斥模式兼容,即外键检查不会妨碍多个事务同时更新非键字段。当然,应用程序也可使用任何合适的模式。
再次强调,读取操作不会使用任何行级锁。
在行版本中可见:
两种情况下均设置了 xmax_keyshr_lock 位,而 Share 模式可通过查看其他信息位来识别2。
13.3. 组事务
锁标志由 xmax 字段中的锁定事务号表示,但共享锁可被多个事务同时持有。如何在一个字段中记录多个事务号?
对于共享锁,使用所谓的 多事务 3(MultiXact)。多事务是一组事务,被赋予一个独立的编号。该组成员及各成员锁模式的详细信息存储在 PGDATA/pg_multixact 目录下的文件中。由于多事务的成员数量可任意,内存中页面的处理采用两个 SLRU 缓存:一个用于多事务成员信息,另一个用于在第一个缓存中查找信息的偏移量。缓存大小由参数 multixact_member_buffers 和 multixact_offset_buffers 控制。(参见 309)(默认值:32)(默认值:16)
多事务编号与普通事务编号具有相同的位宽(32 位),但编号空间独立分配,因此事务编号与多事务编号可能重叠。为区分两者,使用额外的信息位 xmax_is_multi。
向现有锁再添加一个由另一事务执行的互斥锁(由于 Key Share 与 No Key Update 模式兼容,此操作可行):
第一行中,普通编号被多事务编号替代——这由 xmax_is_multi 位表明。
为避免深入多事务实现细节,可使用 pgrowlocks 扩展,它能以方便的格式显示所有类型行锁的全部信息:
该查询外观上类似于访问 pg_locks 视图,但 pgrowlocks 函数会读取表页,因为行级锁信息在内存中并不存在。
由于多事务编号为 32 位,因此与普通事务编号一样,也会面临计数器溢出(xid wraparound)问题。因此,对多事务编号也需执行类似冻结的操作:将旧编号替换为新编号(或在冻结时若锁仅由一个事务持有,则替换为普通事务编号)4。(参见 134)
但与仅对 xmin 字段执行普通事务编号冻结(因为 xmax 非空的版本已无效,将被清理)不同,多事务编号的冻结是针对 xmax 字段的:当前行版本可能持续被多个事务以共享模式锁定。
控制多事务冻结的服务器参数与普通冻结类似:vacuum_multixact_freeze_min_age、vacuum_multixact_freeze_table_age、autovacuum_multixact_freeze_max_age,以及 vacuum_multixact_failsafe_age。(v. 14)
13.4. 等待队列
独占模式
由于行锁仅是一个标志,因此排队机制实现得相当复杂。当事务试图修改一行时,它会执行以下步骤 5:
如果行版本的
xmax字段及信息位表明该行以不兼容模式被锁定,则获取该行版本的互斥重锁;如有必要,等待不兼容锁的释放,通过请求
xmax字段中事务号(或多个事务号,若xmax为多事务号)的锁;将自身事务号写入行版本的
xmax字段,并设置必要的信息位;若在第 1 步中获取了行版本锁,则释放该锁。
行版本锁(tuple lock)是另一种重锁类型,其类型为 tuple。请勿将其与行锁(row lock)混淆。
可能有人认为第 1 步和第 4 步是多余的,仅等待阻塞事务即可。但如果多个事务同时尝试更新同一行,它们都会等待当前正在操作该行的事务结束。当该事务完成后,等待的事务之间将出现竞争,这可能导致某些“倒霉”的事务无限期等待。这种情况称为 资源饥饿(starvation)。
行版本锁确保队列中的第一个事务获得下一次锁的权限。
但最好亲眼看看。由于运行过程中会产生大量不同类型的锁,且每把锁在 pg_locks 表中对应一行,我将创建另一个基于 pg_locks 的视图。该视图以紧凑方式显示信息,并仅保留我们当前关注的锁(与 accounts 表和当前事务相关的锁,但不包括虚拟事务号锁):
启动第一个事务并更新一行:
该事务成功执行了序列中的四个步骤,现在持有表锁:
启动第二个事务并尝试更新同一行。该事务在等待锁时挂起:
第二个事务仅执行到第二步。因此,除了表锁和自身事务号外,它还在 pg_locks 中添加了两条记录:第一步获取的 tuple 类型锁,以及第二步请求的首个事务号锁。
第三个事务仅执行到第一步。它将尝试获取行版本锁,但在此处停止。
第四个及后续事务若希望更新同一行,将与第三个事务无异——它们都将等待同一把行版本锁。
当前等待情况的总体视图可以通过 pg_stat_activity 视图查看,并添加关于阻塞进程的信息:
如果第一个事务回滚,整个结构将按预期工作:剩余事务将按顺序向前推进一步。
但更可能的是,第一个事务会提交。在可重复读或可串行化隔离级别下,这将导致第二个事务因序列化错误而中止6(随后队列中的其他事务也会中止)。但在读已提交隔离级别下,修改后的行会被重新读取,并尝试重新更新。
因此,第一个事务结束:
第二个事务被唤醒,并成功执行了序列的第三和第四步:
一旦第二个事务释放了行版本的锁,第三个事务也被唤醒,但它发现新行版本的 xmax 字段中已有另一个事务号。至此,上述锁定序列以失败告终。在读已提交隔离级别下,会尝试重新锁定行7,但这次尝试不再遵循前述序列。第三个事务将等待第二个事务完成,而不再尝试获取行版本锁:
第四个事务也发生同样的情况:
现在,第三个和第四个事务都在等待第二个事务完成,同时期待竞争获取锁。队列本身已经瓦解。
如果在队列仍然存在时,又有多个其他事务加入,它们都将无意中成为这场竞争的参与者。
结论:在多个并行进程中同时更新同一张表的同一行,不是一个好主意。这会形成热点,当负载足够高时,会成为性能瓶颈。
完成所有已启动的事务。
共享模式
PostgreSQL 仅在检查引用完整性时使用行共享锁。在高负载应用中使用这些锁可能导致资源饥饿,而两级锁机制对此并无防范作用。
再次提醒一下事务在锁定行时执行的操作序列:
如果行版本的
xmax字段和信息位表明该行已被以不兼容模式锁定,则获取该可变行版本的独占重锁;如有必要,等待不兼容锁的释放,通过请求
xmax(或多个事务,若xmax为多事务)的事务号锁;在行版本中写入自己的事务号(在
xmax字段中)并设置必要的信息位;如果在第1步中获取了行版本锁,则释放该锁。
前两个步骤表明,如果锁模式是兼容的,事务将无需排队执行。
让我们从头开始重复这个实验。
启动第一个事务:
第一个事务以共享模式锁定该行:
第二个事务尝试更新同一行,但无法成功——共享模式与无键更新模式不兼容:
第二个事务等待第一个事务完成,并持有行版本锁——与之前示例相同:
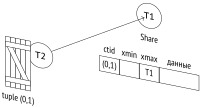
现在让第三个事务以共享模式锁定该行。其锁与现有锁兼容,因此第三个事务无需排队即可通过:
现在已有两个事务锁定了该行:
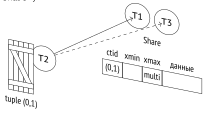
现在,如果第一个事务结束,第二个事务将被唤醒,但它会发现行锁并未消失,于是再次进入队列——这次排在第三个事务之后:
只有当第三个事务结束(且在此期间未出现其他共享锁)时,第二个事务才能执行更新。
外键检查不太可能引发问题,因为键字段通常不会改变,且 Key Share 与 No Key Update 模式是兼容的。但大多数情况下,建议避免在应用中使用行共享锁模式。
13.5. 无等待锁定
通常,SQL 命令会等待所需资源的释放。但有时希望在无法立即获取锁时放弃执行。为此,SELECT、LOCK 和 ALTER 等命令支持 NOWAIT 子句。
锁定一行:
带有 NOWAIT 子句的命令若资源已被占用,将立即以错误终止:
在应用代码中,可以捕获此类错误并进行处理。
UPDATE 和 DELETE 命令不支持 NOWAIT 子句。标准做法是先尝试使用 SELECT FOR UPDATE NOWAIT 锁定行,若成功再执行更新或删除。
在极少数情况下,跳过已锁定的行并立即获取空闲行进行处理会更方便。SELECT FOR 命令配合 SKIP LOCKED 子句可实现此功能:
在此示例中,第一行(已锁定)被跳过,查询锁定了并返回了第二行。
这种方法可用于实现多线程队列处理或分组行的批量处理。但不应为该命令寻找其他用途——大多数任务可通过更简单的方法解决。(参见 179)
最后,可通过设置超时来避免长时间等待:
命令因在 1 秒内未能获取锁而失败。当然,超时可不仅设置在会话级别,也可设置在单个事务级别。
该方法可避免在高负载下执行需要独占锁的命令时出现长时间阻塞。在收到错误后,可稍后重试该命令。
参数 lock_timeout 与参数 statement_timeout 的区别在于,前者限制的是等待锁的时间,而非操作的总执行时间。
13.6. 死锁
一个事务继续运行可能需要另一个事务持有的资源;而那个事务可能需要第三个事务持有的资源,依此类推。事务会通过重锁机制排队等待。
但有可能出现这样的情况:一个正在排队的事务还需要另一个资源,而它自己也必须加入到该资源的同一队列中。这就产生了死锁 8:队列形成闭环,无法自行解除。
为了直观理解锁的状况,我们可以构建一个等待图。该图的顶点是正在执行的进程。其边是箭头,从等待获取锁的进程指向持有这些锁的进程。如果图中存在环,即从某个顶点沿箭头可以回到自身,那么就发生了死锁。(参见 301)
我在图中展示的不是进程,而是事务。通常这种替换是允许的,因为一个进程通常只执行一个事务,且锁不会在事务之外被获取。但在一般情况下,必须讨论进程,因为并非所有锁都会在事务结束后立即释放。
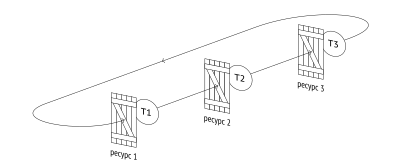
如果发生了死锁且没有任何参与者设置了等待超时,事务将无限期地相互等待。因此,锁管理器 9 会自动监控此类情况。
然而,检查需要一定的开销,我们不希望每次请求新锁时都进行检查(毕竟死锁相当罕见)。因此,当进程尝试获取锁但无法获取时,它只是进入队列并休眠,同时自动设置一个超时时间,该时间由参数 deadlock_timeout 10 指定。如果资源在超时前被释放,那就很好,节省了检查开销。但如果在 deadlock_timeout 时间单位后等待仍未结束,等待的进程将被唤醒并启动检查11。(默认值:1s)
本质上,检查过程就是构建等待图并在其中查找环12。在检查期间,所有重锁操作都会被暂停,以“冻结”当前图的状态。
如果检查未发现死锁,进程将再次休眠;迟早会轮到它继续执行。
如果检测到死锁,其中一个事务将被强制中止,以释放其持有的锁,使其他事务能够继续运行。大多数情况下,被中止的是发起检查的事务,但如果环中包含未因事务计数器溢出而冻结的自动清理工作进程,则自动清理将被中止,因其优先级较低。
死锁通常意味着应用程序设计不当。可以通过两种方式发现此类情况:首先,服务器日志中会出现相关消息;其次,pg_stat_database 表中的 deadlocks 值会增加。
行更新导致的死锁
尽管最终导致死锁的是重锁,但最常见的原因是表行的加锁顺序不一致。
假设第一个事务准备将 100 ₽ 从第一个账户转账到第二个账户。为此,它首先减少第一个账户的余额:
与此同时,第二个事务准备将 10 ₽ 从第二个账户转账到第一个账户。它从减少第二个账户余额开始:
现在第一个事务尝试增加第二个账户余额,但发现该行已被锁定:
随后第二个事务尝试增加第一个账户余额,但同样被阻塞:
出现了循环等待,这种情况无法自行结束。一秒钟后,第一个事务因无法访问资源而发起死锁检查,被服务器中止:
现在第二个事务可以继续执行。它被唤醒并执行更新:
完成事务。
正确执行此类操作的方法是始终以相同的顺序锁定资源。例如,在本例中,可以按账户编号升序锁定账户。
两条 UPDATE 语句之间的死锁
有时,死锁看似不可能发生,但仍然会出现。
我们通常习惯将 SQL 命令视为原子操作。但以 UPDATE 为例,该命令是逐行更新并逐行加锁(而非一次性锁定所有行),且这一过程并非瞬时完成。因此,如果一个 UPDATE 命令以某种顺序更新多行,而另一个以不同顺序更新,它们就可能发生相互阻塞。
为了复现该情况,我们创建一个按 amount 列降序排列的索引:
为了能观察到过程,我们编写一个延迟函数:
第一个 UPDATE 命令将更新整个表。执行计划为全表顺序扫描:
我们将表中行版本按金额升序排列。为此,我们将它们重新插入已清空的表中:
在顺序扫描过程中,行将按相同顺序被更新(对于大表,这并非总是成立)。(参见 198)
启动更新操作:
在它运行期间,我们在另一个会话中禁止使用顺序扫描:
此时,查询规划器将决定对下一个 UPDATE 操作使用索引扫描:
符合条件的是第二行和第三行,且由于索引按金额降序构建,行将按逆序更新。
启动下一个更新操作:
通过 pgrowlocks 扩展查看表页面,我们会发现第一个操作已更新第一行(0,1),而第二个操作已更新最后一行(0,3):
又过了一秒。第一个操作更新了第二行,而第二个操作想更新它,但无法实现。
现在第一个操作想更新表的最后一行,但它已被第二个操作锁定。死锁发生了。
其中一个事务被中止:
另一个事务完成执行:
尽管看似难以置信,但在高负载系统中批量更新行时,此类情况确实会发生。
postgrespro.ru/docs/postgresql/18/explicit-locking#LOCKING-ROWS. ↩︎
backend/access/heap/heapam.c, 函数 FreezeMultiXactId. ↩︎
backend/executor/nodeModifyTable.c, 函数 ExecUpdate. ↩︎
backend/access/heap/heapam_handler.c, 函数 heapam_tuple_lock. ↩︎
postgrespro.ru/docs/postgresql/18/explicit-locking#LOCKING-DEADLOCKS. ↩︎
backend/storage/lmgr/proc.c, 函数 ProcSleep. ↩︎
backend/storage/lmgr/proc.c, 函数 CheckDeadLock. ↩︎
14 不同对象上的锁
14.1. 非关系锁
当需要锁定 PostgreSQL 概念中非 关系 的资源时,会使用类型为 object 的重锁1。此类资源可以是系统目录中几乎任何内容,例如表空间、订阅、模式、角色、策略、枚举类型等。
开始一个事务并在其中创建一张表:
现在查看 pg_locks 中的非关系锁:
此处锁定的资源由三个字段定义:
database — 锁定对象所属数据库的 oid(或为零,表示集群级的通用对象);
classid — pg_class 中的 oid,对应定义资源类型的系统目录表名;
objid — classid 所指向的系统目录表中的 oid。
列 database 显示当前会话连接的数据库 internals。列 classid 指向包含模式的表 pg_namespace。
现在我们可以解析 objid:
因此,public 模式被锁定,以防止在事务完成前被删除。
相应地,删除对象时,会同时对对象本身及其所有依赖对象获取排他锁2。
14.2. 关系扩展锁
当关系中的行数增加时,PostgreSQL 会尽可能在现有页面中利用空闲空间进行插入。但显然,在某个时刻必须添加新页面,即 扩展关系。物理上,页面会添加到相应段文件的末尾(这可能导致创建新的段文件)。
为防止两个进程同时开始添加页面,该操作受到一种特殊的重锁保护,其类型为 extend3。同样,索引清理时也使用这种锁,以防止其他进程在扫描期间添加新页面。
关系扩展锁的行为与之前讨论的锁略有不同:
它在扩展操作完成后立即释放,无需等待事务结束;
它不会导致死锁,因此在检测死锁的程序中对此做了特殊处理:它不会进入等待图。
尽管如此,如果扩展等待时间超过 deadlock_timeout 参数设置的值,检测过程仍会被调用。这是一种异常情况,但当大量并行进程产生高插入负载时可能发生。在这种情况下,检测可能反复触发,实际上使系统陷入瘫痪。
在高插入负载下,扩展锁可能成为瓶颈,因此表文件的扩展不再仅增加一页,而是同时扩展多页(按等待锁的进程数成比例,但每次最多扩展 64 页)4。然而,基于 B-树的索引文件每次仍只增加一页5。(v. 16)
14.3. 页锁
仅在 GIN 索引的特定机制下使用类型为 page 的页面级重锁6。(参见 612)
GIN 索引允许加速在复合值中搜索元素,例如文本文档中的单词。这类索引大致可视为普通 B-树,其中存储的不是文档本身,而是文档中的各个单词。因此,当插入新文档时,索引需要大幅重构,将文档中的每个单词插入其中。
为提升性能,GIN 索引提供了延迟插入功能,通过存储参数 fastupdate 启用。新单词首先快速插入到一个无序的 待处理列表(pending list)中,经过一段时间后,所有累积的单词再批量移入主索引结构。这种优化基于不同文档中单词高度重复的假设,从而节省开销。(默认值:on)
为防止多个进程同时将待处理列表中的单词移入主索引,转移期间会以排他模式锁定索引的元页面。这不会影响索引的常规使用。
与关系扩展锁类似,页面锁在操作完成后立即释放(而非事务结束时),且不会导致死锁。
14.4. 咨询锁
与其他重锁(如关系锁)不同,建议锁 7(advisory locks)从不自动设置,由应用程序开发者手动管理。它们非常适合用于实现非标准的锁定逻辑。
假设存在一个不对应任何数据库对象的资源(我们无法通过 SELECT FOR 或 LOCK TABLE 等命令锁定它)。要锁定该资源,需将其映射为一个数值标识符。若资源具有唯一名称,一种简单方法是使用名称的哈希值:
存在一组完整的函数 8 用于管理建议锁。其名称以 pg_advisory 开头,并包含额外词汇以明确功能:
lock — 获取锁;
try — 尝试获取锁,若无法立即获取则不等待;
unlock — 释放锁;
share — 使用共享模式(默认为排他模式);
xact — 锁定至事务结束(默认为会话结束)。
例如,获取一个会话级的排他锁:
为使锁定机制真正生效,其他进程也必须遵循相同的资源访问顺序。这一规则需由应用程序负责维护。
已设置的锁在事务结束后仍不会被释放:
在完成对资源的操作后,显式释放锁:
14.5. 谓词锁
术语 谓词锁 最初出现在尝试基于锁实现完全隔离的早期尝试中9。当时面临的问题是,即使锁定了所有读取和修改的行,也无法实现完全隔离:表中可能新增满足原有筛选条件的 新行,从而导致 幻影 现象。(参见 51)
因此提出锁定条件(谓词)而非行。当执行带有谓词 a > 10 的查询时,锁定该谓词可防止向表中插入满足该条件的新行,从而避免幻影。但难点在于,当出现另一个条件(如 a < 20)时,需判断两个条件是否重叠。在一般情况下,该问题在算法上不可解;实践中仅能对具有极简单形式的谓词(如示例中)进行处理。
在 PostgreSQL 中,可串行化隔离级别通过另一种机制实现:基于快照的可串行化隔离协议(Serializable Snapshot Isolation, SSI)10。术语 谓词锁 保留了下来,但其含义已根本改变。实际上,此类“锁”并不真正阻塞任何操作,而是用于跟踪事务间的数据依赖关系。
已证明,基于快照的隔离(在 Repeatable Read 级别实现)允许出现 不一致写入异常 和 仅读事务异常,但不会出现其他异常。这两种异常在事务依赖图中对应特定模式,可通过低开销方式检测。(参见 67)
难点在于必须区分两种依赖类型:
一个事务读取了一行,随后被另一个事务修改(RW 依赖);
一个事务修改了一行,随后被另一个事务读取(WR 依赖)。
WR 依赖可通过现有常规锁检测,而 RW 依赖则需借助谓词锁额外跟踪。该跟踪机制在选择可串行化隔离级别时启用,因此至关重要:所有(或至少所有相互关联的)事务必须使用该级别。若任一事务使用其他隔离级别,它将不会设置(或检查)谓词锁,导致可串行化级别退化为 Repeatable Read。
再次强调:尽管名为“锁”,谓词锁实际上并不阻塞任何操作。相反,在事务提交时会进行检查,若发现“不良”依赖结构可能暗示异常,则事务将被中止。
创建一张包含数据的表,并建立一个占用若干页面的索引(为此设置了较低的 fillfactor 值):
若查询通过表的顺序扫描执行,谓词锁将作用于整个表(即使筛选条件仅匹配部分行)。
尽管谓词锁使用独立的基础设施,它们仍显示在 pg_locks 视图中,与重锁一同列出。任何谓词锁始终以一种特殊模式 SIRead(Serializable Isolation Read)获取:
需要注意的是,谓词锁并不总是在事务结束后立即释放,因为它们用于跟踪 事务之间 的依赖关系。但无论如何,其管理是自动完成的。
如果查询是通过索引扫描执行的,情况会向好的方向转变。对于 B-树,只需在读取的表行和索引的叶页面上设置预测性锁即可。这样不仅锁定了特定值,还锁定了整个读取的范围。
覆盖读取范围的叶页面数量可能会发生变化,例如由于插入新行导致索引页面分裂。但实现会考虑这种情况,并锁定新页面:
每读取一个行版本都会创建一个独立的锁,但潜在的行版本数量可能非常多。预测性锁使用单独的锁池,其内存空间在服务器启动时分配。预测性锁的总数受参数 max_pred_locks_per_transaction 和 max_connections 的乘积限制(尽管参数名称暗示按事务分别计数,但实际上并不按事务单独计数)。(默认值:64)(默认值:100)
本质上,这与行锁的问题相同,但解决方式不同:通过提高锁的级别 11。
可以使用配置参数设置提高锁级别时的阈值。如果属于同一页面的行版本锁数量超过 max_pred_locks_per_page,这些锁将被替换为一个页面级别的锁。(默认值:2)
原本有三个 tuple 类型的锁,现在变为一个 page 类型的锁:
同样地,页面锁的级别也会提升。如果属于同一关系的页面锁数量超过 max_pred_locks_per_relation,这些锁将被替换为一个关系级别的锁。(当参数值为负数时,以 max_pred_locks_per_transaction 除以该参数绝对值作为上限;因此默认情况下上限为 32)。(默认值:-2)(默认值:64)
当然,锁级别提升不可避免地会导致更多事务因序列化错误而意外终止。系统吞吐量最终会下降。需要在锁的内存开销与性能之间寻找平衡。
预测性锁支持以下类型的索引:
B-树;
哈希索引、GiST 和 GIN。
如果使用索引访问,但索引不支持预测性锁,则会将整个索引加锁。当然,这也增加了事务因冲突而失败的次数。
为了在可串行化级别更高效地运行,应显式将仅读取的事务标记为 READ ONLY。如果锁管理器确认读取事务与其他事务不可能发生冲突12,它将能够释放已为该事务设置的预测性锁,并不再分配新的锁。如果进一步将此类事务声明为可延迟的(DEFERRABLE),则可避免仅读取事务的异常。(参见 71)
backend/storage/lmgr/lmgr.c, 函数 LockDatabaseObject 和 LockSharedObject. ↩︎
backend/catalog/dependency.c, 函数 performDeletion. ↩︎
backend/storage/lmgr/lmgr.c, 函数 LockRelationForExtension. ↩︎
backend/access/heap/hio.c, 函数 RelationAddBlocks. ↩︎
backend/access/nbtree/nbtpage.c, 函数 _bt_allocbuf. ↩︎
backend/storage/lmgr/lmgr.c, 函数 LockPage. ↩︎
postgrespro.ru/docs/postgresql/18/explicit-locking#ADVISORY-LOCKS. ↩︎
postgrespro.ru/docs/postgresql/18/functions-admin#FUNCTIONS-ADVISORY-LOCKS. ↩︎
K. P. Eswaran, J. N. Gray, R. A. Lorie, I. L. Traiger. The notions of consistency and predicate locks in a database system. ↩︎
backend/storage/lmgr/README-SSI; backend/storage/lmgr/predicate.c. ↩︎
backend/storage/lmgr/predicate.c, 函数 PredicateLockAcquire. ↩︎
backend/storage/lmgr/predicate.c, 宏 SxactIsROSafe. ↩︎
15 内存结构上的锁
15.1. 自旋锁
为了保护共享内存中的结构,使用的是非传统的重锁,而是多种更轻量、成本更低的锁。
其中最简单的是 自旋锁(spinlock),也称为 自旋锁。它们用于在极短的时间内(几条处理器指令)获取,并保护内存的特定区域免受同时修改。
自旋锁基于处理器的原子指令实现,例如 compare-and-swap1。它们仅支持单一的独占模式。如果锁已被占用,等待的进程会执行主动等待——重复执行该指令(“在循环中旋转”,因此得名)。如果在特定时间内无法获取锁,进程将短暂暂停,然后再次开始主动等待循环。
这种策略在冲突概率极低的情况下是有意义的,因此一旦收到拒绝,可以预期锁将在几条指令后被释放。
自旋锁无法检测死锁。从应用角度看,只能相信 PostgreSQL 开发者正确使用了这些锁。
15.2. 轻量锁
接下来是所谓的 轻量锁 2(lightweight locks, lwlocks)。它们被持有以完成对数据结构(例如哈希表或指针列表)的操作所需的时间。通常轻量锁持有时间较短,但在某些情况下它们保护 I/O 操作,因此时间可能相当长。
存在两种模式:独占模式(用于修改数据)和共享模式(仅用于读取)。支持等待队列,但当锁以共享模式持有时,其他读取进程可绕过队列直接访问。在高并发和高负载系统中,这可能导致不良影响3。
未提供死锁检测机制;轻量锁和自旋锁的正确使用,同样依赖于 PostgreSQL 开发者的责任。
15.3. 例子
为了对自旋锁和轻量锁的使用方式和位置有一个大致了解,我们来看三个共享内存结构的示例:缓冲区缓存、预写日志缓冲区和 SLRU 缓存。我不会列出所有锁;完整图景过于复杂,仅对内核开发者有参考价值。
缓冲区缓存
要访问哈希表以查找缓存中的缓冲区,进程必须获取轻量锁  BufferMapping:以共享模式用于读取,以独占模式用于修改。(参见 183)
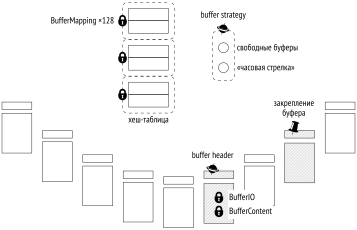
对哈希表的访问非常频繁,这种锁常常成为瓶颈。为了提高粒度,它实际上被设计为一个 分段,由 128 个独立的轻量锁组成,每个锁保护哈希表的一部分 4。
首次将保护哈希表的单一锁改为 16 个锁的分段是在 PostgreSQL 8.2 版本(2006 年)中实现的。十年后,在 9.5 版本中分段大小增加到 128。在现代多核系统中,有时这个值仍然不足。
进程通过获取自旋锁  buffer header 5 来访问缓冲区头(名称为示意性,因为自旋锁没有外部名称)。某些操作,如增加访问计数,可以使用处理器的原子指令在无显式锁的情况下执行。
要读取缓冲区内容,需要获取锁  BufferContent。它位于该缓冲区的头中6。通常,该锁仅在读取行版本指针所需的时间内持有,之后只需依赖
 缓冲区固定提供的保护。要修改缓冲区内容,必须以独占模式获取 BufferContent 锁。(参见 189)
在从磁盘读取缓冲区(或写入磁盘)时,还会获取缓冲区头中的锁  BufferIO;实际上这不是真正的锁,而是一个扮演锁角色的标志7。该锁向其他对该页面感兴趣的进程发出信号,表示必须等待 I/O 完成。
指向空闲缓冲区的指针和淘汰机制的“时针”也由一个共同的自旋锁  buffer strategy8 保护。
WAL 缓冲区
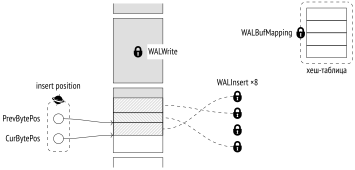
日志缓存也使用哈希表,用于将页面映射到缓冲区。与缓冲区缓存的哈希表不同,该表仅由一个轻量锁  WALBufMapping 保护,因为日志缓存的大小小得多(通常等于一个段),且对缓冲区的访问更有序9。
将日志页面写入磁盘的操作由轻量锁  WALWrite 保护,以确保在任何时刻只有一个进程可以执行此操作。
要创建日志记录,进程首先在 WAL 页面内预留空间,然后填充所需数据。预留操作是严格有序的;进程必须获取自旋锁  insert position,以保护插入指针10。但已预留的空间可以由多个进程同时填充。为此,进程必须获取 任意一个 由八个轻量锁组成的分段
 WALInsert11。
SLRU 缓存
SLRU(简单最近最少使用)缓存 12 用于多事务(multixact)、事务状态(clog)或子事务(subtrans)等数据结构的页面。与缓冲区缓存不同,SLRU 缓存结构简单,设计目标是主要的读写操作集中在最近的页面上:例如,事务的提交和状态检查通常在相近时间发生,之后便不再访问该事务的状态。被淘汰的页面是长时间未被访问的页面。(参见 86)
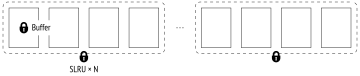
缓存被划分为若干个分组(bank),每组 16 页;页面所属分组由其编号的低四位比特决定。这种设计无需哈希表:在规模较小的分组内,线性搜索已足够。为特定数据结构服务的缓存总大小可单独配置。
每个分组由自己的轻量锁 SLRU 保护(分组名称取决于数据结构:例如,clog 的分组称为 XactSLRU)。每页也有自己的轻量锁 Buffer(clog 为 XactBuffer)。进程持有分组锁以获取或修改其中缓冲区的状态。获取分组锁也用于获取页面锁,以便将页面写入磁盘或从磁盘读取;但在 I/O 操作期间,分组锁会被释放,以便其他进程可以访问该分组中的其他页面。
15.4. 监控等待
当然,锁对于正确运行是必要的,但它们也可能导致不希望的等待。跟踪这些等待有助于查明其原因。
获取系统中长时间持有锁的最简单方法是启用参数 log_lock_waits。此时,每当事务等待时间超过 deadlock_timeout,服务器日志中都会记录详细的锁信息。这些数据在死锁检测检查完成后输出,因此得名。(默认值: off) (默认值: 1s) (参见 286)
但更完整且更有用的信息可以在视图 pg_stat_activity 中找到。当进程(系统或服务)无法执行其工作并等待某些内容时,该等待会在 wait_event_type(等待类型)和 wait_event(具体等待名称)列中显示。
所有等待可以分为几个类型13。
其中一大类是各种锁的等待:
Lock — 重锁;
LWLock — 轻量锁;
BufferPin — 缓冲区固定。
每种类型由等待名称进一步具体化。例如,对于轻量锁,这将是锁名称或相应分段的名称14。
但进程也可能等待其他事件:
IO — 输入/输出,当需要写入或读取数据时;
Client — 来自客户端的数据(在此状态下,psql 通常花费大部分时间);
IPC — 来自其他进程的数据;
Extension — 扩展注册的特定事件;
InjectionPoint — 在注入点执行代码以测试 PostgreSQL(此事件在生产中不会出现)。(v. 17)
有时进程只是不执行任何有用工作。这类等待包括:
Activity — 后台进程在其主循环中;
Timeout — 定时器。
通常,这类等待是“正常”的,不表示任何问题。然而,例如,类型为 Timeout 的 SpinDelay 事件表明正在等待自旋锁。(v. 17)
需要注意的是,该视图仅显示在源代码中适当处理的等待。如果未定义等待类型名称,进程不在任何已知等待中。这种时间应视为 未计入,因为这并不意味着进程一定没有等待;实际上,此时正在发生什么尚不清楚。 15
在这种情况下,访问视图时所有后台服务进程都在空转,而服务进程(client backend)正忙于执行查询,没有任何等待。
15.5. 采样
不幸的是,视图 pg_stat_activity 仅显示当前时刻的等待信息;统计数据不会累积。唯一能够获得随时间变化的等待情况的方法是——以一定间隔对视图状态进行采样。
必须考虑采样的概率性质。相对于采样周期,等待时间越短,被记录到的概率就越低。因此,采样周期越长,需要的测量次数就越多,才能获得可靠的图景。而提高采样频率则会导致开销增加。正因为如此,对于短生命周期会话的分析,采样几乎毫无用处。
系统未提供内置的采样机制,但作为示例,我们将使用扩展 pg_wait_sampling16。需要将该库写入参数 shared_preload_libraries 并重启服务器。
现在在数据库中安装该扩展:
该扩展允许查看保存在环形缓冲区中并逐渐被新数据覆盖的最近等待情况。但更有趣的是获取等待的概要——即整个运行期间累积的统计信息。
例如,观察基准测试运行期间产生的等待情况。启动工具 pgbench,并在它运行时确定其进程号:
工作结束后等待的概要:
默认设置下(参数 pg_wait_sampling.profile_period),值每秒保存 100 次。因此,要估算等待时间(以秒为单位),需将 count 除以 100;总持续时间大致对应于进程的运行时间。(默认值:10ms)(v. 1.1.6)
本例中,工具大部分时间都在执行有用工作。非生产性等待主要与日志记录同步到磁盘有关。此例很好地说明了 未计入 时间的概念。事件 WALSync 的处理功能自 PostgreSQL 12 版本引入;在更早版本中,该概要不会包含第一行,尽管等待本身当然仍然存在。
轻量级锁 ProcArray 保护服务器共享内存中的同名数据结构。(参见 99)
如果人为地减慢文件系统性能(例如使用 slowfs 17),使任何 I/O 操作耗时 0.1 秒,那么概要将呈现如下:
现在 I/O 操作成为首要等待项,主要与日志的同步写入有关。由于日志写入受轻量级锁 WALWrite 保护,相应行也出现在概要中。
显然,该锁在前一个示例中也已被请求过,但由于其等待时间短于采样周期,因此要么极少被采样到,要么根本未被采样。这再次说明,分析短时等待需要长时间的采样。
www.postgresql.org/message-id/flat/CAPpHfdvJhO1qutziOp%3Ddy8TO8Xb4L38BxgKG4RPa1up1Lzh_ UQ%40mail.gmail.com. ↩︎
backend/storage/buffer/bufmgr.c; include/storage/buf_internals.h, 宏 BufMappingPartitionLock. ↩︎
backend/storage/buffer/bufmgr.c, 函数 LockBufHdr. ↩︎
backend/storage/buffer/bufmgr.c, 函数 StartBufferIO. ↩︎
backend/access/transam/xlog.c, 函数 AdvanceXLInsertBuffer. ↩︎
backend/access/transam/xlog.c, 函数 ReserveXLogInsertLocation. ↩︎
backend/access/transam/xlog.c, 函数 WALInsertLockAcquire. ↩︎
postgrespro.ru/docs/postgresql/18/monitoring-stats#WAIT-EVENT-TABLE. ↩︎
postgrespro.ru/docs/postgresql/18/monitoring-stats#WAIT-EVENT-LWLOCK-TABLE. ↩︎
第四部分 查询执行
16 查询执行的各个阶段
16.1. 示例数据库
在本书的前几部分中,我们使用的是包含少量行的简单表。本节及接下来的部分将讨论查询执行,我们需要使用具有大量行的相互关联的表。为了避免为每个示例创建自己的数据集,我直接使用了一个现成的航空运输演示数据库1。该演示数据库有多个版本;我使用的是2017年8月15日的大型版本。要安装它,需要解压数据库副本文件2,并在psql中执行该文件。
在开发演示数据库时,我们力求使数据模式足够简单,以便无需额外说明即可理解,但同时又足够复杂,以支持有意义的查询。数据库中填充了现实的数据,这有助于理解示例,并使操作更具趣味性。
下面我将简要描述演示数据库中的主要对象,完整描述请参见脚注中的链接。
核心实体是预订(表bookings)。一个预订可以包含多个乘客,每个乘客会获得一张电子机票(tickets)。乘客本身不是独立实体;我们将假设所有乘客都是唯一的。
每张机票包含一个或多个航班(ticket_flights)。当执行中转航班或购买往返票时,可能会出现多个航班。数据模式中没有强制约束,但假设同一预订中的所有机票具有相同的航班集合。
每个航班(flights)从一个机场(airports)出发,飞往另一个机场。相同航班号的航班具有相同的出发地和目的地,但出发日期不同。
视图routes从航班表中提取与具体航班日期无关的航线信息。
乘客登机时会获得一张登机牌(boarding_passes),其中标明了飞机上的座位号。乘客只能为机票中包含的航班办理登机手续。航班与座位号的组合必须唯一,以防止为同一座位发放两张登机牌。
飞机上的座位数(seats)及其在不同服务等级中的分布取决于执行航班的特定飞机型号(aircrafts)。假设每种型号仅有一种客舱布局。
某些表使用代理主键,而另一些表使用自然键(其中一些是复合键)。这是出于演示目的而特意设计的,并不建议作为模仿范例。
该演示数据库可视为真实系统的备份:它包含某个特定时刻的最新数据。该时刻的时间保存在函数bookings.now中。在查询中,当现实中需要使用now函数时,可以使用该函数。
机场、城市和飞机型号的名称存储在airports_data和aircrafts_data表中,包含俄语和英语两种语言。在查询中通常使用ER图中所示的视图airports和aircrafts。这些视图根据bookings.lang参数选择的语言提供翻译。但基础表名可能出现在查询执行计划中。(默认值: ru)
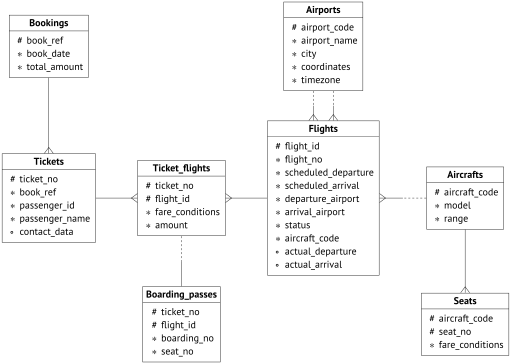
16.2. 简单查询协议
PostgreSQL的简单客户端-服务器协议3允许向服务器发送SQL查询文本,并接收全部结果行,无论结果有多少行4。传入服务器的查询会经历多个阶段:解析、重写、规划,最终执行。
解析
首先,必须对查询文本进行解析5(parse),以明确需要执行什么操作。
词法和语法解析。 词法分析器将查询文本分解为词法单元6(如关键字、字符串和数值字面量),而语法分析器则验证这些词法单元是否符合语言的语法规则7。PostgreSQL使用标准工具(Flex和Bison)进行解析。
解析后的查询在服务进程的内存中以抽象语法树的形式表示。
以以下查询为例:
词法分析器将识别出五个关键字、五个标识符、一个字符串字面量和三个单字符词法单元(用于逗号、等号和分号)。语法分析器将这些词法单元构造成一棵树,如图所示,但以高度简化的方式呈现。树中各节点旁标注了与之对应的查询部分:
SELECT
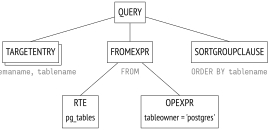
pg_table WHERE tableowner = 'postgres'
RTE是Range Table Entry的非显式缩写。在PostgreSQL源代码中,范围表(range table)指代表、子查询、连接结果等——换句话说,即SQL操作所处理的行集8。
语义解析。 语义分析9的任务是确定数据库中是否存在查询所引用的表及其他对象,并确认用户是否有权访问这些对象。语义分析所需的所有信息均存储在系统目录中。(参见24)
语义分析器从语法分析器接收解析树,并对其进行重构,补充对数据库中具体对象的引用、数据类型信息及其他相关信息。
通过解析生成的完整树可以在服务器日志中获取,只需设置参数debug_print_parse,尽管这在实际中意义不大。
转换
接下来,查询可以被转换(重写)10。
转换由内核用于多种目的。其中一个用途是将解析树中的视图名称替换为对应视图查询的子树。
内核系统另一个使用转换的示例是实现行级访问控制11(row-level security)。
在转换阶段,还会对递归查询的SEARCH和CYCLE子句进行转换12。(v. 14)
在上述示例中,pg_tables是一个视图;将它的定义代入查询文本后,我们得到:
实际上,服务器并不处理文本表示,而是在解析树上执行所有操作。其在转换阶段后的状态如图所示,以简化形式呈现(完整树可通过设置参数debug_print_rewritten在日志中获取)。
解析树反映了查询的语法结构,但并未说明操作的执行顺序。
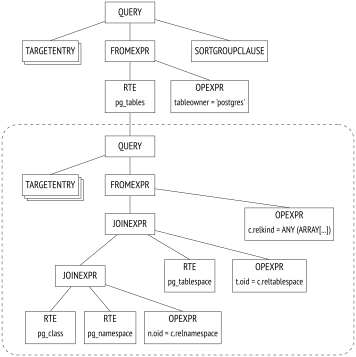
PostgreSQL允许用户编写自己的转换规则。这通过重写规则系统13(rules)实现。
规则支持曾被列为14Postgres开发的目标之一,因此规则在大学项目阶段就已存在,并在之后多次被重新审视。这是一个功能强大但调试和理解都较复杂的机制。甚至曾有提议从PostgreSQL中移除规则,但未获得广泛支持。在大多数情况下,使用触发器比规则更方便且更安全。
规划
SQL是一种声明式语言:查询定义了需要获取哪些数据,但并未说明如何获取。
任何查询都可以通过多种方式执行。对于解析树中表示的每种操作,都可能存在多种实现方式:例如,可以从表中读取全部数据(然后丢弃不需要的部分),也可以使用索引查找匹配的行。行集始终成对连接,这导致了大量不同的执行顺序。此外,还存在不同的连接算法:例如,可以遍历一个行集的每一行,并在第二个行集中查找匹配项,也可以预先对两个行集排序,然后合并它们。某些算法在某些场景下表现更好,而另一些则在其他场景下更优。
非最优计划与最优计划之间的执行时间差异可能达到多个数量级,因此规划器15(负责优化解析后的查询)是系统中最复杂的组件之一。
计划树。 查询执行计划也以树的形式表示,但其节点包含的是对数据的实际物理操作。
出于研究目的,可通过设置参数debug_print_plan在服务器日志中获取完整的计划树。在实际应用中,命令EXPLAIN16会输出计划的文本表示。
图中突出显示了计划树的主要节点。这些节点正是EXPLAIN命令输出中所展示的内容。
计划中的Seq Scan节点对应表扫描,而Nested Loop节点对应连接操作。(参见374)(参见440)
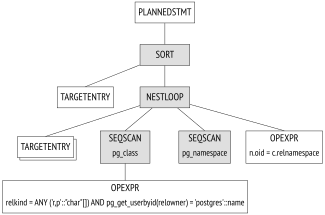
目前请注意以下两点:
查询树中仅保留了三张表中的两张:规划器识别出其中一张表对结果无用,因此可从计划树中移除;
每个计划节点都包含预计生成行数(rows)和成本(cost)的信息。
计划遍历。 PostgreSQL 使用 基于成本的优化器17。优化器会考虑所有可能的执行计划,并评估执行这些计划所需资源的预期数量(如 I/O 操作和 CPU 周期)。优化器评估结果以数值形式表示,称为 计划成本。在所有检查过的计划中,选择成本最低的计划。
问题在于,可能的计划数量随连接表的数量呈指数级增长,即使对于相对简单的查询,逐一遍历所有选项也是不现实的。为了缩小搜索空间,传统上采用动态规划算法结合某些启发式方法。这使得在合理时间内找到数学上精确解的查询表数量得以增加。
优化问题的精确解并不能保证所找到的计划 实际上 是最优的,因为规划器使用的是简化的数学模型,且可能基于不完全准确的输入信息进行决策。
遗憾的是,即使动态规划算法在连接数量超过十时也耗时过长且内存消耗过大。为了进一步限制搜索范围,规划器可能会根据查询的语法结构固定某些连接的顺序18。
考虑一个在 FROM 子句中通过逗号列出表而未显式使用 JOIN 的查询:
对于此类查询,规划器将考虑所有可能的两两连接组合。该查询对应如下(示意性展示)的解析树片段:
下图展示了此类查询计划所需内存随表数量变化的关系(数据通过 EXPLAIN 命令并使用 MEMORY 参数获得):(v. 17)
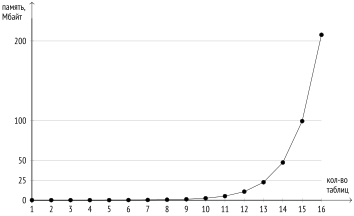
计划时间也大致随着每增加一张表而翻倍。
在另一个例子中,连接结构由 JOIN 子句定义:
解析树反映了这种结构:
通常,规划器会将连接树扁平化,将其转换为与第一个示例相同的形式。该算法递归遍历树,将 joinexpr 节点替换为下层元素的扁平列表19。
但扁平化仅在扁平列表中的元素数量不超过 join_collapse_limit 时才执行。在本例中,有五个元素,因此当参数值小于 5 时,joinexpr 节点不会被扁平化。(默认值:8)
对规划器而言,这意味着:
表
B必须与表C连接(或反之,C与B连接——对连接对的顺序没有限制);表
A、D、E以及B与C的连接结果可以以任意顺序连接。
当参数 join_collapse_limit = 1 时,任何显式 JOIN 连接的顺序都将被保留。
此外,FULL OUTER JOIN 的操作数 永远 不会被扁平化,无论 join_collapse_limit 参数取何值。
参数 from_collapse_limit 以相同方式限制子查询的扁平化。尽管子查询在外观上不像 JOIN,但在解析树层面,这种类比是显而易见的。(默认值:8)
以下是一个查询示例:
相应的连接树如图所示。唯一的区别是,joinexpr 节点被替换为 fromexpr 节点(因此该参数名称并非完全直观)。
因此,扁平化处理后,树中同一层级的元素数量通常受 join_collapse_limit 和 from_collapse_limit 值的限制。
下图展示了仅包含 JOIN 连接的查询所需的内存。图中可见,随着表数量增加,资源消耗呈指数级“阶梯式”增长,但总体仍保持线性增长趋势。初始阶梯由前八个(join_collapse_limit)元素构成,后续阶梯在此基础上增加七个元素,依此类推。这种方法使得即使在包含大量 JOIN 的查询中,也能在合理时间内完成计划。
为便于对比,图中虚线表示仅包含逗号连接的查询的先前图表。
然而,仍存在大量使用逗号连接的查询问题。启用参数 geqo 后,当元素数量达到 geqo_threshold 值时,规划器将切换到使用 遗传算法 20。遗传算法比动态规划算法快得多(即使考虑了 join_collapse_limit 和 from_collapse_limit 的限制),但不能保证找到最优计划。遗传算法有多个可调参数21,但此处不作讨论。(默认值:on)(默认值:12)
下图展示了启用 geqo 参数后,包含逗号连接的查询所需的内存。可见,当表数量达到十二(geqo_threshold)时,资源需求急剧下降,之后呈线性缓慢增长。
为作对比,虚线表示 JOIN 连接查询的图表。
不完全的树扁平化或切换到遗传算法会导致所考虑的计划选项被任意缩减,从而可能遗漏最优计划,并导致计划结果不稳定。在这种情况下,查询作者可能需要手动将查询分解为可独立优化的部分:
公共表表达式(CTE)可以独立于主查询进行优化;
MATERIALIZED子句可确保这种行为22。(v. 12)除 SQL 以外任何语言编写的函数体内的查询,会独立于主查询进行优化(在某些情况下,SQL 函数体可被内联到查询中 23)。
将参数 join_collapse_limit 和 from_collapse_limit 设置为 1 可保留由查询语法结构定义的连接顺序(这可能过于僵化)。
最佳计划选择。 对于客户端而言,计划的最优性取决于预期如何使用结果。如果需要完整结果集(例如用于生成报表),则计划应优化获取所有结果行。但若需尽快获取前几行(例如用于屏幕显示),则可能需要完全不同的计划。
PostgreSQL 通过计算两个成本分量来解决此问题:
第一分量(启动成本,startup cost)表示启动节点执行所需的开销,第二分量(总成本,total cost)表示获取所有结果行的总开销。
有时会看到一种说法,认为启动成本就是获取第一行结果的成本,但这并不完全准确。
为决定优先选择哪些计划,规划器会检查是否使用了游标(SQL 命令 DECLARE 或 PL/pgSQL 中的 显式 游标声明)24。如果没有,则假定客户端将立即获取所有结果行,因此优化器会选择总成本最低的计划。
对于使用游标执行的查询,将选择一个优化获取部分行而非所有行的计划,该部分行的比例等于参数 cursor_tuple_fraction 的值。更准确地说25,将选择表达式值最小的计划(默认值:0.1)
计划评估的通用框架。 要获得计划的总体评估,必须评估其每个节点。节点的成本取决于节点类型(显然,从表中读取数据的成本与排序成本不同)以及该节点处理的数据量(通常数据量越小,成本越低)。节点类型是已知的,而预测数据量需要评估输入数据集的基数(节点输入的行数)和节点的选择性(输出行的比例)。为此,需要有数据的统计信息:表的大小、列中数据的分布。(参见 346)
因此,优化依赖于由自动分析过程收集和更新的正确统计信息。
如果计划中每个节点的基数都正确评估,那么成本通常也能合理反映实际开销。优化器的主要错误通常源于基数和选择性的错误评估。这可能由于统计信息不正确或过时、无法使用统计信息,或(程度较小)由于优化器基础模型的不完善所致。
基数评估。 基数评估是一个递归过程。为了评估计划节点的基数,需要:
评估每个子节点的基数,并获得输入到该节点的行数;
评估该节点的选择性,即输入行中将保留在输出中的比例。
将两者相乘即可得到该节点的基数。
选择性以 0 到 1 之间的数值表示。接近 0 的选择性通常称为 高,接近 1 的称为 低。这可能看起来不合逻辑,但这里的“选择性”指的是 选择能力:选择少量行的条件具有高选择性(选择能力),而保留几乎全部行的条件则具有低选择性。
首先计算叶节点的基数,这些节点包含数据访问方法。这需要使用统计信息,特别是表的总体大小。
施加在表上的条件的选择性取决于这些条件的类型。在最简单的情况下,可以将选择性视为某个常量,尽管优化器会尽量利用所有可用信息来细化评估。只需能够评估简单条件的选择性,而通过逻辑运算组合的条件的选择性则根据公式 26 计算:
不幸的是,这些公式假设谓词 x 和 y 是独立的。在谓词相关的情况下,这种评估将不准确。(参见 365)
为了评估连接的基数,需计算笛卡尔积的基数(等于两个数据集基数的乘积),并评估连接条件的选择性,这同样取决于条件的类型。
类似地评估其他节点(如排序或聚合)的基数。
需要注意的是,计划底层节点中基数计算的错误会向上传播,最终导致评估错误并选择次优计划。这一不良效应因优化器仅掌握表的统计信息,而缺乏连接结果的统计信息而加剧。
成本评估。 成本评估过程也是递归的。为了计算计划子树的成本,需要计算子节点的成本,将它们相加,并加上该节点自身的成本。
节点的运行成本基于执行该节点操作的数学模型计算。评估的输入是已计算出的基数。分别评估初始成本和总成本。
某些操作无需任何准备即可立即开始执行;这类节点的初始成本为零。其他操作则需要执行预处理步骤。例如,排序节点通常必须从子节点获取所有数据后才能开始工作。这类节点的初始成本不为零——即使上层节点(或客户端)只需要结果集中的一个行,也必须支付这一成本。
成本仅反映优化器的估算,如果优化器出错,可能与实际执行时间无相关性。它仅用于使优化器能够在相同查询、相同条件下比较不同计划。在其他情况下,通过成本比较查询(尤其是不同查询)是错误且无意义的。例如,成本可能因错误的统计信息而被低估;在更新统计信息后,成本可能上升,但变得更为合理,而计划实际上可能得到改善。
执行
在查询优化过程中构建的计划将被传递至执行阶段 27。在服务进程的内存中创建一个门户 28——一个存储正在执行查询状态的对象。状态以树形结构表示,与计划树结构一致。实际上,树中的节点作为流水线工作,相互请求和传递行。
执行从根节点开始。根节点(示例中为排序操作 sort)向子节点请求数据。获取所有行后,节点执行排序,并将数据传递给上层节点(即客户端)。
某些节点(如图中的 nestloop)将来自不同源的数据进行连接。此类节点向两个子节点请求数据。获取两条满足连接条件的行后,节点立即向上层(而非排序节点)传递结果行(与排序节点不同,排序节点必须先获取所有行)。该节点的执行在此暂停,直到上层节点请求下一行。因此,如果只需要部分结果(例如由于 LIMIT 限制),操作将不会完全执行。
树中的两个叶节点 seqscan 代表对表的访问。当上层节点请求数据时,叶节点从相应表中读取下一行并返回。
因此,某些节点不存储行,而是立即向上传递并立即遗忘,但某些节点需要先保存——物化——所有行。其中一个节点是通用表表达式 CTE Scan 的扫描。物化可由开发人员显式指定(使用 MATERIALIZED),也可由优化器决定(为避免多次计算同一表表达式)。(v. 12)
需要物化的数据量事先未知。为希望行数较少,最初为存储分配服务进程内存中大小为 work_mem 的内存片段。只要内存足够,数据就保存在其中29。(默认值:4MB)
如果内存溢出,则所有数据将被写入磁盘上的临时文件,并在需要时从该文件读取。
相同的物化机制也用于递归查询(用于工作表和中间表)、窗口函数(用于当前框架)、表函数(用于累积结果)、触发器(用于外部表和过渡关系)等。该机制同样应用于优化器可能插入计划中以物化计算行的 Materialize 节点。
排序采用类似但更复杂的机制。(参见 489)
因此,一个计划中可能包含多个需要数据存储的节点,因此查询可能分配多个大小为 work_mem 的内存片段。查询可用的总内存无任何限制,而临时文件的最大大小可通过参数 temp_file_limit 设置。(默认值:-1)
16.3. 扩展查询协议
在使用简单查询协议时,即使命令重复执行,也必须经过上述所有阶段:
解析;
转换;
规划;
执行。
但重新解析同一个查询毫无意义。解析仅常量不同的查询也无意义——解析树的结构不会改变。
简单执行方式的另一个不便之处在于,客户端会立即收到全部结果,无论结果包含多少行。
原则上,这两个限制都可以通过 SQL 命令克服:第一个通过使用 PREPARE 准备查询并用 EXECUTE 执行,第二个通过使用 DECLARE 创建游标并用 FETCH 提取行。但这样客户端必须负责命名创建的对象,而服务器则需额外解析额外命令的开销。
因此,扩展的客户端-服务器协议允许在协议命令级别详细控制操作执行的各个阶段。
预备
在准备阶段,查询以常规方式解析和转换,但解析树被保存在服务进程的内存中。
PostgreSQL 中没有全局查询缓存。这种设计的缺点是显而易见的——每个服务进程都必须独立解析所有查询,即使其他进程已经解析过相同的查询。但也有优点。共享内存中的缓存很容易因需要锁而成为瓶颈。一个客户端执行大量小而不同的查询(例如仅常量不同)会显著增加此类缓存的负载,从而影响整个实例的性能。在 PostgreSQL 中,查询解析是本地执行的,因此不会影响其他进程。(参见 305)
准备查询时,可以对其进行参数化。利用 psql 支持扩展协议的功能:(v. 18)
可以通过视图 pg_prepared_statements 查看命名的准备语句:
无法通过这种方式查看匿名准备语句(例如 PL/pgSQL 为每个表达式创建的语句)。当然,会话只能访问自己的语句;无法查看其他会话的内存。
参数绑定
在执行准备好的查询之前,需绑定实际的参数值:
准备语句参数相比将字面量连接到查询字符串的优势在于,从根本上不可能注入 SQL 代码,因为任何参数值都无法更改已构建的解析树。若要在不使用准备语句的情况下达到同等安全级别,必须仔细转义从不可靠源获取的每个值。
规划和执行
在执行准备语句时,会根据实际参数值进行规划,随后将计划传递给执行阶段。
考虑参数值非常重要,因为不同值的最优计划可能并不相同。例如,查找非常昂贵的预订时会使用索引,因为规划器假设符合条件的行并不多:
然而,下一个条件适用于所有预订,因此索引毫无用处,必须扫描整个表:
在某些情况下,规划器不仅会记住解析树,还会记住查询计划,以避免重复规划。这种不考虑参数值而构建的计划称为 通用计划(与考虑实际值的 专用计划 相对)30。
显然,可以无损效率地切换到通用计划的典型情况是无参数查询。
带参数的准备语句前五次执行始终会根据实际值进行优化;此时会计算专用计划的平均成本。从第六次开始,如果通用计划的平均成本优于专用计划(考虑到专用计划每次都需要重新构建 31),规划器将记住通用计划,并后续继续使用它,不再重复优化。
准备语句 plane 已经执行过一次。现在我们从 psql 的元命令切换到普通的 SQL 命令:这与直接使用协议命令并不完全相同,但最终效果一致。这样更容易观察到,在接下来的三次执行中仍然使用专用计划——请注意查询计划中参数的值:
在第五次执行后,规划器将切换到使用通用计划——它与专用计划一致,成本相同,但可以被缓存,从而无需再次消耗资源进行优化。命令 EXPLAIN 现在显示的不再是参数值,而是其编号:
不难设想一种情况:由于偶然因素,最初的几个专用计划成本高于通用计划,而后续的计划本应更高效——但规划器将不再考虑这些情况。此外,规划器比较的是 成本估算,而非实际资源消耗,这也可能导致错误。
因此,当自动决策出现错误时,可以强制选择通用计划或专用计划,通过设置相应参数值 plan_cache_mode 来实现:(v. 12)(默认值:auto)
视图 pg_prepared_statements 也显示了计划选择的统计信息:(v. 14)
获取结果
扩展查询协议允许客户端逐行或分批获取结果(每次若干行)。使用 SQL 游标可达到几乎相同的效果(除了服务器端多出额外开销,且规划器优化的是获取前 cursor_tuple_fraction 行,而非整个结果集):
如果查询返回大量行且客户端需要全部数据,则每次获取的数据量对传输速度影响极大。数据量越大,与服务器通信的开销就越低。但随着数据量增加,开销降低的边际效应逐渐减弱:单行与十行之间的差异可能非常显著,而一百行与一千行之间的差异则几乎可以忽略。
backend/tcop/postgres.c, 函数 exec_simple_query. ↩︎
postgrespro.ru/docs/postgresql/18/parser-stage; backend/parser/README. ↩︎
backend/optimizer/plan/initsplan.c, 函数 deconstruct_jointree. ↩︎
postgrespro.ru/docs/postgresql/18/geqo; backend/optimizer/geqo/geqo_main.c. ↩︎
postgrespro.ru/docs/postgresql/18/runtime-config-query#RUNTIME-CONFIG-QUERY-GEQO. ↩︎
backend/optimizer/plan/planner.c, 函数 standard_planner. ↩︎
backend/optimizer/util/pathnode.c, 函数 compare_fractional_path_costs. ↩︎
backend/optimizer/path/clausesel.c, 函数 clauselist_selectivity_ext 和 clauselist_selectivity_or. ↩︎
postgrespro.ru/docs/postgresql/18/executor; backend/executor/README. ↩︎
backend/utils/cache/plancache.c, 函数 choose_custom_plan. ↩︎
backend/utils/cache/plancache.c, 函数 cached_plan_cost. ↩︎
17 统计信息
17.1. 基础统计信息
关系级别的基本统计信息存储在系统目录的 pg_class 表中。其中包括: 1
关系中的行数(
reltuples);关系的大小,以页面为单位(
relpages);在可见性映射中标记的页面数量(
relallvisible)。(参见 32)
以下是 flights 表的这些值示例:
reltuples 的值在查询未对表中的行施加任何条件时用作基数估计。
统计信息在分析过程中收集,无论是手动还是自动2。然而,由于基本统计信息的重要性,某些操作(如 VACUUM FULL 和 CLUSTER3、CREATE INDEX 和 REINDEX 4)也会计算基本统计信息,并在清理过程中更新5。(参见 137)
分析时随机选择 300 × default_statistics_target 行。由于构建给定精度统计信息所需的样本量对所分析数据量的依赖性较弱,因此不考虑表的大小6。(默认值:100)
这些行从相同数量(300 × default_statistics_target)的随机页面中选取7。当然,对于小表,读取的页面数量和用于分析的行数可能更少。
由于在足够大的表中,统计信息并非基于所有行收集,因此估计值可能与实际情况略有偏差。这是正常的:如果数据持续变化,统计信息不可能始终精确。通常,只要估计值落在正确数量级内,就足以选择合适的执行计划。
创建一个禁用自动清理的 flights 表副本,以便控制分析的执行时间:
对于新表,尚未有任何统计信息:
reltuples 的值为 −1 可用于区分从未收集过统计信息的表与确实没有行的空表。(v. 14)
但表在创建后很可能立即会插入一些行。因此,在缺乏信息的情况下,规划器认为该表占用 10 个页面:
行数的计算基于单行的大小;它在查询计划中显示为 width。通常使用分析时计算的平均值进行估计,但在此情况下,由于缺乏统计信息,行大小是根据各列数据类型的近似值计算的8。
现在将 flights 表中的数据复制过来并执行分析:
当前统计信息与实际行数一致(表的大小使得统计信息基于完整数据收集):
relallvisible 的值用于估计仅索引扫描的成本。它在清理过程中更新:(参见 422)
现在将行数翻倍,但不重新收集统计信息,并检查查询计划中的基数估计:
尽管 pg_class 中的信息已过时,但估计值仍然准确:
这是因为规划器通过根据实际数据文件大小与 relpages 值的偏差来缩放 reltuples 的值,从而提高估计精度9。由于文件大小相比 relpages 增加了一倍,因此行数根据数据密度未发生变化的假设进行了调整:
当然,这种调整并非总是有效(例如,如果删除部分行,估计值不会改变),但在某些情况下,它能帮助在大规模数据变更后“撑到”下一次分析执行。
17.2. 空值
尽管理论家们批评不确定值10,但在关系型数据库中,它们仍扮演着重要角色,作为表示值不存在或未知的便捷方式。
但不确定值具有特殊意义,需要特别对待。除了理论上的不一致外,还存在大量实际困难,必须加以考虑。普通的布尔逻辑变为三值逻辑,而 NOT IN 子句的行为变得出人意料。不确定值是否应被视为小于或大于普通值尚不明确(因此引入了 NULLS FIRST 和 NULLS LAST 用于排序)。不确定值是否应计入聚合函数也并不明显。由于严格来说,不确定值根本不是值,因此规划器需要额外信息才能正确处理它们。
除了关系级别的基本统计信息外,分析还会为关系中的每个列收集统计信息。这些信息存储在系统目录表 pg_statistic 中11,但使用视图 pg_stats 更为方便,它以更易读的格式展示信息。
不确定值的比例正是列级别的统计信息;分析时计算的值显示在 null_frac 属性中。
例如,要查找尚未起飞的航班,可以利用其起飞时间未定义这一事实:
估计值计算方式为:总行数乘以 NULL 的比例:
精确值:
17.3. 非重复值
pg_stats 视图中的 n_distinct 字段显示列中唯一值的数量。
如果 n_distinct 的值为负数,则其绝对值表示唯一值的比例而非数量。例如,−1 表示列中所有值都是唯一的,而 −3 表示每个值平均出现在三行中。当分析计算出的唯一值数量超过总行数的 10% 时,分析器会使用比例12。
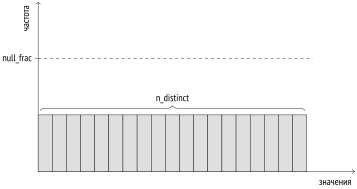
当分析计算出的唯一值数量超过总行数的 10% 时,使用比例;在这种情况下,比例很可能在数据进一步变化时仍保持稳定12。
唯一值数量用于所有假设数据均匀分布的情况。例如,在评估条件「列 = 表达式」的基数时,如果表达式值在规划阶段未知,则认为表达式可能以相等概率取列中的任意可能值13:
此处计划节点 InitPlan 仅执行一次,其计算结果在主计划中复用。
如果由于采样范围有限导致唯一值数量计算错误,可以显式为列指定该值:
如果所有数据始终均匀分布,仅凭这些信息(加上最小值和最大值)就足够了。但在实践中更常见的非均匀分布情况下,这种估计将不准确:
17.4. 高频值
为提高非均匀分布情况下的估计精度,会收集最频繁出现的值(most common values, MCV)及其出现频率。pg_stats 视图在 most_common_vals 和 most_common_freqs 列中显示这两个数组。
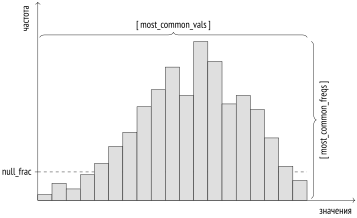
以下是关于不同飞机类型使用频率的统计示例:
对于条件「列 = 值」的选择性评估,只需在 most_common_vals 数组中查找该值,并从同索引的 most_common_freqs 数组元素中获取频率14:
显然,这种估计将非常接近真实值:
最频繁值列表也用于不等式条件的选择性评估。例如,对于条件「列 < 值」,需要在 most_common_vals 中找出所有小于目标值的值,并将对应的 most_common_freqs 中的频率相加15。
当不同值的数量不多时,最频繁值统计效果极佳。数组的最大大小由相同的参数 default_statistics_target 决定,该参数也限制了分析时随机行样本的大小。(默认值:100)
在某些情况下,增加默认参数值以扩展最频繁值列表并提高估计精度是有意义的。这可以在单个列级别进行:
这将增加样本量,但仅针对指定的表。
由于最频繁值数组中保存的是实际值,因此该数组可能占用相当大的空间。为避免过度增大 pg_statistic 并使规划器陷入无用工作,分析和统计信息中会排除大小超过 1 KB 的值。此外,这些大值很可能本身就是唯一的,因此无论如何也不会进入 most_common_vals。
17.5. 直方图
当不同值的数量太多,无法存储在数组中时,就会用到直方图。直方图由若干个“箱子”组成,这些值被放入箱子中。箱子的数量受同一个参数 default_statistics_target 限制。
箱子的宽度被设定为使每个箱子中包含的值数量大致相等(图中该属性对应于大阴影矩形的面积相等)。此时仅考虑未进入最频繁值列表的那些值。在这种构造下,任意一个箱子中值的总频率等于 。
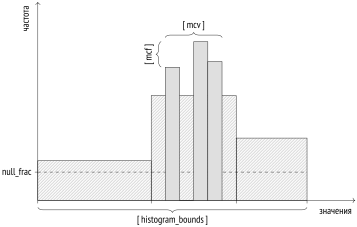
直方图存储在 pg_stats 视图的 histogram_bounds 字段中,作为界定箱子的值的数组:
直方图特别用于与最频繁值列表结合,评估「大于」或「小于」操作符的选择性16。考虑一个例子——分配给远排座位的登机牌数量:
座位号被特意选择为恰好位于直方图箱子的边界上。
此类条件的选择性估计值为 ,其中 N 是满足条件的箱子数量(即位于该值右侧的箱子)。需要注意的是,最频繁值不包含在直方图中。
一般来说,不确定值也不包含在直方图中,但在 seat_no 列中不可能存在此类值:
首先计算满足条件的最频繁值所占比例:
未被直方图包含的最频繁值的总比例为:
由于该区间恰好占据直方图中相同数量的箱子(从100个可能箱子中),我们得到如下估计:
一般情况下,当值不位于边界时,通过线性插值来考虑该值所在箱子的部分比例。
精确值为:
增加 default_statistics_target 参数可能改善估计,然而,正如示例所示,即使在列中存在大量唯一值的情况下,与最频繁值列表结合使用时,直方图通常仍能提供良好结果:
只有当提高估计精度能带来更优的执行计划时,这种提升才有意义。盲目增加该参数可能会减慢分析和规划器的执行速度,而不会带来任何改进。另一方面,降低该参数(甚至降至零)可能加快分析和规划,但也可能导致较差的执行计划。这种‘节省’通常并不合理。
17.6. 非标量数据类型的统计信息
对于非标量数据类型,可以收集不仅包括值本身分布,还包括这些值所包含元素分布的统计信息。这有助于更准确地规划涉及非第一范式列的查询。
- 数组
most_common_elems和most_common_elem_freqs显示了 最频繁元素 列表及其频率。
该统计信息用于评估数组 17 和 tsvector 数据类型 18 的选择性。
- 数组
elem_count_histogram显示了值中 唯一元素数量 的直方图。
该统计信息仅用于数组的选择性评估。
- 对于非空范围,会收集下界和上界分布的直方图(数组
range_bounds_histogram)(v. 17)以及长度分布的直方图(数组range_length_histogram)。空范围的比例(列range_empty_frac)也被单独记录。这些数据用于评估各种范围类型操作的选择性 19。相同类型的统计信息也用于多范围类型 20。(v. 14)
17.7. 平均列宽
pg_stats 视图的 avg_width 字段显示了列中值的平均大小。当然,对于 integer 或 char(3) 等类型,该指标始终相同,但对于长度可变的数据类型(如 text),该值可能在不同列之间差异显著:
该统计信息用于评估某些操作(如排序或哈希)所需的内存容量。
17.8. 相关性
pg_stats 视图的 correlation 字段显示了数据物理位置与比较操作逻辑顺序之间的相关性。如果值严格按升序存储,相关性接近于1;若按降序,则接近于-1。数据在磁盘上越混乱,该值越接近于0。(参见 546)
相关性用于评估索引扫描的成本。对于 coordinates 列,不收集此类统计信息,因为 point 数据类型未定义「大于」和「小于」操作符。(参见 415)
17.9. 表达式统计信息
通常,只有当比较操作中左侧或右侧为列本身而非表达式时,才能使用列的统计信息。例如,规划器不知道对列应用函数后统计信息如何变化,因此对于「函数调用 = 常量」条件,总是使用固定的0.5%估计值 21:
规划器甚至不了解标准函数的语义。虽然我们从一般常识知道,一月份执行的航班数量约为总数的 ,即比预测值高出一个数量级。
PostgreSQL 允许为规划器创建辅助函数22,以提示其在给定参数下某个函数的预期输出行数。因此,对于某些内建函数(如 generate_series),规划器了解一些信息。但并非所有函数都如此,也并非所有情况都适用。
为解决此问题,应基于表达式而非表列收集统计信息。这可以通过两种方式实现。
扩展表达式统计信息v. 14
第一种方法是使用 扩展统计信息 23 来收集表达式的统计信息。此类统计信息不会自动收集,必须手动通过 CREATE STATISTICS 命令创建数据库对象:
收集统计信息后,估计值得到修正:
为使收集的统计信息被使用,查询条件中的表达式必须与 CREATE STATISTICS 命令中写的一致。
可通过 ALTER STATISTICS 命令单独调整收集的扩展统计信息的大小,例如:(v. 13)
关于扩展统计信息的总体信息存储在系统目录表 pg_statistic_ext 中,而实际收集的统计信息则存储在单独的表 pg_statistic_ext_data 中。这种分离的目的是允许限制用户对敏感信息的访问。(v. 12)
用户可访问的表达式扩展统计信息可通过专用视图以更方便的形式查看:
表达式索引统计信息
第二种修正基数估计的方法是利用创建表达式索引时会为该索引单独收集统计信息(如同表一样)的特性。如果确实需要该索引,这种方法较为方便。(参见 401)
表达式索引的统计信息存储方式与表的统计信息相同。例如,可通过在 tablename 中指定索引名称,从 pg_stats 中获取唯一值的数量:
可通过 ALTER INDEX 命令修改索引的统计信息精度。为此,可能需要先确定对应表达式的列名称。例如:
17.10. 多元统计信息
PostgreSQL 支持收集 多变量统计信息,覆盖表中的多个列。为此,必须手动创建相应的扩展统计信息。
已实现三种类型的多变量统计信息。
列之间的函数依赖
如果一个列的值由另一个列的值(完全或部分)决定,且查询中同时包含这两个列的条件,则基数估计将被严重低估。
考虑一个包含两个条件的查询:
估计值被严重低估:
这是著名的 相关谓词问题。规划器假设谓词相互独立,并将整体选择性计算为各条件选择性的乘积(逻辑“与”连接)。这在所附计划中清晰可见:在 Bitmap Index Scan 节点中,基于 flight_no 列的条件得出的估计值,在 Bitmap Heap Scan 节点中经过 departure_airport 列的条件过滤后显著降低。(参见 336)
然而我们清楚,航班号唯一确定了出发和到达机场:实际上第二个条件是冗余的(当然前提是机场名称正确)。在此类情况下,功能依赖的扩展统计信息可改善估计。
创建两个列之间功能依赖的扩展统计信息:
在下一次分析表时,将收集所需的统计信息,评估将得到改进:
可以在系统目录中通过以下方式查看收集到的统计信息:
数字 2 和 5 是 pg_attribute 中表的列号。这些值表示函数依赖程度:从 0(无依赖)到 1(第一个列中的值完全决定第二个列中的值).
多元非重复值的数量
关于多个列中不同值组合数量的信息,有助于更准确地评估多列分组的基数。
例如,规划器将出发机场和到达机场的可能组合数量估算为机场数量的平方,但实际值要小得多,因为并非每对机场之间都有直达航班:
创建并收集不同值数量的扩展统计信息:
现在基数评估已得到修正:
收集到的统计信息可以在系统目录中查看:
多元 MCV 列表v. 12
当某一列的值分布不均匀时,仅知道函数依赖关系可能不够,因为评估结果在很大程度上取决于具体的值对。例如,规划器在估算从谢列梅捷沃机场出发的波音 737 航班数量时会出现错误:
在这种情况下,可以通过收集多值频繁值列表的统计信息来改进评估 24:
新的基数评估要精确得多:
为了获得该评估,规划器使用了系统目录中保存的频率信息:
与普通频繁值列表一样,多值列表中也保存 default_statistics_target 个值(如果在列级别设置了该参数,则使用最大值)。(默认值:100)
与表达式扩展统计信息类似,如需,也可以调整列表大小:(v. 13)
在所有示例中,我仅使用了两个列,但多值统计信息也可以针对更多列创建。
在同一个对象中,可以组合不同类型的统计信息,通过逗号分隔指定(如果不指定类型,则将为给定列同时收集所有可能的统计信息类型).
此外,与表达式统计信息一样,多值统计信息也可以使用任意表达式,而不仅限于列名。(v. 14)
backend/commands/analyze.c, 函数 do_analyze_rel. ↩︎
backend/commands/cluster.c, 函数 copy_table_data. ↩︎
backend/catalog/heap.c, 函数 index_update_stats. ↩︎
backend/access/heap/vacuumlazy.c, 函数 heap_vacuum_rel. ↩︎
backend/commands/analyze.c, 函数 std_typanalyze. ↩︎
backend/commands/analyze.c, 函数 acquire_sample_rows; backend/utils/misc/sampling.c. ↩︎
backend/access/table/tableam.c, 函数 table_block_relation_estimate_size. ↩︎
backend/access/table/tableam.c, 函数 table_block_relation_estimate_size. ↩︎
backend/commands/analyze.c, 函数 compute_distinct_stats. ↩︎ ↩︎
backend/utils/adt/selfuncs.c, 函数 var_eq_non_const. ↩︎
backend/utils/adt/selfuncs.c, 函数 var_eq_const. ↩︎
backend/utils/adt/selfuncs.c, 函数 scalarineqsel. ↩︎
backend/utils/adt/selfuncs.c, 函数 ineq_histogram_selectivity. ↩︎
postgrespro.ru/docs/postgresql/18/arrays; backend/utils/adt/array_typanalyze.c; backend/utils/adt/array_selfuncs.c. ↩︎
postgrespro.ru/docs/postgresql/18/datatype-textsearch; backend/tsearch/ts_typanalyze.c; backend/tsearch/ts_selfuncs.c. ↩︎
postgrespro.ru/docs/postgresql/18/rangetypes; backend/utils/adt/rangetypes_typanalyze.c; backend/utils/adt/rangetypes_selfuncs.c. ↩︎
backend/utils/adt/selfuncs.c, 函数 eqsel. ↩︎
postgrespro.ru/docs/postgresql/18/planner-stats#PLANNER-STATS-EXTENDED; backend/statistics/README. ↩︎
18 表访问方法
18.1. 可插拔存储引擎
PostgreSQL 中采用的磁盘数据组织方式并非唯一可能的方式,也并非适用于所有负载类型的最佳方式。遵循可扩展性理念,PostgreSQL 允许创建和连接不同的 表访问方法(数据存储引擎),尽管目前“开箱即用”仅提供一种:(v. 12)
创建表时可以指定引擎名称(CREATE TABLE ... USING);默认使用由参数 default_table_access_method 的值决定的引擎。之后可以通过(ALTER TABLE ... SET ACCESS METHOD)更改引擎,但代价是重写所有数据。(默认值:heap)(v. 15)
为了使内核能够以统一方式与不同引擎交互,表访问方法必须实现特定接口1。列 amhandler 中指定的函数返回一个接口结构2,其中包含内核所需的所有信息。
内核的大部分组件对任何表访问方法都是通用的:
事务管理器,包括对 ACID 和基于快照的隔离的支持;
缓冲管理器;
输入/输出子系统;
TOAST;
查询优化器和执行器;
索引支持。
并非所有这些组件都必须被引擎使用,但它们的可用性得以保留。
反过来,引擎定义了:
行版本格式和数据结构;
表扫描的实现及其成本估算;
插入、删除、更新和锁的实现;
行版本可见性规则;
清理和分析过程。
历史上,PostgreSQL 仅使用一种内置内核的数据存储系统,且没有明确的编程接口。由于这一历史原因,如今很难设计出一个既能充分考虑标准 heap 引擎的全部特性,又不阻碍其他方法发展的理想接口。
因此,我也并未试图严格区分内核与表访问方法。前几章中提到的许多内容,形式上并不属于内核功能,而是 heap 方法的特性。很可能该方法将永远作为 PostgreSQL 的通用标准引擎存在,而其他方法则占据特定领域,以更高效地应对特定类型的负载。
表访问方法机制的开发始于以下几种引擎:
Zheap 的目标是解决表膨胀问题5。为此,它实现了行版本的原地更新,并将构建快照所需的历史数据移至独立的 undo 存储中。该引擎在包含大量数据更新的负载下尤为有用。
该引擎的结构对 Oracle 用户来说可能较为熟悉,但存在一些差异(例如,索引方法接口不允许创建具有自身版本控制的索引)。(参见 394)
Zedstore 实现了列式存储 6,应能高效处理 OLAP 查询。
数据以行版本标识符的主 B-树组织,每个列存储在与主树关联的独立 B-树中(未来有望将多个列合并至同一棵树中,以实现混合存储)。
遗憾的是,这些引擎尚未达到工业可用状态;相关工作实际上已停止。目前,其他项目正在积极开发,例如:
OrioleDB 是一种针对现代硬件特性和云服务特点设计的引擎7。该访问方法将数据存储在以树结构组织的表中,并通过使用回滚日志消除表膨胀。
由于表访问方法接口尚未充分完善,安装 OrioleDB 需要对 PostgreSQL 内核进行特定修改。
Citus Columnar 实现了经典列式存储并支持压缩8。该访问方法专为分析型负载和数据仓库设计,不支持更新,并存在其他限制。
18.2. 顺序扫描
存储引擎负责表数据的物理组织,并提供访问方式——顺序扫描,即完全读取表主层的文件(或文件集合)。在每一页读取后,检查每一行版本的可见性;不满足查询条件的版本将被丢弃。(参见 97)
读取通过缓冲区缓存进行;为避免大表驱逐有用数据,顺序扫描使用小尺寸的缓冲环。其他同时扫描同一张表的进程可加入该环,从而节省磁盘读取操作。因此,一般情况下扫描可能并非从文件开头启动。(参见 198)
顺序扫描是读取整个表或其大部分内容的最高效方式。换句话说,顺序扫描在低选择性场景下表现良好。(当选择性较高,即仅需表中少量行时,使用索引更为合适。)(参见 394)
成本估算
在查询执行计划中,顺序扫描表现为 Seq Scan 节点:
行数估算属于基础统计信息的一部分:
优化器在成本估算中考虑两个因素:磁盘 I/O 和 CPU 资源9。
I/O 成本 计算为表中页数乘以单页读取成本,前提是页按顺序读取。当缓冲管理器向操作系统请求页时,物理上一次从磁盘读取的数据量大于单页,因此极大概率后续几页已进入操作系统缓存。因此,顺序读取单页的成本(对规划器而言由参数 seq_page_cost 定义)低于随机访问成本(由参数 random_page_cost 定义)。(默认值:1)(默认值:4)
默认值适用于 HDD;对于 SSD 存储,建议显著降低 random_page_cost(通常不调整 seq_page_cost,保持其为 1 作为基准值)。由于该比例依赖于硬件特性,这些参数通常在表空间级别设置(ALTER TABLESPACE ... SET)。
该公式清晰地揭示了因未及时清理导致表膨胀的后果:表主层占用空间越大,无论其中实际有效行版本数量多少,都需要扫描的页数就越多。(参见 170)
CPU 资源估算 考虑了处理每一行版本的成本(对规划器而言由参数 cpu_tuple_cost 定义):(默认值:0.01)
上述两项估算之和即为计划的总成本。初始成本为零,因为顺序扫描无需执行预处理操作。
若对扫描表施加了条件,这些条件将在查询计划的 Seq Scan 节点的 Filter 部分显示。行数估算将考虑这些条件的选择性,成本估算将包含其计算开销。(参见 346)
命令 EXPLAIN ANALYZE 将输出实际获取的行数以及被条件过滤掉的行数:
考虑一个稍复杂的带聚合的执行计划示例:
该计划包含两个节点:上层的 Aggregate 节点负责计算 count 函数,其数据来自下层的 Seq Scan 节点,后者执行表扫描。
Aggregate 节点的初始成本包括聚合本身:无法在未获取所有下层节点数据的情况下输出第一(也是唯一)行结果。该成本基于对每条输入行执行条件操作的成本 cpu_operator_cost 进行估算 10:(默认值:0.0025)
该估算成本将累加至 Seq Scan 节点的总成本中。
Aggregate 节点的总成本额外包含了处理一行结果的成本 cpu_tuple_cost:(默认值:0.01)
在此示例中,成本估算之间的依赖关系可以这样理解:
18.3. 并行计划
PostgreSQL 支持查询的并行执行 11。其核心思想是:执行查询的领导者进程通过 postmaster 启动多个工作进程,这些工作进程同时执行计划的并行部分。这些执行结果被传送到领导者进程,由其在 Gather 节点 12 汇总。在空闲接收数据的时间段内,领导者进程也可以执行计划的并行部分。
如需可选地禁用领导者进程执行计划的并行部分,可使用参数 parallel_leader_participation。 (默认值:on)
显然,进程启动和数据传输需要一定的资源,因此并非每个查询都适合并行执行。
此外,即使在并行执行中,也并非计划中的所有步骤都能同时进行。部分操作仍需由领导者进程单独、顺序地执行。
PostgreSQL 并未实现另一种理论上可能的并行化模式,即多个进程构成流水线来处理数据(粗略地说,计划中的各个节点由不同的进程执行)。PostgreSQL 开发者认为这种模式效率低下。
18.4. 并行顺序扫描
一个专为并行执行设计的节点示例是 Parallel Seq Scan —— “并行顺序扫描”。
名称听起来有些矛盾(到底是并行还是顺序?),但确实反映了操作的本质。从对表页面文件的访问角度来看,页面是按顺序读取的,顺序与普通顺序扫描相同。然而,读取由多个并行运行的进程完成。这些进程通过专门分配的共享内存区域进行同步,以避免重复读取同一页面。
关键点在于,操作系统看到的是多个进程执行随机读取,而非单一顺序读取。因此,通常能加速顺序读取的预读机制效果不佳。为此,每个进程被分配连续的多个页面进行读取13。(v. 14)
单独的并行扫描操作本身意义不大,因为除了常规的页面读取成本外,还增加了进程间数据传输的开销。但如果工作进程对读取的行执行某些处理(例如聚合),则查询的总执行时间可能显著减少。
成本估算
考虑一个对大表执行聚合的简单查询。执行计划将使用并行化:
Gather 节点以下的节点构成计划的并行部分。该部分在每个工作进程中执行(本例中计划了两个工作进程),也可能在领导者进程中执行(如果未通过参数 parallel_leader_participation 禁用)。Gather 节点及其上方的节点构成计划的顺序部分,仅在领导者进程中执行。
Parallel Seq Scan 节点表示以并行模式扫描表。rows 字段显示的是 一个 进程平均将输出的行数。总共需要三个进程协作(领导者和两个工作进程),但领导者进程不会完全被利用:其贡献随工作进程数量增加而减少14。本例中使用了 2.4 的系数。
Parallel Seq Scan 节点的成本估算方式几乎与顺序扫描相同。收益来自于每个进程处理的行数更少;而 I/O 成本仍被完全计入,因为无论如何都必须逐页读取整个表:
下一个节点是 Partial Aggregate —— 它对工作进程获取的数据执行聚合,即本例中统计行数。
聚合成本的估算方式已知,会累加到表扫描成本上:
下一个节点 Gather 在领导者进程中执行。该节点负责启动工作进程并接收它们的数据。
进程启动成本(与进程数量无关)由参数 parallel_setup_cost 定义,而每个数据元组在进程间传输的成本由 parallel_tuple_cost 定义。(默认值:1000)(默认值:0.1)
本例中,初始成本(进程启动)占主导,该值被加到 Partial Aggregate 节点的初始成本上。总成本考虑了两行数据的传输,该值与 Partial Aggregate 节点的总成本相加 15:
最后一个节点 Finalize Aggregate 对 Gather 节点从并行进程获取的局部聚合结果进行最终聚合。
最终聚合的初始成本考虑了三行的计算;该值与 Gather 节点的总成本相加(因为结果计算需要所有行)。总成本还增加了输出一行结果的成本。
成本估算之间的依赖关系取决于节点是否在向上传递结果前累积数据。聚合操作必须在收到所有输入行后才能返回结果。因此,聚合的 初始 成本基于其下层节点的 总 成本。而 Gather 节点在接收到数据后立即向上输出,因此其初始成本取决于下层节点的初始成本,而总成本则取决于下层节点的总成本。
可以这样示意性地理解:
18.5. 并行执行限制
后台工作进程数量
进程数量受三个参数限制,形成层级结构。同时执行的工作进程最大数量由参数 max_worker_processes 决定。(默认值:8)
但工作进程机制不仅用于查询的并行执行。例如,后台工作进程用于逻辑复制,扩展也可能使用它们。专门用于并行计划的工作进程数量由参数 max_parallel_workers 限制。(默认值:8)
其中,最多有 max_parallel_workers_per_gather 个进程可为一个领导者进程服务。(默认值:2)
选择这些参数值时需考虑:
硬件能力 —— 系统必须拥有未被其他任务占用的空闲核心;
数据库中存在大表;
负载情况 —— 必须执行可能从并行执行中获益的查询。
大多数情况下,这类条件更适合 OLAP 系统,而非 OLTP 系统。
如果规划器估算从表中读取的数据量未超过 min_parallel_table_scan_size 的值,将不会考虑并行扫描。(默认值:8MB)
如果未在表的存储参数 parallel_workers 中显式指定进程数量,则按以下公式计算:
这意味着表大小每增加三倍,就增加一个并行进程。例如,使用默认参数可得以下数值:
| 表,MB | 进程数 |
|---|---|
| 8 | 1 |
| 24 | 2 |
| 72 | 3 |
| 216 | 4 |
| 648 | 5 |
| 1944 | 6 |
无论如何,进程数量不能超过 max_parallel_workers_per_gather 的值。
如果查询 19MB 的小表,将计划并启动一个工作进程:
查询 105MB 的表时,由于 max_parallel_workers_per_gather 限制(默认值:2),仅计划两个进程:
解除限制后,可计算出三个进程:
如果在执行查询时可用的进程槽位少于计划数量,将仅启动可用数量的工作进程。
将并行进程总数限制为五个,并同时执行两个查询:
尽管每个查询计划了三个工作进程,但其中一个查询仅获得两个空闲槽位。
恢复参数的默认值:
无法并行化的查询
并非每个查询都可并行执行16。以下操作无法并行化:
- 修改或锁定数据的查询(
UPDATE、DELETE、SELECT FOR UPDATE等)。
这不适用于以下命令中使用的查询:
– CREATE TABLE AS、SELECT INTO、CREATE MATERIALIZED VIEW;
– REFRESH MATERIALIZED VIEW。(v. 14)
但在这两种情况下,行的插入仍按顺序执行。
可能被暂停执行的查询。这包括游标中的查询,包括 PL/pgSQL 中的
FOR循环中的查询。包含标记为
PARALLEL UNSAFE的 非安全 函数调用的查询。默认情况下,所有用户定义函数和一小部分标准函数均属于此类。可通过系统目录获取非安全函数列表:
- 在函数内部的查询,当这些函数从并行查询中被调用时(为防止工作进程数量递归式增长)。
这些限制中的部分将在后续 PostgreSQL 版本中被解除。例如,已实现可串行化隔离级别下查询的并行化。(v. 12)
查询可能因多种原因无法以并行模式执行:
该查询在任何情况下都无法并行化;
并行计划被配置参数值禁止(包括因表大小限制而禁止);
并行计划的成本高于顺序计划。
要检查查询在原则上是否可并行化,可临时启用参数 debug_parallel_query。此时,规划器将在所有可能的情况下构建并行计划:(v. 16)(默认值:off)
现在我们理解了,规划器考虑了并行计划,但选择了在此情况下更高效的顺序扫描。
并行限制的查询
计划中越大的部分能以并行方式执行,所能获得的性能提升就越大。然而,存在一些操作,虽然总体上不阻碍并行化,但本身只能在主进程的顺序部分执行17。换句话说,它们不能出现在 Gather 节点之下的计划树中。
通用表表达式。 通用表表达式的查询结果读取无法并行化18(计划节点 CTE Scan):
如果通用表表达式未物化,则计划中不包含 CTE Scan 节点,此限制不适用。(v. 12)
但通用表表达式本身完全可以在并行模式下计算,只要这样做有利可图:
相关子查询。 一次性计算且在计划中以 InitPlan 节点表示的非相关子查询,可以参与并行计划:(v. 17)
Parallel Append 节点在此实现 UNION ALL 的并行执行。工作进程各自分配一个子查询(如果工作进程数量多于子查询数量,多个进程可共同处理一个子查询)。当所有子查询的数据均已获取后,空闲的进程将接入下一个子查询,直到所有数据合并完成。
而相关子查询(计划节点 SubPlan)则不参与并行计划:
计划中出现了 Append 节点而非 Parallel Append,其中 UNION ALL 操作顺序执行,而并行部分现在仅覆盖第二个子查询,其中仍保留 InitPlan 节点。
临时表。 临时表无法并行扫描,因为它们仅对创建它们的进程可见。临时表的页面操作在本地缓冲区缓存中进行。若允许多个进程访问,需引入类似共享缓存的锁机制,但这会削弱其他优势。(参见 209)(参见 305)
有限并行化的函数。 标记为 PARALLEL RESTRICTED 的函数调用只能在顺序部分执行。
此类函数的列表可通过系统目录查询获得:
将自定义函数标记为 PARALLEL RESTRICTED(更不用说 PARALLEL SAFE)需格外谨慎,必须仔细研究现有限制19。
github.com/citusdata/citus/tree/main/src/backend/columnar. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_seqscan. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_agg. ↩︎
postgrespro.ru/docs/postgresql/18/parallel-query; backend/access/transam/README.parallel. ↩︎
backend/access/heap/heapam.c, 函数 table_block_parallelscan_startblock_init 和 table_block_parallelscan_nextpage. ↩︎
backend/optimizer/path/costsize.c, 函数 get_parallel_divisor. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_gather. ↩︎
postgrespro.ru/docs/postgresql/18/when-can-parallel-query-be-used. ↩︎
postgrespro.ru/docs/postgresql/18/parallel-safety#PARALLEL-LABELING. ↩︎
19 索引访问方法
19.1. 索引和可扩展性
索引是数据库对象,主要用于加速数据访问。它们是辅助结构:任何索引都可以删除并根据表中的信息重新创建。但除了加速之外,索引还用于支持某些完整性约束。
内核中内置了六种索引访问方法(索引类型):(psql: \dA)
遵循可扩展性理念,允许在不修改内核的情况下添加新的访问方法。一个这样的示例(方法 bloom)已包含在标准扩展集合中。
尽管各种索引类型存在诸多差异,但最终任何索引都会建立键(例如,被索引列的值)与包含该键的表行版本之间的对应关系。引用使用六字节的 行版本标识符(tuple id, tid)。已知键或其部分信息后,可以快速读取可能包含所需信息的行版本,而无需完全扫描整个表。(参见 428)
为了使新访问方法能够作为扩展添加,已预留通用的 索引机制。其主要任务是获取访问方法的行版本标识符并对其进行处理:
从相应的表行版本中读取数据;
检查行版本在数据快照中的可见性;(参见 97)
如果访问方法不保证条件成立,则重新验证条件。
索引机制参与执行优化阶段生成的执行计划。优化器在遍历和评估各种查询执行路径时,必须了解所有潜在适用的访问方法的特性:该方法是否能直接按所需顺序返回数据,还是需要额外排序?是否能返回前几个值,还是只能一次性返回全部结果?等等。
访问方法的信息不仅对优化器有用。创建索引时,必须决定:该方法是否支持复合索引?该索引能否保证唯一性?
索引机制允许与各种不同的访问方法协同工作;为此,访问方法必须实现特定接口,并声明其功能和特性。
访问方法的任务包括:
实现索引构建、行插入和删除的算法;
将索引数据组织到页面上(以便与缓冲区缓存管理器协作);(参见 183)
实现清理算法;(参见 125)
设置锁以确保正确并发执行;(参见 305)
生成预写日志;(参见 211)
根据键在索引中查找信息;
评估使用索引的成本。
可扩展性还体现在系统可以添加新的数据类型,而访问方法事先对此一无所知。因此,访问方法需定义自己的接口以连接任意数据类型。
为了使特定类型值能与特定访问方法一起使用,必须实现该接口,提供适用于索引的运算符,以及可能的一些辅助 支持 函数。此类运算符和函数的集合称为 运算符类。
此时,索引逻辑的一部分位于访问方法本身,另一部分则被移至运算符类。这种划分相当随意:对于 B-树,所有逻辑都“固化”在访问方法中,而某些方法可能仅提供基本框架,将所有关键细节交由特定运算符类处理。在许多情况下,同一数据类型存在多个行为不同的运算符类,用户可从中选择最合适的。
图中展示了整体结构的一个小片段:
19.2. 操作符类和操作符族
操作符类
访问方法接口 1 由 运算符类 2 实现——一组运算符和辅助函数,供访问方法用于处理特定数据类型。
运算符类存储在系统目录的 pg_opclass 表中。上图的完整数据可通过以下查询获得:(psql: \dAc)
大多数情况下,我们无需了解运算符类的细节。通常只需创建索引,系统会自动使用默认的运算符类。
例如,以下是 B-树和 text 类型的运算符类。其中至少有一个类被标记为默认使用:
常见的创建索引命令如下所示:
但这只是完整形式的简写:
如果需要其他类型的索引或非标准行为,必须显式指定所需的访问方法或运算符类。
为特定访问方法和特定数据类型创建的运算符类,必须包含一组接受该类型参数且语义符合该访问方法要求的运算符。
例如,btree 访问方法定义了五个必需的比较运算符。任何为此方法创建的运算符类都必须包含全部五个:(psql: \dAo)
访问方法所隐含的运算符语义反映在 amopstrategy 的策略编号 3 中。例如,对于 btree,策略 1 表示“小于”,2 表示“小于或等于”,依此类推。这些运算符本身可以具有任意名称。
在上述示例中,普通运算符与带波浪号的运算符的区别在于,后者不考虑 排序规则(collation) 4,而是逐字节比较字符串。尽管如此,两者都实现了相同的比较语义。
运算符类 text_pattern_ops 可以克服对 ~~ 运算符(对应 LIKE 语法)支持的限制。在非 C 排序规则的数据库中,该运算符无法使用普通文本列索引:
而使用 text_pattern_ops 运算符类的索引则不同:
请注意索引条件中表达式的改变:搜索仅使用模式前缀(直到 % 字符),多余匹配项在过滤条件中被排除。btree 访问方法的运算符类不包含模式比较运算符,因此唯一使用 B-树的方法是将条件重写为比较运算符。text_pattern_ops 类的运算符不考虑排序规则,从而允许将条件替换为等效形式5。
索引可用于加速满足以下条件的访问:
例如,以下查询可以使用索引:
请注意索引条件中参数的顺序发生了变化:执行阶段,索引列必须作为运算符的左操作数。若交换操作数,系统会替换为可交换运算符;在此例中,由于等号关系是可交换的,因此是同一个运算符。
而下一个查询根本无法使用普通索引,因为条件中不是列名,而是函数调用:
此时可使用 表达式索引 8,在创建时指定任意表达式而非列:
表达式只能依赖于表行中的字段值,不能依赖于数据库中的其他数据状态或配置(例如本地化设置)。换句话说,如果表达式包含函数调用,则这些函数必须具有并 遵守 IMMUTABLE 9 变异性类别。否则,使用索引访问执行的查询结果可能与全表扫描的结果不同。
除了运算符外,运算符类还可提供 支持函数 10,供访问方法使用。例如,btree 访问方法定义了五个支持函数11,其中仅第一个(用于比较两个值)是必需的,其余可省略:(psql: \dAp)
操作符族
操作符类始终属于某个 操作符族 12(系统目录表 pg_opfamily)。在同一个通用族中可以包含多个操作符类,只要它们对相似的数据类型以相同的方式工作。
例如,integer_ops 族包含多个用于不同大小但语义相同的数值类型的操作符类:(psql: \dAf)
而 datetime_ops 族则包含用于处理日期的操作符类:
每个操作符类仅针对某个单一数据类型工作。而族则包含可接受不同数据类型的操作符:
通过将操作符分组到族中,规划器可以使用索引处理涉及不同数据类型值的条件,而无需显式转换。
19.3. 索引引擎接口
与表访问方法类似,pg_am 表中的 amhandler 列包含实现接口的函数名称 13:
该函数用必要的值填充接口结构 14。所提供的信息部分包括执行索引扫描并返回行版本标识符等通用操作的函数,另一部分则是索引方法应知晓的属性。
所有属性分为三个级别 15:
访问方法属性;
具体索引属性;
索引中各个列的属性。
划分访问方法级别和索引级别是为了未来扩展:目前,基于同一访问方法创建的所有索引始终具有相同的这两个级别的属性。
访问方法属性
访问方法属性包括以下五项(以 B-树为例):
CAN ORDER 支持直接获取排序后的数据 16。目前仅 B-树支持此属性。
为了获得所需顺序的结果,始终可以扫描表并排序获取的数据:
但若存在支持此属性的索引,则可直接按所需顺序获取数据:
CAN UNIQUE 支持唯一性约束和主键约束 17。仅适用于 B-树。
声明唯一性或主键约束时,会自动创建支持该完整性约束的唯一索引。
另一方面,如果不显式声明完整性约束,但创建了唯一索引,其可见效果相同:该列将不允许存在重复值。两者有何区别?
完整性约束是必须满足的属性声明,而索引是实现该属性的机制。原则上,完整性约束也可通过其他手段保证。
例如,PostgreSQL 不允许在分区表上创建全局索引,但仍允许声明唯一键(如果该键包含分区键)。此时,全局唯一性由每个分区上的局部唯一索引以及两个分区中无法存在相同分区键值的事实共同保证。
CAN MULTI COL 支持基于多个列构建 复合索引 18。
复合索引可加速对表中多个列的不同条件的查询。例如,ticket_flights 表具有复合主键,因此也具有索引:
通过该索引执行按机票编号和航班标识符查询航班:
对于 B-树,搜索的可行性和效率取决于索引中列的顺序。对于其他类型的索引,情况可能并非如此。(参见 536)(参见 628)
CAN EXCLUDE 支持 EXCLUDE 排除约束 19。
排除约束确保由操作符定义的条件在表中任意两行之间均不成立。为验证该约束,会自动创建索引;访问方法的操作符类必须包含所选操作符。
通常使用「交集」操作符 &&。例如,可声明性地定义:同一时间不能重复预订同一房间,或地图上的建筑不能相互重叠。(参见 571)
使用「等于」操作符时,排除约束等价于唯一性约束:禁止表中存在具有相同键列值的两行。但这与唯一性约束并不相同:例如,排除约束的键不能作为外键引用,也不能在 ON CONFLICT 子句中使用。
CAN INCLUDE 支持将非索引键列添加到索引中,以创建覆盖索引。(参见 425)
例如,可以向唯一索引中添加额外列。此类索引将保证键列值的唯一性,同时允许在不访问表的情况下获取额外列的值:
实际上属性远不止这些,但许多属性在 SQL 层级不可见 20。以下是一些示例:
CAN PRED LOCKS 支持谓词锁。(参见 298)
spgist 和 brin 访问方法不支持此属性;在可串行化隔离级别下扫描此类索引时,谓词锁将作用于整个表,如同顺序扫描一样,从而降低性能。
CAN BUILD PARALLEL 支持通过多个进程并行构建索引。btree、brin(v. 17)和 gin(v. 18)访问方法支持此属性。
索引级属性
与索引相关的属性(以现有索引为例):
CLUSTERABLE 支持根据索引在索引扫描中返回的行版本标识符顺序,物理移动表中行版本。 (参见 361)
该属性决定了 CLUSTER 命令是否适用。
INDEX SCAN 支持 索引扫描。(参见 414)
该属性表示访问方法能够逐个返回行版本标识符。虽然看似奇怪,但并非所有索引都支持此属性。
BITMAP SCAN 支持 位图扫描。(参见 427)
该属性表示访问方法能够一次性构建并返回所有行版本标识符的位图。
BACKWARD SCAN 支持以与创建索引时指定顺序相反的顺序返回结果。
此属性仅在访问方法支持索引扫描时才相关。
列级属性
最后是列的属性:
ASC, DESC, NULLS FIRST, NULLS LAST 列值的排序方式。
这些属性定义了值的存储顺序(升序或降序)以及空值的位置(在普通值之前或之后)。该组中的所有属性仅适用于 B-树。(参见 350)
ORDERABLE 支持在 ORDER BY 子句中对列值进行排序。
此属性仅适用于 B-树。
DISTANCE ORDERABLE 支持 排序操作符21。(参见:410)
与返回布尔值的普通索引操作符不同,排序操作符返回一个实数——即一个参数到另一个参数的“距离”。索引支持在 ORDER BY 子句中使用此类操作符。
例如,使用排序操作符 <-> 可以查找距离指定点最近的机场:
RETURNABLE 无需访问表即可从索引中获取数据,即支持 仅索引扫描。(参见:422)
该属性定义索引结构是否能够恢复被索引的值。这并非总是可行;例如,某些索引可能存储的不是实际值,而是其哈希值。在这种情况下,CAN INCLUDE 属性也无法生效。
SEARCH ARRAY 支持对数组中多个值的搜索。
这种需求不仅出现在直接使用数组时。例如,查询规划器会将 IN (список) 结构转换为数组搜索:(另见:554;编辑器添加的链接)
如果索引方法不支持此类操作符,则执行计划时需要多次迭代来查找单个值(这可能影响效率)。
SEARCH NULLS 支持对 IS NULL 和 IS NOT NULL 条件的搜索。
是否应索引空值?这使得可以使用索引处理 IS [NOT] NULL 条件,也可作为无任何表条件时的覆盖索引(因为此时索引必须返回表中所有行的数据,包括空值)。但若不包含空值,索引可能更紧凑。 NULL
该决定由访问方法的开发者做出,但通常仍会索引空值。
如果索引中不需要空值,可以通过构建 部分索引 22 仅对感兴趣的表行进行索引。例如:
部分索引在大小上小于完整索引,且在不包含在索引中的行被修改时不会更新。在某些情况下,这可能带来显著性能提升。当然,WHERE 子句中的条件可以是任意满足 IMMUTABLE 变更性类别要求的表达式,而不仅限于空值检查。
部分索引的构建与访问方法无关,由索引机制本身提供支持。
显然,并非所有索引访问方法的功能都通过接口暴露,仅包括那些需要预先知晓以做出正确决策的功能。例如,没有属性反映是否支持非阻塞创建索引(CONCURRENTLY)。此类属性由实现接口的函数代码决定。
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-STRATEGIES. ↩︎
postgrespro.ru/docs/postgresql/18/collation; postgrespro.ru/docs/postgresql/18/indexes-collations. ↩︎
postgrespro.ru/docs/postgresql/18/xoper-optimization#id-1.8.3.18.6. ↩︎
backend/optimizer/path/indxpath.c, 函数 match_clause_to_indexcol. ↩︎
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-OPFAMILY. ↩︎
backend/utils/adt/amutils.c, 函数 indexam_property. ↩︎
postgrespro.ru/docs/postgresql/18/ddl-constraints#DDL-CONSTRAINTS-EXCLUSION. ↩︎
include/access/amapi.h, 结构 IndexAmRoutine. ↩︎
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-ORDERING-OPS. ↩︎
20 索引扫描
20.1. 常规索引扫描
存在两种使用索引提供的行版本标识符的基本方式。第一种是索引扫描。大多数索引方法(但并非全部)都具有 INDEX SCAN 属性,并支持这种方式。(参见 409)
索引扫描在查询计划中由 Index Scan 节点表示 1:
在索引扫描过程中,访问方法逐个返回行版本标识符2。索引机制获取下一个标识符,访问其所指向的表页,获取行版本,并在该版本满足可见性规则时返回所需字段集。此过程持续进行,直到访问方法不再有符合查询条件的标识符为止。
Index Cond 中仅列出可通过索引检查的条件。需要在表上重新验证的额外条件则单独显示在 Filter 行中。
因此,对索引和表的访问并未分为两个独立的计划节点,而是在同一个 Index Scan 节点中执行。尽管存在专门的 Tid Scan 节点3,它根据已知的标识符从表中读取行版本:
成本估算
索引扫描的评估由索引访问评估和表页读取评估组成。
显然,评估中的索引部分完全取决于具体的访问方法。对于 B-树,主要开销在于读取索引页和处理这些页中的行。具体读取多少页和行,可以通过已知的数据总量和条件的选择性来确定。索引页访问具有随机性(逻辑上相邻的页在物理上可能以不可预测的方式分布)。评估还包含从根节点下降到叶节点的 CPU 资源消耗以及计算所需表达式的开销 4。(参见 335)
表部分的评估考虑了访问页的成本和处理所有读取的行版本所需的 CPU 时间。重要的是,输入/输出评估不仅取决于索引访问的选择性,还取决于行版本在磁盘上的物理位置与访问方法输出其标识符的顺序之间的相关性。
良好场景:高相关性
如果磁盘上行版本的物理顺序与索引中标识符的逻辑顺序完全相关,那么在逐个读取行版本时,Index Scan 节点将顺序地从一页跳到另一页,并且每一页仅被访问一次。
相关性信息作为统计信息的一部分收集:(参见 361)
接近于 1 的值(如 book_ref 列)表示高度有序,而接近于 0 的值则表示分布混乱。
本例中 book_ref 列的高相关性显然源于数据按该列值升序加载到表中且未被修改。对这个列的索引执行 CLUSTER 命令也会产生类似效果。
但即使存在完全相关性,也不能保证任何查询都会按 book_ref 升序返回数据。首先,任何行的修改都会导致该行当前版本被移动到末尾
表中。其次,使用其他列的索引访问方法生成的计划将按不同顺序输出数据。甚至顺序扫描也可能不从表的开头开始。因此,如果需要特定顺序,必须在 ORDER BY 子句中明确指定。
以下是大量行的索引扫描示例:(参见 198)
根据规划器的评估,条件的选择性为:
这接近于基于一般推理得出的 估计值,已知 book_ref 的值范围为 000000 到 FFFFFF。(参见 357)
B-树的索引部分输入/输出评估考虑了读取所需页数的成本。B-树支持的任何条件对应的索引行都是有序的,并位于逻辑上相连的叶页中,因此读取的索引页数量评估为索引大小乘以选择性。但这些页在物理上并不有序,因此读取是随机的。
CPU 资源用于处理所有读取的索引行(每行处理成本评估为 cpu_index_tuple_cost 参数值)以及为每行计算条件(本例中条件包含一个操作符;其计算成本评估为 cpu_operator_cost 参数值)。(默认值:0.005)(默认值:0.0025)
表输入/输出被视为顺序读取所需页数。在理想相关性下,表行版本在物理上彼此相邻,因此页数评估为表大小乘以选择性。
输入/输出成本还包含处理所有读取的行版本的成本;每行版本的处理成本评估为 cpu_tuple_cost 参数值。(默认值:0.01)
该公式展示了成本计算的逻辑,结果与规划器的评估相符,但并非精确值。获得精确值需要考虑我们不深入讨论的细节。
不良场景:低相关性
当相关性较低时,表访问情况发生变化。创建一个与索引几乎无相关性的 book_date 列的索引,并查看选择大致相同比例行的查询。索引访问变得如此昂贵,以至于规划器仅在禁止所有其他替代方案时才会选择它:
原因在于,相关性越低,访问方法返回的下一个行版本标识符指向的页与当前页越可能不同。因此,Index Scan 节点不再顺序读取,而是“跳跃”式地从一页跳到另一页,而在最坏情况下,访问页数可能达到所选行版本数。
但简单地将上述公式中的 seq_page_cost 替换为 random_page_cost,并将 relpages 替换为 reltuples 是不正确的。我们从计划中看到的成本比这样估算出的成本低一个数量级:
原因在于模型额外考虑了缓存效应。频繁访问的页会保留在缓冲区缓存(以及操作系统缓存)中,因此缓存越大,找到所需页的可能性越高,从而避免磁盘操作。为规划目的,缓存大小由 effective_cache_size 参数值决定。该值越小,评估中需要读取的页数越高。(默认值:4GB)
图表显示了在选择性为 且每页容纳十行的情况下,读取页数的评估值随表大小变化的关系 5。
图表中的虚线表示访问次数等于页数的一半(理想相关性下的最佳理论情况)和行数的一半(零相关性且无缓存时的最坏情况)。
假设 effective_cache_size 参数值应对应于可用于缓存的总内存(包括 PostgreSQL 缓冲区缓存和操作系统缓存)。但由于该参数仅用于评估,不导致实际内存分配,因此可根据需要调整,无需考虑真实数值。
将参数设为最小值后,计划评估结果接近于未考虑缓存效应时计算出的最坏情况评估值:
表输入/输出成本针对上述两种情况——良好和糟糕——进行计算,然后根据实际相关性取中间值6。
因此,当需要读取表中部分行时,索引扫描是高效的。如果表中行版本的排列与访问方法输出标识符的顺序相关,则这部分开销可能非常显著。但如果相关性较弱,随着选择性降低,索引访问的吸引力会迅速下降。
20.2. 仅索引扫描
包含执行查询所需的所有表数据的索引称为该查询的覆盖索引(covering)。如果存在覆盖索引,可以避免对表的额外访问,直接从访问方法获取数据而非行版本标识符。这种索引扫描的变体称为仅索引扫描7。它可被支持 RETURNABLE 属性的方法使用。(参见 411)
该操作在查询计划中由 Index Only Scan 节点表示 8:
名称可能让人误以为 Index Only Scan 节点从不访问表,但事实并非如此。PostgreSQL 中的索引不包含判断行可见性的信息,因此访问方法会返回所有符合条件的版本数据,无论其对当前事务是否可见。可见性随后由索引机制检查。(参见 89)
但如果每次都要查看表来确定可见性,这种扫描方法与普通索引扫描并无区别。问题通过 PostgreSQL 支持的表可见性映射解决,其中清理过程标记那些仅包含对所有事务可见的行版本的页,无论其快照如何。如果索引方法返回的行版本标识符属于此类页,则无需检查其可见性。(参见 32)
仅索引扫描的评估受可见性映射中标记的表页比例影响。该信息包含在收集的统计信息中:
仅索引扫描的评估与普通索引扫描不同,其与表访问相关的输入/输出成本按未包含在可见性映射中的页的比例计算。(行版本处理的 CPU 成本保持不变。)
由于本例中所有页上的所有行版本对所有事务都可见,因此成本评估中实际上完全排除了表输入/输出成本:
存在尚未越过数据库视界且未被清理处理的更改,会增加计划成本(从而降低优化器对计划的偏好)。要了解实际的强制表访问次数,可以使用 EXPLAIN ANALYZE 命令。(参见 106)
在新创建的表中,重新检查所有行版本的可见性:
清理创建了可见性映射,因此无需再检查:
包含 INCLUDE 子句的索引
存在一种情况,即无法扩展索引以包含查询所需的所有列:
对于唯一索引,添加列不会保证原始列的唯一性;
新增列的数据类型可能不支持索引访问方法的运算符类。
在这种情况下,可以将列添加到索引中,但不将其作为索引键的一部分。当然,无法通过这些附加列进行搜索,但对于包含这些列的查询,索引仍可作为覆盖索引使用。
示例展示了如何将用于支持主键的自动创建索引替换为包含额外列的另一个索引:
人们常常将此类 INCLUDE 索引称为“覆盖索引”,这是错误的。索引是否为覆盖索引,取决于其列集是否覆盖了特定查询所需的所有列。无论这些列是作为键列还是通过 INCLUDE 子句添加的,都不影响判断。此外,同一个索引对一个查询可能是覆盖的,而对另一个查询则不是。
20.3. 位图扫描
在索引扫描中,相关性降低会增加对页面的访问次数,并将读取方式从顺序读取变为随机读取。这一限制可以通过在访问表之前获取所有行版本标识符并按页面号升序排列来克服9。这就是第二种基本标识符处理方式——“位图扫描”的工作原理。支持 BITMAP SCAN 特性的访问方法可以使用该方式。(参见 409)
与普通索引扫描不同,该操作在查询计划中表现为两个节点:
节点 Bitmap Index Scan 10 向访问方法请求所有行版本标识符的“位图”。 11
位图由若干片段组成,每个片段对应一个表页。所有片段大小相同,足以覆盖页中所有行版本,无论其数量多少。由于头部开销较大,页中最多容纳 256 个行版本,仅需 32 字节即可表示12。
节点 Bitmap Heap Scan 13 随后逐个片段扫描位图,读取对应片段的表页,并在该页上检查位图中标记的所有行版本。因此,页面按编号升序读取,且每页仅读取一次。
由于在构建位图阶段已知所需页面列表,扫描操作可利用异步 I/O。并非所有操作都是多块读取,因为所需页面并不总是一一相邻,但无论如何,异步预读显著提升了该访问方法的效率。(参见 183)
位图准确性
被行版本覆盖的页面越多,位图所占空间越大。位图在服务进程的本地内存中构建,受参数 work_mem 限制。若构建过程中内存使用达到上限,部分位图片段将被“粗化”,使得每个片段比特对应整页,且片段覆盖范围从单页扩展为一个区间14。这可减小位图大小,但牺牲了精度。(默认值:4MB)
命令 EXPLAIN ANALYZE 可显示所构建位图的精度。本例中内存足够构建精确(exact)位图:
若减小 work_mem 值,部分位图片段将存储为低精度(lossy):
当读取对应粗化片段的表页时,必须对页中每个行版本重新检查筛选条件。无论实际是否执行,计划中始终显示 Recheck Cond —— 重新检查条件。通过重新检查过滤掉的行版本数量单独显示(Rows Removed by Index Recheck)。
当选择集非常大时,即使位图完全由粗化片段组成,也可能无法放入 work_mem 所限内存中。此时不再受该限制约束,位图将占用所需全部空间。不会额外降低精度或将部分片段写入磁盘。
位图操作
若查询条件作用于表的多个字段,且为这些字段创建了不同索引,则位图扫描可同时使用多个索引15。为每个索引构建行版本位图,随后根据条件逻辑合并:若表达式由 AND 连接,则进行按位逻辑与;若由 OR 连接,则进行按位逻辑或。
例如:
此处节点 BitmapAnd 通过按位“与”操作合并两个位图。
在合并两个位图为一个时16,若新位图在内存中 work_mem 足够,则精确片段保持精确;但只要任一片段为粗化,则结果片段也将为低精度。
成本估算
以一个使用位图扫描的查询为例:
此处规划器估算的条件选择性约为
节点 Bitmap Index Scan 的总成本估算方式与普通索引访问相同,不考虑对表的访问:
节点 Bitmap Heap Scan 的 I/O 成本估算与理想相关性下的普通索引扫描不同。位图允许按页面号升序读取表页且无重复访问,但满足条件的行版本不再彼此相邻。因此,可能需要读取远多于严格顺序紧凑范围的页面。
读取页面数量估算公式为 17
单页读取成本介于 seq_page_cost 与 random_page_cost 之间,具体取决于读取页面数与表中总页面数的比例:
通常,I/O 成本估算会加上节点处理每个读取行版本的开销。在精确位图情况下,行数估算为表中总行数乘以条件选择性。但当部分位图片段为非精确时,必须检查对应页中所有行版本。因此估算中需考虑位图中非精确片段的预期比例(可通过已知选择集总行数和 work_mem 限制计算得出)18。
估算中还包含条件重新检查的完整成本(与位图精度无关)。
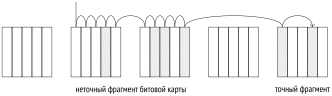
在本例中,位图完全精确,估算大致如下 19:
此处节点 Bitmap Heap Scan 的初始成本估算基于节点 Bitmap Index Scan 的总成本估算,并加上位图处理成本:
若查询计划合并多个位图,各索引访问成本之和将增加(少量)合并本身的成本20。
20.4. 并行索引扫描
所有索引扫描方式——普通扫描、仅索引扫描、位图扫描——均有并行计划版本。(参见 379)
并行执行成本估算方式与串行类似,但(如同并行顺序扫描)CPU 资源在所有并行进程间分配,从而降低总成本。I/O 成本不分配,因为页面读取在进程间同步且为顺序进行。
接下来我仅展示并行计划示例,不再分析成本估算。
并行索引扫描 Parallel Index Scan:
在 B-树的并行扫描中,服务器的共享内存中存储当前索引页号。由启动扫描的进程初始化该值:它从树根下降至叶页并记录该页。工作进程按需请求下一页,更新保存的页号。获取页后,进程处理其中所有匹配行,并从表中读取对应行版本。当读取完所有满足查询条件的值范围时,扫描结束。(参见 524)
并行仅索引扫描 Parallel Index Only Scan:
并行仅索引扫描仅在可见性映射允许时,不访问表页。
最后是并行位图扫描:
在位图扫描中,位图构建始终由一个主进程顺序完成,因此节点 Bitmap Index Scan 不添加 “Parallel” 一词。位图构建完成后,表扫描在节点 Parallel Bitmap Heap Scan 中并行执行。工作进程按需请求下一页并处理。
20.5. 各种访问方法的比较
下一页展示了不同访问方法成本随条件选择性变化的曲线图。该图具有定性特征;具体数值显然取决于表结构和服务器参数。
顺序扫描与选择性无关,当选择行比例达到一定阈值后,通常优于其他方法。
索引扫描成本高度依赖于行版本物理位置与索引访问方法输出标识符顺序之间的相关性。在理想相关性下,即使选择比例较高,索引扫描仍能高效运行。
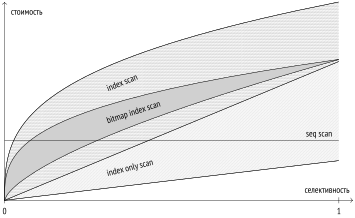
所选行数。但在弱相关性(这在现实中更常见)的情况下,成本很高,并且很快就会超过顺序扫描的成本。尽管如此,在索引(通常是唯一索引)用于检索单行的非常重要的情况下,索引扫描无疑是最佳选择。
如果适用,仅索引扫描可以带来极佳的效果,甚至在选择所有行时也能优于顺序扫描。然而,其性能高度依赖于可见性映射,在最坏情况下,仅索引扫描会退化为普通索引扫描。
位图扫描的成本取决于可用内存的大小,但其受相关性影响的程度远低于索引扫描。在弱相关性情况下,位图扫描具有显著优势。
每种访问方法在某些情况下可能优于其他方法,而在其他情况下则可能表现较差。查询规划器会针对每种具体情况,对所有方法的效率进行深入评估。当然,这些评估结果与实际情况的接近程度,强烈依赖于统计信息的时效性。
backend/access/index/indexam.c, 函数 index_getnext_tid. ↩︎
backend/utils/adt/selfuncs.c, 函数 btcostestimate; postgrespro.ru/docs/postgresql/18/index-cost-estimation. ↩︎
backend/optimizer/path/costsize.c, 函数 index_pages_fetched. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_index. ↩︎
postgrespro.ru/docs/postgresql/18/indexes-index-only-scans. ↩︎
backend/access/index/indexam.c, 函数 index_getbitmap. ↩︎
backend/access/index/indexam.c, 函数 index_getbitmap. ↩︎
backend/nodes/tidbitmap.c, 函数 tbm_lossify. ↩︎
backend/nodes/tidbitmap.c, 函数 tbm_union 和 tbm_intersect. ↩︎
backend/optimizer/path/costsize.c, 函数 compute_bitmap_pages. ↩︎
backend/optimizer/path/costsize.c, 函数 compute_bitmap_pages. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_bitmap_heap_scan. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_bitmap_and_node 和 cost_bitmap_or_node. ↩︎
21 嵌套循环
21.1. 连接类型和方式
连接 — SQL 语言的关键功能,是其灵活性和强大性的基础。来自表的行集(或作为其他操作结果获得的行集)始终成对连接。
存在多种 连接类型。
内连接。 内连接(INNER JOIN,或简写为 JOIN)包含两个行集中的行对,这些行对满足 连接条件。连接条件将一个行集的某些列与另一个行集的某些列关联起来;所有参与的列构成 连接键。
如果连接条件要求两个行集中对应列的值相等,则该连接称为 等值连接;这是最常见的场景。
笛卡尔积(CROSS JOIN)包含两个行集的所有可能行对——这是连接条件恒为真时的内连接特例。
外连接。 左外连接(LEFT OUTER JOIN,或简写为 LEFT JOIN)在内连接的基础上,添加了左行集中未在右行集中找到匹配项的行(右行集中缺失的列将获得空值)。
右外连接(RIGHT JOIN)的情况与此类似,仅行集顺序相反。
全外连接(FULL JOIN)结合了左外连接和右外连接,同时添加了左行集和右行集中未找到匹配项的行。
半连接与反连接。 半连接 类似于内连接,但仅包含在另一个行集中存在匹配项的行集中的行(即使存在多个匹配项,该行也仅在结果中出现一次)。
反连接 包含在另一个行集中未找到匹配项的行集中的行。
SQL 语言中没有显式的半连接和反连接操作,但诸如 EXISTS 和 NOT EXISTS 等结构可实现类似效果。
所有这些操作都是逻辑操作。例如,内连接常被描述为:在笛卡尔积中仅保留满足连接条件的行。但物理上,内连接通常可通过更高效的方式实现。
PostgreSQL 提供了多种 连接方式:
嵌套循环连接(nested loop);
哈希连接(hash join);
合并连接(merge join)。
连接方式是实现 SQL 逻辑连接操作的算法。这些基础算法常有针对特定连接类型的变体,尽管未必支持所有类型。例如,嵌套循环既可用于内连接(此时计划节点为 Nested Loop),也可用于左外连接(计划节点为 Nested Loop Left Join),但无法用于全外连接。
此外,同一算法的变体也可用于执行其他操作,例如聚合。
与访问方法类似,连接方式在不同场景下的表现各异;查询规划器会选择成本最低的方案。
21.2. 嵌套循环连接
嵌套循环连接的基本算法如下:在外层循环中遍历第一个行集(称为 外部行集)。对于每个外部行集中的行,在内层循环中遍历第二个行集(称为 内部行集),筛选出满足连接条件的行。每找到一对匹配行,立即作为结果的一部分返回1。
该算法访问内部行集的次数等于外部行集的行数。因此,嵌套循环连接的效率受以下因素影响:
外部行集的基数;
内部行集是否存在可高效获取所需行的访问方法;
对内部行集相同行的重复访问。
笛卡尔积
嵌套循环连接是执行笛卡尔积的最有效方式,无论行集大小如何:
Nested Loop 节点使用嵌套循环算法执行连接。它始终有两个子节点。计划输出中位于上方的节点表示外部行集;位于下方的节点表示内部行集。
在此例中,内部行集由 Materialize 节点表示2。该节点将下层节点返回的行进行物化,使得后续访问时无需重新扫描整个表,可直接读取已保存的、满足条件的行。(参见 338)
相同类型的计划也可能由普通等值连接查询产生:
此处规划器识别到两个值相等,将连接条件 tf.ticket_no = t.ticket_no 替换为 tf.ticket_no = 常量,实际上将等值连接简化为笛卡尔积3。
基数估算。 笛卡尔积的基数等于两个连接行集基数的乘积:3 = 1 × 3。
成本估算。 连接的初始成本等于两个子节点初始成本之和。
此例中,连接的总成本由以下部分构成:
获取所有外部行集行的成本;
获取所有内部行集行的单次成本(因外部行集基数估算为 1);
处理每行结果的成本。
成本估算的依赖关系如下:
× 1
此例中连接成本的计算方式如下:
现在回到包含 Materialize 节点的前一个示例:
一般情况下,连接的总成本由以下部分构成4:
获取所有外部行集行的成本;
初始获取所有内部行集行的单次成本(此过程执行物化);
(N−1)次重复获取内部行集行的成本(其中 N 为外部行集的行数);
处理每行结果的成本。
此处的依赖关系结构如下:
× 9
由于物化,重复获取数据的成本更低。计划中显示了首次访问 Materialize 节点的成本,但未显示重复访问的成本。我不会详细说明该估算的计算方式5,但在此例中其值为 0.0125。
因此,此例中连接的成本计算如下:
参数化连接
考虑另一个更典型的例子,该例子不能简化为简单的笛卡尔积:
此处嵌套循环节点遍历外部集合(机票)的行,并为每一行访问内部集合(航班)的行,将机票编号 t.ticket_no 作为参数传递给访问条件。当调用内部索引扫描节点时,它处理的是 ticket_no = 常量 条件。
基数估计。 根据规划器的估计,满足预订号条件的外部集合有两行(rows=2),且对于每一行,内部集合平均将找到三行(rows=3)。
连接的选择性是指两个集合的笛卡尔积中,在连接后保留的行所占的比例。显然,必须立即排除两个集合中在连接列上包含空值的行(因为对于这些行,相等条件必然不成立)。
基数估计为两个集合的笛卡尔积基数(即两个集合基数的乘积),再乘以选择性6。
在此情况下,已知第一个(外部)集合的基数估计为两行。第二个(内部)集合除了连接条件外没有其他条件。因此,第二个集合的基数被取为 ticket_flights 表的基数。
由于连接的表通过外键关联,选择性的估计基于每个子表行在父表中恰好有一对匹配行的假设。此时选择性取为外键所引用表大小的倒数7。
因此(考虑到 ticket_no 列没有空值),估计结果为
当然,即使没有外键也可以连接表。此时连接的选择性将基于具体连接条件的选择性估计8。
对于我们的等值连接情况,假设值均匀分布的“基础”选择性计算公式为 ,其中 nd1 是第一个行集合中连接键的唯一值数量,nd2 是第二个行集合中的唯一值数量9。(参见 351)
关于唯一值数量的统计显示,tickets 表中的机票编号是唯一的(这是自然的,因为 ticket_no 列是主键),而 ticket_flights 表中每张机票平均对应约三行:
最终,估计结果与基于外键的估计一致:
规划器会尽可能地细化基础估计。目前它不使用直方图,但若对两个表的连接键收集了最频繁值列表,则会考虑这些统计信息10。在这种情况下,可以相对准确地计算出落入列表部分的行的选择性,而其余部分则基于均匀分布进行估计。(参见 353)
然而,在一般情况下,没有外键时的连接选择性估计可能不如有外键时的估计准确。特别是对于复合连接键,低估的风险更大。
通过 EXPLAIN ANALYZE 命令,不仅可以查看实际行数,还可以查看对内部循环的访问次数:
估计得到验证:外部集合实际有两行(actual rows=2)。因此内部索引扫描节点执行了两次(loops=2),每次平均选择四行(actual rows=4)。由此得出总查找行数:actual rows=8。(参见 166)
我关闭了计划每一步执行时间的输出(timing off),以避免输出宽度因书页尺寸限制而过大;此外,在某些平台上,这种输出可能会显著减慢查询执行。但即使保留时间输出,显示的值也是平均值,与行数相同。要获得完整时间,需将平均值乘以迭代次数(loops)。
成本估计。 成本的计算方式与之前讨论的示例相同。在此情况下,对内部集合的重复扫描与首次扫描的成本无异。
最终结果如下:
缓存行 (Memoization)v. 14
如果对内部集合的重复扫描使用相同的参数值,并因此产生相同的结果,那么缓存内部集合的行可能更有利。
该功能由 Memoize 节点实现11。它类似于 Materialize 节点,但专为参数化连接设计,结构复杂得多:
Materialize 节点简单地物化其子节点的所有行,而 Memoize 节点则为每个参数值分别缓存行;
当 Materialize 节点的存储空间溢出时,它会将数据写入磁盘,而 Memoize 节点的存储空间不会(否则缓存将失去意义)。
以下是使用 Memoize 节点的查询计划示例:
用于缓存行的内存大小为 work_mem × hash_mem_multiplier。从第二个参数的名称可知,内部使用哈希表(开放定址法12)进行行查找。哈希键(Cache Key)是参数值(或多个参数值的组合)。在逻辑模式(Cache Mode: logical)下,键通过值比较(使用普通相等操作符),在二进制模式下则通过位比较。(默认值: 4MB) (默认值: 2.0) (参见: 520)
此外,所有哈希键都链接成一个列表,一端被视为“冷”(长时间未使用),另一端为“热”(最近使用)。
当访问 Memoize 节点时,若对应参数值的行已在缓存中,它们将直接返回给父节点(嵌套循环节点),而无需访问子节点。使用的哈希键将移动到列表的热端。
如果缓存中没有所需行,Memoize 节点将从子节点获取行,将其存入缓存,并返回给上层节点。新哈希键同样被设为热键。
在缓存填充新数据期间,可用内存可能耗尽。为释放内存,将从缓存中移除对应冷键的行。这种淘汰算法不同于缓冲区缓存所用的算法,但完成相同任务。(参见 196)
可能会出现某些参数值对应大量行,即使其他所有行已被淘汰,也无法完全放入缓存。此时这些参数将被跳过——因为只缓存部分行毫无意义,下一次仍需访问子节点获取完整结果。
基数与成本估计。 估计计算方式与前述内容无本质区别。但需注意,计划中显示的 Memoize 节点成本与实际情况无关:它只是子节点成本加上 cpu_tuple_cost 值13。(默认值:0.01)
但要使 Memoize 节点有意义,其成本应低于子节点成本,而非高于。我们之前在 Materialize 节点示例中也遇到过类似情况:‘真实’成本是针对 重复扫描 的计算结果14,在计划中不显示。
Memoize 节点的重复扫描成本考虑了可用于缓存的内存大小以及对缓存访问的预期模式。计算高度依赖于对内部行集合扫描时可能使用的不同参数值数量的估计准确性15。获得该估计后,可粗略判断命中缓存的概率和行被驱逐的概率。预期的缓存命中会降低成本估计,而潜在的驱逐则会提高成本估计。成本计算的细节在此不展开。
通常,要理解查询执行时的真实情况,EXPLAIN ANALYZE 命令最有帮助。
在我们的示例中,查询的是由单一机型服务的单一航线的航班;因此,所有对 Memoize 节点的访问都使用相同的哈希键。第一次访问需从表中读取所需行(Misses: 1),但所有后续访问均由缓存处理(Hits: 112)。总共仅需一 KB 内存。
另外两个输出值为零:缓存驱逐次数(Evictions)和因无法保存同一参数集的所有行而导致的内存溢出次数(Overflows)。较大的数值表明分配给缓存的内存不足,很可能是由于对不同参数值数量的估计不准确。在这种情况下,使用 Memoize 节点可能非常昂贵。极端情况下,可禁用缓存功能,通过关闭参数 enable_memoize 来阻止规划器使用缓存。(默认值:on)
外连接
嵌套循环连接可用于 左外连接(节点 Nested Loop Left Join)。在此示例中,规划器选择了非参数化连接:
左外连接的基数估计方式与内连接相同,但结果取估计值与外部行集合基数的较大值16。换句话说,左外连接永远不会减少行数(但可能增加)。
成本估计与内连接类似。
不支持 右连接17,因为嵌套循环算法中外部和内部行集合不等价。外部集合必须完全扫描,而内部集合在索引访问时仅读取满足连接条件的行。这可能导致部分行未被访问。
由于相同原因,也不支持 全连接。
反连接和半连接
反连接和半连接的相似之处在于:对于第一个(外部)集合的每一行,只需在第二个(内部)集合中找到 一行 匹配即可。
反连接返回第一个集合的行,前提是这些行在另一个集合中未找到匹配项。换句话说,如果在第二个集合中找到了一个匹配行,第一个集合的该行将不再进入结果,后续检查可停止。
反连接可用于计算 NOT EXISTS 谓词。例如,找出尚未配置客舱布局的飞机型号。嵌套循环反连接在计划中由节点 Nested Loop Anti Join 表示:
对于等价的无 NOT EXISTS 查询,也将生成相同的计划:
半连接返回第一个集合中至少有一个匹配项存在于第二个集合中的行(同样,后续匹配无需检查——结果已知)。
半连接可用于计算 EXISTS 谓词。现在找出客舱中已安装座椅的飞机型号:
嵌套循环半连接由节点 Nested Loop Semi Join 表示。在此计划(以及上述反连接计划)中,seats 表的行数估计为普通值(rows=149),尽管实际上只需获取一行。查询执行时,循环在第一行后即停止:
基数估算。 对于半连接,基数按常规方式计算,但内部行集的基数被视为 1。对于反连接,计算出的选择性从 1 中减去,如同否定操作18。
成本估算。 对于反连接和半连接,成本估算考虑了第二个行集并非完全读取,而是在找到与第一个行集的某一行匹配的配对后即停止19。
非等值连接
嵌套循环算法允许根据任意连接条件连接行集。
当然,如果内部行集是基础表,该表上已创建索引,且连接条件的操作符属于该索引的操作符类,则可以对内部行集进行高效访问。但始终存在行集的笛卡尔积结合条件过滤的选项——在这种情况下,条件可以是完全任意的。例如,以下查询选择距离较近的机场对:(参见 397)
并行模式
并行化仅在外部行集级别发生,该行集可由多个工作进程同时读取。每个进程获取外部行集的下一行后,再依次遍历与之匹配的内部行集的行——即顺序执行。
以下是包含多个连接的查询示例,用于查找购买了特定航班机票的乘客:
获取内部行集时使用并行计划。每个进程读取 ticket_flights 表的若干行,并与 tickets 表通过嵌套循环连接。(参见 380)
随后,每个进程将所得行集与通过唯一键获取并物化于 Materialize 节点的一行 flights 表数据连接——因此,即使内部行集较大,嵌套循环也是合理的。(v. 18)
backend/optimizer/path/costsize.c, 函数 initial_cost_nestloop 和 final_cost_nestloop. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_rescan. ↩︎
backend/optimizer/path/costsize.c, 函数 calc_joinrel_size_estimate. ↩︎
backend/optimizer/path/costsize.c, 函数 get_foreign_key_join_selectivity. ↩︎
backend/optimizer/path/clausesel.c, 函数 clauselist_selectivity. ↩︎
backend/utils/adt/selfuncs.c, 函数 eqjoinsel. ↩︎
backend/utils/adt/selfuncs.c, 函数 eqjoinsel. ↩︎
backend/optimizer/util/pathnode.c, 函数 create_memoize_path. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_memoize_rescan. ↩︎
backend/utils/adt/selfuncs.c, 函数 estimate_num_groups. ↩︎
backend/optimizer/path/costsize.c, 函数 calc_joinrel_size_estimate. ↩︎
backend/optimizer/path/joinpath.c, 函数 match_unsorted_outer. ↩︎
backend/optimizer/path/costsize.c, 函数 calc_joinrel_size_estimate. ↩︎
backend/optimizer/path/costsize.c, 函数 final_cost_nestloop. ↩︎
backend/optimizer/path/joinpath.c, 函数 consider_parallel_nestloop. ↩︎
22 哈希
22.1. 哈希连接
一阶段哈希连接
哈希连接的核心思想是使用预先准备好的哈希表来查找匹配的行。以下是一个使用这种连接方式的执行计划示例:
在第一阶段,哈希连接节点 1 会访问哈希节点 2。该节点从其子节点获取整个内部行集,并将其放入哈希表中。
哈希表能够存储由哈希键和值组成的键值对,随后可以以固定时间复杂度(与哈希表大小无关)根据键查找值。为此,哈希键被大致均匀地分布到有限数量的桶(bucket)中。哈希表桶的编号由哈希键的哈希函数值决定;由于桶的数量始终是2的幂,因此从计算出的值中取所需数量的二进制位。
该实现使用动态可扩展的哈希表,并采用链式冲突解决方式 3,与缓冲区缓存的实现类似。(参见 190)
因此,在第一阶段,会顺序读取内部行集的每一行,并为每行计算哈希函数。此时,哈希键是参与连接条件的字段(Hash Cond),而哈希表中保存的是内部行集中查询所需的所有字段。
哈希连接最高效的情况是,哈希表能够完全放入内存中。其可用大小受限于 work_mem × hash_mem_multiplier 的乘积。(v. 13)(默认值:4MB)(默认值:2.0)
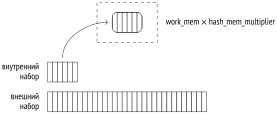
以下是一个使用 EXPLAIN ANALYZE 命令执行查询的示例,以获取内存使用信息:
与嵌套循环连接不同,后者对内部和外部行集有明显区分,而哈希连接允许交换行集的顺序。通常,较小的行集被用作内部行集,因为这样哈希表会更小。
此处的内存容量足以容纳整个哈希表,其大小约为143 MB(Memory Usage),包含4M = 222个桶(Buckets)。因此,连接仅需一次遍历(Batches)完成。
然而,如果查询中仅使用一个列,哈希表仅需111 MB的内存空间:
这再次说明不应在查询中使用多余的字段,包括“星号”(*)。
哈希表的桶数量被选择为:在数据完全填满时,每个桶平均包含一行。过高的填充密度会增加哈希冲突的概率,从而降低查找效率;而过低的填充密度则会浪费内存。计算出的桶数量会向上取整为最接近的2的幂4。
(如果根据单行平均“宽度”估算,按计算桶数的哈希表大小超过了内存限制,则使用双次遍历哈希。)
在哈希表完全构建完成之前,哈希连接无法开始返回结果。
在第二阶段(此时哈希表已准备就绪),哈希连接节点会向第二个子节点请求外部行集。对于每行读取的外部行,检查其在哈希表中是否存在匹配行。为此,对属于连接条件的外部行字段计算哈希函数。
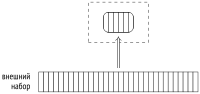
找到的匹配结果将返回给上级节点。
成本估算。我之前已经讨论过基数估算,它与连接方式无关,因此接下来我只讨论成本估算。(参见 444)
哈希节点的成本取其子节点的总成本。这是一个虚构的数值,仅用于在查询计划中显示结果5。所有实际成本估算均包含在哈希连接节点的成本中6。
我们来看一个示例:
连接的初始成本主要反映哈希表的创建,其构成如下:
内部行集获取的完整成本,这是构建哈希表所必需的;
对内部行集的每一行,计算连接键中所有字段的哈希函数的成本(每项操作按参数 cpu_operator_cost 估算);(默认值:
0.0025)将内部行集的所有行插入哈希表的成本(单行插入按参数 cpu_tuple_cost 估算);(默认值:
0.01)外部行集获取的初始成本,没有它无法开始连接操作。
总成本在初始估算的基础上增加了实际连接的成本:
对外部行集的每一行,计算连接键中所有字段的哈希函数的成本(cpu_operator_cost);
由于可能的哈希冲突,需要对连接条件进行重新验证的成本(每个操作按参数 cpu_operator_cost 估算);
每条结果行处理成本(cpu_tuple_cost)。
此处成本估算中最复杂的是确定连接过程中所需的重新验证次数。该值估算为外部行集行数乘以内部行集行数(位于哈希表中)的某个比例。该比例的估算考虑了值分布不均的可能性。我不会深入细节 7;在此情况下,该比例估算为0.150112。
因此,我们示例中的成本估算计算如下:
成本计算的依赖关系可表示如下:
两阶段哈希连接
如果在规划阶段估算显示哈希表无法放入分配的内存空间,则内部行集将被划分为若干个批次(batch),每个批次分别处理。批次数量(与桶数量一样)始终是2的幂;批次编号由哈希值的相应位数决定8。
任何一对在连接中相互匹配的行,必定属于同一个批次,因为不同批次的行不可能具有相同的哈希值。
每个批次对应相同数量的哈希值。如果数据分布均匀,则所有批次的大小也大致相同。规划器可以通过选择合适的批次数量来控制内存使用量9。
在第一阶段,读取内部行集并构建哈希表。如果当前内部行集的某行属于第一个批次,则将其添加到哈希表中并保留在内存中。如果属于其他批次,则将其写入临时文件——每个批次都有自己的临时文件10。(默认值:-1)
请注意,可以通过设置参数 temp_file_limit 来限制会话在磁盘上使用的临时文件大小(临时表不计入此限制)。如果会话超出该限制,查询将
在第二阶段,读取外部行集。如果当前行属于第一个批次,则将其与哈希表进行匹配,该哈希表恰好包含第一个批次的内部行集(其他批次不可能存在匹配)。
如果该行属于其他批次,则将其写入临时文件——同样,每个批次都有自己的临时文件。因此,当有 N 个批次时,将使用 2 (N − 1) 个文件(或更少,如果某些批次为空)。
第二阶段结束后,哈希表占用的内存被释放。此时,已获得一个批次的连接部分结果。
随后,对每个已保存到磁盘的批次,依次重复两个阶段:将临时文件中的内部行集行加载到哈希表;从另一个临时文件中读取对应批次的外部行集行,并与哈希表进行匹配。已使用的临时文件将被删除。
两阶段连接在 EXPLAIN 命令的输出中与单阶段连接的区别在于,其包的数量大于一。此外,使用 buffers 关键字时,命令将显示与磁盘交换的统计信息:
我之前已经给出了这个例子,但将 work_mem 的值增大了。在默认分配的 8 MB 内存中,整个哈希表无法容纳;此处使用了 32 个包,哈希表使用了 128 KB = 217 个桶。在构建哈希表阶段(Hash 节点)会将数据写入临时文件;在连接阶段(Hash Join 节点)则会读取和写入这些文件。
参数 log_temp_files 可以让服务器日志中记录更详细的临时文件信息。当其值为 0 时,日志中将记录每个文件及其大小(在删除时)。(默认值: -1)
动态调整
计划中的事件流程可能被两个问题破坏:统计信息不准确和分布不均。
当连接键中的列值分布不均时,不同的包将包含不同数量的行。
如果某个包(除第一个外)过大,其所有行都必须先写入磁盘,然后再从磁盘读取。主要问题通常出现在外部集合上,因为外部集合通常更大。因此,如果外部集合的行具有普通且非多值的统计信息(即外部集合是一张表,且连接基于单个列),那么哈希码对应于多个最频繁值的行将被视为属于第一个包11。这种优化(倾斜优化)可以在两阶段连接中略微减少 I/O。(参见 369)
这两个问题都可能导致某些(或全部)包的大小超过预期。此时,这些包的哈希表将无法容纳在预定大小内,从而超出限制。
因此,如果在构建哈希表过程中发现其大小超出限制,包的数量将动态增加(翻倍)。实际上,每个包被分成两个新包:大约一半的行(假设分布均匀)保留在哈希表中,另一半则被写入新的临时文件12。
即使原本计划为单阶段连接,这种情况也可能发生。实际上,单阶段和两阶段连接是同一个算法,由同一段代码实现。我将它们分开只是为了便于说明。
包的数量只能增加。如果发现规划器高估了,包不会被合并。
然而,在分布不均的情况下,增加包的数量可能无济于事。例如,键列可能在所有行中包含相同的值:显然,所有行都会落入同一个包中,因为哈希函数会返回相同的值。遗憾的是,在这种情况下,哈希表将不断增长,不受任何限制参数的影响。
理论上,可以采用多阶段连接,每次只处理包的一部分,但目前尚未实现。
为了演示包数量的动态增加,必须采取一些措施来欺骗规划器。(参见 349)
通过这些操作,我们得到了表 bookings_copy —— bookings 的完整副本,但规划器认为其行数仅为实际的十分之一。在现实中,这种情况可能出现在哈希表基于另一个连接的结果构建时,而该连接没有可靠的统计信息。
由于这一错误,规划器认为只需 4 个包就足够了,但在连接执行过程中,包的数量增加到了 16 个:
成本估算。 这是与我之前展示单阶段连接成本计算相同的例子,但现在我将可用内存极小化,规划器被迫使用两个包。此时连接成本增加:
第二阶段的开销与将行写入临时文件以及从文件读取有关。
为单阶段连接计算的初始成本在此情况下增加了对写入足够页面的估算,这些页面足以保存内部集合中所有行的所需字段13。尽管第一个包在构建哈希表时不会写入磁盘,但这一情况未被计入成本估算中,因此成本估算与包的数量无关。
总成本增加了对先前写入的内部集合行的读取估算,以及对外部集合行的写入和读取估算。
读写一页的成本均以参数 seq_page_cost 估算,基于顺序 I/O 的特性。
在此示例中,内部集合行的页面数估算为 7,外部集合行的页面数估算为 2309。将这些估算值加到之前单阶段连接获得的成本上,得到的数字与查询计划中的成本一致:
因此,当内存不足时,连接算法变为两阶段,其效率下降。因此,重要的是:
哈希表中只应包含真正需要的字段(查询作者的责任);
哈希表应基于更小的行集合构建(规划器的责任)。
在并行计划中使用哈希连接
哈希连接可以以我上述描述的形式参与并行计划。这意味着,首先多个并行进程独立地为内部集合构建各自的(完全相同的)哈希表,然后使用并行访问外部集合的行。收益来自于每个进程仅扫描外部集合的一部分。
以下是一个包含普通(本例中为单阶段)哈希连接的计划示例:
在此计划中,每个进程对表 bookings 进行哈希处理,然后使用并行扫描(Parallel Seq Scan)获取的本进程部分行与哈希表进行匹配。
哈希表的内存限制适用于每个并行进程,因此总内存使用量是计划中显示的内存使用量的三倍。
并行一阶段哈希连接
尽管普通哈希连接在并行计划中也能带来一定优势(尤其是在内部集合较小时,无需并行处理),但对于大数据集,专用的并行哈希连接算法表现更佳。
与非并行版本算法的重要区别在于,哈希表不是创建在进程的本地内存中,而是创建在 共享 的动态分配内存中,所有参与连接的并行进程均可访问。这使得可以创建一个统一的哈希表,而不是多个独立的哈希表,从而利用所有参与进程的总内存。这提高了单阶段连接的可能性。
在 第一阶段,计划中由 Parallel Hash 节点表示,所有并行进程通过并行访问内部行集合14共同构建哈希表。
为了继续推进,每个并行进程必须完成其第一阶段的部分工作15。
在 第二阶段(Parallel Hash Join 节点),当哈希表构建完成后,每个进程使用并行访问16将其部分外部集合行与哈希表进行匹配。
以下是一个此类计划的示例:
这是我在前一节展示过的相同查询,但当时并行哈希连接被参数 enable_parallel_hash 显式禁用。(默认值: on)
尽管我将哈希表的内存空间减半,与前一节的普通哈希连接相比,连接仍保持单阶段,这是由于所有并行进程共享内存(Memory Usage)。哈希表略有增大,但仅存在一个实例,因此总内存使用量减少。
并行两阶段哈希连接
即使所有并行进程共享的内存也不足以容纳整个哈希表。这可能在规划阶段或执行阶段变得明显。在这种情况下,将使用两阶段算法,其与之前讨论的所有算法有显著不同。
重要区别在于,不使用一个大的共享哈希表,而是使用多个较小的表。每个进程独立处理自己的表,并独立处理包(与其他进程无关)。(然而,各个哈希表也位于共享内存中,因此任何进程都可以访问它们。)如果在规划阶段就清楚无法仅用一个包完成17,则每个进程会立即创建自己的哈希表。如果在执行阶段才决定,则会重建表18。
因此,在第一阶段,进程并行读取内部集合的行,将其划分为包,并将这些包写入临时文件19。由于每个进程仅读取内部集合的一部分行,没有任何一个进程会为任何一个包构建完整的哈希表(即使是第一个包也不行)。任何包的完整行集合仅在文件中汇集,所有并行进程同步写入该文件20。因此,与非并行版本算法以及并行单阶段版本不同,本例中所有包(包括第一个)都会被写入磁盘。
当所有进程完成内部集合的哈希处理后,开始 第二阶段21。
在非并行版本的算法中,外部数据集的行(属于第一个数据包)会立即与哈希表进行匹配。但在并行版本中,哈希表尚未在内存中准备好,各进程独立处理数据包。因此,在第二阶段开始时,外部数据集的行被并行读取,分配到各个数据包中,每个数据包被写入自己的临时文件22。读取的行不会进入哈希表(如第一阶段那样),因此无法增加数据包的数量。
当所有进程完成对外部数据集的读取后,磁盘上将存在 2N 个临时文件,分别包含内部和外部数据集的数据包。
随后,每个进程选择一个数据包并执行连接:将内部数据集的行加载到内存中的哈希表,读取外部数据集的行,并与哈希表中的行进行匹配。处理完一个数据包后,进程选择下一个尚未处理的数据包23。
当未处理的数据包耗尽时,空闲的进程会连接到尚未完成的数据包的处理中,利用所有哈希表位于共享内存中的优势。
这种方案比所有进程共享一个大型哈希表更高效:更容易组织协作,减少同步所需的资源开销。
调整
哈希连接算法不仅可用于内部连接,还可用于任何其他类型的连接:左外连接、右外连接和全外连接,以及半连接和反连接。然而,再次强调,连接条件仅支持相等比较。
部分操作我已在讨论嵌套循环连接时展示过。以下是一个 右外连接 的示例:(参见 451)
请注意,SQL 查询中的逻辑左连接在执行计划中被转换为物理右连接。
在逻辑层面,外部表(位于连接操作左侧)是预订表(bookings),内部表是票务表(tickets)。因此,连接结果中应包含没有对应票务的预订记录。
在物理层面,外部和内部数据集的定义并非基于查询文本中的位置,而是基于连接成本。通常这意味着内部数据集是哈希表更小的那个。此处也是如此:预订表作为内部数据集,连接类型从左连接变为右连接。
反之,如果在查询中指定右外连接(希望输出未关联到预订的票务),则执行计划中的连接类型会变为左连接:
为完整展示,以下是一个全外连接的执行计划示例:
并行哈希连接支持所有类型的连接:不仅限于内部连接和左外连接,还包括右外连接和全外连接。在以下示例中,规划器优先选择右外连接,以构建更小的哈希表:(v. 16)
22.2. 非重复值与分组
用于聚合的值分组和去重操作可以使用与连接算法类似的算法。一种方法是基于所需列构建哈希表。
仅当值尚未存在于哈希表中时,才将其放入哈希表。因此,最终哈希表中汇集了所有唯一值。
在执行计划中,负责哈希聚合的节点被标记为 HashAggregate24。
以下是一些可能使用此类节点的示例场景。
每个服务等级的座位数量(GROUP BY):
服务等级列表(DISTINCT):
服务等级及其他值(UNION):
节点 Append 对应两个行集的合并,但不会像 UNION 操作那样删除重复项。去重操作由 HashAggregate 节点单独完成。
分配给哈希表的内存受 work_mem × hash_mem_multiplier 限制,与哈希连接情况相同。(默认值:4MB)(默认值:2.0)
如果哈希表能完全容纳在分配的内存中,聚合将在对行集的一次遍历中完成,如本例所示:
成本值的唯一值不多,因此哈希表仅占用了 45 KB(内存使用量)。
一旦在构建哈希表过程中,新值无法再放入分配的内存空间,它们将被写入临时文件,并根据哈希值的若干位进行分区。分区数量为 2 的幂,由规划器选择,以确保每个分区的哈希表能完全放入内存。当然,这一估算依赖于统计信息的质量,因此计算值乘以 1.5,以进一步减小分区大小,提高每个分区能一次性处理的概率25。(v. 13)
在读取完全部数据集后,节点返回那些进入哈希表的值的聚合结果。
随后,哈希表被清空,之前写入临时文件的每个分区将被读取并以与普通行集相同的方式处理。在极端情况下,某个分区的哈希表可能再次无法放入内存;此时,‘多余’的行将再次被分割为分区,并写入磁盘以供后续处理。
再看一个示例。此处唯一标识符的数量过大,无法将整个哈希表放入内存,因此计划使用四个分区:
在查询执行过程中,共进行了五次迭代:一次处理初始数据集,另四次分别处理每个写入磁盘的分区。
在两阶段哈希连接算法中,最频繁的值被特殊处理,移动到第一个数据包,以避免不必要的输入/输出。对于聚合操作,这种优化并不需要,因为分区仅包含内存不足的行,而非所有行。频繁值有很大概率在行集早期就出现,从而及时占据内存空间。
backend/executor/nodeHash.c, 函数 ExecChooseHashTableSize. ↩︎
backend/optimizer/plan/createplan.c, 函数 create_hashjoin_plan. ↩︎
backend/optimizer/path/costsize.c, 函数 initial_cost_hashjoin 和 final_cost_hashjoin. ↩︎
backend/utils/adt/selfuncs.c, 函数 estimate_hash_bucket_stats. ↩︎
backend/executor/nodeHash.c, 函数 ExecHashGetBucketAndBatch. ↩︎
backend/executor/nodeHash.c, 函数 ExecChooseHashTableSize. ↩︎
backend/executor/nodeHash.c, 函数 ExecHashTableInsert. ↩︎
backend/executor/nodeHash.c, 函数 ExecHashBuildSkewHash. ↩︎
backend/executor/nodeHash.c, 函数 ExecHashIncreaseNumBatches. ↩︎
backend/optimizer/path/costsize.c, 函数 page_size. ↩︎
backend/executor/nodeHash.c, 函数 MultiExecParallelHash. ↩︎
backend/executor/nodeHashjoin.c, 函数 ExecParallelHashJoin. ↩︎
backend/executor/nodeHash.c, 函数 ExecChooseHashTableSize. ↩︎
backend/executor/nodeHash.c, 函数 ExecParallelHashIncreaseNumBatches. ↩︎
backend/executor/nodeHash.c, 函数 MultiExecParallelHash. ↩︎
backend/executor/nodeHashjoin.c, 函数 ExecParallelHashJoin. ↩︎
backend/executor/nodeHashjoin.c, 函数 ExecParallelHashJoinPartitionOuter. ↩︎
backend/executor/nodeHashjoin.c, 函数 ExecParallelHashJoinNewBatch. ↩︎
backend/executor/nodeAgg.c, 函数 hash_choose_num_partitions. ↩︎
23 排序与合并
23.1. 归并连接
合并连接适用于按连接键排序的数据集,并返回同样已排序的结果。输入数据集可能由于索引扫描而已经排序,或者可以显式排序1。
归并排序数据集
以下是合并连接的示例;它在执行计划中由 Merge Join 节点表示2:
优化器选择此连接方式,因为它恰好返回了 ORDER BY 子句中指定的顺序。在处理计划时,优化器会考虑数据集的排序顺序,如果不需要则不会执行显式排序。特别是,通过合并连接获得的行集可以用于下一个合并连接,只要其排序顺序合适:
首先,按 ticket_no 顺序通过索引访问读取 boarding_passes 表和 tickets 表的行,结果也按 ticket_no 列排序。该结果集再与通过索引扫描以相同顺序返回的 ticket_flights 表的行进行连接。
合并连接仅需对两个数据集各扫描一次,且不需要额外内存。它使用两个指针分别指向内部和外部数据集的当前行(初始时为第一行)。
如果两个当前行的键不匹配,则指向较小键值行的指针向前移动,直到找到匹配项。对应的行返回给上层节点,同时向前移动内部数据集的指针。连接持续进行,直到其中一个数据集被耗尽。
该算法能够处理内部数据集中键的重复值,但由于外部数据集中也可能存在重复键,算法需要稍作调整:如果在移动外部指针后键值未变,则将内部指针回退到具有相同键值的第一行。这样,外部数据集的每一行都会与内部数据集中所有相同键值的行匹配3。
对于外连接,算法略有不同,但基本思想保持不变。
合并连接仅支持等值连接,即仅支持等值连接(尽管其他条件的支持工作也在进行中4)。
成本估算。 考虑上述示例:
合并连接的初始成本至少包括其子节点的初始成本。
一般情况下,找到第一个匹配项可能需要读取部分外部或内部数据集。
为了估算这一比例,可以使用直方图比较两个数据集中连接键的最小值5。但在本例中,两张表的票号范围完全重合。(参见 356)
合并连接的总成本由从子节点获取数据的成本和计算成本组成。
由于连接算法在其中一个数据集结束时停止(外连接除外),另一个数据集可能不会被完全读取。可以通过比较两个数据集中键的最大值来估算已读行的比例。在本例中,两个数据集都将被完全遍历,因此合并连接的总成本将包括两个子节点的完整成本之和。
此外,由于存在重复项,内部数据集的部分行可能被多次读取。重复读取次数可通过连接结果集与内部数据集的基数之差来估算6。在本查询中,这两个基数相同,表明不存在重复项。
算法比较两个数据集的连接键。单次比较的成本由参数 cpu_operator_cost 估算,比较次数可估算为两个数据集行数之和(加上由重复项引起的重复读取次数)。每条结果行的处理成本通常由参数 cpu_tuple_cost 估算。(默认值:0.0025)(默认值:0.01)
因此,本例中合并连接的成本计算如下7:
并行模式
合并连接没有专门的并行实现,但可以在并行计划中使用8。
外部数据集的扫描由并行工作进程并行执行,但每个工作进程始终独立读取内部数据集。
由于并行哈希连接几乎总是成本更低,我暂时禁用它:(参见 471)
以下是使用合并连接的并行计划示例:
并行计划中不支持完全外连接和右外连接的合并连接。
调整
合并连接支持任何类型的连接。对于完全外连接和右外连接,唯一的限制是连接条件必须仅包含适用于合并的表达式(外部和内部数据集的列相等,或列与常量相等)9。对于内连接和左外连接,合并结果只需过滤掉不合适的条件即可,但对于完全外连接和右外连接,这种过滤不可行。
以下是使用合并算法的完全连接示例:
内连接和左外连接的合并连接保留排序顺序。但对于完全外连接和右外连接则不然,因为有序的外部数据集值之间可能插入空值——这会破坏排序10。因此,此处引入了 Sort 节点以恢复所需顺序。这当然增加了计划成本,使哈希连接更具吸引力,而优化器仅在禁用哈希连接的情况下才选择此计划。
但在下一个示例中,没有其他执行方式:嵌套循环在原则上不支持完全连接,而此处由于条件类型不匹配,合并连接不可用。因此,即使被禁用,仍使用了哈希连接(节点 Hash Full Join 下的 Disabled: true 行提醒了这一点):(v. 18)
恢复之前禁用的哈希连接使用功能:
23.2. 排序
如果某个数据集(或两个)未按连接键排序,则在执行合并前必须重新排序。这种显式排序在执行计划中由 Sort 节点表示11:
这种排序也可在连接上下文之外使用,例如在 ORDER BY 子句中,无论是单独使用还是作为窗口函数的一部分:
此处 WindowAgg 节点12 在 Sort 节点预先排序的数据集上计算窗口函数。
优化器提供了多种排序数据的方法。在我之前展示的示例中,使用了其中两种(Sort Method)。这些细节可通过 EXPLAIN ANALYZE 命令获取:
快排
如果待排序数据集可放入由参数 work_mem 限制的内存中,则使用传统的快速排序(quick sort)。该算法在所有教材中都有描述,因此不再赘述。(默认值:4MB)
从实现角度看,排序由一个特殊组件13执行,该组件根据可用内存和其他因素选择最合适的算法。
成本估算。 以小表排序为例。此时在内存中执行快速排序:
已知对 n 个值进行排序的时间复杂度为 O(n log2 n)。一次比较操作的成本由参数 cpu_operator_cost 的两倍估算。由于必须读取并排序整个数据集才能获得结果,排序的初始成本由子节点的完整成本和所有比较操作成本组成。(默认值:0.0025)
排序的总成本还包括对每条结果行的处理,其成本由参数 cpu_operator_cost 估算(而非通常的 cpu_tuple_cost,因为 Sort 节点的开销较小)14。
在本例中,成本计算如下:
Top-N 堆排序
如果只需对数据集的一部分进行排序(由 LIMIT 子句定义),则可使用部分堆排序(top-N heapsort)。更准确地说,当排序后行数至少减少一半,或输入数据集无法完全放入分配的内存中(但输出数据集仍可容纳)时,该算法被启用。
为了从 n 个值中找出 k 个最大(最小)值,首先将前 k 行加入称为堆(heap)的数据结构中。然后逐个添加其余行,但每次添加后,从堆中移除最小(最大)值。最终,堆中将保留 k 个所需值。
本算法中使用的堆(heap)是一种数据结构,与通常被称为堆的数据库表无关。
成本估算。 算法复杂度为 O(n log2 k),但每次操作成本高于快速排序。因此,成本计算公式15 使用 n log2 2k。
外排
如果在读取数据集时发现其过大,无法在内存中排序,则排序节点将切换到外部合并排序(external merge)。
已读取的行使用快速排序算法在内存中排序,并写入临时文件。
在释放的内存中读取下一批行,重复此过程,直到所有数据被写入多个文件,每个文件各自有序。
接下来,使用与合并连接相同的算法,将多个文件合并为一个文件。主要区别在于,可以同时合并超过两个文件。
合并不需要大量内存。原则上,只需为每个文件保留一个行的空间即可。从文件中读取第一行,从中选择最小(或最大,取决于排序方向)的行作为结果的一部分返回,并用同一文件中的新行替换它。
实际上,行不是逐个读取的,而是以每批32页的方式读取;这减少了输入/输出操作的次数。一次迭代中合并的文件数量由可用内存决定,但永远不会少于六个。该数量也受到上限(500)的限制,因为当文件过多时效率会下降16。
如果无法在一次迭代中合并所有已排序的临时文件,则必须分部分合并文件,并将结果写入新的临时文件。每次迭代都会增加读取和写入的数据量,因此可用的内存越多,外部排序的效率就越高。
在下一次迭代中,合并操作将使用新的文件继续进行。
最终合并通常被延迟执行,直到上层计划节点请求数据时才实时完成。
命令 EXPLAIN ANALYZE 显示了外部排序所需的磁盘空间量。添加 buffers 关键字后,还可以获取临时文件缓冲区的使用统计信息(temp read 和 written)。写入的缓冲区数量(大致)等于读取的缓冲区数量,而计划中 Disk 位置显示的正是该值换算成千字节的结果。
更详细的临时文件使用统计信息可以通过设置参数 log_temp_files 在日志消息中获取。
成本估算。 以同一个带有外部排序的计划为例:
此处除了与内存快速排序相同数量的比较成本外,还增加了输入/输出成本19。所有输入数据必须首先写入磁盘上的临时文件,然后在合并时从磁盘读取(可能多次,如果创建的文件数量超过可同时合并的集合数量)。
磁盘访问(读取和写入)被估算为 75% 顺序访问,25% 随机访问。
落入磁盘的数据量由待排序的行数和查询中使用的列数决定20。本例中,查询输出了 flights 表的所有列,因此写入磁盘的数据量几乎等于整个表的大小,减去行和页面中的元信息(2309 页而非 2624 页)。
在我们的示例中,一次迭代就足以完成排序。
因此,我们计划中的排序成本计算如下:
增量排序v. 13
如果需要按键 K1 … Km … Kn 对数据集进行排序,且已知该数据集已按前 m 个键排序,则无需重新对整个数据集进行排序。可以将数据集划分为若干组,这些组在前 m 个键上具有相同的值(这些组的值彼此相邻),然后分别对每组按剩余的键 Km+1 … Kn 进行排序。这种方法称为 增量排序。
增量排序通过将整个数据集划分为多个较小的组来降低内存需求,并允许在处理完第一组后立即输出结果,而无需等待整个数据集排序完成。
实现方式21 更为精细:仅对相对较大的行组进行单独处理,而较小的组则合并后整体排序。这减少了排序调用的开销22。
执行计划中,增量排序由 Incremental Sort 节点表示:
从计划中可以看出,行集已按 total_amount 排序,因为它是通过按该列构建的索引扫描得到的(Presorted Key)。EXPLAIN ANALYZE 命令还显示了执行时间统计信息。Full-sort Groups 行对应于被合并并完全排序的小组,Presorted Groups 行对应于较大的组,这些组在 book_date 列上进行了二次排序。两种情况下均使用了内存中的快速排序。不同大小的组的存在是由于预订成本分布不均所致。
增量排序也可用于窗口函数的计算:(v. 14)
成本估算。 增量排序的成本估算23 基于对组数的估算24 以及对中等大小组排序的估算(我们已讨论过)。
初始成本反映了对第一个(即第一个)组排序的估算,此时节点已可输出已排序的行;而总成本则包含了对所有组排序的估算。
关于估算的详细计算过程,我将不再赘述。
并行模式
排序可以并行执行。尽管工作进程以已排序的形式输出其数据部分,但 Gather 节点并不知道这一点,只能按到达顺序合并数据。为了保持排序顺序,需使用另一个节点——Gather Merge25。
Gather Merge 节点使用二叉堆26 对来自多个进程的行进行排序。本质上,它执行了多个已排序行集的合并,类似于外部排序,但算法针对不同工作条件进行了优化:固定数量的源(较小且固定),按单行获取,不支持块访问。
成本估算。 Gather Merge 节点的初始成本基于其子节点的初始成本。此外(与 Gather 节点类似),还需加上进程启动成本,该成本由参数 parallel_setup_cost 估算。(参见 382)(默认值:1000)
此外还需估算二叉堆的构建成本,这需要对并行进程数量 n 个值进行排序(即 n log2 n)。每次比较成本为 cpu_operator_cost 的两倍,由于 n 较小,总成本通常可忽略不计。(默认值:0.0025)
总成本包括子节点获取所有数据的成本(由多个并行进程执行)以及这些进程间行传输的成本。每行传输成本为 parallel_tuple_cost 的 1.05 倍,以考虑等待后续值时可能的延迟。(默认值:0.1)
总成本还包括二叉堆的更新成本。对每条输入行,这需要 log2 n 次比较操作以及若干辅助操作(估算为 cpu_operator_cost)27。
以下是另一个带有 Gather Merge 节点的计划示例。该示例有趣之处在于,工作进程使用哈希方法执行部分聚合,然后将结果由 Sort 节点排序(由于聚合后行数较少,成本较低),再传递给主进程,主进程在 Gather Merge 节点中合并完整结果。最终的聚合则基于已排序的值列表执行:(参见 478)
本例中并行进程数量为三个(含主进程),Gather Merge 节点的成本计算如下:
23.3. 非重复值和分组
正如我们刚刚看到的,聚合(以及去重)可以通过哈希或排序实现。在已排序的列表中,重复值的组可以仅通过一次遍历就轻易识别出来。(参见 479)
从已排序列表中提取唯一值在计划中由一个非常简单的节点 Unique 28 表示:
Unique 节点可以参与并行计划,用于消除工作进程返回列表中的重复项:(v. 15)
在本例中,工作进程通过 HashAggregate 节点使用哈希方法在各自数据集中提取唯一值;由 Gather 节点收集的汇总列表在 Sort 节点中排序后,传递给 Unique 节点以最终去除重复项。
聚合使用另一个节点 GroupAggregate 29:
在并行计划中,该节点称为 Partial GroupAggregate,而完成聚合的节点称为 Finalize GroupAggregate。
哈希和排序两种策略可以在同一节点中结合使用,用于对多个集合进行分组(在 GROUPING SETS、CUBE 或 ROLLUP 子句中)。我不会深入探讨算法的复杂细节。仅举一个例子,其中分组需基于三个不同的列:
执行此查询时发生的情况如下:计划中标记为 MixedAggregate 的聚合节点接收按 fare_conditions 列排序的数据集。
在第一阶段,该数据集被扫描,并按 fare_conditions 列分组(Group Key)。在扫描过程中,行按 ticket_no 列重新排序(与普通 Sort 节点相同:若内存足够则使用内存快速排序,否则使用磁盘外部排序),同时将这些行写入以 amount 为键的哈希表中(与哈希聚合相同:若内存足够则在内存中,否则使用临时文件)。
在第二个阶段,扫描在前一阶段按 ticket_no 列排序的行集,并根据同一列(排序键和嵌套分组键)对值进行分组。如果需要按另一列进行排序分组,行将被重新排序为所需顺序。
最后,扫描在第一阶段准备好的哈希表,并根据 amount 列(哈希键)对值进行分组。
23.4. 连接方式的比较
因此,连接两个数据集可以使用三种不同的方法,每种方法都有其优缺点。
嵌套循环连接 不需要任何预处理工作,可立即开始返回结果行。这是唯一一种在内部数据集存在高效索引访问时,无需完全扫描内部数据集的连接方式。这些特性使得嵌套循环算法(与索引结合使用)成为处理短 OLTP 查询的理想机制,这类查询基于少量行的子集构建。
嵌套循环的缺点随着数据量的增长而显现。对于笛卡尔积,该算法具有二次复杂度——开销与连接数据集大小的乘积成正比。笛卡尔积在实践中并不常见;通常情况下,对于外部数据集的每一行,通过索引仅需扫描内部数据集的若干行,而这一平均数量与整个数据集的大小无关(例如,每次预订的平均票数不会随预订数量和售出票数的增加而改变)。因此,复杂度通常表现为线性增长,而非二次增长,尽管系数较大。
嵌套循环的一个重要特点是其通用性:它支持任意连接条件,而其他方法仅支持等值连接。这使得可以执行任何带有任意条件的查询(除完全连接外,完全连接无法通过嵌套循环实现),但需注意,非等值连接在处理大量数据时几乎肯定比预期更慢。
哈希连接 对于大数据集非常高效。在有足够的内存时,它只需对两个数据集各扫描一次,即具有线性复杂度。与表的顺序扫描结合使用时,哈希连接在计算大量数据结果的 OLAP 查询中经常出现。
在响应时间比吞吐量更重要的场景中,哈希连接表现较差,因为结果行必须等到哈希表完全构建后才能返回。
哈希连接的应用受限于等值连接。此外,数据类型必须支持哈希运算(这几乎总是成立)。
嵌套循环有时可通过在 Memoize 节点(基于哈希表)中缓存内部数据集的行而与哈希连接竞争。优势源于哈希连接始终必须完全扫描内部数据集,而嵌套循环算法则不需要。(v. 14)
合并连接 既适用于短 OLTP 查询,也适用于长 OLAP 查询。它具有线性复杂度(只需对连接的数据集各扫描一次),对内存要求不高,并且无需预处理即可输出结果——前提是数据集必须按正确顺序排序。实现这一条件的最有效方法是通过索引扫描获取数据。对于少量行而言,这是自然的选择;对于大量数据,索引访问也可能高效,但前提是访问表的次数较少或完全没有。
如果没有合适的索引,则必须对数据集进行排序,而排序需要内存且复杂度高于线性:O(n log2 n)。
在这种情况下,合并连接几乎总是不如哈希连接——除非结果需要保持排序。
合并连接的一个优点是外部和内部数据集的对称性。嵌套循环和哈希连接的效率高度依赖于查询规划器是否正确选择哪个数据集作为外部,哪个作为内部。
合并连接的应用受限于等值连接。此外,数据类型必须具有 B-树操作符类。(参见 546)
下图展示了不同连接方式的成本随连接行比例变化的近似关系。
在高选择性情况下,嵌套循环连接利用两个表的索引访问;随后规划器切换为完全扫描外部表,成本曲线变为线性。
本例中,哈希连接使用了两个表的完全扫描。成本曲线上的“台阶”出现在哈希表无法完全放入内存,开始将数据包写入磁盘时。
使用索引的合并连接显示出较小的线性成本增长。当 work_mem 足够大时,哈希连接通常更高效,但当涉及临时文件时,合并连接反而占优。
合并连接加排序的上图显示了在无索引可用、必须对数据排序时成本的增长情况。与哈希连接类似,成本曲线上的“台阶”由内存不足引起,需使用临时文件进行排序。
这只是示例;在每个具体场景中,成本关系显然会有所不同。
backend/optimizer/path/joinpath.c, 函数 generate_mergejoin_paths. ↩︎
backend/executor/nodeMergejoin.c, 函数 ExecMergeJoin. ↩︎
backend/utils/adt/selfuncs.c, 函数 mergejoinscansel. ↩︎
backend/optimizer/path/costsize.c, 函数 final_cost_mergejoin. ↩︎
backend/optimizer/path/costsize.c, 函数 initial_cost_mergejoin и final_cost_mergejoin. ↩︎
backend/optimizer/path/joinpath.c, 函数 consider_parallel_mergejoin. ↩︎
backend/optimizer/path/joinpath.c, 函数 select_mergejoin_clauses. ↩︎
backend/optimizer/path/pathkeys.c, 函数 build_join_pathkeys. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_sort. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_sort. ↩︎
backend/utils/sort/tuplesort.c, 函数 tuplesort_merge_order. ↩︎
Дональд Кнут. Искусство программирования. Т. 3: Сортировка и поиск. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_sort. ↩︎
backend/optimizer/path/costsize.c, 函数 relation_byte_size. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_incremental_sort. ↩︎
backend/utils/adt/selfuncs.c, 函数 estimate_num_groups. ↩︎
backend/optimizer/path/costsize.c, 函数 cost_gather_merge. ↩︎
backend/executor/nodeAgg.c, 函数 agg_retrieve_direct. ↩︎
第五部分 索引类型
24 哈希索引
24.1. 总览
哈希索引1 允许通过索引键快速查找行版本的标识符(tid)。在初步近似中,这只是一个存储在磁盘上的哈希表。哈希索引唯一支持的操作是基于相等条件的查找。
在向索引插入时2,会计算索引键值的哈希函数。PostgreSQL 中的哈希函数返回 32 位或 64 位整数,而桶号则使用该值的若干低位比特。所选桶中会添加行版本标识符以及键的哈希码。键值本身不会保存在索引中,因为实现上处理固定长度的小值更为方便。
索引的哈希表是动态扩展的3。最小桶数为两个。随着索引行数的增加,其中一个桶会分裂为两个。为此会使用哈希码的额外一位,因此元素仅在参与分裂的两个桶之间重新分配,而其他桶的内容保持不变4。
在索引中查找时5,会计算索引键的哈希函数,并确定对应值的桶号。从桶的全部内容中,仅返回与键哈希码匹配的行版本标识符。由于桶内元素按键哈希码排序,合适的标识符可通过二分查找高效定位。
由于键值本身不保存在哈希表中,索引方法可能因哈希冲突而返回多余的行版本标识符。因此,索引机制必须通过表对访问方法返回的所有结果进行重新验证。同样原因,无法仅对索引进行扫描。(参见 411)
24.2. 页面布局
与普通哈希表不同,索引存储在磁盘上。因此所有必要信息必须分页存储,且希望索引操作(查找、插入、删除)访问的页面数量尽可能少。
哈希索引使用四种类型的页面:
元页面(meta page)—— 0 号页面,包含索引的“目录”;
桶页面(bucket page)—— 索引的主要页面,每个桶对应一个页面;
溢出页面(overflow page)—— 当桶的主页面无法容纳所有元素时使用的额外页面;
位图页面(bitmap page)—— 包含位数组的页面,用于标记已释放且可重复使用的溢出页面。
可通过 pageinspect 扩展查看索引页面内部结构。
从一个空表开始:
我分析了表以获取最小尺寸的索引;否则桶数将对应于 10 页的表6。(v. 14)
当前索引包含四页:元页面、两个主桶页面和一个位图页面(预先创建以备不时之需):
元页面包含索引的全部控制信息。目前我们关注几个值:
字段 ffactor 显示每桶的估算行数。该值基于块容量和存储参数 fillfactor 的设置计算得出。在数据完全均匀分布且无哈希冲突的情况下,可适当提高 fillfactor,但现实中这会增加单个桶的元素无法容纳于一页的可能性。(默认值:75)
对哈希索引最不利的情况是数据分布严重倾斜,即某个键被重复多次。由于哈希函数会产生相同值,所有数据都会落入同一个桶,增加桶数也无法缓解此问题。
当前索引为空,这由字段 ntuples 的值表明。通过向表中插入大量具有相同索引列值的行来填满桶页面。索引中将出现溢出页面:
页面信息摘要显示桶 0 为空,所有值均落入桶 1:部分在主页面,未容纳的部分在溢出页面。
显然,单个桶的元素分散在多个页面上会严重影响性能。哈希索引在数据均匀分布时表现最佳。
现在来看桶如何分裂。当索引中行数超过当前桶的估算值 ffactor 时发生分裂。本例中,两个桶且 ffactor = 307,当插入第 615 行时将触发分裂:
字段 maxbucket 增加至 2:现在共有三个桶,编号从 0 到 2。尽管仅新增一个桶,但页面数量翻倍:
新增的一个页面用于桶 2,另一个页面保持空闲,将在桶 3 出现时使用。
因此,从操作系统的角度看,哈希索引的大小呈跳跃式增长,尽管逻辑上哈希表是逐步扩展的。
为略微平滑此增长并避免一次性分配过多页面,从第 10 次页面翻倍开始,页面并非一次性全部分配,而是按计算数量的 分批分配。
元页面中的另外两个字段是位掩码,揭示了桶地址的细节:
桶号由哈希码中与掩码 highmask 对应的比特决定。但如果所得桶号不存在(超过 maxbucket),则需使用与掩码 lowmask 对应的比特7。本例中我们取两个最低位,得到 0 到 3 的值;若结果为 3,则仅取一个最低位,即用桶 1 代替桶 3。
每次翻倍时,新桶页面始终以连续块形式分配,而溢出页面和位图页面则按需插入这些块之间。元页面在数组 spares 中存储每个块已分配的页面数量,从而可通过桶号计算其主页面号8。
本例中,第一次翻倍后插入了两页(位图和溢出页),第二次翻倍后尚未新增任何页面:
元页面还存储指向位图页面的数组:
索引页面内部空间在删除对死行版本的引用时释放。这发生在自动清理(当尝试向已满页面插入元素时触发9)或常规清理时。
但哈希索引无法缩小自身尺寸,一旦分配的页面便不会归还给操作系统。主页面始终固定分配给其对应桶,即使桶中无任何元素;空闲的溢出页面由位图跟踪并可重复使用(可能用于其他桶)。唯一能减小索引物理尺寸的方法是使用 REINDEX 或 VACUUM FULL 命令重建索引。(参见 170)
在查询计划中,索引类型不会被特别标记:
24.3. 操作符类
在 PostgreSQL 10 之前,哈希索引未被写入 WAL,即未受崩溃保护且无法复制,因此不推荐使用。但即便如此,它们仍具有一定的价值。原因在于哈希算法被广泛使用(例如用于哈希连接和分组),系统需要知道每种数据类型对应的哈希函数。但这种对应关系并非静态:无法一次性永久设定,因为 PostgreSQL 支持动态添加新数据类型。因此,这种对应关系由哈希索引操作符类与特定数据类型共同维护。哈希函数本身由操作符类的参考函数提供:(参见 457)(参见 397)(psql: \dAp)
这些函数返回 32 位整数。尽管未正式文档化,但可用于计算相应类型值的哈希码。
例如,text_ops 家族使用函数 hashtext:
哈希索引操作符类包含一个操作符——“等于”。通常正是该操作符用于系统级的相等性检查。(psql: \dAo)
24.4. 属性
查看哈希索引方法向系统报告的属性。(参见 404)
访问方法属性
显然,哈希索引不允许对行进行排序:哈希函数以或多或少随机的方式打乱数据。
不支持唯一性约束。尽管可以使用哈希索引实现排除约束,且仅使用单一的「等于」函数时,排除约束就具有了唯一性的意义:(参见 408)
同样不支持多列哈希索引,也不支持向索引中添加额外的 include 列。
索引级属性
哈希索引既支持常规索引扫描,也支持位图扫描。
不支持按哈希索引对表进行聚簇。这是合理的,因为很难想象需要根据哈希函数值物理地对表中数据进行排序的场景。
列级属性
实际上,列的属性完全由访问方法层面定义,并始终取相同的值。
由于哈希函数不保持顺序关系,因此无法对哈希索引应用与顺序性相关的属性。
哈希索引无法参与仅索引扫描,因为它不保存索引键,且需要回表重新验证。
哈希索引不支持处理空值:对 NULL 执行「等于」操作没有意义。
不支持从数组中查找值。
postgrespro.ru/docs/postgresql/18/hash-index; backend/access/hash/README. ↩︎
backend/access/hash/hashpage.c, 函数 _hash_expandtable. ↩︎
backend/access/hash/hashpage.c, 函数 _hash_getbucketbuf_from_hashkey. ↩︎
backend/access/table/tableam.c, 函数 table_block_relation_estimate_size. ↩︎
backend/access/hash/hashutil.c, 函数 _hash_hashkey2bucket. ↩︎
include/access/hash.h, 宏 BUCKET_TO_BLKNO. ↩︎
backend/access/hash/hashinsert.c, 函数 _hash_vacuum_one_page. ↩︎
25 B-树
25.1. 总览
B-树(访问方法 btree)是一种数据结构,它允许通过从根节点向下遍历到叶节点,快速找到树中叶节点的所需元素 1。为了使搜索路径唯一确定,树中的元素必须有序。B-树适用于可比较和可排序的有序数据类型。
在示意性展示的、基于机场代码构建的索引中,内部节点以水平方式表示,而叶节点以垂直方式表示:
树中的每个节点包含多个元素,每个元素由索引键和引用组成。内部节点的元素指向下一层次的节点,而叶节点的元素则指向表行版本(图中未显示这些引用)。
B-树具有多个重要特性:
它们是平衡的,即所有叶节点位于同一深度。因此,查找任意值所需时间相同。
它们具有高度分支性,即每个节点包含大量元素,通常可达数百个(图中节点仅由三个元素组成,仅为示意目的)。由于这一特性,即使对于非常大的表,B-树的深度也保持较小。
B-树名称中的字母“B”具体含义尚不明确。它既可以是“balanced”(平衡的),也可以是“bushy”(茂密的)。但令人惊讶的是,常被误解释为“binary”(二进制的),这显然是错误的。
- 索引中的数据按升序(或降序)排列,既在节点之间,也在每个节点内部。同一层级的节点通过双向链表相互连接,因此只需沿链表单向或反向遍历,即可获得有序数据集,而无需每次都从根节点重新开始。
25.2. 检索和插入
等值检索
考虑在树中按条件「索引列 = 表达式」进行查找 2。假设我们关注的是KJA(克拉斯诺亚尔斯克)机场。
查找从根节点开始,访问方法必须确定应进入哪个子节点。选择满足 Ki ⩽ 表达式 < Ki+1 的键 Ki。
在根节点中,键为 AER 和 OVB。条件 AER ⩽ KJA < OVB 成立,因此应进入指向 AER 键的子节点。
该过程递归重复,直到到达叶节点,从该节点可获取行版本标识符。在此例中,子节点满足 DME ⩽ KJA < KZN,因此应进入指向 DME 键的叶节点。
可以注意到,树中内部节点的最左侧键是冗余的:仅需满足 KJA < OVB 即可选择根节点的子节点。此类键在 B-树中不存储,后续图示中我将保留对应元素为空。
在叶节点中,可通过简单的二分查找快速定位所需元素。
实际上,查找过程远比表面看起来复杂。必须考虑索引中的值可能按升序(如图所示)或降序排列。即使在唯一索引中,也可能存在多个匹配值,查找必须返回全部结果。此外,相同值可能数量众多,无法容纳于单个节点,此时需继续在相邻的叶页面中查找。(参见 533)
由于索引中可能包含非唯一值,更准确的说法应为“非递减”(而非“升序”),以及“非递增”(而非“降序”)。尽管如此,我仍将采用更简洁的表述。此外,行版本标识符是索引键的一部分,使得即使值相同,索引条目仍可视为唯一。
此外,在查找过程中,其他进程可能正在修改数据,页面可能分裂为两个,树结构也可能重新调整。所有算法均设计为尽可能避免并发操作之间的干扰,并减少额外锁的使用。但此处不再深入讨论。(v. 12)
非等值检索
对于条件「索引列 ⩽ 表达式」(或「索引列 ⩾ 表达式」)的查找,首先需在索引中找到等值条件的值,然后沿叶节点向指定方向遍历至末尾。
图示展示了查找代码小于或等于 DME(多莫杰多沃)的机场的过程。
对于「大于」和「小于」操作符,查找方式相同,只需排除最初找到的值即可。
范围检索
对于范围查找「表达式1 ⩽ 索引列 ⩽ 表达式2」,首先需找到 表达式1,然后沿叶节点向右遍历至 表达式2。
图示展示了查找代码从 LED(圣彼得堡)到 ROV(罗斯托夫-纳-顿河)(含)的机场的过程。
插入
新元素在叶节点中的位置由键的顺序唯一确定。例如,向表中插入代码为 RTW(萨拉托夫)的机场时,该元素将被添加到倒数第二个叶节点中,位于现有 ROV 和 SGC 之间。
但可能出现叶节点中无足够空间容纳新元素的情况。例如(假设节点最多容纳三个元素),插入代码为 TJM(秋明)的机场时,最后一个叶节点将溢出。此时节点将被“分裂”为两个,原节点的部分元素被移至新节点,父节点则添加指向新子节点的引用。当然,父节点也可能溢出。此时父节点同样被分裂为两个节点,依此类推。若分裂过程扩展至根节点,则在新节点之上创建一个新节点作为树的新根。此时树的深度增加一。
在本例中,插入机场 TJM 导致两个节点分裂;图中已标出新节点。为支持任意节点的分裂,不仅底层节点通过双向链表连接,其他层级的节点也通过双向链表连接。
上述插入与分裂过程保证了树的平衡性,且由于实际中节点元素数量通常较多,新增层级的情况极为罕见。
问题在于,分裂后的节点永远不会合并,即使清理后节点中仅剩少量元素。这一限制并非 B-树数据结构本身所致,而是 PostgreSQL 实现的特性。因此,若插入时节点已满,访问方法会优先尝试清理节点中的冗余信息,以释放空间,避免不必要的分裂。(参见 123)
25.3. 页面布局
B-树的每个节点占据一页。页面大小决定了节点的容量。
分裂操作导致在不同时间点,树的根节点可能为不同的页面。但查找算法必须从根节点开始。它通过索引的零号页面(称为元页面)获取当前根页面的编号。元页面还包含其他一些管理信息。
索引页面中的信息表示方式与之前图示略有不同。除每层最右侧页面外,其余页面均包含一个额外的「上键」,其值保证不小于该页面中任何值。前图中上键以灰色标出。
通过 pageinspect 扩展,我们可查看六位预订号对应的索引页面内容。在元页面中,我们关注根页面编号和树的最大层级(层级从零开始编号,从叶节点起算):
索引记录中的键以字节序列形式输出,这不太方便。例如:
为解码值,需编写一个临时函数。该函数并非在所有情况下或所有平台上均适用,但适用于本章示例。
现在我们可以查看根页面的内容:
第一条记录如前所述,不存储键。ctid 列包含指向子页面的引用。
假设我们正在查找编号为 E2D725 的预订。此时我们选择第 19 条记录,因为 E2CB14 ⩽ E2D725 < EF6FEA,然后进入页面 5135。
此页面的第一条记录——出人意料地——包含一个上键。从逻辑上讲,它本应位于页面末尾,但从实现角度看,将其置于开头更为方便,这样每次页面内容变化时就不必再移动它。
在此页面中,我们选择第3条记录,因为 E2D71D ⩽ E2D725 < < E2E2F4,然后下降到页面5133。
这是一张索引叶页面。第一条记录是上键,其余所有记录都指向表行版本。
这就是我们的预订:
当我们按预订号查询时,底层大致就是这样工作的:
去重v. 13
非唯一索引可能包含多个相同键,但指向不同的表行。由于重复键会占用大量空间,这些重复项会被“压缩”为一条索引记录,该记录包含键和一个表标识符列表3。在某些情况下,这种称为去重(deduplication)的过程可显著减小索引大小。
但即使是唯一索引,也可能因多版本并发控制而包含重复键,因为索引存储了对所有表行版本的引用。虽然热更新机制有助于缓解因引用非最新版本(通常生命周期很短)而导致的索引膨胀,但该机制并非总能奏效。在这种情况下,去重可节省清理表中非最新版本所需的时间,并减少页面强制分裂的次数。(参见 111)
为了避免在不需要时浪费资源进行去重,压缩操作仅在叶页面空间不足以插入新行时才执行。此时,4自动清理和去重5可释放空间,防止不必要的页面分裂。不过,如果重复项出现频率较低,可通过存储参数 deduplicate_items 禁用去重机制。
并非所有索引都支持去重。主要限制在于:键的相等性必须通过其内部表示的简单二进制比较来判断。并非所有数据类型都可如此比较。浮点数(float 和 double precision)存在两种不同的零值表示。任意精度数(numeric)允许以不同精度表示同一数值,而 jsonb 类型也使用此类数值。此外,使用非确定性排序规则的文本类型6也不适用,因为相同字符可能被表示为不同的字节序列(标准排序规则是确定性的)。
此外,目前对复合类型、范围类型和数组类型不支持去重,且不适用于 include 索引。
要检查特定索引是否支持去重,可以查看元页面中的 allequalimage 字段:
在此情况下,去重功能已启用。事实上,在某张叶页面上我们看到,部分索引记录包含单个表标识符(htid),而另一些则包含标识符列表(tids):
内部索引条目的紧凑存储v. 12
去重可使索引叶页面容纳更多记录。但为防止不必要的页面分裂,内部页面的信息压缩同样至关重要。虽然索引的大部分空间由叶页面占据,但索引查找效率直接取决于树的深度。
内部页面的索引记录包含索引键,但其值仅用于确定在查找时应进入哪个子树。在复合索引中,通常仅第一个键属性或前几个属性就足以完成此判断。其余属性可被丢弃,以节省页面空间。
当叶页面发生分裂且需在内部页面中插入新引用时7,会执行部分属性截断(suffix truncation)过程。
从理论上讲,还可以进一步优化,仅保留属性的有效部分,例如字符串的前几个字符,足以区分子树。但目前尚未实现:属性要么完整保留在索引记录中,要么完全被排除。
例如,以下为基于机票预订号和乘客姓名创建的索引的根页面中的若干记录:
可以看出,某些索引记录中第二个属性已被省略。
叶页面当然必须存储所有键属性,包括额外 include 列的值。否则索引将无法用于仅索引扫描。唯一例外是“上键”,其可不完整存储。
25.4. 排序和复合索引
列的顺序
创建索引时列的顺序极为重要,因为页面内的数据将首先按第一列排序,然后按第二列,依此类推。通常,此类索引的有效查找仅适用于从第一列开始的连续列序列条件:仅第一列、第一列与第二列、第一列至第三列等。其余条件仅用于过滤主条件查找到的值8。
以下是之前在机票表上按预订号和乘客姓名创建的索引的首张叶页面中的索引记录顺序:
此时,有效查找机票的条件可以是:按预订号和乘客姓名,或仅按预订号:
但若仅按乘客姓名查找,则必须遍历所有行:
反之,若按姓名和预订号创建索引,则可高效支持按姓名或同时按姓名与预订号的查询:
跳过扫描优化
一个重要例外是:当第一列包含的唯一值不多时。即使没有针对该列的条件,索引仍可能显著加速查找。为此,需多次访问索引,将缺失条件替换为对每个唯一值的相等性检查。 (v. 18)
设想一张表,显示飞机在哪些航线上运营。其第一列 route_type 仅有两个可能值:D(国内航线,domestic)和 I(国际航线,international)。第二列 aircraft_code 存储机型代码。部分飞机仅用于国内航线,部分仅用于国际航线,部分则用于所有航线。该索引基于前两列创建。
为理解跳过扫描的优化机制,先假设我们已将条件 aircraft_code = '733' 扩展为 route_type = ANY('{D,I}')。由于 B-树支持 SEARCH ARRAY 属性,索引扫描可有效利用此条件。首先,按条件 route_type = 'D' AND aircraft_code = '733' 执行一次搜索:(参见 411)
随后,再执行一次搜索,条件为 route_type = 'I' AND aircraft_code = '733':
从规划器角度看,两次索引搜索均属于同一索引扫描操作,因此执行计划中仅有一个 Bitmap Index Scan 节点。让我们查看实际查询:
Index Searches 行显示了索引搜索次数。本例中,扫描仅需三次从根到叶的下探,而非六次,因为具有四种状态的行恰好被定位在同一页数据中:
此类扫描会跳过无关索引部分,因此该操作被称为跳过扫描(skip scan),并非独立的扫描类型,而是一种优化机制,适用于任何索引访问方式(Index Scan、Index Only Scan、Bitmap Index Scan)。
那么,当未指定第一列条件时会发生什么?可通过统计信息估算唯一值数量,但显然不能依赖统计信息来获取精确的唯一值列表。(参见 351)
因此,我们希望执行一个条件为 aircraft_code = '733' 的表查询。我们不知道 route_type 的最小值,但可以从索引的首张叶页面的首条记录中获取:
现在我们知道 route_type 的第一个值是 D,因此可以执行第二次搜索,条件为 route_type = 'D' AND aircraft_code = '733'。
我们找到了第一个匹配值。如果在读取的叶页面中发现第一条记录的首列值不同,我们就能知道下一个精确条件。本例中我们运气不佳,因此必须执行 route_type > 'D' 的搜索:
在找到的叶页面中未发现所需记录,但我们得知了 route_type 的第二个值。因此执行下一次搜索,条件为 route_type = 'I' AND aircraft_code = '733':
可以结束扫描,因为我们已经到达了索引的最后一个叶页面。否则,还需要执行另一次搜索——条件为 route_type > 'I'——以确认不存在其他值。
没有第一个列条件的查询在索引中执行了稍多的搜索,并读取了稍多的页面,但仍然执行得非常高效:
跳过扫描优化也可应用于其他情况,例如当部分列上没有条件或条件不是等值检查时。Index Searches 值大于 1 表明在索引扫描过程中执行了跳过操作。
当然,上述示例并不完整。特别是,在某些情况下,已启动的搜索可能会继续在相邻的叶页面上进行,以期望在这些页面中找到合适的索引条目。这有助于合并单独的索引访问,减少访问次数,从而节省从根节点到叶节点的下探开销9。
另一个例子:对于 B-树操作符类中的离散数据类型,可以定义一个基准函数,该函数可提供该类型的最小值和最大值,以及用于跳转到下一个和前一个值的函数10。借助这些信息,就不需要再查找索引中的下一个值;扫描可直接跳转到其检查点。
排序方向
创建索引时,不仅要考虑列的顺序,还要考虑排序顺序。默认情况下,值按升序排列(ASC),但也可以指定降序(DESC)。对于单列索引,这没有特别影响,因为索引可以向任意方向扫描。但在复合索引中,顺序很重要。
刚刚创建的索引可用于获取按两个列升序或两个列降序排序的数据:
但无法直接从该索引获取一个列升序、另一个列降序排序的数据。索引提供的是部分有序的数据,随后需按第二个属性进行排序(此处及后续为简化起见,禁用并行计划):(参见 498)
使用索引进行排序的能力也受未定义值位置的影响。默认情况下,未定义值在排序时被视为‘大于’普通值,即在升序排序时位于树的右侧,或在降序排序时位于左侧。此顺序可通过 NULLS LAST 和 NULLS FIRST 子句进行更改。
在以下示例中,索引不满足 ORDER BY 子句,因此结果需要额外排序:
但如果创建一个符合所需顺序的索引,它将被使用:
25.5. 操作符类
比较语义
系统不仅需要能够哈希值,还需要能够对不同类型(包括用户定义类型)的值进行排序。这在排序、分组、合并连接及其他一些操作中是必需的。与哈希类似,数据类型与比较操作符之间的映射由操作符类11定义。
操作符类允许不依赖于名称(如 >、<、=),甚至可以为同一类型提供多种排序方式。
以下是任何 B-树方法操作符类必须定义的比较操作符(以 btree 家族为例):(psql: bool_ops) \dAo
我们看到五个比较操作符。每个操作符对应一个 策略12,该策略定义了其语义:
小于;
小于或等于;
等于;
大于或等于;
大于。
B-树操作符类还包含若干基准函数13。第一个函数应在第一个参数大于第二个参数时返回 1,小于时返回 -1,相等时返回 0。
其余的基准函数是可选的,但它们允许访问方法更高效地运行。
为了更好地理解此机制,创建一个新数据类型并为其设置与默认顺序不同的排序顺序是有帮助的。文档中给出了复数的示例14,但使用的是 C 语言。幸运的是,B-树操作符类也可以使用解释型语言创建,我将采用这种方式,使此示例尽可能简单(尽管显然效率低下)。
我们将创建一个用于信息单位的新复合类型:
现在创建一个包含新类型列的表,并用随机值填充它:
默认情况下,复合类型的值按字典序排序,而在此情况下,这与自然顺序不一致:
我们从一个将容量转换为字节的函数开始创建操作符类:
然后为未来的操作符类创建一个基准函数:
现在,借助基准函数可以轻松定义比较操作符。我特意使用了‘奇怪’的名称,以说明它们可以是任意的:
其余四个操作符按类似方式定义。
此时,我们已经可以正确比较容量了:
在创建操作符类后,排序功能也将正常工作:
我们的操作符类在创建索引时默认使用,创建的索引将返回正确顺序的值:
在创建等值操作符时指定的 MERGES 子句允许对我们的类型值使用合并连接。(参见 483)
25.6. 属性
我们来看一下 B-树的接口特性。(参见 404)
访问方法级属性
B-树可以对数据进行排序并支持唯一性。这是唯一能提供这些特性的访问方法。
许多访问方法允许创建复合索引,但在 B-树中,必须仔细注意索引中列的顺序,因为其中的值是有序的。
虽然形式上支持排除约束,但仅限于等值操作符,这与唯一性要求一致。相比之下,使用真正的完整唯一性约束要好得多。
B-树还允许将额外的列添加到索引中,这些列不参与搜索。
如果表足够大,索引将并行构建。工作进程数量的计算方式与并行顺序扫描相同,但受参数 max_parallel_maintenance_workers 上限限制。所有工作进程共用大小为 maintenance_work_mem 的内存。 (参见 384)(默认值:2)(默认值:64MB)
工作进程并行扫描表并排序获取的数据15;结果形成索引的叶页面,随后在这些页面上构建内部页面,直至根节点。
索引级属性
基于 B-树的索引可用于聚簇。
B-树支持两种值获取方式:索引扫描和位图扫描。由于叶页面通过双向链表连接,索引不仅可以正向遍历,也可以反向遍历,从而获得相反的排序顺序:
列级属性
ORDERABLE 属性表明 B-树以有序方式存储数据,前四个属性(ASC 和 DESC,NULLS FIRST 和 NULLS LAST)定义了该列值的具体排序方式。在以下示例中,列值按升序排序,而未定义值位于末尾。
SEARCH NULLS 属性表明支持对未定义值的搜索。
B-树尚未实现排序操作符支持(DISTANCE ORDERABLE),尽管曾有过此类尝试16。
B-树支持从数组中搜索多个值(SEARCH ARRAY 属性),并允许在不访问表的情况下获取数据(RETURNABLE 属性)。
postgrespro.ru/docs/postgresql/18/btree; backend/access/nbtree/README. ↩︎
backend/access/nbtree/nbtsearch.c, 函数 _bt_search. ↩︎
postgrespro.ru/docs/postgresql/18/btree#BTREE-DEDUPLICATION. ↩︎
backend/access/nbtree/nbtinsert.c, 函数 _bt_delete_or_dedup_one_page. ↩︎
backend/access/nbtree/nbtdedup.c, 函数 _bt_dedup_pass. ↩︎
backend/access/nbtree/nbtinsert.c, 函数 _bt_split. ↩︎
backend/access/nbtree/nbtutils.c, 函数 _bt_advance_array_keys. ↩︎
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-STRATEGIES. ↩︎
backend/access/nbtree/nbtsort.c, 函数 btbuild. ↩︎
26 GiST
26.1. 总览
GiST(广义搜索树)方法1 是平衡搜索树思想的泛化,适用于允许值之间相互定位的数据类型。B-树与有序数据类型紧密绑定,这些类型的值可以进行比较(尽管对这类类型的支撑已实现得极为高效)。而 GiST 允许在操作符类中定义任意的数据分布原则。GiST 索引可以容纳 R-树(用于空间数据)或 RD-树(用于集合),而签名树可用于任何数据类型(例如文本或图像)。
得益于 PostgreSQL 的可扩展性,开发者可以从零开始创建新的访问方法,只需实现索引机制的接口即可。但这不仅需要仔细设计索引逻辑,还需构建页面结构、高效的锁定策略以及日志预写支持。所有这些都要求开发者具备极高的专业水平并付出大量工作量。GiST 通过承担底层问题的解决并实现通用的搜索理念,大大简化了这一任务。要为新数据类型使用 GiST 方法,只需提供一个包含十余个核心函数的操作符类。该类包含了索引逻辑的大部分内容,与 B-树的极简操作符类形成鲜明对比。从这个意义上说,GiST 可以被视为构建新型访问方法的框架。
从最一般的角度来说,叶节点中的每条记录(叶记录)包含一个谓词(逻辑条件)和行版本的标识符。索引键必须满足该谓词;至于该键是否实际包含在该记录中,无关紧要。
每个内部节点中的记录(内部记录)也包含一个谓词和对子节点的引用,且子树中所有索引数据都必须满足该谓词。换句话说,内部记录的谓词包含了所有子记录的谓词。这是一个重要特性,它替代了 B-树的简单有序性,成为 GiST 索引的核心机制。
GiST 树中的搜索使用一致性函数——由操作符类定义的核心函数之一。
一致性函数被调用以检查索引记录的谓词是否与搜索条件(形式为“索引列 操作符 表达式”)一致。对于内部记录,它决定是否需要进入对应的子树;对于叶记录,它判断索引键是否满足搜索条件。
搜索2 通常从根节点开始。通过一致性函数判断哪些子节点值得进入,哪些不值得。随后,算法对每个选定的子节点重复此过程;与 B-树不同,GiST 索引中可能有多个子节点。由一致性函数在叶节点中筛选出的记录作为结果返回。
搜索始终采用深度优先:算法优先尝试到达某个叶节点。这使得可以更快地开始返回结果,这对于用户仅关心前几行数据时尤为重要。
向 GiST 树中插入新值时,一致性函数不适用,因为需要选择一个特定的叶节点3。该节点的选择应使插入成本最小化,该成本由操作符类的惩罚函数决定。
与 B-树类似,所选节点中可能没有空闲空间,从而导致页面分裂4。这需要额外的两个函数:一个决定哪些记录保留在旧节点中,哪些转移到新节点;另一个用于合并两个谓词,以更新父节点的谓词。
新值的添加逐渐扩展现有谓词,而谓词的收缩仅在页面分裂或索引完全重建时发生。这可能导致在频繁更新场景下 GiST 索引性能下降。
由于上述通用性论述可能显得抽象,且大量逻辑依赖于具体操作符类,接下来我将通过几个具体示例进行说明。
26.2. 点的 R 树
第一个示例涉及平面上点(或其他几何对象)的索引。普通 B-树不适用于此类数据,因为点之间未定义比较操作符。当然,可以自行定义这些操作符,但处理几何数据时,我们更关注其他类型的索引支持,我将详细讨论其中两个:在指定区域内查找点,以及查找最近邻。
R-树的核心思想是将平面划分为若干矩形,这些矩形共同覆盖所有待索引的点。索引记录存储一个包围矩形,其谓词可表述为:点位于该包围矩形内部。
R-树的根节点包含多个较大的矩形(可能部分重叠)。子节点包含更小的矩形,嵌套于父节点中;它们共同覆盖所有下层点。
叶节点必须包含实际的索引点,但 GiST 要求所有索引记录的数据类型一致,因此存储的仍是矩形,但“压缩”为点的形式。
通过绘制由机场坐标构建的 R-树三个层级的示意图,可以更直观地理解该结构。为此,我将 demo 数据库中的 airports 表扩展至五千行5。为便于观察,索引使用了较低的 fillfactor 参数值,使树结构更深;默认值(90)下仅需一层即可。 90
在顶层,所有点被划分到多个(部分重叠的)包围矩形中:
在下一层,大矩形进一步分解为更小的矩形:
在树的最后一个内部层级,每个包围矩形包含的点数恰好等于一页所能容纳的数量:
该索引使用了唯一的点操作符类 point_ops。
同样,可以对矩形或其他任何几何图形进行索引,只需在索引中存储其包围矩形即可。
页面布局
可通过 pageinspect 扩展查看 GiST 索引页面的内容。(v. 14)
与 B-树不同,GiST 索引没有元页面,树的根节点始终位于第零页。若根页面发生分裂,旧根节点被移至独立页面,新根节点占据其位置。
以下是根页面的内容:
这四行记录对应于前一页图示中顶层的四个矩形。
操作符类
可通过以下查询获取实现树中搜索与插入逻辑的核心函数列表8:(psql: \dAp)
我已在上文提及主要的必需函数:
用于搜索时遍历树的一致性函数;
合并函数(注意名称:合并的是矩形);
用于插入时选择路径的惩罚函数;
用于分裂时分配记录的函数;
用于检查两个键是否相等的函数。
可选函数允许控制数据存储和性能方面的细节。
操作符类 point_ops 支持以下操作符:
仅凭操作符名称难以判断其含义,因此在查询中列出了其对应函数名称和描述。所有操作符均与对象之间的相对位置(“左”、“右”、“上”、“下”、“包含”、“被包含”)或距离有关。(psql: \dAo)
与 B-树相比,GiST 支持更多策略。部分策略编号适用于多个索引类型9,部分则通过公式计算(例如编号 28、48 和 68 实质上代表同一策略:矩形、多边形和圆的“包含”关系)。此外,还支持一些已弃用的操作符名称(如 <<| 和 |>>)。
具体操作符类可能并未实现所有可用策略。例如,点类不支持“包含”策略,但具有面积的图形类(如 box_ops、poly_ops 和 circle_ops)则支持该策略。
搜索包含的元素
典型的、由索引加速的查询是获取所有位于指定区域内的点。
例如,查找位于莫斯科中心一纬度范围内的所有机场:
操作符“包含于” <@ 用于判断点是否位于指定矩形内部。该操作符对应的一致性函数10 返回“是”,当且仅当索引记录的矩形与给定矩形有交集。对于存储“压缩”为点的矩形的叶页面,这意味着函数(如同操作符本身)判断点是否位于指定矩形内部。
让我们更详细地分析一个非常简单的示例,如图所示:
在这种划分下,索引的结构如下所示:
让我们查找图中右侧所示矩形 (1,2)–(4,7) 的内部点。
搜索从根节点开始。给定矩形与 (0,0)–(3,4) 相交,但不与 (5,3)–(9,9) 相交。因此,我们无需进入第二个子树。
在下一层,给定矩形与 (0,3)–(3,4) 相交,并与 (0,0)–(3,2) 相切,因此我们必须检查两个子树。
当我们到达叶节点时,只需遍历其中包含的所有点,并返回满足一致性函数的那些点。
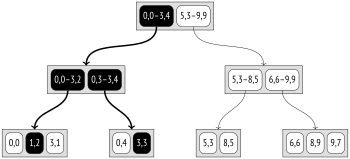
B-树搜索总是明确选择一个子节点;而 GiST 搜索可能需要遍历多个子树,尤其是当它们的包围矩形相交时。
最近邻搜索
大多数由索引支持的操作符(如前例中的 = 或 <@)可称为 搜索 操作符,因为它们在查询中定义了搜索条件。这类操作符是谓词,即返回布尔值。
还存在另一种类型的操作符——排序 操作符,它们返回参数之间的距离。这类操作符可在 ORDER BY 子句中被支持,前提是索引实现了 DISTANCE ORDERABLE 属性,从而能够高效地查找指定数量的最近邻。这种搜索称为 k-NN(k-最近邻搜索)。(参见 410)
例如,可以查找距离科斯特罗马最近的十个机场:
由于索引扫描逐个输出结果,且可在任意时刻停止,因此查找多个值变得非常迅速。
若无索引支持,实现高效搜索将非常困难。必须逐步扩大搜索区域,直到找到所需数量的结果。这需要多次索引扫描,更不用说如何选择初始区域大小及其增量的问题。
在系统目录中可以查看操作符类型(s — 搜索型,o — 排序型):(psql: \dAo)
为支持最近邻搜索,操作符类必须定义额外的 距离函数。该函数被调用以计算索引元素与某个其他值之间的距离。
对于表示索引值的叶节点元素,函数应返回该值之间的距离。对于点 11,这是标准的欧几里得距离,即 。
对于内部节点,函数应返回子叶节点元素之间的 最小 距离。由于遍历所有子记录成本较高,函数可以乐观地低估距离(牺牲效率),但绝不能返回更大的值——否则将破坏搜索的正确性。
因此,对于由包围矩形表示的内部节点,到点的距离按常规数学意义理解,即点到矩形的最小距离,或若点位于矩形内部则为零12。该值可轻松计算,无需遍历矩形的子点,且保证不大于到任何子点的距离。
让我们以我们简单的示例来说明查找点 (6,8) 的三个最近邻的算法:
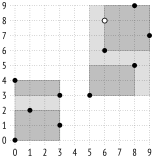
搜索从根节点开始,其中包含两个包围矩形。点到 (0,0)–(3,4) 的距离取为到矩形角点 (3,4) 的距离,即 5.0。点到 (5,3)–(9,9) 的距离为 0.0。(我将值四舍五入到小数点后一位;本例中已足够。)
子节点的遍历按距离递增顺序进行。因此,我们首先进入右侧子节点,其中包含两个矩形:(5,3)–(8,5) 和 (6,6)–(9,9)。到第一个矩形的距离为 3.0,到第二个为 0.0:
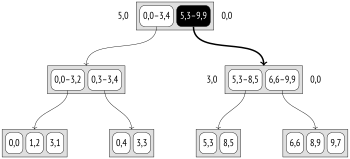
再次进入右侧子树,我们到达一个包含三个点的叶节点:(6,6) 距离为 2.0,(8,9) 距离为 2.2,(9,7) 距离为 3.2。因此,我们已有前两个点 (6,6) 和 (8,9),但该节点中第三个点的距离大于到矩形 (5,3)–(8,5) 的距离:
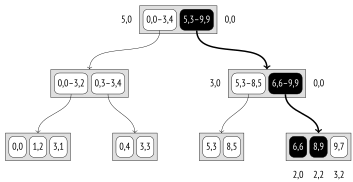
因此,现在我们进入左侧子节点,其中包含两个点:(8,5) 距离为 3.6,(5,3) 距离为 5.1。结果发现,前一个子节点中的点 (9,7) 比左侧子树中的任何点都更近,因此我们可以将其作为第三个结果返回:
此示例说明了内部记录距离函数的要求。对矩形 (5,3)–(8,5) 的距离低估(从 3.6 降至 3.0)降低了效率,因为不得不无谓地检查额外节点,但并未破坏算法的正确性。
插入
在向 R-树插入新键时,插入节点的选择基于惩罚函数,以使包围矩形的面积变化最小13。
例如,点 (4,7) 将被添加到矩形 (5,3)–(9,9) 中,因为其面积仅增加 6 个单位,而将 (0,0)–(3,4) 的面积增加 12 个单位。在下一层(叶层)中,出于相同原因,该点将被添加到矩形 (6,6)–(9,9) 中。
假设每页最多容纳三个元素,将发生页面分裂,元素将在两个页面之间重新分配:
在此示例中结果看似显而易见,但一般情况下,分配选择是一个非常复杂的问题。分裂函数首先尝试最小化包围矩形的重叠,优先选择面积较小的矩形,并倾向于在页面间均匀分布点14。
排它约束
GiST 索引可用于支持排除约束(exclude)。
排除约束保证表中任意两行的指定字段在某个 操作符 意义下不会“匹配”。必须满足以下条件:
排除约束必须由索引方法支持(属性 CAN EXCLUDE);
操作符必须属于该索引方法的操作符类;
操作符必须是可交换的,即必须满足条件 a 操作符 b = b 操作符 a。
前面讨论的 hash 和 btree 访问方法仅提供一个满足条件的操作符——相等性。使用此操作符时,排除约束等价于唯一性约束,这并无太大用处。(参见 521)
但 gist 方法还有另外两种适用的策略:
相交 — 操作符
&&;примыкание — оператор
-|-(определен для интервалов).
举个例子,创建一个禁止将机场放置得过于接近的约束。该条件可重新表述为:以机场坐标为中心、半径为某值的圆不应相交:
创建排除约束时,会自动为其检查创建索引。在本例中,这是一个基于表达式的 GiST 索引。
将问题复杂化。假设允许机场在彼此靠近的情况下共存,但仅限于属于同一城市的情况。解决方案是创建一个新的完整性约束,其表述如下:不允许存在满足以下条件的行对:以机场坐标为中心的圆相交(&&),且城市名称不相等(!=)。
尝试创建此类约束会导致错误,因为不存在文本数据类型的运算符类:
但事实上,GiST 可以处理诸如「位于左侧」、「位于右侧」或「相等」之类的策略,这些策略也可应用于普通有序数据类型,如数字或文本字符串。btree_gist 扩展正是为此添加了对 B-树典型操作的 GiST 支持:
约束已创建。现在由于莫斯科机场之间的距离过近,无法再添加同名城市中的茹科夫斯基机场:
但可以通过将机场所在城市指定为莫斯科来实现添加:
需要注意的是,尽管 GiST 可以处理「大于」、「小于」或「等于」等操作,但 B-树在处理这些操作时效率更高,尤其是在访问值范围时。因此,仅当确实需要 GiST 索引时,才应使用本例中展示的 btree_gist 扩展方法。
属性
访问方法级别属性
不支持值的排序和唯一性。
GiST 索引可以创建包含额外的 include 列。(v. 12)
正如我们所见,索引可以基于多个列构建,并可用于排除约束。
索引级别属性
GiST 索引可用于表的聚簇。
支持两种数据获取方式:逐行获取和位图获取。但 GiST 不支持反向扫描。
列级别属性
大部分列属性在访问方法级别定义,且不会改变:
所有与排序相关的属性均被禁用。
GiST 索引允许 NULL 值,但处理效率不高。认为 NULL 值不会扩展其包围矩形;因此插入时,这些值会随机分配到索引树的不同子树中,必须在整个树中搜索它们。
然而,部分列级别属性会根据运算符类的不同而变化。
索引仅可用于索引扫描,因为索引键完全存储在叶节点中。
在这种情况下,如我们所见,运算符类包含用于查找最近邻的距离操作符。到 NULL 值的距离被视为 NULL;这些值将被排在最后(类似于 B-树中的 NULLS LAST)。
但对于范围类型(表示线段,即同几何图形但位于直线上而非平面上)不实现距离操作符,因此对于此类数据类型的索引,该属性将有所不同:
26.3. 用于全文检索的 RD 树
关于全文检索
全文搜索的任务 15 —— 从一组 文档 中选出与 搜索查询 匹配的文档。
为搜索目的,文档被转换为特殊类型 tsvector,该类型包含 词元 及其在文档中的位置。词元是经过转换后便于搜索的单词。例如,默认情况下,单词会被转换为小写并去除可变词尾:
所谓的停用词(如“和”、“在”)会被删除,因为它们出现频率过高,无法有效用于搜索。当然,所有这些转换均可自定义。
搜索查询以另一种类型表示——tsquery。查询由一个或多个词元组成,通过逻辑连接词连接:「与」&、「或」|、「非」!。也可使用括号来明确操作优先级。
全文搜索仅使用一个 匹配操作符 @@:
该操作符用于判断文档是否与搜索查询匹配。以下是一个简单示例:
这绝非对全文搜索的完整描述,但这些信息已足够理解索引机制。(参见 613)
索引 tsvector 数据
为使全文搜索快速执行,必须使用索引支持 16。由于索引的并非文档本身,而是 tsvector 类型的值,因此有两种选择:构建基于表达式的索引(带类型转换),或创建一个独立的 tsvector 类型列并对其进行索引。第一种方法的优点是无需额外存储 tsvector 值,这些值本身对用户无用。但当索引机制需重新检查表中返回的版本标识符时,其速度不如列方法。此时必须为每行重新计算 tsvector 值,而 GiST 索引如我们所见,会重新检查所有行。(参见 613)
构建一个小示例。创建一个包含两个列的表:第一列存储文档,第二列存储 tsvector 值。第二列可通过触发器更新17,但更方便的做法是将其声明为生成列 18:(v. 12)
之前示例中我使用了带一个参数的 to_tsvector 函数,事先通过参数 default_text_search_config 设置了全文搜索配置。该函数的可变性类别为 STABLE,因为它隐式依赖于参数值。而此处使用的是显式指定配置的函数版本,其可变性类别为 IMMUTABLE,适合用于生成表达式。
向表中插入几行数据:(默认:english)
R-树本身不适用于文档索引,因为其无法定义包围矩形。采用的是该方法的变体——RD-树(俄罗斯套娃,Matryoshka)。该树使用 包围集合 而非包围矩形,即包含所有子集元素的集合。对于全文搜索,该集合由文档的词元组成,但一般情况下集合可以是任意的。
索引记录中表示集合有多种方式。最简单的方式是直接列出集合中的所有元素。其形式可能如下:
因此,例如,要查找满足 doc_tsv @@ to_tsquery('стояла') 条件的文档,需进入那些已知其子记录包含词元「стоя」的节点:
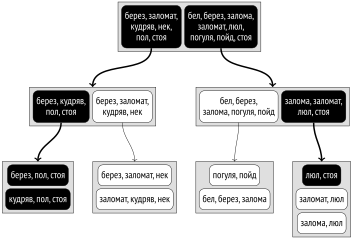
这种表示方式的问题显而易见。文档中的词元数量可能非常庞大,而页面空间有限。即使每篇文档中唯一词元不多,树的上层节点合并集合后仍可能变得非常大。
为全文搜索采用另一种更紧凑的解决方案——签名树。其思想对接触过布隆过滤器(Bloom filter)的人来说并不陌生。(参见 665)
每个词素都可以表示为其自身的签名:一个固定长度的位串,其中所有位都为零(清除),除了一个位为一(设置)。设置位的编号由词素的哈希函数值决定。
文档的签名是指文档中所有词素签名的按位“或”运算结果。
假设我们为词素分配了如下签名:
| 词元 | 签名 |
|---|---|
| бел | 1000000 |
| берез | 0001000 |
| залома | 0000010 |
| заломат | 0010000 |
| кудряв | 0000100 |
| люл | 0100000 |
| нек | 0000100 |
| погуля | 0000001 |
| пойд | 0000010 |
| пол | 0000010 |
| стоя | 0010000 |
那么文档的签名将如下所示:
| 文档 | 签名 |
|---|---|
| Во поле береза стояла | 0011010 |
| Во поле кудрявая стояла | 0010110 |
| Люли, люли, стояла | 0110000 |
| Некому березу заломати | 0011100 |
| Некому кудряву заломати | 0010100 |
| Люли, люли, заломати | 0110000 |
| Я пойду погуляю | 0000011 |
| Белую березу заломаю | 1001010 |
| Люли, люли, заломаю | 0100010 |
在这种情况下,索引树可以表示为:
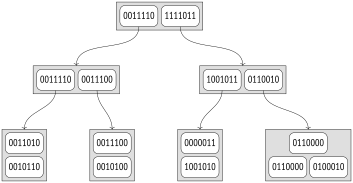
这种方法的优势显而易见:索引条目具有相同且较小的大小,索引变得紧凑。但也有显著的缺点。首先,仅扫描索引变得不可能,因为索引不再存储索引键值,每个返回的标识符都必须通过表进行重新验证。其次,精度丧失:索引可能返回大量误报结果,这些结果随后在重新验证时被过滤掉。
考虑相同的条件 doc_tsv @@ to_tsquery('стояла')。搜索查询的签名计算方式与文档相同,在本例中等于 0010000。一致性函数 19 必须确定所有子节点,其签名包含查询签名中设置的位:
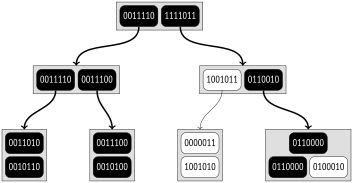
与前一个例子相比,这里由于误报触发而遍历了更多的节点。原因是当词素数量很大时,由于其位宽有限,某些词素不可避免地会获得相同的签名。在本例中,词素“стоя”和“заломат”就是如此。这导致同一个签名对应不同的文档;在本例中,“люли, люли, стояла”和“люли, люли, заломати”都具有签名 0110000。
误报降低了索引的效率,但不会危及正确性,因为这种方案中不可能出现漏报,所需值保证不会被遗漏。
当然,在现实中,签名的大小选择得更大。默认使用 124 字节(992 位),因此碰撞概率远低于示例中的情况。如需,可将签名大小设置为最多约 2000 字节,通过 操作符类参数 实现(v. 13)
此外,如果值足够小 20(略小于 页,即标准页约 500 字节),操作符类 tsvector_ops 在索引的叶页面中存储的不是签名,而是 tsvector 值本身。
为了观察索引在真实数据上的工作方式,我们取 pgsql-hackers 邮件列表归档 21。其中包含 356,125 封邮件,每封邮件包含发送日期、主题、作者姓名和正文。
添加一个 tsvector 类型的列并建立索引。此处我将三个值(主题、作者和邮件正文)合并为一个向量,以说明文档可以动态生成,不必存储在单一列中。
在填充列时,部分单词因过大而被丢弃,但最终索引已构建完成,可支持搜索查询:
除了 898 行符合条件的记录外,访问方法还返回了 7852 行,这些行通过表的重新验证被过滤掉。增大签名大小可提高精度(从而提高效率),但会牺牲索引的紧凑性:
属性
我已展示过访问方法的特性,且大部分特性对所有操作符类都一致。值得关注的是两个列级属性:(参见 574)
索引失去了参与仅索引扫描的能力,因为无法通过签名恢复原始值。在本例中这并无大碍:tsvector 值仅用于搜索,我们真正关心的是文档本身。
对于 tsvector_ops 类,排序操作符未定义。
26.4. 其他数据类型
我仅讨论了两个最具代表性的例子。它们表明,GiST 方法虽然基于平衡树,但通过操作符类的不同实现,可以适用于不同类型的数据。提及 GiST 索引时,必须明确操作符类,因为它显著影响索引的属性和特征。
以下是当前由 GiST 访问方法支持的其他一些数据类型。
几何类型。 除了点之外,GiST 索引还可用于其他几何类型:矩形、圆、多边形。这些类型在索引目的中均以它们的包围矩形表示。
扩展 cube 添加了同名数据类型,用于表示多维立方体,这些立方体通过 R-树进行索引。索引中使用的是相应维度的包围平行六面体,而非包围矩形。
范围类型。 PostgreSQL 的标准类型包括数值范围和时间范围,如 int4range 或 tstzrange22。可以使用 CREATE TYPE AS RANGE 命令定义自定义范围类型。
无论标准还是用户定义的任何范围类型,均通过相同的操作符类 range_ops23 由 GiST 索引支持。索引使用一维 R-树:此时包围矩形被转换为包围区间。
多范围类型也受支持;使用操作符类 multirange_ops。此时包围范围覆盖多范围值中包含的所有范围。(v. 14)
扩展 seg 提供了同名数据类型,用于表示边界具有特定精度的区间。该类型不属于范围类型,但本质上是范围类型,并以相同方式索引。
有序类型。 再次提醒,扩展 btree_gist 提供了 GiST 访问方法的多个操作符类,适用于大量通常使用 B-树索引的有序类型数据。这些操作符类可用于创建复合索引,当某一列类型不被 B-树支持时。
网络地址。 数据类型 inet 内置了 GiST 支持,由操作符类 inet_ops24 实现。
整数数组。 扩展 intarray 使整数数组更具功能性,并为其添加了 GiST 支持。有两个操作符类。对于小数组,可使用 gist__int_ops,它实现的是在索引条目中完整表示键的 RD-树。对于大数组,更适合使用更紧凑但精度较低的签名 RD-树,由 gist__bigint_ops 实现。
操作符类名称中的“额外”下划线出现,是因为下划线开头的名称用于基本类型的数组。例如,对于整数数组,除了更常见的 int4[] 表示法外,还可使用 _int4 类型。不过,_int 和 _bigint 类型并不存在。
标签树。 扩展 ltree 添加了同名数据类型,用于表示带标签的树形结构。GiST 支持通过签名 RD-树实现,由操作符类 gist_ltree_ops 提供 ltree 类型值的支持,以及由 gist__ltree_ops 提供此类类型数组的支持。
键值存储。 扩展 hstore 提供了 hstore 数据类型,用于存储“键–值”对。操作符类 gist_hstore_ops 通过签名 RD-树实现索引支持。
三元组。 扩展 pg_trgm 添加了 gist_trgm_ops 类,实现基于相似性比较和模式搜索的索引支持。(参见 630)
postgrespro.ru/docs/postgresql/18/gist; backend/access/gist/README. ↩︎
backend/access/gist/gistget.c, 函数 gistgettuple. ↩︎
backend/access/gist/gistutil.c, 函数 gistchoose. ↩︎
backend/access/gist/gistsplit.c, 函数 gistSplitByKey. ↩︎
文件可通过以下地址获取 edu.postgrespro.ru/internals-18/extra_airports.copy (数据来自网站 openflights.org). ↩︎
backend/access/gist/gistproc.c, 函数 gist_point_consistent. ↩︎
backend/utils/adt/geo_ops.c, 函数 point_distance. ↩︎
backend/utils/adt/geo_ops.c, 函数 box_closest_point. ↩︎
backend/access/gist/gistproc.c, 函数 gist_box_penalty. ↩︎
backend/access/gist/gistproc.c, 函数 gist_box_picksplit. ↩︎
postgrespro.ru/docs/postgresql/18/textsearch-features#TEXTSEARCH-UPDATE-TRIGGERS. ↩︎
backend/utils/adt/tsgistidx.c, 函数 gtsvector_consistent. ↩︎
backend/utils/adt/tsgistidx.c, 函数 gtsvector_compress. ↩︎
27 SP-GiST
27.1. 总览
SP-GiST 名称中的字母 “SP” 代表 Space Partitioning,即空间划分。此处的 “空间” 指的是任意值域,而不仅仅是日常理解中的空间(例如二维平面)。而 “GiST” 则暗示了与该方法的某种相似性:GiST 和 SP-GiST 都是广义的搜索树,作为各种数据类型索引的框架。
SP-GiST 方法的核心思想是将搜索空间划分为互不重叠的区域,而每个区域本身也可以递归地进一步划分为子区域。这种划分方式生成的是 非平衡树(与 B-树和 GiST 方法不同),可用于实现诸如四叉树(quadtree)、k-维树(k-D tree)或前缀树(trie)等知名结构。 1
通常这类树分支较少,因此深度较大。例如,四叉树的节点最多有四个子节点,而 k-维树的节点仅有两个。当树驻留在内存中时,这并非问题;但对于磁盘上的表示,必须解决一个复杂的问题:如何高效地将节点打包到页面中,以最小化输入/输出操作。B-树和 GiST 无需处理此问题,因为每个树节点恰好占据一个完整的页面。
SP-GiST 树的内部节点包含一个值,该值对应于所有子节点都满足的条件。这种值通常称为 前缀;它在 SP-GiST 中的作用与 GiST 索引中的 谓词 相同。SP-GiST 中的子节点引用可以带有 标签。
叶节点中的元素包含可索引的值(或其一部分)以及相应行版本的标识符。
与 GiST 一样,SP-GiST 访问方法仅实现基本算法,并负责诸如并发访问、锁定和日志记录等底层任务。为了添加新的数据类型和空间划分算法,该方法提供了操作符类接口。操作符类包含大量逻辑,并定义了索引工作的许多方面。
在 SP-GiST 树中的搜索 2 从根节点开始,并以深度优先方式进行。选择有理由进入的节点,是通过一个类似 GiST 中的 一致性 参考函数实现的。对于树的内部节点,该函数返回一组与搜索谓词 一致 的子节点。函数通过检查前缀值和标签来选择节点,而不实际进入它们。对于叶节点,该函数判断该节点中的索引值是否满足搜索谓词。
由于非平衡树中分支深度不同,查找值的时间可能有所差异。
在 SP-GiST 树中插入值时使用两个参考函数。从根节点开始,选择函数 决定一个可能的方案:将新值发送到现有子节点、为它创建一个新子节点,或者(如果值与节点前缀不一致)分裂当前节点。在最终选定的索引叶页面中,可能没有足够的空间,此时 分裂函数 决定哪些节点应移动到新页面。
接下来我将通过具体示例来讨论这些算法。
27.2. 点的四叉树
四叉树(quadtree)用于索引平面上的点。区域通过相对于选定点递归划分为四个部分(象限)。该点称为 质心,作为节点的前缀,即确定子值位置的条件。
根节点将平面划分为四个象限。
然后每个象限进一步划分为其自身的象限。
该过程持续进行,直到获得最终划分。
本例使用基于扩展机场表构建的索引。图中可见,树的分支深度因相应象限中点的密度不同而异。为直观展示,我设置了较小的存储参数 fillfactor 值,使树具有更多层级:(参见 558)(默认值:80)
默认情况下,点类型使用操作符类 quad_point_ops。
操作符类
我已提及 SP-GiST 的主要参考函数:用于搜索的一致性函数,以及用于插入的选择函数和分裂函数。
以下是操作符类 quad_point_ops3 实现的参考函数列表4。所有函数均为必需。
这些函数的含义如下:(psql: \dAp)
配置函数,向访问方法报告操作符类的特性;
插入值时选择节点的函数;
分裂时节点分配的函数;
内部一致性函数,用于判断搜索谓词是否与 内部 节点中的值一致;
叶节点一致性函数,用于判断搜索谓词是否与 叶 节点中的值一致。
除了上述函数外,还有若干可选函数。
操作符类 quad_point_ops 支持与 GiST 共享的策略 5:(参见 562)(psql: \dAo)
例如,使用 “上方” 操作符 >^ 可以查找位于迪克斯顿以北的机场:
现在我们通过一个包含多个点的简单示例,更详细地探讨四叉树的结构与工作原理,该示例我们在讨论 GiST 的章节中已见过。(参见 563)
以下是该情况下平面划分的可能形式:
左图展示了单层树中象限的编号;在后续图示中,我将明确地按从左到右的顺序排列子节点。位于边界上的点归入编号较小的象限。右图展示了最终划分结果。
以下是该示例可能的索引结构。每个内部节点最多引用四个子节点,每条引用均带有象限编号:
页面布局
SP-GiST 树节点与页面之间没有像 B-树和 GiST 索引那样的一一对应关系。由于内部节点通常子节点不多,一个页面需打包多个节点。内部节点存储在一类(内部)页面中,而叶节点则存储在另一类(叶)页面中。
内部页面的索引记录包含用作前缀的值,以及一组指向子节点的引用,每条引用可附带标签。
叶页面的记录由值和表行版本的标识符组成。
属于同一内部节点的所有叶节点存储在同一页面中,并以链表形式连接。如果页面空间不足,链表可被移动到另一页面 6,或发生分裂,但无论如何,链表绝不会跨多个页面断裂。
为节省空间,算法会尽量将新节点放置在已使用的页面中,直到页面填满。服务进程会缓存最近使用的页面编号,并定期将其保存到编号为零的 元页面 中。与 B-树不同,元页面不指向根节点;SP-GiST 的根节点始终位于第一页面。
下图展示了我们示例中树节点在页面上的分布方式。实际上,操作符类 quad_point_ops 并不使用标签。由于子节点数量不超过四个,因此存储一个固定大小的四元素引用数组,其中部分元素可能为空。
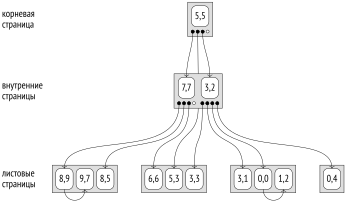
搜索
让我们用同一个例子来考察查找位于点 (3,7) 上方的点的算法。
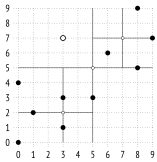
查找从根节点开始。内部一致性函数 9 指明应进入哪些子节点。点 (3,7) 与根节点的质心 (5,5) 进行比较,选择可能包含目标点的象限——本例中为第一象限和第四象限。
在质心为 (7,7) 的节点中,再次选择子节点进入。第一和第四象限适用,但第四象限为空,因此必须检查一个叶节点子节点。使用叶节点一致性函数10 将其点与查询中的点 (3,7) 进行比较。其中只有 (8,9) 满足“上方”条件。
然后返回上一级,检查对应于根节点第四象限的节点。该节点为空,查找结束。
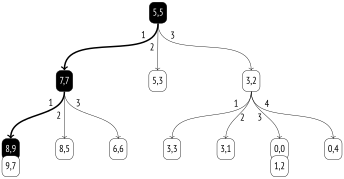
插入
在 SP-GiST 树中插入值时 11,每一步操作由选择函数12 决定。本例中,该函数简单地将新点引导至其所属的现有象限。
例如,添加值 (7,1):
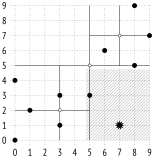
该值属于第二象限,将被添加到树中相应的节点中:
如果值落入叶节点列表过长的象限(必须能容纳在一页内),则发生分裂。分裂函数 13 通过计算所有点坐标的平均值来确定新的质心,从而更均匀地将子节点分配到新的象限。
下图示例中,添加点 (2,1) 导致节点溢出:
在树中添加一个新内部节点,其质心为 (1,1),点 (0,0)、(1,2) 和 (2,1) 被分配到新的象限中:
属性
访问方法级别属性
不支持值的排序和唯一性。也不支持多列索引。
支持排除约束,与 GiST 情况相同。
可以创建带有额外 include 列的 SP-GiST 索引。(v. 14)
索引级别属性
SP-GiST 索引的属性与 GiST 不同,不支持聚簇:
两种版本标识符获取方式(单个标识符和位图)均受支持。SP-GiST 的反向扫描无意义。
列级别属性
大部分列属性保持不变:
不支持排序,所有与排序相关的属性均无意义且被禁用。
到目前为止,我未提及未定义值,但从索引属性可见,它们是受支持的。与 GiST 不同,SP-GiST 索引不将未定义值存储在主树中。为它们创建了单独的树,其根位于索引的第二页。因此,前三个页面始终具有固定含义:元页面、主树根节点和未定义值树根节点。
部分列级别属性可能因操作符类而异:
本例中(如本章其他所有示例),索引仅可用于索引扫描。
但一般情况下,操作符类可能不在叶页面中存储完整值,而是执行表级重新验证。
例如,这使得 SP-GiST 索引可在 PostGIS 中用于潜在的大值类型 geometry。
支持最近邻搜索;在操作符类中我们看到了排序操作符 <->。(v. 12)
27.3. 点的 K 维树
对于平面上的点,可以提出另一种空间划分方式:将平面划分为两部分而非四部分。这种划分使用操作符类 kd_point_ops 14:
请注意,索引值、前缀和标签可以具有不同的数据类型。对于此类操作符类,值为点,前缀为实数,标签不存在(与 quad_point_ops 相同)。
选择坐标轴上的任意一个坐标(例如机场示例中的纬度)。它将平面划分为上下两部分:
对每个区域选择横轴(经度)上的坐标,将区域划分为左右两部分:
我们将继续交替地将每个部分沿水平方向或垂直方向不断分割,直到每个部分中剩余的点数不超过索引页面所能容纳的数量:
通过这种方式构建的树的所有内部节点都只有两个子节点。该方法很容易推广到任意维度的空间,因此这类树在文献中被称为 k-维树(k-D tree)
27.4. 字符串的基数树
SP-GiST 的 text_ops 15 操作符类实现了字符串的前缀树(radix tree)。这里的内部节点的前缀确实是其所有子节点中字符串的共同前缀。
指向树子节点的引用标记了紧随前缀之后的首个字节的值。
为清晰起见,图中我将前缀表示为单个字符,但这仅适用于八位编码。一般情况下,操作符类将字符串视为字节序列。此外,前缀可能包含若干具有特殊含义的其他值,因此实际上前缀占用了两个字节。
子节点中存储的是紧随前缀和标记之后的部分值。叶节点仅保留值的结尾部分。
以下是根据若干名称构建的前缀树示例:
叶节点中索引键的完整值可以通过从树根到该节点路径上所有前缀和标记的拼接来恢复。由于值并非完整存储,而是按需重建,因此前缀树表示有时可能比 B-树更紧凑。
操作符类
text_ops 操作符类支持文本类型(即有序类型)的传统比较操作符:(psql: \dAo)
波浪号操作符与普通操作符不同,它们不处理字符,而是处理字节(类似于 B-树的 text_pattern_ops 操作符类),因此与以字节为标记的前缀树天然兼容。而普通操作符 >= 和 < 则考虑排序规则,必须分析字符。它们仅在使用 “C” 排序规则时才被索引支持。(参见 399)
为加速 LIKE 条件的搜索,操作符类支持 前缀搜索 操作符 ^@:
搜索
以姓名为例,分析以下查询的执行过程:
首先,内部一致性函数 16 在树根处被调用,它必须决定应进入哪些子节点。该函数将前缀 V 与标记 A 和 L 进行拼接。值 VA 被代入查询条件,其中字符串常量被截断,使其长度不超过被检查值的长度:VA ~>=~ 'VA' AND VA ~<~ 'VL'。该条件成立,因此标记为 A 的子节点需要被检查。类似地,VL 也满足条件,因此标记为 L 的节点也需要检查。
现在考虑对应值 VA 的节点。其前缀为空,对于三个子节点,内部一致性函数通过将上一步得到的 VA 与标记拼接,恢复出值 VAD、VAL 和 VAS。条件 VAD ~>=~ 'VAL' AND VAD ~<~ 'VER' 不成立,但另外两个值符合要求。
通过这种方式深入遍历树并舍弃不匹配的分支,算法最终到达叶节点。叶节点一致性函数 17 检查从根到该节点路径上逐步恢复的值是否与原始条件匹配。符合条件的值作为索引扫描的结果返回。
请注意,尽管查询中使用了 B-树常用的“大于”和“小于”操作符,但 SP-GiST 树上的范围搜索效率远低于 B-树。在 B-树中,只需下降到范围的一个端点,然后读取叶页面链即可。
插入
对于点的索引,操作符类选择函数始终可以将新值引导至现有子区域(象限或半区)。但在前缀树中并非如此:新值可能与现有前缀不匹配,此时必须分割内部节点。
以向已有树中添加名称 VLADA 为例。
从树根开始,通过选择函数 18 可以成功下降到一个节点(V + L),但剩余值 ADA 与前缀 ADI 不一致。必须将该节点分割为两个:一个保留最大公共前缀 AD,另一个将剩余前缀下移至下一层:
之后,选择函数在同一节点再次被调用。现在前缀与值匹配,但没有具有合适标记(A)的子节点,因此函数决定创建该节点。最终结果如下面的图所示;图中标记了插入或修改的节点。
属性
我之前已展示过访问方法和索引级别的属性,这些属性不随操作符类的变化而改变。大多数列级别的属性也保持不变。
尽管索引值在树中并未显式存储,但仅索引扫描仍可工作,因为值在从根节点到叶节点的遍历过程中被逐步重建。
然而,字符串的距离操作符未被定义,因此该操作符类不支持最近邻搜索。
这并不意味着无法为字符串定义距离概念。例如,pg_trgm 扩展添加了基于三元组的距离操作符:两个字符串共有的三元组比例越小,它们之间的距离越远。另一种选择是莱文斯坦距离,定义为将一个字符串转换为另一个字符串所需的最少单字符操作次数。计算此类距离的函数存在于 fuzzystrmatch 扩展中。但没有任何扩展提供支持 SP-GiST 的操作符类。
27.5. 其他数据类型
除了上述点和文本字符串的索引示例外,SP-GiST 还实现了其他操作符类。
几何类型。 box_ops 19 操作符类实现了矩形的四象限树。矩形以四维空间中的点表示,因此区域被划分为十六个部分。
poly_ops 操作符类允许索引多边形。这是一个近似操作符类:实际上使用的是多边形的包围矩形,与 box_ops 类似,并在表中进行重新验证。
选择 GiST 还是 SP-GiST 作为访问方法,很大程度上取决于索引数据的类型。例如,PostGIS 文档建议对高度重叠的对象(“面条状”)使用 SP-GiST 20。
范围类型。 范围的四象限树由 range_ops 21 操作符类提供。区间以二维点表示:下界作为横坐标,上界作为纵坐标。
网络地址。 对于 inet 数据类型,inet_ops 22 操作符类实现了前缀树。
postgrespro.ru/docs/postgresql/18/spgist; backend/access/spgist/README. ↩︎
backend/access/spgist/spgscan.c, 函数 spgWalk. ↩︎
backend/access/spgist/spgdoinsert.c, 函数 moveLeafs. ↩︎
backend/access/spgist/spgquadtreeproc.c, 函数 spg_quad_inner_consistent. ↩︎
backend/access/spgist/spgquadtreeproc.c, 函数 spg_quad_leaf_consistent. ↩︎
backend/access/spgist/spgdoinsert.c, 函数 spgdoinsert. ↩︎
backend/access/spgist/spgquadtreeproc.c, 函数 spg_quad_choose. ↩︎
backend/access/spgist/spgquadtreeproc.c, 函数 spg_quad_picksplit. ↩︎
backend/access/spgist/spgtextproc.c, 函数 spg_text_inner_consistent. ↩︎
backend/access/spgist/spgtextproc.c, 函数 spg_text_leaf_consistent. ↩︎
backend/access/spgist/spgtextproc.c, 函数 spg_text_choose. ↩︎
postgis.net/docs/using_postgis_dbmanagement.html#spgist_indexes. ↩︎
28 GIN
28.1. 总览
根据作者的设想,GIN 并非美国的烈性酒,而是一种强大且无畏的精神1。但也有正式的解释:Generalized Inverted Index,即广义倒排索引。
该访问方法适用于那些值由多个元素组成而非原子值的数据类型(例如,在全文搜索的上下文中,文档由词元组成)。与 GiST 中索引整个值不同,GIN 仅索引这些值的元素;通过索引,可以从每个元素跳转到包含该元素的所有值。
对此方法的一个良好类比是书籍末尾的索引。索引中汇集了所有重要术语,并为每个术语列出包含该术语的页面列表。为了便于使用,索引按字母顺序排列,否则将难以快速定位。GIN 也依赖于复合值的元素可以排序这一前提,并以 B-树作为主要数据结构。(参见523)
GIN 的元素树实现比真正的 B-树简单得多,但最初设计时假定不同值由相对较小的、重复出现的元素集合构成。
由此推导出两个重要结论:
- 索引中应仅存储每个元素的一个实例。
每个元素关联一个版本标识符列表。如果该列表(posting list)不足够大,则与元素一同存储;但当列表变大时,可将其移出至单独的 B-树(posting tree)。不仅树是有序的,列表本身也是有序的;虽然这对用户无影响,但有助于加速访问并减少存储空间。
- 从树中删除元素没有意义。
如果某个元素的标识符集合为空,那么该元素很可能在另一个值中再次出现。
因此,索引由元素树构成,其叶节点链接到的是扁平列表或标识符树。
与之前讨论的 GiST 和 SP-GiST 访问方法类似,GIN 可以索引各种类型的数据,通过简化操作符类接口实现。通常,此类操作符检查已索引的复合值是否满足某个元素集合(例如,在全文搜索中,操作符 @@ 检查文档是否匹配查询)。
为了处理特定数据类型,GIN 方法必须能够将复合值分解为词元、对词元排序,并检查找到的值是否匹配查询。这些操作由操作符类的支撑函数实现。
28.2. 用于全文检索的索引
GIN 的主要应用场景是加速全文搜索,因此我将继续在介绍 GiST 索引的章节中开始的示例。显然,在这种情况下,复合值是文档,而这些值的元素是词元。(参见578)
在“在田野里,白桦树……”的表上创建 GIN 索引:(参见579)
该索引的可能结构如图所示:
与之前的插图不同,此处显示并用颜色标出的是具体的标识符值,因为它们对理解算法至关重要。这些值假设表中的行具有以下标识符:
请注意与普通 B-树索引的一些区别。B-树内部节点中最左侧的键为空,因为它是冗余的;而在 GIN 索引中,该键根本不会存储。因此,子节点的引用也相应地发生了偏移。上键在两种索引中均被使用,但在 GIN 中,它位于其合法的最右位置。B-树同一层级的节点通过双向链表连接;而在 GIN 索引中,节点通过单向链表连接,因为树的遍历始终只朝一个方向进行。(参见529)
在我们设想的示例中,所有标识符列表都存放在普通页面中,除了“люл”这个词元的列表。这个词元出现在六个文档中,其标识符被移至单独的树中。
页面布局
从页面组织角度看,GIN 与 B-树非常相似。可以使用 pageinspect 扩展查看索引内部结构。在 pgsql-hackers 邮件列表表上创建 GIN 索引:(参见584)
第零页(元页面)包含总体统计信息,例如元素数量和其他类型页面的数量:
GIN 使用索引页面的专用区域来保存页面类型标志位等信息:(参见76)
带有 meta 标志的页面当然是元页面。带有 data 标志的页面属于标识符树,而没有该标志的页面则属于元素树。在树内部,还区分出带有 leaf 标志的叶页面。
pageinspect 扩展的另一功能可提供树叶页面中存储的标识符信息。实际上,每个此类树的记录包含的不是一个标识符,而是一个小列表:
列表中的标识符是有序的,这使得数据可以压缩(因此带有 compressed 标志)。不再存储六字节的 tid 值,而是存储与前一个值的差值,并以可变字节数编码2:差值越小,数据占用的空间就越少。
操作符类
GIN 操作符类的支撑函数列表如下3:(psql: \dAp)
第一个支撑函数用于比较两个元素,本例中即词元。如果词元由具有 B-树操作符类的 SQL 类型表示,则 GIN 会自动使用该类中的比较操作符。(参见546)
第五个(可选)函数用于部分搜索,检查索引元素与查询键的部分匹配。在本例中,部分搜索即按前缀查找词元。例如,查询「п:*」将匹配所有以「п」开头的词元。
第二个函数从文档中提取词元,第三个函数从搜索查询中提取词元。需要不同的函数至少是因为文档和查询分别以 tsvector 和 tsquery 类型表示。此外,查询函数还定义了搜索的执行方式。如果查询要求文档中包含任意一个词元,则搜索将考虑包含查询中至少一个词元的文档。如果不存在此类条件(例如,需要的是不包含特定词元的文档),则将考虑所有文档——这显然代价更高。(v. 13)
当查询中包含其他搜索键时,索引首先按这些键扫描,然后对结果进行重新验证。这可以避免对索引的无谓遍历。
第四和第六个函数是一致性函数,用于判断找到的文档是否与搜索查询匹配。第四个函数接收关于查询中哪些词元存在于文档中、哪些不存在的精确信息。第六个函数在不确定条件下工作,可能在部分词元是否存在于文档中尚不明确时被调用。操作符类不必实现两个函数:只需提供其中一个即可,但此时搜索效率可能下降。
操作符类 tsvector_ops 仅支持一个文档与搜索查询匹配的操作符4 @@——与 GiST 操作符类所包含的完全相同。
搜索
考虑执行查询「стояла | кудрявая」的过程,其中两个词元通过「或」条件连接。首先,使用支撑函数5 从 tsquery 类型的搜索查询中提取出单独的词元(即搜索键):「стоя」和「кудряв」。
由于查询要求特定词元的存在,将生成一个包含至少一个查询键的文档的标识符列表。为此,需在词元树中查找每个搜索键对应的标识符,并将它们合并为一个总列表。由于索引中所有标识符都是有序存储的,因此可以使用多个已排序的标识符流合并为一个流6。(参见483)
请注意,目前尚不重要的是这些键是通过「与」、「或」还是其他条件连接的——树搜索引擎仅处理键列表,而对搜索查询的语义一无所知。
每个匹配文档的标识符都会通过一致性支撑函数7 进行验证。该函数恰好知道如何解释搜索查询,并仅保留与查询匹配(或至少可能匹配,需要回表验证)的标识符。
在本例中,一致性函数将保留所有标识符:
| tid | «стоя» | «кудряв» | 一致性函数 |
|---|---|---|---|
| (0,1) | ✓ | – | ✓ |
| (0,2) | ✓ | ✓ | ✓ |
| (0,3) | ✓ | – | ✓ |
| (0,4) | ✓ | – | ✓ |
| (1,2) | – | ✓ | ✓ |
搜索查询中可以指定前缀而非完整词元。这在用户可能仅输入单词的前几个字母并期望获得结果时非常有用。例如,对于查询「залом:*」,将找到以「залом」开头的词元的文档:「залома」(由「заломаю」生成)和「заломат」(由「заломати」生成)。
在进行此类部分搜索时,索引中的词元通过单独的支撑函数8 与搜索键进行比较,该函数在一般情况下可实现不仅限于前缀匹配,还可实现其他部分匹配逻辑。
频繁和罕见的词素
如果搜索查询中使用的词元出现频率较高,生成的版本标识符列表将非常长,这显然代价高昂。幸运的是,如果查询中同时包含稀有词元,通常可以避免这种情况。
考虑执行查询「люли & заломаю」。词元「залома」出现三次,而「люл」出现六次。与其将两个词元视为同等重要并收集两者的完整标识符列表,不如将稀有词元「залома」视为必需项,而将较频繁的词元「люл」视为附加项,因为(考虑到查询语义)可以明确,仅当文档同时包含「залома」词元时,包含「люл」词元的文档才符合查询要求。
因此,首先通过索引确定包含「залома」的第一个文档;其标识符为(2,2)。接下来需要判断该文档是否包含词元「люл」,但所有标识符小于(2,2)的文档可直接跳过。由于频繁词元对应大量标识符,它们很可能存储在单独的树中,从而可以跳过部分页面。在本例中,对「люл」词元树的搜索从(2,2)开始,第一个找到的文档标识符为(2,3)。
该过程对下一个必需词元的值重复执行。
标识符列表的长度将等于三个,即稀有词出现的次数:
| tid | «залома» | «люл» | 一致性函数 |
|---|---|---|---|
| (2,2) | ✓ | – | – |
| (2,3) | ✓ | ✓ | ✓ |
| (2,4) | ✓ | ✓ | ✓ |
因此,了解词频可以以最有效的方式组织合并过程,从稀有词开始,并跳过在频繁词树中明显不必要的页面范围。这种优化也减少了对一致性函数的调用次数。(参见 360)
当然,这种优化不仅适用于两个词,也适用于更复杂的情况。在索引中进行搜索时,必需词应被选择为确保不会遗漏任何符合查询条件的文档。算法将词按从稀有到频繁的顺序排序,然后逐个将它们添加到必需词列表中,直到满足条件为止。剩余的词被视为可选词9。
例如,考虑查询「заломати & ( некому | белую )」。最稀有的词是「бел」,它立即被添加到必需词列表中。是否存在一种情况:文档不包含任何必需词,但仍符合查询?为了验证这一点,将虚假值传递给必需词,而将真值传递给其余词。在这种情况下,一致性函数返回 true AND (true OR false) = true,这意味着部分文档可能被遗漏,因此必需词集合必须至少扩展一个剩余词。
接下来将频率第二高的词「нек」添加到必需词列表中,此时一致性函数返回 true AND (false OR false) = false。因此,词「бел」和「нек」成为必需词,而「заломат」成为可选词。
为了验证这种优化的有效性,我们使用 pgsql-hackers 邮件列表存档。我们需要两个词:一个常见词和一个稀有词:(参见 584)
实际上,存在一个文档同时包含这两个词:
查询的执行速度几乎与搜索单个词「tattoo」一样快:
而搜索单个词「wrote」则明显慢得多:
插入
向 GIN 索引中添加元素时10,现有元素不会被重复存储;相反,现有元素的标识符集合(列表或树)会被扩展。标识符列表是索引行的一部分,不能占用页面上过多空间,因此当列表溢出时,它会被转换为树结构11。
在向树中插入新元素(或新标识符)时,可能会导致页面溢出;此时页面会被分裂为两个,元素会在它们之间重新分配12。
但通常每个文档包含大量需要索引的词。因此,创建或修改单个文档时,必须同时对索引树进行大量更改。由于这一原因,GIN 索引的更新相对缓慢。
图中显示了在表中插入标识符为 (4,1) 的行「Некому заломати белую березу」后的树状结构。词「бел」、「берез」和「нек」的标识符列表已扩大,而词「заломат」的列表超过了最大尺寸,因此被单独分配为一棵树。
另一方面,如果在索引中同时考虑多个文档的更改,与逐个更改相比,总体工作量可能减少,因为不同文档的词很可能存在重叠。
这种延迟更新模式通过存储参数 fastupdate 启用。在此模式下,更改会累积到一个单独的无序列表中,该列表在物理上存储在树外的独立页面(列表页面)中。当该列表变得足够大时,所有累积的更改会一次性应用到索引中,然后列表被清空13。列表的最大大小由参数 gin_pending_list_limit 或同名的索引存储参数决定。(默认值:on)(参见 296)(默认值:4MB)
默认情况下,延迟模式已启用,但需要注意的是,它会减慢搜索速度:除了树之外,还必须扫描整个无序列表。此外,插入时间变得不可预测,因为每次更改时列表可能溢出,需要执行代价高昂的合并操作。最后一点部分被以下事实缓解:合并操作也发生在索引清理过程中,即异步执行。
创建新索引14时,元素也不是逐个添加的(那样太慢),而是以延迟方式添加。与磁盘上的无序列表不同,更改在大小为 maintenance_work_mem 的内存区域中累积,并在溢出时一次性写入索引。分配给该操作的内存越多,索引构建速度就越快。(默认值:64MB)
本节中的示例表明,GIN 在搜索精度方面优于 GiST 签名树。因此,在大多数情况下,GIN 被用于支持全文搜索。然而,GIN 更新缓慢的问题可能会影响选择,当数据频繁更改时,可能会倾向于选择 GiST。(参见 578)
限制结果集大小
GIN 访问方法始终以位图形式返回结果;无法逐个获取表标识符。换句话说,支持 BITMAP SCAN 属性,但不支持 INDEX SCAN。(参见 409)
原因在于存在无序的延迟更改列表。在索引访问时,首先扫描列表并生成位图,然后用树中的数据更新位图。如果在搜索过程中无序列表与树合并(例如索引更新或清理过程中),同一个值可能会被获取两次,这是不允许的。但在位图情况下,这没有问题:同一个位被设置两次也无妨。
因此,使用 GIN 索引时,通过 LIMIT 子句限制结果集并不完全高效,因为位图无论如何都会完全构建,其构建成本可能占总成本的很大一部分:
因此,GIN 方法具有特殊功能,可以限制从索引中获取的结果数量。该限制由参数 gin_fuzzy_search_limit 设置,默认不生效。如果启用此参数,索引方法将随机跳过某些值,以获得大约指定数量的行15(因此称为 fuzzy):(默认值:0)
请注意查询中没有 LIMIT 子句。这是在索引访问和表访问中获取不同数据的唯一“合法”方式。规划器对此 GIN 索引的特性一无所知,也不会在成本计算中考虑该参数的值。
属性
访问方法 gin 的所有层级属性都相同,且不依赖于特定的操作符类。
访问方法层级属性
GIN 不支持值的排序或唯一性。
支持复合索引的创建。有趣的是,对于 GIN,索引中列的顺序无关紧要。与普通 B-树不同,多列 GIN 索引不存储复合键,而是存储单独的元素,并附加列号信息。
不支持排除约束,因为不支持 INDEX SCAN 属性。
GIN 不支持额外的 include 列。这在逻辑上也无意义,因为 GIN 索引几乎不可能作为覆盖索引使用:索引值存储在表中,而索引仅包含该值的元素。
索引层级属性
不支持逐个返回结果,索引访问始终返回位图结果。
因此,对 GIN 索引进行排序表没有意义:位图在定义上对应于表中数据的物理位置,无论其如何排列。
不支持反向扫描 GIN 索引:此功能仅对索引扫描有意义,而对位图扫描无意义。
列层级属性
列层级属性均不可用:既不支持排序(显而易见),也不支持将索引用作覆盖索引(因为文档本身不存储在索引中),也不支持处理空值(对非原子类型元素无意义)。
GIN 的限制和 RUM 索引
尽管 GIN 功能强大,但并不能解决全文搜索的所有问题。在 tsvector 数据类型中存在词的位置信息,但这些信息不会进入索引。这使得 GIN 无法高效支持短语搜索(即考虑词的接近性)。此外,搜索系统通常按相关性顺序返回结果(无论该术语具体含义如何)。由于 GIN 不支持排序操作符,唯一的方法是为每个结果行计算排名函数,这显然很慢。
这些缺点在 RUM 索引方法中得到了解决,其名称让人怀疑开发者对 GIN 缩写含义的真诚度。RUM 是一个外部访问方法;该扩展既可通过 PGDG 仓库16的包形式获取,也可通过源代码17获取。
RUM 基于 GIN 构建,与 GIN 有两个根本性区别。首先,它放弃了延迟更新模式;通过这一改进,不仅支持位图扫描,还支持常规索引扫描,并实现了排序操作符。其次,可以在索引键上附加辅助信息。这在某种程度上类似于额外的 include 列,但信息与特定键绑定。在全文搜索的上下文中,RUM 操作符类将词的出现位置与文档中的位置关联起来,从而加速短语搜索和按相关性排序的结果输出。
这种方法的缺点是更新速度慢且索引体积增大。此外,作为扩展,rum 索引方法使用统一日志记录机制18,其性能低于内核内置的日志记录机制,并生成更多 WAL 数据。
28.3. 三元组
扩展 pg_trgm19 允许通过比较三字母序列(即“三元组”)的匹配数量来判断词语的相似性。它可与全文搜索结合使用,即使在输入有拼写错误的词时也能找到变体。
操作符类 gin_trgm_ops 实现了对文本字符串的索引,但文本值的元素不是词或词元,而是所有可能的三字符子串(仅使用字母和数字,其他字符被忽略)。在索引内部,三元组以整数形式表示:对于 UTF-8 编码中占两个字节的俄文字母,这种编码无法还原原始字符。因此,我将在使用八位编码的数据库中展示三元组的生成方式:
该操作符类支持字符串和词的精确与模糊比较操作符。
对于模糊比较,可以将字符串之间的距离定义为匹配三元组数量与查询字符串中三元组总数的比值。但如前所述,GIN 索引不支持排序操作符,因此类中所有操作符必须为布尔型。因此,对于实现模糊比较策略的 %、%> 和 %>> 操作符,一致性函数计算距离,并在距离不超过设定阈值时返回真值。(psql: \dAo)
对于 = 和 LIKE 操作符,一致性函数要求值中包含查询字符串中的所有三元组。正则表达式匹配的检查要复杂得多。
无论如何,基于三元组的搜索都是不精确的,并且始终需要通过表进行重新验证。
28.4. 索引数组
另一个适合的类型示例是数组。基于数组元素的 GIN 索引可以更快地查找数组交集以及一个数组是否包含在另一个数组中:
以 demo 数据库中的 routes 视图为例,该视图包含航班信息。days_of_week 列存储了航班运行的星期几编号数组。当然,要建立索引,必须将该视图「物化」:(psql: \dAo)
使用创建的索引,例如可以筛选出在星期二、星期四和星期日出发的航班。我禁用了顺序扫描,因为否则规划器不会为这么小的表使用索引:
结果发现共有十一个这样的航班:
所构建的索引仅包含七个元素:代表星期几的整数 1 到 7。
查询的执行方式与我之前展示的全文搜索类似。在这种情况下,搜索查询不是通过特殊数据类型表示,而是通过普通数组;该查询意味着在被索引的数组中必须包含所有列出的元素。重要区别在于,等于 条件还要求被索引的数组不包含任何其他元素。一致性函数 20 通过策略编号了解这一特性,但无法确认不存在多余元素,因此要求索引机制重新验证结果:
扩展 GIN 索引,添加其他列可能很有用。例如,要查找从莫斯科出发且在星期二、星期四和星期日出发的航班,索引中缺少 departure_city 列。然而,对于普通标量数据类型,未提供操作符类:
在这种情况下,btree_gin 扩展可提供帮助。它添加了 GIN 操作符类,模拟普通 B-树的行为,将标量值视为包含一个元素的复合值。(参见 573)
关于 btree_gist 扩展的评论依然成立:B-树在支持比较操作方面效率高得多,因此仅在确实需要 GIN 索引时才应使用该扩展。例如,B-树中「小于」或「小于等于」的查询通过反向扫描叶页面实现,而 GIN 不支持此类操作。
28.5. 索引 JSON
另一个具有内置 GIN 支持的非原子数据类型是 jsonb21。为 JSON 提供了一整套操作符,其中部分操作符可通过 GIN 索引加速。
存在两个操作符类,它们从 JSON 文档中提取不同的元素集合:
jsonb_ops 操作符类
第一个操作符类 jsonb_ops 是默认使用的。索引中作为元素包含原始 JSON 文档中的所有键、所有值以及所有数组元素22。这有助于加速包含 JSON 值的查询(@>)、键的存在性查询(?、?| 和 ?&)以及 JSON 路径匹配查询(@? 和 @@):(psql: \dAo)
以 routes 表中的几行数据为例,将其表示为 JSON 格式:
所创建的索引可以如下表示:
考虑查询条件 route @> '{"days_of_week": [6]}',该条件筛选出包含指定路径的 JSON 文档(即在星期六运行的航班)。
从 JSON 值表示的搜索查询中,基础函数 23 提取搜索键:「days_of_week」和「6」。这些键在元素树中被查找,包含至少一个搜索键的文档将由一致性函数24 进行检查。对于「包含」策略,函数要求搜索查询中的所有键都必须存在,但结果仍需通过表重新验证,因为从索引角度看,指定路径可能对应文档 {"days_of_week": [2], "foo": [6]}。
jsonb_path_ops 操作符类
第二个操作符类 jsonb_path_ops 包含更少的操作符:(psql: \dAo)
在这种情况下,索引中并非存储分散的 JSON 片段,而是从文档根到所有值和所有数组元素的完整路径25。这使得搜索更加精确和高效,但无法加速以非路径作为参数的操作。
由于路径可能相当长,实际上索引的不是路径本身,而是其哈希函数值。
为同一张表创建使用此操作符类的索引:
可以这样表示所创建索引的树结构:
在执行相同条件 route @> '{"days_of_week": [6]}' 的查询时,基础函数 26 从搜索查询中提取的不是单独的片段,而是整个路径「days_of_week, 6」。在元素树中立即找到两个匹配文档的标识符。
当然,在这种情况下,找到的记录仍需由一致性函数 27 检查,然后由索引机制根据表重新验证(至少由于哈希冲突的可能性)。但树中搜索的效率要高得多,因此只要查询操作符支持,应始终选择 jsonb_path_ops 类。
28.6. 索引其他数据类型
以下是为某些数据类型添加 GIN 支持的其他扩展。
整数数组。 扩展 intarray 添加了整数数组的操作符类 gin__int_ops。它几乎与标准操作符类 array_ops 相同,但支持搜索查询匹配操作符 @@。
键值存储。 扩展 hstore 实现了键值对存储,并提供了操作符类 gin_hstore_ops。索引中包含键和值。
JSON 查询语言。 第三方扩展 jsquery 提供了自定义查询语言,并支持 JSON 的 GIN 索引。
随着 SQL:2016 标准的采纳以及 PostgreSQL 中 SQL/JSON 路径语言的实现,标准功能显得更具优势。(v. 12)
postgrespro.ru/docs/postgresql/18/gin; backend/access/gin/README. ↩︎
postgrespro.ru/docs/postgresql/18/gin-extensibility; backend/utils/adt/tsginidx.c. ↩︎
backend/utils/adt/tsvector_op.c, 函数 ts_match_vq. ↩︎
backend/utils/adt/tsginidx.c, 函数 gin_extract_tsquery. ↩︎
backend/access/gin/ginget.c, 函数 keyGetItem. ↩︎
backend/utils/adt/tsginidx.c, 函数 gin_tsquery_triconsistent. ↩︎
backend/utils/adt/tsginidx.c, 函数 gin_cmp_prefix. ↩︎
backend/access/gin/ginget.c, 函数 startScanKey. ↩︎
backend/access/gin/gininsert.c, 函数 ginEntryInsert. ↩︎
backend/access/gin/gininsert.c, 函数 addItemPointersToLeafTuple. ↩︎
backend/access/gin/ginbtree.c, 函数 ginInsertValue. ↩︎
backend/access/gin/ginfast.c, 函数 ginInsertCleanup. ↩︎
backend/access/gin/gininsert.c, 函数 ginbuild. ↩︎
backend/access/gin/ginget.c, 宏 dropItem. ↩︎
backend/access/gin/ginarrayproc.c, 函数 ginarrayconsistent. ↩︎
backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb. ↩︎
backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb_query. ↩︎
backend/utils/adt/jsonb_gin.c, 函数 gin_consistent_jsonb. ↩︎
backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb_path. ↩︎
backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb_query_path. ↩︎
backend/utils/adt/jsonb_gin.c, 函数 gin_consistent_jsonb_path. ↩︎
29 BRIN
29.1. 总览
与其他索引不同,BRIN 1 并非用于快速查找所需行,而是为了避免查看那些显然不需要的行。该访问方法是为大小在数TB和数十TB级别的表设计的,因此在精度和较小的存储开销之间更倾向于选择较小的存储开销。
为了加速查找,整个表被划分为若干个 区域(range),每个区域大小为若干页面。因此得名:Block Range Index,即 BRIN。该索引不存储行版本标识符,仅保留每个区域中数据的汇总信息。对于有序数据类型,在最简单的情况下,这包括最小值和最大值,但不同的操作符类可以收集区域中值的其他信息。
每个区域中的页面数量在创建索引时通过存储参数 pages_per_range 设置。(默认值: 128)
在执行包含对已索引列进行条件判断的查询时,可以完全跳过所有值显然不满足查询条件的区域。其余区域的所有页面由索引以 不精确的位图 形式返回;这些页面上的所有行将被检查是否满足条件。(参见 428)
因此,BRIN 适用于值具有局部特性的列,即存储在相邻位置的值在汇总信息意义上具有相似的属性。对于有序数据类型,这意味着值在表中应按升序或降序物理排列,即具有较高的 相关性,其物理位置与由「大于」和「小于」操作定义的逻辑顺序一致。对于其他类型的汇总信息,对「相似属性」的要求可能有所不同。(参见 361)
将 BRIN 视为传统意义上的索引是错误的,它更应被视为一种加速表顺序扫描的机制。也可以将其看作一种类似分区的机制,将每个区域视为一个独立的「虚拟」分区。
29.2. 样例
在演示数据库中没有足够大的表来使用 BRIN,但可以设想,为了满足分析报表的需求,需要一个去规范化的表,其中包含从机场起飞和抵达机场的航班信息,精确到客舱座位。每个机场的数据在对应时区午夜时分添加到表中一次。添加后,数据不再被修改或删除。
该表的结构如下:
可以通过嵌套循环 2 模拟数据加载过程:外层循环按天数(演示数据库中存储了一年的数据),内层循环按时区。这样填充后,表中的数据至少在时间和机场地理分布上会呈现出一定程度的有序性,尽管循环内部的查询中没有显式排序。
我将直接加载一个已准备好的表副本,其大小约为 4 GB,包含约 3000 万行 3:
这样的数据量虽然不算大,但足以用来研究 BRIN 的工作原理。我将预先创建一个索引:
使用默认参数时,它所占空间非常小。
即使考虑到重复值的紧凑存储,B-树索引的大小也是一千倍以上。当然,这种索引的效率也显著更高,但对于真正超大规模的表,额外的存储开销可能成为不可接受的奢侈。(v. 13)
29.3. 页面布局
BRIN 索引的第零页是 元页,包含索引结构信息。
在元数据之后,是存储 汇总信息 的页面。每页上的每个索引行包含某一特定区域的汇总信息。
在元页和汇总信息之间是 区域映射(range map),有时也称为 反向映射(reverse range map,因此常简称为 revmap)。本质上,这是一个指向相应索引行的指针数组;数组中的位置编号等于区域编号。
当表扩展时,区域映射的大小也随之增加。如果映射无法再容纳在分配的页面中,它将扩展到下一页,而原来页中的所有索引行将被移动到其他页面。由于每页可容纳大量指针,此类移动很少发生。
BRIN 索引页面可像通常一样使用 pageinspect 扩展进行分析。元信息显示了区域大小和用于区域映射的页面数量:
此处区域映射占用了四页,从第一页到第四页。可以获取指向汇总信息索引记录的引用:
如果某个区域尚未汇总(即该区域没有汇总信息),映射中的指针将为空。
以下是几个前几个区域的汇总信息:
29.4. 搜索
在对 BRIN 索引支持的条件进行搜索时,会检查区域映射和每个区域的汇总信息。如果区域中的数据可能匹配搜索键,则该区域的所有页面将被添加到位图中。由于索引不存储单个行的标识符,位图最初是以页面为单位构建的。 4
数据与键的匹配性由支持的 一致性函数 判断,该函数理解汇总信息的含义。当然,没有汇总信息的区域始终会被添加到位图中。
最终生成的位图将用于以常规方式扫描表。重要的是,表页面以连续块的形式读取,并使用预读机制。(参见 427)
29.5. 摘要信息更新
插入值
当新行版本被插入表页面时,相应区域索引中的汇总信息将被更新5。区域编号通过简单的算术运算从页面编号计算得出,并通过区域映射读取汇总信息。
是否需要扩展现有汇总信息,由支持的 值添加函数 决定。如果需要扩展,且页面上有足够空间,则会就地进行扩展(无需创建新的索引行)。
例如,假设在第 13 页出现了一条值为 42 的行版本。区域编号(从零开始)通过将页面编号除以区域大小计算得出。假设区域大小为 4 页,则得到区域编号 3,从区域映射中获取第四个指针。该区域的最小值为 31,最大值为 40。新值超出此范围,因此最大值被更新:
如果就地更新不可行,则创建新行,此时区域映射将被修改。
范围提要
上述内容适用于新行版本出现在已有汇总信息的区域的情况。在构建索引时,所有现有区域都会被汇总,但在表后续增长过程中,可能会出现超出此范围的新页面。
如果创建索引时使用存储参数 autosummarize,则新区域将立即被汇总。但由于数据仓库中通常以大批次而非单条方式添加行,这种模式可能会显著减慢插入速度。(默认值: off)
默认情况下,新区域不会立即汇总。这不会破坏索引的正确性,因为没有汇总信息的区域将被完全扫描。汇总操作在表清理时异步执行,或可手动调用 brin_summarize_new_values 或 brin_summarize_range(针对单个区域)函数来触发。(参见 142)
区域汇总 6 不会阻塞表中的数据变更。首先在索引中插入一个占位符行(placeholder)。如果在区域扫描期间数据发生变化,占位符将被更新,包含变更后的汇总信息。随后,该行中的数据将通过支持的 合并函数 与区域计算出的汇总信息合并。
在从表中删除行时,汇总信息本可能收缩。但在 GiST 索引中,页面分裂时至少会重新计算一次,而 BRIN 索引中的汇总信息只会扩展,从不收缩。通常这并非必要,因为数据仓库通常仅用于数据插入。当然,可以手动调用 brin_desummarize_range 函数删除汇总信息,并重新汇总区域。但没有任何提示说明哪些区域的重新汇总可能有益。(参见 557)
因此,BRIN 主要针对非常大的表设计,这些表要么不更新,要么更新极少,因此新行通常被添加到文件末尾。其主要应用场景是数据仓库和分析报表。
29.6. Minmax 类
对于可相互比较的值的数据类型,最简单的汇总信息由最小值和最大值组成。相应的操作符类名称中包含 minmax 一词 7:(psql: \dAc)
这些操作符类的支持函数:(psql: \dAp)
第一个函数返回操作符类的元信息,其余函数我已描述过:即值添加函数、一致性函数和合并函数。
minmax 类使用与 B-树相同的比较操作符:(参见 546)(psql: \dAo)
选择要索引的列
哪些列适合使用此类操作符构建 BRIN 索引?我之前提到过,索引效果良好当行的物理位置与值的逻辑顺序相关时。
我们将在前面准备的例子中验证这一点。
数据按时间顺序排列(无论是计划时间还是实际时间,差异微不足道),因为数据是按时间顺序添加的,且由于没有删除和更新,行在表主层文件中顺序存储,一个接一个。(参见 29)
列 fare_conditions、flight_type 和 airport_utc_offset 显示出相对较高的相关性,但它们的唯一值太少。
其他列的相关性太低,因此使用范围操作符类索引并无意义。
范围大小与搜索效率
确定合适区域大小的提示可以是:值出现的页面数量。
考虑时间调度 scheduled_time,并假设查询按航班选择一天的数据。计算表中一天数据占用多少页面。
为此,我们将利用行版本标识符由页面号和偏移量组成这一事实。不幸的是,没有标准方法可以将标识符分解为两个组成部分,因此必须编写一个不够美观的函数,通过文本表示进行类型转换:
现在可以查看一天数据在表中的分布情况了:
可以看出,分布并不完全均匀。在标准区域大小为 128 页的情况下,每天的数据将占用 9 到 12 个区域。获取一天数据时,扫描将不仅包含所需行,还会包含落入相同区域的其他天的部分行。区域越大,读取的多余边界值就越多;通过增大或减小区域大小,可以增加或减少这些值的数量。
尝试执行一个查询,选取某一天的数据(我已在上文创建了默认参数的索引)。为简化画面,我将禁用并行执行:
可以将某个查询的 BRIN 索引的 利用率 定义为索引扫描中跳过的页面数量与表中总页面数量的比值。当利用率(KPD)为零时,索引访问退化为顺序扫描(不考虑开销)。利用率越高,需要读取的页面就越少。但部分页面包含所需数据,这些数据无法跳过,因此利用率始终小于 1。(参见 436)
本例中,利用率为 ≈ 0.997,其中 528,417 是表中的页面数量。
然而,仅凭一个数值得出结论毫无意义。即使原始数据均匀且具有理想相关性,效率也会因区域边界位置不同而有所差异。只有将利用率视为随机变量并研究其分布,才能获得完整图景。
对于本例,可以取一年中所有不同的天数,检查每个值的执行计划,并计算所得样本的统计指标。该过程易于自动化,可利用 EXPLAIN 命令以 JSON 格式输出结果,便于处理。我不会提供完整代码,但以下小片段包含所有关键细节。
结果可通过称为“箱线图”(或“箱须图”)的图表直观展示。须线表示第一和第四四分位数(即右侧须包含 25% 最大值,左侧须包含 25% 最小值)。箱体包含其余 50% 的值,其中还标出了中位数。重要的是,这种紧凑的图像便于直观比较结果。图中展示了默认区域大小及另外两个相差四倍的区域大小下的利用率分布:
正如预期,即使区域较大,查找的精度和效率也依然很高。
图中虚线表示基于一天数据约占表的 的假设,该查询的最大可能利用率的平均值。请注意,效率提升并非免费:随着效率提高,索引大小也随之增加。BRIN 可灵活地在两者之间找到折中方案。
属性
BRIN 的特性是恒定的,不依赖于特定的操作符类。
访问方法级别特性
排序和唯一性支持显然不存在。由于 BRIN 索引始终返回位图,因此不支持排除约束。附加的 include 列也无意义,因为索引中甚至不存储索引键本身。
但可以创建复合 BRIN 索引。此时,每个列的汇总信息分别收集并保存在独立的索引行中,但区域关联保持一致。当所有列使用相同区域大小时,这种索引才有意义。
作为复合索引的替代方案,可以为各个列分别创建 BRIN 索引,并利用位图可组合的特性。(参见 429)
例如:
大型表的 BRIN 索引可以并行创建。多个进程扫描表,各自计算其数据部分的汇总信息。这些信息按区域排序(分配内存大小为 maintenance_work_mem),随后由主进程聚合并生成索引8。(v. 17)(参见 552)(默认值:64MB)
索引级别特性
显然,仅支持基于位图的扫描。
缺乏聚簇可能引起一些困惑。由于 BRIN 索引对行的物理顺序敏感,似乎应支持重排顺序以最大化索引效率。但无论如何,大型表的聚簇代价过高,考虑到所需工作量和重建期间的磁盘空间消耗。此外,如 flights_bi 表的示例所示,数据仓库中某些有序性可能自然形成。
列级别特性
列级别特性仅包括对 NULL 值的支持。区域中存在 NULL 值会在汇总信息中以单独标志记录: NULL
29.7. 多范围值(minmax-multi)
很容易通过修改数据破坏已建立的相关性。问题不在于修改某个特定值,而在于多版本机制:旧行版本在某一页被删除,而新版本可能插入到另一页。因此,行版本在更新时发生混杂。(v. 14)(参见 80)
部分可通过减小存储参数 fillfactor 来缓解此现象,以在页面中为未来更新预留空间。但是否愿意增加本已庞大的表的体积?此外,删除操作仍会释放现有页面内的空间,从而为新行制造“陷阱”,否则新行将被插入文件末尾。
这种情况很容易模拟。首先删除 0.1% 的随机行,并执行清理以释放空间供新版本使用:
然后为某个时区添加一天的新数据。我只需复制前一天的数据,并将日期加一:
删除的行数量足以使每个或几乎每个区域都出现空位。新行落入内部页面后,自动扩展了值范围。以下是第一区域的汇总信息:之前它仅覆盖不到一天的数据,现在则覆盖整整一年:
查询中使用的日期越小,需要遍历的区域就越多。图表展示了问题的严重性:
为解决此问题,需增强汇总信息:不再存储单一连续范围,而是存储多个范围,共同覆盖所有值。这样,一个范围可覆盖主要数据集,其他范围则覆盖个别异常值。
这正是名称中包含 minmax_multi 的操作符类所实现的功能 9:(psql: \dAc)
与 minmax 操作符类相比,minmax_multi 类额外增加了用于计算两个值之间距离的函数——该函数用于确定范围长度,操作符类试图最小化该长度:(psql: \dAp)
此类操作符包含的操作符与 minmax 类完全相同。
多范围类可接受参数 values_per_range,用于定义单个区域中最多可存储的汇总值数量。表示范围需两个值,表示单点仅需一个值。当值不足时,部分区间将“坍缩”10。(默认值:32)
用多范围索引替代现有索引。为示例起见,限制为 16 个汇总值:
图表显示,新索引的查找效率已恢复至旧值——当然,代价是索引大小增加:
29.8. Inclusion 类
范围类与覆盖类之间的差异,类似于 B-树与 GiST 之间的差异:后者专为不支持比较操作但具有相对位置意义的数据类型设计。覆盖类操作符的汇总信息以包含区域内所有值的区域表示。
这些覆盖类操作符数量不多:(psql: \dAc)
在基础函数基础上,增加了合并两个值的函数以及若干可选函数:(psql: \dAp)
对于支持比较操作符的值,我们可基于相关性统计得出结论;但对于其他类型数据,此类统计不被收集 11。因此,很难预先预测覆盖类 BRIN 索引的性能。
更糟的是,相关性显著影响索引扫描成本估算。若缺乏此类统计,其值被默认视为零12。因此,规划器无法区分精确与不精确的 inclusion 索引,通常拒绝使用它们。(v. 3.1.1)
PostGIS 会收集空间数据的相关性统计信息。
在我们的示例中,我们可以假设机场坐标索引是有意义的,因为经度应当与时区相关。
与 GiST 谓词不同,BRIN 的汇总值与索引数据具有相同类型,因此无法直接为点创建索引。但我们可以创建基于表达式的索引,将点转换为退化的矩形:
时区索引使用相同大小的区域所占用的空间大约相同——3288 KB。
属于该类的运算符与 GiST 类的运算符相对应。例如,可以使用索引加速在指定区域中查找点的操作:
但正如我所说,计划器拒绝在不关闭顺序扫描的情况下使用索引:
29.9. 布隆过滤器(bloom)
基于布隆过滤器的运算符类允许对任何定义了「等于」操作且具有哈希函数的数据类型使用 BRIN。当值集中在特定区域但其位置与逻辑顺序无关时,这类运算符类对普通有序类型也十分有用。(v. 14)
此类运算符类的名称包含单词 bloom 13:(psql: \dAc)
经典的布隆过滤器是一种数据结构,可快速判断元素是否属于某个集合。该过滤器非常紧凑,但允许出现误报(false positive),即可能将不属于集合的元素错误地判定为属于集合。重要的是,不会出现漏报(false negative):如果元素实际上存在于集合中,过滤器绝不会判断其不存在。
布隆过滤器表现为一个长度为 m 位的位数组(也称为 签名),初始时全部填充为零。选择 k 个不同的哈希函数,将集合中的任意元素映射到签名中的 k 个位。向集合中添加元素的操作等价于将这些位设置为 1。因此,如果与元素对应的全部位均为 1,则该元素 可能 存在于集合中;如果其中任意一位为 0,则该元素肯定不存在于集合中。
对于 BRIN 索引,过滤器会处理特定区域内包含的索引列的多个值;该区域的汇总信息由构建的布隆过滤器表示。
扩展 bloom 14 提供了一种基于布隆过滤器的独立索引访问方法。它为表中的每一行构建一个过滤器,并处理该行中多个列的值。这种索引适用于同时对多个列进行索引,对于未知具体哪些列会施加条件的即席查询非常有用。BRIN 索引也可以基于多个列创建,但此时汇总信息将包含每个列独立的多个布隆过滤器。
布隆过滤器的准确性取决于签名的长度。理论表明,最优签名位数可估算为 ,其中 n 为集合中元素的数量,p 为过滤器的误报概率。
这两个值被提取为操作符类的参数:
n_distinct_per_range — 集合中元素的数量;在我们的例子中,这表示一个区域内索引列的唯一值数量。其值解释方式与唯一值统计信息相同:负数表示该区域行数的比例,而非绝对数量。(默认值:
-0.1)(参见 351)false_positive_rate — 误报率。(默认值:
0.01)
接近零的概率表明,索引扫描不会查看那些不存在目标值的区域。但它并不能保证查找的准确性,因为在扫描的区域中,除了所需值外,还可能包含“多余”的行。这取决于区域的宽度和数据的物理布局,而非过滤器的特性。
向操作符类的辅助函数中添加了哈希码计算函数:(psql: \dAp)
由于布隆过滤器基于哈希,唯一支持的操作符是相等操作符:(psql: \dAo)
以航班号 flight_no 列为例,该列具有接近零的相关性,因此对普通范围操作符类毫无用处。我们不更改误报率的设置,但可以计算区域中唯一值的数量。例如,对于八页区域,可得:
对于更小的区域,该数量会更小(无论如何,操作符类不接受小于 16 的值)。
接下来创建索引并检查查询执行计划:
从图中可以看出,对于某些航班号(以单独的点显示在胡须外)索引性能不太理想,但总体效率相当高:
postgrespro.ru/docs/postgresql/18/brin; backend/access/brin/README. ↩︎
backend/access/brin/brin.c, 函数 bringetbitmap. ↩︎
backend/access/brin/brin.c, 函数 brininsert. ↩︎
backend/access/brin/brin.c, 函数 summarize_range. ↩︎
backend/access/brin/brin.c, 函数 brinbuild. ↩︎
backend/access/brin/brin_minmax_multi.c, 函数 reduce_expanded_ranges. ↩︎
backend/commands/analyze.c, 函数 compute_scalar_stats. ↩︎
backend/utils/adt/selfuncs.c, 函数 brincostestimate. ↩︎
结语
好了,是时候做个总结了。希望这本书对您有所帮助,或者至少是有趣的。也许您从中学到了一些新东西(至少我在撰写过程中学到了很多)。
尽管大部分信息可能在相当长的一段时间内仍然有效,但某些细节却会以不可阻挡的速度过时。因此,我认为从本书中最有价值的并非具体事实的集合,而是一种学习系统的方法。不要轻信我,也不要轻信文档本身。要独立思考,动手实验,亲自验证所有信息。PostgreSQL 为此提供了所有必要的工具,我也努力说明了如何使用它们。大多数情况下,这并不比在聊天中提问或向人工智能咨询更复杂,但要可靠得多,也更有用。
出于同样的目的,我希望您能尝试阅读源代码。开源代码是一大优势,不要忽视这一机会。不要担心完全看不懂,只需尝试一下即可。
如果您愿意分享您的感想和建议,我将非常高兴。请发送邮件至 edu@postgrespro.ru。我计划定期更新本书,因此您的反馈可能有助于改进它。最新版电子书可免费在 postgrespro.ru/education/ books/internals 获取。
祝您好运!
索引
A
autoprewarm master 207
autoprewarm worker 209
autosummarize 649
autovacuum 138
autovacuum worker 139
autovacuum_analyze_scale_factor 143
autovacuum_analyze_threshold 143
autovacuum_freeze_min_age 157
autovacuum_freeze_table_age 157
autovacuum_multixact_freeze_max_age 274
autovacuum_vacuum_insert_scale_factor 142
autovacuum_vacuum_insert_threshold 142
autovacuum_vacuum_max_threshold 141
autovacuum_vacuum_scale_factor 141
autovacuum_vacuum_threshold 141
autovacuum_worker_slots 139
autovacuum_work_mem 140
B
bgwriter_delay 230
bgwriter_lru_multiplier. 230
Bison 322
BitmapAnd 430
bloom 666
BRIN 642
效率 654
属性 656
页面 645
btree_gin 635
属性 552
页面 529
C
checkpointer 219
checkpoint_warning 230
client_encoding 631
cmin 和 cmax 104
commit_delay 235
commit_siblings 235
cpu_index_tuple_cost 417
cube 587
D
data_checksums 241
debug_io_direct 185
debug_parallel_query 389
debug_print_parse 323
debug_print_plan 326
debug_print_rewritten 324
deduplicate_items 534
去重 参见 排除重复
default_table_access_method 371
default_text_search_config 579
default_toast_compression 36
default_transaction_isolation 73
E
F
false_positive_rate 667
fdatasync 240
fillfactor 111–112, 119, 123, 148, 151, 171, 300, 514, 558, 592, 659
Finalize Aggregate 383
Finalize GroupAggregate 504
Flex 322
fsync 240
fuzzystrmatch 611
G
geqo 332
geqo_threshold 332
gevel 596
GIN 612
属性 627
页面 615
gin_fuzzy_search_limit 627
gin_pending_list_limit 624
页面 560
GroupAggregate 503
H
I
idle_in_transaction_session_timeout 178
ignore_checksum_failure 242
增量排序 498
仅索引扫描 423
io_max_combine_limit 187
io_max_concurrency 187
io_method 185
io_workers 185
J
K
- k-维树 603
L
M
maintenance_work_mem 140
max_locks_per_transaction 258
max_parallel_maintenance_workers 552
max_parallel_processes 207
max_parallel_workers 384
max_pred_locks_per_page 302
max_pred_locks_per_relation 303
max_wal_senders 247
Merge Join 483
min_parallel_index_scan_size 132
min_parallel_table_scan_size 385
min_wal_size 229
MixedAggregate 504
multixact_member_buffers 272
multixact_offset_buffers 272
N
O
- OID 25
P
pageinspect 75, 79, 83, 90, 149, 215, 270, 513, 560, 596, 615, 646
pages_per_range 642
Parallel Bitmap Heap Scan 436
Parallel Hash 472
Parallel Hash Join 472
Parallel Index Only Scan 435
Parallel Index Scan 435
parallel_workers 385
Partial GroupAggregate 504
pg_checksums 240
pg_controldata 223
PGDATA 23
pg_dump 109
pg_prewarm 206
pg_prewarm.autoprewarm 207
pg_prewarm.autoprewarm_interval 207
pg_rewind 213
pg_test_fsync 240
pg_wait_sampling 312
pg_wait_sampling.profile_period 314
plan_cache_mode 344
postgres 39
Q
- Quadtree 591
R
RD-树 580
Read Committed 51–56, 59–60, 63, 65, 73–74, 97, 105–106, 110, 128, 279
Repeatable Read 52–54, 63–65, 67–68, 70, 72–74, 97, 106, 110, 162, 278, 299
RTE 323
RUM 630
R-树 557
S
search_path 26
seg 587
Serializable 52–53, 70, 72–74, 97, 106, 110, 278, 299, 304, 388, 409
shared_buffers 202
Skip Scan 539
SP-GiST 589
页面 596
statement_timeout 285
SubPlan 391
subtransaction_buffers 92
后缀截断 参见 排除属性
T
temp_buffers 209
Tid Scan 415
track_commit_timestamp 99
track_cost_delay_timing 166
track_counts 139
track_io_timing 206
transaction_buffers 85
transaction_timeout 178
U
- Unique 503
V
vacuum_buffer_usage_limit 200
vacuum_cost_page_dirty 164
vacuum_cost_page_hit 164
vacuum_cost_page_miss 164
vacuum_index_cleanup 158
vacuum_multixact_failsafe_age 274
vacuum_multixact_freeze_min_age 274
vacuum_multixact_freeze_table_age 274
vacuum_truncate 134
values_per_range 661
W
WAL 参见 预写日志
wal_buffers 214
wal_compression 243
wal_init_zero 233
wal_keep_size 230
wal_level 247
wal_log_hints 243
wal_recycle 229
wal_segment_size 216
wal_sync_method 240
walwriter 236
wal_writer_delay 236
wal_writer_flush_after 236
WindowAgg 490
work_mem 20, 338–339, 428–430, 432, 449, 458, 466, 470, 472–473, 480, 491
X
А
排序 501
异常
Б
数据库 23
位提示 参见 信息位
锁 参见 页面
内存中 189
行版本 275
轻量级 306
非关系锁 293
事务号 259
谓词锁 298
关系扩展锁 295
建议锁 296
自旋 305
页面锁 296
事务块 307
淘汰 196
配置 202
В
Г
Д
Ж
З
И
К
М
Н
О
П
限制 388
重写 参见 变换
执行计划 326
通用与专用 343
查询准备 340
全文搜索 577
排名 630
短语 629
部分 620
结果获取 344
门户 337
规则
重写 325
参数绑定 341
查询协议 42
简单 322
扩展 340
进程 39
服务 41
搜索路径 26
Р
查询解析 322
分裂
С
连接 444
操作符族 402
期望采样 312
服务器 23
扫描
并行索引扫描 434
并行顺序扫描 380
跳过扫描 539
方法比较 436
层 28
初始化 30
目录快照 108
导出快照 109
连接
嵌套循环连接 440
内连接 438
参数化连接 444
方法比较 505
快速排序 491
外部排序 494
增量排序 498
并行排序 500
堆排序 492
特殊区域 76
非标量类型统计信息 360
NULL 值比例 350
多值 365
字段大小 361
扩展 363
脏页 189
完整副本 223
模式 25
Т
У
Ф
Х
Э
版权页
«ДМК Пресс» 的书籍可在出版社仓库按批发或零售购买,地址为:俄罗斯莫斯科市叶列茨卡亚街 2 号,12 栋 7 号办公室,电话 +7 (499) 322-19-38,也可通过网站 www.dmkpress.com 订购,配送至俄罗斯任何地区。
罗戈夫·叶戈尔·瓦列里耶维奇
PostgreSQL 18 内参
由 Postgres Professional https://postgrespro.ru 支持
主编 亚岑科夫·V·C.
editor@dmkpress.com 文学编辑 曼特罗娃·L·V. 校对 辛亚耶娃·G·I.
开本 70×1001/16。数码印刷。字体为 PT(Paratype)、Iosevka(任志里)和 两圆体(尤里·戈尔登)。印张 55.4。印数 200 册。
出版社网站:www.dmkpress.com