29.1. 总览 与其他索引不同,BRIN
为了加速查找,整个表被划分为若干个 区域 (range),每个区域大小为若干页面。因此得名:Block Range Index,即 BRIN。该索引不存储行版本标识符,仅保留每个区域中数据的汇总信息。对于有序数据类型,在最简单的情况下,这包括最小值和最大值,但不同的操作符类可以收集区域中值的其他信息。
每个区域中的页面数量在创建索引时通过存储参数 pages_per_range 设置。(默认值: 128)
在执行包含对已索引列进行条件判断的查询时,可以完全跳过所有值显然不满足查询条件的区域。其余区域的所有页面由索引以 不精确的位图 形式返回;这些页面上的所有行将被检查是否满足条件。(参见 428 )
因此,BRIN 适用于值具有局部特性的列,即存储在相邻位置的值在汇总信息意义上具有相似的属性。对于有序数据类型,这意味着值在表中应按升序或降序物理排列,即具有较高的 相关性 ,其物理位置与由「大于」和「小于」操作定义的逻辑顺序一致。对于其他类型的汇总信息,对「相似属性」的要求可能有所不同。(参见 361 )
将 BRIN 视为传统意义上的索引是错误的,它更应被视为一种加速表顺序扫描的机制。也可以将其看作一种类似分区的机制,将每个区域视为一个独立的「虚拟」分区。
29.2. 样例 在演示数据库中没有足够大的表来使用 BRIN,但可以设想,为了满足分析报表的需求,需要一个去规范化的表,其中包含从机场起飞和抵达机场的航班信息,精确到客舱座位。每个机场的数据在对应时区午夜时分添加到表中一次。添加后,数据不再被修改或删除。
该表的结构如下:
CREATE TABLE flights_bi (
airport_code char ( 3 ), -- код аэропорта
airport_coord point , -- координаты аэропорта
airport_utc_offset interval , -- часовой пояс
flight_no char ( 6 ), -- номер рейса
flight_type text , -- тип рейса: вылет или прилет
scheduled_time timestamptz , -- вылет/прилет по расписанию
actual_time timestamptz , -- реальное время
aircraft_code char ( 3 ), -- код воздушного судна
seat_no varchar ( 4 ), -- номер места
fare_conditions varchar ( 10 ), -- класс обслуживания
passenger_id varchar ( 20 ), -- номер документа пассажира
passenger_name text -- имя пассажира
);
可以通过嵌套循环
我将直接加载一个已准备好的表副本,其大小约为 4 GB,包含约 3000 万行
postgres$ pg_restore -d demo -c flights_bi.dump
=> ANALYZE flights_bi;
=> SELECT count(*) FROM flights_bi;
  count
----------
 30517076
(1 row)
=> SELECT pg_size_pretty(pg_total_relation_size('flights_bi'));
 pg_size_pretty
----------------
 4130 MB
(1 row)
这样的数据量虽然不算大,但足以用来研究 BRIN 的工作原理。我将预先创建一个索引:
=> CREATE INDEX ON flights_bi USING brin(scheduled_time);
=> SELECT pg_size_pretty(pg_total_relation_size(
  'flights_bi_scheduled_time_idx'
));
 pg_size_pretty
----------------
 184 kB
(1 row)
使用默认参数时,它所占空间非常小。
即使考虑到重复值的紧凑存储,B-树索引的大小也是一千倍以上。当然,这种索引的效率也显著更高,但对于真正超大规模的表,额外的存储开销可能成为不可接受的奢侈。(v. 13)
=> CREATE INDEX flights_bi_btree_idx ON flights_bi(scheduled_time);
=> SELECT pg_size_pretty(pg_total_relation_size(
  'flights_bi_btree_idx'
));
 pg_size_pretty
----------------
 210 MB
(1 row)
=> DROP INDEX flights_bi_btree_idx;
29.3. 页面布局 BRIN 索引的第零页是 元页 ,包含索引结构信息。
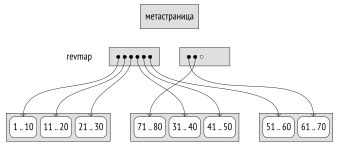
在元数据之后,是存储 汇总信息 的页面。每页上的每个索引行包含某一特定区域的汇总信息。
在元页和汇总信息之间是 区域映射 (range map),有时也称为 反向映射 (reverse range map,因此常简称为 revmap)。本质上,这是一个指向相应索引行的指针数组;数组中的位置编号等于区域编号。
图 29.1 页面组织结构
当表扩展时,区域映射的大小也随之增加。如果映射无法再容纳在分配的页面中,它将扩展到下一页,而原来页中的所有索引行将被移动到其他页面。由于每页可容纳大量指针,此类移动很少发生。
BRIN 索引页面可像通常一样使用 pageinspect 扩展进行分析。元信息显示了区域大小和用于区域映射的页面数量:
=> SELECT pagesperrange, lastrevmappage
FROM brin_metapage_info(get_raw_page(
  'flights_bi_scheduled_time_idx', 0
));
 pagesperrange | lastrevmappage
---------------+----------------
           128 |              4
(1 row)
此处区域映射占用了四页,从第一页到第四页。可以获取指向汇总信息索引记录的引用:
=> SELECT *
FROM brin_revmap_data(get_raw_page(
  'flights_bi_scheduled_time_idx', 1
));
  pages
----------
 (6,197)
 (6,198)
 (6,199)
 (6,200)
 (6,201)
 ...
 (6,193)
 (6,194)
 (6,195)
 (6,196)
(1360 rows)
如果某个区域尚未汇总(即该区域没有汇总信息),映射中的指针将为空。
以下是几个前几个区域的汇总信息:
=> SELECT itemoffset, blknum, value
FROM brin_page_items(
  get_raw_page('flights_bi_scheduled_time_idx', 6),
  'flights_bi_scheduled_time_idx'
)
ORDER BY blknum
LIMIT 3 \gx
-[ RECORD 1 ]--------------------------------------------------
itemoffset | 197
blknum     | 0
value      | {2016-08-15 02:45:00+03 .. 2016-08-15 16:20:00+03}
-[ RECORD 2 ]--------------------------------------------------
itemoffset | 198
blknum     | 128
value      | {2016-08-15 05:50:00+03 .. 2016-08-15 18:55:00+03}
-[ RECORD 3 ]--------------------------------------------------
itemoffset | 199
blknum     | 256
value      | {2016-08-15 07:15:00+03 .. 2016-08-15 18:50:00+03}
29.4. 搜索 在对 BRIN 索引支持的条件进行搜索时,会检查区域映射和每个区域的汇总信息。如果区域中的数据可能匹配搜索键,则该区域的所有页面将被添加到位图中。由于索引不存储单个行的标识符,位图最初是以页面为单位构建的。
数据与键的匹配性由支持的 一致性函数 判断,该函数理解汇总信息的含义。当然,没有汇总信息的区域始终会被添加到位图中。
最终生成的位图将用于以常规方式扫描表。重要的是,表页面以连续块的形式读取,并使用预读机制。(参见 427 )
29.5. 摘要信息更新
插入值 当新行版本被插入表页面时,相应区域索引中的汇总信息将被更新
是否需要扩展现有汇总信息,由支持的 值添加函数 决定。如果需要扩展,且页面上有足够空间,则会就地进行扩展(无需创建新的索引行)。
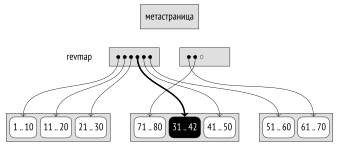
例如,假设在第 13 页出现了一条值为 42 的行版本。区域编号(从零开始)通过将页面编号除以区域大小计算得出。假设区域大小为 4 页,则得到区域编号 3,从区域映射中获取第四个指针。该区域的最小值为 31,最大值为 40。新值超出此范围,因此最大值被更新:
图 29.2 插入值 如果就地更新不可行,则创建新行,此时区域映射将被修改。
范围提要 上述内容适用于新行版本出现在已有汇总信息的区域的情况。在构建索引时,所有现有区域都会被汇总,但在表后续增长过程中,可能会出现超出此范围的新页面。
如果创建索引时使用存储参数 autosummarize ,则新区域将立即被汇总。但由于数据仓库中通常以大批次而非单条方式添加行,这种模式可能会显著减慢插入速度。(默认值: off)
默认情况下,新区域不会立即汇总。这不会破坏索引的正确性,因为没有汇总信息的区域将被完全扫描。汇总操作在表清理时异步执行,或可手动调用 brin_summarize_new_values 或 brin_summarize_range(针对单个区域)函数来触发。(参见 142 )
区域汇总 合并函数 与区域计算出的汇总信息合并。
在从表中删除行时,汇总信息本可能收缩。但在 GiST 索引中,页面分裂时至少会重新计算一次,而 BRIN 索引中的汇总信息只会扩展,从不收缩。通常这并非必要,因为数据仓库通常仅用于数据插入。当然,可以手动调用 brin_desummarize_range 函数删除汇总信息,并重新汇总区域。但没有任何提示说明哪些区域的重新汇总可能有益。(参见 557 )
因此,BRIN 主要针对非常大的表设计,这些表要么不更新,要么更新极少,因此新行通常被添加到文件末尾。其主要应用场景是数据仓库和分析报表。
29.6. Minmax 类 对于可相互比较的值的数据类型,最简单的汇总信息由最小值和最大值组成。相应的操作符类名称中包含 minmax 一词 \dAc)
=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%minmax_ops'
ORDER BY opcname;
        opcname
------------------------
 bit_minmax_ops
 bpchar_minmax_ops
 bytea_minmax_ops
 ...
 timetz_minmax_ops
 uuid_minmax_ops
 varbit_minmax_ops
(26 rows)
这些操作符类的支持函数:(psql: \dAp)
=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'numeric_minmax_ops'
ORDER BY amprocnum;
 amprocnum |         amproc
-----------+------------------------
         1 | brin_minmax_opcinfo
         2 | brin_minmax_add_value
         3 | brin_minmax_consistent
         4 | brin_minmax_union
(4 rows)
第一个函数返回操作符类的元信息,其余函数我已描述过:即值添加函数、一致性函数和合并函数。
minmax 类使用与 B-树相同的比较操作符:(参见 546 )(psql: \dAo)
=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'brin'
AND opcname = 'numeric_minmax_ops'
ORDER BY amopstrategy;
       amopopr       |  oprcode   | amopstrategy
---------------------+------------+--------------
 <(numeric,numeric)  | numeric_lt |            1
 <=(numeric,numeric) | numeric_le |            2
 =(numeric,numeric)  | numeric_eq |            3
 >=(numeric,numeric) | numeric_ge |            4
 >(numeric,numeric)  | numeric_gt |            5
(5 rows)
选择要索引的列 哪些列适合使用此类操作符构建 BRIN 索引?我之前提到过,索引效果良好当行的物理位置与值的逻辑顺序相关时。
我们将在前面准备的例子中验证这一点。
=> SELECT attname, correlation, n_distinct
FROM pg_stats
WHERE tablename = 'flights_bi'
ORDER BY correlation DESC NULLS LAST;
      attname       |  correlation  |  n_distinct
--------------------+---------------+--------------
 scheduled_time     |    0.99999493 |        25930
 actual_time        |     0.9999949 |        34564
 fare_conditions    |     0.8010756 |            3
 flight_type        |     0.5012919 |            2
 airport_utc_offset |     0.4440494 |           11
 aircraft_code      |    0.17335044 |            8
 airport_code       |    0.04215337 |          104
 passenger_name     |   0.009984755 |         8298
 seat_no            | 0.00017101977 |          461
 flight_no          | -0.0043201274 |          707
 passenger_id       | -0.0066375434 | 2.505045e+06
 airport_coord      |               |            0
(12 rows) 数据按时间顺序排列(无论是计划时间还是实际时间,差异微不足道),因为数据是按时间顺序添加的,且由于没有删除和更新,行在表主层文件中顺序存储,一个接一个。(参见 29 )
列 fare_conditions、flight_type 和 airport_utc_offset 显示出相对较高的相关性,但它们的唯一值太少。
其他列的相关性太低,因此使用范围操作符类索引并无意义。
范围大小与搜索效率 确定合适区域大小的提示可以是:值出现的页面数量。
考虑时间调度 scheduled_time,并假设查询按航班选择一天的数据。计算表中一天数据占用多少页面。
为此,我们将利用行版本标识符由页面号和偏移量组成这一事实。不幸的是,没有标准方法可以将标识符分解为两个组成部分,因此必须编写一个不够美观的函数,通过文本表示进行类型转换:
=> CREATE FUNCTION tid2page(t tid) RETURNS integer
LANGUAGE sql
RETURN (t::text::point)[0]::integer;
现在可以查看一天数据在表中的分布情况了:
=> SELECT min(numblk), round(avg(numblk)) avg, max(numblk)
FROM (
  SELECT count(distinct tid2page(ctid)) numblk
  FROM flights_bi
  GROUP BY scheduled_time::date
) t;
 min  | avg  | max
------+------+------
 1195 | 1456 | 1554
(1 row)
可以看出,分布并不完全均匀。在标准区域大小为 128 页的情况下,每天的数据将占用 9 到 12 个区域。获取一天数据时,扫描将不仅包含所需行,还会包含落入相同区域的其他天的部分行。区域越大,读取的多余边界值就越多;通过增大或减小区域大小,可以增加或减少这些值的数量。
尝试执行一个查询,选取某一天的数据(我已在上文创建了默认参数的索引)。为简化画面,我将禁用并行执行:
=> SET max_parallel_workers_per_gather = 0;
=> \set d '2016-08-15 02:45:00+03'
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM flights_bi
WHERE scheduled_time >= :'d'::timestamptz
  AND scheduled_time < :'d'::timestamptz + interval '1 day';
                             QUERY PLAN
---------------------------------------------------------------------
 Bitmap Heap Scan on flights_bi (actual rows=81964.00 loops=1)
   Recheck Cond: ((scheduled_time >= '2016-08-15 02:45:00+03'::ti...
   Rows Removed by Index Recheck: 11606
   Heap Blocks: lossy=1536
   Buffers: shared hit=1561
   -> Bitmap Index Scan on flights_bi_scheduled_time_idx
       (actual rows=15360.00 loops=1)
       Index Cond: ((scheduled_time >= '2016-08-15 02:45:00+03'::...
       Index Searches: 1
       Buffers: shared hit=25
 Planning:
   Buffers: shared hit=1
(12 rows)
可以将某个查询的 BRIN 索引的 利用率 定义为索引扫描中跳过的页面数量与表中总页面数量的比值。当利用率(KPD)为零时,索引访问退化为顺序扫描(不考虑开销)。利用率越高,需要读取的页面就越少。但部分页面包含所需数据,这些数据无法跳过,因此利用率始终小于 1。(参见 436 )
本例中,利用率为 528 417 − 1 561 528 417 \frac{528\,417-1\,561}{528\,417} 528 417 528 417 − 1 561
然而,仅凭一个数值得出结论毫无意义。即使原始数据均匀且具有理想相关性,效率也会因区域边界位置不同而有所差异。只有将利用率视为随机变量并研究其分布,才能获得完整图景。
对于本例,可以取一年中所有不同的天数,检查每个值的执行计划,并计算所得样本的统计指标。该过程易于自动化,可利用 EXPLAIN 命令以 JSON 格式输出结果,便于处理。我不会提供完整代码,但以下小片段包含所有关键细节。
=> DO $$
DECLARE
  plan jsonb;
BEGIN
  EXECUTE
    'EXPLAIN (analyze, timing off, costs off, format json)
     SELECT * FROM flights_bi
     WHERE scheduled_time >= $1
       AND scheduled_time < $1 + interval ''1 day'''
  USING '2016-08-15 02:45:00+03'::timestamptz
  INTO plan;
  RAISE NOTICE 'shared hit=%, read=%',
    plan -> 0 -> 'Plan' ->> 'Shared Hit Blocks',
    plan -> 0 -> 'Plan' ->> 'Shared Read Blocks';
END;
$$;
NOTICE:  shared hit=1561, read=0
DO
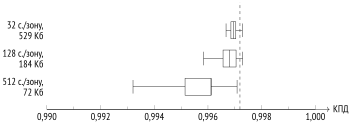
结果可通过称为“箱线图”(或“箱须图”)的图表直观展示。须线表示第一和第四四分位数(即右侧须包含 25% 最大值,左侧须包含 25% 最小值)。箱体包含其余 50% 的值,其中还标出了中位数。重要的是,这种紧凑的图像便于直观比较结果。图中展示了默认区域大小及另外两个相差四倍的区域大小下的利用率分布:
图 29.3 区域大小与查找效率 正如预期,即使区域较大,查找的精度和效率也依然很高。
图中虚线表示基于一天数据约占表的 1 365 \frac{1}{365} 365 1
属性 BRIN 的特性是恒定的,不依赖于特定的操作符类。
访问方法级别特性
=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'brin';
 amname |     name      | pg_indexam_has_property
--------+---------------+-------------------------
 brin   | can_order     | f
 brin   | can_unique    | f
 brin   | can_multi_col | t
 brin   | can_exclude   | f
 brin   | can_include   | f
(5 rows)
排序和唯一性支持显然不存在。由于 BRIN 索引始终返回位图,因此不支持排除约束。附加的 include 列也无意义,因为索引中甚至不存储索引键本身。
但可以创建复合 BRIN 索引。此时,每个列的汇总信息分别收集并保存在独立的索引行中,但区域关联保持一致。当所有列使用相同区域大小时,这种索引才有意义。
作为复合索引的替代方案,可以为各个列分别创建 BRIN 索引,并利用位图可组合的特性。(参见 429 )
例如:
=> CREATE INDEX ON flights_bi USING brin(airport_utc_offset);
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT * FROM flights_bi
WHERE scheduled_time >= :'d'::timestamptz
  AND scheduled_time < :'d'::timestamptz + interval '1 day'
  AND airport_utc_offset = '08:00:00';
                             QUERY PLAN
---------------------------------------------------------------------
 Bitmap Heap Scan on flights_bi (actual rows=1658.00 loops=1)
   Recheck Cond: ((scheduled_time >= '2016-08-15 02:45:00+03'::ti...
   Rows Removed by Index Recheck: 14077
   Heap Blocks: lossy=256
   -> BitmapAnd (actual rows=0.00 loops=1)
       -> Bitmap Index Scan on flights_bi_scheduled_time_idx (act...
           Index Cond: ((scheduled_time >= '2016-08-15 02:45:00+0...
           Index Searches: 1
       -> Bitmap Index Scan on flights_bi_airport_utc_offset_idx ...
           Index Cond: (airport_utc_offset = '08:00:00'::interval)
           Index Searches: 1
(11 rows)
大型表的 BRIN 索引可以并行创建。多个进程扫描表,各自计算其数据部分的汇总信息。这些信息按区域排序(分配内存大小为 maintenance_work_mem ),随后由主进程聚合并生成索引552 )(默认值:64MB)
索引级别特性
=> SELECT p.name, pg_index_has_property(
  'flights_bi_scheduled_time_idx', p.name
)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
---------------+-----------------------
 clusterable   | f
 index_scan    | f
 bitmap_scan   | t
 backward_scan | f
(4 rows)
显然,仅支持基于位图的扫描。
缺乏聚簇可能引起一些困惑。由于 BRIN 索引对行的物理顺序敏感,似乎应支持重排顺序以最大化索引效率。但无论如何,大型表的聚簇代价过高,考虑到所需工作量和重建期间的磁盘空间消耗。此外,如 flights_bi 表的示例所示,数据仓库中某些有序性可能自然形成。
列级别特性
=> SELECT p.name, pg_index_column_has_property(
  'flights_bi_scheduled_time_idx', 1, p.name
)
FROM unnest(array[
  'orderable', 'distance_orderable', 'returnable',
  'search_array', 'search_nulls'
]) p(name);
        name        | pg_index_column_has_property
--------------------+------------------------------
 orderable          | f
 distance_orderable | f
 returnable         | f
 search_array       | f
 search_nulls       | t
(5 rows)
列级别特性仅包括对 NULL 值的支持。区域中存在 NULL 值会在汇总信息中以单独标志记录: NULL
=> SELECT hasnulls, allnulls, value
FROM brin_page_items(
  get_raw_page('flights_bi_airport_utc_offset_idx', 6),
  'flights_bi_airport_utc_offset_idx'
)
WHERE itemoffset= 1;
 hasnulls | allnulls |         value
----------+----------+------------------------
 f        | f        | {03:00:00 .. 03:00:00}
(1 row)
29.7. 多范围值(minmax-multi) 很容易通过修改数据破坏已建立的相关性。问题不在于修改某个特定值,而在于多版本机制:旧行版本在某一页被删除,而新版本可能插入到另一页。因此,行版本在更新时发生混杂。(v. 14)(参见 80 )
部分可通过减小存储参数 fillfactor 来缓解此现象,以在页面中为未来更新预留空间。但是否愿意增加本已庞大的表的体积?此外,删除操作仍会释放现有页面内的空间,从而为新行制造“陷阱”,否则新行将被插入文件末尾。
这种情况很容易模拟。首先删除 0.1% 的随机行,并执行清理以释放空间供新版本使用:
=> WITH t AS (
  SELECT ctid
  FROM flights_bi TABLESAMPLE BERNOULLI(0.1) REPEATABLE(0)
)
DELETE FROM flights_bi
WHERE ctid IN (SELECT ctid FROM t);
DELETE 30122 然后为某个时区添加一天的新数据。我只需复制前一天的数据,并将日期加一:
=> INSERT INTO flights_bi
SELECT airport_code, airport_coord, airport_utc_offset,
  flight_no, flight_type, scheduled_time + interval '1 day',
  actual_time + interval '1 day', aircraft_code, seat_no,
 fare_conditions, passenger_id, passenger_name
FROM flights_bi
WHERE date_trunc('day', scheduled_time) = '2017-08-15'
  AND airport_utc_offset = '03:00:00';
INSERT 0 40531
删除的行数量足以使每个或几乎每个区域都出现空位。新行落入内部页面后,自动扩展了值范围。以下是第一区域的汇总信息:之前它仅覆盖不到一天的数据,现在则覆盖整整一年:
=> SELECT value
FROM brin_page_items(
  get_raw_page('flights_bi_scheduled_time_idx', 6),
  'flights_bi_scheduled_time_idx'
)
WHERE blknum = 0;
                       value
----------------------------------------------------
 {2016-08-15 02:45:00+03 .. 2017-08-16 16:15:00+03}
(1 row)
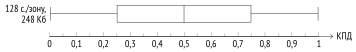
查询中使用的日期越小,需要遍历的区域就越多。图表展示了问题的严重性:
图 29.4 多范围值(minmax-multi) 为解决此问题,需增强汇总信息:不再存储单一连续范围,而是存储多个范围,共同覆盖所有值。这样,一个范围可覆盖主要数据集,其他范围则覆盖个别异常值。
这正是名称中包含 minmax_multi 的操作符类所实现的功能 \dAc)
=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%minmax_multi_ops'
ORDER BY opcname;
           opcname
------------------------------
 date_minmax_multi_ops
 float4_minmax_multi_ops
 float8_minmax_multi_ops
 ...
 timestamp_minmax_multi_ops
 timestamptz_minmax_multi_ops
 timetz_minmax_multi_ops
 uuid_minmax_multi_ops
(19 rows)
与 minmax 操作符类相比,minmax_multi 类额外增加了用于计算两个值之间距离的函数——该函数用于确定范围长度,操作符类试图最小化该长度:(psql: \dAp)
=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'numeric_minmax_multi_ops'
ORDER BY amprocnum;
 amprocnum |               amproc
-----------+------------------------------------
         1 | brin_minmax_multi_opcinfo
         2 | brin_minmax_multi_add_value
         3 | brin_minmax_multi_consistent
         4 | brin_minmax_multi_union
         5 | brin_minmax_multi_options
        11 | brin_minmax_multi_distance_numeric
(6 rows)
此类操作符包含的操作符与 minmax 类完全相同。
多范围类可接受参数 values_per_range ,用于定义单个区域中最多可存储的汇总值数量。表示范围需两个值,表示单点仅需一个值。当值不足时,部分区间将“坍缩”32)
用多范围索引替代现有索引。为示例起见,限制为 16 个汇总值:
=> DROP INDEX flights_bi_scheduled_time_idx;
=> CREATE INDEX ON flights_bi USING brin(
  scheduled_time timestamptz_minmax_multi_ops(
    values_per_range = 16
  )
);
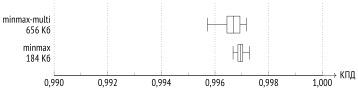
图表显示,新索引的查找效率已恢复至旧值——当然,代价是索引大小增加:
图 29.5 多范围值(minmax-multi) 29.8. Inclusion 类 范围类与覆盖类之间的差异,类似于 B-树与 GiST 之间的差异:后者专为不支持比较操作但具有相对位置意义的数据类型设计。覆盖类操作符的汇总信息以包含区域内所有值的区域表示。
这些覆盖类操作符数量不多:(psql: \dAc)
=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%inclusion_ops'
ORDER BY opcname;
       opcname
---------------------
 box_inclusion_ops
 inet_inclusion_ops
 range_inclusion_ops
(3 rows)
在基础函数基础上,增加了合并两个值的函数以及若干可选函数:(psql: \dAp)
=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'box_inclusion_ops'
ORDER BY amprocnum;
 amprocnum |          amproc
-----------+---------------------------
         1 | brin_inclusion_opcinfo
         2 | brin_inclusion_add_value
         3 | brin_inclusion_consistent
         4 | brin_inclusion_union
        11 | bound_box
        13 | box_contain
(6 rows)
对于支持比较操作符的值,我们可基于相关性统计得出结论;但对于其他类型数据,此类统计不被收集
更糟的是,相关性显著影响索引扫描成本估算。若缺乏此类统计,其值被默认视为零
在我们的示例中,我们可以假设机场坐标索引是有意义的,因为经度应当与时区相关。
与 GiST 谓词不同,BRIN 的汇总值与索引数据具有相同类型,因此无法直接为点创建索引。但我们可以创建基于表达式的索引,将点转换为退化的矩形:
=> CREATE INDEX ON flights_bi USING brin(box(airport_coord))
WITH (pages_per_range = 8);
=> SELECT pg_size_pretty(pg_total_relation_size(
  'flights_bi_box_idx'
));
 pg_size_pretty
----------------
 3816 kB
(1 row)
时区索引使用相同大小的区域所占用的空间大约相同——3288 KB。
属于该类的运算符与 GiST 类的运算符相对应。例如,可以使用索引加速在指定区域中查找点的操作:
=> SELECT airport_code, airport_name
FROM airports
WHERE box(coordinates) <@ box '135,45,140,50';
 airport_code |  airport_name
--------------+-----------------
 KHV          | Хабаровск-Новый
(1 row)
但正如我所说,计划器拒绝在不关闭顺序扫描的情况下使用索引:
=> EXPLAIN (costs off)
SELECT *
FROM flights_bi
WHERE box(airport_coord) <@ box '135,45,140,50';
                         QUERY PLAN
------------------------------------------------------------
 Seq Scan on flights_bi
   Filter: (box(airport_coord) <@ '(140,50),(135,45)'::box)
(2 rows)
=> SET enable_seqscan = off;
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM flights_bi
WHERE box(airport_coord) <@ box '135,45,140,50';
                             QUERY PLAN
---------------------------------------------------------------------
 Bitmap Heap Scan on flights_bi (actual rows=511404.00 loops=1)
   Recheck Cond: (box(airport_coord) <@ '(140,50),(135,45)'::box)
   Rows Removed by Index Recheck: 721565
   Heap Blocks: lossy=21216
   -> Bitmap Index Scan on flights_bi_box_idx (actual rows=212160...
       Index Cond: (box(airport_coord) <@ '(140,50),(135,45)'::box)
       Index Searches: 1
(7 rows) 29.9. 布隆过滤器(bloom)
基于布隆过滤器的运算符类允许对任何定义了「等于」操作且具有哈希函数的数据类型使用 BRIN。当值集中在特定区域但其位置与逻辑顺序无关时,这类运算符类对普通有序类型也十分有用。(v. 14)
此类运算符类的名称包含单词 bloom \dAc)
=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%bloom_ops'
ORDER BY opcname;
        opcname
-----------------------
 bpchar_bloom_ops
 bytea_bloom_ops
 char_bloom_ops
 ...
 timestamptz_bloom_ops
 timetz_bloom_ops
 uuid_bloom_ops
(24 rows)
经典的布隆过滤器是一种数据结构,可快速判断元素是否属于某个集合。该过滤器非常紧凑,但允许出现误报(false positive),即可能将不属于集合的元素错误地判定为属于集合。重要的是,不会出现漏报(false negative):如果元素实际上存在于集合中,过滤器绝不会判断其不存在。
布隆过滤器表现为一个长度为 m 位的位数组(也称为 签名 ),初始时全部填充为零。选择 k 个不同的哈希函数,将集合中的任意元素映射到签名中的 k 个位。向集合中添加元素的操作等价于将这些位设置为 1。因此,如果与元素对应的全部位均为 1,则该元素 可能 存在于集合中;如果其中任意一位为 0,则该元素肯定不存在于集合中。
对于 BRIN 索引,过滤器会处理特定区域内包含的索引列的多个值;该区域的汇总信息由构建的布隆过滤器表示。
说明
扩展 bloom
布隆过滤器的准确性取决于签名的长度。理论表明,最优签名位数可估算为 m = − n log 2 p ln 2 m=-\frac{n\log_2 p}{\ln 2} m = − l n 2 n l o g 2 p n 为集合中元素的数量,p 为过滤器的误报概率。
这两个值被提取为操作符类的参数:
接近零的概率表明,索引扫描不会查看那些不存在目标值的区域。但它并不能保证查找的准确性,因为在扫描的区域中,除了所需值外,还可能包含“多余”的行。这取决于区域的宽度和数据的物理布局,而非过滤器的特性。
向操作符类的辅助函数中添加了哈希码计算函数:(psql: \dAp)
=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'numeric_bloom_ops'
ORDER BY amprocnum;
 amprocnum |        amproc
-----------+-----------------------
         1 | brin_bloom_opcinfo
         2 | brin_bloom_add_value
         3 | brin_bloom_consistent
         4 | brin_bloom_union
         5 | brin_bloom_options
        11 | hash_numeric
(6 rows)
由于布隆过滤器基于哈希,唯一支持的操作符是相等操作符:(psql: \dAo)
=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'brin'
AND opcname = 'numeric_bloom_ops'
ORDER BY amopstrategy;
      amopopr       |  oprcode   | amopstrategy
--------------------+------------+--------------
 =(numeric,numeric) | numeric_eq |            1
(1 row)
以航班号 flight_no 列为例,该列具有接近零的相关性,因此对普通范围操作符类毫无用处。我们不更改误报率的设置,但可以计算区域中唯一值的数量。例如,对于八页区域,可得:
=> SELECT max(nd)
FROM (
  SELECT count(distinct flight_no) nd
  FROM flights_bi
  GROUP BY tid2page(ctid) / 8
) t;
 max
-----
  26
(1 row)
对于更小的区域,该数量会更小(无论如何,操作符类不接受小于 16 的值)。
接下来创建索引并检查查询执行计划:
=> CREATE INDEX ON flights_bi USING brin(
  flight_no bpchar_bloom_ops(
    n_distinct_per_range = 22)
)
WITH (pages_per_range = 8);
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM flights_bi
WHERE flight_no = 'PG0001';
                             QUERY PLAN
---------------------------------------------------------------------
 Bitmap Heap Scan on flights_bi (actual rows=5197.00 loops=1)
   Recheck Cond: (flight_no = 'PG0001'::bpchar)
   Rows Removed by Index Recheck: 127510
   Heap Blocks: lossy=2240
   -> Bitmap Index Scan on flights_bi_flight_no_idx (actual rows=...
       Index Cond: (flight_no = 'PG0001'::bpchar)
       Index Searches: 1
(7 rows)
=> RESET max_parallel_workers_per_gather;
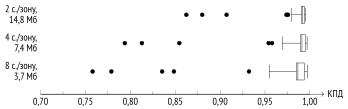
从图中可以看出,对于某些航班号(以单独的点显示在胡须外)索引性能不太理想,但总体效率相当高:
图 29.6 布隆过滤器(bloom)