跳转到主要内容

28 GIN

PostgreSQL 18 · 基于俄文 PG18 原版的简体中文译本

28.1. 总览

根据作者的设想,GIN 并非美国的烈性酒,而是一种强大且无畏的精神1。但也有正式的解释:Generalized Inverted Index,即广义倒排索引。

该访问方法适用于那些值由多个元素组成而非原子值的数据类型(例如,在全文搜索的上下文中,文档由词元组成)。与 GiST 中索引整个值不同,GIN 仅索引这些值的元素;通过索引,可以从每个元素跳转到包含该元素的所有值。

对此方法的一个良好类比是书籍末尾的索引。索引中汇集了所有重要术语,并为每个术语列出包含该术语的页面列表。为了便于使用,索引按字母顺序排列,否则将难以快速定位。GIN 也依赖于复合值的元素可以排序这一前提,并以 B-树作为主要数据结构。(参见523)

GIN 的元素树实现比真正的 B-树简单得多,但最初设计时假定不同值由相对较小的、重复出现的元素集合构成。

由此推导出两个重要结论:

  • 索引中应仅存储每个元素的一个实例。

每个元素关联一个版本标识符列表。如果该列表(posting list)不足够大,则与元素一同存储;但当列表变大时,可将其移出至单独的 B-树(posting tree)。不仅树是有序的,列表本身也是有序的;虽然这对用户无影响,但有助于加速访问并减少存储空间。

  • 从树中删除元素没有意义。

如果某个元素的标识符集合为空,那么该元素很可能在另一个值中再次出现。

因此,索引由元素树构成,其叶节点链接到的是扁平列表或标识符树。

与之前讨论的 GiST 和 SP-GiST 访问方法类似,GIN 可以索引各种类型的数据,通过简化操作符类接口实现。通常,此类操作符检查已索引的复合值是否满足某个元素集合(例如,在全文搜索中,操作符 @@ 检查文档是否匹配查询)。

为了处理特定数据类型,GIN 方法必须能够将复合值分解为词元、对词元排序,并检查找到的值是否匹配查询。这些操作由操作符类的支撑函数实现。

28.2. 用于全文检索的索引

GIN 的主要应用场景是加速全文搜索,因此我将继续在介绍 GiST 索引的章节中开始的示例。显然,在这种情况下,复合值是文档,而这些值的元素是词元。(参见578)

在“在田野里,白桦树……”的表上创建 GIN 索引:(参见579)

=> CREATE INDEX ts_gin_idx ON ts USING gin(doc_tsv);

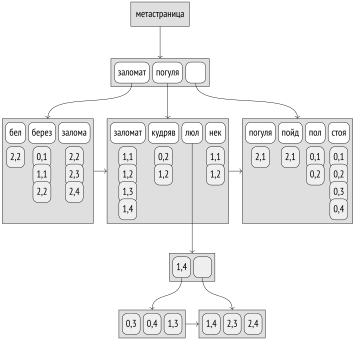
该索引的可能结构如图所示:

全文搜索索引:元页面;заломатзаломатпогуляпогуля;белбереззаломазаломаткудрявлюлнекпогуляпойдполстоя;2,20,12,21,10,21,12,12,10,10,1;1,12,31,21,21,20,20,2;2,22,41,30,3;1,40,4;1,4;0,30,41,31,42,32,4
图 28.1 全文搜索索引

与之前的插图不同,此处显示并用颜色标出的是具体的标识符值,因为它们对理解算法至关重要。这些值假设表中的行具有以下标识符:

=> SELECT ctid, * FROM ts;
  ctid |           doc           |            doc_tsv
-------+-------------------------+--------------------------------
 (0,1) | Во поле береза стояла   | 'берез':3 'пол':2 'стоя':4
 (0,2) | Во поле кудрявая стояла | 'кудряв':3 'пол':2 'стоя':4
 (0,3) | Люли, люли, стояла      | 'люл':1,2 'стоя':3
 (0,4) | Люли, люли, стояла      | 'люл':1,2 'стоя':3
 (1,1) | Некому березу заломати  | 'берез':2 'заломат':3 'нек':1
 (1,2) | Некому кудряву заломати | 'заломат':3 'кудряв':2 'нек':1
 (1,3) | Люли, люли, заломати    | 'заломат':3 'люл':1,2
 (1,4) | Люли, люли, заломати    | 'заломат':3 'люл':1,2
 (2,1) | Я пойду погуляю         | 'погуля':3 'пойд':2
 (2,2) | Белую березу заломаю    | 'бел':1 'берез':2 'залома':3
 (2,3) | Люли, люли, заломаю     | 'залома':3 'люл':1,2
 (2,4) | Люли, люли, заломаю     | 'залома':3 'люл':1,2
(12 rows)

请注意与普通 B-树索引的一些区别。B-树内部节点中最左侧的键为空,因为它是冗余的;而在 GIN 索引中,该键根本不会存储。因此,子节点的引用也相应地发生了偏移。上键在两种索引中均被使用,但在 GIN 中,它位于其合法的最右位置。B-树同一层级的节点通过双向链表连接;而在 GIN 索引中,节点通过单向链表连接,因为树的遍历始终只朝一个方向进行。(参见529)

在我们设想的示例中,所有标识符列表都存放在普通页面中,除了“люл”这个词元的列表。这个词元出现在六个文档中,其标识符被移至单独的树中。

页面布局

从页面组织角度看,GIN 与 B-树非常相似。可以使用 pageinspect 扩展查看索引内部结构。在 pgsql-hackers 邮件列表表上创建 GIN 索引:(参见584)

=> CREATE INDEX mail_gin_idx ON mail_messages USING gin(tsv);

第零页(元页面)包含总体统计信息,例如元素数量和其他类型页面的数量:

=> SELECT *
FROM gin_metapage_info(get_raw_page('mail_gin_idx',0)) \gx
-[ RECORD 1 ]----+-----------
pending_head     | 4294967295
pending_tail     | 4294967295
tail_free_size   | 0
n_pending_pages  | 0
n_pending_tuples | 0
n_total_pages    | 27108
n_entry_pages    | 17699
n_data_pages     | 9408
n_entries        | 999191
version          | 2

GIN 使用索引页面的专用区域来保存页面类型标志位等信息:(参见76)

=> SELECT flags, count(*)
FROM generate_series(0,27107) AS p, -- n_total_pages
  gin_page_opaque_info(get_raw_page('mail_gin_idx',p))
GROUP BY flags
ORDER BY 2;
         flags          | count
------------------------+-------
 {meta}                 |     1
 {}                     |   263
 {data}                 |  1517
 {data,leaf,compressed} |  7891
 {leaf}                 | 17436
(5 rows)

带有 meta 标志的页面当然是元页面。带有 data 标志的页面属于标识符树,而没有该标志的页面则属于元素树。在树内部,还区分出带有 leaf 标志的叶页面。

pageinspect 扩展的另一功能可提供树叶页面中存储的标识符信息。实际上,每个此类树的记录包含的不是一个标识符,而是一个小列表:

=> SELECT left(tids::text,67)||'...' tids
FROM gin_leafpage_items(get_raw_page('mail_gin_idx',2));
                                  tids
------------------------------------------------------------------------
 {"(23,1)","(31,1)","(56,1)","(59,5)","(306,5)","(469,5)","(538,5)",...
 {"(5257,3)","(5373,4)","(5686,8)","(5808,3)","(5864,4)","(5883,1)",...
 {"(12832,8)","(12833,1)","(13454,5)","(13590,3)","(13591,1)","(1392...
 ...
 {"(54024,5)","(54036,3)","(54072,6)","(54139,4)","(54140,6)","(5415...
 {"(57117,7)","(57187,1)","(57230,8)","(57231,1)","(57231,3)","(5723...
 {"(61503,4)","(61513,3)","(61527,7)","(61561,4)","(61562,1)","(6156...
(18 rows)

列表中的标识符是有序的,这使得数据可以压缩(因此带有 compressed 标志)。不再存储六字节的 tid 值,而是存储与前一个值的差值,并以可变字节数编码2:差值越小,数据占用的空间就越少。

操作符类

GIN 操作符类的支撑函数列表如下3:(psql: \dAp)

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'gin'
AND opcname = 'tsvector_ops'
ORDER BY amprocnum;
 amprocnum |              amproc
-----------+-----------------------------------
         1 | gin_cmp_tslexeme
         2 | pg_catalog.gin_extract_tsvector
         3 | pg_catalog.gin_extract_tsquery
         4 | pg_catalog.gin_tsquery_consistent
         5 | gin_cmp_prefix
         6 | gin_tsquery_triconsistent
(6 rows)

第一个支撑函数用于比较两个元素,本例中即词元。如果词元由具有 B-树操作符类的 SQL 类型表示,则 GIN 会自动使用该类中的比较操作符。(参见546)

第五个(可选)函数用于部分搜索,检查索引元素与查询键的部分匹配。在本例中,部分搜索即按前缀查找词元。例如,查询「п:*」将匹配所有以「п」开头的词元。

第二个函数从文档中提取词元,第三个函数从搜索查询中提取词元。需要不同的函数至少是因为文档和查询分别以 tsvector 和 tsquery 类型表示。此外,查询函数还定义了搜索的执行方式。如果查询要求文档中包含任意一个词元,则搜索将考虑包含查询中至少一个词元的文档。如果不存在此类条件(例如,需要的是不包含特定词元的文档),则将考虑所有文档——这显然代价更高。(v. 13)

说明

当查询中包含其他搜索键时,索引首先按这些键扫描,然后对结果进行重新验证。这可以避免对索引的无谓遍历。

第四和第六个函数是一致性函数,用于判断找到的文档是否与搜索查询匹配。第四个函数接收关于查询中哪些词元存在于文档中、哪些不存在的精确信息。第六个函数在不确定条件下工作,可能在部分词元是否存在于文档中尚不明确时被调用。操作符类不必实现两个函数:只需提供其中一个即可,但此时搜索效率可能下降。

操作符类 tsvector_ops 仅支持一个文档与搜索查询匹配的操作符4 @@——与 GiST 操作符类所包含的完全相同。

搜索

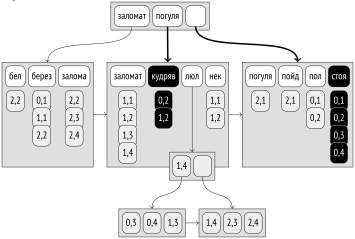
考虑执行查询「стояла | кудрявая」的过程,其中两个词元通过「或」条件连接。首先,使用支撑函数5 从 tsquery 类型的搜索查询中提取出单独的词元(即搜索键):「стоя」和「кудряв」。

由于查询要求特定词元的存在,将生成一个包含至少一个查询键的文档的标识符列表。为此,需在词元树中查找每个搜索键对应的标识符,并将它们合并为一个总列表。由于索引中所有标识符都是有序存储的,因此可以使用多个已排序的标识符流合并为一个流6。(参见483)
搜索:заломатзаломатпогуляпогуля;белбереззаломазаломаткудрявлюлнекпогуляпойдполстоя;2,20,12,21,10,21,12,12,10,10,1;1,12,31,21,21,20,20,2;2,22,41,30,3;1,40,4;1,4;0,30,41,31,42,32,4
图 28.2 搜索

请注意,目前尚不重要的是这些键是通过「与」、「或」还是其他条件连接的——树搜索引擎仅处理键列表,而对搜索查询的语义一无所知。

每个匹配文档的标识符都会通过一致性支撑函数7 进行验证。该函数恰好知道如何解释搜索查询,并仅保留与查询匹配(或至少可能匹配,需要回表验证)的标识符。

在本例中,一致性函数将保留所有标识符:

tid«стоя»«кудряв»一致性函数
(0,1)✓–✓
(0,2)✓✓✓
(0,3)✓–✓
(0,4)✓–✓
(1,2)–✓✓
表 28.1 一致性函数:「стоя」或「кудряв」

搜索查询中可以指定前缀而非完整词元。这在用户可能仅输入单词的前几个字母并期望获得结果时非常有用。例如,对于查询「залом:*」,将找到以「залом」开头的词元的文档:「залома」(由「заломаю」生成)和「заломат」(由「заломати」生成)。

在进行此类部分搜索时,索引中的词元通过单独的支撑函数8 与搜索键进行比较,该函数在一般情况下可实现不仅限于前缀匹配,还可实现其他部分匹配逻辑。

频繁和罕见的词素

如果搜索查询中使用的词元出现频率较高,生成的版本标识符列表将非常长,这显然代价高昂。幸运的是,如果查询中同时包含稀有词元,通常可以避免这种情况。

考虑执行查询「люли & заломаю」。词元「залома」出现三次,而「люл」出现六次。与其将两个词元视为同等重要并收集两者的完整标识符列表,不如将稀有词元「залома」视为必需项,而将较频繁的词元「люл」视为附加项,因为(考虑到查询语义)可以明确,仅当文档同时包含「залома」词元时,包含「люл」词元的文档才符合查询要求。

因此,首先通过索引确定包含「залома」的第一个文档;其标识符为(2,2)。接下来需要判断该文档是否包含词元「люл」,但所有标识符小于(2,2)的文档可直接跳过。由于频繁词元对应大量标识符,它们很可能存储在单独的树中,从而可以跳过部分页面。在本例中,对「люл」词元树的搜索从(2,2)开始,第一个找到的文档标识符为(2,3)。

该过程对下一个必需词元的值重复执行。
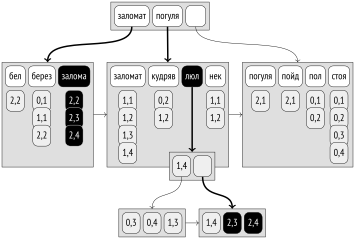
频繁与稀有词元:заломатзаломатпогуляпогуля;белбереззаломазаломаткудрявлюлнекпогуляпойдполстоя;2,20,12,21,10,21,12,12,10,10,1;1,12,31,21,21,20,20,2;2,22,41,30,3;1,40,4;1,4;0,30,41,31,42,32,4
图 28.3 频繁词和稀有词

标识符列表的长度将等于三个,即稀有词出现的次数:

tid«залома»«люл»一致性函数
(2,2)✓––
(2,3)✓✓✓
(2,4)✓✓✓
表 28.2 一致性函数:必需词和可选词

因此,了解词频可以以最有效的方式组织合并过程,从稀有词开始,并跳过在频繁词树中明显不必要的页面范围。这种优化也减少了对一致性函数的调用次数。(参见 360)

当然,这种优化不仅适用于两个词,也适用于更复杂的情况。在索引中进行搜索时,必需词应被选择为确保不会遗漏任何符合查询条件的文档。算法将词按从稀有到频繁的顺序排序,然后逐个将它们添加到必需词列表中,直到满足条件为止。剩余的词被视为可选词9。

例如,考虑查询「заломати & ( некому | белую )」。最稀有的词是「бел」,它立即被添加到必需词列表中。是否存在一种情况:文档不包含任何必需词,但仍符合查询?为了验证这一点,将虚假值传递给必需词,而将真值传递给其余词。在这种情况下,一致性函数返回 true AND (true OR false) = true,这意味着部分文档可能被遗漏,因此必需词集合必须至少扩展一个剩余词。

接下来将频率第二高的词「нек」添加到必需词列表中,此时一致性函数返回 true AND (false OR false) = false。因此,词「бел」和「нек」成为必需词,而「заломат」成为可选词。

为了验证这种优化的有效性,我们使用 pgsql-hackers 邮件列表存档。我们需要两个词:一个常见词和一个稀有词:(参见 584)

=> SELECT word, ndoc
FROM ts_stat('SELECT tsv FROM mail_messages')
WHERE word IN ('wrote', 'tattoo');
  word  |  ndoc
--------+--------
 wrote  | 231173
 tattoo |      2
(2 rows)

实际上,存在一个文档同时包含这两个词:

=> \timing on
=> SELECT count(*) FROM mail_messages
WHERE tsv @@ to_tsquery('wrote & tattoo');
 count
-------
     1
(1 row)
Time: 0.219 ms

查询的执行速度几乎与搜索单个词「tattoo」一样快:

=> SELECT count(*) FROM mail_messages
WHERE tsv @@ to_tsquery('tattoo');
 count
-------
     2
(1 row)
Time: 0.453 ms

而搜索单个词「wrote」则明显慢得多:

=> SELECT count(*) FROM mail_messages
WHERE tsv @@ to_tsquery('wrote');
 count
--------
 231173
(1 row)
Time: 82.090 ms
=> \timing off

插入

向 GIN 索引中添加元素时10,现有元素不会被重复存储;相反,现有元素的标识符集合(列表或树)会被扩展。标识符列表是索引行的一部分,不能占用页面上过多空间,因此当列表溢出时,它会被转换为树结构11。

在向树中插入新元素(或新标识符)时,可能会导致页面溢出;此时页面会被分裂为两个,元素会在它们之间重新分配12。

但通常每个文档包含大量需要索引的词。因此,创建或修改单个文档时,必须同时对索引树进行大量更改。由于这一原因,GIN 索引的更新相对缓慢。

图中显示了在表中插入标识符为 (4,1) 的行「Некому заломати белую березу」后的树状结构。词「бел」、「берез」和「нек」的标识符列表已扩大,而词「заломат」的列表超过了最大尺寸,因此被单独分配为一棵树。

另一方面,如果在索引中同时考虑多个文档的更改,与逐个更改相比,总体工作量可能减少,因为不同文档的词很可能存在重叠。

这种延迟更新模式通过存储参数 fastupdate 启用。在此模式下,更改会累积到一个单独的无序列表中,该列表在物理上存储在树外的独立页面(列表页面)中。当该列表变得足够大时,所有累积的更改会一次性应用到索引中,然后列表被清空13。列表的最大大小由参数 gin_pending_list_limit 或同名的索引存储参数决定。(默认值:on)(参见 296)(默认值:4MB)
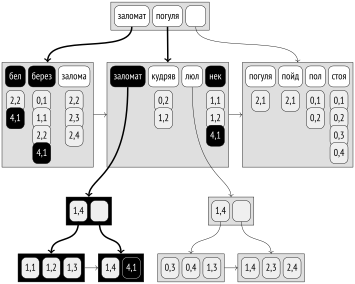
插入:заломатзаломатпогуляпогуля; белбереззаломазаломаткудрявлюлнекпогуляпойдполстоя; 2,20,12,20,21,12,12,10,10,1; 4,11,12,31,21,20,20,2; 2,22,44,10,3; 4,10,4; 1,41,4; 1,11,21,31,44,10,30,41,31,42,32,4
图 28.4 插入

默认情况下,延迟模式已启用,但需要注意的是,它会减慢搜索速度:除了树之外,还必须扫描整个无序列表。此外,插入时间变得不可预测,因为每次更改时列表可能溢出,需要执行代价高昂的合并操作。最后一点部分被以下事实缓解:合并操作也发生在索引清理过程中,即异步执行。

创建新索引14时,元素也不是逐个添加的(那样太慢),而是以延迟方式添加。与磁盘上的无序列表不同,更改在大小为 maintenance_work_mem 的内存区域中累积,并在溢出时一次性写入索引。分配给该操作的内存越多,索引构建速度就越快。(默认值:64MB)

本节中的示例表明,GIN 在搜索精度方面优于 GiST 签名树。因此,在大多数情况下,GIN 被用于支持全文搜索。然而,GIN 更新缓慢的问题可能会影响选择,当数据频繁更改时,可能会倾向于选择 GiST。(参见 578)

限制结果集大小

GIN 访问方法始终以位图形式返回结果;无法逐个获取表标识符。换句话说,支持 BITMAP SCAN 属性,但不支持 INDEX SCAN。(参见 409)

原因在于存在无序的延迟更改列表。在索引访问时,首先扫描列表并生成位图,然后用树中的数据更新位图。如果在搜索过程中无序列表与树合并(例如索引更新或清理过程中),同一个值可能会被获取两次,这是不允许的。但在位图情况下,这没有问题:同一个位被设置两次也无妨。

因此,使用 GIN 索引时,通过 LIMIT 子句限制结果集并不完全高效,因为位图无论如何都会完全构建,其构建成本可能占总成本的很大一部分:

=> EXPLAIN SELECT * FROM mail_messages
WHERE tsv @@ to_tsquery('hacker')
LIMIT 1000;
                        QUERY PLAN
-----------------------------------------------------------
 Limit  (cost=343.76..1869.59 rows=1000 width=1256)
   -> Bitmap Heap Scan on mail_messages
       (cost=343.76..73593.12 rows=48006 width=1256)
       Recheck Cond: (tsv @@ to_tsquery('hacker'::text))
       -> Bitmap Index Scan on mail_gin_idx
           (cost=0.00..331.76 rows=48006 width=0)
           Index Cond: (tsv @@ to_tsquery('hacker'::text))
(7 rows)

因此,GIN 方法具有特殊功能,可以限制从索引中获取的结果数量。该限制由参数 gin_fuzzy_search_limit 设置,默认不生效。如果启用此参数,索引方法将随机跳过某些值,以获得大约指定数量的行15(因此称为 fuzzy):(默认值:0)

=> SET gin_fuzzy_search_limit = 1000;
=> SELECT count(*)
FROM mail_messages
WHERE tsv @@ to_tsquery('hacker');
 count
-------
   766
(1 row)
=> SELECT count(*)
FROM mail_messages
WHERE tsv @@ to_tsquery('hacker');
 count
-------
   767
(1 row)
=> RESET gin_fuzzy_search_limit;

请注意查询中没有 LIMIT 子句。这是在索引访问和表访问中获取不同数据的唯一“合法”方式。规划器对此 GIN 索引的特性一无所知,也不会在成本计算中考虑该参数的值。

属性

访问方法 gin 的所有层级属性都相同,且不依赖于特定的操作符类。

访问方法层级属性

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'gin';
 amname |     name      | pg_indexam_has_property
--------+---------------+-------------------------
 gin    | can_order     | f
 gin    | can_unique    | f
 gin    | can_multi_col | t
 gin    | can_exclude   | f
 gin    | can_include   | f
(5 rows)

GIN 不支持值的排序或唯一性。

支持复合索引的创建。有趣的是,对于 GIN,索引中列的顺序无关紧要。与普通 B-树不同,多列 GIN 索引不存储复合键,而是存储单独的元素,并附加列号信息。

不支持排除约束,因为不支持 INDEX SCAN 属性。

GIN 不支持额外的 include 列。这在逻辑上也无意义,因为 GIN 索引几乎不可能作为覆盖索引使用:索引值存储在表中,而索引仅包含该值的元素。

索引层级属性

=>  SELECT p.name, pg_index_has_property('mail_gin_idx', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
---------------+-----------------------
 clusterable   | f
 index_scan    | f
 bitmap_scan   | t
 backward_scan | f
(4 rows)

不支持逐个返回结果,索引访问始终返回位图结果。

因此,对 GIN 索引进行排序表没有意义:位图在定义上对应于表中数据的物理位置,无论其如何排列。

不支持反向扫描 GIN 索引:此功能仅对索引扫描有意义,而对位图扫描无意义。

列层级属性

=> SELECT p.name,
  pg_index_column_has_property('mail_gin_idx', 1, p.name)
FROM unnest(array[
  'orderable', 'search_array', 'search_nulls',
  'returnable', 'distance_orderable'
]) p(name);
        name        | pg_index_column_has_property
--------------------+------------------------------
 orderable          | f
 search_array       | f
 search_nulls       | f
 returnable         | f
 distance_orderable | f
(5 rows)

列层级属性均不可用:既不支持排序(显而易见),也不支持将索引用作覆盖索引(因为文档本身不存储在索引中),也不支持处理空值(对非原子类型元素无意义)。

GIN 的限制和 RUM 索引

尽管 GIN 功能强大,但并不能解决全文搜索的所有问题。在 tsvector 数据类型中存在词的位置信息,但这些信息不会进入索引。这使得 GIN 无法高效支持短语搜索(即考虑词的接近性)。此外,搜索系统通常按相关性顺序返回结果(无论该术语具体含义如何)。由于 GIN 不支持排序操作符,唯一的方法是为每个结果行计算排名函数,这显然很慢。

这些缺点在 RUM 索引方法中得到了解决,其名称让人怀疑开发者对 GIN 缩写含义的真诚度。RUM 是一个外部访问方法;该扩展既可通过 PGDG 仓库16的包形式获取,也可通过源代码17获取。

RUM 基于 GIN 构建,与 GIN 有两个根本性区别。首先,它放弃了延迟更新模式;通过这一改进,不仅支持位图扫描,还支持常规索引扫描,并实现了排序操作符。其次,可以在索引键上附加辅助信息。这在某种程度上类似于额外的 include 列,但信息与特定键绑定。在全文搜索的上下文中,RUM 操作符类将词的出现位置与文档中的位置关联起来,从而加速短语搜索和按相关性排序的结果输出。

这种方法的缺点是更新速度慢且索引体积增大。此外,作为扩展,rum 索引方法使用统一日志记录机制18,其性能低于内核内置的日志记录机制,并生成更多 WAL 数据。

28.3. 三元组

扩展 pg_trgm19 允许通过比较三字母序列(即“三元组”)的匹配数量来判断词语的相似性。它可与全文搜索结合使用,即使在输入有拼写错误的词时也能找到变体。

操作符类 gin_trgm_ops 实现了对文本字符串的索引,但文本值的元素不是词或词元,而是所有可能的三字符子串(仅使用字母和数字,其他字符被忽略)。在索引内部,三元组以整数形式表示:对于 UTF-8 编码中占两个字节的俄文字母,这种编码无法还原原始字符。因此,我将在使用八位编码的数据库中展示三元组的生成方式:

=> CREATE DATABASE eightbit
WITH ENCODING 'KOI8R'
LC_CTYPE='ru_RU.koi8r'
LC_COLLATE='ru_RU.koi8r'
TEMPLATE=template0; -- кодировки базы и кластера не совпадают
=> \c eightbit
=> CREATE EXTENSION pg_trgm;
=> SET client_encoding = 'UTF8';
=> SELECT unnest(show_trgm('заломаю')),
          unnest(show_trgm('заломати'));
 unnest | unnest
--------+--------
 аю     | ало
 ало    | ати
 лом    | лом
 маю    | мат
 ома    | ома
 зал    | ти
  за    | зал
   з    |  за
        |   з
(9 rows)

该操作符类支持字符串和词的精确与模糊比较操作符。

=> CREATE EXTENSION pg_trgm;
=> SELECT amopopr::regoperator, oprcode::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'gin_trgm_ops'
ORDER BY amopstrategy;
    amopopr     |               oprcode
----------------+--------------------------------------
 %(text,text)   | similarity_op
 ~~(text,text)  | textlike        ┐
 ~~*(text,text) | texticlike      ┘ LIKE и ILIKE
 ~(text,text)   | textregexeq     ┐
 ~*(text,text)  | texticregexeq   ┘ регулярные выражения
 %>(text,text)  | word_similarity_commutator_op
 %>>(text,text) | strict_word_similarity_commutator_op
 =(text,text)   | texteq
(8 rows)

对于模糊比较,可以将字符串之间的距离定义为匹配三元组数量与查询字符串中三元组总数的比值。但如前所述,GIN 索引不支持排序操作符,因此类中所有操作符必须为布尔型。因此,对于实现模糊比较策略的 %、%> 和 %>> 操作符,一致性函数计算距离,并在距离不超过设定阈值时返回真值。(psql: \dAo)

对于 = 和 LIKE 操作符,一致性函数要求值中包含查询字符串中的所有三元组。正则表达式匹配的检查要复杂得多。

无论如何,基于三元组的搜索都是不精确的,并且始终需要通过表进行重新验证。

28.4. 索引数组

另一个适合的类型示例是数组。基于数组元素的 GIN 索引可以更快地查找数组交集以及一个数组是否包含在另一个数组中:

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'array_ops'
ORDER BY amopstrategy;
        amopopr        |    oprcode     | amopstrategy
-----------------------+----------------+--------------
 &&(anyarray,anyarray) | arrayoverlap   |            1
 @>(anyarray,anyarray) | arraycontains  |            2
 <@(anyarray,anyarray) | arraycontained |            3
 =(anyarray,anyarray)  | array_eq       |            4
(4 rows)

以 demo 数据库中的 routes 视图为例,该视图包含航班信息。days_of_week 列存储了航班运行的星期几编号数组。当然,要建立索引,必须将该视图「物化」:(psql: \dAo)

=> CREATE TABLE routes_tbl
  AS SELECT * FROM routes;
SELECT 710
=> CREATE INDEX ON routes_tbl USING gin(days_of_week);

使用创建的索引,例如可以筛选出在星期二、星期四和星期日出发的航班。我禁用了顺序扫描,因为否则规划器不会为这么小的表使用索引:

=> SET enable_seqscan = off;
=> EXPLAIN (costs off) SELECT *
FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7];
                       QUERY PLAN
---------------------------------------------------------
 Bitmap Heap Scan on routes_tbl
   Recheck Cond: (days_of_week = '{2,4,7}'::integer[])
   -> Bitmap Index Scan on routes_tbl_days_of_week_idx
       Index Cond: (days_of_week = '{2,4,7}'::integer[])
(4 rows)

结果发现共有十一个这样的航班:

=> SELECT flight_no, departure_airport_name AS departure,
  arrival_airport_name AS arrival, days_of_week
FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7];
 flight_no |  departure  |     arrival     | days_of_week
-----------+-------------+-----------------+--------------
 PG0023    | Орск        | Курган          | {2,4,7}
 PG0123    | Бегишево    | Ростов-на-Дону  | {2,4,7}
 ...
 PG0482    | Домодедово  | Кемерово        | {2,4,7}
 PG0651    | Усть-Илимск | Хабаровск-Новый | {2,4,7}
(11 rows)

所构建的索引仅包含七个元素:代表星期几的整数 1 到 7。

查询的执行方式与我之前展示的全文搜索类似。在这种情况下,搜索查询不是通过特殊数据类型表示,而是通过普通数组;该查询意味着在被索引的数组中必须包含所有列出的元素。重要区别在于,等于 条件还要求被索引的数组不包含任何其他元素。一致性函数 20 通过策略编号了解这一特性,但无法确认不存在多余元素,因此要求索引机制重新验证结果:

=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT * FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7];
                             QUERY PLAN
---------------------------------------------------------------------
 Bitmap Heap Scan on routes_tbl (actual rows=11.00 loops=1)
   Recheck Cond: (days_of_week = '{2,4,7}'::integer[])
   Rows Removed by Index Recheck: 482
   Heap Blocks: exact=17
   -> Bitmap Index Scan on routes_tbl_days_of_week_idx (actual ro...
       Index Cond: (days_of_week = '{2,4,7}'::integer[])
       Index Searches: 1
(7 rows)

扩展 GIN 索引,添加其他列可能很有用。例如,要查找从莫斯科出发且在星期二、星期四和星期日出发的航班,索引中缺少 departure_city 列。然而,对于普通标量数据类型,未提供操作符类:

=> CREATE INDEX ON routes_tbl USING gin(days_of_week, departure_city);
ERROR:  data type text has no default operator class for access method
"gin"
HINT:  You must specify an operator class for the index or define a
default operator class for the data type.

在这种情况下,btree_gin 扩展可提供帮助。它添加了 GIN 操作符类,模拟普通 B-树的行为,将标量值视为包含一个元素的复合值。(参见 573)

=> CREATE EXTENSION btree_gin;
=> CREATE INDEX ON routes_tbl USING gin(days_of_week,departure_city);
=> EXPLAIN (costs off)
SELECT * FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7]
AND departure_city = 'Москва';
                             QUERY PLAN
---------------------------------------------------------------------
 Bitmap Heap Scan on routes_tbl
   Recheck Cond: ((days_of_week = '{2,4,7}'::integer[]) AND
   (departure_city = 'Москва'::text))
   -> Bitmap Index Scan on routes_tbl_days_of_week_departure_city...
       Index Cond: ((days_of_week = '{2,4,7}'::integer[]) AND
       (departure_city = 'Москва'::text))
(6 rows)
=> RESET enable_seqscan;

关于 btree_gist 扩展的评论依然成立:B-树在支持比较操作方面效率高得多,因此仅在确实需要 GIN 索引时才应使用该扩展。例如,B-树中「小于」或「小于等于」的查询通过反向扫描叶页面实现,而 GIN 不支持此类操作。

28.5. 索引 JSON

另一个具有内置 GIN 支持的非原子数据类型是 jsonb21。为 JSON 提供了一整套操作符,其中部分操作符可通过 GIN 索引加速。

存在两个操作符类,它们从 JSON 文档中提取不同的元素集合:

=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'gin'
AND opcintype = 'jsonb'::regtype;
    opcname
----------------
 jsonb_ops
 jsonb_path_ops
(2 rows)

jsonb_ops 操作符类

第一个操作符类 jsonb_ops 是默认使用的。索引中作为元素包含原始 JSON 文档中的所有键、所有值以及所有数组元素22。这有助于加速包含 JSON 值的查询(@>)、键的存在性查询(?、?| 和 ?&)以及 JSON 路径匹配查询(@? 和 @@):(psql: \dAo)

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'jsonb_ops'
ORDER BY amopstrategy;
      amopopr       |        oprcode        | amopstrategy
--------------------+-----------------------+--------------
 @>(jsonb,jsonb)    | jsonb_contains        |            7
 ?(jsonb,text)      | jsonb_exists          |            9
 ?|(jsonb,text[])   | jsonb_exists_any      |           10
 ?&(jsonb,text[])   | jsonb_exists_all      |           11
 @?(jsonb,jsonpath) | jsonb_path_exists_opr |           15
 @@(jsonb,jsonpath) | jsonb_path_match_opr  |           16
(6 rows)

以 routes 表中的几行数据为例,将其表示为 JSON 格式:

=> CREATE TABLE routes_jsonb AS
SELECT to_jsonb(t) route
FROM (
  SELECT departure_airport_name, arrival_airport_name, days_of_week
  FROM routes
  ORDER BY flight_no
  LIMIT 4
) t;
=> CREATE INDEX ON routes_jsonb USING gin(route);
=> SELECT ctid, jsonb_pretty(route) FROM routes_jsonb;
 ctid  |                 jsonb_pretty
-------+-----------------------------------------------
 (0,1) | {                                            +
       |     "days_of_week": [                        +
       |         6                                    +
       |     ],                                       +
       |     "arrival_airport_name": "Сургут",        +
       |     "departure_airport_name": "Усть-Илимск"  +
       | }
 (0,2) | {                                            +
       |     "days_of_week": [                        +
       |         7                                    +
       |     ],                                       +
       |     "arrival_airport_name": "Усть-Илимск",   +
       |     "departure_airport_name": "Сургут"       +
       | }
 (0,3) | {                                            +
       |     "days_of_week": [                        +
       |         2,                                   +
       |         6                                    +
       |     ],                                       +
       |     "arrival_airport_name": "Сочи",          +
       |     "departure_airport_name": "Иваново-Южный"+
       | }
 (0,4) | {                                            +
       |     "days_of_week": [                        +
       |         3,                                   +
       |         7                                    +
       |     ],                                       +
       |     "arrival_airport_name": "Иваново-Южный", +
       |     "departure_airport_name": "Сочи"         +
       | }
(4 rows)

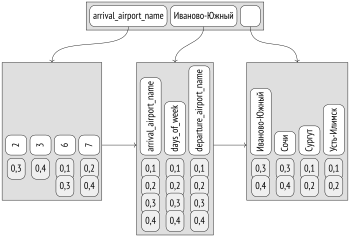
所创建的索引可以如下表示:

操作符类 jsonb\_ops: arrival\_airport\_namearrival\_airport\_nameИваново-ЮжныйИваново-Южный; arrival\_airport\_namedays\_of\_weekdeparture\_airport\_nameИваново-ЮжныйСочиСургутУсть-Илимск; 2367; 0,30,40,10,20,10,10,10,30,30,10,1; 0,30,40,20,20,20,40,40,20,2; 0,30,30,3; 0,40,40,4
图 28.5 操作符类 jsonb_ops

考虑查询条件 route @> '{"days_of_week": [6]}',该条件筛选出包含指定路径的 JSON 文档(即在星期六运行的航班)。

从 JSON 值表示的搜索查询中,基础函数 23 提取搜索键:「days_of_week」和「6」。这些键在元素树中被查找,包含至少一个搜索键的文档将由一致性函数24 进行检查。对于「包含」策略,函数要求搜索查询中的所有键都必须存在,但结果仍需通过表重新验证,因为从索引角度看,指定路径可能对应文档 {"days_of_week": [2], "foo": [6]}。

jsonb_path_ops 操作符类

第二个操作符类 jsonb_path_ops 包含更少的操作符:(psql: \dAo)

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'jsonb_path_ops'
ORDER BY amopstrategy;
      amopopr       |        oprcode        | amopstrategy
--------------------+-----------------------+--------------
 @>(jsonb,jsonb)    | jsonb_contains        |            7
 @?(jsonb,jsonpath) | jsonb_path_exists_opr |           15
 @@(jsonb,jsonpath) | jsonb_path_match_opr  |           16
(3 rows)

在这种情况下,索引中并非存储分散的 JSON 片段,而是从文档根到所有值和所有数组元素的完整路径25。这使得搜索更加精确和高效,但无法加速以非路径作为参数的操作。

由于路径可能相当长,实际上索引的不是路径本身,而是其哈希函数值。

为同一张表创建使用此操作符类的索引:

=> CREATE INDEX ON routes_jsonb USING gin(route jsonb_path_ops);

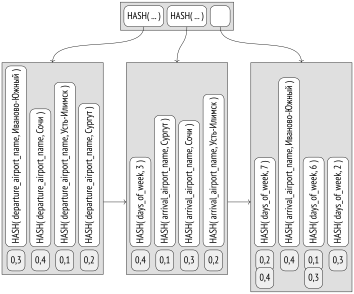
可以这样表示所创建索引的树结构:

操作符类 jsonb\_path\_ops: HASH( … )HASH( … )HASH( … )HASH( … ); HASH( departure\_airport\_name,Иваново-Южный )HASH( departure\_airport\_name,Сочи )HASH( departure\_airport\_name,Усть-Илимск )HASH( departure\_airport\_name,Сургут )HASH( days\_of\_week,3 )HASH( arrival\_airport\_name,Сургут )HASH( arrival\_airport\_name,Сочи )HASH( arrival\_airport\_name,Усть-Илимск )HASH( days\_of\_week,7 )HASH( arrival\_airport\_name,Иваново-Южный )HASH( days\_of\_week,6 )HASH( days\_of\_week,2 ); 0,30,40,10,20,40,10,30,20,20,40,10,3; 0,40,3
图 28.6 操作符类 jsonb_path_ops

在执行相同条件 route @> '{"days_of_week": [6]}' 的查询时,基础函数 26 从搜索查询中提取的不是单独的片段,而是整个路径「days_of_week, 6」。在元素树中立即找到两个匹配文档的标识符。

当然,在这种情况下,找到的记录仍需由一致性函数 27 检查,然后由索引机制根据表重新验证(至少由于哈希冲突的可能性)。但树中搜索的效率要高得多,因此只要查询操作符支持,应始终选择 jsonb_path_ops 类。

28.6. 索引其他数据类型

以下是为某些数据类型添加 GIN 支持的其他扩展。

整数数组。 扩展 intarray 添加了整数数组的操作符类 gin__int_ops。它几乎与标准操作符类 array_ops 相同,但支持搜索查询匹配操作符 @@。

键值存储。 扩展 hstore 实现了键值对存储,并提供了操作符类 gin_hstore_ops。索引中包含键和值。

JSON 查询语言。 第三方扩展 jsquery 提供了自定义查询语言,并支持 JSON 的 GIN 索引。

随着 SQL:2016 标准的采纳以及 PostgreSQL 中 SQL/JSON 路径语言的实现,标准功能显得更具优势。(v. 12)


  1. postgrespro.ru/docs/postgresql/18/gin; backend/access/gin/README. ↩︎

  2. backend/access/gin/ginpostinglist.c. ↩︎

  3. postgrespro.ru/docs/postgresql/18/gin-extensibility; backend/utils/adt/tsginidx.c. ↩︎

  4. backend/utils/adt/tsvector_op.c, 函数 ts_match_vq. ↩︎

  5. backend/utils/adt/tsginidx.c, 函数 gin_extract_tsquery. ↩︎

  6. backend/access/gin/ginget.c, 函数 keyGetItem. ↩︎

  7. backend/utils/adt/tsginidx.c, 函数 gin_tsquery_triconsistent. ↩︎

  8. backend/utils/adt/tsginidx.c, 函数 gin_cmp_prefix. ↩︎

  9. backend/access/gin/ginget.c, 函数 startScanKey. ↩︎

  10. backend/access/gin/gininsert.c, 函数 ginEntryInsert. ↩︎

  11. backend/access/gin/gininsert.c, 函数 addItemPointersToLeafTuple. ↩︎

  12. backend/access/gin/ginbtree.c, 函数 ginInsertValue. ↩︎

  13. backend/access/gin/ginfast.c, 函数 ginInsertCleanup. ↩︎

  14. backend/access/gin/gininsert.c, 函数 ginbuild. ↩︎

  15. backend/access/gin/ginget.c, 宏 dropItem. ↩︎

  16. postgresql.org/download. ↩︎

  17. github.com/postgrespro/rum. ↩︎

  18. postgrespro.ru/docs/postgresql/18/generic-wal. ↩︎

  19. postgrespro.ru/docs/postgresql/18/pgtrgm. ↩︎

  20. backend/access/gin/ginarrayproc.c, 函数 ginarrayconsistent. ↩︎

  21. postgrespro.ru/docs/postgresql/18/datatype-json. ↩︎

  22. backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb. ↩︎

  23. backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb_query. ↩︎

  24. backend/utils/adt/jsonb_gin.c, 函数 gin_consistent_jsonb. ↩︎

  25. backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb_path. ↩︎

  26. backend/utils/adt/jsonb_gin.c, 函数 gin_extract_jsonb_query_path. ↩︎

  27. backend/utils/adt/jsonb_gin.c, 函数 gin_consistent_jsonb_path. ↩︎