# SP-GiST
LLMS 索引: [llms.txt](/zh18/llms.txt)
---
## 27.1. 总览 {#internal-ru-section-27-1}
SP-GiST 名称中的字母 "SP" 代表 Space Partitioning,即空间划分。此处的 "空间" 指的是任意值域,而不仅仅是日常理解中的空间(例如二维平面)。而 "GiST" 则暗示了与该方法的某种相似性:GiST 和 SP-GiST 都是广义的搜索树,作为各种数据类型索引的框架。
SP-GiST 方法的核心思想是将搜索空间划分为互不重叠的区域,而每个区域本身也可以递归地进一步划分为子区域。这种划分方式生成的是 *非平衡树*(与 B-树和 GiST 方法不同),可用于实现诸如四叉树(quadtree)、k-维树(k-D tree)或前缀树(trie)等知名结构。 [^internal-ru-590-1]
通常这类树分支较少,因此深度较大。例如,四叉树的节点最多有四个子节点,而 k-维树的节点仅有两个。当树驻留在内存中时,这并非问题;但对于磁盘上的表示,必须解决一个复杂的问题:如何高效地将节点打包到页面中,以最小化输入/输出操作。B-树和 GiST 无需处理此问题,因为每个树节点恰好占据一个完整的页面。
SP-GiST 树的内部节点包含一个值,该值对应于所有子节点都满足的条件。这种值通常称为 *前缀*;它在 SP-GiST 中的作用与 GiST 索引中的 *谓词* 相同。SP-GiST 中的子节点引用可以带有 *标签*。
叶节点中的元素包含可索引的值(或其一部分)以及相应行版本的标识符。
与 GiST 一样,SP-GiST 访问方法仅实现基本算法,并负责诸如并发访问、锁定和日志记录等底层任务。为了添加新的数据类型和空间划分算法,该方法提供了操作符类接口。操作符类包含大量逻辑,并定义了索引工作的许多方面。
在 SP-GiST 树中的搜索 [^internal-ru-591-1] 从根节点开始,并以深度优先方式进行。选择有理由进入的节点,是通过一个类似 GiST 中的 *一致性* 参考函数实现的。对于树的内部节点,该函数返回一组与搜索谓词 *一致* 的子节点。函数通过检查前缀值和标签来选择节点,而不实际进入它们。对于叶节点,该函数判断该节点中的索引值是否满足搜索谓词。
由于非平衡树中分支深度不同,查找值的时间可能有所差异。
在 SP-GiST 树中插入值时使用两个参考函数。从根节点开始,*选择函数* 决定一个可能的方案:将新值发送到现有子节点、为它创建一个新子节点,或者(如果值与节点前缀不一致)分裂当前节点。在最终选定的索引叶页面中,可能没有足够的空间,此时 *分裂函数* 决定哪些节点应移动到新页面。
接下来我将通过具体示例来讨论这些算法。
## 27.2. 点的四叉树 {#internal-ru-section-27-2}
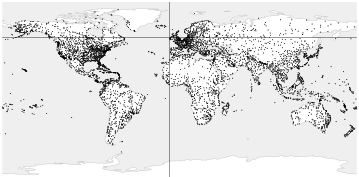
*四叉树*(quadtree)用于索引平面上的点。区域通过相对于选定点递归划分为四个部分(象限)。该点称为 *质心*,作为节点的前缀,即确定子值位置的条件。
根节点将平面划分为四个象限。
{#internal-ru-fig-27-1 num="27.1" caption="点的四叉树" .book-original-figure width=718 height=354}
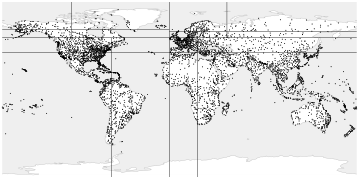
然后每个象限进一步划分为其自身的象限。
{#internal-ru-fig-27-2 num="27.2" caption="点的四叉树" .book-original-figure width=718 height=354}
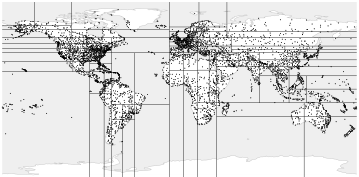
该过程持续进行,直到获得最终划分。
{#internal-ru-fig-27-3 num="27.3" caption="点的四叉树" .book-original-figure width=718 height=354}
本例使用基于扩展机场表构建的索引。图中可见,树的分支深度因相应象限中点的密度不同而异。为直观展示,我设置了较小的存储参数 *fillfactor* 值,使树具有更多层级:(参见 [558](/zh18/26-gist/#internal-ru-page-559))(默认值:`80`)
```text {label="psql"}
=> CREATE INDEX airports_quad_idx ON airports_big
USING spgist(coordinates) WITH (fillfactor = 10);
```
默认情况下,点类型使用操作符类 `quad_point_ops`。
### 操作符类 {#internal-ru-subsection-star-415}
我已提及 SP-GiST 的主要参考函数:用于搜索的一致性函数,以及用于插入的选择函数和分裂函数。
以下是操作符类 `quad_point_ops`[^internal-ru-593-2] 实现的参考函数列表[^internal-ru-593-1]。所有函数均为必需。
```text {label="psql"}
=> SELECT amprocnum, amproc::regproc
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'spgist'
AND opcname = 'quad_point_ops'
ORDER BY amprocnum;
amprocnum | amproc
-----------+---------------------------
1 | spg_quad_config
2 | spg_quad_choose
3 | spg_quad_picksplit
4 | spg_quad_inner_consistent
5 | spg_quad_leaf_consistent
(5 rows)
```
这些函数的含义如下:(psql: `\dAp`)
1) 配置函数,向访问方法报告操作符类的特性;
2) 插入值时选择节点的函数;
3) 分裂时节点分配的函数;
4) 内部一致性函数,用于判断搜索谓词是否与 *内部* 节点中的值一致;
5) 叶节点一致性函数,用于判断搜索谓词是否与 *叶* 节点中的值一致。
除了上述函数外,还有若干可选函数。
操作符类 `quad_point_ops` 支持与 GiST 共享的策略 [^internal-ru-594-1]:(参见 [562](/zh18/26-gist/#internal-ru-page-563))(psql: `\dAo`)
```text {label="psql"}
=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amop amop ON amopfamily = opcfamily
JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'spgist'
AND opcname = 'quad_point_ops'
ORDER BY amopstrategy;
amopopr | oprcode | amopstrategy
------------------+----------------+--------------
<<(point,point) | point_left | 1
>>(point,point) | point_right | 5
~=(point,point) | point_eq | 6
<@(point,box) | on_pb | 8
<<|(point,point) | point_below | 10
|>>(point,point) | point_above | 11
<->(point,point) | point_distance | 15
<^(point,point) | point_below | 29
>^(point,point) | point_above | 30
(9 rows)
```
例如,使用 "上方" 操作符 `>^` 可以查找位于迪克斯顿以北的机场:
```text {label="psql"}
=> SELECT airport_code, airport_name->>'en'
FROM airports_big
WHERE coordinates >^ '(80.3817,73.5167)'::point;
airport_code | ?column?
--------------+----------------------------
THU | Thule Air Base
YEU | Eureka Airport
YLT | Alert Airport
YRB | Resolute Bay Airport
LYR | Svalbard Airport, Longyear
NAQ | Qaanaaq Airport
YGZ | Grise Fiord Airport
DKS | Dikson Airport
(8 rows)
=> EXPLAIN (costs off) SELECT airport_code
FROM airports_big
WHERE coordinates >^ '(80.3817,73.5167)'::point;
QUERY PLAN
---------------------------------------------------------------
Bitmap Heap Scan on airports_big
Recheck Cond: (coordinates >^ '(80.3817,73.5167)'::point)
-> Bitmap Index Scan on airports_quad_idx
Index Cond: (coordinates >^ '(80.3817,73.5167)'::point)
(4 rows)
```
现在我们通过一个包含多个点的简单示例,更详细地探讨四叉树的结构与工作原理,该示例我们在讨论 GiST 的章节中已见过。(参见 [563](/zh18/26-gist/#internal-ru-page-564))
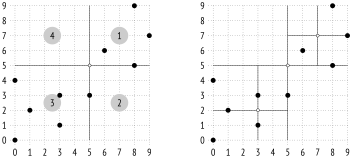
以下是该情况下平面划分的可能形式:
{#internal-ru-fig-27-4 num="27.4" caption="操作符类" .book-original-figure width=705 height=319}
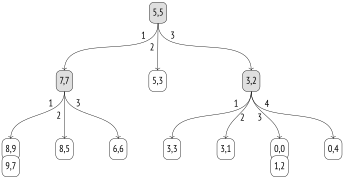
左图展示了单层树中象限的编号;在后续图示中,我将明确地按从左到右的顺序排列子节点。位于边界上的点归入编号较小的象限。右图展示了最终划分结果。
以下是该示例可能的索引结构。每个内部节点最多引用四个子节点,每条引用均带有象限编号:
{#internal-ru-fig-27-5 num="27.5" caption="操作符类" .book-original-figure width=688 height=357}
### 页面布局 {#internal-ru-subsection-star-417}
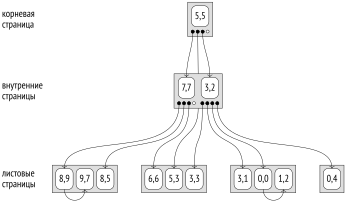
SP-GiST 树节点与页面之间没有像 B-树和 GiST 索引那样的一一对应关系。由于内部节点通常子节点不多,一个页面需打包多个节点。内部节点存储在一类(*内部*)页面中,而叶节点则存储在另一类(*叶*)页面中。
内部页面的索引记录包含用作前缀的值,以及一组指向子节点的引用,每条引用可附带标签。
叶页面的记录由值和表行版本的标识符组成。
属于同一内部节点的所有叶节点存储在同一页面中,并以链表形式连接。如果页面空间不足,链表可被移动到另一页面 [^internal-ru-597-1],或发生分裂,但无论如何,链表绝不会跨多个页面断裂。
为节省空间,算法会尽量将新节点放置在已使用的页面中,直到页面填满。服务进程会缓存最近使用的页面编号,并定期将其保存到编号为零的 *元页面* 中。与 B-树不同,元页面不指向根节点;SP-GiST 的根节点始终位于第一页面。
> [!NOTE]
> 不幸的是,`pageinspect` 没有提供用于研究 SP-GiST 索引的函数,但可以使用第三方扩展 `gevel`[^internal-ru-597-2] 作为替代。曾尝试将 `gevel` 的功能移植到 `pageinspect`,但未成功[^internal-ru-597-3]。
下图展示了我们示例中树节点在页面上的分布方式。实际上,操作符类 `quad_point_ops` 并不使用标签。由于子节点数量不超过四个,因此存储一个固定大小的四元素引用数组,其中部分元素可能为空。
{#internal-ru-fig-27-6 num="27.6" caption="页面组织" .book-original-figure width=693 height=412}
### 搜索 {#internal-ru-subsection-star-419}
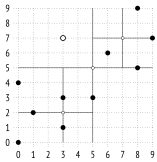
让我们用同一个例子来考察查找位于点 (3,7) 上方的点的算法。
{#internal-ru-fig-27-7 num="27.7" caption="查找" .book-original-figure width=315 height=325}
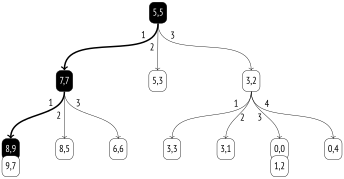
查找从根节点开始。内部一致性函数 [^internal-ru-599-1] 指明应进入哪些子节点。点 (3,7) 与根节点的质心 (5,5) 进行比较,选择可能包含目标点的象限——本例中为第一象限和第四象限。
在质心为 (7,7) 的节点中,再次选择子节点进入。第一和第四象限适用,但第四象限为空,因此必须检查一个叶节点子节点。使用叶节点一致性函数[^internal-ru-599-2] 将其点与查询中的点 (3,7) 进行比较。其中只有 (8,9) 满足“上方”条件。
然后返回上一级,检查对应于根节点第四象限的节点。该节点为空,查找结束。
{#internal-ru-fig-27-8 num="27.8" caption="查找" .book-original-figure width=688 height=357}
### 插入 {#internal-ru-subsection-star-421}
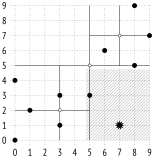
在 SP-GiST 树中插入值时 [^internal-ru-599-3],每一步操作由选择函数[^internal-ru-599-4] 决定。本例中,该函数简单地将新点引导至其所属的现有象限。
例如,添加值 (7,1):
{#internal-ru-fig-27-9 num="27.9" caption="插入" .book-original-figure width=308 height=319}
该值属于第二象限,将被添加到树中相应的节点中:
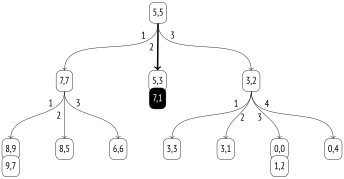
{#internal-ru-fig-27-10 num="27.10" caption="插入" .book-original-figure width=688 height=357}
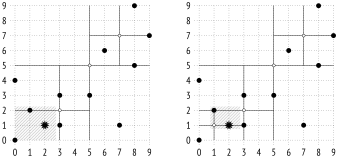
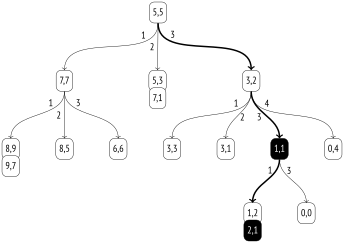
如果值落入叶节点列表过长的象限(必须能容纳在一页内),则发生分裂。分裂函数 [^internal-ru-600-1] 通过计算所有点坐标的平均值来确定新的质心,从而更均匀地将子节点分配到新的象限。
下图示例中,添加点 (2,1) 导致节点溢出:
{#internal-ru-fig-27-11 num="27.11" caption="插入" .book-original-figure width=676 height=319}
在树中添加一个新内部节点,其质心为 (1,1),点 (0,0)、(1,2) 和 (2,1) 被分配到新的象限中:
{#internal-ru-fig-27-12 num="27.12" caption="插入" .book-original-figure width=688 height=486}
### 属性 {#internal-ru-subsection-star-423}
**访问方法级别属性**
```text {label="psql"}
=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
'can_order', 'can_unique', 'can_multi_col',
'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'spgist';
amname | name | pg_indexam_has_property
--------+---------------+-------------------------
spgist | can_order | f
spgist | can_unique | f
spgist | can_multi_col | f
spgist | can_exclude | t
spgist | can_include | t
(5 rows)
```
不支持值的排序和唯一性。也不支持多列索引。
支持排除约束,与 GiST 情况相同。
可以创建带有额外 include 列的 SP-GiST 索引。(v. 14)
**索引级别属性**
SP-GiST 索引的属性与 GiST 不同,不支持聚簇:
```text {label="psql"}
=> SELECT p.name, pg_index_has_property('airports_quad_idx', p.name)
FROM unnest(array[
'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
name | pg_index_has_property
---------------+-----------------------
clusterable | f
index_scan | t
bitmap_scan | t
backward_scan | f
(4 rows)
```
两种版本标识符获取方式(单个标识符和位图)均受支持。SP-GiST 的反向扫描无意义。
**列级别属性**
大部分列属性保持不变:
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('airports_quad_idx', 1, p.name)
FROM unnest(array[
'orderable', 'search_array', 'search_nulls'
]) p(name);
name | pg_index_column_has_property
--------------+------------------------------
orderable | f
search_array | f
search_nulls | t
(3 rows)
```
不支持排序,所有与排序相关的属性均无意义且被禁用。
到目前为止,我未提及未定义值,但从索引属性可见,它们是受支持的。与 GiST 不同,SP-GiST 索引不将未定义值存储在主树中。为它们创建了单独的树,其根位于索引的第二页。因此,前三个页面始终具有固定含义:元页面、主树根节点和未定义值树根节点。
部分列级别属性可能因操作符类而异:
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('airports_quad_idx', 1, p.name)
FROM unnest(array[
'returnable', 'distance_orderable'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
returnable | t
distance_orderable | t
(2 rows)
```
本例中(如本章其他所有示例),索引仅可用于索引扫描。
但一般情况下,操作符类可能不在叶页面中存储完整值,而是执行表级重新验证。
例如,这使得 SP-GiST 索引可在 PostGIS 中用于潜在的大值类型 `geometry`。
支持最近邻搜索;在操作符类中我们看到了排序操作符 `<->`。(v. 12)
## 27.3. 点的 K 维树 {#internal-ru-section-27-3}
对于平面上的点,可以提出另一种空间划分方式:将平面划分为两部分而非四部分。这种划分使用操作符类 `kd_point_ops` [^internal-ru-604-1]:
```text {label="psql"}
=> CREATE INDEX airports_kd_idx ON airports_big
USING spgist(coordinates kd_point_ops);
```
请注意,索引值、前缀和标签可以具有不同的数据类型。对于此类操作符类,值为点,前缀为实数,标签不存在(与 `quad_point_ops` 相同)。
选择坐标轴上的任意一个坐标(例如机场示例中的纬度)。它将平面划分为上下两部分:
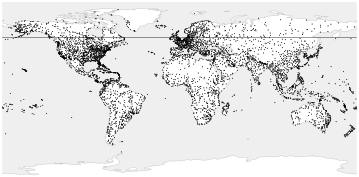
{#internal-ru-fig-27-13 num="27.13" caption="点的 K-维树" .book-original-figure width=718 height=354}
对每个区域选择横轴(经度)上的坐标,将区域划分为左右两部分:
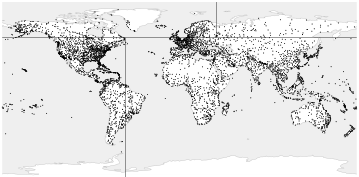
{#internal-ru-fig-27-14 num="27.14" caption="点的 K-维树" .book-original-figure width=718 height=354}
我们将继续交替地将每个部分沿水平方向或垂直方向不断分割,直到每个部分中剩余的点数不超过索引页面所能容纳的数量:
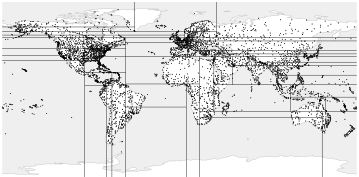
{#internal-ru-fig-27-15 num="27.15" caption="点的 k-维树" .book-original-figure width=718 height=354}
通过这种方式构建的树的所有内部节点都只有两个子节点。该方法很容易推广到任意维度的空间,因此这类树在文献中被称为 *k-维树*(k-D tree)
## 27.4. 字符串的基数树 {#internal-ru-section-27-4}
SP-GiST 的 `text_ops` [^internal-ru-606-1] 操作符类实现了字符串的前缀树(radix tree)。这里的内部节点的前缀确实是其所有子节点中字符串的共同前缀。
指向树子节点的引用标记了紧随前缀之后的首个字节的值。
> [!NOTE]
> 为清晰起见,图中我将前缀表示为单个字符,但这仅适用于八位编码。一般情况下,操作符类将字符串视为字节序列。此外,前缀可能包含若干具有特殊含义的其他值,因此实际上前缀占用了两个字节。
子节点中存储的是紧随前缀和标记之后的部分值。叶节点仅保留值的结尾部分。
以下是根据若干名称构建的前缀树示例:
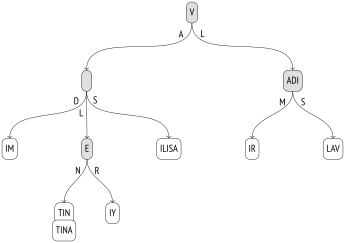
{#internal-ru-fig-27-16 num="27.16" caption="字符串的前缀树" .book-original-figure width=690 height=486}
叶节点中索引键的完整值可以通过从树根到该节点路径上所有前缀和标记的拼接来恢复。由于值并非完整存储,而是按需重建,因此前缀树表示有时可能比 B-树更紧凑。
### 操作符类 {#internal-ru-subsection-star-431}
`text_ops` 操作符类支持文本类型(即有序类型)的传统比较操作符:(psql: `\dAo`)
```text {label="psql"}
=> SELECT oprname, oprcode::regproc, amopstrategy
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amop amop ON amopfamily = opcfamily
JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'spgist'
AND opcname = 'text_ops'
ORDER BY amopstrategy;
oprname | oprcode | amopstrategy
---------+-----------------+--------------
~<~ | text_pattern_lt | 1
~<=~ | text_pattern_le | 2
= | texteq | 3
~>=~ | text_pattern_ge | 4
~>~ | text_pattern_gt | 5
< | text_lt | 11
<= | text_le | 12
>= | text_ge | 14
> | text_gt | 15
^@ | starts_with | 28
(10 rows)
```
波浪号操作符与普通操作符不同,它们不处理字符,而是处理字节(类似于 B-树的 `text_pattern_ops` 操作符类),因此与以字节为标记的前缀树天然兼容。而普通操作符 `>=` 和 `<` 则考虑排序规则,必须分析字符。它们仅在使用 "C" 排序规则时才被索引支持。(参见 [399](/zh18/19-index-access-methods/#internal-ru-page-400))
为加速 `LIKE` 条件的搜索,操作符类支持 *前缀搜索* 操作符 `^@`:
```text {label="psql"}
=> CREATE INDEX tickets_spgist_idx ON tickets
USING spgist(passenger_name);
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE passenger_name LIKE 'IVAN%';
QUERY PLAN
----------------------------------------------------
Bitmap Heap Scan on tickets
Filter: (passenger_name ~~ 'IVAN%'::text)
-> Bitmap Index Scan on tickets_spgist_idx
Index Cond: (passenger_name ^@ 'IVAN'::text)
(4 rows)
```
### 搜索 {#internal-ru-subsection-star-433}
以姓名为例,分析以下查询的执行过程:
```sql
SELECT * FROM names
WHERE name ~>=~ 'VALERIY' AND name ~<~ 'VLADISLAV';
```
首先,内部一致性函数 [^internal-ru-608-1] 在树根处被调用,它必须决定应进入哪些子节点。该函数将前缀 `V` 与标记 `A` 和 `L` 进行拼接。值 `VA` 被代入查询条件,其中字符串常量被截断,使其长度不超过被检查值的长度:`VA ~>=~ 'VA' AND VA ~<~ 'VL'`。该条件成立,因此标记为 `A` 的子节点需要被检查。类似地,`VL` 也满足条件,因此标记为 `L` 的节点也需要检查。
现在考虑对应值 `VA` 的节点。其前缀为空,对于三个子节点,内部一致性函数通过将上一步得到的 `VA` 与标记拼接,恢复出值 `VAD`、`VAL` 和 `VAS`。条件 `VAD ~>=~ 'VAL' AND VAD ~<~ 'VER'` 不成立,但另外两个值符合要求。
通过这种方式深入遍历树并舍弃不匹配的分支,算法最终到达叶节点。叶节点一致性函数 [^internal-ru-608-2] 检查从根到该节点路径上逐步恢复的值是否与原始条件匹配。符合条件的值作为索引扫描的结果返回。
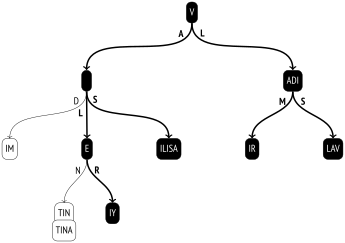
{#internal-ru-fig-27-17 num="27.17" caption="搜索" .book-original-figure width=690 height=486}
请注意,尽管查询中使用了 B-树常用的“大于”和“小于”操作符,但 SP-GiST 树上的范围搜索效率远低于 B-树。在 B-树中,只需下降到范围的一个端点,然后读取叶页面链即可。
### 插入 {#internal-ru-subsection-star-435}
对于点的索引,操作符类选择函数始终可以将新值引导至现有子区域(象限或半区)。但在前缀树中并非如此:新值可能与现有前缀不匹配,此时必须分割内部节点。
以向已有树中添加名称 `VLADA` 为例。
从树根开始,通过选择函数 [^internal-ru-610-1] 可以成功下降到一个节点(`V` + `L`),但剩余值 `ADA` 与前缀 `ADI` 不一致。必须将该节点分割为两个:一个保留最大公共前缀 `AD`,另一个将剩余前缀下移至下一层:
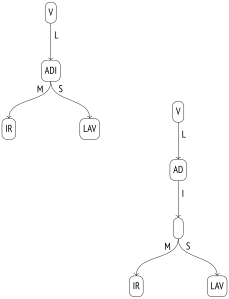
{#internal-ru-fig-27-18 num="27.18" caption="插入" .book-original-figure width=458 height=598}
之后,选择函数在同一节点再次被调用。现在前缀与值匹配,但没有具有合适标记(`A`)的子节点,因此函数决定创建该节点。最终结果如下面的图所示;图中标记了插入或修改的节点。
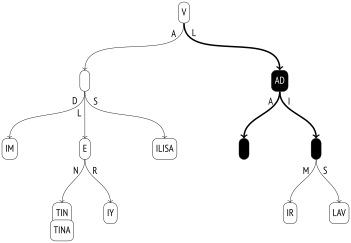
{#internal-ru-fig-27-19 num="27.19" caption="插入" .book-original-figure width=702 height=486}
### 属性 {#internal-ru-subsection-star-437}
我之前已展示过访问方法和索引级别的属性,这些属性不随操作符类的变化而改变。大多数列级别的属性也保持不变。
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('tickets_spgist_idx', 1, p.name)
FROM unnest(array[
'returnable', 'distance_orderable'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
returnable | t
distance_orderable | f
(2 rows)
```
尽管索引值在树中并未显式存储,但仅索引扫描仍可工作,因为值在从根节点到叶节点的遍历过程中被逐步重建。
然而,字符串的距离操作符未被定义,因此该操作符类不支持最近邻搜索。
> [!NOTE]
> 这并不意味着无法为字符串定义距离概念。例如,`pg_trgm` 扩展添加了基于三元组的距离操作符:两个字符串共有的三元组比例越小,它们之间的距离越远。另一种选择是莱文斯坦距离,定义为将一个字符串转换为另一个字符串所需的最少单字符操作次数。计算此类距离的函数存在于 `fuzzystrmatch` 扩展中。但没有任何扩展提供支持 SP-GiST 的操作符类。
## 27.5. 其他数据类型 {#internal-ru-section-27-5}
除了上述点和文本字符串的索引示例外,SP-GiST 还实现了其他操作符类。
**几何类型。** `box_ops` [^internal-ru-612-1] 操作符类实现了矩形的四象限树。矩形以四维空间中的点表示,因此区域被划分为十六个部分。
`poly_ops` 操作符类允许索引多边形。这是一个近似操作符类:实际上使用的是多边形的包围矩形,与 `box_ops` 类似,并在表中进行重新验证。
选择 GiST 还是 SP-GiST 作为访问方法,很大程度上取决于索引数据的类型。例如,PostGIS 文档建议对高度重叠的对象(“面条状”)使用 SP-GiST [^internal-ru-612-2]。
**范围类型。** 范围的四象限树由 `range_ops` [^internal-ru-612-3] 操作符类提供。区间以二维点表示:下界作为横坐标,上界作为纵坐标。
**网络地址。** 对于 `inet` 数据类型,`inet_ops` [^internal-ru-612-4] 操作符类实现了前缀树。
[^internal-ru-590-1]: [postgrespro.ru/docs/postgresql/18/spgist](); [backend/access/spgist/README]().
[^internal-ru-591-1]: [backend/access/spgist/spgscan.c](), 函数 spgWalk.
[^internal-ru-593-1]: [postgrespro.ru/docs/postgresql/18/spgist-extensibility]().
[^internal-ru-593-2]: [backend/access/spgist/spgquadtreeproc.c]().
[^internal-ru-594-1]: [include/access/stratnum.h]().
[^internal-ru-597-1]: [backend/access/spgist/spgdoinsert.c](), 函数 moveLeafs.
[^internal-ru-597-2]: [sigaev.ru/git/gitweb.cgi?p=gevel.git]().
[^internal-ru-597-3]: [commitfest.postgresql.org/15/1207]().
[^internal-ru-599-1]: [backend/access/spgist/spgquadtreeproc.c](), 函数 spg\_quad\_inner\_consistent.
[^internal-ru-599-2]: [backend/access/spgist/spgquadtreeproc.c](), 函数 spg\_quad\_leaf\_consistent.
[^internal-ru-599-3]: [backend/access/spgist/spgdoinsert.c](), 函数 spgdoinsert.
[^internal-ru-599-4]: [backend/access/spgist/spgquadtreeproc.c](), 函数 spg\_quad\_choose.
[^internal-ru-600-1]: [backend/access/spgist/spgquadtreeproc.c](), 函数 spg\_quad\_picksplit.
[^internal-ru-604-1]: [backend/access/spgist/spgkdtreeproc.c]().
[^internal-ru-606-1]: [backend/access/spgist/spgtextproc.c]().
[^internal-ru-608-1]: [backend/access/spgist/spgtextproc.c](), 函数 spg\_text\_inner\_consistent.
[^internal-ru-608-2]: [backend/access/spgist/spgtextproc.c](), 函数 spg\_text\_leaf\_consistent.
[^internal-ru-610-1]: [backend/access/spgist/spgtextproc.c](), 函数 spg\_text\_choose.
[^internal-ru-612-1]: [backend/utils/adt/geo\_spgist.c]().
[^internal-ru-612-2]: [postgis.net/docs/using\_postgis\_dbmanagement.html#spgist\_indexes]().
[^internal-ru-612-3]: [backend/utils/adt/rangetypes\_spgist.c]().
[^internal-ru-612-4]: [backend/utils/adt/network\_spgist.c]().