# B-树
LLMS 索引: [llms.txt](/zh18/llms.txt)
---
## 25.1. 总览 {#internal-ru-section-25-1}
B-树(访问方法 `btree`)是一种数据结构,它允许通过从根节点向下遍历到叶节点,快速找到树中叶节点的所需元素 [^internal-ru-524-1]。为了使搜索路径唯一确定,树中的元素必须有序。B-树适用于可比较和可排序的有序数据类型。
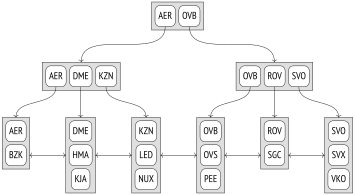
在示意性展示的、基于机场代码构建的索引中,内部节点以水平方式表示,而叶节点以垂直方式表示:
{#internal-ru-fig-25-1 num="25.1" caption="通用原理" .book-original-figure width=709 height=390}
树中的每个节点包含多个元素,每个元素由索引键和引用组成。内部节点的元素指向下一层次的节点,而叶节点的元素则指向表行版本(图中未显示这些引用)。
B-树具有多个重要特性:
- 它们是平衡的,即所有叶节点位于同一深度。因此,查找任意值所需时间相同。
- 它们具有高度分支性,即每个节点包含大量元素,通常可达数百个(图中节点仅由三个元素组成,仅为示意目的)。由于这一特性,即使对于非常大的表,B-树的深度也保持较小。
> [!NOTE]
> B-树名称中的字母“B”具体含义尚不明确。它既可以是“balanced”(平衡的),也可以是“bushy”(茂密的)。但令人惊讶的是,常被误解释为“binary”(二进制的),这显然是错误的。
- 索引中的数据按升序(或降序)排列,既在节点之间,也在每个节点内部。同一层级的节点通过双向链表相互连接,因此只需沿链表单向或反向遍历,即可获得有序数据集,而无需每次都从根节点重新开始。
## 25.2. 检索和插入 {#internal-ru-section-25-2}
### 等值检索 {#internal-ru-subsection-star-363}
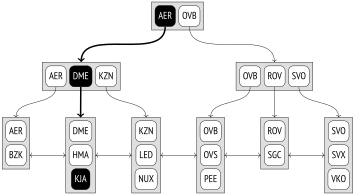
考虑在树中按条件「*索引列* `=` *表达式*」进行查找 [^internal-ru-525-1]。假设我们关注的是KJA(克拉斯诺亚尔斯克)机场。
查找从根节点开始,访问方法必须确定应进入哪个子节点。选择满足 Ki ⩽ *表达式* < Ki+1 的键 Ki。
{#internal-ru-fig-25-2 num="25.2" caption="等值查找" .book-original-figure width=709 height=390}
在根节点中,键为 AER 和 OVB。条件 AER ⩽ KJA < OVB 成立,因此应进入指向 AER 键的子节点。
该过程递归重复,直到到达叶节点,从该节点可获取行版本标识符。在此例中,子节点满足 DME ⩽ KJA < KZN,因此应进入指向 DME 键的叶节点。
可以注意到,树中内部节点的最左侧键是冗余的:仅需满足 KJA < OVB 即可选择根节点的子节点。此类键在 B-树中不存储,后续图示中我将保留对应元素为空。
在叶节点中,可通过简单的二分查找快速定位所需元素。
实际上,查找过程远比表面看起来复杂。必须考虑索引中的值可能按升序(如图所示)或降序排列。即使在唯一索引中,也可能存在多个匹配值,查找必须返回全部结果。此外,相同值可能数量众多,无法容纳于单个节点,此时需继续在相邻的叶页面中查找。(参见 [533](/zh18/25-b-tree/#internal-ru-page-534))
> [!NOTE]
> 由于索引中可能包含非唯一值,更准确的说法应为“非递减”(而非“升序”),以及“非递增”(而非“降序”)。尽管如此,我仍将采用更简洁的表述。此外,行版本标识符是索引键的一部分,使得即使值相同,索引条目仍可视为唯一。
此外,在查找过程中,其他进程可能正在修改数据,页面可能分裂为两个,树结构也可能重新调整。所有算法均设计为尽可能避免并发操作之间的干扰,并减少额外锁的使用。但此处不再深入讨论。(v. 12)
### 非等值检索 {#internal-ru-subsection-star-365}
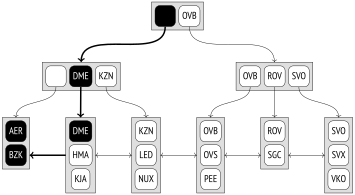
对于条件「*索引列* ⩽ *表达式*」(或「*索引列* ⩾ *表达式*」)的查找,首先需在索引中找到等值条件的值,然后沿叶节点向指定方向遍历至末尾。
{#internal-ru-fig-25-3 num="25.3" caption="不等式查找" .book-original-figure width=709 height=390}
图示展示了查找代码小于或等于 DME(多莫杰多沃)的机场的过程。
对于「大于」和「小于」操作符,查找方式相同,只需排除最初找到的值即可。
### 范围检索 {#internal-ru-subsection-star-367}
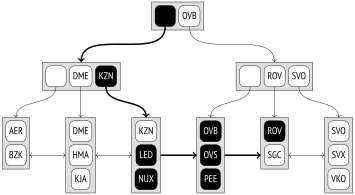
对于范围查找「*表达式*1 ⩽ *索引列* ⩽ *表达式*2」,首先需找到 *表达式*1,然后沿叶节点向右遍历至 *表达式*2。
图示展示了查找代码从 LED(圣彼得堡)到 ROV(罗斯托夫-纳-顿河)(含)的机场的过程。
{#internal-ru-fig-25-4 num="25.4" caption="范围查找" .book-original-figure width=709 height=390}
### 插入 {#internal-ru-subsection-star-369}
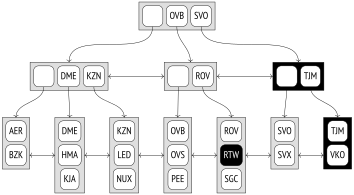
新元素在叶节点中的位置由键的顺序唯一确定。例如,向表中插入代码为 RTW(萨拉托夫)的机场时,该元素将被添加到倒数第二个叶节点中,位于现有 ROV 和 SGC 之间。
{#internal-ru-fig-25-5 num="25.5" caption="插入" .book-original-figure width=707 height=390}
但可能出现叶节点中无足够空间容纳新元素的情况。例如(假设节点最多容纳三个元素),插入代码为 TJM(秋明)的机场时,最后一个叶节点将溢出。此时节点将被“分裂”为两个,原节点的部分元素被移至新节点,父节点则添加指向新子节点的引用。当然,父节点也可能溢出。此时父节点同样被分裂为两个节点,依此类推。若分裂过程扩展至根节点,则在新节点之上创建一个新节点作为树的新根。此时树的深度增加一。
在本例中,插入机场 TJM 导致两个节点分裂;图中已标出新节点。为支持任意节点的分裂,不仅底层节点通过双向链表连接,其他层级的节点也通过双向链表连接。
上述插入与分裂过程保证了树的平衡性,且由于实际中节点元素数量通常较多,新增层级的情况极为罕见。
问题在于,分裂后的节点永远不会合并,即使清理后节点中仅剩少量元素。这一限制并非 B-树数据结构本身所致,而是 PostgreSQL 实现的特性。因此,若插入时节点已满,访问方法会优先尝试清理节点中的冗余信息,以释放空间,避免不必要的分裂。(参见 [123](/zh18/05-page-pruning-and-hot-updates/#internal-ru-page-124))
## 25.3. 页面布局 {#internal-ru-section-25-3}
B-树的每个节点占据一页。页面大小决定了节点的容量。
分裂操作导致在不同时间点,树的根节点可能为不同的页面。但查找算法必须从根节点开始。它通过索引的零号页面(称为元页面)获取当前根页面的编号。元页面还包含其他一些管理信息。
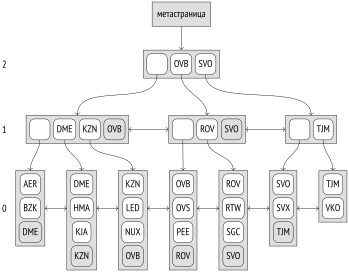
{#internal-ru-fig-25-6 num="25.6" caption="页面组织结构" .book-original-figure width=698 height=545}
索引页面中的信息表示方式与之前图示略有不同。除每层最右侧页面外,其余页面均包含一个额外的「上键」,其值保证不小于该页面中任何值。前图中上键以灰色标出。
通过 `pageinspect` 扩展,我们可查看六位预订号对应的索引页面内容。在元页面中,我们关注根页面编号和树的最大层级(层级从零开始编号,从叶节点起算):
```text {label="psql"}
=> SELECT root, level
FROM bt_metap('bookings_pkey');
root | level
------+-------
290 | 2
(1 row)
```
索引记录中的键以字节序列形式输出,这不太方便。例如:
```text {label="psql"}
=> SELECT data
FROM bt_page_items('bookings_pkey',290)
WHERE itemoffset = 2;
data
-------------------------
0f 30 43 39 41 42 31 00
(1 row)
```
为解码值,需编写一个临时函数。该函数并非在所有情况下或所有平台上均适用,但适用于本章示例。
```text {label="psql"}
=> CREATE FUNCTION data_to_text(data text)
RETURNS text
AS $$
DECLARE
raw bytea := ('\x'||replace(data,' ',''))::bytea;
pos integer := 0;
len integer;
res text := '';
BEGIN
WHILE (octet_length(raw) > pos) LOOP
len := (get_byte(raw,pos) - 3) / 2;
EXIT WHEN len <= 0;
IF pos > 0 THEN
res := res || ', ';
END IF;
res := res || (
SELECT string_agg( chr(get_byte(raw, i)),'')
FROM generate_series(pos+1,pos+len) i
);
pos := pos + len + 1;
END LOOP;
RETURN res;
END;
$$ LANGUAGE plpgsql;
```
现在我们可以查看根页面的内容:
```text {label="psql" hl_lines="14"}
=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('bookings_pkey',290);
itemoffset | ctid | data_to_text
------------+----------+--------------
1 | (3,0) |
2 | (289,1) | 0C9AB1
3 | (575,1) | 192F03
4 | (860,1) | 25D715
5 | (1145,1) | 32785C
6 | (1430,1) | 3F0EB8
...
17 | (4565,1) | C993F6
18 | (4850,1) | D63931
19 | (5135,1) | E2CB14
20 | (5420,1) | EF6FEA
21 | (5705,1) | FC147D
(21 rows)
```
第一条记录如前所述,不存储键。`ctid` 列包含指向子页面的引用。
假设我们正在查找编号为 E2D725 的预订。此时我们选择第 19 条记录,因为 E2CB14 ⩽ E2D725 < EF6FEA,然后进入页面 5135。
```text {label="psql" hl_lines="7"}
=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('bookings_pkey',5135);
itemoffset | ctid | data_to_text
------------+----------+--------------
1 | (5417,1) | EF6FEA ← верхний ключ
2 | (5132,0) |
3 | (5133,1) | E2D71D
4 | (5134,1) | E2E2F4
5 | (5136,1) | E2EDE7
...
282 | (5413,1) | EF41BE
283 | (5414,1) | EF4D69
284 | (5415,1) | EF58D4
285 | (5416,1) | EF6410
(285 rows)
```
此页面的第一条记录——出人意料地——包含一个上键。从逻辑上讲,它本应位于页面末尾,但从实现角度看,将其置于开头更为方便,这样每次页面内容变化时就不必再移动它。
在此页面中,我们选择第3条记录,因为 E2D71D ⩽ E2D725 < < E2E2F4,然后下降到页面5133。
```text {label="psql" hl_lines="7"}
=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('bookings_pkey',5133);
itemoffset | ctid | data_to_text
------------+-------------+--------------
1 | (11921,1) | E2E2F4
2 | (11919,76) | E2D71D
3 | (11919,77) | E2D725
4 | (11919,78) | E2D72D
5 | (11919,79) | E2D733
...
364 | (11921,124) | E2E2DB
365 | (11921,125) | E2E2DF
366 | (11921,126) | E2E2E5
367 | (11921,127) | E2E2ED
(367 rows)
```
这是一张索引叶页面。第一条记录是上键,其余所有记录都指向表行版本。
这就是我们的预订:
```text {label="psql"}
=> SELECT * FROM bookings WHERE ctid = '(11919,77)';
book_ref | book_date | total_amount
----------+------------------------+--------------
E2D725 | 2017-01-25 04:10:00+03 | 28000.00
(1 row)
```
当我们按预订号查询时,底层大致就是这样工作的:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM bookings WHERE book_ref = 'E2D725';
QUERY PLAN
---------------------------------------------
Index Scan using bookings_pkey on bookings
Index Cond: (book_ref = 'E2D725'::bpchar)
(2 rows)
```
### 去重v. 13 {#internal-ru-subsection-star-371}
非唯一索引可能包含多个相同键,但指向不同的表行。由于重复键会占用大量空间,这些重复项会被“压缩”为一条索引记录,该记录包含键和一个表标识符列表[^internal-ru-534-1]。在某些情况下,这种称为*去重*(deduplication)的过程可显著减小索引大小。
但即使是唯一索引,也可能因多版本并发控制而包含重复键,因为索引存储了对所有表行版本的引用。虽然热更新机制有助于缓解因引用非最新版本(通常生命周期很短)而导致的索引膨胀,但该机制并非总能奏效。在这种情况下,去重可节省清理表中非最新版本所需的时间,并减少页面强制分裂的次数。(*参见* [111](/zh18/05-page-pruning-and-hot-updates/#internal-ru-page-112))
为了避免在不需要时浪费资源进行去重,压缩操作仅在叶页面空间不足以插入新行时才执行。此时,[^internal-ru-535-1]自动清理和去重[^internal-ru-535-2]可释放空间,防止不必要的页面分裂。不过,如果重复项出现频率较低,可通过存储参数 *deduplicate\_items* 禁用去重机制。
并非所有索引都支持去重。主要限制在于:键的相等性必须通过其内部表示的简单二进制比较来判断。并非所有数据类型都可如此比较。浮点数(`float` 和 `double precision`)存在两种不同的零值表示。任意精度数(`numeric`)允许以不同精度表示同一数值,而 `jsonb` 类型也使用此类数值。此外,使用非确定性排序规则的文本类型[^internal-ru-535-3]也不适用,因为相同字符可能被表示为不同的字节序列(标准排序规则是确定性的)。
此外,目前对复合类型、范围类型和数组类型不支持去重,且不适用于 include 索引。
要检查特定索引是否支持去重,可以查看元页面中的 `allequalimage` 字段:
```text {label="psql"}
=> CREATE INDEX ON tickets(book_ref);
=> SELECT allequalimage FROM bt_metap('tickets_book_ref_idx');
allequalimage
---------------
t
(1 row)
```
在此情况下,去重功能已启用。事实上,在某张叶页面上我们看到,部分索引记录包含单个表标识符(`htid`),而另一些则包含标识符列表(`tids`):
```text {label="psql"}
=> SELECT itemoffset, htid, left(tids::text,27) tids,
data_to_text(data) AS data
FROM bt_page_items('tickets_book_ref_idx',1)
WHERE itemoffset > 1;
itemoffset | htid | tids | data
------------+------------+-----------------------------+--------
2 | (32965,40) | | 000004
3 | (47429,51) | | 00000F
4 | (3648,56) | {"(3648,56)","(3648,57)"} | 000010
5 | (6498,47) | | 000012
...
271 | (21492,46) | | 000890
272 | (26601,55) | {"(26601,55)","(26601,56)"} | 0008AC
273 | (25669,37) | | 0008B6
(272 rows)
```
### 内部索引条目的紧凑存储v. 12 {#internal-ru-subsection-star-373}
去重可使索引叶页面容纳更多记录。但为防止不必要的页面分裂,内部页面的信息压缩同样至关重要。虽然索引的大部分空间由叶页面占据,但索引查找效率直接取决于树的深度。
内部页面的索引记录包含索引键,但其值仅用于确定在查找时应进入哪个子树。在复合索引中,通常仅第一个键属性或前几个属性就足以完成此判断。其余属性可被丢弃,以节省页面空间。
当叶页面发生分裂且需在内部页面中插入新引用时[^internal-ru-536-1],会执行*部分属性截断*(suffix truncation)过程。
> [!NOTE]
> 从理论上讲,还可以进一步优化,仅保留属性的*有效部分*,例如字符串的前几个字符,足以区分子树。但目前尚未实现:属性要么完整保留在索引记录中,要么完全被排除。
例如,以下为基于机票预订号和乘客姓名创建的索引的根页面中的若干记录:
```text {label="psql"}
=> CREATE INDEX tickets_bref_name_idx
ON tickets(book_ref, passenger_name);
=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('tickets_bref_name_idx',229)
WHERE itemoffset BETWEEN 8 AND 13;
itemoffset | ctid | data_to_text
------------+----------+----------------------------
8 | (1607,1) | 1A98A0
9 | (1833,2) | 1E57D1, SVETLANA MAKSIMOVA
10 | (2054,1) | 220797
11 | (2282,1) | 25DB06
12 | (2509,2) | 299FE4, YURIY AFANASEV
13 | (2736,1) | 2D62C9
(6 rows)
```
可以看出,某些索引记录中第二个属性已被省略。
叶页面当然必须存储所有键属性,包括额外 include 列的值。否则索引将无法用于仅索引扫描。唯一例外是“上键”,其可不完整存储。
## 25.4. 排序和复合索引 {#internal-ru-section-25-4}
### 列的顺序 {#internal-ru-subsection-star-375}
创建索引时列的顺序极为重要,因为页面内的数据将首先按第一列排序,然后按第二列,依此类推。通常,此类索引的有效查找仅适用于从第一列开始的连续列序列条件:仅第一列、第一列与第二列、第一列至第三列等。其余条件仅用于过滤主条件查找到的值[^internal-ru-537-1]。
以下是之前在机票表上按预订号和乘客姓名创建的索引的首张叶页面中的索引记录顺序:
```text {label="psql"}
=> SELECT itemoffset, data_to_text(data)
FROM bt_page_items('tickets_bref_name_idx',1)
WHERE itemoffset > 1;
itemoffset | data_to_text
------------+-----------------------------
2 | 000004, PETR MAKAROV
3 | 00000F, ANNA ANTONOVA
4 | 000010, ALEKSANDR SOKOLOV
5 | 000010, LYUDMILA BOGDANOVA
6 | 000012, TAMARA ZAYCEVA
...
189 | 00040C, DMITRIY FEDOROV
190 | 00041E, EGOR FEDOROV
191 | 00041E, ILYA STEPANOV
192 | 000447, VIKTOR VASILEV
193 | 00044D, NADEZHDA KULIKOVA
(192 rows)
```
此时,有效查找机票的条件可以是:按预订号和乘客姓名,或仅按预订号:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE book_ref = '000010';
QUERY PLAN
--------------------------------------------------
Index Scan using tickets_book_ref_idx on tickets
Index Cond: (book_ref = '000010'::bpchar)
(2 rows)
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE book_ref = '000010' AND passenger_name = 'LYUDMILA BOGDANOVA';
QUERY PLAN
---------------------------------------------------------------------
Index Scan using tickets_bref_name_idx on tickets
Index Cond: ((book_ref = '000010'::bpchar) AND (passenger_name...
(2 rows)
```
但若仅按乘客姓名查找,则必须遍历所有行:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE passenger_name = 'LYUDMILA BOGDANOVA';
QUERY PLAN
-------------------------------------------------------------
Gather
Workers Planned: 2
-> Parallel Seq Scan on tickets
Filter: (passenger_name = 'LYUDMILA BOGDANOVA'::text)
(4 rows)
```
反之,若按姓名和预订号创建索引,则可高效支持按姓名或同时按姓名与预订号的查询:
```text {label="psql"}
=> CREATE INDEX tickets_name_bref_idx
ON tickets(passenger_name, book_ref);
=> SELECT itemoffset, data_to_text(data)
FROM bt_page_items('tickets_name_bref_idx',1)
WHERE itemoffset > 1;
itemoffset | data_to_text
------------+------------------------------
2 | ADELINA ABRAMOVA, E37EDB
3 | ADELINA AFANASEVA, 1133B7
4 | ADELINA AFANASEVA, 4F3370
5 | ADELINA AKIMOVA, 7D2881
...
185 | ADELINA LEBEDEVA, 0A00E3
186 | ADELINA LEBEDEVA, DAEADE
187 | ADELINA LEBEDEVA, DFD7E5
188 | ADELINA LOGINOVA, 8022F3
189 | ADELINA LOGINOVA, EE67B9
190 | ADELINA LUKYANOVA, 292786
191 | ADELINA LUKYANOVA, 54D3F9
(190 rows)
=> EXPLAIN (costs off) SELECT * FROM tickets
WHERE passenger_name = 'LYUDMILA BOGDANOVA';
QUERY PLAN
-----------------------------------------------------------------
Bitmap Heap Scan on tickets
Recheck Cond: (passenger_name = 'LYUDMILA BOGDANOVA'::text)
-> Bitmap Index Scan on tickets_name_bref_idx
Index Cond: (passenger_name = 'LYUDMILA BOGDANOVA'::text)
(4 rows)
```
### 跳过扫描优化 {#internal-ru-subsection-star-377}
一个重要例外是:当第一列包含的唯一值不多时。即使没有针对该列的条件,索引仍可能显著加速查找。为此,需多次访问索引,将缺失条件替换为对每个唯一值的相等性检查。 (v. 18)
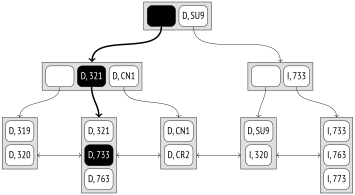
设想一张表,显示飞机在哪些航线上运营。其第一列 `route_type` 仅有两个可能值:`D`(国内航线,domestic)和 `I`(国际航线,international)。第二列 `aircraft_code` 存储机型代码。部分飞机仅用于国内航线,部分仅用于国际航线,部分则用于所有航线。该索引基于前两列创建。
为理解跳过扫描的优化机制,先假设我们已将条件 `aircraft_code = '733'` 扩展为 `route_type = ANY('{D,I}')`。由于 B-树支持 SEARCH ARRAY 属性,索引扫描可有效利用此条件。首先,按条件 `route_type = 'D' AND aircraft_code = '733'` 执行一次搜索:(*参见* [411](/zh18/19-index-access-methods/#internal-ru-page-412))
{#internal-ru-fig-25-7 num="25.7" caption="跳过扫描优化" .book-original-figure width=710 height=390}
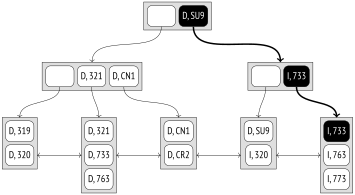
随后,再执行一次搜索,条件为 `route_type = 'I' AND aircraft_code = '733'`:
{#internal-ru-fig-25-8 num="25.8" caption="跳过扫描优化" .book-original-figure width=710 height=390}
从规划器角度看,两次索引搜索均属于同一索引扫描操作,因此执行计划中仅有一个 Bitmap Index Scan 节点。让我们查看实际查询:
```text {label="psql" hl_lines="15"}
=> CREATE INDEX ON flights(status, aircraft_code);
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM flights
WHERE status IN ('Arrived', 'Cancelled', 'Delayed',
'Departed', 'On Time', 'Scheduled')
AND aircraft_code = '733';
QUERY PLAN
---------------------------------------------------------------------
Bitmap Heap Scan on flights (actual rows=8263.00 loops=1)
Recheck Cond: (((status)::text = ANY ('{Arrived,Cancelled,Dela...
Heap Blocks: exact=133
Buffers: shared hit=136 read=14
-> Bitmap Index Scan on flights_status_aircraft_code_idx (actu...
Index Cond: (((status)::text = ANY ('{Arrived,Cancelled,De...
Index Searches: 3
Buffers: shared hit=3 read=14
(8 rows)
```
Index Searches 行显示了索引搜索次数。本例中,扫描仅需三次从根到叶的下探,而非六次,因为具有四种状态的行恰好被定位在同一页数据中:
```text {label="psql"}
=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('flights_status_aircraft_code_idx',174)
WHERE data_to_text(data) LIKE '% 733';
itemoffset | ctid | data_to_text
------------+-----------+----------------
6 | (24,8207) | Cancelled, 733
15 | (1015,64) | Delayed, 733
22 | (24,8194) | Departed, 733
30 | (24,8214) | On Time, 733
(4 rows)
```
此类扫描会跳过无关索引部分,因此该操作被称为*跳过扫描*(skip scan),并非独立的扫描类型,而是一种优化机制,适用于任何索引访问方式(Index Scan、Index Only Scan、Bitmap Index Scan)。
那么,当未指定第一列条件时会发生什么?可通过统计信息估算唯一值数量,但显然不能依赖统计信息来获取精确的唯一值列表。(*参见* [351](/zh18/17-statistics/#internal-ru-page-352))
因此,我们希望执行一个条件为 `aircraft_code = '733'` 的表查询。我们不知道 `route_type` 的最小值,但可以从索引的首张叶页面的首条记录中获取:
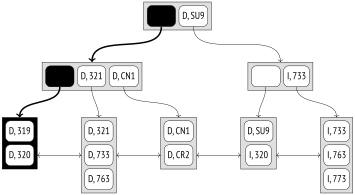
{#internal-ru-fig-25-9 num="25.9" caption="跳过扫描优化" .book-original-figure width=710 height=390}
现在我们知道 `route_type` 的第一个值是 `D`,因此可以执行第二次搜索,条件为 `route_type = 'D' AND aircraft_code = '733'`。
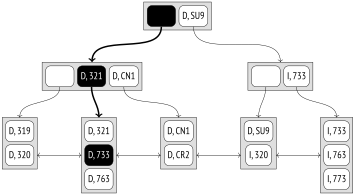
{#internal-ru-fig-25-10 num="25.10" caption="跳过扫描优化" .book-original-figure width=710 height=390}
我们找到了第一个匹配值。如果在读取的叶页面中发现第一条记录的首列值不同,我们就能知道下一个精确条件。本例中我们运气不佳,因此必须执行 `route_type > 'D'` 的搜索:
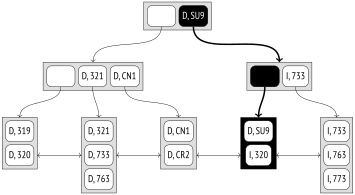
{#internal-ru-fig-25-11 num="25.11" caption="跳过扫描优化" .book-original-figure width=710 height=390}
在找到的叶页面中未发现所需记录,但我们得知了 `route_type` 的第二个值。因此执行下一次搜索,条件为 `route_type = 'I' AND aircraft_code = '733'`:
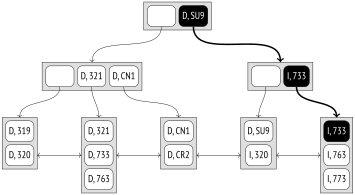
{#internal-ru-fig-25-12 num="25.12" caption="跳过扫描优化" .book-original-figure width=710 height=390}
可以结束扫描,因为我们已经到达了索引的最后一个叶页面。否则,还需要执行另一次搜索——条件为 `route_type > 'I'`——以确认不存在其他值。
没有第一个列条件的查询在索引中执行了稍多的搜索,并读取了稍多的页面,但仍然执行得非常高效:
```text {label="psql"}
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM flights
WHERE aircraft_code = '733';
QUERY PLAN
---------------------------------------------------------------------
Bitmap Heap Scan on flights (actual rows=8263.00 loops=1)
Recheck Cond: (aircraft_code = '733'::bpchar)
Heap Blocks: exact=133
Buffers: shared hit=154 read=4
-> Bitmap Index Scan on flights_status_aircraft_code_idx (actu...
Index Cond: (aircraft_code = '733'::bpchar)
Index Searches: 4
Buffers: shared hit=21 read=4
(8 rows)
```
跳过扫描优化也可应用于其他情况,例如当部分列上没有条件或条件不是等值检查时。Index Searches 值大于 1 表明在索引扫描过程中执行了跳过操作。
当然,上述示例并不完整。特别是,在某些情况下,已启动的搜索可能会继续在相邻的叶页面上进行,以期望在这些页面中找到合适的索引条目。这有助于合并单独的索引访问,减少访问次数,从而节省从根节点到叶节点的下探开销[^internal-ru-545-1]。
另一个例子:对于 B-树操作符类中的离散数据类型,可以定义一个基准函数,该函数可提供该类型的最小值和最大值,以及用于跳转到下一个和前一个值的函数[^internal-ru-545-2]。借助这些信息,就不需要再查找索引中的下一个值;扫描可直接跳转到其检查点。
### 排序方向 {#internal-ru-subsection-star-379}
创建索引时,不仅要考虑列的顺序,还要考虑排序顺序。默认情况下,值按升序排列(`ASC`),但也可以指定降序(`DESC`)。对于单列索引,这没有特别影响,因为索引可以向任意方向扫描。但在复合索引中,顺序很重要。
刚刚创建的索引可用于获取按两个列升序或两个列降序排序的数据:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name, book_ref;
QUERY PLAN
---------------------------------------------------
Index Scan using tickets_name_bref_idx on tickets
(1 row)
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name DESC, book_ref DESC;
QUERY PLAN
------------------------------------------------------------
Index Scan Backward using tickets_name_bref_idx on tickets
(1 row)
```
但无法直接从该索引获取一个列升序、另一个列降序排序的数据。索引提供的是部分有序的数据,随后需按第二个属性进行排序(此处及后续为简化起见,禁用并行计划):(参见 [498](/zh18/23-sorting-and-merging/#internal-ru-page-499))
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name ASC, book_ref DESC;
QUERY PLAN
--------------------------------------------------------
Incremental Sort
Sort Key: passenger_name, book_ref DESC
Presorted Key: passenger_name
-> Index Scan using tickets_name_bref_idx on tickets
(4 rows)
```
使用索引进行排序的能力也受未定义值位置的影响。默认情况下,未定义值在排序时被视为‘大于’普通值,即在升序排序时位于树的右侧,或在降序排序时位于左侧。此顺序可通过 `NULLS LAST` 和 `NULLS FIRST` 子句进行更改。
在以下示例中,索引不满足 `ORDER BY` 子句,因此结果需要额外排序:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name NULLS FIRST, book_ref DESC;
QUERY PLAN
-------------------------------------------------------
Sort
Sort Key: passenger_name NULLS FIRST, book_ref DESC
-> Seq Scan on tickets
(3 rows)
```
但如果创建一个符合所需顺序的索引,它将被使用:
```text {label="psql"}
=> CREATE INDEX tickets_name_bref_idx2
ON tickets(passenger_name NULLS FIRST, book_ref DESC);
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name NULLS FIRST, book_ref DESC;
QUERY PLAN
----------------------------------------------------
Index Scan using tickets_name_bref_idx2 on tickets
(1 row)
```
## 25.5. 操作符类 {#internal-ru-section-25-5}
### 比较语义 {#internal-ru-subsection-star-381}
系统不仅需要能够哈希值,还需要能够对不同类型(包括用户定义类型)的值进行排序。这在排序、分组、合并连接及其他一些操作中是必需的。与哈希类似,数据类型与比较操作符之间的映射由操作符类[^internal-ru-547-1]定义。
操作符类允许不依赖于名称(如 `>`、`<`、`=`),甚至可以为同一类型提供多种排序方式。
以下是任何 B-树方法操作符类必须定义的比较操作符(以 `btree` 家族为例):(psql: `bool_ops`) `\dAo`
```text {label="psql"}
=> SELECT amopopr::regoperator AS opfamily_operator,
amopstrategy
FROM pg_am am
JOIN pg_opfamily opf ON opfmethod = am.oid
JOIN pg_amop amop ON amopfamily = opf.oid
WHERE amname = 'btree'
AND opfname = 'bool_ops'
ORDER BY amopstrategy;
opfamily_operator | amopstrategy
---------------------+--------------
<(boolean,boolean) | 1
<=(boolean,boolean) | 2
=(boolean,boolean) | 3
>=(boolean,boolean) | 4
>(boolean,boolean) | 5
(5 rows)
```
我们看到五个比较操作符。每个操作符对应一个 *策略*[^internal-ru-548-1],该策略定义了其语义:
1) 小于;
2) 小于或等于;
3) 等于;
4) 大于或等于;
5) 大于。
B-树操作符类还包含若干基准函数[^internal-ru-548-2]。第一个函数应在第一个参数大于第二个参数时返回 1,小于时返回 -1,相等时返回 0。
其余的基准函数是可选的,但它们允许访问方法更高效地运行。
为了更好地理解此机制,创建一个新数据类型并为其设置与默认顺序不同的排序顺序是有帮助的。文档中给出了复数的示例[^internal-ru-548-3],但使用的是 C 语言。幸运的是,B-树操作符类也可以使用解释型语言创建,我将采用这种方式,使此示例尽可能简单(尽管显然效率低下)。
我们将创建一个用于信息单位的新复合类型:
```text {label="psql"}
=> CREATE TYPE capacity_units AS ENUM (
'B', 'kB', 'MB', 'GB', 'TB', 'PB'
);
=> CREATE TYPE capacity AS (
amount integer,
unit capacity_units
);
```
现在创建一个包含新类型列的表,并用随机值填充它:
```text {label="psql"}
=> CREATE TABLE test AS
SELECT ( (random()*1023)::integer, u.unit )::capacity AS cap
FROM generate_series(1,100),
unnest(enum_range(NULL::capacity_units)) AS u(unit);
```
默认情况下,复合类型的值按字典序排序,而在此情况下,这与自然顺序不一致:
```text {label="psql"}
=> SELECT * FROM test ORDER BY cap;
cap
-----------
(1,MB)
(2,kB)
(3,MB)
(7,GB)
...
(1018,TB)
(1020,B)
(1020,kB)
(1021,PB)
(600 rows)
```
我们从一个将容量转换为字节的函数开始创建操作符类:
```text {label="psql"}
=> CREATE FUNCTION capacity_to_bytes(a capacity) RETURNS numeric
AS $$
SELECT a.amount::numeric *
1024::numeric ^ ( array_position(enum_range(a.unit), a.unit) - 1 );
$$ LANGUAGE sql STRICT IMMUTABLE;
=> SELECT capacity_to_bytes('(1,kB)'::capacity);
capacity_to_bytes
--------------------
1024.0000000000000
(1 row)
```
然后为未来的操作符类创建一个基准函数:
```text {label="psql"}
=> CREATE FUNCTION capacity_cmp(a capacity, b capacity)
RETURNS integer
AS $$
SELECT sign(bookings.capacity_to_bytes(a) - bookings.capacity_to_bytes(b));
$$ LANGUAGE sql STRICT IMMUTABLE;
```
现在,借助基准函数可以轻松定义比较操作符。我特意使用了‘奇怪’的名称,以说明它们可以是任意的:
```text {label="psql"}
=> CREATE FUNCTION capacity_lt(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
RETURN capacity_cmp(a,b) < 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #<# (
LEFTARG = capacity,
RIGHTARG = capacity,
FUNCTION = capacity_lt
);
```
其余四个操作符按类似方式定义。
```text {label="psql"}
=> CREATE FUNCTION capacity_le(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
RETURN capacity_cmp(a,b) <= 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #<=# (
LEFTARG = capacity,
RIGHTARG = capacity,
FUNCTION = capacity_le
);
```
```text {label="psql"}
=> CREATE FUNCTION capacity_eq(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
RETURN capacity_cmp(a,b) = 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #=# (
LEFTARG = capacity,
RIGHTARG = capacity,
FUNCTION = capacity_eq,
MERGES -- можно использовать в соединении слиянием
);
```
```text {label="psql"}
=> CREATE FUNCTION capacity_ge(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
RETURN capacity_cmp(a,b) >= 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #>=# (
LEFTARG = capacity,
RIGHTARG = capacity,
FUNCTION = capacity_ge
);
```
```text {label="psql"}
=> CREATE FUNCTION capacity_gt(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
RETURN capacity_cmp(a,b) > 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #># (
LEFTARG = capacity,
RIGHTARG = capacity,
FUNCTION = capacity_gt
);
```
此时,我们已经可以正确比较容量了:
```text {label="psql"}
=> SELECT (1,'MB')::capacity #># (512, 'kB')::capacity;
?column?
----------
t
(1 row)
```
在创建操作符类后,排序功能也将正常工作:
```text {label="psql"}
=> CREATE OPERATOR CLASS capacity_ops
DEFAULT FOR TYPE capacity -- будет использоваться по умолчанию
USING btree AS
OPERATOR 1 #<#,
OPERATOR 2 #<=#,
OPERATOR 3 #=#,
OPERATOR 4 #>=#,
OPERATOR 5 #>#,
FUNCTION 1 capacity_cmp(capacity,capacity);
=> SELECT * FROM test ORDER BY cap;
cap
-----------
(9,B)
(30,B)
(42,B)
(47,B)
...
(999,PB)
(1007,PB)
(1015,PB)
(1021,PB)
(600 rows)
```
我们的操作符类在创建索引时默认使用,创建的索引将返回正确顺序的值:
```text {label="psql"}
=> CREATE INDEX ON test(cap);
=> SELECT * FROM test WHERE cap #<# (100,'B')::capacity ORDER BY cap;
cap
--------
(9,B)
(30,B)
(42,B)
(47,B)
(66,B)
(67,B)
(69,B)
(97,B)
(99,B)
(9 rows)
=> EXPLAIN (costs off)
SELECT * FROM test WHERE cap #<# (100,'B')::capacity ORDER BY cap;
QUERY PLAN
---------------------------------------------
Index Only Scan using test_cap_idx on test
Index Cond: (cap #<# '(100,B)'::capacity)
(2 rows)
```
在创建等值操作符时指定的 `MERGES` 子句允许对我们的类型值使用合并连接。(参见 [483](/zh18/23-sorting-and-merging/#internal-ru-page-484))
## 25.6. 属性 {#internal-ru-section-25-6}
我们来看一下 B-树的接口特性。(参见 [404](/zh18/19-index-access-methods/#internal-ru-page-405))
### 访问方法级属性 {#internal-ru-subsection-star-383}
```text {label="psql"}
=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
'can_order', 'can_unique', 'can_multi_col',
'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'btree';
amname | name | pg_indexam_has_property
--------+---------------+-------------------------
btree | can_order | t
btree | can_unique | t
btree | can_multi_col | t
btree | can_exclude | t
btree | can_include | t
(5 rows)
```
B-树可以对数据进行排序并支持唯一性。这是唯一能提供这些特性的访问方法。
许多访问方法允许创建复合索引,但在 B-树中,必须仔细注意索引中列的顺序,因为其中的值是有序的。
虽然形式上支持排除约束,但仅限于等值操作符,这与唯一性要求一致。相比之下,使用真正的完整唯一性约束要好得多。
B-树还允许将额外的列添加到索引中,这些列不参与搜索。
如果表足够大,索引将并行构建。工作进程数量的计算方式与并行顺序扫描相同,但受参数 *max\_parallel\_maintenance\_workers* 上限限制。所有工作进程共用大小为 *maintenance\_work\_mem* 的内存。 (参见 [384](/zh18/18-table-access-methods/#internal-ru-page-385))(默认值:`2`)(默认值:`64MB`)
工作进程并行扫描表并排序获取的数据[^internal-ru-554-1];结果形成索引的叶页面,随后在这些页面上构建内部页面,直至根节点。
### 索引级属性 {#internal-ru-subsection-star-385}
```text {label="psql"}
=> SELECT p.name, pg_index_has_property('flights_pkey', p.name)
FROM unnest(array[
'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
name | pg_index_has_property
---------------+-----------------------
clusterable | t
index_scan | t
bitmap_scan | t
backward_scan | t
(4 rows)
```
基于 B-树的索引可用于聚簇。
B-树支持两种值获取方式:索引扫描和位图扫描。由于叶页面通过双向链表连接,索引不仅可以正向遍历,也可以反向遍历,从而获得相反的排序顺序:
```text {label="psql" hl_lines="5"}
=> EXPLAIN (costs off) SELECT *
FROM bookings ORDER BY book_ref DESC;
QUERY PLAN
-----------------------------------------------------
Index Scan Backward using bookings_pkey on bookings
(1 row)
```
### 列级属性 {#internal-ru-subsection-star-387}
ORDERABLE 属性表明 B-树以有序方式存储数据,前四个属性(ASC 和 DESC,NULLS FIRST 和 NULLS LAST)定义了该列值的具体排序方式。在以下示例中,列值按升序排序,而未定义值位于末尾。
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('flights_pkey', 1, p.name)
FROM unnest(array[
'asc', 'desc', 'nulls_first', 'nulls_last', 'orderable',
'distance_orderable', 'returnable', 'search_array', 'search_nulls'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
asc | t
desc | f
nulls_first | f
nulls_last | t
orderable | t
distance_orderable | f
returnable | t
search_array | t
search_nulls | t
(9 rows)
```
SEARCH NULLS 属性表明支持对未定义值的搜索。
B-树尚未实现排序操作符支持(DISTANCE ORDERABLE),尽管曾有过此类尝试[^internal-ru-555-1]。
B-树支持从数组中搜索多个值(SEARCH ARRAY 属性),并允许在不访问表的情况下获取数据(RETURNABLE 属性)。
[^internal-ru-524-1]: [postgrespro.ru/docs/postgresql/18/btree](); [backend/access/nbtree/README]().
[^internal-ru-525-1]: [backend/access/nbtree/nbtsearch.c](), 函数 \_bt\_search.
[^internal-ru-534-1]: [postgrespro.ru/docs/postgresql/18/btree#BTREE-DEDUPLICATION]().
[^internal-ru-535-1]: [backend/access/nbtree/nbtinsert.c](), 函数 \_bt\_delete\_or\_dedup\_one\_page.
[^internal-ru-535-2]: [backend/access/nbtree/nbtdedup.c](), 函数 \_bt\_dedup\_pass.
[^internal-ru-535-3]: [postgrespro.ru/docs/postgresql/18/collation]().
[^internal-ru-536-1]: [backend/access/nbtree/nbtinsert.c](), 函数 \_bt\_split.
[^internal-ru-537-1]: [postgrespro.ru/docs/postgresql/18/indexes-multicolumn]().
[^internal-ru-545-1]: [backend/access/nbtree/nbtutils.c](), 函数 \_bt\_advance\_array\_keys.
[^internal-ru-545-2]: [include/utils/skipsupport.h]().
[^internal-ru-547-1]: [postgrespro.ru/docs/postgresql/18/btree#BTREE-BEHAVIOR]().
[^internal-ru-548-1]: [postgrespro.ru/docs/postgresql/18/xindex#XINDEX-STRATEGIES]().
[^internal-ru-548-2]: [postgrespro.ru/docs/postgresql/18/btree-support-funcs]().
[^internal-ru-548-3]: [postgrespro.ru/docs/postgresql/18/xindex#XINDEX-EXAMPLE]().
[^internal-ru-554-1]: [backend/access/nbtree/nbtsort.c](), 函数 btbuild.
[^internal-ru-555-1]: [commitfest.postgresql.org/27/1804]().