24.1. 总览 哈希索引
在向索引插入时
索引的哈希表是动态扩展的
在索引中查找时
由于键值本身不保存在哈希表中,索引方法可能因哈希冲突而返回多余的行版本标识符。因此,索引机制必须通过表对访问方法返回的所有结果进行重新验证。同样原因,无法仅对索引进行扫描。(参见 411 )
24.2. 页面布局 与普通哈希表不同,索引存储在磁盘上。因此所有必要信息必须分页存储,且希望索引操作(查找、插入、删除)访问的页面数量尽可能少。
哈希索引使用四种类型的页面:
元页面(meta page)—— 0 号页面,包含索引的“目录”;
桶页面(bucket page)—— 索引的主要页面,每个桶对应一个页面;
溢出页面(overflow page)—— 当桶的主页面无法容纳所有元素时使用的额外页面;
位图页面(bitmap page)—— 包含位数组的页面,用于标记已释放且可重复使用的溢出页面。
可通过 pageinspect 扩展查看索引页面内部结构。
从一个空表开始:
=> CREATE EXTENSION pageinspect;
=> CREATE TABLE t(n integer);
=> ANALYZE t;
=> CREATE INDEX ON t USING hash(n);
我分析了表以获取最小尺寸的索引;否则桶数将对应于 10 页的表
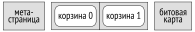
当前索引包含四页:元页面、两个主桶页面和一个位图页面(预先创建以备不时之需):
=> SELECT page, hash_page_type(get_raw_page('t_n_idx', page))
FROM generate_series(0,3) page;
 page | hash_page_type
------+----------------
    0 | metapage
    1 | bucket
    2 | bucket
    3 | bitmap
(4 rows)
图 24.1 页面组织 元页面包含索引的全部控制信息。目前我们关注几个值:
=> SELECT ntuples, ffactor, maxbucket
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 ntuples | ffactor | maxbucket
---------+---------+-----------
       0 |     307 |         1
(1 row)
字段 ffactor 显示每桶的估算行数。该值基于块容量和存储参数 fillfactor 的设置计算得出。在数据完全均匀分布且无哈希冲突的情况下,可适当提高 fillfactor ,但现实中这会增加单个桶的元素无法容纳于一页的可能性。(默认值:75)
对哈希索引最不利的情况是数据分布严重倾斜,即某个键被重复多次。由于哈希函数会产生相同值,所有数据都会落入同一个桶,增加桶数也无法缓解此问题。
当前索引为空,这由字段 ntuples 的值表明。通过向表中插入大量具有相同索引列值的行来填满桶页面。索引中将出现溢出页面:
=> INSERT INTO t(n)
  SELECT 0 FROM generate_series(1,500); -- одно значение
=> SELECT page, hash_page_type(get_raw_page('t_n_idx', page))
FROM generate_series(0,4) page;
 page | hash_page_type
------+----------------
    0 | metapage
    1 | bucket
    2 | bucket
    3 | bitmap
    4 | overflow
(5 rows)
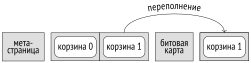
图 24.2 页面组织 页面信息摘要显示桶 0 为空,所有值均落入桶 1:部分在主页面,未容纳的部分在溢出页面。
=> SELECT page, live_items, free_size, hasho_bucket
FROM (VALUES (1), (2), (4)) p(page),
  hash_page_stats(get_raw_page('t_n_idx', page));
 page | live_items | free_size | hasho_bucket
------+------------+-----------+--------------
    1 |          0 |      8148 |            0
    2 |        407 |         8 |            1
    4 |         93 |      6288 |            1
(3 rows)
显然,单个桶的元素分散在多个页面上会严重影响性能。哈希索引在数据均匀分布时表现最佳。
现在来看桶如何分裂。当索引中行数超过当前桶的估算值 ffactor 时发生分裂。本例中,两个桶且 ffactor = 307,当插入第 615 行时将触发分裂:
=> SELECT ntuples, ffactor, maxbucket, ovflpoint
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 ntuples | ffactor | maxbucket | ovflpoint
---------+---------+-----------+-----------
     500 |     307 |         1 |         1
(1 row)
=> INSERT INTO t(n)
  SELECT n FROM generate_series(1,115) n; -- теперь разные
=> SELECT ntuples, ffactor, maxbucket, ovflpoint
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 ntuples | ffactor | maxbucket | ovflpoint
---------+---------+-----------+-----------
     615 |     307 |         2 |         2
(1 row)
字段 maxbucket 增加至 2:现在共有三个桶,编号从 0 到 2。尽管仅新增一个桶,但页面数量翻倍:
=> SELECT page, hash_page_type(get_raw_page('t_n_idx', page))
FROM generate_series(0,6) page;
 page | hash_page_type
------+----------------
    0 | metapage
    1 | bucket
    2 | bucket
    3 | bitmap
    4 | overflow
    5 | bucket
    6 | unused
(7 rows)
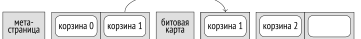
图 24.3 页面组织 新增的一个页面用于桶 2,另一个页面保持空闲,将在桶 3 出现时使用。
=> SELECT page, live_items, free_size, hasho_bucket
FROM (VALUES (1), (2), (4), (5)) p(page),
  hash_page_stats(get_raw_page('t_n_idx', page));
 page | live_items | free_size | hasho_bucket
------+------------+-----------+--------------
    1 |         27 |      7608 |            0
    2 |        407 |         8 |            1
    4 |        158 |      4988 |            1
    5 |         23 |      7688 |            2
(4 rows)
因此,从操作系统的角度看,哈希索引的大小呈跳跃式增长,尽管逻辑上哈希表是逐步扩展的。
为略微平滑此增长并避免一次性分配过多页面,从第 10 次页面翻倍开始,页面并非一次性全部分配,而是按计算数量的 1 4 \frac14 4 1
元页面中的另外两个字段是位掩码,揭示了桶地址的细节:
=> SELECT maxbucket, highmask::bit(4), lowmask::bit(4)
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 maxbucket | highmask | lowmask
-----------+----------+---------
         2 | 0011     | 0001
(1 row)
桶号由哈希码中与掩码 highmask 对应的比特决定。但如果所得桶号不存在(超过 maxbucket),则需使用与掩码 lowmask 对应的比特
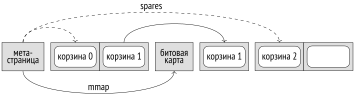
每次翻倍时,新桶页面始终以连续块形式分配,而溢出页面和位图页面则按需插入这些块之间。元页面在数组 spares 中存储每个块已分配的页面数量,从而可通过桶号计算其主页面号
本例中,第一次翻倍后插入了两页(位图和溢出页),第二次翻倍后尚未新增任何页面:
=> SELECT spares[2], spares[3]
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 spares | spares
--------+--------
      2 |      2
(1 row)
元页面还存储指向位图页面的数组:
=> SELECT mapp[1]
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 mapp
------
    3
(1 row)
图 24.4 页面组织 索引页面内部空间在删除对死行版本的引用时释放。这发生在自动清理(当尝试向已满页面插入元素时触发
但哈希索引无法缩小自身尺寸,一旦分配的页面便不会归还给操作系统。主页面始终固定分配给其对应桶,即使桶中无任何元素;空闲的溢出页面由位图跟踪并可重复使用(可能用于其他桶)。唯一能减小索引物理尺寸的方法是使用 REINDEX 或 VACUUM FULL 命令重建索引。(参见 170 )
在查询计划中,索引类型不会被特别标记:
=> CREATE INDEX ON flights USING hash(flight_no);
=> EXPLAIN (costs off)
SELECT *
FROM flights
WHERE flight_no = 'PG0001';
                    QUERY PLAN
--------------------------------------------------
 Bitmap Heap Scan on flights
   Recheck Cond: (flight_no = 'PG0001'::bpchar)
   -> Bitmap Index Scan on flights_flight_no_idx
       Index Cond: (flight_no = 'PG0001'::bpchar)
(4 rows)
24.3. 操作符类 在 PostgreSQL 10 之前,哈希索引未被写入 WAL,即未受崩溃保护且无法复制,因此不推荐使用。但即便如此,它们仍具有一定的价值。原因在于哈希算法被广泛使用(例如用于哈希连接和分组),系统需要知道每种数据类型对应的哈希函数。但这种对应关系并非静态:无法一次性永久设定,因为 PostgreSQL 支持动态添加新数据类型。因此,这种对应关系由哈希索引操作符类与特定数据类型共同维护。哈希函数本身由操作符类的参考函数提供:(参见 457 )(参见 397 )(psql: \dAp)
=> SELECT opfname AS opfamily_name,
  amproc::regproc AS opfamily_procedure
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_amproc amproc ON amprocfamily = opf.oid
WHERE amname = 'hash'
AND amprocnum = 1
ORDER BY opfamily_name, opfamily_procedure;
   opfamily_name    | opfamily_procedure
--------------------+--------------------
 aclitem_ops        | hash_aclitem
 array_ops          | hash_array
 bool_ops           | hashbool
 bpchar_ops         | hashbpchar
 bpchar_pattern_ops | hashbpchar
 bytea_ops          | hashbytea
 ...
 timestamptz_ops    | timestamptz_hash
 timetz_ops         | timetz_hash
 uuid_ops           | uuid_hash
 xid8_ops           | hashxid8
 xid_ops            | hashxid
(38 rows)
这些函数返回 32 位整数。尽管未正式文档化,但可用于计算相应类型值的哈希码。
例如,text_ops 家族使用函数 hashtext:
=> SELECT hashtext('раз'), hashtext('два');
 hashtext  | hashtext
-----------+-----------
 127722028 | 345620034
(1 row)
哈希索引操作符类包含一个操作符——“等于”。通常正是该操作符用于系统级的相等性检查。(psql: \dAo)
=> SELECT opfname AS opfamily_name,
  left(amopopr::regoperator::text, 20) AS opfamily_operator
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opf.oid
WHERE amname = 'hash'
ORDER BY opfamily_name, opfamily_operator;
   opfamily_name    |  opfamily_operator
--------------------+----------------------
 aclitem_ops        | =(aclitem,aclitem)
 array_ops          | =(anyarray,anyarray)
 bool_ops           | =(boolean,boolean)
 ...
 xid8_ops           | =(xid8,xid8)
 xid_ops            | =(xid,xid)
(48 rows)
24.4. 属性 查看哈希索引方法向系统报告的属性。(参见 404 )
访问方法属性
=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'hash';
 amname |     name      | pg_indexam_has_property
--------+---------------+-------------------------
 hash   | can_order     | f
 hash   | can_unique    | f
 hash   | can_multi_col | f
 hash   | can_exclude   | t
 hash   | can_include   | f
(5 rows)
显然,哈希索引不允许对行进行排序:哈希函数以或多或少随机的方式打乱数据。
不支持唯一性约束。尽管可以使用哈希索引实现排除约束,且仅使用单一的「等于」函数时,排除约束就具有了唯一性的意义:(参见 408 )
=> ALTER TABLE aircrafts_data
  ADD CONSTRAINT unique_range EXCLUDE USING hash(range WITH =);
=> INSERT INTO aircrafts_data
  VALUES ('744','{"ru": "Боинг 747-400"}',11100);
ERROR:  conflicting key value violates exclusion constraint
"unique_range"
DETAIL:  Key (range)=(11100) conflicts with existing key
(range)=(11100).
同样不支持多列哈希索引,也不支持向索引中添加额外的 include 列。
索引级属性
=>  SELECT p.name, pg_index_has_property('flights_flight_no_idx', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
---------------+-----------------------
 clusterable   | f
 index_scan    | t
 bitmap_scan   | t
 backward_scan | t
(4 rows)
哈希索引既支持常规索引扫描,也支持位图扫描。
不支持按哈希索引对表进行聚簇。这是合理的,因为很难想象需要根据哈希函数值物理地对表中数据进行排序的场景。
列级属性 实际上,列的属性完全由访问方法层面定义,并始终取相同的值。
=> SELECT p.name,
  pg_index_column_has_property('flights_flight_no_idx', 1, p.name)
FROM unnest(array[
  'asc', 'desc', 'nulls_first', 'nulls_last', 'orderable',
  'distance_orderable', 'returnable', 'search_array', 'search_nulls'
]) p(name);
        name        | pg_index_column_has_property
--------------------+------------------------------
 asc                | f
 desc               | f
 nulls_first        | f
 nulls_last         | f
 orderable          | f
 distance_orderable | f
 returnable         | f
 search_array       | f
 search_nulls       | f
(9 rows)
由于哈希函数不保持顺序关系,因此无法对哈希索引应用与顺序性相关的属性。
哈希索引无法参与仅索引扫描,因为它不保存索引键,且需要回表重新验证。
哈希索引不支持处理空值:对 NULL 执行「等于」操作没有意义。
不支持从数组中查找值。