# 哈希
LLMS 索引: [llms.txt](/zh18/llms.txt)
---
## 22.1. 哈希连接 {#internal-ru-section-22-1}
### 一阶段哈希连接 {#internal-ru-subsection-star-311}
哈希连接的核心思想是使用预先准备好的哈希表来查找匹配的行。以下是一个使用这种连接方式的执行计划示例:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets t
JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no;
QUERY PLAN
-------------------------------------------
Hash Join
Hash Cond: (tf.ticket_no = t.ticket_no)
-> Seq Scan on ticket_flights tf
-> Hash
-> Seq Scan on tickets t
(5 rows)
```
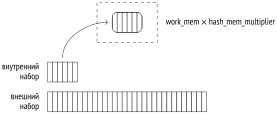
在**第一阶段**,哈希连接节点 [^internal-ru-458-1] 会访问哈希节点 [^internal-ru-458-2]。该节点从其子节点获取整个内部行集,并将其放入*哈希表*中。
哈希表能够存储由*哈希键*和*值*组成的键值对,随后可以以固定时间复杂度(与哈希表大小无关)根据键查找值。为此,哈希键被大致均匀地分布到有限数量的*桶*(bucket)中。哈希表桶的编号由哈希键的*哈希函数*值决定;由于桶的数量始终是2的幂,因此从计算出的值中取所需数量的二进制位。
该实现使用动态可扩展的哈希表,并采用链式冲突解决方式 [^internal-ru-459-1],与缓冲区缓存的实现类似。(参见 [190](/zh18/09-buffer-cache/#internal-ru-page-191))
因此,在第一阶段,会顺序读取内部行集的每一行,并为每行计算哈希函数。此时,哈希键是参与连接条件的字段(Hash Cond),而哈希表中保存的是内部行集中查询所需的所有字段。
哈希连接最高效的情况是,哈希表能够完全放入内存中。其可用大小受限于 *work\_mem* × *hash\_mem\_multiplier* 的乘积。(v. 13)(默认值:`4MB`)(默认值:`2.0`)
{#internal-ru-fig-22-1 num="22.1" caption="单次遍历哈希连接" .book-original-figure width=555 height=228}
以下是一个使用 `EXPLAIN ANALYZE` 命令执行查询的示例,以获取内存使用信息:
```text {label="psql" hl_lines="12"}
=> SET work_mem = '128MB';
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM bookings b
JOIN tickets t ON b.book_ref = t.book_ref;
QUERY PLAN
------------------------------------------------------------------
Hash Join (actual rows=2949857.00 loops=1)
Hash Cond: (t.book_ref = b.book_ref)
-> Seq Scan on tickets t (actual rows=2949857.00 loops=1)
-> Hash (actual rows=2111110.00 loops=1)
Buckets: 4194304 Batches: 1 Memory Usage: 145986kB
-> Seq Scan on bookings b (actual rows=2111110.00 loops=1)
(6 rows)
```
与嵌套循环连接不同,后者对内部和外部行集有明显区分,而哈希连接允许交换行集的顺序。通常,较小的行集被用作内部行集,因为这样哈希表会更小。
此处的内存容量足以容纳整个哈希表,其大小约为143 MB(Memory Usage),包含4M = 222个桶(Buckets)。因此,连接仅需一次遍历(Batches)完成。
然而,如果查询中仅使用一个列,哈希表仅需111 MB的内存空间:
```text {label="psql" hl_lines="11"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT b.book_ref
FROM bookings b
JOIN tickets t ON b.book_ref = t.book_ref;
QUERY PLAN
------------------------------------------------------------------
Hash Join (actual rows=2949857.00 loops=1)
Hash Cond: (t.book_ref = b.book_ref)
-> Seq Scan on tickets t (actual rows=2949857.00 loops=1)
-> Hash (actual rows=2111110.00 loops=1)
Buckets: 4194304 Batches: 1 Memory Usage: 113172kB
-> Seq Scan on bookings b (actual rows=2111110.00 loops=1)
(6 rows)
=> RESET work_mem;
```
这再次说明不应在查询中使用多余的字段,包括“星号”(*)。
哈希表的桶数量被选择为:在数据完全填满时,每个桶平均包含一行。过高的填充密度会增加哈希冲突的概率,从而降低查找效率;而过低的填充密度则会浪费内存。计算出的桶数量会向上取整为最接近的2的幂[^internal-ru-461-1]。
(如果根据单行平均“宽度”估算,按计算桶数的哈希表大小超过了内存限制,则使用双次遍历哈希。)
在哈希表完全构建完成之前,哈希连接无法开始返回结果。
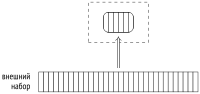
在**第二阶段**(此时哈希表已准备就绪),哈希连接节点会向第二个子节点请求外部行集。对于每行读取的外部行,检查其在哈希表中是否存在匹配行。为此,对属于连接条件的外部行字段计算哈希函数。
{#internal-ru-fig-22-2 num="22.2" caption="单次遍历哈希连接" .book-original-figure width=400 height=188}
找到的匹配结果将返回给上级节点。
**成本估算**。我之前已经讨论过基数估算,它与连接方式无关,因此接下来我只讨论成本估算。(参见 [444](/zh18/21-nested-loop/#internal-ru-page-445))
哈希节点的成本取其子节点的总成本。这是一个虚构的数值,仅用于在查询计划中显示结果[^internal-ru-462-1]。所有实际成本估算均包含在哈希连接节点的成本中[^internal-ru-462-2]。
我们来看一个示例:
```text {label="psql" hl_lines="6 9 11"}
=> EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT * FROM flights f
JOIN seats s ON s.aircraft_code = f.aircraft_code;
QUERY PLAN
---------------------------------------------------------------------
Hash Join (cost=42.13..278511.28 rows=16518865 width=78)
(actual rows=16518865.00 loops=1)
Hash Cond: (f.aircraft_code = s.aircraft_code)
-> Seq Scan on flights f (cost=0.00..4772.67 rows=214867 widt...
(actual rows=214867.00 loops=1)
-> Hash (cost=25.39..25.39 rows=1339 width=15)
(actual rows=1339.00 loops=1)
Buckets: 2048 Batches: 1 Memory Usage: 79kB
-> Seq Scan on seats s (cost=0.00..25.39 rows=1339 width=15)
(actual rows=1339.00 loops=1)
(10 rows)
```
连接的初始成本主要反映哈希表的创建,其构成如下:
- 内部行集获取的完整成本,这是构建哈希表所必需的;
- 对内部行集的每一行,计算连接键中所有字段的哈希函数的成本(每项操作按参数 *cpu\_operator\_cost* 估算);(默认值:`0.0025`)
- 将内部行集的所有行插入哈希表的成本(单行插入按参数 *cpu\_tuple\_cost* 估算);(默认值:`0.01`)
- 外部行集获取的初始成本,没有它无法开始连接操作。
总成本在初始估算的基础上增加了实际连接的成本:
- 对外部行集的每一行,计算连接键中所有字段的哈希函数的成本(*cpu\_operator\_cost*);
- 由于可能的哈希冲突,需要对连接条件进行重新验证的成本(每个操作按参数 *cpu\_operator\_cost* 估算);
- 每条结果行处理成本(*cpu\_tuple\_cost*)。
此处成本估算中最复杂的是确定连接过程中所需的重新验证次数。该值估算为外部行集行数乘以内部行集行数(位于哈希表中)的某个比例。该比例的估算考虑了值分布不均的可能性。我不会深入细节 [^internal-ru-463-1];在此情况下,该比例估算为0.150112。
因此,我们示例中的成本估算计算如下:
```text {label="psql"}
=> WITH cost(startup) AS (
SELECT round((
21.39 +
current_setting('cpu_operator_cost')::real * 1339 +
current_setting('cpu_tuple_cost')::real * 1339 +
0.00
)::numeric, 2)
)
SELECT startup,
startup + round((
4772.67 +
current_setting('cpu_operator_cost')::real * 214867 +
current_setting('cpu_operator_cost')::real * 214867 * 1339 *
0.150112 +
current_setting('cpu_tuple_cost')::real * 16518865
)::numeric, 2) AS total
FROM cost;
startup | total
---------+-----------
38.13 | 278507.26
(1 row)
```
成本计算的依赖关系可表示如下:
```text
QUERY PLAN
--------------------------------------------------
Hash Join
(cost=42.13..278511.28 rows=16518865 width=78)
Hash Cond: (f.aircraft_code = s.aircraft_code)
-> Seq Scan on flights f
(cost=0.00..4772.67 rows=214867 width=63)
-> Hash
(cost=25.39..25.39 rows=1339 width=15)
-> Seq Scan on seats s
(cost=0.00..25.39 rows=1339 width=15)
(9 rows)
```
### 两阶段哈希连接 {#internal-ru-subsection-star-315}
如果在规划阶段估算显示哈希表无法放入分配的内存空间,则内部行集将被划分为若干个*批次*(batch),每个批次分别处理。批次数量(与桶数量一样)始终是2的幂;批次编号由哈希值的相应位数决定[^internal-ru-464-1]。
任何一对在连接中相互匹配的行,必定属于同一个批次,因为不同批次的行不可能具有相同的哈希值。
每个批次对应相同数量的哈希值。如果数据分布均匀,则所有批次的大小也大致相同。规划器可以通过选择合适的批次数量来控制内存使用量[^internal-ru-464-2]。
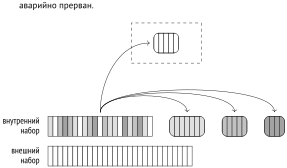
在**第一阶段**,读取内部行集并构建哈希表。如果当前内部行集的某行属于第一个批次,则将其添加到哈希表中并保留在内存中。如果属于其他批次,则将其写入*临时文件*——每个批次都有自己的临时文件[^internal-ru-465-1]。(默认值:`-1`)
> [!NOTE]
> 请注意,可以通过设置参数 *temp\_file\_limit* 来限制会话在磁盘上使用的临时文件大小(临时表不计入此限制)。如果会话超出该限制,查询将
{#internal-ru-fig-22-3 num="22.3" caption="双次遍历哈希连接" .book-original-figure width=573 height=337}
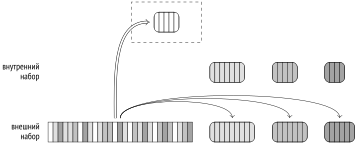
在**第二阶段**,读取外部行集。如果当前行属于第一个批次,则将其与哈希表进行匹配,该哈希表恰好包含第一个批次的内部行集(其他批次不可能存在匹配)。
如果该行属于其他批次,则将其写入临时文件——同样,每个批次都有自己的临时文件。因此,当有 *N* 个批次时,将使用 2 (*N* − 1) 个文件(或更少,如果某些批次为空)。
第二阶段结束后,哈希表占用的内存被释放。此时,已获得一个批次的连接部分结果。
{#internal-ru-fig-22-4 num="22.4" caption="双次遍历哈希连接" .book-original-figure width=713 height=288}
随后,对每个已保存到磁盘的批次,依次重复两个阶段:将临时文件中的内部行集行加载到哈希表;从另一个临时文件中读取对应批次的外部行集行,并与哈希表进行匹配。已使用的临时文件将被删除。
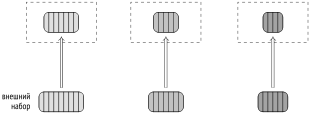
{#internal-ru-fig-22-5 num="22.5" caption="两阶段哈希连接" .book-original-figure width=620 height=228}
两阶段连接在 `EXPLAIN` 命令的输出中与单阶段连接的区别在于,其包的数量大于一。此外,使用 `buffers` 关键字时,命令将显示与磁盘交换的统计信息:
```text {label="psql" hl_lines="9 13 14"}
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM bookings b
JOIN tickets t ON b.book_ref = t.book_ref;
QUERY PLAN
-----------------------------------------------------------------
Hash Join (actual rows=2949857.00 loops=1)
Hash Cond: (t.book_ref = b.book_ref)
Buffers: shared hit=12759 read=50169, temp read=54218 writ...
-> Seq Scan on tickets t (actual rows=2949857.00 loops=1)
Buffers: shared hit=385 read=49055
-> Hash (actual rows=2111110.00 loops=1)
Buckets: 131072 Batches: 32 Memory Usage: 4551kB
Buffers: shared hit=12374 read=1114, temp written=10701
-> Seq Scan on bookings b (actual rows=2111110.00 loop...
Buffers: shared hit=12374 read=1114
(10 rows)
```
我之前已经给出了这个例子,但将 *work\_mem* 的值增大了。在默认分配的 8 MB 内存中,整个哈希表无法容纳;此处使用了 32 个包,哈希表使用了 128 KB = 217 个桶。在构建哈希表阶段(Hash 节点)会将数据写入临时文件;在连接阶段(Hash Join 节点)则会读取和写入这些文件。
参数 *log\_temp\_files* 可以让服务器日志中记录更详细的临时文件信息。当其值为 0 时,日志中将记录每个文件及其大小(在删除时)。(*默认值:* `-1`)
### 动态调整 {#internal-ru-subsection-star-317}
计划中的事件流程可能被两个问题破坏:统计信息不准确和分布不均。
当连接键中的列值分布不均时,不同的包将包含不同数量的行。
如果某个包(除第一个外)过大,其所有行都必须先写入磁盘,然后再从磁盘读取。主要问题通常出现在外部集合上,因为外部集合通常更大。因此,如果外部集合的行具有普通且非多值的统计信息(即外部集合是一张表,且连接基于单个列),那么哈希码对应于多个最频繁值的行将被视为属于第一个包[^internal-ru-468-1]。这种优化(倾斜优化)可以在两阶段连接中略微减少 I/O。(*参见* [369](/zh18/17-statistics/#internal-ru-page-370))
这两个问题都可能导致某些(或全部)包的大小超过预期。此时,这些包的哈希表将无法容纳在预定大小内,从而超出限制。
因此,如果在构建哈希表过程中发现其大小超出限制,包的数量将动态增加(翻倍)。实际上,每个包被分成两个新包:大约一半的行(假设分布均匀)保留在哈希表中,另一半则被写入新的临时文件[^internal-ru-468-2]。
即使原本计划为单阶段连接,这种情况也可能发生。实际上,单阶段和两阶段连接是同一个算法,由同一段代码实现。我将它们分开只是为了便于说明。
包的数量只能增加。如果发现规划器高估了,包不会被合并。
然而,在分布不均的情况下,增加包的数量可能无济于事。例如,键列可能在所有行中包含相同的值:显然,所有行都会落入同一个包中,因为哈希函数会返回相同的值。遗憾的是,在这种情况下,哈希表将不断增长,不受任何限制参数的影响。
> [!NOTE]
> 理论上,可以采用多阶段连接,每次只处理包的一部分,但目前尚未实现。
为了演示包数量的动态增加,必须采取一些措施来欺骗规划器。(*参见* [349](/zh18/17-statistics/#internal-ru-page-350))
```text {label="psql"}
=> CREATE TABLE bookings_copy (LIKE bookings INCLUDING INDEXES)
WITH (autovacuum_enabled = off);
=> INSERT INTO bookings_copy SELECT * FROM bookings;
INSERT 0 2111110
=> DELETE FROM bookings_copy WHERE random() < 0.9;
DELETE 1899898
=> ANALYZE bookings_copy;
=> INSERT INTO bookings_copy SELECT * FROM bookings
ON CONFLICT DO NOTHING;
INSERT 0 1899898
=> SELECT reltuples FROM pg_class WHERE relname = 'bookings_copy';
reltuples
-----------
211212
(1 row)
```
通过这些操作,我们得到了表 `bookings_copy` —— `bookings` 的完整副本,但规划器认为其行数仅为实际的十分之一。在现实中,这种情况可能出现在哈希表基于另一个连接的结果构建时,而该连接没有可靠的统计信息。
由于这一错误,规划器认为只需 4 个包就足够了,但在连接执行过程中,包的数量增加到了 16 个:
```text {label="psql" hl_lines="11 12"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM bookings_copy b
JOIN tickets t ON b.book_ref = t.book_ref;
QUERY PLAN
---------------------------------------------------------------------
Hash Join (actual rows=2949857.00 loops=1)
Hash Cond: (t.book_ref = b.book_ref)
-> Seq Scan on tickets t (actual rows=2949857.00 loops=1)
-> Hash (actual rows=2111110.00 loops=1)
Buckets: 131072 (originally 131072) Batches: 16 (originally
4) Memory Usage: 8085kB
-> Seq Scan on bookings_copy b (actual rows=2111110.00 loo...
(7 rows)
```
**成本估算。** 这是与我之前展示单阶段连接成本计算相同的例子,但现在我将可用内存极小化,规划器被迫使用两个包。此时连接成本增加:
```text {label="psql" hl_lines="9 16"}
=> SET work_mem = '64kB';
=> SET hash_mem_multiplier = 1.0;
=> EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT *
FROM flights f
JOIN seats s ON s.aircraft_code = f.aircraft_code;
QUERY PLAN
---------------------------------------------------------------------
Hash Join (cost=49.13..283143.28 rows=16518865 width=78)
(actual rows=16518865.00 loops=1)
Hash Cond: (f.aircraft_code = s.aircraft_code)
-> Seq Scan on flights f (cost=0.00..4772.67 rows=214867 widt...
(actual rows=214867.00 loops=1)
-> Hash (cost=25.39..25.39 rows=1339 width=15)
(actual rows=1339.00 loops=1)
Buckets: 2048 Batches: 2 Memory Usage: 55kB
-> Seq Scan on seats s (cost=0.00..25.39 rows=1339 width=15)
(actual rows=1339.00 loops=1)
(10 rows)
=> RESET work_mem;
=> RESET hash_mem_multiplier;
```
第二阶段的开销与将行写入临时文件以及从文件读取有关。
为单阶段连接计算的初始成本在此情况下增加了对写入足够页面的估算,这些页面足以保存内部集合中所有行的所需字段[^internal-ru-470-1]。尽管第一个包在构建哈希表时不会写入磁盘,但这一情况未被计入成本估算中,因此成本估算与包的数量无关。
总成本增加了对先前写入的内部集合行的读取估算,以及对外部集合行的写入和读取估算。
读写一页的成本均以参数 *seq\_page\_cost* 估算,基于顺序 I/O 的特性。
在此示例中,内部集合行的页面数估算为 7,外部集合行的页面数估算为 2309。将这些估算值加到之前单阶段连接获得的成本上,得到的数字与查询计划中的成本一致:
```text {label="psql"}
=> SELECT 38.13 + -- начальная стоимость однопроходного соединения
current_setting('seq_page_cost')::real * 7
AS startup,
278507.28 + -- полная стоимость однопроходного соединения
current_setting('seq_page_cost')::real * 2 * (7 + 2309)
AS total;
startup | total
---------+-----------
45.13 | 283139.28
(1 row)
```
因此,当内存不足时,连接算法变为两阶段,其效率下降。因此,重要的是:
- 哈希表中只应包含真正需要的字段(查询作者的责任);
- 哈希表应基于更小的行集合构建(规划器的责任)。
### 在并行计划中使用哈希连接 {#internal-ru-subsection-star-321}
哈希连接可以以我上述描述的形式参与并行计划。这意味着,首先多个并行进程独立地为内部集合构建各自的(完全相同的)哈希表,然后使用并行访问外部集合的行。收益来自于每个进程仅扫描外部集合的一部分。
以下是一个包含普通(本例中为单阶段)哈希连接的计划示例:
```text {label="psql"}
=> SET work_mem = '128MB';
=> SET enable_parallel_hash = off;
```
```text {label="psql" hl_lines="16"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT count(*)
FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref;
QUERY PLAN
---------------------------------------------------------------------
Finalize Aggregate (actual rows=1.00 loops=1)
-> Gather (actual rows=3.00 loops=1)
Workers Planned: 2
Workers Launched: 2
-> Partial Aggregate (actual rows=1.00 loops=3)
-> Hash Join (actual rows=983285.67 loops=3)
Hash Cond: (t.book_ref = b.book_ref)
-> Parallel Seq Scan on tickets t (actual rows=983...
-> Hash (actual rows=2111110.00 loops=3)
Buckets: 4194304 Batches: 1 Memory Usage:
113172kB
-> Seq Scan on bookings b (actual rows=2111110...
(12 rows)
```
```text {label="psql"}
=> RESET enable_parallel_hash;
```
在此计划中,每个进程对表 `bookings` 进行哈希处理,然后使用并行扫描(Parallel Seq Scan)获取的本进程部分行与哈希表进行匹配。
哈希表的内存限制适用于每个并行进程,因此总内存使用量是计划中显示的内存使用量的三倍。
### 并行一阶段哈希连接 {#internal-ru-subsection-star-323}
尽管普通哈希连接在并行计划中也能带来一定优势(尤其是在内部集合较小时,无需并行处理),但对于大数据集,专用的并行哈希连接算法表现更佳。
与非并行版本算法的重要区别在于,哈希表不是创建在进程的本地内存中,而是创建在 *共享* 的动态分配内存中,所有参与连接的并行进程均可访问。这使得可以创建一个统一的哈希表,而不是多个独立的哈希表,从而利用所有参与进程的总内存。这提高了单阶段连接的可能性。
在 **第一阶段**,计划中由 Parallel Hash 节点表示,所有并行进程通过并行访问内部行集合[^internal-ru-473-1]共同构建哈希表。
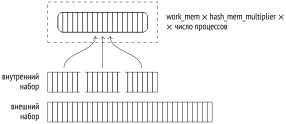
{#internal-ru-fig-22-6 num="22.6" caption="并行单阶段哈希连接" .book-original-figure width=572 height=248}
为了继续推进,每个并行进程必须完成其第一阶段的部分工作[^internal-ru-473-2]。
在 **第二阶段**(Parallel Hash Join 节点),当哈希表构建完成后,每个进程使用并行访问[^internal-ru-473-3]将其部分外部集合行与哈希表进行匹配。
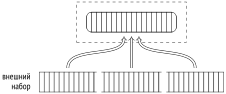
{#internal-ru-fig-22-7 num="22.7" caption="并行单阶段哈希连接" .book-original-figure width=451 height=188}
以下是一个此类计划的示例:
```text {label="psql"}
=> SET work_mem = '64MB';
```
```text {label="psql" hl_lines="12 15 16"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT count(*)
FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref;
QUERY PLAN
---------------------------------------------------------------------
Finalize Aggregate (actual rows=1.00 loops=1)
-> Gather (actual rows=3.00 loops=1)
Workers Planned: 2
Workers Launched: 2
-> Partial Aggregate (actual rows=1.00 loops=3)
-> Parallel Hash Join (actual rows=983285.67 loops=3)
Hash Cond: (t.book_ref = b.book_ref)
-> Parallel Seq Scan on tickets t (actual rows=983...
-> Parallel Hash (actual rows=703703.33 loops=3)
Buckets: 4194304 Batches: 1 Memory Usage:
115424kB
-> Parallel Seq Scan on bookings b (actual row...
(12 rows)
```
```text {label="psql"}
=> RESET work_mem;
```
这是我在前一节展示过的相同查询,但当时并行哈希连接被参数 *enable\_parallel\_hash* 显式禁用。(*默认值:* `on`)
尽管我将哈希表的内存空间减半,与前一节的普通哈希连接相比,连接仍保持单阶段,这是由于所有并行进程共享内存(Memory Usage)。哈希表略有增大,但仅存在一个实例,因此总内存使用量减少。
### 并行两阶段哈希连接 {#internal-ru-subsection-star-325}
即使所有并行进程共享的内存也不足以容纳整个哈希表。这可能在规划阶段或执行阶段变得明显。在这种情况下,将使用两阶段算法,其与之前讨论的所有算法有显著不同。
重要区别在于,不使用一个大的共享哈希表,而是使用多个较小的表。每个进程独立处理自己的表,并独立处理包(与其他进程无关)。(然而,各个哈希表也位于共享内存中,因此任何进程都可以访问它们。)如果在规划阶段就清楚无法仅用一个包完成[^internal-ru-475-1],则每个进程会立即创建自己的哈希表。如果在执行阶段才决定,则会重建表[^internal-ru-475-2]。
因此,**在第一阶段**,进程并行读取内部集合的行,将其划分为包,并将这些包写入临时文件[^internal-ru-475-3]。由于每个进程仅读取内部集合的一部分行,没有任何一个进程会为任何一个包构建完整的哈希表(即使是第一个包也不行)。任何包的完整行集合仅在文件中汇集,所有并行进程同步写入该文件[^internal-ru-475-4]。因此,与非并行版本算法以及并行单阶段版本不同,本例中所有包(包括第一个)都会被写入磁盘。
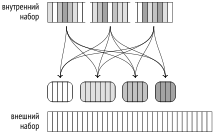
{#internal-ru-fig-22-8 num="22.8" caption="并行两阶段哈希连接" .book-original-figure width=428 height=267}
当所有进程完成内部集合的哈希处理后,开始 **第二阶段**[^internal-ru-476-1]。
在非并行版本的算法中,外部数据集的行(属于第一个数据包)会立即与哈希表进行匹配。但在并行版本中,哈希表尚未在内存中准备好,各进程独立处理数据包。因此,在第二阶段开始时,外部数据集的行被并行读取,分配到各个数据包中,每个数据包被写入自己的临时文件[^internal-ru-476-2]。读取的行不会进入哈希表(如第一阶段那样),因此无法增加数据包的数量。
当所有进程完成对外部数据集的读取后,磁盘上将存在 2*N* 个临时文件,分别包含内部和外部数据集的数据包。
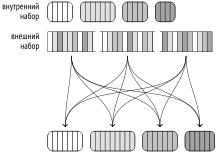
{#internal-ru-fig-22-9 num="22.9" caption="并行两阶段哈希连接" .book-original-figure width=434 height=307}
随后,每个进程选择一个数据包并执行连接:将内部数据集的行加载到内存中的哈希表,读取外部数据集的行,并与哈希表中的行进行匹配。处理完一个数据包后,进程选择下一个尚未处理的数据包[^internal-ru-476-3]。
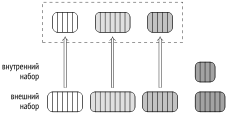
{#internal-ru-fig-22-10 num="22.10" caption="并行两阶段哈希连接" .book-original-figure width=454 height=228}
当未处理的数据包耗尽时,空闲的进程会连接到尚未完成的数据包的处理中,利用所有哈希表位于共享内存中的优势。
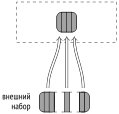
{#internal-ru-fig-22-11 num="22.11" caption="并行两阶段哈希连接" .book-original-figure width=237 height=228}
这种方案比所有进程共享一个大型哈希表更高效:更容易组织协作,减少同步所需的资源开销。
### 调整 {#internal-ru-subsection-star-327}
哈希连接算法不仅可用于内部连接,还可用于任何其他类型的连接:左外连接、右外连接和全外连接,以及半连接和反连接。然而,再次强调,连接条件仅支持相等比较。
部分操作我已在讨论嵌套循环连接时展示过。以下是一个 *右外连接* 的示例:(参见 [451](/zh18/21-nested-loop/#internal-ru-page-452))
```text {label="psql" hl_lines="6"}
=> EXPLAIN (costs off) SELECT *
FROM bookings b
LEFT OUTER JOIN tickets t ON t.book_ref = b.book_ref;
QUERY PLAN
----------------------------------------
Hash Right Join
Hash Cond: (t.book_ref = b.book_ref)
-> Seq Scan on tickets t
-> Hash
-> Seq Scan on bookings b
(5 rows)
```
请注意,SQL 查询中的逻辑左连接在执行计划中被转换为物理右连接。
在逻辑层面,外部表(位于连接操作左侧)是预订表(`bookings`),内部表是票务表(`tickets`)。因此,连接结果中应包含没有对应票务的预订记录。
在物理层面,外部和内部数据集的定义并非基于查询文本中的位置,而是基于连接成本。通常这意味着内部数据集是哈希表更小的那个。此处也是如此:预订表作为内部数据集,连接类型从左连接变为右连接。
反之,如果在查询中指定右外连接(希望输出未关联到预订的票务),则执行计划中的连接类型会变为左连接:
```text {label="psql" hl_lines="6"}
=> EXPLAIN (costs off) SELECT *
FROM bookings b
RIGHT OUTER JOIN tickets t ON t.book_ref = b.book_ref;
QUERY PLAN
----------------------------------------
Hash Left Join
Hash Cond: (t.book_ref = b.book_ref)
-> Seq Scan on tickets t
-> Hash
-> Seq Scan on bookings b
(5 rows)
```
为完整展示,以下是一个全外连接的执行计划示例:
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT *
FROM bookings b
FULL OUTER JOIN tickets t ON t.book_ref = b.book_ref;
QUERY PLAN
----------------------------------------
Hash Full Join
Hash Cond: (t.book_ref = b.book_ref)
-> Seq Scan on tickets t
-> Hash
-> Seq Scan on bookings b
(5 rows)
```
并行哈希连接支持所有类型的连接:不仅限于内部连接和左外连接,还包括右外连接和全外连接。在以下示例中,规划器优先选择右外连接,以构建更小的哈希表:(v. 16)
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT sum(b.total_amount)
FROM bookings b
LEFT OUTER JOIN tickets t ON t.book_ref = b.book_ref;
QUERY PLAN
------------------------------------------------------
Finalize Aggregate
-> Gather
Workers Planned: 2
-> Partial Aggregate
-> Parallel Hash Right Join
Hash Cond: (t.book_ref = b.book_ref)
-> Parallel Seq Scan on tickets t
-> Parallel Hash
-> Parallel Seq Scan on bookings b
(9 rows)
```
## 22.2. 非重复值与分组 {#internal-ru-section-22-2}
用于聚合的值分组和去重操作可以使用与连接算法类似的算法。一种方法是基于所需列构建哈希表。
仅当值尚未存在于哈希表中时,才将其放入哈希表。因此,最终哈希表中汇集了所有唯一值。
在执行计划中,负责哈希聚合的节点被标记为 HashAggregate[^internal-ru-480-1]。
以下是一些可能使用此类节点的示例场景。
每个服务等级的座位数量(`GROUP BY`):
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT fare_conditions, count(*)
FROM seats
GROUP BY fare_conditions;
QUERY PLAN
------------------------------
HashAggregate
Group Key: fare_conditions
-> Seq Scan on seats
(3 rows)
```
服务等级列表(`DISTINCT`):
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT DISTINCT fare_conditions
FROM seats;
QUERY PLAN
------------------------------
HashAggregate
Group Key: fare_conditions
-> Seq Scan on seats
(3 rows)
```
服务等级及其他值(`UNION`):
```text {label="psql"}
=> EXPLAIN (costs off) SELECT fare_conditions
FROM seats
UNION
SELECT NULL;
QUERY PLAN
------------------------------------
HashAggregate
Group Key: seats.fare_conditions
-> Append
-> Seq Scan on seats
-> Result
(5 rows)
```
节点 Append 对应两个行集的合并,但不会像 `UNION` 操作那样删除重复项。去重操作由 HashAggregate 节点单独完成。
分配给哈希表的内存受 *work\_mem* × *hash\_mem\_multiplier* 限制,与哈希连接情况相同。(默认值:`4MB`)(默认值:`2.0`)
如果哈希表能完全容纳在分配的内存中,聚合将在对行集的一次遍历中完成,如本例所示:
```text {label="psql" hl_lines="7"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT DISTINCT amount FROM ticket_flights;
QUERY PLAN
------------------------------------------------------------------
HashAggregate (actual rows=338.00 loops=1)
Group Key: amount
Batches: 1 Memory Usage: 56kB
-> Seq Scan on ticket_flights (actual rows=8391852.00 loops=1)
(4 rows)
```
成本值的唯一值不多,因此哈希表仅占用了 45 KB(内存使用量)。
一旦在构建哈希表过程中,新值无法再放入分配的内存空间,它们将被写入临时文件,并根据哈希值的若干位进行分区。分区数量为 2 的幂,由规划器选择,以确保每个分区的哈希表能完全放入内存。当然,这一估算依赖于统计信息的质量,因此计算值乘以 1.5,以进一步减小分区大小,提高每个分区能一次性处理的概率[^internal-ru-481-1]。(v. 13)
在读取完全部数据集后,节点返回那些进入哈希表的值的聚合结果。
随后,哈希表被清空,之前写入临时文件的每个分区将被读取并以与普通行集相同的方式处理。在极端情况下,某个分区的哈希表可能再次无法放入内存;此时,‘多余’的行将再次被分割为分区,并写入磁盘以供后续处理。
再看一个示例。此处唯一标识符的数量过大,无法将整个哈希表放入内存,因此计划使用四个分区:
```text {label="psql" hl_lines="7"}
=> SET hash_mem_multiplier = 1.1;
=> EXPLAIN
SELECT DISTINCT flight_id FROM ticket_flights;
QUERY PLAN
---------------------------------------------------------------------
HashAggregate (cost=174858.15..176000.70 rows=114255 width=4)
Group Key: flight_id
-> Seq Scan on ticket_flights (cost=0.00..153878.52 rows=8391...
(3 rows)
```
在查询执行过程中,共进行了五次迭代:一次处理初始数据集,另四次分别处理每个写入磁盘的分区。
```text {label="psql" hl_lines="7"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT DISTINCT flight_id FROM ticket_flights;
QUERY PLAN
------------------------------------------------------------------
HashAggregate (actual rows=150588.00 loops=1)
Group Key: flight_id
Batches: 5 Memory Usage: 4665kB Disk Usage: 71536kB
-> Seq Scan on ticket_flights (actual rows=8391852.00 loops=1)
(4 rows)
```
```text {label="psql"}
=> RESET hash_mem_multiplier;
```
在两阶段哈希连接算法中,最频繁的值被特殊处理,移动到第一个数据包,以避免不必要的输入/输出。对于聚合操作,这种优化并不需要,因为分区仅包含内存不足的行,而非所有行。频繁值有很大概率在行集早期就出现,从而及时占据内存空间。
[^internal-ru-458-1]: [backend/executor/nodeHashjoin.c]().
[^internal-ru-458-2]: [backend/executor/nodeHash.c]().
[^internal-ru-459-1]: [backend/utils/hash/dynahash.c]().
[^internal-ru-461-1]: [backend/executor/nodeHash.c](), 函数 ExecChooseHashTableSize.
[^internal-ru-462-1]: [backend/optimizer/plan/createplan.c](), 函数 create\_hashjoin\_plan.
[^internal-ru-462-2]: [backend/optimizer/path/costsize.c](), 函数 initial\_cost\_hashjoin 和 final\_cost\_hashjoin.
[^internal-ru-463-1]: [backend/utils/adt/selfuncs.c](), 函数 estimate\_hash\_bucket\_stats.
[^internal-ru-464-1]: [backend/executor/nodeHash.c](), 函数 ExecHashGetBucketAndBatch.
[^internal-ru-464-2]: [backend/executor/nodeHash.c](), 函数 ExecChooseHashTableSize.
[^internal-ru-465-1]: [backend/executor/nodeHash.c](), 函数 ExecHashTableInsert.
[^internal-ru-468-1]: [backend/executor/nodeHash.c](), 函数 ExecHashBuildSkewHash.
[^internal-ru-468-2]: [backend/executor/nodeHash.c](), 函数 ExecHashIncreaseNumBatches.
[^internal-ru-470-1]: [backend/optimizer/path/costsize.c](), 函数 page\_size.
[^internal-ru-473-1]: [backend/executor/nodeHash.c](), 函数 MultiExecParallelHash.
[^internal-ru-473-2]: [backend/storage/ipc/barrier.c]().
[^internal-ru-473-3]: [backend/executor/nodeHashjoin.c](), 函数 ExecParallelHashJoin.
[^internal-ru-475-1]: [backend/executor/nodeHash.c](), 函数 ExecChooseHashTableSize.
[^internal-ru-475-2]: [backend/executor/nodeHash.c](), 函数 ExecParallelHashIncreaseNumBatches.
[^internal-ru-475-3]: [backend/executor/nodeHash.c](), 函数 MultiExecParallelHash.
[^internal-ru-475-4]: [backend/utils/sort/sharedtuplestore.c]().
[^internal-ru-476-1]: [backend/executor/nodeHashjoin.c](), 函数 ExecParallelHashJoin.
[^internal-ru-476-2]: [backend/executor/nodeHashjoin.c](), 函数 ExecParallelHashJoinPartitionOuter.
[^internal-ru-476-3]: [backend/executor/nodeHashjoin.c](), 函数 ExecParallelHashJoinNewBatch.
[^internal-ru-480-1]: [backend/executor/nodeAgg.c]().
[^internal-ru-481-1]: [backend/executor/nodeAgg.c](), 函数 hash\_choose\_num\_partitions.