跳转到主要内容

19 索引访问方法

PostgreSQL 18 · 基于俄文 PG18 原版的简体中文译本

19.1. 索引和可扩展性

索引是数据库对象,主要用于加速数据访问。它们是辅助结构:任何索引都可以删除并根据表中的信息重新创建。但除了加速之外,索引还用于支持某些完整性约束。

内核中内置了六种索引访问方法(索引类型):(psql: \dA)

=> SELECT amname FROM pg_am WHERE amtype = 'i';
 amname
--------
 btree
 hash
 gist
 gin
 spgist
 brin
(6 rows)

遵循可扩展性理念,允许在不修改内核的情况下添加新的访问方法。一个这样的示例(方法 bloom)已包含在标准扩展集合中。

尽管各种索引类型存在诸多差异,但最终任何索引都会建立键(例如,被索引列的值)与包含该键的表行版本之间的对应关系。引用使用六字节的 行版本标识符(tuple id, tid)。已知键或其部分信息后,可以快速读取可能包含所需信息的行版本,而无需完全扫描整个表。(参见 428)

为了使新访问方法能够作为扩展添加,已预留通用的 索引机制。其主要任务是获取访问方法的行版本标识符并对其进行处理:

  • 从相应的表行版本中读取数据;

  • 检查行版本在数据快照中的可见性;(参见 97)

  • 如果访问方法不保证条件成立,则重新验证条件。

索引机制参与执行优化阶段生成的执行计划。优化器在遍历和评估各种查询执行路径时,必须了解所有潜在适用的访问方法的特性:该方法是否能直接按所需顺序返回数据,还是需要额外排序?是否能返回前几个值,还是只能一次性返回全部结果?等等。

访问方法的信息不仅对优化器有用。创建索引时,必须决定:该方法是否支持复合索引?该索引能否保证唯一性?

索引机制允许与各种不同的访问方法协同工作;为此,访问方法必须实现特定接口,并声明其功能和特性。

访问方法的任务包括:

  • 实现索引构建、行插入和删除的算法;

  • 将索引数据组织到页面上(以便与缓冲区缓存管理器协作);(参见 183)

  • 实现清理算法;(参见 125)

  • 设置锁以确保正确并发执行;(参见 305)

  • 生成预写日志;(参见 211)

  • 根据键在索引中查找信息;

  • 评估使用索引的成本。

可扩展性还体现在系统可以添加新的数据类型,而访问方法事先对此一无所知。因此,访问方法需定义自己的接口以连接任意数据类型。

为了使特定类型值能与特定访问方法一起使用,必须实现该接口,提供适用于索引的运算符,以及可能的一些辅助 支持 函数。此类运算符和函数的集合称为 运算符类。

此时,索引逻辑的一部分位于访问方法本身,另一部分则被移至运算符类。这种划分相当随意:对于 B-树,所有逻辑都“固化”在访问方法中,而某些方法可能仅提供基本框架,将所有关键细节交由特定运算符类处理。在许多情况下,同一数据类型存在多个行为不同的运算符类,用户可从中选择最合适的。

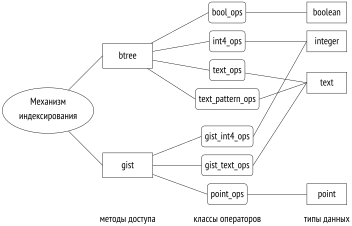
图中展示了整体结构的一个小片段:

索引与可扩展性:bool\_opsboolean; int4\_opsinteger; btree; text\_ops; text; text\_pattern\_ops; 机制; 索引化; gist\_int4\_ops; gistgist\_text\_ops; point\_opspoint; 访问方法; 运算符类; 数据类型
图 19.1 索引与可扩展性

19.2. 操作符类和操作符族

操作符类

访问方法接口 1 由 运算符类 2 实现——一组运算符和辅助函数,供访问方法用于处理特定数据类型。

运算符类存储在系统目录的 pg_opclass 表中。上图的完整数据可通过以下查询获得:(psql: \dAc)

=> SELECT amname, opcname, opcintype::regtype
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid;
 amname |           opcname            |          opcintype
--------+------------------------------+-----------------------------
 btree  | array_ops                    | anyarray
 hash   | array_ops                    | anyarray
 btree  | bit_ops                      | bit
 btree  | bool_ops                     | boolean
 ...
 brin   | pg_lsn_minmax_multi_ops      | pg_lsn
 brin   | pg_lsn_bloom_ops             | pg_lsn
 brin   | box_inclusion_ops            | box
(177 rows)

大多数情况下,我们无需了解运算符类的细节。通常只需创建索引,系统会自动使用默认的运算符类。

例如,以下是 B-树和 text 类型的运算符类。其中至少有一个类被标记为默认使用:

=> SELECT opcname, opcdefault
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'btree'
  AND opcintype = 'text'::regtype;
       opcname       | opcdefault
---------------------+------------
 text_ops            | t
 varchar_ops         | f
 text_pattern_ops    | f
 varchar_pattern_ops | f
(4 rows)

常见的创建索引命令如下所示:

CREATE INDEX ON aircrafts_data(model, range);

但这只是完整形式的简写:

CREATE INDEX ON aircrafts_data
USING btree -- метод доступа по умолчанию
(
  model text_ops, -- класс операторов по умолчанию для text
  range int4_ops  -- класс операторов по умолчанию для integer
);

如果需要其他类型的索引或非标准行为,必须显式指定所需的访问方法或运算符类。

为特定访问方法和特定数据类型创建的运算符类,必须包含一组接受该类型参数且语义符合该访问方法要求的运算符。

例如,btree 访问方法定义了五个必需的比较运算符。任何为此方法创建的运算符类都必须包含全部五个:(psql: \dAo)

=> SELECT opcname, amopstrategy, amopopr::regoperator
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
WHERE amname = 'btree'
  AND opcname IN ('text_ops', 'text_pattern_ops')
  AND amoplefttype = 'text'::regtype
  AND amoprighttype = 'text'::regtype
ORDER BY opcname, amopstrategy;
     opcname      | amopstrategy |     amopopr
------------------+--------------+-----------------
 text_ops         |            1 | <(text,text)
 text_ops         |            2 | <=(text,text)
 text_ops         |            3 | =(text,text)
 text_ops         |            4 | >=(text,text)
 text_ops         |            5 | >(text,text)
 text_pattern_ops |            1 | ~<~(text,text)
 text_pattern_ops |            2 | ~<=~(text,text)
 text_pattern_ops |            3 | =(text,text)
 text_pattern_ops |            4 | ~>=~(text,text)
 text_pattern_ops |            5 | ~>~(text,text)
(10 rows)

访问方法所隐含的运算符语义反映在 amopstrategy 的策略编号 3 中。例如,对于 btree,策略 1 表示“小于”,2 表示“小于或等于”,依此类推。这些运算符本身可以具有任意名称。

在上述示例中,普通运算符与带波浪号的运算符的区别在于,后者不考虑 排序规则(collation) 4,而是逐字节比较字符串。尽管如此,两者都实现了相同的比较语义。

运算符类 text_pattern_ops 可以克服对 ~~ 运算符(对应 LIKE 语法)支持的限制。在非 C 排序规则的数据库中,该运算符无法使用普通文本列索引:

=> SELECT datcollate FROM pg_database
WHERE datname = current_database();
 datcollate
-------------
 en_US.UTF-8
(1 row)
=> CREATE INDEX ON tickets(passenger_name);
=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE passenger_name LIKE 'ELENA%';
                  QUERY PLAN
----------------------------------------------
 Seq Scan on tickets
   Filter: (passenger_name ~~ 'ELENA%'::text)
(2 rows)

而使用 text_pattern_ops 运算符类的索引则不同:

=> CREATE INDEX tickets_passenger_name_pattern_idx
ON tickets(passenger_name text_pattern_ops);
=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE passenger_name LIKE 'ELENA%';
                          QUERY PLAN
--------------------------------------------------------------
 Bitmap Heap Scan on tickets
   Filter: (passenger_name ~~ 'ELENA%'::text)
   -> Bitmap Index Scan on tickets_passenger_name_pattern_idx
       Index Cond: ((passenger_name ~>=~ 'ELENA'::text) AND
       (passenger_name ~<~ 'ELENB'::text))
(5 rows)

请注意索引条件中表达式的改变:搜索仅使用模式前缀(直到 % 字符),多余匹配项在过滤条件中被排除。btree 访问方法的运算符类不包含模式比较运算符,因此唯一使用 B-树的方法是将条件重写为比较运算符。text_pattern_ops 类的运算符不考虑排序规则,从而允许将条件替换为等效形式5。

索引可用于加速满足以下条件的访问:

  1. 该条件形式为「索引列 运算符 表达式」(若指定了可交换运算符6,则也允许「表达式 运算符 索引列」)7

  2. 且该 运算符 属于创建索引时为 索引列 指定的运算符类。

例如,以下查询可以使用索引:

=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE 'ELENA BELOVA' = passenger_name;
                       QUERY PLAN
--------------------------------------------------------
 Index Scan using tickets_passenger_name_idx on tickets
   Index Cond: (passenger_name = 'ELENA BELOVA'::text)
(2 rows)

请注意索引条件中参数的顺序发生了变化:执行阶段,索引列必须作为运算符的左操作数。若交换操作数,系统会替换为可交换运算符;在此例中,由于等号关系是可交换的,因此是同一个运算符。

而下一个查询根本无法使用普通索引,因为条件中不是列名,而是函数调用:

=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE initcap(passenger_name) = 'Elena Belova';
                         QUERY PLAN
------------------------------------------------------------
 Seq Scan on tickets
   Filter: (initcap(passenger_name) = 'Elena Belova'::text)
(2 rows)

此时可使用 表达式索引 8,在创建时指定任意表达式而非列:

=> CREATE INDEX ON tickets( (initcap(passenger_name)) );
=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE initcap(passenger_name) = 'Elena Belova';
                             QUERY PLAN
--------------------------------------------------------------------
 Bitmap Heap Scan on tickets
   Recheck Cond: (initcap(passenger_name) = 'Elena Belova'::text)
   -> Bitmap Index Scan on tickets_initcap_idx
       Index Cond: (initcap(passenger_name) = 'Elena Belova'::text)
(4 rows)

表达式只能依赖于表行中的字段值,不能依赖于数据库中的其他数据状态或配置(例如本地化设置)。换句话说,如果表达式包含函数调用,则这些函数必须具有并 遵守 IMMUTABLE 9 变异性类别。否则,使用索引访问执行的查询结果可能与全表扫描的结果不同。

除了运算符外,运算符类还可提供 支持函数 10,供访问方法使用。例如,btree 访问方法定义了五个支持函数11,其中仅第一个(用于比较两个值)是必需的,其余可省略:(psql: \dAp)

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
  JOIN pg_amproc amproc ON amprocfamily = opcfamily
WHERE amname = 'btree'
  AND opcname = 'text_ops'
  AND amproclefttype = 'text'::regtype
  AND amprocrighttype = 'text'::regtype
ORDER BY amprocnum;
 amprocnum |       amproc
-----------+--------------------
         1 | bttextcmp
         2 | bttextsortsupport
         4 | btvarstrequalimage
(3 rows)

操作符族

操作符类始终属于某个 操作符族 12(系统目录表 pg_opfamily)。在同一个通用族中可以包含多个操作符类,只要它们对相似的数据类型以相同的方式工作。

例如,integer_ops 族包含多个用于不同大小但语义相同的数值类型的操作符类:(psql: \dAf)

=> SELECT opcname, opcintype::regtype
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
WHERE amname = 'btree'
  AND opfname = 'integer_ops';
 opcname  | opcintype
----------+-----------
 int2_ops | smallint
 int4_ops | integer
 int8_ops | bigint
(3 rows)

而 datetime_ops 族则包含用于处理日期的操作符类:

=> SELECT opcname, opcintype::regtype
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
WHERE amname = 'btree'
  AND opfname = 'datetime_ops';
     opcname     |          opcintype
-----------------+-----------------------------
 date_ops        | date
 timestamptz_ops | timestamp with time zone
 timestamp_ops   | timestamp without time zone
(3 rows)

每个操作符类仅针对某个单一数据类型工作。而族则包含可接受不同数据类型的操作符:

=> SELECT opcname, amopopr::regoperator
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
WHERE amname = 'btree'
  AND opfname = 'integer_ops'
  AND amoplefttype = 'integer'::regtype
  AND amopstrategy = 1
ORDER BY opcname;
 opcname  |       amopopr
----------+---------------------
 int2_ops | <(integer,bigint)
 int2_ops | <(integer,smallint)
 int2_ops | <(integer,integer)
 int4_ops | <(integer,bigint)
 int4_ops | <(integer,smallint)
 int4_ops | <(integer,integer)
 int8_ops | <(integer,bigint)
 int8_ops | <(integer,smallint)
 int8_ops | <(integer,integer)
(9 rows)

通过将操作符分组到族中,规划器可以使用索引处理涉及不同数据类型值的条件,而无需显式转换。

19.3. 索引引擎接口

与表访问方法类似,pg_am 表中的 amhandler 列包含实现接口的函数名称 13:

=> SELECT amname, amhandler FROM pg_am WHERE amtype = 'i';
 amname |  amhandler
--------+-------------
 btree  | bthandler
 hash   | hashhandler
 gist   | gisthandler
 gin    | ginhandler
 spgist | spghandler
 brin   | brinhandler
(6 rows)

该函数用必要的值填充接口结构 14。所提供的信息部分包括执行索引扫描并返回行版本标识符等通用操作的函数,另一部分则是索引方法应知晓的属性。

所有属性分为三个级别 15:

  • 访问方法属性;

  • 具体索引属性;

  • 索引中各个列的属性。

划分访问方法级别和索引级别是为了未来扩展:目前,基于同一访问方法创建的所有索引始终具有相同的这两个级别的属性。

访问方法属性

访问方法属性包括以下五项(以 B-树为例):

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'btree';
 amname |     name      | pg_indexam_has_property
--------+---------------+-------------------------
 btree  | can_order     | t
 btree  | can_unique    | t
 btree  | can_multi_col | t
 btree  | can_exclude   | t
 btree  | can_include   | t
(5 rows)

CAN ORDER 支持直接获取排序后的数据 16。目前仅 B-树支持此属性。

为了获得所需顺序的结果,始终可以扫描表并排序获取的数据:

=> EXPLAIN (costs off)
SELECT * FROM seats ORDER BY seat_no;
       QUERY PLAN
------------------------
 Sort
   Sort Key: seat_no
   -> Seq Scan on seats
(3 rows)

但若存在支持此属性的索引,则可直接按所需顺序获取数据:

=> EXPLAIN (costs off)
SELECT * FROM seats ORDER BY aircraft_code;
              QUERY PLAN
--------------------------------------
 Index Scan using seats_pkey on seats
(1 row)

CAN UNIQUE 支持唯一性约束和主键约束 17。仅适用于 B-树。

声明唯一性或主键约束时,会自动创建支持该完整性约束的唯一索引。

=> INSERT INTO bookings(book_ref, book_date, total_amount)
VALUES ('000004', now(), 100.00);
ERROR:  duplicate key value violates unique constraint
"bookings_pkey"
DETAIL:  Key (book_ref)=(000004) already exists.

另一方面,如果不显式声明完整性约束,但创建了唯一索引,其可见效果相同:该列将不允许存在重复值。两者有何区别?

完整性约束是必须满足的属性声明,而索引是实现该属性的机制。原则上,完整性约束也可通过其他手段保证。

例如,PostgreSQL 不允许在分区表上创建全局索引,但仍允许声明唯一键(如果该键包含分区键)。此时,全局唯一性由每个分区上的局部唯一索引以及两个分区中无法存在相同分区键值的事实共同保证。

CAN MULTI COL 支持基于多个列构建 复合索引 18。

复合索引可加速对表中多个列的不同条件的查询。例如,ticket_flights 表具有复合主键,因此也具有索引:

=> \d ticket_flights_pkey
     Index "bookings.ticket_flights_pkey"
  Column   |     Type      | Key? | Definition
-----------+---------------+------+------------
 ticket_no | character(13) | yes  | ticket_no
 flight_id | integer       | yes  | flight_id
primary key, btree, for table "bookings.ticket_flights"

通过该索引执行按机票编号和航班标识符查询航班:

=> EXPLAIN (costs off)
SELECT * FROM ticket_flights
WHERE ticket_no = '0005432001355' AND flight_id = 51618;
                        QUERY PLAN
----------------------------------------------------------
 Index Scan using ticket_flights_pkey on ticket_flights
   Index Cond: ((ticket_no = '0005432001355'::bpchar) AND
   (flight_id = 51618))
(3 rows)

对于 B-树,搜索的可行性和效率取决于索引中列的顺序。对于其他类型的索引,情况可能并非如此。(参见 536)(参见 628)

CAN EXCLUDE 支持 EXCLUDE 排除约束 19。

排除约束确保由操作符定义的条件在表中任意两行之间均不成立。为验证该约束,会自动创建索引;访问方法的操作符类必须包含所选操作符。

通常使用「交集」操作符 &&。例如,可声明性地定义:同一时间不能重复预订同一房间,或地图上的建筑不能相互重叠。(参见 571)

使用「等于」操作符时,排除约束等价于唯一性约束:禁止表中存在具有相同键列值的两行。但这与唯一性约束并不相同:例如,排除约束的键不能作为外键引用,也不能在 ON CONFLICT 子句中使用。

CAN INCLUDE 支持将非索引键列添加到索引中,以创建覆盖索引。(参见 425)

例如,可以向唯一索引中添加额外列。此类索引将保证键列值的唯一性,同时允许在不访问表的情况下获取额外列的值:

=> CREATE UNIQUE INDEX ON flights(flight_id) INCLUDE (status);
=> EXPLAIN (costs off)
SELECT status FROM flights WHERE flight_id = 51618;
                          QUERY PLAN
---------------------------------------------------------------
 Index Only Scan using flights_flight_id_status_idx on flights
   Index Cond: (flight_id = 51618)
(2 rows)

实际上属性远不止这些,但许多属性在 SQL 层级不可见 20。以下是一些示例:

CAN PRED LOCKS 支持谓词锁。(参见 298)

spgist 和 brin 访问方法不支持此属性;在可串行化隔离级别下扫描此类索引时,谓词锁将作用于整个表,如同顺序扫描一样,从而降低性能。

CAN BUILD PARALLEL 支持通过多个进程并行构建索引。btree、brin(v. 17)和 gin(v. 18)访问方法支持此属性。

索引级属性

与索引相关的属性(以现有索引为例):

=>  SELECT p.name, pg_index_has_property('seats_pkey', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
---------------+-----------------------
 clusterable   | t
 index_scan    | t
 bitmap_scan   | t
 backward_scan | t
(4 rows)

CLUSTERABLE 支持根据索引在索引扫描中返回的行版本标识符顺序,物理移动表中行版本。 (参见 361)

该属性决定了 CLUSTER 命令是否适用。

INDEX SCAN 支持 索引扫描。(参见 414)

该属性表示访问方法能够逐个返回行版本标识符。虽然看似奇怪,但并非所有索引都支持此属性。

BITMAP SCAN 支持 位图扫描。(参见 427)

该属性表示访问方法能够一次性构建并返回所有行版本标识符的位图。

BACKWARD SCAN 支持以与创建索引时指定顺序相反的顺序返回结果。

此属性仅在访问方法支持索引扫描时才相关。

列级属性

最后是列的属性:

=> SELECT p.name,
  pg_index_column_has_property('seats_pkey', 1, p.name)
FROM unnest(array[
  'asc', 'desc', 'nulls_first', 'nulls_last', 'orderable',
  'distance_orderable', 'returnable', 'search_array', 'search_nulls'
]) p(name);
        name        | pg_index_column_has_property
--------------------+------------------------------
 asc                | t
 desc               | f
 nulls_first        | f
 nulls_last         | t
 orderable          | t
 distance_orderable | f
 returnable         | t
 search_array       | t
 search_nulls       | t
(9 rows)

ASC, DESC, NULLS FIRST, NULLS LAST 列值的排序方式。

这些属性定义了值的存储顺序(升序或降序)以及空值的位置(在普通值之前或之后)。该组中的所有属性仅适用于 B-树。(参见 350)

ORDERABLE 支持在 ORDER BY 子句中对列值进行排序。

此属性仅适用于 B-树。

DISTANCE ORDERABLE 支持 排序操作符21。(参见:410)

与返回布尔值的普通索引操作符不同,排序操作符返回一个实数——即一个参数到另一个参数的“距离”。索引支持在 ORDER BY 子句中使用此类操作符。

例如,使用排序操作符 <-> 可以查找距离指定点最近的机场:

=> CREATE INDEX ON airports_data USING gist(coordinates);
=> EXPLAIN (costs off)
SELECT * FROM airports
ORDER BY coordinates <-> point (43.578,57.593)
LIMIT 3;
                           QUERY PLAN
-----------------------------------------------------------------
 Limit
   -> Index Scan using airports_data_coordinates_idx on airpo...
       Order By: (coordinates <-> '(43.578,57.593)'::point)
(3 rows)

RETURNABLE 无需访问表即可从索引中获取数据,即支持 仅索引扫描。(参见:422)

该属性定义索引结构是否能够恢复被索引的值。这并非总是可行;例如,某些索引可能存储的不是实际值,而是其哈希值。在这种情况下,CAN INCLUDE 属性也无法生效。

SEARCH ARRAY 支持对数组中多个值的搜索。

这种需求不仅出现在直接使用数组时。例如,查询规划器会将 IN (список) 结构转换为数组搜索:(另见:554;编辑器添加的链接)

=> EXPLAIN (costs off)
SELECT * FROM bookings
WHERE book_ref IN ('C7C821', 'A5D060', 'DDE1BB');
                 QUERY PLAN
--------------------------------------------
 Index Scan using bookings_pkey on bookings
   Index Cond: (book_ref = ANY
   ('{C7C821,A5D060,DDE1BB}'::bpchar[]))
(3 rows)

如果索引方法不支持此类操作符,则执行计划时需要多次迭代来查找单个值(这可能影响效率)。

SEARCH NULLS 支持对 IS NULL 和 IS NOT NULL 条件的搜索。

是否应索引空值?这使得可以使用索引处理 IS [NOT] NULL 条件,也可作为无任何表条件时的覆盖索引(因为此时索引必须返回表中所有行的数据,包括空值)。但若不包含空值,索引可能更紧凑。 NULL

该决定由访问方法的开发者做出,但通常仍会索引空值。

如果索引中不需要空值,可以通过构建 部分索引 22 仅对感兴趣的表行进行索引。例如:

=> CREATE INDEX ON flights(actual_arrival)
WHERE actual_arrival IS NOT NULL;
CREATE INDEX
=> EXPLAIN (costs off)
SELECT * FROM flights
WHERE actual_arrival = '2017-06-13 10:33:00+03';
                           QUERY PLAN
-----------------------------------------------------------------
 Index Scan using flights_actual_arrival_idx on flights
   Index Cond: (actual_arrival = '2017-06-13 10:33:00+03'::ti...
(2 rows)
部分索引在大小上小于完整索引,且在不包含在索引中的行被修改时不会更新。在某些情况下,这可能带来显著性能提升。当然,WHERE 子句中的条件可以是任意满足 IMMUTABLE 变更性类别要求的表达式,而不仅限于空值检查。

部分索引的构建与访问方法无关,由索引机制本身提供支持。

显然,并非所有索引访问方法的功能都通过接口暴露,仅包括那些需要预先知晓以做出正确决策的功能。例如,没有属性反映是否支持非阻塞创建索引(CONCURRENTLY)。此类属性由实现接口的函数代码决定。