# 查询执行的各个阶段
LLMS 索引: [llms.txt](/zh18/llms.txt)
---
## 16.1. 示例数据库 {#internal-ru-section-16-1}
在本书的前几部分中,我们使用的是包含少量行的简单表。本节及接下来的部分将讨论查询执行,我们需要使用具有大量行的相互关联的表。为了避免为每个示例创建自己的数据集,我直接使用了一个现成的航空运输演示数据库[^internal-ru-320-1]。该演示数据库有多个版本;我使用的是2017年8月15日的大型版本。要安装它,需要解压数据库副本文件[^internal-ru-320-2],并在psql中执行该文件。
在开发演示数据库时,我们力求使数据模式足够简单,以便无需额外说明即可理解,但同时又足够复杂,以支持有意义的查询。数据库中填充了现实的数据,这有助于理解示例,并使操作更具趣味性。
下面我将简要描述演示数据库中的主要对象,完整描述请参见脚注中的链接。
核心实体是**预订**(表`bookings`)。一个预订可以包含多个乘客,每个乘客会获得一张电子**机票**(`tickets`)。乘客本身不是独立实体;我们将假设所有乘客都是唯一的。
每张机票包含一个或多个**航班**(`ticket_flights`)。当执行中转航班或购买往返票时,可能会出现多个航班。数据模式中没有强制约束,但假设同一预订中的所有机票具有相同的航班集合。
每个**航班**(`flights`)从一个**机场**(`airports`)出发,飞往另一个机场。相同航班号的航班具有相同的出发地和目的地,但出发日期不同。
视图`routes`从航班表中提取与具体航班日期无关的**航线**信息。
乘客登机时会获得一张**登机牌**(`boarding_passes`),其中标明了飞机上的座位号。乘客只能为机票中包含的航班办理登机手续。航班与座位号的组合必须唯一,以防止为同一座位发放两张登机牌。
飞机上的**座位数**(`seats`)及其在不同服务等级中的分布取决于执行航班的特定**飞机型号**(`aircrafts`)。假设每种型号仅有一种客舱布局。
某些表使用代理主键,而另一些表使用自然键(其中一些是复合键)。这是出于演示目的而特意设计的,并不建议作为模仿范例。
该演示数据库可视为真实系统的备份:它包含某个特定时刻的最新数据。该时刻的时间保存在函数`bookings.now`中。在查询中,当现实中需要使用`now`函数时,可以使用该函数。
机场、城市和飞机型号的名称存储在`airports_data`和`aircrafts_data`表中,包含俄语和英语两种语言。在查询中通常使用ER图中所示的视图`airports`和`aircrafts`。这些视图根据`bookings.lang`参数选择的语言提供翻译。但基础表名可能出现在查询执行计划中。(*默认值:* `ru`)
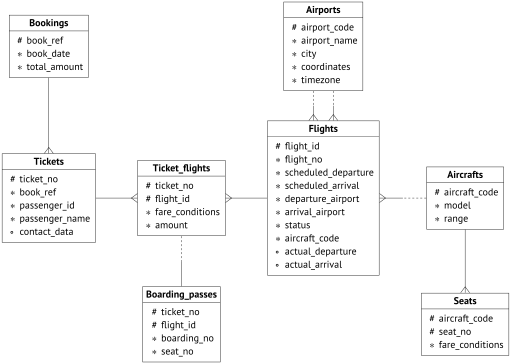
{#internal-ru-fig-16-1 num="16.1" caption="演示数据库" .book-original-figure width=1021 height=728}
## 16.2. 简单查询协议 {#internal-ru-section-16-2}
PostgreSQL的简单客户端-服务器协议[^internal-ru-323-1]允许向服务器发送SQL查询文本,并接收全部结果行,无论结果有多少行[^internal-ru-323-2]。传入服务器的查询会经历多个阶段:解析、重写、规划,最终执行。
### 解析 {#internal-ru-subsection-star-194}
首先,必须对查询文本进行*解析*[^internal-ru-323-3](parse),以明确需要执行什么操作。
**词法和语法解析。** *词法分析器*将查询文本分解为*词法单元*[^internal-ru-323-4](如关键字、字符串和数值字面量),而*语法分析器*则验证这些词法单元是否符合语言的语法规则[^internal-ru-323-5]。PostgreSQL使用标准工具(Flex和Bison)进行解析。
解析后的查询在服务进程的内存中以抽象语法树的形式表示。
以以下查询为例:
```sql
SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;
```
词法分析器将识别出五个关键字、五个标识符、一个字符串字面量和三个单字符词法单元(用于逗号、等号和分号)。语法分析器将这些词法单元构造成一棵树,如图所示,但以高度简化的方式呈现。树中各节点旁标注了与之对应的查询部分:
`SELECT`
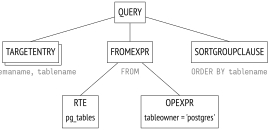
{#internal-ru-fig-16-2 num="16.2" caption="解析" .book-original-figure width=539 height=261}
`pg_table WHERE tableowner = 'postgres'`
RTE是Range Table Entry的非显式缩写。在PostgreSQL源代码中,*范围表*(range table)指代表、子查询、连接结果等——换句话说,即SQL操作所处理的*行集*[^internal-ru-324-1]。
**语义解析。** *语义分析*[^internal-ru-324-2]的任务是确定数据库中是否存在查询所引用的表及其他对象,并确认用户是否有权访问这些对象。语义分析所需的所有信息均存储在系统目录中。(参见[24](/zh18/01-introduction/#internal-ru-page-25))
语义分析器从语法分析器接收解析树,并对其进行重构,补充对数据库中具体对象的引用、数据类型信息及其他相关信息。
通过解析生成的完整树可以在服务器日志中获取,只需设置参数*debug\_print\_parse*,尽管这在实际中意义不大。
### 转换 {#internal-ru-subsection-star-200}
接下来,查询可以被*转换*(*重写*)[^internal-ru-325-1]。
转换由内核用于多种目的。其中一个用途是将解析树中的视图名称替换为对应视图查询的子树。
内核系统另一个使用转换的示例是实现行级访问控制[^internal-ru-325-2](row-level security)。
在转换阶段,还会对递归查询的`SEARCH`和`CYCLE`子句进行转换[^internal-ru-325-3]。(v. 14)
在上述示例中,`pg_tables`是一个视图;将它的定义代入查询文本后,我们得到:
```sql
SELECT schemaname, tablename
FROM (
-- pg_tables
SELECT n.nspname AS schemaname,
c.relname AS tablename,
pg_get_userbyid(c.relowner) AS tableowner,
...
FROM pg_class c
LEFT JOIN pg_namespace n ON n.oid = c.relnamespace
LEFT JOIN pg_tablespace t ON t.oid = c.reltablespace
WHERE c.relkind = ANY (ARRAY['r'::char, 'p'::char])
)
WHERE tableowner = 'postgres'
ORDER BY tablename;
```
实际上,服务器并不处理文本表示,而是在解析树上执行所有操作。其在转换阶段后的状态如图所示,以简化形式呈现(完整树可通过设置参数*debug\_print\_rewritten*在日志中获取)。
解析树反映了查询的语法结构,但并未说明操作的执行顺序。
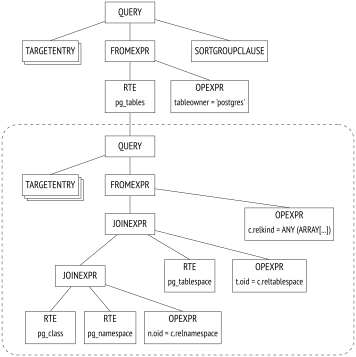
{#internal-ru-fig-16-3 num="16.3" caption="转换" .book-original-figure width=712 height=714}
PostgreSQL允许用户编写自己的转换规则。这通过*重写规则系统*[^internal-ru-326-1](rules)实现。
> [!NOTE]
> 规则支持曾被列为[^internal-ru-326-2]Postgres开发的目标之一,因此规则在大学项目阶段就已存在,并在之后多次被重新审视。这是一个功能强大但调试和理解都较复杂的机制。甚至曾有提议从PostgreSQL中移除规则,但未获得广泛支持。在大多数情况下,使用触发器比规则更方便且更安全。
### 规划 {#internal-ru-subsection-star-202}
SQL是一种声明式语言:查询定义了*需要获取哪些数据*,但并未说明*如何获取*。
任何查询都可以通过多种方式执行。对于解析树中表示的每种操作,都可能存在多种实现方式:例如,可以从表中读取全部数据(然后丢弃不需要的部分),也可以使用索引查找匹配的行。行集始终成对连接,这导致了大量不同的执行顺序。此外,还存在不同的连接算法:例如,可以遍历一个行集的每一行,并在第二个行集中查找匹配项,也可以预先对两个行集排序,然后合并它们。某些算法在某些场景下表现更好,而另一些则在其他场景下更优。
非最优计划与最优计划之间的执行时间差异可能达到多个数量级,因此*规划器*[^internal-ru-327-1](负责*优化*解析后的查询)是系统中最复杂的组件之一。
**计划树。** 查询执行计划也以树的形式表示,但其节点包含的是对数据的实际物理操作。
出于研究目的,可通过设置参数*debug\_print\_plan*在服务器日志中获取完整的计划树。在实际应用中,命令`EXPLAIN`[^internal-ru-327-2]会输出计划的文本表示。
图中突出显示了计划树的主要节点。这些节点正是`EXPLAIN`命令输出中所展示的内容。
计划中的Seq Scan节点对应表扫描,而Nested Loop节点对应连接操作。(参见[374](/zh18/18-table-access-methods/#internal-ru-page-375))(参见[440](/zh18/21-nested-loop/#internal-ru-page-441))
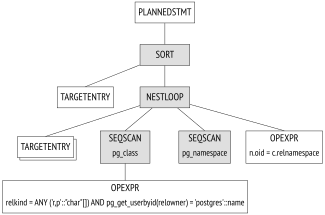
{#internal-ru-fig-16-4 num="16.4" caption="规划" .book-original-figure width=649 height=431}
```text {label="psql" hl_lines="7 9 11 13"}
=> EXPLAIN SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;
QUERY PLAN
---------------------------------------------------------------------
Sort (cost=22.91..22.92 rows=1 width=128)
Sort Key: c.relname
-> Nested Loop Left Join (cost=0.00..22.90 rows=1 width=128)
Join Filter: (n.oid = c.relnamespace)
-> Seq Scan on pg_class c (cost=0.00..21.79 rows=1 width=72)
Filter: ((relkind = ANY ('{r,p}'::"char"[])) AND (pg_g...
-> Seq Scan on pg_namespace n (cost=0.00..1.05 rows=5 wid...
(7 rows)
```
目前请注意以下两点:
- 查询树中仅保留了三张表中的两张:规划器识别出其中一张表对结果无用,因此可从计划树中移除;
- 每个计划节点都包含预计生成行数(rows)和成本(cost)的信息。
**计划遍历。** PostgreSQL 使用 *基于成本的优化器*[^internal-ru-329-1]。优化器会考虑所有可能的执行计划,并评估执行这些计划所需资源的预期数量(如 I/O 操作和 CPU 周期)。优化器评估结果以数值形式表示,称为 *计划成本*。在所有检查过的计划中,选择成本最低的计划。
问题在于,可能的计划数量随连接表的数量呈指数级增长,即使对于相对简单的查询,逐一遍历所有选项也是不现实的。为了缩小搜索空间,传统上采用动态规划算法结合某些启发式方法。这使得在合理时间内找到数学上精确解的查询表数量得以增加。
> [!NOTE]
> 优化问题的精确解并不能保证所找到的计划 *实际上* 是最优的,因为规划器使用的是简化的数学模型,且可能基于不完全准确的输入信息进行决策。
遗憾的是,即使动态规划算法在连接数量超过十时也耗时过长且内存消耗过大。为了进一步限制搜索范围,规划器可能会根据查询的语法结构固定某些连接的顺序[^internal-ru-329-2]。
考虑一个在 `FROM` 子句中通过逗号列出表而未显式使用 `JOIN` 的查询:
```sql
SELECT ...
FROM a, b, c, d, e
WHERE ...
```
对于此类查询,规划器将考虑所有可能的两两连接组合。该查询对应如下(示意性展示)的解析树片段:
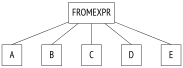
{#internal-ru-fig-16-5 num="16.5" caption="计划" .book-original-figure width=367 height=135}
下图展示了此类查询计划所需内存随表数量变化的关系(数据通过 `EXPLAIN` 命令并使用 `MEMORY` 参数获得):(v. 17)
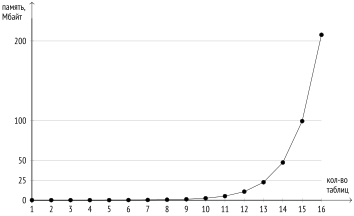
{#internal-ru-fig-16-6 num="16.6" caption="计划" .book-original-figure width=708 height=432}
计划时间也大致随着每增加一张表而翻倍。
在另一个例子中,连接结构由 `JOIN` 子句定义:
```sql
SELECT ...
FROM a,
b JOIN c ON ...,
d,
e
WHERE ...
```
解析树反映了这种结构:
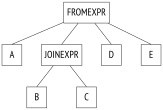
{#internal-ru-fig-16-7 num="16.7" caption="计划" .book-original-figure width=327 height=220}
通常,规划器会将连接树扁平化,将其转换为与第一个示例相同的形式。该算法递归遍历树,将 `joinexpr` 节点替换为下层元素的扁平列表[^internal-ru-331-1]。
但扁平化仅在扁平列表中的元素数量不超过 *join\_collapse\_limit* 时才执行。在本例中,有五个元素,因此当参数值小于 5 时,`joinexpr` 节点不会被扁平化。(默认值:`8`)
对规划器而言,这意味着:
- 表 `B` 必须与表 `C` 连接(或反之,`C` 与 `B` 连接——对连接对的顺序没有限制);
- 表 `A`、`D`、`E` 以及 `B` 与 `C` 的连接结果可以以任意顺序连接。
当参数 *join\_collapse\_limit* = 1 时,任何显式 `JOIN` 连接的顺序都将被保留。
此外,`FULL OUTER JOIN` 的操作数 *永远* 不会被扁平化,无论 *join\_collapse\_limit* 参数取何值。
参数 *from\_collapse\_limit* 以相同方式限制子查询的扁平化。尽管子查询在外观上不像 `JOIN`,但在解析树层面,这种类比是显而易见的。(默认值:`8`)
以下是一个查询示例:
```sql
SELECT ...
FROM a,
(
SELECT ...
FROM b, c
WHERE ...
) bc,
d, e
WHERE ...
```
相应的连接树如图所示。唯一的区别是,`joinexpr` 节点被替换为 `fromexpr` 节点(因此该参数名称并非完全直观)。
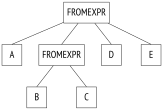
{#internal-ru-fig-16-8 num="16.8" caption="计划" .book-original-figure width=327 height=220}
因此,扁平化处理后,树中同一层级的元素数量通常受 *join\_collapse\_limit* 和 *from\_collapse\_limit* 值的限制。
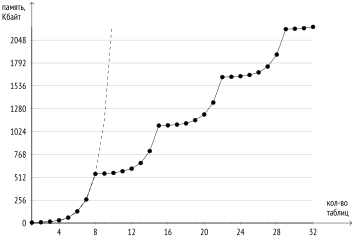
下图展示了仅包含 `JOIN` 连接的查询所需的内存。图中可见,随着表数量增加,资源消耗呈指数级“阶梯式”增长,但总体仍保持线性增长趋势。初始阶梯由前八个(*join\_collapse\_limit*)元素构成,后续阶梯在此基础上增加七个元素,依此类推。这种方法使得即使在包含大量 `JOIN` 的查询中,也能在合理时间内完成计划。
为便于对比,图中虚线表示仅包含逗号连接的查询的先前图表。
{#internal-ru-fig-16-9 num="16.9" caption="计划" .book-original-figure width=708 height=478}
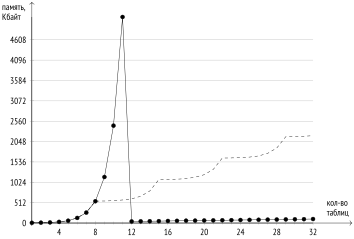
然而,仍存在大量使用逗号连接的查询问题。启用参数 *geqo* 后,当元素数量达到 *geqo\_threshold* 值时,规划器将切换到使用 *遗传算法* [^internal-ru-333-1]。遗传算法比动态规划算法快得多(即使考虑了 *join\_collapse\_limit* 和 *from\_collapse\_limit* 的限制),但不能保证找到最优计划。遗传算法有多个可调参数[^internal-ru-333-2],但此处不作讨论。(默认值:`on`)(默认值:`12`)
下图展示了启用 *geqo* 参数后,包含逗号连接的查询所需的内存。可见,当表数量达到十二(*geqo\_threshold*)时,资源需求急剧下降,之后呈线性缓慢增长。
为作对比,虚线表示 `JOIN` 连接查询的图表。
{#internal-ru-fig-16-10 num="16.10" caption="计划" .book-original-figure width=708 height=478}
不完全的树扁平化或切换到遗传算法会导致所考虑的计划选项被任意缩减,从而可能遗漏最优计划,并导致计划结果不稳定。在这种情况下,查询作者可能需要手动将查询分解为可独立优化的部分:
- 公共表表达式(CTE)可以独立于主查询进行优化;`MATERIALIZED` 子句可确保这种行为[^internal-ru-334-1]。(v. 12)
- 除 SQL 以外任何语言编写的函数体内的查询,会独立于主查询进行优化(在某些情况下,SQL 函数体可被内联到查询中 [^internal-ru-334-2])。
- 将参数 *join\_collapse\_limit* 和 *from\_collapse\_limit* 设置为 1 可保留由查询语法结构定义的连接顺序(这可能过于僵化)。
**最佳计划选择。** 对于客户端而言,计划的最优性取决于预期如何使用结果。如果需要完整结果集(例如用于生成报表),则计划应优化获取所有结果行。但若需尽快获取前几行(例如用于屏幕显示),则可能需要完全不同的计划。
PostgreSQL 通过计算两个成本分量来解决此问题:
```text {label="psql" hl_lines="8 10 12 14"}
=> EXPLAIN
SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;
QUERY PLAN
---------------------------------------------------------------------
Sort (cost=22.91..22.92 rows=1 width=128)
Sort Key: c.relname
-> Nested Loop Left Join (cost=0.00..22.90 rows=1 width=128)
Join Filter: (n.oid = c.relnamespace)
-> Seq Scan on pg_class c (cost=0.00..21.79 rows=1 width=72)
Filter: ((relkind = ANY ('{r,p}'::"char"[])) AND (pg_g...
-> Seq Scan on pg_namespace n (cost=0.00..1.05 rows=5 wid...
(7 rows)
```
第一分量(启动成本,startup cost)表示启动节点执行所需的开销,第二分量(总成本,total cost)表示获取所有结果行的总开销。
> [!NOTE]
> 有时会看到一种说法,认为启动成本就是获取第一行结果的成本,但这并不完全准确。
为决定优先选择哪些计划,规划器会检查是否使用了游标(SQL 命令 `DECLARE` 或 PL/pgSQL 中的 *显式* 游标声明)[^internal-ru-335-1]。如果没有,则假定客户端将立即获取所有结果行,因此优化器会选择总成本最低的计划。
对于使用游标执行的查询,将选择一个优化获取部分行而非所有行的计划,该部分行的比例等于参数 *cursor\_tuple\_fraction* 的值。更准确地说[^internal-ru-336-1],将选择表达式值最小的计划(默认值:`0.1`)
$$
\text{启动成本}+\mathit{cursor\_tuple\_fraction}(\text{总成本}-\text{启动成本}).
$$
**计划评估的通用框架。** 要获得计划的总体评估,必须评估其每个节点。节点的成本取决于节点类型(显然,从表中读取数据的成本与排序成本不同)以及该节点处理的数据量(通常数据量越小,成本越低)。节点类型是已知的,而预测数据量需要评估输入数据集的*基数*(节点输入的行数)和节点的*选择性*(输出行的比例)。为此,需要有数据的*统计信息*:表的大小、列中数据的分布。(参见 [346](/zh18/17-statistics/#internal-ru-page-347))
因此,优化依赖于由自动分析过程收集和更新的正确统计信息。
如果计划中每个节点的基数都正确评估,那么成本通常也能合理反映实际开销。优化器的主要错误通常源于基数和选择性的错误评估。这可能由于统计信息不正确或过时、无法使用统计信息,或(程度较小)由于优化器基础模型的不完善所致。
**基数评估。** 基数评估是一个递归过程。为了评估计划节点的基数,需要:
1) 评估每个子节点的基数,并获得输入到该节点的行数;
2) 评估该节点的选择性,即输入行中将保留在输出中的比例。
将两者相乘即可得到该节点的基数。
> [!NOTE]
> 选择性以 0 到 1 之间的数值表示。接近 0 的选择性通常称为 *高*,接近 1 的称为 *低*。这可能看起来不合逻辑,但这里的“选择性”指的是 *选择能力*:选择少量行的条件具有高选择性(选择能力),而保留几乎全部行的条件则具有低选择性。
首先计算叶节点的基数,这些节点包含数据访问方法。这需要使用统计信息,特别是表的总体大小。
施加在表上的条件的选择性取决于这些条件的类型。在最简单的情况下,可以将选择性视为某个常量,尽管优化器会尽量利用所有可用信息来细化评估。只需能够评估简单条件的选择性,而通过逻辑运算组合的条件的选择性则根据公式 [^internal-ru-337-1] 计算:
$$
\begin{aligned}sel_{\mathrm{not}\,x}&=1-sel_x;\\sel_{x\,\mathrm{and}\,y}&=sel_x\,sel_y;\\sel_{x\,\mathrm{or}\,y}&=1-(1-sel_x)(1-sel_y)=sel_x+sel_y-sel_x\,sel_y.\end{aligned}
$$
不幸的是,这些公式假设谓词 *x* 和 *y* 是独立的。在谓词相关的情况下,这种评估将不准确。(参见 [365](/zh18/17-statistics/#internal-ru-page-366))
为了评估连接的基数,需计算笛卡尔积的基数(等于两个数据集基数的乘积),并评估连接条件的选择性,这同样取决于条件的类型。
类似地评估其他节点(如排序或聚合)的基数。
需要注意的是,计划底层节点中基数计算的错误会向上传播,最终导致评估错误并选择次优计划。这一不良效应因优化器仅掌握表的统计信息,而缺乏连接结果的统计信息而加剧。
**成本评估。** 成本评估过程也是递归的。为了计算计划子树的成本,需要计算子节点的成本,将它们相加,并加上该节点自身的成本。
节点的运行成本基于执行该节点操作的数学模型计算。评估的输入是已计算出的基数。分别评估初始成本和总成本。
某些操作无需任何准备即可立即开始执行;这类节点的初始成本为零。其他操作则需要执行预处理步骤。例如,排序节点通常必须从子节点获取*所有*数据后才能开始工作。这类节点的初始成本不为零——即使上层节点(或客户端)只需要结果集中的一个行,也必须支付这一成本。
成本仅反映优化器的估算,如果优化器出错,可能与实际执行时间无相关性。它仅用于使优化器能够在*相同*查询、*相同*条件下比较不同计划。在其他情况下,通过成本比较查询(尤其是不同查询)是错误且无意义的。例如,成本可能因错误的统计信息而被低估;在更新统计信息后,成本可能上升,但变得更为合理,而计划实际上可能得到改善。
### 执行 {#internal-ru-subsection-star-217}
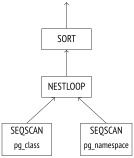
在查询优化过程中构建的计划将被传递至*执行*阶段 [^internal-ru-338-1]。在服务进程的内存中创建一个*门户* [^internal-ru-338-2]——一个存储正在执行查询状态的对象。状态以树形结构表示,与计划树结构一致。实际上,树中的节点作为流水线工作,相互请求和传递行。
执行从根节点开始。根节点(示例中为排序操作 sort)向子节点请求数据。获取所有行后,节点执行排序,并将数据传递给上层节点(即客户端)。
{#internal-ru-fig-16-11 num="16.11" caption="执行" .book-original-figure width=269 height=315}
某些节点(如图中的 nestloop)将来自不同源的数据进行连接。此类节点向两个子节点请求数据。获取两条满足连接条件的行后,节点立即向上层(而非排序节点)传递结果行(与排序节点不同,排序节点必须先获取*所有*行)。该节点的执行在此暂停,直到上层节点请求下一行。因此,如果只需要部分结果(例如由于 `LIMIT` 限制),操作将不会完全执行。
树中的两个叶节点 seqscan 代表对表的访问。当上层节点请求数据时,叶节点从相应表中读取下一行并返回。
因此,某些节点不存储行,而是立即向上传递并立即遗忘,但某些节点需要先保存——*物化*——所有行。其中一个节点是通用表表达式 CTE Scan 的扫描。物化可由开发人员显式指定(使用 `MATERIALIZED`),也可由优化器决定(为避免多次计算同一表表达式)。(v. 12)
需要物化的数据量事先未知。为希望行数较少,最初为存储分配服务进程内存中大小为 *work\_mem* 的内存片段。只要内存足够,数据就保存在其中[^internal-ru-339-1]。(默认值:`4MB`)
```text {label="psql" hl_lines="9"}
=> EXPLAIN (analyze, costs off, timing off, buffers off)
WITH t AS MATERIALIZED (
SELECT * FROM seats
)
SELECT * FROM t;
QUERY PLAN
--------------------------------------------------------
CTE Scan on t (actual rows=1339.00 loops=1)
Storage: Memory Maximum Storage: 69kB
CTE t
-> Seq Scan on seats (actual rows=1339.00 loops=1)
(4 rows)
```
如果内存溢出,则*所有*数据将被写入磁盘上的临时文件,并在需要时从该文件读取。
```text {label="psql" hl_lines="9"}
=> EXPLAIN (analyze, costs off, timing off, buffers off)
WITH t AS MATERIALIZED (
SELECT * FROM tickets
)
SELECT * FROM t;
QUERY PLAN
-------------------------------------------------------------
CTE Scan on t (actual rows=2949857.00 loops=1)
Storage: Disk Maximum Storage: 330144kB
CTE t
-> Seq Scan on tickets (actual rows=2949857.00 loops=1)
(4 rows)
```
相同的物化机制也用于递归查询(用于工作表和中间表)、窗口函数(用于当前框架)、表函数(用于累积结果)、触发器(用于外部表和过渡关系)等。该机制同样应用于优化器可能插入计划中以物化计算行的 Materialize 节点。
排序采用类似但更复杂的机制。(参见 [489](/zh18/23-sorting-and-merging/#internal-ru-page-490))
因此,一个计划中可能包含多个需要数据存储的节点,因此查询可能分配多个大小为 *work\_mem* 的内存片段。查询可用的总内存无任何限制,而临时文件的最大大小可通过参数 *temp\_file\_limit* 设置。(默认值:`-1`)
## 16.3. 扩展查询协议 {#internal-ru-section-16-3}
在使用简单查询协议时,即使命令重复执行,也必须经过上述所有阶段:
1) 解析;
2) 转换;
3) 规划;
4) 执行。
但重新解析同一个查询毫无意义。解析仅常量不同的查询也无意义——解析树的结构不会改变。
简单执行方式的另一个不便之处在于,客户端会立即收到全部结果,无论结果包含多少行。
原则上,这两个限制都可以通过 SQL 命令克服:第一个通过使用 `PREPARE` 准备查询并用 `EXECUTE` 执行,第二个通过使用 `DECLARE` 创建游标并用 `FETCH` 提取行。但这样客户端必须负责命名创建的对象,而服务器则需额外解析额外命令的开销。
因此,扩展的客户端-服务器协议允许在协议命令级别详细控制操作执行的各个阶段。
### 预备 {#internal-ru-subsection-star-220}
在*准备*阶段,查询以常规方式解析和转换,但解析树被保存在服务进程的内存中。
PostgreSQL 中没有全局查询缓存。这种设计的缺点是显而易见的——每个服务进程都必须独立解析所有查询,即使其他进程已经解析过相同的查询。但也有优点。共享内存中的缓存很容易因需要锁而成为瓶颈。一个客户端执行大量小而不同的查询(例如仅常量不同)会显著增加此类缓存的负载,从而影响整个实例的性能。在 PostgreSQL 中,查询解析是本地执行的,因此不会影响其他进程。(参见 [305](/zh18/15-locks-on-memory-structures/#internal-ru-page-306))
准备查询时,可以对其进行参数化。利用 psql 支持扩展协议的功能:(v. 18)
```text {label="psql"}
=> SELECT * FROM aircrafts WHERE aircraft_code = $1 \parse plane
```
可以通过视图 `pg_prepared_statements` 查看命名的准备语句:
```text {label="psql"}
=> SELECT name, statement, parameter_types
FROM pg_prepared_statements \gx
-[ RECORD 1 ]---+--------------------------------------------------
name | plane
statement | SELECT * FROM aircrafts WHERE aircraft_code = $1
parameter_types | {character}
```
无法通过这种方式查看匿名准备语句(例如 PL/pgSQL 为每个表达式创建的语句)。当然,会话只能访问自己的语句;无法查看其他会话的内存。
### 参数绑定 {#internal-ru-subsection-star-222}
在执行准备好的查询之前,需绑定实际的参数值:
```text {label="psql"}
=> \bind_named plane '733' \g
aircraft_code | model | range
---------------+---------------+-------
733 | Боинг 737-300 | 4200
(1 row)
```
准备语句参数相比将字面量连接到查询字符串的优势在于,从根本上不可能注入 SQL 代码,因为任何参数值都无法更改已构建的解析树。若要在不使用准备语句的情况下达到同等安全级别,必须仔细转义从不可靠源获取的每个值。
### 规划和执行 {#internal-ru-subsection-star-224}
在执行准备语句时,会根据实际参数值进行规划,随后将计划传递给执行阶段。
考虑参数值非常重要,因为不同值的最优计划可能并不相同。例如,查找非常昂贵的预订时会使用索引,因为规划器假设符合条件的行并不多:
```text {label="psql" hl_lines="6 8"}
=> CREATE INDEX ON bookings(total_amount);
=> EXPLAIN SELECT * FROM bookings
WHERE total_amount > 1000000;
QUERY PLAN
---------------------------------------------------------------------
Bitmap Heap Scan on bookings (cost=81.86..9154.92 rows=4314 wid...
Recheck Cond: (total_amount > '1000000'::numeric)
-> Bitmap Index Scan on bookings_total_amount_idx (cost=0.00....
Index Cond: (total_amount > '1000000'::numeric)
(4 rows)
```
然而,下一个条件适用于所有预订,因此索引毫无用处,必须扫描整个表:
```text {label="psql" hl_lines="4"}
=> EXPLAIN SELECT * FROM bookings WHERE total_amount > 100;
QUERY PLAN
-------------------------------------------------------------------
Seq Scan on bookings (cost=0.00..39876.88 rows=2111110 width=21)
Filter: (total_amount > '100'::numeric)
(2 rows)
```
在某些情况下,规划器不仅会记住解析树,还会记住查询计划,以避免重复规划。这种不考虑参数值而构建的计划称为 *通用计划*(与考虑实际值的 *专用计划* 相对)[^internal-ru-344-1]。
显然,可以无损效率地切换到通用计划的典型情况是无参数查询。
带参数的准备语句前五次执行始终会根据实际值进行优化;此时会计算专用计划的平均成本。从第六次开始,如果通用计划的平均成本优于专用计划(考虑到专用计划每次都需要重新构建 [^internal-ru-344-2]),规划器将记住通用计划,并后续继续使用它,不再重复优化。
准备语句 `plane` 已经执行过一次。现在我们从 psql 的元命令切换到普通的 SQL 命令:这与直接使用协议命令并不完全相同,但最终效果一致。这样更容易观察到,在接下来的三次执行中仍然使用专用计划——请注意查询计划中参数的值:
```text {label="psql" hl_lines="7"}
=> EXECUTE plane('763'); -- то же, что \bind_named, но в SQL
=> EXECUTE plane('773');
=> EXPLAIN EXECUTE plane('319');
QUERY PLAN
------------------------------------------------------------------
Seq Scan on aircrafts_data ml (cost=0.00..1.36 rows=1 width=40)
Filter: (aircraft_code = '319'::bpchar)
(2 rows)
```
在第五次执行后,规划器将切换到使用通用计划——它与专用计划一致,成本相同,但可以被缓存,从而无需再次消耗资源进行优化。命令 `EXPLAIN` 现在显示的不再是参数值,而是其编号:
```text {label="psql" hl_lines="6"}
=> EXECUTE plane('320');
=> EXPLAIN EXECUTE plane('321');
QUERY PLAN
------------------------------------------------------------------
Seq Scan on aircrafts_data ml (cost=0.00..1.36 rows=1 width=40)
Filter: (aircraft_code = $1)
(2 rows)
```
不难设想一种情况:由于偶然因素,最初的几个专用计划成本高于通用计划,而后续的计划本应更高效——但规划器将不再考虑这些情况。此外,规划器比较的是 *成本估算*,而非实际资源消耗,这也可能导致错误。
因此,当自动决策出现错误时,可以强制选择通用计划或专用计划,通过设置相应参数值 *plan\_cache\_mode* 来实现:(v. 12)(默认值:`auto`)
```text {label="psql" hl_lines="6"}
=> SET plan_cache_mode = 'force_custom_plan';
=> EXPLAIN EXECUTE plane('CN1');
QUERY PLAN
------------------------------------------------------------------
Seq Scan on aircrafts_data ml (cost=0.00..1.36 rows=1 width=40)
Filter: (aircraft_code = 'CN1'::bpchar)
(2 rows)
```
视图 `pg_prepared_statements` 也显示了计划选择的统计信息:(v. 14)
```text {label="psql"}
=> SELECT name, generic_plans, custom_plans
FROM pg_prepared_statements;
name | generic_plans | custom_plans
-------+---------------+--------------
plane | 1 | 6
(1 row)
```
### 获取结果 {#internal-ru-subsection-star-226}
扩展查询协议允许客户端逐行或分批获取结果(每次若干行)。使用 SQL 游标可达到几乎相同的效果(除了服务器端多出额外开销,且规划器优化的是获取前 *cursor\_tuple\_fraction* 行,而非整个结果集):
```text {label="psql"}
=> BEGIN;
=> DECLARE cur CURSOR FOR
SELECT * FROM aircrafts ORDER BY aircraft_code;
=> FETCH 3 FROM cur;
aircraft_code | model | range
---------------+------------------+-------
319 | Аэробус A319-100 | 6700
320 | Аэробус A320-200 | 5700
321 | Аэробус A321-200 | 5600
(3 rows)
=> FETCH 2 FROM cur;
aircraft_code | model | range
---------------+---------------+-------
733 | Боинг 737-300 | 4200
763 | Боинг 767-300 | 7900
(2 rows)
=> COMMIT;
```
如果查询返回大量行且客户端需要全部数据,则每次获取的数据量对传输速度影响极大。数据量越大,与服务器通信的开销就越低。但随着数据量增加,开销降低的边际效应逐渐减弱:单行与十行之间的差异可能非常显著,而一百行与一千行之间的差异则几乎可以忽略。
[^internal-ru-320-1]: [postgrespro.ru/education/demodb]().
[^internal-ru-320-2]: [edu.postgrespro.ru/demo-big-20170815.zip]().
[^internal-ru-323-1]: [postgrespro.ru/docs/postgresql/18/protocol]().
[^internal-ru-323-2]: [backend/tcop/postgres.c](), 函数 exec\_simple\_query.
[^internal-ru-323-3]: [postgrespro.ru/docs/postgresql/18/parser-stage](); [backend/parser/README]().
[^internal-ru-323-4]: [backend/parser/scan.l]().
[^internal-ru-323-5]: [backend/parser/gram.y]().
[^internal-ru-324-1]: [include/nodes/parsenodes.h]().
[^internal-ru-324-2]: [backend/parser/analyze.c]().
[^internal-ru-325-1]: [postgrespro.ru/docs/postgresql/18/rule-system]().
[^internal-ru-325-2]: [backend/rewrite/rowsecurity.c]().
[^internal-ru-325-3]: [backend/rewrite/rewriteSearchCycle.c]().
[^internal-ru-326-1]: [postgrespro.ru/docs/postgresql/18/rules]().
[^internal-ru-326-2]: [M.]() [Stonebraker,]() [L.]() [A.]() [Rowe]()[.]() [The]() [Design]() [of]() [Postgres]().
[^internal-ru-327-1]: [postgrespro.ru/docs/postgresql/18/planner-optimizer]().
[^internal-ru-327-2]: [postgrespro.ru/docs/postgresql/18/using-explain]().
[^internal-ru-329-1]: [backend/optimizer/README]().
[^internal-ru-329-2]: [postgrespro.ru/docs/postgresql/18/explicit-joins]().
[^internal-ru-331-1]: [backend/optimizer/plan/initsplan.c](), 函数 deconstruct\_jointree.
[^internal-ru-333-1]: [postgrespro.ru/docs/postgresql/18/geqo](); [backend/optimizer/geqo/geqo\_main.c]().
[^internal-ru-333-2]: [postgrespro.ru/docs/postgresql/18/runtime-config-query#RUNTIME-CONFIG-QUERY-GEQO]().
[^internal-ru-334-1]: [postgrespro.ru/docs/postgresql/18/queries-with]().
[^internal-ru-334-2]: [wiki.postgresql.org/wiki/Inlining\_of\_SQL\_functions]().
[^internal-ru-335-1]: [backend/optimizer/plan/planner.c](), 函数 standard\_planner.
[^internal-ru-336-1]: [backend/optimizer/util/pathnode.c](), 函数 compare\_fractional\_path\_costs.
[^internal-ru-337-1]: [backend/optimizer/path/clausesel.c](), 函数 clauselist\_selectivity\_ext 和 clauselist\_selectivity\_or.
[^internal-ru-338-1]: [postgrespro.ru/docs/postgresql/18/executor](); [backend/executor/README]().
[^internal-ru-338-2]: [backend/utils/mmgr/portalmem.c]().
[^internal-ru-339-1]: [backend/utils/sort/tuplestore.c]().
[^internal-ru-344-1]: [backend/utils/cache/plancache.c](), 函数 choose\_custom\_plan.
[^internal-ru-344-2]: [backend/utils/cache/plancache.c](), 函数 cached\_plan\_cost.