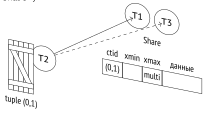
13.1. 锁设计 由于基于快照的隔离,读取表中的行时无需锁定。但不能允许两个事务同时修改同一行。需要对行进行锁定,然而重锁并不适合此用途:每把重锁都会占用服务器共享内存中的空间(数百字节,还不包括辅助基础设施),且内部机制并未设计用于处理大量同时存在的锁。
在某些数据库系统中,该问题通过提升锁级别来解决:当行级锁数量过多时,它们会被一个更通用的锁(例如页级或表级锁)所替代。这简化了实现,但可能导致效率显著下降。
在 PostgreSQL 中,关于某行被锁定的信息仅存储在行版本的头部。实际上,这仅仅是数据页面中的标志位,而非真正的锁——这些标志在内存中不会体现。
通常在修改或删除行时会锁定该行。在这两种情况下,当前行版本都会被标记为已删除。其标志是 xmax 字段中的事务号,而该事务号(结合额外的信息位)也表明该行已被锁定。当某个事务试图修改一行,但发现当前版本的 xmax 字段中包含一个未完成的事务号时,它必须等待该事务完成。之后所有锁都将被释放,等待的事务便可继续对行执行操作。(参见 87 )
这种方案允许锁定任意数量的行,且不消耗任何资源。
其缺点在于,由于内存中没有锁信息,其他进程无法排队等待。因此,仍不得不使用常规的重锁。等待行被释放意味着等待阻塞事务的结束,而为此必须请求该事务号的锁。因此,所使用的重锁数量与同时运行的进程数成正比,而非与被修改的行数成正比。
13.2. 行级锁模式 存在四种可以锁定行的模式
冲突矩阵如下所示:
表 13.1 行锁冲突矩阵
独占模式
Update 模式表示修改行的任意字段或删除该行;No Key Update 模式表示仅修改不涉及唯一索引的字段(即不会影响外键的修改)。
UPDATE 命令会自行选择最合适的锁模式;由于键通常不会改变,因此大多数情况下行是以 No Key Update 模式被锁定的。 UPDATE
创建一个函数,利用 pageinspect 扩展来显示我们关心的行版本信息,特别是 xmax 字段和一些信息位:
=> CREATE FUNCTION row_locks(relname text, pageno integer)
RETURNS TABLE(
  ctid tid, xmax text,
  lock_only text, is_multi text,
  keys_upd text, keyshr text, shr text
) AS $$
SELECT (pageno,lp)::text::tid,
  t_xmax,
  CASE WHEN t_infomask  & 128   = 128   THEN 't' END,
  CASE WHEN t_infomask  & 4096  = 4096  THEN 't' END,
  CASE WHEN t_infomask2 & 8192  = 8192  THEN 't' END,
  CASE WHEN t_infomask  & 16    = 16    THEN 't' END,
  CASE WHEN t_infomask  & 16+64 = 16+64 THEN 't' END
FROM heap_page_items(get_raw_page(relname,pageno))
ORDER BY lp;
$$ LANGUAGE sql;
启动一个事务,并更新 accounts 表中第一个账户的金额(键未改变)和第二个账户的编号(键被改变):
=> BEGIN;
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> UPDATE accounts SET id = 20 WHERE id = 2;
查看页面内容:
=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  |  xmax  | lock_only | is_multi | keys_upd | keyshr | shr
-------+--------+-----------+----------+----------+--------+-----
 (0,1) | 191451 |           |          |          |        |
 (0,2) | 191451 |           |          | t        |        |
(2 rows)
锁模式由信息位 keys_updated 决定。
同一 xmax 字段也用于 SELECT FOR 命令的锁标志,但此时会设置额外的信息位 xmax_lock_only。该位表示行版本仅被锁定,尚未被删除,且仍为当前有效版本:
=> BEGIN;
=> SELECT * FROM accounts WHERE id = 1 FOR NO KEY UPDATE;
=> SELECT * FROM accounts WHERE id = 2 FOR UPDATE;
=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  |  xmax  | lock_only | is_multi | keys_upd | keyshr | shr
-------+--------+-----------+----------+----------+--------+-----
 (0,1) | 191452 | t         |          |          |        |
 (0,2) | 191452 | t         |          | t        |        |
(2 rows)
=> ROLLBACK;
共享模式 Share 模式确保读取的行不会被其他事务修改。Key Share 模式允许修改行的任意字段,但不能修改键字段。
在共享模式中,PostgreSQL 核心仅在检查外键时使用 Key Share 模式。它与 No Key Update 互斥模式兼容,即外键检查不会妨碍多个事务同时更新非键字段。当然,应用程序也可使用任何合适的模式。
再次强调,读取操作不会使用任何行级锁。
=> BEGIN;
=> SELECT * FROM accounts WHERE id = 1 FOR KEY SHARE;
=> SELECT * FROM accounts WHERE id = 2 FOR SHARE;
在行版本中可见:
=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  |  xmax  | lock_only | is_multi | keys_upd | keyshr | shr
-------+--------+-----------+----------+----------+--------+-----
 (0,1) | 191453 | t         |          |          | t      |
 (0,2) | 191453 | t         |          |          | t      | t
(2 rows)
两种情况下均设置了 xmax_keyshr_lock 位,而 Share 模式可通过查看其他信息位来识别
13.3. 组事务 锁标志由 xmax 字段中的锁定事务号表示,但共享锁可被多个事务同时持有。如何在一个字段中记录多个事务号?
对于共享锁,使用所谓的 多事务 multixact_member_buffers 和 multixact_offset_buffers 控制。(参见 309 )(默认值:32)(默认值:16)
多事务编号与普通事务编号具有相同的位宽(32 位),但编号空间独立分配,因此事务编号与多事务编号可能重叠。为区分两者,使用额外的信息位 xmax_is_multi。
向现有锁再添加一个由另一事务执行的互斥锁(由于 Key Share 与 No Key Update 模式兼容,此操作可行):
=> BEGIN;
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  |  xmax  | lock_only | is_multi | keys_upd | keyshr | shr
-------+--------+-----------+----------+----------+--------+-----
 (0,1) | 1      |           | t        |          |        |
 (0,2) | 191453 | t         |          |          | t      | t
(2 rows)
第一行中,普通编号被多事务编号替代——这由 xmax_is_multi 位表明。
为避免深入多事务实现细节,可使用 pgrowlocks 扩展,它能以方便的格式显示所有类型行锁的全部信息:
=> CREATE EXTENSION pgrowlocks;
=> SELECT * FROM pgrowlocks('accounts') \gx
-[ RECORD 1 ]---------------------------------
locked_row | (0,1)
locker     | 1
multi      | t
xids       | {191453,191454}
modes      | {"For Key Share","No Key Update"}
pids       | {65884,66190}
-[ RECORD 2 ]---------------------------------
locked_row | (0,2)
locker     | 191453
multi      | f
xids       | {191453}
modes      | {"For Share"}
pids       | {65884}
该查询外观上类似于访问 pg_locks 视图,但 pgrowlocks 函数会读取表页,因为行级锁信息在内存中并不存在。
由于多事务编号为 32 位,因此与普通事务编号一样,也会面临计数器溢出(xid wraparound)问题。因此,对多事务编号也需执行类似冻结的操作:将旧编号替换为新编号(或在冻结时若锁仅由一个事务持有,则替换为普通事务编号)134 )
但与仅对 xmin 字段执行普通事务编号冻结(因为 xmax 非空的版本已无效,将被清理)不同,多事务编号的冻结是针对 xmax 字段的:当前行版本可能持续被多个事务以共享模式锁定。
控制多事务冻结的服务器参数与普通冻结类似:vacuum_multixact_freeze_min_age 、vacuum_multixact_freeze_table_age 、autovacuum_multixact_freeze_max_age ,以及 vacuum_multixact_failsafe_age 。(v. 14)
13.4. 等待队列
独占模式
由于行锁仅是一个标志,因此排队机制实现得相当复杂。当事务试图修改一行时,它会执行以下步骤
xmax 字段及信息位表明该行以不兼容模式被锁定,则获取该行版本的互斥重锁;
如有必要,等待不兼容锁的释放,通过请求 xmax 字段中事务号(或多个事务号,若 xmax 为多事务号)的锁;
xmax 字段,并设置必要的信息位;
若在第 1 步中获取了行版本锁,则释放该锁。
行版本锁(tuple lock)是另一种重锁类型,其类型为 tuple。请勿将其与行锁(row lock)混淆。
可能有人认为第 1 步和第 4 步是多余的,仅等待阻塞事务即可。但如果多个事务同时尝试更新同一行,它们都会等待当前正在操作该行的事务结束。当该事务完成后,等待的事务之间将出现竞争,这可能导致某些“倒霉”的事务无限期等待。这种情况称为 资源饥饿 (starvation)。
行版本锁确保队列中的第一个事务获得下一次锁的权限。
但最好亲眼看看。由于运行过程中会产生大量不同类型的锁,且每把锁在 pg_locks 表中对应一行,我将创建另一个基于 pg_locks 的视图。该视图以紧凑方式显示信息,并仅保留我们当前关注的锁(与 accounts 表和当前事务相关的锁,但不包括虚拟事务号锁):
=> CREATE VIEW locks_accounts AS
SELECT pid,
  locktype,
  CASE locktype
    WHEN 'relation' THEN relation::regclass::text
    WHEN 'transactionid' THEN transactionid::text
    WHEN 'tuple' THEN relation::regclass||'('||page||','||tuple||')'
  END AS lockid,
  mode,
  granted
FROM pg_locks
WHERE locktype in ('relation','transactionid','tuple')
  AND (locktype != 'relation' OR relation = 'accounts'::regclass)
ORDER BY 1, 2, 3;
启动第一个事务并更新一行:
=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
--------------+----------------
       191456 |          66190
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
该事务成功执行了序列中的四个步骤,现在持有表锁:
=> SELECT * FROM locks_accounts WHERE pid = 66190;
  pid  |   locktype    |  lockid  |       mode       | granted
-------+---------------+----------+------------------+---------
 66190 | relation      | accounts | RowExclusiveLock | t
 66190 | transactionid | 191456   | ExclusiveLock    | t
(2 rows)
启动第二个事务并尝试更新同一行。该事务在等待锁时挂起:
=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
--------------+----------------
       191457 |          66267
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
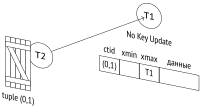
图 13.1 互斥模式
第二个事务仅执行到第二步。因此,除了表锁和自身事务号外,它还在 pg_locks 中添加了两条记录:第一步获取的 tuple 类型锁,以及第二步请求的首个事务号锁。
=> SELECT * FROM locks_accounts WHERE pid = 66267;
  pid  |   locktype    |    lockid     |       mode       | granted
-------+---------------+---------------+------------------+---------
 66267 | relation      | accounts      | RowExclusiveLock | t
 66267 | transactionid | 191456        | ShareLock        | f
 66267 | transactionid | 191457        | ExclusiveLock    | t
 66267 | tuple         | accounts(0,1) | ExclusiveLock    | t
(4 rows)
第三个事务仅执行到第一步。它将尝试获取行版本锁,但在此处停止。
=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
--------------+----------------
       191458 |          66344
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> SELECT * FROM locks_accounts WHERE pid = 66344;
  pid  |   locktype    |    lockid     |       mode       | granted
-------+---------------+---------------+------------------+---------
 66344 | relation      | accounts      | RowExclusiveLock | t
 66344 | transactionid | 191458        | ExclusiveLock    | t
 66344 | tuple         | accounts(0,1) | ExclusiveLock    | f
(3 rows)
第四个及后续事务若希望更新同一行,将与第三个事务无异——它们都将等待同一把行版本锁。
       => BEGIN;
       => SELECT txid_current(), pg_backend_pid();
        txid_current | pg_backend_pid
       --------------+----------------
              191459 |          66421
       (1 row)
       => UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> SELECT * FROM locks_accounts WHERE pid = 66344;
  pid  |   locktype    |    lockid     |       mode       | granted
-------+---------------+---------------+------------------+---------
 66344 | relation      | accounts      | RowExclusiveLock | t
 66344 | transactionid | 191458        | ExclusiveLock    | t
 66344 | tuple         | accounts(0,1) | ExclusiveLock    | f
(3 rows)
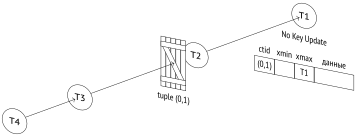
图 13.2 独占模式 当前等待情况的总体视图可以通过 pg_stat_activity 视图查看,并添加关于阻塞进程的信息:
=> SELECT pid,
  wait_event_type,
  wait_event,
  pg_blocking_pids(pid)
FROM pg_stat_activity
WHERE pid IN (66190,66267,66344,66421);
  pid  | wait_event_type |  wait_event   | pg_blocking_pids
-------+-----------------+---------------+------------------
 66190 | Client          | ClientRead    | {}
 66267 | Lock            | transactionid | {66190}
 66344 | Lock            | tuple         | {66267}
 66421 | Lock            | tuple         | {66267,66344}
(4 rows)
如果第一个事务回滚,整个结构将按预期工作:剩余事务将按顺序向前推进一步。
但更可能的是,第一个事务会提交。在可重复读或可串行化隔离级别下,这将导致第二个事务因序列化错误而中止
因此,第一个事务结束:
第二个事务被唤醒,并成功执行了序列的第三和第四步:
=> SELECT * FROM locks_accounts WHERE pid = 66267;
  pid  |   locktype    |  lockid  |       mode       | granted
-------+---------------+----------+------------------+---------
 66267 | relation      | accounts | RowExclusiveLock | t
 66267 | transactionid | 191457   | ExclusiveLock    | t
(2 rows)
一旦第二个事务释放了行版本的锁,第三个事务也被唤醒,但它发现新行版本的 xmax 字段中已有另一个事务号。至此,上述锁定序列以失败告终。在读已提交隔离级别下,会尝试重新锁定行
=> SELECT * FROM locks_accounts WHERE pid = 66344;
  pid  |   locktype    |  lockid  |       mode       | granted
-------+---------------+----------+------------------+---------
 66344 | relation      | accounts | RowExclusiveLock | t
 66344 | transactionid | 191457   | ShareLock        | f
 66344 | transactionid | 191458   | ExclusiveLock    | t
(3 rows)
第四个事务也发生同样的情况:
=> SELECT * FROM locks_accounts WHERE pid = 66421;
  pid  |   locktype    |  lockid  |       mode       | granted
-------+---------------+----------+------------------+---------
 66421 | relation      | accounts | RowExclusiveLock | t
 66421 | transactionid | 191457   | ShareLock        | f
 66421 | transactionid | 191459   | ExclusiveLock    | t
(3 rows)
现在,第三个和第四个事务都在等待第二个事务完成,同时期待竞争获取锁。队列本身已经瓦解。
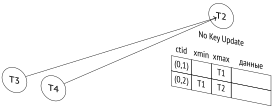
图 13.3 独占模式 如果在队列仍然存在时,又有多个其他事务加入,它们都将无意中成为这场竞争的参与者。
结论:在多个并行进程中同时更新同一张表的同一行,不是一个好主意。这会形成热点,当负载足够高时,会成为性能瓶颈。
完成所有已启动的事务。
共享模式 PostgreSQL 仅在检查引用完整性时使用行共享锁。在高负载应用中使用这些锁可能导致资源饥饿,而两级锁机制对此并无防范作用。
再次提醒一下事务在锁定行时执行的操作序列:
xmax 字段和信息位表明该行已被以不兼容 模式锁定,则获取该可变行版本的独占重锁;
不兼容 锁的释放,通过请求 xmax(或多个事务,若 xmax 为多事务)的事务号锁;
xmax 字段中)并设置必要的信息位;
如果在第1步中获取了行版本锁,则释放该锁。
前两个步骤表明,如果锁模式是兼容 的,事务将无需排队 执行。
让我们从头开始重复这个实验。
=> TRUNCATE accounts;
=> INSERT INTO accounts(id, client, amount)
VALUES (1,'alice',100.00),
       (2,'bob',200.00),
       (3,'charlie',300.00);
启动第一个事务:
=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
--------------+----------------
       191462 |          66190
(1 row)
第一个事务以共享模式锁定该行:
=> SELECT * FROM accounts WHERE id = 1 FOR SHARE; 第二个事务尝试更新同一行,但无法成功——共享模式与无键更新模式不兼容:
=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
--------------+----------------
       191463 |          66267
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
第二个事务等待第一个事务完成,并持有行版本锁——与之前示例相同:
=> SELECT * FROM locks_accounts WHERE pid = 66267;
  pid  |   locktype    |    lockid     |       mode       | granted
-------+---------------+---------------+------------------+---------
 66267 | relation      | accounts      | RowExclusiveLock | t
 66267 | transactionid | 191462        | ShareLock        | f
 66267 | transactionid | 191463        | ExclusiveLock    | t
 66267 | tuple         | accounts(0,1) | ExclusiveLock    | t
(4 rows)
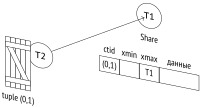
图 13.4 共享模式 现在让第三个事务以共享模式锁定该行。其锁与现有锁兼容,因此第三个事务无需排队即可通过:
=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
--------------+----------------
       191464 |          66344
(1 row)
=> SELECT * FROM accounts WHERE id = 1 FOR SHARE;
现在已有两个事务锁定了该行:
=> SELECT * FROM pgrowlocks('accounts') \gx
-[ RECORD 1 ]-------------------------
locked_row | (0,1)
locker     | 2
multi      | t
xids       | {191462,191464}
modes      | {"For Share","For Share"}
pids       | {66190,66344}
图 13.5 共享模式 现在,如果第一个事务结束,第二个事务将被唤醒,但它会发现行锁并未消失,于是再次进入队列——这次排在第三个事务之后:
=> SELECT * FROM locks_accounts WHERE pid = 66267;
  pid  |   locktype    |    lockid     |       mode       | granted
-------+---------------+---------------+------------------+---------
 66267 | relation      | accounts      | RowExclusiveLock | t
 66267 | transactionid | 191463        | ExclusiveLock    | t
 66267 | transactionid | 191464        | ShareLock        | f
 66267 | tuple         | accounts(0,1) | ExclusiveLock    | t
(4 rows)
只有当第三个事务结束(且在此期间未出现其他共享锁)时,第二个事务才能执行更新。
外键检查不太可能引发问题,因为键字段通常不会改变,且 Key Share 与 No Key Update 模式是兼容的。但大多数情况下,建议避免在应用中使用行共享锁模式。
13.5. 无等待锁定 通常,SQL 命令会等待所需资源的释放。但有时希望在无法立即获取锁时放弃执行。为此,SELECT、LOCK 和 ALTER 等命令支持 NOWAIT 子句。
锁定一行:
=> BEGIN;
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
带有 NOWAIT 子句的命令若资源已被占用,将立即以错误终止:
=> SELECT * FROM accounts
FOR UPDATE NOWAIT;
ERROR:  could not obtain lock on row in relation "accounts"
在应用代码中,可以捕获此类错误并进行处理。
UPDATE 和 DELETE 命令不支持 NOWAIT 子句。标准做法是先尝试使用 SELECT FOR UPDATE NOWAIT 锁定行,若成功再执行更新或删除。
在极少数情况下,跳过已锁定的行并立即获取空闲行进行处理会更方便。SELECT FOR 命令配合 SKIP LOCKED 子句可实现此功能:
=> SELECT * FROM accounts
ORDER BY id
FOR UPDATE SKIP LOCKED
LIMIT 1;
 id | client | amount
----+--------+--------
  2 | bob    | 200.00
(1 row)
在此示例中,第一行(已锁定)被跳过,查询锁定了并返回了第二行。
这种方法可用于实现多线程队列处理或分组行的批量处理。但不应为该命令寻找其他用途——大多数任务可通过更简单的方法解决。(参见 179 )
最后,可通过设置超时来避免长时间等待:
=> SET lock_timeout = '1s';
=> ALTER TABLE accounts DROP COLUMN amount;
ERROR:  canceling statement due to lock timeout
命令因在 1 秒内未能获取锁而失败。当然,超时可不仅设置在会话级别,也可设置在单个事务级别。
该方法可避免在高负载下执行需要独占锁的命令时出现长时间阻塞。在收到错误后,可稍后重试该命令。
说明
参数 lock_timeout 与参数 statement_timeout 的区别在于,前者限制的是等待锁的时间,而非操作的总执行时间。
13.6. 死锁
一个事务继续运行可能需要另一个事务持有的资源;而那个事务可能需要第三个事务持有的资源,依此类推。事务会通过重锁机制排队等待。
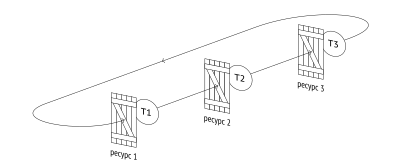
但有可能出现这样的情况:一个正在排队的事务还需要另一个资源,而它自己也必须加入到该资源的同一队列中。这就产生了死锁
为了直观理解锁的状况,我们可以构建一个等待图。该图的顶点是正在执行的进程。其边是箭头,从等待获取锁的进程指向持有这些锁的进程。如果图中存在环 ,即从某个顶点沿箭头可以回到自身,那么就发生了死锁。(参见 301 )
说明
我在图中展示的不是进程,而是事务。通常这种替换是允许的,因为一个进程通常只执行一个事务,且锁不会在事务之外被获取。但在一般情况下,必须讨论进程,因为并非所有锁都会在事务结束后立即释放。
图 13.6 死锁
如果发生了死锁且没有任何参与者设置了等待超时,事务将无限期地相互等待。因此,锁管理器
然而,检查需要一定的开销,我们不希望每次请求新锁时都进行检查(毕竟死锁相当罕见)。因此,当进程尝试获取锁但无法获取时,它只是进入队列并休眠,同时自动设置一个超时时间,该时间由参数 deadlock_timeout deadlock_timeout 时间单位后等待仍未结束,等待的进程将被唤醒并启动检查1s)
本质上,检查过程就是构建等待图并在其中查找环
如果检查未发现死锁,进程将再次休眠;迟早会轮到它继续执行。
如果检测到死锁,其中一个事务将被强制中止,以释放其持有的锁,使其他事务能够继续运行。大多数情况下,被中止的是发起检查的事务,但如果环中包含未因事务计数器溢出而冻结的自动清理工作进程,则自动清理将被中止,因其优先级较低。
死锁通常意味着应用程序设计不当。可以通过两种方式发现此类情况:首先,服务器日志中会出现相关消息;其次,pg_stat_database 表中的 deadlocks 值会增加。
行更新导致的死锁 尽管最终导致死锁的是重锁,但最常见的原因是表行的加锁顺序不一致。
假设第一个事务准备将 100 ₽ 从第一个账户转账到第二个账户。为此,它首先减少第一个账户的余额:
=> BEGIN;
=> UPDATE accounts SET amount = amount - 100.00 WHERE id = 1;
UPDATE 1
与此同时,第二个事务准备将 10 ₽ 从第二个账户转账到第一个账户。它从减少第二个账户余额开始:
=> BEGIN;
=> UPDATE accounts SET amount = amount - 10.00 WHERE id = 2;
UPDATE 1
现在第一个事务尝试增加第二个账户余额,但发现该行已被锁定:
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 2; 随后第二个事务尝试增加第一个账户余额,但同样被阻塞:
=> UPDATE accounts SET amount = amount + 10.00 WHERE id = 1; 出现了循环等待,这种情况无法自行结束。一秒钟后,第一个事务因无法访问资源而发起死锁检查,被服务器中止:
ERROR:  deadlock detected
DETAIL:  Process 65884 waits for ShareLock on transaction 191470;
blocked by process 66190.
Process 66190 waits for ShareLock on transaction 191469; blocked by
process 65884.
HINT:  See server log for query details.
CONTEXT:  while updating tuple (0,2) in relation "accounts"
现在第二个事务可以继续执行。它被唤醒并执行更新:
完成事务。
正确执行此类操作的方法是始终以相同的顺序锁定资源。例如,在本例中,可以按账户编号升序锁定账户。
两条 UPDATE 语句之间的死锁 有时,死锁看似不可能发生,但仍然会出现。
我们通常习惯将 SQL 命令视为原子操作。但以 UPDATE 为例,该命令是逐行更新并逐行加锁(而非一次性锁定所有行),且这一过程并非瞬时完成。因此,如果一个 UPDATE 命令以某种顺序更新多行,而另一个以不同顺序更新,它们就可能发生相互阻塞。
为了复现该情况,我们创建一个按 amount 列降序排列的索引:
=> CREATE INDEX ON accounts(amount DESC); 为了能观察到过程,我们编写一个延迟函数:
=> CREATE FUNCTION inc_slow(n numeric)
RETURNS numeric
AS $$
  SELECT pg_sleep(1);
  SELECT n + 100.00;
$$ LANGUAGE sql;
第一个 UPDATE 命令将更新整个表。执行计划为全表顺序扫描:
=> EXPLAIN (costs off)
  UPDATE accounts SET amount = inc_slow(amount);
        QUERY PLAN
---------------------------
 Update on accounts
   -> Seq Scan on accounts
(2 rows)
我们将表中行版本按金额升序排列。为此,我们将它们重新插入已清空的表中:
=> TRUNCATE accounts;
=> INSERT INTO accounts(id, client, amount)
VALUES (1,'alice',100.00),
       (2,'bob',200.00),
       (3,'charlie',300.00);
=> ANALYZE accounts;
=> SELECT ctid, * FROM accounts;
 ctid  | id | client  | amount
-------+----+---------+--------
 (0,1) |  1 | alice   | 100.00
 (0,2) |  2 | bob     | 200.00
 (0,3) |  3 | charlie | 300.00
(3 rows)
在顺序扫描过程中,行将按相同顺序被更新(对于大表,这并非总是成立)。(参见 198 )
启动更新操作:
=> UPDATE accounts SET amount = inc_slow(amount); 在它运行期间,我们在另一个会话中禁止使用顺序扫描:
=> SET enable_seqscan = off; 此时,查询规划器将决定对下一个 UPDATE 操作使用索引扫描:
=> EXPLAIN (costs off)
  UPDATE accounts SET amount = inc_slow(amount)
  WHERE amount > 100.00;
                      QUERY PLAN
-------------------------------------------------------
 Update on accounts
   -> Index Scan using accounts_amount_idx on accounts
       Index Cond: (amount > 100.00)
(3 rows)
符合条件的是第二行和第三行,且由于索引按金额降序构建,行将按逆序更新。
启动下一个更新操作:
=> UPDATE accounts SET amount = inc_slow(amount)
WHERE amount > 100.00;
通过 pgrowlocks 扩展查看表页面,我们会发现第一个操作已更新第一行(0,1),而第二个操作已更新最后一行(0,3):
=> SELECT locked_row, locker, modes FROM pgrowlocks('accounts');
 locked_row | locker |       modes
------------+--------+-------------------
 (0,1)      | 191476 | {"No Key Update"}    ← первый
 (0,3)      | 191477 | {"No Key Update"}    ← второй
(2 rows)
又过了一秒。第一个操作更新了第二行,而第二个操作想更新它,但无法实现。
=> SELECT locked_row, locker, modes FROM pgrowlocks('accounts');
 locked_row | locker |       modes
------------+--------+-------------------
 (0,1)      | 191476 | {"No Key Update"}
 (0,2)      | 191476 | {"No Key Update"}    ← первый успел раньше
 (0,3)      | 191477 | {"No Key Update"}
(3 rows)
现在第一个操作想更新表的最后一行,但它已被第二个操作锁定。死锁发生了。
其中一个事务被中止:
ERROR:  deadlock detected
DETAIL:  Process 66267 waits for ShareLock on transaction 191476;
blocked by process 66190.
Process 66190 waits for ShareLock on transaction 191477; blocked by
process 66267.
HINT:  See server log for query details.
CONTEXT:  while updating tuple (0,2) in relation "accounts"
另一个事务完成执行:
尽管看似难以置信,但在高负载系统中批量更新行时,此类情况确实会发生。