12 关系级锁
PostgreSQL 18 · 基于俄文 PG18 原版的简体中文译本
12.1. 关于锁
锁(locks),也称为 锁,用于协调对共享资源的并发访问。
并发访问指的是多个进程同时访问某个资源。这些进程可以并行执行(如果硬件允许),也可以在时间分片模式下顺序执行——这并不重要。如果没有竞争,就不需要锁(例如,共享缓冲区缓存需要锁,而本地缓存则不需要)。
在访问资源之前,进程必须 获取(acquire)与该资源关联的锁,而在完成工作后必须 释放(release)它,以便其他进程可以使用该资源。当锁由数据库管理系统(DBMS)管理时,这种顺序会自动维护;如果锁由应用程序设置,则必须由应用程序自身遵守规则。
在底层,锁表现为共享内存中的一段区域,其中以某种方式标记锁的状态(空闲或已被获取),并可能包含额外信息(如进程号和获取时间)。
可以注意到,这段共享内存本身也是一个资源。对它的并发访问通过操作系统提供的特殊同步原语(如信号量或互斥锁)来协调。这些原语确保访问共享资源的代码严格按顺序执行。在最低层,这些原语
是基于处理器的原子指令(如 test-and-set 或 compare-and-swap)实现的。
原则上,任何可以唯一标识并映射到锁地址的资源都可以作为受保护的资源。
例如,资源可以是数据库正在操作的对象,如表(通过系统目录中的 oid 标识)、数据页面(通过文件名和文件内位置标识)、行版本(通过页面和页面内偏移标识)。资源也可以是内存中的结构,如哈希表或缓冲区(通过预先分配的编号标识)。有时甚至方便使用没有实际物理意义的抽象资源。
锁的获取并非总是可行:资源可能已被其他进程占用。此时,进程要么进入队列(如果锁机制支持),要么在一段时间后重试获取。无论如何,这都会导致进程必须等待资源释放。
我将强调两个显著影响锁效率的因素。
粒度——锁的细化程度。当资源具有层次结构时,粒度尤为重要。
例如,表由页组成,页包含行版本。这些对象都可以作为资源。如果在表级别设置锁(粗粒度),即使多个进程访问不同的页或行,也无法同时工作。
行级锁(细粒度)没有这一缺点,但锁的数量会显著增加。为了防止这些信息占用过多内存,可以采用各种方法,例如 升级(escalation):当低级别、细粒度锁的数量超过某个阈值时,它们会被一个更高级别的锁所替代。
锁模式集合,即锁可以被获取的模式。
通常只使用两种模式。排他(exclusive)或 独占 模式与任何其他模式(包括自身)都不兼容。共享(shared)模式允许多个进程同时获取锁。共享模式通常用于读取资源,而排他模式用于修改资源。
一般情况下,模式可以更多。模式名称本身并不重要,重要的是它们之间的兼容性矩阵。
粒度越细、可兼容的模式越多,就越能实现并行化。
锁可以根据使用时间进行分类。
长期锁可能持有很长时间(通常直到事务结束),通常用于关系和行等资源。数据库系统通常自动管理这些锁,但用户仍可在某种程度上控制该过程。
长期锁具有较多模式,允许对数据执行多种并发操作。通常这类锁配有完善的基础设施(等待队列、死锁检测、监控),因为维护这些机制的成本远低于保护数据的操作成本。
短期锁持有时间仅为几毫秒(通常仅为执行几条处理器指令的时间),通常用于共享内存中的数据结构。数据库系统完全自动管理这些锁。
短期锁的特点是模式最少,基础设施简单,甚至可能没有监控机制。
PostgreSQL 使用多种类型的锁1。长期锁包括 重锁(在关系及其他对象级别);单独列出 行级锁。短期锁包括各种 内存结构上的锁。特别的是 谓词锁,尽管名称如此,但它们并非真正的锁。(参见 268)(参见 305)(参见 298)
12.2. 重锁
重锁(heavyweight)属于长期锁。它们在 对象 级别设置:主要是关系,但也包括其他一些对象。这些锁通常用于防止对象被同时修改或在重组期间被使用,但也可能用于其他用途。这种模糊的定义源于这些锁被用于各种不同目的,而它们的共同点仅在于其结构方式。
通常,当未明确说明时,“锁”指的就是这种重锁。
重锁位于服务器的共享内存中 2,可通过 pg_locks 视图查看。其数量受限于两个服务器参数值的乘积:max_locks_per_transaction 和 max_connections。(默认值:64)(默认值:100)
锁池对所有事务共享,即一个事务可以获取超过 max_locks_per_transaction 数量的锁。重要的是系统中锁的总数不超过设定上限。锁池在服务器启动时创建,因此修改任一参数都需要重启服务器。
如果资源已被不兼容模式的锁占用,试图获取锁的进程将被放入队列。等待的进程不消耗 CPU 时间:它们休眠,并在资源释放时由操作系统唤醒。
可能发生 死锁(deadlock),即两个事务陷入 僵局,其中第一个事务需要第二个事务占用的资源,而第二个事务又需要第一个事务占用的资源。这是最简单的情况;多个事务也可能陷入僵局。由于死锁会导致无限等待,PostgreSQL 会自动检测僵局并强制中止其中一个事务,以使其他事务得以继续执行。(参见 286)
由于不同类型的重锁服务于不同目的,保护不同的资源,并具有不同的模式,因此每种类型都需单独讨论。
以下列表中的名称对应 pg_locks 视图中 locktype 列的值:
transactionid 和 virtualxid —— 事务编号锁;(参见 259)
relation —— 关系锁;(参见 261)
tuple —— 行版本锁;(参见 275)
object —— 非关系对象的锁;(参见 293)
extend —— 在向关系文件添加新页面时的文件锁;(参见 295)
page —— 页面锁(某些索引类型使用);(参见 296)
advisory —— 建议性锁。(参见 296)
几乎所有重锁都是在需要时自动设置,并在事务结束时自动释放。例外情况包括:关系锁可以显式请求,而建议性锁的管理完全由用户控制。
12.3. 事务 ID 上的锁
每个事务始终持有其自身编号(虚拟和真实,若存在)的排他锁。(参见 91)
使用两种锁模式:排他和共享。冲突矩阵非常简单:共享模式与自身兼容;排他模式与任何模式都不兼容。
| 模式 | Shared | Exclusive |
|---|---|---|
| Shared | × | |
| Exclusive | × | × |
要等待某个事务结束,只需请求其编号的锁(任意模式)。由于该事务本身已持有其编号的排他锁,因此无法获取。请求进程将进入队列并休眠。当事务结束时,锁被释放,等待的进程将被唤醒。当然,它无法获取所请求的锁——资源已不存在。但这并非必需。
在独立会话中启动一个事务并获取其服务进程编号:
刚刚启动的事务持有其自身虚拟编号的排他锁:
此处 locktype 为锁类型,virtualxid 为事务的虚拟编号(标识资源),mode 为模式(此处为排他)。granted 标志显示是否成功获取了请求的锁。
当事务获得真实编号时,其锁也会被添加到列表中:
现在事务持有其两个编号的排他锁。
12.4. 关系级锁
关系锁定义了八种不同的模式3。如此多的模式是为了尽可能让针对同一关系(表、索引或其他对象)的多种命令能够并发执行。
下图展示了冲突矩阵,并附有需要相应锁模式的命令示例。没有必要试图记忆这些模式或在它们的名称中寻找逻辑。但仔细研究这张表,得出一般性结论,并在需要时查阅——毫无疑问,这是值得的。
| 模式 | AS | RS | RE | SUE | S | SRE | E | AE | 命令 |
|---|---|---|---|---|---|---|---|---|---|
| Access Share | × | SELECT | |||||||
| Row Share | × | × | SELECT FOR UPDATE/SHARE | ||||||
| Row Exclusive | × | × | × | × | INSERT, UPDATE, DELETE | ||||
| Share Update Exclusive | × | × | × | × | × | VACUUM, CREATE INDEX CONCURRENTLY | |||
| Share | × | × | × | × | × | CREATE INDEX | |||
| Share Row Exclusive | × | × | × | × | × | × | CREATE TRIGGER | ||
| Exclusive | × | × | × | × | × | × | × | REFRESH MAT. VIEW CONCURRENTLY | |
| Access Exclusive | × | × | × | × | × | × | × | × | DROP, TRUNCATE, VACUUM FULL, LOCK TABLE, REFRESH MAT. VIEW |
第一个模式 Access Share 是最弱的。它与除最后一个模式 Access Exclusive 外的任何其他模式都兼容。因此,SELECT 命令几乎不会妨碍其他命令的执行,但例如,它不会允许删除正在被查询访问的表。相反,Access Exclusive 模式是最严格的:它与任何其他模式都不兼容,即具有排他性。
前四种模式允许同时对表中的数据进行修改,而后四种模式则不允许。例如,CREATE INDEX 命令使用 Share 模式。该模式与自身兼容(即可以同时为同一张表创建多个索引),也与读取类命令的模式兼容。因此,SELECT 命令可以执行,但 INSERT、UPDATE 和 DELETE 命令将被阻塞。
相反,正在修改表中数据的未完成事务将阻塞 CREATE INDEX 命令的执行。因此,存在 CREATE INDEX CONCURRENTLY 选项,它使用较弱的 Share Update Exclusive 模式:该命令创建索引的时间比普通命令更长(甚至可能失败),但允许同时进行数据修改。
ALTER TABLE 命令有多种变体,需要不同的锁模式(Share Update Exclusive、Share Row Exclusive、Access Exclusive)。当然,所有模式都在文档中都有描述4。
本章中的示例将使用我们已熟悉的账户表:
查询锁表的操作还会多次用到,因此我们为它创建一个视图,将所有标识符合并为一个简短输出的通用列:
第一个会话中的事务(尚未结束)正在更新一行。与表一起,该表的所有索引也被锁定,因此出现了两个类型为 relation、模式为 Row Exclusive 的新锁:
12.5. 等待队列
重锁提供“公平”的等待队列5。如果一个进程试图获取与已持有锁的模式不兼容,或与队列中已有等待进程的模式不兼容的锁,它就会进入等待队列。
当第一个会话中的事务正在执行更新时,尝试在另一个会话中为该表创建索引:
该命令“挂起”以等待资源释放。事务试图以 Share 模式获取表锁,但无法成功:
现在,假设在第三个会话中启动了 VACUUM FULL 命令。它也会进入队列,因为其所需的 Access Exclusive 模式与任何其他模式都不兼容:
现在,所有后续请求者都将进入队列,无论其锁模式如何。即使普通的 SELECT 查询也会诚实地排在 VACUUM FULL 之后,尽管它们与第一个会话中执行 UPDATE 命令所持有的 Row Exclusive 锁是兼容的。
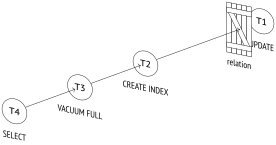
函数 pg_blocking_pids 可以提供等待情况的总体视图。它显示了在指定进程之前排队的进程编号,这些进程要么持有不兼容的锁,要么正在请求不兼容的锁:
更详细的视图可以通过仔细分析 pg_locks 表的内容获得6。
当事务结束(无论通过提交还是回滚)时,其所有锁都会被释放7。队列中的第一个进程将获得所需的锁并被唤醒。
一个不明显的情况是,当回滚到保存点(通过 ROLLBACK TO SAVEPOINT 命令或进入 PL/pgSQL 块的 EXCEPTION 部分)时,事务自该保存点以来获取的所有锁都会被释放。这是由于嵌套事务的回滚及其锁的释放所致。
在我们的示例中,第一个会话中事务的结束将导致队列中所有查询的依次执行:(参见 92)
postgrespro.ru/docs/postgresql/18/explicit-locking#LOCKING-TABLES. ↩︎
backend/storage/lmgr/lock.c, 函数 LockAcquire. ↩︎
backend/storage/lmgr/lock.c, 函数 LockReleaseAll 和 LockRelease. ↩︎