# 自动清理
LLMS 索引: [llms.txt](/zh18/llms.txt)
---
## 7.1. 自动清理和分析 {#internal-ru-section-7-1}
只要数据库视界定期向前推进,常规清理就能完成自己的工作。问题在于,应该多久调用一次。
如果对经常变化的表清理得太少,它会膨胀到不希望的大小。此外,表中可能积累太多变化,下一次清理就不得不多次扫描索引。
如果清理过于频繁,服务器就会一直忙于维护,而不是做有用的工作。
工作负载还会随时间变化,所以按固定时间表启动清理无论如何都不合适:表更新越频繁,清理也应越频繁。
这个问题由*自动清理*[^internal-ru-139-1]解决:它根据表的变化速度调整清理和分析的触发频率。
### 自动清理的工作机制 {#internal-ru-subsection-star-106}
启用自动清理(配置参数 *autovacuum*)后,系统中始终有一个负责调度的 autovacuum launcher 进程。它依据使用统计维护一个包含活动数据库的列表。这些统计信息由 *track\_counts* 参数启用时收集。不要关闭这两个参数,否则自动清理将无法工作。(*默认值:* `on`)(*默认值:* `on`)
每隔 *autovacuum\_naptime* 个时间单位,autovacuum launcher(照例通过 postmaster)会为列表中每个“活跃”数据库启动一个 autovacuum worker[^internal-ru-140-1]。因此,如果集群中使用了 *N* 个数据库,那么在一个 *autovacuum\_naptime* 间隔内会启动 *N* 个工作进程。不过,同时运行的工作进程总数受 *autovacuum\_max\_workers* 参数限制。(*默认值:* `1min`)(*默认值:* `3`)
工作进程数量上限可以在线调整,但只能在 *autovacuum\_worker\_slots* 范围内。调整槽位数量则需要重启服务器,因为这会为共享内存预留空间。(v. 18)(*默认值:* `16`)(*第 [379](/zh18/18-table-access-methods/#internal-ru-page-380) 页*)
> [!NOTE]
> 自动清理工作进程与后台工作进程很相似,但早在通用任务机制创建前就已出现。自动清理进程的实现没有改变,因此它们不会占用 *max\_worker\_processes* 的槽位。
工作进程启动后会连接指定的数据库,先建立两个列表:
- 需要清理的全部表、物化视图和 TOAST 表;
- 需要分析的全部表和物化视图(TOAST 表不分析,因为它们总是通过索引访问)。
随后,工作进程依次清理或分析选中的对象(也可能两种操作都执行),完成后退出。
每个表的清理方式与手动执行 `VACUUM` 命令相同,但有一些差异:
- 手动清理使用大小为 *maintenance\_work\_mem* 的内存片段来累积行版本标识符。
自动清理可能同时运行多个工作进程,每个进程都需要内存。因此,自动清理使用单独的 *autovacuum\_work\_mem* 参数。默认情况下它采用普通的 *maintenance\_work\_mem* 限制;如果配置中有较多工作进程(*autovacuum\_max\_workers*),通常需要相应调整这个值。(*默认值:* `-1`)
- 手动清理可以并行处理同一张表上的多个索引,而自动清理不行,否则可能同时启动过多进程。
如果某个工作进程没能在 *autovacuum\_naptime* 间隔内完成预定任务,autovacuum launcher 会向同一个数据库再派出一个工作进程,让它们并行工作。第二个进程会建立自己的待清理和待分析对象列表并开始处理。只有*不同*的表可以并行处理;同一张表没有并行性。
### 哪些表需要清理 {#internal-ru-subsection-star-108}
可以在单个表的层面禁用自动清理,尽管很难想到这样做的理由。为此有两个存储参数,一个用于普通表,另一个用于 TOAST 表:
- *autovacuum\_enabled*;
- *toast.autovacuum\_enabled*。
通常,自动清理会在死行版本或新行积累到一定数量时触发。(*第 [153](/zh18/07-autovacuum/#internal-ru-page-154) 页*)
**死行版本。** 死行版本的近似数量会持续跟踪,并可在 `pg_stat_all_tables` 表中查看。
当死行版本数量超过由以下三个参数确定的阈值时,就认为需要清理:
- *autovacuum\_vacuum\_threshold*:绝对值(数量);(*默认值:* `50`)
- *autovacuum\_vacuum\_scale\_factor*:表中行的比例;(*默认值:* `0.2`)
- *autovacuum\_vacuum\_max\_threshold*:针对超大表的额外阈值上限。(*默认值:* `1 亿`)(v. 18)
公式如下:当满足以下条件时,需要清理死行版本:
$$
\begin{gathered}\texttt{pg\_stat\_all\_tables.n\_dead\_tup} > \\ \mathit{autovacuum\_vacuum\_threshold} + \\ \mathit{autovacuum\_vacuum\_scale\_factor} \times \texttt{pg\_class.reltuples}\end{gathered}
$$
或者(v. 18)
$$
\begin{gathered}\texttt{pg\_stat\_all\_tables.n\_dead\_tup} > \\ \mathit{autovacuum\_vacuum\_max\_threshold}.\end{gathered}
$$
对于大表(潜在问题主要出现在大表上),公式第一部分中的 *autovacuum\_vacuum\_scale\_factor* 很重要。默认值 20% 似乎高得离谱,很可能需要大幅降低。如果这样得到的阈值对超大表仍然过高,还可以用公式第二部分的参数为它设定上限。
如果无法找到一组适用于所有表的参数值,可以用同名存储参数为特定表覆盖它们(*autovacuum\_vacuum\_threshold*、*autovacuum\_vacuum\_scale\_factor*、*autovacuum\_vacuum\_max\_threshold*)。带有 *toast* 前缀的相应存储参数则决定 TOAST 表的设置。
**插入的行。** 数据仓库常见一种情况:行不断插入,却从不删除或更新。此时表中不会产生死行版本,前面的触发条件也不会满足。但这类表同样需要清理,以便提前冻结行版本并更新可见性映射(从而允许只扫描索引)。因此又增加了一个触发条件。(v. 13)(*第 [422](/zh18/20-index-scans/#internal-ru-page-423) 页*)
如果自上次清理以来插入的行数超过由以下两个参数确定的阈值,就会执行清理:
- *autovacuum\_vacuum\_insert\_threshold*;(*默认值:* `1000`)
- *autovacuum\_vacuum\_insert\_scale\_factor*。(*默认值:* `0.2`)
与死行版本数量一样,插入行数也作为表使用统计的一部分进行跟踪。
公式如下:
$$
\begin{gathered}\texttt{pg\_stat\_all\_tables.n\_ins\_since\_vacuum} > \\ \mathit{autovacuum\_vacuum\_insert\_threshold} + \\ \mathit{autovacuum\_vacuum\_insert\_scale\_factor} \times \texttt{pg\_class.reltuples} \times \\ \left(1-\texttt{pg\_class.relallfrozen}/\texttt{pg\_class.relpages}\right).\end{gathered}
$$
第一个加数只是绝对值,这一点很清楚;第二个加数则需要解释。它计算的不是全部行的比例,而是*未冻结*行的比例;表中相应部分用完全冻结页面数(`relallfrozen`)与页面总数(`relpages`)的比值来估算。原因在于,表不断增大,行数越来越多;没有这个系数,清理的触发频率就会越来越低。而未冻结行的数量会周期性减少,因此触发频率不会增加,这是一件好事。(v. 18)
和前一种情况一样,也可以使用同名存储参数(*autovacuum\_vacuum\_insert\_threshold*、*autovacuum\_vacuum\_insert\_scale\_factor*)及其 TOAST 对应参数,为单独的表覆盖这些值。
### 哪些表需要分析 {#internal-ru-subsection-star-114}
自动分析比清理简单,因为它只考虑发生过变化的行。
如果自上次分析以来修改的行数超过由以下两个参数确定的阈值,就认为需要分析该表:
- *autovacuum\_analyze\_threshold*;(*默认值:* `50`)
- *autovacuum\_analyze\_scale\_factor*。(*默认值:* `0.1`)
自动分析的触发公式为:
$$
\begin{gathered}\texttt{pg\_stat\_all\_tables.n\_mod\_since\_analyze} > \\ \mathit{autovacuum\_analyze\_threshold} + \\ \mathit{autovacuum\_analyze\_scale\_factor} \times \texttt{pg\_class.reltuples}.\end{gathered}
$$
也可以使用同名存储参数(*autovacuum\_analyze\_threshold* 和 *autovacuum\_analyze\_scale\_factor*)在表级别覆盖自动分析设置。TOAST 表不参与分析,因此没有对应参数。
### 自动清理实战 {#internal-ru-subsection-star-116}
先写一个返回参数当前值的函数:
```text {label="psql"}
=> CREATE FUNCTION p(param text, c pg_class) RETURNS float
AS $$
SELECT coalesce(
-- если параметр хранения задан, то берем его
(SELECT option_value
FROM pg_options_to_table(c.reloptions)
WHERE option_name = CASE -- для toast-таблиц имя отличается
WHEN c.relkind = 't' THEN 'toast.' ELSE ''
END || param
),
-- иначе берем значение конфигурационного параметра
current_setting(param)
)::float;
$$ LANGUAGE sql;
```
我们将在视图中使用这个函数,以显示当前哪些表需要清理和分析[^internal-ru-145-1]。这些视图会用于后面的示例,同时也把本节前面的说明形式化。
清理视图可以这样写:
```text {label="psql"}
=> CREATE VIEW need_vacuum AS
WITH c AS (
SELECT c.oid,
greatest(c.reltuples, 0) AS reltuples,
CASE
WHEN c.relpages > 0 THEN
1 - c.relallfrozen::float / c.relpages
ELSE 1
END AS pct_unfrozen,
p('autovacuum_vacuum_threshold', c) AS threshold,
p('autovacuum_vacuum_scale_factor', c) AS scale_factor,
p('autovacuum_vacuum_max_threshold', c) AS max_threshold,
p('autovacuum_vacuum_insert_threshold', c) AS ins_threshold,
p('autovacuum_vacuum_insert_scale_factor', c) AS ins_scale_factor
FROM pg_class c
WHERE c.relkind IN ('r','m','t')
),
r AS (
SELECT st.schemaname || '.' || st.relname AS tablename,
st.n_dead_tup AS dead_tup,
least(
c.threshold + c.scale_factor * c.reltuples,
c.max_threshold
) AS max_dead_tup,
st.n_ins_since_vacuum AS ins_tup,
c.ins_threshold + c.ins_scale_factor * c.reltuples * c.pct_unfrozen
AS max_ins_tup,
st.last_autovacuum
FROM pg_stat_all_tables st
JOIN c ON c.oid = st.relid
)
SELECT *,
CASE
WHEN dead_tup > max_dead_tup OR ins_tup > max_ins_tup
THEN 'Пора!'
END AS is_it_time
FROM r;
```
列 `max_dead_tup` 显示因死行版本触发自动清理的阈值,列 `max_ins_tup` 显示因插入新行触发清理的阈值。
下面是相应的分析视图:
```text {label="psql"}
=> CREATE VIEW need_analyze AS
WITH c AS (
SELECT c.oid,
greatest(c.reltuples, 0) AS reltuples,
p('autovacuum_analyze_threshold', c) AS threshold,
p('autovacuum_analyze_scale_factor', c) AS scale_factor
FROM pg_class c
WHERE c.relkind IN ('r','m')
),
r AS (
SELECT st.schemaname || '.' || st.relname AS tablename,
st.last_autoanalyze,
st.n_mod_since_analyze AS mod_tup,
c.threshold + c.scale_factor * c.reltuples AS max_mod_tup
FROM pg_stat_all_tables st
JOIN c ON c.oid = st.relid
)
SELECT *,
CASE
WHEN mod_tup > max_mod_tup THEN 'Пора!'
END AS is_it_time
FROM r;
```
列 `max_mod_tup` 显示触发自动分析的阈值。
为了不长时间等待自动清理,实验中让该进程每秒运行一次:
```text {label="psql"}
=> ALTER SYSTEM SET autovacuum_naptime = '1s';
=> SELECT pg_reload_conf();
```
清空表 `vac`,再向其中插入 1000 行。提醒一下,表级别的自动清理仍处于关闭状态。
```text {label="psql"}
=> TRUNCATE TABLE vac;
=> INSERT INTO vac(id,s)
SELECT id, 'A' FROM generate_series(1,1000) id;
```
清理视图会显示:
```text {label="psql"}
=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
-[ RECORD 1 ]---+-----------
tablename | public.vac
dead_tup | 0
max_dead_tup | 50
ins_tup | 1000
max_ins_tup | 1000
last_autovacuum |
is_it_time |
```
阈值 `max_dead_tup` = 50,虽然上面的公式给出的结果应该是 50 + 0.2 × 1000 = 250。这是因为表的统计信息还不存在,单独执行 `INSERT` 不会更新统计信息:
```text {label="psql"}
=> SELECT reltuples FROM pg_class WHERE relname = 'vac';
reltuples
-----------
-1
(1 row)
```
`pg_class.reltuples` 的特殊常量 −1 用于区分没有统计信息的表和已经分析过、但确实为空的表;后者的这个列值为零。计算时会把负值当作零,因此得到 50 + 0.2 × 0 = 50。(v. 14)
同理,`max_ins_tup` = 1000 与计算得到的 1200 不同。
再看一下分析视图:
```text {label="psql"}
=> SELECT * FROM need_analyze WHERE tablename = 'public.vac' \gx
-[ RECORD 1 ]----+-----------
tablename | public.vac
last_autoanalyze |
mod_tup | 1006
max_mod_tup | 50
is_it_time | Пора!
```
我们修改了 1000 行(这里是插入),这超过了当前按未知表大小计算出的 50 行阈值。因此,自动分析应该会触发。
现在重新启用自动清理:
```text {label="psql"}
=> ALTER TABLE vac SET (autovacuum_enabled = on);
```
短暂等待后,表已经完成分析,阈值也修正为正确的 150 行:
```text {label="psql"}
=> SELECT reltuples FROM pg_class WHERE relname = 'vac';
reltuples
-----------
1000
(1 row)
=> SELECT * FROM need_analyze WHERE tablename = 'public.vac' \gx
-[ RECORD 1 ]----+------------------------------
tablename | public.vac
last_autoanalyze | 2026-04-05 20:52:06.591521+03
mod_tup | 0
max_mod_tup | 150
is_it_time |
```
回到自动清理:
```text {label="psql"}
=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
-[ RECORD 1 ]---+-----------
tablename | public.vac
dead_tup | 0
max_dead_tup | 250
ins_tup | 1000
max_ins_tup | 1200
last_autovacuum |
is_it_time |
```
根据分析过程中得到的表大小,`max_dead_tup` 和 `max_ins_tup` 的值也修正了。
现在,清理会在以下两种情况之一发生时执行:
- 产生超过 250 个死行版本;
- 向表中插入超过 200 行。(v. 13)
再次关闭自动清理,并更新 251 行,比阈值多一行:
```text {label="psql"}
=> ALTER TABLE vac SET (autovacuum_enabled = off);
=> UPDATE vac SET s = 'B' WHERE id % 4 = 0 OR id = 1;
UPDATE 251
=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
-[ RECORD 1 ]---+-----------
tablename | public.vac
dead_tup | 251
max_dead_tup | 250
ins_tup | 1000
max_ins_tup | 1200
last_autovacuum |
is_it_time | Пора!
```
现在触发条件已经满足。启用自动清理,短暂等待后可以看到表已处理,使用统计也已重置:
```text {label="psql"}
=> ALTER TABLE vac SET (autovacuum_enabled = on);
=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
-[ RECORD 1 ]---+------------------------------
tablename | public.vac
dead_tup | 0
max_dead_tup | 250
ins_tup | 0
max_ins_tup | 1200
last_autovacuum | 2026-04-05 20:52:11.763126+03
is_it_time |
```
## 7.2. 冻结 {#internal-ru-section-7-2}
创建一张新表来实验冻结。把 *fillfactor* 设为最小值,使每个页面只能容纳两行,这样更容易观察过程。和前面一样,关闭自动清理,以便自行控制清理时机。
```text {label="psql"}
=> CREATE TABLE tfreeze(
id integer,
s char(300)
) WITH (fillfactor = 10, autovacuum_enabled = off);
```
再写一个使用 `pageinspect` 扩展查看页面的函数版本。它会显示一段页面范围,解码冻结标志(`f`),并显示事务 `xmin` 的年龄(为此要调用系统函数 `age`;年龄本身当然不会存储在数据页面中):
```text {label="psql"}
=> CREATE FUNCTION heap_page(
relname text, pageno_from integer, pageno_to integer
)
RETURNS TABLE(
ctid tid, state text,
xmin text, xmin_age integer, xmax text
) AS $$
SELECT (pageno,lp)::text::tid AS ctid,
CASE lp_flags
WHEN 0 THEN 'unused'
WHEN 1 THEN 'normal'
WHEN 2 THEN 'redirect to '||lp_off
WHEN 3 THEN 'dead'
END AS state,
t_xmin || CASE
WHEN (t_infomask & 256+512) = 256+512 THEN ' f'
WHEN (t_infomask & 256) > 0 THEN ' c'
WHEN (t_infomask & 512) > 0 THEN ' a'
ELSE ''
END AS xmin,
age(t_xmin) AS xmin_age,
t_xmax || CASE
WHEN (t_infomask & 1024) > 0 THEN ' c'
WHEN (t_infomask & 2048) > 0 THEN ' a'
ELSE ''
END AS xmax
FROM generate_series(pageno_from, pageno_to) p(pageno),
heap_page_items(get_raw_page(relname, pageno))
ORDER BY pageno, lp;
$$ LANGUAGE sql;
```
向表中插入一些行,并立即执行清理,以便创建可见性映射:
```text {label="psql"}
=> CREATE EXTENSION IF NOT EXISTS pg_visibility;
=> INSERT INTO tfreeze(id, s)
SELECT id, 'FOO'||id FROM generate_series(1,100) id;
INSERT 0 100
=> VACUUM tfreeze;
```
通过 `pg_visibility` 扩展观察前两个页面。清理完成后,这两个页面都会在可见性映射中标记为 `all_visible`,但不会标记为 `all_frozen`,因为其中仍有未冻结的行版本:
```text {label="psql"}
=> SELECT *
FROM generate_series(0,1) g(blkno),
pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
blkno | all_visible | all_frozen
-------+-------------+------------
0 | t | f
1 | t | f
(2 rows)
```
创建这些行的事务的 `xmin_age` 为 1,因为它是系统中最近执行的事务:
```text {label="psql"}
=> SELECT * FROM heap_page('tfreeze',0,1);
ctid | state | xmin | xmin_age | xmax
-------+--------+-------+----------+------
(0,1) | normal | 877 c | 1 | 0 a
(0,2) | normal | 877 c | 1 | 0 a
(1,1) | normal | 877 c | 1 | 0 a
(1,2) | normal | 877 c | 1 | 0 a
(4 rows)
```
## 7.3. 管理冻结 {#internal-ru-section-7-3}
冻结由四个主要配置参数控制。这四个参数都表示事务年龄,并确定从什么时候开始发生以下事件:
- 行版本开始冻结:*vacuum\_freeze\_min\_age*;
- 执行激进冻结:*vacuum\_freeze\_table\_age*;
- 冻结紧急触发:*autovacuum\_freeze\_max\_age*;
- 冻结进入优先模式:*vacuum\_failsafe\_age*。(v. 14)
### 冻结的最小年龄 {#internal-ru-subsection-star-118}
`xmin` 事务的最小年龄由 *vacuum\_freeze\_min\_age* 参数确定,只有达到这个年龄,行版本才可以冻结。值越小,开销可能越大:如果一行很“热”并且频繁变化,那么冻结它不断产生的新版本就会白费力气。把参数设得相对大一些,可以先等待一段时间。(*默认值:* `5000 万`)
> [!NOTE]
> 如果手动调用 `VACUUM FREEZE`,所有行版本都会被冻结,不考虑事务年龄,就好像 *vacuum\_freeze\_min\_age* = 0 一样。这正是前面示例中连刚刚创建的行版本也被冻结的原因。
为了观察冻结过程,把它的值降为 1:(*第 [136](/zh18/06-vacuum-and-freezing/#internal-ru-page-137) 页*)
```text {label="psql"}
=> ALTER SYSTEM SET vacuum_freeze_min_age = 1;
=> SELECT pg_reload_conf();
```
现在更新第 0 页上的一行。由于 *fillfactor* 值很小,新的行版本会进入同一个页面:
```text {label="psql"}
=> UPDATE tfreeze SET s = 'BAR' WHERE id = 1;
```
事务年龄增加了 1。现在表页面如下:
```text {label="psql"}
=> SELECT * FROM heap_page('tfreeze',0,1);
ctid | state | xmin | xmin_age | xmax
-------+--------+-------+----------+------
(0,1) | normal | 877 c | 2 | 878
(0,2) | normal | 877 c | 2 | 0 a
(0,3) | normal | 878 | 1 | 0 a
(1,1) | normal | 877 c | 2 | 0 a
(1,2) | normal | 877 c | 2 | 0 a
(5 rows)
```
现在,年龄大于 *vacuum\_freeze\_min\_age* = 1 的行版本可以冻结。但清理只处理未在可见性映射中标记的页面:(*第 [131](/zh18/06-vacuum-and-freezing/#internal-ru-page-132) 页*)
```text {label="psql" hl_lines="7"}
=> SELECT *
FROM generate_series(0,1) g(blkno),
pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
blkno | all_visible | all_frozen
-------+-------------+------------
0 | f | f
1 | t | f
(2 rows)
```
> [!NOTE]
> 只有在连续至少有 32 个页面都被可见性映射标记时,清理才会跳过这些页面[^internal-ru-153-1]。如果标志交替出现得更频繁,清理就会忽略可见性映射:跳过单独的页面没有多大意义,因为预取会让它们无论如何进入内存。因此,虽然实验只关注两个页面,`tfreeze` 表仍然创建得足够大。
前面的 `UPDATE` 命令清除了第 0 页的可见性位,而第 1 页会被清理跳过:
```text {label="psql" hl_lines="7 8"}
=> VACUUM tfreeze;
VACUUM
=> SELECT * FROM heap_page('tfreeze',0,1);
ctid | state | xmin | xmin_age | xmax
-------+---------------+-------+----------+------
(0,1) | redirect to 3 | | |
(0,2) | normal | 877 f | 2 | 0 a
(0,3) | normal | 878 f | 1 | 0 a
(1,1) | normal | 877 c | 2 | 0 a
(1,2) | normal | 877 c | 2 | 0 a
(5 rows)
```
注意,第 0 页上的两个行版本都被冻结了,虽然第二个版本的事务 `xmin` 年龄没有超过 *vacuum\_freeze\_min\_age*。既然页面本来就必须修改,位于数据库视界之外的所有行版本都会在该页面上被冻结;这几乎不会增加操作成本,却可能为将来省下工作。(v. 16)
现在两个页面又都在可见性映射中标记了。虽然第 1 页包含未冻结的行版本,但只要它没有发生变化,清理就会跳过它:
```text {label="psql" hl_lines="7"}
=> SELECT * FROM generate_series(0,1) g(blkno),
pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
blkno | all_visible | all_frozen
-------+-------------+------------
0 | t | t
1 | t | f
(2 rows)
```
### 激进冻结的年龄 {#internal-ru-subsection-star-120}
由此可见,如果页面中只剩下在所有快照中都可见的当前行版本,清理就不会冻结它们。*vacuum\_freeze\_table\_age* 参数可以解决这个问题:当事务年龄达到该值时,清理会忽略可见性映射并冻结所有页面,从而避免事务计数器回卷的后果。这种清理模式称为激进清理;由于它的主要任务是冻结,我也会使用“激进冻结”这个术语。(*默认值:* `1.5 亿`)(*第 [134](/zh18/06-vacuum-and-freezing/#internal-ru-page-135) 页*)
系统目录为每张表保存一个事务编号,并且已知所有早于该事务的事务都已经保证冻结:
```text {label="psql"}
=> SELECT relfrozenxid, age(relfrozenxid)
FROM pg_class WHERE relname = 'tfreeze';
relfrozenxid | age
--------------+-----
877 | 2
(1 row)
```
清理会将这个已保存事务的年龄与 *vacuum\_freeze\_table\_age* 的值比较,以决定是否进行激进冻结。
有了冻结映射,清理时就不必扫描整张表,只需检查尚未在映射中标记的页面。冻结映射不仅显著减少工作量,还能抵御中断:如果清理进程停止后重新开始,就不必返回上一次已经处理并在映射中标记的页面。
要冻结整张表,把 *vacuum\_freeze\_table\_age* 降到 2,使激进冻结条件成立:
```text {label="psql"}
=> ALTER SYSTEM SET vacuum_freeze_table_age = 2;
=> SELECT pg_reload_conf();
```
执行清理:
```text {label="psql" hl_lines="2 7"}
=> VACUUM VERBOSE tfreeze;
INFO: aggressively vacuuming "internals.public.tfreeze"
INFO: finished vacuuming "internals.public.tfreeze": index scans: 0
pages: 0 removed, 50 remain, 50 scanned (100.00% of total), 0 eagerly
scanned
tuples: 0 removed, 100 remain, 0 are dead but not yet removable
removable cutoff: 879, which was 0 XIDs old when operation ended
new relfrozenxid: 879, which is 2 XIDs ahead of previous value
frozen: 48 pages from table (96.00% of total) had 96 tuples frozen
visibility map: 0 pages set all-visible, 48 pages set all-frozen (48
were all-visible)
index scan not needed: 0 pages from table (0.00% of total) had 0 dead
item identifiers removed
avg read rate: 0.000 MB/s, avg write rate: 0.000 MB/s
buffer usage: 116 hits, 0 reads, 0 dirtied
WAL usage: 97 records, 0 full page images, 6615 bytes, 0 buffers full
system usage: CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
VACUUM
```
现在,激进清理会检查整张表,因此可以推进冻结事务编号:页面中已经保证不存在更老的未冻结事务。
```text {label="psql"}
=> SELECT relfrozenxid, age(relfrozenxid)
FROM pg_class WHERE relname = 'tfreeze';
relfrozenxid | age
--------------+-----
879 | 0
(1 row)
```
当然,第 1 页上的所有行版本现在都已冻结:
```text {label="psql" hl_lines="7 8"}
=> SELECT * FROM heap_page('tfreeze',0,1);
ctid | state | xmin | xmin_age | xmax
-------+---------------+-------+----------+------
(0,1) | redirect to 3 | | |
(0,2) | normal | 877 f | 2 | 0 a
(0,3) | normal | 878 f | 1 | 0 a
(1,1) | normal | 877 f | 2 | 0 a
(1,2) | normal | 877 f | 2 | 0 a
(5 rows)
```
此外,第 1 页也已经在冻结映射中标记:
```text {label="psql" hl_lines="7"}
=> SELECT * FROM generate_series(0,1) g(blkno),
pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
blkno | all_visible | all_frozen
-------+-------------+------------
0 | t | t
1 | t | t
(2 rows)
```
整张表的激进冻结执行频率不会高于每 *vacuum\_freeze\_table\_age* − *vacuum\_freeze\_min\_age* 个事务一次(参数取默认值时为每 1 亿个事务一次)。如果非激进清理也能推进 `relfrozenxid`,它的实际触发频率还会更低[^internal-ru-156-1]。无论如何都要注意,*vacuum\_freeze\_min\_age* 设得过大,可能导致激进冻结过度触发并增加开销,反而达不到节省的目的。(v. 15)
### 自动清理紧急触发的年龄 {#internal-ru-subsection-star-122}
有时,前面两个参数仍不足以让行版本及时冻结。可以关闭自动清理,也可以完全不运行常规清理(这当然不应该做,但技术上可行)。此外,还可能有表没有进入自动清理队列,或者存在自动清理根本不会访问的不活跃数据库(例如 `template0`)。为此,PostgreSQL 提供了以激进模式紧急触发自动清理的机制,可以避免事务计数器回卷。(*第 [139](/zh18/07-autovacuum/#internal-ru-page-140) 页*)
当数据库中某个未冻结事务的年龄可能超过 *autovacuum\_freeze\_max\_age* 时,数据库级激进清理会紧急启动[^internal-ru-157-1]。即使关闭自动清理,它也会启动,只是不是立刻,而是在第一次手动执行清理或重启服务器时启动。(*默认值:* `2 亿`)
决定是否紧急触发的是数据库中所有表的 `pg_class.relfrozenxid` 中最老事务的年龄,因为所有更老的事务都已经保证冻结。该事务编号会记录在系统目录中:
```text {label="psql"}
=> SELECT datname, datfrozenxid, age(datfrozenxid) FROM pg_database;
datname | datfrozenxid | age
-----------+--------------+-----
postgres | 744 | 135
template1 | 744 | 135
template0 | 744 | 135
internals | 744 | 135
(4 rows)
```
`datfrozenxid`
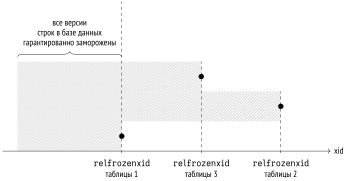
{#internal-ru-fig-7-1 num="7.1" caption="自动清理紧急触发的年龄" .book-original-figure width=692 height=363}
*autovacuum\_freeze\_max\_age* 的上限是 20 亿个事务(略小于圆的一半),默认值小十倍。这样做是有道理的:值过大,会增加这样的风险——在计数器回卷前剩余的时间内,自动清理来不及冻结所有必要的行版本。此时 PostgreSQL 会为避免问题而紧急停止,之后需要管理员介入才能启动。
此外,这个参数还限制了 clog 结构的大小。整个集群中不可能残留比所有数据库中最老的 `datfrozenxid` 更老的未冻结事务,而冻结事务不需要保存状态。多余的 clog 文件段会由自动清理删除[^internal-ru-158-1]。(*第 [85](/zh18/03-pages-and-tuples/#internal-ru-page-86) 页*)
修改 *autovacuum\_freeze\_max\_age* 需要重启服务器。不过,前面讨论的冻结控制参数都可以通过表级存储参数覆盖。注意,这些参数的名称都以“auto”开头:*autovacuum\_freeze\_min\_age*、*autovacuum\_freeze\_table\_age* 和 *autovacuum\_freeze\_max\_age*。
### 优先冻结模式的年龄 {#internal-ru-subsection-star-124}
如果自动清理已经在努力防止事务计数器回卷,却明显来不及,就会触发“保险丝”:自动清理不再考虑 *autovacuum\_vacuum\_cost\_delay*(*vacuum\_cost\_delay*)造成的延迟,也停止清理索引,以尽快冻结行版本。(v. 14)
如果数据库中某个未冻结事务的年龄可能超过 *vacuum\_failsafe\_age*,就会启用优先冻结模式[^internal-ru-158-2]。一般认为这个参数应当高于 *autovacuum\_freeze\_max\_age*。(*默认值:* `16 亿`)
> [!NOTE]
> 手动调用清理时,如果目标不是释放数据页面空间,而是尽快完成冻结,那么也可以禁用索引清理。可以直接执行 `VACUUM (freeze,`
> `index_cleanup false)`,也可以使用 *vacuum\_index\_cleanup* 存储参数。(v. 12)
## 7.4. 积极扫描 {#internal-ru-section-7-4}
当清理不进行激进冻结时,会跳过在可见性映射中标记的页面,因为这些页面没有需要清除的内容。但这条规则有例外。(v. 18)
前面已经顺带提到一个例外:如果连续的页面不足 32 个,清理就*必须*扫描那些在可见性映射中标记的页面。跳过这样的小片段不但没有用,反而有害:它可能扰乱操作系统负责页面预取的算法。
另一个例外更有意思。清理可以*有意*扫描一部分已在可见性映射中标记、但未在冻结映射中标记的页面。这种扫描称为“积极扫描”(eager scanning)。
在这两种情况下,读取到的页面都会应用普通的冻结规则,因此有机会冻结页面上的所有行版本、在冻结映射中标记页面,从而减少激进模式下的工作量。另一方面,读取额外页面会增加负载,不应妨碍主要工作。
如果连续几个页面都无法冻结,很可能说明表的这一片段中所有行版本都还不够老,继续尝试没有意义。片段大小固定为 4096 个页面,失败尝试的比例由 *vacuum\_max\_eager\_freeze\_failure\_rate* 参数(或同名存储参数)限制。默认设置允许失败 122 次,随后停止扫描当前片段。(*默认值:* `0.03`)
但表的其他位置可能情况不同,因此进入下一个片段时会重置失败计数,积极扫描也会继续。
所以在最坏情况下,积极扫描会白白读取的页面数,最多相当于那些已在可见性映射中标记但未在冻结映射中标记的页面数乘以 *vacuum\_max\_eager\_freeze\_failure\_rate*。将该参数设为 0,实际上就禁用了积极扫描。
即使条件理想,也不应一次冻结太多页面,以免显著延长运行时间,把普通清理变成激进清理。因此成功尝试的数量同样受限,不能超过已在可见性映射中标记但未在冻结映射中标记的页面数的 20%。
为了观察积极扫描中的冻结,把激进冻结年龄恢复为原值,但保留之前设置的普通清理最小触发年龄。
```text {label="psql"}
=> ALTER SYSTEM RESET vacuum_freeze_table_age;
=> SELECT pg_reload_conf();
=> SHOW vacuum_freeze_min_age;
vacuum_freeze_min_age
-----------------------
1
(1 row)
```
积极扫描并非总会发生;条件之一是表不能太小,至少要有 8192 个页面。因此重新向 `tfreeze` 填充足够多的行(提醒一下,每个页面能容纳两个行版本):
```text {label="psql"}
=> TRUNCATE tfreeze;
=> INSERT INTO tfreeze(id, s)
SELECT id, 'FOO'||id FROM generate_series(1,8192*2) id;
INSERT 0 16384
```
然后清理这张表,使所有页面都在可见性映射中标记。最后再做一个准备步骤:执行一个事务,让所有行版本的年龄增加 1;现在它们满足冻结条件。
```text {label="psql"}
=> VACUUM tfreeze;
=> SELECT pg_current_xact_id();
pg_current_xact_id
--------------------
881
(1 row)
```
```text {label="psql"}
=> SELECT * FROM heap_page('tfreeze',0,8191);
ctid | state | xmin | xmin_age | xmax
----------+--------+-------+----------+------
(0,1) | normal | 880 c | 2 | 0 a
(0,2) | normal | 880 c | 2 | 0 a
(1,1) | normal | 880 c | 2 | 0 a
(1,2) | normal | 880 c | 2 | 0 a
...
(8191,1) | normal | 880 c | 2 | 0 a
(8191,2) | normal | 880 c | 2 | 0 a
(16384 rows)
```
```text {label="psql"}
=> SELECT * FROM generate_series(0,8191) g(blkno),
pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
blkno | all_visible | all_frozen
-------+-------------+------------
0 | t | f
1 | t | f
...
8191 | t | f
(8192 rows)
```
最后一切就绪,用 `verbose` 参数启动清理:
```text {label="psql" hl_lines="3 4 10 11"}
=> VACUUM VERBOSE tfreeze;
INFO: vacuuming "internals.public.tfreeze"
INFO: disabling eager scanning after freezing 1638 eagerly scanned
blocks of relation "internals.public.tfreeze"
INFO: finished vacuuming "internals.public.tfreeze": index scans: 0
pages: 0 removed, 8192 remain, 1640 scanned (20.02% of total), 1639
eagerly scanned
tuples: 0 removed, 16384 remain, 0 are dead but not yet removable
removable cutoff: 882, which was 0 XIDs old when operation ended
frozen: 1640 pages from table (20.02% of total) had 3280 tuples frozen
visibility map: 0 pages set all-visible, 1640 pages set all-frozen
(1640 were all-visible)
index scan not needed: 0 pages from table (0.00% of total) had 0 dead
item identifiers removed
avg read rate: 0.000 MB/s, avg write rate: 0.000 MB/s
buffer usage: 3299 hits, 0 reads, 0 dirtied
WAL usage: 3281 records, 0 full page images, 215167 bytes, 0 buffers
full
system usage: CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
VACUUM
```
可以看到,积极扫描在成功冻结 1638 个页面后中断了,这正好是 8192 的 20%。注意,下面几行还显示总共冻结了 1640 个页面:正如前面所说,积极扫描并不是普通清理读取可见性映射页面的唯一情况。例如,最后一个页面总会扫描;如果其中有行版本,清理就不会尝试截断表,以免白白获取排他锁。(*第 [133](/zh18/06-vacuum-and-freezing/#internal-ru-page-134) 页*)
```sql
SELECT * FROM generate_series(0,8191) g(blkno),
pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
blkno | all_visible | all_frozen
-------+-------------+------------
0 | t | t
1 | t | t
...
1637 | t | t
1638 | t | t
1639 | t | f
1640 | t | f
...
8189 | t | f
8190 | t | f
8191 | t | t
(8192 rows)
```
## 7.5. 加载时冻结 {#internal-ru-section-7-5}
不应再变化的数据可以在初始加载时立即冻结。为此,要使用带有 `FREEZE` 参数的 `COPY` 命令。
只有在同一个事务中创建或清空(使用 `TRUNCATE`)的表,才能在加载时冻结数据。这两个操作都会对表加排他锁。这个限制是必要的,因为冻结行版本无论隔离级别如何,都被视为在所有数据快照中可见;否则,其他事务会在数据加载过程中突然看到刚刚冻结的行版本。但表一旦被锁住,其他事务就无法访问它。(*第 [261](/zh18/12-relation-level-locks/#internal-ru-page-262) 页*)
不过,从形式上说,隔离仍然可能被破坏。在另一个会话中,以 Repeatable Read 隔离级别启动事务:
```text {label="psql"}
=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT 1; -- построен снимок
```
清空表 `tfreeze`,并在同一个事务中向它加载新行。(如果读事务已经访问过 `tfreeze`,`TRUNCATE` 命令就会被阻塞。)
```text {label="psql"}
=> BEGIN;
=> TRUNCATE tfreeze;
=> COPY tfreeze FROM stdin WITH FREEZE;
1 FOO
2 BAR
3 BAZ
\.
=> COMMIT;
```
现在,读事务看到了新数据,隔离性因此被破坏:
```text {label="psql"}
=> SELECT count(*) FROM tfreeze;
count
-------
3
(1 row)
=> COMMIT;
```
不过,数据加载不太可能经常发生,所以在大多数情况下这不会造成问题。
加载时冻结会立即创建可见性映射,并在页头中设置可见性标志:(v. 14)(*第 [127](/zh18/06-vacuum-and-freezing/#internal-ru-page-128) 页*)
```text {label="psql"}
=> SELECT * FROM pg_visibility_map('tfreeze',0);
all_visible | all_frozen
-------------+------------
t | t
(1 row)
=> SELECT flags & 4 > 0 AS all_visible
FROM page_header(get_raw_page('tfreeze',0));
all_visible
-------------
t
(1 row)
```
因此,加载时冻结后,清理就不会再处理这张表(当然,前提是其中的数据保持不变)。遗憾的是,TOAST 表目前还不支持这一功能:如果加载了较长的值,清理就必须额外重写整个 TOAST 表,才能在所有页头中设置可见性标志。(v. 14)
## 7.6. 负载调节和监控 {#internal-ru-section-7-6}
清理按页面工作,因此不会阻塞其他进程;但它仍然会给系统增加负载,并可能明显影响性能。
跟踪清理进度,可以发现进程活动过度或效率低下的情况,例如无法处理那些未清理且未冻结、像滚雪球一样不断增加的行版本。
### 手动清理 {#internal-ru-subsection-star-126}
清理大约执行 *vacuum\_cost\_limit* 个工作单位,然后休眠 *vacuum\_cost\_delay* 个时间单位。工作与等待交替进行,可以比较均匀地把清理对系统的影响摊开,避免负载出现峰值。(*默认值:* `200`)(*默认值:* `0`)
*vacuum\_cost\_delay* 的默认值为 0,实际上意味着手动清理完全不会休眠,因此 *vacuum\_cost\_limit* 的具体值没有作用。这样设定是因为,既然管理员不得不手动启动清理,就很可能希望它尽快完成。
不过,如果设置了休眠时间,那么 *vacuum\_cost\_limit* 指定的工作量就由缓冲区缓存中页面操作的成本组成。如果页面在缓冲区缓存中找到,每次读取页面计为 *vacuum\_cost\_page\_hit* 个单位;如果没有找到,则计为 *vacuum\_cost\_page\_miss* 个单位[^internal-ru-165-1]。如果页面原本是干净的,而清理操作又修改了它,还要额外计 *vacuum\_cost\_page\_dirty* 个单位[^internal-ru-165-2]。(*第 [183](/zh18/09-buffer-cache/#internal-ru-page-184) 页*)(*默认值:* `1`)(*默认值:* `2`)(*默认值:* `20`)
如果保持 *vacuum\_cost\_limit* 的默认值,清理每个周期最多可以处理 200 个页面(最佳情况:页面都已缓存,且没有新页面变脏),最少只能处理 9 个页面(最坏情况:所有页面都从磁盘读取并变脏)。
带有 `VERBOSE` 的 `VACUUM` 命令会执行清理并输出工作报告,而 `pg_stat_progress_vacuum` 视图会显示已经启动的清理进程的状态。
分析也有类似的视图(`pg_stat_progress_analyze`),虽然分析执行得很快,通常不会带来问题。(v. 13)
向表中插入更多行并全部更新,使清理能够持续足够长的时间:
```text {label="psql"}
=> TRUNCATE vac;
=> INSERT INTO vac(id,s)
SELECT id, 'A' FROM generate_series(1,5_000_000) id;
=> UPDATE vac SET s = 'B';
UPDATE 5000000
```
为了演示,把用于存储标识符的内存大小降到一个荒谬的小值:
```text {label="psql"}
=> ALTER SYSTEM SET maintenance_work_mem = '1MB';
=> SELECT pg_reload_conf();
```
启动清理,并在它运行期间多次查询 `pg_stat_progress_vacuum` 视图:
```text {label="psql"}
=> VACUUM VERBOSE vac;
```
```sql
SELECT * FROM pg_stat_progress_vacuum \gx
-[ RECORD 1 ]--------+--------------
pid | 20941
datid | 16391
datname | internals
relid | 16486
phase | scanning heap
heap_blks_total | 98483
heap_blks_scanned | 21329
heap_blks_vacuumed | 0
index_vacuum_count | 0
max_dead_tuple_bytes | 67108864
dead_tuple_bytes | 0
num_dead_item_ids | 0
indexes_total | 0
indexes_processed | 0
delay_time | 0
```
```sql
SELECT * FROM pg_stat_progress_vacuum \gx
-[ RECORD 1 ]--------+------------------
pid | 17602
datid | 16391
datname | internals
relid | 16486
phase | vacuuming indexes
heap_blks_total | 172414
heap_blks_scanned | 36833
heap_blks_vacuumed | 0
index_vacuum_count | 0
max_dead_tuple_bytes | 1048576
dead_tuple_bytes | 1114112
num_dead_item_ids | 2136372
indexes_total | 1
indexes_processed | 0
delay_time | 0
```
该视图还会显示以下信息:(v. 17)
- `phase`:当前清理阶段(前面介绍了主要阶段,但实际上还有更多阶段[^internal-ru-167-1]);
- `heap_blks_total`:表的页面总数;
- `heap_blks_scanned`:已扫描的页面数;
- `heap_blks_vacuumed`:已经清理的页面数;
- `index_vacuum_count`:索引扫描次数;
- `dead_tuple_bytes` 和 `num_dead_item_ids`:本次扫描收集的死版本大小和数量。
清理的总体进度由 `heap_blks_vacuumed` 与 `heap_blks_total` 的比值确定,但要注意,由于索引扫描,这个值会跳跃式变化。
需要重点关注清理循环的次数(字段 `index_vacuum_count`):如果该值大于 1,说明分配的内存不足以在一次索引扫描中完成清理。不过,只要 *maintenance\_work\_mem* 设置合理,出现这种情况的概率很低。还可以用 `dead_tuple_bytes` 与 `num_dead_item_ids` 的比值评估存储效率;在这个例子中,每个 `tid` 大约占用半个字节。
启用 *track\_cost\_delay\_timing* 后,字段 `delay_time` 会显示实际休眠时间。需要注意,在某些平台上,跟踪时间可能显著拖慢执行,因此应谨慎使用这个功能。(*默认值:* `off`)(v. 18)
此时已经完成的 `VACUUM VERBOSE` 命令输出了整体情况:
```sql {hl_lines="2 21"}
INFO: vacuuming "internals.public.vac"
INFO: finished vacuuming "internals.public.vac": index scans: 3
pages: 0 removed, 172414 remain, 172414 scanned (100.00% of total), 0
eagerly scanned
tuples: 5000000 removed, 5000000 remain, 0 are dead but not yet
removable
removable cutoff: 886, which was 0 XIDs old when operation ended
new relfrozenxid: 886, which is 3 XIDs ahead of previous value
frozen: 86208 pages from table (50.00% of total) had 5000000 tuples
frozen
visibility map: 172414 pages set all-visible, 172414 pages set
all-frozen (0 were all-visible)
index scan needed: 86207 pages from table (50.00% of total) had 5000000
dead item identifiers removed
index "vac_s": pages: 8652 in total, 4325 newly deleted, 4325 currently
deleted, 0 reusable
avg read rate: 342.318 MB/s, avg write rate: 341.067 MB/s
buffer usage: 223204 hits, 263773 reads, 262809 dirtied
WAL usage: 591745 records, 177971 full page images, 1300060561 bytes,
14908 buffers full
system usage: CPU: user: 1.03 s, system: 0.76 s, elapsed: 6.01 s
VACUUM
```
在这个例子中,清理总共需要扫描索引三次。
### 自动清理 {#internal-ru-subsection-star-128}
自动清理的负载调节[^internal-ru-168-1]与普通清理大致相同。但为了让两者能够以不同强度运行,自动清理有自己的一组参数:
- *autovacuum\_vacuum\_cost\_limit*;(*默认值:* `-1`)
- *autovacuum\_vacuum\_cost\_delay*。(*默认值:* `2ms`)
如果这些参数中有一个等于 −1,就使用普通清理对应参数的值。也就是说,默认情况下,*autovacuum\_vacuum\_cost\_limit* 使用 *vacuum\_cost\_limit* 的值。
一个周期内受 *autovacuum\_vacuum\_cost\_limit* 限制的自动清理工作单位由所有工作进程共享,因此无论工作进程数量是多少,系统总负载都大致相同。所以,如果要加快自动清理,增加 *autovacuum\_max\_workers* 的同时,也应按比例增加 *autovacuum\_vacuum\_cost\_limit*。
如有需要,可以通过存储参数(*autovacuum\_vacuum\_cost\_limit* 和 *autovacuum\_vacuum\_cost\_delay*)及其 TOAST 对应参数,为不同的表设置各自的值。
前面已经介绍过的 `need_vacuum` 和 `need_analyze` 视图,可以用来跟踪需要清理和分析的表的列表。如果列表变长,说明自动清理跟不上,需要通过缩短暂停时间(*autovacuum\_vacuum\_cost\_delay*)或增加两次暂停之间的工作量(*autovacuum\_vacuum\_cost\_limit*)来加快它。也可能还需要提高并行度(*autovacuum\_max\_workers*)。
除了查询之外,监控自动清理还有一种标准方法:把与 `VACUUM VERBOSE` 输出类似的信息写入服务器消息日志,以便后续分析。
把 *log\_autovacuum\_min\_duration* 设为 0,这样日志会记录自动清理的每次运行:(*默认值:* `-1`)
```text {label="psql"}
=> ALTER SYSTEM SET log_autovacuum_min_duration = 0;
```
同时开启清理休眠时间的跟踪。手动清理默认不休眠,跟踪它没有太大信息量;但对自动清理来说,这可能提供值得分析的信息。(v. 18)
```text {label="psql"}
=> ALTER SYSTEM SET track_cost_delay_timing = on;
=> SELECT pg_reload_conf();
```
再次更新表中的所有行,让自动清理有事可做:
```text {label="psql" hl_lines="4 20 25 26"}
=> UPDATE vac SET s = 'C';
UPDATE 5000000
postgres$ tail -n 20 /home/postgres/logfile
2026-04-05 20:54:21.347 MSK [51046] LOG: automatic vacuum of table
"internals.public.vac": index scans: 3
pages: 0 removed, 172414 remain, 172414 scanned (100.00% of total),
0 eagerly scanned
tuples: 5000000 removed, 5000000 remain, 0 are dead but not yet
removable
removable cutoff: 888, which was 0 XIDs old when operation ended
new relfrozenxid: 888, which is 2 XIDs ahead of previous value
frozen: 86208 pages from table (50.00% of total) had 5000000 tuples
frozen
visibility map: 172414 pages set all-visible, 172414 pages set
all-frozen (0 were all-visible)
index scan needed: 86208 pages from table (50.00% of total) had
5000000 dead item identifiers removed
index "vac_s": pages: 16923 in total, 4325 newly deleted, 8650
currently deleted, 4325 reusable
delay time: 68789.809 ms
avg read rate: 26.782 MB/s, avg write rate: 24.155 MB/s
buffer usage: 236780 hits, 288039 reads, 259792 dirtied
WAL usage: 616268 records, 187331 full page images, 1502256915
bytes, 9413 buffers full
system usage: CPU: user: 5.13 s, system: 4.50 s, elapsed: 84.02 s
2026-04-05 20:54:22.349 MSK [51046] LOG: automatic analyze of table
"internals.public.vac"
delay time: 663.495 ms
avg read rate: 214.227 MB/s, avg write rate: 0.008 MB/s
buffer usage: 2742 hits, 27421 reads, 1 dirtied
WAL usage: 5 records, 1 full page images, 5509 bytes, 0 buffers full
system usage: CPU: user: 0.20 s, system: 0.06 s, elapsed: 0.99 s
```
从日志可以看出,自动清理大部分时间都在等待,因此还有足够余量来提高速度。
清理和分析表所花费的总时间(毫秒)可以从系统统计中获得:(v. 18)
```text {label="psql"}
=> SELECT total_vacuum_time, total_autovacuum_time,
total_analyze_time, total_autoanalyze_time
FROM pg_stat_all_tables WHERE relname = 'vac' \gx
-[ RECORD 1 ]----------+------
total_vacuum_time | 6025
total_autovacuum_time | 84026
total_analyze_time | 0
total_autoanalyze_time | 1825
```
[^internal-ru-139-1]: [postgrespro.ru/docs/postgresql/18/routine-vacuuming#AUTOVACUUM]()。
[^internal-ru-140-1]: [backend/postmaster/autovacuum.c]()。
[^internal-ru-145-1]: [backend/postmaster/autovacuum.c](),函数 relation\_needs\_vacanalyze。
[^internal-ru-153-1]: [backend/access/heap/vacuumlazy.c](),函数 heap\_vac\_scan\_next\_block。
[^internal-ru-156-1]: [commitfest.postgresql.org/37/3433]()。
[^internal-ru-157-1]: [backend/access/transam/varsup.c](),函数 SetTransactionIdLimit。
[^internal-ru-158-1]: [backend/commands/vacuum.c](),函数 vac\_truncate\_clog。
[^internal-ru-158-2]: [backend/access/heap/vacuumlazy.c](),函数 lazy\_check\_wraparound\_failsafe。
[^internal-ru-165-1]: [backend/storage/buffer/bufmgr.c](),函数 ReadBuffer\_common。
[^internal-ru-165-2]: [backend/storage/buffer/bufmgr.c](),函数 MarkBufferDirty。
[^internal-ru-167-1]: [postgrespro.ru/docs/postgresql/18/progress-reporting#VACUUM-PHASES]()。
[^internal-ru-168-1]: [backend/postmaster/autovacuum.c](),函数 autovac\_balance\_cost。