4 数据快照
PostgreSQL 18 · 基于俄文 PG18 原版的简体中文译本
4.1 什么是数据快照
数据页面在物理上可能包含同一行的多个版本,但每个事务最多只能看到其中一个。事务所看到的不同数据行的所有版本合在一起,构成一个数据快照(snapshot)。快照提供特定时刻的一致(在 ACID 意义上)数据视图,其中只包含创建快照时已经提交的最新数据。(第 54 页)
为了实现隔离,每个事务都使用自己的快照。因此,不同事务看到的数据可能不同,来自不同的时间点,但仍然保持一致。
在 Read Committed 隔离级别下,快照在事务每条语句开始时创建,并在该语句执行期间保持有效。
在 Repeatable Read 和 Serializable 隔离级别下,快照在事务第一条语句开始时创建一次,并一直保持有效,直到事务结束。
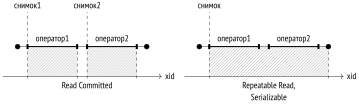
图中文字(从左到右):快照1、快照2、快照;操作1、操作2、操作1、操作2;xid;Read Committed;Repeatable Read、Serializable。
4.2 快照中的行版本可见性
当然,数据快照并不是所有所需行版本的物理副本。实际上,快照由几个数字定义,而快照中的行版本可见性则由规则决定。
某个行版本是否在快照中可见,取决于其头部的 xmin 和 xmax 字段(也就是创建它和删除它的事务编号)以及对应的信息位。xmin–xmax 区间不会相交,因此在任何快照中,每行最多由自己的一个版本表示。
精确的可见性规则1相当复杂,还要考虑许多不同的情况和边界条件。简单地说,当 xmin 事务所做的更改在快照中可见,而 xmax 事务所做的更改不可见时,这个行版本就是可见的(换句话说,该行版本已经出现,但还没有被删除)。
相应地,如果事务在创建快照之前已提交,那么该事务的更改在快照中可见。还有一个例外:事务在快照中可以看到自己尚未提交的更改。中止事务的更改当然不会在任何快照中可见。
下面看一个简单例子。图中用线段表示事务(从开始到提交):
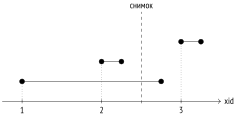
这里:
事务 2 的更改可见,因为它在快照创建之前已结束;
事务 1 的更改不可见,因为创建快照时它仍处于活动状态;
事务 3 的更改不可见,因为它在快照创建之后才开始(无论它是否已结束都不重要)。
4.3 快照由什么组成
遗憾的是,PostgreSQL 实际看到的情况与图中所示完全不同2。原因在于系统不知道事务何时提交。它只知道事务何时开始(由事务编号确定),而事务结束这一事实不会记录在任何地方。(默认为: off)
提交时间会在启用参数 track_commit_timestamp 时被跟踪3,但它完全不参与可见性检查(不过可能有用,例如用于第三方复制方案)。
此外,PostgreSQL 总会在相应的日志记录中保存事务的提交时间和中止时间,但只会在恢复到目标时间点时使用这些信息。
只能知道事务的当前状态。这些信息位于服务器共享内存的 ProcArray 结构中,其中包含所有活动会话及其事务的列表。但事后无法判断某个事务在快照创建时是否处于活动状态。(第 211 页)
因此,创建快照时仅保存创建时刻还不够:还必须记住该时刻每个事务的状态。没有这些状态信息,之后就无法判断哪些行版本应在快照中可见,哪些不应可见。
请比较一下,在快照创建时和一段时间之后,系统分别能获得哪些信息(白色圆圈表示活动事务,黑色圆圈表示已结束事务):
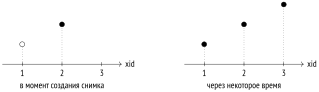
图中文字(从左到右):创建快照时;一段时间后;xid,以及事务编号 1、2、3。
如果不记住创建快照时第一个事务仍在执行,而第三个事务还不存在,就无法把它们与当时已经提交的第二个事务区分开,也就无法将它们排除在外。
因此,PostgreSQL 无法创建一个显示过去某个时刻一致数据状态的快照,即使表页面中存在所有所需的行版本。因此也无法实现回溯查询(也称时态查询或 flashback 查询)。
有意思的是,这项功能曾被列为 Postgres 的目标之一,并且从一开始就已实现;但项目转由社区维护后,它被从数据库系统中移除了4。
所以,数据快照由创建时保存的几个值组成5:
快照的下边界 xmin:最老的活动事务编号。
编号小于它的所有事务要么已提交,此时它们的更改在快照中可见;要么已中止,此时这些更改会被忽略。(第 134 页)
快照的上边界 xmax:它取最近一次已提交事务编号加一的值。上边界定义了快照创建的时刻。
编号大于或等于 xmax 的所有事务要么尚未结束,要么并不存在,因此这些事务的更改绝不会可见。
活动事务列表 xip_list(xid-in-progress list)包含所有活动事务的编号(小于 xmax),但不包括完全不影响可见性的虚拟事务。(第 91 页)
快照中还会保存几个其他参数,不过现在还不重要。
从图形上看,可以把快照表示为一个覆盖 xmin 到 xmax 之间事务的矩形:
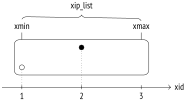
为了看看快照如何决定可见性,我们在 accounts 表上重现上面场景。
第一个事务向表中插入第一行,并保持活动状态:
第二个事务插入第二行并立即提交:
此时,在另一个会话中创建新快照。为此执行任意查询就足够了,但我们直接使用专用函数查看该快照:
该函数用冒号分隔输出快照的三个组成部分:xmin、xmax 和 xip_list(本例中只包含一个编号)。
快照创建后,提交第一个事务:
第三个事务在快照创建后开始执行,并修改第二行。于是出现了新版本:
创建的快照中只有一个版本可见:
但表中有三个版本:
那么 PostgreSQL 如何判断要显示哪些版本?按照上面的规则,只有以下已提交事务的更改会出现在快照中:
编号
xid<xmin的事务:其更改无条件可见(例如创建accounts表的事务);xmin⩽xid<xmax的事务:其更改可见,但位于xip_list中的除外。
第一行(0,1)不可见,因为创建它的事务编号位于活动事务列表中(虽然它也位于快照范围内)。
第二行的最后一个版本(0,3)不可见,因为创建它的事务编号超出了快照的上边界。
不过,第二行的第一个版本(0,2)可见:创建它的事务编号落在快照范围内但不在活动事务列表中(插入可见),而删除它的事务编号超出了快照的上边界(删除不可见)。
4.4 事务自身更改的可见性
确定事务自身更改的可见性时,情况会更复杂,因为有时只应看到其中一部分。例如,在某个时刻打开的游标,无论隔离级别如何,都不能看到之后发生的更改。
为此,行版本头部包含一个特殊字段(显示为伪列 cmin 和 cmax),用于表示事务内操作的序号。cmin 表示插入操作的编号,cmax 表示删除操作的编号;不过为节省行版本头部的空间,实际上它们共用一个字段,而不是两个不同字段。一般认为,在同一个事务中插入并删除同一行的情况很少。(如果确实发生了,系统会在同一个字段中写入一个特殊的“组合编号”,后台进程会为它记录真实的 cmin 和 cmax6。)
举个例子,先开启事务并向表中插入一行:
现在打开一个游标,用于执行返回表中行数的查询:
然后再插入一行:
现在显示表的内容,并增加一列 cmin,只为本事务插入的行显示该值(对其他行来说,这个值没有意义):
游标查询会得到三行而不是四行——游标打开后插入的行不会进入快照,因为快照只考虑满足 cmin < 1 的行版本:
当然,这个 cmin 编号也会保存在快照中,但无法通过 SQL 显示。
4.5 事务视界
快照的下边界(创建快照时处于活动状态的最老事务的 xmin 编号)具有重要含义——它定义了使用该快照的事务的视界。
没有活动快照的事务(例如,Read Committed 隔离级别下两条语句执行之间的事务)的视界由其自身编号决定,前提是它已经分配到编号。
位于视界之外的所有事务(即编号 xid < xmin 的事务)都已经确定提交。这意味着,在自己的视界之外,事务总是只能看到当前的行版本。
这个名称当然来自物理学中的事件视界概念。
PostgreSQL 跟踪所有进程当前的事务视界;事务可以在 pg_stat_activity 表中查看自己的视界:
虚拟事务虽然没有真正的编号,但也像普通事务一样使用快照,因此同样拥有自己的视界。例外是没有活动快照的虚拟事务:对它们而言,视界这个概念没有意义;从数据快照和可见性的角度看,它们对系统完全“透明”(即使 pg_stat_activity.backend_xmin 中可能还保留着旧快照的编号)。
类似地,可以定义数据库视界。为此,取在该数据库中运行的所有事务的视界,找出其中“最远”的一个,即 xmin 最老的那个7。这就是数据库视界:在它之外,该数据库中的任何事务都不可能再看到过期的行版本。这些行版本可以由清理安全删除——这就是视界概念在实践中如此重要的原因。
由此可以得出:
如果处于 Repeatable Read 或 Serializable 隔离级别的事务(无论是真实事务还是虚拟事务)长时间运行,它就会保持数据库视界,从而阻碍清理;
Read Committed 隔离级别下的真实事务同样会保持数据库视界,无论它是在执行语句,还是只是处于空闲状态(idle in transaction);
Read Committed 隔离级别下的虚拟事务只在执行语句期间保持视界。
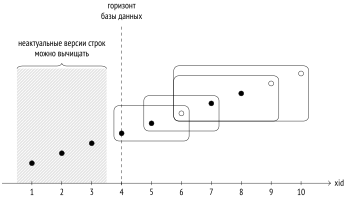
图中文字:数据库视界、过期行版本、可以清理、xid,以及事务编号 1 至 10。
不过,整个数据库只有一个视界;如果某个事务持有这个视界,它就不允许清理该视界以内的数据,即使事务从未访问过这些数据。
对于集群范围的系统目录表,会使用一个单独的视界,该视界会考虑所有数据库中的事务。相反,对于临时表,除了当前进程中正在执行的事务外,无需考虑任何事务。
继续这个例子。第一个会话中的事务仍在执行,并继续持有视界;可以通过增加事务计数器来验证:
只有在事务结束后,视界才会向前推进,清理才能删除过期的行版本:
理想情况下,不应把产生新行版本的更新操作与长事务结合起来,因为这会导致表和索引膨胀。(第 178 页)
4.6 系统目录的快照
虽然系统目录也是由普通表组成的,但访问它们时不能使用事务或语句所用的同一个数据快照。快照必须足够“新”,能够包含所有最新更改,否则事务可能看到已经过时的表列定义,或错过新建的完整性约束。
下面是一个简单例子:
INSERT 命令“看到了”在事务快照创建后才出现的完整性约束。看起来这种行为似乎破坏了隔离性,但如果事务已经访问了 accounts 表,ALTER TABLE 命令就会一直阻塞到该事务结束。(第 261 页)
总的来说,系统的行为就像为每次访问系统目录都创建一个新快照。不过,实现当然更复杂8,因为不断创建新快照会影响性能;此外还要考虑许多系统目录对象都被缓存这一事实。
4.7 导出数据快照
有时,多个并行事务必须确保看到完全相同的数据视图。例如,pg_dump 工具可以以并行模式运行:所有工作进程都必须看到数据库的同一状态,才能生成一致的备份。
当然,不能只因为事务“同时”启动,就指望它们的视图相同。快照导出和导入机制可以提供这样的保证。
函数 pg_export_snapshot 返回一个快照 ID,可以通过数据库系统外部的手段传递给另一个事务:
在执行第一条语句之前,另一个事务可以通过执行 SET TRANSACTION SNAPSHOT 命令导入这个快照。必须先将隔离级别设置为 Repeatable Read 或 Serializable,因为在 Read Committed 级别下,每条语句都会使用自己的快照:
现在第二个事务会使用第一个事务的快照,因此它会看到四行(而不是零行):
显然,第一个事务在导出快照后所做的更改不会被第二个事务看到,反之亦然:仍然遵循通常的可见性规则。
导出快照的生命周期与导出它的事务相同。
Joseph Hellerstein. 回顾 Postgres // habr.com/ru/company/postgrespro/blog/ 438890. ↩︎
backend/storage/ipc/procarray.c, 函数 GetSnapshotData. ↩︎
backend/storage/ipc/procarray.c, 函数 ComputeXidHorizons. ↩︎
backend/utils/time/snapmgr.c, 函数 GetCatalogSnapshot. ↩︎