3 页面与行版本
PostgreSQL 18 · 基于俄文 PG18 原版的简体中文译本
3.1 页面结构
每个页面都有特定的内部布局,通常由以下部分组成1:
页头;
指向行版本的项指针数组;
空闲空间;
行版本;
特殊空间。
页头
页头位于地址的最低处,其大小固定。它存储着关于页面的各种信息,比如校验和以及页面其他所有部分的大小。(第 127 页)
这些大小可以通过 pageinspect 扩展查看。让我们看一下表的第一个页面,页号从零开始2:
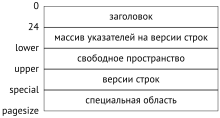
图中文字(从上到下):页头、行版本指针数组、空闲空间、行版本、特殊空间。左侧边界标记依次为 0、24、lower、upper、special、pagesize。
特殊空间
特殊空间位于页面的另一端,占据最高地址。某些类型的索引用它来存储辅助信息;其他情况下,包括堆页面在内,这个空间的大小为零。
总体上,索引页面的布局更加多样,具体内容取决于索引类型。即使同一种索引也可以有不同种类的页面:例如,B-树(B-tree)有一个特殊结构的元数据页面(第零页),以及按照堆页面方式组织的“普通”页面。(第 529 页)
行版本
行(rows)位于特殊空间之前,其中包含存储在数据库中的实际数据,以及一些管理信息。
对于表,我们讨论的不只是行,而是行版本(row versions,tuples),因为多版本机制允许同一行存在多个版本。多版本机制不用于索引;索引会引用表中所有可能的行版本,再根据可见性规则从中选出合适的版本。
tuple 这个术语来自关系理论,译为元组。这也是 PostgreSQL 学术历史留下的一项遗产。为避免混淆理论与数据库管理系统的内部实现,我会采用行版本这一说法;在不会造成歧义时,有时会简称为行。
项指针
指向行版本的指针数组充当页面的目录,紧接在页头之后。
索引条目必须以某种方式引用表中的行版本。为此,PostgreSQL 使用六字节的行版本标识符(tuple id,tid)。标识符包含主分支文件中的页号,还必须包含对该页面内特定行版本的引用。(第 29 页)
这种引用本来可以使用行版本相对于页面起始位置的偏移量。但这样一来,移动页面内的行版本就会破坏索引中的引用,进而造成页内空间碎片和其他问题。
因此,这里使用间接寻址:行版本标识符引用指针编号,再由指针指向行版本在页面中的当前位置。移动行版本时,其标识符保持不变,只需修改位于同一页面中的指针即可。
每个指针恰好占四个字节,包含以下信息:
行版本相对于页面起始位置的偏移量;
行版本长度;
定义行版本状态的若干位。
空闲空间
指针与行版本之间可能留有空闲空间,这些空间会记录在空闲空间映射中。页面内部不会有碎片,所有空闲空间始终聚集成一个连续区域3。(第 31 页)
3.2 行版本结构
每个行版本都包含一个行头,后面跟着实际的数据。行头由多个字段组成,包括以下内容:
xmin、xmax:事务 ID,用于区分同一行的这个版本与其他版本;
infomask:一组定义行版本属性的信息位;
ctid:指向同一行的下一个更新版本的引用;
空值位图:标记允许包含空值(NULL)的列的位数组。
因此,行头相当大:每个行版本至少需要 23 字节,而且由于空值位图以及数据起始位置必须对齐,通常还会更大。在“窄”表中,管理信息占用的空间完全可能超过有效数据。
磁盘上的数据格式与内存中的表示完全一致。页面及其中的行版本按原样读入缓冲区缓存,无需任何转换。因此,一个平台的数据文件与其他平台并不兼容4。
不兼容的原因之一是字节序。例如,x86 架构采用从低位到高位的小端序(little-endian),z/Architecture 采用相反的大端序(big-endian),而 ARM 的字节序可以切换。
另一个原因是许多架构要求数据按机器字边界对齐。例如,在 32 位 x86 系统中,整数(integer 类型,占四字节)按四字节字边界对齐,双精度浮点数(double precision 类型,占八字节)也是如此。而在 64 位系统中,double 值按八字节字边界对齐。
由于需要对齐,表中行的大小取决于字段的排列顺序。通常这种影响不太明显,但有时可能使行的大小显著增加。例如:
这里使用的 heap_page_items 函数由 pageinspect 扩展提供,可以获取指针和行版本的信息。
PostgreSQL 用 heap(堆)来指代表。这又是一个不太直观的用法,暗示为行版本分配空间的机制与动态内存分配相似。当然,两者有一定相似之处,但管理表所用的算法完全不同。也可以把这个词理解为“全都堆在一起”,以强调它与有序索引的区别。
这一行占 56 字节,其中行头占 24 字节,两个 float 列各占 8 字节,两个 boolean 列各占 1 字节。合计为 42 字节,另外 14 字节浪费在 float 的八字节字边界对齐上。重建表可以更有效地利用空间:
但还要考虑到,页面中的行版本本身也需要对齐。正如预期,行的大小变成了 42 字节,但行与行之间仍然会浪费 6 字节:
另一种可能的微优化,是把所有长度固定且不允许空值的列放到表的开头。这样可以缓存字段相对于行版本起始位置的偏移量,从而提高访问这些字段的效率5。
3.3 行版本操作
为了区分同一行的不同版本,每个行版本都有两个标记来定义其“有效时间”:xmin 和 xmax。不过,这里使用的并非实际时间,而是不断递增的事务 ID 计数器。(第 134 页)
创建一行时,其 xmin 值被设置为执行 INSERT 命令的事务 ID。
删除一行时,其当前版本的 xmax 值被设置为执行 DELETE 命令的事务 ID。
在一定程度上,可以把 UPDATE 命令看成 DELETE 和 INSERT 两个操作。先将当前行版本的 xmax 设置为执行 UPDATE 的事务 ID,再为同一行创建新版本;新版本的 xmin 与前一个版本的 xmax 相同。同样,MERGE 命令也可以“拆解”为基本的插入和删除操作。(v. 15)
接下来,我将详细展示各种行版本操作在底层是如何执行的6。
对于这些实验,我们需要一个含有两列的表,并在其中一列上创建索引:
插入
开启一个事务并插入一行:
这是当前的事务 ID:
PostgreSQL 常用 xact 作为事务的缩写,在函数名和代码中都能看到它。因此,事务 ID 会写成 xact id、txid,甚至直接写作 xid。后面还会多次遇到这些名称。
让我们看一下页面内容。heap_page_items 函数可以提供所需的全部信息,但它按原样显示数据,格式不太容易理解:
为了看得更清楚,我们只保留一部分信息,并解释其中几列的含义:
此查询完成了以下操作:
将指针
lp转换为行版本标识符的常用形式:(页号,指针编号)。解释指针状态
lp_flags。这里的值为 normal,表示该指针确实指向一个行版本。暂时只选出所有信息位中的两对。
xmin_committed和xmin_aborted表示编号为xmin的事务是否已提交或已中止。对于xmax事务,xmax_committed和xmax_aborted则提供相应信息。
pageinspect 扩展提供了 heap_tuple_infomask_flags 函数,可以解释所有信息位。但这里仅以更紧凑的形式输出当前需要的信息位。(v. 13)
插入行后,堆页面中出现了编号为 1 的指针,它引用第一个行版本,也是目前唯一的行版本。
行版本的 xmin 字段被设置为当前事务 ID。该事务仍处于活动状态,因此 xmin_committed 和 xmin_aborted 位均未设置。
xmax 字段填入的是占位编号 0,因为这个行版本没有被删除,仍然有效。由于 xmax_aborted 位已经设置,事务不会理会这个编号。
为一个根本没有发生过的事务设置“已中止”位,似乎有些奇怪。但从隔离性的角度看,两者是一样的:中止的事务不留下痕迹,因此就相当于没有发生过。
这个查询还会用到多次,因此我将它封装成一个函数。同时,为了让输出更紧凑,去掉信息位所在的列,把事务状态附在事务 ID 后面:
现在,行版本头部的情况就清楚多了:
使用 xmin 和 xmax 伪列,也可以从表本身获得类似但远不如它详细的信息:
提交
事务成功完成后,需要记下它的状态,标明它已经提交。为此,PostgreSQL 使用名为 clog(commit log,提交日志)的结构。它并非系统目录表,而是 PGDATA/pg_xact 目录中的专用文件7。
clog 被拆成多个文件只是为了方便。这些文件通过服务器共享内存中的缓冲区逐页访问。clog 缓存的大小由 transaction_buffers 参数设置,默认是缓冲区缓存大小的 。(v. 17)(第 309 页)
与行版本头部一样,clog 为每个事务分配两个位:committed 和 aborted。
因此,事务提交时,会在 clog 中设置该事务的 committed 位。其他事务访问我们的堆页面时,必须回答一个问题:编号为 xmin 的事务是否已经结束?
- 如果还没有结束,创建的行版本就不应该可见。
要检查事务是否仍在运行,需要查看另一个位于实例共享内存中的结构:ProcArray。它列出了所有活动进程,并为每个进程记录其当前的活动事务 ID。
- 如果已经结束,是提交还是中止?如果是中止,该行版本同样不应该可见。
这项检查需要使用 clog。尽管最新的 clog 页面保存在内存缓冲区中,每次都进行这种检查仍有不小的开销。因此,事务状态一经查明,就会写入行版本头部的 xmin_committed 和 xmin_aborted 信息位;这些位也称为提示位(hint bits)。只要其中一个位已设置,xmin 事务的状态就被视为已知,下一个事务便无需再访问 clog 或 ProcArray。
为什么不由插入行的事务设置这些位?因为在插入时,它还不知道自己能否成功完成。而到了提交时,又已经不清楚究竟修改了哪些页面中的哪些行。涉及的页面可能很多,记住它们并不划算。而且,一些页面可能已经从缓冲区缓存逐出到磁盘;仅仅为了修改这些位而重新读取它们,会显著拖慢提交。
这种节省也有代价:任何事务,即使只是执行简单读取的 SELECT,也可能设置数据页面中的信息位。这样一来,缓冲区缓存中的这些页面自然就变成了脏页。
现在,终于可以提交事务最开始执行的那次行插入了:
页面中没有任何变化,但我们知道,事务状态已经写入 clog:
接下来,第一个以“正常”方式访问页面、而非通过 pageinspect 访问的事务,必须确定 xmin 事务的状态,并将它写入信息位:
删除
删除一行时,会把执行删除的事务 ID 写入当前行版本的 xmax 字段,并清除 xmax_aborted 位。(第 268 页)
当 xmax 对应一个活动事务时,这个值也起着行锁的作用。如果另一个事务打算更新或删除该行,就必须等到 xmax 事务结束。
让我们删除一行:
事务 ID 已写入 xmax 字段,但信息位尚未设置:
中止
中止更改的机制与提交相似,速度也同样快,只不过在 clog 中设置的是 aborted 位而非 committed 位。尽管命令名为 ROLLBACK,实际上并不回滚更改:事务在数据页面中已经做出的所有修改都保留在原处。
访问页面时,会检查事务状态,并在行版本中设置 xmax_aborted 提示位。xmax 编号本身仍保留在页面中,但之后不会再被理会:
更新
更新的执行方式,就像先删除当前行版本,再插入一个新版本:
查询返回一行,即新版本:
但页面中保留了两个版本:
先前被删除的行版本,其 xmax 字段现在被标记为当前事务 ID。由于之前的事务已经中止,这个值会覆盖原值。同时,xmax_aborted 位被清除,因为当前事务的状态尚不明确。
最后,提交事务。
3.4 索引
任何类型的索引都不会为其条目维护多个版本,每个索引条目都只有一份。换句话说,索引条目的头部没有 xmin 和 xmax 字段。索引会引用表中的所有行版本;事务必须访问表,才能确定哪个版本对它可见,除非该页面已在可见性映射中标记。(第 115 页)
为方便起见,让我们创建一个简单的函数,使用 pageinspect 扩展显示页面中的所有索引条目。在 B-树的一个页面内部,条目以扁平列表的形式排列。(第 523 页)
可以看到,索引页面引用了表中两个行版本,既有当前版本,也有旧版本:
由于 BAR < FOO,指向第二个行版本的指针在索引中排在第一位。
3.5 TOAST
TOAST 表本质上是一张普通表,维护着自己的多版本机制:“toast”的版本与主表的行版本并不关联。不过,TOAST 表的内部操作方式决定了其中的行从不更新,只会添加或删除,因此这里的多版本机制是一种退化形式。(第 33 页)
数据发生变化时,主表总会创建一个新行版本。但如果更新没有涉及存储在 TOAST 中的“长”值,新行版本仍会引用 TOAST 表中原来的值。只有当更新改变了这个长值时,才会同时创建主表的新行版本和新的“toast”。
3.6 虚拟事务
PostgreSQL 使用了一种可以“节约”事务 ID 的优化。
如果事务只读取数据,就不会影响行版本的可见性。因此,后端进程最初只为事务分配一个虚拟事务 ID(virtual xid),由后端进程标识符和一个序号组成。分配这个编号不需要所有进程之间的同步,因此速度很快。此时,事务还没有真正的事务 ID8:(第 259 页)
在不同时间,系统中的虚拟事务完全可以使用曾经用过的编号。这没有问题,因为虚拟编号仅在事务活动期间存在于内存中,既不会写入数据页面,也不会落盘。
一旦事务开始修改数据,就会为它分配一个真正且唯一的事务 ID:
3.7 子事务
保存点
SQL 定义了保存点(savepoint),允许撤销事务中的一部分操作,而不中止整个事务。但这不符合前面介绍的机制:一个事务的所有修改只有一个共同状态,而且数据本身并不会物理回滚。
为了实现这一功能,带有保存点的事务被拆成若干个子事务(subtransaction),各自的状态可以单独管理9。
子事务拥有自己的事务 ID,大于主事务的 ID。其状态照常写入 clog,但已提交的子事务会同时设置 committed 和 aborted 两个位。最终状态取决于主事务:如果主事务中止,它的所有子事务也都被视为已经中止。
事务嵌套关系保存在 PGDATA/pg_subtrans 目录的文件中,通过 SLRU 缓存访问这些文件的页面。缓存大小由 subtransaction_buffers 参数设置,默认是缓冲区缓存大小的 。(第 309 页)
不要把子事务与自治事务混为一谈。与子事务不同,自治事务彼此完全独立。原生 PostgreSQL 没有自治事务,这或许是好事:真正需要它们的场合极少,而其他数据库管理系统提供了这项功能,反而容易招致滥用,让所有人受累。
让我们清空表,开启一个事务并插入一行:
现在创建一个保存点,并插入另一行:
注意,pg_current_xact_id 函数返回的是主事务 ID,而不是子事务 ID。
让我们回滚到保存点,并插入第三行:
在页面中,仍然可以看到已经中止的子事务添加的行。
提交更改:
现在可以清楚地看到,每个子事务都有自己的状态。
不能在 SQL 中直接使用子事务,也就是说,不能在当前事务结束前再开始一个新事务:
这个机制会在使用保存点、处理 PL/pgSQL 异常,以及其他一些更少见的场景中隐式启用。
错误与操作的原子性
执行操作时发生错误,会怎样?
例如:
发生错误后,事务被视为已经中止,不能再执行任何操作:
即使尝试提交更改,PostgreSQL 也会报告事务已经中止:
为什么发生错误后不能继续执行事务?因为已经完成的操作从不物理回滚,继续执行就能访问出错前完成的部分修改。这不仅会破坏事务的原子性,甚至连单条语句的原子性都无法保证。
正如本例中,语句在出错前已经更新了两行中的一行:
顺便说一下,psql 有一种模式,允许事务在发生错误后继续执行,就好像出错语句的操作已经回滚一样:
不难猜到,在这种模式下,psql 实际上会在每条命令前隐式设置保存点,发生错误时就回滚到该保存点。默认不启用这种模式,因为设置保存点,即使不回滚到它,也会带来显著开销。
postgrespro.ru/docs/postgresql/18/storage-page-layout; include/storage/bufpage.h. ↩︎
backend/storage/page/bufpage.c, 函数 PageRepairFragmentation. ↩︎
backend/access/common/heaptuple.c, 函数 heap_deform_tuple. ↩︎
postgrespro.ru/docs/postgresql/18/transaction-id; backend/access/transam/xact.c. ↩︎
postgrespro.ru/docs/postgresql/18/subxacts; backend/access/transam/subtrans.c. ↩︎