1 绪论
PostgreSQL 18 · 基于俄文 PG18 原版的简体中文译本
1.1. 数据组织
数据库
PostgreSQL 是一款数据库管理系统软件。程序运行时,我们称之为 PostgreSQL 服务器,或服务器实例。
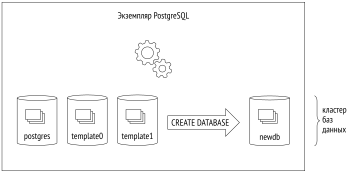
PostgreSQL 管理的数据存储在数据库1中。一个 PostgreSQL 实例可以同时管理多个数据库,它们合称为数据库集簇。
使用集簇之前,必须先对其进行初始化2(创建)。存放集簇所有文件的目录通常称为 PGDATA,这个名称来自指向该目录的环境变量。
通过软件包安装时,可能会在 PostgreSQL 自带机制之上加入自己的“抽象层”,显式指定工具所需的全部参数。这时数据库服务器表现为操作系统服务,你可能从来不会直接遇到 PGDATA 变量。不过,这个术语已经约定俗成,本书仍会使用它。
初始化时,会在 PGDATA 中创建三个相同的数据库:
template0 用于从逻辑备份恢复数据、创建采用其他编码的数据库等场合,绝不能修改; (第 631 页)
template1 是用户在此集簇中创建其他数据库时使用的模板;
postgres 是一个普通数据库,可以按自己的需要使用。
系统目录
集簇内所有对象(如表、索引、数据类型或函数)的元数据,都存储在系统目录3的表中。每个数据库都有自己的一组表和视图,用来描述该数据库的对象。此外,还有几个系统目录表为整个集簇所共有,不属于任何特定数据库(形式上使用一个标识符为零的虚拟数据库),但在任意数据库中都能访问。
可以使用普通 SQL 查询访问系统目录,而系统目录的变更由 DDL 命令触发。psql 客户端还提供了一系列查看系统目录的专用命令。
所有系统目录表的名称都以 pg_ 为前缀,例如 pg_database。列名以三个字母的代码开头,通常与表名对应,例如 datname。
在所有系统目录表中,主键列都名为 oid,类型也是 oid(object identifier,对象标识符),即一个 32 位整数。
oid 对象标识符机制本质上类似于序列,但比序列早得多。它的特点是,由同一个计数器分配的唯一编号会用于不同的系统目录表。已分配的编号超出取值范围时,计数器会归零。为保证某个表内的值唯一,下一个 oid 值会通过唯一索引检查;如果该表已在使用这个值,就增加计数器并再次检查4。
模式
模式5是数据库中所有对象的命名空间。除了用户模式,还有几个特殊的系统模式:
public 是用户对象的默认模式,除非另行配置;
pg_catalog 用于系统目录表;
information_schema 提供 SQL 标准规定的另一种系统目录视图;
pg_toast 用于与 TOAST 有关的对象; (第 33 页)
pg_temp 用于临时表(不同用户的临时表虽然建立在各自的 pg_temp_N 模式中,但每个用户都使用 pg_temp 这个名称访问自己的对象)。
模式存在于数据库内部,数据库中的所有对象都属于某个模式。
访问对象时,如果没有显式指定模式,就会从搜索路径中列出的模式里选择第一个合适的模式。搜索路径基于 search_path 参数的值形成,并会隐式加入 pg_catalog 和必要时的 pg_temp 等模式。因此,不同模式可以包含同名对象。
表空间
数据库和模式决定对象的逻辑分布,表空间则决定数据的物理位置。实际上,表空间就是文件系统中的一个目录。例如,可以用表空间把归档数据放在较慢的存储介质上,而把经常使用的数据放在较快的介质上。
同一个表空间可以由多个数据库使用,一个数据库也可以把数据存储在多个表空间中。也就是说,逻辑结构与物理结构相互独立。
每个数据库都有一个所谓的默认表空间。除非显式指定其他位置,所有对象都会在这里创建。系统目录对象也存储在这个表空间中。
初始化集簇时会创建两个表空间:
pg_default 位于 PGDATA/base 目录中。如果没有显式选择其他表空间,它就是默认表空间;
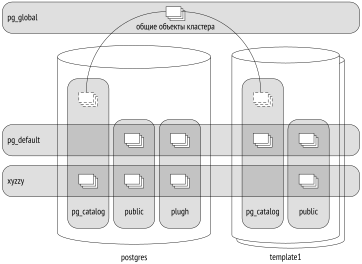
pg_global 位于 PGDATA/global 目录中,用来存储整个集簇共有的系统目录对象。
创建用户表空间时可以指定任意目录;PostgreSQL 会在 PGDATA/pg_tblspc 目录中建立指向它的符号链接。实际上,PostgreSQL 中的所有路径都是相对路径,以数据目录 PGDATA 为起点。因此,可以把 PGDATA 移到其他位置(当然,要先停止服务器)。
下图把数据库、模式和表空间放在了一起。数据库 postgres 的默认表空间是 xyzzy,而 template1 的默认表空间是 pg_default。表空间与模式的交叉处是各种数据库对象:
关系
数据库中最重要的对象——表和索引——虽然有许多差异,却有一个共同点:它们都由行组成。对表来说,这一点显而易见;B-树(B-tree)的节点也由行组成,每行包含被索引的值,以及指向其他节点或表行的引用。 (第 523 页)
还有一些对象的结构与此类似:序列本质上是只有一行的表,物化视图本质上是记住了查询的表。另外还有普通视图,它们本身不存储数据,但在其他方面都与表相似。
在 PostgreSQL 中,这些对象统称为关系(relation)。
我认为这个词选得不太好,因为它把数据库中的表与关系理论中真正的关系混在了一起。这体现了项目的大学背景,以及创始人 Michael Stonebraker 把一切都看成关系的倾向。在一篇论文中,他甚至引入了“有序关系”(ordered relation)的概念,用来表示行的顺序由索引决定的表。
关系的系统目录表最初名为 pg_relation,但很快便随着面向对象的热潮,改名为今天熟悉的 pg_class。不过,它的列名仍以 rel 为前缀。
分支与文件
与关系有关的信息按类型组织为多个分支6(fork),每个分支包含一种特定的数据。
起初,一个分支只有一个文件。文件名由数字标识符(oid)组成,还可能加上表示分支类型的后缀。
文件会逐渐增长,达到 1 GB 时,就会为同一分支创建下一个文件(这类文件有时称为段)。段的序号会添加到文件名末尾。
1 GB 的文件大小限制源于历史上的文件系统兼容性需求,因为有些文件系统不能处理大文件。可以在编译 PostgreSQL 时修改这一限制(./configure --with-segsize)。
因此,一个关系在磁盘上可能对应多个文件。即使是一张没有索引的小表,也至少会有三个文件,分别对应必需的三个分支。
每个表空间目录(pg_global 除外)中都会为各个数据库创建子目录。属于同一表空间、同一数据库的所有对象文件,都放在同一个子目录中。需要考虑这一点,因为文件系统处理单个目录中大量文件的效率通常不高。
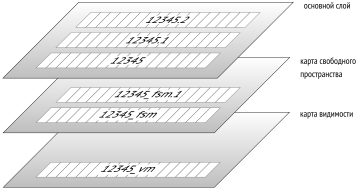
标准分支类型有以下几种。
主分支(main fork)存储实际数据,也就是表行或索引行。所有关系都有主分支,不存储数据的视图除外。
主分支的文件名只有数字标识符,其值等于 pg_class 表中 relfilenode 列的值。
来看一个例子:在 pg_default 表空间中创建一张表,查看它的文件路径:
base 目录对应 pg_default 表空间,下一级子目录对应数据库,而我们要找的文件就在其中:
下面是文件系统中对应的文件:
初始化分支(init fork)7只存在于无日志表(使用 UNLOGGED 创建的表)及其索引中。这类对象与普通对象的唯一区别在于,对它们执行的操作不会写入预写式日志。因此,操作会更快,但发生故障时就无法把数据恢复到一致状态。恢复时,PostgreSQL 会直接删除这些对象的所有分支,再用初始化分支替代主分支,得到一个“空壳”。 (第 211 页)
表 t 创建为无日志表,因此有初始化分支。它与主分支同名,但带有 _init 后缀:
空闲空间映射(free space map)8这个分支记录页面内空闲空间的大致大小。空闲空间一直在变化:加入新的行版本时会减少,清理时则会增加。插入新行版本时,可以借助空闲空间映射迅速找到能容纳这些数据的页面。
空闲空间映射文件带有 _fsm 后缀。不过,这些文件不会立即创建,而是等到需要时才出现。让它们出现的最简单方法就是清理表: (第 133 页)
为了加快查找,空闲空间映射采用树形结构,至少占用三个页面。这也解释了为什么一张几乎为空的表,其映射分支文件仍有这样的大小。
表和索引都有空闲空间映射。不过,索引行不能添加到任意页面(例如,B-树的插入位置由排序顺序决定),因此索引的映射只记录那些已经完全清空、可以在索引结构中重新使用的页面。
可见性映射(visibility map)9这个分支能帮助我们迅速判断页面是否需要清理或冻结。为此,它为每个堆页面分配了两个比特。
其中一个比特标记只包含有效行版本的页面。清理过程会跳过这样的页面,因为没有需要清理的内容。而且,事务从这样的页面读取行时,可以不再检查行的可见性,这就使仅索引扫描成为可能。 (第 131 页) (第 422 页)
另一个比特标记所有行版本都已冻结的页面。我把这个分支的这一部分称为冻结映射。 (第 134 页)
可见性映射文件带有 _vm 后缀,通常是最小的分支文件:
表有可见性映射,索引则没有。 (第 89 页)
页面
为便于组织 I/O,文件在逻辑上被分为页面(或块),这是读写数据的最小单位。因此,PostgreSQL 的许多内部算法都以页面为操作单位。 (第 75 页)
页面通常为 8 KB,可以在一定范围内调整,最大为 32 KB,但只能在编译时指定(./configure --with-blocksize),通常也没有人这样做。编译并启动之后,一个实例只能处理同一种大小的页面,不能创建页面大小各异的表空间。
无论文件属于哪个分支,服务器处理它们的方式都大致相同。页面先进入缓冲区缓存,供各个进程读取和修改,然后在需要时被逐出、写回磁盘。 (第 183 页)
TOAST
每一行都必须完整地放在一个页面内,不能把一行“接着”存到下一个页面。对于很长的行,PostgreSQL 使用 TOAST10(The Oversized Attributes Storage Technique,超长属性存储技术)。
TOAST 有几种策略。可以先把较长的属性值切成小片段,像切“吐司”一样,再放到一张单独的辅助表中;也可以压缩长值,使整行仍能放进一个页面;还可以把两者结合起来,先压缩,再切分并存入辅助表。
如果主表包含可能很长的属性,就会立即为它创建一张单独的 TOAST 表,供所有属性共用。例如,只要表中有 numeric 或 text 类型的列,就会创建 TOAST 表,即使这些列从来不会存储长值。
对索引而言,TOAST 只提供压缩功能,不支持把属性移到单独的表中。这就限制了索引键的大小,具体如何实施这一限制取决于操作符类。 (第 397 页)
策略通常由列的数据类型决定。查看策略最简单的方法是使用 psql 的 \d+ 命令,不过为了缩短输出,这里改用系统目录查询:(psql:\d+)
各个策略的含义如下:
plain:不使用 TOAST,适用于已知较“短”的数据类型,例如 integer;
extended:允许压缩,也允许存到单独的 TOAST 表中;
external:将长值不经压缩地存到 TOAST 表中;
main:优先压缩长值,只有压缩仍不足以解决问题时,才把它们存到 TOAST 表中。
算法大致如下11。PostgreSQL 力求让每个页面至少容纳四行。因此,如果一行的大小超过页面大小的四分之一再减去头部开销(标准页面约为 2000 字节),就需要对部分属性值应用 TOAST。按以下顺序处理,一旦行长不再超过阈值,就立即停止。
首先从最长的属性开始,按从长到短的顺序处理使用 external 和 extended 策略的属性。extended 属性先压缩;如果压缩后的值本身(不计其他属性)仍超过页面的四分之一,就立即将它移到 TOAST 表中。external 属性的处理方式相同,只是不进行压缩。
如果第一轮处理后整行仍放不下,就把剩余采用 external 和 extended 策略的属性逐一移到 TOAST 表中。
如果这仍不够,就尝试压缩采用 main 策略的属性,同时将它们保留在堆页面中。
如果整行仍不够短,就把 main 属性移到 TOAST 表中。
这个阈值仍是 2000 字节,但可以通过表级存储参数 toast_tuple_target 重新设置。
有时,改变某些列的策略会有帮助。如果事先知道列中的数据无法压缩(例如存储 JPEG 图像的列),就可以把它设为 external 策略,省去徒劳的压缩尝试。既可以在建表时通过 CREATE TABLE 命令的 STORAGE 子句指定策略,也可以在之后修改:(v. 16)
再次执行查询,得到:
可用的压缩算法有两种:传统的 PGLZ 和较新的 LZ4,两者都是 Lempel–Ziv 字典压缩算法的变体。默认采用 default_toast_compression 参数指定的算法,也可以用 COMPRESSION 子句为单个列指定算法。基准测试表明,在压缩率与 PGLZ 相近的情况下,LZ4 消耗的 CPU 资源更少。(v. 15)(默认值: pglz)
TOAST 表位于独立的 pg_toast 模式中。该模式不在搜索路径内,因此通常看不到这些表。临时表则使用 pg_toast_temp_N 模式,与普通临时表的 pg_temp_N 模式类似。
当然,只要愿意,总能看看这个过程的内部机制。比如,表 t 有三个可能很长的属性,因此一定存在对应的 TOAST 表。它就在这里:
行被切成的“吐司”片段采用 plain 策略,这是合理的:并不存在第二层 TOAST。
创建 TOAST 表时,还会在同一模式中创建一个索引,访问属性值片段时总是使用这个索引。上面的命令输出中可以看到索引名称,也可以通过查询找到它:
因此,TOAST 表把存储一张表所需的最少文件数增加到了八个:主表的三个分支、TOAST 表的三个分支,以及 TOAST 索引的两个分支。
列 c 使用 extended 策略,它的值会被压缩:
TOAST 表是空的:这些重复字符经 PGLZ 压缩后,已经能放进普通堆页面中。
现在构造一个由随机字符组成的值:
这样的字符序列无法压缩。表行中保存的是 chunk_id 标识符:
值本身则存入 TOAST 表:
可以看到,数据被切成了若干片段。片段大小的选择要使 TOAST 表的一个页面能够容纳四行。随着页面头部大小的变化,这个值在不同版本间可能略有不同。
访问“长”属性时,PostgreSQL 会自动还原原始值并返回给客户端,这个过程对应用完全透明。如果查询没有用到这些属性,就不会读取 TOAST 表。这也是生产代码中不宜使用“星号”的原因之一。
如果客户端只请求长值的开头部分,就只会读取所需的片段,即使该值以压缩形式存储也是如此。(v. 13)
不过,压缩、切分以及之后的还原都会消耗相当多的资源。因此,把大块数据存入 PostgreSQL 并不是个好主意,尤其是数据经常被使用、又不需要事务逻辑时,例如扫描的会计凭证原件。一个可能更划算的选择是把这些数据存入文件系统,而在数据库中只保存相应的文件名。不过,这样一来,数据库管理系统就无法保证数据的一致性了。
使用带有 analyze 和 serialize 参数的 EXPLAIN 命令,可以估算还原经 TOAST 处理的值所需的开销。(v. 17)
1.2. 进程与内存
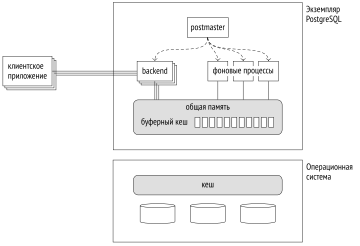
PostgreSQL 服务器实例由多个相互协作的进程组成。
服务器启动时,首先启动 postgres 进程,习惯上称为 postmaster。它负责启动所有其他进程(类 Unix 系统通过 fork 系统调用实现),并“照看”它们。如果某个进程异常退出,postmaster 就会重启它;如果认为该进程可能破坏了共享数据,则会重启整个服务器。
由于进程模型简单,PostgreSQL 从项目诞生时起就采用了这一模型,关于改用线程的讨论也从未停止。
当前模型有一些缺点:静态分配的共享内存使缓冲区缓存等结构无法在运行时调整大小;并行算法实现复杂,效率也低于本来可能达到的水平;会话与进程紧密绑定。改用线程看起来很有前景,但也会带来隔离性、操作系统兼容性和资源管理方面的难题。更不用说,这需要对代码作出根本性修改,耗费多年工作。目前仍是保守观点占上风,在近期看不到改变的迹象。
服务器的运行由一组辅助进程支撑,主要包括:
startup:在故障后恢复系统; (第 223 页)
autovacuum:清理表和索引中的失效数据; (第 138 页)
wal writer:把日志记录写入磁盘; (第 236 页)
checkpointer:执行检查点; (第 219 页)
writer:把脏页面写入磁盘; (第 226 页)
wal sender:把日志记录发送给副本;
wal receiver:在副本上接收日志记录。
其中一些进程在完成任务后便会退出,一些始终在后台运行,还有一些可以禁用。
每个进程都由配置参数控制,有时涉及数十个参数。要合理配置服务器,就必须充分了解其内部结构。不过,仅凭一般原理只能选择合适的初始值,之后仍需根据监控反馈不断调整。
为了让进程能够交换信息,postmaster 会分配所有进程都能访问的共享内存。
磁盘的速度远低于内存,HDD 尤其如此,SSD 也不例外,因此需要使用缓存:在共享内存中留出空间存放最近读取的页面,希望它们还会被多次使用,从而省去重复访问磁盘的开销。修改后的数据也不会立即写入磁盘,而是过一段时间再写入。 (第 183 页)
缓冲区缓存占用了共享内存的大部分空间。此外,共享内存中还有其他缓冲区,用来加快服务器的磁盘访问。
操作系统也有自己的缓存。PostgreSQL 几乎不使用绕过操作系统机制的直接 I/O,因此形成了双重缓存。
发生故障时,例如意外断电或操作系统崩溃,内存中的内容都会丢失,包括缓冲区缓存。磁盘上留下的文件,其页面是在不同时间写入的。
为了能够恢复数据的一致性,PostgreSQL 在运行过程中维护预写式日志(WAL),必要时可以据此重新执行丢失的操作。 (第 211 页)
1.3. 客户端与客户端/服务器协议
postmaster 进程的另一项任务是监听传入连接。有新客户端到来时,postmaster 会为它创建一个后端进程12(backend)。客户端建立连接,开始与自己的服务器进程进行会话。会话一直持续到客户端主动断开,或连接中断为止。
服务器会为每个客户端创建一个独立的后端进程。连接过多可能带来一些问题:
每个进程都需要内存来存放系统目录缓存、预备语句、执行查询时的中间结果,以及其他数据。打开的连接越多,需要的可用内存就越多。 (第 340 页) (第 338 页)
如果频繁建立连接,而会话又很短(客户端执行一个小查询便断开),建立连接、创建新进程以及无谓地填充本地缓存就会消耗过多资源。
启动的进程越多,遍历进程列表所需的时间就越长,而这项操作会被频繁执行。因此,随着客户端数量增加,性能可能下降。 (第 99 页)
这时可以使用连接池来限制后端进程数量。PostgreSQL 没有内置连接池,因此需要第三方方案:集成在应用服务器中的连接池管理器,或 PgBouncer13、Odyssey14 这样的外部程序。通常,服务器上的同一个进程会依次执行不同客户端的事务。这给应用开发带来了一定限制:可以使用局限于事务范围的功能,却不能依赖会话范围的功能。
客户端与服务器要相互理解,就必须使用同一种通信协议15。通常通过自带的 libpq 库实现这一协议,但也有独立实现。
概括地说,这个协议允许客户端连接服务器并执行 SQL 查询。
连接总是以某个角色(用户)的身份建立,并指向一个具体的数据库。虽然服务器管理的是整个数据库集簇,但应用若要同时使用多个数据库,就必须分别连接到每个数据库。连接时会进行身份验证:后端进程确认用户确实是其声称的身份,例如通过询问密码;同时还会检查该用户是否有权连接服务器和选定的数据库。
SQL 查询以文本形式传给后端进程。后端进程解析文本、优化查询、执行查询,然后把结果返回给客户端。