29 Индекс BRIN
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
29.1. Общий принцип
В отличие от остальных индексов, BRIN 1 предназначен не для быстрого поиска нужных строк, а для того, чтобы избежать просмотра заведомо ненужных. Этот метод доступа создавался в расчете на таблицы размером в единицы и десятки терабайт, так что меньшему объему отдается предпочтение перед точностью поиска.
Для ускорения поиска вся таблица разбивается на зоны (range) размером в несколько страниц. Отсюда и название: Block Range Index, BRIN. Индекс не хранит идентификаторы версий, а ограничивается лишь сводной информацией о данных в каждой зоне. Для порядковых типов данных в простом случае это минимальное и максимальное значения, но разные классы операторов могут собирать разную информацию о значениях в зоне.
Количество страниц в зоне устанавливается при создании индекса параметром хранения pages_per_range. (по умолчанию: 128)
При выполнении запроса, содержащего условие на проиндексированный столбец, можно целиком пропустить все зоны, значения в которых гарантированно не попадают под условие запроса. Все страницы остальных зон возвращаются индексом в виде неточной битовой карты; все строки на этих страницах проверяются на выполнение условия. (с. 428)
Таким образом, BRIN хорошо работает для столбцов, значения в которых локализованы, то есть когда значения, хранящиеся рядом, имеют схожие (в смысле сводной информации) свойства. Для порядковых типов данных это означает, что значения должны быть физически расположены в таблице в порядке возрастания или убывания, то есть иметь высокую корреляцию между физическим расположением и логическим порядком, определяемым операциями «больше» и «меньше». Для других типов сводной информации требования к «схожим свойствам» могут отличаться. (с. 361)
Не будет ошибкой рассматривать BRIN не как индекс в обычном понимании, а как ускоритель последовательного сканирования таблицы. Можно посмотреть на него и как на аналог секционирования, если каждую зону считать отдельной «виртуальной» секцией.
29.2. Пример
В демонстрационной базе данных нет достаточно больших для BRIN таблиц, но можно представить, что для нужд аналитической отчетности требуется денормализованная таблица с информацией о вылетевших из аэропорта и приземлившихся в аэропорту рейсах с точностью до места в салоне. Данные по каждому аэропорту добавляются в таблицу раз в сутки, как только в соответствующем часовом поясе наступает полночь. После добавления данные не изменяются и не удаляются.
Таблица имеет следующий вид:
Процедуру загрузки данных можно имитировать вложенными циклами 2: внешний — по дням (в демобазе хранятся данные за год), внутренний — по часовым поясам. В результате такого заполнения данные в таблице окажутся более или менее упорядочены как минимум по времени и по географии аэропортов, несмотря на отсутствие сортировки в запросе внутри цикла.
Я сразу загружу готовую копию таблицы, занимающую примерно 4 Гбайта и содержащую около 30 млн строк 3:
Такой объем данных сложно назвать большим, но его будет достаточно, чтобы изучить работу метода BRIN. Один индекс я создам заранее:
С параметрами по умолчанию он занимает совсем мало места.
Индекс на основе B-дерева, даже с учетом компактного хранения дубликатов, оказывается в тысячу раз больше. Конечно, и эффективность такого индекса существенно выше, но для действительно больших таблиц дополнительный объем может оказаться непозволительной роскошью. (v. 13)
29.3. Страничная организация
Нулевая страница BRIN-индекса — метастраница с информацией о структуре индекса.
С некоторым отступом от метаданных находятся страницы со сводной информацией. Каждая индексная строка на такой странице содержит сводку по какой-то одной зоне.
Между метастраницей и сводными данными располагается карта зон (range map), которая иногда называется обратной картой (reverse range map, отсюда принятое сокращение revmap). По сути, это массив указателей на соответствующие индексные строки; номер позиции в массиве равен номеру зоны.
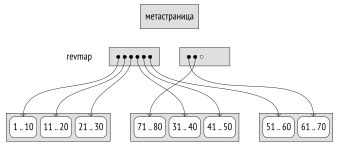
При расширении таблицы размер карты зон увеличивается. Если карта перестает помещаться в отведенные ей страницы, она захватывает следующую, а все индексные строки, которые там были, переносятся на другие страницы. Поскольку на странице помещается много указателей, такие перестановки случаются редко.
Страницы BRIN-индекса можно изучать, как обычно, с помощью расширения pageinspect. Метаинформация показывает размер зоны и количество страниц, отведенных под карту зон:
Здесь карта зон занимает четыре страницы, с первой по четвертую. Можно получить ссылки на индексные записи о сводных данных:
Если зона еще не обобщена (то есть для нее нет сводной информации), указатель в карте зон будет пустым.
Вот и сами сводные данные для нескольких первых зон:
29.4. Поиск
При поиске по условию, которое поддерживается индексом BRIN4, просматривается карта зон и сводная информация по каждой зоне. Если данные в зоне могут соответствовать ключу поиска, все страницы зоны добавляются к битовой карте. Поскольку индекс не хранит идентификаторы отдельных строк, битовая карта изначально строится с точностью до страниц.
Соответствие данных ключу определяется с помощью опорной функции согласованности, которая понимает смысл сводной информации. Конечно, зоны без сводной информации всегда добавляются к битовой карте.
Получившаяся в итоге битовая карта используется для сканирования таблицы обычным образом. Важно, что табличные страницы читаются последовательными фрагментами и используется предвыборка. (с. 427)
29.5. Обновление сводной информации
Вставка значений
При добавлении новой версии строки в табличную страницу обновляется сводная информация в соответствующей зоне индекса5. Номер зоны вычисляется по номеру страницы простыми арифметическими действиями, и с помощью карты зон читается сводная информация.
Нужно ли расширять имеющуюся сводную информацию, решает опорная функция добавления значения. Если расширение необходимо, оно происходит по месту (без создания новой индексной строки) при наличии на странице достаточного пространства.
Пусть, например, на странице 13 появилась версия строки со значением 42. Номер зоны (начиная с нуля) вычисляется целочисленным делением номера страницы на размер зоны. Считая, что размер зоны равен четырем страницам, получаем зону № 3, и в карте зон берем четвертый по счету указатель. Минимальное значение для этой зоны — 31, максимальное — 40. Новое значение выходит за эти пределы, и максимальное значение обновляется:
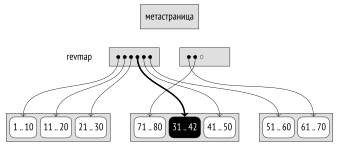
Если обновление по месту невозможно, создается новая строка, и тогда карта зон изменяется.
Обобщение зоны
Все сказанное касается случая, когда новая версия строки появляется в зоне, для которой уже есть сводная информация. При построении индекса обобщаются все существующие зоны, но при дальнейшем росте таблицы могут появиться новые страницы, выходящие за этот диапазон.
Если создать индекс с параметром хранения autosummarize, то новая зона будет обобщаться немедленно. Но поскольку обычно в хранилищах данных строки добавляются не по одной, а большими пакетами, такой режим может сильно замедлять вставку. (по умолчанию: off)
По умолчанию немедленного обобщения новых зон не происходит. Это не нарушает корректность работы индекса, поскольку зоны без сводной информации просматриваются полностью. Обобщение выполняется асинхронно при очистке таблицы, либо его можно инициировать вручную, вызвав функцию brin_summarize_new_values или brin_summarize_range (для отдельной зоны). (с. 142)
Обобщение зоны 6 не блокирует изменение данных в таблице. Сначала в индекс вставляется строка-пустышка (placeholder). Если во время сканирования зоны данные поменяются, пустышка обновится и будет содержать сводную информацию по случившимся изменениям. Затем данные из этой строки объединяются с вычисленной сводной информацией по зоне с помощью опорной функции объединения.
При удалении строк из таблицы в некоторых случаях сводная информация могла бы сжаться. Но если в GiST-индексе пересчет происходит хотя бы при разделении страницы, в индексах BRIN сводная информация только расширяется и никогда не сжимается. Обычно этого и не требуется, поскольку хранилища данных используются, как правило, только для добавления данных. Конечно, можно вручную удалить сводную информацию, вызвав функцию brin_desummarize_range, и заново обобщить зону. Однако нет никакой подсказки, для каких зон такой пересчет может быть полезен. (с. 557)
Таким образом, BRIN в первую очередь рассчитан на таблицы очень большого размера, которые либо не обновляются, либо обновляются очень незначительно, и, соответственно, новые строки в них добавляются преимущественно в конец файла. Основная область его применения — хранилища данных и аналитическая отчетность.
29.6. Диапазоны значений (minmax)
Для типов данных, значения которых можно сравнивать между собой, сводная информация в самом простом случае состоит из минимального и максимального значений. Соответствующие классы операторов содержат в названии слово minmax 7: (psql: \dAc)
Опорные функции этих классов операторов: (psql: \dAp)
Первая функция возвращает служебную информацию о классе операторов, а остальные я уже описывал: это функции добавления значения, согласованности и объединения.
В классе minmax используются те же самые операторы сравнения, что и в B-дереве: (с. 546) (psql: \dAo)
Выбор столбцов для индексирования
По каким столбцам имеет смысл строить BRIN-индекс с таким классом операторов? Я уже говорил, что индекс будет хорошо работать, если физическое расположение строк коррелирует с логическим порядком значений.
Проверим это на подготовленном выше примере.
Данные упорядочены по времени (как по плановому, так и по реальному — разница если и есть, то несущественная), поскольку добавляются в хронологическом порядке, а в отсутствие удалений и обновлений строки укладываются в файл основного слоя таблицы последовательно, одна за другой. (с. 29)
Столбцы fare_conditions, flight_type и airport_utc_offset показывают относительно высокую корреляцию, но в них слишком мало уникальных значений.
Корреляция остальных столбцов слишком мала, чтобы их индексирование с помощью диапазонного класса операторов представляло интерес.
Размер зоны и эффективность поиска
Подсказкой для определения подходящего размера зоны может послужить количество страниц, на которых встречаются значения.
Рассмотрим время по расписанию scheduled_time и предположим, что запросы выбирают данные по рейсам за сутки. Посчитаем, сколько страниц занимают в таблице одни сутки.
Для этого мы воспользуемся тем, что идентификатор версии строки состоит из номера страницы и смещения. К сожалению, нет штатного способа разложить идентификатор на две его составляющие, поэтому придется написать некрасивую функцию, приводящую типы через текстовое представление:
Теперь можно посмотреть распределение суток по таблице:
Видно, что распределение не совсем равномерное. При стандартном размере зоны в 128 страниц каждые сутки будут занимать от 9 до 12 зон. Получая информацию за одни сутки, сканирование захватит как нужные строки, так и часть строк, относящихся к другим суткам, но попавших в те же зоны. Чем больше размер зоны, тем больше будет прочитано лишних пограничных значений; уменьшая или увеличивая размер зоны, можно увеличить или уменьшить их количество.
Попробуем выполнить запрос, взяв какой-нибудь один день (индекс с параметрами по умолчанию я уже создал выше). Для упрощения картины я отключу параллельное выполнение:
Можно определить коэффициент полезного действия BRIN-индекса для некоторого запроса как отношение количества страниц, которые удалось пропустить при индексном сканировании, к общему количеству страниц в таблице. При нулевом КПД индексный доступ вырождается в последовательное сканирование (если не учитывать накладные расходы). Чем выше КПД, тем меньше страниц приходится читать. Но часть страниц содержат искомые данные, которые никак нельзя пропустить, поэтому КПД всегда меньше единицы. (с. 436)
В данном случае КПД составляет ≈ 0,997, где 528 417 — количество страниц в таблице.
Однако бессмысленно делать какие-то выводы по одному значению. Даже при равномерных исходных данных и идеальной корреляции эффективность будет отличаться как минимум из-за того, что границы зон будут расположены по-разному. Полную картину можно получить, лишь рассматривая КПД как случайную величину и изучая ее распределение.
Для нашего примера можно взять все различные сутки за год, проверить план выполнения для каждого значения и рассчитать статистические показатели по получившейся выборке. Процесс нетрудно автоматизировать, воспользовавшись тем, что команда EXPLAIN может выдавать результат в формате JSON, удобном для обработки. Я не буду приводить полный код, но следующий небольшой фрагмент содержит все существенные детали.
Результаты можно представить наглядно с помощью диаграммы размаха, именуемой также «ящиком с усами». Усы обозначают первый и четвертый квартиль (то есть в правый ус попадают 25 % наибольших значений, а в левый — 25 % наименьших). Ящик составляют оставшиеся 50 % значений; в нем также отмечена медиана. Что важно, такое компактное изображение позволяет наглядно сравнивать между собой результаты. На рисунке показано распределение КПД как для размера зоны по умолчанию, так и для двух других значений, отличающихся от него в четыре раза:
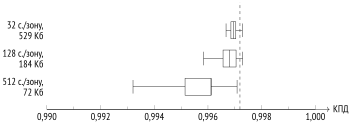
Как и следовало ожидать, точность и эффективность поиска высоки даже для довольно большой зоны.
На рисунке пунктиром отмечено среднее значение максимально возможного КПД для этого запроса исходя из того, что одни сутки занимают примерно часть таблицы. Обратите внимание, что эффективность растет не бесплатно: вместе с ней увеличивается и размер индекса. BRIN довольно гибко позволяет находить компромисс между одним и другим.
Свойства
Свойства BRIN постоянны и не зависят от конкретного класса операторов.
Свойства уровня метода доступа
Сортировка и поддержка уникальности, разумеется, отсутствуют. Из-за того, что индекс BRIN всегда возвращает битовую карту, нет поддержки и ограничений исключения. Дополнительные include-столбцы тоже лишены смысла, поскольку в индексе не хранятся даже сами ключи индексирования.
А вот создать составной BRIN-индекс можно. В этом случае сводная информация по каждому столбцу собирается и сохраняется в отдельной индексной строке, но привязка к зонам остается общей. Такой индекс имеет смысл, если для всех столбцов подходит один и тот же размер зоны.
В качестве альтернативы составному индексу можно создать BRIN-индексы по отдельным столбцам и пользоваться тем, что битовые карты могут комбинироваться. (с. 429)
Например:
BRIN-индексы для больших таблиц могут создаваться параллельно. Таблица сканируется несколькими процессами, которые рассчитывают сводную информацию по своей части данных. Эта информация сортируется по зонам (выделяется память размером maintenance_work_mem), затем ведущий процесс агрегирует ее и формирует индекс8. (v. 17) (с. 552) (по умолчанию: 64MB)
Свойства уровня индекса
Очевидно, что поддерживается только сканирование по битовой карте.
Отсутствие кластеризации может вызвать некоторое недоумение. Казалось бы, раз BRIN-индекс чувствителен к физическому порядку строк, то логично было бы уметь перестраивать порядок, максимизируя эффективность индекса. Но в любом случае кластеризация больших таблиц — слишком дорогое удовольствие, учитывая объем необходимой работы и расход места на диске на время перестроения. К тому же, как показывает пример с таблицей flights_bi, некоторая упорядоченность в хранилищах данных может возникать естественным образом.
Свойства уровня столбца
Из свойств уровня столбца не доступно ничего, кроме возможности работы с неопределенными значениями. Наличие NULL в зоне учитывается отдельным признаком в сводной информации:
29.7. Мультидиапазоны значений (minmax-multi)
Сложившуюся корреляцию легко нарушить, изменяя данные. Дело здесь не в изменении какого-то конкретного значения, а в устройстве многоверсионности: старая версия строки удаляется на одной странице, а новая может быть вставлена на другую. Из-за этого при обновлениях версии строк перемешиваются. (v. 14) (с. 80)
Отчасти с этим явлением можно бороться, уменьшая значение параметра хранения fillfactor, чтобы оставить запас места на странице под будущие обновления. Вот только захочется ли увеличивать объем и без того огромной таблицы? К тому же остаются удаления, которые освобождают место внутри существующих страниц и таким образом готовят «ловушки» для новых строк, которые иначе попали бы в конец файла.
Такую ситуацию несложно смоделировать. Сначала удалим 0,1 % случайных строк и выполним очистку, чтобы освободить место для новых версий:
Затем добавим в таблицу новый день для одного из часовых поясов. Я просто скопирую данные предыдущих суток, увеличив день на единицу:
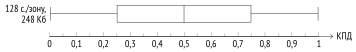
Количества удаленных строк достаточно, чтобы в каждой или почти каждой зоне оказались свободные места. Новые строки, попадая во внутренние страницы, автоматически расширили диапазоны значений. Вот сводная информация по первой зоне, и если раньше она охватывала неполные сутки, то теперь — целый год:
Чем меньше дата, используемая в запросе, тем больше зон придется перебрать. Диаграмма показывает масштаб бедствия:
Для решения этой проблемы необходимо усложнить сводную информацию: вместо одного непрерывного диапазона хранить несколько, суммарно покрывающих все значения. Тогда один диапазон сможет охватить основной набор данных, а другие — отдельные выбросы.
Именно такую возможность и реализуют классы операторов, содержащие в своем названии minmax_multi 9: (psql: \dAc)
По сравнению с классами операторов minmax, к опорным функциям добавляется еще одна для вычисления расстояния между двумя значениями — она необходима для определения длины диапазона, которую класс операторов старается минимизировать: (psql: \dAp)
Сами операторы, составляющие такие классы, ровно те же, что и для классов minmax.
Мультидиапазонные классы могут принимать параметр values_per_range, определяющий максимальное количество сводных значений для одной зоны. Для представления диапазона требуется два значения, а для отдельной точки — одно. При нехватке значений часть интервалов «схлопывается»10. (по умолчанию: 32)
Построим мультидиапазонный индекс вместо существующего. Для примера ограничимся 16 сводными значениями:
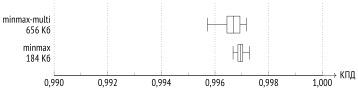
Диаграмма показывает, что эффективность поиска с новым индексом вернулась к старым значениям — конечно, ценой увеличения размера индекса:
29.8. Охватывающие значения (inclusion)
Разница между диапазонными и охватывающими классами операторов примерно такая же, как между B-деревьями и GiST: последние предназначены для типов данных, к которым неприменимы операции сравнения, но для которых имеет смысл взаимное расположение. Сводная информация охватывающих классов операторов представлена областью, ограничивающей все входящие в зону значения.
Вот эти классы операторов, их немного: (psql: \dAc)
К опорным функциям добавляется функция слияния двух значений и некоторое количество необязательных функций: (psql: \dAp)
Если про значения, совместимые с операторами сравнения, мы могли делать выводы на основе статистики по корреляции, то для других типов данных такая статистика не собирается 11. Поэтому сложно заранее спрогнозировать, насколько хорошо будет работать охватывающий BRIN-индекс.
Хуже того, от корреляции существенно зависит оценка стоимости индексного сканирования. Если такая статистика отсутствует, она считается равной нулю12. Поэтому планировщик, увы, никак не различает точные и неточные inclusion-индексы и, как правило, отказывается их использовать. (v. 3.1.1)
PostGIS собирает статистику по корреляции для пространственных данных.
В нашем примере мы можем предположить, что индекс по координатам аэропортов имеет смысл, поскольку долгота должна коррелировать с часовым поясом.
В отличие от предикатов GiST, сводные значения BRIN имеют тот же тип, что и индексируемые данные, поэтому просто так не удастся построить индекс для точек. Но мы можем создать индекс по выражению, преобразовав точки в вырожденные прямоугольники:
Индекс по часовым поясам с зоной такого же размера занимает примерно тот же объем — 3288 Кбайт.
Операторы, входящие в класс, соответствуют операторам GiST-классов. Например, с помощью индекса можно ускорять поиск точек в заданной области:
Но, как я и говорил, планировщик отказывается использовать индекс без отключения последовательного сканирования:
29.9. Фильтры Блума (bloom)
Классы операторов, построенные на фильтрах Блума, позволяют использовать BRIN с любыми типами данных, для которых определена операция «равно» и имеется хеш-функция. Пригодятся они и для обычных порядковых типов в ситуациях, когда значения локализованы в отдельных зонах, но при этом расположение не коррелирует с логическим порядком. (v. 14)
Названия таких классов операторов содержат слово bloom 13: (psql: \dAc)
Классический фильтр Блума — структура данных, позволяющая быстро проверить принадлежность элемента множеству. Фильтр очень компактен, но допускает ложноположительные срабатывания (false positive), то есть может приписать множеству лишние элементы. Важно, что ложноотрицательных срабатываний (false negative) быть не может: фильтр не имеет права решить, что элемента нет в множестве, если на самом деле он там присутствует.
Фильтр представляет собой битовый массив (называемый также сигнатурой) длиной m бит, изначально заполненный нулями. Выбираются k различных хеш-функций, которые отображают любой элемент множества в k бит сигнатуры. Добавление элемента к множеству сводится к установке в сигнатуре каждого из этих битов в единицу. Следовательно, если все соответствующие элементу биты установлены в единицу, элемент может присутствовать в множестве; если хотя бы один из этих битов равен нулю — элемент точно отсутствует.
В случае BRIN-индекса фильтр работает с множеством значений индексируемого столбца, содержащихся в определенной зоне; сводная информация этой зоны представляется построенным фильтром Блума.
Расширение bloom 14 предоставляет самостоятельный индексный метод доступа, основанный на фильтрах Блума. В нем фильтр строится для каждой строки таблицы и работает с множеством значений столбцов этой строки. Такой индекс рассчитан на индексацию сразу нескольких столбцов и полезен для adhoc-запросов, когда неизвестно, на какие именно столбцы будут накладываться условия. BRIN-индекс тоже можно создать по нескольким столбцам, но в этом случае сводная информация будет содержать несколько независимых фильтров Блума для каждого из столбцов.
Точность фильтра Блума зависит от длины сигнатуры. Теория говорит, что оптимальное количество битов сигнатуры можно оценить как , где n — число элементов множества, а p — вероятность ложного срабатывания фильтра.
Эти два значения и вынесены в параметры класса операторов:
n_distinct_per_range — число элементов множества; в нашем случае это количество уникальных значений индексируемого столбца в одной зоне. Значения интерпретируются так же, как статистика уникальных значений: отрицательные числа показывают долю от числа строк в зоне, а не абсолютное количество. (по умолчанию:
-0.1) (с. 351)false_positive_rate — вероятность ложноположительных срабатываний. (по умолчанию:
0.01)
Вероятность, близкая к нулю, говорит о том, что индексное сканирование не будет заглядывать в зоны, где нет искомых значений. Но она не гарантирует точность поиска, поскольку в просматриваемых зонах, помимо нужных значений, будут находиться и «лишние» строки. Это определяется не свойствами фильтра, а шириной зоны и физическим расположением данных.
К опорным функциям класса операторов добавляется функция вычисления хеш-кода: (psql: \dAp)
Поскольку фильтр Блума основан на хешировании, единственный поддерживаемый оператор — оператор равенства: (psql: \dAo)
В качестве примера возьмем столбец с номером рейса flight_no, имеющий околонулевую корреляцию и поэтому безнадежный для обычного диапазонного класса операторов. Настройку вероятности ложного срабатывания менять не будем, а количество уникальных значений в зоне можно вычислить. Например, для восьмистраничной зоны получим:
Для зон меньшего размера это количество будет еще меньше (в любом случае класс операторов не принимает значения, меньшие 16).
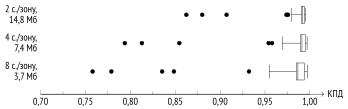
Остается создать индекс и проверить план выполнения запроса:
Из диаграммы видно, что для некоторых номеров рейсов (показанных отдельными точками вне усов) индекс работает не очень хорошо, но в целом его эффективность довольно высока:
postgrespro.ru/docs/postgresql/18/brin; backend/access/brin/README. ↩︎
backend/access/brin/brin.c, функция bringetbitmap. ↩︎
backend/access/brin/brin.c, функция brininsert. ↩︎
backend/access/brin/brin.c, функция summarize_range. ↩︎
backend/access/brin/brin.c, функция brinbuild. ↩︎
backend/access/brin/brin_minmax_multi.c, функция reduce_expanded_ranges. ↩︎
backend/commands/analyze.c, функция compute_scalar_stats. ↩︎
backend/utils/adt/selfuncs.c, функция brincostestimate. ↩︎