28 Индекс GIN
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
28.1. Общий принцип
По задумке авторов, GIN — не американский спиртной напиток, а могущественный и неустрашимый дух 1. Но есть и формальная расшифровка: Generalized Inverted Index, обобщенный обратный (инвертированный) индекс.
Этот метод доступа работает с типами данных, значения которых состоят из элементов, а не являются атомарными (так, например, в контексте полнотекстового поиска документы состоят из лексем). При этом индексируются не сами значения, как мы видели в случае GiST, а только их элементы; от каждого элемента по индексу можно перейти ко всем значениям, в которых этот элемент встречается.
Хорошая аналогия для этого метода — предметный указатель в конце книги. В указателе собраны все важные термины, и для каждого приведен список страниц, на которых этот термин упоминается. Чтобы указателем было удобно пользоваться, он составляется по алфавиту, иначе в нем было бы невозможно быстро ориентироваться. Так и GIN полагается на то, что элементы составных значений можно упорядочить, и в качестве основной структуры данных использует B-дерево. (с. 523)
Реализация дерева элементов GIN во многом более проста, чем «настоящее» B-дерево, но изначально рассчитана на то, что разные значения будут состоять из относительно небольшого набора многократно повторяющихся элементов.
Из этого предположения следуют два важных вывода:
- Элементы в индексе следует хранить в единственном экземпляре.
С каждым элементом связан список идентификаторов версий. Если такой список (posting list) не слишком велик, то он хранится вместе с элементом, но при увеличении может быть вынесен в отдельное B-дерево (posting tree). Упорядочены не только деревья, но и списки идентификаторов; это не имеет значения для пользователя, но позволяет ускорить доступ и уменьшить объем.
- Нет смысла удалять элементы из дерева.
Если набор идентификаторов элемента оказался пустым, с большой вероятностью тот же элемент появится снова в составе другого значения.
Таким образом, индекс состоит из дерева элементов, к листовым записям которого привязаны либо плоские списки, либо деревья идентификаторов.
Как и рассмотренные ранее методы доступа GiST и SP-GiST, GIN позволяет индексировать самые разные типы данных, предоставляя упрощенный интерфейс класса операторов. Обычно операторы этого класса проверяют, удовлетворяет ли проиндексированное составное значение некоторому набору элементов (как, например, в случае полнотекстового поиска оператор @@ проверяет соответствие документа запросу).
Для работы с конкретными типами данных метод GIN должен уметь разбивать составные значения на лексемы, сортировать лексемы и проверять, соответствует ли найденное значение запросу. Эти операции реализуются опорными функциями класса операторов.
28.2. Индекс для полнотекстового поиска
Основная область применения GIN — ускорение полнотекстового поиска, поэтому я продолжу пример, начатый в главе про GiST-индекс. Понятно, что составными значениями в этом случае являются документы, а элементами этих значений — лексемы. (с. 578)
Построим GIN-индекс на таблице c «Во поле береза…»: (с. 579)
Возможная структура такого индекса показана на рисунке:
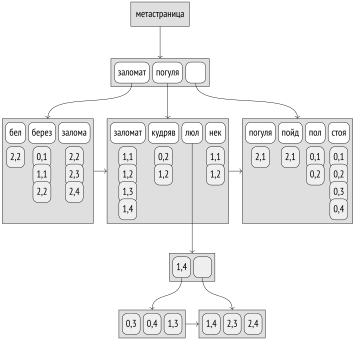
В отличие от предыдущих иллюстраций, здесь показаны (и выделены цветом) конкретные значения идентификаторов, поскольку они будут важны для понимания алгоритмов. Значения предполагают, что строки таблицы имеют следующие идентификаторы:
Обратите внимание на некоторые отличия от обычного индекса на основе B-дерева. Крайний левый ключ во внутренних узлах B-дерева пуст из-за его избыточности; в GIN-индексе он не хранится вовсе. Из-за этого оказываются сдвинутыми и ссылки на дочерние узлы. Верхний ключ используется в обоих индексах, но в GIN он располагается на своем законном месте в крайней правой позиции. Узлы одного уровня B-дерева соединены двунаправленным списком; в GIN-индексе — однонаправленным, поскольку обход дерева выполняется всегда только в одну сторону. (с. 529)
В нашем умозрительном примере все списки идентификаторов поместились в обычные страницы, за исключением списка для лексемы «люл». Эта лексема встретилась в целых шести документах, и ее идентификаторы были перенесены в отдельное дерево.
Страничная организация
С точки зрения страничной организации GIN очень похож на B-дерево. Заглянуть внутрь индекса можно с помощью расширения pageinspect. Создадим GIN-индекс на таблице почтовой рассылки pgsql-hackers: (с. 584)
Нулевая страница (метастраница) содержит общую статистику, такую как количество элементов и страниц других типов:
GIN использует специальную область индексных страниц, например чтобы сохранить в ней биты, определяющие тип страницы: (с. 76)
Страница с признаком meta — это, конечно, метастраница. Страницы с признаком data относятся к деревьям идентификаторов, а страницы без этого признака — к деревьям элементов. Внутри деревьев выделяются листовые страницы, несущие признак leaf.
Еще одна функция расширения pageinspect выдает информацию об идентификаторах, хранящихся в листовых страницах деревьев. Фактически каждая запись такого дерева содержит не один идентификатор, а небольшой список:
Идентификаторы в списках упорядочены, что позволяет сжимать данные (отсюда признак compressed). Вместо шестибайтного значения tid хранится разность с предыдущим значением, которая кодируется переменным числом байтов 2: чем меньше эта разность, тем меньше места занимают данные.
Класс операторов
Вот список опорных функций для классов операторов GIN 3: (psql: \dAp)
Первая опорная функция сравнивает два элемента, в данном случае — лексемы. Если бы лексемы были представлены обычным типом SQL, для которого определен класс операторов B-дерева, то GIN автоматически использовал бы операторы сравнения из этого класса. (с. 546)
Пятая (необязательная) функция используется при частичном поиске и проверяет частичное соответствие элемента индекса ключу запроса. В нашем случае частичный поиск — это поиск лексем по префиксу. Например, запрос «п:*» соответствует всем лексемам на букву «п».
Вторая функция выделяет лексемы из документа, а третья — из поискового запроса. Разные функции нужны хотя бы потому, что документ и запрос представлены разными типами данных, tsvector и tsquery. К тому же функция для поискового запроса определяет, как будет выполняться поиск. Если запрос требует наличия в документе какой-либо лексемы, при поиске будут рассматриваться документы, содержащие хотя бы одну лексему из запроса. Если же такого условия нет (например, нужны документы, не содержащие определенную лексему), будут рассматриваться все документы вообще — что, конечно, значительно дороже. (v. 13)
При наличии в запросе других ключей поиска индекс сначала сканируется по ним, а затем полученные результаты перепроверяются. Это позволяет избежать бесполезного просмотра индекса.
Четвертая и шестая — функции согласованности, которые определяют соответствие найденного документа поисковому запросу. Четвертая функция получает на вход точные данные о том, какая лексема из запроса содержится в документе, а какая — нет. Шестая функция работает в условиях неопределенности и может вызываться, когда для части лексем еще неизвестно, присутствуют ли они в документе. Класс операторов не обязан реализовывать обе функции: достаточно предоставить одну, но в таком случае поиск может проиграть в эффективности.
Класс операторов tsvector_ops поддерживает только один оператор сопоставления документа с поисковым запросом 4 @@ — ровно тот же, который включает и класс операторов GiST.
Поиск
Рассмотрим процесс выполнения поиска по запросу «стояла | кудрявая», в котором две лексемы соединены условием «или». Сначала с помощью опорной функции 5 из поискового запроса типа tsquery выделяются отдельные лексемы (ключи поиска): «стоя» и «кудряв».
Поскольку запрос требует наличия определенных лексем, формируется список идентификаторов документов, содержащих хотя бы один ключ из запроса. Для этого в дереве лексем отыскиваются идентификаторы, соответствующие каждому ключу поиска, и из них составляется один общий список. В индексе все идентификаторы хранятся упорядоченно, что дает возможность использовать слияние нескольких отсортированных потоков идентификаторов в один6. (с. 483)
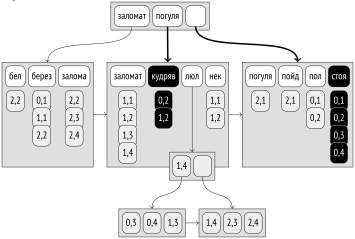
Заметьте, что пока не имеет значения, были ли ключи объединены условием «и», «или» либо каким-то еще, — движок поиска по дереву работает со списком ключей и ничего не знает о смысле поискового запроса.
Каждый найденный идентификатор, соответствующий документу, проверяется опорной функцией согласованности7. Эта функция как раз таки знает, как интерпретировать поисковый запрос, и оставляет только те идентификаторы, которые ему соответствуют (или по крайней мере могут соответствовать и нуждаются в перепроверке по таблице).
В данном случае функция согласованности оставит все идентификаторы:
| tid | «стоя» | «кудряв» | функция согласованности |
|---|---|---|---|
| (0,1) | ✓ | – | ✓ |
| (0,2) | ✓ | ✓ | ✓ |
| (0,3) | ✓ | – | ✓ |
| (0,4) | ✓ | – | ✓ |
| (1,2) | – | ✓ | ✓ |
Вместо обычной лексемы в поисковом запросе может быть указан префикс. Это полезно в случаях, когда пользователь приложения может ввести в поле поиска первые буквы слова, ожидая получить по ним результаты. Например, для запроса «залом:*» будут найдены документы с лексемами, начинающимися на «залом»: «залома» (которая получилась из слова «заломаю») и «заломат» (из слова «заломати»).
При таком частичном поиске проиндексированные лексемы сравниваются с ключом поиска с помощью отдельной опорной функции8, которая в общем случае может реализовывать не только проверку совпадения префикса, но и другую логику частичного соответствия.
Частые и редкие лексемы
Если лексемы, использованные в поисковом запросе, встречаются часто, сформированный список идентификаторов версий окажется длинным, что, конечно, накладно. К счастью, этого зачастую можно избежать, если в запросе присутствуют и редкие лексемы.
Рассмотрим выполнение запроса «люли & заломаю». Лексема «залома» встречается три раза, а «люл» — шесть. Вместо того чтобы считать обе лексемы равноправными и собирать полный перечень идентификаторов по обеим, редкая лексема «залома» считается обязательной, а более частая «люл» — дополнительной, поскольку (с учетом семантики запроса) понятно, что документ с лексемой «люл» будет соответствовать запросу, только если в нем содержится и лексема «залома».
Итак, сначала по индексу определяется первый документ, содержащий «залома»; он имеет идентификатор (2,2). Дальше требуется определить, не содержит ли этот же документ лексему «люл», но все документы с идентификаторами, меньшими (2,2), можно сразу пропустить. Поскольку частым лексемам соответствует много идентификаторов, они, скорее всего, хранятся в отдельном дереве, что позволяет пропустить часть страниц. В данном случае поиск в дереве лексем «люл» начинается с (2,2), и первый найденный документ имеет идентификатор (2,3).
Процедура повторяется для следующих значений обязательной лексемы.
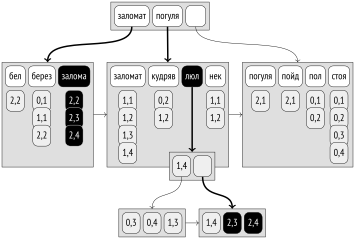
Длина списка идентификаторов будет равна трем, по числу вхождений редкой лексемы:
| tid | «залома» | «люл» | функция согласованности |
|---|---|---|---|
| (2,2) | ✓ | – | – |
| (2,3) | ✓ | ✓ | ✓ |
| (2,4) | ✓ | ✓ | ✓ |
Таким образом, знание частот позволяет организовать слияние наиболее эффективным способом, начиная с редких лексем и пропуская заведомо ненужные диапазоны страниц в деревьях частых лексем. Экономия происходит и на количестве вызовов функции согласованности. (с. 360)
Такая оптимизация работает, конечно, не только для двух лексем, но и в более сложных случаях. Обязательные лексемы, по которым происходит поиск в индексе, должны быть выбраны таким образом, чтобы не пропустить ни одного документа, соответствующего запросу. Алгоритм упорядочивает лексемы от редких к частым и затем по одной добавляет их к списку обязательных до тех пор, пока это условие не выполнится. Оставшиеся лексемы считаются дополнительными9.
Например, возьмем запрос «заломати & ( некому | белую )». Самая редкая лексема — «бел» — сразу добавляется в список обязательных. Возможна ли ситуация, когда документ не содержит ни одной обязательной лексемы, но при этом соответствует запросу? Чтобы проверить это, в функцию согласованности передаются ложные значения для обязательных лексем и истинные — для остальных. В данном случае функция возвращает true AND (true OR false) = true, то есть часть документов может быть пропущена и поэтому набор обязательных лексем необходимо расширить как минимум одной из оставшихся.
В список обязательных добавляется следующая по частоте лексема — «нек», и теперь функция согласованности возвращает true AND (false OR false) = false. Таким образом, лексемы «бел» и «нек» становятся обязательными, а «заломат» — дополнительной.
Чтобы убедиться в эффективности этой оптимизации, используем архив рассылки pgsql-hackers. Нам понадобятся две лексемы, частая и редкая: (с. 584)
Оказывается, есть один документ, в котором встречаются оба этих слова:
Запрос выполняется почти так же быстро, как и поиск одного слова «tattoo»:
А вот поиск одного слова «wrote» выполняется существенно дольше:
Вставка
При добавлении элемента к GIN-индексу 10 существующие элементы не дублируются; вместо этого у имеющегося элемента расширяется набор идентификаторов (список или дерево). Список идентификаторов является частью индексной строки, которая не может занимать слишком много места на странице, поэтому при переполнении список преобразуется в дерево11.
При вставке в дерево нового элемента (или нового идентификатора) может возникнуть переполнение страницы; в этом случае страница расщепляется на две, и элементы перераспределяются между ними12.
Но каждый документ обычно содержит много лексем, подлежащих индексированию. Поэтому при создании или изменении одного-единственного документа приходится вносить сразу множество изменений в дерево индекса. Из-за этого GIN-индекс обновляется относительно медленно.
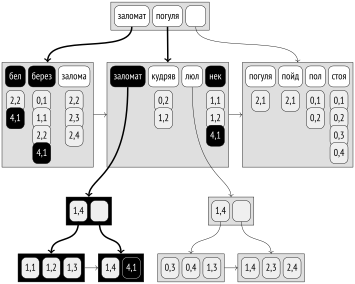
На рисунке показано состояние дерева после добавления в таблицу строки «Некому заломати белую березу» с идентификатором (4,1). Список идентификаторов лексем «бел», «берез» и «нек» увеличился, а список лексемы «заломат» превысил максимальный размер и был выделен в отдельное дерево.
С другой стороны, если учитывать в индексе изменения сразу нескольких документов, то общий объем работы, вероятно, уменьшится по сравнению с последовательным изменением, поскольку часть лексем у документов, скорее всего, окажется общей.
Такой отложенный режим обновления включается параметром хранения fastupdate. Изменения в этом режиме накапливаются в отдельном неупорядоченном списке, который физически хранится вне дерева элементов в отдельных страницах (list pages). Когда этот список становится достаточно большим, все накопленные изменения одномоментно вносятся в индекс, а список очищается13. Максимальный размер списка определяется параметром gin_pending_list_limit или одноименным параметром хранения индекса. (по умолчанию: on) (с. 296) (по умолчанию: 4MB)
По умолчанию отложенный режим включен, но следует иметь в виду, что он замедляет поиск: кроме дерева приходится просматривать и весь неупорядоченный список. К тому же время вставки становится менее предсказуемым, поскольку при очередном изменении список может переполниться, и потребуется выполнить дорогостоящую процедуру слияния. Последний момент отчасти нивелируется тем, что слияние выполняется в том числе и при очистке индекса, то есть асинхронно.
При создании нового индекса 14 элементы тоже добавляются не по одному, что было бы слишком медленно, а отложенно. Вместо неупорядоченного списка на диске изменения накапливаются в области оперативной памяти размером maintenance_work_mem и сбрасываются в индекс при переполнении. Чем больше памяти будет выделено под операцию, тем быстрее будет построен индекс. (по умолчанию: 64MB)
Приведенные в этом разделе примеры позволяют убедиться в превосходстве GIN по точности поиска над сигнатурным деревом GiST. Поэтому в большинстве случаев именно GIN используется для поддержки полнотекстового поиска. Однако проблема медленного обновления GIN может повлиять на выбор индекса в пользу GiST, если данные активно изменяются. (с. 578)
Ограничение выборки
Метод доступа GIN всегда возвращает результат в виде битовой карты; получать табличные идентификаторы по одному невозможно. Иными словами, поддерживается свойство BITMAP SCAN, но не INDEX SCAN. (с. 409)
Причина этого — в наличии неупорядоченного списка отложенных изменений. При индексном доступе сначала просматривается список и формируется битовая карта, а затем битовая карта обновляется данными из дерева. Если в процессе поиска неупорядоченный список будет объединен с деревом (в результате обновления индекса или в процессе очистки), одно и то же значение может быть получено дважды, что недопустимо. Но в случае битовой карты это не представляет проблемы: один и тот же бит просто будет установлен два раза.
Как следствие, ограничение выборки по GIN-индексу с помощью предложения LIMIT не вполне эффективно, поскольку битовая карта в любом случае строится полностью, и ее построение может составлять существенную часть общей стоимости:
Поэтому метод GIN имеет специальную возможность ограничить количество результатов, получаемых из индекса. Ограничение задается параметром gin_fuzzy_search_limit и по умолчанию не действует. Если его установить, индексный метод будет случайным образом пропускать некоторые значения, чтобы получить примерно указанное количество строк 15 (потому и fuzzy): (по умолчанию: 0)
Обратите внимание на отсутствие предложения LIMIT в запросах. Это единственный «легализованный» способ получить разные данные при индексном и при табличном доступе. Планировщик ничего не знает об этой особенности GIN-индексов и никак не учитывает значение параметра при расчете стоимости.
Свойства
Все свойства метода доступа gin на всех уровнях одинаковые и не зависят от конкретного класса операторов.
Свойства уровня метода доступа
GIN не обеспечивает ни сортировку, ни уникальность значений.
Создание составных индексов поддерживается. Интересно, что для GIN порядок столбцов в индексе не имеет никакого значения. В отличие от обычного B-дерева, многоколоночный индекс GIN хранит не составные ключи, а отдельные элементы, дополненные указанием номера столбца.
Ограничение исключения не поддерживается, так как нет свойства INDEX SCAN.
Дополнительные include-столбцы для GIN не реализованы. В них и нет большого смысла, поскольку GIN-индекс вряд ли получится использовать как покрывающий: индексируемое значение хранится в таблице, а индекс содержит только элементы этого значения.
Свойства уровня индекса
Выдача результатов по одному не поддерживается, индексный доступ всегда возвращает битовую карту результатов.
Поэтому и нет смысла в упорядочивании таблицы по GIN-индексу: битовая карта по определению соответствует физическому расположению данных в таблице, какое бы оно ни было.
Сканирование GIN-индекса в обратную сторону не поддерживается: эта возможность актуальна для индексного сканирования, но не для сканирования по битовой карте.
Свойства уровня столбца
Ни одно из свойств уровня столбца не доступно: ни сортировка (что понятно), ни использование индекса в качестве покрывающего (поскольку сам документ не хранится в индексе), ни работа с неопределенными значениями (не имеет смысла для элементов неатомарных типов).
Ограничения GIN и RUM-индекс
При всем своем могуществе GIN не решает всех проблем полнотекстового поиска. В типе данных tsvector присутствуют позиции лексем, но в индекс они не попадают. Это не позволяет эффективно использовать GIN для ускорения фразового поиска, при котором учитывается близость лексем. Кроме того, поисковые системы обычно возвращают результаты в порядке релевантности (что бы ни означал этот термин). Поскольку GIN не поддерживает упорядочивающие операторы, единственный выход — вычислять функцию ранжирования для каждой строки результата, что, конечно, медленно.
Эти недостатки устранены в индексном методе RUM, название которого заставляет усомниться в искренности разработчиков относительно смысла, вкладываемого в аббревиатуру GIN. Это сторонний метод доступа; расширение доступно и как пакет в репозитории PGDG16, и в исходных кодах17.
RUM создан на основе GIN и отличается от него двумя принципиальными свойствами. Во-первых, в нем отказались от отложенного режима обновления; за счет этого появилась поддержка не только сканирования по битовой карте, но и обычного индексного сканирования, а также были реализованы упорядочивающие операторы. Во-вторых, к ключам индекса можно добавлять вспомогательную информацию. Это отчасти похоже на дополнительные include-столбцы, но информация привязывается к конкретному ключу. В контексте полнотекстового поиска класс операторов RUM связывает вхождения лексем с их позициями в документе, что позволяет ускорять фразовый поиск и выдачу результатов в порядке ранжирования.
Недостатком такого подхода является медленное обновление и увеличенный объем индекса. Кроме того, являясь расширением, индексный метод rum пользуется механизмом унифицированных журнальных записей18, который работает медленнее встроенного в ядро журналирования и генерирует больший объем WAL.
28.3. Индекс для триграмм
Расширение pg_trgm 19 позволяет определять схожесть слов, сравнивая количество совпадающих последовательностей из трех букв (триграмм). Его можно использовать вместе с полнотекстовым поиском, чтобы находить варианты даже при вводе слов с опечатками.
Класс операторов gin_trgm_ops реализует индексирование текстовых строк, но в качестве элементов текстовых значений выделяются не слова или лексемы, а всевозможные трехсимвольные подстроки (используются только буквы и цифры, остальные символы игнорируются). Внутри индекса триграммы представляются целыми числами: для русских букв, занимающих два байта в кодировке UTF-8, такое кодирование не позволяет расшифровать исходные символы. Поэтому я покажу, как формируются триграммы, в базе данных с восьмибитной кодировкой:
Класс операторов поддерживает операторы точного и нечеткого сравнения строк и слов.
Для нечеткого сравнения можно определить расстояние между строками как отношение числа совпадающих триграмм к их общему количеству в строке-запросе. Но, как я уже показывал, индекс GIN не поддерживает упорядочивающие операторы, так что все операторы в классе должны быть булевыми. Поэтому для операторов %, %> и %>>, реализующих стратегии нечеткого сравнения, функция согласованности вычисляет расстояние и дает положительный вердикт, если оно не превышает установленный порог. (psql: \dAo)
Для операторов = и LIKE функция согласованности требует, чтобы в значении присутствовали все триграммы из строки-запроса. Соответствие регулярному выражению проверяется существенно более сложно.
В любом случае поиск по триграммам является неточным и всегда перепроверяется по таблице.
28.4. Индекс для массивов
Другой пример подходящего типа данных — массив. GIN-индекс по элементам массива позволяет быстрее находить пересечения массивов и вхождения одного массива в другой:
В качестве примера возьмем представление routes демобазы с информацией о рейсах. Столбец days_of_week хранит массив номеров дней недели, по которым выполняются рейсы. Конечно, чтобы построить индекс, представление придется «материализовать»: (psql: \dAo)
С помощью созданного индекса можно, например, отобрать рейсы, отправляющиеся по вторникам, четвергам и воскресеньям. Я отключаю последовательное сканирование, поскольку иначе планировщик не будет использовать индекс для такой небольшой таблицы:
Оказывается, есть одиннадцать таких рейсов:
Построенный индекс содержит всего семь элементов: целые числа от 1 до 7, представляющие дни недели.
Запрос выполняется примерно так же, как я показывал выше для полнотекстового поиска. Поисковый запрос в данном случае представлен не специальным типом данных, а обычным массивом; такой запрос подразумевает, что в индексированном массиве должны встретиться все перечисленные элементы. Важное отличие состоит в том, что условие равенства требует также, чтобы индексированный массив не содержал никаких других элементов. Функция согласованности 20 знает об этой особенности благодаря номеру стратегии, но не может удостовериться в отсутствии лишних элементов и поэтому просит механизм индексирования перепроверить результаты:
Может оказаться полезным расширить GIN-индекс, добавив в него другие столбцы. Например, для поиска рейсов, отправляющихся по вторникам, четвергам и воскресеньям из Москвы, в индексе не хватает столбца departure_city. Однако для обычных скалярных типов данных классы операторов не предусмотрены:
В таких случаях помогает расширение btree_gin. Оно добавляет классы операторов GIN, имитирующие работу обычного B-дерева, представляя скалярное значение как составное, но содержащее один элемент. (с. 573)
По-прежнему остается справедливым замечание, которое я уже делал в отношении расширения btree_gist: B-дерево гораздо эффективнее справляется с поддержкой операций сравнения, так что использовать расширение имеет смысл лишь в тех случаях, когда GIN-индекс действительно необходим. Например, поиск по условиям «меньше» или «меньше или равно» выполняется в B-дереве сканированием листовых страниц в обратную сторону, а в GIN такая возможность отсутствует.
28.5. Индекс для JSON
Еще один неатомарный тип данных, для которого есть встроенная GIN-поддержка, — jsonb21. Для работы с JSON предусмотрен целый ряд операторов, часть из которых может быть ускорена с помощью GIN-индекса.
Существует два класса операторов, которые выделяют разные наборы элементов из документа JSON:
Класс операторов jsonb_ops
Первый класс операторов, jsonb_ops, используется по умолчанию. В индекс в качестве элементов попадают все ключи, все значения и все элементы массивов исходного документа JSON22. Это позволяет ускорять запросы с условиями включения JSON-значения (@>), существования ключей (?, ?| и ?&) и сопоставления путей JSON (@? и @@): (psql: \dAo)
Для примера представим несколько строк из routes в виде JSON:
Созданный индекс можно представить следующим образом:
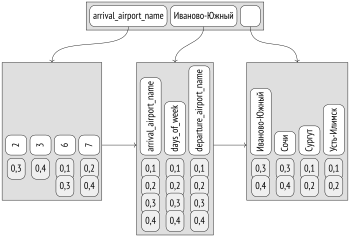
Рассмотрим запрос по условию route @> '{"days_of_week": [6]}', которое отбирает документы JSON, содержащие указанный путь (то есть рейсы, совершаемые по субботам).
Из поискового запроса, представленного значением JSON, опорная функция 23 выделяет ключи поиска: «days_of_week» и «6». Эти ключи ищутся в дереве элементов, и документы, содержащие по крайней мере один ключ, проверяются функцией согласованности24. Для стратегии «содержит» функция требует наличия всех ключей из поискового запроса, но результаты все равно должны перепроверяться по таблице, поскольку с точки зрения индекса указанный путь соответствует, например, документу {"days_of_week": [2], "foo": [6]}.
Класс операторов jsonb_path_ops
Второй класс jsonb_path_ops содержит меньше операторов: (psql: \dAo)
В этом случае в индекс попадают не разрозненные фрагменты JSON, а пути от корня документа до всех значений и всех элементов массивов25. Это делает поиск гораздо более точным и эффективным, хотя и не позволяет ускорять операции, аргументами которых являются не пути, а отдельные ключи.
Поскольку путь может быть достаточно длинным, фактически индексируются не сами пути, а значения хеш-функций от них.
Создадим индекс с этим классом операторов для той же таблицы:
Вот как можно представить дерево созданного индекса:
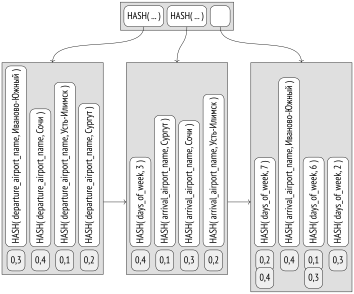
При выполнении запроса с тем же условием route @> '{"days_of_week": [6]}' опорная функция 26 выделит из поискового запроса не отдельные фрагменты, а весь путь «days_of_week, 6». В дереве элементов сразу же будут найдены идентификаторы двух подходящих документов.
Конечно, и в этом случае найденные записи будут проверены функцией согласованности 27 и затем перепроверены по таблице механизмом индексирования (как минимум из-за возможных хеш-коллизий). Но поиск по дереву выполняется намного эффективнее, так что стоит выбирать класс jsonb_path_ops всегда, когда входящих в него операторов достаточно для индексной поддержки запросов.
28.6. Другие типы данных
Вот еще несколько расширений, добавляющих поддержку GIN для некоторых типов данных.
Целочисленные массивы. Расширение intarray добавляет класс операторов gin__int_ops для целочисленных массивов. Он практически идентичен стандартному классу операторов array_ops, но поддерживает оператор сопоставления с поисковым запросом @@.
Хранилище «ключ–значение». Расширение hstore реализует хранилище пар «ключ–значение» и предлагает класс операторов gin_hstore_ops. Индексируются и ключи, и значения.
Язык запросов JSON. Стороннее расширение jsquery предоставляет собственный язык запросов и поддержку GIN-индексов для JSON.
С принятием стандарта SQL:2016 и реализацией в PostgreSQL языка путей SQL/JSON стандартные возможности выглядят более предпочтительными. (v. 12)
postgrespro.ru/docs/postgresql/18/gin; backend/access/gin/README. ↩︎
postgrespro.ru/docs/postgresql/18/gin-extensibility; backend/utils/adt/tsginidx.c. ↩︎
backend/utils/adt/tsvector_op.c, функция ts_match_vq. ↩︎
backend/utils/adt/tsginidx.c, функция gin_extract_tsquery. ↩︎
backend/access/gin/ginget.c, функция keyGetItem. ↩︎
backend/utils/adt/tsginidx.c, функция gin_tsquery_triconsistent. ↩︎
backend/utils/adt/tsginidx.c, функция gin_cmp_prefix. ↩︎
backend/access/gin/ginget.c, функция startScanKey. ↩︎
backend/access/gin/gininsert.c, функция ginEntryInsert. ↩︎
backend/access/gin/gininsert.c, функция addItemPointersToLeafTuple. ↩︎
backend/access/gin/ginbtree.c, функция ginInsertValue. ↩︎
backend/access/gin/ginfast.c, функция ginInsertCleanup. ↩︎
backend/access/gin/gininsert.c, функция ginbuild. ↩︎
backend/access/gin/ginget.c, макрос dropItem. ↩︎
backend/access/gin/ginarrayproc.c, функция ginarrayconsistent. ↩︎
backend/utils/adt/jsonb_gin.c, функция gin_extract_jsonb. ↩︎
backend/utils/adt/jsonb_gin.c, функция gin_extract_jsonb_query. ↩︎
backend/utils/adt/jsonb_gin.c, функция gin_consistent_jsonb. ↩︎
backend/utils/adt/jsonb_gin.c, функция gin_extract_jsonb_path. ↩︎
backend/utils/adt/jsonb_gin.c, функция gin_extract_jsonb_query_path. ↩︎
backend/utils/adt/jsonb_gin.c, функция gin_consistent_jsonb_path. ↩︎