# Индекс SP-GiST
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
## 27.1. Общий принцип {#internal-ru-section-27-1}
Буквы «SP» в названии SP-GiST расшифровываются как Space Partitioning, то есть разбиение пространства. Под пространством здесь подразумевается произвольная область значений, в которой производится поиск, а не обязательно пространство в обыденном понимании (например, двумерная плоскость). Ну а «GiST» намекает на определенную схожесть с этим методом: и GiST, и SP-GiST являются обобщенными деревьями поиска и служат каркасами для индексации различных типов данных.
Идея метода SP-GiST [^internal-ru-590-1] состоит в разбиении пространства поиска на непересекающиеся области, каждая из которых, в свою очередь, также может быть рекурсивно разбита на подобласти. Такое разбиение порождает *несбалансированные* деревья (в отличие от B-деревьев и метода GiST) и может использоваться для реализации таких известных структур, как деревья квадрантов (quadtree), k-мерные деревья (k-D tree) или префиксные деревья (trie).
Обычно такие деревья слабо ветвятся и, следовательно, имеют большую глубину. Например, узел дерева квадрантов имеет не больше четырех дочерних узлов, а узел k-мерного дерева — только два. Это не проблема, когда дерево находится в оперативной памяти, но для дискового представления приходится решать непростую задачу эффективной упаковки узлов в страницы, чтобы минимизировать операции ввода-вывода. Для B-деревьев и GiST это не требуется, поскольку каждый узел дерева занимает страницу полностью.
Внутренний узел дерева SP-GiST содержит значение, соответствующее условию, которое выполняется для всех дочерних узлов. Такое значение часто называют *префиксом*; оно играет ту же роль, что *предикат* в индексе GiST. Ссылки на дочерние узлы в SP-GiST могут иметь *метки*.
Элементы листовых узлов содержат индексируемое значение (или его часть) и идентификатор соответствующей версии строки.
Как и GiST, метод доступа SP-GiST реализует только основные алгоритмы и берет на себя заботу о таких низкоуровневых задачах, как организация конкурентного доступа, блокирование и журналирование. Для добавления новых типов данных и алгоритмов разбиения пространства на области этот метод предоставляет интерфейс класса операторов. Класс операторов содержит значительную часть логики и определяет многие аспекты работы индекса.
Поиск [^internal-ru-591-1] в дереве SP-GiST начинается с корневого узла и производится в глубину. Узлы, в которые имеет смысл заходить, выбираются с помощью опорной функции *согласованности*, похожей на аналогичную функцию в GiST. Для внутреннего узла дерева эта функция возвращает набор дочерних узлов, значения которых «согласуются» с поисковым предикатом. Функция выбирает узлы, не спускаясь в них, а ориентируясь на значения префикса и меток. Для листового узла функция определяет, удовлетворяет ли индексированное значение в этом узле поисковому предикату.
Время поиска значений в несбалансированном дереве может отличаться из-за разной глубины ветвей.
Для вставки значения в дерево SP-GiST используются две опорные функции. В узлах дерева, начиная с корня, *функция выбора* принимает одно из возможных решений: отправить новое значение в существующий дочерний узел, создать для него новый дочерний узел или (если значение не согласуется с префиксом узла) расщепить текущий узел. В выбранной в итоге листовой странице индекса может не оказаться достаточно места, и тогда *функция расщепления* решает, какие узлы перенести в новую страницу.
Дальше я рассмотрю эти алгоритмы на конкретных примерах.
## 27.2. Дерево квадрантов для точек {#internal-ru-section-27-2}
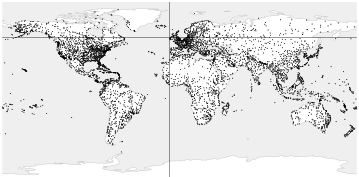
*Дерево квадрантов* (quadtree) используется для индексирования точек на плоскости. Область рекурсивно разбивается на четыре части (квадранта) по отношению к выбранной точке. Эта точка называется *центроидом* и служит префиксом узла, то есть условием, определяющим положение дочерних значений.
Корневой узел делит плоскость на четыре квадранта.
{#internal-ru-fig-27-1 num="27.1" caption="Дерево квадрантов для точек" .book-original-figure width=718 height=354}
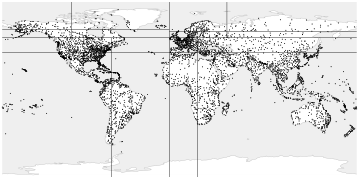
Затем каждый из них делится на собственные квадранты.
{#internal-ru-fig-27-2 num="27.2" caption="Дерево квадрантов для точек" .book-original-figure width=718 height=354}
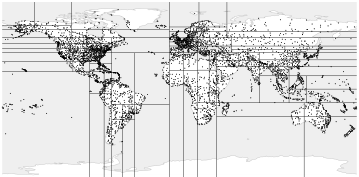
Процедура продолжается, пока не будет получено итоговое разбиение.
{#internal-ru-fig-27-3 num="27.3" caption="Дерево квадрантов для точек" .book-original-figure width=718 height=354}
В этом примере использован индекс, построенный на расширенной таблице аэропортов. На рисунках видно, что глубина ветвей дерева отличается в зависимости от плотности точек в соответствующих квадрантах. Для наглядности я взял небольшое значение параметра хранения *fillfactor*, чтобы дерево имело больше уровней: (*с.* [558](/ru/26-gist/#internal-ru-page-559)) (*по умолчанию:* `80`)
```text {label="psql"}
=> CREATE INDEX airports_quad_idx ON airports_big
USING spgist(coordinates) WITH (fillfactor = 10);
```
По умолчанию для точек используется класс операторов `quad_point_ops`.
### Класс операторов {#internal-ru-subsection-star-415}
Я уже называл основные опорные функции SP-GiST: функцию согласованности для поиска и функции выбора и расщепления для вставки.
Ниже приведен список опорных функций[^internal-ru-593-1], которые реализует класс операторов `quad_point_ops`[^internal-ru-593-2]. Все они являются обязательными.
```text {label="psql"}
=> SELECT amprocnum, amproc::regproc
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'spgist'
AND opcname = 'quad_point_ops'
ORDER BY amprocnum;
amprocnum | amproc
-----------+---------------------------
1 | spg_quad_config
2 | spg_quad_choose
3 | spg_quad_picksplit
4 | spg_quad_inner_consistent
5 | spg_quad_leaf_consistent
(5 rows)
```
Функции имеют следующий смысл: (psql: `\dAp`)
1) настроечная функция, которая сообщает методу доступа характеристики класса операторов;
2) функция выбора узла для вставки значения;
3) функция распределения узлов при расщеплении;
4) функция внутренней согласованности, которая определяет, согласуется ли с поисковым предикатом значение во *внутреннем* узле;
5) функция листовой согласованности, которая определяет, согласуется ли с поисковым предикатом значение в *листовом* узле.
Кроме перечисленных, есть и несколько необязательных функций.
Класс операторов `quad_point_ops` поддерживает стратегии, общие с GiST [^internal-ru-594-1]: (*с.* [562](/ru/26-gist/#internal-ru-page-563)) (psql: `\dAo`)
```text {label="psql"}
=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amop amop ON amopfamily = opcfamily
JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'spgist'
AND opcname = 'quad_point_ops'
ORDER BY amopstrategy;
amopopr | oprcode | amopstrategy
------------------+----------------+--------------
<<(point,point) | point_left | 1
>>(point,point) | point_right | 5
~=(point,point) | point_eq | 6
<@(point,box) | on_pb | 8
<<|(point,point) | point_below | 10
|>>(point,point) | point_above | 11
<->(point,point) | point_distance | 15
<^(point,point) | point_below | 29
>^(point,point) | point_above | 30
(9 rows)
```
Например, с помощью оператора «выше» `>^` можно найти аэропорты, расположенные севернее Диксона:
```text {label="psql"}
=> SELECT airport_code, airport_name->>'en'
FROM airports_big
WHERE coordinates >^ '(80.3817,73.5167)'::point;
airport_code | ?column?
--------------+----------------------------
THU | Thule Air Base
YEU | Eureka Airport
YLT | Alert Airport
YRB | Resolute Bay Airport
LYR | Svalbard Airport, Longyear
NAQ | Qaanaaq Airport
YGZ | Grise Fiord Airport
DKS | Dikson Airport
(8 rows)
=> EXPLAIN (costs off) SELECT airport_code
FROM airports_big
WHERE coordinates >^ '(80.3817,73.5167)'::point;
QUERY PLAN
---------------------------------------------------------------
Bitmap Heap Scan on airports_big
Recheck Cond: (coordinates >^ '(80.3817,73.5167)'::point)
-> Bitmap Index Scan on airports_quad_idx
Index Cond: (coordinates >^ '(80.3817,73.5167)'::point)
(4 rows)
```
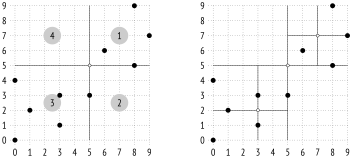
Рассмотрим теперь подробнее устройство и функционирование дерева квадрантов на простом примере с несколькими точками, который нам уже встречался в главе про GiST. (*с.* [563](/ru/26-gist/#internal-ru-page-564))
Вот как может выглядеть разбиение плоскости в этом случае:
{#internal-ru-fig-27-4 num="27.4" caption="Класс операторов" .book-original-figure width=705 height=319}
Левый рисунок показывает нумерацию квадрантов на примере одного уровня дерева; на следующих иллюстрациях я для определенности буду располагать дочерние узлы слева направо именно в такой последовательности. Точки, лежащие на границах, относятся к квадранту с меньшим номером. На правом рисунке показано окончательное разбиение.
Ниже приведена возможная структура индекса для этого примера. Каждый внутренний узел ссылается максимум на четыре дочерних узла, и каждая ссылка помечена номером квадранта:
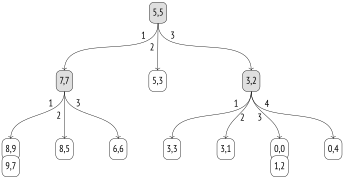
{#internal-ru-fig-27-5 num="27.5" caption="Класс операторов" .book-original-figure width=688 height=357}
### Страничная организация {#internal-ru-subsection-star-417}
Между узлами дерева SP-GiST и страницами нет однозначного соответствия, которое характерно для B-деревьев и GiST-индексов. Из-за того, что внутренние узлы обычно имеют не очень много дочерних, в одну страницу приходится упаковывать несколько узлов. Внутренние узлы при этом хранятся на одних (*внутренних*) страницах, а листовые — на других (*листовых*).
Индексные записи внутренних страниц содержат значение, используемое как префикс, и набор ссылок на дочерние узлы, каждая из которых может сопровождаться меткой.
Записи листовых страниц состоят из значения и идентификатора табличной версии строки.
Все листовые узлы, относящиеся к одному и тому же внутреннему, хранятся в одной странице и связаны в список. Если в странице не хватает места, список может быть перемещен на другую страницу [^internal-ru-597-1] или может произойти расщепление, но в любом случае список никогда не разрывается между несколькими страницами.
Чтобы экономно расходовать место, алгоритм старается располагать новые узлы в одних и тех же страницах, пока те не заполнятся. Номера последних использованных страниц кешируются обслуживающими процессами, а также периодически сохраняются в *метастранице* с нулевым номером. Метастраница не ссылается на корневой узел, как это происходит в случае B-дерева; корень SP-GiST всегда находится в первой странице.
> [!NOTE]
> К сожалению, в `pageinspect` нет функций для исследования индекса SP-GiST, но вместо него можно воспользоваться сторонним расширением `gevel`[^internal-ru-597-2]. Попытка перенести его функциональность в `pageinspect` предпринималась, но не увенчалась успехом[^internal-ru-597-3].
Вариант распределения узлов дерева по страницам для нашего примера показан на рисунке ниже. На самом деле класс операторов `quad_point_ops` не использует метки. Поскольку дочерних узлов не может быть больше четырех, хранится массив фиксированного размера из четырех ссылок, некоторые из которых могут быть пустыми.
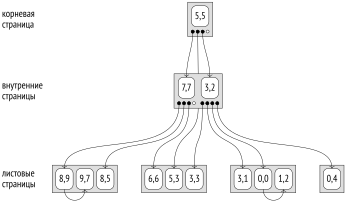
{#internal-ru-fig-27-6 num="27.6" caption="Страничная организация" .book-original-figure width=693 height=412}
### Поиск {#internal-ru-subsection-star-419}
Рассмотрим на этом же примере алгоритм поиска точек, расположенных выше точки (3,7).
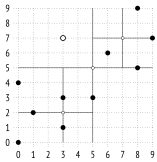
{#internal-ru-fig-27-7 num="27.7" caption="Поиск" .book-original-figure width=315 height=325}
Поиск начинается с корневого узла. Функция внутренней согласованности [^internal-ru-599-1] показывает, в какие дочерние узлы надо спускаться. Точка (3,7) сравнивается с центроидом корневого узла (5,5), и выбираются квадранты, в которых могут находиться искомые точки — в данном случае первый и четвертый.
В узле с центроидом (7,7) снова выбираются дочерние узлы для спуска. Подходят первый и четвертый квадранты, но четвертый пуст, так что необходимо проверить один листовой дочерний узел. Его точки сравниваются с точкой (3,7) из запроса с помощью функции листовой согласованности[^internal-ru-599-2]. Из них только (8,9) удовлетворяет условию «выше».
Остается вернуться на уровень выше и проверить узел, соответствующий четвертому квадранту корневого узла. Он пуст, и на этом поиск завершен.
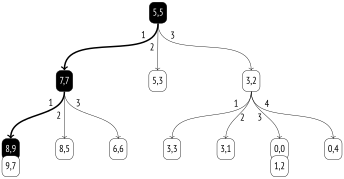
{#internal-ru-fig-27-8 num="27.8" caption="Поиск" .book-original-figure width=688 height=357}
### Вставка {#internal-ru-subsection-star-421}
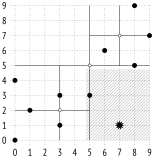
При вставке значения в дерево SP-GiST [^internal-ru-599-3] каждое следующее действие определяется функцией выбора[^internal-ru-599-4]. В данном случае она просто направляет новую точку в тот из существующих квадрантов, к которому она принадлежит.
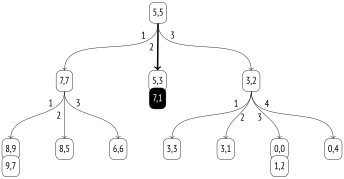
Например, добавим значение (7,1):
{#internal-ru-fig-27-9 num="27.9" caption="Вставка" .book-original-figure width=308 height=319}
Значение принадлежит второму квадранту и будет добавлено к соответствующему узлу дерева:
{#internal-ru-fig-27-10 num="27.10" caption="Вставка" .book-original-figure width=688 height=357}
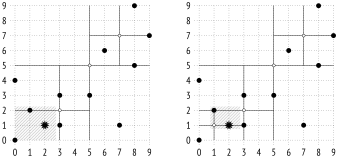
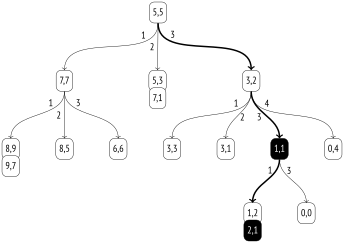
Если значение попадает в квадрант, список листовых узлов которого оказывается слишком велик (он должен помещаться в одной странице), происходит расщепление. Функция расщепления [^internal-ru-600-1] определяет новый центроид, вычисляя среднее значение координат всех точек, и таким образом распределяет дочерние узлы по новым квадрантам более или менее равномерно.
В примере на рисунке ниже добавление точки (2,1) приводит к переполнению узла:
{#internal-ru-fig-27-11 num="27.11" caption="Вставка" .book-original-figure width=676 height=319}
В дерево добавляется новый внутренний узел с центроидом (1,1), а точки (0,0), (1,2) и (2,1) распределяются между новыми квадрантами:
{#internal-ru-fig-27-12 num="27.12" caption="Вставка" .book-original-figure width=688 height=486}
### Свойства {#internal-ru-subsection-star-423}
**Свойства уровня метода доступа**
```text {label="psql"}
=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
'can_order', 'can_unique', 'can_multi_col',
'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'spgist';
amname | name | pg_indexam_has_property
--------+---------------+-------------------------
spgist | can_order | f
spgist | can_unique | f
spgist | can_multi_col | f
spgist | can_exclude | t
spgist | can_include | t
(5 rows)
```
Поддержка сортировки значений и уникальности отсутствует. Не поддерживаются и многоколоночные индексы.
Ограничения исключения поддерживаются, как и в случае GiST.
Индекс SP-GiST можно создавать с дополнительными include-столбцами. (v. 14)
**Свойства уровня индекса**
Свойства индекса SP-GiST отличаются от свойств GiST тем, что не допускается кластеризация:
```text {label="psql"}
=> SELECT p.name, pg_index_has_property('airports_quad_idx', p.name)
FROM unnest(array[
'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
name | pg_index_has_property
---------------+-----------------------
clusterable | f
index_scan | t
bitmap_scan | t
backward_scan | f
(4 rows)
```
Оба способа получения идентификаторов версий (по одному и битовой картой) поддерживаются. Обратное сканирование SP-GiST не имеет смысла.
**Свойства уровня столбца**
Основная часть свойств столбцов неизменна:
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('airports_quad_idx', 1, p.name)
FROM unnest(array[
'orderable', 'search_array', 'search_nulls'
]) p(name);
name | pg_index_column_has_property
--------------+------------------------------
orderable | f
search_array | f
search_nulls | t
(3 rows)
```
Сортировка не поддерживается, и все свойства, связанные с ней, не имеют смысла и отключены.
До сих пор я ничего не говорил про неопределенные значения, но, как видно из свойств индекса, они поддерживаются. В отличие от GiST, индекс SP-GiST не хранит неопределенные значения в основном дереве. Для них создается отдельное дерево с корнем на второй странице индекса. Таким образом, первые три страницы всегда имеют фиксированный смысл: метастраница, корень основного дерева и корень дерева неопределенных значений.
Часть свойств уровня столбца может меняться в зависимости от класса операторов:
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('airports_quad_idx', 1, p.name)
FROM unnest(array[
'returnable', 'distance_orderable'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
returnable | t
distance_orderable | t
(2 rows)
```
В данном случае (как и во всех остальных примерах этой главы) индекс может использоваться для сканирования только индекса.
Но в общем случае класс операторов может не хранить полное значение в листовых страницах, выполняя вместо этого перепроверку по таблице.
Это, например, позволяет использовать индексы SP-GiST в PostGIS для потенциально больших значений типа `geometry`.
Поиск ближайших соседей поддерживается; в классе операторов мы видели упорядочивающий оператор `<->`. (v. 12)
## 27.3. K-мерные деревья для точек {#internal-ru-section-27-3}
Для точек на плоскости можно предложить и другой способ разбиения пространства: делить плоскость не на четыре части, а на две. Такое разбиение использует класс операторов `kd_point_ops` [^internal-ru-604-1]:
```text {label="psql"}
=> CREATE INDEX airports_kd_idx ON airports_big
USING spgist(coordinates kd_point_ops);
```
Обратите внимание, что индексируемые значения, префиксы и метки могут иметь различные типы данных. Для этого класса операторов значения являются точками, префиксы — вещественными числами, а метки отсутствуют (как и в `quad_point_ops`).
Выберем какую-нибудь координату на оси ординат (в примере с аэропортами — широту). Она поделит плоскость на две части, верхнюю и нижнюю:
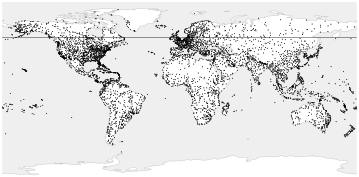
{#internal-ru-fig-27-13 num="27.13" caption="K-мерные деревья для точек" .book-original-figure width=718 height=354}
Для каждой из двух областей выберем координаты на оси абсцисс (долготу), которые поделят области на две части, левую и правую:
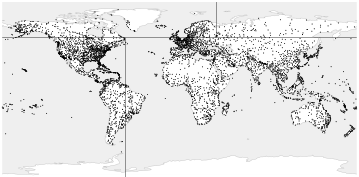
{#internal-ru-fig-27-14 num="27.14" caption="K-мерные деревья для точек" .book-original-figure width=718 height=354}
Будем продолжать делить каждую из частей попеременно то по горизонтали, то по вертикали, пока в каждой из них не останется столько точек, сколько помещается на одну страницу индекса:
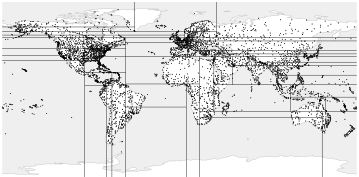
{#internal-ru-fig-27-15 num="27.15" caption="K-мерные деревья для точек" .book-original-figure width=718 height=354}
У всех внутренних узлов дерева, построенного таким образом, будет всего два дочерних узла. Метод легко обобщается на случай пространства произвольной размерности, поэтому и деревья называются в литературе *k-мерными* (k-D tree).
## 27.4. Префиксное дерево для строк {#internal-ru-section-27-4}
Класс операторов `text_ops` [^internal-ru-606-1] для SP-GiST реализует префиксное дерево (radix tree) для строк. Здесь *префикс* внутреннего узла действительно является префиксом, общим для всех строк в дочерних узлах.
Ссылки на дочерние узлы дерева помечены первым байтом значений, следующих за префиксом.
> [!NOTE]
> На рисунке я для ясности показываю префикс как один символ, но это верно только для восьмибитных кодировок. В общем случае класс операторов работает со строкой как с последовательностью байтов. Кроме того, префикс может принимать еще несколько значений, имеющих специальный смысл, так что фактически под префикс выделено два байта.
В дочерних узлах хранятся те части значений, которые следуют за префиксом и меткой. На долю листовых узлов остаются только окончания.
Вот пример префиксного дерева, построенного по нескольким именам:
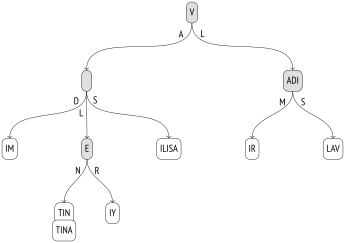
{#internal-ru-fig-27-16 num="27.16" caption="Префиксное дерево для строк" .book-original-figure width=690 height=486}
Полное значение ключа индексирования в листовом узле можно восстановить конкатенацией всех префиксов и меток, следуя от корня дерева к этому узлу. За счет того, что значения не хранятся целиком, а реконструируются по мере необходимости, представление в виде префиксного дерева может иногда оказаться существенно компактнее B-дерева.
### Класс операторов {#internal-ru-subsection-star-431}
Класс операторов `text_ops` поддерживает операторы сравнения, традиционные для порядкового типа, которым является текстовая строка: (psql: `\dAo`)
```text {label="psql"}
=> SELECT oprname, oprcode::regproc, amopstrategy
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amop amop ON amopfamily = opcfamily
JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'spgist'
AND opcname = 'text_ops'
ORDER BY amopstrategy;
oprname | oprcode | amopstrategy
---------+-----------------+--------------
~<~ | text_pattern_lt | 1
~<=~ | text_pattern_le | 2
= | texteq | 3
~>=~ | text_pattern_ge | 4
~>~ | text_pattern_gt | 5
< | text_lt | 11
<= | text_le | 12
>= | text_ge | 14
> | text_gt | 15
^@ | starts_with | 28
(10 rows)
```
Операторы с тильдами отличаются от обычных тем, что работают не с символами, а с байтами (аналогично операторам класса `text_pattern_ops` для B-дерева), и поэтому органично поддерживаются префиксным деревом, которое тоже размечено байтами. Обычные же операторы `>=` и `<` учитывают правила сортировки и вынуждены анализировать символы. Они поддерживаются индексом только при использовании правила сортировки «C». (*с.* [399](/ru/19-index-access-methods/#internal-ru-page-400))
Для ускорения поиска по условию `LIKE` класс операторов поддерживает оператор *префиксного поиска* `^@`:
```text {label="psql"}
=> CREATE INDEX tickets_spgist_idx ON tickets
USING spgist(passenger_name);
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE passenger_name LIKE 'IVAN%';
QUERY PLAN
----------------------------------------------------
Bitmap Heap Scan on tickets
Filter: (passenger_name ~~ 'IVAN%'::text)
-> Bitmap Index Scan on tickets_spgist_idx
Index Cond: (passenger_name ^@ 'IVAN'::text)
(4 rows)
```
### Поиск {#internal-ru-subsection-star-433}
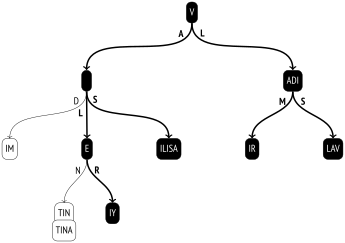
Рассмотрим на примере с именами выполнение следующего запроса:
```sql
SELECT * FROM names
WHERE name ~>=~ 'VALERIY' AND name ~<~ 'VLADISLAV';
```
Сначала функция внутренней согласованности [^internal-ru-608-1] вызывается в корне дерева, и она должна определить, в какие дочерние узлы спускаться. Функция конкатенирует префикс `V` и метки `A` и `L`. Значение `VA` подставляется в условие запроса, в котором строковые константы обрезаются так, чтобы их длина не превышала длины проверяемого значения: `VA ~>=~ 'VA' AND VA ~<~ 'VL'`. Условие выполняется, так что дочерний узел с меткой `A` должен быть проверен. Аналогично проверяется и значение `VL`. Оно тоже подходит, поэтому и узел с меткой `L` требует проверки.
Возьмем теперь узел, соответствующий значению `VA`. Его префикс пуст, и для трех дочерних узлов функция внутренней согласованности восстанавливает значения `VAD`, `VAL` и `VAS`, конкатенируя полученное на предыдущем шаге `VA` с меткой. Условие `VAD ~>=~ 'VAL' AND VAD ~<~ 'VER'` не выполняется, но два других значения подходят.
Обходя таким образом дерево вглубь и отбрасывая неподходящие ветви, алгоритм добирается до листовых узлов. Функция листовой согласованности [^internal-ru-608-2] проверяет, соответствует ли восстановленное по мере спуска значение исходному условию. Подходящие значения возвращаются в качестве результата индексного сканирования.
{#internal-ru-fig-27-17 num="27.17" caption="Поиск" .book-original-figure width=690 height=486}
Обратите внимание, что хотя в запросе используются операторы «больше» и «меньше», обычные для B-деревьев, поиск диапазона по дереву SP-GiST гораздо менее эффективен. В случае B-дерева достаточно спуститься только к одному крайнему значению диапазона и затем прочитать цепочку листовых страниц.
### Вставка {#internal-ru-subsection-star-435}
Функция выбора классов операторов для точек всегда может направить новое значение в одну из существующих подобластей (квадрант или половину). В префиксном дереве это не так: новое значение может не соответствовать имеющемуся префиксу, и тогда внутренний узел приходится разделять.
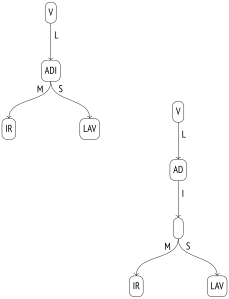
В качестве примера рассмотрим добавление имени `VLADA` к уже имеющемуся дереву.
От корня дерева с помощью функции выбора [^internal-ru-610-1] можно успешно спуститься на один узел (`V` + `L`), но остаток значения `ADA` не согласуется с префиксом `ADI`. Узел необходимо разделить на два: в одном оставить наибольший общий префикс, то есть `AD`, а остаток префикса перенести на уровень ниже:
{#internal-ru-fig-27-18 num="27.18" caption="Вставка" .book-original-figure width=458 height=598}
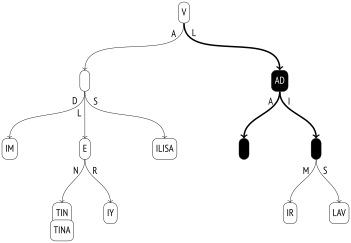
После этого функция выбора вызывается в том же узле еще раз. Префикс теперь соответствует значению, но нет дочернего узла с подходящей меткой (`A`), и функция принимает решение создать такой узел. Конечный результат показан на рисунке ниже; на нем выделены узлы, добавленные или измененные в ходе вставки.
{#internal-ru-fig-27-19 num="27.19" caption="Вставка" .book-original-figure width=702 height=486}
### Свойства {#internal-ru-subsection-star-437}
Свойства уровня метода доступа и индекса я уже показывал, они не меняются от класса к классу. Большинство свойств уровня столбца также постоянны.
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('tickets_spgist_idx', 1, p.name)
FROM unnest(array[
'returnable', 'distance_orderable'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
returnable | t
distance_orderable | f
(2 rows)
```
Хотя индексируемые значения и не хранятся в явном виде в дереве, сканирование только индекса работает, поскольку значения восстанавливаются по мере спуска от корня до листовых узлов.
А вот оператор расстояния для строк не определен, и поиск ближайших соседей не поддерживается этим классом операторов.
> [!NOTE]
> Это не значит, что для строк нельзя ввести понятие расстояния. Например, расширение `pg_trgm` добавляет оператор для расстояния на основе триграмм: считается, что чем меньше доля общих триграмм у двух строк, тем дальше они находятся друг от друга. Другой вариант — расстояние Левенштейна, которое определяется как минимальное количество односимвольных операций, преобразующих одну строку в другую. Функция для расчета такого расстояния есть в расширении `fuzzystrmatch`. Но ни одно из расширений не предоставляет класс операторов с поддержкой SP-GiST.
## 27.5. Другие типы данных {#internal-ru-section-27-5}
Помимо рассмотренных примеров индексирования точек и текстовых строк, реализованы и другие классы операторов для SP-GiST.
**Геометрические типы.** Класс операторов `box_ops` [^internal-ru-612-1] реализует дерево квадрантов для прямоугольников. Прямоугольники представляются точками в четырехмерном пространстве, так что область разбивается на шестнадцать частей.
Класс операторов `poly_ops` позволяет индексировать полигоны. Это неточный класс операторов: фактически вместо полигонов используются ограничивающие прямоугольники, как в `box_ops`, с перепроверкой по таблице.
Какой из методов доступа предпочесть — GiST или SP-GiST, — существенно зависит от вида индексируемых данных. Например, документация PostGIS рекомендует SP-GiST для сильно пересекающихся объектов («лапши»)[^internal-ru-612-2].
**Диапазонные типы.** Дерево квадрантов для диапазонов предоставляет класс операторов `range_ops`[^internal-ru-612-3]. Интервал представляется двумерной точкой: нижняя граница становится абсциссой, а верхняя — ординатой.
**Сетевые адреса.** Для типа данных `inet` класс операторов `inet_ops` [^internal-ru-612-4] реализует префиксное дерево.
[^internal-ru-590-1]: [postgrespro.ru/docs/postgresql/18/spgist](); [backend/access/spgist/README]().
[^internal-ru-591-1]: [backend/access/spgist/spgscan.c](), функция spgWalk.
[^internal-ru-593-1]: [postgrespro.ru/docs/postgresql/18/spgist-extensibility]().
[^internal-ru-593-2]: [backend/access/spgist/spgquadtreeproc.c]().
[^internal-ru-594-1]: [include/access/stratnum.h]().
[^internal-ru-597-1]: [backend/access/spgist/spgdoinsert.c](), функция moveLeafs.
[^internal-ru-597-2]: [sigaev.ru/git/gitweb.cgi?p=gevel.git]().
[^internal-ru-597-3]: [commitfest.postgresql.org/15/1207]().
[^internal-ru-599-1]: [backend/access/spgist/spgquadtreeproc.c](), функция spg\_quad\_inner\_consistent.
[^internal-ru-599-2]: [backend/access/spgist/spgquadtreeproc.c](), функция spg\_quad\_leaf\_consistent.
[^internal-ru-599-3]: [backend/access/spgist/spgdoinsert.c](), функция spgdoinsert.
[^internal-ru-599-4]: [backend/access/spgist/spgquadtreeproc.c](), функция spg\_quad\_choose.
[^internal-ru-600-1]: [backend/access/spgist/spgquadtreeproc.c](), функция spg\_quad\_picksplit.
[^internal-ru-604-1]: [backend/access/spgist/spgkdtreeproc.c]().
[^internal-ru-606-1]: [backend/access/spgist/spgtextproc.c]().
[^internal-ru-608-1]: [backend/access/spgist/spgtextproc.c](), функция spg\_text\_inner\_consistent.
[^internal-ru-608-2]: [backend/access/spgist/spgtextproc.c](), функция spg\_text\_leaf\_consistent.
[^internal-ru-610-1]: [backend/access/spgist/spgtextproc.c](), функция spg\_text\_choose.
[^internal-ru-612-1]: [backend/utils/adt/geo\_spgist.c]().
[^internal-ru-612-2]: [postgis.net/docs/using\_postgis\_dbmanagement.html#spgist\_indexes]().
[^internal-ru-612-3]: [backend/utils/adt/rangetypes\_spgist.c]().
[^internal-ru-612-4]: [backend/utils/adt/network\_spgist.c]().