27 Индекс SP-GiST
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
27.1. Общий принцип
Буквы «SP» в названии SP-GiST расшифровываются как Space Partitioning, то есть разбиение пространства. Под пространством здесь подразумевается произвольная область значений, в которой производится поиск, а не обязательно пространство в обыденном понимании (например, двумерная плоскость). Ну а «GiST» намекает на определенную схожесть с этим методом: и GiST, и SP-GiST являются обобщенными деревьями поиска и служат каркасами для индексации различных типов данных.
Идея метода SP-GiST 1 состоит в разбиении пространства поиска на непересекающиеся области, каждая из которых, в свою очередь, также может быть рекурсивно разбита на подобласти. Такое разбиение порождает несбалансированные деревья (в отличие от B-деревьев и метода GiST) и может использоваться для реализации таких известных структур, как деревья квадрантов (quadtree), k-мерные деревья (k-D tree) или префиксные деревья (trie).
Обычно такие деревья слабо ветвятся и, следовательно, имеют большую глубину. Например, узел дерева квадрантов имеет не больше четырех дочерних узлов, а узел k-мерного дерева — только два. Это не проблема, когда дерево находится в оперативной памяти, но для дискового представления приходится решать непростую задачу эффективной упаковки узлов в страницы, чтобы минимизировать операции ввода-вывода. Для B-деревьев и GiST это не требуется, поскольку каждый узел дерева занимает страницу полностью.
Внутренний узел дерева SP-GiST содержит значение, соответствующее условию, которое выполняется для всех дочерних узлов. Такое значение часто называют префиксом; оно играет ту же роль, что предикат в индексе GiST. Ссылки на дочерние узлы в SP-GiST могут иметь метки.
Элементы листовых узлов содержат индексируемое значение (или его часть) и идентификатор соответствующей версии строки.
Как и GiST, метод доступа SP-GiST реализует только основные алгоритмы и берет на себя заботу о таких низкоуровневых задачах, как организация конкурентного доступа, блокирование и журналирование. Для добавления новых типов данных и алгоритмов разбиения пространства на области этот метод предоставляет интерфейс класса операторов. Класс операторов содержит значительную часть логики и определяет многие аспекты работы индекса.
Поиск 2 в дереве SP-GiST начинается с корневого узла и производится в глубину. Узлы, в которые имеет смысл заходить, выбираются с помощью опорной функции согласованности, похожей на аналогичную функцию в GiST. Для внутреннего узла дерева эта функция возвращает набор дочерних узлов, значения которых «согласуются» с поисковым предикатом. Функция выбирает узлы, не спускаясь в них, а ориентируясь на значения префикса и меток. Для листового узла функция определяет, удовлетворяет ли индексированное значение в этом узле поисковому предикату.
Время поиска значений в несбалансированном дереве может отличаться из-за разной глубины ветвей.
Для вставки значения в дерево SP-GiST используются две опорные функции. В узлах дерева, начиная с корня, функция выбора принимает одно из возможных решений: отправить новое значение в существующий дочерний узел, создать для него новый дочерний узел или (если значение не согласуется с префиксом узла) расщепить текущий узел. В выбранной в итоге листовой странице индекса может не оказаться достаточно места, и тогда функция расщепления решает, какие узлы перенести в новую страницу.
Дальше я рассмотрю эти алгоритмы на конкретных примерах.
27.2. Дерево квадрантов для точек
Дерево квадрантов (quadtree) используется для индексирования точек на плоскости. Область рекурсивно разбивается на четыре части (квадранта) по отношению к выбранной точке. Эта точка называется центроидом и служит префиксом узла, то есть условием, определяющим положение дочерних значений.
Корневой узел делит плоскость на четыре квадранта.
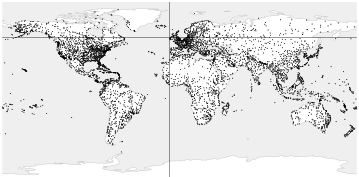
Затем каждый из них делится на собственные квадранты.
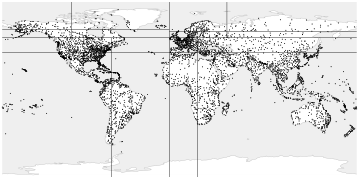
Процедура продолжается, пока не будет получено итоговое разбиение.
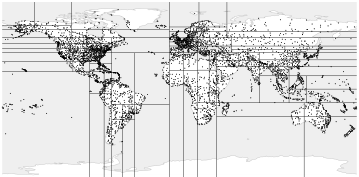
В этом примере использован индекс, построенный на расширенной таблице аэропортов. На рисунках видно, что глубина ветвей дерева отличается в зависимости от плотности точек в соответствующих квадрантах. Для наглядности я взял небольшое значение параметра хранения fillfactor, чтобы дерево имело больше уровней: (с. 558) (по умолчанию: 80)
По умолчанию для точек используется класс операторов quad_point_ops.
Класс операторов
Я уже называл основные опорные функции SP-GiST: функцию согласованности для поиска и функции выбора и расщепления для вставки.
Ниже приведен список опорных функций3, которые реализует класс операторов quad_point_ops4. Все они являются обязательными.
Функции имеют следующий смысл: (psql: \dAp)
настроечная функция, которая сообщает методу доступа характеристики класса операторов;
функция выбора узла для вставки значения;
функция распределения узлов при расщеплении;
функция внутренней согласованности, которая определяет, согласуется ли с поисковым предикатом значение во внутреннем узле;
функция листовой согласованности, которая определяет, согласуется ли с поисковым предикатом значение в листовом узле.
Кроме перечисленных, есть и несколько необязательных функций.
Класс операторов quad_point_ops поддерживает стратегии, общие с GiST 5: (с. 562) (psql: \dAo)
Например, с помощью оператора «выше» >^ можно найти аэропорты, расположенные севернее Диксона:
Рассмотрим теперь подробнее устройство и функционирование дерева квадрантов на простом примере с несколькими точками, который нам уже встречался в главе про GiST. (с. 563)
Вот как может выглядеть разбиение плоскости в этом случае:
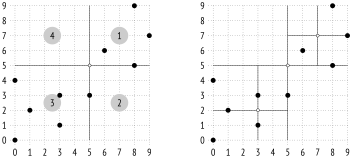
Левый рисунок показывает нумерацию квадрантов на примере одного уровня дерева; на следующих иллюстрациях я для определенности буду располагать дочерние узлы слева направо именно в такой последовательности. Точки, лежащие на границах, относятся к квадранту с меньшим номером. На правом рисунке показано окончательное разбиение.
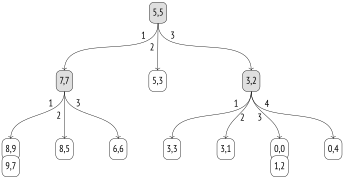
Ниже приведена возможная структура индекса для этого примера. Каждый внутренний узел ссылается максимум на четыре дочерних узла, и каждая ссылка помечена номером квадранта:
Страничная организация
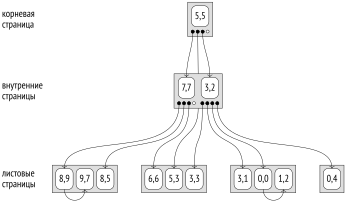
Между узлами дерева SP-GiST и страницами нет однозначного соответствия, которое характерно для B-деревьев и GiST-индексов. Из-за того, что внутренние узлы обычно имеют не очень много дочерних, в одну страницу приходится упаковывать несколько узлов. Внутренние узлы при этом хранятся на одних (внутренних) страницах, а листовые — на других (листовых).
Индексные записи внутренних страниц содержат значение, используемое как префикс, и набор ссылок на дочерние узлы, каждая из которых может сопровождаться меткой.
Записи листовых страниц состоят из значения и идентификатора табличной версии строки.
Все листовые узлы, относящиеся к одному и тому же внутреннему, хранятся в одной странице и связаны в список. Если в странице не хватает места, список может быть перемещен на другую страницу 6 или может произойти расщепление, но в любом случае список никогда не разрывается между несколькими страницами.
Чтобы экономно расходовать место, алгоритм старается располагать новые узлы в одних и тех же страницах, пока те не заполнятся. Номера последних использованных страниц кешируются обслуживающими процессами, а также периодически сохраняются в метастранице с нулевым номером. Метастраница не ссылается на корневой узел, как это происходит в случае B-дерева; корень SP-GiST всегда находится в первой странице.
Вариант распределения узлов дерева по страницам для нашего примера показан на рисунке ниже. На самом деле класс операторов quad_point_ops не использует метки. Поскольку дочерних узлов не может быть больше четырех, хранится массив фиксированного размера из четырех ссылок, некоторые из которых могут быть пустыми.
Поиск
Рассмотрим на этом же примере алгоритм поиска точек, расположенных выше точки (3,7).
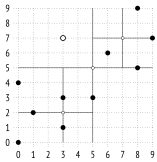
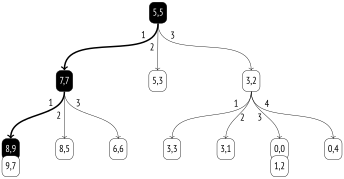
Поиск начинается с корневого узла. Функция внутренней согласованности 9 показывает, в какие дочерние узлы надо спускаться. Точка (3,7) сравнивается с центроидом корневого узла (5,5), и выбираются квадранты, в которых могут находиться искомые точки — в данном случае первый и четвертый.
В узле с центроидом (7,7) снова выбираются дочерние узлы для спуска. Подходят первый и четвертый квадранты, но четвертый пуст, так что необходимо проверить один листовой дочерний узел. Его точки сравниваются с точкой (3,7) из запроса с помощью функции листовой согласованности10. Из них только (8,9) удовлетворяет условию «выше».
Остается вернуться на уровень выше и проверить узел, соответствующий четвертому квадранту корневого узла. Он пуст, и на этом поиск завершен.
Вставка
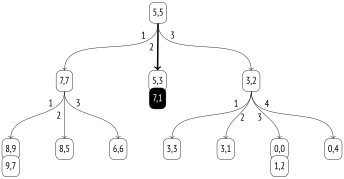
При вставке значения в дерево SP-GiST 11 каждое следующее действие определяется функцией выбора12. В данном случае она просто направляет новую точку в тот из существующих квадрантов, к которому она принадлежит.
Например, добавим значение (7,1):
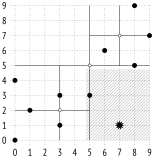
Значение принадлежит второму квадранту и будет добавлено к соответствующему узлу дерева:
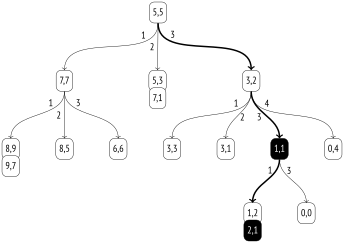
Если значение попадает в квадрант, список листовых узлов которого оказывается слишком велик (он должен помещаться в одной странице), происходит расщепление. Функция расщепления 13 определяет новый центроид, вычисляя среднее значение координат всех точек, и таким образом распределяет дочерние узлы по новым квадрантам более или менее равномерно.
В примере на рисунке ниже добавление точки (2,1) приводит к переполнению узла:
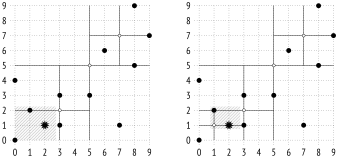
В дерево добавляется новый внутренний узел с центроидом (1,1), а точки (0,0), (1,2) и (2,1) распределяются между новыми квадрантами:
Свойства
Свойства уровня метода доступа
Поддержка сортировки значений и уникальности отсутствует. Не поддерживаются и многоколоночные индексы.
Ограничения исключения поддерживаются, как и в случае GiST.
Индекс SP-GiST можно создавать с дополнительными include-столбцами. (v. 14)
Свойства уровня индекса
Свойства индекса SP-GiST отличаются от свойств GiST тем, что не допускается кластеризация:
Оба способа получения идентификаторов версий (по одному и битовой картой) поддерживаются. Обратное сканирование SP-GiST не имеет смысла.
Свойства уровня столбца
Основная часть свойств столбцов неизменна:
Сортировка не поддерживается, и все свойства, связанные с ней, не имеют смысла и отключены.
До сих пор я ничего не говорил про неопределенные значения, но, как видно из свойств индекса, они поддерживаются. В отличие от GiST, индекс SP-GiST не хранит неопределенные значения в основном дереве. Для них создается отдельное дерево с корнем на второй странице индекса. Таким образом, первые три страницы всегда имеют фиксированный смысл: метастраница, корень основного дерева и корень дерева неопределенных значений.
Часть свойств уровня столбца может меняться в зависимости от класса операторов:
В данном случае (как и во всех остальных примерах этой главы) индекс может использоваться для сканирования только индекса.
Но в общем случае класс операторов может не хранить полное значение в листовых страницах, выполняя вместо этого перепроверку по таблице.
Это, например, позволяет использовать индексы SP-GiST в PostGIS для потенциально больших значений типа geometry.
Поиск ближайших соседей поддерживается; в классе операторов мы видели упорядочивающий оператор <->. (v. 12)
27.3. K-мерные деревья для точек
Для точек на плоскости можно предложить и другой способ разбиения пространства: делить плоскость не на четыре части, а на две. Такое разбиение использует класс операторов kd_point_ops 14:
Обратите внимание, что индексируемые значения, префиксы и метки могут иметь различные типы данных. Для этого класса операторов значения являются точками, префиксы — вещественными числами, а метки отсутствуют (как и в quad_point_ops).
Выберем какую-нибудь координату на оси ординат (в примере с аэропортами — широту). Она поделит плоскость на две части, верхнюю и нижнюю:
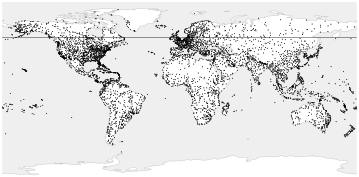
Для каждой из двух областей выберем координаты на оси абсцисс (долготу), которые поделят области на две части, левую и правую:
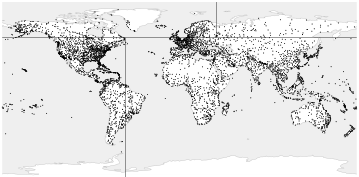
Будем продолжать делить каждую из частей попеременно то по горизонтали, то по вертикали, пока в каждой из них не останется столько точек, сколько помещается на одну страницу индекса:
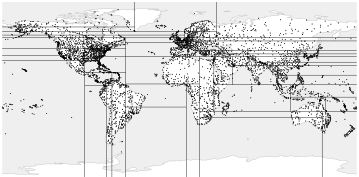
У всех внутренних узлов дерева, построенного таким образом, будет всего два дочерних узла. Метод легко обобщается на случай пространства произвольной размерности, поэтому и деревья называются в литературе k-мерными (k-D tree).
27.4. Префиксное дерево для строк
Класс операторов text_ops 15 для SP-GiST реализует префиксное дерево (radix tree) для строк. Здесь префикс внутреннего узла действительно является префиксом, общим для всех строк в дочерних узлах.
Ссылки на дочерние узлы дерева помечены первым байтом значений, следующих за префиксом.
На рисунке я для ясности показываю префикс как один символ, но это верно только для восьмибитных кодировок. В общем случае класс операторов работает со строкой как с последовательностью байтов. Кроме того, префикс может принимать еще несколько значений, имеющих специальный смысл, так что фактически под префикс выделено два байта.
В дочерних узлах хранятся те части значений, которые следуют за префиксом и меткой. На долю листовых узлов остаются только окончания.
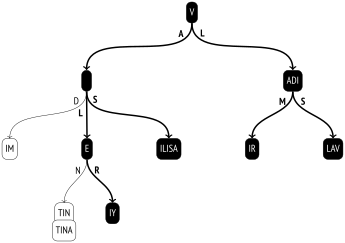
Вот пример префиксного дерева, построенного по нескольким именам:
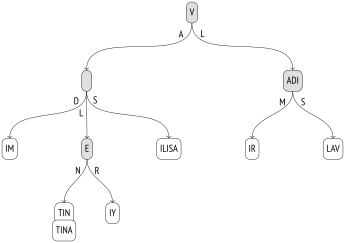
Полное значение ключа индексирования в листовом узле можно восстановить конкатенацией всех префиксов и меток, следуя от корня дерева к этому узлу. За счет того, что значения не хранятся целиком, а реконструируются по мере необходимости, представление в виде префиксного дерева может иногда оказаться существенно компактнее B-дерева.
Класс операторов
Класс операторов text_ops поддерживает операторы сравнения, традиционные для порядкового типа, которым является текстовая строка: (psql: \dAo)
Операторы с тильдами отличаются от обычных тем, что работают не с символами, а с байтами (аналогично операторам класса text_pattern_ops для B-дерева), и поэтому органично поддерживаются префиксным деревом, которое тоже размечено байтами. Обычные же операторы >= и < учитывают правила сортировки и вынуждены анализировать символы. Они поддерживаются индексом только при использовании правила сортировки «C». (с. 399)
Для ускорения поиска по условию LIKE класс операторов поддерживает оператор префиксного поиска ^@:
Поиск
Рассмотрим на примере с именами выполнение следующего запроса:
Сначала функция внутренней согласованности 16 вызывается в корне дерева, и она должна определить, в какие дочерние узлы спускаться. Функция конкатенирует префикс V и метки A и L. Значение VA подставляется в условие запроса, в котором строковые константы обрезаются так, чтобы их длина не превышала длины проверяемого значения: VA ~>=~ 'VA' AND VA ~<~ 'VL'. Условие выполняется, так что дочерний узел с меткой A должен быть проверен. Аналогично проверяется и значение VL. Оно тоже подходит, поэтому и узел с меткой L требует проверки.
Возьмем теперь узел, соответствующий значению VA. Его префикс пуст, и для трех дочерних узлов функция внутренней согласованности восстанавливает значения VAD, VAL и VAS, конкатенируя полученное на предыдущем шаге VA с меткой. Условие VAD ~>=~ 'VAL' AND VAD ~<~ 'VER' не выполняется, но два других значения подходят.
Обходя таким образом дерево вглубь и отбрасывая неподходящие ветви, алгоритм добирается до листовых узлов. Функция листовой согласованности 17 проверяет, соответствует ли восстановленное по мере спуска значение исходному условию. Подходящие значения возвращаются в качестве результата индексного сканирования.
Обратите внимание, что хотя в запросе используются операторы «больше» и «меньше», обычные для B-деревьев, поиск диапазона по дереву SP-GiST гораздо менее эффективен. В случае B-дерева достаточно спуститься только к одному крайнему значению диапазона и затем прочитать цепочку листовых страниц.
Вставка
Функция выбора классов операторов для точек всегда может направить новое значение в одну из существующих подобластей (квадрант или половину). В префиксном дереве это не так: новое значение может не соответствовать имеющемуся префиксу, и тогда внутренний узел приходится разделять.
В качестве примера рассмотрим добавление имени VLADA к уже имеющемуся дереву.
От корня дерева с помощью функции выбора 18 можно успешно спуститься на один узел (V + L), но остаток значения ADA не согласуется с префиксом ADI. Узел необходимо разделить на два: в одном оставить наибольший общий префикс, то есть AD, а остаток префикса перенести на уровень ниже:
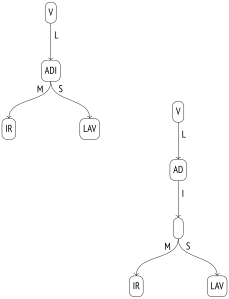
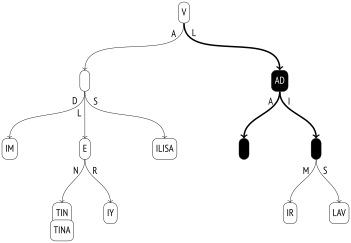
После этого функция выбора вызывается в том же узле еще раз. Префикс теперь соответствует значению, но нет дочернего узла с подходящей меткой (A), и функция принимает решение создать такой узел. Конечный результат показан на рисунке ниже; на нем выделены узлы, добавленные или измененные в ходе вставки.
Свойства
Свойства уровня метода доступа и индекса я уже показывал, они не меняются от класса к классу. Большинство свойств уровня столбца также постоянны.
Хотя индексируемые значения и не хранятся в явном виде в дереве, сканирование только индекса работает, поскольку значения восстанавливаются по мере спуска от корня до листовых узлов.
А вот оператор расстояния для строк не определен, и поиск ближайших соседей не поддерживается этим классом операторов.
Это не значит, что для строк нельзя ввести понятие расстояния. Например, расширение pg_trgm добавляет оператор для расстояния на основе триграмм: считается, что чем меньше доля общих триграмм у двух строк, тем дальше они находятся друг от друга. Другой вариант — расстояние Левенштейна, которое определяется как минимальное количество односимвольных операций, преобразующих одну строку в другую. Функция для расчета такого расстояния есть в расширении fuzzystrmatch. Но ни одно из расширений не предоставляет класс операторов с поддержкой SP-GiST.
27.5. Другие типы данных
Помимо рассмотренных примеров индексирования точек и текстовых строк, реализованы и другие классы операторов для SP-GiST.
Геометрические типы. Класс операторов box_ops 19 реализует дерево квадрантов для прямоугольников. Прямоугольники представляются точками в четырехмерном пространстве, так что область разбивается на шестнадцать частей.
Класс операторов poly_ops позволяет индексировать полигоны. Это неточный класс операторов: фактически вместо полигонов используются ограничивающие прямоугольники, как в box_ops, с перепроверкой по таблице.
Какой из методов доступа предпочесть — GiST или SP-GiST, — существенно зависит от вида индексируемых данных. Например, документация PostGIS рекомендует SP-GiST для сильно пересекающихся объектов («лапши»)20.
Диапазонные типы. Дерево квадрантов для диапазонов предоставляет класс операторов range_ops21. Интервал представляется двумерной точкой: нижняя граница становится абсциссой, а верхняя — ординатой.
Сетевые адреса. Для типа данных inet класс операторов inet_ops 22 реализует префиксное дерево.
postgrespro.ru/docs/postgresql/18/spgist; backend/access/spgist/README. ↩︎
backend/access/spgist/spgscan.c, функция spgWalk. ↩︎
backend/access/spgist/spgdoinsert.c, функция moveLeafs. ↩︎
backend/access/spgist/spgquadtreeproc.c, функция spg_quad_inner_consistent. ↩︎
backend/access/spgist/spgquadtreeproc.c, функция spg_quad_leaf_consistent. ↩︎
backend/access/spgist/spgdoinsert.c, функция spgdoinsert. ↩︎
backend/access/spgist/spgquadtreeproc.c, функция spg_quad_choose. ↩︎
backend/access/spgist/spgquadtreeproc.c, функция spg_quad_picksplit. ↩︎
backend/access/spgist/spgtextproc.c, функция spg_text_inner_consistent. ↩︎
backend/access/spgist/spgtextproc.c, функция spg_text_leaf_consistent. ↩︎
backend/access/spgist/spgtextproc.c, функция spg_text_choose. ↩︎
postgis.net/docs/using_postgis_dbmanagement.html#spgist_indexes. ↩︎