# Индекс GiST
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
## 26.1. Общий принцип {#internal-ru-section-26-1}
Метод доступа GiST (Generalized Search Tree) [^internal-ru-556-1] — обобщение идеи сбалансированного дерева поиска для типов данных, допускающих взаимное расположение значений. B-деревья жестко привязаны к порядковым типам данных, значения которых можно сравнивать (но поддержка таких типов реализована максимально эффективно). А GiST позволяет задать произвольный принцип распределения данных по дереву в классе операторов. В GiST-индекс можно «уложить» R-дерево для пространственных данных или RD-дерево для множеств, а сигнатурное дерево можно применять для любых типов данных (например, для текстов или изображений).
Благодаря расширяемости в PostgreSQL можно с нуля создать новый метод доступа, реализовав интерфейс с механизмом индексирования. Но это требует не только продумывания логики индексации, но и организации страничной структуры, эффективной стратегии блокирования, поддержки журнала упреждающей записи. Все это подразумевает очень высокую квалификацию разработчика и большую трудоемкость. GiST упрощает задачу, беря на себя решение низкоуровневых проблем и реализуя общую идею поиска. Чтобы использовать метод GiST для нового типа данных, достаточно предоставить класс операторов, состоящий из десятка опорных функций. Такой класс содержит значительную часть логики индексирования, в отличие от совсем простого класса операторов B-дерева. В этом смысле можно говорить о том, что GiST является каркасом для построения новых методов доступа.
Каждая запись листового узла (листовая запись) содержит, если говорить в самом общем виде, некий *предикат* (логическое условие) и идентификатор табличной версии строки. Ключ индексирования обязан удовлетворять предикату; при этом не важно, входит сам ключ в эту запись или нет.
Каждая запись внутреннего узла (внутренняя запись) также содержит предикат и ссылку на дочерний узел, причем все индексированные данные дочернего поддерева должны удовлетворять этому предикату. Иными словами, предикат внутренней записи включает в себя предикаты всех дочерних записей. Это важное свойство, заменяющее индексу GiST простую упорядоченность B-дерева.
Поиск в дереве GiST использует *функцию согласованности* — одну из опорных функций, определяемых классом операторов.
Функция согласованности вызывается для индексной записи и определяет, «согласуется» ли предикат данной записи с условием поиска (вида «*индексированный-столбец оператор выражение*»). Для внутренней записи она показывает, надо ли спускаться в соответствующее поддерево, а для листовой записи — удовлетворяет ли условию ключ индексирования.
Поиск[^internal-ru-557-1], как обычно в дереве, начинается с корневого узла. С помощью функции согласованности выясняется, в какие дочерние узлы имеет смысл заходить, а в какие — нет. Затем алгоритм повторяется для каждого из найденных дочерних узлов; в индексе GiST, в отличие от B-дерева, их может оказаться несколько. Записи, отобранные функцией согласованности в листовых узлах, возвращаются в качестве результатов.
Поиск всегда производится в глубину: алгоритм в первую очередь старается добраться до какого-нибудь листового узла. Это позволяет быстрее начать возвращать результаты, что может быть важно, если пользователя интересуют только несколько первых строк.
Для вставки нового значения в дерево GiST функция согласованности не годится, поскольку нужно выбрать один конкретный листовой узел[^internal-ru-557-2]. Узел выбирается так, чтобы минимизировать стоимость вставки, определяемую *штрафной функцией* класса операторов.
Как и в случае B-дерева, в выбранном узле может не оказаться свободного места, что приводит к расщеплению[^internal-ru-558-1]. Для этого требуются еще две функции. Одна решает, какие записи останутся в старом узле, а какие будут перенесены в новый; другая объединяет два предиката, чтобы обновить предикат родительского узла.
Добавление новых значений постепенно расширяет существующие предикаты, а сужение выполняется только при расщеплении страницы либо при полном перестроении индекса. Это может приводить к деградации производительности GiST-индекса при частых обновлениях.
Поскольку все эти рассуждения общего вида могут показаться непонятными, а значительная часть логики зависит от конкретного класса операторов, дальше я рассмотрю несколько конкретных примеров.
## 26.2. R-дерево для точек {#internal-ru-section-26-2}
Первый пример относится к индексации точек (или других геометрических объектов) на плоскости. Обычное B-дерево не подходит для такого типа данных, поскольку для точек не определены операторы сравнения. Конечно, такие операторы можно определить самостоятельно, но при работе с геометрическими данными нас интересует индексная поддержка совсем других операций, из которых я подробно рассмотрю две: поиск вхождения в заданную область и поиск ближайших соседей.
Идея R-дерева состоит в том, что плоскость разбивается на прямоугольники, которые в сумме покрывают все индексируемые точки. Индексная запись хранит ограничивающий прямоугольник, а предикат можно сформулировать так: *точка лежит внутри данного ограничивающего прямоугольника*.
Корень R-дерева содержит несколько самых крупных прямоугольников (возможно, даже пересекающихся). В дочерних узлах находятся меньшие по размеру прямоугольники, вложенные в родительские; в совокупности они охватывают все нижележащие точки.
Листовые узлы должны содержать сами индексируемые точки, однако GiST требует, чтобы тип данных совпадал во всех индексных записях; поэтому хранятся все те же прямоугольники, но «схлопнутые» в точки.
Представить эту структуру наглядно помогут рисунки трех уровней R-дерева, построенного по координатам аэропортов. Для этого примера я расширяю таблицу `airports` демобазы до пяти тысяч строк[^internal-ru-559-1]. Для наглядности индекс построен с низким значением параметра хранения *fillfactor*, чтобы дерево получилось глубоким; со значением по умолчанию хватает одного уровня. (*по умолчанию:* `90`)
```text {label="psql"}
=> CREATE TABLE airports_big AS
SELECT * FROM airports_data;
=> COPY airports_big FROM
'/home/student/internals/airports/extra_airports.copy';
=> CREATE INDEX airports_gist_idx ON airports_big
USING gist(coordinates) WITH (fillfactor=10);
```
На верхнем уровне все точки поделены между несколькими (отчасти пересекающимися) ограничивающими прямоугольниками:
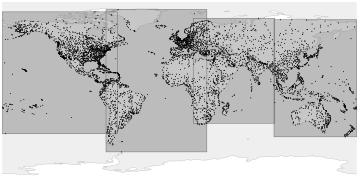
{#internal-ru-fig-26-1 num="26.1" caption="R-дерево для точек" .book-original-figure width=718 height=354}
На следующем уровне большие прямоугольники распадаются на меньшие:
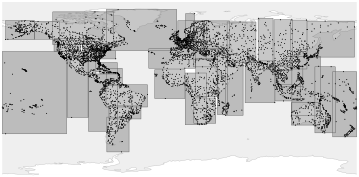
{#internal-ru-fig-26-2 num="26.2" caption="R-дерево для точек" .book-original-figure width=718 height=354}
На последнем, внутреннем уровне дерева каждый ограничивающий прямоугольник содержит столько точек, сколько помещается на одну страницу:
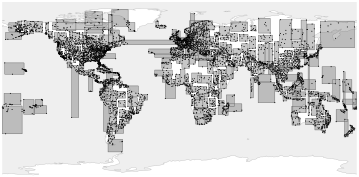
{#internal-ru-fig-26-3 num="26.3" caption="R-дерево для точек" .book-original-figure width=718 height=354}
> [!NOTE]
> Рисунки показывают структуру индекса, созданного 13-й версией PostgreSQL. Версия 14 предварительно сортирует точки в z-порядке [^internal-ru-560-1] — это дает значительный выигрыш в скорости построения индекса, но увеличивает перекрытия прямоугольников (и снижает эффективность поиска). В версии 15 алгоритм сортировки был существенно улучшен[^internal-ru-560-2], но прежние рисунки остаются более наглядными.
В этом индексе используется класс операторов `point_ops`, единственный для точек.
Точно так же можно индексировать и прямоугольники, и любые другие геометрические фигуры, если вместо самой фигуры сохранять в индексе ограничивающий ее прямоугольник.
### Страничная организация {#internal-ru-subsection-star-389}
Содержимое страниц GiST-индекса можно изучать с помощью расширения `pageinspect`. (v. 14)
В отличие от B-дерева, индекс GiST не имеет метастраницы, а корень дерева всегда располагается в нулевой странице. Если корневая страница расщепляется, старый корень переносится в отдельную страницу, а новый занимает его место.
Вот содержимое корневой страницы:
```text {label="psql"}
=> SELECT ctid, left(keys,65) AS keys
FROM gist_page_items(
get_raw_page('airports_gist_idx', 0), 'airports_gist_idx'
) \gx
-[ RECORD 1 ]-----------------------------------------------------------
ctid | (216,65535)
keys | (coordinates)=("(27.588300704956055,42.55270004272461),(-179.8769
-[ RECORD 2 ]-----------------------------------------------------------
ctid | (367,65535)
keys | (coordinates)=("(27.826700210571,82.51779937740001),(-176.6459960
-[ RECORD 3 ]-----------------------------------------------------------
ctid | (217,65535)
keys | (coordinates)=("(50.84510040283203,70.871399),(13.922200202941895
-[ RECORD 4 ]-----------------------------------------------------------
ctid | (526,65535)
keys | (coordinates)=("(179.951004028,73.51780700683594),(46.95610046386
```
Эти четыре строки соответствуют четырем прямоугольникам верхнего уровня, показанным на рисунке на предыдущем развороте.
### Класс операторов {#internal-ru-subsection-star-391}
Список опорных функций, реализующих логику поиска и вставки в дерево[^internal-ru-562-1], можно получить следующим запросом: (psql: `\dAp`)
```text {label="psql"}
=> SELECT amprocnum, amproc::regproc
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'gist'
AND opcname = 'point_ops'
ORDER BY amprocnum;
amprocnum | amproc
-----------+------------------------
1 | gist_point_consistent
2 | gist_box_union
3 | gist_point_compress
5 | gist_box_penalty
6 | gist_box_picksplit
7 | gist_box_same
8 | gist_point_distance
9 | gist_point_fetch
11 | gist_point_sortsupport
(9 rows)
```
Основные обязательные функции я уже называл выше:
1) функция согласованности для обхода дерева при поиске;
2) функция объединения (обратите внимание на название: объединяются прямоугольники);
5) функция штрафа для спуска при вставке;
6) функция, распределяющая записи при расщеплении;
7) функция, проверяющая равенство двух ключей.
Необязательные функции позволяют управлять аспектами хранения данных и производительности.
Класс операторов `point_ops` поддерживает следующие операторы:
```text {label="psql"}
=> SELECT amopopr::regoperator, amopstrategy AS st, oprcode::regproc,
left(obj_description(opr.oid, 'pg_operator'), 19) description
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amop amop ON amopfamily = opcfamily
JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gist'
AND opcname = 'point_ops'
ORDER BY amopstrategy;
amopopr | st | oprcode | description
-------------------+----+---------------------+---------------------
<<(point,point) | 1 | point_left | is left of
>>(point,point) | 5 | point_right | is right of
~=(point,point) | 6 | point_eq | same as
<<|(point,point) | 10 | point_below | is below
|>>(point,point) | 11 | point_above | is above
<->(point,point) | 15 | point_distance | distance between
<@(point,box) | 28 | on_pb | point inside box
<^(point,point) | 29 | point_below | deprecated, use <<|
>^(point,point) | 30 | point_above | deprecated, use |>>
<@(point,polygon) | 48 | pt_contained_poly | is contained by
<@(point,circle) | 68 | pt_contained_circle | is contained by
(11 rows)
```
По именам операторов бывает сложно догадаться об их значении, поэтому в запросе выведены названия реализующих их функций и описание. Все операторы так или иначе связаны со взаимным положением объектов («слева», «справа», «выше», «ниже», «содержит», «содержится в») и расстоянием между ними. (psql: `\dAo`)
В отличие от B-деревьев, GiST располагает значительно бóльшим количеством стратегий. Часть номеров стратегий общая для нескольких типов индексов[^internal-ru-563-1], а часть вычисляется по формулам (например, номера 28, 48 и 68 представляют, по сути, одну стратегию: «содержится в» для прямоугольников, полигонов и окружностей). Кроме того, поддерживаются некоторые устаревшие названия операторов (`<<|` и `|>>`).
Конкретный класс операторов может реализовывать не все из имеющихся стратегий. Например, класс для точек не реализует стратегию «содержит», но такая стратегия присутствует в классах фигур, имеющих площадь (`box_ops`, `poly_ops` и `circle_ops`).
### Поиск вхождения в область {#internal-ru-subsection-star-393}
Типичный запрос, ускоряемый индексом, получает все точки, входящие в заданную область.
Например, найдем все аэропорты, находящиеся в пределах одного градуса от центра Москвы:
```text {label="psql"}
=> SELECT airport_code, airport_name->>'en'
FROM airports_big
WHERE coordinates <@ '<(37.622513,55.753220),1.0>'::circle;
airport_code | ?column?
--------------+------------------------------------
SVO | Sheremetyevo International Airport
VKO | Vnukovo International Airport
DME | Domodedovo International Airport
BKA | Bykovo Airport
ZIA | Zhukovsky International Airport
CKL | Chkalovskiy Air Base
OSF | Ostafyevo International Airport
(7 rows)
=> EXPLAIN (costs off) SELECT airport_code
FROM airports_big
WHERE coordinates <@ '<(37.622513,55.753220),1.0>'::circle;
QUERY PLAN
---------------------------------------------------------------------
Bitmap Heap Scan on airports_big
Recheck Cond: (coordinates <@ '<(37.622513,55.75322),1>'::circle)
-> Bitmap Index Scan on airports_gist_idx
Index Cond: (coordinates <@ '<(37.622513,55.75322),1>'::ci...
(4 rows)
```
Оператор «содержится в» `<@` определяет, лежит ли точка внутри заданного прямоугольника. Функция согласованности для этого оператора [^internal-ru-564-1] возвращает «да», если прямоугольник индексной записи имеет общие точки с заданным прямоугольником. Для листовых страниц, записи которых хранят «схлопнутые» в точки прямоугольники, это означает, что функция (как и сам оператор) определяет, содержится ли точка внутри заданного прямоугольника.
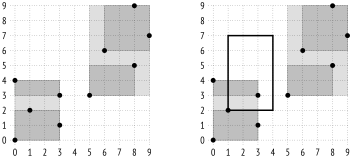
Рассмотрим подробнее работу оператора на совсем простом примере, показанном на рисунке:
{#internal-ru-fig-26-4 num="26.4" caption="Поиск вхождения в область" .book-original-figure width=705 height=319}
Структура индекса при таком разбиении выглядит следующим образом:
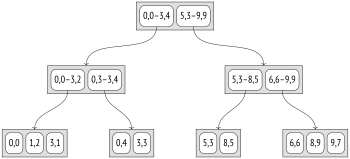
{#internal-ru-fig-26-5 num="26.5" caption="Поиск вхождения в область" .book-original-figure width=700 height=318}
Давайте найдем внутренние точки прямоугольника (1,2)–(4,7), показанного справа на рисунке выше.
Поиск начинается с корневого узла. Заданный прямоугольник пересекается с (0,0)–(3,4), но не пересекается с (5,3)–(9,9). Поэтому во второе поддерево нам спускаться не нужно.
На следующем уровне заданный прямоугольник пересекается с (0,3)–(3,4) и касается (0,0)–(3,2), поэтому нам придется проверить оба поддерева.
Когда мы дойдем до листовых узлов, останется перебрать все содержащиеся там точки и вернуть те, для которых выполняется функция согласованности.
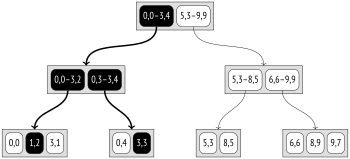
{#internal-ru-fig-26-6 num="26.6" caption="Поиск вхождения в область" .book-original-figure width=700 height=318}
Поиск по В-дереву всегда однозначно выбирает дочерний узел; поиск по GiST же может потребовать обхода нескольких поддеревьев, особенно если их ограничивающие прямоугольники пересекаются.
### Поиск ближайших соседей {#internal-ru-subsection-star-395}
Большинство операторов, поддерживаемых индексами (таких как `=` или `<@` в предыдущем примере), можно назвать *поисковыми*, так как они задают условия поиска в запросе. Такие операторы являются предикатами, то есть возвращают логическое значение.
Есть и другой тип операторов — *упорядочивающие*, которые возвращают расстояние между аргументами. Такие операторы в предложении `ORDER BY` могут поддерживаться индексами, реализующими свойство DISTANCE ORDERABLE, что позволяет эффективно находить заданное количество ближайших соседей. Такой поиск известен как k-NN — k-nearest neighbor search. (*с.* [410](/ru/19-index-access-methods/#internal-ru-page-411))
Например, можно найти десять аэропортов, ближайших к Костроме:
```text {label="psql"}
=> SELECT airport_code, airport_name->>'en'
FROM airports_big
ORDER BY coordinates <-> '(40.926780,57.767943)'::point
LIMIT 10;
airport_code | ?column?
--------------+------------------------------------------------
KMW | Kostroma Sokerkino Airport
IAR | Tunoshna Airport
IWA | Ivanovo South Airport
VGD | Vologda Airport
RYB | Staroselye Airport
GOJ | Nizhny Novgorod Strigino International Airport
CEE | Cherepovets Airport
CKL | Chkalovskiy Air Base
ZIA | Zhukovsky International Airport
BKA | Bykovo Airport
(10 rows)
=> EXPLAIN (costs off) SELECT airport_code
FROM airports_big
ORDER BY coordinates <-> '(40.926780,57.767943)'::point
LIMIT 10;
QUERY PLAN
-----------------------------------------------------------------
Limit
-> Index Scan using airports_gist_idx on airports_big
Order By: (coordinates <-> '(40.92678,57.767943)'::point)
(3 rows)
```
За счет того, что индексное сканирование выдает результаты по одному и его можно остановить в любой момент, поиск нескольких значений получается очень быстрым.
> [!NOTE]
> В отсутствие индексной поддержки построить эффективный поиск было бы непросто. Для этого пришлось бы искать точки, входящие в некоторую область, постепенно расширяя ее, пока не будет найдено заданное количество результатов. Это потребовало бы нескольких индексных сканирований, не говоря уже о проблеме выбора начального размера области и ее приращения.
В системном каталоге можно увидеть тип оператора (s — поисковый, o — упорядочивающий): (psql: `\dAo`)
```text {label="psql" hl_lines="15"}
=> SELECT amopopr::regoperator, amoppurpose, amopstrategy
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amop amop ON amopfamily = opcfamily
WHERE amname = 'gist'
AND opcname = 'point_ops'
ORDER BY amopstrategy;
amopopr | amoppurpose | amopstrategy
-------------------+-------------+--------------
<<(point,point) | s | 1
>>(point,point) | s | 5
~=(point,point) | s | 6
<<|(point,point) | s | 10
|>>(point,point) | s | 11
<->(point,point) | o | 15
<@(point,box) | s | 28
<^(point,point) | s | 29
>^(point,point) | s | 30
<@(point,polygon) | s | 48
<@(point,circle) | s | 68
(11 rows)
```
Для поддержки поиска ближайших соседей класс операторов должен определить дополнительную опорную *функцию расстояния*. Функция расстояния вызывается для элемента индекса и вычисляет расстояние от значения в данном элементе до некоторого другого значения.
Для листового элемента, представляющего собой индексированное значение, функция должна вернуть расстояние от этого значения. В случае точек [^internal-ru-568-1] это обычное евклидово расстояние, равное \(\sqrt{(x_2-x_1)^2+(y_2-y_1)^2}\).
Для внутреннего элемента функция должна вернуть *минимальное* из расстояний от дочерних листовых элементов. Поскольку перебирать все дочерние записи весьма накладно, функция имеет право оптимистически приуменьшать расстояние (жертвуя при этом эффективностью), но не должна возвращать большее значение — это нарушит корректность поиска.
Поэтому для внутреннего элемента, представленного ограничивающим прямоугольником, расстояние до точки понимается в обычном математическом смысле, как минимальное расстояние между точкой и прямоугольником или ноль, если точка находится внутри[^internal-ru-568-2]. Это значение легко вычислить, не обходя дочерние точки прямоугольника, и оно гарантированно не больше расстояния до любой из них.
Рассмотрим на нашем простом примере алгоритм поиска трех ближайших соседей точки (6,8):
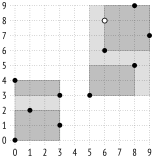
{#internal-ru-fig-26-7 num="26.7" caption="Поиск ближайших соседей" .book-original-figure width=308 height=319}
Поиск начинается с корневого узла, в котором имеется два ограничивающих прямоугольника. За расстояние от точки до (0,0)–(3,4) принимается расстояние до угла (3,4) прямоугольника, и оно составляет 5,0. Расстояние до (5,3)–(9,9) равно 0,0. (Я буду округлять значения до одного знака после запятой; в этом примере такой точности достаточно.)
Обход дочерних узлов происходит в порядке увеличения расстояния. Таким образом, сначала мы спускаемся в правый дочерний узел, содержащий два прямоугольника: (5,3)–(8,5) и (6,6)–(9,9). Расстояние до первого составляет 3,0, а до второго — 0,0:
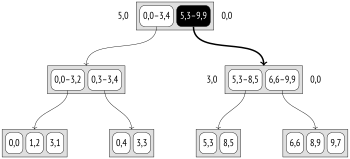
{#internal-ru-fig-26-8 num="26.8" caption="Поиск ближайших соседей" .book-original-figure width=700 height=318}
Снова спускаемся в правое поддерево и попадаем в листовой узел, содержащий три точки: (6,6) на расстоянии 2,0, (8,9) на расстоянии 2,2 и (9,7) на расстоянии 3,2. Таким образом, у нас есть первые две точки (6,6) и (8,9), но расстояние до третьей точки этого узла больше, чем расстояние до прямоугольника (5,3)–(8,5):
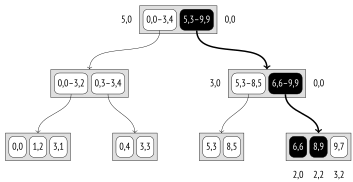
{#internal-ru-fig-26-9 num="26.9" caption="Поиск ближайших соседей" .book-original-figure width=707 height=364}
Поэтому теперь спускаемся в левый дочерний узел, содержащий две точки: (8,5) на расстоянии 3,6 и (5,3) на расстоянии 5,1. Оказывается, точка (9,7) в предыдущем дочернем узле ближе, чем любая из точек левого поддерева, и мы можем вернуть ее в качестве третьего результата:
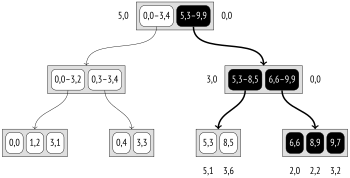
{#internal-ru-fig-26-10 num="26.10" caption="Поиск ближайших соседей" .book-original-figure width=700 height=357}
Этот пример поясняет требования к функции расстояния для внутренних записей. Уменьшенное расстояние (3,0 вместо реальных 3,6) до прямоугольника (5,3)–(8,5) ухудшило эффективность, поскольку пришлось напрасно просмотреть дополнительный узел, но не нарушило правильность работы алгоритма.
### Вставка {#internal-ru-subsection-star-397}
При вставке нового ключа в R-дерево узел для вставки выбирается на основании штрафной функции так, чтобы площадь охватывающего прямоугольника изменилась как можно меньше[^internal-ru-571-1].
Например, точка (4,7) будет добавлена к прямоугольнику (5,3)–(9,9), поскольку его площадь при этом увеличится всего на 6 единиц, в то время как площадь прямоугольника (0,0)–(3,4) пришлось бы увеличить на 12. На следующем (листовом) уровне из этих же соображений точка будет добавлена к прямоугольнику (6,6)–(9,9).
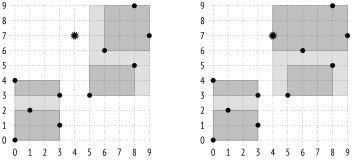
{#internal-ru-fig-26-11 num="26.11" caption="Вставка" .book-original-figure width=705 height=319}
Если предположить, что на странице помещается не более трех элементов, произойдет расщепление страницы на две, и элементы перераспределятся между ними:
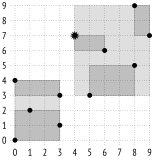
{#internal-ru-fig-26-12 num="26.12" caption="Вставка" .book-original-figure width=308 height=319}
В этом примере результат кажется очевидным, но в общем случае выбор распределения представляет весьма непростую задачу. Функция расщепления в первую очередь пытается минимизировать пересечение ограничивающих прямоугольников, отдавая предпочтение прямоугольникам с меньшей площадью и равномерному распределению точек между страницами[^internal-ru-572-1].
### Ограничение исключения {#internal-ru-subsection-star-399}
Индекс GiST может применяться для поддержки ограничений исключения (exclude).
Ограничение исключения гарантирует, что заданные поля любых двух строк таблицы не будут «соответствовать» друг другу в смысле некоторого *оператора*. Должны выполняться следующие условия:
- ограничение исключения должно поддерживаться индексным методом (свойство CAN EXCLUDE);
- оператор должен входить в класс операторов этого индексного метода;
- оператор должен быть коммутативным, то есть должно выполняться условие *a оператор b* = *b оператор a*.
Методы доступа `hash` и `btree`, рассмотренные выше, предлагают единственный оператор, подходящий под условие, — равенство. С таким оператором ограничение исключения соответствует ограничению уникальности, что не особенно полезно. (*с.* [521](/ru/24-hash/#internal-ru-page-522))
Но метод `gist` имеет еще две подходящие стратегии:
- пересечение — оператор `&&`;
- примыкание — оператор `-|-` (определен для интервалов).
В качестве примера создадим ограничение, запрещающее располагать аэропорты слишком близко друг к другу. Это условие можно переформулировать так: окружности некоторого радиуса с центрами в координатах аэропортов не должны пересекаться:
```text {label="psql"}
=> ALTER TABLE airports_data ADD EXCLUDE
USING gist (circle(coordinates,0.2) WITH &&);
```
```text {label="psql"}
=> INSERT INTO airports_data(
airport_code, airport_name, city, coordinates, timezone
) VALUES (
'ZIA', '{}', '{"en": "Moscow"}', point(38.1517, 55.5533),
'Europe/Moscow'
);
ERROR: conflicting key value violates exclusion constraint
"airports_data_circle_excl"
DETAIL: Key (circle(coordinates, 0.2::double
precision))=(<(38.1517,55.5533),0.2>) conflicts with existing key
(circle(coordinates, 0.2::double
precision))=(<(37.90629959106445,55.40879821777344),0.2>).
```
При создании ограничения исключения автоматически создается индекс для его проверки. В данном примере это GiST-индекс по выражению.
Усложним задачу. Пусть требуется разрешить близкое соседство аэропортов, но только в том случае, когда они относятся к одному городу. Решением будет создать новое ограничение целостности, которое можно сформулировать так: не допускаются пары строк, в которых *пересекаются* (`&&`) окружности с центрами в координатах аэропортов и при этом *не совпадают* (`!=`) названия городов.
Попытка создать такое ограничение приводит к ошибке, поскольку не существует класса операторов для текстового типа данных:
```text {label="psql"}
=> ALTER TABLE airports_data
DROP CONSTRAINT airports_data_circle_excl; -- удаляем старое
=> ALTER TABLE airports_data ADD EXCLUDE USING gist (
circle(coordinates,0.2) WITH &&,
(city->>'en') WITH !=
);
ERROR: data type text has no default operator class for access method
"gist"
HINT: You must specify an operator class for the index or define a
default operator class for the data type.
```
Но ведь GiST работает со стратегиями вроде «находится слева», «находится справа» и «совпадает», которые можно применить и к обычным порядковым типам данных, таким как числа или текстовые строки. Расширение `btree_gist` как раз и добавляет GiST-поддержку операций, характерных для B-деревьев:
```text {label="psql"}
=> CREATE EXTENSION btree_gist;
=> ALTER TABLE airports_data ADD EXCLUDE USING gist (
circle(coordinates,0.2) WITH &&,
(city->>'en') WITH !=
);
ALTER TABLE
```
Ограничение создано. Добавить аэропорт Жуковский в городе с тем же названием теперь не получится из-за близости московских аэропортов:
```text {label="psql"}
=> INSERT INTO airports_data(
airport_code, airport_name, city, coordinates, timezone
) VALUES (
'ZIA', '{}', '{"en": "Zhukovsky"}', point(38.1517, 55.5533),
'Europe/Moscow'
);
ERROR: conflicting key value violates exclusion constraint
"airports_data_circle_expr_excl"
DETAIL: Key (circle(coordinates, 0.2::double precision), (city ->>
'en'::text))=(<(38.1517,55.5533),0.2>, Zhukovsky) conflicts with
existing key (circle(coordinates, 0.2::double precision), (city ->>
'en'::text))=(<(37.90629959106445,55.40879821777344),0.2>, Moscow).
```
Но это можно сделать, указав городом аэропорта Москву:
```text {label="psql"}
=> INSERT INTO airports_data(
airport_code, airport_name, city, coordinates, timezone
) VALUES (
'ZIA', '{}', '{"en": "Moscow"}', point(38.1517, 55.5533),
'Europe/Moscow'
);
INSERT 0 1
```
Важно помнить, что хотя GiST и может работать с операциями «больше», «меньше» или «равно», B-дерево справляется с ними гораздо эффективнее, особенно при доступе к диапазону значений. Так что показанный в примере прием с расширением `btree_gist` стоит использовать, только если индекс GiST необходим по существу.
### Свойства {#internal-ru-subsection-star-401}
**Свойства уровня метода доступа**
```text {label="psql"}
=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
'can_order', 'can_unique', 'can_multi_col',
'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'gist';
amname | name | pg_indexam_has_property
--------+---------------+-------------------------
gist | can_order | f
gist | can_unique | f
gist | can_multi_col | t
gist | can_exclude | t
gist | can_include | t
(5 rows)
```
Поддержка сортировки значений и уникальности отсутствует.
GiST-индекс можно создавать с дополнительными include-столбцами. (v. 12)
Индекс, как мы видели, можно строить по нескольким столбцам и использовать в ограничениях исключения.
**Свойства уровня индекса**
```text {label="psql"}
=> SELECT p.name, pg_index_has_property('airports_gist_idx', p.name)
FROM unnest(array[
'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
name | pg_index_has_property
---------------+-----------------------
clusterable | t
index_scan | t
bitmap_scan | t
backward_scan | f
(4 rows)
```
GiST-индекс можно использовать для кластеризации таблицы.
Поддерживаются оба способа получения данных: и строка за строкой, и по битовой карте. Но обратный порядок сканирования для GiST не определен.
**Свойства уровня столбца**
Основная часть свойств столбцов определена на уровне метода доступа и не меняется:
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('airports_gist_idx', 1, p.name)
FROM unnest(array[
'orderable', 'search_array', 'search_nulls'
]) p(name);
name | pg_index_column_has_property
--------------+------------------------------
orderable | f
search_array | f
search_nulls | t
(3 rows)
```
Все свойства, связанные с сортировкой, отключены.
Неопределенные значения допускаются GiST-индексом, но обрабатываются не слишком эффективно. Считается, что неопределенное значение не расширяет ограничивающий прямоугольник; поэтому при вставке такие значения попадают в разные поддеревья индекса случайным образом, и их приходится искать во всем дереве.
Однако пара свойств уровня столбца может меняться в зависимости от класса операторов.
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('airports_gist_idx', 1, p.name)
FROM unnest(array[
'returnable', 'distance_orderable'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
returnable | t
distance_orderable | t
(2 rows)
```
Индекс может использоваться в сканировании только индекса, поскольку ключи индексирования полностью хранятся в листовых узлах.
В данном случае, как мы видели, класс операторов содержит оператор расстояния для поиска ближайших соседей. Расстояние до неопределенного значения считается неопределенным; такие значения выдаются последними (аналогично указанию `NULLS LAST` в B-деревьях).
Но для диапазонных типов (которые представляют отрезки, то есть те же геометрические фигуры, только на прямой, а не на плоскости) оператор расстояния не реализован, поэтому для индекса по такому типу данных свойство будет отличаться:
```text {label="psql"}
=> CREATE TABLE reservations(during tsrange);
```
```text {label="psql"}
=> CREATE INDEX ON reservations USING gist(during);
```
```text {label="psql" hl_lines="9"}
=> SELECT p.name,
pg_index_column_has_property('reservations_during_idx', 1, p.name)
FROM unnest(array[
'returnable', 'distance_orderable'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
returnable | t
distance_orderable | f
(2 rows)
```
## 26.3. RD-дерево для полнотекстового поиска {#internal-ru-section-26-3}
### Про полнотекстовый поиск {#internal-ru-subsection-star-409}
Задача полнотекстового поиска [^internal-ru-578-1] — выбрать из набора *документов* те, которые соответствуют *поисковому запросу*.
Для целей поиска документ приводится к специальному типу `tsvector`, который содержит *лексемы* и их позиции в документе. Лексемы — это слова, преобразованные к виду, удобному для поиска. Например, по умолчанию слова приводятся к нижнему регистру и лишаются изменяемых окончаний:
```text {label="psql"}
=> SET default_text_search_config = russian;
=> SELECT to_tsvector(
'И встал Айболит, побежал Айболит. ' ||
'По полям, по лесам, по лугам он бежит.'
);
to_tsvector
--------------------------------------------------------------------
'айбол':3,5 'беж':13 'встал':2 'лес':9 'луг':11 'побежа':4 'пол':7
(1 row)
```
Так называемые стоп-слова («и», «по») удаляются, так как они предположительно встречаются слишком часто, чтобы поиск по ним был осмысленным. Разумеется, все эти преобразования настраиваются.
Поисковый запрос представляется другим типом — `tsquery`. Запрос состоит из одной или нескольких лексем, соединенных логическими связками: «и» `&`, «или» `|`, «не» `!`. Также можно использовать скобки для уточнения приоритета операций.
```text {label="psql"}
=> SELECT to_tsquery('Айболит & (побежал | пошел)');
to_tsquery
----------------------------------
'айбол' & ( 'побежа' | 'пошел' )
(1 row)
```
Для полнотекстового поиска используется единственный *оператор соответствия* `@@`:
```text {label="psql"}
=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
JOIN pg_opclass opc ON opcmethod = am.oid
JOIN pg_amop amop ON amopfamily = opcfamily
JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gist'
AND opcname = 'tsvector_ops'
ORDER BY amopstrategy;
amopopr | oprcode | amopstrategy
----------------------+-------------+--------------
@@(tsvector,tsquery) | ts_match_vq | 1
(1 row)
```
Этот оператор определяет, соответствует ли документ поисковому запросу. Вот простой пример:
```text {label="psql"}
=> SELECT to_tsvector('И встал Айболит, побежал Айболит.') @@
to_tsquery('Айболит & побежать');
?column?
----------
t
(1 row)
```
Это ни в коей мере не исчерпывающее описание полнотекстового поиска, но этих сведений будет достаточно для понимания индексирования. (*с.* [613](/ru/28-gin/#internal-ru-page-614))
### Индексация tsvector {#internal-ru-subsection-star-411}
Чтобы полнотекстовый поиск работал быстро, его нужно поддержать индексом [^internal-ru-579-1]. Поскольку индексируются не сами документы, а значения типа `tsvector`, есть два варианта: построить индекс по выражению, с приведением типа, или создать отдельный столбец типа `tsvector` и индексировать его. Плюс первого варианта в том, что он не расходует место для хранения значений `tsvector`, которые сами по себе никому не нужны. Однако он проигрывает варианту со столбцом по скорости, когда механизм индексирования перепроверяет по таблице идентификаторы версий, возвращенные индексным методом. Для этого приходится повторно вычислять значение `tsvector` для каждой проверяемой строки, а индекс GiST, как мы увидим, перепроверяет все строки. (*с.* [613](/ru/28-gin/#internal-ru-page-614))
Построим небольшой пример. Создадим таблицу с двумя столбцами: в первом будет храниться документ, во втором — значение `tsvector`. Второй столбец можно обновлять триггером[^internal-ru-580-1], но удобнее просто объявить его как генерируемый [^internal-ru-580-2]: (v. 12)
```text {label="psql"}
=> CREATE TABLE ts(
doc text,
doc_tsv tsvector GENERATED ALWAYS AS (
to_tsvector('pg_catalog.russian', doc)
) STORED
);
=> CREATE INDEX ts_gist_idx ON ts USING gist(doc_tsv);
```
> [!NOTE]
> В примерах выше я приводил функцию `to_tsvector` с одним параметром, предварительно устанавливая *конфигурацию* полнотекстового поиска в параметре *default\_text\_search\_config*. Такой вариант функции имеет категорию изменчивости `STABLE`, поскольку неявно зависит от значения параметра. Здесь же используется вариант функции с явным указанием конфигурации, который имеет категорию `IMMUTABLE`, подходящую для использования в генерирующем выражении.
Вставим в таблицу несколько строк: (*по умолчанию:* `english`)
```text {label="psql"}
=> INSERT INTO ts(doc) VALUES
('Во поле береза стояла'), ('Во поле кудрявая стояла'),
('Люли, люли, стояла'), ('Люли, люли, стояла'),
('Некому березу заломати'), ('Некому кудряву заломати'),
('Люли, люли, заломати'), ('Люли, люли, заломати'),
('Я пойду погуляю'), ('Белую березу заломаю'),
('Люли, люли, заломаю'), ('Люли, люли, заломаю')
RETURNING doc_tsv;
doc_tsv
--------------------------------
'берез':3 'пол':2 'стоя':4
'кудряв':3 'пол':2 'стоя':4
'люл':1,2 'стоя':3
'люл':1,2 'стоя':3
'берез':2 'заломат':3 'нек':1
'заломат':3 'кудряв':2 'нек':1
'заломат':3 'люл':1,2
'заломат':3 'люл':1,2
'погуля':3 'пойд':2
'бел':1 'берез':2 'залома':3
'залома':3 'люл':1,2
'залома':3 'люл':1,2
(12 rows)
INSERT 0 12
```
R-дерево как таковое не годится для индексации документов, поскольку к ним неприменимо понятие ограничивающего прямоугольника. Используется модификация этого подхода — RD-дерево (Russian Doll, матрешка). Вместо ограничивающего прямоугольника это дерево использует *ограничивающее множество*, то есть множество, содержащее все элементы дочерних множеств. Для полнотекстового поиска множество состоит из лексем документа, но в общем случае множество может быть произвольным.
Есть несколько способов представления множеств в индексных записях. Самый простой — непосредственно перечислить все элементы множества. Вот как это могло бы выглядеть:
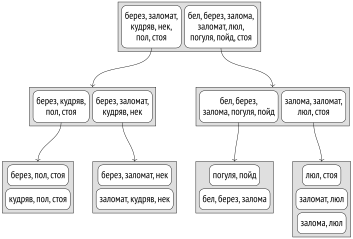
{#internal-ru-fig-26-13 num="26.13" caption="Индексация tsvector" .book-original-figure width=706 height=479}
Тогда, например, для поиска документов, удовлетворяющих условию `doc_tsv @@ to_tsquery('стояла')`, нужно спускаться в узлы, для которых известно, что дочерние записи содержат лексему «стоя»:
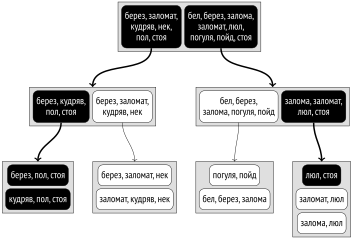
{#internal-ru-fig-26-14 num="26.14" caption="Индексация tsvector" .book-original-figure width=706 height=479}
Проблемы такого представления очевидны. Количество лексем в документе может быть огромным, а место в странице ограничено. Даже если в каждом документе не так много уникальных лексем, объединение множеств на верхних уровнях дерева все равно может получиться очень большим.
Для полнотекстового поиска применяется другое, более компактное решение — *сигнатурное дерево*. Идея его хорошо знакома всем, кто имел дело с фильтром Блума. (*с.* [665](/ru/29-brin/#internal-ru-page-666))
Каждую лексему можно представить своей *сигнатурой*: битовой строкой определенной длины, в которой все биты равны нулю (сброшены), кроме одного, который равен единице (установлен). Номер установленного бита определяется значением хеш-функции от лексемы.
Сигнатурой документа называется побитовое «или» сигнатур всех лексем документа.
Допустим, мы присвоили нашим лексемам такие сигнатуры:
| Лексема | Сигнатура |
| --- | --- |
| бел | `1000000` |
| берез | `0001000` |
| залома | `0000010` |
| заломат | `0010000` |
| кудряв | `0000100` |
| люл | `0100000` |
| нек | `0000100` |
| погуля | `0000001` |
| пойд | `0000010` |
| пол | `0000010` |
| стоя | `0010000` |
{#internal-ru-table-26-1 num="26.1" caption="Сигнатуры лексем" class="wide"}
Тогда сигнатуры документов будут следующими:
| Документ | Сигнатура |
| --- | --- |
| Во поле береза стояла | `0011010` |
| Во поле кудрявая стояла | `0010110` |
| Люли, люли, стояла | `0110000` |
| Некому березу заломати | `0011100` |
| Некому кудряву заломати | `0010100` |
| Люли, люли, заломати | `0110000` |
| Я пойду погуляю | `0000011` |
| Белую березу заломаю | `1001010` |
| Люли, люли, заломаю | `0100010` |
{#internal-ru-table-26-2 num="26.2" caption="Сигнатуры документов" class="wide"}
Дерево индекса в этом случае можно представить так:
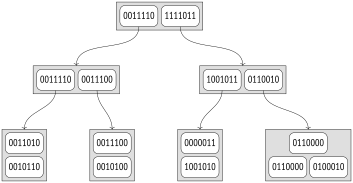
{#internal-ru-fig-26-15 num="26.15" caption="Индексация tsvector" .book-original-figure width=706 height=366}
Преимущества такого подхода налицо: индексные записи имеют одинаковый и небольшой размер, индекс получается компактным. Но есть и существенные недостатки. Во-первых, сканирование только индекса оказывается невозможным, поскольку индекс больше не хранит значения ключей индексирования и каждый возвращаемый идентификатор должен перепроверяться по таблице. Во-вторых, теряется точность: индекс может возвращать много ложных результатов, которые затем отсеиваются при перепроверке.
Рассмотрим все то же условие `doc_tsv @@ to_tsquery('стояла')`. Сигнатура поискового запроса вычисляется так же, как и для документа, и в нашем случае равна `0010000`. Функция согласованности [^internal-ru-584-1] должна определить все дочерние узлы, сигнатура которых содержит установленные биты сигнатуры запроса:
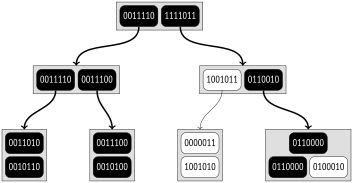
{#internal-ru-fig-26-16 num="26.16" caption="Индексация tsvector" .book-original-figure width=706 height=366}
По сравнению с предыдущим примером здесь перебирается больше узлов из-за ложноположительных срабатываний. Причина в том, что при большом количестве лексем некоторые из них неизбежно будут получать совпадающие сигнатуры из-за их ограниченной разрядности. В этом примере такими лексемами являются «стоя» и «заломат». Это приводит к тому, что одна и та же сигнатура соответствует разным документам; в данном случае «люли, люли, стояла» и «люли, люли, заломати» имеют сигнатуру `0110000`.
Ложноположительные срабатывания снижают эффективность индекса, но не ставят под угрозу корректность, поскольку ложноотрицательных срабатываний в такой схеме быть не может и нужное значение гарантированно не будет пропущено.
Конечно, в реальности размер сигнатуры выбирается больше. По умолчанию используется 124 байта (992 бита), так что вероятность коллизий существенно ниже, чем в примере. При необходимости можно установить другой размер сигнатуры вплоть до примерно 2000 байт, используя *параметр класса* *операторов*: (v. 13)
```sql
CREATE INDEX ... USING gist(столбец tsvector_ops(siglen = размер));
```
Кроме того, если значения достаточно малы [^internal-ru-585-1] (чуть меньше \(\frac{1}{16}\) страницы, что составляет около 500 байт для стандартной страницы), класс операторов `tsvector_ops` хранит в листовых страницах индекса не сигнатуры, а сами значения `tsvector`.
Чтобы посмотреть, как индексирование работает на реальных данных, возьмем архив рассылки pgsql-hackers [^internal-ru-585-2]. В нем содержится 356 125 писем с датой отправления, темой, именем автора и текстом.
Добавим столбец типа `tsvector` и построим индекс. Здесь я объединяю в один вектор три значения (тему, автора и текст письма), чтобы показать, что документ может формироваться динамически и не обязан храниться в каком-то одном столбце.
```text {label="psql"}
=> ALTER TABLE mail_messages ADD COLUMN tsv tsvector
GENERATED ALWAYS AS ( to_tsvector(
'pg_catalog.english', subject||' '||author||' '||body_plain
) ) STORED;
NOTICE: word is too long to be indexed
DETAIL: Words longer than 2047 characters are ignored.
...
NOTICE: word is too long to be indexed
DETAIL: Words longer than 2047 characters are ignored.
ALTER TABLE
=> CREATE INDEX mail_gist_idx ON mail_messages USING gist(tsv);
=> SELECT pg_size_pretty(pg_relation_size('mail_gist_idx'));
pg_size_pretty
----------------
127 MB
(1 row)
```
При заполнении столбца некоторое количество слов было отброшено из-за слишком большого размера, но в итоге индекс построен и готов поддерживать поисковые запросы:
```text {label="psql" hl_lines="8 10"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM mail_messages
WHERE tsv @@ to_tsquery('magic & value');
QUERY PLAN
----------------------------------------------------------
Index Scan using mail_gist_idx on mail_messages
(actual rows=898.00 loops=1)
Index Cond: (tsv @@ to_tsquery('magic & value'::text))
Rows Removed by Index Recheck: 7852
Index Searches: 1
(5 rows)
```
Вместе с 898 строками, подходящими под условие, метод доступа вернул еще 7852 строки, которые были отсеяны перепроверкой по таблице. Увеличив размер сигнатуры, можно повысить точность (и, следовательно, эффективность), жертвуя компактностью индекса:
```text {label="psql" hl_lines="16 18"}
=> DROP INDEX mail_messages_tsv_idx;
=> CREATE INDEX ON mail_messages
USING gist(tsv tsvector_ops(siglen=248));
=> SELECT pg_size_pretty(pg_relation_size('mail_messages_tsv_idx'));
pg_size_pretty
----------------
139 MB
(1 row)
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM mail_messages
WHERE tsv @@ to_tsquery('magic & value');
QUERY PLAN
----------------------------------------------------------
Index Scan using mail_messages_tsv_idx on mail_messages
(actual rows=898.00 loops=1)
Index Cond: (tsv @@ to_tsquery('magic & value'::text))
Rows Removed by Index Recheck: 2057
Index Searches: 1
(5 rows)
```
### Свойства {#internal-ru-subsection-star-413}
Свойства метода доступа я уже показывал, и по большей части они совпадают для всех классов операторов. Внимания заслуживают два свойства уровня столбца: (*с.* [574](/ru/26-gist/#internal-ru-page-575))
```text {label="psql"}
=> SELECT p.name,
pg_index_column_has_property('mail_messages_tsv_idx', 1, p.name)
FROM unnest(array[
'returnable', 'distance_orderable'
]) p(name);
name | pg_index_column_has_property
--------------------+------------------------------
returnable | f
distance_orderable | f
(2 rows)
```
Индекс потерял возможность участвовать в сканировании только индекса, поскольку по сигнатуре невозможно восстановить исходное значение. В данном случае в этом нет ничего страшного: значение `tsvector` используется только для поиска, а интересует нас сам документ.
Упорядочивающий оператор для класса `tsvector_ops` тоже не определен.
## 26.4. Другие типы данных {#internal-ru-section-26-4}
Я рассмотрел только два наиболее показательных примера. Они демонстрируют, что метод GiST, имея в основе сбалансированное дерево, может по-разному применяться для разных типов данных за счет разной реализации опорных функций класса операторов. Говоря о GiST-индексе, всегда необходимо уточнять класс операторов, поскольку он существенно влияет на свойства и характеристики индекса.
Вот еще несколько типов данных, которые в настоящее время поддерживает метод доступа GiST.
**Геометрические типы.** Кроме точек, GiST-индекс может использоваться и для других геометрических типов: прямоугольников, окружностей, полигонов. Любой из этих типов представляется для целей индексирования своим ограничивающим прямоугольником.
Расширение `cube` добавляет одноименный тип данных для представления многомерных кубов, которые индексируются с помощью R-дерева. Вместо ограничивающих прямоугольников в индексе используются ограничивающие параллелепипеды соответствующей размерности.
**Диапазонные типы.** К стандартным типам PostgreSQL относятся числовые и временны́е диапазоны, такие как `int4range` или `tstzrange`[^internal-ru-588-1]. Можно определять и собственные диапазонные типы командой `CREATE TYPE AS RANGE`.
Любые диапазонные типы, как стандартные, так и пользовательские, поддерживаются GiST-индексом с помощью одного и того же класса операторов `range_ops`[^internal-ru-588-2]. Для индексирования применяется одномерное R-дерево: в данном случае ограничивающие прямоугольники превращаются в ограничивающие отрезки.
Мультидиапазонные типы также поддерживаются; для них используется класс операторов `multirange_ops`. Ограничивающий диапазон в этом случае охватывает все диапазоны, входящие в мультидиапазонное значение. (v. 14)
Расширение `seg` предоставляет одноименный тип данных для интервалов с границами, заданными с определенной точностью. Такой тип не относится к диапазонным, но по сути является им и индексируется точно так же.
**Порядковые типы.** Напомню еще раз про расширение `btree_gist`, предоставляющее классы операторов метода GiST для большого количества порядковых типов данных, которые обычно индексируются с помощью B-дерева. Такие классы операторов можно использовать для создания составного индекса, когда тип одного из столбцов не поддерживается B-деревом.
**Сетевые адреса.** Тип данных `inet` имеет встроенную GiST-поддержку, реализованную классом операторов `inet_ops`[^internal-ru-589-1].
**Целочисленные массивы.** Расширение `intarray` делает целочисленные массивы более функциональными и добавляет для них GiST-поддержку. Имеются два класса операторов. Для небольших массивов можно использовать `gist__int_ops`, реализующий RD-дерево с полным представлением ключей в индексных записях. Для больших массивов подойдет более компактное, но менее точное сигнатурное RD-дерево, реализуемое `gist__bigint_ops`.
> [!NOTE]
> «Лишнее» подчеркивание в именах классов операторов появляется, потому что с подчеркивания начинаются названия массивов базовых типов. Например, для целочисленного массива наряду с более привычным обозначением `int4[]` можно использовать тип `_int4`. Правда, типов `_int` и `_bigint` не существует.
**Дерево меток.** Расширение `ltree` добавляет одноименный тип данных для древовидных структур с метками. GiST-поддержка реализована с помощью сигнатурных RD-деревьев и представлена классами операторов `gist_ltree_ops` для значений типа `ltree` и `gist__ltree_ops` для массивов значений такого типа.
**Хранилище «ключ–значение».** Расширение `hstore` предоставляет тип данных `hstore` для хранения пар «ключ–значение». Класс операторов `gist_hstore_ops` реализует индексную поддержку на основе сигнатурного RD-дерева.
**Триграммы.** Расширение `pg_trgm` добавляет класс `gist_trgm_ops`, реализующий индексную поддержку сравнения схожести текстовых строк и поиска по шаблону. (*с.* [630](/ru/28-gin/#internal-ru-page-631))
[^internal-ru-556-1]: [postgrespro.ru/docs/postgresql/18/gist](); [backend/access/gist/README]().
[^internal-ru-557-1]: [backend/access/gist/gistget.c](), функция gistgettuple.
[^internal-ru-557-2]: [backend/access/gist/gistutil.c](), функция gistchoose.
[^internal-ru-558-1]: [backend/access/gist/gistsplit.c](), функция gistSplitByKey.
[^internal-ru-559-1]: Файл доступен по адресу [edu.postgrespro.ru/internals-18/extra\_airports.copy]() (использовались данные с сайта [openflights.org]()).
[^internal-ru-560-1]: [commitfest.postgresql.org/29/2276]().
[^internal-ru-560-2]: [commitfest.postgresql.org/37/3488]().
[^internal-ru-562-1]: [postgrespro.ru/docs/postgresql/18/gist-extensibility]().
[^internal-ru-563-1]: [include/access/stratnum.h]().
[^internal-ru-564-1]: [backend/access/gist/gistproc.c](), функция gist\_point\_consistent.
[^internal-ru-568-1]: [backend/utils/adt/geo\_ops.c](), функция point\_distance.
[^internal-ru-568-2]: [backend/utils/adt/geo\_ops.c](), функция box\_closest\_point.
[^internal-ru-571-1]: [backend/access/gist/gistproc.c](), функция gist\_box\_penalty.
[^internal-ru-572-1]: [backend/access/gist/gistproc.c](), функция gist\_box\_picksplit.
[^internal-ru-578-1]: [postgrespro.ru/docs/postgresql/18/textsearch]().
[^internal-ru-579-1]: [postgrespro.ru/docs/postgresql/18/textsearch-indexes]().
[^internal-ru-580-1]: [postgrespro.ru/docs/postgresql/18/textsearch-features#TEXTSEARCH-UPDATE-TRIGGERS]().
[^internal-ru-580-2]: [postgrespro.ru/docs/postgresql/18/ddl-generated-columns]().
[^internal-ru-584-1]: [backend/utils/adt/tsgistidx.c](), функция gtsvector\_consistent.
[^internal-ru-585-1]: [backend/utils/adt/tsgistidx.c](), функция gtsvector\_compress.
[^internal-ru-585-2]: [edu.postgrespro.ru/mail\_messages.sql.gz]().
[^internal-ru-588-1]: [postgrespro.ru/docs/postgresql/18/rangetypes]().
[^internal-ru-588-2]: [backend/utils/adt/rangetypes\_gist.c]().
[^internal-ru-589-1]: [backend/utils/adt/network\_gist.c]().