25 B-дерево
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
25.1. Общий принцип
B-дерево (метод доступа btree) — структура данных, которая позволяет быстро найти нужный элемент в листьях дерева, спускаясь к нему от корня 1. Чтобы путь поиска был однозначно определен, элементы в дереве должны быть упорядочены. B-дерево предназначено для порядковых типов данных, значения которых можно сравнивать и сортировать.
На схематично показанном индексе, построенном по кодам аэропортов, внутренние узлы изображены горизонтально, а листовые — вертикально:
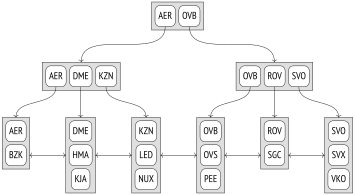
Каждый узел дерева содержит несколько элементов, состоящих из ключа индексирования и ссылки. Элементы внутренних узлов дерева ссылаются на узлы следующего уровня, а элементы листовых узлов — на версии строк таблицы (на рисунке эти ссылки не показаны).
B-деревья обладают несколькими важными свойствами:
Они сбалансированы, то есть все листья находятся на одной глубине. Поэтому поиск любого значения занимает одинаковое время.
Они сильно ветвисты, то есть каждый узел содержит много элементов, часто сотни (на рисунке узлы состоят всего из трех элементов исключительно для наглядности). За счет этого глубина B-деревьев получается небольшой даже для очень больших таблиц.
Доподлинно неизвестно, что означает буква «B» в названии дерева. Одинаково хорошо подходит и balanced (сбалансированное), и bushy (ветвистое). Но на удивление часто встречается расшифровка binary (двоичное), которая, конечно, неверна.
- Данные в индексе упорядочены по возрастанию (или по убыванию) как между узлами, так и внутри каждого узла. Узлы одного уровня связаны между собой двунаправленным списком, поэтому можно получить упорядоченный набор данных, просто пройдя по списку в одну или в другую сторону, не повторяя каждый раз путь от корня.
25.2. Поиск и вставка
Поиск по равенству
Рассмотрим поиск 2 значения в дереве по условию «индексированный-столбец = выражение». Допустим, нас интересует аэропорт KJA (Красноярск).
Поиск начинается с корневого узла, и метод доступа должен определить, в какой из дочерних узлов спускаться. Выбирается ключ Ki, для которого верно Ki ⩽ выражение < Ki+1.
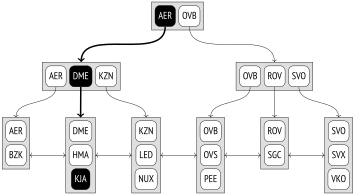
В корневом узле находятся ключи AER и OVB. Выполняется условие AER ⩽ ⩽ KJA < OVB, поэтому спускаться надо в дочерний узел, на который ссылается элемент с ключом AER.
Эта процедура повторяется рекурсивно до тех пор, пока мы не дойдем до листового узла, из которого уже можно получить идентификатор версии строки. В данном случае в дочернем узле выполняется условие DME ⩽ KJA < < KZN, поэтому надо спуститься в листовой узел, на который ссылается элемент с ключом DME.
Можно заметить, что во внутренних узлах дерева крайний левый ключ избыточен: чтобы выбрать дочерний узел корня, достаточно выполнения условия KJA < OVB. Такие ключи не хранятся в B-дереве, и на следующих рисунках я буду оставлять соответствующие элементы пустыми.
В листовом узле нужный элемент быстро находится простым двоичным поиском.
В реальности процедура поиска вовсе не так проста, как кажется на первый взгляд. Нужно учитывать, что значения в индексе могут быть упорядочены не только по возрастанию, как на рисунке, но и по убыванию. Даже в уникальном индексе может оказаться несколько подходящих значений, и поиск должен вернуть их все. Причем одинаковых значений может оказаться так много, что они не поместятся в один узел, и тогда поиск придется продолжить в соседней листовой странице. (с. 533)
Из-за того, что в индексе могут находиться неуникальные значения, правильнее было бы говорить не «по возрастанию», а «по неубыванию» (и не «по убыванию», а «по невозрастанию»). Я все-таки буду придерживаться более простого варианта. К тому же идентификатор версии строки является частью индексного ключа, что позволяет считать элементы индекса уникальными, даже когда значения совпадают.
Кроме всего прочего, во время поиска другие процессы могут изменять данные, страницы могут расщепляться на две, и дерево может перестраиваться. Все алгоритмы построены таким образом, чтобы эти одновременные действия по возможности не мешали друг другу и не требовали лишних блокировок. Но в эти детали я вдаваться не буду. (v. 12)
Поиск по неравенству
При поиске по условию «индексированный-столбец ⩽ выражение» (или «индексированный-столбец ⩾ выражение») сначала надо найти в индексе значение по условию равенства, а затем двигаться по листовым узлам в нужную сторону до самого конца.
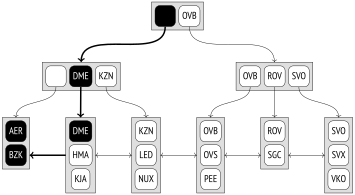
Рисунок показывает процесс поиска аэропортов с кодами, меньшими или равными DME (Домодедово).
Для операторов «больше» и «меньше» поиск выполняется так же, надо только исключить исходно найденное значение.
Поиск по диапазону
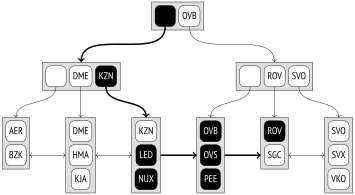
При поиске по диапазону «выражение1 ⩽ индексированный-столбец ⩽ выражение2» сначала надо найти выражение1, а затем двигаться вправо по листовым узлам до выражения2.
На рисунке показан процесс поиска аэропортов с кодами от LED (Санкт-Петербург) до ROV (Ростов-на-Дону) включительно.
Вставка
Место нового элемента в листовых узлах однозначно определяется порядком расположения ключей. Например, при вставке в таблицу аэропорта с кодом RTW (Саратов) элемент будет добавлен в предпоследний листовой узел между имеющимися ROV и SGC.
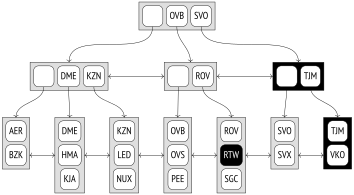
Но может получиться так, что в листовом узле не хватит места для нового элемента. Например (если считать, что узел вмещает максимум три элемента), при вставке аэропорта с кодом TJM (Тюмень) последний листовой узел переполнится. В этом случае узел расщепляется на два, часть элементов старого узла переносится в новый, а в родительский узел добавляется ссылка на нового потомка. Конечно, родительский узел тоже может переполниться. В таком случае и он расщепляется на два узла, и так далее. Если дело доходит до расщепления корня, над образовавшимися узлами создается еще один узел, который становится новым корнем дерева. В этом случае глубина дерева увеличивается на единицу.
В данном примере добавление аэропорта TJM привело к расщеплению двух узлов; новые узлы выделены на рисунке. Чтобы можно было расщеплять любые узлы дерева, двунаправленным списком связаны не только узлы нижнего уровня, но и узлы остальных уровней тоже.
Описанная процедура вставок и расщеплений гарантирует сбалансированность дерева, а поскольку в реальности количество элементов в узле обычно велико, наращивание дополнительного уровня происходит редко.
Проблема в том, что расщепленные узлы никогда не объединяются, даже если после очистки в них остается мало элементов. Это ограничение не B-дерева как структуры данных, а реализации PostgreSQL. Поэтому если при вставке узел оказывается заполнен, метод доступа старается в первую очередь очистить узел от лишней информации, чтобы освободить место и не допустить лишнее расщепление. (с. 123)
25.3. Страничная организация
Каждый узел B-дерева занимает одну страницу. Размер страницы и определяет вместимость узла.
Расщепления приводят к тому, что в разные моменты времени корнем дерева могут выступать разные страницы. Но алгоритм поиска должен начинать работу именно с корня. Он находит номер текущей корневой страницы в нулевой странице индекса (называемой метастраницей). Метастраница содержит и некоторую другую служебную информацию.
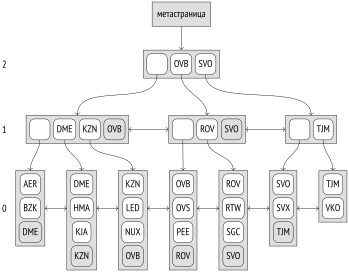
Представление информации на индексных страницах немного отличается от того, что было изображено ранее. Все страницы, кроме самых правых на своем уровне, содержат дополнительный «верхний ключ», гарантированно не меньший любого значения на данной странице. На предыдущем рисунке верхние ключи выделены серым.
Заглянем в страницы настоящего индекса по шестизначным номерам бронирований с помощью расширения pageinspect. В метастранице нас интересует номер корневой страницы и максимальный уровень дерева (уровни нумеруются с нуля, начиная с листьев):
Ключи в индексных записях выводятся как последовательность байтов, что не очень-то удобно. Вот пример:
Для расшифровки значений придется написать adhoc-функцию. Она будет работать не во всех случаях и не на всех платформах, но годится для примеров в этой главе:
Теперь мы можем посмотреть на содержимое корневой страницы:
Первая запись, как я и говорил, не хранит ключ. Столбец ctid содержит ссылки на дочерние страницы.
Допустим, мы ищем бронирование с номером E2D725. В этом случае мы выбираем запись 19, поскольку E2CB14 ⩽ E2D725 < EF6FEA, и спускаемся на страницу 5135.
Первая запись этой страницы — несколько неожиданно — содержит верхний ключ. Логически он должен был бы располагаться в конце страницы, но с точки зрения реализации удобнее держать его в начале, чтобы не переносить каждый раз, когда содержимое страницы меняется.
На этой странице мы выбираем запись 3, поскольку E2D71D ⩽ E2D725 < < E2E2F4, и спускаемся на страницу 5133.
Это листовая страница индекса. Первая запись — верхний ключ, а все остальные записи ссылаются на табличные версии строк.
Вот и наше бронирование:
Примерно такая работа и выполняется на низком уровне, когда мы запрашиваем бронирование по коду:
Компактное хранение дубликатов
Неуникальные индексы могут содержать множество одинаковых ключей со ссылками на разные табличные строки. Поскольку повторяющиеся ключи занимают много места, дубликаты «схлопываются» в одну индексную запись, содержащую ключ и список табличных идентификаторов3. В ряде случаев эта процедура, называемая исключением дубликатов (deduplication), позволяет существенно сократить размер индекса. (v. 13)
Но и уникальные индексы могут содержать дубликаты ключей из-за многоверсионности, поскольку индекс хранит ссылки на все версии табличных строк. С раздуванием индекса из-за ссылок на неактуальные и обычно короткоживущие версии помогает справиться механизм hot-обновлений, но он работает не всегда. В таком случае исключение дубликатов позволяет выиграть время, необходимое для очистки таблицы от неактуальных версий, и сократить количество вынужденных расщеплений страниц. (с. 111)
Чтобы не тратить ресурсы на исключение дубликатов, когда в этом нет необходимости, «схлопывание» выполняется, только когда на листовой странице не хватает места для вставки новой строки. В этом случае 4 самоочистка и исключение дубликатов 5 могут освободить место и предотвратить ненужное расщепление. Впрочем, если дубликаты возникают редко, механизм исключения можно отключить с помощью параметра хранения deduplicate_items.
Исключение дубликатов может применяться не для всех индексов. Основное ограничение состоит в том, что равенство ключей должно проверяться простым двоичным сравнением внутреннего представления. Далеко не все типы данных можно сравнивать таким образом. Числа с плавающей точкой (float и double precision) имеют два разных представления нуля. Числа с произвольной точностью (numeric) допускают представление одного и того же числа в разных масштабах, а тип jsonb использует такие числа. Не годятся также текстовые типы при использовании недетерминированных правил сортировки6, позволяющих представлять одинаковые символы разными последовательностями байтов (стандартные правила сортировки детерминированы).
Кроме того, в настоящее время исключение дубликатов невозможно для составных типов, диапазонов и массивов, а также не работает с include-индексами.
Чтобы проверить, поддерживается ли исключение дубликатов для конкретного индекса, можно заглянуть в поле allequalimage метастраницы:
В данном случае исключение дубликатов поддерживается. И действительно, на одной из листовых страниц мы видим, что некоторые индексные записи содержат единственный табличный идентификатор (htid), а некоторые — список идентификаторов (tids):
Компактное хранение внутренних индексных записей
Исключение дубликатов позволяет разместить больше записей в листовых страницах индекса. Но для предотвращения лишних расщеплений уплотнение информации во внутренних страницах играет не меньшую роль. Основной объем индекса составляют листовые страницы, но эффективность поиска в индексе напрямую зависит от глубины дерева. (v. 12)
Индексные записи во внутренних страницах содержат ключи индексирования, но их значения используются только для определения поддерева, в которое надо спускаться при поиске. В составных индексах для этого часто достаточно только первого атрибута ключа или нескольких первых. Остальные атрибуты могут быть отброшены, чтобы не занимать место на странице.
Процедура исключения некоторых атрибутов (suffix truncation) выполняется, когда происходит расщепление листовой страницы и во внутренней странице необходимо разместить новую ссылку7.
В принципе, можно пойти еще дальше и оставлять только значимую часть атрибута, например несколько первых символов строки, достаточных для различения поддеревьев. Но это пока не реализовано: атрибут или целиком остается в индексной записи, или полностью исключается из нее.
Для примера — несколько записей корневой страницы индекса, построенного на таблице билетов по номеру бронирования и имени пассажира:
Видно, что в некоторых индексных записях второй атрибут исключен.
В листовых страницах, конечно, должны храниться все ключевые атрибуты, в том числе и значения дополнительных include-столбцов. В противном случае индекс не мог бы использоваться в сканировании только индекса. Исключение составляет «верхний ключ», который может храниться не полностью.
25.4. Сортировка и составные индексы
Порядок столбцов
Порядок, в котором столбцы перечисляются при создании индекса, крайне важен, поскольку данные внутри страниц будут отсортированы сначала по первому столбцу, затем по второму и так далее. Как правило, эффективный поиск в таком индексе возможен по условиям на непрерывную последовательность столбцов, начиная с самого первого: по одному первому, по первому и второму, с первого по третий и так далее. При этом все остальные условия используются только для фильтрации значений, найденных по основным критериям8.
Вот порядок индексных записей в первой листовой странице индекса, созданного ранее на таблице билетов по номеру бронирования и по имени пассажира:
В этом случае эффективный поиск билетов возможен либо по номеру бронирования и имени пассажира, либо только по номеру бронирования:
Но для поиска только по имени пассажира придется перебрать все строки:
И наоборот, если создать индекс по именам и по номерам бронирования, эффективно будут поддерживаться запросы по имени или одновременно по имени и по номеру бронирования:
Оптимизация пропуска
Важное исключение представляет собой случай, когда первый столбец содержит не слишком много уникальных значений. Если условие на такой столбец отсутствует, индекс все равно может значительно ускорить поиск. Для этого надо обратиться к индексу несколько раз, подставляя на место пропущенного условия проверку на равенство каждому из уникальных значений. (v. 18)
Представим себе таблицу, которая показывает, на каких авиалиниях эксплуатируются самолеты. Ее первый столбец route_type имеет всего два возможных значения: D (внутренние линии, domestic) и I (международные, international). Второй столбец aircraft_code хранит код модели. Некоторые самолеты летают только внутри страны, некоторые — только за рубеж, а часть используется на любых рейсах. На первом и втором столбцах построен индекс.
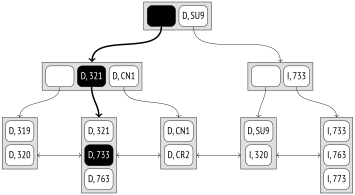
Чтобы разобраться с оптимизацией пропуска, предположим сначала, что мы сумели добавить к условию aircraft_code = '733' еще одно: route_type = ANY('{D,I}'). Индексное сканирование эффективно учтет такое условие благодаря тому, что B-дерево поддерживает свойство SEARCH ARRAY. Сначала поиск в индексе выполняется по условию route_type = 'D' AND aircraft_code = '733': (с. 411)
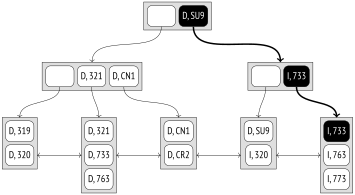
Затем выполняется еще один поиск, теперь по условию route_type = 'I' AND aircraft_code = '733':
С точки зрения планировщика оба поиска в индексе происходят в рамках одного индексного сканирования, поэтому в плане выполнения будет один узел Bitmap Index Scan. Посмотрим на реальном запросе:
Строка Index Searches показывает количество поисков в индексе. В данном случае сканирование потребовало всего три спуска от корня к листьям, а не шесть, поскольку строки с четырьмя статусами оказались удачно локализованы на одной странице данных:
Нерелевантные части индекса при таком сканировании пропускаются, поэтому операция и называется оптимизацией пропуска, или skip scan. Это не отдельный вид сканирования, а именно оптимизация, которая работает с любым индексным доступом (Index Scan, Index Only Scan, Bitmap Index Scan).
Что же происходит, когда условие на первый столбец не указано? Оценить количество уникальных значений можно по статистике, но полагаться на статистику для получения точного списка, конечно, нельзя. (с. 351)
Итак, мы хотим выполнить запрос к таблице по условию aircraft_code = '733'. Нам неизвестно наименьшее значение route_type, но его можно получить из самой первой записи самой первой листовой страницы индекса:
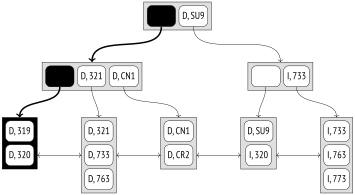
Теперь мы знаем, что первое значение столбца route_type равно D, и можем выполнить второй поиск по условию на оба столбца: route_type = 'D' AND aircraft_code = '733'.
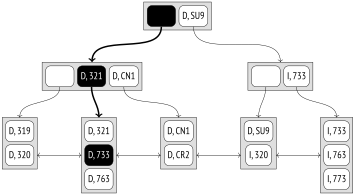
Мы нашли первое подходящее значение. Если бы на прочитанной листовой странице оказалась запись с другим значением первого столбца, мы бы знали следующее точное условие. В данном случае нам не повезло, поэтому приходится выполнить поиск по условию route_type > 'D':
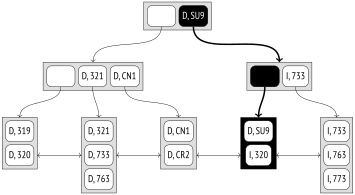
На найденной листовой странице не оказалось нужной записи, но мы узнали второе значение столбца route_type. Поэтому выполняем следующий поиск по условию route_type = 'I' AND aircraft_code = '733':
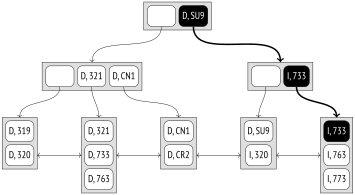
Сканирование можно завершать, поскольку мы добрались до последней листовой страницы индекса. В противном случае пришлось бы выполнить еще один поиск — по условию route_type > 'I', — чтобы убедиться, что других значений нет.
Запрос без условия на первый столбец потребовал немного больше поисков в индексе и прочитал немного больше страниц, чем предыдущий вариант, но все же выполнился весьма эффективно:
Оптимизация пропуска может применяться и в других ситуациях, когда условия на часть столбцов отсутствуют или не являются проверкой равенства. Значение Index Searches, большее единицы, говорит о том, что при сканировании индекса выполнялись пропуски.
Конечно, приведенный пример не претендует на полноту описания. В частности, в некоторых случаях начатый поиск может продолжаться на соседних листовых страницах в надежде на то, что в них обнаружится подходящая индексная запись. Это позволяет укрупнить отдельные обращения к индексу и уменьшить их количество, экономя на спуске от корня к листовым узлам9.
Другой пример: для дискретных типов данных в классе операторов B-дерева можно определить опорную функцию, которая сообщит минимальное и максимальное значения данного типа и функции для перехода к следующему и предыдущему значениям10. Благодаря этой информации отыскивать очередное значение в индексе не потребуется; сканирование сможет сразу перейти к его проверке.
Направление сортировки
При создании индекса нужно учитывать не только порядок столбцов, но и порядок сортировки. По умолчанию значения упорядочены по возрастанию (ASC), но можно указать и обратный порядок (DESC). В индексе по одному столбцу это не играет особой роли, поскольку индекс можно сканировать в любую сторону. Но в составном индексе порядок важен.
Только что созданный индекс можно использовать для получения данных, отсортированных по обоим столбцам по возрастанию или по обоим столбцам по убыванию:
Но из этого индекса невозможно сразу же получить данные, которые по одному столбцу будут отсортированы по возрастанию, а по другому — по убыванию. Индекс поставляет частично упорядоченные данные, которые затем сортируются по второму атрибуту (здесь и далее для простоты отключены параллельные планы): (с. 498)
На возможность использовать индекс для сортировки влияет и расположение неопределенных значений. По умолчанию для целей сортировки неопределенные значения считаются «больше» обычных значений, то есть располагаются с правого конца дерева при сортировке по возрастанию или с левого при сортировке по убыванию. Этот порядок можно менять с помощью предложений NULLS LAST и NULLS FIRST.
В следующем примере индекс не удовлетворяет предложению ORDER BY, и результат приходится сортировать:
Но если создать индекс, соответствующий желаемому порядку, он будет использоваться:
25.5. Класс операторов
Семантика сравнения
Системе необходимо уметь не только хешировать значения, но и упорядочивать значения разных типов, в том числе пользовательских. Это требуется для сортировок и группировок, соединения слиянием и некоторых других операций. И так же, как для хеширования, соответствие между типом данных и операторами сравнения задается классом операторов11.
Класс операторов позволяет не привязываться к именам (таким как >, <, =) и даже иметь несколько способов упорядочить значения одного и того же типа.
Вот какие операторы сравнения должны быть заданы в любом классе операторов метода btree (на примере семейства bool_ops): (psql: \dAo)
Здесь мы видим пять операторов сравнения. Каждый из них соответствует одной из стратегий12, которая определяет его семантику:
меньше;
меньше либо равно;
равно;
больше либо равно;
больше.
Класс операторов B-дерева включает также несколько опорных функций13. Первая из них должна возвращать единицу, если ее первый аргумент больше второго, минус единицу — если меньше, и ноль — если аргументы равны.
Остальные опорные функции необязательны, но позволяют методу доступа работать более производительно.
Чтобы лучше разобраться в этом механизме, полезно создать новый тип данных и установить для него порядок сортировки, отличный от порядка по умолчанию. Документация приводит такой пример для комплексных чисел14, но использует язык C. К счастью, класс операторов для B-дерева можно создать и с помощью интерпретируемых языков, чем я и воспользуюсь, чтобы сделать этот пример как можно более простым (хотя и заведомо неэффективным).
Создадим новый составной тип для единиц измерения информации:
Теперь создадим таблицу со столбцом нового типа и заполним ее случайными значениями:
По умолчанию значения составных типов сортируются в лексикографическом порядке, который в данном случае не совпадает с естественным порядком:
Создание класса операторов начнем с функции, которая пересчитывает объем в байты:
Затем создадим опорную функцию для будущего класса операторов:
Теперь с помощью опорной функции легко определить операторы сравнения. Я специально использую «странные» имена, чтобы показать, что они могут быть произвольными:
Остальные четыре оператора определяются по аналогии.
На этом этапе мы уже можем правильно сравнивать объемы:
А после создания класса операторов заработает как надо и сортировка:
Наш класс операторов используется по умолчанию при создании индексов, а созданный индекс возвращает значения в правильном порядке:
Предложение MERGES, указанное при создании оператора равенства, разрешает использовать соединение слиянием для значений нашего типа. (с. 483)
25.6. Свойства
Посмотрим интерфейсные свойства B-деревьев. (с. 404)
Свойства уровня метода доступа
B-дерево может упорядочивать данные и поддерживает уникальность. Это единственный метод доступа, который обеспечивает такие свойства.
Многие методы доступа позволяют создавать составные индексы, но в случае B-деревьев приходится тщательно следить за порядком столбцов в индексе, поскольку значения в нем упорядочены.
Поддержка ограничений исключения формально есть, но ограничивается оператором равенства, что соответствует требованию уникальности. Вместо такого ограничения гораздо лучше использовать настоящее полноценное ограничение уникальности.
B-дерево позволяет также добавлять в индекс дополнительные столбцы, не участвующие в поиске.
Индекс будет строиться в параллельном режиме, если таблица достаточно велика. Количество рабочих процессов определяется по той же формуле, что и для параллельного последовательного сканирования, но ограничено сверху значением параметра max_parallel_maintenance_workers. На все рабочие процессы выделяется объем памяти размером maintenance_work_mem. (с. 384) (по умолчанию: 2) (по умолчанию: 64MB)
Рабочие процессы параллельно сканируют таблицу и сортируют полученные данные 15; результат образует листовые страницы индекса, над которыми затем надстраиваются внутренние страницы вплоть до корня.
Свойства уровня индекса
Индекс на основе B-дерева можно использовать для кластеризации.
B-деревья поддерживают оба способа получения значений: и индексное сканирование, и сканирование по битовой карте. Благодаря тому что листовые страницы связаны двунаправленным списком, индекс можно обходить не только в прямом, но и в обратном направлении, получая противоположный порядок сортировки:
Свойства уровня столбца
Свойство ORDERABLE говорит о том, что B-дерево хранит данные упорядоченно, и первые четыре свойства (ASC и DESC, NULLS FIRST и NULLS LAST) определяют, как именно они упорядочены для данного столбца. В следующем примере значения столбца отсортированы по возрастанию, а неопределенные значения находятся в конце.
Свойство SEARCH NULLS показывает возможность поиска неопределенных значений.
Для B-деревьев не реализована поддержка операторов упорядочивания (DISTANCE ORDERABLE), хотя такие попытки предпринимались16.
B-деревья поддерживают поиск нескольких значений из массива (свойство SEARCH ARRAY) и позволяют получать данные без обращения к таблице (RETURNABLE).
postgrespro.ru/docs/postgresql/18/btree; backend/access/nbtree/README. ↩︎
backend/access/nbtree/nbtsearch.c, функция _bt_search. ↩︎
postgrespro.ru/docs/postgresql/18/btree#BTREE-DEDUPLICATION. ↩︎
backend/access/nbtree/nbtinsert.c, функция _bt_delete_or_dedup_one_page. ↩︎
backend/access/nbtree/nbtdedup.c, функция _bt_dedup_pass. ↩︎
backend/access/nbtree/nbtinsert.c, функция _bt_split. ↩︎
backend/access/nbtree/nbtutils.c, функция _bt_advance_array_keys. ↩︎
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-STRATEGIES. ↩︎
backend/access/nbtree/nbtsort.c, функция btbuild. ↩︎