24 Хеш-индекс
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
24.1. Общий принцип
Хеш-индекс 1 позволяет по ключу индексирования быстро найти идентификатор версии строки (tid). В первом приближении это просто хеш-таблица, хранящаяся на диске. Единственная операция, которую поддерживает хеш-индекс, — поиск по условию равенства.
При вставке в индекс 2 вычисляется хеш-функция от значения ключа индексирования. Хеш-функции в PostgreSQL возвращают 32-битные или 64-битные целые, а в качестве номера корзины используются несколько младших битов этого значения. В выбранную корзину добавляется идентификатор версии вместе с хеш-кодом ключа. Само значение ключа не сохраняется в индексе, поскольку реализации удобнее иметь дело с небольшими значениями фиксированной длины.
Хеш-таблица индекса динамически расширяется3. Минимальное число корзин равно двум. По мере увеличения количества индексируемых строк одна из корзин расщепляется на две. Для этого задействуется дополнительный бит хеш-кода, так что элементы перераспределяются только между двумя корзинами, участвующими в расщеплении, а состав остальных корзин хеш-таблицы не меняется4.
При поиске в индексе 5 вычисляется хеш-функция от ключа индексирования и соответствующий этому значению номер корзины. Из всего содержимого корзины возвращаются только те идентификаторы версий, которые соответствуют хеш-коду ключа. Благодаря тому что элементы корзин упорядочены по хеш-кодам ключей, подходящие идентификаторы эффективно находятся двоичным поиском.
Поскольку само значение ключа не сохраняется в хеш-таблице, индексный метод может вернуть лишние идентификаторы версий строк из-за хеш-коллизий. Поэтому механизм индексирования перепроверяет все полученные от метода доступа результаты по таблице. По этой же причине невозможно сканирование только индекса. (с. 411)
24.2. Страничная организация
В отличие от обычной хеш-таблицы, индекс хранится на диске. Поэтому вся необходимая информация должна быть разложена по страницам, причем желательно, чтобы операциям над индексом (поиск, вставка, удаление) требовался доступ к как можно меньшему количеству страниц.
Хеш-индекс использует страницы четырех видов:
метастраница (meta page) — нулевая страница с «оглавлением» индекса;
страницы корзин (bucket page) — основные страницы индекса, по одной на каждую корзину;
страницы переполнения (overflow page) — дополнительные страницы, которые используются, когда основной страницы корзины не хватает для размещения всех элементов;
страницы битовой карты (bitmap page) — страницы с битовым массивом, в котором отмечены освободившиеся и доступные для повторного использования страницы переполнения.
Заглянуть внутрь индексных страниц позволяет расширение pageinspect.
Начнем с пустой таблицы:
Я проанализировал таблицу, чтобы получить индекс минимального размера; иначе количество корзин соответствовало бы таблице из 10 страниц6. (v. 14)
Сейчас в индексе четыре страницы: метастраница, две основные страницы корзин и одна страница битовой карты (сразу созданная «про запас»):
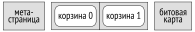
Метастраница содержит всю управляющую информацию об индексе. Пока нас интересует несколько значений:
Расчетное количество строк на одну корзину показано в поле ffactor. Это значение вычисляется исходя из вместимости блока и установленного значения параметра хранения fillfactor. При совершенно равномерном распределении данных и отсутствии хеш-коллизий значение fillfactor можно было бы и увеличить, но в реальности это повышает вероятность того, что элементы одной корзины не поместятся на одну страницу. (по умолчанию: 75)
Самый плохой для хеш-индекса случай — сильный перекос в распределении данных, когда один ключ повторяется много раз. Поскольку хеш-функция будет выдавать одно и то же значение, все данные будут попадать в одну и ту же корзину, и увеличение количества корзин ничем не поможет.
Сейчас индекс пуст, о чем говорит значение поля ntuples. Переполним страницу корзины, вставив в таблицу определенное количество строк с одинаковым значением индексируемого столбца. В индексе появится страница переполнения:
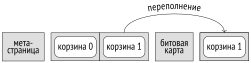
Сводка информации по страницам показывает, что корзина 0 пуста, а все значения попали в корзину 1: часть на основную страницу, а те, что не поместились, — на страницу переполнения.
Очевидно, что разброс элементов одной корзины по нескольким страницам плохо сказывается на производительности. Лучшие результаты хеш-индекс показывает на равномерно распределенных данных.
Посмотрим теперь, как расщепляется корзина. Это происходит, когда количество строк в индексе превышает расчетное число ffactor для имеющихся корзин. В данном случае при двух корзинах и ffactor = 307 это произойдет, когда в индекс будет вставлена 615-я строка:
Значение maxbucket увеличилось до двух: теперь у нас есть три корзины с номерами от 0 до 2. Но хотя добавилась всего одна корзина, количество страниц удваивается:
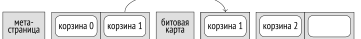
Одна из новых страниц задействована под корзину 2, а другая остается незанятой и будет использована для корзины 3, когда та появится.
Таким образом, с точки зрения операционной системы размер хеш-индекса растет скачкообразно, хотя логически хеш-таблица увеличивается постепенно.
Чтобы немного сгладить этот рост и не выделять сразу слишком много страниц, начиная с 10-го удвоения страницы выделяются не все сразу, а частями, по от расчетного количества.
Еще два поля из метастраницы, представляющих собой битовые маски, раскрывают детали адресации корзин:
Номер корзины определяется битами хеш-кода, соответствующими маске highmask. Но если полученный номер корзины не существует (превышает maxbucket), то надо взять биты, соответствующие маске lowmask7. В данном случае мы берем два младших бита, что дает значения от 0 до 3; но если выпадает 3, то берем только один младший бит, то есть вместо третьей корзины используем первую.
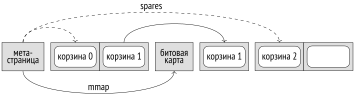
При каждом удвоении размера новые страницы корзин всегда выделяются одним непрерывным фрагментом, а страницы переполнения и битовой карты вставляются между этими фрагментами по необходимости. Метастраница хранит количество вставленных страниц для каждого из фрагментов в массиве spares, и это дает возможность по номеру корзины вычислить номер ее основной страницы8.
В данном случае после первого удвоения было вставлено две страницы (битовая карта и страница переполнения), а после второго пока не добавилось ничего нового:
В метастранице также хранится массив ссылок на страницы битовой карты:
Место внутри индексных страниц освобождается при удалении ссылок на мертвые версии строк. Это происходит при самоочистке (она срабатывает при попытке вставки элемента в полностью заполненную страницу 9) или при обычной очистке.
Но уменьшаться в размерах хеш-индекс не умеет, и однажды выделенные страницы уже не возвращаются операционной системе. Основные страницы всегда закреплены за своими корзинами, даже если в них нет ни одного элемента; опустевшие страницы переполнения отслеживаются в битовой карте и переиспользуются (возможно, уже для другой корзины). Единственный вариант уменьшить физический размер индекса — перестроить его командой REINDEX или VACUUM FULL. (с. 170)
В плане запроса тип индекса никак не отмечается:
24.3. Класс операторов
До версии PostgreSQL 10 хеш-индексы не журналировались, то есть не были защищены от сбоев и не реплицировались, и, как следствие, не рекомендовались к использованию. Но даже в таком виде они представляли определенную ценность. Дело в том, что алгоритм хеширования применяется очень широко (в частности, для хеш-соединений и группировок), и системе требуется знать, какая хеш-функция предназначена для каждого типа данных. Но это соответствие не статично: его нельзя задать раз и навсегда, поскольку PostgreSQL позволяет добавлять новые типы данных на лету. Поэтому соответствие поддерживается классом операторов для хеш-индекса и конкретного типа данных. Собственно функция хеширования представлена опорной функцией класса: (с. 457) (с. 397) (psql: \dAp)
Эти функции возвращают 32-битные целые числа. Хотя они и не документированы, их можно использовать для вычисления хеш-кода значения соответствующего типа.
Например, для семейства text_ops используется функция hashtext:
В класс операторов хеш-индекса входит один оператор — «равно». Обычно именно он используется для системных проверок значений на равенство. (psql: \dAo)
24.4. Свойства
Посмотрим свойства хеш-индекса, которые этот метод доступа сообщает о себе системе. (с. 404)
Свойства уровня метода доступа
Очевидно, что хеш-индексы не позволяют упорядочивать строки: хеш-функция перемешивает данные более или менее случайным образом.
Не поддерживается и ограничение уникальности. Правда, хеш-индексы можно использовать для ограничения исключения, а с единственной функцией «равно» исключение приобретает смысл уникальности: (с. 408)
Также не поддерживаются многоколоночные хеш-индексы и возможность добавлять к индексу дополнительные include-столбцы.
Свойства уровня индекса
Хеш-индекс работает как с обычным индексным сканированием, так и со сканированием по битовой карте.
Кластеризация таблицы по хеш-индексу не предусмотрена. Это логично, поскольку сложно представить, зачем может понадобиться физически упорядочить данные в таблице по значению хеш-функции.
Свойства уровня столбца
Фактически свойства столбцов полностью определены на уровне метода доступа и всегда принимают одни и те же значения.
Поскольку хеш-функция не сохраняет отношение порядка, к хеш-индексу не применимы свойства, касающиеся упорядоченности.
Хеш-индекс не может участвовать в сканировании только индекса, поскольку не сохраняет ключ индексации и требует перепроверки по таблице.
Хеш-индекс не работает с неопределенными значениями: операция «равно» не имеет смысла для NULL.
Поиск значений из массива не реализован.
postgrespro.ru/docs/postgresql/18/hash-index; backend/access/hash/README. ↩︎
backend/access/hash/hashpage.c, функция _hash_expandtable. ↩︎
backend/access/hash/hashpage.c, функция _hash_getbucketbuf_from_hashkey. ↩︎
backend/access/table/tableam.c, функция table_block_relation_estimate_size. ↩︎
backend/access/hash/hashutil.c, функция _hash_hashkey2bucket. ↩︎
include/access/hash.h, макрос BUCKET_TO_BLKNO. ↩︎
backend/access/hash/hashinsert.c, функция _hash_vacuum_one_page. ↩︎