# Сортировка и слияние
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
## 23.1. Соединение слиянием {#internal-ru-section-23-1}
Соединение слиянием работает для наборов данных, отсортированных по ключу соединения, и возвращает отсортированный же результат. Входной набор может оказаться уже отсортированным в результате индексного сканирования, или он может быть отсортирован явно [^internal-ru-484-1].
### Слияние отсортированных наборов {#internal-ru-subsection-star-329}
Вот пример соединения слиянием; оно представлено в плане выполнения узлом Merge Join [^internal-ru-484-2]:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets t
JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
ORDER BY t.ticket_no;
QUERY PLAN
----------------------------------------------------------------
Merge Join
Merge Cond: (t.ticket_no = tf.ticket_no)
-> Index Scan using tickets_pkey on tickets t
-> Index Scan using ticket_flights_pkey on ticket_flights tf
(4 rows)
```
Здесь оптимизатор предпочел именно этот способ соединения, поскольку он возвращает результат как раз в том порядке, который указан в предложении `ORDER BY`. Работая с планами, оптимизатор учитывает порядок сортировки наборов данных и не выполняет явную сортировку, если в ней нет необходимости. В частности, набор строк, полученный в результате соединения слиянием, можно использовать для следующего соединения слиянием, если подходит имеющийся порядок сортировки:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets t
JOIN ticket_flights tf ON t.ticket_no = tf.ticket_no
JOIN boarding_passes bp ON bp.ticket_no = tf.ticket_no
AND bp.flight_id = tf.flight_id
ORDER BY t.ticket_no;
QUERY PLAN
---------------------------------------------------------------------
Merge Join
Merge Cond: ((t.ticket_no = tf.ticket_no) AND (bp.flight_id = ...
-> Merge Join
Merge Cond: (bp.ticket_no = t.ticket_no)
-> Index Scan using boarding_passes_pkey on boarding_passe...
-> Index Scan using tickets_pkey on tickets t
-> Index Scan using ticket_flights_pkey on ticket_flights tf
(7 rows)
```
Сначала соединяются строки таблиц посадочных талонов `boarding_passes` и билетов `tickets`, прочитанные с помощью индексного доступа в порядке `ticket_no`; результат тоже отсортирован по столбцу `ticket_no`. Полученный набор соединяется со строками таблицы перелетов `ticket_flights`, выдаваемыми индексным сканированием в том же порядке.
Соединение выполняется за один проход по обоим наборам данных и не требует дополнительной памяти. Используются два указателя на текущие (изначально — первые) строки внутреннего и внешнего наборов.
Если ключи двух текущих строк не совпадают, один из указателей — тот, что ссылается на строку с меньшим ключом, — продвигается на одну позицию вперед до тех пор, пока не будет найдено совпадение. Соответствующие друг другу строки возвращаются вышестоящему узлу, а вперед продвигается указатель внутреннего набора данных. Соединение продолжается до исчерпания одного из наборов.
Такой алгоритм справляется с дубликатами ключей во внутреннем наборе данных, но поскольку дубликаты могут быть и во внешнем наборе, алгоритм приходится немного усложнить: если после продвижения внешнего указателя ключ остается прежним, внутренний указатель возвращается назад на первую строку с тем же значением ключа. Таким образом, каждой строке из внешнего набора данных будут сопоставлены все строки с тем же ключом из внутреннего набора данных[^internal-ru-486-1].
Для внешнего соединения алгоритм еще немного меняется, но общая идея остается той же самой.
Единственный оператор, на который рассчитано соединение слиянием, — равенство, то есть поддерживаются только эквисоединения (хотя работа над поддержкой других условий тоже ведется [^internal-ru-486-2]).
**Оценка стоимости.** Рассмотрим приведенный выше пример:
```text {label="psql" hl_lines="7"}
=> EXPLAIN SELECT *
FROM tickets t
JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
ORDER BY t.ticket_no;
QUERY PLAN
----------------------------------------------------------------
Merge Join (cost=0.99..822507.74 rows=8391852 width=136)
Merge Cond: (t.ticket_no = tf.ticket_no)
-> Index Scan using tickets_pkey on tickets t
(cost=0.43..139136.22 rows=2949857 width=104)
-> Index Scan using ticket_flights_pkey on ticket_flights tf
(cost=0.56..571098.73 rows=8391852 width=32)
(6 rows)
```
В начальную стоимость соединения входят как минимум начальные стоимости дочерних узлов.
В общем случае для нахождения первого соответствия может потребоваться прочитать некоторую долю внешнего или внутреннего набора данных.
Чтобы оценить эту долю, можно сравнить (с помощью гистограммы) минимальные значения ключа соединения в двух наборах[^internal-ru-487-1]. Но в данном случае диапазоны номеров билетов в обеих таблицах совпадают. (*с.* [356](/ru/17-statistics/#internal-ru-page-357))
Полная стоимость соединения складывается из стоимости получения данных от дочерних узлов и стоимости вычислений.
Поскольку алгоритм соединения останавливается, когда заканчивается один из наборов данных (конечно, кроме случая внешнего соединения), другой набор может быть прочитан не полностью. Оценку доли прочитанных строк можно получить, сравнив максимальные значения ключа в двух наборах. В нашем случае оба набора будут просмотрены до конца, так что в полную стоимость соединения войдет сумма полных стоимостей обоих дочерних узлов.
Кроме того, при наличии дубликатов часть строк внутреннего набора может быть прочитана несколько раз. Количество повторных чтений оценивается разностью кардинальностей результата соединения и внутреннего набора[^internal-ru-487-2]. В нашем запросе эти кардинальности совпадают, что говорит об отсутствии дубликатов.
Алгоритм сравнивает ключи соединений двух наборов. Стоимость одного сравнения оценивается значением параметра *cpu\_operator\_cost*, а их количество можно оценить суммой числа строк в обоих наборах (добавив к ней количество повторных чтений, вызванных дубликатами). Стоимость обработки каждой результирующей строки оценивается, как обычно, значением параметра *cpu\_tuple\_cost*. (*по умолчанию:* `0.0025`) (*по умолчанию:* `0.01`)
В итоге для нашего примера стоимость соединения вычисляется следующим образом [^internal-ru-487-3]:
```text {label="psql"}
=> SELECT 0.43 + 0.56 AS startup,
round((
139110.29 + 571098.73 +
current_setting('cpu_tuple_cost')::real * 8391852 +
current_setting('cpu_operator_cost')::real * (2949857 + 8391852)
)::numeric, 2) AS total;
startup | total
---------+-----------
0.99 | 822481.81
(1 row)
```
### Параллельный режим {#internal-ru-subsection-star-333}
Соединение слиянием не имеет специальной параллельной реализации, но может использоваться в параллельных планах[^internal-ru-488-1].
Сканирование внешнего набора строк выполняется рабочими процессами параллельно, но внутренний набор строк каждый рабочий процесс всегда читает самостоятельно.
Поскольку параллельное хеш-соединение почти всегда выигрывает по стоимости, я временно отключу его: (*с.* [471](/ru/22-hashing/#internal-ru-page-472))
```text {label="psql"}
=> SET enable_hashjoin = off;
```
Вот пример параллельного плана, использующего соединение слиянием:
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT count(*), sum(tf.amount)
FROM tickets t
JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no;
QUERY PLAN
---------------------------------------------------------------------
Finalize Aggregate
-> Gather
Workers Planned: 2
-> Partial Aggregate
-> Merge Join
Merge Cond: (tf.ticket_no = t.ticket_no)
-> Parallel Index Scan using ticket_flights_pkey o...
-> Index Only Scan using tickets_pkey on tickets t
(8 rows)
```
Полные и правые внешние соединения слиянием в параллельных планах не поддерживаются.
### Модификации {#internal-ru-subsection-star-335}
Соединение слиянием поддерживает любые виды соединений. Для полного и правого внешних соединений есть единственное ограничение: условие соединения должно содержать только выражения, подходящие для слияния (равенство столбцов из внешнего и внутреннего наборов или равенство столбца константе)[^internal-ru-489-1]. При внутреннем и левом внешнем соединениях результат слияния просто фильтруется по неподходящим условиям, но для полного и правого соединений такая фильтрация невозможна.
Вот пример полного соединения, использующего алгоритм слияния:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT *
FROM tickets t
FULL JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
ORDER BY t.ticket_no;
QUERY PLAN
--------------------------------------------------------------------
Sort
Sort Key: t.ticket_no
-> Merge Full Join
Merge Cond: (t.ticket_no = tf.ticket_no)
-> Index Scan using tickets_pkey on tickets t
-> Index Scan using ticket_flights_pkey on ticket_flights tf
(6 rows)
```
Внутреннее и левое соединения слиянием сохраняют порядок сортировки. Но для полного и правого внешних соединений это не так, поскольку между упорядоченными значениями внешнего набора данных могут быть вставлены неопределенные значения — а это нарушает сортировку[^internal-ru-489-2]. Поэтому здесь появляется узел Sort, восстанавливающий нужный порядок. Это, конечно, увеличивает стоимость плана и делает хеш-соединение более привлекательным, и планировщик выбрал этот план только потому, что хеш-соединения были отключены.
Но в следующем примере нет иного способа выполнить операцию: вложенный цикл в принципе не поддерживает полное соединение, а слияние здесь неприменимо из-за условия неподходящего вида. Поэтому хеш-соединение используется, даже несмотря на запрет (о чем напоминает строка Disabled: true под узлом Hash Full Join): (v. 18)
```text {label="psql" hl_lines="13"}
=> EXPLAIN (costs off) SELECT *
FROM tickets t
FULL JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
AND tf.amount > 0
ORDER BY t.ticket_no;
QUERY PLAN
-----------------------------------------------
Sort
Sort Key: t.ticket_no
-> Hash Full Join
Disabled: true
Hash Cond: (tf.ticket_no = t.ticket_no)
Join Filter: (tf.amount > '0'::numeric)
-> Seq Scan on ticket_flights tf
-> Hash
-> Seq Scan on tickets t
(9 rows)
```
Восстановим отключенную ранее возможность использования хеш-соединений:
```text {label="psql"}
=> RESET enable_hashjoin;
```
## 23.2. Сортировка {#internal-ru-section-23-2}
Если какой-то из наборов строк (а возможно, и оба) не отсортирован по ключу соединения, перед выполнением слияния он должен быть переупорядочен. Такая явная сортировка представляется в плане выполнения узлом Sort [^internal-ru-490-1]:
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT *
FROM flights f
JOIN airports_data dep ON f.departure_airport = dep.airport_code
ORDER BY dep.airport_code;
QUERY PLAN
--------------------------------------------------------
Merge Join
Merge Cond: (f.departure_airport = dep.airport_code)
-> Sort
Sort Key: f.departure_airport
-> Seq Scan on flights f
-> Sort
Sort Key: dep.airport_code
-> Seq Scan on airports_data dep
(8 rows)
```
Такая же сортировка может применяться и вне контекста соединений при использовании предложения `ORDER BY`, как самого по себе, так и в составе оконных функций:
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT flight_id,
row_number() OVER (PARTITION BY flight_no ORDER BY flight_id)
FROM flights f;
QUERY PLAN
---------------------------------------------------------------------
WindowAgg
Window: w1 AS (PARTITION BY flight_no ORDER BY flight_id ROWS ...
-> Sort
Sort Key: flight_no, flight_id
-> Seq Scan on flights f
(5 rows)
```
Здесь узел WindowAgg [^internal-ru-491-1] вычисляет оконную функцию по набору данных, предварительно отсортированному узлом Sort.
В арсенале планировщика имеется несколько способов сортировки данных. В примере, который я уже показывал, используются два из них (Sort Method). Как обычно, эти детали позволяет узнать команда `EXPLAIN ANALYZE`:
```text {label="psql" hl_lines="12 16"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM flights f
JOIN airports_data dep ON f.departure_airport = dep.airport_code
ORDER BY dep.airport_code;
QUERY PLAN
---------------------------------------------------------------------
Merge Join (actual rows=214867.00 loops=1)
Merge Cond: (f.departure_airport = dep.airport_code)
-> Sort (actual rows=214867.00 loops=1)
Sort Key: f.departure_airport
Sort Method: external merge Disk: 17120kB
-> Seq Scan on flights f (actual rows=214867.00 loops=1)
-> Sort (actual rows=104.00 loops=1)
Sort Key: dep.airport_code
Sort Method: quicksort Memory: 42kB
-> Seq Scan on airports_data dep (actual rows=104.00 loops=1)
(10 rows)
```
### Быстрая сортировка {#internal-ru-subsection-star-337}
Если сортируемый набор данных помещается в память, ограниченную значением параметра *work\_mem*, применяется традиционная *быстрая сортировка* (quick sort). Этот алгоритм описан во всех учебниках, так что я не буду его повторять. (*по умолчанию:* `4MB`)
С точки зрения реализации сортировка выполняется специальным компонентом[^internal-ru-492-1], который выбирает наиболее подходящий алгоритм в зависимости от доступной памяти и других факторов.
**Оценка стоимости.** В качестве примера возьмем сортировку небольшой таблицы. В этом случае выполняется быстрая сортировка в памяти:
```text {label="psql" hl_lines="6"}
=> EXPLAIN SELECT *
FROM airports_data
ORDER BY airport_code;
QUERY PLAN
---------------------------------------------------------------------
Sort (cost=7.52..7.78 rows=104 width=145)
Sort Key: airport_code
-> Seq Scan on airports_data (cost=0.00..4.04 rows=104 width=...
(3 rows)
```
Известно, что сортировка *n* значений имеет вычислительную сложность *O*(*n* log2 *n*). Одна операция сравнения оценивается удвоенным значением параметра *cpu\_operator\_cost*. Поскольку результат можно получить, только прочитав и отсортировав *весь* набор данных, начальная стоимость сортировки определяется полной стоимостью дочернего узла и стоимостью всех операций сравнения. (*по умолчанию:* `0.0025`)
В полную стоимость сортировки добавляется обработка каждой строки результата, которая оценивается значением параметра *cpu\_operator\_cost* (а не *cpu\_tuple\_cost*, как обычно, поскольку для узла Sort накладные расходы невелики)[^internal-ru-493-1].
В нашем примере стоимость вычисляется так:
```text {label="psql"}
=> WITH costs(startup) AS (
SELECT 4.04 + round((
current_setting('cpu_operator_cost')::real * 2 *
104 * log(2, 104)
)::numeric, 2)
)
SELECT startup,
startup + round((
current_setting('cpu_operator_cost')::real * 104
)::numeric, 2) AS total
FROM costs;
startup | total
---------+-------
7.52 | 7.78
(1 row)
```
### Частичная пирамидальная сортировка {#internal-ru-subsection-star-341}
Если нужно отсортировать не весь набор данных, а только его часть (что определяется предложением `LIMIT`), может применяться *частичная пирамидальная сортировка* (top-N heapsort). Точнее, этот алгоритм используется, если количество строк после сортировки уменьшается как минимум вдвое или если входной набор строк не помещается целиком в отведенную оперативную память (но для выходного набора при этом достаточно места).
```text {label="psql" hl_lines="6 11"}
=> EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT * FROM seats
ORDER BY seat_no LIMIT 100;
QUERY PLAN
-------------------------------------------------------------------
Limit (cost=72.57..72.82 rows=100 width=15)
(actual rows=100.00 loops=1)
-> Sort (cost=72.57..75.91 rows=1339 width=15)
(actual rows=100.00 loops=1)
Sort Key: seat_no
Sort Method: top-N heapsort Memory: 32kB
-> Seq Scan on seats (cost=0.00..21.39 rows=1339 width=15)
(actual rows=1339.00 loops=1)
(8 rows)
```
Чтобы найти *k* максимальных (минимальных) значений из *n*, в структуру данных, называемую кучей, добавляются *k* первых строк. Затем по одной добавляются и все остальные строки, но после добавления каждой следующей строки из кучи изымается одно наименьшее (наибольшее) значение. В результате в куче остаются *k* искомых значений.
> [!NOTE]
> Куча (heap), используемая в этом алгоритме, является структурой данных и не имеет ничего общего с таблицами базы данных, которые часто называют этим же термином.
**Оценка стоимости.** Сложность алгоритма оценивается как *O*(*n* log2 *k*), однако каждая операция обходится дороже, чем в случае быстрой сортировки. Поэтому формула расчета стоимости [^internal-ru-494-1] использует *n* log2 2*k*.
```text {label="psql"}
=> WITH costs(startup) AS (
SELECT 21.39 + round((
current_setting('cpu_operator_cost')::real * 2 *
1339 * log(2, 2 * 100)
)::numeric, 2)
)
SELECT startup,
startup + round((
current_setting('cpu_operator_cost')::real * 100
)::numeric, 2) AS total
FROM costs;
startup | total
---------+-------
72.57 | 72.82
(1 row)
```
### Внешняя сортировка {#internal-ru-subsection-star-345}
Если при чтении набора данных выясняется, что он слишком велик для сортировки в оперативной памяти, узел сортировки переключается на *внешнюю* *сортировку слиянием* (external merge).
Уже прочитанные строки сортируются в памяти алгоритмом быстрой сортировки и записываются во временный файл.
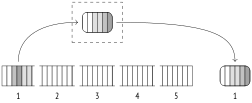
{#internal-ru-fig-23-1 num="23.1" caption="Внешняя сортировка" .book-original-figure width=503 height=205}
В освобожденную память читаются следующие строки, и процедура повторяется до тех пор, пока все данные не будут записаны в несколько файлов, каждый из которых в отдельности отсортирован.
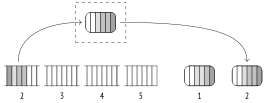
{#internal-ru-fig-23-2 num="23.2" caption="Внешняя сортировка" .book-original-figure width=528 height=205}
Далее несколько файлов объединяются в один примерно тем же алгоритмом, что используется и при соединении слиянием. Основное отличие состоит в том, что объединяться могут более двух файлов одновременно.
Для слияния не требуется много памяти. В принципе, достаточно располагать местом под одну строку для каждого файла. Из файлов читаются первые строки, среди них выбирается минимальная (или максимальная, в зависимости от направления сортировки) и возвращается как часть результата, а на ее место читается новая строка из того же файла.
На практике строки читаются не по одной, а порциями по 32 страницы; это уменьшает количество операций ввода-вывода. Количество файлов, которые объединяются за одну итерацию, определяется доступным местом в памяти, но меньше шести не используется никогда. Сверху это количество тоже ограничено (числом 500), поскольку эффективность теряется, когда файлов становится слишком много[^internal-ru-496-1].
> [!NOTE]
> Для алгоритмов сортировки в английском языке исторически сложилась специальная терминология. Внешняя сортировка изначально использовала накопители на магнитной ленте, и компонент PostgreSQL, управляющий временными файлами, сохранил это название[^internal-ru-496-2]. Частично отсортированные наборы данных называются словом run (*серия* в русском переводе книги Кнута [^internal-ru-496-3]). Количество серий, участвующих в слиянии, называется merge order (*порядок слияния*). Я не использовал эти термины, но их полезно знать, чтобы понимать код и комментарии.
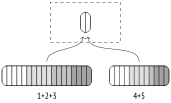
Если объединить все отсортированные временные файлы за одну итерацию не получается, приходится выполнять слияние файлов по частям и записывать результат в новые временные файлы. Каждая такая итерация увеличивает объем записываемых и читаемых данных, поэтому чем больше оперативной памяти доступно, тем эффективнее будет выполняться внешняя сортировка.
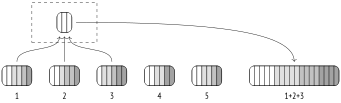
{#internal-ru-fig-23-3 num="23.3" caption="Внешняя сортировка" .book-original-figure width=682 height=205}
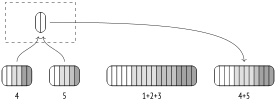
{#internal-ru-fig-23-4 num="23.4" caption="Внешняя сортировка" .book-original-figure width=552 height=205}
На следующей итерации слияние продолжается уже с новыми файлами.
{#internal-ru-fig-23-5 num="23.5" caption="Внешняя сортировка" .book-original-figure width=342 height=205}
Финальное слияние обычно откладывается и выполняется на лету, когда вышестоящий узел плана запрашивает данные.
Команда `EXPLAIN ANALYZE` показывает объем дисковой памяти, который потребовался внешней сортировке. Добавив ключевое слово `buffers`, можно получить и статистику использования буферов временных файлов (temp read и written). Количество записанных буферов будет (примерно) равно количеству прочитанных, и именно это значение, пересчитанное в килобайты, показано в плане в позиции Disk:
```text {label="psql" hl_lines="8 9"}
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM flights
ORDER BY scheduled_departure;
QUERY PLAN
----------------------------------------------------------
Sort (actual rows=214867.00 loops=1)
Sort Key: scheduled_departure
Sort Method: external merge Disk: 17120kB
Buffers: shared hit=2627, temp read=2140 written=2145
-> Seq Scan on flights (actual rows=214867.00 loops=1)
Buffers: shared hit=2624
(6 rows)
```
Более подробную статистику использования временных файлов можно получить в журнале сообщений, установив параметр *log\_temp\_files*.
**Оценка стоимости.** В качестве примера возьмем тот же план с внешней сортировкой:
```text {label="psql" hl_lines="6 8"}
=> EXPLAIN SELECT *
FROM flights
ORDER BY scheduled_departure;
QUERY PLAN
---------------------------------------------------------------------
Sort (cost=31883.96..32421.12 rows=214867 width=63)
Sort Key: scheduled_departure
-> Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=63)
(3 rows)
```
Здесь к обычной стоимости сравнений (количество которых остается таким же, как и в случае быстрой сортировки в памяти) добавляется стоимость ввода-вывода[^internal-ru-498-1]. Все входные данные придется сначала записать на диск во временные файлы, а затем прочитать с диска при слиянии (причем, возможно, несколько раз, если количество созданных файлов будет превышать количество одновременно объединяемых наборов).
Обращение к диску (и запись, и чтение) считается на три четверти последовательным и на одну четверть случайным.
Объем данных, попадающих на диск, определяется количеством сортируемых строк и числом столбцов, используемых в запросе[^internal-ru-498-2]. В данном случае запрос выводит все столбцы таблицы `flights`, поэтому на диск попадет объем, почти равный размеру всей таблицы, за вычетом служебной информации в версиях строк и страницах (2309 страниц вместо 2624).
В нашем примере для сортировки хватает одной итерации.
Таким образом, стоимость сортировки в нашем плане вычисляется так:
```text {label="psql"}
=> WITH costs(startup) AS (
SELECT 4772.67 + round((
current_setting('cpu_operator_cost')::real * 2 *
214867 * log(2, 214867) +
(current_setting('seq_page_cost')::real * 0.75 +
current_setting('random_page_cost')::real * 0.25) *
2 * 2309 * 1 -- одна итерация
)::numeric, 2)
)
SELECT startup,
startup + round((
current_setting('cpu_operator_cost')::real * 214867
)::numeric, 2) AS total
FROM costs;
startup | total
----------+----------
31883.96 | 32421.13
(1 row)
```
### Инкрементальная сортировка {#internal-ru-subsection-star-349}
Если набор данных требуется отсортировать по ключам *K*1 … *K*m … *K*n и при этом известно, что набор уже отсортирован по первым *m* ключам, то не обязательно пересортировывать весь набор заново. Можно разбить набор данных на группы, имеющие одинаковые значения начальных ключей *K*1 … *K*m (значения таких групп следуют друг за другом), и затем отсортировать отдельно каждую из групп по оставшимся ключам *K*m+1 … *K*n. Такой способ называется *инкрементальной сортировкой*. (v. 13)
Инкрементальная сортировка уменьшает требования к памяти, разбивая весь набор на несколько меньших групп, и позволяет выдавать результаты уже после обработки первой группы, не дожидаясь сортировки всего набора.
Реализация [^internal-ru-499-1] действует более тонко: отдельно обрабатываются только относительно крупные группы строк, а небольшие объединяются и сортируются полностью. Это уменьшает накладные расходы на вызов сортировки[^internal-ru-499-2].
В плане выполнения инкрементальная сортировка представлена узлом Incremental Sort:
```text {label="psql"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM bookings
ORDER BY total_amount, book_date;
QUERY PLAN
--------------------------------------------------------------------
Incremental Sort (actual rows=2111110.00 loops=1)
Sort Key: total_amount, book_date
Presorted Key: total_amount
Full-sort Groups: 2823 Sort Method: quicksort Average
Memory: 27kB Peak Memory: 27kB
Pre-sorted Groups: 2624 Sort Method: quicksort Average
Memory: 1953kB Peak Memory: 2014kB
-> Index Scan using bookings_total_amount_idx on bookings (ac...
Index Searches: 1
(9 rows)
```
Как видно из плана, набор строк уже отсортирован по `total_amount`, поскольку получен сканированием индекса, построенного по этому столбцу (Presorted Key). Команда `EXPLAIN ANALYZE` показывает также статистику времени выполнения. Строка Full-sort Groups относится к небольшим группам, которые были объединены и отсортированы полностью, а строка Presorted Groups — к крупным группам, которые досортировывались по столбцу `book_date`. В обоих случаях использовалась быстрая сортировка в памяти. Наличие групп разного размера вызвано неравномерным распределением стоимости бронирований.
Инкрементальная сортировка может использоваться и при вычислении оконных функций: (v. 14)
```text {label="psql"}
=> EXPLAIN (costs off)
SELECT row_number() OVER (ORDER BY total_amount, book_date)
FROM bookings;
QUERY PLAN
---------------------------------------------------------------------
WindowAgg
Window: w1 AS (ORDER BY total_amount, book_date ROWS UNBOUNDED...
-> Incremental Sort
Sort Key: total_amount, book_date
Presorted Key: total_amount
-> Index Scan using bookings_total_amount_idx on bookings
(6 rows)
```
**Оценка стоимости.** Расчет стоимости инкрементальной сортировки [^internal-ru-501-1] опирается на оценку количества групп [^internal-ru-501-2] и оценку сортировки группы среднего размера (которую мы уже рассмотрели).
Начальная стоимость отражает оценки сортировки одной (первой) группы, после которой узел уже может выдавать отсортированные строки, а полная стоимость учитывает сортировку всех групп.
Подробно останавливаться на вычислении оценок я не буду.
### Параллельный режим {#internal-ru-subsection-star-353}
Сортировка может выполняться параллельно. Но хотя рабочие процессы выдают свою часть данных в отсортированном виде, узел Gather ничего про это не знает и может объединять данные только в порядке поступления. Чтобы сохранить сортировку, применяется другой узел — Gather Merge[^internal-ru-501-3].
```text {label="psql"}
=> EXPLAIN (analyze, costs off, timing off, summary off, buffers off)
SELECT *
FROM flights
ORDER BY scheduled_departure
LIMIT 10;
QUERY PLAN
---------------------------------------------------------------------
Limit (actual rows=10.00 loops=1)
-> Gather Merge (actual rows=10.00 loops=1)
Workers Planned: 1
Workers Launched: 1
-> Sort (actual rows=8.50 loops=2)
Sort Key: scheduled_departure
Sort Method: top-N heapsort Memory: 27kB
Worker 0: Sort Method: top-N heapsort Memory: 27kB
-> Parallel Seq Scan on flights (actual rows=107433.50...
(9 rows)
```
Узел Gather Merge использует двоичную кучу [^internal-ru-501-4] для упорядочения строк, поступающих от нескольких процессов. По сути, он выполняет слияние нескольких отсортированных наборов строк, как при внешней сортировке, но алгоритм рассчитан на другие условия работы: на небольшое фиксированное число источников и получение строк по одной, без блочного доступа.
**Оценка стоимости.** Начальная стоимость узла Gather Merge опирается на начальную стоимость дочернего узла. К ней (как и для узла Gather) добавляется стоимость запуска процессов, которая оценивается значением параметра *parallel\_setup\_cost*. (*с.* [382](/ru/18-table-access-methods/#internal-ru-page-383)) (*по умолчанию:* `1000`)
Сюда же добавляется оценка построения двоичной кучи, что требует сортировки *n* значений по числу параллельных процессов (то есть *n* log2 *n*). Одна операция сравнения оценивается удвоенным значением параметра *cpu\_operator\_cost*, и общая сумма обычно пренебрежимо мала, поскольку *n* невелико. (*по умолчанию:* `0.0025`)
В полную стоимость входят получение всех данных дочерним узлом, который выполняется несколькими параллельными процессами, и стоимость пересылки строк от этих процессов. Пересылка одной строки оценивается значением параметра *parallel\_tuple\_cost*, увеличенным на 5 %, чтобы учесть возможные потери при ожидании очередных значений. (*по умолчанию:* `0.1`)
В полную стоимость входит также обновление двоичной кучи. Для каждой входящей строки данных это требует log2 *n* операций сравнения и определенных вспомогательных действий (которые оцениваются значением *cpu\_operator\_cost*)[^internal-ru-502-1].
Вот еще один пример плана с узлом Gather Merge. Он интересен тем, что рабочие процессы выполняют частичную агрегацию с помощью хеширования, затем полученные результаты сортируются узлом Sort (это дешево, поскольку после агрегации остается немного строк) и передаются ведущему процессу, который собирает полный результат в узле Gather Merge. Окончательная же агрегация выполняется по отсортированному списку значений: (*с.* [478](/ru/22-hashing/#internal-ru-page-479))
```text {label="psql" hl_lines="8"}
=> EXPLAIN SELECT amount, count(*)
FROM ticket_flights
GROUP BY amount;
QUERY PLAN
---------------------------------------------------------------------
Finalize GroupAggregate (cost=123426.68..123528.57 rows=338 wid...
Group Key: amount
-> Gather Merge (cost=123426.68..123521.13 rows=811 width=14)
Workers Planned: 2
-> Sort (cost=122426.65..122427.50 rows=338 width=14)
Sort Key: amount
-> Partial HashAggregate (cost=122409.07..122412.46 r...
Group Key: amount
-> Parallel Seq Scan on ticket_flights (cost=0.00...
(9 rows)
```
В данном случае количество параллельных процессов равно трем (включая основной), и стоимость узла Gather Merge вычисляется так:
```text {label="psql"}
=> WITH costs(startup, run) AS (
SELECT round((
-- запуск процессов
current_setting('parallel_setup_cost')::real +
-- построение кучи
current_setting('cpu_operator_cost')::real * 2 * 3 * log(2, 3)
)::numeric, 2),
round((
-- передача строк
current_setting('parallel_tuple_cost')::real * 1.05 * 676 +
-- обновление кучи
current_setting('cpu_operator_cost')::real * 2 * 676 * log(2, 3) +
current_setting('cpu_operator_cost')::real * 676
)::numeric, 2)
)
SELECT 122426.65 + startup AS startup,
122427.50 + startup + run AS total
FROM costs;
startup | total
-----------+-----------
123426.67 | 123505.55
(1 row)
```
## 23.3. Группировка и уникальные значения {#internal-ru-section-23-3}
Как мы только что видели, группировка значений для агрегации (и устранения дубликатов) может выполняться не только хешированием, но также и с помощью сортировки. В отсортированном списке группы повторяющихся значений элементарно выделяются за один проход. (*с.* [479](/ru/22-hashing/#internal-ru-page-480))
Выбор уникальных значений из отсортированного списка представляется в плане очень простым узлом Unique [^internal-ru-504-1]:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT DISTINCT book_ref
FROM bookings
ORDER BY book_ref;
QUERY PLAN
------------------------------------------------------
Unique
-> Index Only Scan using bookings_pkey on bookings
(2 rows)
```
Узел Unique может участвовать в параллельном плане, устраняя дубликаты в списке, полученном от рабочих процессов: (v. 15)
```text {label="psql"}
=> EXPLAIN (costs off) SELECT DISTINCT fare_conditions
FROM ticket_flights;
QUERY PLAN
------------------------------------------------------
Unique
-> Gather Merge
Workers Planned: 2
-> Sort
Sort Key: fare_conditions
-> HashAggregate
Group Key: fare_conditions
-> Parallel Seq Scan on ticket_flights
(8 rows)
```
В этом примере рабочие процессы выделяют уникальные значения в своих наборах данных с помощью хеширования в узле HashAggregate; общий список, собранный узлом Gather, сортируется в узле Sort и передается узлу Unique для окончательного устранения дубликатов.
Для агрегации используется другой узел, GroupAggregate [^internal-ru-504-2]:
```text {label="psql"}
=> EXPLAIN (costs off) SELECT book_ref, count(*)
FROM bookings
GROUP BY book_ref
ORDER BY book_ref;
QUERY PLAN
------------------------------------------------------
GroupAggregate
Group Key: book_ref
-> Index Only Scan using bookings_pkey on bookings
(3 rows)
```
В параллельных планах такой узел будет называться Partial GroupAggregate, а узел, завершающий агрегацию, — Finalize GroupAggregate.
Обе стратегии — хеширование и сортировка — могут совмещаться в одном узле при группировке по нескольким наборам (в предложениях `GROUPING SETS`, `CUBE` или `ROLLUP`). Я не буду углубляться в весьма непростые детали алгоритма. Приведу лишь один пример, в котором группировка должна вычисляться по трем разным столбцам:
```text {label="psql" hl_lines="7 8 9"}
=> EXPLAIN (costs off) SELECT count(*)
FROM ticket_flights
GROUP BY GROUPING SETS (fare_conditions, ticket_no, amount);
QUERY PLAN
-------------------------------------
MixedAggregate
Hash Key: amount
Group Key: fare_conditions
Sort Key: ticket_no
Group Key: ticket_no
-> Sort
Sort Key: fare_conditions
-> Seq Scan on ticket_flights
(8 rows)
```
Вот что происходит при выполнении этого запроса. Узел агрегации, который обозначен в плане как MixedAggregate, получает набор данных, отсортированных по столбцу `fare_conditions`.
На первом этапе этот набор сканируется, и значения группируются по столбцу `fare_conditions` (Group Key). По мере сканирования строки переупорядочиваются по столбцу `ticket_no` (так, как это делает обычный узел Sort: либо быстрой сортировкой в памяти, если ее достаточно, либо внешней сортировкой на диске) и одновременно с этим записываются в хеш-таблицу с ключом `amount` (так, как это делает агрегация хешированием: либо в памяти, либо с использованием временных файлов).
На втором этапе сканируется набор строк, отсортированный на предыдущем этапе по столбцу `ticket_no`, и значения группируются по этому же столбцу (Sort Key и вложенный Group Key). Если бы требовалась группировка сортировкой по еще одному столбцу, строки были бы пересортированы в необходимом дальше порядке.
Наконец, сканируется хеш-таблица, подготовленная на первом этапе, и значения группируются по столбцу `amount` (Hash Key).
## 23.4. Сравнение способов соединения {#internal-ru-section-23-4}
Итак, для соединения двух наборов данных могут использоваться три разных способа, каждый со своими достоинствами и недостатками.
*Соединение вложенным циклом* не требует никакой подготовительной работы и сразу начинает возвращать результирующие строки. Это единственный из способов соединения, которому не требуется просматривать внутренний набор полностью, если для него есть эффективный индексный доступ. Эти свойства делают алгоритм вложенного цикла (в сочетании с индексами) идеальным механизмом для коротких OLTP-запросов, которые строятся на небольшой выборке строк.
Недостаток вложенного цикла проявляется с ростом объема данных. Для декартова произведения этот алгоритм имеет квадратичную сложность — затраты пропорциональны произведению размеров соединяемых наборов данных. Декартово произведение нечасто встречается на практике; обычно для каждой строки внешнего набора данных с помощью индекса просматривается некоторое количество строк внутреннего набора, и это среднее количество не зависит от размера всего набора данных (например, среднее количество билетов в одном бронировании не меняется с ростом числа бронирований и купленных билетов). Поэтому часто рост сложности будет линейным, а не квадратичным, хотя и с большим коэффициентом.
Важная особенность вложенного цикла состоит в его универсальности: он поддерживает любые условия соединения, в то время как остальные способы работают только с эквисоединениями. Это дает возможность выполнять любые запросы с любыми условиями (кроме полного соединения, которое не реализуется вложенным циклом), но надо помнить о том, что неэквисоединение больших объемов почти наверняка будет выполняться медленнее, чем хотелось бы.
*Соединение хешированием* очень эффективно для больших наборов данных. При наличии достаточного объема оперативной памяти оно требует однократного просмотра двух наборов данных, то есть имеет линейную сложность. В сочетании с последовательным сканированием таблиц соединение хешированием часто встречается в OLAP-запросах, вычисляющих результат на основании большого объема данных.
Для ситуаций, в которых время отклика важнее пропускной способности, хеш-соединение подходит хуже, поскольку результирующие строки не могут возвращаться, пока хеш-таблица не построена полностью.
Применение хеш-соединения ограничено эквисоединениями. Кроме того, тип данных должен допускать хеширование (это выполняется почти всегда).
Вложенный цикл может иногда составить конкуренцию соединению хешированием за счет кеширования строк внутреннего набора в узле Memoize (также основанного на хеш-таблице). Выигрыш может достигаться благодаря тому, что соединение хешированием всегда просматривает внутренний набор строк полностью, а алгоритм вложенного цикла — нет. (v. 14)
*Соединение слиянием* отлично подходит и для коротких OLTP-запросов, и для длинных запросов OLAP. Оно имеет линейную сложность (требуется однократный просмотр соединяемых наборов строк), не требовательно к памяти и выдает результаты без предварительной подготовки — правда, наборы данных должны быть отсортированы в правильном порядке. Наиболее эффективный способ добиться этого — получать данные от индексного сканирования. Это естественный вариант для небольшого количества строк; при большом объеме данных индексный доступ тоже может быть эффективен, но только если обращений к таблице немного или их вовсе нет.
Если подходящих индексов нет, то наборы данных придется сортировать, а сортировка требует памяти и имеет сложность выше линейной: *O*(*n* log2 *n*).
В таком случае соединение слиянием почти всегда проигрывает соединению хешированием — за исключением ситуации, когда результат нужен отсортированным.
Приятным свойством соединения слиянием является равноценность внешнего и внутреннего наборов строк. Эффективность и вложенного цикла, и хеш-соединения сильно зависит от того, правильно ли планировщик выберет, какой из наборов данных поставить внешним, а какой — внутренним.
Применение соединения слиянием ограничено эквисоединениями. Кроме того, тип данных должен иметь класс операторов для B-дерева. (*с.* [546](/ru/25-b-tree/#internal-ru-page-547))
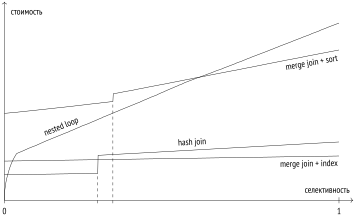
Ниже показан примерный график зависимости стоимостей различных способов соединений от доли соединяемых строк.
{#internal-ru-fig-23-6 num="23.6" caption="Сравнение способов соединения" .book-original-figure width=710 height=436}
Соединение вложенным циклом при высокой селективности использует индексный доступ к обеим таблицам; затем планировщик переключается на полное сканирование внешней таблицы, и график становится линейным.
Соединение хешированием использует в этом примере полное сканирование обеих таблиц. «Ступенька» на графике возникает в тот момент, когда хеш-таблица перестает помещаться в оперативной памяти и пакеты начинают сбрасываться на диск.
Соединение слиянием с использованием индекса показывает небольшой линейный рост стоимости. При достаточном объеме *work\_mem* соединение хешированием обычно оказывается эффективнее, но когда дело доходит до временных файлов, соединение слиянием выигрывает.
Верхний график соединения слиянием с сортировкой показывает рост стоимости в ситуации, когда индексы недоступны и данные приходится сортировать. Как и в случае соединения хешированием, «ступенька» на графике вызвана недостатком памяти и необходимостью использовать для сортировки временные файлы.
Это только пример; в каждом конкретном случае соотношения стоимостей, разумеется, будут отличаться.
[^internal-ru-484-1]: [backend/optimizer/path/joinpath.c](), функция generate\_mergejoin\_paths.
[^internal-ru-484-2]: [backend/executor/nodeMergejoin.c]().
[^internal-ru-486-1]: [backend/executor/nodeMergejoin.c](), функция ExecMergeJoin.
[^internal-ru-486-2]: Например, [commitfest.postgresql.org/33/3160]().
[^internal-ru-487-1]: [backend/utils/adt/selfuncs.c](), функция mergejoinscansel.
[^internal-ru-487-2]: [backend/optimizer/path/costsize.c](), функция final\_cost\_mergejoin.
[^internal-ru-487-3]: [backend/optimizer/path/costsize.c](), функции initial\_cost\_mergejoin и final\_cost\_mergejoin.
[^internal-ru-488-1]: [backend/optimizer/path/joinpath.c](), функция consider\_parallel\_mergejoin.
[^internal-ru-489-1]: [backend/optimizer/path/joinpath.c](), функция select\_mergejoin\_clauses.
[^internal-ru-489-2]: [backend/optimizer/path/pathkeys.c](), функция build\_join\_pathkeys.
[^internal-ru-490-1]: [backend/executor/nodeSort.c]().
[^internal-ru-491-1]: [backend/executor/nodeWindowAgg.c]().
[^internal-ru-492-1]: [backend/utils/sort/tuplesort.c]().
[^internal-ru-493-1]: [backend/optimizer/path/costsize.c](), функция cost\_sort.
[^internal-ru-494-1]: [backend/optimizer/path/costsize.c](), функция cost\_sort.
[^internal-ru-496-1]: [backend/utils/sort/tuplesort.c](), функция tuplesort\_merge\_order.
[^internal-ru-496-2]: [backend/utils/sort/logtape.c]().
[^internal-ru-496-3]: *Дональд Кнут*. Искусство программирования. Т. 3: Сортировка и поиск.
[^internal-ru-498-1]: [backend/optimizer/path/costsize.c](), функция cost\_sort.
[^internal-ru-498-2]: [backend/optimizer/path/costsize.c](), функция relation\_byte\_size.
[^internal-ru-499-1]: [backend/executor/nodeIncrementalSort.c]().
[^internal-ru-499-2]: [backend/utils/sort/tuplesort.c]().
[^internal-ru-501-1]: [backend/optimizer/path/costsize.c](), функция cost\_incremental\_sort.
[^internal-ru-501-2]: [backend/utils/adt/selfuncs.c](), функция estimate\_num\_groups.
[^internal-ru-501-3]: [backend/executor/nodeGatherMerge.c]().
[^internal-ru-501-4]: [backend/lib/binaryheap.c]().
[^internal-ru-502-1]: [backend/optimizer/path/costsize.c](), функция cost\_gather\_merge.
[^internal-ru-504-1]: [backend/executor/nodeUnique.c]().
[^internal-ru-504-2]: [backend/executor/nodeAgg.c](), функция agg\_retrieve\_direct.