22 Хеширование
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
22.1. Соединение хешированием
Однопроходное соединение хешированием
Идея соединения хешированием состоит в поиске подходящих строк с помощью заранее подготовленной хеш-таблицы. Вот пример плана, использующего такое соединение:
На первом этапе узел Hash Join 1 обращается к узлу Hash2. Тот получает от своего дочернего узла весь внутренний набор строк и помещает его в хеш-таблицу.
Хеш-таблица позволяет сохранять пары, составленные из ключа хеширования и значения, а затем искать значения по ключу за фиксированное время, не зависящее от размера хеш-таблицы. Для этого ключи хеширования распределяются более или менее равномерно по ограниченному количеству корзин (bucket). Номер корзины хеш-таблицы определяется значением хеш-функции от ключа хеширования; поскольку число корзин всегда является степенью двойки, из вычисленного значения берется нужное количество двоичных разрядов.
Реализация использует динамически расширяемую хеш-таблицу с разрешением коллизий с помощью цепочек3, как для буферного кеша. (с. 190)
Итак, на первом этапе последовательно читаются строки внутреннего набора, и для каждой из них вычисляется хеш-функция. Ключом хеширования в данном случае являются поля, участвующие в условии соединения (Hash Cond), а в самой хеш-таблице сохраняются все поля строки из внутреннего набора, необходимые для запроса.
Наиболее эффективно — за один проход по данным — соединение хешированием работает, если хеш-таблица целиком помещается в оперативную память. Отведенный ей размер ограничен значением work_mem × × hash_mem_multiplier. (v. 13) (по умолчанию: 4MB) (по умолчанию: 2.0)
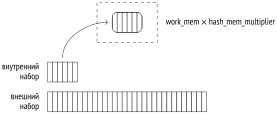
Вот пример, в котором запрос выполнен с помощью команды EXPLAIN ANALYZE, чтобы получить информацию об использовании памяти:
В отличие от соединения вложенным циклом, для которого внутренний и внешний наборы существенно различаются, соединение на основе хеширования позволяет переставлять наборы местами. Как правило, в качестве внутреннего используется меньший набор, поскольку и хеш-таблица в таком случае получается меньше.
Здесь объема памяти хватило для размещения всей хеш-таблицы, которая занимает около 143 Мбайт (Memory Usage) и содержит 4 М = 222 корзин (Buckets). Поэтому соединение выполняется за один проход (Batches).
Однако если бы в запросе использовался один столбец, то для хеш-таблицы хватило бы 111 Мбайт:
Это еще одна причина не использовать в запросах лишние поля, в том числе «звездочку».
Количество корзин хеш-таблицы выбирается так, чтобы в полностью заполненной данными таблице каждая корзина содержала в среднем одну строку. Более плотное заполнение повысило бы вероятность хеш-коллизий и, следовательно, снизило бы эффективность поиска, а более разреженная хеш-таблица слишком неэкономно расходовала бы память. Рассчитанное количество корзин увеличивается до первой подходящей степени двойки4.
(Если, исходя из оценки средней «ширины» одной строки, размер хеш-таблицы с расчетным количеством корзин превышает ограничение по памяти, используется двухпроходное хеширование.)
Пока хеш-таблица не построена полностью, соединение хешированием не может начать возвращать результаты.
На втором этапе (хеш-таблица к этому моменту уже готова) узел Hash Join обращается ко второму дочернему узлу за внешним набором строк. Для каждой прочитанной строки проверяется наличие соответствующих ей строк в хеш-таблице. Для этого хеш-функция вычисляется от значений полей внешнего набора, входящих в условие соединения.
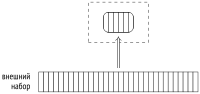
Найденные соответствия возвращаются вышестоящему узлу.
Оценка стоимости. Оценку кардинальности я уже рассматривал, и она не зависит от способа соединения, поэтому дальше я буду говорить только об оценке стоимости. (с. 444)
В качестве стоимости узла Hash берется полная стоимость его дочернего узла. Это фиктивная цифра, просто чтобы было что показать в плане запроса5. Все реальные оценки включены в стоимость узла Hash Join6.
Рассмотрим пример:
Начальная стоимость соединения отражает в основном создание хеш-таблицы и складывается:
из полной стоимости получения внутреннего набора строк, который необходим для построения хеш-таблицы;
стоимости вычисления хеш-функции от всех полей, входящих в ключ соединения, для каждой строки внутреннего набора (одна операция оценивается значением параметра cpu_operator_cost); (по умолчанию:
0.0025)стоимости вставки всех строк внутреннего набора в хеш-таблицу (вставка отдельной строки оценивается значением параметра cpu_tuple_cost); (по умолчанию:
0.01)начальной стоимости получения внешнего набора строк, без которого нельзя приступить к выполнению соединения.
Полная стоимость добавляет к начальной оценке стоимость собственно соединения:
стоимость вычисления хеш-функции от всех полей, входящих в ключ соединения, для каждой строки внешнего набора (cpu_operator_cost);
стоимость перепроверок условий соединения, которые необходимы из-за возможных хеш-коллизий (вычисление каждого оператора оценивается значением параметра cpu_operator_cost);
стоимость обработки каждой результирующей строки (cpu_tuple_cost).
Наиболее сложной частью оценки здесь является определение количества перепроверок, которые потребуются в ходе соединения. Оно оценивается произведением числа строк внешнего набора на некоторую долю числа строк внутреннего набора (находящегося в хеш-таблице). Оценка этой доли учитывает в том числе и возможное неравномерное распределение значений. Я не буду вдаваться в подробности 7; в данном случае эта доля оценивается как 0,150112.
Итак, для нашего примера оценка вычисляется следующим образом:
Схему зависимостей расчета стоимости можно представить так:
Двухпроходное соединение хешированием
Если на этапе планирования оценки показывают, что хеш-таблица не поместится в отведенные рамки, внутренний набор строк разбивается на отдельные пакеты (batch), каждый из которых обрабатывается отдельно. Количество пакетов (как и корзин) всегда является степенью двойки; номер пакета определяется соответствующим количеством битов хеш-значения8.
Любые две строки, соответствующие друг другу при соединении, принадлежат одному и тому же пакету, поскольку у строк из разных пакетов не могут совпасть хеш-коды.
К каждому пакету относится одинаковое количество хеш-значений. Если данные распределены равномерно, то и размеры всех пакетов будут примерно одинаковыми. Планировщик может управлять потреблением памяти, выбирая подходящее количество пакетов9.
На первом этапе выполнения читается внутренний набор строк и строится хеш-таблица. Если очередная строка внутреннего набора относится к первому пакету, она добавляется к хеш-таблице и остается в оперативной памяти. Если же строка относится к какому-либо другому пакету, она записывается во временный файл — свой для каждого из пакетов10. (по умолчанию: -1)
Напомню, что объем используемых сеансом временных файлов на диске можно ограничить, установив предельное значение в параметре temp_file_limit (временные таблицы в это ограничение не входят). Если сеанс исчерпает ограничение, запрос будет
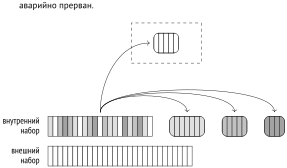
На втором этапе читается внешний набор строк. Если очередная строка принадлежит первому пакету, она сопоставляется с хеш-таблицей, которая как раз содержит строки первого пакета внутреннего набора (а в других пакетах соответствий быть не может).
Если же строка принадлежит другому пакету, она сбрасывается во временный файл — опять же свой для каждого пакета. Таким образом, при N пакетах будет использоваться 2 (N − 1) файлов (или меньше, если некоторые пакеты окажутся пустыми).
После окончания второго этапа память, занимаемая хеш-таблицей, освобождается. На этот момент уже имеется частичный результат соединения по одному из имеющихся пакетов.
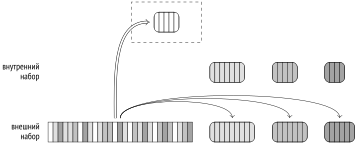
Далее оба этапа повторяются поочередно для каждого из сохраненных на диск пакетов: из временного файла в хеш-таблицу переносятся строки внутреннего набора; строки внешнего набора, соответствующие этому же пакету, считываются из другого временного файла и сопоставляются с хеш-таблицей. Использованные временные файлы удаляются.
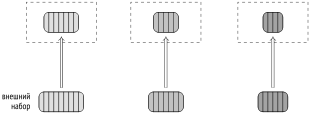
Двухпроходное соединение в выводе команды EXPLAIN отличается от однопроходного количеством пакетов, большим единицы. Кроме того, с ключевым словом buffers команда покажет статистику обмена с диском:
Я уже приводил этот пример выше, но с увеличенным значением work_mem. В отведенные по умолчанию 8 Мбайт вся хеш-таблица не помещается; здесь задействовано 32 пакета, хеш-таблица использует 128 K = 217 корзин. На этапе построения хеш-таблицы (узел Hash) выполняется запись во временные файлы; на этапе соединения (узел Hash Join) файлы и записываются, и читаются.
Параметр log_temp_files позволяет получать более детальную информацию о временных файлах в журнале сообщений сервера. При нулевом значении в журнале будет отмечен каждый файл и его размер (на момент удаления). (по умолчанию: -1)
Динамические корректировки плана
Запланированный ход событий могут нарушить две проблемы: некорректная статистика и неравномерное распределение.
При неравномерном распределении значений в столбцах, входящих в ключ соединения, разные пакеты будут иметь разное количество строк.
Если какой-нибудь пакет (кроме самого первого) окажется большим, все его строки придется сначала записать на диск, а затем прочитать с диска. В основном неприятность доставляет внешний набор данных, потому что обычно он больше. Поэтому если для внешнего набора строк доступна обычная, не многовариантная статистика по наиболее частым значениям (то есть внешний набор представлен таблицей и соединение выполняется по одному столбцу), то строки с хеш-кодами, соответствующими нескольким наиболее частым значениям, считаются принадлежащими первому пакету11. Эта оптимизация (skew optimization) позволяет несколько уменьшить ввод-вывод при двухпроходном соединении. (с. 369)
Обе проблемы могут привести к тому, что размер некоторых (или всех) пакетов окажется больше расчетного. Тогда хеш-таблица для них не поместится в запланированный размер и выйдет за рамки ограничений.
Поэтому если в процессе построения хеш-таблицы выясняется, что ее размер не укладывается в ограничения, количество пакетов увеличивается (удваивается) на лету. Фактически каждый пакет разделяется на два новых: примерно половина строк (если предполагать равномерное распределение) остается в хеш-таблице, а другая половина сбрасывается на диск в новый временный файл12.
Это может произойти и в том случае, когда планировалось однопроходное соединение. По сути, одно- и двухпроходное соединения — один и тот же алгоритм, реализуемый одним и тем же кодом. Я разделяю их только для удобства изложения.
Количество пакетов может только увеличиваться. Если оказывается, что планировщик ошибся в бóльшую сторону, пакеты не объединяются.
Однако при неравномерном распределении увеличение числа пакетов может не помочь. Например, ключевой столбец может содержать одно и то же значение во всех строках: очевидно, что все они попадут в один пакет, поскольку хеш-функция будет возвращать одно и то же значение. Увы, в таком случае хеш-таблица будет просто расти, невзирая на значения ограничивающих параметров.
Теоретически для такой ситуации можно было бы применить многопроходное соединение, рассматривая за один раз только часть пакета, но это не реализовано.
Для демонстрации динамического увеличения количества пакетов придется приложить некоторые усилия, чтобы обмануть планировщик. (с. 349)
В результате этих манипуляций мы получили таблицу bookings_copy — полную копию bookings, но планировщик считает, что в ней в десять раза меньше строк, чем на самом деле. В реальности похожая ситуация может возникнуть, например, когда хеш-таблица строится по набору строк, полученному в результате другого соединения, для которого в таком случае нет достоверной статистики.
Из-за этой ошибки планировщик полагает, что будет достаточно 4 пакетов, но в процессе выполнения соединения их число возрастает до 16:
Оценка стоимости. Вот тот же пример, на котором я показывал расчет стоимости для однопроходного соединения, но теперь я предельно уменьшаю размер доступной памяти, и планировщик вынужден использовать два пакета. Стоимость соединения при этом увеличивается:
Расходы второго прохода связаны с записью строк во временные файлы и чтением их из файлов.
Начальная стоимость, рассчитанная для однопроходного соединения, увеличивается в этом случае на оценку записи такого количества страниц, которого хватит для сохранения нужных полей 13 всех строк внутреннего набора. Хотя первый пакет и не записывается на диск при построении хеш-таблицы, это не учитывается в оценке, поэтому она не зависит от количества пакетов.
Полная стоимость увеличивается на оценку чтения записанных ранее строк внутреннего набора и оценку записи и чтения строк внешнего набора.
Как запись, так и чтение одной страницы оцениваются значением параметра seq_page_cost, исходя из последовательного характера ввода-вывода.
В данном примере количество страниц для строк внутреннего набора оценено как 7, а для внешнего — как 2309. Добавив оценки к стоимости, которая была получена выше для однопроходного соединения, получаем цифры, совпадающие со стоимостью в плане запроса:
Таким образом, при нехватке оперативной памяти алгоритм соединения становится двухпроходным, и эффективность его падает. Поэтому важно, чтобы:
в хеш-таблицу попадали только действительно нужные поля (обязанность автора запроса);
хеш-таблица строилась по меньшему набору строк (обязанность планировщика).
Соединение хешированием в параллельных планах
Соединение хешированием может участвовать в параллельных планах в том виде, в котором я описывал его выше. Это означает, что сначала несколько параллельных процессов независимо друг от друга строят собственные (совершенно одинаковые) хеш-таблицы по внутреннему набору данных, а затем используют параллельный доступ к внешнему набору строк. Выигрыш здесь достигается за счет того, что каждый из процессов просматривает только часть внешнего набора.
Вот пример плана с участием обычного (в данном случае однопроходного) соединения хешированием:
Здесь каждый процесс хеширует таблицу bookings, а затем сопоставляет с хеш-таблицей свою часть строк, полученную параллельным сканированием (Parallel Seq Scan).
Ограничение на память под хеш-таблицу применяется к каждому параллельному процессу, так что суммарно будет выделено в три раза больше памяти, чем это указано в плане (Memory Usage).
Параллельное однопроходное хеш-соединение
Несмотря на то что и обычное соединение хешированием может давать определенную выгоду в параллельных планах (особенно в случае небольшого внутреннего набора, который нет смысла обрабатывать параллельно), для больших наборов данных лучше работает специальный параллельный алгоритм хеш-соединения.
Важное отличие от непараллельной версии алгоритма состоит в том, что хеш-таблица создается не в локальной памяти процесса, а в общей динамически выделяемой памяти и доступна каждому параллельному процессу, участвующему в соединении. Это позволяет вместо нескольких отдельных хеш-таблиц создать одну общую, используя суммарный объем памяти, выделяемый всем процессам-участникам. Благодаря этому увеличивается вероятность выполнения соединения за один проход.
На первом этапе, представляемом в плане узлом Parallel Hash, все параллельные процессы строят общую хеш-таблицу, используя параллельный доступ к внутреннему набору строк14.
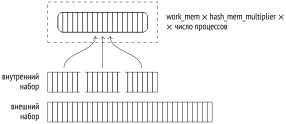
Чтобы можно было двигаться дальше, каждый из параллельных процессов должен завершить свою часть первого этапа15.
На втором этапе (узел Parallel Hash Join), когда хеш-таблица построена, каждый процесс сопоставляет с ней свою часть строк внешнего набора, используя параллельный доступ16.
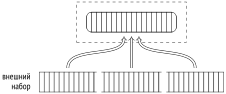
Вот пример такого плана:
Это тот же запрос, что я показывал в предыдущем разделе, но там параллельная версия хеш-соединения была специально отключена параметром enable_parallel_hash. (по умолчанию: on)
Несмотря на то что я уменьшил объем памяти под хеш-таблицу вдвое по сравнению с обычным хеш-соединением из предыдущего раздела, соединение осталось однопроходным за счет совместного использования памяти всех параллельных процессов (Memory Usage). Хеш-таблица немного выросла, но существует теперь в единственном экземпляре, так что суммарное использование памяти уменьшилось.
Параллельное двухпроходное хеш-соединение
Даже совместной памяти всех параллельных процессов может не хватить для размещения всей хеш-таблицы. Это может стать понятно как на этапе планирования, так и позже, во время выполнения. В таком случае используется двухпроходный алгоритм, который существенно отличается от всех уже рассмотренных.
Важное отличие состоит в том, что используется не одна большая общая хеш-таблица, а несколько таблиц меньшего размера. Каждый процесс работает со своей таблицей и обрабатывает пакеты независимо от других процессов. (Однако отдельные хеш-таблицы тоже располагаются в общей памяти, так что доступ к ним может получить любой процесс.) Если уже на этапе планирования становится ясно, что одним пакетом не обойтись17, для каждого процесса сразу создается своя хеш-таблица. Если решение принимается во время выполнения, таблица перестраивается18.
Итак, на первом этапе процессы параллельно читают внутренний набор строк, разделяя его на пакеты и записывая эти пакеты во временные файлы19. Поскольку каждый процесс читает только свою часть строк внутреннего набора, ни один из них не построит полную хеш-таблицу ни для одного из пакетов (даже для первого). Полный набор строк любого пакета собирается только в файле, запись в который ведут все параллельные процессы, синхронизируясь друг с другом20. Поэтому, в отличие от непараллельной версии алгоритма и от параллельной однопроходной версии, в данном случае на диск сбрасываются все пакеты, в том числе и первый.
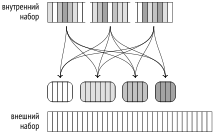
Когда все процессы закончили хеширование внутреннего набора, начинается второй этап21.
В случае непараллельной версии алгоритма строки внешнего набора, относящиеся к первому пакету, сразу же сопоставлялись бы с хеш-таблицей. Но в параллельной версии готовой хеш-таблицы еще нет в памяти, и пакеты обрабатываются процессами независимо. Поэтому в начале второго этапа внешний набор строк читается параллельно, распределяется по пакетам, и каждый пакет записывается в свой временный файл22. Прочитанные строки не попадают в хеш-таблицу (как это происходит на первом этапе), так что увеличение количества пакетов невозможно.
Когда все процессы закончили чтение внешнего набора данных, на диске оказывается 2N временных файлов, содержащих пакеты внутреннего и внешнего наборов.
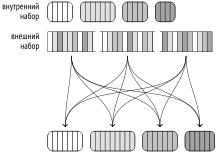
Затем каждый процесс выбирает один из пакетов и выполняет соединение: загружает внутренний набор строк в свою хеш-таблицу в памяти, читает строки внешнего набора и сопоставляет их со строками в хеш-таблице. Завершив обработку одного пакета, процесс выбирает следующий, еще не обработанный23.
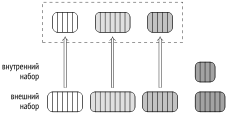
Когда необработанные пакеты заканчиваются, освободившийся процесс подключается к обработке одного из еще не завершенных пакетов, пользуясь тем, что все хеш-таблицы находятся в разделяемой памяти.
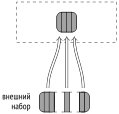
Такая схема работает лучше, чем одна большая хеш-таблица, общая для всех процессов: проще организовать совместную работу, меньше ресурсов тратится на синхронизацию.
Модификации
Алгоритм соединения хешированием может использоваться не только для внутренних, но и для любых других типов соединений: левых, правых и полных внешних соединений, для полу- и антисоединений. Однако, повторюсь, в качестве условия соединения допускается только равенство.
Часть операций я уже показывал, когда говорил о соединении вложенным циклом. Вот пример правого внешнего соединения: (с. 451)
Обратите внимание, как логическая операция левого соединения в SQL-запросе превратилась в физическую операцию правого соединения в плане выполнения.
На логическом уровне внешней таблицей (стоящей слева от операции соединения) являются бронирования (bookings), а внутренней — таблица билетов (tickets). Поэтому в результат соединения должны попасть в том числе и бронирования без билетов.
На физическом уровне внешний и внутренний наборы данных определяются не по положению в тексте запроса, а исходя из стоимости соединения. Обычно это означает, что внутренним набором будет тот, чья хеш-таблица меньше. Так происходит и здесь: в качестве внутреннего набора выступает таблица бронирований, и вид соединения меняется с левого на правый.
И наоборот, если в запросе указать правое внешнее соединение (желая вывести билеты, не связанные с бронированиями), то в плане выполнения соединение поменяется на левое:
Для полноты картины — пример плана с полным внешним соединением:
Параллельное соединение хешированием поддерживается для всех видов соединений: не только для внутренних и внешних левых, но также и для правых и полных. В следующем примере планировщик отдает предпочтение правому соединению, чтобы построить хеш-таблицу меньшего размера: (v. 16)
22.2. Группировка и уникальные значения
Группировка значений для агрегации и устранение дубликатов могут выполняться алгоритмами, схожими с алгоритмами соединения. Один из способов состоит в том, чтобы построить хеш-таблицу по нужным столбцам.
Значения помещаются в хеш-таблицу, только если они отсутствуют в ней. Таким образом, в конечном итоге в хеш-таблице собираются все уникальные значения.
Узел, который отвечает за агрегацию методом хеширования, обозначается в плане выполнения как HashAggregate24.
Приведу несколько примеров ситуаций, в которых может использоваться такой узел.
Количество мест для каждого класса обслуживания (GROUP BY):
Список классов обслуживания (DISTINCT):
Классы обслуживания и еще одно значение (UNION):
Узел Append соответствует объединению двух наборов строк, но не удаляет дубликаты, как того требует операция UNION. Удаление выполняется отдельно узлом HashAggregate.
Память, выделяемая под хеш-таблицу, ограничена значением work_mem × × hash_mem_multiplier, как и в случае хеш-соединения. (по умолчанию: 4MB) (по умолчанию: 2.0)
Если хеш-таблица помещается в отведенную память, агрегация выполняется за один проход по набору строк, как в этом примере:
Уникальных значений стоимости не так много, поэтому хеш-таблица заняла всего 45 Кбайт (Memory Usage).
Как только во время построения хеш-таблицы новые значения перестают помещаться в отведенный объем, они сбрасываются во временные файлы, распределяясь по разделам на основании нескольких битов хеш-значения. Количество разделов является степенью двойки и выбирается планировщиком так, чтобы хеш-таблица для каждого из них поместилась целиком в оперативную память. Конечно, эта оценка зависит от качества статистики, поэтому расчетное значение умножается на полтора, чтобы дополнительно уменьшить размер разделов и увеличить вероятность того, что каждый из них можно будет обработать за один раз25. (v. 13)
После того как весь набор данных прочитан, узел возвращает результаты агрегации по тем значениям, которые попали в хеш-таблицу.
Затем хеш-таблица очищается, и каждый из разделов, записанных на предыдущем шаге во временные файлы, читается и обрабатывается точно так же, как обычный набор строк. При неудачном стечении обстоятельств хеш-таблица раздела может снова не поместиться в память; тогда «лишние» строки опять будут разбиты на разделы и записаны на диск для последующей обработки.
Рассмотрим другой пример. Здесь количество уникальных идентификаторов слишком велико, чтобы хеш-таблица поместилась в память целиком, поэтому планируется использовать четыре раздела:
В процессе выполнения запроса потребовалось пять итераций: одна по начальному набору данных и еще четыре по каждому из записанных на диск разделов.
В двухпроходном алгоритме соединения хешированием наиболее частые значения специальным образом перемещаются в первый пакет, для того чтобы избежать лишнего ввода-вывода. Для агрегации такая оптимизация не нужна, поскольку на разделы разбиваются не все строки, а только те, которым не хватило отведенной памяти. Частые значения с большой вероятностью встретятся в наборе строк достаточно рано, чтобы успеть занять место.
backend/executor/nodeHash.c, функция ExecChooseHashTableSize. ↩︎
backend/optimizer/plan/createplan.c, функция create_hashjoin_plan. ↩︎
backend/optimizer/path/costsize.c, функции initial_cost_hashjoin и final_cost_hashjoin. ↩︎
backend/utils/adt/selfuncs.c, функция estimate_hash_bucket_stats. ↩︎
backend/executor/nodeHash.c, функция ExecHashGetBucketAndBatch. ↩︎
backend/executor/nodeHash.c, функция ExecChooseHashTableSize. ↩︎
backend/executor/nodeHash.c, функция ExecHashTableInsert. ↩︎
backend/executor/nodeHash.c, функция ExecHashBuildSkewHash. ↩︎
backend/executor/nodeHash.c, функция ExecHashIncreaseNumBatches. ↩︎
backend/optimizer/path/costsize.c, функция page_size. ↩︎
backend/executor/nodeHash.c, функция MultiExecParallelHash. ↩︎
backend/executor/nodeHashjoin.c, функция ExecParallelHashJoin. ↩︎
backend/executor/nodeHash.c, функция ExecChooseHashTableSize. ↩︎
backend/executor/nodeHash.c, функция ExecParallelHashIncreaseNumBatches. ↩︎
backend/executor/nodeHash.c, функция MultiExecParallelHash. ↩︎
backend/executor/nodeHashjoin.c, функция ExecParallelHashJoin. ↩︎
backend/executor/nodeHashjoin.c, функция ExecParallelHashJoinPartitionOuter. ↩︎
backend/executor/nodeHashjoin.c, функция ExecParallelHashJoinNewBatch. ↩︎
backend/executor/nodeAgg.c, функция hash_choose_num_partitions. ↩︎