20 Индексное сканирование
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
20.1. Простое индексное сканирование
Существует два базовых варианта работы с идентификаторами версий строк, поставляемыми индексом. Первый из них — индексное сканирование. Большинство индексных методов (но не все) обладают свойством INDEX SCAN и поддерживают этот способ. (с. 409)
Операция представляется в плане запроса узлом Index Scan 1:
При индексном сканировании метод доступа возвращает идентификаторы версий строк по одному за раз2. Механизм индексирования получает очередной идентификатор, обращается к табличной странице, на которую он указывает, получает версию строки и, если она удовлетворяет правилам видимости, возвращает необходимый набор полей. Процесс продолжается, пока у метода доступа не закончатся идентификаторы, подходящие под условия запроса.
В строке Index Cond указываются только те условия, которые могут быть проверены с помощью индекса. Дополнительные условия, требующие перепроверки по таблице, отображаются отдельно в строке Filter.
Таким образом, обращения к индексу и к таблице не выделены в два отдельных узла плана, а выполняются в общем узле Index Scan. Хотя и существует специальный узел Tid Scan3, читающий из таблицы версии строк по известным идентификаторам:
Оценка стоимости
Оценка индексного сканирования складывается из оценки доступа к индексу и оценки чтения табличных страниц.
Очевидно, что индексная часть оценки полностью зависит от конкретного метода доступа. В случае B-дерева основные расходы приходятся на чтение индексных страниц и обработку строк в этих страницах. Сколько именно страниц и строк будет прочитано, можно определить, зная общий объем данных и селективность условий. Доступ к индексной странице носит случайный характер (страницы, соседствующие друг с другом логически, физически могут располагаться непредсказуемым образом). К оценкам также добавляются ресурсы процессора на спуск от корня до листовой страницы и на вычисление необходимых выражений 4. (с. 335)
Табличная часть оценки учитывает стоимость доступа к страницам и процессорное время на обработку всех прочитанных версий. Важно, что оценка ввода-вывода зависит не только от селективности индексного доступа, но и от корреляции физического расположения версий строк на диске с тем порядком, в котором метод доступа выдает их идентификаторы.
Хороший случай: высокая корреляция
Если физический порядок версий на диске идеально коррелирует с логическим порядком идентификаторов в индексе, то, читая версии строк одну за другой, узел Index Scan будет последовательно переходить от страницы к странице и обратится к каждой из них только один раз.
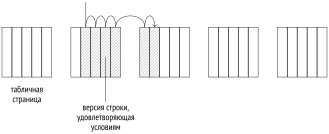
Информация о корреляции собирается как часть статистики: (с. 361)
Значения, близкие по модулю к единице (как для столбца book_ref), говорят о высокой упорядоченности, а близкие к нулю — наоборот, о хаотичном распределении.
В данном случае высокая корреляция для столбца book_ref вызвана, конечно, тем, что данные были загружены в таблицу в порядке возрастания значений этого столбца и не изменялись. К такой же картине приведет выполнение команды CLUSTER для индекса по этому столбцу.
Но даже наличие полной корреляции не дает никаких гарантий, что любой запрос будет возвращать данные именно в порядке возрастания book_ref. Во-первых, изменение любой строки приведет к перемещению актуальной версии строки в конец
таблицы. Во-вторых, план, использующий индексный доступ по какому-либо другому столбцу, выдаст данные в другом порядке. И даже последовательное сканирование может начаться не с начала таблицы. Поэтому если требуется определенный порядок, его необходимо указать в предложении ORDER BY.
Вот пример индексного сканирования большого количества строк: (с. 198)
Селективность условия по оценке планировщика составляет:
Это близко к оценке , которую можно дать из общих соображений, зная диапазон значений book_ref от 000000 до FFFFFF. (с. 357)
Индексная часть оценки ввода-вывода для B-дерева учитывает стоимость чтения необходимого количества страниц. Индексные строки, соответствующие любому условию, которое поддерживается B-деревом, упорядочены и находятся в логически связанных листовых страницах, поэтому количество прочитанных индексных страниц оценивается произведением размера индекса на селективность. Но физически эти страницы не упорядочены, поэтому чтение носит случайный характер.
Ресурсы процессора тратятся на обработку всех прочитанных индексных строк (стоимость обработки одной строки оценивается значением параметра cpu_index_tuple_cost) и вычисление условия для каждой из этих строк (в данном случае условие содержит один оператор; стоимость его вычисления оценивается значением параметра cpu_operator_cost). (по умолчанию: 0.005) (по умолчанию: 0.0025)
Табличный ввод-вывод рассматривается как последовательное чтение необходимого количества страниц. При идеальной корреляции табличные версии строк будут физически соседствовать друг с другом, поэтому количество страниц оценивается произведением размера таблицы на селективность.
К стоимости ввода-вывода добавляются затраты на обработку всех прочитанных версий строк; стоимость обработки одной версии оценивается значением параметра cpu_tuple_cost. (по умолчанию: 0.01)
Формула показывает логику вычисления стоимости, и результат хорошо соответствует оценке планировщика, хотя и не является точным. Получение точного значения потребовало бы учета деталей, на которых мы не будем останавливаться.
Плохой случай: низкая корреляция
Ситуация с доступом к таблице меняется, когда корреляция оказывается низкой. Создадим индекс по столбцу book_date, имеющему практически нулевую корреляцию с индексом, и посмотрим на запрос, выбирающий приблизительно ту же долю строк, что и в предыдущем примере. Индексный доступ оказывается настолько дорогим, что планировщик выбирает его, только если запретить ему все альтернативы:
Дело в том, что чем ниже корреляция, тем выше вероятность того, что следующая версия строки, идентификатор которой выдает метод доступа, окажется на другой странице. Поэтому вместо последовательного чтения узел Index Scan «скачет» со страницы на страницу, а количество обращений к страницам в предельном случае может достигать количества выбираемых версий строк.
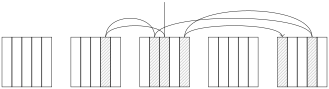
Однако было бы некорректным просто заменить в приведенной выше формуле seq_page_cost на random_page_cost, а relpages — на reltuples. Стоимость, которую мы видим в плане, на порядок меньше полученной таким образом оценки:
Дело в том, что модель дополнительно учитывает эффект кеширования. Часто используемые страницы задерживаются в буферном кеше (и в кеше операционной системы), поэтому чем больше кеш, тем больше вероятность найти нужную страницу в нем и избежать дисковой операции. Для целей планирования размер кеша определяется значением параметра effective_cache_size. Чем оно меньше, тем выше оценка количества страниц, которые придется прочитать. (по умолчанию: 4GB)
График показывает зависимость оценки количества прочитанных страниц от размера таблицы (для селективности и случая, когда на странице помещается десять строк)5.
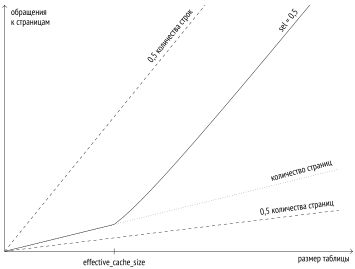
Пунктиром на графике показано количество обращений, равное половине количества страниц (лучший теоретически возможный случай при идеальной корреляции) и половине количества строк (худший случай при нулевой корреляции и отсутствии кеша).
Предполагается, что значение параметра effective_cache_size должно соответствовать общему объему памяти, доступному для кеширования (включая и буферный кеш PostgreSQL, и кеш ОС). Но поскольку параметр служит только для оценки и не приводит к реальному выделению памяти, при необходимости его можно изменять и без оглядки на реальные цифры.
Установив минимальное значение параметра, получим оценку плана, близкую к наихудшей, вычисленной выше без учета эффекта кеширования:
Стоимость табличного ввода-вывода вычисляется для двух рассмотренных случаев — хорошего и плохого, а затем берется промежуточное значение в зависимости от реальной корреляции6.
Итак, индексное сканирование эффективно, когда требуется прочитать некоторую часть строк таблицы. Если расположение версий строк в таблице коррелирует с порядком, в котором метод доступа выдает идентификаторы, эта часть может быть весьма существенной. Если же корреляция слабая, то с уменьшением селективности индексный доступ очень быстро теряет свою привлекательность.
20.2. Сканирование только индекса
Индекс, содержащий все данные из таблицы, необходимые для выполнения запроса, называется покрывающим (covering) для данного запроса. При наличии покрывающего индекса можно избежать лишних обращений к таблице, получая от метода доступа не идентификаторы версий строк, а сами данные. Такая вариация индексного сканирования называется сканированием только индекса7. Она может использоваться теми методами доступа, которые поддерживают свойство RETURNABLE. (с. 411)
Операция представляется в плане запроса узлом Index Only Scan 8:
Название может навести на мысль, что узел Index Only Scan никогда не обращается к таблице, но это не так. Индексы в PostgreSQL не содержат информации, позволяющей судить о видимости строк, поэтому метод доступа возвращает данные из всех версий, попадающих под условие поиска, независимо от того, видны они текущей транзакции или нет. Видимость затем проверяется механизмом индексирования. (с. 89)
Но если бы приходилось каждый раз заглядывать в таблицу для определения видимости, этот метод сканирования ничем не отличался бы от обычного индексного сканирования. Проблема решается тем, что PostgreSQL поддерживает для таблиц карту видимости, в которой процесс очистки отмечает страницы, содержащие только такие версии строк, которые видны всем транзакциям, независимо от их снимков. Если идентификатор версии строки, возвращенный индексным методом, относится к такой странице, то видимость версии можно не проверять. (с. 32)
На оценку сканирования только индекса влияет доля табличных страниц, отмеченных в карте видимости. Эта информация входит в собираемую статистику:
Оценка стоимости сканирования только индекса отличается от оценки обычного индексного сканирования тем, что стоимость ввода-вывода, связанная с доступом к таблице, берется пропорционально доле страниц, не включенных в карту видимости. (Стоимость обработки версий строк процессором остается без изменений.)
Поскольку в данном примере все версии строк на всех страницах видны всем транзакциям, фактически из оценки стоимости полностью исключается стоимость табличного ввода-вывода:
Наличие изменений, еще не попавших за горизонт базы данных и не обработанных очисткой, увеличивает оценку стоимости плана (и, соответственно, уменьшает привлекательность плана для оптимизатора). Чтобы узнать реальное количество вынужденных обращений к таблице, можно использовать команду EXPLAIN ANALYZE. (с. 106)
В только что созданной таблице перепроверяется видимость всех версий:
Очистка создает карту видимости, и необходимость в проверке отпадает:
Include-индексы
Возможна ситуация, когда индекс нельзя расширить так, чтобы он содержал все необходимые запросу столбцы:
для уникального индекса добавление столбца не будет гарантировать уникальность исходных столбцов;
тип данных дополнительного столбца может не иметь класса операторов для индексного метода доступа.
В этом случае можно добавить к индексу столбцы, не делая их частью индексного ключа. Поиск по дополнительным столбцам, конечно, будет невозможен, но для запросов, включающих эти столбцы, индекс сможет работать как покрывающий.
Пример показывает замену индекса, автоматически созданного для поддержки первичного ключа, на другой, с дополнительным столбцом:
Очень часто покрывающими называют именно такие include-индексы, но это неверно. Индекс является покрывающим, если его набор столбцов покрывает столбцы, необходимые для конкретного запроса. Используются ли при этом ключевые поля или поля, добавленные с помощью предложения INCLUDE, — не играет никакой роли. Более того, один и тот же индекс может быть покрывающим для одного запроса и не быть таковым для другого.
20.3. Сканирование по битовой карте
При индексном сканировании уменьшение корреляции увеличивает количество обращений к страницам и меняет характер чтения с последовательного на случайный. Это ограничение можно преодолеть, получив перед обращением к таблице все идентификаторы и расположив их в порядке возрастания номеров страниц9. Именно так устроен второй базовый способ работы с идентификаторами — сканирование по битовой карте. Его могут использовать методы доступа, поддерживающие свойство BITMAP SCAN. (с. 409)
В отличие от обычного индексного сканирования, операция представляется в плане запроса двумя узлами:
Узел Bitmap Index Scan 10 обращается к методу доступа за битовой картой всех идентификаторов версий строк11.
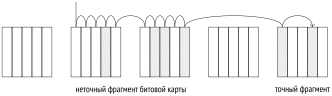
Битовая карта состоит из фрагментов, каждый из которых соответствует одной табличной странице. Все фрагменты имеют одинаковый размер, достаточный для того, чтобы охватить все версии на странице, сколько бы их ни было. Это количество ограничено из-за довольно крупного заголовка; на странице стандартного размера помещается не больше 256 версий, для представления которых хватает 32 байт12.
Узел Bitmap Heap Scan 13 затем просматривает битовую карту фрагмент за фрагментом, читает соответствующую очередному фрагменту страницу и проверяет на этой странице все версии строк, отмеченные в битовой карте. Таким образом, страницы читаются в порядке возрастания номеров, и каждая — только один раз.
Поскольку список необходимых страниц известен уже на этапе построения битовой карты, сканирование задействует асинхронный ввод-вывод. Не все операции будут многоблочными, из-за того что нужные страницы не всегда располагаются подряд друг за другом, но в любом случае асинхронная предвыборка значительно повышает эффективность этого метода доступа. (с. 183)
Точность карты
Чем больше страниц охвачено версиями строк, соответствующих условию запроса, тем больше места занимает битовая карта. Она строится в локальной памяти обслуживающего процесса и ограничена размером, указанным в параметре work_mem. Если при построении карты размер достигает предельного значения, некоторые фрагменты карты «загрубляются» таким образом, чтобы каждый бит фрагмента соответствовал целой странице, а сам фрагмент охватывал не одну страницу, а диапазон14. Это позволяет уменьшить размер битовой карты, пожертвовав при этом точностью. (по умолчанию: 4MB)
Команда EXPLAIN ANALYZE показывает точность построенной карты. В данном случае объема памяти хватило для точной (exact) битовой карты:
Если уменьшить значение work_mem, часть фрагментов карты будет храниться с потерей точности (lossy):
При чтении табличной страницы, соответствующей грубому фрагменту битовой карты, необходимо перепроверять условия выборки для каждой версии строки на странице. Условие перепроверки всегда отображается в плане как Recheck Cond — независимо от того, выполняется ли перепроверка на самом деле. А количество версий строк, отфильтрованных перепроверкой, показывается отдельно (Rows Removed by Index Recheck).
При очень большой выборке может получиться, что битовая карта, даже целиком состоящая из грубых фрагментов, все равно не помещается в память размером work_mem. В этом случае ограничение не соблюдается, и карта занимает столько места, сколько необходимо. Никакого дополнительного уменьшения точности или сброса части фрагментов на диск не предусмотрено.
Действия с битовыми картами
Если в запросе условия наложены на несколько полей таблицы и для этих полей созданы разные индексы, сканирование битовой карты позволяет использовать несколько индексов одновременно15. Для каждого из индексов строятся битовые карты версий строк, которые затем либо побитово логически умножаются (если выражения соединены условием AND), либо логически складываются (если выражения соединены условием OR).
Например:
Здесь узел BitmapAnd объединяет две битовые карты с помощью битовой операции «и».
При объединении двух битовых карт в одну 16 точные фрагменты остаются точными (если для новой карты хватает места work_mem в памяти), но если хотя бы один из фрагментов грубый, то и результирующий фрагмент тоже будет иметь низкую точность.
Оценка стоимости
Возьмем пример запроса со сканированием по битовой карте:
Здесь селективность условия по оценке планировщика равна примерно
Оценка полной стоимости узла Bitmap Index Scan вычисляется так же, как стоимость обычного индексного доступа без учета обращений к таблице:
Для узла Bitmap Heap Scan оценка ввода-вывода отличается от аналогичной оценки в случае простого индексного сканирования при идеальной корреляции. Битовая карта позволяет читать табличные страницы в порядке возрастания номеров и без повторных обращений, но версии строк, соответствующие условию, больше не располагаются по соседству друг с другом. Вместо строго последовательного компактного диапазона, скорее всего, потребуется прочитать намного больше страниц.
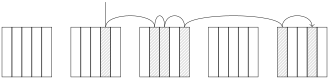
Количество прочитанных страниц оценивается формулой 17
а стоимость чтения одной страницы — значением от seq_page_cost до random_page_cost в зависимости от отношения числа прочитанных страниц к их общему количеству в таблице:
Как обычно, к оценке ввода-вывода добавляется оценка обработки каждой прочитанной узлом версии строки. При точной битовой карте количество строк оценивается произведением общего количества строк в таблице на селективность условий. Но когда некоторые фрагменты битовой карты неточны, приходится проверять все версии строк на соответствующих страницах. Поэтому в оценке учитывается предполагаемая доля неточных фрагментов битовой карты (которую можно посчитать, зная общее количество строк в выборке и ограничение на размер битовой карты work_mem)18.
К оценке также добавляется полная стоимость перепроверки условий (независимо от точности битовой карты).
В нашем примере битовая карта полностью точна, и оценка вычисляется примерно следующим образом 19:
Здесь оценка начальной стоимости узла Bitmap Heap Scan опирается на оценку полной стоимости узла Bitmap Index Scan, к которой добавляется стоимость работы с битовыми картами:
Если план запроса использует объединение нескольких битовых карт, сумма стоимостей доступа к отдельным индексам увеличивается на (небольшую) стоимость собственно объединения20.
20.4. Параллельные версии индексного сканирования
Все способы индексного сканирования — обычное, сканирование только индекса, сканирование по битовой карте — имеют версии для параллельных планов. (с. 379)
Стоимость параллельного выполнения оценивается аналогично последовательному, но (как и в случае параллельного последовательного сканирования) ресурсы процессора распределяются между всеми параллельными процессами, уменьшая итоговую стоимость. Составляющая ввода-вывода не распределяется, поскольку чтение страниц синхронизируется между процессами и происходит последовательно.
Дальше я просто покажу примеры параллельных планов без разбора оценок стоимости.
Параллельное индексное сканирование Parallel Index Scan:
При параллельном сканировании B-дерева в общей памяти сервера хранится номер текущей индексной страницы. Начальное значение устанавливается процессом, который начинает сканирование: он спускается от корня дерева к листовой странице и запоминает ее. Рабочие процессы обращаются по мере необходимости за следующей индексной страницей, изменяя сохраненный номер. Получив страницу, процесс обрабатывает все подходящие строки в ней и читает соответствующие версии строк из таблицы. Сканирование завершается, когда прочитан весь диапазон значений, удовлетворяющих условию запроса. (с. 524)
Параллельное сканирование только индекса Parallel Index Only Scan:
Параллельное сканирование только индекса отличается лишь тем, что не обращается к табличным страницам, если это позволяет карта видимости.
И наконец, параллельное сканирование по битовой карте:
При сканировании по битовой карте построение карты всегда выполняется последовательно, одним ведущим процессом; поэтому к названию узла Bitmap Index Scan не добавляется слово Parallel. Когда битовая карта готова, сканирование таблицы выполняется параллельно в узле Parallel Bitmap Heap Scan. Рабочие процессы обращаются за очередной табличной страницей и обрабатывают ее.
20.5. Сравнение методов доступа
График зависимости стоимости различных методов доступа от селективности условий показан на следующей странице. Он имеет качественный характер; конкретные числа, разумеется, будут зависеть от таблицы и от параметров сервера.
Последовательное сканирование не зависит от селективности и, начиная с некоторой доли выбираемых строк, обычно работает лучше остальных методов.
Стоимость индексного сканирования сильно зависит от корреляции между физическим расположением версий строк и порядком, в котором индексный метод доступа выдает их идентификаторы. При идеальной корреляции индексное сканирование эффективно даже при довольно большой доле
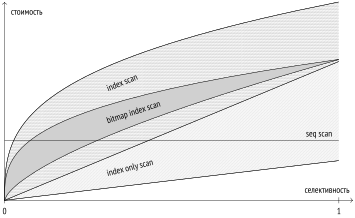
выбираемых строк. Но при слабой корреляции (что чаще встречается в реальности) стоимость высока и очень быстро начинает превышать даже стоимость последовательного сканирования. При всем этом индексное сканирование — безусловный лидер в очень важном случае, когда индекс (часто уникальный) используется для выборки единственной строки.
Сканирование только индекса (если оно применимо) может давать прекрасные результаты и выигрывать у последовательного сканирования даже при выборке всех строк. Его производительность, однако, очень сильно зависит от карты видимости, и в худшем случае сканирование только индекса деградирует до обычного индексного сканирования.
Стоимость сканирования по битовой карте зависит от объема доступной памяти, но в гораздо меньшей степени, чем стоимость индексного сканирования зависит от корреляции. При слабой корреляции сканирование по битовой карте существенно выигрывает.
Каждый из методов доступа может превосходить остальные в одних ситуациях и проигрывать им в других. Планировщик выполняет серьезную работу по оценке эффективности всех методов в каждом конкретном случае. Конечно, близость этих оценок к реальности сильно зависит от актуальности статистической информации.
backend/access/index/indexam.c, функция index_getnext_tid. ↩︎
backend/utils/adt/selfuncs.c, функция btcostestimate; postgrespro.ru/docs/postgresql/18/index-cost-estimation. ↩︎
backend/optimizer/path/costsize.c, функция index_pages_fetched. ↩︎
backend/optimizer/path/costsize.c, функция cost_index. ↩︎
postgrespro.ru/docs/postgresql/18/indexes-index-only-scans. ↩︎
backend/access/index/indexam.c, функция index_getbitmap. ↩︎
backend/access/index/indexam.c, функция index_getbitmap. ↩︎
backend/nodes/tidbitmap.c, функция tbm_lossify. ↩︎
backend/nodes/tidbitmap.c, функции tbm_union и tbm_intersect. ↩︎
backend/optimizer/path/costsize.c, функция compute_bitmap_pages. ↩︎
backend/optimizer/path/costsize.c, функция compute_bitmap_pages. ↩︎
backend/optimizer/path/costsize.c, функция cost_bitmap_heap_scan. ↩︎
backend/optimizer/path/costsize.c, функции cost_bitmap_and_node и cost_bitmap_or_node. ↩︎