19 Индексные методы доступа
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
19.1. Индексы и расширяемость
Индексы — объекты базы данных, предназначенные в основном для ускорения доступа к данным. Это вспомогательные структуры: любой индекс можно удалить и восстановить заново по информации в таблице. Но, кроме ускорения, индексы служат и для поддержки некоторых ограничений целостности.
В ядро встроены шесть индексных методов доступа (типов индексов): (psql: \dA)
Следование идее расширяемости предполагает возможность добавлять и новые методы доступа без изменения ядра. Один такой пример (метод bloom) включен в стандартный набор расширений.
Несмотря на все различия между типами индексов, в конечном счете любой из них устанавливает соответствие между ключом (например, значением проиндексированного столбца) и версиями строк таблицы, в которых этот ключ встречается. В качестве ссылки используется шестибайтный идентификатор версии строки (tuple id, tid). Зная ключ или некоторую информацию о нем, можно быстро прочитать те версии строк, в которых может находиться нужная информация, не просматривая всю таблицу полностью. (с. 428)
Чтобы новый метод доступа можно было добавить как расширение, выделен общий механизм индексирования. Его основной задачей является получение идентификаторов версий строк от метода доступа и работа с ними:
чтение данных из соответствующих версий строк таблицы;
проверка видимости версий строк в снимке данных; (с. 97)
перепроверка условий, если метод не гарантирует их выполнения.
Механизм индексирования участвует в исполнении планов, построенных на этапе оптимизации. Оптимизатор, перебирая и оценивая различные пути выполнения запроса, должен знать свойства всех потенциально применимых методов доступа: может ли метод отдавать данные сразу в нужном порядке или надо отдельно предусмотреть сортировку? может ли метод вернуть несколько первых значений или только всю выборку сразу? и так далее.
Информация о методе доступа нужна не только оптимизатору. При создании индекса надо решить: допускает ли метод создание составного индекса? может ли данный индекс обеспечить уникальность?
Механизм индексирования позволяет работать с самыми разными методами доступа; для этого метод доступа должен реализовать определенный интерфейс, сообщив о своих возможностях и особенностях.
В задачи метода доступа входят:
реализация алгоритмов построения индекса, вставки и удаления строк;
организация разбиения данных индекса по страницам (для работы с менеджером буферного кеша); (с. 183)
реализация алгоритма очистки; (с. 125)
установка блокировок для корректного конкурентного выполнения; (с. 305)
формирование журнала предзаписи; (с. 211)
поиск информации в индексе по ключу;
оценка стоимости использования индекса.
Расширяемость проявляется и в том, что в систему могут добавляться новые типы данных, про которые методу доступа заранее ничего неизвестно. Поэтому методы доступа определяют собственные интерфейсы для подключения произвольных типов данных.
Чтобы значения определенного типа можно было использовать с определенным методом доступа, нужно реализовать этот интерфейс, предоставив операторы, для которых применим индекс и, возможно, некоторые вспомогательные опорные функции. Такой набор операторов и функций называется классом операторов.
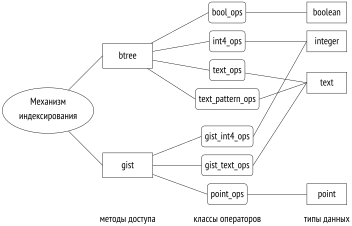
Часть логики индексирования при этом находится в самом методе доступа, а часть оказывается вынесенной в класс операторов. Это довольно произвольное деление: если для B-деревьев вся логика «зашита» в методе доступа, то некоторые методы могут предоставлять лишь основной каркас, отдавая все существенные детали на откуп конкретным классам операторов. Во многих случаях для одного и того же типа данных существует несколько классов операторов с отличающимся поведением, среди которых пользователь может выбрать наиболее подходящий.
Небольшой фрагмент общей картины показан на рисунке:
19.2. Классы и семейства операторов
Класс операторов
Интерфейс метода доступа 1 реализуется классом операторов 2 — набором операторов и опорных функций, который используется методом доступа для работы с конкретным типом данных.
Классы операторов хранятся в системном каталоге в таблице pg_opclass. Полные данные для рисунка выше можно было бы получить запросом: (psql: \dAc)
В большинстве случаев про классы операторов не требуется ничего знать. Обычно мы просто создаем индекс, и при этом используется некоторый класс операторов по умолчанию.
Например, вот классы операторов для B-дерева и типа text. Один из имеющихся классов обязательно помечен для использования по умолчанию:
Привычная команда создания индекса выглядит так:
Но это просто сокращение для развернутого варианта:
Если нужен индекс какого-то другого типа или необходимо нестандартное поведение, потребуется явно указать желаемый метод доступа или класс операторов.
Класс операторов, созданный для некоторого метода доступа и некоторого типа данных, должен содержать набор операторов, которые принимают параметры этого типа и имеют семантику, предусмотренную этим методом доступа.
Например, метод доступа btree определяет пять обязательных операторов сравнения. Любой класс операторов для него должен содержать все пять: (psql: \dAo)
Семантика оператора, подразумеваемая методом доступа, отражена в номере стратегии amopstrategy3. Например, для btree стратегия 1 означает «меньше», 2 — «меньше или равно» и так далее. Сами операторы при этом могут иметь произвольные названия.
В приведенном примере обычные операторы и операторы с тильдой отличаются тем, что последние не учитывают правила сортировки (collation) 4 и сравнивают строки побайтово. Тем не менее оба варианта реализуют одни и те же смысловые операции сравнения.
Класс операторов text_pattern_ops позволяет преодолеть ограничение на поддержку оператора ~~ (который соответствует конструкции LIKE). В базе данных с правилом сортировки, отличным от C, этот оператор не может использовать обычный индекс по текстовому полю:
Другое дело — индекс с классом операторов text_pattern_ops:
Обратите внимание, как изменилось выражение в условии Index Cond. Для поиска используется только префикс шаблона до символа %, а лишние совпадения отсеиваются при перепроверке условием Filter. Класс операторов для метода доступа btree не содержит оператора сравнения по шаблону, и единственный способ использовать B-дерево — переписать условие с помощью операторов сравнения. Операторы из класса text_pattern_ops действуют без учета правил сортировки, что и дает возможность заменить условие на эквивалентное5.
Индекс может использоваться для ускорения доступа по условию, если
это условие имеет вид «индексированный-столбец оператор выражение» (если указан коммутирующий оператор6, то допускается и «выражение оператор индексированный-столбец») 7
и при этом оператор входит в класс операторов, указанный для индексированного-столбца при создании индекса.
Например, такой запрос может использовать индекс:
Обратите внимание на то, как переставлены аргументы в условии Index Cond: на этапе выполнения индексированное поле должно быть левым аргументом оператора. При перестановке оператор заменяется на коммутирующий; в данном случае это тот же самый оператор, поскольку отношение равенства коммутативно.
А следующий запрос в принципе не может использовать обычный индекс, поскольку вместо имени столбца в условии стоит вызов функции:
В таком случае можно применить индекс по выражению 8, указав при его создании не столбец, а произвольное выражение:
Выражение может зависеть только от значений полей в табличной строке и не должно зависеть ни от состояния других данных в базе, ни от настроек (например, от локали). Иными словами, если выражение содержит вызовы функций, то эти функции обязаны иметь и соблюдать категорию изменчивости IMMUTABLE 9. В противном случае результат запроса, выполненного с индексным доступом, может отличаться от результата того же запроса, выполненного полным сканированием таблицы.
Кроме собственно операторов, класс операторов может предоставлять опорные функции 10, необходимые методу. Например, метод доступа btree определяет пять опорных функций11, из которых только первая (сравнивающая два значения) является необходимой, а остальные могут отсутствовать: (psql: \dAp)
Семейство операторов
Класс операторов всегда входит в какое-либо семейство операторов 12 (таблица pg_opfamily системного каталога). При этом в одно общее семейство могут входить несколько классов, если они работают одинаковым образом с похожими типами данных.
Например, семейство integer_ops включает несколько классов для разных по размеру, но одинаковых по смыслу числовых типов: (psql: \dAf)
А в семейство datetime_ops входят классы операторов для работы с датами:
Каждый класс операторов работает с каким-то одним типом. Семейство же включает и операторы, принимающие разные типы данных:
За счет группировки операторов в семейство планировщик может использовать индекс для условий со значениями разных типов, не требуя явного приведения.
19.3. Интерфейс механизма индексирования
Как и для табличных методов доступа, столбец amhandler таблицы pg_am содержит имя функции, реализующей интерфейс 13:
Функция заполняет интерфейсную структуру 14 необходимыми значениями. Часть предоставляемой информации — это функции, выполняющие отдельные элементы общей работы (например, сканирующие индекс и возвращающие идентификаторы версий строк), а часть — свойства индексного метода, о которых должен знать механизм индексирования.
Все свойства разделены на три уровня 15:
свойства метода доступа;
свойства конкретного индекса;
свойства отдельных столбцов индекса.
Выделение уровней метода доступа и индекса сделано с прицелом на будущее: в настоящее время все индексы, созданные на основе одного метода доступа, всегда будут иметь одинаковые свойства этих двух уровней.
Свойства метода доступа
К свойствам метода доступа относятся следующие пять (показаны на примере B-дерева):
CAN ORDER Возможность сразу получить отсортированные данные 16. В настоящее время поддерживается только B-деревьями.
Чтобы получить результаты в нужном порядке, всегда можно просканировать таблицу и отсортировать полученные данные:
Но при наличии индекса, поддерживающего это свойство, можно получить данные сразу в нужном порядке:
CAN UNIQUE Поддержка ограничения уникальности и первичного ключа17. Применимо только к B-деревьям.
При объявлении уникального или первичного ключа автоматически создается уникальный индекс, поддерживающий это ограничение целостности.
С другой стороны, если не объявлять ограничение целостности явно, но создать уникальный индекс, видимый эффект будет таким же: столбец не будет допускать дубликатов. В чем разница?
Ограничение целостности — декларация свойства, которое должно выполняться, а индекс — тот механизм, который это обеспечивает. В принципе, ограничение может гарантироваться и другими средствами.
Например, PostgreSQL не позволяет создавать глобальные индексы на секционированных таблицах, но тем не менее позволяет объявить уникальный ключ (если в него входит ключ секционирования). В этом случае глобальная уникальность обеспечивается локальными уникальными индексами на каждой секции и тем фактом, что в двух секциях не может быть одинаковых значений ключа секционирования.
CAN MULTI COL Возможность построить составной индекс по нескольким столбцам 18.
Составной индекс позволяет ускорить поиск по нескольким условиям на разные столбцы таблицы. Например, таблица ticket_flights имеет составной первичный ключ и, соответственно, индекс:
Поиск перелета по номеру билета и идентификатору рейса выполняется с помощью этого индекса:
В случае B-дерева возможность и эффективность поиска зависят от порядка столбцов в индексе. Для индексов других типов это может быть и не так. (с. 536) (с. 628)
CAN EXCLUDE Поддержка ограничения исключения EXCLUDE 19.
Ограничение исключения гарантирует, что условие, определяемое оператором, не будет выполняться для любых пар строк таблицы. Для проверки ограничения автоматически создается индекс; класс операторов метода доступа должен содержать выбранный оператор.
В качестве оператора обычно используется «пересечение» &&. Например, таким образом можно декларативно объявить, что аудитория не может быть дважды забронирована на одно и то же время или что здания на карте не могут накладываться друг на друга. (с. 571)
С оператором «равно» ограничение исключения приобретает смысл ограничения уникальности: запрещается наличие в таблице двух строк с совпадающими значениями ключевых столбцов. Тем не менее это не то же самое, что ограничение уникальности: в частности, на ключ ограничения исключения нельзя ссылаться во внешних ключах, его нельзя использовать во фразе ON CONFLICT.
CAN INCLUDE Возможность добавить к индексу столбцы, не являющиеся частью индексного ключа, чтобы сделать индекс покрывающим. (с. 425)
Так, например, можно добавить дополнительные столбцы к уникальному индексу. Такой индекс будет гарантировать уникальность значений в ключевых столбцах, позволяя при этом получать значения дополнительных столбцов без обращения к таблице:
Свойств на самом деле гораздо больше, но многие недоступны на уровне SQL20. Вот некоторые из них:
CAN PRED LOCKS Поддержка предикатных блокировок. (с. 298)
Отсутствует у методов доступа spgist и brin; при сканировании индексов таких типов на уровне изоляции Serializable предикатные блокировки будут устанавливаться на всю таблицу, как при последовательном сканировании, что приведет к снижению производительности.
CAN BUILD PARALLEL Возможность построения индекса несколькими процессами параллельно. Поддерживается методами доступа btree, brin и gin. (v. 17) (v. 18)
Свойства индекса
Свойства, относящиеся к индексу (показаны на примере существующего):
CLUSTERABLE Возможность физически переместить версии строк таблицы в соответствии с порядком, в котором данный индекс выдает их идентификаторы при индексном сканировании. (с. 361)
Это свойство определяет, применима ли команда CLUSTER.
INDEX SCAN Поддержка индексного сканирования. (с. 414)
Свойство означает, что метод доступа умеет выдавать идентификаторы версий строк по одному. Может показаться странным, но не все индексы поддерживают это свойство.
BITMAP SCAN Поддержка сканирования по битовой карте. (с. 427)
Свойство означает, что метод доступа может построить и вернуть битовую карту сразу по всем идентификаторам версий строк.
BACKWARD SCAN Возможность возвращать результат в порядке, обратном указанному при создании индекса.
Это свойство актуально, только если метод доступа поддерживает индексное сканирование.
Свойства столбцов
Наконец, свойства столбцов:
ASC, DESC, NULLS FIRST, NULLS LAST Упорядоченность значений столбца.
Эти свойства определяют, в каком порядке хранятся значения (по возрастанию или по убыванию) и где находятся неопределенные значения (до обычных значений или после). Все свойства из этой группы применимы только к B-деревьям. (с. 350)
ORDERABLE Возможность упорядочивать значения данного столбца в предложении ORDER BY.
Это свойство также применимо только к B-деревьям.
DISTANCE ORDERABLE Поддержка операторов упорядочивания21. (с. 410)
В отличие от обычных индексных операторов, возвращающих логическое значение, операторы упорядочивания возвращают вещественное число — «расстояние» от одного аргумента до другого. Индекс поддерживает такие операторы в предложении ORDER BY.
Например, с помощью оператора упорядочивания <-> можно найти аэропорты, ближайшие к заданной точке:
RETURNABLE Возможность получения данных из индекса без обращения к таблице, то есть поддержка сканирования только индекса. (с. 422)
Свойство определяет, позволяет ли индексная структура восстановить проиндексированные значения. Это возможно не всегда; например, некоторые индексы могут сохранять не сами значения, а их хеш-коды. В таких случаях не будет работать и свойство CAN INCLUDE.
SEARCH ARRAY Поддержка поиска нескольких значений из массива.
Такая необходимость возникает не только при использовании массивов как таковых. Например, планировщик преобразует конструкцию IN (список) в поиск по массиву: (см. также: с. 554; ссылка добавлена редактором веб-издания)
Если индексный метод не умеет работать с такими операторами, при исполнении плана потребуется несколько итераций для поиска одиночных значений (что может сказаться на эффективности).
SEARCH NULLS Возможность поиска по условиям IS NULL и IS NOT NULL.
Надо ли индексировать неопределенные значения? Это дает возможность использовать индекс для условий IS [NOT] NULL, а также в качестве покрывающего индекса при полном отсутствии условий на таблицу (поскольку в этом случае индекс должен вернуть данные всех строк таблицы, в том числе и с неопределенными значениями). Зато без NULL индекс может получиться компактнее.
Решение принимают разработчики метода доступа, но обычно неопределенные значения все-таки индексируются.
Если неопределенные значения в индексе не нужны, их можно исключить, построив частичный индекс 22 только по тем строкам таблицы, которые представляют интерес. Например:
Частичный индекс будет меньше полного по размеру и не будет обновляться при изменении строк, не входящих в индекс. В некоторых случаях это может дать ощутимый выигрыш. Конечно, условие в предложении WHERE может быть любым (удовлетворяющим требованиям категории изменчивости IMMUTABLE), а не только проверкой неопределенных значений.
Построение частичных индексов не зависит от метода доступа и обеспечивается механизмом индексирования.
Разумеется, интерфейсом охвачены не все возможности индексных методов доступа, а только те, о которых необходимо знать заранее, чтобы принять правильное решение. Например, нет свойства, которое отражает возможность неблокирующего создания индекса (CONCURRENTLY). Такие свойства определяются кодом функций, реализующих интерфейс.
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-STRATEGIES. ↩︎
postgrespro.ru/docs/postgresql/18/collation; postgrespro.ru/docs/postgresql/18/indexes-collations. ↩︎
postgrespro.ru/docs/postgresql/18/xoper-optimization#id-1.8.3.18.6. ↩︎
backend/optimizer/path/indxpath.c, функция match_clause_to_indexcol. ↩︎
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-OPFAMILY. ↩︎
backend/utils/adt/amutils.c, функция indexam_property. ↩︎
postgrespro.ru/docs/postgresql/18/ddl-constraints#DDL-CONSTRAINTS-EXCLUSION. ↩︎
include/access/amapi.h, структура IndexAmRoutine. ↩︎
postgrespro.ru/docs/postgresql/18/xindex#XINDEX-ORDERING-OPS. ↩︎