18 Табличные методы доступа
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
18.1. Подключаемые движки хранения
Способ организации данных на диске, принятый в PostgreSQL, не является ни единственно возможным, ни наилучшим для всех типов нагрузки. Следуя идее расширяемости, PostgreSQL позволяет создавать и подключать различные табличные методы доступа (движки хранения данных), хотя в настоящее время «из коробки» доступен только один: (v. 12)
Имя движка может указываться при создании таблицы (CREATE TABLE ... USING); по умолчанию используется движок, определяемый значением параметра default_table_access_method. Впоследствии движок можно сменить (ALTER TABLE ... SET ACCESS METHOD), но, конечно, ценой переписывания всех данных. (по умолчанию: heap) (v. 15)
Чтобы ядро могло однотипно работать с разными движками, табличные методы доступа должны реализовывать специальный интерфейс1. Функция, указанная в столбце amhandler, возвращает интерфейсную структуру2, содержащую всю необходимую для ядра информацию.
Бóльшая часть компонентов ядра остается общей для любых табличных методов доступа:
менеджер транзакций, включая поддержку ACID и изоляции на основе снимков;
буферный менеджер;
журнал, включая поддержку специфичных операций с помощью механизма унифицированных журнальных записей 3 или пользовательских менеджеров ресурсов 4; (v. 15)
подсистема ввода-вывода;
TOAST;
оптимизатор и исполнитель запросов;
индексная поддержка.
Не все эти компоненты могут быть нужны движку, но возможность их использования сохраняется.
В свою очередь, движок определяет:
формат версии строки и структуру данных;
реализацию сканирования таблицы и оценку его стоимости;
реализацию вставок, удалений, обновлений и блокировок;
правила видимости версий строк;
процедуры очистки и анализа.
Исторически PostgreSQL использовал единственную систему хранения данных, встроенную в ядро без какого-либо определенного программного интерфейса. Из-за этого сейчас крайне сложно создать удачный интерфейс, который учитывал бы все сложившиеся особенности стандартного движка и при этом не мешал бы другим методам.
Поэтому и я не старался придерживаться строгого деления между ядром и табличными методами. Многое из сказанного в предыдущих частях книги формально относится не к функциям ядра, а к особенностям метода heap. Скорее всего, этот метод навсегда останется в PostgreSQL как универсальный стандартный движок, а другие методы будут занимать отдельные ниши, позволяя оптимальнее справляться с определенными типами нагрузки.
Освоение механизма табличных методов началось со следующих движков:
Zheap был призван справиться с проблемой раздувания таблиц5. Для этого он реализует обновление версий строк на месте и выносит исторические данные, необходимые для построения снимка, в отдельное undo-хранилище. Такой движок полезен при нагрузке, включающей активное обновление данных.
Устройство движка покажется знакомым пользователям Oracle, хотя есть и нюансы (например, интерфейс индексных методов не позволяет создавать индексы с собственной версионностью). (с. 394)
Zedstore реализует колоночное хранение 6 и должен быть эффективен для OLAP-запросов.
Данные организованы в основное B-дерево идентификаторов версий строк, а каждый столбец хранится в собственном B-дереве, связанном с основным (с перспективой сохранения в одном дереве сразу нескольких столбцов для получения гибридного хранилища).
К сожалению, эти движки не были доведены до промышленной готовности; работа над ними фактически прекратилась. В настоящее время активно развиваются другие проекты, например:
OrioleDB — движок, спроектированный с учетом возможностей современного оборудования и особенностей облачных сервисов7. Метод доступа хранит данные в таблицах, организованных как деревья, и устраняет раздувание таблиц за счет использования журнала отката.
Из-за недостаточно проработанного интерфейса табличных методов доступа установка OrioleDB требует определенных изменений в ядре PostgreSQL.
Citus Columnar реализует классическое колоночное хранение данных со сжатием8. Этот метод доступа предназначен для аналитической нагрузки и хранилищ данных, он не поддерживает обновление и имеет другие ограничения.
18.2. Последовательное сканирование
Движок хранения отвечает за физическую организацию табличных данных и предоставляет метод доступа к ним — последовательное сканирование, при котором полностью читается файл (или файлы) основного слоя таблицы. На каждой прочитанной странице проверяется видимость каждой версии строки; версии, не удовлетворяющие условиям запроса, отбрасываются. (с. 97)
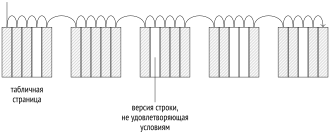
Чтение происходит через буферный кеш; чтобы большие таблицы не вытесняли полезные данные, для последовательного сканирования используется буферное кольцо небольшого размера. При этом другие процессы, одновременно сканирующие ту же таблицу, присоединяются к кольцу и тем самым экономят операции дисковых чтений. Поэтому в общем случае сканирование может стартовать не с начала файла. (с. 198)
Последовательное сканирование — самый эффективный способ прочитать всю таблицу или значительную ее часть. Иными словами, последовательное сканирование хорошо работает при низкой селективности. (При высокой селективности, когда из всей таблицы нужна только небольшая часть строк, более предпочтительным будет использование индекса.) (с. 394)
Оценка стоимости
В плане выполнения запроса последовательное сканирование представляется узлом Seq Scan:
Оценка количества строк (rows) является частью базовой статистики:
В оценке стоимости оптимизатор учитывает две составляющие: дисковый ввод-вывод и ресурсы процессора9.
Стоимость ввода-вывода рассчитывается как произведение числа страниц в таблице на стоимость чтения одной страницы, при условии что страницы читаются последовательно. Когда буферный менеджер запрашивает страницу у операционной системы, физически с диска за один раз читается больший объем данных, так что с высокой вероятностью несколько следующих страниц уже окажутся в кеше ОС. За счет этого стоимость последовательного чтения одной страницы (которая для планировщика определяется значением параметра seq_page_cost) получается меньше, чем стоимость при случайном доступе (определяемая значением параметра random_page_cost). (по умолчанию: 1) (по умолчанию: 4)
Значения по умолчанию подходят для HDD-дисков; для накопителей SSD имеет смысл существенно уменьшить random_page_cost (значение seq_page_cost, как правило, не трогают, оставляя единицу в качестве опорного значения). Поскольку соотношение зависит от характеристик оборудования, параметры обычно задают на уровне табличных пространств (ALTER TABLESPACE ... SET).
Приведенная формула отчетливо показывает последствия раздувания таблиц из-за несвоевременной очистки: чем больший объем занимает основной слой таблицы, тем больше страниц придется сканировать, независимо от количества актуальных версий строк в них. (с. 170)
Оценка ресурсов процессора учитывает стоимость обработки каждой версии строки (которая определяется для планировщика значением параметра cpu_tuple_cost): (по умолчанию: 0.01)
Сумма двух приведенных оценок и составляет полную стоимость плана. Начальная стоимость равна нулю, поскольку последовательное сканирование не требует выполнения подготовительных действий.
Если на сканируемую таблицу наложены условия, они отображаются в плане запроса под узлом Seq Scan в секции Filter. Оценка числа строк будет учитывать селективность этих условий, а оценка стоимости — затраты на их вычисления. (с. 346)
Команда EXPLAIN ANALYZE выведет и реально полученное количество строк, и количество строк, отфильтрованных условиями:
Рассмотрим чуть более сложный пример плана выполнения с агрегацией:
План состоит из двух узлов: верхний узел Aggregate, в котором происходит вычисление функции count, получает данные от нижнего узла Seq Scan, выполняющего сканирование таблицы.
Начальная стоимость узла Aggregate включает саму агрегацию: невозможно выдать первую (и единственную) строку результата, не получив все строки от нижестоящего узла. Оценка вычисляется исходя из стоимости выполнения условной операции cpu_operator_cost над каждой входной строкой 10: (по умолчанию: 0.0025)
Полученная оценка добавляется к полной стоимости узла Seq Scan.
Полная стоимость узла Aggregate дополнительно включает стоимость обработки одной строки результата cpu_tuple_cost: (по умолчанию: 0.01)
Зависимости между оценками стоимостей в этом примере можно представить себе следующим образом:
18.3. Параллельные планы выполнения
PostgreSQL поддерживает параллельное выполнение запросов 11. Идея состоит в том, что ведущий процесс, выполняющий запрос, порождает (с помощью postmaster) несколько рабочих процессов, которые одновременно выполняют одну и ту же параллельную часть плана. Результаты этого выполнения передаются ведущему процессу, который собирает их в узле Gather12. В свободное от приема данных время ведущий процесс также может выполнять параллельную часть плана.
При необходимости можно отключить ведущий процесс от выполнения параллельной части плана с помощью параметра parallel_leader_participation. (по умолчанию: on)
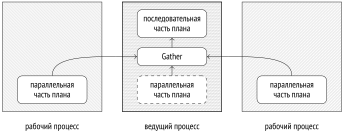
Разумеется, запуск процессов и пересылка данных требуют определенных ресурсов, поэтому далеко не каждый запрос имеет смысл выполнять параллельно.
Кроме того, даже при параллельном выполнении не над всеми шагами плана запроса можно работать одновременно. Часть операций может выполняться ведущим процессом в одиночку, последовательно.
В PostgreSQL не реализован другой теоретически возможный режим распараллеливания, при котором несколько процессов составляют конвейер для обработки данных (грубо говоря, отдельные узлы плана выполняются отдельными процессами). Разработчики PostgreSQL сочли такой режим неэффективным.
18.4. Параллельное последовательное сканирование
Примером узла, предназначенного для параллельного выполнения, является Parallel Seq Scan — «параллельное последовательное сканирование».
Название звучит несколько противоречиво (все-таки параллельное или последовательное?), но тем не менее отражает суть операции. С точки зрения обращений к файлу страницы таблицы читаются последовательно, в том же порядке, в котором они читались бы при обычном последовательном сканировании. Однако чтение выполняется несколькими параллельно работающими процессами. Процессы синхронизируются между собой с помощью специально отведенного участка общей памяти, чтобы не прочитать одну и ту же страницу дважды.
Тонкий момент состоит в том, что вместо общей картины последовательного сканирования операционная система видит несколько процессов, выполняющих случайное чтение. Из-за этого предвыборка данных, обычно ускоряющая последовательное чтение, работает плохо. Поэтому каждому процессу выделяется для чтения не одна, а несколько страниц, идущих подряд13. (v. 14)
Сама по себе операция параллельного сканирования не имеет большого смысла, поскольку к обычным затратам на чтение страниц добавляются накладные расходы на пересылку данных от процесса к процессу. Но если рабочие процессы выполняют какую-то обработку прочитанных строк (например, агрегацию), то суммарное время выполнения запроса может оказаться существенно меньшим.
Оценка стоимости
Рассмотрим простой запрос с агрегацией над большой таблицей. План выполнения будет использовать параллелизм:
Узлы ниже Gather составляют параллельную часть плана. Она выполняется в каждом из рабочих процессов (которых в данном случае запланировано две штуки) и, возможно, в ведущем процессе (если это не отключено параметром parallel_leader_participation). Сам узел Gather и узлы выше него составляют последовательную часть плана и выполняются только в ведущем процессе.
Узел Parallel Seq Scan представляет сканирование таблицы в параллельном режиме. В поле rows показана оценка числа строк, которые в среднем выдаст один процесс. Всего над выполнением должно трудиться три процесса (ведущий и два рабочих), но ведущий процесс будет задействован не полностью: его вклад уменьшается с ростом числа рабочих процессов14. В данном случае используется коэффициент 2,4.
Стоимость узла Parallel Seq Scan оценивается почти так же, как и стоимость последовательного сканирования. Выигрыш получается за счет того, что каждый из процессов обрабатывает меньшее количество строк; составляющая ввода-вывода при этом учитывается полностью, поскольку таблицу все равно придется прочитать целиком, страница за страницей:
Следующий узел — Partial Aggregate — выполняет агрегацию данных, полученных рабочим процессом, то есть в данном случае подсчитывает количество строк.
Оценка стоимости агрегации выполняется уже известным образом и добавляется к оценке сканирования таблицы:
Следующий узел — Gather — выполняется ведущим процессом. Этот узел отвечает за запуск рабочих процессов и получение от них данных.
Оценка стоимости запуска процессов (независимо от их количества) определяется для планировщика значением параметра parallel_setup_cost, а стоимость пересылки каждой строки данных между процессами — значением parallel_tuple_cost. (по умолчанию: 1000) (по умолчанию: 0.1)
В данном случае преобладает начальная стоимость (запуск процессов), и это значение добавляется к начальной стоимости узла Partial Aggregate. Полная стоимость учитывает пересылку двух строк, и это значение складывается с полной стоимостью узла Partial Aggregate 15:
Последний узел — Finalize Aggregate — агрегирует частичные суммы, полученные узлом Gather от параллельных процессов.
Начальная стоимость этой окончательной агрегации учитывает подсчет трех строк; полученное значение складывается с полной стоимостью узла Gather (поскольку для вычисления результата нужны все строки). К полной стоимости добавляется стоимость выдачи одной строки результата.
Зависимости между оценками стоимостей определяются тем, накапливает ли узел данные перед выдачей результатов вышестоящему узлу. Агрегация не может возвращать результаты до тех пор, пока не получит все входные строки. Поэтому в основу начальной стоимости агрегации ложится полная стоимость нижестоящего узла. А узел Gather выдает строки наверх сразу, как только получает их снизу. Поэтому начальная стоимость этой операции зависит от начальной стоимости нижестоящего узла, а полная — от полной.
Схематически это можно представить себе следующим образом:
18.5. Ограничения параллельного выполнения
Количество рабочих процессов
Количество процессов ограничивают три параметра, образующих иерархию. Максимальное число одновременно выполняющихся рабочих процессов определяется значением параметра max_worker_processes. (по умолчанию: 8)
Но механизм рабочих процессов используется не только для параллельного выполнения запросов. Например, фоновые рабочие процессы задействованы в логической репликации, ими могут пользоваться расширения. Количество рабочих процессов, занимающихся именно параллельными планами, ограничено значением параметра max_parallel_workers. (по умолчанию: 8)
Из этого числа не более max_parallel_workers_per_gather процессов могут обслуживать один ведущий процесс. (по умолчанию: 2)
На выбор значений для этих параметров влияют:
возможности аппаратуры — система должна располагать свободными ядрами, не занятыми другими задачами;
наличие в базе данных больших таблиц;
нагрузка — должны выполняться запросы, потенциально выигрывающие от параллельного выполнения.
В большинстве случаев таким критериям удовлетворяют OLAP-, а не OLTP-системы.
Планировщик вообще не будет рассматривать параллельное сканирование, если по его оценке размер прочитанных из таблицы данных не превысит значение min_parallel_table_scan_size. (по умолчанию: 8MB)
Если число процессов не указано для таблицы явно в параметре хранения parallel_workers, оно вычисляется по формуле
Она означает, что каждое увеличение таблицы в три раза будет добавлять еще один параллельный процесс. Например, значения параметров по умолчанию дают следующие цифры:
| Таблица, Мбайт | Количество процессов |
|---|---|
| 8 | 1 |
| 24 | 2 |
| 72 | 3 |
| 216 | 4 |
| 648 | 5 |
| 1944 | 6 |
В любом случае число процессов не может превышать значение параметра max_parallel_workers_per_gather.
Если запросить информацию из небольшой таблицы размером 19 Мбайт, будет запланирован и запущен один рабочий процесс:
При запросе данных из таблицы размером 105 Мбайт будет запланировано только два процесса из-за ограничения max_parallel_workers_per_gather: (по умолчанию: 2)
Сняв ограничение, получим расчетные три процесса:
Если при выполнении запроса число свободных слотов окажется меньше запланированного количества процессов, будет запущено только доступное количество рабочих процессов.
Ограничим общее количество параллельных процессов пятью и выполним два запроса одновременно:
Хотя в каждом случае было запланировано три рабочих процесса, одному запросу досталось только два свободных слота.
Восстановим значения параметров по умолчанию:
Нераспараллеливаемые запросы
Не каждый запрос может выполняться в параллельном режиме16. Не могут распараллеливаться:
- Запросы, изменяющие или блокирующие данные (
UPDATE,DELETE,SELECT FOR UPDATEи подобные им).
Это не касается запросов, которые используются в командах:
– CREATE TABLE AS, SELECT INTO, CREATE MATERIALIZED VIEW;
– REFRESH MATERIALIZED VIEW. (v. 14)
Но вставка строк и в этих случаях выполняется последовательно.
Запросы, выполнение которых может быть приостановлено. Это относится к запросам в курсорах, в том числе в циклах
FORPL/pgSQL.Запросы, содержащие вызовы небезопасных функций, помеченных как
PARALLEL UNSAFE. К таковым по умолчанию относятся все пользовательские функции и небольшая часть стандартных. Список небезопасных функций можно получить из системного каталога:
- Запросы внутри функций, когда эти функции вызываются из распараллеленного запроса (чтобы не допустить рекурсивного разрастания количества рабочих процессов).
Часть этих ограничений может быть снята в следующих версиях PostgreSQL. Так, например, появилась возможность распараллеливания запросов на уровне изоляции Serializable. (v. 12)
Запрос может не выполняться в параллельном режиме по нескольким причинам:
данный запрос в принципе не может быть распараллелен ни при каких обстоятельствах;
параллельный план запрещен значениями конфигурационных параметров (в том числе из-за ограничения на размер таблиц);
параллельный план имеет более высокую стоимость по сравнению с последовательным.
Чтобы проверить, может ли запрос быть распараллелен в принципе, можно на время включить параметр debug_parallel_query. При этом планировщик будет строить параллельные планы во всех случаях, когда это возможно: (v. 16) (по умолчанию: off)
Теперь мы понимаем, что планировщик рассматривал параллельный план, но выбрал более эффективное в данном случае последовательное сканирование.
Ограниченно распараллеливаемые запросы
Чем большую часть плана удается выполнить параллельно, тем больший возможен эффект. Однако есть ряд операций, которые в целом не препятствуют распараллеливанию, но сами могут выполняться только последовательно в ведущем процессе17. Иными словами, они не могут появиться в дереве плана ниже узла Gather.
Общие табличные выражения. Не распараллеливается чтение результата общего табличного выражения 18 (узел плана CTE Scan):
Если общее табличное выражение не материализуется, то план не содержит узла CTE Scan, и это ограничение не действует. (v. 12)
При этом само общее табличное выражение вполне может вычисляться в параллельном режиме, если это выгодно:
Коррелированные подзапросы. Некоррелированные подзапросы, вычисляемые один раз и представленные в плане узлом InitPlan, могут участвовать в параллельном плане: (v. 17)
Узел Parallel Append реализует здесь параллельное выполнение команды UNION ALL. Рабочие процессы разбирают себе по подзапросу (если процессов больше, чем подзапросов, несколько могут работать над одной задачей). Когда все данные от подзапроса уже получены, освободившийся процесс подключается к другому подзапросу, пока все данные не будут объединены.
А вот коррелированные подзапросы (узел плана SubPlan) не участвуют в параллельных планах:
Вместо Parallel Append в плане появился узел Append, в котором операция UNION ALL выполняется последовательно, а параллельная часть плана охватывает теперь только второй подзапрос, в котором остался узел InitPlan.
Временные таблицы. Временные таблицы не могут сканироваться параллельно, поскольку доступны исключительно создавшему их процессу. Работа со страницами временных таблиц ведется в локальном буферном кеше. Чтобы разрешить обращаться к нему нескольким процессам, потребовалось бы ввести блокировки, как в разделяемом кеше, а это уменьшило бы остальные преимущества. (с. 209) (с. 305)
Ограниченно распараллеливаемые функции. Вызовы функций, помеченных как PARALLEL RESTRICTED, могут выполняться только в последовательной части плана.
Список таких функций можно получить из системного каталога запросом
Помечать собственные функции как PARALLEL RESTRICTED (и тем более как PARALLEL SAFE) нужно с большой осторожностью, внимательно изучив имеющиеся ограничения19.
github.com/citusdata/citus/tree/main/src/backend/columnar. ↩︎
backend/optimizer/path/costsize.c, функция cost_seqscan. ↩︎
backend/optimizer/path/costsize.c, функция cost_agg. ↩︎
postgrespro.ru/docs/postgresql/18/parallel-query; backend/access/transam/README.parallel. ↩︎
backend/access/heap/heapam.c, функции table_block_parallelscan_startblock_init и table_block_parallelscan_nextpage. ↩︎
backend/optimizer/path/costsize.c, функция get_parallel_divisor. ↩︎
backend/optimizer/path/costsize.c, функция cost_gather. ↩︎
postgrespro.ru/docs/postgresql/18/when-can-parallel-query-be-used. ↩︎
postgrespro.ru/docs/postgresql/18/parallel-safety#PARALLEL-LABELING. ↩︎