# Статистика
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
## 17.1. Базовая статистика {#internal-ru-section-17-1}
Базовая статистика уровня отношения [^internal-ru-347-1] хранится в таблице `pg_class` системного каталога. К ней относятся:
- число строк в отношении (`reltuples`);
- размер отношения, в страницах (`relpages`);
- количество страниц, отмеченных в карте видимости (`relallvisible`). (*с.* [32](/ru/01-introduction/#internal-ru-page-33))
Вот эти значения на примере таблицы `flights`:
```text {label="psql"}
=> SELECT reltuples, relpages, relallvisible
FROM pg_class WHERE relname = 'flights';
reltuples | relpages | relallvisible
-----------+----------+---------------
214867 | 2624 | 0
(1 row)
```
Значение `reltuples` используется в качестве оценки кардинальности, когда запрос не накладывает никаких условий на строки таблицы:
```text {label="psql" hl_lines="4"}
=> EXPLAIN SELECT * FROM flights;
QUERY PLAN
----------------------------------------------------------------
Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=63)
(1 row)
```
Статистика собирается при анализе, ручном или автоматическом[^internal-ru-348-1]. Однако ввиду особой важности базовая статистика рассчитывается также при выполнении некоторых операций (`VACUUM FULL` и `CLUSTER`[^internal-ru-348-2], `CREATE INDEX` и `REINDEX` [^internal-ru-348-3]) и уточняется при очистке [^internal-ru-348-4]. (*с.* [137](/ru/06-vacuum-and-freezing/#internal-ru-page-138))
Для анализа случайно выбираются 300 × *default\_statistics\_target* строк. Поскольку размер выборки, достаточной для построения статистики заданной точности, слабо зависит от объема анализируемых данных, размер таблицы не учитывается[^internal-ru-348-5]. (*по умолчанию:* `100`)
Строки выбираются из такого же количества (300 × *default\_statistics\_target*) случайных страниц [^internal-ru-348-6]. Конечно, для небольшой таблицы количество прочитанных страниц и выбранных для анализа строк может оказаться меньше.
Поскольку в достаточно больших таблицах статистика собирается не по всем строкам, оценки могут немного расходиться с реальностью. Это нормально: статистика в любом случае не может все время быть точной, если данные изменяются. Для выбора адекватного плана обычно достаточно попадания в порядок.
Создадим копию таблицы `flights` с отключенной автоочисткой, чтобы управлять временем выполнения анализа:
```text {label="psql"}
=> CREATE TABLE flights_copy(LIKE flights)
WITH (autovacuum_enabled = false);
```
Для новой таблицы никакой статистики еще нет:
```text {label="psql"}
=> SELECT reltuples, relpages, relallvisible
FROM pg_class WHERE relname = 'flights_copy';
reltuples | relpages | relallvisible
-----------+----------+---------------
-1 | 0 | 0
(1 row)
```
Значение `reltuples` = −1 позволяет отличить таблицу, для которой статистика ни разу не собиралась, от действительно пустой таблицы без строк. (v. 14)
Но с большой вероятностью в таблицу будут добавлены какие-то строки сразу после создания. Поэтому, находясь в неведении, планировщик считает, что таблица занимает 10 страниц:
```text {label="psql" hl_lines="4"}
=> EXPLAIN SELECT * FROM flights_copy;
QUERY PLAN
-----------------------------------------------------------------
Seq Scan on flights_copy (cost=0.00..14.10 rows=410 width=170)
(1 row)
```
Количество строк рассчитывается исходя из размера одной строки; он отображается в плане запроса как width. Обычно для оценки используется среднее значение, вычисляемое при анализе, но в этом случае, поскольку статистика отсутствует, размер строки вычисляется приблизительно с учетом типов данных каждого из столбцов[^internal-ru-349-1].
Теперь скопируем данные из таблицы `flights` и выполним анализ:
```text {label="psql"}
=> INSERT INTO flights_copy SELECT * FROM flights;
INSERT 0 214867
=> ANALYZE flights_copy;
```
Сейчас статистика совпадает с реальным количеством строк (размер таблицы таков, что статистика собирается по полным данным):
```text {label="psql"}
=> SELECT reltuples, relpages, relallvisible
FROM pg_class WHERE relname = 'flights_copy';
reltuples | relpages | relallvisible
-----------+----------+---------------
214867 | 2624 | 0
(1 row)
```
Значение `relallvisible` используется при оценке стоимости сканирования только индекса. Оно обновляется при очистке: (*с.* [422](/ru/20-index-scans/#internal-ru-page-423))
```text {label="psql"}
=> VACUUM flights_copy;
=> SELECT relallvisible FROM pg_class WHERE relname = 'flights_copy';
relallvisible
---------------
2624
(1 row)
```
Теперь удвоим количество строк, не собирая статистику, и проверим оценку кардинальности в плане запроса:
```text {label="psql" hl_lines="10"}
=> INSERT INTO flights_copy SELECT * FROM flights;
=> SELECT count(*) FROM flights_copy;
count
--------
429734
(1 row)
=> EXPLAIN SELECT * FROM flights_copy;
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on flights_copy (cost=0.00..9545.34 rows=429734 width=63)
(1 row)
```
Оценка оказалась точна, несмотря на устаревшие сведения в `pg_class`:
```text {label="psql"}
=> SELECT reltuples, relpages
FROM pg_class WHERE relname = 'flights_copy';
reltuples | relpages
-----------+----------
214867 | 2624
(1 row)
```
Дело в том, что планировщик повышает точность оценки, масштабируя значение `reltuples` в соответствии с отклонением реального размера файла данных от значения `relpages`[^internal-ru-350-1]. Поскольку размер файла вырос в два раза по сравнению с `relpages`, количество строк скорректировалось исходя из предположения, что плотность данных не изменилась:
```text {label="psql"}
=> SELECT reltuples *
(pg_relation_size('flights_copy') / 8192) / relpages AS tuples
FROM pg_class WHERE relname = 'flights_copy';
tuples
--------
429734
(1 row)
```
Конечно, такая корректировка работает не всегда (например, если удалить часть строк, оценка не изменится), но в ряде случаев позволяет «продержаться» до прихода анализа при крупных изменениях.
## 17.2. Неопределенные значения {#internal-ru-section-17-2}
Неопределенные значения, порицаемые теоретиками [^internal-ru-351-1], играют тем не менее важную роль в реляционных базах данных как удобный способ представления того факта, что значение не существует или неизвестно.
Но особое значение требует и особого к себе отношения. Помимо теоретических неувязок, возникает множество сугубо практических сложностей, с которыми приходится считаться. Обычная булева логика превращается в трехзначную, а конструкция `NOT IN` ведет себя *неожиданно*. Непонятно, должны ли неопределенные значения считаться меньше обычных значений или больше (отсюда специальные предложения `NULLS FIRST` и `NULLS LAST` для сортировки). Не так уж очевидно, должны ли неопределенные значения учитываться в агрегатных функциях. Поскольку, строго говоря, неопределенные значения вовсе не являются значениями, то для их учета планировщику необходима дополнительная информация.
Помимо самой простой, базовой статистики на уровне отношений, при анализе собирается статистика для каждого столбца отношения. Она хранится в таблице системного каталога `pg_statistic`[^internal-ru-351-2], но значительно проще пользоваться представлением `pg_stats`, которое показывает информацию в более удобном виде.
*Доля неопределенных значений* как раз относится к статистике уровня столбца; вычисленное при анализе значение показывает атрибут `null_frac`.
Например, чтобы найти еще не отправившиеся рейсы, можно воспользоваться тем, что время их вылета не определено:
```text {label="psql" hl_lines="4"}
=> EXPLAIN SELECT * FROM flights WHERE actual_departure IS NULL;
QUERY PLAN
---------------------------------------------------------------
Seq Scan on flights (cost=0.00..4772.67 rows=16473 width=63)
Filter: (actual_departure IS NULL)
(2 rows)
```
Оценка вычисляется как общее число строк, умноженное на долю `NULL`:
```text {label="psql"}
=> SELECT round(reltuples * s.null_frac) AS rows
FROM pg_class
JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
AND s.attname = 'actual_departure';
rows
-------
16473
(1 row)
```
Точное значение:
```text {label="psql"}
=> SELECT count(*) FROM flights WHERE actual_departure IS NULL;
count
-------
16348
(1 row)
```
## 17.3. Уникальные значения {#internal-ru-section-17-3}
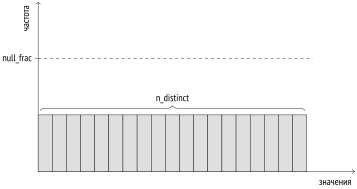
Поле `n_distinct` представления `pg_stats` показывает количество уникальных значений в столбце.
Если значение `n_distinct` отрицательно, то модуль этого числа равен не количеству, а доле уникальных значений. Например, −1 означает, что все значения в столбце уникальны, а −3 говорит о том, что каждое значение в среднем встречается в трех строках. Анализатор использует доли, когда вычисленное при анализе количество уникальных значений превышает 10 % от
{#internal-ru-fig-17-1 num="17.1" caption="Уникальные значения" .book-original-figure width=714 height=379}
общего количества строк; в этом случае пропорция, скорее всего, сохранится и при дальнейшем изменении данных[^internal-ru-353-1].
Количество уникальных значений используется во всех случаях, которые предполагают равномерное распределение данных. Например, при оценке кардинальности условия «*столбец* = *выражение*», когда значение *выражения* неизвестно на этапе планирования, считается, что *выражение* может принимать любое из возможных значений столбца с равной вероятностью [^internal-ru-353-2]:
```text {label="psql" hl_lines="8 9 10"}
=> EXPLAIN SELECT *
FROM flights
WHERE departure_airport = (
SELECT airport_code FROM airports WHERE city = 'Санкт-Петербург'
);
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on flights (cost=30.56..5340.40 rows=2066 width=63)
Filter: (departure_airport = (InitPlan 1).col1)
InitPlan 1
-> Seq Scan on airports_data ml (cost=0.00..30.56 rows=1 wi...
Filter: ((city ->> lang()) = 'Санкт-Петербург'::text)
(5 rows)
```
Здесь узел плана InitPlan выполняется один раз, и вычисленное значение используется в основном плане.
```text {label="psql"}
=> SELECT round(reltuples / s.n_distinct) AS rows
FROM pg_class
JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
AND s.attname = 'departure_airport';
rows
------
2066
(1 row)
```
Если количество уникальных значений вычисляется неверно (из-за ограниченности выборки, по которой проводится анализ), это количество можно указать для столбца явно:
```sql
ALTER TABLE ... ALTER COLUMN ... SET (n_distinct = ...);
```
Если бы все данные были всегда распределены равномерно, этой информации (дополненной минимальным и максимальным значениями) было бы достаточно. Но при неравномерном распределении, которое на практике встречается гораздо чаще, такая оценка не будет точна:
```text {label="psql"}
=> SELECT min(cnt), round(avg(cnt)) avg, max(cnt) FROM (
SELECT departure_airport, count(*) cnt
FROM flights GROUP BY departure_airport
) t;
min | avg | max
-----+------+-------
113 | 2066 | 20875
(1 row)
```
## 17.4. Наиболее частые значения {#internal-ru-section-17-4}
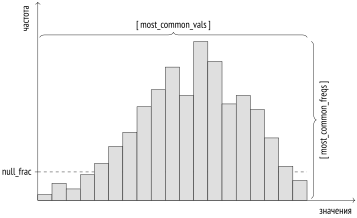
Для уточнения оценки при неравномерном распределении собирается статистика по наиболее часто встречающимся значениям (most common values, MCV) и частоте их появления. Представление `pg_stats` показывает два этих массива в столбцах `most_common_vals` и `most_common_freqs`.
{#internal-ru-fig-17-2 num="17.2" caption="Наиболее частые значения" .book-original-figure width=714 height=436}
Вот пример такой статистики по частоте использования различных типов самолетов:
```text {label="psql"}
=> SELECT most_common_vals AS mcv,
left(most_common_freqs::text,60) || '...' AS mcf
FROM pg_stats
WHERE tablename = 'flights' AND attname = 'aircraft_code' \gx
-[ RECORD 1 ]--------------------------------------------------------
mcv | {CN1,CR2,SU9,321,733,319,763,773}
mcf | {0.28123334,0.2653,0.264,0.0595,0.03816667,0.0374,0.0368,0.0...
```
Для оценки селективности условия «*столбец* = *значение*» достаточно найти значение в массиве `most_common_vals` и взять частоту из элемента массива `most_common_freqs` с тем же номером [^internal-ru-355-1]:
```text {label="psql" hl_lines="4"}
=> EXPLAIN SELECT * FROM flights WHERE aircraft_code = '733';
QUERY PLAN
--------------------------------------------------------------
Seq Scan on flights (cost=0.00..5309.84 rows=8201 width=63)
Filter: (aircraft_code = '733'::bpchar)
(2 rows)
=> SELECT round(reltuples * s.most_common_freqs[
array_position((s.most_common_vals::text::text[]),'733')
])
FROM pg_class
JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
AND s.attname = 'aircraft_code';
round
-------
8201
(1 row)
```
Очевидно, что такая оценка будет близка к точному значению:
```text {label="psql"}
=> SELECT count(*) FROM flights WHERE aircraft_code = '733';
count
-------
8263
(1 row)
```
Список частых значений используется и для оценки селективности условий с неравенствами. Например, для условия вида «*столбец* < *значение*» надо найти в `most_common_vals` все значения, меньшие искомого, и просуммировать частоты из `most_common_freqs`[^internal-ru-356-1].
Статистика частых значений отлично работает, когда количество различных значений не очень велико. Максимальный размер массивов определяется тем же параметром *default\_statistics\_target*, который ограничивает размер случайной выборки строк для анализа. (*по умолчанию:* `100`)
В некоторых случаях может иметь смысл увеличить значение параметра по умолчанию, чтобы расширить список частых значений и повысить точность оценок. Это можно сделать на уровне отдельного столбца:
```sql
ALTER TABLE ... ALTER COLUMN ... SET STATISTICS ...;
```
При этом увеличится и размер выборки, но только для указанной таблицы.
Поскольку в массиве частых значений сохраняются сами значения, массив может занимать довольно много места. Чтобы чрезмерно не увеличивать `pg_statistic` и не нагружать планировщик бесполезной работой, из анализа и статистики исключаются значения, размер которых превышает 1 Кбайт. К тому же такие большие значения, скорее всего, уникальны и поэтому все равно не должны попасть в `most_common_vals`.
## 17.5. Гистограмма {#internal-ru-section-17-5}
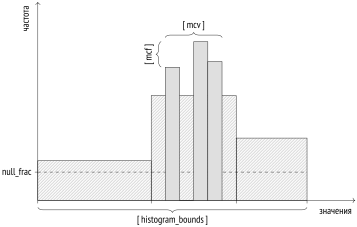
Когда число различных значений слишком велико, чтобы записать их в массив, на помощь приходит гистограмма. Гистограмма состоит из нескольких *корзин*, в которые помещаются значения. Количество корзин ограничено все тем же параметром *default\_statistics\_target*.
Ширина корзин выбирается так, чтобы в каждую попало примерно одинаковое количество значений (на рисунке этому свойству соответствует одинаковая площадь больших заштрихованных прямоугольников). При этом учитываются только те значения, которые не попали в список наиболее частых. При таком построении суммарная частота значений одной (любой) корзины равна \(\frac{1}{\textit{число корзин}}.\)
{#internal-ru-fig-17-3 num="17.3" caption="Гистограмма" .book-original-figure width=714 height=453}
Гистограмма хранится в поле `histogram_bounds` представления `pg_stats` как массив значений, ограничивающих корзины:
```text {label="psql"}
=> SELECT left(histogram_bounds::text,60) || '...' AS hist_bounds
FROM pg_stats s
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
hist_bounds
-----------------------------------------------------------------
{10A,10A,10F,10F,11G,12B,13B,13K,14C,14C,15B,15C,15C,16B,17B...
(1 row)
```
Гистограмма используется, в частности, для оценки селективности операторов «больше» или «меньше» вместе со списком наиболее частых значений[^internal-ru-358-1]. Рассмотрим пример — количество посадочных талонов, выданных на дальние ряды:
```text {label="psql" hl_lines="4"}
=> EXPLAIN SELECT * FROM boarding_passes WHERE seat_no > '30B';
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on boarding_passes (cost=0.00..157374.55 rows=2991709 ...
Filter: ((seat_no)::text > '30B'::text)
(2 rows)
```
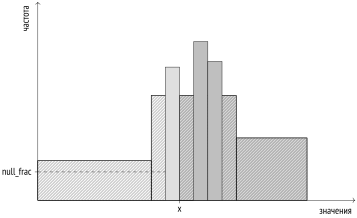
Номер места специально выбран так, что он лежит точно на границе корзин гистограммы.
Оценка селективности такого условия будет равна \(\frac{N}{\textit{число корзин}}\), где *N* — количество корзин, значения в которых удовлетворяют условию (то есть находятся справа от значения). При этом необходимо учесть, что наиболее частые значения не входят в гистограмму.
Вообще говоря, неопределенные значения тоже не входят в гистограмму, но в столбце `seat_no` их быть не может:
```text {label="psql"}
=> SELECT s.null_frac FROM pg_stats s
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
null_frac
-----------
0
(1 row)
```
{#internal-ru-fig-17-4 num="17.4" caption="Гистограмма" .book-original-figure width=714 height=436}
Сначала найдем долю наиболее частых значений, которые удовлетворяют условию:
```text {label="psql"}
=> SELECT sum(s.most_common_freqs[
array_position((s.most_common_vals::text::text[]),v)
])
FROM pg_stats s, unnest(s.most_common_vals::text::text[]) v
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no'
AND v > '30B';
sum
------------
0.20833333
(1 row)
```
Общая доля наиболее частых значений (не учитываемая гистограммой) составляет:
```text {label="psql"}
=> SELECT sum(s.most_common_freqs[
```
```text
array_position((s.most_common_vals::text::text[]),v)
])
FROM pg_stats s, unnest(s.most_common_vals::text::text[]) v
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
sum
-----------
0.6747334
(1 row)
```
Поскольку интервал занимает ровное количество корзин гистограммы (из 100 возможных), получаем следующую оценку:
```text {label="psql"}
=> SELECT round( reltuples * (
0.20833333 -- вклад частых значений
+ (1 - 0.6747334 - 0) * (52 / 100.0) -- вклад гистограммы
))
FROM pg_class WHERE relname = 'boarding_passes';
round
---------
2991708
(1 row)
```
В общем случае, когда значение лежит не на границе, с помощью линейной интерполяции учитывается доля корзины, в которой находится значение.
Точное значение составляет:
```text {label="psql"}
=> SELECT count(*) FROM boarding_passes WHERE seat_no > '30B';
count
---------
2993735
(1 row)
```
Увеличение параметра *default\_statistics\_target* может улучшить оценку, однако, как показывает пример, в сочетании со списком наиболее частых значений гистограмма обычно дает хороший результат даже при большом количестве уникальных значений в столбце:
```text {label="psql"}
=> SELECT n_distinct FROM pg_stats
WHERE tablename = 'boarding_passes' AND attname = 'seat_no';
n_distinct
------------
461
(1 row)
```
Увеличение точности оценки имеет смысл только в том случае, когда оно приводит к построению более качественного плана. Бездумное увеличение параметра может замедлить выполнение анализа и работу планировщика, ничего не улучшив. С другой стороны, уменьшение параметра (вплоть до нуля) может ускорить анализ и планирование, но может и послужить причиной плохих планов. Такая «экономия» обычно неоправданна.
## 17.6. Статистика для нескалярных типов данных {#internal-ru-section-17-6}
Для нескалярных типов данных может собираться статистика по распределению не только самих значений, но и элементов, из которых эти значения состоят. Это позволяет более точно планировать запросы с участием столбцов не в первой нормальной форме.
- Массивы `most_common_elems` и `most_common_elem_freqs` показывают список *наиболее частых элементов* и их частоты.
Статистика собирается и используется при оценке селективности для массивов [^internal-ru-361-1]и типа данных `tsvector` [^internal-ru-361-2].
- Массив `elem_count_histogram` показывает гистограмму *количества* *уникальных элементов* в значении.
Статистика собирается и используется при оценке селективности только для массивов.
- Для непустых диапазонов собираются гистограммы распределения нижних и верхних границ (массив `range_bounds_histogram`) и длины (массив `range_length_histogram`). Отдельно отмечается доля пустых диапазонов (столбец `range_empty_frac`). Эти данные используются для оценки селективности различных операций с диапазонными типами [^internal-ru-361-3]. Такая же статистика используется и для мультидиапазонных типов[^internal-ru-361-4]. (v. 17) (v. 14)
## 17.7. Средний размер поля {#internal-ru-section-17-7}
Поле `avg_width` представления `pg_stats` показывает средний размер значений в столбце. Конечно, для таких типов, как `integer` или `char(3)`, этот показатель всегда одинаков, но для типов данных с переменной длиной, таких как `text`, он может сильно отличаться от столбца к столбцу:
```text {label="psql"}
=> SELECT attname, avg_width FROM pg_stats
WHERE (tablename, attname) IN ( VALUES
('tickets', 'passenger_name'), ('ticket_flights','fare_conditions')
);
attname | avg_width
-----------------+-----------
fare_conditions | 8
passenger_name | 16
(2 rows)
```
Эта статистика используется для оценки объема памяти, необходимой некоторым операциям, например сортировке или хешированию.
## 17.8. Корреляция {#internal-ru-section-17-8}
Поле `correlation` представления `pg_stats` показывает корреляцию между физическим расположением данных и логическим порядком в смысле операций сравнения. Если значения хранятся строго по возрастанию, корреляция будет близка к единице; если по убыванию — к минус единице. Чем более хаотично расположены данные на диске, тем ближе значение к нулю. (*с.* [546](/ru/25-b-tree/#internal-ru-page-547))
```text {label="psql"}
=> SELECT attname, correlation
FROM pg_stats WHERE tablename = 'airports_data'
ORDER BY abs(correlation) DESC;
attname | correlation
--------------+-------------
coordinates |
airport_code | -0.21120238
city | -0.1970127
airport_name | -0.18223621
timezone | 0.17961165
(5 rows)
```
Корреляция используется для оценки стоимости индексного сканирования. Для столбца `coordinates` эта статистика не собирается, поскольку для типа данных `point` не определены операторы «больше» и «меньше». (*с.* [415](/ru/20-index-scans/#internal-ru-page-416))
## 17.9. Статистика по выражению {#internal-ru-section-17-9}
Обычно статистика по столбцу может использоваться, только если в операции сравнения слева или справа от оператора фигурирует сам столбец, а не выражение. Например, планировщик не знает, как изменится статистика после вычисления функции от столбца, и поэтому для условия «*вызов-функции* = *константа*» всегда использует фиксированную оценку в 0,5 % [^internal-ru-363-1]:
```text {label="psql" hl_lines="7"}
=> EXPLAIN SELECT * FROM flights
WHERE extract(
month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on flights (cost=0.00..6384.17 rows=1074 width=63)
Filter: (EXTRACT(month FROM (scheduled_departure AT TIME ZONE ...
(2 rows)
=> SELECT round(reltuples * 0.005)
FROM pg_class WHERE relname = 'flights';
round
-------
1074
(1 row)
```
Планировщику неизвестна семантика даже стандартных функций. Хотя нам из общих соображений понятно, что рейсов, совершенных в январе, будет примерно \(\frac{1}{12}\) от общего количества, то есть на порядок больше спрогнозированного значения.
> [!NOTE]
> PostgreSQL позволяет создать вспомогательную функцию для планировщика[^internal-ru-363-2], которая подскажет ему ожидаемое количество строк на выходе некоторой функции при заданных аргументах. Поэтому про некоторые встроенные функции (например, `generate_series`) планировщик кое-что знает. Но далеко не все и не про все.
Чтобы исправить ситуацию, надо собрать статистику не по столбцу таблицы, а по выражению. Это можно сделать двумя способами.
### Расширенная статистика по выражению {#internal-ru-subsection-star-230}
Первый вариант — использовать *расширенную статистику* [^internal-ru-364-1] по выражению. Такая статистика не собирается автоматически; необходимо вручную создать объект базы данных командой `CREATE STATISTICS`: (v. 14)
```text {label="psql"}
=> CREATE STATISTICS flights_expr_stat ON (extract(
month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
))
FROM flights;
```
После сбора статистики оценка исправляется:
```text {label="psql" hl_lines="8"}
=> ANALYZE flights;
=> EXPLAIN SELECT * FROM flights
WHERE extract(
month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on flights (cost=0.00..6384.17 rows=16502 width=63)
Filter: (EXTRACT(month FROM (scheduled_departure AT TIME ZONE ...
(2 rows)
```
Чтобы собранная статистика использовалась, выражение в условии запроса должно быть записано в том же виде, что и в команде `CREATE STATISTICS`.
Размер собираемой расширенной статистики можно изменить отдельно командой `ALTER STATISTICS`, например: (v. 13)
```text {label="psql"}
=> ALTER STATISTICS flights_expr_stat SET STATISTICS 42;
```
Общая информация о расширенной статистике хранится в таблице системного каталога `pg_statistic_ext`, а собственно собранная статистика — в отдельной таблице `pg_statistic_ext_data`. Смысл такого разделения состоит в возможности ограничения доступа пользователей к чувствительной информации. (v. 12)
Доступную пользователю расширенную статистику по выражению можно посмотреть в более удобном виде с помощью специального представления:
```text {label="psql"}
=> SELECT left(expr,50) || '...' AS expr,
null_frac, avg_width, n_distinct,
most_common_vals AS mcv,
left(most_common_freqs::text,50) || '...' AS mcf,
correlation
FROM pg_stats_ext_exprs WHERE statistics_name = 'flights_expr_stat' \gx
-[ RECORD 1 ]------------------------------------------------------
expr | EXTRACT(month FROM (scheduled_departure AT TIME ZO...
null_frac | 0
avg_width | 8
n_distinct | 12
mcv | {8,9,11,7,5,12,1,3,10,4,6,2}
mcf | {0.121,0.1112,0.0796,0.0793,0.0791,0.07746667,0.07...
correlation | 0.08110773
```
### Статистика для индекса по выражению {#internal-ru-subsection-star-232}
Второй способ исправить оценки кардинальности — воспользоваться тем, что при создании индекса по выражению для него собирается отдельная статистика, как для таблицы. Это удобно, если индекс действительно нужен. (*с.* [401](/ru/19-index-access-methods/#internal-ru-page-402))
```text {label="psql" hl_lines="12"}
=> DROP STATISTICS flights_expr_stat;
=> CREATE INDEX ON flights(extract(
month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
));
=> ANALYZE flights;
=> EXPLAIN SELECT * FROM flights
WHERE extract(
month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
QUERY PLAN
---------------------------------------------------------------------
Bitmap Heap Scan on flights (cost=318.81..3237.23 rows=16824 wi...
Recheck Cond: (EXTRACT(month FROM (scheduled_departure AT TIME...
-> Bitmap Index Scan on flights_extract_idx (cost=0.00..314.6...
Index Cond: (EXTRACT(month FROM (scheduled_departure AT TI...
(4 rows)
```
Статистика для индексов по выражению хранится так же, как статистика по таблице. Например, из `pg_stats` можно получить количество уникальных значений, указав в качестве `tablename` имя индекса:
```text {label="psql"}
=> SELECT n_distinct FROM pg_stats
WHERE tablename = 'flights_extract_idx';
n_distinct
------------
12
(1 row)
```
Изменить точность статистики в случае индекса можно командой `ALTER INDEX`. Для этого сначала может потребоваться узнать, как называется столбец, соответствующий выражению. Например:
```text {label="psql"}
=> SELECT attname FROM pg_attribute
WHERE attrelid = 'flights_extract_idx'::regclass;
attname
---------
extract
(1 row)
=> ALTER INDEX flights_extract_idx
ALTER COLUMN extract SET STATISTICS 42;
```
## 17.10. Многовариантная статистика {#internal-ru-section-17-10}
PostgreSQL дает возможность собирать *многовариантную статистику*, охватывающую не один, а несколько столбцов таблицы. Для этого необходимо вручную создать соответствующую расширенную статистику.
Реализовано три вида многовариантной статистики.
### Функциональные зависимости между столбцами {#internal-ru-subsection-star-234}
Если значения в одном столбце определяются (полностью или частично) значениями другого столбца и в запросе указаны условия на оба таких столбца, оценка кардинальности будет занижена.
Рассмотрим запрос с двумя условиями:
```text {label="psql"}
=> SELECT count(*) FROM flights
WHERE flight_no = 'PG0007' AND departure_airport = 'VKO';
count
-------
396
(1 row)
```
Оценка оказывается сильно заниженной:
```text {label="psql" hl_lines="5 9"}
=> EXPLAIN SELECT * FROM flights
WHERE flight_no = 'PG0007' AND departure_airport = 'VKO';
QUERY PLAN
---------------------------------------------------------------------
Bitmap Heap Scan on flights (cost=10.49..814.25 rows=14 width=63)
Recheck Cond: (flight_no = 'PG0007'::bpchar)
Filter: (departure_airport = 'VKO'::bpchar)
-> Bitmap Index Scan on flights_flight_no_scheduled_departure_key
(cost=0.00..10.48 rows=275 width=0)
Index Cond: (flight_no = 'PG0007'::bpchar)
(6 rows)
```
Это известная *проблема коррелированных предикатов*. Планировщик полагается на то, что предикаты независимы, и вычисляет общую селективность как произведение селективностей условий, объединенных логическим «и». Это хорошо видно в приведенном плане: оценка в узле Bitmap Index Scan, полученная по условию на столбец `flight_no`, существенно уменьшается после фильтрации по условию на столбец `departure_airport` в узле Bitmap Heap Scan. (*с.* [336](/ru/16-query-execution-stages/#internal-ru-page-337))
Однако мы понимаем, что номер рейса однозначно определяет аэропорты: фактически второе условие избыточно (конечно, если аэропорт указан правильно). В таких случаях расширенная статистика по функциональным зависимостям может улучшить оценку.
Создадим расширенную статистику по функциональной зависимости между двумя столбцами:
```text {label="psql"}
=> CREATE STATISTICS flights_dep_stat(dependencies)
ON flight_no, departure_airport FROM flights;
```
При очередном анализе таблицы желаемая статистика будет собрана, и оценка улучшится:
```text {label="psql" hl_lines="6"}
=> ANALYZE flights;
=> EXPLAIN SELECT * FROM flights
WHERE flight_no = 'PG0007' AND departure_airport = 'VKO';
QUERY PLAN
---------------------------------------------------------------------
Bitmap Heap Scan on flights (cost=10.56..816.91 rows=276 width=63)
Recheck Cond: (flight_no = 'PG0007'::bpchar)
Filter: (departure_airport = 'VKO'::bpchar)
-> Bitmap Index Scan on flights_flight_no_scheduled_departure_key
(cost=0.00..10.49 rows=276 width=0)
Index Cond: (flight_no = 'PG0007'::bpchar)
(6 rows)
```
В системном каталоге собранную статистику можно посмотреть следующим образом:
```text {label="psql"}
=> SELECT dependencies
FROM pg_stats_ext WHERE statistics_name = 'flights_dep_stat';
dependencies
------------------------------------------
{"2 => 5": 1.000000, "5 => 2": 0.010300}
(1 row)
```
Числа 2 и 5 — номера столбцов таблицы из `pg_attribute`. Значения определяют степень функциональной зависимости: от 0 (зависимости нет) до 1 (значения в первом столбце полностью определяют значения во втором).
### Многовариантное число различных значений {#internal-ru-subsection-star-236}
Информация о количестве уникальных комбинаций значений из нескольких столбцов позволяет точнее оценить кардинальность группировки по нескольким столбцам.
Например, количество возможных пар аэропортов отправления и прибытия оценивается планировщиком как квадрат количества аэропортов, но реальное значение сильно меньше, поскольку далеко не каждая пара аэропортов соединена прямым рейсом:
```text {label="psql" hl_lines="13"}
=> SELECT count(*)
FROM (
SELECT DISTINCT departure_airport, arrival_airport FROM flights
) t;
count
-------
618
(1 row)
=> EXPLAIN SELECT DISTINCT departure_airport, arrival_airport
FROM flights;
QUERY PLAN
--------------------------------------------------------------------
HashAggregate (cost=5847.01..5955.16 rows=10816 width=8)
Group Key: departure_airport, arrival_airport
-> Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=8)
(3 rows)
```
Создадим и соберем расширенную статистику по числу разных значений:
```text {label="psql"}
=> CREATE STATISTICS flights_nd_stat(ndistinct)
ON departure_airport, arrival_airport FROM flights;
=> ANALYZE flights;
```
Теперь оценка кардинальности исправилась:
```text {label="psql" hl_lines="5"}
=> EXPLAIN SELECT DISTINCT departure_airport, arrival_airport
FROM flights;
QUERY PLAN
--------------------------------------------------------------------
HashAggregate (cost=5847.01..5853.19 rows=618 width=8)
Group Key: departure_airport, arrival_airport
-> Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=8)
(3 rows)
```
Собранную статистику можно увидеть в системном каталоге:
```text {label="psql"}
=> SELECT n_distinct
FROM pg_stats_ext WHERE statistics_name = 'flights_nd_stat';
n_distinct
---------------
{"5, 6": 618}
(1 row)
```
### Многовариантные списки частых значений {#internal-ru-subsection-star-238}
При неравномерном распределении значений одного только знания функциональной зависимости может быть недостаточно, поскольку оценка существенно зависит от конкретной пары значений. Например, планировщик ошибается, оценивая количество рейсов из Шереметьева, выполняемых Боингом 737: (v. 12)
```text {label="psql" hl_lines="11"}
=> SELECT count(*) FROM flights
WHERE departure_airport = 'SVO' AND aircraft_code = '733';
count
-------
2037
(1 row)
=> EXPLAIN SELECT * FROM flights
WHERE departure_airport = 'SVO' AND aircraft_code = '733';
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on flights (cost=0.00..5847.00 rows=737 width=63)
Filter: ((departure_airport = 'SVO'::bpchar) AND (aircraft_cod...
(2 rows)
```
В таком случае оценку можно уточнить, собирая статистику по многовариантным спискам частых значений [^internal-ru-370-1]:
```text {label="psql"}
=> CREATE STATISTICS flights_mcv_stat(mcv)
ON departure_airport, aircraft_code FROM flights;
=> ANALYZE flights;
```
Новая оценка кардинальности гораздо точнее:
```text {label="psql" hl_lines="5"}
=> EXPLAIN SELECT * FROM flights
WHERE departure_airport = 'SVO' AND aircraft_code = '733';
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on flights (cost=0.00..5847.00 rows=2127 width=63)
Filter: ((departure_airport = 'SVO'::bpchar) AND (aircraft_cod...
(2 rows)
```
Для ее получения планировщик воспользовался частотой, сохраненной в системном каталоге:
```text {label="psql"}
=> SELECT values, frequency
FROM pg_statistic_ext stx
JOIN pg_statistic_ext_data stxd ON stx.oid = stxd.stxoid,
pg_mcv_list_items(stxdmcv) m
WHERE stxname = 'flights_mcv_stat'
AND values = '{SVO,773}';
values | frequency
-----------+----------------------
{SVO,773} | 0.005066666666666666
(1 row)
```
В многовариантном списке, как и в обычном списке частых значений, сохраняется *default\_statistics\_target* значений (если параметр задан на уровне столбцов, то используется наибольшее значение). (*по умолчанию:* `100`)
Как и для расширенной статистики по выражению, при необходимости можно изменить размер списка: (v. 13)
```sql
ALTER STATISTICS ... SET STATISTICS ...;
```
Во всех примерах я использовал только два столбца, но многовариантную статистику можно создавать и по большему количеству.
В одном объекте можно комбинировать статистику разных типов, указывая их через запятую (а если не указать тип, для заданных столбцов будут собираться сразу все возможные варианты статистики).
Более того, как и в статистике по выражению, в многовариантной статистике тоже можно использовать произвольные выражения, а не только имена столбцов. (v. 14)
[^internal-ru-347-1]: [postgrespro.ru/docs/postgresql/18/planner-stats]().
[^internal-ru-348-1]: [backend/commands/analyze.c](), функция do\_analyze\_rel.
[^internal-ru-348-2]: [backend/commands/cluster.c](), функция copy\_table\_data.
[^internal-ru-348-3]: [backend/catalog/heap.c](), функция index\_update\_stats.
[^internal-ru-348-4]: [backend/access/heap/vacuumlazy.c](), функция heap\_vacuum\_rel.
[^internal-ru-348-5]: [backend/commands/analyze.c](), функция std\_typanalyze.
[^internal-ru-348-6]: [backend/commands/analyze.c](), функция acquire\_sample\_rows; [backend/utils/misc/sampling.c]().
[^internal-ru-349-1]: [backend/access/table/tableam.c](), функция table\_block\_relation\_estimate\_size.
[^internal-ru-350-1]: [backend/access/table/tableam.c](), функция table\_block\_relation\_estimate\_size.
[^internal-ru-351-1]: [citforum.ru/database/articles/evergreen\_nulls]().
[^internal-ru-351-2]: [include/catalog/pg\_statistic.h]().
[^internal-ru-353-1]: [backend/commands/analyze.c](), функция compute\_distinct\_stats.
[^internal-ru-353-2]: [backend/utils/adt/selfuncs.c](), функция var\_eq\_non\_const.
[^internal-ru-355-1]: [backend/utils/adt/selfuncs.c](), функция var\_eq\_const.
[^internal-ru-356-1]: [backend/utils/adt/selfuncs.c](), функция scalarineqsel.
[^internal-ru-358-1]: [backend/utils/adt/selfuncs.c](), функция ineq\_histogram\_selectivity.
[^internal-ru-361-1]: [postgrespro.ru/docs/postgresql/18/arrays](); [backend/utils/adt/array\_typanalyze.c](); [backend/utils/adt/array\_selfuncs.c]().
[^internal-ru-361-2]: [postgrespro.ru/docs/postgresql/18/datatype-textsearch](); [backend/tsearch/ts\_typanalyze.c](); [backend/tsearch/ts\_selfuncs.c]().
[^internal-ru-361-3]: [postgrespro.ru/docs/postgresql/18/rangetypes](); [backend/utils/adt/rangetypes\_typanalyze.c](); [backend/utils/adt/rangetypes\_selfuncs.c]().
[^internal-ru-361-4]: [backend/utils/adt/multirangetypes\_selfuncs.c]().
[^internal-ru-363-1]: [backend/utils/adt/selfuncs.c](), функция eqsel.
[^internal-ru-363-2]: [postgrespro.ru/docs/postgresql/18/xfunc-optimization]().
[^internal-ru-364-1]: [postgrespro.ru/docs/postgresql/18/planner-stats#PLANNER-STATS-EXTENDED](); [backend/statistics/README]().
[^internal-ru-370-1]: [backend/statistics/README.mcv](); [backend/statistics/mcv.c]().