16 Этапы выполнения запросов
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
16.1. Демонстрационная база данных
В предыдущих частях книги мы обходились простыми таблицами с несколькими строками. Эта и следующая части имеют дело с выполнением запросов, и нам понадобятся взаимосвязанные таблицы с большим количеством строк. Вместо того чтобы изобретать для каждого примера свой набор данных, я взял готовую демонстрационную базу данных авиаперевозок1. Демобаза существует в нескольких вариантах; я использую версию большого объема от 15.08.2017. Для ее установки надо разархивировать файл с копией базы данных 2 и выполнить его в psql.
При разработке демобазы мы старались сделать схему данных достаточно простой, чтобы ее было легко понять без особых пояснений, но в то же время достаточно сложной, чтобы она позволяла строить осмысленные запросы. База наполнена реалистичными данными, которые упрощают понимание примеров и с которыми интересно работать.
Ниже я кратко опишу основные объекты демобазы, а полное описание можно прочитать по ссылке в сноске.
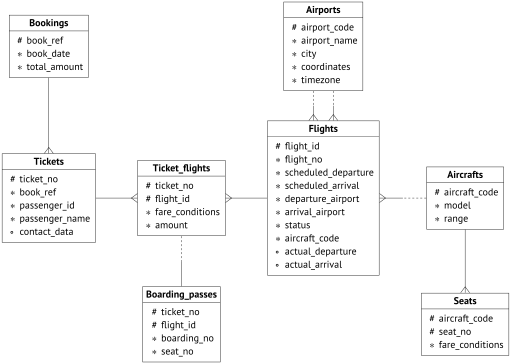
Основной сущностью является бронирование (таблица bookings). В одно бронирование можно включить несколько пассажиров, каждому из которых выдается электронный билет (tickets). Пассажир не является отдельной сущностью; будем считать, что все пассажиры уникальны.
Каждый билет включает один или несколько перелетов (ticket_flights). Несколько перелетов может появиться, когда выполняется полет с пересадками или билет взят «туда и обратно». В схеме данных нет жесткого ограничения, но предполагается, что все билеты в одном бронировании имеют одинаковый набор перелетов.
Каждый рейс (flights) следует из одного аэропорта (airports) в другой. Рейсы с одним номером имеют одинаковые пункты вылета и назначения, но будут отличаться датой отправления.
Представление routes выделяет из таблицы рейсов информацию о маршрутах, не зависящую от конкретных дат рейсов.
При регистрации на рейс пассажиру выдается посадочный талон (boarding_passes), в котором указано место в самолете. Пассажир может зарегистрироваться только на тот рейс, который есть у него в билете. Комбинация рейса и места в самолете должна быть уникальной, чтобы не допустить выдачу двух посадочных талонов на одно место.
Количество мест (seats) в самолете и их распределение по классам обслуживания зависят от конкретной модели самолета (aircrafts), выполняющего рейс. Предполагается, что у каждой модели есть только одна компоновка салона.
В одних таблицах используются суррогатные первичные ключи, в других — естественные (причем некоторые из них являются составными). Это сделано в демонстрационных целях и не является примером для подражания.
Демобазу можно рассматривать как резервную копию реальной системы: она содержит актуальные данные на определенный момент. Время этого момента сохранено в функции bookings.now. Ее можно использовать в запросах там, где в обычной жизни встретилась бы функция now.
Названия аэропортов, городов и моделей самолетов хранятся в таблицах airports_data и aircrafts_data на двух языках, русском и английском. В запросах обычно используются представления airports и aircrafts, показанные на ER-диаграмме. Они подставляют перевод в зависимости от языка, выбранного в параметре bookings.lang. Но имена базовых таблиц могут появляться в планах выполнения запросов. (по умолчанию: ru)
16.2. Простой протокол запросов
Простой вариант клиент-серверного протокола PostgreSQL 3 позволяет отправить серверу текст SQL-запроса и получить в ответ все строки результата, сколько бы их ни было4. Запрос, поступающий серверу, проходит несколько этапов: он разбирается, трансформируется, планируется и, наконец, исполняется.
Разбор
Во-первых, текст запроса необходимо разобрать 5 (parse), чтобы понять, что именно требуется выполнить.
Лексический и синтаксический разборы. Лексический анализатор разбирает текст запроса на лексемы 6 (такие как ключевые слова, строковые и числовые литералы), а синтаксический анализатор убеждается, что полученный набор лексем соответствует грамматике языка7. PostgreSQL использует для разбора стандартные инструменты — утилиты Flex и Bison.
Разобранный запрос представляется в памяти обслуживающего процесса в виде абстрактного синтаксического дерева.
Возьмем для примера следующий запрос:
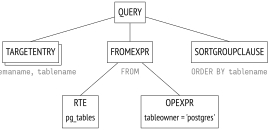
Лексический анализатор выделит пять ключевых слов, пять идентификаторов, строковый литерал и три односимвольные лексемы (для запятой, знака равенства и точки с запятой). Синтаксический анализатор построит из этих лексем дерево, показанное на рисунке в сильно упрощенном виде. Рядом с узлами дерева подписаны части запроса, которые им соответствуют:
SELECT
pg_table WHERE tableowner = 'postgres'
RTE — неочевидное сокращение от Range Table Entry. Именем range table в исходном коде PostgreSQL называются таблицы, подзапросы, результаты соединений — иными словами, наборы строк, над которыми работают операторы SQL8.
Семантический разбор. Задача семантического анализа 9 — определить, есть ли в базе данных таблицы и другие объекты, на которые запрос ссылается по имени, и есть ли у пользователя право обращаться к этим объектам. Вся необходимая для семантического анализа информация хранится в системном каталоге. (с. 24)
Семантический анализатор получает от синтаксического анализатора дерево разбора и перестраивает его, дополняя ссылками на конкретные объекты базы данных, указанием типов данных и другой информацией.
Полное дерево, построенное в результате разбора, можно получить в журнале сообщений сервера, установив параметр debug_print_parse, хотя практического смысла в этом немного.
Трансформация
Далее запрос может трансформироваться (переписываться)10.
Трансформации используются ядром для нескольких целей. Одна из них — заменять в дереве разбора имя представления на поддерево, соответствующее запросу этого представления.
Другой пример использования трансформаций ядром системы — реализация разграничения доступа на уровне строк 11 (row-level security).
На этапе трансформации также происходит преобразование предложений SEARCH и CYCLE для рекурсивных запросов12. (v. 14)
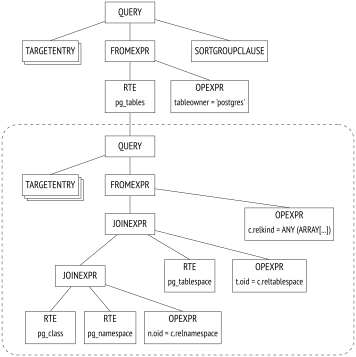
В примере выше pg_tables — представление; подставив его определение в текст запроса, мы получили бы:
На самом деле сервер не работает с текстовым представлением и выполняет все манипуляции только над деревом разбора. Его состояние после этапа трансформации показано на рисунке в упрощенном виде (а полный можно получить в журнале сообщений, установив параметр debug_print_rewritten).
Дерево разбора отражает синтаксическую структуру запроса, но ничего не говорит о том, в каком порядке будут выполнены операции.
PostgreSQL дает пользователю возможность написать свои собственные трансформации. Для этого используется система правил перезаписи 13 (rules).
Поддержка правил была заявлена как одна из целей 14 разработки Postgres, так что правила существовали еще на этапе университетского проекта и затем неоднократно переосмысливались. Это мощный, но сложный в отладке и понимании механизм. Поступало даже предложение убрать правила из PostgreSQL, но оно не нашло общей поддержки. В большинстве случаев вместо правил удобнее и безопаснее использовать триггеры.
Планирование
SQL — декларативный язык: запрос определяет, какие данные надо получить, но не говорит, как именно их получать.
Любой запрос можно выполнить разными способами. Для каждой операции, представленной в дереве разбора, могут существовать разные варианты ее реализации: например, данные из таблицы можно получить, прочитав всю таблицу (и отбросив ненужное), а можно найти подходящие строки с помощью индекса. Наборы строк всегда соединяются попарно, что приводит к огромному количеству вариантов, отличающихся порядком соединений. Кроме того, существуют разные алгоритмы соединений: например, можно перебирать строки одного набора и находить для них соответствие во втором наборе, а можно предварительно отсортировать оба набора и затем слить их вместе. Какие-то алгоритмы работают лучше в одних ситуациях, какие-то — в других.
Разница во времени выполнения между неоптимальными и оптимальными планами может составлять многие и многие порядки, поэтому планировщик15, выполняющий оптимизацию разобранного запроса, является одним из самых сложных компонентов системы.
Дерево плана. План выполнения также представляется в виде дерева, но его узлы содержат не логические, а физические операции над данными.
Для исследовательских целей полное дерево плана можно получить в журнале сообщений сервера, установив параметр debug_print_plan. А на практике текстовое представление плана выводит команда EXPLAIN16.
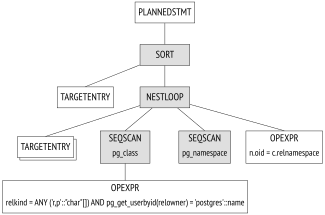
На рисунке выделены основные узлы дерева. Именно они и показаны ниже в выводе команды EXPLAIN.
Узлы Seq Scan в плане запроса соответствуют чтению таблиц, а узел Nested Loop — соединению. (с. 374) (с. 440)
Пока стоит обратить внимание на два момента:
из трех таблиц запроса в дереве осталось только две: планировщик понял, что одна из таблиц не нужна для получения результата и ее можно удалить из дерева плана;
каждый узел дерева снабжен информацией о предполагаемом числе продуцируемых строк (rows) и о стоимости (cost).
Перебор планов. PostgreSQL использует стоимостной оптимизатор17. Оптимизатор рассматривает потенциально возможные планы и оценивает предполагаемое количество ресурсов, необходимых для их выполнения (таких как операции ввода-вывода и такты процессора). Оценка оптимизатора, приведенная к числовому виду, называется стоимостью плана. Из всех просмотренных планов выбирается план с наименьшей стоимостью.
Проблема в том, что количество возможных планов экспоненциально зависит от количества соединяемых таблиц, и просто перебрать один за другим все варианты нереально даже для относительно простых запросов. Для сокращения пространства перебора традиционно используется алгоритм динамического программирования в сочетании с некоторыми эвристиками. Это позволяет увеличить количество таблиц в запросе, для которых может быть найдено математически точное решение за приемлемое время.
Точное решение задачи оптимизации не гарантирует, что найденный план действительно будет лучшим, поскольку планировщик использует упрощенные математические модели и может действовать на основе не вполне точной входной информации.
К сожалению, даже алгоритм динамического программирования занимает слишком много времени и требует слишком много памяти, когда количество соединений переваливает за десяток. Чтобы еще больше ограничить перебор, планировщик может зафиксировать порядок некоторых соединений в соответствии с синтаксической структурой запроса18.
Рассмотрим запрос, в котором таблицы перечислены через запятую в предложении FROM без явного указания JOIN:
Для такого запроса планировщик будет рассматривать все возможные комбинации попарных соединений. Запросу соответствует следующий (схематично показанный) фрагмент дерева разбора:
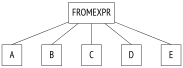
Ниже приведен график зависимости объема памяти, необходимого для планирования такого запроса, от количества таблиц в нем (данные получены командой EXPLAIN с параметром MEMORY): (v. 17)
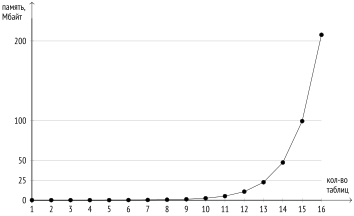
Время планирования также примерно удваивается с каждой добавляемой таблицей.
В другом примере соединения имеют структуру, определяемую предложением JOIN:
Дерево разбора отражает эту структуру:
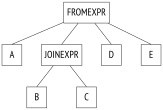
Обычно планировщик уплощает дерево соединений, преобразуя его к тому же виду, что в первом примере. Алгоритм рекурсивно обходит дерево, заменяя узлы joinexpr плоским списком нижележащих элементов19.
Но уплощение выполняется только при условии, что в плоском списке не появится более join_collapse_limit элементов. В данном примере пять элементов, поэтому при любых значениях параметра, меньших 5, узел joinexpr уплощаться не будет. (по умолчанию: 8)
Для планировщика это означает следующее:
таблица
Bдолжна быть соединена с таблицейC(или наоборот,CсB— на порядок соединения в паре ограничение не накладывается);таблицы
A,D,Eи результат соединенияBсCмогут быть соединены в любом порядке.
При значении параметра join_collapse_limit = 1 порядок любых явных соединений JOIN будет сохранен.
Кроме того, операнды FULL OUTER JOIN никогда не уплощаются, какое бы значение ни принимал параметр join_collapse_limit.
Параметр from_collapse_limit точно так же ограничивает уплощение подзапросов. Хотя внешне подзапросы не похожи на соединения JOIN, на уровне дерева разбора аналогия становится очевидной. (по умолчанию: 8)
Вот пример запроса:
Соответствующее ему дерево соединений показано на рисунке. Вся разница в том, что вместо узла joinexpr стоит узел fromexpr (отсюда и не совсем очевидное название параметра).
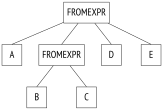
Таким образом, количество элементов на одном уровне дерева после процедуры уплощения, как правило, ограничено значениями join_collapse_limit и from_collapse_limit.
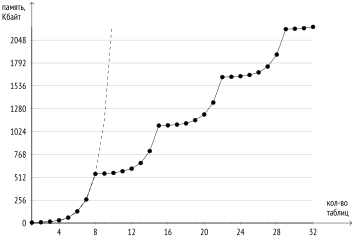
Ниже показано, сколько памяти требуется планировщику для запроса, содержащего только соединения JOIN. На графике видно, что с увеличением количества таблиц расход ресурсов прибывает экспоненциальными «ступеньками», сохраняя в целом линейный рост. Начальная ступенька образована первыми восьмью (join_collapse_limit) элементами, следующая добавляет к этой группе еще семь элементов и т. д. Такой подход позволяет за разумное время планировать запросы даже с очень большим количеством JOIN-соединений.
Для наглядности пунктиром показан и предыдущий график для запросов с соединениями через запятую.
Остается, однако, проблема запросов с большим количеством соединений через запятую. Включенный параметр geqo переключает планировщик на использование генетического алгоритма 20, если число элементов достигает значения параметра geqo_threshold. Генетический алгоритм работает существенно быстрее алгоритма динамического программирования (даже с учетом ограничений join_collapse_limit и from_collapse_limit), но не гарантирует нахождение оптимального плана. Для генетического алгоритма имеется целый ряд настроек21, но я не буду их рассматривать. (по умолчанию: on) (по умолчанию: 12)
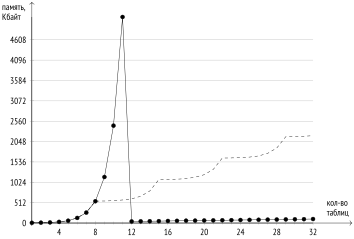
Ниже показан график потребности в памяти для запроса, содержащего соединения через запятую, с включенным параметром geqo. Видно, что когда количество таблиц доходит до двенадцати (geqo_threshold), необходимость в ресурсах резко сокращается и далее растет линейно и очень медленно.
Для сравнения пунктиром показан график для запросов с JOIN-соединениями.
Неполное уплощение дерева или переключение на генетический алгоритм приводит к произвольному сокращению рассматриваемых вариантов плана и, как следствие, к риску упустить оптимальный план и нестабильным результатам планирования. В таких случаях автору запроса может потребоваться взять на себя разбиение запроса на независимо оптимизируемые части:
Общие табличные выражения могут оптимизироваться отдельно от основного запроса; предложение
MATERIALIZEDгарантирует именно такое поведение22. (v. 12)Запросы внутри функций, написанных на любом языке, кроме SQL, оптимизируются отдельно от основного запроса (тело функции на SQL в некоторых случаях может подставляться в запрос 23).
Установка параметров join_collapse_limit и from_collapse_limit в единицу сохраняет порядок соединений, заданный синтаксической структурой запроса (что, скорее всего, слишком негибко).
Выбор лучшего плана. Для клиента оптимальность плана зависит от того, как предполагается использовать результат. Если результат нужен целиком (например, для построения отчета), план должен оптимизировать получение всех строк выборки. Но чтобы как можно быстрее получить первые строки (например, для вывода на экран), может потребоваться совершенно другой план.
PostgreSQL решает эту задачу, вычисляя две компоненты стоимости:
Первая компонента (начальная стоимость, startup cost) представляет затраты на подготовку к началу выполнения узла, а вторая (полная стоимость, total cost) — полные затраты на получение всех результирующих строк.
Иногда можно встретить утверждение, что начальная стоимость — это стоимость получения первой строки выборки, но это не вполне точно.
Чтобы решить, каким планам отдавать предпочтение, планировщик смотрит, используется ли курсор (команда SQL DECLARE или явное объявление курсора в PL/pgSQL)24. Если нет, то предполагается немедленное получение всех результирующих строк клиентом, и из просмотренных планов оптимизатор выбирает план с наименьшей полной стоимостью.
Для запроса, который выполняется с помощью курсора, выбирается план, оптимизирующий получение не всех строк, а только доли, равной значению параметра cursor_tuple_fraction. Говоря точнее25, выбирается план с наименьшим значением выражения (по умолчанию: 0.1)
Общая схема вычисления оценки. Чтобы получить общую оценку плана, необходимо оценить каждый из его узлов. Стоимость узла зависит от типа этого узла (очевидно, что стоимость чтения данных из таблицы и стоимость сортировки отличаются) и от объема обрабатываемых этим узлом данных (обычно чем меньше, тем дешевле). Тип узла известен, а для прогноза объема данных необходимо оценить кардинальность входных наборов (количество строк, принимаемых узлом на входе) и селективность узла (долю строк, которая останется у него на выходе). Для этого, в свою очередь, надо иметь статистическую информацию о данных: размер таблиц, распределение данных по столбцам. (с. 346)
Таким образом, оптимизация зависит от корректной статистики, собираемой и обновляемой процессом автоанализа.
Если в каждом узле плана кардинальность оценена правильно, то и стоимость обычно адекватно отражает реальные затраты. Основные ошибки планировщика связаны именно с неправильной оценкой кардинальности и селективности. Это может происходить из-за некорректной или устаревшей статистики, невозможности ее использования или — в меньшей степени — из-за несовершенства моделей, лежащих в основе планировщика.
Оценка кардинальности. Оценка кардинальности — рекурсивный процесс. Чтобы оценить кардинальность узла плана, надо:
оценить кардинальность каждого из дочерних узлов и получить количество строк, поступающих узлу на вход;
оценить селективность самого узла, то есть долю входящих строк, которая останется на выходе.
Произведение одного на другое и даст кардинальность узла.
Селективность представляется числом от 0 до 1. Селективность, близкая к нулю, обычно называется высокой, а близкая к единице — низкой. Это может показаться нелогичным, но селективность здесь понимается как избирательность: условие, выбирающее малую долю строк, обладает высокой селективностью (избирательностью), а условие, оставляющее почти все строки, — низкой.
Сначала рассчитываются кардинальности листовых узлов, в которых находятся методы доступа к данным. Для этого используется статистика, в частности общий размер таблицы.
Селективность условий, наложенных на таблицу, зависит от вида этих условий. В простейшем случае можно принять за селективность какую-то константу, хотя, конечно, планировщик старается использовать всю доступную информацию для уточнения оценки. Достаточно уметь оценивать селективность простых условий, а селективность условий, составленных с помощью логических операций, рассчитывается по формулам 26:
К сожалению, эти формулы предполагают независимость предикатов x и y. В случае коррелированных предикатов такая оценка будет неточной. (с. 365)
Для оценки кардинальности соединений вычисляется кардинальность декартова произведения (равная произведению кардинальностей двух наборов данных) и оценивается селективность условий соединения, которая опять же зависит от типа условий.
Аналогично оценивается кардинальность и других узлов, таких как сортировка или агрегация.
Важно отметить, что ошибка расчета кардинальности, возникшая в нижних узлах плана, распространяется выше, приводя в итоге к неверной оценке и выбору неудачного плана. Этот неприятный эффект усугубляется тем, что планировщик располагает статистической информацией только о таблицах, но не о результатах соединений.
Оценка стоимости. Процесс оценки стоимости также рекурсивен. Чтобы вычислить стоимость поддерева плана, надо рассчитать стоимости дочерних узлов, сложить их и добавить стоимость самого узла.
Стоимость работы узла рассчитывается на основе математической модели операции, которую выполняет данный узел. Входными данными для оценки служит кардинальность, которая уже рассчитана. Отдельно оцениваются начальная и полная стоимости.
Некоторые операции не требуют никакой подготовки и начинают выполняться немедленно; у таких узлов начальная стоимость будет равна нулю. Другие операции, наоборот, требуют выполнения предварительных действий. Например, узел сортировки обычно должен получить от дочернего узла все данные, чтобы начать работу. У таких узлов начальная стоимость будет отлична от нуля — эту цену придется заплатить, даже если вышестоящему узлу (или клиенту) потребуется только одна строка из всей результирующей выборки.
Стоимость отражает оценку планировщика и, если планировщик ошибается, может не коррелировать с реальным временем выполнения. Она нужна лишь для того, чтобы планировщик мог сравнивать разные планы одного и того же запроса в одних и тех же условиях. В остальных случаях сравнивать запросы (тем более разные) по стоимости — неправильно и бессмысленно. Например, стоимость могла быть недооценена из-за неправильной статистики; после актуализации статистики стоимость может вырасти, но стать более адекватной, и план на самом деле улучшится.
Исполнение
План, построенный в ходе оптимизации запроса, передается на исполнение 27. В памяти обслуживающего процесса создается портал 28 — объект, хранящий состояние выполняющегося запроса. Состояние представляется в виде дерева, повторяющего структуру дерева плана. Фактически узлы дерева работают как конвейер, запрашивая и передавая друг другу строки.
Выполнение начинается с корня. Корневой узел (в примере это операция сортировки sort) обращается за данными к дочернему узлу. Получив все строки, узел выполняет сортировку и отдает данные выше, то есть клиенту.
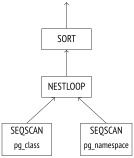
Некоторые узлы (как nestloop на рисунке) соединяют данные, полученные из разных источников. Такой узел обращается за данными к двум дочерним узлам. Получив две строки, удовлетворяющие условию соединения, узел сразу же передает результирующую строку наверх (в отличие от сортировки, которая сначала вынуждена получить все строки). На этом выполнение узла прерывается до тех пор, пока вышестоящий узел не затребует следующую строку. Таким образом, если нужен только частичный результат (например, из-за ограничения LIMIT), операция не будет выполняться полностью.
Два листовых узла дерева seqscan представляют обращение к таблицам. Когда вышестоящий узел обращается за данными, листовой узел читает очередную строку из соответствующей таблицы и возвращает ее.
Таким образом, часть узлов не хранит строки, а немедленно передает их выше и тут же забывает, но некоторым узлам требуется сначала сохранить — материализовать — все строки. Один из таких узлов — сканирование общего табличного выражения CTE Scan. Материализацию включает либо разработчик (явным указанием MATERIALIZED), либо планировщик (чтобы не вычислять одно и то же табличное выражение несколько раз). (v. 12)
Объем данных, подлежащих материализации, заранее неизвестен. В надежде, что строк будет немного, сначала для хранилища выделяется фрагмент оперативной памяти обслуживающего процесса размером work_mem. Пока этой памяти хватает, данные сохраняются в ней29. (по умолчанию: 4MB)
Если же память переполняется, все данные сбрасываются на диск во временный файл и при необходимости читаются из этого файла.
Тот же механизм материализации используется рекурсивными запросами (для рабочей и промежуточной таблиц), оконными функциями (для текущей рамки), табличными функциями (для накопления результата), триггерами (для сторонних таблиц и переходных отношений) и т. п. Он же применяется и в узле Materialize, который планировщик может вставлять в план для материализации вычисленных строк.
Похожий, но более сложный механизм применяется для сортировки. (с. 489)
Таким образом, в одном плане может быть несколько узлов, которым необходимо хранилище данных, поэтому для запроса может быть выделено несколько фрагментов памяти, каждый размером work_mem. Общий объем оперативной памяти, доступный запросу, никак не ограничен, а предельный объем временных файлов можно установить параметром temp_file_limit. (по умолчанию: -1)
16.3. Расширенный протокол запросов
При использовании простого протокола запросов каждая команда, даже если она повторяется из раза в раз, проходит все перечисленные выше этапы:
разбор;
трансформацию;
планирование;
исполнение.
Но нет никакого смысла разбирать один и тот же запрос заново. Нет смысла разбирать и запросы, отличающиеся только константами, — структура дерева разбора не изменится.
Еще одно неудобство простого способа выполнения запросов состоит в том, что клиент получает всю выборку сразу, сколько бы строк она ни содержала.
В принципе, оба ограничения можно преодолеть, используя команды SQL: первое — подготавливая запрос командой PREPARE и выполняя его с помощью EXECUTE, второе — создавая курсор командой DECLARE и извлекая строки с помощью FETCH. Но в этом случае на клиента ложится ответственность за именование создаваемых объектов, а сервер нагружается лишней работой по разбору дополнительных команд.
Поэтому расширенный клиент-серверный протокол позволяет детально управлять отдельными этапами выполнения операторов на уровне команд самого протокола.
Подготовка
На этапе подготовки запрос разбирается и трансформируется обычным образом, но полученное дерево разбора сохраняется в памяти обслуживающего процесса.
В PostgreSQL отсутствует глобальный кеш запросов. Минусы такого решения понятны — каждый обслуживающий процесс вынужден разбирать все запросы самостоятельно, даже если такой же запрос уже был разобран другим процессом. Но есть и плюсы. Кеш в общей памяти легко может стать узким местом из-за необходимости блокировок. Один клиент, выполняющий множество мелких, но разных запросов (отличающихся, например, только константами), создает большую нагрузку на такой кеш, что может сказаться на производительности всего экземпляра. В PostgreSQL разбор запросов выполняется локально и поэтому не влияет на другие процессы. (с. 305)
При подготовке запроса его можно параметризовать. Воспользуемся тем, что psql позволяет задействовать расширенный протокол: (v. 18)
Посмотреть именованные подготовленные операторы можно в представлении pg_prepared_statements:
Увидеть таким образом безымянные подготовленные операторы (которые, например, PL/pgSQL создает для каждого выражения) не получится. Конечно, сеансу доступны только собственные операторы; заглянуть в память другого сеанса невозможно.
Привязка параметров
Перед выполнением подготовленного запроса выполняется привязка фактических значений параметров:
Преимущество параметров подготовленных операторов перед конкатенацией литералов со строкой запроса — принципиальная невозможность внедрения SQL-кода, поскольку никакое значение параметра не сможет изменить уже построенное дерево разбора. Чтобы достичь того же уровня безопасности без подготовленных операторов, требуется аккуратно экранировать каждое значение, полученное из ненадежного источника.
Планирование и исполнение
Когда дело доходит до выполнения подготовленного оператора, происходит планирование с учетом значений фактических параметров, после чего план передается на исполнение.
Учитывать значения параметров важно, поскольку оптимальные планы для разных значений могут не совпадать. Например, поиск очень дорогих бронирований использует индекс, так как планировщик предполагает, что подходящих строк не очень много:
Однако под следующее условие попадают вообще все бронирования, поэтому индекс бесполезен, и таблица просматривается целиком:
В некоторых случаях планировщик запоминает не только дерево разбора, но и план запроса, чтобы не выполнять планирование повторно. Такой план, построенный без учета значений параметров, называется общим планом (в отличие от частного плана, учитывающего фактические значения)30.
Очевидный случай, когда можно перейти на общий план без ущерба для эффективности, — запрос без параметров.
Подготовленные операторы с параметрами первые пять раз всегда оптимизируются с учетом фактических значений; при этом вычисляется средняя стоимость частных планов. Начиная с шестого раза, если общий план оказывается в среднем выгоднее, чем частные (с учетом того, что частные планы необходимо каждый раз строить заново 31), планировщик запоминает общий план и дальше использует его, уже не повторяя оптимизацию.
Подготовленный оператор plane уже был один раз выполнен. Теперь перейдем с метакоманд psql на обычные команды SQL: это не совсем то же самое, что прямое использование команд протокола, но в конечном счете эффект тот же. Зато так будет проще увидеть, что после следующих трех выполнений по-прежнему используются частные планы — обратите внимание на значение параметра в плане запроса:
После еще одного, пятого выполнения планировщик переключится на использование общего плана — он совпадает с частными планами, имеет ту же стоимость, но его можно запомнить и больше не тратить ресурсы на оптимизацию. Команда EXPLAIN показывает теперь не значение параметра, а его номер:
Несложно представить ситуацию, в которой по неудачному стечению обстоятельств первые несколько частных планов будут более дорогими, чем общий план, а последующие оказались бы эффективнее общего — но планировщик уже не будет их рассматривать. Кроме того, планировщик сравнивает оценки стоимостей, а не фактические ресурсы, и это также может приводить к ошибкам.
Поэтому при неправильном автоматическом решении можно принудительно выбрать общий либо частный план, установив соответствующее значение параметра plan_cache_mode: (v. 12) (по умолчанию: auto)
Представление pg_prepared_statements показывает в том числе и статистику выбора планов: (v. 14)
Получение результатов
Расширенный протокол запросов позволяет клиенту принимать результат построчно или частями по нескольку строк. Почти тот же эффект дает использование SQL-курсоров (за исключением лишней работы для сервера и того факта, что планировщик оптимизирует получение не всей выборки, а первых cursor_tuple_fraction строк):
Если запрос возвращает много строк и клиенту нужны они все, то огромное значение для скорости передачи данных играет размер выборки, получаемой за один раз. Чем больше выборка, тем меньше коммуникационных издержек на обращение к серверу и получение ответа. Но с ростом выборки эффект сокращения издержек уменьшается: разница между одной строкой и десятью может быть колоссальной, а между сотней и тысячей — уже почти незаметной.
backend/tcop/postgres.c, функция exec_simple_query. ↩︎
postgrespro.ru/docs/postgresql/18/parser-stage; backend/parser/README. ↩︎
backend/optimizer/plan/initsplan.c, функция deconstruct_jointree. ↩︎
postgrespro.ru/docs/postgresql/18/geqo; backend/optimizer/geqo/geqo_main.c. ↩︎
postgrespro.ru/docs/postgresql/18/runtime-config-query#RUNTIME-CONFIG-QUERY-GEQO. ↩︎
backend/optimizer/plan/planner.c, функция standard_planner. ↩︎
backend/optimizer/util/pathnode.c, функция compare_fractional_path_costs. ↩︎
backend/optimizer/path/clausesel.c, функции clauselist_selectivity_ext и clauselist_selectivity_or. ↩︎
postgrespro.ru/docs/postgresql/18/executor; backend/executor/README. ↩︎
backend/utils/cache/plancache.c, функция choose_custom_plan. ↩︎
backend/utils/cache/plancache.c, функция cached_plan_cost. ↩︎