15 Блокировки в памяти
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
15.1. Спин-блокировки
Для защиты структур в разделяемой оперативной памяти используются не обычные тяжелые блокировки, а несколько видов более легких и менее затратных блокировок.
Самые простые из них — спин-блокировки, или спинлоки (spinlock). Они предназначены для захвата на очень короткое время (несколько инструкций процессора) и защищают отдельные участки памяти от одновременного изменения.
Спин-блокировки реализуются на основе атомарных инструкций процессора, таких как compare-and-swap1. Они поддерживают единственный исключительный режим. Если блокировка занята, ожидающий процесс выполняет активное ожидание — команда повторяется («крутится» в цикле, отсюда и название). Если блокировку не удается получить за определенное время, процесс ненадолго приостанавливается и затем снова начинает цикл активного ожидания.
Такая стратегия имеет смысл, если вероятность конфликта оценивается как очень низкая, и поэтому, получив отказ, можно ожидать освобождения блокировки уже через несколько инструкций.
Спин-блокировки не позволяют обнаруживать взаимоблокировки. С прикладной точки зрения остается только верить в то, что разработчики PostgreSQL используют эти блокировки правильно.
15.2. Легкие блокировки
Следом идут так называемые легкие блокировки 2 (lightweight locks, lwlocks). Их захватывают на время, необходимое для работы со структурой данных (например, с хеш-таблицей или списком указателей). Как правило, легкие блокировки удерживаются недолго, но в некоторых случаях они защищают операции ввода-вывода, так что, в принципе, время может оказаться и значительным.
Имеются два режима: исключительный (для изменения данных) и разделяемый (только для чтения). Поддерживается очередь ожидания, но пока блокировка удерживается в разделяемом режиме, другие читающие процессы проходят вне очереди. В системах с высокой степенью параллельности и большой нагрузкой это может приводить к неприятным эффектам3.
Механизм проверки взаимоблокировок не предусмотрен; корректное использование легких блокировок, как и спин-блокировок, остается на совести разработчиков PostgreSQL.
15.3. Примеры
Чтобы получить некоторое представление о том, как и где используются спинлоки и легкие блокировки, рассмотрим три примера структур в разделяемой памяти: буферный кеш, буферы журнала предзаписи и кеш SLRU. Я назову далеко не все блокировки; полная картина слишком сложна и представляет интерес только для разработчиков ядра.
Буферный кеш
Чтобы обратиться к хеш-таблице, позволяющей найти буфер в кеше, процесс должен захватить легкую блокировку  BufferMapping: в разделяемом режиме — для чтения, в исключительном — для изменений. (с. 183)
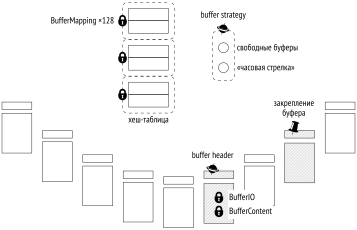
Обращения к хеш-таблице происходят очень активно, и зачастую эта блокировка становится узким местом. Для увеличения гранулярности она фактически устроена как транш, состоящий из 128 отдельных легких блокировок, каждая из которых защищает свою часть хеш-таблицы 4.
Впервые единичную блокировку, защищающую хеш-таблицу, преобразовали в транш размером 16 в версии PostgreSQL 8.2 в 2006 году. Спустя 10 лет в версии 9.5 размер транша увеличили до 128. На современных многоядерных системах порой и этого значения оказывается мало.
Процесс получает доступ к заголовку буфера, захватывая спин-блокировку  buffer header 5 (название условное, поскольку спин-блокировки не имеют внешних имен). Отдельные операции, такие как увеличение счетчика обращений, могут выполняться и без явных блокировок с помощью атомарных инструкций процессора.
Чтобы прочитать содержимое буфера, требуется блокировка  BufferContent. Она располагается в заголовке данного буфера6. Обычно эта блокировка захватывается только на время, необходимое для чтения указателей на версии строк, а дальше достаточно защиты, предоставляемой
 закреплением буфера. Для изменения содержимого буфера блокировка BufferContent должна захватываться в исключительном режиме. (с. 189)
При чтении буфера с диска (или записи на диск) захватывается также блокировка  BufferIO в заголовке буфера; фактически это не настоящая блокировка, а признак, играющий ее роль7. Блокировка сигнализирует другим процессам, заинтересованным в этой странице, что необходимо дождаться окончания ввода-вывода.
Указатель на свободные буферы и «часовая стрелка» механизма вытеснения также защищены одной общей спин-блокировкой  buffer strategy8.
Буферы журнала предзаписи
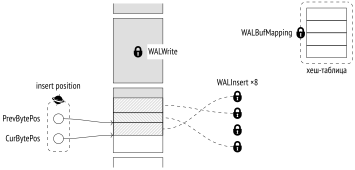
Для журнального кеша тоже используется хеш-таблица, содержащая отображение страниц в буферы. В отличие от хеш-таблицы буферного кеша, эта таблица защищена единственной легкой блокировкой  WALBufMapping, поскольку размер журнального кеша гораздо меньше (обычно он равен одному сегменту) и обращение к буферам более упорядочено9.
Запись страниц журнала на диск защищена легкой блокировкой  WALWrite, чтобы в каждый момент времени только один процесс мог выполнять эту операцию.
Чтобы создать журнальную запись, процесс сначала резервирует место внутри страницы WAL, а затем заполняет его необходимыми данными. Резервирование строго упорядочено; процесс должен захватить спин-блокировку  insert position, защищающую указатель вставки10. Но заполнять уже зарезервированное место могут одновременно несколько процессов. Для этого процесс должен захватить любую из восьми легких блокировок, образующих транш
 WALInsert11.
Кеш SLRU
Кеши SLRU (simple least-recently-used) 12 применяются для страниц таких структур данных, как мультитранзакции (multixact), статусы транзакций (clog) или вложенные транзакции (subtrans). В отличие от буферного кеша, кеш SLRU устроен довольно просто и рассчитан на то, что основной поток изменений и чтений приходится на последние страницы: например, завершение транзакции и проверка ее состояния обычно происходят примерно в одно время, после чего к статусу этой транзакции уже никто не обращается. Вытесняются страницы, к которым дольше всего не было обращений. (с. 86)
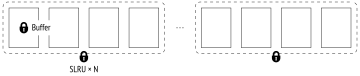
Кеш поделен на банки по 16 страниц; принадлежность страницы банку определяется четырьмя младшими битами ее номера. Такая схема позволяет обойтись без хеш-таблицы: внутри небольшого банка достаточно линейного поиска. Общий размер кеша, обслуживающего конкретную структуру данных, настраивается индивидуально.
Каждый банк защищен своей легкой блокировкой SLRU (имя транша зависит от структуры данных: например, транш для clog называется XactSLRU). Каждая страница также имеет собственную легкую блокировку Buffer (для clog — XactBuffer). Процессы удерживают блокировку банка для получения или изменения состояния входящих в него буферов. Получить блокировку банка требуется и для захвата блокировки страницы с целью записать ее на диск или прочитать с диска, но на время ввода-вывода блокировка банка освобождается, чтобы процессы могли работать с другими страницами этого банка.
15.4. Мониторинг ожиданий
Безусловно, блокировки необходимы для корректной работы, но они могут приводить и к нежелательным ожиданиям. Такие ожидания полезно отслеживать, чтобы разобраться в причине их возникновения.
Самый простой способ получить представление о длительных блокировках в системе — включить параметр log_lock_waits. В этом случае в журнал сообщений сервера будут попадать подробные сведения о блокировке каждый раз, когда транзакция ждет дольше, чем deadlock_timeout. Эти данные выводятся при завершении проверки на взаимоблокировки, отсюда и имя параметра. (по умолчанию: off) (по умолчанию: 1s) (с. 286)
Но гораздо более полную и полезную информацию можно найти в представлении pg_stat_activity. Когда процесс — системный или обслуживающий — не может выполнять свою работу и ждет чего-либо, это ожидание отображается в столбцах wait_event_type (тип ожидания) и wait_event (имя конкретного ожидания).
Все ожидания можно разделить на несколько типов13.
Большую категорию составляют ожидания различных блокировок:
Lock — тяжелых блокировок;
LWLock — легких блокировок;
BufferPin — закрепленного буфера.
Каждый тип конкретизируется именем ожидания. Например, для легких блокировок это будет имя блокировки или соответствующего транша14.
Но процессы могут ожидать и других событий:
IO — ввода-вывода, когда требуется записать или прочитать данные;
Client — данных от клиента (в этом состоянии обычно проводит бóльшую часть времени psql);
IPC — данных от другого процесса;
Extension — специфического события, зарегистрированного расширением;
InjectionPoint — выполнения кода в точке внедрения с целью тестирования PostgreSQL (такое событие не появляется при эксплуатации). (v. 17)
Бывают ситуации, когда процесс просто не выполняет никакой полезной работы. К этой категории относятся ожидания:
Activity — фоновых процессов в своем основном цикле;
Timeout — таймера.
Как правило, такие ожидания «нормальны» и не говорят о каких-либо проблемах. Однако, например, событие SpinDelay типа Timeout свидетельствует об ожидании спин-блокировки. (v. 17)
Следует учитывать, что представление показывает только те ожидания, которые соответствующим образом обрабатываются в исходном коде15. Если имя типа ожидания не определено, процесс не находится ни в одном известном ожидании. Такое время следует считать неучтенным, так как это не означает со стопроцентной вероятностью, что процесс ничего не ждет; на самом деле неизвестно, что именно происходит в этот момент.
В данном случае во время обращения к представлению все фоновые служебные процессы «бездельничали», а обслуживающий процесс (client backend) был занят выполнением запроса и ничего не ждал.
15.5. Семплирование
К сожалению, представление pg_stat_activity показывает информацию об ожиданиях только на текущий момент; статистика не накапливается. Единственный способ получить картину ожиданий во времени — семплирование состояния представления с определенным интервалом.
Необходимо учитывать вероятностный характер семплирования. Чем меньше длится ожидание по отношению к периоду семплирования, тем меньше вероятность того, что это ожидание будет зафиксировано. Поэтому чем больше период, тем большее количество измерений требуется, чтобы получить достоверную картину. А повышение частоты семплирования приводит к увеличению накладных расходов. По этой же причине семплирование практически бесполезно для анализа короткоживущих сеансов.
Встроенных средств для семплирования не предусмотрено, но в качестве примера мы воспользуемся расширением pg_wait_sampling16. Необходимо прописать библиотеку в параметр shared_preload_libraries и перезапустить сервер.
Теперь установим расширение в базе данных:
Расширение позволяет просмотреть последние ожидания, которые сохраняются в кольцевой буфер и постепенно перезаписываются новыми данными. Но гораздо интереснее получить профиль ожиданий — накопленную статистику за все время работы.
Например, посмотрим на ожидания, возникающие при работе эталонного тестирования. Запустим утилиту pgbench и, пока она работает, определим номер процесса:
Профиль ожиданий после окончания работы:
С установками по умолчанию (параметр pg_wait_sampling.profile_period) значения сохраняются 100 раз в секунду. Поэтому, чтобы оценить длительность ожиданий в секундах, значение count надо делить на 100; общая длительность будет примерно соответствовать времени работы процесса. (по умолчанию: 10ms) (v. 1.1.6)
В данном случае бóльшую часть времени утилита выполняла полезную работу. «Непроизводственные» ожидания в основном связаны с синхронизацией журнальных записей с диском. Этот пример хорошо иллюстрирует понятие неучтенного времени. Обработка события WALSync появилась в версии PostgreSQL 12; на более ранней версии профиль не содержал бы первой строки, хотя само ожидание, разумеется, имело бы место.
Легкая блокировка ProcArray защищает одноименную структуру данных в разделяемой памяти сервера. (с. 99)
А вот как будет выглядеть профиль, если искусственно замедлить работу файловой системы (например, с помощью slowfs 17), чтобы любая операция ввода-вывода занимала 0,1 секунды:
Теперь на первое место вышли операции ввода-вывода, главным образом связанные с записью журнала в синхронном режиме. Поскольку запись журнала на диск защищена легкой блокировкой WALWrite, соответствующая строка также присутствует в профиле.
Очевидно, что эта блокировка запрашивалась и в предыдущем примере, но, поскольку ее ожидание было короче, чем период семплирования, она либо попала в выборку очень небольшое количество раз, либо не попала вовсе. Это еще раз показывает, что анализ коротких ожиданий требует семплирования в течение достаточно продолжительного времени.
www.postgresql.org/message-id/flat/CAPpHfdvJhO1qutziOp%3Ddy8TO8Xb4L38BxgKG4RPa1up1Lzh_ UQ%40mail.gmail.com. ↩︎
backend/storage/buffer/bufmgr.c; include/storage/buf_internals.h, макрос BufMappingPartitionLock. ↩︎
backend/storage/buffer/bufmgr.c, функция LockBufHdr. ↩︎
backend/storage/buffer/bufmgr.c, функция StartBufferIO. ↩︎
backend/access/transam/xlog.c, функция AdvanceXLInsertBuffer. ↩︎
backend/access/transam/xlog.c, функция ReserveXLogInsertLocation. ↩︎
backend/access/transam/xlog.c, функция WALInsertLockAcquire. ↩︎
postgrespro.ru/docs/postgresql/18/monitoring-stats#WAIT-EVENT-TABLE. ↩︎
postgrespro.ru/docs/postgresql/18/monitoring-stats#WAIT-EVENT-LWLOCK-TABLE. ↩︎