10 Журнал предзаписи
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
10.1. Журналирование
В случае сбоя, например при выключении электропитания либо при отказе СУБД или операционной системы, теряется все содержимое оперативной памяти; остается только информация, записанная на диск. Чтобы сервер мог стартовать после сбоя, необходимо восстановить согласованность данных. Если при сбое пострадал сам диск, та же задача возникает и при восстановлении из резервной копии.
Один из теоретически возможных способов — все время поддерживать данные на диске в согласованном виде. Фактически это означает необходимость постоянной записи отдельных страниц на диск (а случайная запись обходится дороже последовательной), причем в таком порядке, что ни в какой момент времени согласованность не нарушается (а это трудно, особенно для сложно организованных индексов).
PostgreSQL, как и большинство СУБД, использует другой подход.
В процессе работы часть актуальных данных хранится только в оперативной памяти и записывается на диск (или на другой энергонезависимый носитель) отложенно. Поэтому данные на диске рассогласованы в течение всего времени работы сервера — разные страницы оказываются записанными по состоянию на разные моменты времени. При этом каждое действие в оперативной памяти (например, изменение страницы в буферном кеше) журналируется: создается и сохраняется на диске журнальная запись, содержащая минимальную информацию, достаточную для повторения того же действия в случае необходимости1.
Журнальная запись об изменении страницы в обязательном порядке попадает на диск перед тем, как туда попадет измененная страница. Отсюда и название: журнал предзаписи (write-ahead log). Это требование дает возможность в случае сбоя прочитать с диска журнал и повторить те операции, которые были выполнены до сбоя, но результат которых не успел дойти до диска из оперативной памяти и пропал.
Как правило, вести журнал эффективнее, чем записывать отдельные страницы. Журнал представляет собой последовательный поток, с записью которого неплохо справляются даже HDD-диски. К тому же журнальная запись может быть меньше страницы по размеру.
Журналировать нужно все операции, при выполнении которых есть риск получить несогласованность на диске в случае сбоя. В частности, в журнал записываются следующие действия:
изменение страниц отношений в буферном кеше — сброс измененной страницы на диск откладывается;
фиксация и отмена транзакций — изменение статуса происходит в буферах clog и тоже попадает на диск не сразу;
файловые операции (создание и удаление файлов и каталогов, например, при создании таблицы) — такие операции должны происходить синхронно с изменением данных.
В журнал не записываются:
операции с нежурналируемыми (
UNLOGGED) таблицами;операции с нежурналируемыми последовательностями (как правило, относящимися к нежурналируемым таблицам); (v. 15)
операции с временными таблицами и последовательностями — время жизни таких объектов в любом случае не превышает время жизни создавшего их сеанса.
Журнал используется не только для восстановления после сбоя, но и для восстановления на произвольный момент времени из резервной копии, а также для репликации.
10.2. Устройство журнала
Логическая структура
Логически журнал 2 можно представить себе как последовательность записей различной длины. Каждая запись содержит данные о некоторой операции, предваренные стандартным заголовком3. В заголовке, в числе прочего, указаны:
номер транзакции, к которой относится запись;
менеджер ресурсов, ответственный за интерпретацию записи 4;
контрольная сумма для обнаружения повреждений данных;
длина записи;
ссылка на предыдущую запись журнала.
Обычно журнал читается в прямом направлении, но, например, утилита pg_rewind просматривает его в обратном.
Сами данные имеют разный формат и смысл. Например, они могут представлять собой некоторый фрагмент страницы, который надо записать поверх ее содержимого с определенным смещением. Менеджер ресурсов «понимает», как расшифровать и воспроизвести запись. Есть отдельные менеджеры для таблиц, для каждого типа индекса, для статуса транзакций и других сущностей. Полный их список можно получить командой pg_waldump -r list.
В разделяемой памяти сервера для журнала выделены специальные буферы. Размер журнального кеша задается параметром wal_buffers. Значение по умолчанию подразумевает автоматическую настройку: выделяется 16 Мбайт (размер журнального сегмента) или меньше при совсем небольших размерах буферного кеша. (по умолчанию: -1) (с. 216)
Журнальный кеш похож по своему устройству на буферный, но работает преимущественно в режиме кольцевого буфера: записи добавляются в «голову», а сохраняются на диск с «хвоста». Слишком маленький размер журнального кеша приведет к тому, что синхронизация с диском будет выполняться чаще, чем необходимо.
Позиция уже сохраненных записей («хвост» буфера) и позиция вставки («голова» буфера) в ненагруженной системе почти всегда будут совпадать:
Чтобы сослаться на определенную запись, используется тип данных pg_lsn (log sequence number, LSN), представляющий 64-битное смещение в байтах до журнальной записи относительно начала журнала. LSN выводится как два 32-битных числа в шестнадцатеричной системе через косую черту.
Создадим таблицу:
Начнем транзакцию и запомним позицию вставки в журнал:
Теперь выполним какую-нибудь операцию, например обновим строку:
Изменение выполняется в странице, находящейся в буферном кеше в оперативной памяти. Информация об изменении сохраняется и в журнальную страницу, также в оперативной памяти. Поэтому позиция вставки увеличивается:
Чтобы гарантировать, что измененная страница данных будет вытеснена на диск строго позже, чем журнальная запись, в заголовке страницы сохраняется номер LSN последней записи, относящейся к этой странице. Позицию можно проверить с помощью расширения pageinspect:
Для всего кластера баз данных используется один общий журнал, и в него все время попадают новые записи. Поэтому номер LSN на странице может оказаться меньше, чем значение, которое вернула чуть раньше функция pg_current_wal_insert_lsn. Но в системе, где ничего не происходит, цифры совпадут.
Теперь завершим транзакцию:
Запись о фиксации также попадает в журнал, и позиция снова меняется:
Фиксация меняет статус транзакции в страницах clog, располагающихся в SLRU-кеше. Чтобы страницу clog нельзя было вытеснить на диск раньше, чем соответствующую журнальную запись, для страниц clog тоже отслеживается номер LSN последней журнальной записи. Но эта информация хранится не в самой странице, а в оперативной памяти. (с. 85) (с. 309)
В какой-то момент созданные журнальные записи окажутся на диске. После этого страницы данных и clog могут быть вытеснены из кеша. Если бы потребовалось вытеснить их раньше, это было бы обнаружено, и журнальные записи были бы принудительно сброшены на диск первыми5. (с. 235)
Зная две позиции LSN, можно получить размер журнальных записей между ними (в байтах) простым вычитанием одной позиции из другой. Надо только привести позиции к типу pg_lsn:
В данном случае обновление строки и фиксация потребовали около сотни байтов в журнале.
Таким же способом можно оценить, какой объем журнальных записей генерируется сервером за единицу времени при определенной нагрузке. Эта информация потребуется при настройке контрольной точки.
Физическая структура
На диске журнал хранится в каталоге PGDATA/pg_wal в виде файлов-сегментов. Параметр wal_segment_size, доступный только для чтения, показывает размер сегмента. (по умолчанию: 16MB)
Для нагруженных систем увеличение размера сегментов может снизить накладные расходы, но эта настройка выполняется только при инициализации кластера (initdb --wal-segsize).
Журнальные записи попадают в текущий файл; когда он заканчивается — начинает использоваться следующий.
Можно узнать, в каком файле мы найдем нужную позицию и с каким смещением от начала файла:
Имя файла состоит из двух частей. Старшие восемь шестнадцатеричных разрядов показывают номер ветви времени, которая используется при восстановлении из резервной копии, а остаток соответствует старшим разрядам LSN (младшие разряды LSN показывает поле file_offset).
Журнальные файлы можно посмотреть специальной функцией:
Заглянуть в заголовки созданных журнальных записей можно либо утилитой pg_waldump, либо с помощью расширения pg_walinspect: (v. 15)
Здесь мы видим заголовки двух записей.
Первая — операция HOT_UPDATE, относящаяся к менеджеру ресурсов Heap. В столбце block_ref указаны имя файла и номер обновленной табличной страницы: (с. 115)
Вторая запись — COMMIT, относящаяся к менеджеру ресурсов Transaction.
10.3. Контрольная точка
Для восстановления согласованности после сбоя необходимо последовательно читать журнал и применять к страницам те записи, которые относятся к пропавшим изменениям. Чтобы их обнаружить, надо сравнить LSN страницы на диске с LSN журнальной записи. Однако остается непонятным, с какой именно записи следует начинать восстановление. Если начать слишком поздно, то к страницам, записанным на диск раньше этого момента, будут применены не все изменения, а это приведет к необратимому повреждению данных. Начать же с самого начала нереально: невозможно хранить такой потенциально огромный объем данных, и невозможно смириться со столь же огромным временем восстановления. Нужна такая постепенно продвигающаяся вперед контрольная точка, с которой можно безопасно начинать восстановление; предшествующие ей журнальные записи, соответственно, можно удалять.
Самый простой вариант получить контрольную точку — периодически приостанавливать работу системы и сбрасывать на диск все грязные страницы буферного и других кешей. Такой способ, конечно, никуда не годится, поскольку в эти моменты система будет замирать на неопределенное, но весьма существенное время.
Поэтому на практике контрольная точка растягивается во времени и фактически превращается в отрезок. Выполнением контрольной точки занимается специальный фоновый процесс checkpointer 6.
Начало контрольной точки. Сначала процесс контрольной точки сбрасывает на диск структуры, которые можно записать одномоментно благодаря их небольшому объему. К ним относятся объекты из кеша SLRU (такие как статусы транзакций clog или вложенные транзакции) и некоторые другие. (с. 309)
Выполнение контрольной точки. Основное время выполнения контрольной точки занимает запись грязных страниц буферного кеша 7.
Сначала в заголовках всех грязных на текущий момент (момент начала контрольной точки) буферов проставляется специальный флаг. Это происходит быстро, поскольку не связано с вводом-выводом.
Затем процесс контрольной точки постепенно проходит по всем буферам и сбрасывает помеченные на диск. Страницы при этом не вытесняются из кеша, а только записываются, поэтому не нужно обращать внимания ни на число обращений к буферу, ни на его закрепление.
Страницы сбрасываются по порядку номеров, чтобы запись на диск была по возможности последовательной, а не случайной. При этом запись в разные табличные пространства (которые могут соответствовать разным физическим устройствам) чередуется для равномерного распределения нагрузки. (с. 26)
Помеченные буферы могут также быть записаны и обслуживающими процессами — смотря кто доберется до буфера первым. В любом случае при записи снимается установленный ранее флаг, так что (для целей контрольной точки) буфер будет записан только один раз.
Естественно, в ходе выполнения контрольной точки страницы продолжают изменяться в буферном кеше. Но новые грязные буферы не помечены флагом, и процесс контрольной точки не будет их записывать.
Завершение контрольной точки. Когда все буферы, которые были грязными на момент начала контрольной точки, оказываются записанными, контрольная точка считается завершенной. Теперь (но не раньше) момент начала используется в качестве той точки, с которой надо начинать восстановление. Все предшествующие журнальные записи больше не нужны.
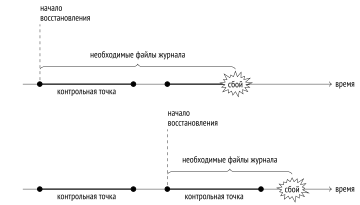
В конце своей работы процесс создает журнальную запись об окончании контрольной точки, указывая LSN момента ее начала.
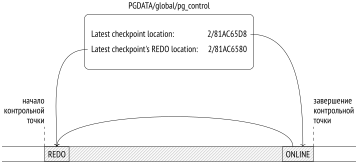
Кроме того, в файле PGDATA/global/pg_control обновляется указание на последнюю пройденную контрольную точку. (До завершения процесса pg_control указывает на предыдущую.)
Чтобы окончательно разобраться, что на что указывает, рассмотрим небольшой пример.
Сделаем несколько страниц в буферном кеше грязными:
Запомним текущую позицию в журнале:
Теперь выполним контрольную точку вручную. Все грязные страницы будут сброшены на диск; поскольку в системе ничего не происходит, новых грязных страниц не появится:
Посмотрим, как контрольная точка отразилась в журнале. Запись CHECKPOINT_REDO отмечает начало контрольной точки, а CHECKPOINT_ONLINE — ее завершение: (v. 17)
Между двумя этими позициями в журнале будут располагаться другие записи, порожденные продолжающим свою работу сервером.
До версии PostgreSQL 10 для журнала предзаписи часто использовался акроним XLOG (transaction log). Следы этого именования остались не только в названии менеджера ресурсов, но и в исходном коде.
Ту же информацию найдем и в управляющем файле:
10.4. Восстановление
При старте сервера первым делом запускается процесс postmaster. В свою очередь он запускает процесс startup 8, задача которого — обеспечить восстановление, если произошел сбой.
Чтобы определить, требуется ли восстановление, startup читает управляющий файл pg_control и проверяет статус кластера. Утилита pg_controldata позволяет заглянуть в содержимое файла:
Статус аккуратно остановленного сервера — «shut down». Статус «in production» у неработающего сервера свидетельствует о сбое. В этом случае процесс startup автоматически выполняет восстановление с позиции начала последней пройденной контрольной точки из того же файла pg_control.
Если в каталоге PGDATA присутствует файл backup_label из резервной копии, позиция начала восстановления читается из него.
Процесс последовательно читает журнал, начиная с найденной позиции, и применяет журнальные записи к страницам данных, если LSN страницы меньше LSN записи. Если же LSN страницы оказался больше, то запись применять не нужно, а точнее говоря — нельзя, поскольку записи рассчитаны на строго последовательное применение.
Однако некоторые записи формируются как полный образ страницы (full page image, FPI). Полный образ можно применить к любому состоянию страницы, поскольку оно все равно будет стерто. Такие изменения называют идемпотентными. Другой пример идемпотентного действия — запись об изменении статуса транзакции: каждой транзакции соответствуют отдельные фиксированные биты в clog, установка которых не зависит от их предыдущего значения. Поэтому внутри страниц clog нет необходимости хранить LSN последнего изменения.
Журнальные записи применяются к страницам в буферном кеше, как это происходит и при обычной работе.
Аналогично журнальные записи применяются и к файлам: например, если запись говорит о том, что файл должен существовать, а его нет, — файл создается.
После окончания восстановления все нежурналируемые отношения перезаписываются с помощью образов в init-файлах. (с. 30)
В заключение выполняется контрольная точка, чтобы зафиксировать на диске восстановленное состояние.
На этом работа процесса startup заканчивается.
В классическом виде процесс восстановления состоит из двух этапов. На первом (roll forward) накатываются журнальные записи, при этом сервер повторяет потерянную при сбое работу. На втором (roll back) откатываются транзакции, которые не были зафиксированы на момент сбоя.
PostgreSQL не нуждается во втором этапе. После восстановления в clog не будет установлен ни бит фиксации, ни бит обрыва (что формально соответствует выполняющейся транзакции), но поскольку точно известно, что транзакция уже не выполняется, она будет считаться оборванной9.
Можно сымитировать сбой, принудительно остановив сервер в режиме immediate:
Проверим состояние кластера:
При запуске сервера процесс startup понимает, что произошел сбой, и запускает восстановление:
При нормальном останове сервера процесс postmaster отключает всех клиентов и затем выполняет финальную контрольную точку, чтобы сбросить грязные страницы на диск.
Запомним текущую позицию в журнале:
Теперь аккуратно остановим сервер:
Проверим состояние кластера:
Посмотрев журнал, обнаружим в конце запись о финальной контрольной точке (CHECKPOINT_SHUTDOWN):
Последнее сообщение от pg_waldump говорит о том, что утилита дочитала журнал до конца.
Снова запустим экземпляр:
10.5. Фоновая запись
Если обслуживающему процессу потребуется вытеснить из буфера грязную страницу, ему придется самостоятельно записать ее на диск. Это нехорошая ситуация, приводящая к ожиданиям, — гораздо лучше, когда запись происходит асинхронно, в фоновом режиме.
Частично работу по сбросу грязных страниц берет на себя процесс контрольной точки, но этого недостаточно.
Поэтому существует также процесс фоновой записи bgwriter10, который применяет тот же алгоритм поиска буферов, что и механизм вытеснения, но с двумя отличиями:
используется собственная «часовая стрелка», которая может опережать «часовую стрелку» вытеснения, но никогда не отстает от нее;
при обходе буферов счетчик обращений не уменьшается.
Грязная страница сбрасывается на диск, если буфер не закреплен и имеет нулевое число обращений. Таким образом, фоновый процесс записи идет впереди вытеснения и заранее сбрасывает те буферы, которые с большой вероятностью вскоре будут вытеснены.
Это увеличивает шансы на то, что буферы, выбранные при вытеснении, не будут грязными.
10.6. Настройка
Настройка контрольной точки
Продолжительность контрольной точки (точнее говоря, продолжительность этапа записи грязных буферов) определяется значением параметра checkpoint_completion_target. Оно показывает, какую часть времени между началами двух соседних контрольных точек будет происходить запись. Увеличивать значение до единицы не рекомендуется, поскольку может получиться так, что следующая контрольная точка должна будет начаться до того, как полностью завершилась предыдущая. Катастрофы не случится, поскольку в любом случае в один момент времени выполняется только одна контрольная точка, но нормальный ритм работы может быть нарушен. (по умолчанию: 0.9) (v. 14)
К настройке остальных параметров можно подойти следующим образом. Сначала определимся, какой объем журнальных файлов допустимо сохранять между двумя последовательными контрольными точками. Чем больше объем, тем меньше накладных расходов, но в любом случае это значение будет ограничено доступным свободным местом и допустимым временем восстановления.
Можно посчитать, за какое время при обычной нагрузке будет генерироваться этот объем. Для этого надо запомнить начальную позицию вставки в журнал и периодически проверять разность текущей и запомненной позиций.
Полученное время будем считать обычным интервалом между контрольными точками и запишем его в параметр checkpoint_timeout. Значение по умолчанию, скорее всего, слишком мало; обычно время увеличивают, например, до получаса. (по умолчанию: 5min) (с. 245)
Однако возможно (и даже вероятно), что иногда нагрузка будет выше, и за указанное в параметре время будет сгенерирован слишком большой объем журнальных записей. В этом случае контрольная точка должна выполняться чаще. Для этого параметром max_wal_size ограничим объем журнальных файлов, необходимых для восстановления. При превышении этого предела 11 сервер инициирует внеплановую контрольную точку. (по умолчанию: 1GB)
Журнальные файлы, необходимые для восстановления, содержат записи за прошедшую завершенную контрольную точку и за текущую, еще не завершенную. Поэтому для оценки общего объема надо умножить известный объем между контрольными точками на (1 + checkpoint_completion_target).
При такой настройке бóльшая часть контрольных точек происходит по расписанию раз в checkpoint_timeout единиц времени. Но при повышенной нагрузке контрольная точка вызывается чаще, по достижении журналом объема max_wal_size.
Процесс контрольной точки постоянно сопоставляет свой фактический прогресс с ожидаемым 12:
фактический прогресс определяется долей уже просмотренных страниц буферного кеша;
ожидаемый прогресс по времени определяется долей уже потраченного времени, исходя из того, что контрольная точка должна завершиться за интервал checkpoint_timeout × checkpoint_completion_target;
ожидаемый прогресс по объему определяется долей уже заполненных журнальных файлов, планируемое количество которых вычисляется исходя из значения max_wal_size × checkpoint_completion_target.
Если запись грязных страниц опережает график, она приостанавливается; если отстает хотя бы по одному из двух параметров — догоняет без задержек13. Учет и времени, и объема позволяет однотипно управлять скоростью выполнения контрольных точек как по расписанию, так и по требованию.
После прохождения контрольной точки сервер избавляется от ненужных для восстановления (и других задач) журнальных записей14. При этом часть файлов удаляется, а остальные переименовываются и используются заново. Их количество зависит от интенсивности генерации журнальных записей, но в любом случае в PGDATA/pg_wal поддерживается минимальный объем min_wal_size15. (по умолчанию: 80MB)
Обычно переименование позволяет сэкономить на постоянном создании и удалении файлов, но при необходимости такое поведение можно отключить с помощью параметра wal_recycle. (v. 12) (по умолчанию: on)
Рисунок показывает, как меняется объем необходимых серверу журнальных файлов в нормальных условиях.
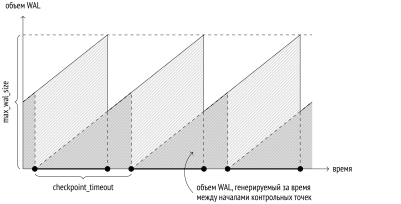
Важно понимать, что реальный объем журнальных файлов на сервере может быть больше, а в некоторых случаях может и превысить значение max_wal_size:
Параметр max_wal_size задает ориентир, но не служит жестким ограничением. Если нагрузка возрастет, запись может отстать от графика.
Сервер не имеет права стирать журнальные файлы, еще не переданные через слоты репликации и еще не записанные в архив при непрерывном архивировании. Этот функционал требует постоянного мониторинга, потому что можно легко переполнить дисковую память сервера.
Некоторое количество файлов может быть зарезервировано администратором с помощью параметра wal_keep_size. (v. 12) (по умолчанию:
0MB)
Настройка фоновой записи
Процесс фоновой записи имеет смысл настраивать после контрольной точки. Совместно эти процессы должны успевать записывать грязные буферы до того, как они потребуются обслуживающим процессам.
Процесс фоновой записи выполняет работу циклами, засыпая в промежутках на bgwriter_delay единиц времени. (по умолчанию: 200ms)
Количество страниц, которые будут записаны за один цикл работы, определяется по среднему количеству буферов, запрошенных обслуживающими процессами с прошлого запуска (используется скользящее среднее, чтобы сгладить неравномерность между запусками, но при этом не зависеть от давней истории). Вычисленное количество дополнительно умножается на коэффициент bgwriter_lru_multiplier. Но в любом случае за один цикл работы не будет записано более bgwriter_lru_maxpages страниц. (по умолчанию: 2) (по умолчанию: 100)
Если процесс не обнаружил ни одного грязного буфера (то есть в системе ничего не происходит), он «впадает в спячку». После первого же обращения серверного процесса за буфером процесс просыпается и продолжает работать обычным образом.
Мониторинг
Настройку контрольной точки и фоновой записи можно и нужно корректировать, получая обратную связь от мониторинга.
Если контрольные точки, вызванные превышением объема журнальных файлов, выполняются чаще, чем указано в параметре checkpoint_warning, в журнал сообщений выводится предупреждение. Значение параметра стоит привести в соответствие с предполагаемой пиковой нагрузкой. (по умолчанию: 30s)
Детальная информация о ходе выполнения контрольных точек выводится в журнал сообщений сервера при включенном параметре log_checkpoints. (по умолчанию: on)
Поменяем что-нибудь в данных и инициируем контрольную точку:
В журнале сообщений мы увидим, сколько буферов было записано, как изменился состав журнальных файлов после контрольной точки, сколько времени заняла контрольная точка и расстояние (в байтах) между началами соседних контрольных точек:
Но наиболее полезная информация для целей настройки — статистика работы процесса контрольной точки в представлении pg_stat_checkpointer. (v. 17)
До версии 17 контрольная точка и фоновая запись разделяли одно представление pg_stat_bgwriter, поскольку раньше обе задачи выполнялись процессом фоновой записи; в версии 9.2 контрольную точку выделили в отдельный процесс, но представление долгое время оставалось общим.
В числе прочего представление показывает количество выполненных контрольных точек:
num_timed— по расписанию (по истечении интервала времени checkpoint_timeout);num_requested— по требованию (в том числе по достижении объема журнала max_wal_size).
Большое значение в столбце num_requested (по сравнению с num_timed) говорит о том, что в реальности контрольные точки происходят чаще, чем предполагалось.
Поля, начинающиеся на restartpoints, актуальны только для реплики.
Представление pg_stat_bgwriter показывает статистику фоновой записи:
Для настройки полезно значение maxwritten_clean: это число показывает, сколько раз процесс фоновой записи прекращал цикл работы из-за превышения bgwriter_lru_maxpages.
В хорошо настроенной системе обслуживающие процессы практически не выполняют запись; основной ее объем приходится на процессы контрольной точки (buffers_written) и фоновой записи (buffers_clean).
Кроме подробных сведений о контрольной точке и фоновой записи, важно иметь информацию и о журнале предзаписи в целом. Самую общую статистику — количество журнальных записей и полных образов страниц, а также занимаемый ими объем — можно получить из представления pg_stat_wal: (v. 14)
Наиболее детальная информация о вводе-выводе, связанном с журналом (в том числе и разбивка по типам процессов, хотя здесь я ее не показываю), содержится в уже знакомом представлении pg_stat_io: (v. 18) (с. 204)
Для журнала поле context может принимать следующие значения:
init— инициализация сегмента WAL (а также заполнение его нулями при установленном параметре wal_init_zero — отсюда и 16 Мбайт данных, записанных каждой операцией); (по умолчанию:on)normal— операции с уже существующими сегментами.
Статистику отдельного обслуживающего процесса во время его работы можно получить функцией pg_stat_get_backend_wal. (v. 18)
postgrespro.ru/docs/postgresql/18/wal-internals; backend/access/transam/README. ↩︎
backend/storage/buffer/bufmgr.c, функция FlushBuffer. ↩︎
backend/postmaster/checkpointer.c; backend/access/transam/xlog.c, функция CreateCheckPoint. ↩︎
backend/storage/buffer/bufmgr.c, функция BufferSync. ↩︎
backend/postmaster/startup.c; backend/access/transam/xlog.c, функция StartupXLOG. ↩︎
backend/access/heap/heapam_visibility.c, функция HeapTupleSatisfiesMVCC. ↩︎
backend/access/transam/xlog.c, функции XLogCheckpointNeeded и CalculateCheckpointSegments. ↩︎
backend/postmaster/checkpointer.c, функция IsCheckpointOnSchedule. ↩︎
backend/postmaster/checkpointer.c, функция CheckpointWriteDelay. ↩︎
backend/access/transam/xlog.c, функция RemoveOldXlogFiles. ↩︎
backend/access/transam/xlog.c, функция XLOGfileslop. ↩︎