9 Буферный кеш
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
9.1. Ввод-вывод и кеширование
Общие соображения
Операции ввода-вывода можно разделить на прямые и буферизованные.
Прямой ввод-вывод (Direct I/O) перемещает данные непосредственно между памятью пользовательского процесса и диском. Если при этом поддерживается прямой доступ к памяти (DMA), то такая операция даже не нагружает процессор.
Буферизованный ввод-вывод задействует операционную систему и ее кеш. Пользовательский процесс запрашивает данные с помощью системного вызова. Если нужные данные есть в кеше, операционная система возвращает результат немедленно; в противном случае она предварительно читает данные с диска. Так или иначе, данные сначала (возможно, заранее) помещаются в кеш в памяти ядра операционной системы, а затем копируются в память пользовательского процесса: в нашем случае — в буферный кеш PostgreSQL.
Хотя здесь мы говорим про оперативную память и диски, та же идея кеширования применяется для компенсации разницы в производительности любых двух типов памяти, одна из которых быстрее, но дороже и меньше по объему, а другая — медленнее, но дешевле и больше. В быстрой памяти невозможно разместить все данные из медленной памяти. Но в большинстве случаев активная работа ведется одновременно только с небольшой выборкой, поэтому, выделив часть быстрой памяти под хранение «горячих» данных, удается существенно экономить на обращениях к медленному
устройству. В современных вычислительных системах кеширование применяется повсеместно, как на программном, так и на аппаратном уровне. У одного только процессора можно насчитать три-четыре уровня кеша; свой кеш бывает также и у контроллеров дисковых массивов, и у самих дисков.
Операции ввода-вывода можно классифицировать и иначе.
При синхронном вводе-выводе процесс отправляет команду и блокируется. Пока операция выполняется, процесс вынужден простаивать, дожидаясь ее завершения.
При асинхронном вводе-выводе (Async I/O) процесс формирует и отправляет задание и продолжает работу. За результатом он возвращается позже, в удобный для себя момент. Если операция уже выполнилась, процесс получает результат сразу; если нет — блокируется до ее завершения, как при синхронном вводе-выводе.
Довольно очевидно, что прямой ввод-вывод может обеспечить более высокую пропускную способность и меньшую задержку получения данных, а асинхронный ввод-вывод позволяет меньше простаивать и выполнять больше полезной работы. Но с точки зрения программирования обычный синхронный буферизованный ввод-вывод гораздо проще, а проигрывает совсем не так сильно, как можно было бы подумать. PostgreSQL тридцать лет использовал именно синхронный буферизованный ввод-вывод. Дело в том, что хотя код СУБД при этом работает последовательно, ввод-вывод фактически выполняется асинхронно: операционная система во многих случаях предугадывает последовательность чтений и заранее, в фоновом для СУБД режиме, считывает нужные данные в свой кеш. На операционную систему перекладываются все заботы о предвыборке данных и об отложенной записи грязных страниц.
Мотивацией для собственной реализации асинхронного ввода-вывода является уменьшение зависимости от операционной системы: не все системы выполняют предвыборку одинаково хорошо, а СУБД в любом случае лучше знает, какие страницы ей понадобятся и когда. Кроме того, привлекает возможность асинхронно выполнять синхронизацию данных с диском (fsync).
Переход на прямой ввод-вывод тоже сулит преимущества: избавление от двойной буферизации (в кеше операционной системы и буферном кеше PostgreSQL) и потенциально существенное повышение производительности. Однако при этом теряется вся поддержка операционной системы. Придется реализовать собственную предвыборку данных, учитывающую особенности методов доступа, и самостоятельно сбрасывать грязные страницы на диск, равномерно распределяя пишущую нагрузку. Понадобится и алгоритм объединения мелких запросов на ввод-вывод в более крупные. Без всего этого прямой ввод-вывод только замедлит систему.
Текущее положение дел
Работа над тем, чтобы отвязать PostgreSQL от файловой системы, началась уже несколько лет назад. (v. 18)
Прямой ввод-вывод включается параметром debug_io_direct, но пока не реализовано все необходимое, эта настройка имеет смысл только для разработчиков ядра. (по умолчанию: off) (v. 16)
Асинхронный ввод-вывод 1 доступен пока только для чтения; запись и синхронизация по-прежнему остаются синхронными. Имеются несколько реализаций ввода-вывода, одна из которых указывается в параметре io_method: можно выбрать тот способ, который поддерживается на конкретной платформе и показывает лучшие результаты в конкретной системе. (по умолчанию: worker)
- При значении
workerввод-вывод выполняется отдельными рабочими процессами2. Этот способ работает на любых платформах и выбирается по умолчанию.
Чтобы прочитать страницу или несколько подряд идущих страниц, процесс (обслуживающий или системный) помещает свой запрос в очередь, общую для всех рабочих процессов. В какой-то момент один из них выполнит запрошенную операцию, например прочитает требуемые страницы в буферный кеш.
Количество рабочих процессов постоянно и определяется параметром io_workers. На серверах с большим количеством ядер значение параметра имеет смысл увеличить (максимальное значение — 32). (по умолчанию: 3)
- При значении
io_uringввод-вывод выполняется самим процессом с помощью одноименного интерфейса ядра Linux и работает только в этой операционной системе3.
Интерфейс io_uring использует два кольцевых буфера в памяти пользовательского процесса (отсюда и название — user-space ring): один для запросов на ввод-вывод, другой — для получения результата этих запросов. Поскольку буферы находятся в памяти процесса, взаимодействие с интерфейсом происходит без системных вызовов и не приводит к переключению контекста.
- При значении
syncиспользуется обычный синхронный ввод-вывод.
Интерфейс io_uring потенциально эффективнее рабочих процессов, но есть нюансы. Помимо собственно ввода-вывода, у прочитанных страниц требуется проверять контрольные суммы, а пока ввод-вывод остается буферизованным, надо еще и копировать прочитанные данные из кеша операционной системы в буферный кеш PostgreSQL. При выборе io_uring эта работа выполняется самим процессом, при worker — распределяется между рабочими процессами. Поэтому единственный интенсивно читающий процесс, скорее всего, выиграет от способа worker, особенно при достаточном количестве рабочих процессов, а множество читающих процессов, порождающих массу мелких одностраничных запросов, наоборот, могут упереться в возможности ограниченного пула рабочих процессов.
Асинхронный ввод-вывод настраивается, по сути, парой значений: количеством асинхронных операций ввода-вывода, которые могут выполняться одновременно, и количеством идущих подряд страниц, которые будут читаться одной операцией. Однако параметров несколько больше.
Параметром io_max_concurrency мы задаем максимальное количество асинхронных операций в расчете на один процесс. Размер структур данных, которые создаются для асинхронного ввода-вывода в разделяемой памяти при запуске экземпляра, зависит от произведения этого значения на максимальное число процессов в системе (включая служебные). При значении по умолчанию количество выбирается автоматически исходя из размеров буферного кеша, но не превышает 644. (по умолчанию: -1)
Само по себе значение io_max_concurrency не ограничивает количество операций одного процесса. Такое ограничение устанавливают два других параметра: effective_io_concurrency для обычного чтения данных из таблиц и maintenance_io_concurrency для таких служебных задач, как, например, очистка. Установка этих параметров в ноль фактически отключает асинхронный ввод-вывод. Поскольку степень параллелизма зависит от возможностей устройства ввода-вывода, эти параметры можно устанавливать и на уровне табличных пространств. (по умолчанию: 16) (по умолчанию: 16)
Максимальный объем данных, который может быть прочитан одной операцией ввода-вывода, устанавливается параметром io_combine_limit; значение по умолчанию соответствует 16 стандартным 8-килобайтным страницам. Если операционная система поддерживает более крупные операции, увеличение значения может пойти на пользу OLAP-системам, в которых большие таблицы часто сканируются полностью. (по умолчанию: 128 kB)
Параметр io_combine_limit можно менять на лету, но в пределах, установленных другим параметром, io_max_combine_limit, изменение которого требует перезапуска сервера. (по умолчанию: 128 kB)
Пока асинхронно выполняются только следующие операции:
последовательное чтение (Seq Scan); (с. 374)
сканирование по битовой карте (Bitmap Heap Scan); (с. 427)
очистка и анализ таблиц, а также очистка B-деревьев и индексов GiST и SP-GiST; (с. 125)
прогрев буферного кеша (расширение
pg_prewarm);проверка целостности отношений (функция
verify_heapamрасширенияamcheck).
Если асинхронный ввод-вывод отключен, при этих операциях PostgreSQL старается подсказать операционной системе глубину желаемой предвыборки, ориентируясь на значение параметра effective_io_concurrency или maintenance_io_concurrency. Также есть пара операций, которые пока не охвачены асинхронным вводом-выводом, но тоже инициируют предвыборку:
чтение индексных страниц при удалении строк из таблицы 5;
чтение страниц журнала при восстановлении6.
Представление pg_aios показывает дескрипторы асинхронного ввода-вывода, которые определяют операции и хранят состояния этих операций, пока они выполняются. Впрочем, представление предназначено не для обычного мониторинга, а скорее для разработчиков ядра.
9.2. Устройство буферного кеша
Буферный кеш PostgreSQL 7 хранит страницы отношений, сглаживая разницу между временем доступа к оперативной памяти (наносекунды) и к дискам (миллисекунды).
Буферный кеш располагается в общей памяти сервера и доступен всем процессам. Он занимает бóльшую часть общей памяти и является одной из самых важных и сложных структур данных. Понимание принципа работы кеша важно само по себе; к тому же многие другие структуры (такие как вложенные транзакции, статусы транзакций clog, журнальные записи) используют похожее, хотя и более простое кеширование.
Кеш называется буферным, потому что представляет собой массив буферов. Каждый буфер резервирует фрагмент памяти, достаточный для одной страницы данных и ее заголовка8.
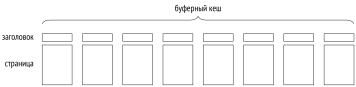
Заголовок содержит информацию о буфере и загруженной в него странице, такую как:
физическое расположение страницы (идентификатор файла отношения, слой и номер блока в слое);
признак того, что данные на странице изменились и рано или поздно должны быть записаны на диск (такую страницу называют грязной);
число обращений к буферу (usage count);
счетчик закреплений буфера (pin count или reference count).
Чтобы получить доступ к странице данных отношения, процесс запрашивает ее у менеджера буферов 9 и получает номер буфера, содержащего эту страницу. Процесс читает данные из страницы в кеше и там же может менять их. На время работы со страницей буфер закрепляется, чтобы менеджер не заменил ее на другую. При каждом закреплении увеличивается счетчик обращений к странице. Помимо закреплений, применяются и другие блокировки. (с. 306)
Пока страница находится в буферном кеше, работа с ней не приводит к файловым операциям.
Внутрь буферного кеша позволяет заглянуть расширение pg_buffercache:
Создадим таблицу и вставим в нее одну строку:
Теперь в буферном кеше содержится табличная страница с только что вставленной строкой. В этом можно убедиться, отобрав буферы, относящиеся к конкретной таблице. Такой запрос нам еще пригодится, поэтому обернем его в функцию:
Страница грязная (isdirty), поскольку изменена и еще не записана на диск. Счетчик обращений (usagecount) равен единице.
9.3. Попадание в кеш
Когда менеджеру буферов требуется прочитать страницу10, он сначала пытается найти ее в буферном кеше. Для быстрого поиска нужного буфера используется хеш-таблица 11, хранящая номера буферов.
Многие современные языки программирования включают хеш-таблицы как один из базовых типов данных. Часто они называются ассоциативным массивом. И действительно, с точки зрения пользователя они выглядят как массив, но в качестве индекса (который называется ключом хеширования) можно использовать любой тип данных, например текстовую строку, а не целое число.
Диапазон возможных значений ключа может быть очень велик, но одновременно в хеш-таблице хранится не так много значений. Идея хеширования состоит в том, что значение ключа с помощью хеш-функции отображается в некоторое целое число. Полученное число или часть его битов используется как индекс обычного массива. Элементы такого массива называют корзинами хеш-таблицы.
Хорошая хеш-функция распределяет ключи по корзинам равномерно, но тем не менее она может выдать одинаковые числа для разных ключей и таким образом направить ключи в одну и ту же корзину; это называется коллизией. Поэтому вместе со значением в корзине сохраняется и ключ хеширования, а при чтении значения по ключу перепроверяются все ключи, которые попали в одну корзину.
Известно много вариантов реализации хеш-таблиц. Для буферного кеша используется динамически расширяемая таблица c разрешением хеш-коллизий с помощью цепочек12.
Ключом хеширования служат идентификатор файла отношения, тип слоя и номер страницы внутри файла этого слоя. Таким образом, зная страницу, можно быстро найти содержащий ее буфер или удостовериться, что страницы нет в кеше.
Использование хеш-таблицы давно вызывает нарекания. Такая структура никак не помогает найти все буферы, занятые страницами определенного отношения. А это требуется при удалении (DROP), опустошении (TRUNCATE) или усечении хвостовой части таблицы во время очистки, чтобы убрать из кеша соответствующие страницы13. Но хорошую замену пока никто не предложил.
Если номер буфера найден в хеш-таблице, менеджер закрепляет этот буфер и возвращает его номер процессу. После этого процесс может работать со страницей в буферном кеше, и это не приводит к вводу-выводу. (с. 133)
Чтобы закрепить буфер, нужно увеличить счетчик pin count в его заголовке; один и тот же буфер могут одновременно закрепить несколько процессов.
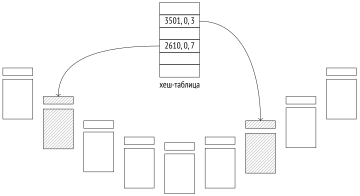
Пока буфер закреплен (т. е. значение счетчика больше нуля), считается, что буфер используется и его содержимое не должно «радикально» измениться. Например, в странице может появиться новая версия строки (она не будет видна благодаря правилам видимости), но страница не может быть заменена на другую.
Команда EXPLAIN с параметрами analyze и buffers не просто показывает план запроса, но и выполняет его, а также выводит количество использованных буферов:
Здесь hit=1 говорит о том, что потребовалось прочитать одну страницу и она была найдена в кеше.
Закрепление буфера увеличило счетчик обращений на единицу:
Теперь обновим строку, чтобы в странице были две версии: одна актуальная, а вторая — мертвая. Это понадобится нам чуть позже.
Воспользуемся тем, что открытый курсор удерживает закрепление, чтобы иметь возможность быстро прочитать следующую строку выборки. Это позволит нам увидеть закрепление в процессе работы запроса:
В некоторых случаях, когда требуется именно закрепленный буфер, процесс встает в очередь и засыпает до того момента, когда он сможет получить монопольный доступ к буферу. Пример такой операции — заморозка 14. (с. 134)
Но, как правило, если процессу мешает закрепление, он просто пропускает такой буфер и выбирает другой. Примером может служить очистка таблицы. В данном случае страница будет пропущена, поскольку закрепление, установленное другим процессом, препятствует физическому удалению мертвой версии:
При переходе курсора на другую страницу или после его закрытия закрепление снимается. В нашем примере это происходит одновременно с окончанием транзакции:
Так же закрепление работает и при изменении страницы. Например, добавим в таблицу еще одну строку (она попадет в ту же самую страницу):
Страница не записывается на диск немедленно, а остается грязной в буферном кеше: происходит экономия и на чтении с диска, и на записи.
9.4. Промах кеша
Если в хеш-таблице не нашлось записи, соответствующей странице, значит, эта страница отсутствует в буферном кеше. В таком случае для страницы выбирается (и тут же закрепляется) новый буфер, страница читается в этот буфер, а ссылки в хеш-таблице изменяются соответствующим образом.
Уберем страницу из буфера (вместо этого можно было бы очистить весь буферный кеш, перезапустив экземпляр): (v. 17)
Попытка прочитать страницу приведет к промаху кеша, и страница будет загружена в заново отведенный для нее буфер:
Теперь вместо hit команда показывает read, что означает промах кеша. При этом в результате запроса страница стала грязной (dirtied), так как запрос изменил биты-подсказки на странице. (с. 86)
Запрос к буферному кешу покажет, что счетчик использований только что добавленной страницы равен единице:
Общую статистику использования буферного кеша для таблицы можно получить из представления pg_statio_all_tables:
Аналогичные представления есть для индексов и для последовательностей.
Поиск буфера и вытеснение
Поиск подходящего буфера 15 — непростая задача. Есть два варианта развития событий.
- Сразу после запуска сервера кеш содержит только пустые, свободные буферы, и все они связаны в общий список.
Пока остаются свободные буферы, первый из них считается подходящим и убирается из списка.
Буфер может вернуться 16 в список свободных буферов только в том случае, когда страница исчезает, а не заменяется другой страницей. Это происходит при удалении (DROP), опустошении (TRUNCATE) или усечении хвостовой части таблиц во время очистки. (с. 133)
- Рано или поздно свободные буферы заканчиваются (поскольку обычно размер базы данных превышает объем памяти, выделенной под кеш), и тогда менеджер должен выбрать один из занятых буферов и вытеснить находящуюся там страницу. Для этого используется «часовой» алгоритм (clock sweep). Имеется «часовая стрелка», указывающая на один из буферов. Стрелка пробегает буферный кеш по кругу, уменьшая счетчики обращений к страницам на единицу. Поиск завершается, когда стрелка доходит до незакрепленного буфера с нулевым счетчиком.
С одной стороны, счетчик обращений увеличивается каждый раз, когда буфер используется (закрепляется). С другой — уменьшается при поиске буфера для вытеснения. Таким образом, в первую очередь вытесняются те страницы, к которым реже обращались в последнее время, а активно используемые страницы остаются в кеше.
Можно заметить, что если все буферы имеют ненулевой счетчик обращений, то «часовой стрелке» придется сделать больше одного круга, уменьшая счетчики, пока какой-нибудь из них не обратится наконец в ноль. Чтобы избежать долгого «наматывания кругов», максимальное значение счетчика обращений ограничено числом 5.
После того как буфер найден, надо удалить из хеш-таблицы ссылку на старую страницу, еще находящуюся в буфере.
Но если буфер оказался грязным, то есть содержит измененные данные, старую страницу нельзя просто выбросить — сначала менеджер буферов сохраняет ее на диск. (с. 226)
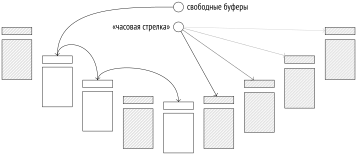
В найденный буфер — среди свободных или среди занятых — менеджер буферов читает новую страницу. Для этого используется буферизованный ввод-вывод, поэтому страница будет прочитана с диска только в том случае, если операционная система не найдет ее в своем собственном кеше.
СУБД, использующие прямой ввод-вывод и не зависящие от кеша операционной системы, различают логические чтения (из оперативной памяти, то есть из буферного кеша) и физические чтения (с диска). С точки зрения PostgreSQL страница либо прочитана из буферного кеша, либо запрошена у операционной системы, но у СУБД нет возможности узнать, была ли она в последнем случае найдена в оперативной памяти или прочитана с диска.
В хеш-таблицу помещается ссылка на новую страницу, а буфер закрепляется. Это приводит к увеличению счетчика обращений, то есть к установке его в единицу. В итоге у буфера появляется время нарастить счетчик обращений, пока «часовая стрелка» обходит по кругу буферный кеш.
9.5. Массовое вытеснение
При операциях, выполняющих массовое чтение или запись данных, есть опасность быстрого вытеснения полезных страниц из буферного кеша «одноразовыми» данными.
Чтобы этого избежать, для массовых операций в буферном кеше используются относительно небольшие буферные кольца (buffer ring), и вытеснение происходит в их пределах, не затрагивая остальные буферы.
Наряду с термином «buffer ring» в коде используется и «ring buffer», то есть «кольцевой буфер». Но такой перевод вызвал бы путаницу, поскольку сам (кольцевой) буфер состоит из буферов (буферного кеша). Термин «кольцо» лишен такого недостатка.
Буферное кольцо заданного размера представляет собой массив буферов, которые используются «по кругу», один за другим. Сначала буферное кольцо пусто, и буферы набираются в него из буферного кеша обычным образом. А затем начинает действовать вытеснение, но только внутри кольца17.
При этом буферы, входящие в кольцо, не исключаются из буферного кеша и в принципе могут быть использованы и другими операциями. Поэтому если очередной буфер оказывается закрепленным или имеет более одного обращения, он убирается из буферного кольца и заменяется каким-нибудь другим буфером.
Существует три стратегии вытеснения18.
Стратегия массового чтения (bulkread) применяется при последовательном сканировании больших таблиц, размер которых превышает четверть буферного кеша. (с. 374)
При использовании этой стратегии грязные страницы не записываются на диск, чтобы освободить буфер; вместо этого буфер отключается от кольца и заменяется другим. Так чтению не надо дожидаться записи, и оно выполняется быстрее.
Если в момент начала сканирования таблицы процесс обнаруживает, что эта таблица уже сканируется, он присоединяется к существующему буферному кольцу и получает часть таблицы без избыточного ввода-вывода19. Когда первый процесс заканчивает сканирование, второй отдельно дочитывает пропущенное начало таблицы.
Кольцо должно быть достаточно большим, чтобы буферы успевали освобождаться до того, как потребуются повторно, и задерживались в кольце достаточно долго, чтобы несколько читающих процессов могли синхронизироваться. При асинхронном вводе-выводе одновременно могут выполняться effective_io_concurrency операций, каждая из которых может читать io_combine_limit байт, что и определяет необходимый размер. Если асинхронный ввод-вывод отключен, произведение обратится в ноль; на этот случай добавляется еще 256 Кбайт (32 стандартные страницы). Но чтобы кольцо не получилось уж слишком большим, его размер ограничен отношением объема буферного кеша к максимальному количеству процессов в системе: кеша должно хватить на всех. (v. 18) (с. 183) (по умолчанию: 16) (по умолчанию: 128K)
Таким образом, с настройками по умолчанию — при достаточном большом буферном кеше — размер кольца будет составлять 32 + 16 ⋅ 16 = 288 буферов.
Стратегия массовой записи (bulkwrite) применяется для операций COPY FROM, CREATE TABLE AS SELECT, CREATE MATERIALIZED VIEW и тех вариантов ALTER TABLE, которые вызывают перезапись таблицы. Выделяется довольно большое кольцо размером 16 Мбайт (2048 стандартных страниц), но не больше от размера всего буферного кеша.
Стратегия очистки (vacuum) применяется процессами очистки и анализа при полном сканировании таблиц без учета карты видимости. Размер кольца определяется параметром vacuum_buffer_usage_limit, но может быть переопределен в команде VACUUM или ANALYZE. (по умолчанию: 2MB) (v. 16)
Буферные кольца не всегда защищают от ненужного вытеснения. При изменении большого числа строк командами UPDATE или DELETE таблица сканируется, используя стратегию массового чтения, но из-за того, что страницы изменяются, буферное кольцо вырождается и фактически не работает.
Другой важный случай — хранение в базе данных больших значений, для которых используется TOAST. Доступ к toast-таблице всегда происходит по индексу, несмотря на потенциально большой объем читаемых данных, и, следовательно, не использует буферное кольцо. (с. 33)
Посмотрим теперь на стратегию массового чтения. Для упрощения расчетов создадим таблицу так, чтобы при вставке одна строка занимала целую страницу. Размер буферного кеша по умолчанию — 16 384 страницы по 8 Кбайт. Значит, чтобы сканирование таблицы использовало буферное кольцо, таблица должна занимать больше 4096 страниц.
Проанализируем таблицу:
Очистим кеш от табличных страниц, прочитанных во время анализа, после чего прочитаем всю таблицу: (v. 18)
Размер буферного кольца ограничен из-за небольшого объема буферного кеша — табличными страницами в нем занято только 94 буфера вместо ожидаемых 288:
Если же таблица читается с помощью индекса, то буферное кольцо не используется:
В результате в буферном кеше оказывается вся таблица и весь индекс:
9.6. Настройка размера
Размер буферного кеша определяется параметром shared_buffers. Значение по умолчанию заведомо занижено; имеет смысл увеличить его сразу же после установки PostgreSQL. Изменение параметра требует перезапуска, поскольку общая память выделяется под кеш при старте сервера. (по умолчанию: 128MB)
Из каких соображений выбирать подходящее значение?
Даже самая большая база имеет ограниченный набор «горячих» данных, с которыми ведется активная работа в каждый момент времени. В идеале именно этот набор и должен помещаться в буферный кеш (конечно, с запасом под неизбежные «одноразовые» данные). Если размер кеша будет меньше, то активно используемые страницы будут постоянно вытеснять друг друга, создавая избыточный ввод-вывод. Но и бездумно увеличивать кеш тоже неправильно, поскольку это повышает накладные расходы на его поддержание, а оперативная память требуется и для других нужд.
Оптимальный размер буферного кеша будет разным в разных системах: он зависит и от общего доступного объема памяти, и от данных, и от профиля нагрузки. К сожалению, нет такого волшебного значения или даже формулы, одинаково хорошо подходящей всем.
Надо также принимать во внимание, что — пока не включен прямой ввод-вывод — промах кеша PostgreSQL не обязательно приводит к физическому вводу-выводу. При небольшом буферном кеше свободное место будет задействовано под кеш операционной системы, что может в определенной степени сглаживать проблему. Но, в отличие от СУБД, операционная система ничего не знает о смысле прочитанных данных, поэтому использует другую стратегию вытеснения.
Стандартная рекомендация — взять в качестве первого приближения оперативной памяти, а дальше смотреть по ситуации.
Лучше всего провести эксперименты: увеличить или уменьшить размер кеша и сравнить характеристики системы. Конечно, для этого надо иметь тестовый стенд, аналогичный производственной системе, и уметь воспроизводить типовую нагрузку.
Но некоторый анализ все же возможен.
Во-первых, с помощью уже знакомого расширения pg_buffercache можно смотреть на текущее состояние кеша под разными углами. Например, изучить распределение буферов по степени их использования:
Пустые значения счетчика соответствуют свободным буферам. В данном случае это неудивительно, поскольку сервер практически бездействует. Большинство занятых буферов содержат страницы системных таблиц, которые были прочитаны обслуживающим процессом для заполнения своего кеша системного каталога и для выполнения запросов.
Можно посмотреть, какая часть каждого из отношений закеширована и насколько активно используются эти данные (в этом запросе активными считаются страницы со счетчиком использования больше единицы):
Здесь видно, что таблица big и ее индекс полностью закешированы, но их страницы не используются активно.
Стоит учитывать, что запросы к pg_buffercache:
надо повторять несколько раз, так как цифры будут меняться в определенных пределах;
не надо выполнять непрерывно, потому что представление блокирует, хоть и кратковременно, просматриваемые буферы.
Поэтому для мониторинга лучше пользоваться другими функциями расширения — pg_buffercache_summary и pg_buffercache_usage_counts, — которые требуют меньше блокировок и за счет этого позволяют быстро оценить общую (хотя, возможно, немного рассогласованную) картину происходящего. (v. 16)
Во-вторых, подробная информация о вводе-выводе, проходящем через буферный кеш, накапливается в представлении pg_stat_io. Например, можно изучить количество операций ввода-вывода в разбивке по стратегиям использования буферных колец (контекст normal соответствует обычным операциям без кольца): (v. 16)
Запрос также показывает число попаданий в кеш (hits) и вытеснений из кеша: «обычные» вытеснения учитываются в поле evictions, а вытеснения страниц из буферного кольца — в поле reuses. Из этих цифр можно сделать определенные выводы о характере использования кеша.
Кроме количества операций чтения и записи (reads и writes), из представления можно узнать и объем ввода-вывода (read_bytes и write_bytes) в байтах: (v. 18)
Здесь мы видим, что очистка и последовательное сканирование читают сразу несколько страниц за одну операцию ввода-вывода, а вот запись пока всегда одностраничная.
При включенном параметре track_io_timing в этом же представлении отслеживается и время, затраченное на ввод-вывод. Однако, как я уже говорил, такое отслеживание может приводить к существенным накладным расходам на некоторых платформах. (с. 166)
Представление pg_stat_io показывает данные, сгруппированные по типам процессов. Детализацию до конкретного обслуживающего процесса (пока он работает) можно получить функцией pg_stat_get_backend_io, которая возвращает таблицу с тем же набором полей. (v. 18)
Изучение данных pg_buffercache и pg_stat_io в различных разрезах может дать полезную информацию для размышлений.
9.7. Прогрев кеша
После перезапуска сервера должно пройти некоторое время, чтобы кеш «прогрелся» — набрал актуальные активно использующиеся данные. Иногда может оказаться полезным сразу прочитать в кеш данные определенных таблиц, и для этого предназначено расширение pg_prewarm:
Кроме обычного чтения таблиц в буферный кеш (или только в кеш операционной системы), расширение позволяет сохранять актуальное состояние кеша на диск и восстанавливать его же после перезагрузки сервера. Для этого надо добавить библиотеку расширения в параметр shared_preload_libraries и перезагрузить сервер:
После перезапуска, если значение параметра pg_prewarm.autoprewarm не менялось, будет автоматически запущен фоновый процесс autoprewarm leader, который раз в pg_prewarm.autoprewarm_interval единиц времени будет сбрасывать на диск список страниц, находящихся в кеше (этот процесс использует один из слотов max_parallel_processes). (по умолчанию: on) (по умолчанию: 300s)
Изначально процесс назывался autoprewarm master, но в версии 13 и он попал под раздачу.
Сейчас, после перезагрузки, таблица big в кеше отсутствует:
Если есть обоснованные предположения, что все содержимое таблицы будет активно использоваться, а доступ к диску недопустимо снизит время отклика запросов, таблицу можно заранее прочитать в буферный кеш:
Список страниц сбрасывается в файл PGDATA/autoprewarm.blocks. Можно подождать, пока процесс autoprewarm leader отработает в первый раз, но мы инициируем запись вручную:
Число сброшенных страниц больше 4097, поскольку включает все занятые буферы. Файл записывается в текстовом формате и содержит идентификаторы базы данных, табличного пространства и файла, номер слоя и номер блока:
Теперь снова перезапустим сервер.
Таблица сразу же оказывается в кеше:
Это обеспечивается тем же самым процессом autoprewarm leader: он читает файл, разделяет страницы по базам данных, сортирует их (чтобы чтение с диска было по возможности последовательным) и передает отдельному рабочему процессу autoprewarm worker для обработки.
9.8. Локальный кеш
Исключением из общего правила являются временные таблицы. Поскольку временные данные видны только одному процессу, им нечего делать в общем буферном кеше. Поэтому для временных данных используется кеш в локальной памяти процесса, владеющего таблицей20.
В целом локальный буферный кеш устроен так же, как и общий:
для поиска страниц используется собственная хеш-таблица;
страницы вытесняются по обычному алгоритму (но без использования буферных колец);
страницы могут закрепляться, чтобы избежать вытеснения.
Однако его реализация серьезно упрощается, поскольку отпадает необходимость в блокировках в оперативной памяти (так как доступ к буферам имеет только один процесс) и в защите данных от сбоя (так как данные в любом случае существуют максимум до конца сеанса). (с. 306) (с. 211)
Память под локальный кеш выделяется постепенно, по мере необходимости, поскольку временные таблицы используются далеко не во всех сеансах. Максимальный объем кеша одного сеанса ограничен параметром temp_buffers. (по умолчанию: 8MB)
Параметр с созвучным именем temp_file_limit относится не к временным таблицам, а к файлам, которые могут создаваться при выполнении запросов для временного хранения промежуточных данных.
В выводе команды EXPLAIN обращения к локальному буферному кешу отмечаются словом local вместо shared:
Данные о вводе-выводе страниц локальных кешей процессов позволяет получить уже знакомое нам представление pg_stat_io: (v. 16)
backend/storage/aio/aio_init.c, функция AioChooseMaxConcurrency. ↩︎
backend/access/heap/heapam.c, функция index_delete_prefetch_buffer. ↩︎
backend/storage/buffer/bufmgr.c, функция ReadBuffer_common. ↩︎
backend/storage/buffer/bufmgr.c, функция DropRelFileNodeBuffers. ↩︎
backend/storage/buffer/bufmgr.c, функция LockBufferForCleanup. ↩︎
backend/storage/buffer/freelist.c, функция StrategyGetBuffer. ↩︎
backend/storage/buffer/freelist.c, функция StrategyFreeBuffer. ↩︎
backend/storage/buffer/freelist.c, функция GetBufferFromRing. ↩︎
backend/storage/buffer/freelist.c, функция GetAccessStrategy. ↩︎