7 Автоочистка
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
7.1. Автоматическая очистка и анализ
Когда горизонт базы данных регулярно продвигается вперед, обычная очистка должна справляться со своей работой. Вопрос в том, как часто ее следует вызывать.
Если очищать изменяющуюся таблицу слишком редко, она вырастет в размерах больше, чем хотелось бы. Кроме того, в ней может накопиться слишком много изменений, и тогда очередной очистке потребуется совершить несколько проходов по индексам.
Если очищать таблицу слишком часто, то вместо полезной работы сервер будет постоянно заниматься обслуживанием.
К тому же нагрузка может изменяться со временем, так что запуск очистки по какому-либо фиксированному расписанию в любом случае не годится: чем чаще обновляется таблица, тем чаще ее надо и очищать.
Задача решается автоматической очисткой 1 — механизмом, который подстраивает частоту срабатывания очистки и анализа под скорость изменения таблиц.
Устройство автоочистки
При включенной автоматической очистке (конфигурационный параметр autovacuum) в системе всегда присутствует процесс autovacuum launcher, ответственный за расписание. Он поддерживает список баз данных, в которых есть какая-либо активность, опираясь на статистику их использования. Такая статистика собирается при установленном параметре track_counts. Не следует выключать эти параметры, иначе автоочистка не будет работать. (по умолчанию: on) (по умолчанию: on)
Раз в autovacuum_naptime единиц времени процесс autovacuum launcher запускает (как обычно, с помощью postmaster) рабочий процесс autovacuum worker 2 для каждой «активной» базы данных из списка. Соответственно, если в кластере используется несколько баз данных (N штук), то за интервал autovacuum_naptime будет запущено N рабочих процессов. Но при этом общее количество одновременно выполняющихся рабочих процессов ограничено значением параметра autovacuum_max_workers. (по умолчанию: 1min) (по умолчанию: 3)
Ограничение количества рабочих процессов можно менять на лету, но только в пределах autovacuum_worker_slots. А изменение количества слотов уже требует перезапуска сервера, поскольку резервирует место в его разделяемой памяти. (v. 18) (по умолчанию: 16) (с. 379)
Рабочие процессы автоочистки очень напоминают фоновые рабочие процессы, но появились задолго до того, как был создан этот механизм заданий общего вида. Реализацию процессов автоочистки не стали менять, поэтому они не задействуют слоты
из max_worker_processes.
Запустившись, рабочий процесс подключается к указанной ему базе данных и начинает с того, что строит два списка:
список всех таблиц, материализованных представлений и toast-таблиц, требующих очистки;
список всех таблиц и материализованных представлений, требующих анализа (toast-таблицы не анализируются, потому что обращение к ним всегда происходит по индексу).
Затем рабочий процесс по очереди очищает или анализирует отобранные объекты (или выполняет и то, и другое), после чего завершается.
Очистка каждой таблицы происходит так же, как при запуске команды VACUUM вручную. Но есть некоторые отличия:
- Очистка, запускаемая вручную, использует для накопления идентификаторов версий фрагмент памяти размером maintenance_work_mem.
При автоматической очистке одновременно выполняются несколько рабочих процессов, и оперативная память нужна каждому. Поэтому для автоочистки предусмотрен отдельный параметр autovacuum_work_mem. Значение по умолчанию, при котором используется обычное ограничение maintenance_work_mem, скорее всего, следует скорректировать, если конфигурация предполагает большое количество рабочих процессов (autovacuum_max_workers). (по умолчанию: -1)
- Очистка, запускаемая вручную, может обрабатывать несколько индексов на одной таблице параллельно, а автоматическая очистка — нет, поскольку это могло бы привести к слишком большому числу одновременно запущенных процессов.
Если процесс не успеет выполнить всю намеченную работу за интервал времени autovacuum_naptime, процесс autovacuum launcher пошлет в ту же базу данных еще один рабочий процесс, и они будут работать вместе. Второй процесс построит свои собственные списки объектов для очистки и анализа и пойдет по ним. Параллельно будут обрабатываться разные таблицы; на уровне одной таблицы параллелизма нет.
Какие таблицы требуют очистки
Автоочистку можно отключить на уровне отдельных таблиц, хотя сложно придумать причину, по которой это было бы необходимо. За отключение отвечают два параметра хранения: один для простых таблиц, другой — для toast-таблиц:
autovacuum_enabled;
toast.autovacuum_enabled.
Обычно же автоочистка срабатывает при накоплении либо неактуальных версий, либо новых строк. (с. 153)
Неактуальные версии строк. Примерное число неактуальных версий постоянно отслеживается и доступно в таблице pg_stat_all_tables.
Считается, что очистка необходима, если количество неактуальных, мертвых версий строк превышает пороговое значение, определяемое тремя параметрами:
autovacuum_vacuum_threshold — абсолютное значение (в штуках); (по умолчанию:
50)autovacuum_vacuum_scale_factor — доля строк в таблице; (по умолчанию:
0.2)autovacuum_vacuum_max_threshold — дополнительный порог для очень больших таблиц. (по умолчанию:
100 млн) (v. 18)
Формула такова: очистка мертвых версий требуется, если
или (v. 18)
В первой части формулы для больших таблиц (а именно с ними и связаны возможные проблемы) важен параметр autovacuum_vacuum_scale_factor. Значение по умолчанию 20 % представляется сильно завышенным; скорее всего, его потребуется существенно уменьшить. Если и после этого пороговое значение слишком велико для очень больших таблиц, его можно ограничить сверху параметром из второй части формулы.
Если не удается подобрать универсальные значения параметров, их можно переопределить для отдельных таблиц с помощью одноименных параметров хранения (autovacuum_vacuum_threshold, autovacuum_vacuum_scale_factor, autovacuum_vacuum_max_threshold). Аналогичные параметры хранения с префиксом toast определяют настройки для toast-таблиц.
Вставленные строки. Для хранилищ данных типична ситуация, когда строки добавляются, но никогда не удаляются и не изменяются. В этом случае в таблице не будет мертвых версий и предыдущее условие срабатывания не будет выполняться. Однако и такие таблицы необходимо очищать, чтобы заблаговременно замораживать версии строк и обновлять карту видимости (и тем самым разрешать сканирование только индекса). Поэтому добавляется еще одно условие. (v. 13) (с. 422)
Очистка будет выполняться, если число строк, вставленных с момента последней очистки, превышает пороговое значение, определяемое парой параметров:
autovacuum_vacuum_insert_threshold; (по умолчанию:
1000)autovacuum_vacuum_insert_scale_factor. (по умолчанию:
0.2)
Как и число неактуальных версий, количество вставленных строк отслеживается как часть статистики использования таблицы.
Формула такова:
Если с первым слагаемым все понятно — это просто абсолютное значение, — то ко второму необходим комментарий. В нем вычисляется доля не от всех, а только от незамороженных строк; соответствующая часть таблицы оценивается отношением числа полностью замороженных страниц (relallfrozen) к их общему количеству (relpages). Дело в том, что с ростом таблицы строк в ней становится все больше и больше, и без коэффициента очистка выполнялась бы все реже и реже. А вот количество незамороженных строк периодически уменьшается, поэтому частота срабатываний не увеличивается — что хорошо. (v. 18)
Как и в предыдущем случае, мы можем переопределить значения параметров для отдельных таблиц с помощью одноименных параметров хранения (autovacuum_vacuum_insert_threshold и autovacuum_vacuum_insert_scale_factor) и их toast-версий.
Какие таблицы требуют анализа
С автоанализом дело обстоит проще, чем с очисткой, потому что учитываются только измененные строки.
Считается, что анализа требуют те таблицы, в которых число измененных строк (с момента прошлого анализа) превышает пороговое значение, заданное парой параметров:
autovacuum_analyze_threshold; (по умолчанию:
50)autovacuum_analyze_scale_factor. (по умолчанию:
0.1)
Формула срабатывания автоанализа:
Настройки автоанализа также можно переопределить на уровне таблиц с помощью одноименных параметров хранения (autovacuum_analyze_threshold и autovacuum_analyze_scale_factor). Поскольку toast-таблицы не анализируются, для них соответствующих параметров нет.
Автоочистка в действии
Начнем с написания функции, возвращающей текущее значение параметра:
Мы используем эту функцию в представлениях, которые покажут нам, какие таблицы в данный момент нуждаются в очистке и анализе3. Представления пригодятся в примерах, а заодно формализуют все сказанное выше в этом разделе.
Так может выглядеть представление для очистки:
Столбец max_dead_tup показывает пороговое значение срабатывания автоочистки из-за мертвых версий строк, а столбец max_ins_tup — из-за вставки новых строк.
А вот аналогичное представление для анализа:
Столбец max_mod_tup показывает пороговое значение срабатывания автоанализа.
Чтобы не ждать долго автоочистку, для экспериментов будем запускать процесс каждую секунду:
Опустошим таблицу vac и вставим в нее тысячу строк. Напомню, что автоочистка отключена на уровне таблицы.
Вот что покажет наше представление для очистки:
Пороговое значение max_dead_tup = 50, хотя по приведенной выше формуле должно быть 50 + 0,2 × 1000 = 250. Дело в том, что еще нет статистики по таблице, поскольку команда INSERT сама по себе ее не обновляет:
Специальная константа −1 для pg_class.reltuples позволяет отличать таблицу без статистики от пустой, но проанализированной таблицы, для которой этот столбец будет равен нулю. Для расчетов отрицательное значение приводится к нулю, что и дает 50 + 0,2 × 0 = 50. (v. 14)
Значение max_ins_tup = 1000 отличается от расчетного числа 1200 по той же причине.
Заглянем в представление для анализа:
Мы изменили тысячу строк (в данном случае они были добавлены), и это больше порога, который пока равен 50 с учетом неизвестного размера таблицы. Значит, автоанализ должен сработать.
Включим его:
После небольшой паузы таблица оказывается проанализированной, пороговое значение исправляется на корректные 150 строк:
Вернемся к автоочистке:
Значения max_dead_tup и max_ins_tup тоже исправились с учетом выясненного в процессе анализа размера таблицы.
На данный момент очистка может состояться в одном из двух случаев:
при появлении более 250 мертвых версий строк;
при вставке в таблицу более 200 строк. (v. 13)
Снова отключим автоочистку и обновим 251 строку — на одну больше, чем пороговое значение:
Теперь условие срабатывания выполняется. Включим автоочистку и после непродолжительной паузы обнаружим, что таблица обработана, а статистика использования сброшена:
7.2. Заморозка
Для экспериментов с заморозкой создадим новую таблицу. Установим для нее минимальное значение параметра fillfactor так, чтобы на каждой странице помещалось всего две строки — так будет удобнее наблюдать за происходящим. И как и раньше, отключим автоматику, чтобы управлять временем очистки самостоятельно.
Очередной вариант функции для просмотра страниц с помощью расширения pageinspect будет отображать диапазон страниц, расшифровывать признак заморозки (f) и показывать возраст транзакции xmin (для этого используется системная функция age; сам возраст, конечно, не хранится в страницах данных):
Вставляем в таблицу некоторое количество строк и сразу выполняем очистку, чтобы создалась карта видимости:
Будем наблюдать за первыми двумя страницами с помощью расширения pg_visibility. После очистки обе страницы оказываются отмеченными в карте видимости (all_visible), но не в карте заморозки (all_frozen) — они еще содержат незамороженные версии строк:
У транзакции, создавшей строки, возраст xmin_age равен 1, поскольку это последняя транзакция, которая выполнялась в системе:
7.3. Управление заморозкой
Заморозкой управляют четыре основных конфигурационных параметра. Значения всех четырех представляют возраст транзакций и определяют моменты, начиная с которых:
версии начинают замораживаться — vacuum_freeze_min_age;
выполняется агрессивная заморозка — vacuum_freeze_table_age;
заморозка срабатывает аварийно — autovacuum_freeze_max_age;
заморозка работает в приоритетном режиме — vacuum_failsafe_age. (v. 14)
Минимальный возраст для заморозки
Минимальный возраст транзакции xmin, при котором версию строки можно замораживать, определяется параметром vacuum_freeze_min_age. Чем меньше это значение, тем сильнее могут вырасти накладные расходы: если строка окажется «горячей» и будет активно изменяться, то заморозка все новых и новых версий будет пропадать без пользы. Установка относительно большого значения параметра позволяет выждать. (по умолчанию: 50 млн)
Если вызвать заморозку вручную командой VACUUM FREEZE, будут заморожены все версии строк без оглядки на возраст транзакций, как будто vacuum_freeze_min_age = 0. Именно поэтому в рассмотренном ранее примере была заморожена буквально только что появившаяся версия.
Чтобы посмотреть, как происходит заморозка, уменьшим значение до единицы: (с. 136)
Обновим теперь одну строку на нулевой странице. Новая версия попадет на ту же страницу благодаря небольшому значению fillfactor:
Возраст транзакций увеличился на единицу. Табличные страницы выглядят сейчас следующим образом:
Теперь строки старше vacuum_freeze_min_age = 1 подлежат заморозке. Но очистка рассматривает только те страницы, которые не отмечены в карте видимости: (с. 131)
Очистка пропускает страницы, отмеченные в карте видимости, только если подряд идут минимум 32 такие страницы4. Если же признаки чередуются чаще, карта видимости игнорируется: пропускать отдельные страницы не имеет большого смысла, поскольку они все равно окажутся в оперативной памяти благодаря предвыборке. Именно поэтому таблица tfreeze создана достаточно большой, хотя нас интересуют только две страницы.
Предыдущая команда UPDATE сбросила бит видимости нулевой страницы, а вот первую страницу очистка пропустит:
Обратите внимание, что на нулевой странице были заморожены обе версии строк, хотя возраст транзакции xmin во второй версии не превышает значение параметра vacuum_freeze_min_age. Поскольку страницу все равно приходится менять, на ней замораживаются все версии строк за горизонтом базы данных — это практически не увеличивает стоимость операции, но может сэкономить усилия в будущем. (v. 16)
Теперь обе страницы снова отмечены в карте видимости. Несмотря на то что первая страница содержит незамороженные строки, очистка будет пропускать ее, если в ней ничего не изменится:
Возраст для агрессивной заморозки
Итак, если на странице остались только актуальные версии, видимые во всех снимках, очистка не заморозит их. Справиться с проблемой позволяет параметр vacuum_freeze_table_age. Его значение определяет возраст транзакции, при котором очистка игнорирует карту видимости и замораживает все страницы, предотвращая последствия переполнения счетчика транзакций. Такой режим очистки называется агрессивным; поскольку его основная задача состоит в заморозке, я буду употреблять и термин «агрессивная заморозка». (по умолчанию: 150 млн) (с. 134)
Для каждой таблицы в системном каталоге хранится номер транзакции, про которую известно, что все более старые транзакции гарантированно заморожены:
С возрастом этой запомненной транзакции и сравнивается значение параметра vacuum_freeze_table_age для принятия решения об агрессивной заморозке.
Благодаря карте заморозки нет необходимости полностью сканировать таблицу при очистке; достаточно просмотреть только те страницы, которые еще не отмечены в карте. Карта заморозки не только существенно уменьшает объем работы, но и дает устойчивость к прерываниям: если процесс очистки остановить и начать заново, ему не придется возвращаться к страницам, которые уже были обработаны и отмечены в карте в прошлый раз.
Для заморозки всей таблицы уменьшим значение vacuum_freeze_table_age до двух, чтобы выполнилось условие агрессивной заморозки:
Выполним очистку:
Теперь, поскольку агрессивная очистка проверяет всю таблицу, номер замороженной транзакции можно увеличить — в страницах гарантированно не осталось более старой незамороженной транзакции:
Разумеется, на первой странице теперь заморожены все версии строк:
Кроме того, первая страница отмечена в карте заморозки:
Агрессивная заморозка всех страниц в таблице выполняется не чаще, чем раз в vacuum_freeze_table_age − vacuum_freeze_min_age транзакций (100 млн при значениях параметров по умолчанию). Она будет запускаться реже, если очистка в неагрессивном режиме тоже сможет продвинуть значение relfrozenxid5. В любом случае надо учитывать, что слишком большое значение параметра vacuum_freeze_min_age вместо экономии может привести к избыточным срабатываниям агрессивной заморозки и увеличению накладных расходов. (v. 15)
Возраст для аварийного срабатывания автоочистки
Бывают ситуации, когда предыдущих двух настроек оказывается недостаточно для своевременной заморозки версий строк. Автоочистку можно отключить, а обычную очистку — не запускать (так делать не надо, но технически это возможно). Также могут присутствовать таблицы, не попадающие в очередь автоочистки, или неактивные базы данных (например, template0), в которые автоочистка вообще не приходит. Для подобных случаев предусмотрено аварийное срабатывание автоочистки в агрессивном режиме, что позволяет предотвратить переполнение счетчика транзакций. (с. 139)
Агрессивная очистка базы данных запускается аварийно, когда возраст какой-нибудь незамороженной транзакции в этой базе может превысить значение autovacuum_freeze_max_age6. Даже если отключить автоочистку, она все равно запустится — правда, не сразу, а при первом ручном выполнении очистки или перезапуске сервера. (по умолчанию: 200 млн)
Определяющим для аварийного срабатывания является возраст самой старой из транзакций pg_class.relfrozenxid по всем таблицам базы, поскольку все еще более старые транзакции гарантированно заморожены. Номер этой транзакции запоминается в системном каталоге:
datfrozenxid
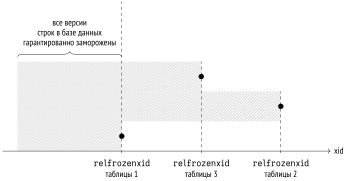
Предел для значения autovacuum_freeze_max_age составляет 2 млрд транзакций (чуть менее половины круга), а значение по умолчанию в 10 раз меньше. В этом есть смысл: большое значение увеличивает риск того, что за оставшееся до переполнения счетчика время автоочистка просто не успеет заморозить все необходимые версии строк. В этом случае PostgreSQL аварийно остановится, чтобы предотвратить возможные проблемы, и запуск потребует вмешательства администратора.
Кроме того, значение этого параметра ограничивает размер структуры clog. В кластере не может остаться более старых незамороженных транзакций, чем старейшая из datfrozenxid по всем базам данных, а для замороженных транзакций статус хранить не нужно. Лишние файлы-сегменты clog удаляются автоочисткой7. (с. 85)
Изменение параметра autovacuum_freeze_max_age требует перезапуска сервера. Но при необходимости все рассмотренные выше параметры управления заморозкой можно переопределить с помощью параметров хранения на уровне отдельных таблиц. Обратите внимание на то, что названия всех параметров начинаются на «auto»: autovacuum_freeze_min_age, autovacuum_freeze_table_age и autovacuum_freeze_max_age.
Возраст для приоритетного режима заморозки
Если автоочистка уже работает над предотвращением переполнения счетчика транзакций, но явно не успевает, срабатывает «предохранитель»: автоочистка прекращает учитывать задержку autovacuum_vacuum_cost_delay (vacuum_cost_delay) и перестает очищать индексы, чтобы как можно быстрее заморозить версии строк. (v. 14)
Приоритетный режим заморозки включается8, если возраст какой-нибудь незамороженной транзакции в базе данных может превысить значение параметра vacuum_failsafe_age. Предполагается, что значение этого параметра должно быть выше, чем значение autovacuum_freeze_max_age. (по умолчанию: 1,6 млрд)
При ручном вызове, когда цель состоит не в освобождении места на страницах данных, а в максимально быстрой заморозке, очистку индексов тоже имеет смысл отключить. Это можно сделать либо явно, используя команду VACUUM (freeze,
index_cleanup false), либо с помощью параметра хранения vacuum_index_cleanup. (v. 12)
7.4. Нетерпеливое сканирование
Когда очистка не занимается агрессивной заморозкой, она пропускает страницы, отмеченные в карте видимости, поскольку вычищать из них нечего. Но из этого правила есть исключения. (v. 18)
Про одно я уже вскользь упоминал: очистка вынуждена сканировать страницы, отмеченные в карте видимости, если не набирается хотя бы 32 страницы, идущие подряд. Пропускать такие небольшие группы не только бесполезно, но и вредно: может сбиться алгоритм операционной системы, отвечающий за предвыборку страниц.
Другое исключение более интересно. Очистка может намеренно просканировать некоторое количество страниц, отмеченных в карте видимости (но не в карте заморозки). Такое сканирование называется «нетерпеливым» (eager).
И в том, и в другом случае к прочитанным страницам применяются обычные правила заморозки, что дает шанс заморозить все версии строк на странице, отметить ее в карте заморозки и таким образом уменьшить объем работы в агрессивном режиме. С другой стороны, чтение лишних страниц — это дополнительная нагрузка, и она не должна мешать основной деятельности.
Если не удается заморозить несколько страниц подряд, то, скорее всего, все версии строк в этом фрагменте таблицы еще недостаточно старые, так что продолжать попытки бесполезно. Размер фрагмента фиксирован (4096 страниц), а доля неудачных попыток ограничена значением параметра vacuum_max_eager_freeze_failure_rate (или одноименного параметра хранения). Настройки по умолчанию дают право на 122 промаха, после чего нетерпеливое сканирование текущего фрагмента прерывается. (по умолчанию: 0.03)
Но в другом месте таблицы ситуация может отличаться, поэтому при входе в следующий фрагмент счетчик неудачных попыток сбрасывается и нетерпеливое сканирование продолжается.
Таким образом, в худшем случае нетерпеливое сканирование зря прочитает vacuum_max_eager_freeze_failure_rate от количества страниц, отмеченных в карте видимости, но не отмеченных в карте заморозки. Установка этого параметра в ноль фактически запрещает нетерпеливое сканирование.
Но и при удачном стечении обстоятельств замораживать сразу много страниц не нужно, чтобы не сильно увеличивать время работы и не превращать обычную очистку в агрессивную. Поэтому число успешных попыток тоже ограничено и не может превышать 20 % от количества страниц, отмеченных в карте видимости, но не в карте заморозки.
Чтобы посмотреть на заморозку при нетерпеливом сканировании, вернем исходное значение возраста агрессивной заморозки, но сохраним установленный ранее минимальный возраст срабатывания обычной очистки.
Нетерпеливое сканирование происходит не всегда; одно из условий — не слишком маленькая таблица, минимум 8192 страницы. Поэтому наполним tfreeze заново достаточным количеством строк (напомню, что на одной странице помещается две версии):
Затем очистим таблицу, чтобы все страницы отметились в карте видимости. И финальный подготовительный штрих: выполним транзакцию, чтобы увеличить возраст всех версий на единицу — теперь они попадают под условие заморозки.
Наконец, все готово, запускаем очистку с параметром verbose:
Мы видим, что нетерпеливое сканирование было прервано после успешной заморозки 1638 страниц: это как раз 20 % от 8192. Заметьте, что несколькими строками ниже сказано, что всего было заморожено 1640 страниц: как я говорил, нетерпеливое сканирование — не единственный случай, когда обычная очистка читает страницы, отмеченные в карте видимости. Например, последняя страница сканируется всегда: если в ней есть версии строк, очистка не будет пытаться усекать таблицу, чтобы не захватывать впустую исключительную блокировку. (с. 133)
7.5. Заморозка при загрузке
Данные, которые не должны меняться, можно заморозить сразу при начальной загрузке. Для этого используется команда COPY с параметром FREEZE.
Загружать данные с заморозкой можно только в таблицу, созданную или опустошенную (командой TRUNCATE) в этой же транзакции. Обе эти операции монопольно блокируют таблицу. Такое ограничение необходимо, поскольку замороженные версии считаются видимыми во всех снимках данных независимо от уровня изоляции; иначе транзакции неожиданно обнаруживали бы свежезамороженные строки прямо по мере их загрузки. Но пока таблица заблокирована, другие транзакции не смогут получить к ней доступ. (с. 261)
Тем не менее формально нарушение изоляции все же возможно. В отдельном сеансе начнем транзакцию с уровнем изоляции Repeatable Read:
Опустошим таблицу tfreeze и в той же транзакции загрузим в нее новые строки. (Если бы читающая транзакция успела обратиться к tfreeze, команда TRUNCATE была бы заблокирована.)
Теперь читающая транзакция видит новые данные в нарушение изоляции:
Но поскольку загрузка данных вряд ли происходит регулярно, в большинстве случаев это не представляет проблемы.
При загрузке с заморозкой сразу же создается карта видимости, а в заголовках страниц проставляется признак видимости: (v. 14) (с. 127)
Таким образом, после загрузки с заморозкой очистка уже не будет обрабатывать таблицу (если, конечно, данные в ней останутся неизменными). К сожалению, это пока не работает для toast-таблиц: при загрузке длинных значений очистке придется лишний раз переписать всю toast-таблицу, чтобы проставить признак видимости в заголовки всех страниц. (v. 14)
7.6. Регулирование нагрузки и мониторинг
Очистка не блокирует другие процессы, поскольку работает постранично, но тем не менее создает нагрузку на систему и может оказывать заметное влияние на производительность.
Отслеживание хода выполнения очистки позволяет обнаружить ситуации, когда процесс проявляет избыточную активность или работает неэффективно, не справляясь с невычищенными и незамороженными версиями, нарастающими как снежный ком.
Ручная очистка
Очистка выполняет примерно vacuum_cost_limit условных единиц работы, а затем засыпает на vacuum_cost_delay единиц времени. Такое чередование работы и ожидания позволяет более или менее равномерно распределить влияние очистки на систему, не допуская пиковых нагрузок. (по умолчанию: 200) (по умолчанию: 0)
Нулевое значение по умолчанию для vacuum_cost_delay фактически означает, что (ручная) очистка вовсе не засыпает, так что конкретное значение vacuum_cost_limit не играет никакой роли. Это сделано из соображения, что если уж администратору пришлось запускать очистку вручную, то он, вероятно, хочет выполнить ее как можно быстрее.
Тем не менее если все-таки установить время сна, то указанный в параметре vacuum_cost_limit объем работы будет складываться из стоимостей работы со страницами в буферном кеше. Каждое чтение страницы оценивается в vacuum_cost_page_hit единиц, если страница нашлась в буферном кеше, и в vacuum_cost_page_miss единиц, если не нашлась9. Если же страница не была грязной, а в результате работы очистки на ней что-то поменялось, это стоит дополнительных vacuum_cost_page_dirty единиц10. (с. 183) (по умолчанию: 1) (по умолчанию: 2) (по умолчанию: 20)
Если оставить значение vacuum_cost_limit по умолчанию, за один цикл очистка может обработать от 200 страниц в лучшем случае (если все они закешированы и в результате работы не появилось ни одной новой грязной) до всего 9 в худшем (если все страницы читаются с диска и становятся грязными).
Команда VACUUM с указанием VERBOSE выполняет очистку и выводит отчет о проделанной работе, а представление pg_stat_progress_vacuum показывает состояние уже запущенного процесса.
Похожее представление есть и для анализа (pg_stat_progress_analyze), хотя анализ выполняется быстро и обычно не доставляет проблем. (v. 13)
Вставим в таблицу больше строк и все обновим, чтобы очистка выполнялась ощутимое время:
Для целей демонстрации уменьшим размер памяти, выделенной под хранение идентификаторов, до абсурдно скромного значения:
Запустим очистку и, пока она работает, обратимся несколько раз к представлению pg_stat_progress_vacuum:
Представление, в частности, показывает: (v. 17)
phase— текущий этап очистки (выше я описал основные, но вообще их больше 11);heap_blks_total— общее число страниц таблицы;heap_blks_scanned— число просканированных страниц;heap_blks_vacuumed— число уже очищенных страниц;index_vacuum_count— количество проходов по индексам;dead_tuple_bytesиnum_dead_item_ids— объем и количество мертвых версий, собранных за данный проход.
Общий прогресс очистки определяется отношением heap_blks_vacuumed к heap_blks_total, но нужно учитывать, что из-за сканирования индексов это значение изменяется «рывками».
Основное внимание стоит обратить на количество циклов очистки (поле index_vacuum_count): значение больше единицы сигнализирует о том, что выделенной памяти не хватило для завершения очистки за один проход по индексам. Впрочем, вероятность этого при разумном значении maintenance_work_mem мала. Эффективность хранения можно оценить по отношению dead_tuple_bytes к num_dead_item_ids: в данном примере на один tid расходуется примерно полбайта.
Если включить параметр track_cost_delay_timing, поле delay_time покажет фактическое время сна. Надо иметь в виду, что на некоторых платформах отслеживание времени может существенно замедлить выполнение, так что этой возможностью следует пользоваться с осторожностью. (по умолчанию: off) (v. 18)
Вывод завершившейся к этому времени команды VACUUM VERBOSE показывает общую картину:
В данном случае очистке потребовалось выполнить целых три прохода по индексам.
Автоочистка
Регулирование нагрузки для автоматической очистки 12 работает примерно так же, как и для обычной. Но чтобы они могли работать с разной интенсивностью, для автоочистки предусмотрены собственные параметры:
autovacuum_vacuum_cost_limit; (по умолчанию:
-1)autovacuum_vacuum_cost_delay. (по умолчанию:
2ms)
Если какой-либо из этих параметров равен −1, для него используется значение соответствующего параметра обычной очистки. То есть по умолчанию для autovacuum_vacuum_cost_limit применяется значение vacuum_cost_limit.
Единицы работы автоочистки, ограниченные в одном цикле пределом autovacuum_vacuum_cost_limit, расходуются всеми рабочими процессами, так что общая нагрузка на систему остается примерно одинаковой при любом их количестве. Поэтому если стоит задача ускорить автоочистку, при увеличении параметра autovacuum_max_workers стоит пропорционально увеличить и значение autovacuum_vacuum_cost_limit.
При необходимости для разных таблиц можно устанавливать собственные значения с помощью параметров хранения (autovacuum_vacuum_cost_limit и autovacuum_vacuum_cost_delay) и их toast-версий.
Представления need_vacuum и need_analyze, которые мы уже рассмотрели, позволяют отслеживать список таблиц, требующих очистки и анализа. Увеличение длины списка говорит о том, что автоочистка не справляется и ее надо ускорить, уменьшив паузу (autovacuum_vacuum_cost_delay) или увеличив объем работы между паузами (autovacuum_vacuum_cost_limit). Не исключено, что понадобится также увеличить степень параллелизма (autovacuum_max_workers).
Помимо запросов есть и штатный способ мониторинга автоочистки — вывод информации (аналогичной той, которую показывает команда VACUUM VERBOSE) в журнал сообщений сервера для дальнейшего анализа.
Установим нулевое значение параметра log_autovacuum_min_duration, при котором в журнал попадают все запуски автоочистки: (по умолчанию: -1)
Включим также отслеживание времени сна очистки. Для ручной очистки, которая по умолчанию не спит, это не было бы информативно, а вот для автоочистки может дать информацию к размышлению. (v. 18)
Снова обновим все строки таблицы, чтобы автоочистке было чем заняться:
Из журнала следует, что бо́льшую часть времени автоочистка простаивала, так что для увеличения скорости имеется достаточный резерв.
Общее время, затраченное на очистку и анализ таблицы (в миллисекундах), можно узнать из системной статистики: (v. 18)
postgrespro.ru/docs/postgresql/18/routine-vacuuming#AUTOVACUUM. ↩︎
backend/postmaster/autovacuum.c, функция relation_needs_vacanalyze. ↩︎
backend/access/heap/vacuumlazy.c, функция heap_vac_scan_next_block. ↩︎
backend/access/transam/varsup.c, функция SetTransactionIdLimit. ↩︎
backend/commands/vacuum.c, функция vac_truncate_clog. ↩︎
backend/access/heap/vacuumlazy.c, функция lazy_check_wraparound_failsafe. ↩︎
backend/storage/buffer/bufmgr.c, функция ReadBuffer_common. ↩︎
backend/storage/buffer/bufmgr.c, функция MarkBufferDirty. ↩︎
postgrespro.ru/docs/postgresql/18/progress-reporting#VACUUM-PHASES. ↩︎
backend/postmaster/autovacuum.c, функция autovac_balance_cost. ↩︎