3 Страницы и версии строк
PostgreSQL 18 · Издание 2026 года · Китайский перевод доступен для PostgreSQL 18
3.1. Структура страниц
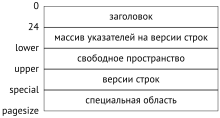
Каждая страница имеет внутреннюю разметку и, как правило, содержит следующие разделы 1:
заголовок;
массив указателей на версии строк;
свободное пространство;
версии строк;
специальную область.
Заголовок страницы
Заголовок страницы располагается в младших адресах и имеет фиксированный размер. Он хранит различную информацию о странице, такую как контрольная сумма, а также размеры всех остальных областей. (с. 127)
Размеры легко получить с помощью расширения pageinspect2. Заглянем в самую первую страницу таблицы (нумерация начинается с нуля):
Специальная область
Специальная область расположена в противоположном конце страницы, в старших адресах. Она используется некоторыми типами индексов для хранения вспомогательной информации. В остальных случаях, в том числе в табличных страницах, эта область имеет нулевой размер.
В целом индексные страницы устроены более разнообразно, и их содержимое зависит от конкретного типа индекса. И даже у одного типа индекса бывают разные виды страниц: например, у B-дерева есть нулевая страница метаданных с особой структурой и «обычные» страницы, организованные как табличные. (с. 529)
Версии строк
Перед специальной областью располагаются строки (rows) — те самые данные, которые хранятся в базе, с добавлением некоторой служебной информации.
В случае таблиц мы говорим не просто о строках, а о версиях строк (row versions, tuples), поскольку многоверсионность предполагает существование нескольких версий одной и той же строки. На индексы многоверсионность не распространяется; вместо этого индексы ссылаются на все возможные табличные версии строк, среди которых по правилам видимости выбираются подходящие.
Термин tuple заимствован из реляционной теории и переводится как кортеж. Это еще одно наследие академического прошлого PostgreSQL. Чтобы не смешивать теорию с устройством СУБД, я буду использовать перевод версия строки (иногда, если это не вызывает неоднозначностей, заменяя более коротким словом строка).
Указатели на версии строк
Массив указателей на версии строк служит оглавлением страницы. Он располагается сразу за заголовком.
Индексные строки должны как-то ссылаться на версии строк в таблице. Для этого используются шестибайтные идентификаторы версий строк (tuple id, tid). Идентификатор состоит из номера страницы в файле основного слоя и должен еще содержать какое-то указание на версию строки в этой странице. (с. 29)
В качестве такого указания можно было бы использовать смещение относительно начала страницы. Но тогда версию строки нельзя было бы перемещать внутри страницы, не сломав ссылки из индексов. А это привело бы к фрагментации места внутри страниц и другим неприятным последствиям.
Поэтому используется косвенная адресация: идентификатор версии ссылается на номер указателя, а уже указатель — на текущую позицию версии строки в странице. При перемещении версии строки ее идентификатор не меняется; достаточно изменить указатель, который находится на той же странице.
Каждый указатель занимает ровно четыре байта и содержит:
смещение версии строки относительно начала страницы;
длину версии строки;
несколько битов, определяющих статус версии строки.
Свободное место
Между указателями и версиями строк может оставаться свободное место (которое и отмечено в карте свободного пространства). Никакой фрагментации внутри страницы не бывает, все свободное место всегда представлено одним фрагментом 3. (с. 31)
3.2. Структура версий строк
Версия строки состоит из заголовка, за которым следуют собственно данные. Заголовок версии содержит множество полей, среди которых:
xmin, xmax — номера транзакций, которые отличают данную версию от других версий той же строки;
infomask — ряд информационных битов, определяющих свойства версии;
ctid — ссылка на следующую, более новую версию той же строки;
битовая карта неопределенных значений — массив битов, отмечающих столбцы, которые допускают неопределенные значения (NULL).
В результате заголовок получается довольно большой — минимум 23 байта на каждую версию строки, а обычно больше из-за карты неопределенных значений и из-за обязательного выравнивания начала данных. Для «узкой» таблицы объем служебных данных вполне может превышать объем полезной информации.
Формат данных на диске полностью совпадает с представлением данных в оперативной памяти. Страница вместе с версиями строк читается в буферный кеш «как есть», без каких бы то ни было преобразований. Поэтому файлы данных с одной платформы оказываются несовместимыми с другими платформами4.
Одна из причин несовместимости — порядок следования байтов. Например, в архитектуре x86 принят порядок от младших разрядов к старшим (little-endian), z/Architecture использует обратный порядок (big-endian), а в ARM порядок переключаемый.
Несовместимость вызывается также выравниванием данных по границам машинных слов, которое требуется многим архитектурам. Например, в 32-битной системе архитектуры x86 целые числа (тип integer, занимает четыре байта) будут выровнены по границе четырехбайтных слов, как и числа с плавающей точкой двойной точности (тип double precision, восемь байт). А в 64-битной системе значения double будут выровнены по границе восьмибайтных слов.
Из-за выравнивания размер табличной строки зависит от порядка расположения полей. Обычно этот эффект не сильно заметен, но в некоторых случаях он может привести к существенному увеличению размера. Вот пример:
Я использовал функцию heap_page_items расширения pageinspect, которая позволяет получить информацию об указателях и версиях строк.
Словом heap (куча) в PostgreSQL обозначаются таблицы. Это еще одно не вполне очевидное употребление термина, намекающее на сходство механизма выделения места под версии строк с динамическим распределением оперативной памяти. Конечно, некоторую аналогию усмотреть можно, но для управления таблицей используются совсем другие алгоритмы. Можно считать, что слово употребляется в смысле «все свалено в кучу», подчеркивая отличие от упорядоченных индексов.
Строка занимает 56 байт. Из них 24 байта уходит на заголовок, столбцы типа float занимают по 8 байт, boolean — по 1 байту. В сумме имеем 42, а 14 байт пропадают из-за выравнивания float по границе восьмибайтных слов. Перестроив таблицу, можно использовать место более эффективно:
Надо, однако, учитывать, что выравниваются и версии строк внутри страницы. Как и предполагалось, строки стали занимать 42 байта, но 6 байт все-таки пропадают между строками:
Еще одна возможная микрооптимизация — перенести в начало таблицы все столбцы фиксированного размера, не допускающие неопределенных значений. Доступ к таким полям будет более эффективным благодаря возможности закешировать смещение поля от начала версии строки5.
3.3. Выполнение операций над версиями строк
Чтобы разные версии одной и той же строки можно было различить, каждая из версий имеет две отметки, определяющие ее «время действия», — xmin и xmax. Но используется не время как таковое, а постоянно увеличивающийся счетчик номеров транзакций. (с. 134)
Когда строка создается, значение xmin устанавливается равным номеру транзакции, выполнившей команду INSERT.
Когда строка удаляется, значению xmax текущей версии присваивается номер транзакции, выполнившей команду DELETE.
Команду UPDATE можно в некотором приближении рассматривать как две операции: DELETE и INSERT. В текущей версии строки устанавливается значение xmax, равное номеру транзакции, выполнившей UPDATE. Затем создается новая версия той же строки; значение xmin у нее совпадает со значением xmax предыдущей версии. Точно так же и команда MERGE «распадается» на элементарные вставки и удаления. (v. 15)
Дальше я подробно покажу, как выполняются разные операции с версиями строк на низком уровне6.
Для экспериментов понадобится таблица с двумя столбцами и индексом по одному из них:
Вставка
Вставляем одну строку, предварительно начав транзакцию:
Вот номер нашей текущей транзакции:
Для понятия транзакции в PostgreSQL часто используется сокращение xact, которое можно найти и в именах функций, и в коде. Соответственно, номер транзакции обозначается как xact id, txid или даже просто xid. Эти названия еще не раз нам встретятся.
Заглянем в содержимое страницы. Функция heap_page_items дает нам всю необходимую информацию, но показывает данные «как есть», в формате, сложном для восприятия:
Чтобы разобраться, оставим только часть информации и расшифруем некоторые столбцы:
Вот что здесь сделано:
Указатель
lpприведен к обычному виду идентификатора версии строки: (номер страницы, номер указателя).Расшифровано состояние указателя
lp_flags. Здесь он имеет значение normal — это значит, что указатель действительно ссылается на версию строки.Из всех информационных битов пока выделены только две пары. Биты
xmin_committedиxmin_abortedпоказывают, зафиксирована ли и отменена ли транзакция с номеромxmin. Аналогичную информацию о транзакцииxmaxдают битыxmax_committedиxmax_aborted.
В расширении pageinspect есть функция heap_tuple_infomask_flags, расшиф- (v. 13)
ровывающая все информационные биты, но я буду выводить только те, что нужны в данный момент, и в более компактном виде.
Итак, при вставке строки в табличной странице появился указатель с номером 1, ссылающийся на первую и пока единственную версию строки.
Поле xmin в версии строки заполнено номером текущей транзакции. Транзакция еще активна, поэтому биты xmin_committed и xmin_aborted не установлены.
Поле xmax заполнено фиктивным номером 0, поскольку данная версия строки не удалена и является актуальной. Транзакции не будут обращать внимания на этот номер, поскольку установлен бит xmax_aborted.
Может показаться странным, что бит оборванной транзакции установлен у транзакции, которой не было. Но с точки зрения изоляции это одно и то же: отмененная транзакция не оставляет следов и, следовательно, не существовала.
Такой запрос нам еще не раз понадобится, поэтому я оберну его в функцию. А заодно для компактности вывода уберу столбцы информационных битов, приписав статус транзакции к ее номеру:
В таком виде уже значительно понятнее, что творится в заголовке версии:
Похожую, но существенно менее детальную информацию можно получить и из самой таблицы, используя псевдостолбцы xmin и xmax:
Фиксация
При успешном завершении транзакции нужно запомнить ее статус — отметить, что она зафиксирована. Для этого используется структура, называемая clog 7 (commit log). Это не таблица системного каталога, а специальные файлы в каталоге PGDATA/pg_xact.
На несколько файлов clog разбит исключительно для удобства. Работа с этими файлами ведется постранично, через буферы в общей памяти сервера. Размер кеша clog настраивается параметром transaction_buffers, а по умолчанию составляет размера буферного кеша. (с. 309) (v. 17)
В clog, как и в заголовке версии строки, для каждой транзакции отведено два бита: committed и aborted.
Итак, при фиксации транзакции в clog выставляется бит committed для данной транзакции. Когда какая-либо другая транзакция обратится к нашей табличной странице, ей придется ответить на вопрос: завершилась ли транзакция с номером xmin?
- Если нет, то созданная версия строки не должна быть видна.
Чтобы проверить, выполняется ли транзакция, просматривается еще одна структура, которая располагается в общей памяти экземпляра и называется ProcArray. В ней находится список всех активных процессов, и для каждого указан номер его текущей (активной) транзакции.
- Если завершилась, то фиксацией или отменой? При отмене версия строки тоже не должна быть видна.
Для этой проверки как раз и нужна структура clog. Но хотя последние страницы clog сохраняются в буферах в оперативной памяти, все равно такую проверку накладно выполнять каждый раз. Поэтому выясненный однажды статус транзакции записывается в заголовок версии строки в информационные биты xmin_committed и xmin_aborted; их еще называют битами-подсказками (hint bits). Если один из этих битов установлен, то состояние транзакции xmin считается известным, и следующей транзакции уже не придется обращаться ни к clog, ни к ProcArray.
Почему эти биты не устанавливаются той транзакцией, которая вставляет строку? Дело в том, что в это время транзакция еще не знает, завершится ли она успешно. А в момент фиксации уже не понятно, какие именно строки в каких именно страницах были изменены. Таких страниц может оказаться много, и запоминать их невыгодно. К тому же часть страниц может быть вытеснена из буферного кеша на диск; читать их заново, чтобы изменить биты, означало бы существенно замедлить фиксацию.
Обратная сторона экономии состоит в том, что любая транзакция (даже выполняющая простое чтение — SELECT) может начать выставлять информационные биты в страницах данных. Конечно, страницы в буферном кеше при этом становятся грязными.
Зафиксируем наконец вставку строки, с которой мы начали транзакцию:
В странице ничего не изменилось (но мы знаем, что статус транзакции уже записан в clog):
Теперь транзакция, первой обратившаяся к странице («нормальным» образом, не с помощью pageinspect), должна будет определить статус транзакции xmin и записать его в информационные биты:
Удаление
При удалении строки в поле xmax актуальной версии записывается номер удаляющей транзакции, а бит xmax_aborted сбрасывается. (с. 268)
Это же значение xmax, соответствующее активной транзакции, выступает в качестве блокировки строки. Если другая транзакция собирается обновить или удалить эту строку, она будет вынуждена дождаться завершения транзакции xmax.
Удалим строку:
Номер транзакции записался в поле xmax, но информационные биты еще не установлены:
Отмена
Отмена изменений работает аналогично фиксации и выполняется так же быстро, только в clog вместо бита committed выставляется бит aborted. Хоть команда и называется ROLLBACK, отката изменений не происходит: все, что транзакция успела изменить в страницах данных, остается на месте.
При обращении к странице проверяется статус, и в версии строки устанавливается бит-подсказка xmax_aborted. Сам номер xmax при этом остается в странице, но смотреть на него уже никто не будет:
Обновление
Обновление работает так, как будто сначала выполнилось удаление текущей версии строки, а затем — вставка новой:
Запрос выдает одну строку (новую версию):
Но в странице хранятся обе версии:
Удаленная ранее версия помечена номером текущей транзакции в поле xmax. Это значение записано поверх старого, поскольку предыдущая транзакция была отменена. А бит xmax_aborted сброшен, так как статус текущей транзакции еще неизвестен.
Ну и завершим транзакцию.
3.4. Индексы
В индексах любого типа никогда не бывает версий строк, каждая строка представлена ровно одним экземпляром. Иными словами, в заголовке индексной строки не бывает полей xmin и xmax. Ссылки из индекса ведут на все табличные версии строк. Транзакции требуется заглянуть в таблицу, чтобы разобраться, какая из версий ей видна (если только страница не отмечена в карте видимости). (с. 115)
Для удобства создадим простую функцию, показывающую с помощью расширения pageinspect все индексные записи на странице (в пределах страницы B-дерева записи располагаются в виде плоского списка): (с. 523)
Обнаруживаем на странице указатели на обе версии табличной строки, как на актуальную, так и на старую:
Поскольку BAR < FOO, указатель на вторую версию строки стоит в индексе на первом месте.
3.5. TOAST
Toast-таблица является, по сути, обычной таблицей, и для нее поддерживается собственная версионность: версии «тостов» не связаны с версиями строк основной таблицы. Но внутренняя работа с toast-таблицей построена так, что строки никогда не обновляются, а только добавляются и удаляются, так что версионность в данном случае несколько вырожденная. (с. 33)
Когда данные меняются, в основной таблице всегда создается новая версия строки. Но если обновление не затрагивает «длинное» значение, хранящееся в TOAST, то новая версия строки будет ссылаться на прежнее значение в toast-таблице. И только когда обновление поменяет «длинное» значение, будут созданы и новая версия строки в основной таблице, и новые «тосты».
3.6. Виртуальные транзакции
PostgreSQL использует оптимизацию, позволяющую «экономить» номера транзакций.
Если транзакция только читает данные, то она никак не влияет на видимость версий строк. Поэтому вначале обслуживающий процесс выдает транзакции виртуальный номер 8 (virtual xid). Номер состоит из идентификатора обслуживающего процесса и последовательного числа. Выдача этого номера не требует синхронизации между всеми процессами и поэтому выполняется очень быстро. Настоящего номера у транзакции еще нет: (с. 259)
В разные моменты времени в системе вполне могут оказаться виртуальные транзакции с номерами, которые уже использовались. И это нормально, поскольку виртуальные номера существуют только в оперативной памяти, пока транзакция активна; они никогда не записываются в страницы данных и не попадают на диск.
Если же транзакция начинает менять данные, ей выдается настоящий, уникальный номер транзакции:
3.7. Вложенные транзакции
Точки сохранения
В SQL определены точки сохранения (savepoint), которые позволяют отменить часть операций транзакции, не прерывая ее полностью. Но это не укладывается в приведенную выше схему, поскольку статус транзакции один на все изменения, а физически никакие данные не откатываются.
Чтобы реализовать такой функционал, транзакция с точкой сохранения разбивается на несколько вложенных транзакций 9 (subtransaction), статусом которых можно управлять отдельно.
Вложенные транзакции имеют свой собственный номер (больший, чем номер основной транзакции). Статус вложенных транзакций записывается в clog обычным образом, но зафиксированные вложенные транзакции одновременно отмечаются двумя битами, committed и aborted. Финальный статус зависит от статуса основной транзакции: если она отменена, то и все вложенные транзакции считаются отмененными.
Информация о вложенности транзакций хранится в файлах внутри каталога PGDATA/pg_subtrans, а обращение к страницам этих файлов происходит через SLRU-кеш. Его размер настраивается параметром subtransaction_buffers, а по умолчанию составляет размера буферного кеша. (с. 309)
Не путайте вложенные транзакции с автономными. Автономные транзакции никак не зависят друг от друга, в отличие от вложенных. Автономных транзакций в обычном PostgreSQL нет, и, пожалуй, к лучшему: по делу они нужны очень и очень редко, а их наличие в других СУБД провоцирует злоупотребления, от которых потом все страдают.
Опустошим таблицу, начнем транзакцию и вставим строку:
Теперь поставим точку сохранения и вставим еще одну строку:
Заметьте, что функция pg_current_xact_id выдает номер основной, а не вложенной транзакции.
Откатимся к точке сохранения и вставим третью строку:
В странице мы продолжаем видеть строку, добавленную отмененной вложенной транзакцией.
Фиксируем изменения:
Теперь хорошо видно, что каждая вложенная транзакция имеет собственный статус.
Вложенные транзакции нельзя использовать в SQL напрямую, то есть нельзя начать новую транзакцию, не завершив текущую:
Этот механизм задействуется неявно: при использовании точек сохранения, при обработке исключений PL/pgSQL и в некоторых других, более экзотических случаях.
Ошибки и атомарность операций
Что случится, если в процессе выполнения операции произойдет ошибка?
Например:
После сбоя транзакция считается прерванной, и больше ни одна операция в ней не допускается:
И даже если попытаться зафиксировать изменения, PostgreSQL сообщит об отмене:
Почему нельзя продолжить выполнение транзакции после сбоя? Поскольку уже выполненные действия никогда не откатываются, мы получили бы доступ к части изменений, выполненных до ошибки, — была бы нарушена атомарность даже не транзакции, а оператора.
Как в нашем примере, где оператор до ошибки успел обновить одну строку из двух:
К слову, в psql имеется режим, который все-таки позволяет продолжать работу транзакции после сбоя так, как будто действия ошибочного оператора откатываются:
Нетрудно догадаться, что в таком режиме psql фактически ставит перед каждой командой неявную точку сохранения, а в случае сбоя инициирует откат к ней. Такой режим не используется по умолчанию, поскольку установка точек сохранения (даже без отката к ним) сопряжена с существенными накладными расходами.
postgrespro.ru/docs/postgresql/18/storage-page-layout; include/storage/bufpage.h. ↩︎
backend/storage/page/bufpage.c, функция PageRepairFragmentation. ↩︎
backend/access/common/heaptuple.c, функция heap_deform_tuple. ↩︎
postgrespro.ru/docs/postgresql/18/transaction-id; backend/access/transam/xact.c. ↩︎
postgrespro.ru/docs/postgresql/18/subxacts; backend/access/transam/subtrans.c. ↩︎