# Введение
Индекс LLMS: [llms.txt](/ru/llms.txt)
---
## 1.1. Организация данных {#internal-ru-section-1-1}
### Базы данных {#internal-ru-subsection-star-10}
PostgreSQL — программа, которая относится к классу систем управления базами данных. Когда эта программа выполняется, мы называем ее *сервером* PostgreSQL, или *экземпляром* сервера.
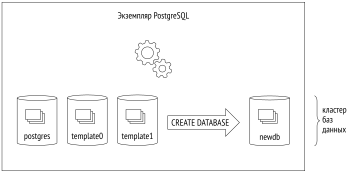
Данные, которыми управляет PostgreSQL, хранятся в базах данных [^internal-ru-24-1]. Один экземпляр PostgreSQL одновременно работает с несколькими базами, которые вместе называются *кластером баз данных*.
Чтобы кластер можно было использовать, его необходимо *инициализировать* [^internal-ru-24-2] (создать). Каталог, в котором размещаются все файлы, относящиеся к кластеру, обычно называют словом PGDATA, по имени переменной окружения, указывающей на этот каталог.
> [!NOTE]
> Пакетные установки могут вводить свои «слои абстракции» над штатным механизмом PostgreSQL, явно прописывая все необходимые утилитам параметры. Сервер баз данных представляется в таком случае в виде службы операционной системы, и непосредственно с переменной PGDATA можно никогда не встретиться. Но сам термин устоялся, и я буду им пользоваться.
При инициализации в PGDATA создаются три одинаковые базы данных:
**template0** используется, например, для восстановления из логической резервной копии или для создания базы в другой кодировке и никогда не должна меняться; (*с.* [631](/ru/28-gin/#internal-ru-page-632))
**template1** служит шаблоном для всех остальных баз данных, которые может создать пользователь в этом кластере;
**postgres** представляет собой обычную базу данных, которую можно использовать по своему усмотрению.
{#internal-ru-fig-1-1 num="1.1" caption="Базы данных" .book-original-figure width=718 height=345}
### Системный каталог {#internal-ru-subsection-star-13}
Метаинформация обо всех объектах кластера (таких как таблицы, индексы, типы данных или функции) хранится в таблицах, относящихся к *системному каталогу* [^internal-ru-25-1]. В каждой базе данных имеется собственный набор таблиц (и представлений), описывающих объекты этой конкретной базы. Существует также несколько таблиц системного каталога, общих для всего кластера, которые не принадлежат какой-либо определенной базе данных (формально используется фиктивная база с нулевым идентификатором), но доступны в любой из них.
К системному каталогу можно обращаться с помощью обычных запросов SQL, а изменения в нем происходят при выполнении команд DDL. Клиент psql располагает целым рядом специальных команд для просмотра системного каталога.
Все имена таблиц системного каталога имеют префикс `pg_`, например `pg_database`. Имена столбцов начинаются с трехбуквенного кода, который обычно соответствует имени таблицы, например `datname`.
Во всех таблицах системного каталога столбец с первичным ключом называется `oid` и имеет одноименный тип `oid` (object identifier) — целое 32-битное число.
> [!NOTE]
> По сути, механизм идентификаторов объектов `oid` — аналог последовательностей, появившийся в PostgreSQL задолго до самих последовательностей. Его особенность в том, что уникальные номера используются в разных таблицах системного каталога, хотя выдаются с помощью единого счетчика. Когда общее число выданных номеров выходит за диапазон значений, счетчик обнуляется. Уникальность значений в конкретной таблице гарантируется тем, что очередное значение `oid` проверяется с помощью уникального индекса и, если оно уже используется в этой таблице, счетчик увеличивается, а проверка повторяется[^internal-ru-26-1].
### Схемы {#internal-ru-subsection-star-15}
*Схемы* [^internal-ru-26-2] представляют собой пространства имен для всех объектов, хранящихся в базе данных. Кроме пользовательских схем, имеется несколько специальных служебных:
**public** используется по умолчанию для пользовательских объектов, если не выполнены иные настройки;
**pg\_catalog** используется для таблиц системного каталога;
**information\_schema** дает альтернативное представление системного каталога, регламентируемое стандартом SQL;
**pg\_toast** используется для объектов, относящихся к TOAST; (*с.* [33](/ru/01-introduction/#internal-ru-page-34))
**pg\_temp** объединяет временные таблицы (хотя временные таблицы разных пользователей создаются в разных схемах `pg_temp_N`, каждый обращается к своим объектам, используя имя `pg_temp`).
Схемы существуют внутри базы данных, и все объекты базы принадлежат каким-либо схемам.
Если при обращении к объекту схема не указана явно, выбирается первая подходящая схема из перечисленных в *пути поиска*. Путь формируется на основе значения параметра *search\_path*, к которому, в частности, неявно добавляются схемы `pg_catalog` и (при необходимости) `pg_temp`. Это позволяет иметь в разных схемах объекты с одинаковыми именами.
### Табличные пространства {#internal-ru-subsection-star-17}
В отличие от логического распределения объектов по базам данных и схемам, *табличные пространства* определяют физическое расположение данных. Фактически табличное пространство — это каталог файловой системы. Например, табличные пространства можно использовать, чтобы разместить архивные данные на медленных носителях, а данные, с которыми идет активная работа, — на быстрых.
Одно и то же табличное пространство может использоваться разными базами данных, а одна база данных может хранить данные в нескольких табличных пространствах. То есть логическая и физическая структуры не зависят друг от друга.
У каждой базы данных есть так называемое *табличное пространство по* *умолчанию*, в котором создаются все объекты, если явно не указать иное. В этом же табличном пространстве хранятся и объекты системного каталога.
При инициализации кластера создаются два табличных пространства:
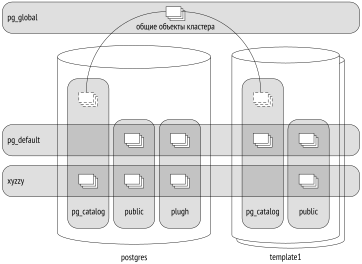
**pg\_default** располагается в каталоге PGDATA/base и используется как табличное пространство по умолчанию, если явно не выбрать для этой цели другое пространство;
**pg\_global** располагается в каталоге PGDATA/global и хранит общие для всего кластера объекты системного каталога.
При создании пользовательского табличного пространства указывается произвольный каталог; PostgreSQL создает на него символьную ссылку в каталоге PGDATA/pg\_tblspc. Вообще, все пути PostgreSQL относительные и отсчитываются от каталога данных PGDATA. Благодаря этому можно переносить PGDATA на другое место (конечно, предварительно остановив сервер).
Рисунок сводит воедино базы данных, схемы и табличные пространства. Здесь база данных `postgres` использует табличное пространство по умолчанию `xyzzy`, а база `template1` — `pg_default`. На пересечении табличных пространств и схем находятся различные объекты базы данных:
{#internal-ru-fig-1-2 num="1.2" caption="Табличные пространства" .book-original-figure width=723 height=529}
### Отношения {#internal-ru-subsection-star-19}
Самые важные объекты базы данных — *таблицы* и *индексы* — при всех своих различиях схожи в том, что состоят из строк. Для таблиц это очевидно, но и в B-деревьях узлы состоят из строк, содержащих индексированные значения и ссылки на другие узлы или на табличные строки. (*с.* [523](/ru/25-b-tree/#internal-ru-page-524))
Есть еще некоторое количество объектов, устроенных похожим образом: *последовательности* (по сути однострочные таблицы), *материализованные* *представления* (по сути таблицы, которые помнят запрос). А еще есть обычные *представления*, которые сами по себе не хранят данные, но во всех остальных смыслах похожи на таблицы.
Все эти объекты в PostgreSQL называются общим словом *отношение* (relation).
> [!NOTE]
> Слово, на мой взгляд, выбрано неудачно, поскольку смешивает таблицы базы данных и (настоящие) отношения реляционной теории. Дает о себе знать университетское происхождение проекта и склонность его основателя, Майкла Стоунбрейкера, во всем видеть отношения. В одной из работ он даже ввел понятие «упорядоченного отношения» (ordered relation) для таблицы, в которой порядок строк задается индексом.
>
> Таблица системного каталога для отношений изначально называлась `pg_relation`, но довольно скоро, на волне увлечения объектной ориентированностью, ее переименовали в привычный нам сейчас `pg_class`. Однако столбцы этой таблицы по-прежнему имеют префикс `rel`.
### Слои и файлы {#internal-ru-subsection-star-21}
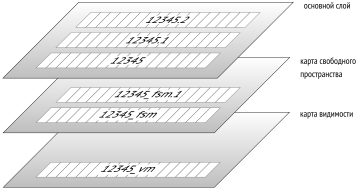
Информация, связанная с отношением, организована в несколько *слоев* [^internal-ru-29-1] (forks) разных типов, каждый из них содержит определенный вид данных.
Изначально слой представлен единственным *файлом*. Имя файла состоит из числового идентификатора (`oid`), к которому может быть добавлен суффикс, соответствующий типу слоя.
Файл постепенно растет, и когда его размер достигает 1 Гбайта, создается следующий файл этого же слоя (такие файлы иногда называют *сегментами*). Порядковый номер сегмента добавляется в конец имени файла.
Ограничение размера файла в 1 Гбайт возникло исторически для поддержки различных файловых систем, некоторые из которых не умеют работать с файлами большого размера. Ограничение можно изменить при сборке PostgreSQL (`./configure --with-segsize`).
Таким образом, одному отношению на диске может соответствовать несколько файлов. Даже для небольшой таблицы без индексов их будет минимум три, по числу обязательных слоев.
Внутри каталога каждого табличного пространства (кроме `pg_global`) создаются подкаталоги для отдельных баз данных. Все файлы объектов, принадлежащих одному табличному пространству и одной базе данных, будут помещены в один подкаталог. Это необходимо учитывать, потому что файловые системы обычно не очень хорошо работают с большим количеством файлов в каталоге.
{#internal-ru-fig-1-3 num="1.3" caption="Слои и файлы" .book-original-figure width=716 height=380}
Имеется несколько стандартных типов слоев.
**Основной слой** (main fork) — это собственно данные: те самые табличные или индексные строки. Основной слой существует для любых отношений (кроме представлений, которые не содержат данных).
Имена файлов основного слоя состоят только из числового идентификатора (равного значению столбца `relfilenode` таблицы `pg_class`).
Посмотрим для примера путь к файлу таблицы, созданной в табличном пространстве `pg_default`:
```text {label="psql"}
=> CREATE UNLOGGED TABLE t(
a integer,
b numeric,
c text,
d json
);
=> INSERT INTO t VALUES (1, 2.0, 'foo', '{}');
=> SELECT pg_relation_filepath('t');
pg_relation_filepath
----------------------
base/16384/16385
(1 row)
```
Каталог base соответствует табличному пространству `pg_default`, следующий подкаталог — базе данных, и уже в нем находится интересующий нас файл:
```text {label="psql"}
=> SELECT oid FROM pg_database WHERE datname = 'internals';
oid
-------
16384
(1 row)
=> SELECT relfilenode FROM pg_class WHERE relname = 't';
relfilenode
-------------
16385
(1 row)
```
Вот соответствующий файл в файловой системе:
```text {label="psql"}
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385');
size
------
8192
(1 row)
```
**Слой инициализации** (init fork) [^internal-ru-31-1] существует только для нежурналируемых таблиц (созданных с указанием `UNLOGGED`) и их индексов. Такие объекты ничем не отличаются от обычных, кроме того, что действия с ними не записываются в журнал предзаписи. За счет этого работа с ними происходит быстрее, но в случае сбоя невозможно восстановить данные в согласованном состоянии. Поэтому при восстановлении PostgreSQL просто удаляет все слои таких объектов и записывает слой инициализации на место основного слоя. В результате получается «пустышка». (*с.* [211](/ru/10-write-ahead-log/#internal-ru-page-212))
Таблица `t` создана нежурналируемой, поэтому у нее есть слой инициализации. Он имеет такое же имя, как и основной слой, но с суффиксом \_init:
```text {label="psql"}
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_init');
size
------
0
(1 row)
```
**Карта свободного пространства** (free space map) [^internal-ru-32-1] — слой, в котором отслеживается примерный объем свободного места внутри страниц. Этот объем постоянно меняется: при добавлении новых версий строк уменьшается, при очистке — увеличивается. Карта свободного пространства используется при вставке новых версий строк, чтобы быстро найти подходящую страницу, на которую поместятся добавляемые данные.
Файлы, относящиеся к карте свободного пространства, имеют суффикс \_fsm. Но появляются они не сразу, а только при необходимости. Самый простой способ добиться этого — выполнить очистку таблицы: (*с.* [133](/ru/06-vacuum-and-freezing/#internal-ru-page-134))
```text {label="psql"}
=> VACUUM t;
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_fsm');
size
-------
24576
(1 row)
```
Для ускорения поиска карта свободного пространства организована как дерево и занимает минимум три страницы (отсюда и размер файла слоя для почти пустой таблицы).
Карта свободного пространства существует не только для таблиц, но и для индексов. Но поскольку индексную строку нельзя добавить на произвольную страницу (например, для B-дерева место вставки определяется порядком сортировки), отслеживаются только те страницы, которые были полностью очищены и могут быть снова задействованы в индексной структуре.
**Карта видимости** (visibility map) [^internal-ru-33-1] — слой, который позволяет быстро определить, требует ли страница очистки или заморозки. Для этого на каждую табличную страницу в этом слое отведено два бита.
Одним битом отмечены страницы, которые содержат только актуальные версии строк. Процесс очистки пропускает такие страницы, поскольку в них нечего очищать. Кроме того, когда транзакция пытается прочитать строку из такой страницы, можно не проверять ее видимость, а это позволяет использовать сканирование только индекса. (*с.* [131](/ru/06-vacuum-and-freezing/#internal-ru-page-132)) (*с.* [422](/ru/20-index-scans/#internal-ru-page-423))
Второй бит отмечает страницы, на которых все версии строк заморожены. Эту часть слоя я буду называть *картой заморозки*. (*с.* [134](/ru/06-vacuum-and-freezing/#internal-ru-page-135))
Файлы карты видимости имеют суффикс \_vm. Обычно они самые небольшие по размеру:
```text {label="psql"}
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_vm');
size
------
8192
(1 row)
```
Карта видимости существует для таблиц, но не для индексов. (*с.* [89](/ru/03-pages-and-tuples/#internal-ru-page-90))
### Страницы {#internal-ru-subsection-star-23}
Для удобства организации ввода-вывода файлы логически поделены на *страницы* (или *блоки*) — это минимальный объем данных, который считывается или записывается. Соответственно, и многие внутренние алгоритмы PostgreSQL ориентированы на работу со страницами. (*с.* [75](/ru/03-pages-and-tuples/#internal-ru-page-76))
Обычно страница имеет размер 8 Кбайт. Его можно поменять в некоторых пределах (до 32 Кбайт), но только при сборке (`./configure --with-blocksize`), и, как правило, никто этим не занимается. Собранный и запущенный экземпляр может работать со страницами только одного размера — создать табличные пространства с разноразмерными страницами нельзя.
Независимо от того, к какому слою принадлежат файлы, они используются сервером примерно одинаково. Страницы сначала помещаются в буферный кеш (где их могут читать и изменять процессы), а затем при необходимости вытесняются обратно на диск. (*с.* [183](/ru/09-buffer-cache/#internal-ru-page-184))
### TOAST {#internal-ru-subsection-star-25}
Каждая строка должна помещаться целиком на одну страницу: нет способа «продолжить» строку на следующей странице. Для длинных строк используется технология, названная TOAST [^internal-ru-34-1] (The Oversized Attributes Storage Technique).
TOAST подразумевает несколько стратегий. Длинные значения атрибутов можно отправить в отдельную служебную таблицу, предварительно нарезав на небольшие фрагменты-«тосты». Другой вариант — сжать длинное значение так, чтобы строка все-таки поместилась на одну страницу. А можно и то и другое: сначала сжать, а уже потом нарезать и отправить.
Если основная таблица содержит потенциально длинные атрибуты, для нее сразу же создается отдельная toast-таблица (одна для всех атрибутов). Например, если в таблице есть столбец типа `numeric` или `text`, toast-таблица будет создана, даже если в таком столбце никогда не будут храниться длинные значения.
Для индексов технология TOAST предлагает только сжатие; вынесение атрибутов в отдельную таблицу не поддерживается. Это накладывает ограничение на размер индексируемых ключей (как это ограничение реализуется, зависит от класса операторов). (*с.* [397](/ru/19-index-access-methods/#internal-ru-page-398))
Обычно стратегии определяются типами столбцов. Посмотреть стратегии проще всего командой `\d+` в psql, но для сокращения вывода я использую запрос к системному каталогу: (psql: `\d+`)
```text {label="psql"}
=> SELECT attname, atttypid::regtype,
CASE attstorage
WHEN 'p' THEN 'plain'
WHEN 'e' THEN 'external'
WHEN 'm' THEN 'main'
WHEN 'x' THEN 'extended'
END AS storage
FROM pg_attribute
WHERE attrelid = 't'::regclass AND attnum > 0;
attname | atttypid | storage
---------+----------+----------
a | integer | plain
b | numeric | main
c | text | extended
d | json | extended
(4 rows)
```
Стратегии состоят в следующем:
**plain** — TOAST не используется (стратегия применяется для заведомо «коротких» типов данных, как integer);
**extended** — допускается как сжатие, так и хранение в отдельной toast-таблице;
**external** — длинные значения хранятся в toast-таблице несжатыми;
**main** — длинные значения в первую очередь сжимаются, а в toast-таблицу попадают, только если сжатие не помогло.
В общих чертах алгоритм выглядит следующим образом[^internal-ru-35-1]. PostgreSQL стремится к тому, чтобы на странице помещалось хотя бы четыре строки. Поэтому, если размер строки превышает четвертую часть страницы за вычетом заголовка (для страницы стандартного размера это около 2000 байт), к части значений необходимо применить TOAST. Действуем в порядке, описанном ниже, и прекращаем, как только длина строки перестает превышать пороговое значение.
1. Сначала перебираем атрибуты со стратегиями external и extended, двигаясь от самых длинных к более коротким. Extended-атрибуты сжимаются, и если после этого значение (само по себе, без учета других атрибутов) превосходит четверть страницы, оно сразу же отправляется в toast-таблицу. External-атрибуты обрабатываются так же, но не сжимаются.
2. Если после первого прохода строка все еще не помещается, по одному отправляем в toast-таблицу оставшиеся атрибуты со стратегиями external и extended.
3. Если и это не помогло, пытаемся сжать атрибуты со стратегией main, оставляя их при этом в табличной странице.
4. Если строка все равно недостаточно коротка, отправляем в toast-таблицу main-атрибуты.
Пороговое значение составляет все те же 2000 байт, но может переопределяться параметром хранения *toast\_tuple\_target* на уровне таблицы.
Иногда может оказаться полезным изменить стратегию для некоторых столбцов. Если заранее известно, что данные в столбце не сжимаются (например, в столбце хранятся JPEG-изображения), можно установить для него стратегию external — это позволит сэкономить на бесполезных попытках сжатия. Изменить стратегию можно как при создании таблицы (предложение `STORAGE` команды `CREATE TABLE`), так и впоследствии: (v. 16)
```text {label="psql"}
=> ALTER TABLE t ALTER COLUMN d SET STORAGE external;
```
Повторив запрос, получим:
```text {hl_lines="6"}
attname | atttypid | storage
---------+----------+----------
a | integer | plain
b | numeric | main
c | text | extended
d | json | external
(4 rows)
```
Для сжатия доступны два алгоритма: традиционный PGLZ и более современный LZ4 (оба являются разновидностями алгоритма словарного сжатия Лемпеля—Зива). По умолчанию сжатие выполняется алгоритмом, указанным в параметре *default\_toast\_compression*; значение можно установить для отдельных столбцов в предложении `COMPRESSION`. Эталонные тесты показывают, что при сходном с PGLZ уровне сжатия LZ4 тратит меньше ресурсов процессора. (v. 15) (*по умолчанию:* `pglz`)
Toast-таблицы располагаются в отдельной схеме `pg_toast`, не входящей в путь поиска, и поэтому обычно не видны. Для временных таблиц используется схема `pg_toast_temp_N` аналогично обычной `pg_temp_N`.
Конечно, при желании всегда можно подглядеть за внутренней механикой процесса. Скажем, в таблице `t` есть три потенциально длинных атрибута, поэтому toast-таблица обязана быть. Вот она:
```text {label="psql"}
=> SELECT relnamespace::regnamespace, relname
FROM pg_class WHERE oid = (
SELECT reltoastrelid FROM pg_class WHERE relname = 't'
);
relnamespace | relname
--------------+----------------
pg_toast | pg_toast_16385
(1 row)
```
```text {label="psql"}
=> \d+ pg_toast.pg_toast_16385
TOAST table "pg_toast.pg_toast_16385"
Column | Type | Storage
------------+---------+---------
chunk_id | oid | plain
chunk_seq | integer | plain
chunk_data | bytea | plain
Owning table: "public.t"
Indexes:
"pg_toast_16385_index" PRIMARY KEY, btree (chunk_id, chunk_seq)
Access method: heap
```
Логично, что для «тостов», на которые нарезается строка, применяется стратегия plain: TOAST второго уровня не существует.
Вместе с toast-таблицей в той же схеме создается и индекс, который *всегда* используется для доступа к фрагментам значений. Имя индекса видно в выводе команды, но его можно найти и запросом:
```text {label="psql"}
=> SELECT indexrelid::regclass FROM pg_index
WHERE indrelid = (
SELECT oid FROM pg_class WHERE relname = 'pg_toast_16385'
);
indexrelid
-------------------------------
pg_toast.pg_toast_16385_index
(1 row)
```
```text {label="psql"}
=> \d pg_toast.pg_toast_16385_index
Unlogged index "pg_toast.pg_toast_16385_index"
Column | Type | Key? | Definition
-----------+---------+------+------------
chunk_id | oid | yes | chunk_id
chunk_seq | integer | yes | chunk_seq
primary key, btree, for table "pg_toast.pg_toast_16385"
```
Таким образом, toast-таблица увеличивает минимальное число файлов, «обслуживающих» таблицу, до восьми: три слоя основной таблицы, три слоя toast-таблицы и два слоя toast-индекса.
Столбец `c` использует стратегию extended, значения в нем будут сжиматься:
```text {label="psql"}
=> UPDATE t SET c = repeat('A',5000);
=> SELECT * FROM pg_toast.pg_toast_16385;
chunk_id | chunk_seq | chunk_data
----------+-----------+------------
(0 rows)
```
В toast-таблице ничего нет: повторяющиеся символы сжались алгоритмом PGLZ, и после этого значение поместилось в обычной табличной странице.
А теперь составим значение из случайных символов:
```text {label="psql"}
=> UPDATE t SET c = (
SELECT string_agg( chr(trunc(65+random()*26)::integer), '')
FROM generate_series(1,5000)
)
RETURNING left(c,10) || '...' || right(c,10);
?column?
-------------------------
TGSXWZTOBN...SJWTGKUXDT
(1 row)
UPDATE 1
```
Такую последовательность сжать не получается. В табличную строку записывается идентификатор `chunk_id`:
```text {label="psql"}
=> SELECT pg_column_toast_chunk_id(c) -- начиная с v.17
FROM t;
pg_column_toast_chunk_id
--------------------------
16390
(1 row)
```
А само значение попадает в toast-таблицу:
```text {label="psql"}
=> SELECT chunk_id,
chunk_seq,
length(chunk_data),
left(encode(chunk_data,'escape')::text, 10) || '...' ||
right(encode(chunk_data,'escape')::text, 10)
FROM pg_toast.pg_toast_16385;
chunk_id | chunk_seq | length | ?column?
----------+-----------+--------+-------------------------
16390 | 0 | 1996 | TGSXWZTOBN...LGRUNTKNNC
16390 | 1 | 1996 | AFBHZKOFQG...KMKVNXBKWL
16390 | 2 | 1008 | VEVQVJGFYA...SJWTGKUXDT
(3 rows)
```
Видно, что данные нарезаны на фрагменты. Размер фрагментов выбирается так, чтобы на странице toast-таблицы помещалось четыре строки. От версии к версии это значение может немного меняться в зависимости от размера заголовка страницы.
При обращении к «длинному» атрибуту PostgreSQL автоматически, прозрачно для приложения, восстанавливает исходное значение и возвращает его клиенту. Если же такие атрибуты не участвуют в запросе, то toast-таблица не читается. Это одна из причин не использовать «звездочку» в производственном коде.
Если клиент запрашивает начальную часть длинного значения, то будут прочитаны только необходимые фрагменты, в том числе и в случае, когда значение хранится в сжатом виде. (v. 13)
Тем не менее и на сжатие с нарезкой, и на последующее восстановление тратится довольно много ресурсов. Поэтому хранить объемные данные в PostgreSQL — не лучшая идея, особенно если они активно используются и при этом для них не требуется транзакционная логика (как пример: отсканированные оригиналы бухгалтерских документов). Потенциально более выгодная альтернатива — хранить такие данные в файловой системе, а в базе данных держать только имена соответствующих файлов. Правда, тогда СУБД не сможет обеспечивать согласованность данных. (v. 17)
> [!NOTE]
> Затраты на распаковку значений, обработанных TOAST, позволяет оценить команда
`EXPLAIN` с параметрами `analyze` и `serialize`.
## 1.2. Процессы и память {#internal-ru-section-1-2}
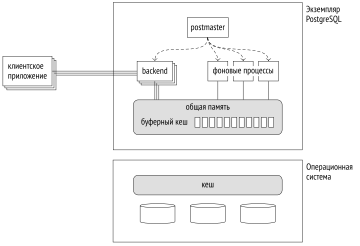
Экземпляр сервера PostgreSQL состоит из нескольких взаимодействующих процессов.
В первую очередь при старте сервера запускается процесс postgres, традиционно называемый postmaster. Postmaster запускает все остальные процессы (в Unix-подобных системах для этого используется системный вызов `fork`) и «присматривает» за ними — если какой-нибудь процесс завершится аварийно, postmaster перезапустит его (или весь сервер, если сочтет, что процесс мог повредить общие данные).
> [!NOTE]
> Процессная модель применяется в PostgreSQL с самого начала проекта из-за своей простоты, и все это время не прекращаются дискуссии о переходе к использованию потоков.
>
> У текущей модели есть ряд недостатков: статически выделяемая общая память не позволяет на лету менять размер таких структур, как буферный кеш; параллельные алгоритмы сложны в реализации и менее эффективны, чем могли бы быть; сеансы жестко привязаны к процессам. Использование потоков выглядит многообещающе, хотя и чревато сложностями с изолированностью, совместимостью c операционными системами, управлением ресурсами. Не говоря уже о том, что переход потребует радикальных изменений в коде и годы работы. Пока побеждает консервативный взгляд, и в ближайшее время никаких изменений не предвидится.
Работу сервера обеспечивает ряд служебных процессов. Основные из них:
**startup** восстанавливает систему после сбоев; (*с.* [223](/ru/10-write-ahead-log/#internal-ru-page-224))
**autovacuum** очищает таблицы и индексы от неактуальных данных; (*с.* [138](/ru/07-autovacuum/#internal-ru-page-139))
**wal writer** записывает на диск журнальные записи; (*с.* [236](/ru/11-wal-modes/#internal-ru-page-237))
**checkpointer** выполняет контрольную точку; (*с.* [219](/ru/10-write-ahead-log/#internal-ru-page-220))
**writer** записывает грязные страницы на диск; (*с.* [226](/ru/10-write-ahead-log/#internal-ru-page-227))
**wal sender** передает журнальные записи на реплику;
**wal receiver** принимает журнальные записи на реплике.
Некоторые из этих процессов завершаются после выполнения своей задачи, другие работают постоянно в фоновом режиме, а какие-то могут быть отключены.
> [!NOTE]
> Каждый процесс управляется конфигурационными параметрами, иногда десятками параметров. Чтобы осмысленно выполнять настройку сервера, нужно хорошо представлять его внутреннее устройство. Но из общих соображений можно выбрать лишь начальные адекватные значения параметров, которые затем потребуется уточнять, получая обратную связь от мониторинга.
Чтобы процессы могли обмениваться информацией, postmaster выделяет *общую память*, которая доступна всем процессам.
Из-за того, что диски (особенно HDD, но и SSD тоже) работают значительно медленнее, чем оперативная память, применяется кеширование: в общей области оперативной памяти отводится место под недавно прочитанные страницы в надежде, что они еще не раз понадобятся и можно будет сэкономить на повторном обращении к диску. Измененные данные также записываются на диск не сразу, а через некоторое время. (*с.* [183](/ru/09-buffer-cache/#internal-ru-page-184))
Буферный кеш занимает бóльшую часть общей памяти. В ней же располагаются и другие буферы, которые используются сервером для ускорения работы с диском.
Свой кеш имеется и у операционной системы. PostgreSQL не использует (почти) прямой ввод-вывод в обход механизмов операционной системы, поэтому кеширование получается двойным.
При сбое (например, при аварийном отключении питания или крахе операционной системы) содержимое оперативной памяти, включая буферный кеш, пропадает. На диске остаются файлы, страницы которых записаны
{#internal-ru-fig-1-4 num="1.4" caption="Процессы и память" .book-original-figure width=720 height=492}
в разные моменты времени. Чтобы иметь возможность восстановить согласованность данных, в процессе работы PostgreSQL ведет *журнал предзаписи* (WAL), позволяющий при необходимости выполнить потерянные операции повторно. (*с.* [211](/ru/10-write-ahead-log/#internal-ru-page-212))
## 1.3. Клиенты и клиент-серверный протокол {#internal-ru-section-1-3}
Еще одна задача процесса postmaster — слушать входящие соединения. При появлении нового клиента postmaster порождает для него *обслуживающий* *процесс* [^internal-ru-42-1] (backend). Клиент устанавливает соединение и начинает *сеанс* общения со своим серверным процессом. Сеанс продолжается до отключения клиента или разрыва связи.
Для каждого клиента на сервере порождается собственный обслуживающий процесс. Большое количество подключений может вызывать проблемы:
- Каждому процессу требуется оперативная память для хранения кеша системного каталога, подготовленных запросов, промежуточных результатов при выполнении запросов и других данных. Чем больше соединений открыто, тем больше должно быть доступной памяти. (*с.* [340](/ru/16-query-execution-stages/#internal-ru-page-341)) (*с.* [338](/ru/16-query-execution-stages/#internal-ru-page-339))
- Если соединения выполняются часто, а сеансы при этом короткие (то есть клиент выполняет один небольшой запрос и отключается), непозволительно много ресурсов будет тратиться на установление соединения, порождение нового процесса и ненужное заполнение локальных кешей.
- Чем больше запущено процессов, тем больше времени требуется на просмотр их списка, а эта операция выполняется очень часто. В результате с увеличением числа клиентов производительность может падать. (*с.* [99](/ru/04-snapshots/#internal-ru-page-100))
В таких случаях используют *пул соединений*, чтобы ограничить число обслуживающих процессов. PostgreSQL не имеет встроенного пула соединений, поэтому приходится применять сторонние решения: менеджеры пулов, встроенные в сервер приложений, или внешние программы (такие как PgBouncer [^internal-ru-43-1] или Odyssey [^internal-ru-43-2]). При этом, как правило, один процесс на сервере поочередно выполняет транзакции разных клиентов. Это накладывает определенные ограничения на разработку приложений, позволяя использовать средства, которые локализованы в пределах транзакции, но не сеанса.
Чтобы клиент и сервер понимали друг друга, они должны использовать один и тот же протокол взаимодействия [^internal-ru-43-3]. Обычно для реализации протокола используют штатную библиотеку libpq, хотя встречаются и независимые реализации.
Говоря в самых общих чертах, протокол позволяет клиенту подключиться к серверу и выполнять SQL-запросы.
Подключение всегда выполняется под определенной ролью (пользователем) и к конкретной базе данных. Несмотря на то что сервер работает с кластером баз данных, для использования в приложении сразу нескольких баз придется выполнить отдельное подключение к каждой из них. При подключении выполняется *аутентификация*: обслуживающий процесс удостоверяется, что пользователь является тем, за кого себя выдает (например, спросив пароль), и проверяет полномочия пользователя на подключение к серверу и к выбранной базе данных.
SQL-запросы передаются обслуживающему процессу в текстовом виде. Процесс разбирает текст, оптимизирует запрос, выполняет его и возвращает результат клиенту.
[^internal-ru-24-1]: [postgrespro.ru/docs/postgresql/18/managing-databases]().
[^internal-ru-24-2]: [postgrespro.ru/docs/postgresql/18/app-initdb]().
[^internal-ru-25-1]: [postgrespro.ru/docs/postgresql/18/catalogs]().
[^internal-ru-26-1]: [backend/catalog/catalog.c](), функция GetNewOidWithIndex.
[^internal-ru-26-2]: [postgrespro.ru/docs/postgresql/18/ddl-schemas]().
[^internal-ru-29-1]: [postgrespro.ru/docs/postgresql/18/storage-file-layout]().
[^internal-ru-31-1]: [postgrespro.ru/docs/postgresql/18/storage-init]().
[^internal-ru-32-1]: [postgrespro.ru/docs/postgresql/18/storage-fsm](); [backend/storage/freespace/README]().
[^internal-ru-33-1]: [postgrespro.ru/docs/postgresql/18/storage-vm]().
[^internal-ru-34-1]: [postgrespro.ru/docs/postgresql/18/storage-toast](); [include/access/heaptoast.h]().
[^internal-ru-35-1]: [backend/access/heap/heaptoast.c]().
[^internal-ru-42-1]: [backend/tcop/postgres.c](), функция PostgresMain.
[^internal-ru-43-1]: [pgbouncer.org]().
[^internal-ru-43-2]: [yandex.ru/dev/odyssey]().
[^internal-ru-43-3]: [postgrespro.ru/docs/postgresql/18/protocol]().