跳转到主要内容

PostgreSQL 14 内参

深入解析运行原理:从隔离性与 MVCC,到缓冲区、预写日志、锁、查询执行与索引。
PostgreSQL 14 Internals 英文原版封面

Egor Rogov 著 · 熊灿灿 译
《PostgreSQL 内参:深入解析运行原理》
简体中文 · PostgreSQL 14

开始阅读 · 整书打印 · 译者原站

本译本与 PG14 英文版 的 29 章逐章对应,可在章节顶部切换语言。PG18 中文版 是基于 2026 年俄文原版的独立新译,部分章节结构和技术细节有所变化。

目录

插图

  1. 图 1.1
  2. 图 1.2
  3. 图 1.3
  4. 图 1.4
  5. 图 2.1
  6. 图 2.2
  7. 图 3.1
  8. 图 4.1
  9. 图 4.2
  10. 图 4.3
  11. 图 4.4
  12. 图 4.5
  13. 图 5.1
  14. 图 5.2
  15. 图 5.3
  16. 图 5.4
  17. 图 5.5
  18. 图 5.6
  19. 图 5.7
  20. 图 6.1
  21. 图 7.1
  22. 图 7.2
  23. 图 7.3
  24. 图 9.1
  25. 图 9.2
  26. 图 9.3
  27. 图 10.1
  28. 图 10.2
  29. 图 10.3
  30. 图 10.4
  31. 图 12.1
  32. 图 12.2
  33. 图 12.3
  34. 图 13.1
  35. 图 13.2
  36. 图 13.3
  37. 图 13.4
  38. 图 13.5
  39. 图 13.6
  40. 图 13.7
  41. 图 15.1
  42. 图 15.2
  43. 图 16.1
  44. 图 16.2
  45. 图 16.3
  46. 图 16.4
  47. 图 16.5
  48. 图 16.6
  49. 图 16.7
  50. 图 16.8
  51. 图 17.1
  52. 图 17.2
  53. 图 17.3
  54. 图 17.4
  55. 图 17.5
  56. 图 18.1
  57. 图 18.2
  58. 图 18.3
  59. 图 18.4
  60. 图 18.5
  61. 图 18.6
  62. 图 18.7
  63. 图 18.8
  64. 图 18.9
  65. 图 19.1
  66. 图 20.1
  67. 图 20.2
  68. 图 20.3
  69. 图 20.4
  70. 图 20.5
  71. 图 20.6
  72. 图 20.7
  73. 图 21.1
  74. 图 21.2
  75. 图 21.3
  76. 图 22.1
  77. 图 22.2
  78. 图 22.3
  79. 图 22.4
  80. 图 22.5
  81. 图 22.6
  82. 图 22.7
  83. 图 22.8
  84. 图 22.9
  85. 图 22.10
  86. 图 22.11
  87. 图 22.12
  88. 图 23.1
  89. 图 23.2
  90. 图 23.3
  91. 图 23.4
  92. 图 23.5
  93. 图 24.1
  94. 图 24.2
  95. 图 24.3
  96. 图 24.4
  97. 图 25.1
  98. 图 25.2
  99. 图 25.3
  100. 图 25.4
  101. 图 25.5
  102. 图 25.6
  103. 图 26.1
  104. 图 26.2
  105. 图 26.3
  106. 图 26.4
  107. 图 26.5
  108. 图 26.6
  109. 图 26.7
  110. 图 26.8
  111. 图 26.9
  112. 图 26.10
  113. 图 26.11
  114. 图 26.12
  115. 图 26.13
  116. 图 26.14
  117. 图 26.15
  118. 图 26.16
  119. 图 26.17
  120. 图 27.1
  121. 图 27.2
  122. 图 27.3
  123. 图 27.4
  124. 图 27.5
  125. 图 27.6
  126. 图 27.7
  127. 图 27.8
  128. 图 27.9
  129. 图 27.10
  130. 图 27.11
  131. 图 27.12
  132. 图 27.13
  133. 图 27.14
  134. 图 27.15
  135. 图 27.16
  136. 图 27.17
  137. 图 27.18
  138. 图 27.19
  139. 图 28.1
  140. 图 28.2
  141. 图 28.3
  142. 图 28.4
  143. 图 28.5
  144. 图 28.6
  145. 图 28.7
  146. 图 28.8
  147. 图 29.1
  148. 图 29.2
  149. 图 29.3
  150. 图 29.4
  151. 图 29.5
  152. 图 29.6

关于这个版本

正文来自熊灿灿发布的中文译本,保留原文、示例、插图、旁注、脚注、推荐序与译者介绍。原著及英文译本由 Postgres Professional 出版,英文译者为 Liudmila Mantrova。

本地阅读版将译文接入 OINK 的目录、搜索、图片放大与整书打印。插图编号用于本站导航;中文原站的部分表格和示例以图片呈现,故图片数与英文版不同。中文原站未提供书末索引译文,可查阅英文索引。上方书影为英文原版封面。

版权与来源 · 译者序与译者介绍 · 推荐序

译者序与译者介绍

内容导航

文章导航 内容简介 推荐序

关于此书

PostgreSQL 的发展势头蒸蒸日上,正在经历一场慢热的崛起。PostgreSQL 是世界上最先进的开源数据库,不仅功能强大丰富,而且一专多长,除了内置的多种高级数据类型之外,还提供了丰富的扩展,融汇百家之所长,使其成为满足多样化数据处理需求的理想选择,市面上关于 PostgreSQL 人才的需求迫在眉睫。

目前市面上已有的相关书籍大多数是关于运维使用方向的,详细介绍内核原理的还是彭老师编著的《PostgreSQL 数据库内核分析》,但是此书是基于 8.4.1 的版本,迄今为止,最新版已经到了 17,两个版本相差十年之久,书中很多内核特性和原理都已发生了较大的变化,不再适用于较新的版本。另外一本是《The Internals of PostgreSQL》,作者是日本的铃木启修,已经由冯若航、刘阳明和张文升翻译成中文,于 2019 年发布,对应的中文版是《PostgreSQL 内幕指南》,该书主要介绍了体系架构、查询处理、MVCC和缓存管理等,阅读需要一定的基础,有一定的门槛。《PostgreSQL 14 Internals》 基于 14 的版本编著,与《PostgreSQL 内幕指南》相比各有千秋,书中不仅有大量的原理解析,还包含了许多实战性很强的内容 ↘️


英文原版 PDF


该书由浅入深地介绍了体系架构、MVCC、锁和查询执行等,是市面上不可多得的优质书籍,不仅是广大的运维管理人员,内核开发人员也可以从中受益良多,相信这本书的问世可以极大地推动 PostgreSQL 在中国的发展。 笔者历经两年有余,将这本书翻译成为了中文,由于笔者能力有限,翻译过程中难免会有错误疏漏之处,敬请谅解。如果你发现有任何错误的地方,请随时联系我进行更正,读者的反馈至关重要,也欢迎大家提出改进建议。读者可以通过邮件方式与我联系:xiongcc_1994@126.com / xiongcc_1994@outlook.com。

关于译者
熊灿灿的 GitHub 头像

熊灿灿 xiongcc · xiongcccc

Working from home

Location

四川省成都市

Focus

PostgreSQL · Greenplum

Homepage

xiongcc.cn

PostgreSQL · Database Internals · AI Infrastructure

大家好,我是熊灿灿,也可以喊我 CC。我是 PostgreSQL / Greenplum 工程师、开源爱好者和技术写作者,长期关注数据库内核、生产实践,以及 AI 时代的数据基础设施。

PostgreSQL ACE / MVP PostgreSQL 学徒 100+ 技术文章 PostgreSQL DBA Daily

最近写了 PostgreSQL 的 2026 与下一个十年 当答案不再稀缺,DBA 真正稀缺的是什么?

GitHub:xiongcccc 微信公众号:PostgreSQL学徒 邮箱:xiongcc_1994@126.com / xiongcc19950101@gmail.com

变更历史

2026/05/14

最新

  • 大幅优化移动端阅读体验,调整部分页面布局

2025/10/13

  • 优化第 4 章版本可见性翻译 — “第二行的最新版本 (0,3) 是不可见的”

2025/03/25

  • 修复第 13 章拼写 BUG

2025/01/06

  • 修复部分拼写错误

2024/12/25

  • 调整部分遗漏参数样式

  • 优化第 24 章和第 26 章部分 LaTeX 语法

2024/12/24

  • 优化“旁注”显示效果 (之前使用背景色)

  • 修复部分语法错误

  • 优化移动端读者阅读体验

遗留问题:Windows 版微信里点开上面的链接,会自动下载英文版原书 PDF。

注意事项

✅ 推荐使用 PC 端 + Chrome / Safari 浏览器进行浏览,阅读体验更佳。

阅读过程中如果有什么问题,可以加群沟通 (群聊二维码不定时更新,如果过期,请狠狠地催译者 👋)
Logo

现在,可以开启你的旅程了!Enjoy it ~~ 😉🥳🥰🤒😃😘😆

内容简介

01-08

基础机制

从数据库结构、事务可见性到空间清理,建立理解 PostgreSQL 内核的基础。

09-15

缓存、日志与锁

深入数据库运行时的核心设施:缓存、WAL、表级锁、行级锁和内存锁。

16-23

查询执行与优化

围绕查询从解析、规划到执行的全过程,理解统计信息、扫描、连接和排序。

24-29

索引结构

系统梳理 PostgreSQL 丰富的索引类型,理解不同数据模型下的搜索能力。

推荐序

As the author, I'm very excited that this book got translated to Chinese, for which I'm very grateful to Mr. Cancan. This translation will surely contribute to growing popularity of PostgreSQL in China. I hope that many readers will get acquainted with this great database system and, perhaps, will learn something new about it. Happy reading!

Egor Rogov Author of 《PostgreSQL 14 Internals》

德哥

PostgreSQL 中国社区发起人之一

在这个快速发展的信息技术时代,PostgreSQL 凭借其卓越的性能和高度的可扩展性,赢得了广大开发者的青睐。PostgreSQL 的设计理念强调扩展灵活性、安全及可靠性,支持除常见关系数据库以外的 JSON、向量、时序、图、时空地理信息、全文检索等多种数据模型和索引方法,能够满足从个人项目到大型企业应用的各种需求。作为 PostgreSQL 社区中的知名博主,熊灿灿通过其活跃的公众号,已经成为许多 PostgreSQL 爱好者心中的良师益友。

多年来,他持续分享高质量的文章,涵盖了从基础入门到高级优化的广泛主题,帮助无数读者解决了实际遇到的技术难题。灿灿不仅精通 PostgreSQL 的各项技术,更重要的是,他善于用平实的语言解析复杂的概念,使学习过程变得轻松愉快。现在,我们有幸见证灿灿翻译的最新力作 —《PostgreSQL 14 Internals》中文译本即将出版。

这本书系统地介绍了 PostgreSQL 14 版本内部架构和技术细节。书中不仅包含了大量的理论知识,还有丰富的实例分析,旨在帮助读者全面掌握 PostgreSQL 的工作原理,并能够灵活应用于实际工作中。无论是刚刚接触 PostgreSQL 的新手,还是资深老用户,这本书都将是一部极具价值的参考资料。

汪洋

2024 年 9 月于深圳

我与本书的译者熊灿灿相识已久,一直以来,他在 PostgreSQL 数据库上的热忱和钻研精神感染和激励着很多人,从他的个人博客,从他积极参与 PostgreSQL 社区的活跃程度,都能够让人深深地体会到他对 PostgreSQL 数据库的热爱。因此,从他告诉我他要翻译本书开始,我就对本书中文版的出版充满了期待。

读过本书英文版的人,应该都深知翻译它很有挑战。一般的数据库管理书籍,不会涉及太多的数据库理论知识和专业术语,翻译的难度相对来讲会小一些。本书既然名为 PostgreSQL Internals,阐述的是 PostgreSQL的内部运作机制,包含了关系性数据库理论的大量知识和专业名词,加上 PostgreSQL 数据库自身就比较偏向于学院派,这些特点就更加突出。那么,翻译它,而且要成功地翻译它就要解决三个问题。一是自身的英文功底要非常扎实;二是需要对关系型数据库理论和 PostgreSQL 有深入透彻的了解,从我个人来看,光有理论知识也不足够,还需要有大量的实践经验,才能够对书中的知识点有更加透彻的理解;而在前两点的基础上,还要考虑如何将本书尽可能翻译得通俗易懂,让广大的 PostgreSQL 数据库爱好者和从业者受益。这不才是翻译本书的本质之所在吗?灿灿也深知这些挑战,凭借着自己的努力,扎实的基础和丰富的实践经验,加上和原作者持续的沟通,终于让我们盼到了此书中文版的面世!

结合自己多年数据库从业的经验,我一直认为,要成为一名优秀的 DBA 数据库管理员,或者用时下更时髦的说法,DBRE 数据库稳定工程师,不能只对每一种数据库浅尝即止,而要深入了解其内部的实现原理和运作机制。只有这样,当解决问题时,或者性能优化时,才能不仅知其然,还知其所以然,也才能有豁然开朗,醍醐灌顶的感觉。就像打通了任督二脉,功力才能够不断地提升。在本书英文版面世之前也有过一本介绍 PostgreSQL 内部机制的材料,一方面基于的数据库版本已经较老 (PostgreSQL 发展迅速,版本迭代更新很快);另一方面只是挑了几个知识点出来,论述不够体系化。而本书则不然,涵盖了 PostgreSQL 的方方面面,系统化地将 PostgreSQL 的内部机制呈现在广大读者面前。从数据组织,到进程和内存管理,到事务隔离和多版本并发控制,到缓冲区和 WAL 管理,再到 PostgreSQL 的锁实现机制,到 SQL 查询的全生命周期,最后到 PostgreSQL 丰富的索引类型及其内部实现,无一不进行了深入的讲解。还配有示例,方便大家对概念有直观的认识,更加便于理解。再加上灿灿的用心翻译,使其成为一本值得珍藏的好书。

从受众来讲,我觉得不仅广大 PostgreSQL 的 DBA 可以从中受益,从事 PostgreSQL 内核研发的众多研发人员也会发现在读完本书后获益良多。一方面原作者供职于 PostgresPro,而 PostgresPro 众所周知是 PostgreSQL 的核心贡献者之一,自然能够让读者更快地熟悉内部实现;另一方面,虽说 PostgreSQL 代码极其工整,便于阅读,可要在短时间内通过阅读代码了解 PostgreSQL 的强大功能和丰富模块的具体实现,还是颇具难度的。而本书可以帮助研发人员更快地了解内部机制的代码实现,更快地上手以及掌握 PostgreSQL。

总之,本书中文译本的面世对于中国广大的 PostgreSQL 爱好者和从业者无疑是一个福音,无论是 DBA 还是内核研发人员,相信都可以通过阅读本书从中获益,能够对 PostgreSQL 这一款优秀的数据库有更加深刻的认识和理解。也希望本书的出版能够在推动中国数据库技术发展的路程上起到一定的作用!

最后,感谢灿灿邀请我为本书中文译本作序,深感荣幸!

冯若航

Pigsty 作者

PostgreSQL 在过去十年的发展可谓日新月异,已经成为世界上最流行,最受开发者喜爱的的数据库。而《PostgreSQL 14 Internals》这本书及时地反映了 PostgreSQL 内核上的前沿进展,无论是对开发者还是 DBA 都极具价值。熊灿灿在 PostgreSQL 上有着长期的积累与深厚的功力,灿灿出品,必属精品,这是一本任何数据库专业人士都不应错过的书籍。

朱贤文

成都文武信息技术有限公司总经理

本书的中文译者熊灿灿同学是一位经验丰富的 PostgreSQL DBA,历时接近 2 年对本书翻译耗费了大量时间和精力,力求对原书内容的准确性和正确性精雕细琢,对很多技术细节进行验证,其目的是确保将原书的精彩呈现给国内的读者朋友,是一本倾注了心血认真翻译的书籍。

原书是一本非常好、非常完整并且有一定深度和广度的 PostgreSQL 著作,它主要为数据库开发人员和 DBA 梳理和详细讲解了 PostgreSQL 的内部机制,对 PostreSQL 的存储管理、多版本并发控制、缓存管理、日志机制和流复制、锁、索引等许多方面,内容非常全面并且有深度,非常适合帮助 DBA 和开发人员对 PostgreSQL 进行深度理解。这是一本非常精彩,翻译更精彩的高质量技术书籍,值得推荐。

白鳝

2024 年 11 月于深圳

在我的数据库从业三十多年时间里,一直认为理解数据库内在原理对于数据库运维与优化至关重要。对于 Oracle 内核的理解在这些年分析一些复杂案例的时候起到关键作用 。作为日益流行的开源数据库,学和使用 PostgreSQL数据库的人越来越多,不过到目前为止,解密 PostgreSQL 技术内核的资料少之又少,是十分令人遗憾的事情。

灿灿这些年一直深耕 PostgreSQL,这回他又给大家带来了一个巨大的惊喜,《PostgreSQL 内参:深入解析运行原理》利用他深厚的实战经验,深入解析了 PostgreSQL 的技术内幕,对于正在学习与运维 PostgreSQL 的人来说,是一本必读的佳作。

梁敬彬

《收获, 不止 Oracle》、《收获,不止 SQL 优化》作者

身处数据时代,PostgreSQL 举足轻重,而《PostgreSQL 14 Internals》更是一本宝藏之书。其围绕的内核部分,乃数据库关键所在,关乎性能优劣、数据安全与系统扩展,从业者欲在技术上精进,深入研习内核原理必不可少。

好友灿灿,作为本书译者,本身就是 PostgreSQL 领域的行家,其专业能力备受认可,凭借扎实专业知识与对技术的严谨态度,开启这场翻译之旅。过程中,灿灿反复斟酌每一处表述,精心打磨译文,力求精准传递书中深厚的专业知识,让更多人跨越语言障碍,深入探索 PostgreSQL 14 的内核世界,从中汲取养分助力自身成长。

这本书不仅重内核知识本身,更注重深入浅出的剖析过程。读者学到的不是结论,而是思维方式。可以说是收获不止PostgreSQL。感谢灿灿能把这样一本好书带给数据库从业者们,为灿灿点赞!

李海龙

PostgreSQL 中文社区常委,2024 年 12 月于北京

《PostgreSQL 14 Internals》是一本市面上少有的深入探究 PostgreSQL 内核机制的优质书籍。本书通过多方面由浅入深的讲解,向读者阐述了诸多 PostgreSQL 内部原理及实践应用。相比于其他中国市面上的 PostgreSQL 内核相关书籍,该书更加具有实践指导意义,对于 PostgreSQL 的开发、运维人员来说都是一本不可多得的佳作!相信在 PostgreSQL 领域有着深厚造诣的灿灿,耗时 2 年呕心沥血翻译的这本杰作,必将为进一步推动 PostgreSQL 在中国的发展起到十分积极的作用。我作为一名从业十余年的 DBA,强烈推荐所有从事 PostgreSQL 相关工作的读者细心品读。

姚延栋

北京四维纵横数据技术有限公司创始人 & CEO,PostgreSQL 中文社区常委

PostgreSQL 爱好者的绝佳福音!对于所有对 PostgreSQL 怀有好奇心的探索者,无论是应用开发者、数据库管理员,还是内核开发者,这本《PostgreSQL 14 Internals》无疑是不可多得的佳作。本书系统且深入地剖析了 PostgreSQL 的内部机理,涵盖了从隔离级别、多版本并发控制到 Buffer 管理、日志处理和锁机制等核心知识;从查询优化树到查询执行,乃至各种索引技术,无一不囊括其中。这些内容不仅可以极大满足读者对 PostgreSQL 内部机制的探索兴趣,还通过丰富的实操案例,教会读者如何使用标准 SQL 和 PostgreSQL 提供的模块,直观地观察和理解数据库的运行状态以及内部机理。这种透视机制如同"X 光"或"彩超"一般,将 PostgreSQL 的"内部秘密"呈现在眼前,可以极大满足技术爱好者的好奇心和求知欲。

更重要的是,这种知识带来的不仅仅是技术上的满足。好奇心驱动下的深入学习,会让你从一个"问题制造者"变成真正的"问题解决者",成为团队中备受信赖的"问答专家",甚至成为客户心目中最可靠的顾问。这对个人的职业发展与成就感的提升,无疑是一大助力。

在当前的国内外技术趋势下,PostgreSQL 凭借其开源特性、四十多年的技术积累,以及强大的社区支持,正在被越来越多的行业专家和开发者所喜爱。尤其在中国,PostgreSQL 的应用正在迅速增长。更值得一提的是,本书的作者和译者均为业界深耕多年的资深专家,他们在实际工作中运维和管理过上千台 PostgreSQL 服务器实例,支撑关键的 OLTP 业务;还运维过大量 YMatrix/Greenplum 集群,处理 PB 级数据规模,助力客户的关键 OLAP 业务。这些丰富的实践经验为本书增添了宝贵的实战指导价值。

关于此书
关于此书:原版书影

本书适合哪些人?

本书适合那些在使用数据库时不愿满足于"暗箱"操作的人。如果你渴望学习,不愿盲从专家的建议,并且喜欢自己弄清楚一切,那么请继续阅读。

我假设读者已经尝试使用过 PostgreSQL,并且对其工作原理有一定的了解。初学者可能会觉得这本书有点难。例如,我不会讲解如何安装服务器、输入 psql 命令或设置配置参数。

我希望这本书对那些熟悉其他数据库系统,但想转而使用 PostgreSQL 并希望了解两者之间差异的人也有所帮助。几年前,如果有这样一本书,我本可以节省很多时间。这也正是我最终写下这本书的原因。

本书不提供的内容

本书并不是一本配方集。在此处,你无法找到适用于所有场合的现成解决方案,但如果你理解了复杂系统的内部机制,你将能够分析和批判性地评价他人的经验,并得出自己的结论。正因如此,我会解释一些细节,这些细节一开始看起来可能并没有实际用途。

但本书也不是一本教程。虽然我会深入探讨一些领域 (这些领域我自己更感兴趣),但可能对其他领域只字不提。

本书绝不是一本参考手册。我尽量做到准确,但并不打算替代官方文档,因此可能会略过一些我认为不重要的细节。在任何不清楚的情况下,请阅读官方文档。

本书不会教你如何开发 PostgreSQL 内核。我并不要求读者具备 C 语言的知识,因为这本书主要面向数据库管理员和应用开发者。但我确实提供了大量源代码的引用,这些引用可以为你提供尽可能多的细节,甚至更多。

本书提供的内容

在介绍章节中,我简要介绍了主要的数据库概念,这些概念将作为所有进一步叙述的基础。我并不期望你从这一章节获取太多新的信息,但我仍然将其包括在内,以便构建完整的概念框架。此外,这一概述对于那些从其他数据库系统迁移过来的人来说可能也会有所帮助。

第一部分讨论了数据一致性和隔离性的问题。我首先从用户的角度来探讨这些问题 (你将了解到有哪些隔离级别以及它们的影响),然后深入探讨其内部机制。为此,我将解释多版本并发控制以及快照隔离的实现细节,尤其是对于过期行版本的清理。

第二部分描述了缓冲区缓存和预写式日志,后者用于在故障后恢复数据的一致性。

第三部分详细介绍了各种锁的结构和使用,包括用于内存的轻量级锁、用于关系的重量级锁以及行级锁。

第四部分解释了服务器如何规划和执行 SQL 查询。我会告诉你有哪些数据访问方法、可以使用哪些连接方法,以及如何应用收集的统计信息。

第五部分在之前已经讨论过的 B 树索引的基础上,进一步探讨了其他访问方法的索引。我将解释一些扩展性的基本原则,这些原则定义了索引系统的核心、索引访问方法和数据类型之间的界限 (这将引出操作符类的概念),然后详细介绍每种可用的方法。

PostgreSQL 包括多个"自省"扩展,这些扩展在日常工作中不常使用,但为我们提供了观察服务器内部行为的机会。本书大量使用了这些扩展。除了让我们能够探索服务器的内部工作原理之外,在复杂的使用场景中,这些扩展还可以协助我们进行故障排查。

约定

我试图以一种可以从头到尾逐页阅读的方式来编写这本书。然而,要一次性揭示所有真相几乎是不可能的,所以我不得不多次回到同一个话题。如果每次都写上"将在后面讨论",这不可避免地会让文本变得冗长。因此,在这种情况下,我只是在页边空白处标注了页码,以便你参考后续的讨论。类似地,指向前面的数字,将带你回到之前已经讨论过该主题的页面。

本书中的文字和所有代码示例都适用于 PostgreSQL 14。在某些段落旁边,你可以看到页边空白处标有一个版本号。这意味着提供的信息从所标注版本开始适用,而所有之前的版本要么没有描述的功能,要么采用了不同的实现。对于尚未将系统升级到最新版本的用户,这样的提示可能会非常有用。

我还使用页边空白处来显示所讨论参数的默认值。普通参数和存储参数的名称均以斜体字显示,例如:work_mem4MB。

在脚注中,我提供了多个信息来源的链接。首先也是最重要的是,我列出了 PostgreSQL 的文档 1,这些文档是知识的源泉。作为项目的重要组成部分,它们始终由 PostgreSQL 开发者自行更新。然而,最重要的参考资料无疑是源代码 2。即使你不了解 C 语言,单纯通过阅读注释和浏览 README 文件,你也可以找到很多答案。有时,我还会引用 commitfest 的条目 3:你总是可以通过阅读 psql-hackers 邮件列表中的相关讨论,追溯所有变更的历史,并理解开发者做出决策的逻辑,但这需要翻阅大量邮件。

书中包含的旁注可能会使讨论偏离主线 (但我还是忍不住把它们加入书中),这些内容以这样的形式印刷,便于跳过。

当然,本书包含了多个代码示例,主要是 SQL 代码。代码示例以提示符 => 开始,必要时会跟随服务器的响应信息:

=> SELECT now();
              now
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 2023−03−06 14:00:08.008545+03
(1 row)

如果你在 PostgreSQL 14 中仔细重复所有提供的命令,你应该能够获得完全相同的结果 (包括事务 ID 和其他不重要的细节)。无论如何,本书中的所有代码示例都是由包含这些命令的脚本生成的。

当需要演示多个事务的并发执行时,在另一个会话中运行的代码会缩进,并用一条竖线标注。

=> SHOW server_version;
 server_version
−−−−−−−−−−−−−−−−
 14.7
(1 row)

要尝试这些命令 (这对自学很有用,就像任何实验一样),可以打开两个 psql 终端。

命令名称和各种数据库对象 (如表与列、函数或扩展) 的名称在文本中使用无衬线字体突出显示:UPDATE,pg_class。

如果从操作系统调用程序,它会以 $ 结尾的提示符显示:

postgres$ whoami
postgres

我使用的是 Linux,但不涉及任何技术细节;只需要对这个操作系统有一些基本了解就足够了。

致谢

写书并非孤军奋战,现在我有一个绝佳的机会来感谢那些帮助过我的好人们。

我非常感谢 Pavel Luzanov,他在正确的时机出现,鼓励我开始做一些真正有意义的事情。

我还要感谢 Postgres Professional 公司,感谢他们让我有机会在工作之外的时间继续这本书的创作。当然,公司背后是具体的人,因此我想特别感谢 Oleg Bartunov,感谢他分享的想法和无尽的精力;还要感谢 Ivan Panchenko,感谢他的全面支持以及对 LATEX 的帮助。

我要感谢教育团队的同事们,感谢他们营造的创意氛围以及对讨论的参与,这些讨论塑造了我们培训课程的范围和形式,并且在本书中也有所体现。特别感谢 Pavel Tolmachev,他对草稿进行了细致的审查。

本书的许多章节最初以文章形式发表在 Habr 博客上 4,我非常感谢读者们的评论和反馈。这些反馈展示了这项工作的重要性,揭示了我知识中的一些空白,并帮助我改进了文本。

我还要感谢 Liudmila Mantrova,她为润色这本书的语言付出了很多努力。如果你未曾在每个句子上都磕磕巴巴,那便是她的功劳。此外,Liudmila 还费心将这本书翻译成英文,我对此也深表感谢。

我没有列出具体的名字,但本书中提到的每一个功能或特性,都凝聚了许多人的多年心血。我敬佩PostgreSQL 的开发者们,并且很高兴能有幸称其中的许多人为我的同事。

1 介绍

1.1 数据组织

1.1.1 数据库

PostgreSQL 是一种属于数据库管理系统类的程序。当此程序运行时,我们称之为 PostgreSQL 服务或实例。

PostgreSQL 管理的数据存储在数据库 1 中。单个 PostgreSQL 实例可以同时服务于多个数据库,它们一起被称为数据库集簇。

使用实例之前,你需要先初始化 2 (创建)。包含所有与集簇相关文件的目录通常被称为 PGDATA,此名称源自指向该目录的环境变量。

通过显式设置程序所需的所有参数,源自预建包的安装可以在 PostgreSQL 机制上添加自己的"抽象层"。在这种情况下,数据库服务以操作系统服务的形式运行,而你可能永远不会直接遇到 PGDATA 变量。但是这个术语本身已经十分成熟,所以我仍打算使用它。

集簇初始化之后,PGDATA 包含三个相同的数据库:

template0 用于从逻辑备份中恢复数据或创建一个含有不同编码的数据库等情况,绝对不可修改此数据库。

template1 作为用户在集簇中创建的所有其他数据库的模板。

postgres 是一个常规的数据库,你可以根据需要使用。
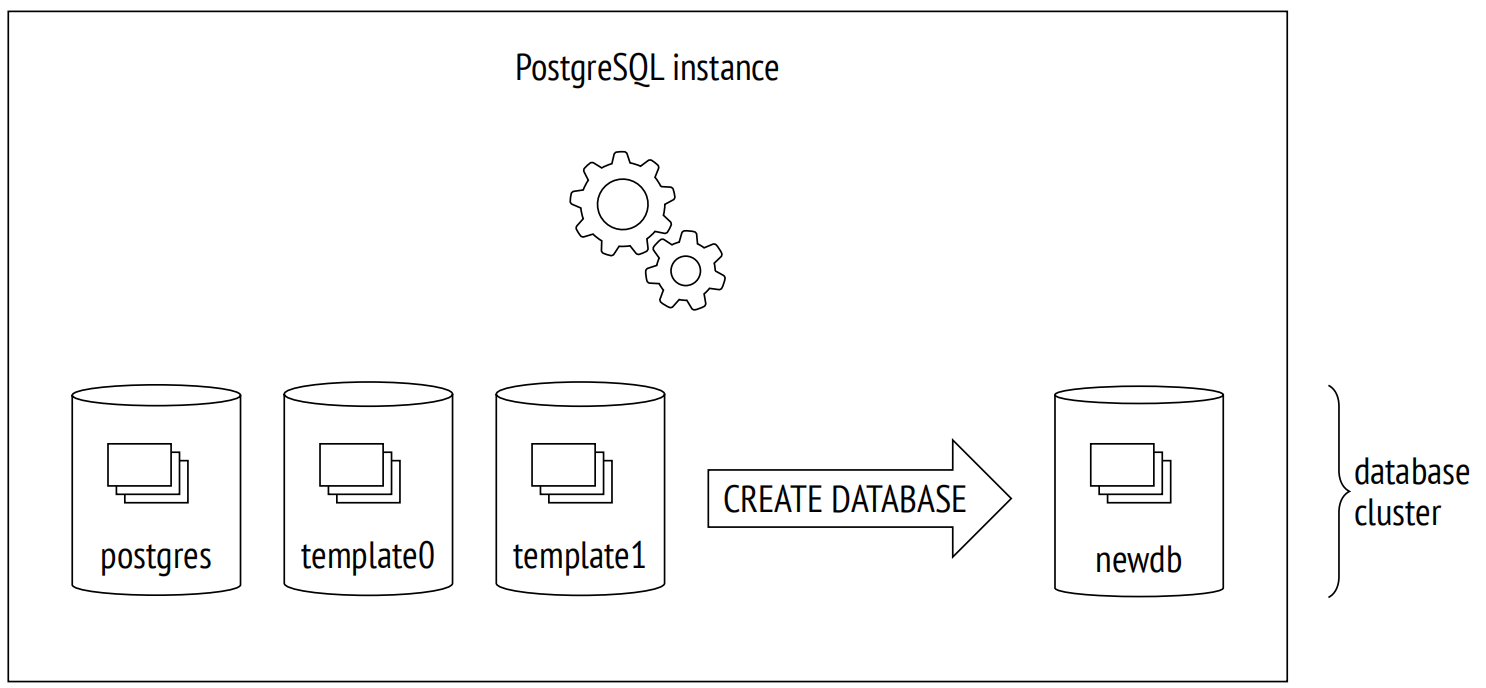
1.1.1 数据库:插图 1
图 1.1

1.1.2 系统目录

所有集簇对象 (例如表、索引、数据类型或函数) 的元数据都存储在属于系统目录 3 的表中。每个数据库都有其自己的一组用于描述该数据库对象的表 (和视图)。有几个系统目录表是整个集簇共有的,它们不属于任何特定的数据库 (从技术上讲,使用的是一个 ID 为零的虚拟数据库),但可以从所有数据库中访问这些表。

系统目录可以使用常规 SQL 查询进行查看,所有对系统目录的修改都是通过 DDL 命令执行的。psql 客户端还提供了一系列命令,用于显示系统目录的内容。

所有系统目录表的名称都以 pg_ 开头,比如 pg_database。列名通常以对应于表名的三个字母前缀开头,比如 datname。

在所有的系统目录表中,声明为主键的列称之为 oid (对象标识符),其类型是一个 32 位整数,也被称为 oid。

在 PostgreSQL 中,oid 对象标识符的实现几乎与序列相同,但它出现得更早。其特殊之处在于,由公共计数器生成的唯一 ID 被用于不同的系统目录表。当分配的 ID 超过最大值时,计数器将重置。为了确保特定表中的所有值都是唯一的,下一个生成的 oid 会通过唯一索引进行检查;如果在这个表中已经使用过,计数器就会增加,然后再次检查。4

1.1.3 模式

模式 5 是存储数据库中所有对象的命名空间。除了用户模式,PostgreSQL 还提供了几个预定义的模式:

public 是用户对象的默认模式,除非指定了其他设置。

pg_catalog 用于系统目录表。

information_schema 为 SQL 标准定义的系统目录提供了一个替代视图。

pg_toast 用于与 TOAST 相关的对象。

pg_temp 由临时表所组成。虽然不同的用户在名为 pg_temp_N 的不同模式中创建临时表,但每个用户都使用 pg_temp 别名来访问他们的对象。

每个模式都限定在特定的数据库中,并且所有数据库对象都属于其中一个模式。

如果在访问对象时没有明确指定模式,PostgreSQL 会从搜索路径中选择第一个合适的模式。搜索路径基于 search_path 参数的值,该参数隐式扩展了 pg_catalog 和 (如有需要) pg_temp。这意味着不同的模式可以包含具有相同名称的对象。

1.1.4 表空间

不同于决定对象逻辑分布的数据库和模式,表空间定义了物理数据布局。表空间实际上是文件系统中的一个目录。你可以在表空间之间分布数据,使得归档数据存储在低速磁盘上,而频繁更新的数据则存储在快速磁盘上。

同一个表空间可以被不同数据库使用,并且每个数据库可以在多个表空间中存储数据。这意味着逻辑结构和物理数据布局并不相互依赖。

每个数据库都有所谓的默认表空间。除非指定了其他位置,否则所有数据库对象都在此表空间中创建。与该数据库相关的系统目录对象也存储在那里。
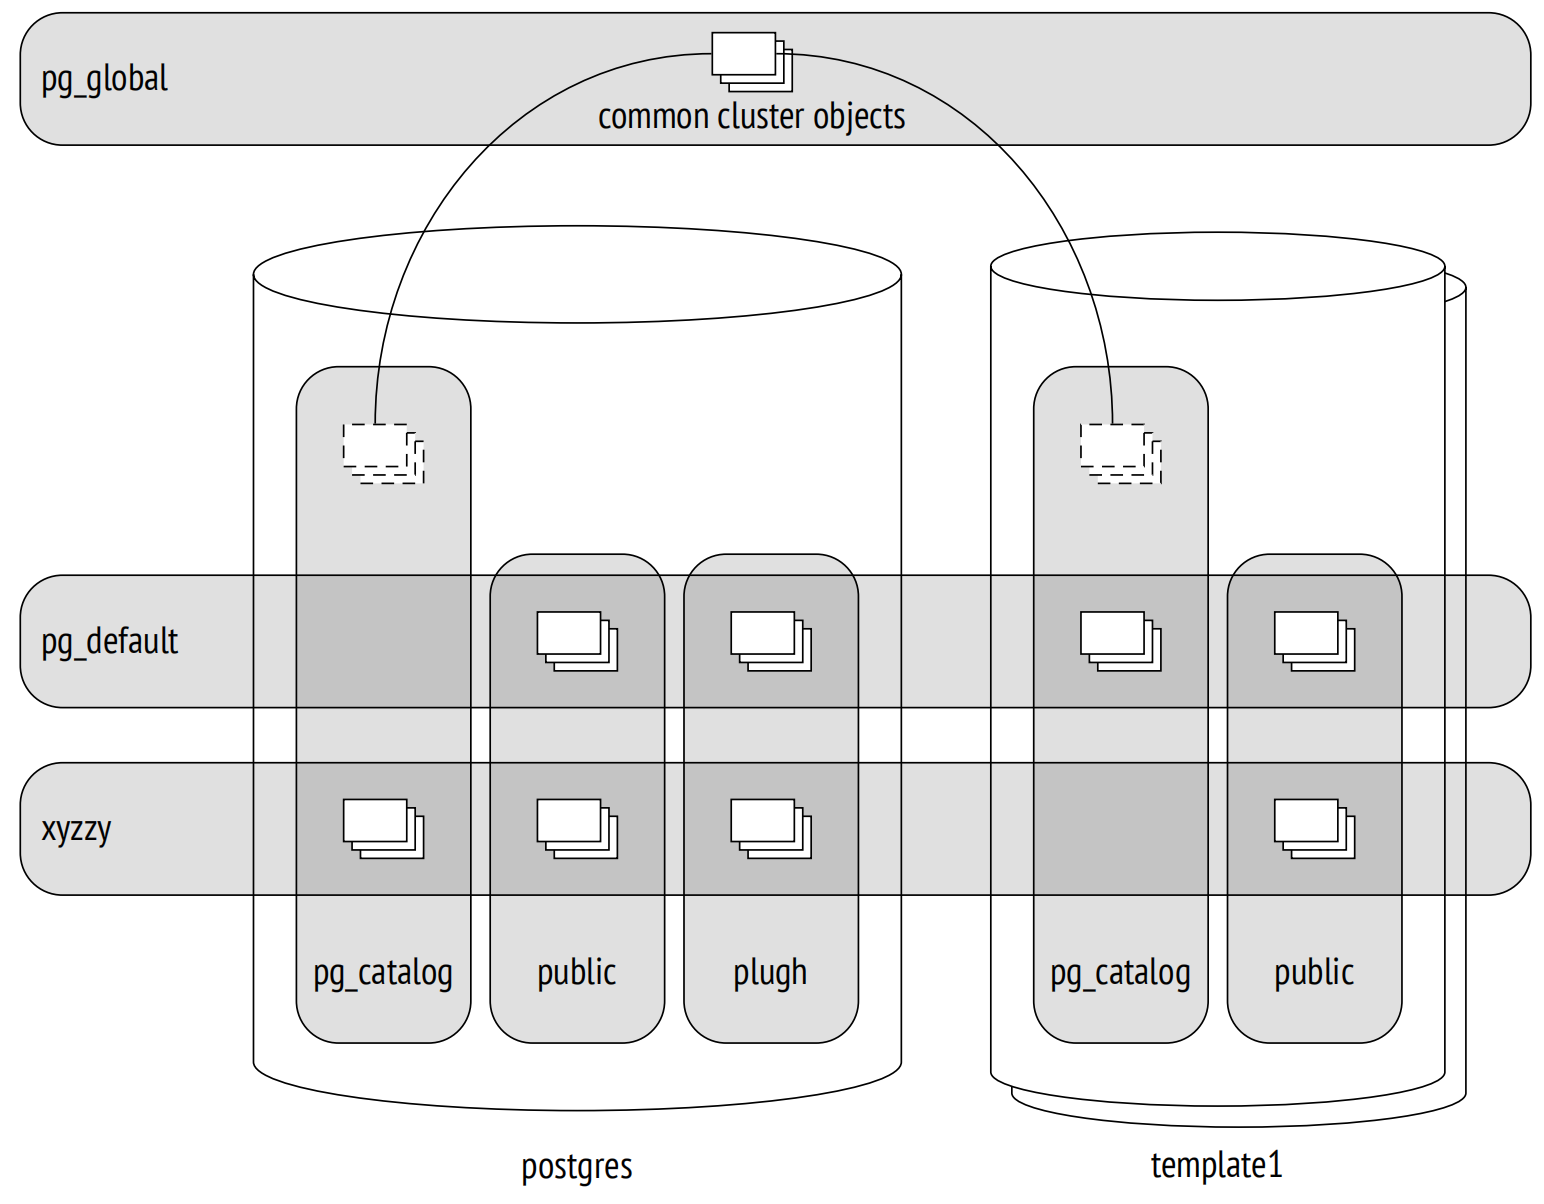
1.1.4 表空间:插图 2
图 1.2

在集簇初始化期间,会创建两个表空间:

pg_default 位于 PGDATA/base 目录中;除非明确选择了另一个表空间,否则它会被用作默认表空间。

pg_global 位于 PGDATA/global 目录中;它存储着整个集簇公共的系统目录对象。

在创建自定义表空间时,你可以指定任意目录;PostgreSQL 会在 PGDATA/pg_tblspc 目录中创建指向该目录位置的符号链接。实际上,PostgreSQL 使用的所有路径都是相对于 PGDATA 目录的,这允许你将其移动到不同的位置 (当然,前提是你已经停止了服务)。

前一页的插图将数据库、模式和表空间放在了一起。此处, postgres 数据库使用表空间 xyzzy 作为默认表空间,而 template1 数据库使用 pg_default。表空间和模式的交叉处展示了各种数据库对象。

1.1.5 关系

尽管表和索引 (最重要的数据库对象) 之间存在着诸多差异,但它们有一个共同点:都由行组成。当我们联想到表时,这一点是不言而喻的,但对于 B 树节点 (包含索引值和对其他节点或表行的引用) 来说,这同样成立。

其他一些对象也具有相同的结构;比如序列 (实际上是单行表) 和物化视图 (可以认为是"保持"相关查询的表)。此外,还有一些常规视图,它们不存储任何数据,但在其他方面与表非常相似。

在 PostgreSQL 中,所有这些对象都被统称为"关系"。

我并不认为这是一个好的术语,因为它将数据库中的表与关系理论中定义的"真正"关系混淆了。在这里,我们可以感受到此项目的学术遗产和其创始人 Michael Stonebraker 将一切均视为关系的倾向。在他的一项工作中,他甚至引入了"有序关系"的概念,来表示行的顺序由索引定义的表。

关系的系统目录表最初被称为 pg_relation,但随着面向对象趋势的发展,它很快被重命名为我们现在熟悉的 pg_class。尽管如此,它的列仍然有 REL 前缀。

1.1.6 文件和分支

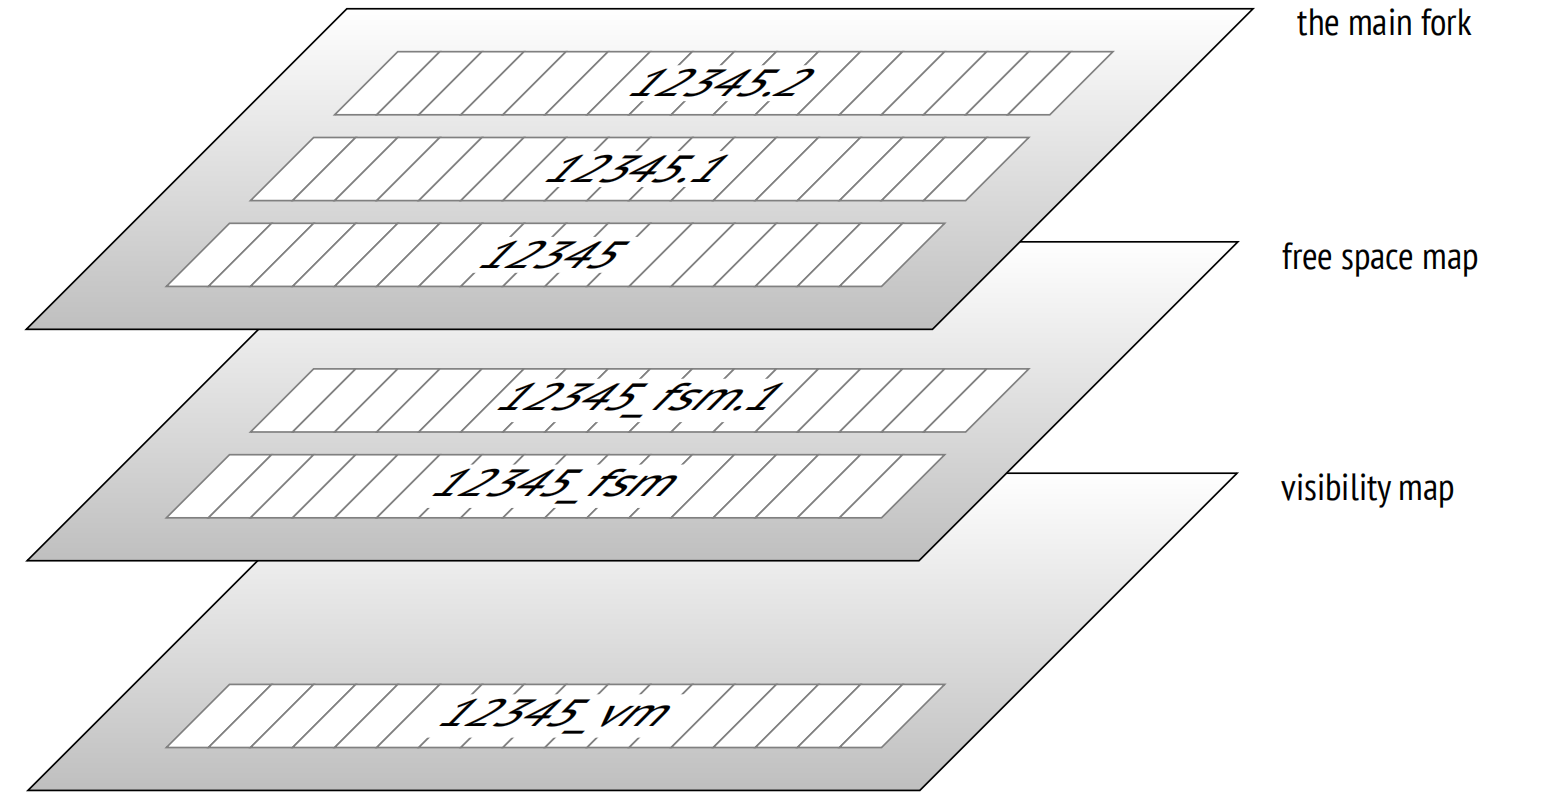
与关系相关的所有信息都存储在几个不同的分支 6 中,每个分支包含特定类型的数据。

起初,分支由一个单一文件表示。其文件名由一个数字 ID (oid) 组成,可以通过与分支类型相对应的后缀来扩展。

随着时间的推移,文件会增长,当其大小达到 1GB 时,就会创建该分支的另一个文件 (这些文件有时被称为段)。段的序列号会被添加到文件名的末尾。

1GB 的文件大小限制历史上是为了支持各种无法处理大文件的文件系统而设定的。在编译 PostgreSQL 时,你可以更改此限制 (./configure –with-segsize)。
1.1.6 文件和分支:插图 3
图 1.3

因此,单个关系在磁盘上由多个文件表示。即使是没有索引的小表,也至少会有三个文件,对应于必需的分支数量。

每个表空间目录 (pg_global 除外) 都包含特定数据库的单独子目录。属于同一表空间和数据库的对象,其所有文件都位于同一子目录中。你必须要考虑到这一点,因为文件系统可能无法很好地处理单个目录中存在太多文件的情况。

有几种标准类型的分支。

主分支代表实际的数据:表行或者索引行。此分支适用于任何关系 (除了视图,视图中没有数据)。

主分支的文件以它们的数字 ID 命名,这些 ID 作为 relfilenode 的值存储在 pg_class 表中。

让我们看一下在 pg_default 表空间中创建的表的所属文件路径:

=> CREATE UNLOGGED TABLE t(
  a integer, 
  b numeric, 
  c text, 
  d json
);  
=> INSERT INTO t VALUES (1, 2.0, 'foo', '{}');
=> SELECT pg_relation_filepath('t');  
 pg_relation_filepath 
−−−−−−−−−−−−−−−−−−−−−− 
 base/16384/16385
(1 row)

base 目录对应于 pg_default 表空间,下一个子目录对应数据库,在这里我们找到了要查找的文件:

=> SELECT oid FROM pg_database WHERE datname = 'internals';
  oid
−−−−−−−
 16384
(1 row)

=> SELECT relfilenode FROM pg_class WHERE relname = 't';
 relfilenode
−−−−−−−−−−−−−
       16385
(1 row)

这是文件系统上对应的文件:

=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385');
 size
−−−−−−
 8192
(1 row)

初始分支 7 仅适用于无日志表 (使用 UNLOGGED 子句创建) 及其索引。此类对象与常规对象相同,不同之处在于对它们执行的任何操作都不会写入预写式日志。这使得这些操作的速度非常的快,但如果发生故障,将无法恢复一致的数据。因此,在恢复期间,PostgreSQL 会简单地删除此类对象的所有分支,并用初始分支覆盖主分支,从而创建了一个伪文件。

t 表以 unlogged 的方式创建,因此存在初始分支。它与主分支的名称相同,但带有 _init 的后缀。

=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_init');
 size
−−−−−−
    0
(1 row)

空闲空间映射 8 用于跟踪页内的可用空间。其容量一直在变化,vacuum 后变大,并在新的行版本出现时变小。空闲空间映射用于快速找到可以容纳被插入的新数据的页面。所有与空闲空间映射相关的文件都带有 _fsm 后缀。最初,不会创建此类文件,它们仅在必要时出现。获取它们最简单的方式是对表进行 vacuum:

=> VACUUM t;
=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_fsm');
 size
−−−−−−−
 24576
(1 row)

为了加快搜索速度,空闲空间映射以一棵树的形式组织,它至少有三个数据页 (因此即使是几乎空的表,其文件大小也会有所体现)。

空闲空间映射既适用于表,也适用于索引。但是,由于索引行不能被添加到任意页面 (例如,B 树根据排序的顺序定义插入位置),PostgreSQL 只跟踪那些已经完全清空并且可以在索引结构中重用的页面。

可见性映射 9 可以快速显示页面是否需要被清理或冻结。 为此,它为每个表页面提供了两个比特位。第一个比特,为仅包含最新行版本的页面设置。vacuum 操作会跳过这样的页面,因为没有东西需要清理。此外,当某个事务尝试从这样的页面读取一行数据时,没有必要检查其可见性,因此便可以使用仅索引扫描。

当页面包含的行版本都已被冻结后v. 9.6,便会设置第二个比特。我将使用"冻结映射"术语来指代这部分分支。

可见性映射文件带有 _vm 后缀。它们通常是最小的文件:

=> SELECT size
FROM pg_stat_file('/usr/local/pgsql/data/base/16384/16385_vm');
 size
−−−−−−
 8192
(1 row)

可见性映射文件适用于表,索引没有此文件。

1.1.7 页面

为了提升 I/O 效率,所有文件在逻辑上都被分割成页 (或者块),表示可以读取或写入的最小数据量。因此,许多内部的 PostgreSQL 算法都针对页面处理进行了优化。

页面大小通常是 8 kB。在某种程度上可以配置页面大小 (最大 32 kB),但只能在编译时进行配置 (./configure –with-blocksize),但通常没有人这样做。一旦编译并启动,实例只能处理大小相同的页面,因此无法创建支持不同页面大小的表空间。

无论属于哪个分支,所有文件都被服务器以大致相同的方式进行处理。页面首先被移动到缓冲区缓存中 (在那里,页面可以被进程读取和更新),然后根据需要刷回磁盘。

1.1.8 TOAST

每一行都必须适合单个页面:无法在下一个页面继续存储一行数据。为了存储较长的行,PostgreSQL 使用了一种称为 TOAST 10 (超长属性存储技术) 的特殊机制。

TOAST 涉及多种策略。你可以将长属性值移动到一个单独的表中,并将它们切成较小的"toasts"块。另一种选项是将长值进行压缩,以适合页面。或者你可以二者都做:先将值压缩,然后切分并移动。

如果主表包含可能很长的属性,那么会立即为其创建一张单独的 TOAST 表,用于其所有的属性。例如,如果某个表有一个 numeric 或 text 的列,即使该列永远不会存储任何长值,也会创建一个 TOAST 表。

对于索引,TOAST 机制只能提供压缩功能,不支持将长属性移动到一张单独的表中。这限制了可以索引的键的大小 (具体实现取决于特定的操作符类)。

默认情况下,根据列的数据类型选择 TOAST 的策略。查看所用策略的最简单方法是在 psql 中运行 \d+ 命令,但我将查询系统目录以获得更清晰的输出:

=> SELECT attname, atttypid::regtype,
  CASE attstorage
    WHEN 'p' THEN 'plain'
    WHEN 'e' THEN 'external'
    WHEN 'm' THEN 'main'
    WHEN 'x' THEN 'extended'
  END AS storage
FROM pg_attribute
WHERE attrelid = 't'::regclass AND attnum > 0;
 attname | atttypid | storage
−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−
 a       | integer  | plain
 b       | numeric  | main
 c       | text     | extended
 d       | json     | extended
(4 rows)

PostgreSQL支持如下策略:

plain 意味着不使用 TOAST (此策略适用于已知是"短"的数据类型,例如整数类型)。

extended 允许压缩属性并将它们存储在单独的 TOAST 表中。

external 意味着长属性以未压缩的状态存储在 TOAST 表中。

main 需要先压缩长属性,只有在压缩没有帮助的情况下时,它们才会被移动到 TOAST 表中。

一般而言,算法如下 11。PostgreSQL 的目标是在每个页面中至少包含四行数据。因此,如果行的大小超过了页面的四分之一,不包括行头大小 (对于标准大小的页面大约为 2000 字节),那么我们必须对一些值应用 TOAST 机制。按照下面所描述的工作流程,一旦行的长度不再超过阈值,我们便停止:

  1. 首先,我们从最长的属性开始,遍历具有 external 和 extended 策略的属性。extended 属性会被压缩,如果压缩后的值 (单独考虑,不考虑其他列) 超过了页面的四分之一,那么它将被立即移动到 TOAST 表中。external 属性的处理方式相同,只是跳过了压缩阶段。

  2. 如果在第一个阶段之后这一行仍然不适合页面,我们将剩余使用 external 或 extended 策略的属性逐个移动到 TOAST 表中。

  3. 如果这也没有帮助,我们会尝试压缩使用 main 策略的属性,将它们保留在表页面中。

  4. 如果这一行仍然不够短,那么 main 属性将被移动到 TOAST 表中。

阈值是 2000 字节,但可以通过使用 toast_tuple_target 存储参数在表级别重新定义。v. 11

有时更改某些列的默认策略可能是有用的。如果事先知道特定列中的数据不能被压缩 (例如,此列存储 JPEG 图像),那么你可以设置该列为 external 策略;这可以避免去徒劳地尝试压缩数据。策略可以按如下所示进行更改:

=> ALTER TABLE t ALTER COLUMN d SET STORAGE external;

如果我们重复查询,我们将得到以下结果:

 attname | atttypid | storage
−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−
 a       | integer  | plain
 b       | numeric  | main
 c       | text     | extended
 d       | json     | external
(4 rows)

TOAST 表位于一个名为 pg_toast 的单独模式中;它不包含在搜索路径中,因此 TOAST 表通常是隐藏的。对于临时表,类似于 pg_temp_N,使用的是 pg_toast_temp_N 模式。

让我们来看看这个过程的内部机制。假设表 t 包含三个可能很长的属性;这意味着必须有一个相应的 TOAST 表。如下:

=> SELECT relnamespace::regnamespace, relname
FROM pg_class
WHERE oid = (
  SELECT reltoastrelid
  FROM pg_class WHERE relname = 't'
);
 relnamespace | relname
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
 pg_toast     | pg_toast_16385
(1 row)

=> \d+ pg_toast.pg_toast_16385
TOAST table "pg_toast.pg_toast_16385"
   Column   |  Type   | Storage
−−−−−−−−−−−−+−−−−−−−−−+−−−−−−−−−
 chunk_id 	| oid     | plain
 chunk_seq 	| integer | plain
 chunk_data | bytea   | plain
Owning table: "public.t"
Indexes:
    "pg_toast_16385_index" PRIMARY KEY, btree (chunk_id, chunk_seq)
Access method: heap

合乎逻辑的是,TOAST 行的结果块使用的是 plain 策略:没有第二级 TOAST。

除了 TOAST 表本身,PostgreSQL 在同一模式中还会创建相应的索引。此索引始终用于访问 TOAST 块。索引的名称显示在输出中,但是也可以通过执行以下查询查看:

=> SELECT indexrelid::regclass FROM pg_index
WHERE indrelid = (
  SELECT oid
  FROM pg_class WHERE relname = 'pg_toast_16385'
);
          indexrelid
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 pg_toast.pg_toast_16385_index
(1 row)
27

=> \d pg_toast.pg_toast_16385_index
Unlogged index "pg_toast.pg_toast_16385_index"
    Column |  Type 	 | Key? | Definition
−−−−−−−−−−−+−−−−−−−−−+−−−−−−+−−−−−−−−−−−−
 chunk_id  | oid     | yes 	| chunk_id
 chunk_seq | integer | yes 	| chunk_seq
primary key, btree, for table "pg_toast.pg_toast_16385"

因此,TOAST 表将表使用的分支文件的最小数量增加至八个:主表三个,TOAST 表三个,TOAST 索引两个。

c 列使用 extended 策略,因此它的值会被压缩:

=> UPDATE t SET c = repeat('A',5000);
=> SELECT * FROM pg_toast.pg_toast_16385;
 chunk_id | chunk_seq | chunk_data
−−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−−−
(0 rows)

TOAST 表是空的:重复的符号已经通过 LZ 算法压缩,因此这个值适合表页面。

现在让我们构造由随机符号组成的值:

=> UPDATE t SET c = (
  SELECT string_agg( chr(trunc(65+random()*26)::integer), '')
  FROM generate_series(1,5000)
)
RETURNING left(c,10) || '...' || right(c,10);
        ?column?
−−−−−−−−−−−−−−−−−−−−−−−−−
 YEYNNDTSZR...JPKYUGMLDX
(1 row)
UPDATE 1

此序列值无法被压缩,所以它被存储到了 TOAST 表中:

=> SELECT chunk_id,
  chunk_seq,
  length(chunk_data),
  left(encode(chunk_data,'escape')::text, 10) || '...' ||
  right(encode(chunk_data,'escape')::text, 10)
FROM pg_toast.pg_toast_16385;
 chunk_id | chunk_seq | length |        ?column?
−−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
    16390 |         0 |   1996 | YEYNNDTSZR...TXLNDZOXMY
    16390 |         1 |   1996 | EWEACUJGZD...GDBWMUWTJY
    16390 |         2 |   1008 | GSGDYSWTKF...JPKYUGMLDX
(3 rows)

我们可以看到字符被切成块。块大小的选择方式是:使得 TOAST 表的页面可以容纳四行。这个值在不同的版本中有所差异,取决于页头的大小。

当访问一个长属性时,PostgreSQL 会自动恢复原始值并返回给客户端,这一切对于应用来说无缝进行。如果长属性不参与查询,那么根本不会读取 TOAST 表。这就是为什么在生产解决方案中应避免使用 * 的原因之一。

如果客户端查询长值的前几个块,即使值已被压缩,PostgreSQL 也只会读取所需的块v. 13。

然而,数据压缩和切片需要大量资源;恢复原始值也是如此。这就是为什么将大量数据存储在 PostgreSQL 中并不是一个好主意,特别是如果这些数据正在被频繁使用,并且不需要事务逻辑 (如扫描的账户文件)。一个可能的更好选择是将这些数据存储在文件系统中,数据库中只保留相应文件的名称。但这样数据库系统就不能保证数据的一致性了。

1.2 进程和内存

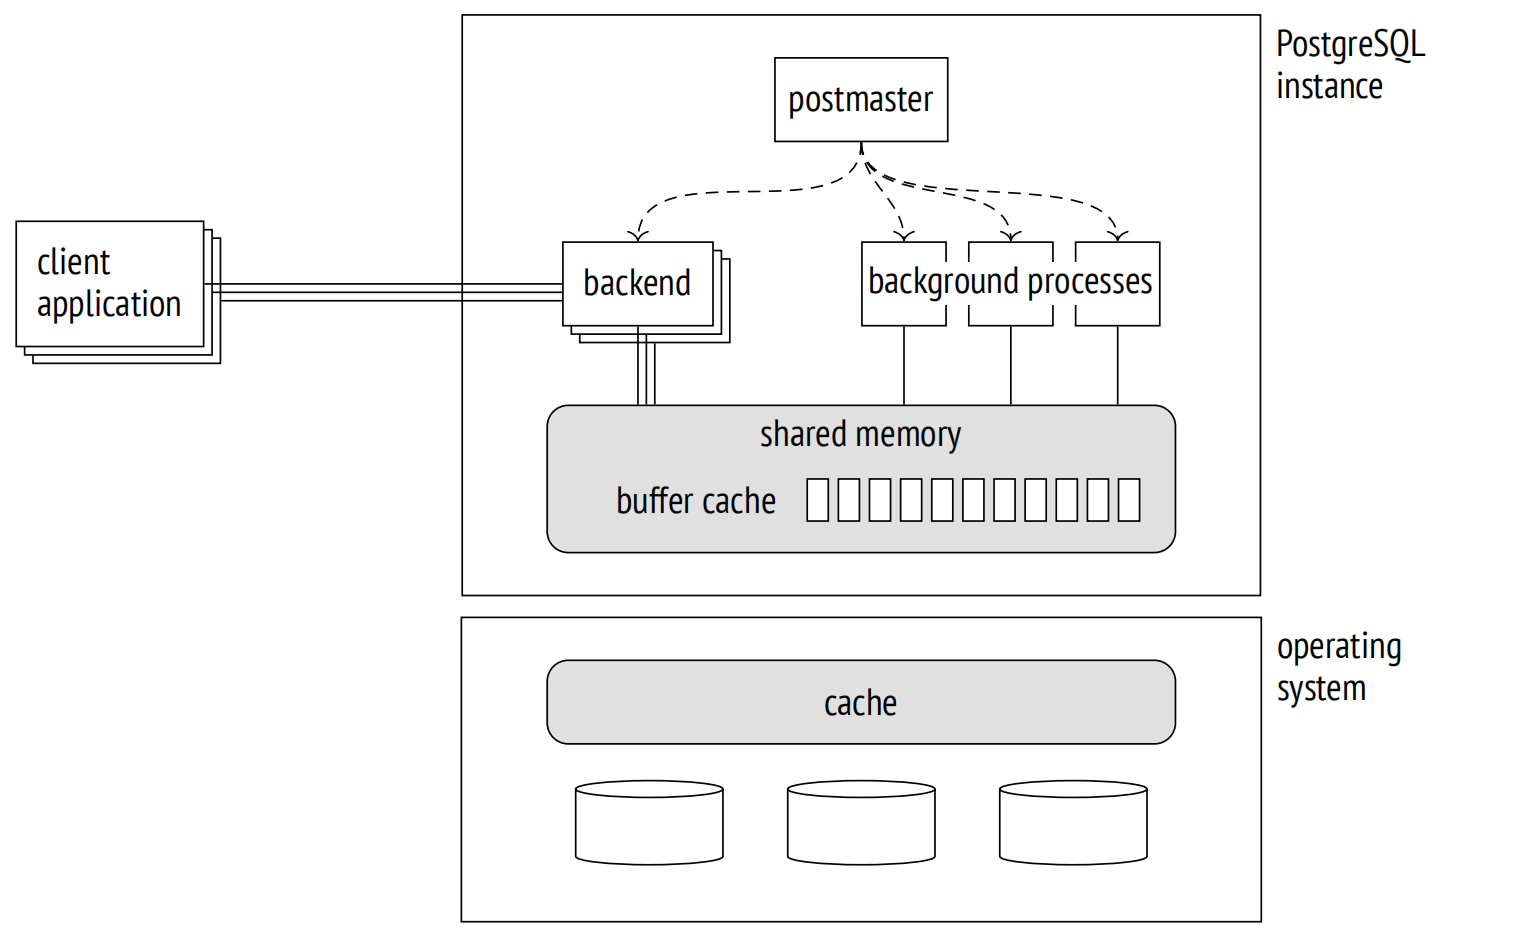
一个 PostgreSQL 服务实例由多个相辅相成的进程组成。

服务启动时,启动的第一个进程是 postgres,传统上称之为 postmaster。它负责创建所有其他进程 (类 Unix 系统使用 fork 系统调用实现) 并管理它们:如果有任何进程失败,postmaster 会重新启动它 (或者如果存在共享数据已损坏的风险,则重启整个服务)。

由于其简单性,进程模型自 PostgreSQL 最初开始就一直在使用,并且自那以后,关于切换到线程的讨论就从未停止过。

当前模型有几个缺点:静态共享内存分配不允许动态调整缓冲区缓存之类的结构;并行算法难以实现,并且效率也不如预期的高;会话与进程紧密绑定。使用线程听起来前景很不错,尽管它涉及到一些与隔离性、操作系统兼容性和资源管理相关的挑战。然而,它们的实现将需要对代码进行彻底的重构和多年的工作,因此目前保守的观点占主导地位:在不久的将来,并不预期会有此类变化。

服务操作由后台进程维护。以下是主要的后台进程:

startup:在故障之后恢复系统。

autovacuum:从表和索引中移除过期数据。

wal writer:将 WAL 写入到磁盘中。

checkpointer:执行检查点。

writer:将脏页刷到磁盘。

stats collector:收集实例的使用统计信息。

wal sender:将 WAL 条目发送给副本。

wal receiver:在副本上接收 WAL 条目。

其中一些进程在任务完成后就会终止,其他一些进程则一直在后台运行,还有一些可以关闭。

每个进程都由配置参数管理,有时需要几十个参数管理。为了全面地配置服务器,你需要了解内部工作原理。但是通用考虑只会帮助你选择或多或少合适的初始值;之后,这些设置需要根据监控数据进行微调。

为了实现进程间的交互,postmaster 会分配共享内存,所有进程都可以访问该内存。

由于磁盘 (尤其是 HDD,但 SSD 也是如此) 的速度比 RAM 慢得多,因此 PostgreSQL 使用了缓存:保留一部分共享内存用于最近读取的页面,寄希望于这些页面会被多次使用,从而减少重复访问磁盘的开销。被修改的数据会在一定的延迟后再刷盘,而不是立即刷新。

缓冲区缓存占据了大部分的共享内存,共享内存中还包含其他由服务器用来加速磁盘访问的缓冲区。

操作系统也有其自己的缓存。PostgreSQL (几乎) 从不绕过操作系统机制而使用 direct I/O,因此这会导致双缓存。
1.2 进程和内存:插图 4
图 1.4

如果发生故障 (例如断电或操作系统崩溃) ,存储在 RAM 中的数据会丢失,包括缓冲区缓存中的数据。保留在磁盘上的文件包括在不同时间点写入的页面。为了能够恢复数据的一致性,PostgreSQL 在其运行期间维护了预写式日志 (WAL),这使得在必要时,可以重复执行丢失的操作。

1.3 客户端和服务端协议

postmaster 进程的另一项任务是监听传入的连接。一旦出现新的客户端,postmaster 便会生成一个单独的后端进程 12,并与该后端进程建立连接,开始会话。会话持续至客户端断开连接或连接丢失。

服务器必须为每个客户端生成一个单独的后端进程。如果许多客户端都在尝试连接,这可能会成为一个问题。

  • 每个进程都需要 RAM 来缓存系统目录表、预备语句、中间查询结果和其他数据。打开的连接越多,需要的内存就越多。

  • 如果连接是短而频繁的 (客户端执行一个小查询并断开连接),那么建立连接、生成新进程和执行无意义的本地缓存的成本过高。

  • 启动的进程越多,扫描它们的列表所需的时间就越多,而且这种操作非常频繁。因此,性能可能会随着客户端数量的增加而下降。

这个问题可以通过连接池来解决,它限制了生成的后端进程的数量。PostgreSQL 本身没有内置的连接池功能,因此我们必须依赖第三方解决方案:集成到应用服务器的连接池管理器或外部工具 (如 PgBouncer 13 或 Odyssey 14) 。这种方式通常意味着每个服务器后端进程可以依次执行不同客户端的事务。这对应用程序开发施加了一些限制,因为它只允许使用事务本地的资源,而不是整个会话的资源。

为了进行交互,客户端和服务器必须使用相同的接口协议 15。这通常基于标准的 libpq 库,但也有其他自定义的实现。

通俗地说,这种协议允许客户端连接到服务器并执行 SQL 查询。

连接总是代表一个特定的角色或用户建立到一个特定的数据库。尽管服务器支持数据库集簇,但你需要在应用中对每个数据库分别建立连接。此时会进行身份验证:后端进程验证用户的身份 (例如,通过请求密码) 并检查该用户是否有权限连接到服务器和指定的数据库。

SQL 查询作为文本字符串传递给后端进程,然后该进程解析文本、优化查询与执行,并将结果返回给客户端。

第一部分:隔离性与 MVCC

第一部分:隔离性与 MVCC。

本分部页按原书结构编排,用于中英目录对照。

2 隔离性

2.1 一致性

关系型数据库的关键特征是它们能够保证数据的一致性,即数据的正确性。

众所周知,在数据库层面可以创建完整性约束,例如 NOT NULL 或 UNIQUE。数据库系统确保这些约束永远不会被破坏,从而保证数据的完整性。

如果所有需要的约束都能在数据库层面上制定,那么一致性就能得到保证。但有些条件过于复杂,无法通过数据库层面的约束来实现,例如,它们可能一次涉及多个表。而且即使某个约束可以在数据库中定义,但由于某些原因没有被定义,也并不意味着这个约束条件可以被违反。

因此,数据的一致性比完整性更严格,但是数据库系统并不清楚"一致性"实际上意味着什么。如果应用程序在不破坏完整性的情况下破坏了一致性,那么数据库系统是没有办法发现的。因此,必须由应用程序来制定数据一致性的标准,而且我们必须相信它编写得正确,且永远不会有任何错误。

但是,如果应用程序始终只执行正确的操作符序列,那么数据库系统的作用何在呢?

首先,正确的操作符序列可以暂时破坏数据一致性,并且 — 虽然这听起来可能很奇怪 — 这是完全正常的。

一个老套但浅显易懂的例子是将资金从一个账户转移到另一个账户。一致性规则可能是这样的:资金转移绝不能改变受影响账户的总余额。将此规则表述为 SQL 中的完整性约束是相当困难的 (尽管可能),因此让我们假设它是在应用程序层面定义的,并且对数据库系统保持不透明。转账包括两个操作:第一个操作从其中一个账户中提取一些钱,而第二个操作将这笔钱添加到另一个账户。第一个操作破坏了数据的一致性,但第二个操作恢复了一致性。

如果第一个操作成功了,但第二个操作失败了 (因为一些故障),数据一致性将被打破。这种情况是无法接受的,但是在应用程序层面检测和解决它们需要付出很大的努力。幸运的是,这并不是必要的 — 如果数据库系统知道这两个操作构成一个不可分割的整体,即一个事务,那么这个问题完全可以由数据库系统本身解决。

但这里还有一个更微妙的方面。事务本身是绝对正确的,但当并行运行时,事务可能会开始不正确地运行。这是因为属于不同事务的操作经常会被混合在一起。如果数据库系统先完成一个事务的所有操作,然后再进行下一个事务,就不会出现此类问题,但顺序执行的性能会低得令人难以置信。

真正的事务同时执行只能在具有适当硬件的系统上实现:多核处理器、磁盘阵列等。但同样的推断也适用于以分时模式顺序执行命令的服务器。为了概括起见,这两种情况有时统称为并发执行。

正确的事务在一起运行时表现异常会导致并发异常,或称为并发现象。

此处是一个简单的例子。为了从数据库中获取一致的数据,应用程序至少不能看到其他未提交事务所做的任何更改。否则 (如果某些事务回滚),它将看到从未存在过的数据库状态。这种异常称为脏读,还有很多其他更为复杂的异常。

当并发运行事务时,数据库必须保证这种执行的结果与某种可能的顺序执行结果相同。换句话说,它必须将事务彼此隔离,从而处理任何可能的异常。

总而言之,事务是一组将数据库从一个正确状态转变到另一个正确状态 (一致性) 的操作,前提是它完全执行 (原子性) 并且不受其他事务的影响 (隔离性)。这个定义结合了 ACID 首字母缩写中前三个字母所暗示的要求。它们交织在一起,一起讨论它们是有意义的。事实上,持久性要求也几乎不可能分开:在系统崩溃之后,系统中可能仍然包含一些由未提交事务所做的更改,你必须采取措施来恢复数据的一致性。

因此,即使数据库系统对隐含的一致性规则一无所知,它也通过考虑事务边界来帮助应用程序维护数据一致性。

不幸的是,完全隔离很难实现,并且会对性能产生负面影响。大多数实际系统使用较弱的隔离级别,这可以防止一些异常,但并非全部。这意味着维护数据一致性的部分工作落在了应用程序上。这也正是为什么了解系统中使用的隔离级别非常重要的原因,以及在这个级别下保证了什么、没有保证什么,以及如何确保在这种条件下代码是正确的。

2.2 SQL 标准中的隔离级别与异常

SQL 标准定义了四种隔离级别 1。这些级别由并发事务执行期间可能发生或不发生的异常所定义。因此,在谈论隔离级别时,我们需要从异常开始讲起。

需要记住的是,标准是一种理论概念:它影响了实践,但实践在许多方面与之不同。这就是为什么此处所有的例子都是假设性的。虽然这些例子处理的是银行账户上的事务,它们非常直观,但我必须承认,它们与实际的银行操作无关。

有趣的是,实际的数据库理论也与标准有所偏离:它是在标准被采纳之后发展起来的,而实践已经领先很多。

2.2.1 更新丢失

当两个事务读取同一行表数据,然后其中一个事务更新该行,最后另一个事务在不考虑第一个事务所做的任何更改的情况下更新同一行时,就会发生更新丢失异常。

假设有两个事务打算使同一账户的余额增加 100 美元。第一个事务读取了当前值 ($1000),然后第二个事务读取了相同的值。第一个事务增加了余额 (使余额变为 1100 美元),并将新值写入数据库中。第二个事务也是如此:在增加余额后获得 1100 美元,并写入该值。结果,客户损失了 100 美元。

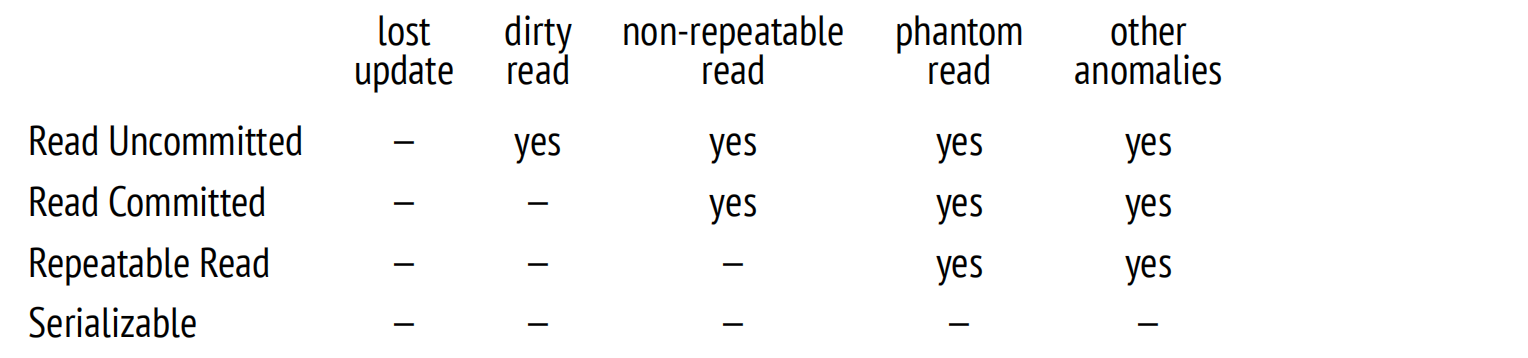
在所有隔离级别下,SQL 标准都禁止更新丢失。

2.2.2 脏读与读未提交

当一个事务读取了另一个事务所做的未提交的更改时,就会发生脏读异常。

例如,第一个事务将 100 美元转移到一个空账户,但没有提交此更改。另一个事务读取了帐户的状态 (已被更新但还未提交),并允许客户提取这笔钱 — 即使第一个事务中断并且其更改被回滚,所以帐户其实是空的。

SQL 标准允许在读未提交隔离级别下发生脏读。

2.2.3 不可重复读与读已提交

当一个事务两次读取同一行数据,而在这两次读取之间,另一个事务更新 (或删除) 了这一行并提交了更改时,就会发生不可重复读异常。最终,第一个事务得到了不同的结果。

例如,假设有一条一致性规则,禁止银行账户中出现负余额。第一个事务准备使账户余额减少 100 美元。它检查当前值,得到 1000 美元,因此认定此操作是可行的。同时,另一个事务从该账户中取出了所有钱并提交更改。如果第一个事务在此时再次检查余额,它会得到 0 美元 (但取钱的决定已经做出,那么这个操作会导致透支)。

SQL 标准允许在读未提交和读已提交隔离级别下发生不可重复读。

2.2.4 幻读与可重复读

当同一个事务执行两次相同的查询,返回一组满足特定条件的行,而在这两次查询期间,另一个事务添加了一些满足此条件的其他行,并提交了此更改,就会出现幻读异常。最终,第一个事务获得了两组不同的行。

例如,假设有一个一致性规则,禁止客户拥有三个以上的帐户。第一个事务打算开一个新帐户,因此它检查当前有多少个帐户可用 (假设有两个),并认定此操作是可行的。此时,第二个事务也为该客户开了一个新帐户并提交了更改。如果第一个事务再次检查打开的账户数量,它会得到三个 (但它已经在开另一个账户,客户最终拥有了四个账户)。

SQL 标准允许在读未提交、读已提交和可重复读隔离级别下发生幻读。

2.2.5 无异常与可串行化

SQL 标准还定义了可串行化隔离级别,该级别不允许任何异常。这与禁止更新丢失、脏读、不可重复读和幻读不同。事实上,已知异常的数量远远超过标准定义的数量,还有未知数量的未知异常。

可串行化隔离级别必须防止任何异常。这意味着应用程序开发人员不必考虑隔离问题。如果事务在单独运行时执行正确的操作符序列,那么并发执行也不能破坏数据的一致性。

为了阐述这个概念,我将使用标准中提供的一个众所周知的表格;为清晰起见,此处还添加了最后一列:
2.2.5 无异常与可串行化:插图 1
图 2.1

2.2.6 为什么是这些异常?

为什么标准只提到了某些可能的异常,而且为什么是这些异常呢?

似乎没有人确切知道。但很有可能是在制定最初版本的标准时,其他异常没有被考虑进去,因为那时理论远远落后于实践。

此外,当时的假设是隔离必须基于锁。广泛使用的两阶段锁定协议 (2PL) 要求事务在执行期间锁定受影响的行,并在完成时释放锁。简单来说,事务获取的锁越多,它与其他事务的隔离程度就越好。相应地,系统的性能就越差,因为事务开始排队访问同一行,而不是并发运行。

我相信,在很大程度上,标准隔离级别之间的区别是由实现它们所需的锁数量来定义的。

如果要更新的行对写入锁定但对读取不锁定,我们便会得到读未提交隔离级别,允许在提交前读取数据。

如果要更新的行对读取和写入都锁定,我们便会得到读已提交隔离级别:禁止读取未提交的数据,但如果查询多次运行,可能返回不同的值 (不可重复读)。

在所有操作中锁定要读取和更新的行,我们便会得到可重复读隔离级别:重复查询将返回相同的结果。

然而,可串行化隔离级别带来了一个问题:无法锁定尚不存在的行。这为幻读的发生留下了可能性:一个事务可以添加满足先前查询条件的行,并且这一行将出现在下一个查询结果中。

因此,常规的锁无法提供完全隔离:要实现这一点,我们必须锁定条件 (谓词) 而不是行。谓词锁早在 1976 年 System R 开发时就被引入了;然而,它们的实际适用范围有限,只适用于那些很容易判断两个不同谓词是否可能冲突的简单条件。据我所知,在任何系统中从未实现过预期形式的谓词锁。

2.3 PostgreSQL 中的隔离级别

随着时间的推移,基于锁的事务管理协议被快照隔离 (SI) 协议所取代。这种方法的思想是,每个事务访问的是在特定时间点呈现的数据一致性快照。这个快照包括在快照生成之前提交的所有当前更改。

快照隔离最大限度地减少了所需的锁数量。实际上,只有在尝试并发更新时,行才会被锁定。在所有其他情况下,操作均可以并发执行:写操作不会锁定读操作,读操作也永远不会锁定任何东西。

PostgreSQL 使用了 SI 协议的多版本形式。多版本并发控制意味着,在任何时候数据库系统都可以包含同一行的多个版本,因此 PostgreSQL 可以将适当的版本包含在快照中,而不是中止尝试读取老版本数据的事务。

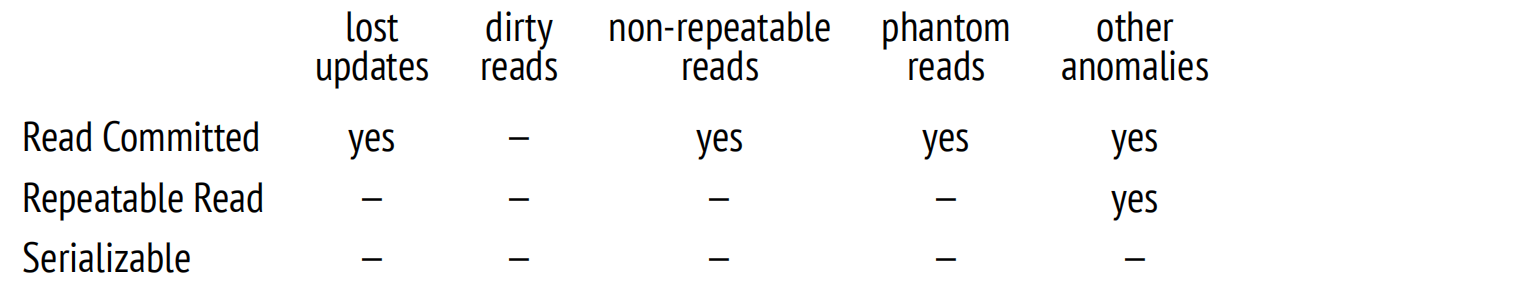
基于快照,PostgreSQL 的隔离级别与标准中指定的要求有所不同 — 实际上,它甚至更加严格。脏读从设计上是禁止的。技术上,你可以指定读未提交级别,但其行为与读已提交相同,因此我将不再提及这个级别。可重复读既不允许不可重复读,也不允许幻读 (尽管它不保证完全隔离)。但在某些情况下,读已提交隔离级别存在更新丢失的风险。
2.3 PostgreSQL 中的隔离级别:插图 2
图 2.2

在探讨隔离的内部机制之前,让我们从用户的角度分别讨论这三个隔离级别。

为此,我们将创建一个账户表;Alice 和 Bob 分别拥有 1000 美元,但 Bob 拥有两个账户:

=> CREATE TABLE accounts(
  id integer PRIMARY KEY GENERATED BY DEFAULT AS IDENTITY,
  client text,
  amount numeric
);
=> INSERT INTO accounts VALUES
  (1, 'alice', 1000.00), (2, 'bob', 100.00), (3, 'bob', 900.00);

2.3.1 读已提交

不会脏读。很容易验证无法读取脏数据。让我们开启一个事务。默认情况下,它使用读已提交 2 隔离级别:

=> BEGIN;
=> SHOW transaction_isolation;
 transaction_isolation
−−−−−−−−−−−−−−−−−−−−−−−
 read committed
(1 row)

更确切地说,默认级别由以下参数设置,可以按需修改:

=> SHOW default_transaction_isolation;
 default_transaction_isolation
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 read committed
(1 row)

已开启的事务从客户账户中提取一些资金,但尚未提交这些更改。它会看到自己的更改,因为这总是被允许的:

=> UPDATE accounts SET amount = amount - 200 WHERE id = 1;
=> SELECT * FROM accounts WHERE client = 'alice';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  1 | alice  | 800.00
(1 row)

在第二个会话中,我们启动另一个事务,此事务也在读已提交级别下运行:

=> BEGIN;
=> SELECT * FROM accounts WHERE client = 'alice';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−−
  1 | alice  | 1000.00
(1 row)

可以预见的是,第二个事务看不到任何未提交的更改 — 因为脏读是被禁止的。

不可重复读。现在提交第一个事务的更改。然后第二个事务执行相同的查询:

=> COMMIT;
=> SELECT * FROM accounts WHERE client = 'alice';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  1 | alice  | 800.00
(1 row)
=> COMMIT;

查询接收到的是更新后的数据版本 — 这正是在读已提交级别下允许的不可重复读异常。

一个实用的见解是:在事务中,你不能基于之前操作符读取的数据做出任何决策,因为中间的一切都可能发生变化。这里有一个例子,其变体经常出现在应用程序代码中,可以被认为是一个经典的反模式:

IF (SELECT amount FROM accounts WHERE id = 1) >= 1000 THEN
  UPDATE accounts SET amount = amount - 1000 WHERE id = 1;
END IF;

在检查和更新期间,其他事务可以随意改变账户的状态,因此这样的"检查"是毫无作用的。为了更好地理解,你可以想象其他事务的随机操作符被"楔入"到当前事务的操作符之间。例如,像这样:

IF (SELECT amount FROM accounts WHERE id = 1) >= 1000 THEN

|   UPDATE accounts SET amount = amount - 200 WHERE id = 1;
|   COMMIT;

  UPDATE accounts SET amount = amount - 1000 WHERE id = 1;
END IF;

如果一旦重新排列操作符就出现了问题,代码便是不正确的。不要自欺欺人地认为永远不会遇到这种麻烦:任何可能出错的事情都会出错。这类错误很难复现,因此,修复它们是一项真正的挑战。

你该如何修正此代码?有几个选项:

  • 使用声明式代码替换过程式代码。

    例如,在这个特定案例中,很容易将 IF 语句转换为 CHECK 约束:

    ALTER TABLE accounts ADD CHECK amount >= 0;

    现在你不需要在代码中进行任何检查:只需简单地运行命令,并处理在尝试违反完整性约束时引发的异常就足够了。

  • 使用单个 SQL 操作符。

    如果一个事务在另一个事务的操作符之间的时间间隙内提交,那么数据一致性可能会受到影响,从而改变数据的可见性。如果只有一个操作符,则不存在这样的间隙。

    PostgreSQL 有足够的能力用单个 SQL 语句解决复杂的任务。特别是,它提供了可以包含诸如 INSERT、UPDATE、DELETE 此类操作符的通用表达式 (CTE),以及实现以下逻辑的 INSERT ON CONFLICT 操作符:如果行不存在,则插入;否则执行更新。

  • 使用显式锁定。

    最后的手段是手动对所有需要的行 (SELECT FOR UPDATE) 甚至整个表 (LOCK TABLE) 设置排它锁。这种方法总是有效的,但它使 MVCC 的所有优势都失效了:一些本可以并发执行的操作将顺序执行。

读偏序。然而,事情并非总是那么简单。PostgreSQL 的实现方式允许一些其他鲜为人知的异常,这些异常并不受标准约束。

假设第一个事务已经开始在 Bob 的账户之间转移资金:

=> BEGIN;
=> UPDATE accounts SET amount = amount - 100 WHERE id = 2;

与此同时,另一个事务开始遍历 Bob 所有的账户以计算它们的总余额。它从第一个帐户开始 (当然,查看的是它之前的状态):

=> BEGIN;
=> SELECT amount FROM accounts WHERE id = 2;
 amount
−−−−−−−−
 100.00
(1 row)

此时,第一个事务成功完成:

=> UPDATE accounts SET amount = amount + 100 WHERE id = 3;
=> COMMIT;

第二个事务读取第二个账户的状态 (并且看到已经更新的值):

=> SELECT amount FROM accounts WHERE id = 3;
  amount
−−−−−−−−−
 1000.00
(1 row)
=> COMMIT;

结果,第二个事务得到了 1100 美元,因为它读取了不正确的数据。这种异常称为读偏序。

在读已提交级别该如何避免这种异常?答案很明显:使用单个操作符。例如,像这样:

SELECT sum(amount) FROM accounts WHERE client = 'bob';

到目前为止,我一直在强调数据的可见性只能在操作符之间发生变化,但事实真的如此吗?如果查询运行了很长时间呢?在这种情况下,它能否看到处于不同状态的数据的不同部分?

让我们试试。一种便捷的方式是通过调用 pg_sleep 函数为操作符添加延迟。然后立即读取第一行,但第二行将不得不等待两秒钟:

=> SELECT amount, pg_sleep(2) -- two seconds
FROM accounts WHERE client = 'bob';

在执行这条语句时,让我们开启另一个事务将钱转回去:

=> BEGIN;
=> UPDATE accounts SET amount = amount + 100 WHERE id = 2;
=> UPDATE accounts SET amount = amount - 100 WHERE id = 3;
=> COMMIT;

结果表明,操作符看到的所有数据都处于其执行开始时的状态,这当然是正确的:

 amount  | pg_sleep
−−−−−−−−−+−−−−−−−−−−
    0.00 |
 1000.00 |
(2 rows)

但情况也并非那么简单。如果查询中包含一个声明为 VOLATILE 的函数,而这个函数执行了另一个查询,那么这个嵌套查询看到的数据将与主查询的结果不一致。

让我们使用以下函数检查 Bob 帐户中的余额:

=> CREATE FUNCTION get_amount(id integer) RETURNS numeric
AS $$
SELECT amount FROM accounts a WHERE a.id = get_amount.id;
  $$ VOLATILE LANGUAGE sql;
=> SELECT get_amount(id), pg_sleep(2)
FROM accounts WHERE client = 'bob';

我们将在延迟查询执行时,再次在账户之间转移资金:

=> BEGIN;
=> UPDATE accounts SET amount = amount + 100 WHERE id = 2;
=> UPDATE accounts SET amount = amount - 100 WHERE id = 3;
=> COMMIT;

在这种情况下,我们将获得不一致的数据 — 100 美元丢失了:

 get_amount | pg_sleep
−−−−−−−−−−−−+−−−−−−−−−−
     100.00 |
     800.00 |
(2 rows)

我想强调的是,这种情况仅在读已提交隔离级别并且仅当函数被声明为 VOLATILE 时。可问题在于, PostgreSQL 默认使用这种隔离级别和这种稳定性类别。因此,我们不得不承认,这个陷阱设置得非常狡猾。

读偏序而不是更新丢失。读偏序异常也可能在更新过程中的单个操作符内发生 — 即使是以某种出乎意料的方式。

让我们看看如果两个事务试图修改同一行时会发生什么。目前 Bob 的两个账户中总共有 1000 美元:

=> SELECT * FROM accounts WHERE client = 'bob';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  2 | bob 	 | 200.00
  3 | bob 	 | 800.00
(2 rows)

开启一个事务,减少 Bob 的余额:

=> BEGIN;
=> UPDATE accounts SET amount = amount - 100 WHERE id = 3;

同时,另一笔事务将计算总余额为 1000 美元或者更多的所有客户账户的利息:

=> UPDATE accounts SET amount = amount * 1.01
WHERE client IN (
  SELECT client
  FROM accounts
  GROUP BY client
  HAVING sum(amount) >= 1000
);

UPDATE 操作符的执行实际上包含两个阶段。首先,根据提供的条件选择要更新的行。由于第一个事务尚未提交,第二个事务无法看到其结果,因此选择用于计算利息的行不受影响。所以,Bob 的账户满足条件,一旦 UPDATE 操作完成,他的余额必须增加 10 美元。

在第二阶段,逐个更新所选行。第二个事务必须等待,因为 id = 3 的行被锁定:它正在被第一个事务更新。

与此同时,第一个事务提交了它的更改:

=> COMMIT;
=> SELECT * FROM accounts WHERE client = 'bob';
 id | client |  amount
−−−−+−−−−−−−−+−−−−−−−−−−
  2 | bob 	 | 202.0000
  3 | bob 	 | 707.0000
(2 rows)

一方面,UPDATE 命令不能看到第一个事务所做的任何更改。但另一方面,它不能丢失任何已提交的更改。

一旦锁被释放,UPDATE 操作符重新读取要更新的行 (但仅限这一行!)。结果,基于总额 900 美元,Bob 获得了 9 美元的利息。但如果他有 900 美元,他的账户本就不应该包含在查询结果中。

因此,我们的事务返回了不正确的数据:从不同的快照中读取了不同的行。我们再次观察到读偏序异常,而不是更新丢失。

更新丢失。但是,如果数据被不同的 SQL 操作符修改,那么重新读取锁定行的技巧将无法防止更新丢失。

此处是一个我们已经见过的例子。应用程序读取并记录 (在数据库外) Alice 账户的当前余额:

=> BEGIN;
=> SELECT amount FROM accounts WHERE id = 1;
 amount
−−−−−−−−
 800.00
(1 row)

同时,另一个事务也做同样的事情:

=> BEGIN;
=> SELECT amount FROM accounts WHERE id = 1;
 amount
−−−−−−−−
 800.00
(1 row)

第一个事务将先前记录的值增加了 100 美元,并提交了这个更改:

=> UPDATE accounts SET amount = 800.00 + 100 WHERE id = 1
RETURNING amount;
 amount
−−−−−−−−
 900.00
(1 row)
UPDATE 1
=> COMMIT;

第二个事务也做同样的事情:

=> UPDATE accounts SET amount = 800.00 + 100 WHERE id = 1
RETURNING amount;
 amount
−−−−−−−−
 900.00
(1 row)
UPDATE 1

不幸的是,Alice 丢失了 100 美元。数据库系统不知道记录的 800 美元值与 accounts.amount 有某种关联,因此无法防止更新丢失异常。在读已提交隔离级别下,这段代码是不正确的。

2.3.2 可重复读

不会出现不可重复读和幻读。顾名思义,可重复读隔离 3 级别必须保证可重复读取。让我们确认一下,确保幻读也不会发生。为此,我们开启一个事务,将 Bob 的账户恢复到之前的状态,并为 Charlie 创建一个新账户:

=> BEGIN;
=> UPDATE accounts SET amount = 200.00 WHERE id = 2;
=> UPDATE accounts SET amount = 800.00 WHERE id = 3;
=> INSERT INTO accounts VALUES
	(4, 'charlie', 100.00);
	
=> SELECT * FROM accounts ORDER BY id;
 id | client  | amount
−−−−+−−−−−−−−−+−−−−−−−−
  1 | alice   | 900.00
  2 | bob     | 200.00
  3 | bob     | 800.00
  4 | charlie | 100.00
(4 rows)

在第二个会话中,让我们开启另一个事务,在 BEGIN 命令中明确指定可重复读级别 (第一个事务的隔离级别并不重要):

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT * FROM accounts ORDER BY id;
   id | client |  amount
−−−−−−+−−−−−−−−+−−−−−−−−−−
    1 | alice  |   900.00
    2 | bob    | 202.0000
    3 | bob    | 707.0000
(3 rows)

现在,第一个事务提交其更改,第二个事务重复相同的查询:

=> COMMIT;
=> SELECT * FROM accounts ORDER BY id;
  id | client |  amount
−−−−−+−−−−−−−−+−−−−−−−−−−
   1 | alice  |   900.00
   2 | bob 	  | 202.0000
   3 | bob 	  | 707.0000
(3 rows)
=> COMMIT;

第二个事务仍然看到和之前相同的数据:新行与更新的行都不可见。在这个隔离级别下,你不必担心在操作符之间会发生某些变化。

序列化失败而不是更新丢失。正如我们已经看到的,如果两个事务在读已提交级别下更新同一个行,它可能会导致读偏序异常:等待的事务必须重新读取锁定的行,因此它看到这一行的状态与其他行相比处于不同的时间点。

在可重复读隔离级别下,不允许出现这种异常,如果确实发生了,事务只能因序列化失败而中止。我们可以通过重复带利息计算的场景来确认这一点:

=> SELECT * FROM accounts WHERE client = 'bob';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  2 | bob 	 | 200.00
  3 | bob 	 | 800.00
(2 rows)
=> BEGIN;
=> UPDATE accounts SET amount = amount - 100.00 WHERE id = 3;
=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> UPDATE accounts SET amount = amount * 1.01
WHERE client IN (
  SELECT client
  FROM accounts
  GROUP BY client
  HAVING sum(amount) >= 1000
);
=> COMMIT;
ERROR: could not serialize access due to concurrent update
=> ROLLBACK;

数据保持一致:

=> SELECT * FROM accounts WHERE client = 'bob';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  2 | bob 	 | 200.00
  3 | bob 	 | 700.00
(2 rows)

任何并发行更新,即使它们影响的是不同的列,也会引发同样的错误。

如果我们尝试基于之前存储的值更新余额,我们也会遇到这个错误:

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT amount FROM accounts WHERE id = 1;
 amount
−−−−−−−−
 900.00
(1 row)
=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT amount FROM accounts WHERE id = 1;
 amount
−−−−−−−−
 900.00
(1 row)
=> UPDATE accounts SET amount = 900.00 + 100.00 WHERE id = 1
RETURNING amount;
 amount
−−−−−−−−−
 1000.00
(1 row)
UPDATE 1
=> COMMIT;
=> UPDATE accounts SET amount = 900.00 + 100.00 WHERE id = 1
RETURNING amount;
ERROR: could not serialize access due to concurrent update
=> ROLLBACK;

一个实用的见解是:如果你的应用程序对写事务使用可重复读隔离级别,那么必须准备好重试那些由于序列化失败而结束的事务。对于只读事务,这种结果是不会发生的。

写偏序。正如我们所见,PostgreSQL 对可重复读隔离级别的实现可以防止标准中描述的所有异常。但并非所有可能的异常都可以防止:没有人知道存在多少异常。然而,有一点是确凿无疑的:无论还有多少其他类型的异常,快照隔离仅无法防止两种异常。

第一个异常是写偏序。

让我们定义以下一致性规则:只要总余额不是负数,就允许某些客户的账户余额为负数。

第一个事务获取 Bob 账户的总余额:

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT sum(amount) FROM accounts WHERE client = 'bob';
	sum
−−−−−−−−
 900.00
(1 row)

第二个事务获得了相同的余额:

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT sum(amount) FROM accounts WHERE client = 'bob';
  sum
−−−−−−−−
 900.00
(1 row)

第一个事务合理地假设它可以从其中一个账户中扣除 600 美元:

=> UPDATE accounts SET amount = amount - 600.00 WHERE id = 2;

第二个事务也得出相同的结论,但是从另外一个账户中扣除了资金:

=> UPDATE accounts SET amount = amount - 600.00 WHERE id = 3;
=> COMMIT;
=> COMMIT;
=> SELECT * FROM accounts WHERE client = 'bob';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−−
  2 | bob 	 | −400.00
  3 | bob 	 |  100.00
(2 rows)

Bob 的总余额现在是负数,尽管如果两个事务分开运行,都是正确的。

只读事务异常。只读事务异常是可重复读隔离级别所允许的第二个异常,也是最后一个异常。要观察此异常,我们需要运行三个事务:其中两个事务将更新数据,而第三个事务是只读的。

首先让我们先恢复 Bob 的余额:

=> UPDATE accounts SET amount = 900.00 WHERE id = 2;
=> SELECT * FROM accounts WHERE client = 'bob';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  3 | bob 	 | 100.00
  2 | bob 	 | 900.00
(2 rows)

第一个事务计算 Bob 总余额应累积的利息,并将此金额添加到他的一个账户中:

=> BEGIN ISOLATION LEVEL REPEATABLE READ; -- 1
=> UPDATE accounts SET amount = amount + (
  SELECT sum(amount) FROM accounts WHERE client = 'bob'
) * 0.01
WHERE id = 2;

然后第二个事务从 Bob 的其他账户中取出一些钱并提交此更改:

=> BEGIN ISOLATION LEVEL REPEATABLE READ; -- 2
=> UPDATE accounts SET amount = amount - 100.00 WHERE id = 3;
=> COMMIT;

如果第一个事务在此时提交,就不会出现异常:我们可以假设第一个事务在第二事务之前提交 (但反之则不行 — 在第二个事务进行任何更新之前,第一个事务已经看到了 id = 3 的账户的状态)。

但是让我们想象一下,在这一刻,我们开启一个只读事务,查询不受前两个事务影响的账户:

=> BEGIN ISOLATION LEVEL REPEATABLE READ; -- 3
=> SELECT * FROM accounts WHERE client = 'alice';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−−
  1 | alice  | 1000.00
(1 row)

直到现在才提交第一个事务:

=> COMMIT;

此时第三个事务应该看到哪个状态?开启后,它可以看到第二个事务 (已经提交) 所做的更改,但看不到第一个 (尚未提交) 事务所做的更改。但是正如我们已经确定的那样,第二个事务应该被视为在第一个事务之后开启的。第三个事务看到的任何状态都将是不一致的 — 这正是只读事务异常的含义:

=> SELECT * FROM accounts WHERE client = 'bob';
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  2 | bob 	 | 900.00
  3 | bob 	 |   0.00
(2 rows)
=> COMMIT;

2.3.3 可序列化

可序列化 4 隔离级别可防止所有可能的异常。这个隔离级别实际上建立在快照隔离之上。在可重复读隔离级别不会出现的异常 (例如脏读、不可重复读或幻读) 在可序列化级别也不会出现。并且确实发生的那两个异常 (写偏序和只读事务异常) 会以特殊方式进行检测并中止事务,从而导致我们所熟知的序列化失败。

没有异常。让我们确保写偏序场景最终会以序列化失败结束:

=> BEGIN ISOLATION LEVEL SERIALIZABLE;
=> SELECT sum(amount) FROM accounts WHERE client = 'bob';
   sum
−−−−−−−−−−
 910.0000
(1 row)
=> BEGIN ISOLATION LEVEL SERIALIZABLE;
=> SELECT sum(amount) FROM accounts WHERE client = 'bob';
   sum
−−−−−−−−−−
 910.0000
(1 row)
=> UPDATE accounts SET amount = amount - 600.00 WHERE id = 2;
=> UPDATE accounts SET amount = amount - 600.00 WHERE id = 3;
=> COMMIT;
COMMIT
=> COMMIT;
ERROR: could not serialize access due to read/write dependencies
among transactions
DETAIL: Reason code: Canceled on identification as a pivot, during
commit attempt.
HINT: The transaction might succeed if retried.

只读事务异常的场景也将导致同样的错误。

延迟只读事务。为了避免只读事务可能导致损害数据一致性的异常情况,PostgreSQL 提供了一个有趣的解决方案:可以推迟此事务,直到其执行变得安全。这是 SELECT 语句唯一可能被更新阻塞的情况。

我们将通过重复演示只读事务异常的场景来确认这一点:

=> UPDATE accounts SET amount = 900.00 WHERE id = 2;
=> UPDATE accounts SET amount = 100.00 WHERE id = 3;
=> SELECT * FROM accounts WHERE client = 'bob' ORDER BY id;
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  2 | bob 	 | 900.00
  3 | bob 	 | 100.00
(2 rows)
=> BEGIN ISOLATION LEVEL SERIALIZABLE; -- 1
=> UPDATE accounts SET amount = amount + (
  SELECT sum(amount) FROM accounts WHERE client = 'bob'
) * 0.01
WHERE id = 2;
=> BEGIN ISOLATION LEVEL SERIALIZABLE; -- 2
=> UPDATE accounts SET amount = amount - 100.00 WHERE id = 3;
=> COMMIT;

让我们明确声明第三个事务为 READ ONLY 和 DEFERRABLE:

=> BEGIN ISOLATION LEVEL SERIALIZABLE READ ONLY DEFERRABLE; -- 3
=> SELECT * FROM accounts WHERE client = 'alice';

尝试运行查询会阻塞事务 — 否则,它将导致异常。

只有当第一个事务提交后,第三个事务才能继续执行:

=> COMMIT;
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−−
  1 | alice  | 1000.00
(1 row)
=> SELECT * FROM accounts WHERE client = 'bob';
 id | client |  amount
−−−−+−−−−−−−−+−−−−−−−−−−
  2 | bob 	 | 910.0000
  3 | bob 	 |     0.00
(2 rows)
=> COMMIT;

因此,如果应用程序使用可序列化隔离级别,那么必须准备好重试那些由于序列化失败而结束的事务。(可重复读级别也需要相同的方式,除非应用程序仅限于只读事务。)

可序列化隔离级别为编程带来了便利性,但是付出的代价是异常检测带来的开销以及部分事务被强制终止。你可以通过在声明只读事务时显式使用 READ ONLY 子句来降低这种影响。但主要问题当然是被中止事务的比例有多大 — 因为这些事务将不得不重试。如果 PostgreSQL 只中止那些导致数据冲突并且确实不兼容的事务,那情况就不会那么糟糕了。但这种方法不可避免地会消耗太多资源,因为会涉及到对每一行的跟踪操作。

当前的实现允许误判:PostgreSQL 可以中止一些绝对安全的事务,这些事务仅仅是运气不佳。他们的"运气"取决于许多因素,例如是否存在适当的索引或可用的 RAM 量,因此很难提前预测实际行为。

如果你使用了可序列化隔离级别,所有应用程序的事务都需要遵守。当与其它级别结合使用时,可序列化的行为与可重复读一样,并且没有任何通知。因此,如果你决定使用可序列化级别,相应地修改 default_transaction_isolationread committed 参数值是有意义的 — 尽管仍然可以通过显式设置不同的级别以覆盖它。

还有其他限制v. 12;例如,在可序列化级别运行的查询不能在备库上执行。尽管这个级别的功能在不断改进,但当前的限制和开销使其变得不那么吸引人。

2.4 该使用哪种隔离级别?

PostgreSQL 中的默认隔离级别是读已提交,显然绝大多数的应用程序都使用该级别。这个级别很方便,因为它只允许在失败的情况下中止事务;它不会为了保持数据一致性而中止任何事务。换句话说,不会发生序列化失败,因此你无需关心事务重试。

这个级别的缺点是可能发生大量异常,这在上面已经详细讨论过。开发人员必须始终牢记这些异常,并以防止它们发生的方式编写代码。如果无法在单个 SQL 语句中定义所有需要的操作,那么你必须使用显式锁定。最困难的部分是,代码很难测试与数据不一致相关的错误;这些错误可能以不可预测且几乎无法重现的方式出现,因此也很难修复。

可重复读隔离级别消除了一些不一致问题,但遗憾的是,并非全部。因此,你不仅要谨记剩余的异常,还要修改应用程序以正确处理序列化失败,这当然很不方便。但是,对于只读事务,此级别是对读已提交的完美补充;它对于生成涉及多个 SQL 查询的报告等场景非常有用。

最后,可序列化隔离级别使你完全不用担心数据一致性,这在很大程度上简化了代码的编写。应用程序唯一需要做的是能够重试因序列化失败而中止的任何事务。然而,被中止事务的数量和相关开销会显著降低系统吞吐量。同时你还应该记住,备库上不支持可序列化隔离级别,并且不能与其他隔离级别结合使用。

3 页与元组

3.1 页面结构

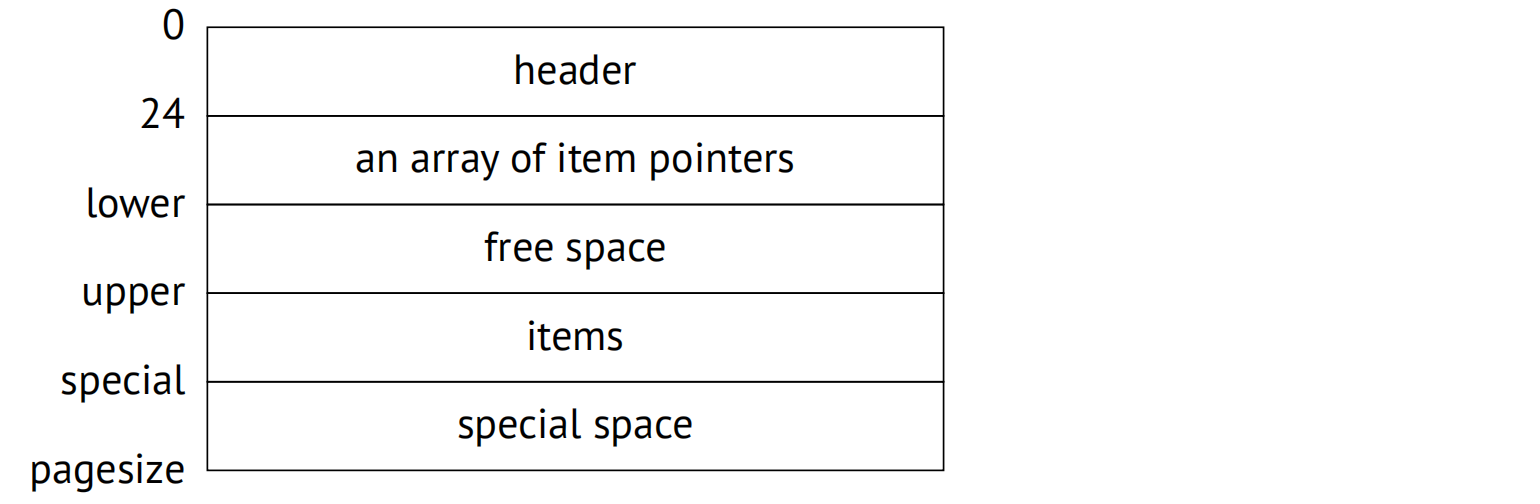
每个页面都有特定的内部布局,通常由以下部分组成 1:

  • 页头

  • 项指针数组

  • 空闲空间

  • 项 (行版本)

  • 特殊空间

3.1.1 页头

页头位于地址的最低处,其大小固定。它存储着关于页面的各种信息,比如校验和以及页面其他所有部分的大小。

这些大小可以通过 pageinspect 扩展 2 查看。让我们看下表的第一个页面,页号从零开始:
=> CREATE EXTENSION pageinspect;
=> SELECT lower, upper, special, pagesize
FROM page_header(get_raw_page('accounts',0));
 lower | upper | special | pagesize
−−−−−−−+−−−−−−−+−−−−−−−−−+−−−−−−−−−−
   152 |  6904 |    8192 |     8192
(1 row)
3.1.1 页头:插图 1
图 3.1

3.1.2 特殊空间

特殊空间位于页面的另一边,占据最高地址。它被某些索引用来存储辅助信息;在其他索引和表页面中,这个空间的大小为零。

一般来说,索引页面的布局相当多样;它们的内容很大程度上取决于特定的索引类型。即使是同一个索引也可以有不同类型的页面:例如,B 树有一个特殊结构的元数据页面 (第零页) 和与表页面非常相似的常规页面。

3.1.3 元组

行 (rows) 包含存储在数据库中的实际数据以及一些额外信息。它们位于特殊空间之前。

在处理表时,我们需要处理的是行版本而不是行,因为多版本并发控制意味着同一行有多个版本。索引不使用这种 MVCC 机制;相反,它们必须引用所有可用的行版本,然后依靠可见性规则来选择合适的行版本。

表的行版本和索引条目通常都被称为元组。这个术语源自关系理论 — 这是 PostgreSQL 学术历史的另一项遗产。

3.1.4 项指针

指向元组的指针数组作为页面的目录。它位于页头之后。

索引条目必须以某种方式引用特定的堆元组。为此 PostgreSQL 使用六字节的元组标识符 (TIDS)。每个 TID 由主分支的页号以及对该页面中特定行版本的引用所组成。

理论上,元组可以通过它们从页面开始的偏移量来引用。但这样一来,如果不破坏这些引用,就无法在页面内移动元组,进而导致页面碎片以及其他不愉快的后果。

为此,PostgreSQL 使用间接寻址:元组标识符指向相应的指针号,而这个指针指定了元组的当前偏移量。如果元组在页面内移动,其 TID 仍然保持不变,只需修改位于该页面中的指针即可。

每个指针占用四个字节,并包含以下数据:

  • 元组从页面开始的偏移量

  • 元组长度

  • 定义元组状态的若干比特位

3.1.5 空闲空间

页面在指针和元组之间会留下一些空闲空间 (这反映在空闲空间映射中)。页面不会碎片化:所有可用的空闲空间总是聚集成一个块 3。

3.2 行版本布局

每个行版本都包含一个行头,后面跟着实际的数据。行头由多个字段组成,包括以下内容:

xmin, xmax 代表事务 ID;它们用于区分同一行的当前版本与其他版本。

infomask 提供了一组用于定义行版本属性的信息位。

ctid 是指向同一行的下一个更新版本的指针。

null bitmap 是一个位数组,用于标记列中是否包含空值。

因此,行头会变得非常大:每个元组至少需要 23 个字节,并且由于空值位图以及用于数据对齐的强制填充,通常情况下会超过此值。在"窄"表中,各种元数据的大小很容易超过实际存储数据的大小。

磁盘上的数据布局与 RAM 中的数据表示完全一致。页面及其元组按原样读入缓冲区缓存中,无需任何转换。这就是为什么数据文件在不同平台之间不兼容的原因 4。

不兼容的原因之一是字节序。例如,x86 架构是小端序,z/Architecture 是大端序,而 ARM 的字节序是可配置的。

另一个原因是按照机器字边界进行数据对齐,这也是许多架构所要求的。例如,在 32 位 x86 系统中,整数 (integer 类型,占用四个字节) 按四字节字边界对齐,就像双精度浮点数 (double precision 类型,占用八个字节)。但在 64 位系统中,双精度数按八字节字边界对齐。

数据对齐使得元组的大小取决于表中字段的顺序。这种影响通常可以忽略不计,但在某些情况下,它会导致大小显著增加。此处是一个例子:

=> CREATE TABLE padding(
  b1 boolean,
  i1 integer,
  b2 boolean,
  i2 integer
);
=> INSERT INTO padding VALUES (true,1,false,2);
=> SELECT lp_len FROM heap_page_items(get_raw_page('padding', 0));
 lp_len
−−−−−−−−
     40
(1 row)

我使用了 pageinspect 扩展中的 heap_page_items 函数来显示关于指针和元组的一些细节。

在 PostgreSQL 中,表通常被称为堆 (heap)。这是另一个晦涩的术语,暗示了元组的空间分配和动态内存分配之间的相似性。确实可以看到某种类比,但表由完全不同的算法管理。与有序索引相比,我们可以将这个术语理解为"一切都堆积成堆"。

这一行的大小是 40 个字节,其行头占 24 个字节,integer 类型的列占用 4 个字节,每个 boolean 类型的列占用 1 个字节。总共 34 个字节,因此浪费了 6 个字节用于整数列的四字节对齐。

如果我们重建表,空间将被更有效地利用:

=> DROP TABLE padding;
=> CREATE TABLE padding(
  i1 integer,
  i2 integer,
  b1 boolean,
  b2 boolean
);
=> INSERT INTO padding VALUES (1,2,true,false);
=> SELECT lp_len FROM heap_page_items(get_raw_page('padding', 0));
 lp_len
−−−−−−−−
     34
(1 row)

另一种可能的微优化是在表的开头放置不包含空值的固定长度的列。对这些列的访问会更有效率,因为可以缓存它们在元组内的偏移量 5。

3.3 元组操作

为了识别同一行的不同版本,PostgreSQL 使用两个值来标记每个版本:xmin 和 xmax。这些值定义了每个行版本的"有效时间",但它们不是实际时间,而是依赖于不断增加的事务 ID。

当创建一行时,其 xmin 值被设置为 INSERT 命令的事务 ID。

当删除一行时,其当前版本的 xmax 值被设置为 DELETE 命令的事务 ID。

UPDATE 命令具有一定程度的抽象性,可以将其看作是两个独立的操作:DELETE 和 INSERT。首先,当前行版本的 xmax 值设置为 UPDATE 命令的事务 ID。然后创建该行的新版本;其 xmin 值与前一个版本的 xmax 值相同。

现在,让我们深入了解一些关于元组操作的底层细节 6。

对于这些实验,我们需要一个含有两列的表,并在其中一列上创建索引:

=> CREATE TABLE t(
  id integer GENERATED ALWAYS AS IDENTITY,
  s text
);
=> CREATE INDEX ON t(s);

3.3.1 插入

开启一个事务并插入一行:

=> BEGIN;
=> INSERT INTO t(s) VALUES ('FOO');

这是当前的事务ID

=> -- txid_current() before v.13
SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                776
(1 row)

为了表示事务的概念,PostgreSQL 使用了术语 xact,这个术语可以在 SQL 函数名和源代码中找到。因此,事务 ID 可以称为 xact ID、TXID 或简称为 XID。我们会反复遇到这些缩写。

让我们看一下页面内容。heap_page_items 函数可以提供我们所有需要的信息,但是它"按原样"显示数据,因此输出格式有点难以理解:

=> SELECT *
FROM heap_page_items(get_raw_page('t',0)) \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−−−−−−
lp          | 1
lp_off      | 8160
lp_flags    | 1
lp_len      | 32
t_xmin      | 776
t_xmax      | 0
t_field3    | 0
t_ctid      | (0,1)
t_infomask2 | 2
t_infomask 	| 2050
t_hoff      | 24
t_bits      |
t_oid       |
t_data      | \x0100000009464f4f

为了使其更具有可读性,我们可以省略一些信息并扩展一些列:

=> SELECT '(0,'||lp||')' AS ctid,
     CASE lp_flags
       WHEN 0 THEN 'unused'
       WHEN 1 THEN 'normal'
       WHEN 2 THEN 'redirect to '||lp_off
       WHEN 3 THEN 'dead'
     END AS state,
     t_xmin as xmin,
     t_xmax as xmax,
     (t_infomask & 256) > 0 AS xmin_committed,
     (t_infomask & 512) > 0 AS xmin_aborted,
     (t_infomask & 1024) > 0 AS xmax_committed,
     (t_infomask & 2048) > 0 AS xmax_aborted
FROM heap_page_items(get_raw_page('t',0)) \gx

−[ RECORD 1 ]−−+−−−−−−−
ctid           | (0,1)
state          | normal
xmin           | 776
xmax           | 0
xmin_committed | f
xmin_aborted   | f
xmax_committed | f
xmax_aborted   | t

此查询完成了以下操作:

  • lp 指针被转换为元组 ID 的标准格式:页号,指针号。

  • lp_flags 的状态被详细展示出来。此处它被设为 normal,意味着确实指向一个元组。

  • 在所有信息位中,到目前为止我们只挑选出了两对。xmin_committed 和 xmin_aborted 表示 xmin 对应的事务已提交或者已中止。xmax_committed 和 xmax_aborted 提供了关于 xmax 事务的类似信息。

pageinspect 扩展提供了 heap_tuple_infomask_flagsv. 13 函数,用于解释所有的信息位 ,但我目前只检索需要的那些信息位,并以更简洁的形式展示。

让我们回到我们的实验。INSERT 命令已将指针 1 添加到堆页面中,它引用第一个元组,这也是目前唯一的一个元组。

元组的 xmin 字段被设置为当前事务 ID。此事务目前仍然活跃,因此 xmin_committed 和 xmin_aborted 位均还没有设置。

xmax 字段包含 0,这是一个虚拟数字,用于表示该元组尚未被删除,并且代表该行的当前版本。事务会忽略这个数字,因为 xmax_aborted 位被设置了。

为尚未发生的事务设置对应于已中止事务的位可能看起来有些奇怪。但是从隔离的角度来看,这些事务之间没有区别:一个已中止的事务不留下任何痕迹,因此就好像它从未存在过一样。

我们会多次使用这个查询,所以我将它封装成一个函数。同时,我还会隐藏信息位的列,并将事务的状态与其 ID 一起显示,以使输出更加简洁。

=> CREATE FUNCTION heap_page(relname text, pageno integer)
RETURNS TABLE(ctid tid, state text, xmin text, xmax text)
AS $$
SELECT (pageno,lp)::text::tid AS ctid,
     CASE lp_flags
       WHEN 0 THEN 'unused'
       WHEN 1 THEN 'normal'
       WHEN 2 THEN 'redirect to '||lp_off
       WHEN 3 THEN 'dead'
     END AS state,
     t_xmin || CASE
       WHEN (t_infomask & 256) > 0 THEN ' c'
       WHEN (t_infomask & 512) > 0 THEN ' a'
       ELSE ''
     END AS xmin,
     t_xmax || CASE
       WHEN (t_infomask & 1024) > 0 THEN ' c'
       WHEN (t_infomask & 2048) > 0 THEN ' a'
       ELSE ''
     END AS xmax
FROM heap_page_items(get_raw_page(relname,pageno))
ORDER BY lp;
$$ LANGUAGE sql;

现在,元组头中发生的事情更加清晰了:

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−
 (0,1) | normal | 776  | 0 a
(1 row)

通过查询 xmin 和 xmax 伪列,你可以从表本身获得类似但不太详细的信息:

=> SELECT xmin, xmax, * FROM t;
 xmin | xmax | id |  s
−−−−−−+−−−−−−+−−−−+−−−−−
  776 |    0 |  1 | FOO
(1 row)

3.3.2 提交

一旦事务成功完成,其状态必须以某种方式存储 — 必须记录该事务已提交。为此,PostgreSQL 使用了一种特殊的 CLOG (提交日志) 结构 7。它作为文件存储在 PGDATA/pg_xact 目录中,而不是系统表。

以前,这些文件位于 PGDATA/pg_clog,但在 10 版本中,该目录被重命名了 8:对于不熟悉 PostgreSQL 的数据库管理员来说,认为"日志"是不必要的,因此删除它们以释放可用磁盘空间的情况并不少见。

CLOG 被划分成多个文件只是为了方便。这些文件通过服务器共享内存中的缓冲区逐页访问 9。

就像元组头一样,CLOG 用两个位表示每个事务:已提交和已中止。

一旦提交,事务会在 CLOG 中被标记为 committed。当任何其他事务访问堆页面时,它必须回答以下问题:xmin 事务是否已经完成?

  • 如果没有,那么创建的元组一定是不可见的。

    为了检查事务是否仍处于活跃状态,PostgreSQL 使用了另一个位于实例共享内存中的结构;它被称为 ProcArray。该结构包含所有活动进程的列表,每个进程对应的当前 (活动) 事务也在其中指定。

  • 如果是的,它是已提交还是已中止了?如果是后者,相应的元组也不可见。

    正是这种检查需要查询 CLOG。尽管最近的 CLOG 页面存储在内存缓冲区中,每次执行这种检查仍然很昂贵。一旦确定,事务状态就被写入到元组头部 — 更具体地说,写入 xmin_committed 和 xmin_aborted 信息位,也被称为提示位。如果设置了这些位中的一个,则认为 xmin 事务状态是已知的,并且下一个事务将不需要再访问 CLOG 或 ProcArray。

为什么插入这些行的事务没有设置这些提示位?问题在于,当时尚不知道此事务是否会成功完成。并且当事务提交时,已经不清楚哪些元组和页面被更改了。如果一个事务影响了许多页面,那么跟踪它们的成本可能太高。此外,其中一些页面可能已不在缓存中了;再次读取它们仅仅为了更新提示位会严重降低提交的速度。

这种成本削减的负面影响是任何事务 (甚至是只读 SELECT 命令) 都可以设置提示位,从而在缓冲区缓存中留下脏页的痕迹。

最后,让我们提交以 INSERT 语句开始的事务:

=> COMMIT;

页面中没有任何变化 (但我们知道事务状态已经写入 CLOG):

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−
 (0,1) | normal | 776  | 0 a
(1 row)

现在,第一个访问页面的事务 (以"标准"方式,不使用 pageinspect) 必须确认 xmin 事务的状态,并更新了提示位:

=> SELECT * FROM t;
 id |  s
−−−−+−−−−−
  1 | FOO
(1 row)

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin 	| xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
 (0,1) | normal | 776 c | 0 a
(1 row)

3.3.3 删除

当删除一行时,其当前版本的 xmax 字段被设置为执行删除操作的事务 ID,并且 xmax_aborted 位还未被设置。

当此事务处于活跃状态时,xmax 值用于行锁。如果另一个事务打算更新或删除这一行,则必须等待,直至 xmax 事务完成。

让我们删除一行:

=> BEGIN;
=> DELETE FROM t;
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                777
(1 row)

事务 ID 已写入 xmax 字段,但信息位尚未被设置:

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
 (0,1) | normal | 776 c | 777
(1 row)

3.3.4 中止

事务中止的机制与提交类似,同样迅速,但它在 CLOG 中设置的是中止位而不是提交位。尽管相应的命令称为 ROLLBACK,但实际上并没有发生数据回滚:数据页中被中止事务所做的所有更改都保持原样。

=> ROLLBACK;
=> SELECT * FROM heap_page('t',0);
 ctid  | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
 (0,1) | normal | 776 c | 777
(1 row)

当访问页面时,会检查事务状态,然后元组接收到 xmax_aborted 提示位。xmax 数字本身仍然保留在页面中,但没有人会再关注它:

=> SELECT * FROM t;
 id |  s
−−−−+−−−−−
  1 | FOO
(1 row)

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−
 (0,1) | normal | 776 c | 777 a
(1 row)

3.3.5 更新

更新的执行方式就像删除当前元组,然后插入一个新元组:

=> BEGIN;
=> UPDATE t SET s = 'BAR';
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                778
(1 row)

查询返回一行 (其新版本):

=> SELECT * FROM t;
 id |  s
−−−−+−−−−−
  1 | BAR
(1 row)

但是页面中保留了两个版本:

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
 (0,1) | normal | 776 c | 778
 (0,2) | normal | 778 	| 0 a
(2 rows)

之前删除的版本的 xmax 字段包含当前事务 ID。这个值被写入到旧值之上,因为前一个事务被中止了。xmax_aborted 位未被设置,因为当前事务仍然属于未知状态。

为了完成这个实验,让我们提交事务。

=> COMMIT;

3.4 索引

不管索引的类型如何,均不使用行版本控制;每行都由一个确切的元组表示。换句话说,索引行头不包含 xmin 和 xmax 字段。索引条目指向相应表行的所有版本。要确定哪个行版本是可见的,事务必须访问表 (除非所需的页面出现在可见性映射中)。

为方便起见,让我们创建一个简单的函数,该函数使用 pageinspect 显示页面中的所有索引条目 (B 树索引页将它们存储为一个扁平列表):

=> CREATE FUNCTION index_page(relname text, pageno integer)
RETURNS TABLE(itemoffset smallint, htid tid)
AS $$
SELECT itemoffset,
       htid -- ctid before v.13
FROM bt_page_items(relname,pageno);
$$ LANGUAGE sql;

页面引用了两个堆元组,当前的和之前的:

=> SELECT * FROM index_page('t_s_idx',1);
 itemoffset | htid
−−−−−−−−−−−−+−−−−−−−
          1 | (0,2)
          2 | (0,1)
(2 rows)

由于 BAR < FOO,因此在索引中指向第二个元组的指针排在前面。

3.5 TOAST

TOAST 表实际上是一个普通的表,并且它有自己的版本控制,不依赖于主表的行版本。但是,TOAST 表里的行永远不会被更新;要么添加,要么删除,因此其版本控制在某种程度上是人为的。

每次数据修改都会在主表中创建一条新元组。但是,如果更新不影响存储在 TOAST 中的任何长值,则新元组将引用现有的 TOAST 值。只有当长值被更新时,PostgreSQL 才会在主表中创建一个新元组和新的 “toasts”。

3.6 虚拟事务

为了节约使用事务 ID,PostgreSQL 提供了一种特殊的优化机制。

如果事务是只读的,它不会以任何方式影响行的可见性。这就是为什么这样一个事务首先被赋予一个虚拟的 XID 10,它由后端进程 ID 和一个序号组成。分配虚拟 XID 不需要不同进程之间的任何同步,所以分配的速度非常快。此时,事务还没有真正的 ID:

=> BEGIN;
=> -- txid_current_if_assigned() before v.13
SELECT pg_current_xact_id_if_assigned();
 pg_current_xact_id_if_assigned
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−

(1 row)

在不同的时间点,系统可以包含一些已经使用过的虚拟 XID。这是完全正常的:虚拟 XID 只存在于 RAM 中,并且仅在相应的事务处于活动状态时才存在;虚拟 ID 永远不会写入数据页面,也永远不会存储到磁盘上。

一旦事务开始修改数据,它便会收到一个真实的唯一 ID:

=> UPDATE accounts
SET amount = amount - 1.00;

=> SELECT pg_current_xact_id_if_assigned();
 pg_current_xact_id_if_assigned
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
                            780
(1 row)

=> COMMIT;

3.7 子事务

3.7.1 保存点

SQL 支持保存点,允许在不中止整个事务的情况下取消事务内的某些操作。但是这样的场景不适合上面描述的操作过程:事务的状态应用到其所有操作,并且不会执行物理数据回滚。

为了实现这个功能,一个包含保存点的事务被分成若干子事务 11,这样它们的状态就可以分别管理。

子事务有其自己的 ID (比主事务 ID 大)。子事务的状态以往常的方式写入到 CLOG 中;但是,已提交的子事务会同时接收到已提交和已中止的位。最终决定取决于主事务的状态:如果主事务被中止,那么它所有的子事务也将被视为已中止。

有关子事务的信息存储在 PGDATA/pg_subtrans 目录下。文件访问通过实例共享内存中的缓冲区进行,这些缓冲区的结构与 CLOG 缓冲区 12 相同。

不要将子事务与自治事务相混淆。与子事务不同,后者彼此之间完全互不依赖。原生的 PostgreSQL 不支持自治事务,这可能是最好的:它们在极少数情况下才需要,但在其他数据库系统中的可用性往往会引起误用,这可能会导致很多麻烦。

让我们截断表,开启一个新的事务并插入一行:

=> TRUNCATE TABLE t;
=> BEGIN;
=> INSERT INTO t(s) VALUES ('FOO');
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                782
(1 row)

现在创建一个保存点,并插入另一行:

=> SAVEPOINT sp;
=> INSERT INTO t(s) VALUES ('XYZ');
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                782
(1 row)

请注意,pg_current_xact_id 函数返回的是主事务 ID,而不是子事务 ID。

=> SELECT *
FROM heap_page('t',0) p
  LEFT JOIN t ON p.ctid = t.ctid;
  ctid | state  | xmin | xmax | id |  s
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−+−−−−+−−−−−
 (0,1) | normal | 782  | 0 a  |  2 | FOO
 (0,2) | normal | 783  | 0 a  |  3 | XYZ
(2 rows)

让我们回滚到保存点,并插入第三行:

=> ROLLBACK TO sp;

=> INSERT INTO t(s) VALUES ('BAR');
=> SELECT *
FROM heap_page('t',0) p
  LEFT JOIN t ON p.ctid = t.ctid;
  ctid | state  | xmin | xmax | id |  s
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−+−−−−+−−−−−
 (0,1) | normal | 782  | 0 a  | 2  | FOO
 (0,2) | normal | 783  | 0 a  |    |	
 (0,3) | normal | 784  | 0 a  | 4  | BAR
(3 rows)

页面仍然包含由已中止的子事务添加的行。

提交更改:

=> COMMIT;

=> SELECT * FROM t;
 id | s
−−−−+−−−−−
  2 | FOO
  4 | BAR
(2 rows)

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
 (0,1) | normal | 782 c | 0 a
 (0,2) | normal | 783 a | 0 a
 (0,3) | normal | 784 c | 0 a
(3 rows)

现在我们可以清楚地看到,每个子事务都有其自己的状态。

SQL 不允许直接使用子事务,也就是说,你不能在完成当前事务之前开始一个新事务:

=> BEGIN;
BEGIN
=> BEGIN;
WARNING: there is already a transaction in progress
BEGIN
=> COMMIT;
COMMIT
=> COMMIT;
WARNING: there is no transaction in progress
COMMIT

子事务是隐式使用的:为了实现保存点,处理 PL/pgSQL 中的异常,以及一些其他更罕见的情况。

3.7.2 错误与原子性

在执行语句期间,如果出现了错误会发生什么?

=> BEGIN;
=> SELECT * FROM t;
 id |  s
−−−−+−−−−−
  2 | FOO
  4 | BAR
(2 rows)
=> UPDATE t SET s = repeat('X', 1/(id-4));
ERROR: division by zero

失败后,整个事务将被视为已中止,并且无法执行任何进一步的操作:

=> SELECT * FROM t;
ERROR: current transaction is aborted, commands ignored until end of transaction block

并且即使你尝试提交更改,PostgreSQL 也会提示事务已回滚:

=> COMMIT;
ROLLBACK

为什么在失败之后禁止继续执行事务?因为已执行的操作永远不会回滚,我们将能够访问在错误之前所做的一些更改 — 这将打破语句的原子性,从而破坏事务本身的原子性。

例如,在我们的实验中,操作符在失败之前,已经成功更新了两行中的一行:

=> SELECT * FROM heap_page('t',0);
  ctid | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
 (0,1) | normal | 782 c | 785
 (0,2) | normal | 783 a | 0 a
 (0,3) | normal | 784 c | 0 a
 (0,4) | normal | 785 	| 0 a
(4 rows)

顺带说明一下,psql 提供了一种特殊模式,允许在失败后继续执行事务,就好像错误的语句已经回滚了一样:

=> \set ON_ERROR_ROLLBACK on

=> BEGIN;

=> UPDATE t SET s = repeat('X', 1/(id-4));
ERROR: division by zero

=> SELECT * FROM t;
 id |  s
−−−−+−−−−−
  2 | FOO
  4 | BAR
(2 rows)

=> COMMIT;
COMMIT

如你所料,psql 在此模式下运行时,会在每个命令之前隐式添加一个保存点;如果发生错误,则会执行回滚。默认情况下不会使用此模式,因为执行保存点 (即使它们没有被回滚) 会产生大量开销。


  1. postgresql.org/docs/14/storage-page-layout.html
    include/storage/bufpage.h ↩︎

  2. postgresql.org/docs/14/pageinspect.html ↩︎

  3. backend/storage/page/bufpage.c, PageRepairFragmentation function ↩︎

  4. include/access/htup_details.h ↩︎

  5. backend/access/common/heaptuple.c, heap_deform_tuple function ↩︎

  6. backend/access/transam/README ↩︎

  7. include/access/clog.h
    backend/access/transam/clog.c ↩︎

  8. commitfest.postgresql.org/13/750 ↩︎

  9. backend/access/transam/clog.c ↩︎

  10. backend/access/transam/xact.c ↩︎

  11. backend/access/transam/subtrans.c ↩︎

  12. backend/access/transam/slru.c ↩︎

4 快照

4.1 什么是快照?

数据页可以包含同一行的多个版本,尽管每个事务最多只能看到其中一个版本。所有不同行的可见版本共同构成一个快照。快照仅包括在获取时已提交的当前数据,因此为这一特定时刻提供了一致的 (在 ACID 意义上) 数据视图。

为了确保隔离性,每个事务都使用其自己的快照。这意味着不同的事务可以看到在不同时间点获取的不同快照,但这些快照仍然是一致的。

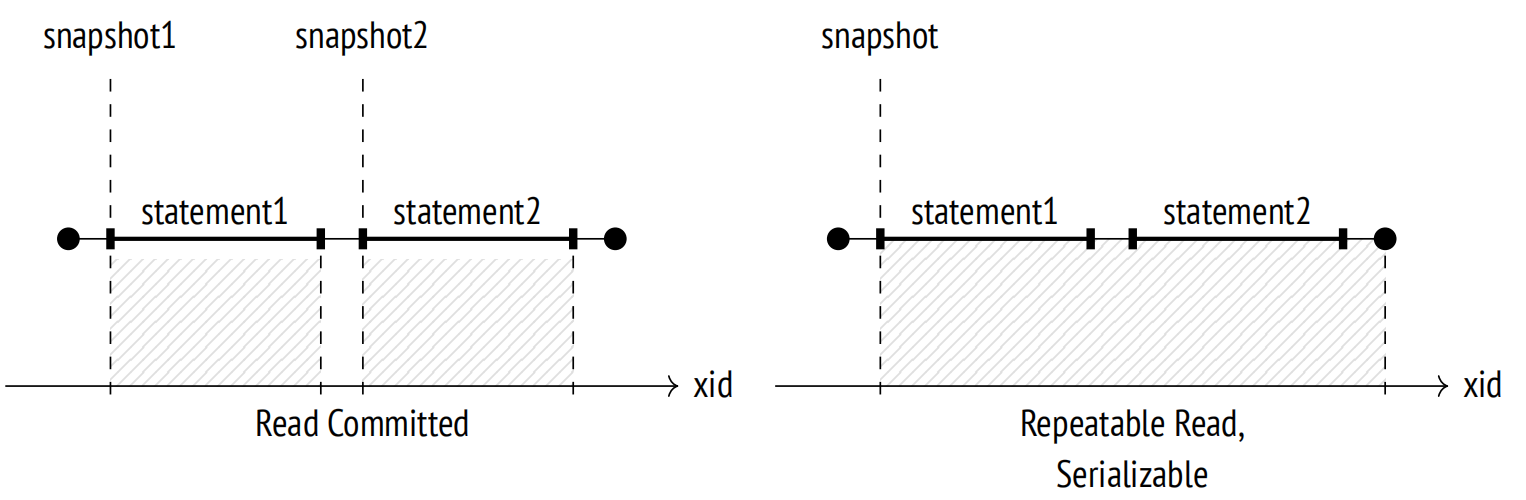
在读已提交隔离级别下,每个语句开始时获取一个快照,并且仅在该语句期间内保持活跃状态。

在可重复读和可序列化隔离级别下,在事务内的第一条语句开始时获取一个快照,并且会保持活跃状态直到整个事务完成。
4.1 什么是快照?:插图 1
图 4.1

4.2 行版本可见性

快照并不是所有所需元组的物理拷贝。相反,它由几个数字定义,而元组的可见性则由特定规则决定。

元组可见性由元组头中的 xmin 和 xmax 字段 (即执行插入和删除的事务 ID) 和相应的提示位定义。由于 xmin–xmax 区间不相交,因此在任何快照中,每一行仅由其版本中的一个所表示。

确切的可见性规则十分复杂 1,因为考虑到了各种不同的场景和极端情况。非常粗略地,我们可以这样描述它们:一个元组在包括 xmin 事务更改但不包括 xmax 事务更改的快照中是可见的 (换句话说,该元组已经出现并且尚未被删除)。

如果事务在快照创建之前提交,那么事务更改在快照中是可见的。作为一个例外,事务可以看到自己未提交的更改。如果事务被中止,其更改不会在任何快照中可见。

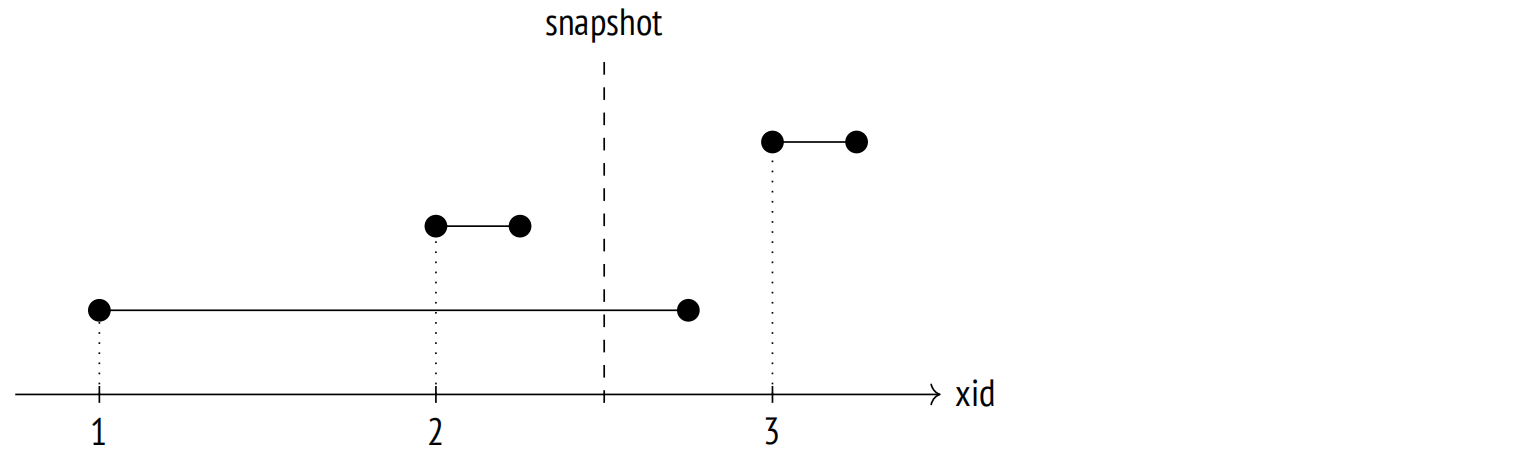
让我们看一个简单的例子。在此图中,线段代表事务 (从它们的开始时间到提交时间):
4.2 行版本可见性:插图 2
图 4.2

此处,应用于事务的可见性规则如下:

  • 事务 2 在快照创建之前已提交,因此其更改是可见的。

  • 事务 1 在快照创建时仍处于活跃状态,因此其更改不可见。

  • 事务 3 是在快照创建后启动的,因此它的更改也不可见 (无论此事务完成与否都没有区别)。

4.3 快照结构

不幸的是,前面的示例与 PostgreSQL 实际看到的情况并不相符 2。问题在于,系统不知道事务何时提交。仅知道它们是何时开始的 (这一时刻由事务 ID 定义),事务何时完成的未在任何地方记录。

如果启用了 track_commit_timestampoff 参数,可以跟踪事务的提交时间 3,但它们不会以任何方式参与可见性检查 (尽管出于其他目的跟踪它们仍然是有用的,例如,应用于外部复制解决方案)。

此外,PostgreSQL 总是在相应的 WAL 条目中记录提交和回滚的时间,但这些信息仅用于时间点恢复。

我们只能了解到事务的当前状态。此信息可以在服务器的共享内存中获取:ProcArray 结构包含所有活跃会话及其事务的列表。一旦事务完成,就无法确定它在快照创建时是否处于活跃状态。

因此创建快照仅记录获取的时刻是不够的:还需要收集在那一时刻所有事务的状态。否则,之后将无法确定哪些元组在快照中必须可见,哪些必须被排除。

让我们看一下系统在获取快照时以及一段时间后可用的信息,白色圆圈表示活跃事务,黑色圆圈表示已完成的事务:
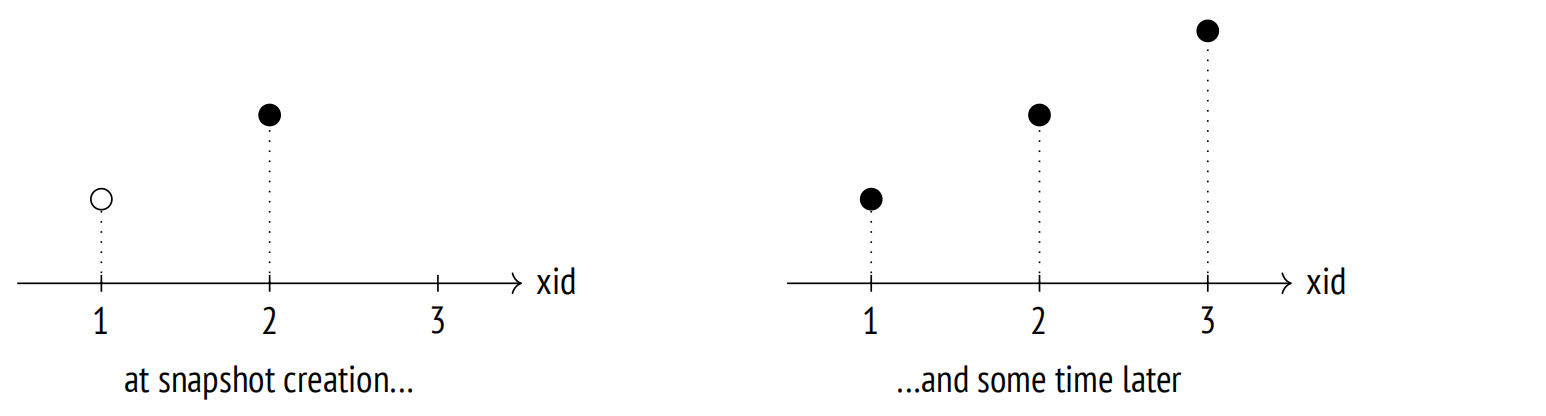
4.3 快照结构:插图 3
图 4.3

假设我们不知道在获取快照时第一个事务仍在执行中,而第三个事务尚未开始。那么看起来它们就像第二个事务 (在那个时刻已提交) 一样,无法将它们过滤掉。

因此,即使所有需要的元组都存在于堆页面中,PostgreSQL 也无法创建一个快照来显示过去某个任意时间点的数据一致状态。所以,PostgreSQL 无法实现回溯查询 (有时也称为时间或闪回查询)。

有趣的是,该功能被宣布为 Postgres 的目标之一,并在初期就实现了,但是当项目支持转交给社区时,它被从数据库系统中移除了 4。

因此,快照由创建时保存的几个值所组成 5:

xmin 是快照的下边界,由最老的活跃事务 ID 表示。

所有 ID 更小的事务要么已提交 (因此它们的更改包含在快照中),要么已中止 (因此它们的更改会被忽略)。

xmax 是快照的上边界,由最新已提交的事务 ID 加 1 所表示。上边界定义了获取快照的时刻。

所有 ID 大于或等于 xmax 的事务要么仍在运行中,要么不存在,因此它们的更改不可见。

xip_list 是除了虚拟事务之外的所有活跃事务 ID 的列表,虚拟事务不会以任何方式影响可见性。

快照还包括其他几个参数,但此处我们将忽略它们。

以图形表示,快照可以表示为一个矩形,包括从 xmin 到 xmax 的事务。
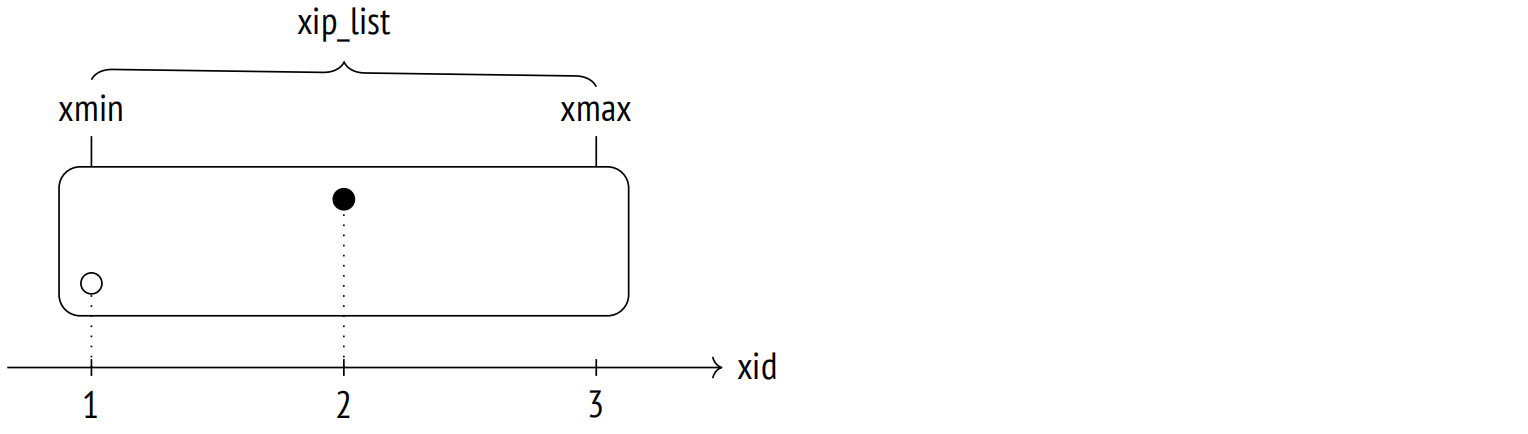
4.3 快照结构:插图 4
图 4.4

为了理解快照是如何定义可见性规则的,我们将在 accounts 表上复现上述场景。

=> TRUNCATE TABLE accounts;

第一个事务向表中插入第一行,并保持开启状态:

=> BEGIN;
=> INSERT INTO accounts VALUES (1, 'alice', 1000.00);
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                790
(1 row)

第二个事务插入第二行,并立即提交此更改:

=> BEGIN;
=> INSERT INTO accounts VALUES (2, 'bob', 100.00);
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                791
(1 row)
=> COMMIT;

此时,让我们在另一个会话中创建一个新的快照。 为此,我们可以简单地运行任何查询,但我们将使用一个特殊函数来立即查看此快照:

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> -- txid_current_snapshot() before v.13
SELECT pg_current_snapshot();
 pg_current_snapshot
−−−−−−−−−−−−−−−−−−−−−
 790:792:790
(1 row)

此函数显示了快照的组成,以冒号分隔:xmin、xmax 和 xip_list (活跃事务列表;在这个特定案例中,它由单个条目组成)。

一旦获取了快照之后,提交第一个事务:

=> COMMIT;

第三个事务是在快照创建后开始的。它修改了第二行,所以出现了一个新的元组:

=> BEGIN;
=> UPDATE accounts SET amount = amount + 100 WHERE id = 2;
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                792
(1 row)
=> COMMIT;

我们的快照只看到一个元组:

=> SELECT ctid, * FROM accounts;
  ctid | id | client | amount
−−−−−−−+−−−−+−−−−−−−−+−−−−−−−−
 (0,2) | 2  | bob    | 100.00
(1 row)

但是表中包含了三个元组:

=> SELECT * FROM heap_page('accounts',0);
  ctid | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−
 (0,1) | normal | 790 c | 0 a
 (0,2) | normal | 791 c | 792 c
 (0,3) | normal | 792 c | 0 a
(3 rows)

那么 PostgreSQL 是如何选择要显示哪些版本的呢? 根据上述规则,仅当满足以下条件的已提交事务执行的更改,才会被包含在快照中:

  • 如果 xid < xmin,那么更改会无条件显示 (就像创建 accounts 表的事务一样)。

  • 如果 xmin ⩽ xid < xmax,那么仅当相应的事务 ID 不在 xip_list 中时,更改才会被显示。

第一行 (0,1) 是不可见的,因为插入它的事务出现在了 xip_list 中 (即使该事务落在了快照范围内)。

第二行的最新版本 (0,3) 是不可见的,因为相应的事务 ID 超过了快照的上边界。

但是第二行的第一个版本 (0,2) 是可见的:插入行的事务落在了快照范围内,并且没有出现在 xip_list 中 (插入是可见的),而删除行的事务,其 ID 超过了快照的上边界 (删除是不可见的)。

=> COMMIT;

4.4 事务自身更改的可见性

在定义事务自身更改的可见性规则时,事情变得更加复杂:在某些情况下,只有部分更改必须是可见的。例如,无论隔离级别如何,在特定时间点打开的游标不能看到之后发生的任何更改。

为了解决这类情况,元组头提供了一个特殊字段 (cmin 和 cmax 伪列),用于显示事务内操作的序号。cmin 列用于标识插入,而 cmax 用于删除操作。为了节省空间,这些值存储在元组头的单个字段中,而不是存储在两个不同的字段中。考虑到同一行几乎永远不会在单个事务中既被插入又被删除。(如果确实发生了,PostgreSQL 会在这个字段中写入一个特殊的 combo 标识符,在这种情况下,实际的 cmin 和 cmax 值由后端进程存储 6)。

作为示例,让我们启动一个事务并在表中插入一行:

=> BEGIN;
=> INSERT INTO accounts VALUES (3, 'charlie', 100.00);
=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                793
(1 row)

然后打开一个游标,用于执行返回表中行数的查询:

=> DECLARE c CURSOR FOR SELECT count(*) FROM accounts;

再插入一行:

=> INSERT INTO accounts VALUES (4, 'charlie', 200.00);

现在用另一列来扩展输出,以显示插入行的 cmin 值 (对于其他行没有意义):

=> SELECT xmin, CASE WHEN xmin = 793 THEN cmin END cmin, *
FROM accounts;
 xmin | cmin | id | client  | amount
−−−−−−+−−−−−−+−−−−+−−−−−−−−−+−−−−−−−−−
  790 |      |  1 | alice 	| 1000.00
  792 |      |  2 | bob     |  200.00
  793 |   0	 |  3 | charlie |  100.00
  793 |   1  |  4 | charlie |  200.00
(4 rows)

游标查询只获取到三行;在游标已经打开时插入的行未包含在快照中,因为它不满足 cmin < 1 的条件:

=> FETCH c;
 count
−−−−−−−
     3
(1 row)

当然,这个 cmin 数字也存储在快照中,但无法使用任何 SQL 手段显示它。

4.5 事务视界

如前文所述,快照的下边界由 xmin 表示,xmin 是快照创建时处于活跃状态的最老的事务 ID。这个值非常重要,因为它定义了使用这个快照的事务视界。

如果一个事务没有活跃的快照 (例如,在读已提交隔离级别的语句执行之间),那么其视界由它自己的 ID 定义(如果已分配)。

所有超出视界的事务 (那些 xid < xmin 的事务) 都保证已提交。这意味着,一个事务只能看到其视界之外的当前行版本。

如你所料,这个术语的灵感来自物理学中的事件视界概念。

PostgreSQL 跟踪所有进程的当前视界;事务可以在 pg_stat_activity 表中看到它们自己的视界:

=> BEGIN;
=> SELECT backend_xmin FROM pg_stat_activity
WHERE pid = pg_backend_pid();
 backend_xmin
−−−−−−−−−−−−−−
          793
(1 row)

虚拟事务没有真正的 ID,但它们仍然像常规事务一样使用快照,因此它们有自己的视界。唯一例外是没有活跃快照的虚拟事务:视界的概念对于它们来说毫无意义,当涉及到快照和可见性时,它们对系统是完全"透明的" (尽管 pg_stat_activity.backend_xmin 中仍可能包含旧快照的 xmin)。

我们也可以用类似的方式去定义数据库视界。为此,我们应当获取这个数据库中所有事务的视界,并选择最远的一个,其 xmin 最老 7。在这个视界之外,过期的堆元组将永远不会对这个数据库中的任何事务可见。这样的元组便可以被 vacuum 安全地清理掉 — 这正是从实际角度来看,为什么视界的概念如此重要的原因。
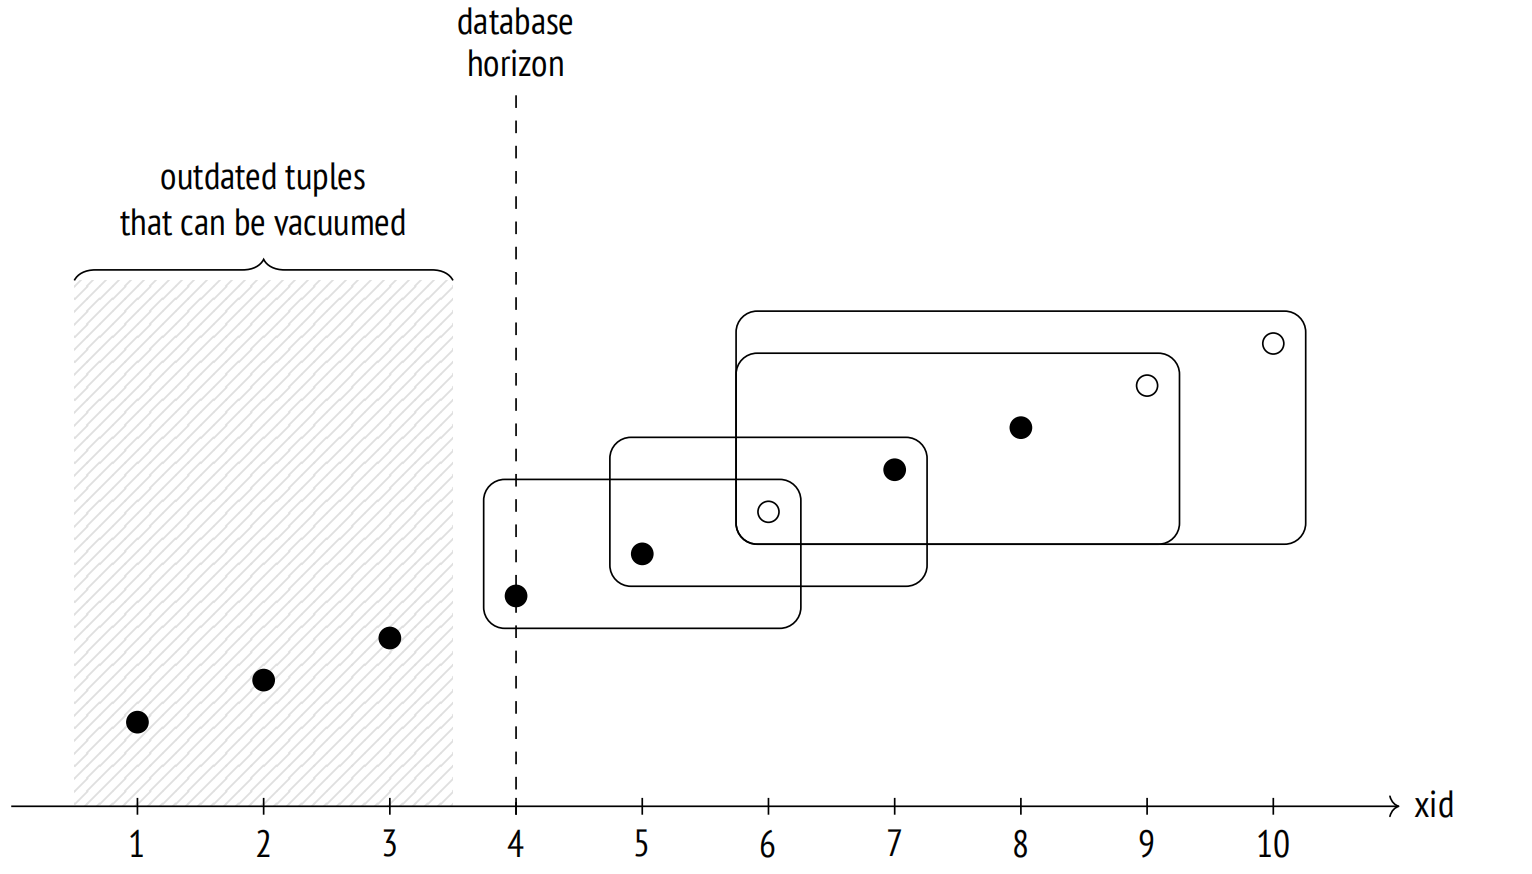
4.5 事务视界:插图 5
图 4.5

让我们总结一下:

  • 如果处于可重复读或可序列化隔离级别下的事务 (无论是真实的还是虚拟的) 运行了很长时间,它会保持数据库视界并推迟清理。

  • 处于读已提交隔离级别下的真实事务以相同的方式保持数据库视界,即使它没有执行任何操作符 (处于 “idle in transaction” 状态)。

  • 处于读已提交隔离级别下的虚拟事务仅在执行操作符时才保持视界。

整个数据库只有一个视界,因此如果它被一个事务持有,那么这个视界内的任何数据都无法进行清理 — 即使这个事务没有访问这些数据。

集簇范围的系统目录表有一个单独的视界,该视界考虑了所有数据库中的所有事务。相反,临时表不需要关注除当前进程正在执行的事务之外的任何事务。

让我们回到当前的实验。第一个会话的活跃事务仍然持有数据库视界;我们可以通过增加事务计数器来看到这一点:

=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
                794
(1 row)
=> SELECT backend_xmin FROM pg_stat_activity
WHERE pid = pg_backend_pid();
 backend_xmin
−−−−−−−−−−−−−−
          793
(1 row)

只有当这个事务完成时,视界才会向前推动,过期的元组才能被清理掉:

=> COMMIT;
=> SELECT backend_xmin FROM pg_stat_activity
WHERE pid = pg_backend_pid();
 backend_xmin
−−−−−−−−−−−−−−
          795
(1 row)

在理想情况下,你应该避免将长事务与频繁更新 (产生新的行版本) 相结合,因为这会导致表和索引膨胀。

4.6 系统目录快照

尽管系统目录由常规表组成,但它们不能通过事务或操作符使用的快照来访问。快照必须足够"新鲜"以包含所有最新的更改,否则事务可能会看到过时的列定义或错过新添加的完整性约束。

此处是一个简单的例子:

=> BEGIN TRANSACTION ISOLATION LEVEL REPEATABLE READ;

=> SELECT 1; -- a snapshot for the transaction is taken
=> ALTER TABLE accounts
  ALTER amount SET NOT NULL;
=> INSERT INTO accounts(client, amount)
VALUES ('alice', NULL);
ERROR: null value in column "amount" of relation "accounts"
violates not−null constraint
DETAIL: Failing row contains (1, alice, null).

=> ROLLBACK;

快照创建之后出现的完整性约束对 INSERT 命令是可见的。看起来这种行为打破了隔离性,但是如果插入的事务在 ALTER TABLE 命令之前就访问了 accounts 表,那么后者就会被阻塞,直至该事务完成。

通常,服务器的行为就像为每个系统目录查询创建了一个单独的快照。但是实现当然要复杂得多 8,因为频繁创建快照会对性能产生负面影响;此外,许多系统目录对象都被缓存了,这也是必须考虑的。

4.7 导出快照

在某些情况下,必须确保并发事务无论如何都能看到同一个快照。例如,如果 pg_dump 工具以并行模式运行,所有的进程必须看到相同的数据库状态,以产生一致的备份。

我们不能仅仅因为事务是"同时"启动的,就假设快照也是相同的。为了确保所有事务看到相同的数据,我们必须使用快照导出机制。

pg_export_snapshot 函数返回一个快照 ID,这个 ID 可以传递给另一个事务 (在数据库系统之外):

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT count(*) FROM accounts;
 count
−−−−−−−
     4
(1 row)

=> SELECT pg_export_snapshot();
 pg_export_snapshot
−−−−−−−−−−−−−−−−−−−−−
 00000004−0000006E−1
(1 row)

在执行第一个语句之前,另一个事务可以通过运行 SET TRANSACTION SNAPSHOT 命令来导入快照。隔离级别必须设置为可重复读或可序列化,因为在读已提交级别下,操作符使用它们自己的快照:

=> DELETE FROM accounts;
=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SET TRANSACTION SNAPSHOT '00000004-0000006E-1';

现在第二个事务将使用第一个事务的快照,因此,它将看到四行 (而不是零):

=> SELECT count(*) FROM accounts;
 count
−−−−−−−
  	 4
(1 row)

显然,在快照导出后,第二个事务不会看到第一个事务所做的任何更改 (反之亦然):常规的可见性规则仍然适用。

导出快照的生命周期与导出事务的生命周期相同。

=> COMMIT;
=> COMMIT;

  1. backend/access/heap/heapam_visibility.c ↩︎

  2. include/utils/snapshot.h
    backend/utils/time/snapmgr.c ↩︎

  3. backend/access/transam/commit_ts.c ↩︎

  4. Joseph M. Hellerstein, Looking Back at Postgres. https://arxiv.org/pdf/1901.01973.pdf ↩︎

  5. backend/storage/ipc/procarray.c, GetSnapshotData function ↩︎

  6. backend/utils/time/combocid.c ↩︎

  7. backend/storage/ipc/procarray.c, ComputeXidHorizons function ↩︎

  8. backend/utils/time/snapmgr.c, GetCatalogSnapshot function ↩︎

5 页剪枝与 HOT 更新

5.1 页剪枝

在读取或更新堆页面时,PostgreSQL 可以执行一些快速的页面清理,或称之为剪枝 1。剪枝发生在以下情况:

  • 之前的 UPDATE 操作没有找到足够的空间将新元组放入同一页面中。此事件反映在页头中。

  • 堆页面中包含的数据超过了 fillfactor100 存储参数所允许的量。仅当此页面的填充率低于 fillfactor 百分比时,INSERT 操作才能将新行添加到页面中。其余空间会保留,用于 UPDATE 操作 (默认情况下不保留此空间) 。

页剪枝会移除在任何快照中都不再可见的元组 (即超出数据库视界的元组)。页剪枝永远不会超出单个堆页面的范围,但相对得,它执行得非常快。指向剪枝后的元组指针仍在原处,它们可能会被不同的页面所引用。

出于同样的原因,也不会刷新可见性映射和空闲空间映射 (因此回收的空间是为更新留存的,而不是用于插入)。

由于可以在读取过程中修剪页面,因此任何的 SELECT 语句都可能导致页面修改。这是除了延迟设置提示位之外的另一种情况。

让我们看一下页剪枝实际是如何工作的。我们将创建一个含有两列的表,并在每一列上创建一个索引:

=> CREATE TABLE hot(id integer, s char(2000)) WITH (fillfactor = 75);
=> CREATE INDEX hot_id ON hot(id);
=> CREATE INDEX hot_s ON hot(s);

如果 s 列仅包含拉丁字母,那么每个堆元组将具有 2004 字节的固定大小,加上 24 个字节的元组头。fillfactor 存储参数设置为 75%。这意味着页面有足够的空间容纳四个元组,但我们只能插入三个。

让我们插入一行数据并多次更新:

=> INSERT INTO hot VALUES (1, 'A');
=> UPDATE hot SET s = 'B';
=> UPDATE hot SET s = 'C';
=> UPDATE hot SET s = 'D';

现在页面包含四个元组:

=> SELECT * FROM heap_page('hot',0);
  ctid | state  | xmin  | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−
 (0,1) | normal | 801 c | 802 c
 (0,2) | normal | 802 c | 803 c
 (0,3) | normal | 803 c | 804
 (0,4) | normal | 804   | 0 a
(4 rows)

不出所料,我们刚刚超过了 fillfactor 阈值。你可以通过 pagesize 和 upper 之间的差值来判断 — 它大于页面大小的 75 %,即 6144 个字节:

=> SELECT upper, pagesize FROM page_header(get_raw_page('hot',0));
 upper | pagesize
−−−−−−−+−−−−−−−−−−
    64 |     8192
(1 row)

下一次页面访问将会触发页剪枝,移除所有过期元组。然后,在释放的空间中添加一个新的元组 (0,5):

=> UPDATE hot SET s = 'E';
=> SELECT * FROM heap_page('hot',0);
  ctid | state  | xmin 	| xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
 (0,1) | dead   |       |	
 (0,2) | dead   |       |
 (0,3) | dead   |       |
 (0,4) | normal | 804 c | 805
 (0,5) | normal | 805 	| 0 a
(5 rows)

剩余的堆元组在物理上会被移向页面的最高地址处,以便所有空闲空间汇聚成一个连续的块。元组指针也相应地被修改。这样的话,页面中便没有空闲空间碎片。

指向被剪枝元组的指针还不能被删除,因为它们仍然被索引引用;PostgreSQL 将它们的状态从 normal 修改为 dead。让我们看看 hot_s 索引的第一个页面 (第零页用于存储元数据):

=> SELECT * FROM index_page('hot_s',1);
 itemoffset | htid
−−−−−−−−−−−−+−−−−−−−
          1 | (0,1)
          2 | (0,2)
          3 | (0,3)
          4 | (0,4)
          5 | (0,5)
(5 rows)

我们在另一个索引中也可以看到相同的情况:

=> SELECT * FROM index_page('hot_id',1);
 itemoffset | htid
−−−−−−−−−−−−+−−−−−−−
          1 | (0,1)
          2 | (0,2)
          3 | (0,3)
          4 | (0,4)
          5 | (0,5)
(5 rows)

索引扫描返回 (0,1)、(0,2) 和 (0,3) 作为元组标识符。服务器尝试读取相应的堆元组,但发现指针是 dead 的状态;这意味着这个元组不再存在,应该被忽略。并且在处理的同时,服务器还会改变索引页中的指针状态,以避免重复访问堆页面 2。

让我们扩展显示索引页面的函数v. 13,以显示指针是否是 dead 的状态:

=> DROP FUNCTION index_page(text, integer);

=> CREATE FUNCTION index_page(relname text, pageno integer)
RETURNS TABLE(itemoffset smallint, htid tid, dead boolean)
AS $$
SELECT itemoffset,
       htid,
       dead -- starting from v.13
FROM bt_page_items(relname,pageno);
$$ LANGUAGE sql;

=> SELECT * FROM index_page('hot_id',1);
 itemoffset | htid  | dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,1) | f
          2 | (0,2) | f
          3 | (0,3) | f
          4 | (0,4) | f
          5 | (0,5) | f
(5 rows)

到目前为止,索引页中的所有指针都处于活跃状态。但是一旦第一次索引扫描发生之后,指针状态就会改变:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM hot WHERE id = 1;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using hot_id on hot (actual rows=1 loops=1)
   Index Cond: (id = 1)
(2 rows)

=> SELECT * FROM index_page('hot_id',1);
 itemoffset | htid  | dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,1) | t
          2 | (0,2) | t
          3 | (0,3) | t
          4 | (0,4) | t
          5 | (0,5) | f
(5 rows)

虽然第四个指针引用的堆元组还没有被剪枝,处于正常状态,但它已经超出了数据库视界。这就是为什么这个指针在索引中也被标记为 dead 的原因。

5.2 HOT 更新

在索引中保留对所有堆元组的引用是非常低效的。

首先,每次行修改都会触发表上所有索引的更新:一旦出现一条新的堆元组,每个索引都必须包含对该元组的引用,即使修改的字段没有被索引。

此外,索引积累了对历史堆元组的引用,因此它们必须与这些元组一起被剪枝。

随着在表上创建的索引越来越多,情况会变得更糟。

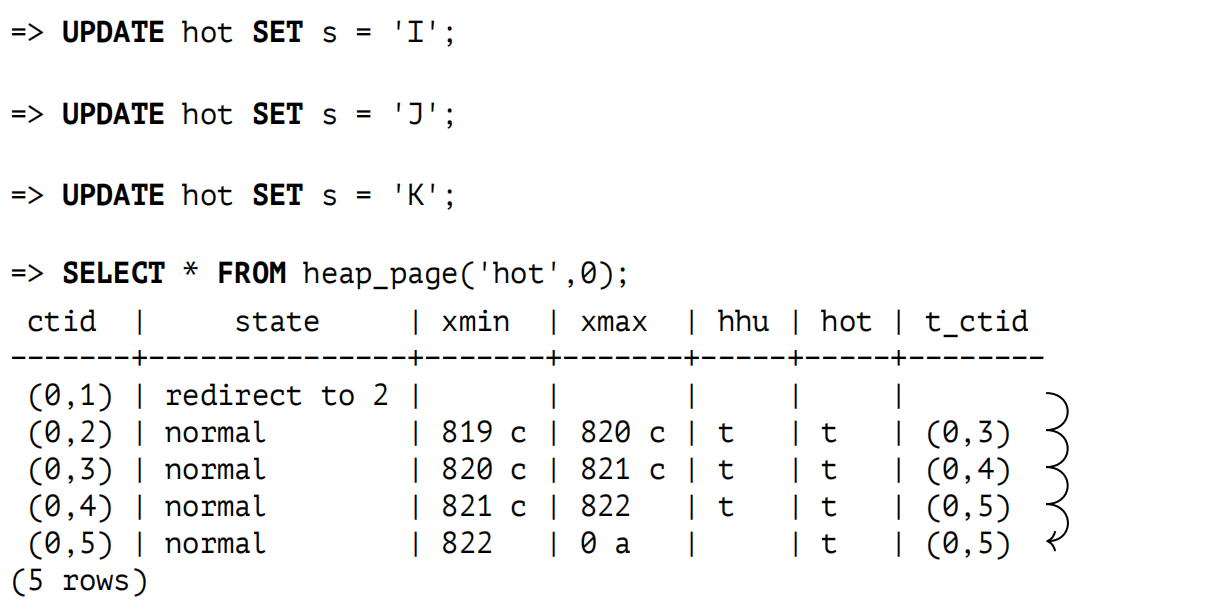
但是,如果更新的列不是任何索引的一部分,那么创建另一个包含相同键值的索引条目是没有意义的。为了避免这种冗余项,PostgreSQL 提供了一种称为 Heap-Only Tuple update 的优化机制 3。

如果执行这样的更新,索引页面对于每一行只包含一个条目。这个条目指向该行的第一个版本;所有后续位于同一页面中的行版本通过元组头中的 ctid 指针形成一条链。

未被任何索引引用的行版本使用 Heap-Only Tuple 位进行标记。如果一个行版本包含在 HOT 链中,那么会使用 Heap Hot Updated 位进行标记。

如果索引扫描访问堆页面并找到标记为 Heap Hot Updated 的行版本,这意味着扫描应该继续进行,因此它会沿着 HOT 更新链进一步扫描。显然,在将结果返回给客户端之前,所有获取的行版本都会检查其可见性。

为了了解 HOT 更新是如何执行的,让我们删除其中一个索引并截断表。

=> DROP INDEX hot_s;
=> TRUNCATE TABLE hot;

为方便起见,我们将重新定义 heap_page 函数,使其输出包含另外三个字段:ctid 以及与 HOT 更新相关的两个位:

=> DROP FUNCTION heap_page(text,integer);
=> CREATE FUNCTION heap_page(relname text, pageno integer)
RETURNS TABLE(
  ctid tid, state text,
  xmin text, xmax text,
  hhu text, hot text, t_ctid tid
) AS $$
SELECT (pageno,lp)::text::tid AS ctid,
       CASE lp_flags
         WHEN 0 THEN 'unused'
         WHEN 1 THEN 'normal'
         WHEN 2 THEN 'redirect to '||lp_off
         WHEN 3 THEN 'dead'
       END AS state,
       t_xmin || CASE
         WHEN (t_infomask & 256) > 0 THEN ' c'
         WHEN (t_infomask & 512) > 0 THEN ' a'
         ELSE ''
       END AS xmin,
       t_xmax || CASE
         WHEN (t_infomask & 1024) > 0 THEN ' c'
         WHEN (t_infomask & 2048) > 0 THEN ' a'
         ELSE ''
       END AS xmax,
       CASE WHEN (t_infomask2 & 16384) > 0 THEN 't' END AS hhu,
       CASE WHEN (t_infomask2 & 32768) > 0 THEN 't' END AS hot,
       t_ctid
FROM heap_page_items(get_raw_page(relname,pageno))
ORDER BY lp;
$$ LANGUAGE sql;

让我们重复插入和更新操作:

=> INSERT INTO hot VALUES (1, 'A');
=> UPDATE hot SET s = 'B';

页面现在包含了一个 HOT 更新链:

  • Heap Hot Updated 位表示执行器需要沿着 CTID 链继续扫描。

  • Heap Only Tuple 位表示这个元组没有被任何索引引用。

5.2 HOT 更新:插图 1
图 5.1

随着我们进一步更新,链会增长 — 但仅限于页面范围内:

5.2 HOT 更新:插图 2
图 5.2

索引仍然只包含一个引用,它指向这个链的头部:

=> SELECT * FROM index_page('hot_id',1);
 itemoffset | htid  | dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,1) | f
(1 row)

如果被修改的字段不是任何索引的一部分,那么就可以进行 HOT 更新。否则,某些索引将包含对出现在链中间的堆元组的引用,这与此优化的想法相矛盾。由于 HOT 链只能在单个页面内增长,遍历整个链永远不需要访问其他页面,因此不会损害性能。

5.3 HOT 更新的页剪枝

页剪枝的一个特殊情况 — 也同样重要,是 HOT 更新链的剪枝。

在上面的例子中,已经超过了 fillfactor 阈值,因此下一次更新会触发页剪枝。但这一次,页面包含了 HOT 链。这个链的头部必须始终保持原位,因为它被索引引用,但其他指针可以被释放,因为它们肯定没有外部引用。

为了避免移动头部,PostgreSQL 使用双重寻址:索引引用的指针 (在本例中为 (0,1)) 获取到的是 redirect 状态,因为它指向了当前链开始的元组:
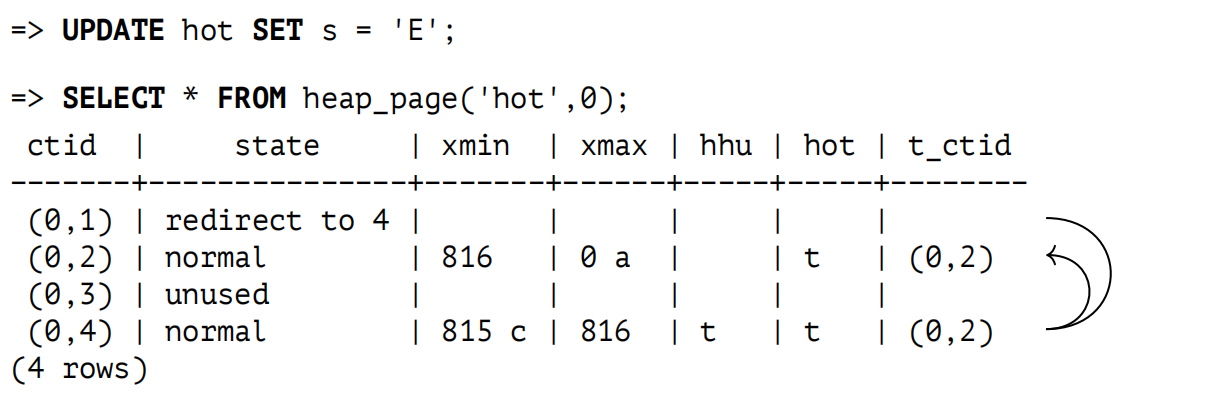
5.3 HOT 更新的页剪枝:插图 3
图 5.3

元组 (0,1),(0,2),(0,3) 被剪枝了;头指针 1 被保留,用于重定向,而指针 2 和 3 已被释放 (unused 的状态) ,因此,它们保证没有来自索引的引用。新的元组作为元组 (0,2) 写入到空闲空间中。

让我们再做一些更新:
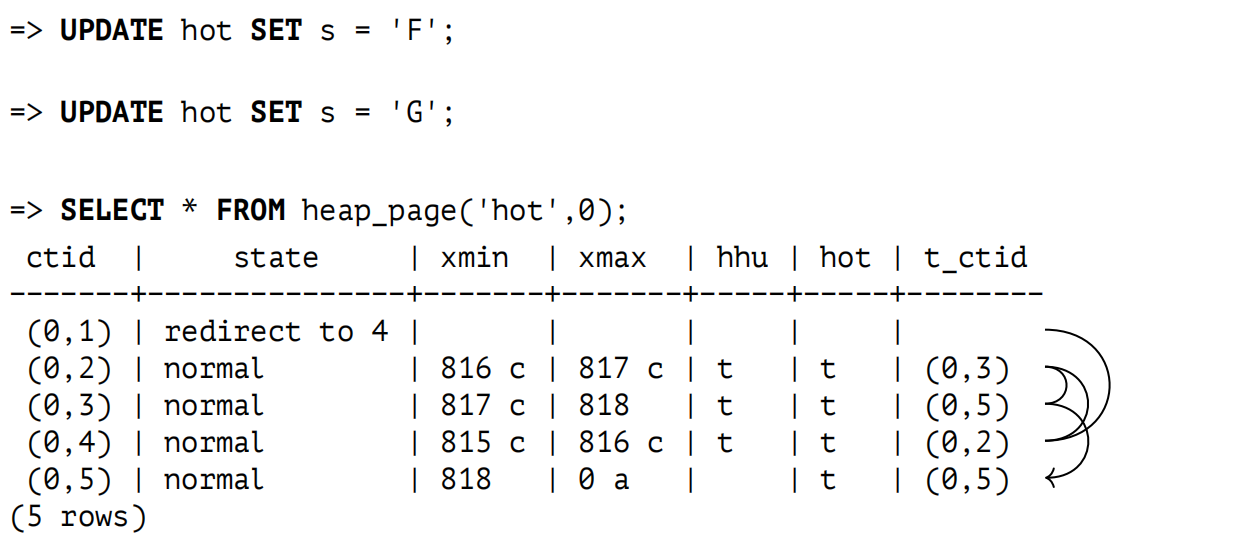
5.3 HOT 更新的页剪枝:插图 4
图 5.4

下一次更新会触发页剪枝:

5.3 HOT 更新的页剪枝:插图 5
图 5.5

同样,一些元组被剪枝,指向链头的指针也相应地被移动。

如果经常修改非索引列,那么减少 fillfactor 的值是有意义的,从而在页面中保留一些空间用于更新。当然,你必须牢记,fillfactor 值越低,页面中剩余的空闲空间就越多,因此表的物理大小会增长。

5.4 HOT 链分裂

如果页面没有更多空间来容纳新的元组,那么链将被切断。PostgreSQL 将不得不添加一个单独的索引条目来引用位于另一个页面的元组。

为了观察这种情况,让我们开启一个并发事务,其快照会阻止页剪枝:

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT 1;

现在我们在第一个会话中执行一些更新操作:

5.4 HOT 链分裂:插图 6
图 5.6

当下一次更新发生时,此页面将无法容纳另一个元组,并且页剪枝将无法释放任何空间:
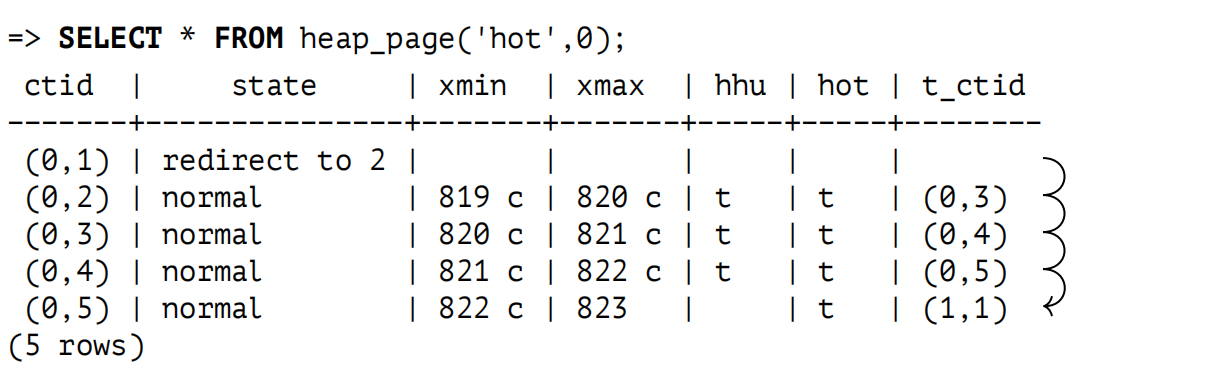
=> UPDATE hot SET s = 'L';
=> COMMIT; -- the snapshot is not required anymore
5.4 HOT 链分裂:插图 7
图 5.7

元组 (0,5) 包含跳转到第一个页面的引用 (1,1):

=> SELECT * FROM heap_page('hot',1);
  ctid | state  | xmin | xmax | hhu | hot | t_ctid
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−+−−−−−+−−−−−+−−−−−−−−
 (1,1) | normal | 823  | 0 a  |     |     | (1,1)
(1 row)

但是,这个引用并未被使用:元组 (0,5) 没有设置 Heap Hot Updated 位。至于元组 (1,1),可以从当前含有两个条目的索引中访问。它们中的每一个都指向其自己的 HOT 链头:

=> SELECT * FROM index_page('hot_id',1);
 itemoffset | htid  | dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,1) | f
          2 | (1,1) | f
(2 rows)

5.5 索引页剪枝

我已经声明,页剪枝仅限于单个堆页面,并且不会影响索引。但是,索引也有自己的剪枝机制 4,它也清理单个页面 — 在这种情况下是索引页面。

当向 B 树中的插入操作即将使页面一分为二时,就会发生索引剪枝,因为原始页面已经没有足够的空间了。问题是,即使稍后删除了一些索引条目,两个单独的索引页也不会合并为一个。这会导致索引膨胀,一旦膨胀,即使删除了很大一部分数据,索引也无法收缩。但是,如果剪枝可以删除一些元组,那么页面分裂可能会被推迟。

可以从索引中剪枝两种类型的元组。

首先,PostgreSQL 会剪枝那些被标记为 dead 的元组 5。正如我之前所说,如果 PostgreSQL 在索引扫描过程中,检测到索引条目指向一个在任何快照中均不再可见或根本不存在的元组,便会设置这样的标记。

如果没有元组已知是 dead 的状态,PostgreSQL 会检查那些引用同一个表行的不同版本的索引条目v. 14。6 因为 MVCC,更新操作可能会生成大量的行版本,而其中许多可能很快就会消失在数据库视界之外。HOT 更新减缓了这种影响,但它们并不总是适用:如果要更新的列是索引的一部分,那么相应的引用将传播到所有索引。在页面分裂之前,搜索尚未标记为 dead 但已经可以剪枝的行是有意义的。为了实现这一点,PostgreSQL 必须检查堆元组的可见性。此类检查需要访问表,因此仅针对"有希望的"的索引元组执行,这些元组是为了 MVCC 目的而创建的现有元组的副本。进行这样的检查比允许额外的页面分裂成本更低。


  1. backend/access/heap/pruneheap.c, heap_page_prune_opt function ↩︎

  2. backend/access/index/indexam.c, index_fetch_heap function ↩︎

  3. backend/access/heap/README.HOT ↩︎

  4. postgresql.org/docs/14/btree-implementation.html#BTREE-DELETION ↩︎

  5. backend/access/nbtree/README, Simple deletion section ↩︎

  6. backend/access/nbtree/README, Bottom-Up deletion section
    include/access/tableam.h ↩︎

6 Vacuum 与 Autovacuum

6.1 Vacuum

页剪枝发生得非常快,但它只释放了部分潜在可以回收的空间。页剪枝在单个堆页面内工作,并且不涉及索引 (反之亦然,清理索引页面也不会影响表)。

例行清理 (Routine vacuuming) 1 是由 VACUUM 2 命令执行的主要清理过程。它会处理整个表,并移除过期的堆元组以及相应的所有索引条目。

清理过程与数据库系统中的其他进程并行运行。当进行清理时,表和索引可以以常规方式进行读取和写入 (但不允许同时执行比如 CREATE INDEX,ALTER TABLE 等命令)。

为了避免扫描额外的页面,PostgreSQL 会使用可见性映射。在可见性映射中跟踪的页面会被跳过,因为这些页面肯定只包含当前元组,因此只有未出现在映射中的页面才会被清理。如果清理后,页面中剩余的所有元组都超出了数据库视界,便会刷新可见性映射以包含此页面。

空闲空间映射也会更新,以反馈已清理的空间。

让我们创建一个带有索引的表:

=> CREATE TABLE vac(
	id integer,
	s char(100)
)
WITH (autovacuum_enabled = off);
	
=> CREATE INDEX vac_s ON vac(s);

autovacuum_enabled 存储参数用于关闭自动清理;此处,我们仅出于实验的目的而关闭它,以精确控制清理的启动时间。

让我们插入一行数据并进行几次更新:

=> INSERT INTO vac(id,s) VALUES (1,'A');

=> UPDATE vac SET s = 'B';

=> UPDATE vac SET s = 'C';

现在表里含有三个元组:

=> SELECT * FROM heap_page('vac',0);
  ctid | state  | xmin  | xmax  | hhu | hot | t_ctid
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−+−−−−−+−−−−−+−−−−−−−−
 (0,1) | normal | 826 c | 827 c |     |     | (0,2)
 (0,2) | normal | 827 c | 828 	|     |     | (0,3)
 (0,3) | normal | 828 	| 0 a 	|     |     | (0,3)
(3 rows)

每个元组都被索引引用:

=> SELECT * FROM index_page('vac_s',1);
 itemoffset | htid  | dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,1) | f
          2 | (0,2) | f
          3 | (0,3) | f
(3 rows)

VACUUM 已删除所有死元组,仅留下了当前元组:

=> VACUUM vac;
=> SELECT * FROM heap_page('vac',0);
  ctid | state  | xmin 	| xmax | hhu | hot | t_ctid
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−+−−−−−+−−−−−+−−−−−−−−
 (0,1) | unused |       |      |     |     |
 (0,2) | unused |       |      |     |     |
 (0,3) | normal | 828 c | 0 a  |     |     | (0,3)
(3 rows)

如果是页剪枝,前两个指针会被认为是 dead 的,但此处它们是 unused 的状态,因为现在没有索引条目引用它们:

=> SELECT * FROM index_page('vac_s',1);
 itemoffset | htid 	| dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,3) | f
(1 row)

具有 unused 状态的指针被视为空闲指针,可以被新的行版本复用。

现在,堆页面出现在可见性映射中;我们可以使用 pg_visibility 扩展来检查这一点:

=> CREATE EXTENSION pg_visibility;
=> SELECT all_visible
FROM pg_visibility_map('vac',0);
 all_visible
−−−−−−−−−−−−−
 t
(1 row)

页头中的属性也进行了更新,表明其所有元组在所有快照中都是可见的:

=> SELECT flags & 4 > 0 AS all_visible
FROM page_header(get_raw_page('vac',0));
 all_visible
−−−−−−−−−−−−−
 t
(1 row)

6.2 再次审视数据库视界

VACUUM 基于数据库视界检测死元组。这个概念很基础,因此有必要再次回顾一下。

让我们从最开始重新我们的实验:

=> TRUNCATE vac;
=> INSERT INTO vac(id,s) VALUES (1,'A');
=> UPDATE vac SET s = 'B';

但这一次,在更新行之前,我们将开启另一个事务,此事务将保持数据库视界 (几乎可以是任何事务,除了在读已提交隔离级别下执行的虚拟事务)。例如,这个事务可以修改另一个表中的一些行:

=> BEGIN;
=> UPDATE accounts SET amount = 0;
=> UPDATE vac SET s = 'C';

现在表中含有三个元组,索引包含三个引用。让我们清理一下表,看看会有什么变化:

=> VACUUM vac;
=> SELECT * FROM heap_page('vac',0);
 ctid  | state  | xmin  | xmax  | hhu | hot | t_ctid
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−+−−−−−+−−−−−+−−−−−−−−
 (0,1) | unused |       |       |     |     |
 (0,2) | normal | 833 c | 835 c |     |     | (0,3)
 (0,3) | normal | 835 c | 0 a 	|     |     | (0,3)
(3 rows)
=> SELECT * FROM index_page('vac_s',1);
 itemoffset | htid  | dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,2) | f
          2 | (0,3) | f
(2 rows)

虽然前一次实验只在页面中留下了一个元组,但这一次我们有两个元组:VACUUM 判断行版本 (0,2) 还不能移除。原因是数据库视界,在这个案例中,是由一个未完成的事务定义的:

=> SELECT backend_xmin FROM pg_stat_activity
WHERE pid = pg_backend_pid();
 backend_xmin
−−−−−−−−−−−−−−
          834
(1 row)

我们可以在调用 VACUUM 时使用 verbose 子句来观察发生了什么:

=> VACUUM VERBOSE vac;
INFO: vacuuming "public.vac"
INFO: table "vac": found 0 removable, 2 nonremovable row versions
in 1 out of 1 pages
DETAIL:  1 dead row versions cannot be removed yet, oldest xmin: 834
Skipped 0 pages due to buffer pins, 0 frozen pages.
CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s.
VACUUM

VACUUM 的输出显示了以下信息:

  • VACUUM 没有检测到可以移除的元组 (0 REMOVABLE)。

  • 两个元组不能被移除 (2 NONREMOVABLE)。

  • 其中一个不可移除的元组状态是 dead (1 DEAD),其他的正在使用。

  • VACUUM 当前所遵循的视界 (OLDEST XMIN) 是活跃事务的视界。

一旦活跃事务完成,数据库视界将向前移动,VACUUM 便可以继续:

=> COMMIT;
=> VACUUM VERBOSE vac;
INFO:  vacuuming "public.vac"
INFO:  scanned index "vac_s" to remove 1 row versions
DETAIL:  CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
INFO:  table "vac": removed 1 dead item identifiers in 1 pages
DETAIL:  CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
INFO:  index "vac_s" now contains 1 row versions in 2 pages
DETAIL:  1 index row versions were removed.
0 index pages were newly deleted.
0 index pages are currently deleted, of which 0 are currently
reusable.
CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s.
INFO:  table "vac":  found 1 removable, 1 nonremovable row versions
in 1 out of 1 pages
DETAIL:  0 dead row versions cannot be removed yet, oldest xmin: 836
Skipped 0 pages due to buffer pins, 0 frozen pages.
CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s.
VACUUM

VACUUM 检测并删除了超出新的数据库视界的死元组。

现在页面不包含过期的行版本,剩下的唯一行版本是当前版本:

=> SELECT * FROM heap_page('vac',0);
  ctid | state  | xmin  | xmax | hhu | hot | t_ctid
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−+−−−−−+−−−−−+−−−−−−−−
 (0,1) | unused |       |      |     |     |
 (0,2) | unused |       |      |     |     |
 (0,3) | normal | 835 c | 0 a  |     |     | (0,3)
(3 rows)

索引也只包含一个条目:

=> SELECT * FROM index_page('vac_s',1);
 itemoffset | htid  | dead
−−−−−−−−−−−−+−−−−−−−+−−−−−−
          1 | (0,3) | f
(1 row)

6.3 清理阶段

清理的机制似乎很简单,但这种印象具有误导性。毕竟,表和索引都必须同时处理,且不能阻塞其他进程。为了实现这样的操作,每个表的清理都分为几个阶段 3 进行。

一切都从扫描表开始,寻找死元组;如果找到,首先从索引中移除它们,然后从表自身中移除。如果一次性需要清理太多的死元组,那么会重复此过程。在最后阶段,可能会执行堆截断。

6.3.1 堆扫描

在第一阶段,执行堆扫描 4。扫描过程会考虑可见性映射:在此映射中跟踪的所有页面都会被跳过,因为这些页面肯定不包含过期的元组。如果一个元组超出了视界且不再需要,那么其 ID 将被添加到一个特殊的 tid 数组中。这些元组还不能被移除,因为它们仍然可能被索引引用。

tid 数组位于 VACUUM 进程的本地内存中;分配的内存块大小由 maintenance_work_mem64MB 参数定义。整个内存块是一次性分配的,而不是按需分配。但是,分配的内存永远不会超过最坏情况下所需的容量,因此如果表很小,清理操作可能使用的内存比此参数指定的要少。

6.3.2 索引清理

第一阶段可能有两个结果:要么表全部扫描了,要么在此操作完成之前,为 tid 数组分配的内存已满。无论哪种情况,索引清理 5 都会开始。在此阶段,表上创建的每个索引都会被完整扫描,以找到所有引用 tid 数组中记录的元组条目。这些条目将从索引页面中移除。

索引可以通过索引键帮助你快速定位到一个堆元组,但还没有办法通过相应的元组 ID 快速找到索引条目。这个功能目前正在为 B 树实现中 6,但这项工作尚未完成。

如果有多个大于 min_parallel_index_scan_size512kB 的索引,那么这些索引可以被后台工作进程并行清理v. 13。除非子句 parallel N 明确指定了并行度级别,否则 VACUUM 会为每个合适的索引启动一个工作进程 (在后台工作进程数量的总体限制内) 7。一个索引不能由多个工作进程处理。

在索引清理阶段,PostgreSQL 会更新空闲空间映射并计算清理的统计信息。但是,如果仅插入行 (既不删除也不更新),那么会跳过此阶段,因为在此情况下表中没有死元组。那么,只有在最后,作为独立的索引规整 (index cleanup) 8 阶段的一部分,才会强制进行一次索引扫描。

索引清理阶段在索引中不再保留对过期堆元组的引用,但这些元组本身仍然存在于表中。这是正常的:索引扫描无法找到任何死元组,而对表的顺序扫描依赖于可见性规则将它们过滤掉。

6.3.3 堆清理

然后开始堆清理阶段 9。表将被再次扫描,以移除 tid 数组中记录的元组并释放相应的指针。由于所有相关的索引引用已经被移除,这个操作现在可以安全地进行。

VACUUM 回收的空间反映在空闲空间映射中,而现在仅包含在所有快照中均可见的当前元组的页面,将在可见性映射中进行标记。

如果在堆扫描阶段没有完整读取表,那么会清空 tid 数组,并从上次停止的地方恢复,继续堆扫描。

6.3.4 堆截断

已清理的堆页面包含一些空闲空间;有时,你可能会幸运地清除整个页面。如果文件末尾有若干个空页面,那么清理进程可以"咬掉"这条尾巴,并将回收的空间返回给操作系统。这发生在堆截断 10 期间,即清理的最后阶段。

堆截断需要获取表上短暂的排它锁。为了避免阻塞其他进程太久,尝试获取锁的时间不超过 5 秒。

由于需要锁表,因此仅当尾部空闲空间至少占表大小的 1/16 或达到 1000 页的长度时,才会执行截断。这些阈值是硬编码的,无法配置。

如果,尽管采取了这些预防措施,表锁仍然可能会导致问题,那么可以使用 vacuum_truncate 和 toast.vacuum_truncate 存储参数彻底禁用截断v. 12。

6.4 分析

在讨论清理时,我们必须提到另一个与之密切相关的任务,即使它们之间没有正式的联系。这便是分析 11,或者说为查询规划器收集统计信息。收集的统计信息包括表中的行数 (pg_class.reltuples) 和页数(pg_class.relpages)、列中的数据分布情况以及一些其他信息。

你可以使用 ANALYZE 12 命令手动运行分析,或通过调用 VACUUM ANALYZE 将其与 VACUUM 相结合。不过这两个任务还是顺序执行的,所以性能方面没有区别。

历史上,VACUUM ANALYZE 首先出现在 6.1 版本中,而单独的 ANALYZE 命令直到 7.2 版本才实现。在早期版本中,统计信息是通过一个 TCL 脚本收集的。

自动清理和自动分析的设置方式类似,因此有必要一起讨论它们。

6.5 自动清理和分析

除非数据库视界被长时间保持,否则例行清理足以应付它的工作。但是我们需要多久调用一次 VACUUM 命令?

如果一个频繁更新的表很少清理,那么其大小会比预期的要大。此外,它可能会积累太多的更改,然后下一次 VACUUM 操作将不得不对索引进行多次遍历。

如果表清理得太频繁,服务器将忙于维护而不是有用的工作。

此外,典型的工作负载可能会随着时间而变化,因此就算有一个固定的清理计划也无济于事:表更新得越频繁,就越需要更频繁地进行清理。

这个问题由自动清理 13 解决,它根据表更新的强度启动清理和分析进程。

6.5.1 自动清理机制

启用自动清理时 (autovacuumon 配置参数为 on) ,系统中始终运行着自动清理守护进程。该进程定义了自动清理的周期,并根据统计信息维护着"活跃"数据库的列表。如果启用了 track_countson 参数,则会收集此类统计信息。不要关闭这些参数,否则自动清理将无法工作。

每隔 autovacuum_naptime1min 时间,自动清理守护进程就会为列表中的每个活跃数据库启动一个自动清理工作进程 14 (这些工作进程如往常一样由 postmaster 创建) 。因此,如果集簇中有 N 个活跃数据库,那么在 autovacuum_naptime 时间间隔内将生成 N 个工作进程。但是,并行运行的自动清理工作进程总数不能超过 autovacuum_max_workers3 参数定义的阈值。

自动清理工作进程与常规的后台工作进程十分相似,但它们比这种通用的任务管理机制出现得早得多。自动清理的实现决定保持不变,因此自动清理工作进程不使用 max_worker_processes 槽。

一旦启动,后台工作进程便会连接到指定的数据库,并构建两个列表:

  • 所有需要清理的表、物化视图和 TOAST 表的列表

  • 所有需要分析的表和物化视图的列表 (因为 TOAST 表总是通过索引访问,所以不会进行分析)

然后逐一清理或分析选定的对象 (或同时进行两种操作),一旦工作完成,工作进程就会终止。

自动清理的工作方式类似于 VACUUM 命令发起的手动清理,但有一些细微差别:

  • 手动清理会在 maintenance_work_mem 所指定大小的内存块中累积元组 ID。但是,对自动清理使用相同的限制是不可取的,因为这会导致过多的内存消耗:可能有多个自动清理工作进程同时运行,每个工作进程都会同时获得 maintenance_work_mem 大小的内存。相反,PostgreSQL 为自动清理进程提供了单独的内存限制,该限制由 autovacuum_work_mem 参数定义。

    默认情况下,autovacuum_work_mem-1 参数回退到常规 maintenance_work_mem 参数的限制,因此如果 autovacuum_max_workers 的值较高,你可能需要相应地调整 autovacuum_work_mem 的值。

  • 只能通过手动清理才能并发处理表上创建的多个索引;使用自动清理会导致大量并行进程,因此不允许这样做。

如果工作进程未能在 autovacuum_naptime 时间间隔内完成所有预期任务,那么自动清理守护进程会在该数据库中生成另外一个工作进程,并行运行。第二个工作进程会创建自己的待清理和待分析的对象列表,并开始处理它们。表级别层面没有并行性;只有不同的表可以同时被处理。

6.5.2 哪些表需要被清理?

你可以在表级别禁用自动清理 — 尽管很难想象为什么需要这样做。为此,提供了两个存储参数,一个用于常规的表,另一个用于 TOAST 表:

  • autovacuum_enabled

  • toast.autovacuum_enabled

通常情况下,自动清理由累积的死元组数量或新行的插入数量触发。

死元组累积。统计信息收集器会不断计算死元组数量;当前死元组的数量显示在名为 pg_stat_all_tables 的系统表中。

当死元组超过以下两个参数所定义的阈值时,则必须清除死元组:

  • autovacuum_vacuum_threshold50,指定死元组的数量 (绝对值)

  • autovacuum_vacuum_scale_factor0.2,设置表中死元组的比例

如果满足以下条件,则需要进行清理:pg_stat_all_tables.n_dead_tup > autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor × pg_class.reltuples。

此处主要参数当然是 autovacuum_vacuum_scale_factor:它的值对于大表很重要 (而且大表可能会导致大部分问题)。默认值 20% 似乎太大,可能需要大幅减小。

对于不同的表,最佳参数值可能会有所不同:这很大程度上取决于表的大小和工作负载的类型。设置合理的初始值是有意义的,然后使用存储参数为特定的表覆盖这些值:

  • autovacuum_vacuum_threshold 和 toast.autovacuum_vacuum_threshold

  • autovacuum_vacuum_scale_factor 和 toast.autovacuum_vacuum_scale_factor

行插入。如果仅插入行,而不删除或更新行,那么表中不会包含死元组。但是这样的表也应该被清理以提前冻结堆元组,并更新可见性映射v. 13 (从而允许使用仅索引扫描)。

如果自上次清理以来插入的行数超过了另一对类似参数所定义的阈值,那么表便会被清理:

  • autovacuum_vacuum_insert_threshold1000

  • autovacuum_vacuum_insert_scale_factor0.2

公式如下:

pg_stat_all_tables.n_ins_since_vacuum > autovacuum_vacuum_insert_threshold + autovacuum_vacuum_insert_scale_factor × pg_class.reltuples

与前面的示例一样,你可以使用存储参数在表级别覆盖这些值:

  • autovacuum_vacuum_insert_threshold 和 TOAST 相对应的参数

  • autovacuum_vacuum_insert_scale_factor 和 TOAST 相对应的参数

6.5.3 哪些表需要被分析?

自动分析只需要处理修改过的行,因此计算比自动清理要简单一些。

如果自上次分析以来修改的行数超过了以下两个配置参数所定义的阈值,那么就需要对表进行分析:

  • autovacuum_analyze_threshold50

  • autovacuum_analyze_scale_factor0.1

如果满足以下条件,则会触发自动分析:pg_stat_all_tables.n_mod_since_analyze > autovacuum_analyze_threshold + autovacuum_analyze_scale_factor × pg_class.reltuples

要覆盖特定表的自动分析设置,你可以使用同名存储参数:

  • autovacuum_analyze_threshold

  • autovacuum_analyze_scale_factor

由于不会分析 TOAST 表,因此没有相应参数。

6.5.4 自动清理实践

为了具体描述本节所述内容,让我们创建两个视图以显示当前哪些表需要被清理和分析 15。这些视图中使用的函数返回当前传递参数的值,同时考虑到这个值可以在表级别被重新定义:

=> CREATE FUNCTION p(param text, c pg_class) RETURNS float
AS $$
  SELECT coalesce(
    -- use storage parameter if set
    (SELECT option_value
     FROM pg_options_to_table(c.reloptions)
     WHERE option_name = CASE
             -- for TOAST tables the parameter name is different
             WHEN c.relkind = 't' THEN 'toast.' ELSE ''
            END || param
    ),
    -- else take the configuration parameter value
    current_setting(param)
  )::float;
$$ LANGUAGE sql;

这是与 VACUUM 相关的视图:

=> CREATE VIEW need_vacuum AS
WITH c AS (
  SELECT c.oid,
    greatest(c.reltuples, 0) reltuples,
    p('autovacuum_vacuum_threshold', c) threshold,
    p('autovacuum_vacuum_scale_factor', c) scale_factor,
    p('autovacuum_vacuum_insert_threshold', c) ins_threshold,
    p('autovacuum_vacuum_insert_scale_factor', c) ins_scale_factor
  FROM pg_class c
WHERE c.relkind IN ('r','m','t')
)
SELECT st.schemaname || '.' || st.relname AS tablename,
  st.n_dead_tup AS dead_tup,
  c.threshold + c.scale_factor * c.reltuples AS max_dead_tup,
  st.n_ins_since_vacuum AS ins_tup,
  c.ins_threshold + c.ins_scale_factor * c.reltuples AS max_ins_tup,
  st.last_autovacuum
FROM pg_stat_all_tables st
  JOIN c ON c.oid = st.relid;

max_dead_tup 列显示了触发自动清理的死元组数量,而 max_ins_tup 列则显示了与插入相关的阈值。

以下是一个类似的 analyze 视图:

=> CREATE VIEW need_analyze AS
WITH c AS (
  SELECT c.oid,
    greatest(c.reltuples, 0) reltuples,
    p('autovacuum_analyze_threshold', c) threshold,
    p('autovacuum_analyze_scale_factor', c) scale_factor
  FROM pg_class c
  WHERE c.relkind IN ('r','m')
)
SELECT st.schemaname || '.' || st.relname AS tablename,
  st.n_mod_since_analyze AS mod_tup,
  c.threshold + c.scale_factor * c.reltuples AS max_mod_tup,
  st.last_autoanalyze
FROM pg_stat_all_tables st
  JOIN c ON c.oid = st.relid;

max_mod_tup 列显示了触发自动分析的阈值。

为了加快实验,我们将每秒启动一次自动清理:

=> ALTER SYSTEM SET autovacuum_naptime = '1s';
=> SELECT pg_reload_conf();

让我们截断 vac 表,然后插入 1000 行。请注意,自动清理在表级别层面被关闭了。

=> TRUNCATE TABLE vac;
=> INSERT INTO vac(id,s)
SELECT id, 'A' FROM generate_series(1,1000) id;

此处是与 vacuum 相关的视图内容:

=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
−[ RECORD 1 ]−−−+−−−−−−−−−−−
tablename       | public.vac
dead_tup        | 0
max_dead_tup    | 50
ins_tup         | 1000
max_ins_tup     | 1000
last_autovacuum |

实际的阈值是 max_dead_tup = 50,尽管上面列出的公式表明它应该是 50 + 0.2 × 1000 = 250。问题在于,由于 INSERT 命令没有更新统计信息,所以这个表的统计信息还不可用。

=> SELECT reltuples FROM pg_class WHERE relname = 'vac';
 reltuples
−−−−−−−−−−−
        −1
(1 row)

pg_class.reltuples 值被设为 -1v. 14;这个替代零值的特殊常数用于区分没有任何统计信息的表和已经分析过的真正的空表。为了方便计算,负值被当做零值处理,因此值是 50 + 0.2 × 0 = 50。

max_ins_tup 的值是 1000,与预期的 1200 不同,原因也是一样的。

让我们看一下 analyze 视图:

=> SELECT * FROM need_analyze WHERE tablename = 'public.vac' \gx
−[ RECORD 1 ]−−−−+−−−−−−−−−−−
tablename        | public.vac
mod_tup          | 1006
max_mod_tup      | 50
last_autoanalyze |

我们已经更新了 (在这个例子中是插入) 1000 行; 因此已经超过了阈值,由于表的大小未知,所以当前被设置为 50 。这意味着当我们启用自动分析时,将会立即触发自动分析:

=> ALTER TABLE vac SET (autovacuum_enabled = on);

一旦表分析完成,阈值将被重置为合适的值:150 行。

=> SELECT reltuples FROM pg_class WHERE relname = 'vac';
 reltuples
−−−−−−−−−−−
      1000
(1 row)

=> SELECT * FROM need_analyze WHERE tablename = 'public.vac' \gx
−[ RECORD 1 ]−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
tablename        | public.vac
mod_tup          | 0
max_mod_tup      | 150
last_autoanalyze | 2023−03−06 14:00:45.533464+03

让我们回到自动清理:

=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
−[ RECORD 1 ]−−−+−−−−−−−−−−−
tablename       | public.vac
dead_tup        | 0
max_dead_tup    | 250
ins_tup         | 1000
max_ins_tup     | 1200
last_autovacuum |

基于分析统计的实际表大小,max_dead_tup 和 max_ins_tup 的值也已更新。

如果满足以下至少一个条件,将开始进行清理操作:

  • 累计超过 250 个死元组

  • 插入表中的行数超过了 200v. 13

让我们再次关闭自动清理 ,并更新 251 行,使阈值超过 1:

=> ALTER TABLE vac SET (autovacuum_enabled = off);
=> UPDATE vac SET s = 'B' WHERE id <= 251;
=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
−[ RECORD 1 ]−−−+−−−−−−−−−−−
tablename       | public.vac
dead_tup        | 251
max_dead_tup    | 250
ins_tup         | 1000
max_ins_tup     | 1200
last_autovacuum |

现在触发条件已满足。让我们启用自动清理,短暂过后,我们便会看到表已被处理,并且其使用统计信息已被重置:

=> ALTER TABLE vac SET (autovacuum_enabled = on);
=> SELECT * FROM need_vacuum WHERE tablename = 'public.vac' \gx
−[ RECORD 1 ]−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
tablename       | public.vac
dead_tup        | 0
max_dead_tup    | 250
ins_tup         | 0
max_ins_tup     | 1200
last_autovacuum | 2023−03−06 14:00:51.736815+03

6.6 管理负载

在页级别操作,清理不会阻塞其他进程;但尽管如此,它仍会增加系统负载,并且可能对性能产生明显影响。

6.6.1 Vacuum 限流

为了控制清理的强度,PostgreSQL 会在处理表的过程中定期暂停。在完成大约 vacuum_cost_limit200 个单位工作后,进程会进入休眠状态,并在 vacuum_cost_delay0 时间间隔内保持空闲。

vacuum_cost_delay 的默认值为 0,意味着例行清理实际上从不休眠,因此 vacuum_cost_limit 的确切值并没有区别。这基于如果管理员不得不手动清理,他们可能希望尽快完成的假设。

如果设置了睡眠时间,那么每当在缓冲区缓存中的页面处理上花费了 vacuum_cost_limit 个单位工作后,进程就会暂停。如果在缓冲区缓存中找到页面,那么每个页面读取的成本预估为 vacuum_cost_page_hit1 个单位,否则为 vacuum_cost_page_miss2 16。如果一个干净的页面被 VACUUM 弄脏了,它会增加额外的 vacuum_cost_page_dirty20 单位 17。

如果保持 vacuum_cost_limit 参数的默认值,VACUUM 在最佳情况下每个周期最多可以处理 200 个页面 (如果所有页面都被缓存,并且没有页面被 VACUUM 弄脏),在最坏的情况下只能处理 9 个页面 (如果所有页面都从磁盘读取,并且变脏了)。

6.6.2 Autovacuum 限流

Autovacuum 限流 18 和 VACUUM 限流十分类似。但是,Autovacuum 可以以不同的强度运行,因为它有自己的一套参数:

  • autovacuum_vacuum_cost_limit-1

  • autovacuum_vacuum_cost_delay2ms

如果这些参数中的任何一个设置为 -1,那么便会回退到常规 VACUUM 相应的参数。 因此,默认情况下,autovacuum_vacuum_cost_limit 参数依赖于 vacuum_cost_limit 的值。

在 12 版本之前,autovacuum_vacuum_cost_delay 的默认值为 20 ms,这会导致在现代硬件上的性能非常之差。

每个周期内,Autovacuum 的工作单位限制在 autovacuum_vacuum_cost_limit,并且由于此限制在所有工作进程之间共享,因此对系统的总体影响大致相同,无论其数量如何。因此,如果你需要加快自动清理的速度,那么 autovacuum_max_workers 和 autovacuum_vacuum_cost_limit 的值都应该按比例增加。

如果需要,你可以通过设置以下存储参数来覆盖特定表的这些设置:

  • autovacuum_vacuum_cost_delay 和 toast.autovacuum_vacuum_cost_delay

  • autovacuum_vacuum_cost_limit 和 toast.autovacuum_vacuum_cost_limit

6.7 监控

如果对清理操作进行监控,你可以检测到无法一次性移除死元组的情况,因为对这些死元组的引用不适合 maintenance_work_mem 内存块。在这种情况下,所有索引将不得不被完全扫描多次。对于大表来说,这可能需要相当长的时间,从而对系统造成显著负载。尽管查询不会被阻塞,但额外的 I/O 操作也会严重限制系统的吞吐量。

此类问题可以通过更频繁地清理表 (以便每次只需清理较少的元组) 或分配更多的内存来改善。

6.7.1 监控 Vacuum

当使用 VERBOSE 子句运行时,VACUUM 命令执行清理并显示状态报告信息,pg_stat_progress_vacuumv. 9.6 视图显示了已启动进程的当前状态。

分析也有类似的视图 (pg_stat_progress_analyzev. 13),尽管它通常执行得非常快并且不太可能导致问题。

让我们在表中插入更多的行,并全部更新,这样 VACUUM 就需要运行相当长的一段时间:

=> TRUNCATE vac;
=> INSERT INTO vac(id,s)
  SELECT id, 'A' FROM generate_series(1,500000) id;
=> UPDATE vac SET s = 'B';

出于演示的目的,我们将分配给 tid 数组的内存限制为 1 MB:

=> ALTER SYSTEM SET maintenance_work_mem = '1MB';
=> SELECT pg_reload_conf();

然后启动 VACUUM 命令,并在 VACUUM 运行时多次查询 pg_stat_progress_vacuum 视图:

=> VACUUM VERBOSE vac;
=> SELECT * FROM pg_stat_progress_vacuum \gx
−[ RECORD 1 ]−−−−−−+−−−−−−−−−−−−−−−−−−
pid                | 14531
datid              | 16391
datname            | internals
relid              | 16479
phase              | vacuuming indexes
heap_blks_total    | 17242
heap_blks_scanned  | 3009
heap_blks_vacuumed | 0
index_vacuum_count | 0
max_dead_tuples    | 174761
num_dead_tuples    | 174522
=> SELECT * FROM pg_stat_progress_vacuum \gx
−[ RECORD 1 ]−−−−−−+−−−−−−−−−−−−−−−−−−
pid                | 14531
datid              | 16391
datname            | internals
relid              | 16479
phase              | vacuuming indexes
heap_blks_total    | 17242
heap_blks_scanned  | 17242
heap_blks_vacuumed | 6017
index_vacuum_count | 2
max_dead_tuples    | 174761
num_dead_tuples    | 150956

该视图主要显示了:

  • phase — 当前清理阶段的名称 (我描述了主要的几个阶段,但实际上还有更多 19)

  • heap_blks_total — 表中的页面总数

  • heap_blks_scanned — 已扫描的页面数量

  • heap_blks_vacuumed —已清理的页面数量

  • index_vacuum_count — 索引扫描的次数

整体的清理进度由 heap_blks_vacuumed 与 heap_blks_total 的比率所定义,但你必须记住,由于索引扫描,这个比率会间歇性变化。事实上,更重要的是要关注清理的循环次数:如果这个值大于 1,说明分配的内存不足以一次性完成清理。

你可以在 VACUUM VERBOSE 命令的输出中看到整个过程,此时命令已经完成了:
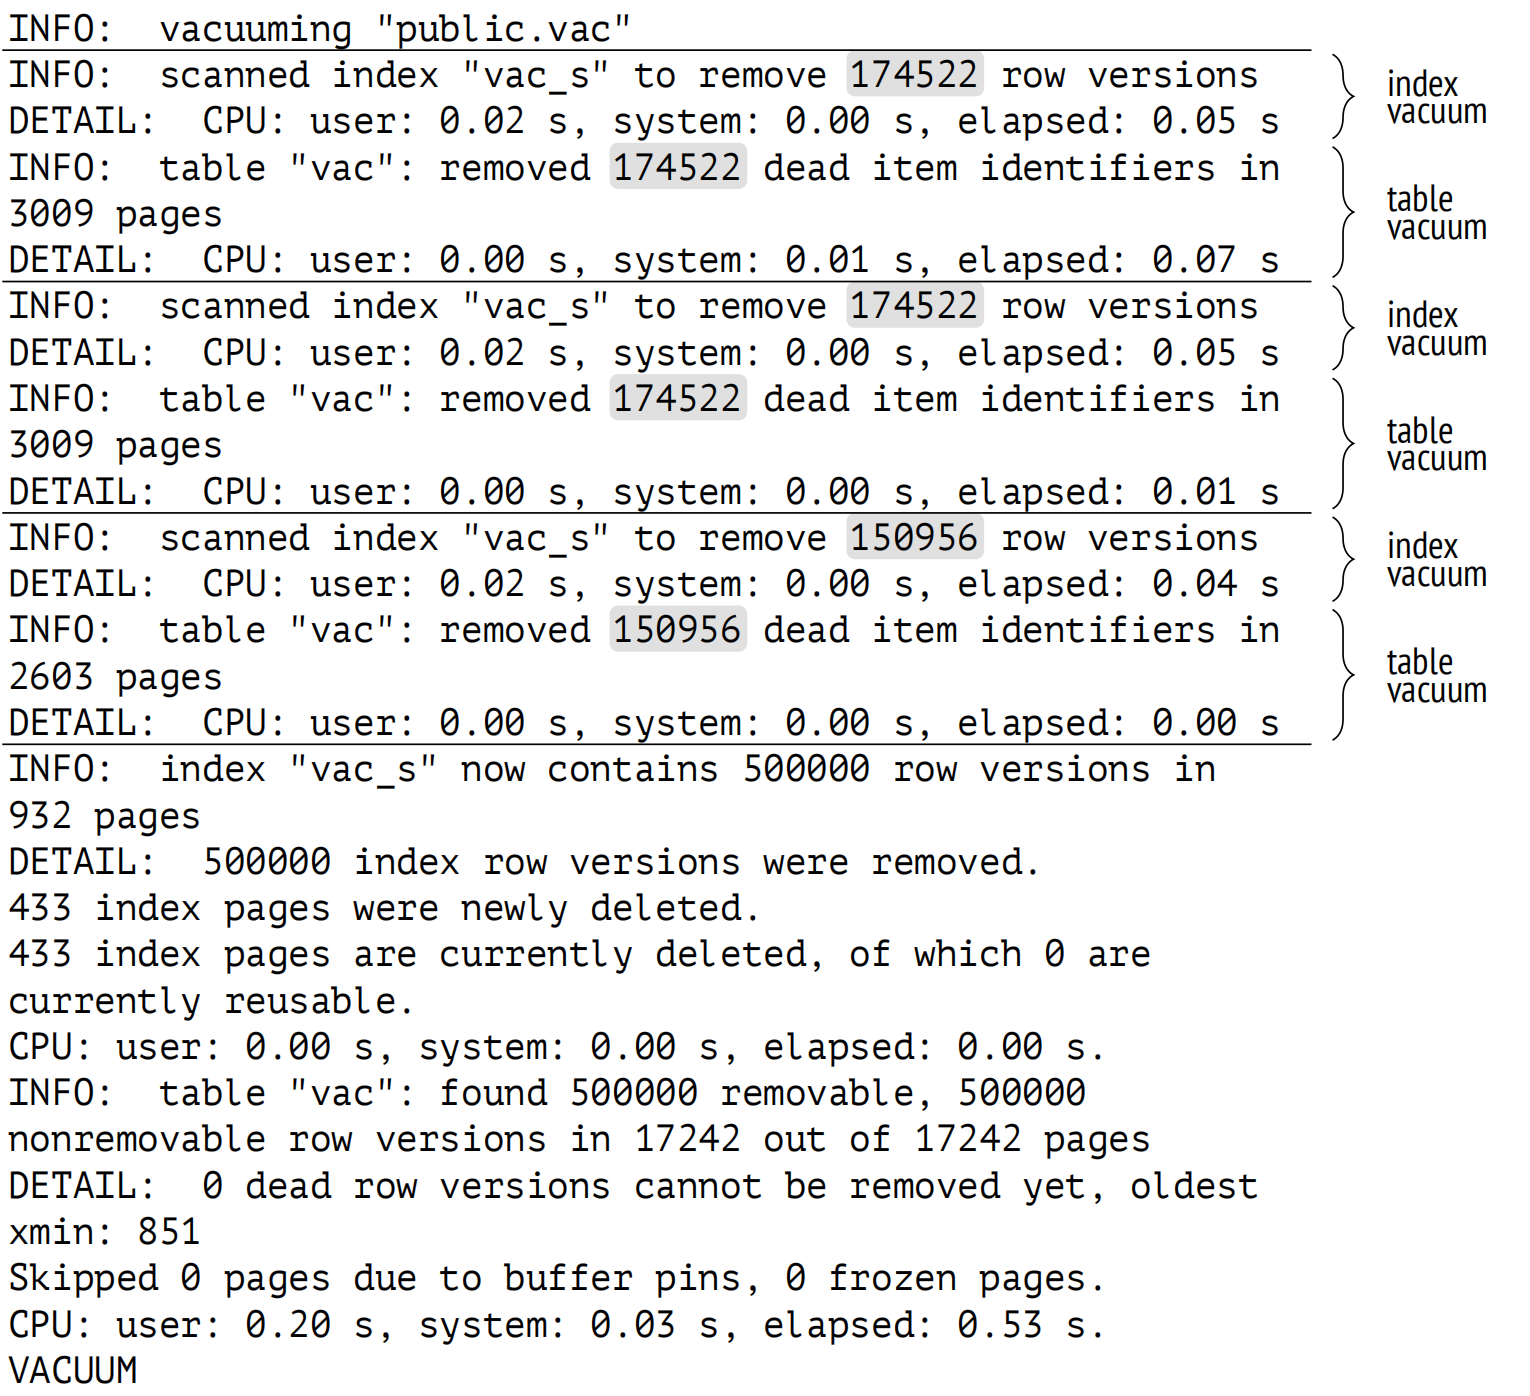
6.7.1 监控 Vacuum:插图 1
图 6.1

总而言之,进行了 3 次索引扫描; 每次扫描最多移除了 174522 个指向死元组的指针。这个值由能放入 maintenance_work_mem 中的 TID 数组指针的数量 (每个指针需要 6 个字节) 所定义。可能的最大大小由 pg_stat_progress_vacuum.max_dead_tuples 显示,但实际使用的空间总是要稍小一些。这保证了当读取下一个页面时,无论这个页面中有多少指向死元组的指针,都将适合剩余的内存。

6.7.2 监控 Autovacuum

监控 autovacuum 的主要方式是将其状态信息 (类似于 VACUUM VERBOSE 命令的输出) 打印到服务器日志中,以供进一步的分析。如果 log_autovacuum_min_duration-1 参数设置为零,则记录所有 autovacuum 的运行状况:

=> ALTER SYSTEM SET log_autovacuum_min_duration = 0;

=> SELECT pg_reload_conf();

=> UPDATE vac SET s = 'C';
UPDATE 500000
postgres$ tail -n 13 /home/postgres/logfile
2023−03−06 14:01:13.727 MSK [17351] LOG:  automatic vacuum of table
"internals.public.vac": index scans: 3
pages: 0 removed, 17242 remain, 0 skipped due to pins, 0
skipped frozen
tuples: 500000 removed, 500000 remain, 0 are dead but not
yet removable, oldest xmin: 853
index scan needed: 8622 pages from table (50.01% of total)
had 500000 dead item identifiers removed
index "vac_s": pages: 1428 in total, 496 newly deleted, 929
currently deleted, 433 reusable
avg read rate: 12.404 MB/s, avg write rate: 14.810 MB/s
buffer usage: 46038 hits, 5670 misses, 6770 dirtied
WAL usage: 40390 records, 15062 full page images, 89188595
bytes
system usage: CPU: user: 0.31 s, system: 0.33 s, elapsed:
3.57 s
2023−03−06 14:01:14.117 MSK [17351] LOG:  automatic analyze of table
"internals.public.vac"
avg read rate: 41.081 MB/s, avg write rate: 0.020 MB/s
buffer usage: 15355 hits, 2035 misses, 1 dirtied
system usage: CPU: user: 0.14 s, system: 0.00 s, elapsed:
0.38 s

为了跟踪需要被清理和分析的表列表,你可以使用我们已经审阅过的 need_vacuum 和 need_analyze 视图。如果此列表增长,这意味着自动清理无法应对负载,则需要通过减小间隔 (autovacuum_vacuum_cost_delay) 或者增加间隔内完成的工作量 (autovacuum_vacuum_cost_limit) 来加速清理。同时,并行度也可以增加 (autovacuum_max_workers)。


  1. postgresql.org/docs/14/routine-vacuuming.html ↩︎

  2. postgresql.org/docs/14/sql-vacuum.htmll
    backend/commands/vacuum.c ↩︎

  3. backend/access/heap/vacuumlazy.c, heap_vacuum_rel function ↩︎

  4. backend/access/heap/vacuumlazy.c, lazy_scan_heap function ↩︎

  5. backend/access/heap/vacuumlazy.c, lazy_vacuum_all_indexes function ↩︎

  6. commitfest.postgresql.org/21/1802 ↩︎

  7. postgresql.org/docs/14/bgworker.html ↩︎

  8. backend/access/heap/vacuumlazy.c, lazy_cleanup_all_indexes function
    backend/access/nbtree/nbtree.c, btvacuumcleanup function ↩︎

  9. backend/access/heap/vacuumlazy.c, lazy_vacuum_heap function ↩︎

  10. backend/access/heap/vacuumlazy.c, lazy_truncate_heap function ↩︎

  11. postgresql.org/docs/14/routine-vacuuming.html#VACUUM-FOR-STATISTICS ↩︎

  12. backend/commands/analyze.c ↩︎

  13. postgresql.org/docs/14/routine-vacuuming.html#AUTOVACUUM ↩︎

  14. backend/postmaster/autovacuum.c ↩︎

  15. backend/postmaster/autovacuum.c, relation_needs_vacanalyze function ↩︎

  16. backend/storage/buffer/bufmgr.c, ReadBuffer_common function ↩︎

  17. backend/storage/buffer/bufmgr.c, MarkBufferDirty function ↩︎

  18. backend/postmaster/autovacuum.c, autovac_balance_cost function ↩︎

  19. postgresql.org/docs/14/progress-reporting.html#VACUUM-PHASES ↩︎

7 冻结

7.1 事务 ID 回卷

在 PostgreSQL 中,事务 ID 占用 32 位。四十亿似乎是一个相当大的数字,但如果系统使用频繁,那么可能很快便会耗尽。例如,对于平均每秒 1000 个事务的负载 (不包括虚拟事务),在连续运行大约六周后就会发生这种情况。

一旦用完所有的数字,那么计数器必须重置以开始下一轮 (这种情况被称为"回卷")。但是,只有分配的数字在始终增加的情况下,才能认为具有较小 ID 的事务比具有较大 ID 的事务更老。因此,计数器在重置后不能简单地开始重新使用相同的数字。

为事务 ID 分配 64 位本可以彻底解决这个问题,那为什么 PostgreSQL 不使用呢?问题在于,每个元组头必须存储两个事务 ID:xmin 和 xmax。元组头目前已经相当大了 (如果考虑到数据对齐,至少 24 字节),增加更多位将会再增加 8 字节。

PostgreSQL 确实实现了 64 位事务 ID 1,通过一个 32 位 epoch 扩展了常规 ID,但它们仅在内部使用,并且从不进入数据页。

为了正确处理回卷,PostgreSQL 必须比较事务的年龄 (年龄定义为自该事务开始以来,后续出现的事务数量) 而不是事务 ID。因此,我们应该使用更老 (先于) 和更年轻 (后于) 的概念,而不是小于和大于的术语。

在代码中,这种比较方式通过使用 32 位算术实现:首先找到 32 位事务 ID 之间的差值,然后将这个结果与零进行比较 2。

为了更好地可视化这个概念,你可以将一系列事务 ID 想象成一个时钟面。对于每个事务,顺时针方向的半圆是未来,而另一半是过去。
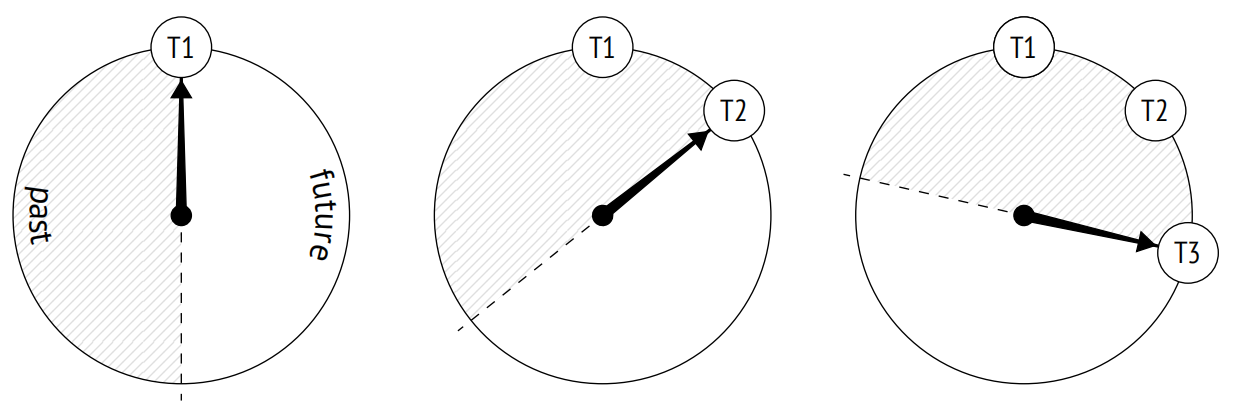
7.1 事务 ID 回卷:插图 1
图 7.1

然而,这种可视化有一个令人头疼的问题。与最近的事务相比,旧事务 (T1) 处于遥远的过去。但迟早一个新的事务会在与未来有关的半圆中看到它。如果真是这样,那将产生灾难性的影响:从现在开始,所有更新的事务都将看不到事务 T1 所做的更改。

7.2 元组冻结和可见性规则

为了防止这种"时间旅行",清理进程会执行一项额外的任务 (除了页面清理 3 ):它寻找超过数据库视界的元组 (所以这些元组在所有快照中都可见) 并以一种特殊的方式标记它们,也就是,冻结它们。

对于冻结的元组,由于这些元组已知在所有快照中都是可见的,因此可见性规则不必考虑 xmin,可以安全重用此事务 ID。

你可以想象为 xmin 事务 ID 在冻结的元组中被一个假想的"负无穷大" 所替代 (如下图所示的雪花);这表明该元组由一个过去很久的事务所创建,它的实际 ID 已经不重要了。然而,实际上 xmin 保持不变,而冻结属性由两个提示位的组合所定义:committed 和 aborted。
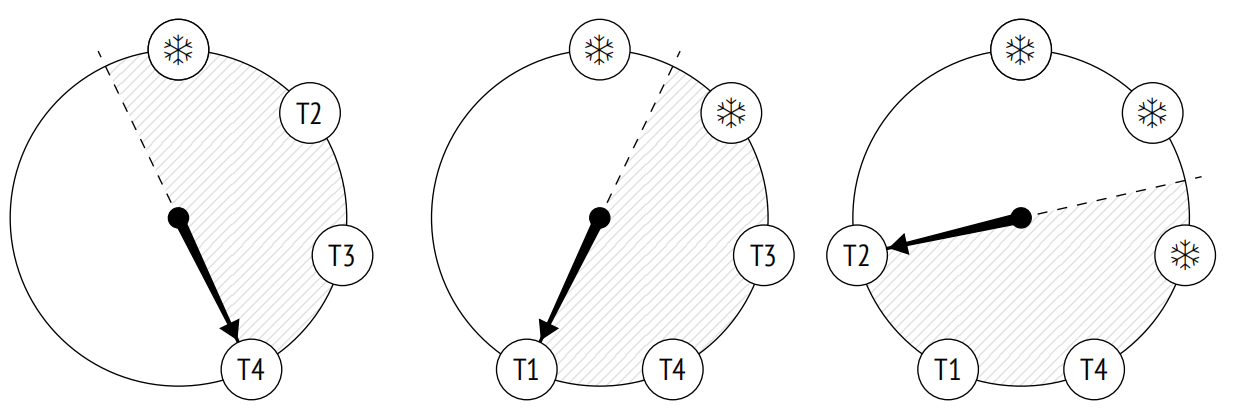
7.2 元组冻结和可见性规则:插图 2
图 7.2

许多来源 (包括文档) 都提到 FrozenTransactionId = 2。这就是我所提及的"负无穷大" — 在 9.4 之前的版本中,这个值用于替换 xmin,但现在改为使用提示位。这样一来,原来的事务 ID 保留在元组中,这对调试和支持都很方便。即使旧系统已升级到更高版本,它们仍然可能包含已废弃的 FrozenTransactionId。

xmax 事务 ID 不以任何方式参与冻结。它只存在于过期的元组中,一旦这些元组在所有快照中都不再可见 (这意味着 xmax ID 超出了数据库视界),便会将其清理掉。

为了实验,让我们创建一个新表。将 fillfactor 参数设置为最低值,以便每个页面只能容纳两个元组 — 这样跟踪进度会更容易。我们还将禁用自动清理,以确保仅在需要的时候清理表。

=> CREATE TABLE tfreeze(
  id integer,
  s char(300)
)
WITH (fillfactor = 10, autovacuum_enabled = off);

我们将创建另一个使用 pageinspect 显示堆页面的函数版本。在处理页面时,它将显示每个元组的冻结属性 (f) 和 xmin 事务年龄 (当然,它需要调用 age 系统函数 — 年龄本身并不存储在堆页面中):

=> CREATE FUNCTION heap_page(
  relname text, pageno_from integer, pageno_to integer
)
RETURNS TABLE(
  ctid tid, state text,
  xmin text, xmin_age integer, xmax text
) AS $$
SELECT (pageno,lp)::text::tid AS ctid,
       CASE lp_flags
         WHEN 0 THEN 'unused'
         WHEN 1 THEN 'normal'
         WHEN 2 THEN 'redirect to '||lp_off
         WHEN 3 THEN 'dead'
       END AS state,
       t_xmin || CASE
         WHEN (t_infomask & 256+512) = 256+512 THEN ' f'
         WHEN (t_infomask & 256) > 0 THEN ' c'
         WHEN (t_infomask & 512) > 0 THEN ' a'
         ELSE ''
       END AS xmin,
       age(t_xmin) AS xmin_age,
       t_xmax || CASE
         WHEN (t_infomask & 1024) > 0 THEN ' c'
         WHEN (t_infomask & 2048) > 0 THEN ' a'
         ELSE ''
       END AS xmax
FROM generate_series(pageno_from, pageno_to) p(pageno),
     heap_page_items(get_raw_page(relname, pageno))
ORDER BY pageno, lp;
$$ LANGUAGE sql;

现在让我们在表中插入一些行,并运行 VACUUM 命令,该命令将立即创建可见性映射。

=> CREATE EXTENSION IF NOT EXISTS pg_visibility;

=> INSERT INTO tfreeze(id, s)
  SELECT id, 'FOO'||id FROM generate_series(1,100) id;
INSERT 0 100

我们将使用 pg_visibility 扩展观察前两个堆页面。当清理完成后,这两个页面都会在可见性映射中被标记 (all_visible) ,但不在冻结映射 (all_frozenv. 9.6) 中,因为它们仍然包含一些未冻结的元组:

=> VACUUM tfreeze;
=> SELECT *
FROM generate_series(0,1) g(blkno),
     pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
 blkno | all_visible | all_frozen
−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−−−
     0 | t           | f
     1 | t           | f
(2 rows)

插入行的事务其 xmin_age 等于 1,因为它是系统中执行的最新事务:

=> SELECT * FROM heap_page('tfreeze',0,1);
  ctid | state  | xmin  | xmin_age | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−−−−+−−−−−−
 (0,1) | normal | 856 c |        1 | 0 a
 (0,2) | normal | 856 c |        1 | 0 a
 (1,1) | normal | 856 c |        1 | 0 a
 (1,2) | normal | 856 c |        1 | 0 a
(4 rows)

7.3 管理冻结

主要有四个参数用于控制冻结。它们都代表着事务年龄,并定义以下事件何时发生:

  • 冻结开始 (vacuum_freeze_min_age)

  • 执行急切冻结 (vacuum_freeze_table_age)

  • 强制冻结 (autovacuum_freeze_max_age)

  • 冻结优先 (vacuum_failsafe_agev. 14)

7.3.1 最小冻结年龄

vacuum_freeze_min_age50,000,000 参数定义了 xmin 事务的最小冻结年龄。它的值越低,开销就越大:如果一行是"热的"并且被频繁更改,那么冻结其所有新创建的行版本将是一种浪费。将此参数设置为相对较高的值可以允许等待一段时间。

为了观察冻结过程,我们将这个参数值减为 1:

=> ALTER SYSTEM SET vacuum_freeze_min_age = 1;
=> SELECT pg_reload_conf();

现在更新第零页中的一行。因为 fillfactor 值非常小,因此新的行版本将进入到同一页中:

=> UPDATE tfreeze SET s = 'BAR' WHERE id = 1;

所有事务的年龄都增加了 1,堆页面现在如下所示:

=> SELECT * FROM heap_page('tfreeze',0,1);
 ctid  | state  | xmin  |  xmin_age| xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−−−−+−−−−−−
 (0,1) | normal | 856 c |        2 | 857
 (0,2) | normal | 856 c |        2 | 0 a
 (0,3) | normal | 857 	|        1 | 0 a
 (1,1) | normal | 856 c |        2 | 0 a
 (1,2) | normal | 856 c |        2 | 0 a
(5 rows)

此时,那些比 vacuum_freeze_min_age = 1 更老的元组将被冻结。但是,vacuum 不会处理可见性映射中标记的任何页面:

=> SELECT * FROM generate_series(0,1) g(blkno),
      pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
 blkno | all_visible | all_frozen
−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−−−
     0 | f           | f
     1 | t           | f
(2 rows)

之前的 UPDATE 命令已经移除了第零页的可见性位,所以该页面中有合适的 xmin 年龄的元组都会被冻结。但是第一页将被彻底跳过:

=> VACUUM tfreeze;

=> SELECT * FROM heap_page('tfreeze',0,1);
 ctid  |     state     | xmin  | xmin_age | xmax
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−+−−−−−−−−−−+−−−−−−
 (0,1) | redirect to 3 |       |          |
 (0,2) | normal        | 856 f |        2 | 0 a
 (0,3) | normal        | 857 c |        1 | 0 a
 (1,1) | normal        | 856 c |        2 | 0 a
 (1,2) | normal        | 856 c |        2 | 0 a
(5 rows)

现在第零页再次出现在可见性映射中,如果第零页没有任何变化的话,那么 vacuum 将不会再返回到此页面:

=> SELECT * FROM generate_series(0,1) g(blkno),
     pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
 blkno | all_visible | all_frozen
−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−−−
     0 | t           | f
     1 | t           | f
(2 rows)

7.3.2 急切冻结年龄

正如我们刚刚已看到的,如果一个页面仅包含在所有快照中都可见的当前版本元组,那么 vacuum 将不会冻结它们。为了克服这个限制,PostgreSQL 提供了 vacuum_freeze_table_age150,000,000 参数。该参数定义了允许 vacuum 忽略可见性映射的事务年龄,因此可以冻结任何堆页面。

对于每个表,系统表都保留了一个事务 ID,可以确定所有比该事务 ID 更老的事务都已被冻结。这个值为 relfrozenid:

=> SELECT relfrozenxid, age(relfrozenxid)
FROM pg_class
WHERE relname = 'tfreeze';
 relfrozenxid | age
−−−−−−−−−−−−−−+−−−−−
          854 |   4
(1 row)

将此事务的年龄与 vacuum_freeze_table_age 的值进行比较,以决定是否到了进行急切冻结的时候。

得益于冻结映射,在清理期间便无需进行全表扫描v. 9.6:只需检查那些未出现在映射中的页面就足够了。除了这个重要的优化项之外,冻结映射还带来了容错能力:如果清理操作中断,下一次运行将不必回到已处理并且在映射中标记的页面。

每当系统中的事务数量达到了 vacuum_freeze_table_age − vacuum_freeze_min_age 限制时,PostgreSQL 就会对表中的所有页面进行急切冻结 (如果使用默认值,这将在每 100 百万个事务后发生) 。因此,如果 vacuum_freeze_min_age 值太大,可能会导致过度冻结并且增加开销。

要冻结整个表,让我们将 vacuum_freeze_table_age 值减小到 4,那么就满足了急切冻结的条件:

=> ALTER SYSTEM SET vacuum_freeze_table_age = 4;
=> SELECT pg_reload_conf();

执行 VACUUM 命令:

=> VACUUM VERBOSE tfreeze;
INFO:  aggressively vacuuming "public.tfreeze"
INFO:  table "tfreeze": found 0 removable, 100 nonremovable row
versions in 50 out of 50 pages
DETAIL:  0 dead row versions cannot be removed yet, oldest xmin: 858
Skipped 0 pages due to buffer pins, 0 frozen pages.
CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s.
VACUUM

现在整个表已被清理,可以推进 relfrozenid 的值 — 堆页内已确保没有更老的未冻结的 xmin 事务:

=> SELECT relfrozenxid, age(relfrozenxid)
FROM pg_class
WHERE relname = 'tfreeze';
 relfrozenxid | age
−−−−−−−−−−−−−−+−−−−−
          857 |   1
(1 row)

第一页现在只包含已冻结的元组:

=> SELECT * FROM heap_page('tfreeze',0,1);
 ctid  |     state     | xmin  | xmin_age | xmax
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−+−−−−−−−−−−+−−−−−−
 (0,1) | redirect to 3 |       |          |
 (0,2) | normal        | 856 f |        2 | 0 a
 (0,3) | normal        | 857 c |        1 | 0 a
 (1,1) | normal        | 856 f |        2 | 0 a
 (1,2) | normal        | 856 f |        2 | 0 a
(5 rows)

另外冻结映射中也已标记此页面:

=> SELECT * FROM generate_series(0,1) g(blkno),
	pg_visibility_map('tfreeze',g.blkno)
ORDER BY g.blkno;
 blkno | all_visible | all_frozen
−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−−−
     0 | t           | f
     1 | t           | t
(2 rows)

7.3.3 强制自动清理年龄

有时,仅仅配置上面讨论的两个参数以及时冻结元组是不够的。自动清理进程可能会被关闭,而常规 VACUUM 根本没有被调用 (这是一个非常糟糕的主意,但从技术上来说是可能的)。另外,一些不活跃的数据库 (比如 template0) 可能不会被清理。PostgreSQL 可以通过以急切模式强制启用自动清理来处理这种情况。

当数据库中存在某些未冻结事务 ID 的年龄超过 autovacuum_freeze_max_age200,000,000 值的风险时,将强制启动自动清理 4 (即使它已关闭)。这种行为基于所有表中最老的 pg_class.relfrozenxid 事务的年龄,因为所有更老的事务都确保已被冻结。此事务 ID 存储在系统表中:
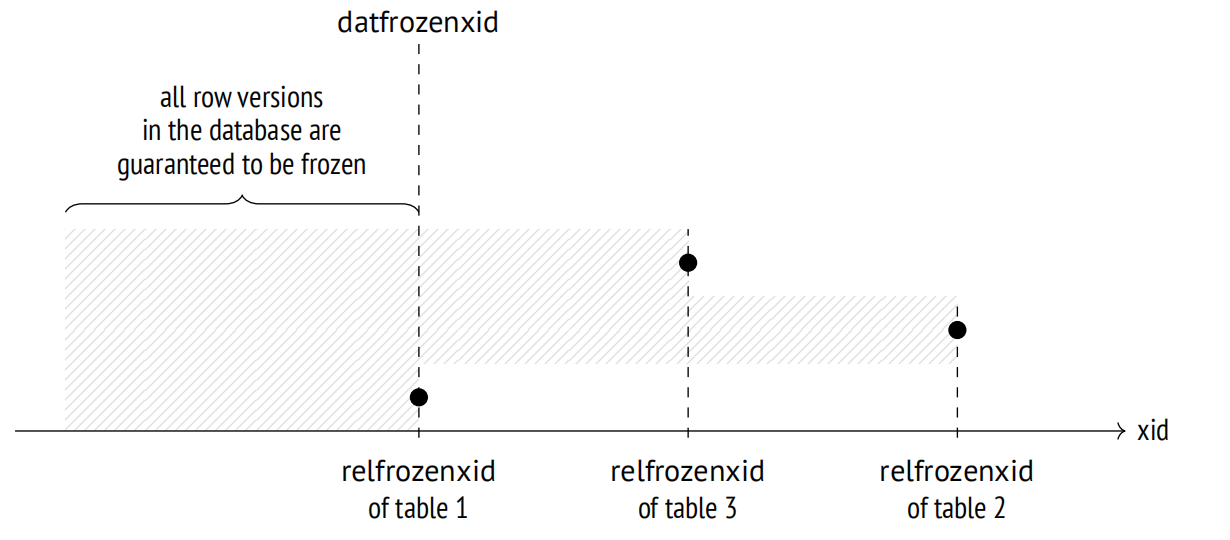
=> SELECT datname, datfrozenxid, age(datfrozenxid) FROM pg_database;
  datname  | datfrozenxid | age
−−−−−−−−−−−+−−−−−−−−−−−−−−+−−−−−
 postgres  |          726 | 132
 template1 |          726 | 132
 template0 |          726 | 132
 internals |          726 | 132
(4 rows)
7.3.3 强制自动清理年龄:插图 3
图 7.3

autovacuum_freeze_max_age 被限制在 20 亿个事务 (略小于圆的一半),默认值是这个值的十分之一。这样做是有充分理由的:较大的值会增加事务 ID 回卷的风险,因为 PostgreSQL 可能无法及时冻结所有需要的元组。在此情况下,服务器必须立即停止以防止可能的问题,并且必须由管理员重启。

autovacuum_freeze_max_age 的值也会影响到 CLOG 的大小。没有必要保留已冻结事务的状态,集簇中在 datfrozenxid 最老事务之前的所有事务都已经确保被冻结。那些不再需要的 CLOG 文件会被自动清理进程删除 5。

更改 autovacuum_freeze_max_age 参数需要重启服务器。但是,上面讨论的所有冻结设置也可以在表级别通过相应的存储参数进行调整。请注意,所有这些参数的名称都以"auto"开头:

  • autovacuum_freeze_min_age 和 toast.autovacuum_freeze_min_age

  • autovacuum_freeze_table_age 和 toast.autovacuum_freeze_table_age

  • autovacuum_freeze_max_age 和 toast.autovacuum_freeze_max_age

7.3.4 Failsafe 冻结年龄

如果自动清理进程已经在努力防止事务 ID 回卷,并且显然在与时间赛跑,那么就会"拉动"安全开关:自动清理进程将忽略 autovacuum_vacuum_cost_delay (vacuum_cost_delay) 值,并将停止清理索引以尽快冻结堆元组。

如果数据库中存在未冻结事务的年龄有超过 vacuum_failsafe_age1,600,000,000 值的风险时,那么就会启用 failsafe 模式 6。假定此值必须高于 autovacuum_freeze_max_age。

7.4 手动冻结

有时,手动管理冻结比依靠自动清理会更加方便。

7.4.1 Vacuum 时进行冻结

你可以通过调用带有 FREEZE 选项的 VACUUM 命令以开启冻结操作。这将冻结所有堆元组,不管元组的事务年龄如何,就好像 vacuum_freeze_min_age 为 0 一样。

如果这样调用的目的是为了尽快冻结堆元组,那么禁用索引清理v. 12是有意义的,就像在 failsafe 模式下所做的那样。你可以通过运行 VACUUM (freeze, index_cleanup false) 命令或通过 vacuum_index_cleanup 存储参数来显式做到这一点。很明显,这不应该定期进行,因为在这种情况下,VACUUM 将无法很好地处理其主要任务 — 页面清理。

7.4.2 在初始加载时冻结数据

在加载数据至数据库时,预估不会更改的数据可以立即被冻结。这是通过带有 FREEZE 选项的 COPY 命令来完成的。

结果表只有在同一事务中被创建或截断时,元组才能在初始加载期间被冻结,因为这两种操作都会对表获取排它锁。此限制是必要的,因为无论隔离级别如何,冻结的元组都应在所有快照中可见;否则,事务会在加载数据时突然看到刚刚冻结的元组。但如果获取了锁,其他事务将无法访问该表。

尽管如此,从技术上来说,打破隔离性仍然是可能的。让我们在一个单独的会话中以可重复读隔离级别开启一个新事务:

=> BEGIN ISOLATION LEVEL REPEATABLE READ;
=> SELECT 1; -- the shapshot is built

在同一个事务中截断 tfreeze 表并将新行插入到该表中 (如果只读事务已经访问过 tfreeze 表,TRUNCATE 命令将被阻塞。)

=> BEGIN;
=> TRUNCATE tfreeze;
=> COPY tfreeze FROM stdin WITH FREEZE;
1 FOO
2 BAR
3 BAZ
\.
=> COMMIT;

现在只读事务也看到了新数据:

=> SELECT count(*) FROM tfreeze;
 count
−−−−−−−
  	 3
(1 row)
=> COMMIT;

这确实打破了隔离性,但由于数据加载不太可能定期发生,因此在大多数情况下它不会引起任何问题。

如果在加载数据时进行冻结v. 14,那么会立即创建可见性映射,并且页头会接收到可见性属性:

=> SELECT * FROM pg_visibility_map('tfreeze',0);
 all_visible | all_frozen
−−−−−−−−−−−−−+−−−−−−−−−−−−
 t           | t
(1 row)
=> SELECT flags & 4 > 0 AS all_visible
FROM page_header(get_raw_page('tfreeze',0));
 all_visible
−−−−−−−−−−−−−
 t
(1 row)

因此,如果数据已经在加载时被冻结v. 14,那么表将不会被 VACUUM 处理 (只要数据保持不变)。不幸的是,TOAST 表尚不支持此功能:如果加载了过大的值,VACUUM 将不得不重写整个 TOAST 表,以设置所有页头中的可见性属性。


  1. include/access/transam.h, FullTransactionId type ↩︎

  2. backend/access/transam/transam.c, TransactionIdPrecedes function ↩︎

  3. postgresql.org/docs/14/routine-vacuuming.html#VACUUM-FOR-WRAPAROUND ↩︎

  4. backend/access/transam/varsup.c, SetTransactionIdLimit function ↩︎

  5. backend/commands/vacuum.c, vac_truncate_clog function ↩︎

  6. backend/access/heap/vacuumlazy.c, lazy_check_wraparound_failsafe function ↩︎

8 重建表与索引

8.1 完全清理

8.1.1 为什么例行清理不够?

与页剪枝相比,例行清理可以释放更多空间,但有时这可能仍然不够。

如果表或索引文件的大小增加了,VACUUM 可以清理一些页内空间,但很少能减少页面的数量。只有当文件末尾出现若干空页面时,回收的空间才能返还给操作系统,但这种情况并不常见。

大小过大会导致诸多不良影响:

  • 全表 (或索引) 扫描将花费更长时间。

  • 可能需要更大的缓冲区缓存 (页面作为一个整体被缓存,因此数据密度降低)。

  • B 树会有额外的层级,这会减慢索引访问的速度。

  • 文件在磁盘上和备份中占用额外空间。

如果文件中有用数据的比例下降至某个合理水平以下,管理员可以通过运行 VACUUM FULL 命令 1 来执行完全清理。在此情况下,表和其所有索引都将从头重建,并且数据会被尽可能密集地组织在一起 (同时考虑到 fillfactor 参数)。

当执行完全清理时,PostgreSQL 首先会完全重建表,然后重建它的每一个索引。在重建期间,新旧文件都需要存储在磁盘上 2,因此该过程可能需要大量的空闲空间。

你还应该记住,此操作会完全阻塞对表的访问,包括读取和写入。

8.1.2 评估数据密度

为了举例说明,让我们在表中插入一些行:

=> TRUNCATE vac;
=> INSERT INTO vac(id,s)
SELECT id, id::text FROM generate_series(1,500000) id;

存储密度可以使用 pgstattuple 扩展来评估:

=> CREATE EXTENSION pgstattuple;
=> SELECT * FROM pgstattuple('vac') \gx
−[ RECORD 1 ]−−−−−−+−−−−−−−−−
table_len          | 70623232
tuple_count        | 500000
tuple_len          | 64500000
tuple_percent      | 91.33
dead_tuple_count   | 0
dead_tuple_len     | 0
dead_tuple_percent | 0
free_space         | 381844
free_percent       | 0.54

此函数读取整个表并显示其文件中空间分布的统计数据。tuple_percent 字段显示了有用数据 (堆元组) 占用空间的百分比。由于页面内有各种元数据,这个值不可避免地会小于 100%,但在这个例子中仍然相当高。

对于索引,显示的信息略有不同,但 avg_leaf_density 字段含义相同:它显示了有用数据的百分比 (在 B 树叶子页面中)。

=> SELECT * FROM pgstatindex('vac_s') \gx
−[ RECORD 1 ]−−−−−−+−−−−−−−−−−
version            | 4
tree_level         | 3
index_size         | 114302976
root_block_no      | 2825
internal_pages     | 376
leaf_pages         | 13576
empty_pages        | 0
deleted_pages      | 0
avg_leaf_density   | 53.88
leaf_fragmentation | 10.59

之前使用的 pgstattuple 函数会完整读取表或索引以获得精确的统计数据。对于大型对象,这可能会耗费太多资源,因此该扩展还提供了另一个名为 pgstattuple_approx 的函数,该函数会跳过可见性映射中跟踪的页面,以显示近似数据。

一种更快但精度更低的方式是使用系统表粗略估算数据量与文件大小之间的比例 3。

以下是表及其索引的当前大小:

=> SELECT pg_size_pretty(pg_table_size('vac')) AS table_size,
        pg_size_pretty(pg_indexes_size('vac')) AS index_size;
 table_size | index_size
−−−−−−−−−−−−+−−−−−−−−−−−−
 67 MB      | 109 MB
(1 row)

现在让我们删除 90% 的行:

=> DELETE FROM vac WHERE id % 10 != 0;
DELETE 450000

例行清理不会缩减文件大小,因为文件末尾没有空页面:

=> VACUUM vac;
=> SELECT pg_size_pretty(pg_table_size('vac')) AS table_size,
				pg_size_pretty(pg_indexes_size('vac')) AS index_size;
 table_size | index_size
−−−−−−−−−−−−+−−−−−−−−−−−−
 67 MB      | 109 MB
(1 row)

但是,数据密度下降了大约 10 倍:

=> SELECT vac.tuple_percent, vac_s.avg_leaf_density
FROM pgstattuple('vac') vac, pgstatindex('vac_s') vac_s;
 tuple_percent | avg_leaf_density
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−
          9.13 |             6.71
(1 row)

表和索引当前位于以下文件中:

=> SELECT pg_relation_filepath('vac') AS vac_filepath,
        pg_relation_filepath('vac_s') AS vac_s_filepath \gx
−[ RECORD 1 ]−−+−−−−−−−−−−−−−−−−−
vac_filepath   | base/16391/16514
vac_s_filepath | base/16391/16515

让我们检查一下在 VACUUM FULL 之后会发生什么。当该命令运行时,可以在 pg_stat_progress_clusterv. 12 视图中跟踪其进度 (与为 VACUUM 提供的 pg_stat_progress_vacuum 视图类似):

=> VACUUM FULL vac;
=> SELECT * FROM pg_stat_progress_cluster \gx
−[ RECORD 1 ]−−−−−−−+−−−−−−−−−−−−−−−−−
pid                 | 19488
datid               | 16391
datname             | internals
relid               | 16479
command             | VACUUM FULL
phase               | rebuilding index
cluster_index_relid | 0
heap_tuples_scanned | 50000
heap_tuples_written | 50000
heap_blks_total     | 8621
heap_blks_scanned 	| 8621
index_rebuild_count | 0

如预期那样, VACUUM FULL 的各个阶段 4 与常规清理有所不同。

完全清理已用新文件替换了旧文件:

=> SELECT pg_relation_filepath('vac') AS vac_filepath,
        pg_relation_filepath('vac_s') AS vac_s_filepath \gx
−[ RECORD 1 ]−−+−−−−−−−−−−−−−−−−−
vac_filepath   | base/16391/16526
vac_s_filepath | base/16391/16529

现在索引和表的大小都小多了:

=> SELECT pg_size_pretty(pg_table_size('vac')) AS table_size,
        pg_size_pretty(pg_indexes_size('vac')) AS index_size;
 table_size | index_size
−−−−−−−−−−−−+−−−−−−−−−−−−
 6904 kB    | 6504 kB
(1 row)				

结果,数据密度也增加了。对于索引,数据密度甚至比原来的还要高:基于现有数据从头开始创建一棵 B 树比将条目逐行插入到已经存在的索引中更加有效:

=> SELECT vac.tuple_percent,
          vac_s.avg_leaf_density
FROM pgstattuple('vac') vac,
     pgstatindex('vac_s') vac_s;
 tuple_percent | avg_leaf_density
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−
         91.23 |            91.08
(1 row)

8.1.3 冻结

当表被重建时,PostgreSQL 会冻结其元组,因为与剩余工作相比,这个操作的成本几乎可以忽略不计:

=> SELECT * FROM heap_page('vac',0,0) LIMIT 5;
 ctid  | state  | xmin  | xmin_age | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−−−−+−−−−−−
 (0,1) | normal | 861 f |        5 | 0 a
 (0,2) | normal | 861 f |        5 | 0 a
 (0,3) | normal | 861 f |        5 | 0 a
 (0,4) | normal | 861 f |        5 | 0 a
 (0,5) | normal | 861 f |        5 | 0 a
(5 rows)

但是页面既没有在可见性映射中标记,也没有在冻结映射中标记,而且页头也没有可见性属性 (这在使用带有 FREEZE 选项的 COPY 命令时是会发生的):

=> SELECT * FROM pg_visibility_map('vac',0);
 all_visible | all_frozen
−−−−−−−−−−−−−+−−−−−−−−−−−−
 f           | f
(1 row)
=> SELECT flags & 4 > 0 all_visible
FROM page_header(get_raw_page('vac',0));
 all_visible
−−−−−−−−−−−−−
 f
(1 row)

仅在调用 VACUUM (或触发 autovacuum) 之后,情况才有所改善:

=> VACUUM vac;
=> SELECT * FROM pg_visibility_map('vac',0);
 all_visible | all_frozen
−−−−−−−−−−−−−+−−−−−−−−−−−−
 t           | t
(1 row)
=> SELECT flags & 4 > 0 AS all_visible
FROM page_header(get_raw_page('vac',0));
 all_visible
−−−−−−−−−−−−−
 t
(1 row)

这基本上意味着,即使页面中的所有元组都超出了数据库的视界,这样的页面仍然需要被重写。

8.2 其他重建方式

8.2.1 完全清理的替代方式

除了 VACUUM FULL 之外,还有其他几个可以完全重建表和索引的命令。这些命令都会以排它方式锁定表,删除旧的数据文件并重建。

CLUSTER 命令与 VACUUM FULL 完全类似,但它还会根据可用索引之一对文件中的元组进行重新排序。在某些情况下,它可以帮助规划器更加有效地使用索引扫描。但是你应该记住,PostgreSQL 不支持聚簇:所有后续的表更新都会破坏元组的物理顺序。

从编程角度来看,VACUUM FULL 只是 CLUSTER 命令的一个特例,不需要对元组重新排序 5。

REINDEX 命令用于重建一个或多个索引 6。实际上,VACUUM FULL 和 CLUSTER 在重建索引时底层会使用这个命令。

TRUNCATE 命令 7 会删除表中所有的行;它与运行不带有 WHERE 子句的 DELETE 命令的逻辑等效。但是, DELETE 只是将堆元组标记为已删除 (因此它们仍然需要被清理),而 TRUNCATE 则是创建一个新的空文件,这通常更快。

8.2.2 减少重建期间的停机时间

VACUUM FULL 并不意味着要定期运行,因为它会在整个操作过程期间对表进行排它锁定 (对查询也是如此)。对于高可用系统来说,这通常不是一个选项。

有几个扩展 (例如 pg_repack 8) 可以在几乎零停机的情况下重建表和索引。排它锁仍然是必需的,但只在重建的开始与结束时刻,而且只需要很短的时间。这是通过更复杂的机制来实现的:在重建原始表时,所有对原始表所做的更改都由触发器保存,然后应用于新表。最后阶段,pg_repack 会用一个系统目录中的表替换原表。

pgcompacttable 工具 9 提供了一个非传统的解决方案。它执行多次伪行更新 (不更改任何数据),使得当前行版本逐渐移向文件的开头。

在这些更新操作期间,清理进程会移除过期的元组,并一点一点截断文件。这种方法需要更多的时间和资源,但它不需要额外的空间来重建表并且不会导致负载高峰。在截断表时,仍然会获取短暂的排它锁,但清理操作处理起来相当平滑。

8.3 预防措施

8.3.1 只读查询

文件膨胀的原因之一是执行长时间运行的事务,这些事务在密集更新数据的同时保持着数据库视界。

长时间运行 (只读) 事务并不会导致任何问题。因此,一种常见的方式是在不同系统之间分配负载:在主库上执行快速的 OLTP 查询,并将所有 OLAP 事务转移到备库。尽管这使得解决方案变得更加昂贵和复杂,但这些措施可能是不可或缺的。

在某些情况下,长事务是应用程序或驱动 BUG 的结果,而不是必需的。如果问题无法以优雅的方式解决,管理员可以使用以下两个参数:

  • old_snapshot_thresholdv. 9.6 参数定义了快照的最大生命周期。一旦到达此时间,服务器便有权移除过期的元组;如果长时间运行的事务仍然需要它们,那么便会出现 “snapshot too old” 的错误。

  • idle_in_trasaction_session_timeoutv. 9.6 参数限制了空闲事务的生命周期。事务一旦达到此阈值后,便会被中止。

8.3.2 数据更新

膨胀的另一个原因是同时修改了大量元组。如果所有行都更新了,元组的数量可能会翻倍,而清理操作可能没有足够的时间进行干预。页剪枝可以减缓这个问题,但并不能完全解决它。

让我们扩展输出,增加另一列以跟踪处理过的行:

=> ALTER TABLE vac ADD processed boolean DEFAULT false;
=> SELECT pg_size_pretty(pg_table_size('vac'));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 6936 kB
(1 row)

一旦所有的行都更新了,表的大小几乎增加了一倍:

=> UPDATE vac SET processed = true;
UPDATE 50000
=> SELECT pg_size_pretty(pg_table_size('vac'));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 14 MB
(1 row)

为了解决这种情况,你可以减少单个事务执行的更改数量,将它们分散到不同的时间点上;然后清理操作便可以移除过期的元组,并在现有页面中为新元组腾出一些空间。假设每个行更新可以单独提交,我们可以使用以下查询作为模板,该查询选择一批指定大小的行:

SELECT ID
FROM table
WHERE filtering the already processed rows
LIMIT batch size
FOR UPDATE SKIP LOCKED

这段代码选择并立即锁定一组不超过指定大小的行。已被其他事务锁定的行将被跳过:下次它们会进入另一个批次。这是一个相当灵活和方便的解决方案,允许你轻松更改批次大小,并在故障发生时重新开始操作。让我们恢复 processed 属性,并执行完全清理以恢复表的原始大小:

=> UPDATE vac SET processed = false;
=> VACUUM FULL vac;

第一批次更新之后,表的大小会略有增长:

=> WITH batch AS (
  SELECT id FROM vac WHERE NOT processed LIMIT 1000
  FOR UPDATE SKIP LOCKED
)
UPDATE vac SET processed = true
WHERE id IN (SELECT id FROM batch);
UPDATE 1000
=> SELECT pg_size_pretty(pg_table_size('vac'));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 7064 kB
(1 row)

但从现在开始,表的大小几乎保持不变,因为新的元组替换了被移除的元组:

=> VACUUM vac;
=> WITH batch AS (
	SELECT id FROM vac WHERE NOT processed LIMIT 1000
	FOR UPDATE SKIP LOCKED
)
UPDATE vac SET processed = true
WHERE id IN (SELECT id FROM batch);
UPDATE 1000
=> SELECT pg_size_pretty(pg_table_size('vac'));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 7072 kB
(1 row)

  1. postgresql.org/docs/14/routine-vacuuming.html#VACUUM-FOR-SPACE-RECOVERY ↩︎

  2. backend/commands/cluster.c ↩︎

  3. wiki.postgresql.org/wiki/Show_database_bloat ↩︎

  4. postgresql.org/docs/14/progress-reporting.html#CLUSTER-PHASES ↩︎

  5. backend/commands/cluster.c ↩︎

  6. backend/commands/indexcmds.c ↩︎

  7. backend/commands/tablecmds.c, ExecuteTruncate function ↩︎

  8. github.com/reorg/pg_repack ↩︎

  9. github.com/dataegret/pgcompacttable ↩︎

第二部分:缓冲区缓存与预写日志

第二部分:缓冲区缓存与预写日志。

本分部页按原书结构编排,用于中英目录对照。

9 缓冲区缓存

9.1 缓存

在现代计算机系统中,缓存无处不在 — 不管是在硬件层面还是在软件层面。仅处理器自身就可能有多达三到四层缓存。RAID 控制器和磁盘也有它们自己的缓存。

缓存用于平衡高速与低速内存之间的性能差异。高速内存昂贵且容量更小,而低速内存更大且更便宜。因此,高速内存无法容纳所有存储在低速内存中的数据。但在大多数情况下,每个特定时刻只有一小部分数据被频繁使用,因此为缓存分配一些高速内存以保持热数据,可以显著减少低速内存访问所带来的开销。

在 PostgreSQL 中,缓冲区缓存 1 中保存着关系页面,以平衡对磁盘 (毫秒级) 和 RAM (纳秒级) 的访问时间。

出于同样目的,操作系统也有其自己的缓存。基于此,数据库系统通常被设计为要避免双缓存:通常直接查询存储在磁盘上的数据,绕过 OS 缓存。但是 PostgreSQL 使用了不同的方式:它通过缓冲区文件操作来读取和写入所有的数据。

如果使用 Direct I/O ,那么便可以避免双缓存的问题。这将减少开销,因为 PostgreSQL 将使用直接内存访问 (DMA) 而不是将缓冲区页面复制到操作系统地址空间中;此外,你将直接控制磁盘上的物理写入。然而,Direct I/O 不支持数据预取 (Buffered I/O 支持预取),因此你必须通过异步 I/O 单独实现它,这需要在 PostgreSQL 内核代码中进行大量的修改,以及处理操作系统在 Direct I/O 和异步 I/O 支持方面的不兼容问题。但一旦建立了异步通信,你便可以享受到无等待磁盘访问的额外好处。

PostgreSQL 社区已经开始了这项重大工程 2,但实际结果仍需要很长时间才能出现。

9.2 缓冲区缓存设计

缓冲区缓存位于服务器的共享内存中,所有进程都可以访问。它占据了大部分的共享内存,并且无疑是 PostgreSQL 中最重要和最复杂的数据结构之一。理解缓存的工作原理本身就很重要,但更重要的是,许多其他结构 (例如子事务、CLOG 事务状态和 WAL 条目) 使用类似的缓存机制,尽管这些结构更简单一些。

这个缓存的名称受其内部结构的启发,因为它由一系列缓冲区组成。每个缓冲区保留了一个内存块,可以容纳单个数据页及其页头 3。
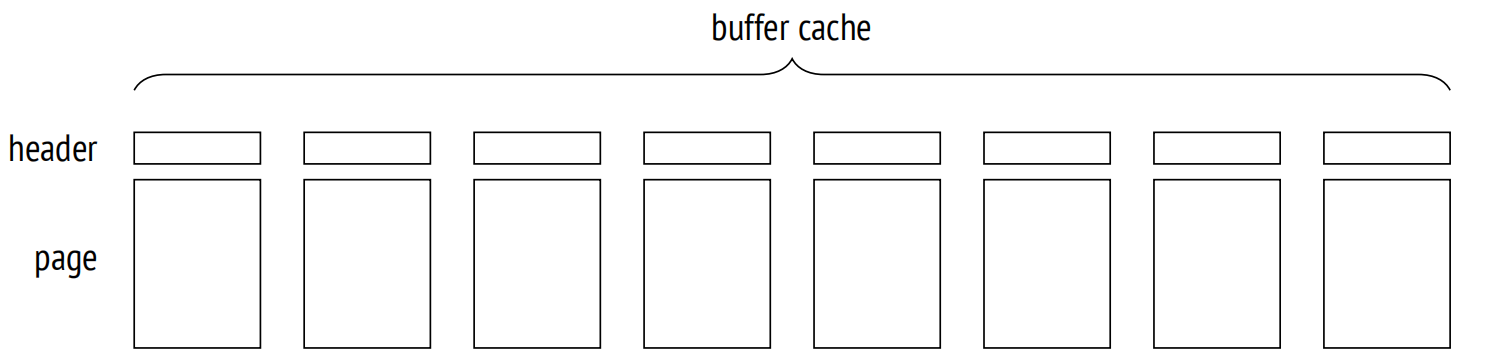
9.2 缓冲区缓存设计:插图 1
图 9.1

页头包含了一些关于缓冲区和其中页面的信息,比如:

  • 页面的物理位置 (文件 ID、分支和分支中的块号)

  • 用于显示页面中的数据已被修改,并且需要回写到磁盘的属性 (这样的页面被称为脏页)

  • 缓冲区使用计数

  • 锁定计数 (或者引用计数)

要访问表的数据页,进程会向缓冲区管理器 4 请求它,并接收包含该页的缓冲区 ID。然后,读取缓存数据并在需要时直接在缓存中修改它。当页面正在使用时,其缓冲区被锁定。锁定过程会禁止逐出缓存页面,并且可以与其他锁一起使用。每次锁定也会增加使用计数。

只要页面被缓存,它的使用就不会产生任何文件操作。

我们可以使用 pg_buffercache 扩展来窥探缓冲区缓存:

=> CREATE EXTENSION pg_buffercache;

让我们创建一个表并插入一行:

=> CREATE TABLE cacheme(
  id integer
) WITH (autovacuum_enabled = off);
=> INSERT INTO cacheme VALUES (1);

现在缓冲区缓存包含一个带有新插入行的堆页面。你可以通过选择与特定表相关的所有缓冲区进行查看。由于需要多次执行这样的查询,所以让我们将其封装至一个函数中:

=> CREATE FUNCTION buffercache(rel regclass)
RETURNS TABLE(
  bufferid integer, relfork text, relblk bigint,
  isdirty boolean, usagecount smallint, pins integer
) AS $$
SELECT bufferid,
  CASE relforknumber
    WHEN 0 THEN 'main'
    WHEN 1 THEN 'fsm'
    WHEN 2 THEN 'vm'
  END,
  relblocknumber,
  isdirty,
  usagecount,
  pinning_backends
FROM pg_buffercache
WHERE relfilenode = pg_relation_filenode(rel)
ORDER BY relforknumber, relblocknumber;
$$ LANGUAGE sql;

=> SELECT * FROM buffercache('cacheme');
 bufferid | relfork | relblk | isdirty | usagecount | pins
−−−−−−−−−−+−−−−−−−−−+−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−−+−−−−−−
      268 | main    |      0 | t       |          1 |    0
(1 row)

页面是脏的:它已经被修改,但尚未写入磁盘。它的使用计数设置为 1。

9.3 缓存命中

当缓冲区管理器需要读取一个页面时 5,它首先会检查缓冲区缓存。

所有缓冲区 ID 都存储在一个哈希表中 6,用于加速它们的搜索。

许多现代编程语言将哈希表作为基础数据类型之一。哈希表通常被称为关联数组,实际上,从用户的角度来看,它们确实看起来像一个数组。但是,它们的索引 (哈希键) 可以是任何数据类型,例如一个文本字符串,而不是一个整数。

虽然可能的键值范围会非常大,但哈希表一次性永远不会包含那么多不同的值。哈希的思想是使用哈希函数将键值转换为一个整数。这个数字 (或这个数字的某些位) 被用作常规数组的索引。这个数组的元素被称为哈希表桶。

一个好的哈希函数在桶之间或多或少均匀地分配哈希键,但它仍然可能为不同的键分配相同的数字,从而将它们放入到同一个桶中;这种情况被称为哈希碰撞。因此,值与哈希键一起存储在桶中;要通过其键访问哈希值,PostgreSQL 必须检查所有存储在桶中的键。

哈希表有多种实现方式;在所有可能的选项中,缓冲区缓存使用的是可扩展哈希表,通过链解决哈希碰撞 7。

哈希键由表文件的 ID、分支类型和此分支文件中的页面 ID 组成。因此,知道页面后,PostgreSQL 便可以快速找到包含该页面的缓冲区,或确认该页面当前没有被缓存。
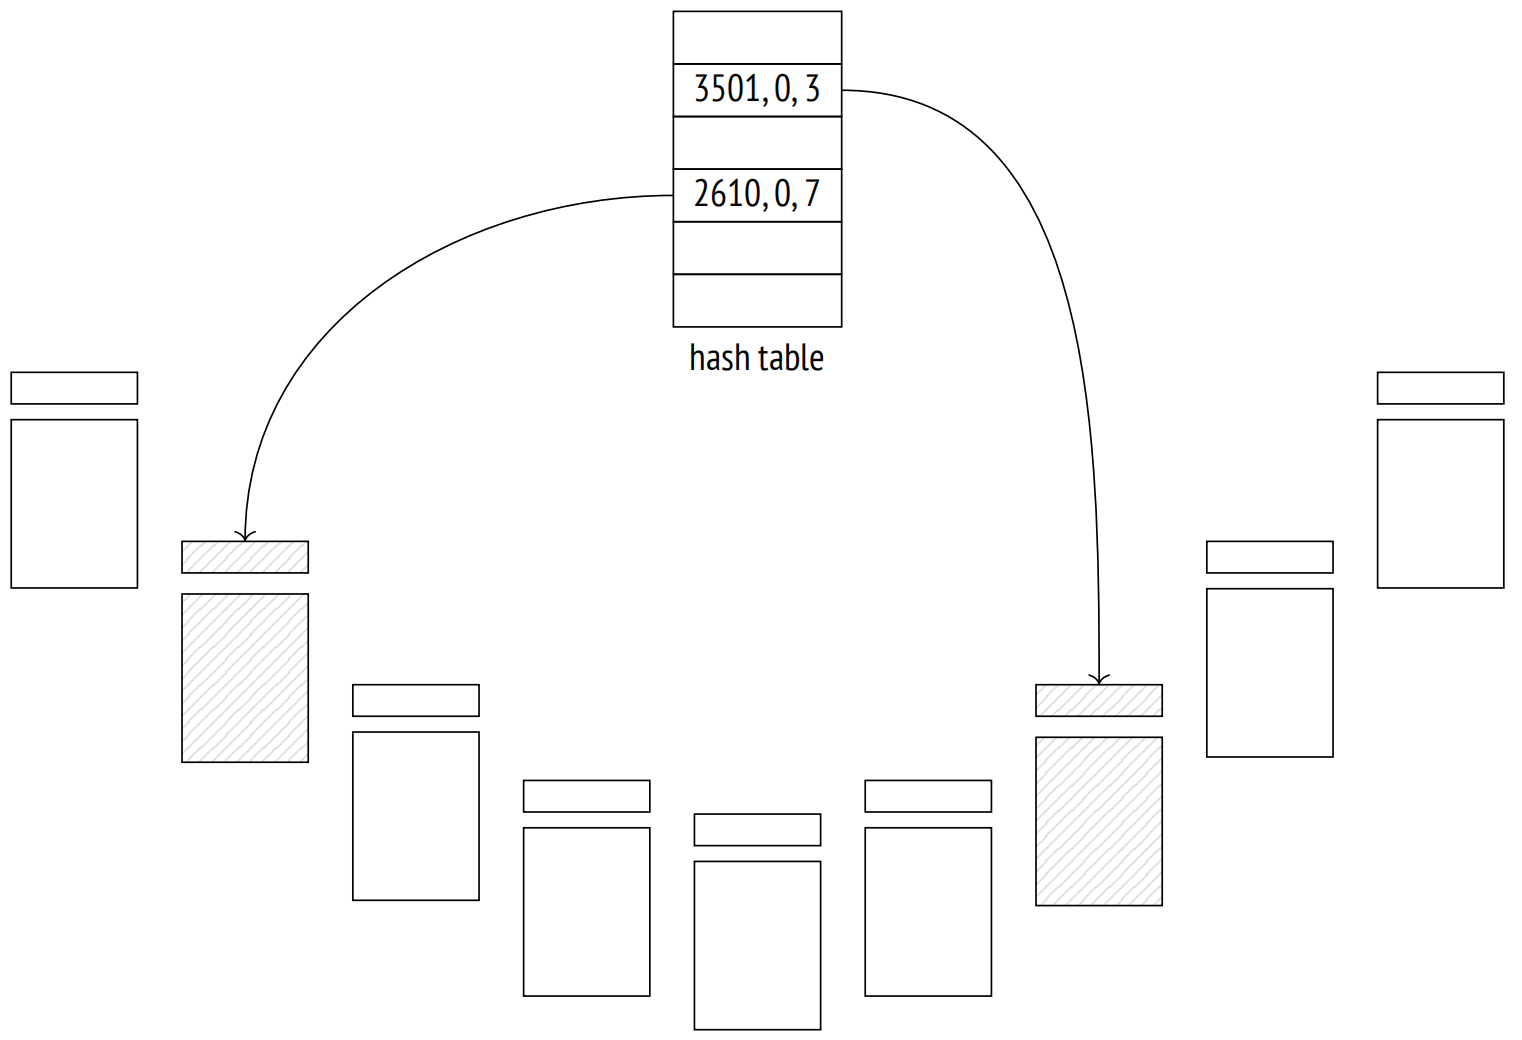
9.3 缓存命中:插图 2
图 9.2

长期以来,缓冲区缓存的实现因依赖于哈希表而饱受批评:当需要查找某个特定关系的页面所占用的所有缓冲区时,这种结构是没有用的,因为在运行 DROP 和 TRUNCATE 命令,或在清理期间截断一个表时 8,需要从缓存中移除页面。然而,到目前为止还没有人提出适当的替代方案。

如果哈希表包含所需的缓冲区 ID,缓冲区管理器会锁定此缓冲区并将其 ID 返回给进程。然后这个进程便可以开始使用缓存页面,而不会产生任何 I/O 流量。

为了锁定一个缓冲区,PostgreSQL 必须在其头部增加锁定计数;一个缓冲区可以同时被多个进程锁定。当其锁定计数大于零时,表明该缓冲区正在使用,不允许对其内容进行根本性的更改。例如,可以出现一条新的元组 (按照可见性规则,它将是不可见的),但页面本身不能被替换。

当使用 analyze 和 buffers 选项运行时,EXPLAIN 命令会执行所展示的执行计划,并显示使用的缓冲区数量:

=> EXPLAIN (analyze, buffers, costs off, timing off, summary off)
  SELECT * FROM cacheme;
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on cacheme (actual rows=1 loops=1)
   Buffers: shared hit=1
 Planning:
   Buffers: shared hit=12 read=7
(4 rows)

此处 hit = 1 意味着在缓存中找到了唯一需要读取的页面。

锁定缓冲区操作使得使用计数增加了 1:

=> SELECT * FROM buffercache('cacheme');
 bufferid | relfork | relblk | isdirty | usagecount | pins
−−−−−−−−−−+−−−−−−−−−+−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−−+−−−−−−
      268 | main    |      0 | t       |          2 |    0
(1 row)

为了在查询执行期间观察锁定行为,让我们打开一个游标 — 它将保持缓冲区锁定,因为它需要提供对结果集中下一行的快速访问:

=> BEGIN;
=> DECLARE c CURSOR FOR SELECT * FROM cacheme;
=> FETCH c;
 id
−−−−
  1
(1 row)
=> SELECT * FROM buffercache('cacheme');
 bufferid | relfork | relblk | isdirty | usagecount | pins
−−−−−−−−−−+−−−−−−−−−+−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−−+−−−−−−
      268 | main    |      0 | t       |          3 |    1
(1 row)

如果某个进程无法使用被锁定的缓冲区,该进程通常会跳过它,并简单地选择另外一个缓冲区。我们可以在表清理期间看到这一点:

=> VACUUM VERBOSE cacheme;
INFO: vacuuming "public.cacheme"
INFO: table "cacheme": found 0 removable, 0 nonremovable row
versions in 1 out of 1 pages
DETAIL: 0 dead row versions cannot be removed yet, oldest xmin:
877
Skipped 1 page due to buffer pins, 0 frozen pages.
CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s.
VACUUM

因为无法从被锁定的缓冲区中物理移除元组,所以页面被跳过了。

但如果的确需要这个缓冲区,那么进程将加入到队列中,并等待对这个缓冲区的独占访问。此操作的一个示例是带有 freeze 的清理操作 9。

一旦游标关闭或移动到另一个页面,缓冲区就会被取消锁定。在此示例中,这发生在事务结束时:

=> COMMIT;
=> SELECT * FROM buffercache('cacheme');
 bufferid | relfork | relblk | isdirty | usagecount | pins
−−−−−−−−−−+−−−−−−−−−+−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−−+−−−−−−
      268 | main    |      0 | t       |          3 |    0
      310 | vm      |      0 | f       |          2 |    0
(2 rows)

页面修改也受相同的锁定机制保护。例如,让我们再向表中插入另一行 (它会进入同一页面):

=> INSERT INTO cacheme VALUES (2);
=> SELECT * FROM buffercache('cacheme');
 bufferid | relfork | relblk | isdirty | usagecount | pins
−−−−−−−−−−+−−−−−−−−−+−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−−+−−−−−−
      268 | main    |      0 | t       |          4 |    0
      310 | vm      |      0 | f       |          2 |    0
(2 rows)

PostgreSQL 不会立即执行任何磁盘写入操作:页面会在缓冲区缓存中保持脏的状态一段时间,这为读取和写入操作带来了一些性能提升。

9.4 缓存未命中

如果哈希表中没有与查询页面相关的条目,那意味着这个页面没有被缓存。在此情况下,将分配一个新的缓冲区 (并立即锁定),随后页面被读入此缓冲区中,哈希表引用也相应地被修改。

让我们重启实例以清除缓冲区缓存:

postgres$ pg_ctl restart -l /home/postgres/logfile

尝试读取页面会导致缓存未命中,页面将被加载到一个新的缓冲区中:

=> EXPLAIN (analyze, buffers, costs off, timing off, summary off)
 SELECT * FROM cacheme;
                QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on cacheme (actual rows=2 loops=1)
   Buffers: shared read=1 dirtied=1
 Planning:
   Buffers: shared hit=15 read=7
(4 rows)

现在计划显示的是 read 状态,而不是 hit,这表明缓存未命中。此外,由于查询修改了一些提示位,这个页面已经变成了脏页。

缓冲区缓存查询显示,新添加页面的使用计数被设置为 1:

=> SELECT * FROM buffercache('cacheme');
 bufferid | relfork | relblk | isdirty | usagecount | pins
−−−−−−−−−−+−−−−−−−−−+−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−−+−−−−−−
       98 | main    |      0 | t       |          1 |    0
(1 row)

pg_statio_all_tables 视图包含表的缓冲区缓存使用情况的完整统计数据:

=> SELECT heap_blks_read, heap_blks_hit
FROM pg_statio_all_tables
WHERE relname = 'cacheme';
 heap_blks_read | heap_blks_hit
−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−
              2 |             5
(1 row)

PostgreSQL 为索引和序列提供了类似的视图。它们还可以显示有关 I/O 操作的统计数据,但前提是需要打开 track_io_timingoff 参数。

9.4.1 缓冲区查找与逐出

为页面选择缓冲区并非易事 10。有两种可能的情况:

  1. 服务器启动后,所有缓冲区都是空的,并被绑定到一个列表中。当一些缓冲区仍然空闲时,从磁盘读取的下一个页面将占用第一个缓冲区,并将其从列表中移除。缓冲区只有在其页面消失时才能返回到列表中 11,而不是被另一个页面替换。如果调用 DROP 或 TRUNCATE 命令,或者表在清理期间被截断,则可能会发生这种情况。

  2. 最终,所有空闲的缓冲区都将被用完 (因为数据库的大小通常大于为缓存分配的内存块)。那个时候,缓冲区管理器将不得不选择一个已经在使用的缓冲区,并从这个缓冲区中逐出缓存页面。逐出操作使用的是时钟扫描算法,时钟隐喻很好地说明了这一点。时钟指针指向一个缓冲区,开始绕着缓冲区缓存转动,并且在经过时将每个缓存页面的使用计数减一。时钟指针找到的第一个计数为零,并且未被锁定的缓冲区将被清除。因此,每次访问缓冲区 (即锁定) 时,使用计数都会增加,而当缓冲区管理器搜索要逐出的页面时,使用计数会减少。最终,最近最少使用的页面首先被逐出,而那些经常访问的页面将在缓存中保留更长时间。可以猜到,如果所有缓冲区的使用计数均不等于零,在它们中的任何一个计数变为零之前,时钟指针必须完成一次以上的完整循环。为了避免多次循环,PostgreSQL 将使用计数限制为 5 次。一旦找到了要逐出的缓冲区,便需要从哈希表中删除仍在该缓冲区中的页面引用。但是如果这个缓冲区是脏的,也就是说,它包含了一些修改过的数据,那么旧页面将不能被简单地丢弃 — 缓冲区管理器必须先将其写入到磁盘。
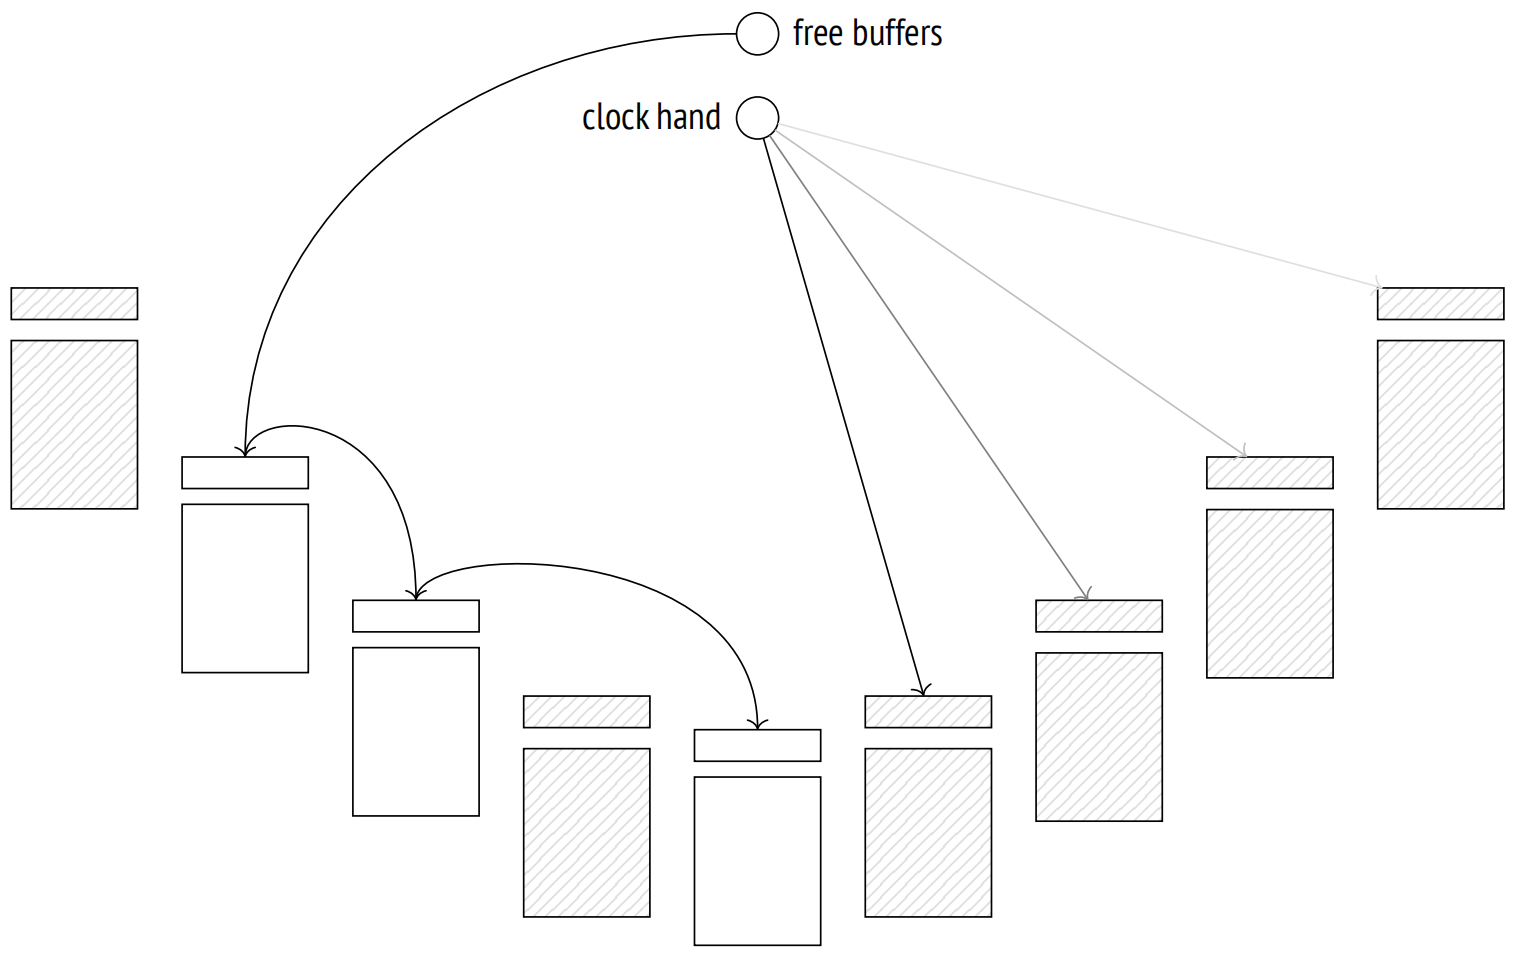
9.4.1 缓冲区查找与逐出:插图 3
图 9.3

然后缓冲区管理器将一个新页面读入所找到的缓冲区中 — 无论它是否需要被逐出或仍然是空闲的。此操作使用的是 Buffered I/O,所以只有当操作系统无法在其自己的缓存中找到该页面时,才会从磁盘读取该页面。

那些使用 Direct I/O 并且不依赖操作系统缓存的数据库系统区分逻辑读 (来自 RAM,即来自缓冲区缓存) 和物理读 (来自磁盘)。从 PostgreSQL 的角度来看,页面既可以从缓冲区缓存中读取,也可以从操作系统请求,但是在后一种情况下,无法判断页面是在 RAM 中找到的,还是从磁盘读取的。

哈希表被更新以引用新页面,并且缓冲区被锁定。其使用次数增加,此刻设置为 1,这允许在时钟扫描算法遍历缓冲区缓存期间,页面至少能保留一整轮。

9.5 批量逐出

如果执行批量读取或写入操作,存在一次性的数据从缓冲区缓存中挤出有用页面的风险。

作为预防措施,批量操作使用的是相对较小的环形缓冲区,并且驱逐操作在其边界内执行,不会影响其他缓冲区。

除了 “buffer ring” 这个术语之外,代码中还使用了术语 “ring buffer”。 然而,这个同义词相当模糊,因为环形缓冲区本身由若干个缓冲区 (也属于缓冲区缓存) 组成。在这方面,术语 “buffer ring” 更为准确。

特定大小的环形缓冲区由依次使用的一组缓冲区组成。起初,环形缓冲区是空的,各个缓冲区在以常规方式被从缓冲区缓存中选择后,逐个加入到环形缓冲区中。然后驱逐策略开始发挥作用,但是仅限于环内 12。

添加到环中的缓冲区不会从缓冲区缓存中排除,仍然可以被其他操作使用。因此,如果要重用的缓冲区被锁定了,或者它的使用计数高于 1,它将简单地被从环中剥离,并被另一个缓冲区替换。

PostgreSQL 支持三种逐出策略。

批量读取策略用于对大表的顺序扫描,当大表的大小超过了缓冲区缓存的 1/4 时便会使用。环形缓冲区占用 256 kB (32 个标准页面)。

此策略不允许将脏页写入磁盘以释放缓冲区;相反,缓冲区从环中排除,并被另一个取代。因此,读取不必等待写入完成,因此执行得更快。

如果发现表已在扫描中,那么开始另一次扫描的进程会加入现有的环形缓冲区,并访问当前可用的数据,而不会产生额外的 I/O 操作 13。当第一个进程完成扫描后,第二个进程返回到表跳过的部分。

批量写入策略由 COPY FROM、CREATE TABLE AS SELECT 和 CREATE MATERIALIZED VIEW 命令,以及那些导致表重写的 ALTER TABLE 变体应用。所分配的环形缓冲区很大,默认大小是 16 MB (2048 个标准页面),但它永远不会超过缓冲区缓存总大小的 1/8。

清理策略由清理进程在执行全表扫描而不考虑可见性映射时使用。环形缓冲区分配了 256 kB 的内存 (32 个标准页面)。

环形缓冲区并不总是能防止不希望的驱逐。如果 UPDATE 或 DELETE 命令影响了大量行,执行的表扫描会应用批量读取策略,但由于页面不断被修改,环形缓冲区环实际上变得毫无用处。

另外一个值得一提的例子是在 TOAST 表中存储超大数据。尽管可能需要读取大量数据,但 TOAST 值始终通过索引访问,因此它们会绕过环形缓冲区。

让我们仔细看看批量读取策略。为方便起见,我们将创建一个表,使插入的行占据整个页面。 默认情况下,缓冲区缓存大小为 16384 个页面,每个 8 kB。 因此,表必须占用超过 4096 个页面,才能在扫描时使用环形缓冲区。

=> CREATE TABLE big(
  id integer PRIMARY KEY GENERATED ALWAYS AS IDENTITY,
  s char(1000)
) WITH (fillfactor = 10);
=> INSERT INTO big(s)
  SELECT 'FOO' FROM generate_series(1,4096+1);

让我们分析一下表:

=> ANALYZE big;
=> SELECT relname, relfilenode, relpages
FROM pg_class
WHERE relname IN ('big', 'big_pkey');
 relname  | relfilenode | relpages
−−−−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−
 big      |       16546 |     4097
 big_pkey |       16551 |       14
(2 rows)

重启服务器以清除缓存,因为现在它包含了在分析过程中读取的一些堆页面。

postgres$ pg_ctl restart -l /home/postgres/logfile

重启服务器之后,让我们读取整个表:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT id FROM big;
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on big (actual rows=4097 loops=1)
(1 row)

堆页面只占用 32 个缓冲区,这些缓冲区构成了此操作的环形缓冲区:

=> SELECT count(*)
FROM pg_buffercache
WHERE relfilenode = pg_relation_filenode('big'::regclass);
 count
−−−−−−−
    32
(1 row)

但在索引扫描的情况下,并不使用环形缓冲区:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM big ORDER BY id;
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using big_pkey on big (actual rows=4097 loops=1)
(1 row)

缓冲区缓存最终包含了整个表和整个索引:

=> SELECT relfilenode, count(*)
FROM pg_buffercache
WHERE relfilenode IN (
  pg_relation_filenode('big'),
  pg_relation_filenode('big_pkey')
)
GROUP BY relfilenode;
 relfilenode | count
−−−−−−−−−−−−−+−−−−−−−
       16546 |  4097
       16551 |    14
(2 rows)

9.6 选择缓冲区缓存大小

缓冲区缓存的大小由 shared_buffers128MB 参数定义。众所周知,其默认值很低,因此在安装 PostgreSQL 后增加这个值是有必要的。在此情况下,你需要重新加载服务器,因为在服务器启动时便为缓存分配了共享内存。

但我们如何确定一个合适的值呢?

即使是一个非常大的数据库,也有一组同时使用的有限热数据。在理想情况下,这个数据集必须适合缓冲区缓存 (为一次性的数据预留一些空间)。如果缓存大小太小,那么频繁使用的页面将一直相互驱逐,从而导致过多的 I/O 操作。但是无脑增加缓存大小也不是一个好主意:RAM 是稀缺资源,此外,更大的缓存会带来更高的维护成本。

最佳的缓冲区缓存大小因系统而异:它取决于可用内存的总大小、数据概况和工作负载类型等因素。不幸的是,没有一个万能的值或公式能同等适合所有场景。

你还应该记住, PostgreSQL 中的缓存未命中不一定会触发物理 I/O。如果缓冲区缓存非常小,操作系统缓存会使用剩余的空闲内存,并且可以在一定程度上有所缓解。但与数据库不同的是,操作系统对读取的数据一无所知,因此它采用了一种不同的驱逐策略。

一个典型的建议是从 1/4 RAM 开始,然后根据需要调整这个设置。

最好的方式是不断试验:你可以增加或减少缓存大小,并比较系统性能。当然,这需要一个完全类似于生产系统的测试系统,并且能够重现典型的工作负载。

你还可以使用 pg_buffercache 扩展进行一些分析。例如,基于使用情况分析缓冲区的分布状况:

=> SELECT usagecount, count(*)
FROM pg_buffercache
GROUP BY usagecount
ORDER BY usagecount;
 usagecount | count
−−−−−−−−−−−−+−−−−−−−
          1 |  4128
          2 |    50
          3 |     4
          4 |     4
          5 |    73
            | 12125
(6 rows)

空的使用计数对应于空闲的缓冲区。在这种情况下,是完全可以预料的,因为服务器已重新启动,并且大部分时间都保持空闲状态。大多数使用的缓冲区包含后端进程读取的系统表页面,用于填充其系统表缓存并执行查询。

我们可以检查每个表的哪一部分被缓存,以及这些数据是否是热的 (如果一个页面的使用计数大于 1,那么此处便认为它是热的):

=> SELECT c.relname,
  count(*) blocks,
  round( 100.0 * 8192 * count(*) /
    pg_table_size(c.oid) ) AS "% of rel",
  round( 100.0 * 8192 * count(*) FILTER (WHERE b.usagecount > 1) /
    pg_table_size(c.oid) ) AS "% hot"
  FROM pg_buffercache b
    JOIN pg_class c ON pg_relation_filenode(c.oid) = b.relfilenode
  WHERE b.reldatabase IN (
    0, -- cluster-wide objects
    (SELECT oid FROM pg_database WHERE datname = current_database())
)
AND b.usagecount IS NOT NULL
GROUP BY c.relname, c.oid
ORDER BY 2 DESC
LIMIT 10;
             relname             | blocks | % of rel | % hot
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−+−−−−−−−−−−+−−−−−−−
 big                             | 	 4097 |      100 |     1
 pg_attribute                    |     30 |       48 |    47
 big_pkey                        |     14 |      100 |     0
 pg_proc                         |     13 |       12 |     6
 pg_operator                     |     11 |       61 |    50
 pg_class                        |     10 |       59 |    59
 pg_proc_oid_index               |      9 |       82 |    45
 pg_attribute_relid_attnum_index |      8 |       73 |    64
 pg_proc_proname_args_nsp_index  |      6 |       18 |     6
 pg_amproc                       |      5 |       56 |    56
(10 rows)

这个例子表明大表及其索引已被完全缓存,但它们的页面并未被频繁使用。

从不同角度分析数据,你可以获得一些有用的见解。但是,在运行 pg_buffercache 查询时,请确保遵循以下简单规则:

  • 多次重复这样的查询,因为返回的数据在一定程度上会有所不同。

  • 不要连续不断地运行这样的查询,因为 pg_buffercache 扩展会锁定查看的缓冲区,即使只是短暂的。

9.7 缓存预热

服务器重启后,缓存需要一段时间来预热,也就是积累频繁使用的数据。立即缓存某些表可能会有所帮助, pg_prewarm 扩展正是用于此目的:

=> CREATE EXTENSION pg_prewarm;

除了将表加载到缓冲区缓存 (或仅加载到操作系统缓存) 之外,此扩展v. 11还可以将当前缓存状态写入磁盘,然后在服务器重新启动后恢复。要启用此功能,你需要将此扩展的库添加到 shared_preload_libraries 并重启服务器:

=> ALTER SYSTEM SET shared_preload_libraries = 'pg_prewarm';

postgres$ pg_ctl restart -l /home/postgres/logfile

如果 pg_prewarm.autoprewarmon 设置没有改变,服务器重新加载后会自动启动一个名为 autoprewarm leader 的进程;一旦达到 pg_prewarm.autoprewarm_interval300s 秒,这个进程便会将缓存页面的列表刷新到磁盘 (会使用一个 max_parallel_processes 槽)。

postgres$ ps -o pid,command \
--ppid `head -n 1 /usr/local/pgsql/data/postmaster.pid` | \
grep prewarm
  23124 postgres: autoprewarm leader

现在服务器已经重启,大表没有被缓存:

=> SELECT count(*)
FROM pg_buffercache
WHERE relfilenode = pg_relation_filenode('big'::regclass);
 count
−−−−−−−
     0
(1 row)

如果你有充分的理由认为整个表将被频繁使用,并且磁盘访问使响应时间变得无法接受,那么你可以提前将这个表加载到缓冲区缓存中:

=> SELECT pg_prewarm('big');
 pg_prewarm
−−−−−−−−−−−−
       4097
(1 row)

=> SELECT count(*)
FROM pg_buffercache
WHERE relfilenode = pg_relation_filenode('big'::regclass);
 count
−−−−−−−
  4097
(1 row)

页面列表将转储到 PGDATA/autoprewarm.blocks 文件中。你可以等到 autoprewarm leader 首次完成,但此处我们手动执行转储:

=> SELECT autoprewarm_dump_now();
 autoprewarm_dump_now
−−−−−−−−−−−−−−−−−−−−−−
                 4224
(1 row)

刷盘的页面数量大于 4097,因为考虑了所有正在使用的缓冲区。此文件以文本格式编写,它包含数据库、表空间和文件 ID,以及分支和段号:

postgres$ head -n 10 /usr/local/pgsql/data/autoprewarm.blocks
<<4224>>
0,1664,1262,0,0
0,1664,1260,0,0
16391,1663,1259,0,0
16391,1663,1259,0,1
16391,1663,1259,0,2
16391,1663,1259,0,3
16391,1663,1249,0,0
16391,1663,1249,0,1
16391,1663,1249,0,2

让我们再次重启服务器。

postgres$ pg_ctl restart -l /home/postgres/logfile

此时,表立刻出现在了缓存中:

=> SELECT count(*)
FROM pg_buffercache
WHERE relfilenode = pg_relation_filenode('big'::regclass);
 count
−−−−−−−
  4097
(1 row)

autoprewarm leader 也会完成所有初始工作:它读取文件,根据数据库对页面进行排序,重新排列它们 (以便磁盘读取尽可能顺序执行),然后将它们传递给 autoprewarm worker 进行处理。

9.8 本地缓存

临时表不遵循上述工作流程。由于临时数据仅对单个进程可见,因此没有必要将其加载到共享缓冲区缓存中。因此,临时数据使用的是拥有该表的进程的本地缓存 14。

一般来说,本地缓冲区缓存的工作方式类似于共享缓存:

  • 通过哈希表进行页面搜索。

  • 驱逐遵循标准算法 (除了不使用环形缓冲区)。

  • 页面可以被锁定以避免被驱逐。

但是,本地缓存实现要简单得多,因为它既不需要处理内存结构上的锁 (缓冲区只能由单个进程访问),也不需要容错机制 (临时数据最多存在至会话结束)。

由于通常只有少数会话使用临时表,因此本地缓存内存是按需分配的。会话可用的本地缓存的最大大小受到 temp_buffers8MB 参数的限制。

尽管名称相似,但 temp_file_limit 参数与临时表无关;它与可能在查询执行期间创建的文件有关,用于临时存储中间数据。

在 EXPLAIN 命令的输出中,所有对本地缓冲区缓存的调用都标记为 local 而不是 shared:

=> CREATE TEMPORARY TABLE tmp AS SELECT 1;
=> EXPLAIN (analyze, buffers, costs off, timing off, summary off)
  SELECT * FROM tmp;
               QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on tmp (actual rows=1 loops=1)
   Buffers: local hit=1
 Planning:
   Buffers: shared hit=12 read=7
(4 rows)

  1. backend/storage/buffer/README ↩︎

  2. www.postgresql.org/message-id/flat/20210223100344.llw5an2aklengrmn%40alap3.anarazel.de ↩︎

  3. include/storage/buf_internals.h ↩︎

  4. backend/storage/buffer/bufmgr.c ↩︎

  5. backend/storage/buffer/bufmgr.c, ReadBuffer_common function ↩︎

  6. backend/storage/buffer/buf_table.c ↩︎

  7. backend/utils/hash/dynahash.c ↩︎

  8. backend/storage/buffer/bufmgr.c, DropRelFileNodeBuffers function ↩︎

  9. backend/storage/buffer/bufmgr.c, LockBufferForCleanup function ↩︎

  10. backend/storage/buffer/freelist.c, StrategyGetBuffer function ↩︎

  11. backend/storage/buffer/freelist.c, StrategyFreeBuffer function ↩︎

  12. backend/storage/buffer/freelist.c, GetBufferFromRing function ↩︎

  13. backend/access/common/syncscan.c ↩︎

  14. backend/storage/buffer/localbuf.c ↩︎

10 预写式日志

10.1 日志

当发生故障时,例如断电、 操作系统错误或数据库服务器崩溃,RAM 中所有的内容都将丢失;只有写入磁盘的数据才会持久保存。为了在故障之后启动服务器,你必须恢复数据的一致性。如果磁盘本身受损,同样的问题必须通过备份恢复来解决。

理论上,你可以始终保持磁盘上数据的一致性。但实际上,这意味着服务器必须不断地将随机页面写入磁盘(即使顺序写入代价更低),并且这些写入的顺序必须保证在任何特定时刻都不会损害一致性 (这很难实现,尤其是在处理复杂的索引结构时)。

就像大多数数据库系统一样,PostgreSQL 采用了不同的方式。

当服务器运行时,一些当前数据仅在 RAM 中可用,然后数据被延迟写入至持久化存储中。因此,存储在磁盘上的数据在服务器操作期间总是不一致,因为页面从未一次性全部刷新过。但在 RAM 中发生的每次更改 (例如在缓冲区缓存中进行的页面更新) 都会被记录下来:PostgreSQL 会创建一个日志条目,其中包含了在需要时重复执行此操作所需的所有基本信息 1。

与页面修改相关的日志条目必须在被修改页面本身写入磁盘之前写入,因此得名:预写式日志,或者 WAL。这个要求保证了在发生故障的情况下,PostgreSQL 可以从磁盘读取 WAL 条目,并重放它们以重复已完成的操作,这些操作的结果仍在 RAM 中,在崩溃之前还没有写入到磁盘中。

维护预写式日志通常比将随机页面写入磁盘更高效。WAL 条目构成连续的数据流,即使是 HDD 也能处理。此外,WAL 条目通常比页面大小更小。

所有在发生故障时可能破坏数据一致性的操作都需要被记录。特别是,以下操作会记录在 WAL 中:

  • 在缓冲区缓存中执行的页面修改 — 因为写入被推迟了

  • 事务提交和回滚 — 因为状态变化发生在 CLOG 缓存中,并且不会立即写入磁盘

  • 文件操作 (例如在添加或删除表时创建和删除文件和目录) — 因为此类操作必须与数据更改同步

以下操作不会被记录:

  • 在无日志表上的操作

  • 对临时表的操作 — 因为它们的生命周期无论如何,都受限于生成它们的会话

    在 PostgreSQL 10 之前,哈希索引也不会记录 WAL。它们的唯一目的是将哈希函数与不同的数据类型相匹配。

除了崩溃恢复,WAL 还可以用于从备份中进行时间点恢复以及复制。

10.2 WAL 结构

10.2.1 逻辑结构

在讲述其逻辑结构时,我们可以将 WAL 2 描述为一个可变长度的日志条目流。每个条目都包含了一些关于特定操作的数据,在其前面有一个标准头结构 3。该头结构提供的信息包括:

  • 与条目相关的事务 ID

  • 解析条目的资源管理器 4

  • 用于检测数据损坏的校验和

  • 条目长度

  • 对前一个 WAL 条目的引用

    WAL 通常是向前读取的,但是像 pg_rewind 这样的工具可能会向后扫描。

WAL 数据本身可以有不同的格式和含义。例如,它可以是一个必须在指定的偏移量处替换页面某些部分的页面片段。相应的资源管理器必须知道如何解析和重放特定条目。表、各种索引类型、事务状态和其他实体都有单独的管理器。

WAL 文件在服务器的共享内存中占用特殊的缓冲区。由 wal_buffers-1 参数定义 WAL 使用的缓存大小。默认情况下,其大小是自动计算的,为总缓冲区缓存大小的 1/32。

WAL 缓存与缓冲区缓存非常相似,但它通常以环形缓冲区模式运行:新的条目添加到头部,而旧条目从尾部开始保存至磁盘。如果 WAL 缓存太小,磁盘同步的执行频率会超出以往。

在低负载下,插入的位置 (缓冲区头部) 几乎总是与已保存到磁盘的条目位置 (缓冲区尾部) 相同:

=> SELECT pg_current_wal_lsn(), pg_current_wal_insert_lsn();
 pg_current_wal_lsn | pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/3DF56000         | 0/3DF57968
(1 row)

在 PostgreSQL 10 之前,所有函数名都包含了 XLOG 首字母缩写,而不是 WAL。

为了引用特定条目,PostgreSQL 使用了一种特殊的数据类型:pg_lsn (日志序列号,LSN)。它表示从 WAL 开始处到某个条目的 64 位字节偏移量。LSN 以两个 32 位的十六进制数字表示,以斜线分隔。

现在,让我们创建一个表:

=> CREATE TABLE wal(id integer);
=> INSERT INTO wal VALUES (1);

开启一个事务,注意 WAL 插入位置的 LSN:

=> BEGIN;
=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/3DF708D8
(1 row)

现在运行任意命令,比如更新一行:

=> UPDATE wal SET id = id + 1;

页面修改在 RAM 中的缓冲区缓存中进行。此更改记录在 WAL 页面中,也在 RAM 中。然后,插入的 LSN 向前推进:

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/3DF70920
(1 row)

为了确保修改后的数据页在相应的 WAL 条目之后被刷新到磁盘,页头存储了与此页面相关的最新 WAL 条目的 LSN。你可以使用 pageinspect 查看此 LSN:

=> SELECT lsn FROM page_header(get_raw_page('wal',0));
    lsn
−−−−−−−−−−−−
 0/3DF70920
(1 row)

整个数据库集簇只有一个 WAL,新的条目不断追加到其中。因此,存储在页面中的 LSN 可能会小于一段时间前 pg_current_wal_insert_lsn 函数返回的 LSN。但是,如果系统中没有发生任何事情,这些数字将是相同的。

现在让我们提交事务:

=> COMMIT;

提交操作也被记录下来,插入的 LSN 同样发生了改变:

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/3DF70948
(1 row)

事务提交会更新 CLOG 页面中的事务状态,这些页面保存在它们自己的缓存中 5。CLOG 缓存通常在共享内存中占用 128 个页面 6。为了确保 CLOG 页面不会在相应的 WAL 条目之前被刷新到磁盘,也必须跟踪 CLOG 页面最新 WAL 条目的 LSN。但这些信息存储在 RAM 中,而不是在页面本身中。

在某个时刻,WAL 条目将被写入磁盘;之后便可以从缓存中逐出 CLOG 和数据页面。如果需要提前逐出,这一情况会被发现,且 WAL 条目会首先被强制写入磁盘。7

如果知道两个 LSN 的位置,那么你可以通过从一个位置减去另一个位置来计算它们之间 WAL 条目的大小 (以字节为单位)。你只需将它们转换为 pg_lsn 类型:

=> SELECT '0/3DF70948'::pg_lsn - '0/3DF708D8'::pg_lsn;
 ?column?
−−−−−−−−−−
      112
(1 row)

在此特例中,与 UPDATE 和 COMMIT 操作相关的 WAL 条目占用了大约 100 字节。

你可以使用相同的方式来评估特定工作负载在单位时间内生成的 WAL 条目的数量。这些信息对于设置检查点来说是必需的。

10.2.2 物理结构

在磁盘上,WAL 作为单独的文件或段存储在 PGDATA/pg_wal 目录中。其大小由只读参数 wal_segment_size16MB 表示。

对于高负载系统,增加段大小v. 11是有意义的,因为这样可能会减少开销,但是此设置只能在集群初始化期间修改 (initdb –wal-segsize)。

WAL 条目写入当前文件,直至空间用完;然后 PostgreSQL 会创建一个新的文件。

我们可以了解特定条目位于哪个文件中,以及从文件开始的偏移量是多少:
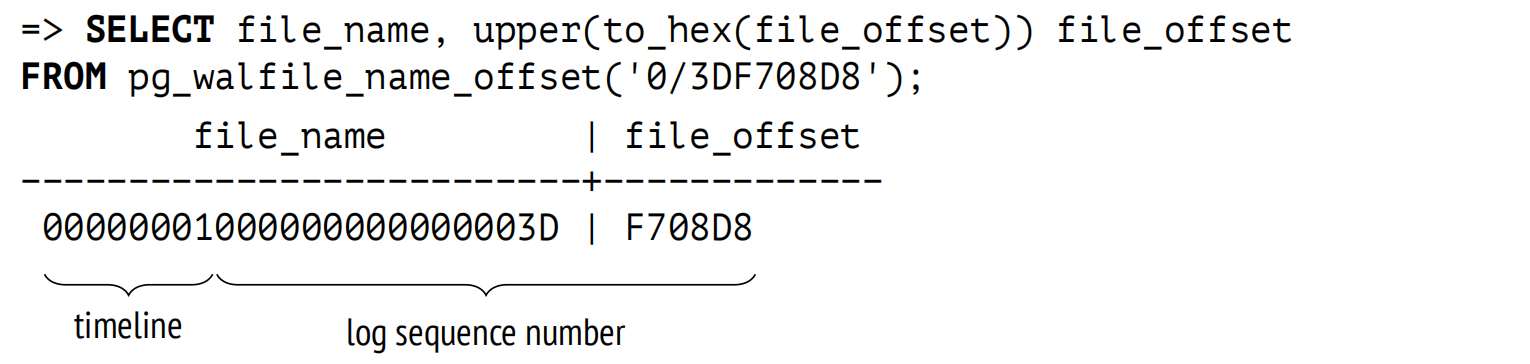
10.2.2 物理结构:插图 1
图 10.1

文件名由两部分组成。最高的八位十六进制数字定义了时间线,用于从备份中恢复,而其余部分代表了最高的 LSN 位 (最低的 LSN 位显示在 file_offset 字段中)。

要查看当前的 WAL 文件,你可以使用如下函数v. 10:

=> SELECT *
FROM pg_ls_waldir()
WHERE name = '00000001000000000000003E';
          name            |   size 	 |     modification
−−−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−
 00000001000000000000003D | 16777216 | 2023−03−06 14:01:48+03
(1 row)

现在让我们使用 pg_waldump 工具查看新创建的 WAL 条目头部 ,pg_waldump 可以按 LSN 范围 (比如本例) 或特定事务 ID 过滤 WAL 条目。

pg_waldump 工具应以 postgres 操作系统用户启动,因为它需要访问磁盘上的 WAL 文件。

postgres$ /usr/local/pgsql/bin/pg_waldump \
-p /usr/local/pgsql/data/pg_wal -s 0/3DF708D8 -e 0/3DF70948#
rmgr: Heap        len (rec/tot):     69/    69, tx:        886, lsn:
0/3DF708D8, prev 0/3DF708B0, desc: HOT_UPDATE off 1 xmax 886 flags
0x40 ; new off 2 xmax 0, blkref #0: rel 1663/16391/16562 blk 0
rmgr: Transaction len (rec/tot):     34/    34, tx:        886, lsn:
0/3DF70920, prev 0/3DF708D8, desc: COMMIT 2023−03−06 14:01:48.875861
MSK

此处我们可以看到两个 WAL 条目的头部。

第一个是由堆资源管理器处理的 HOT_UPDATE 操作。blkref 字段显示了更新的堆页面其文件名和页面 ID :

=> SELECT pg_relation_filepath('wal');
 pg_relation_filepath
−−−−−−−−−−−−−−−−−−−−−−
 base/16391/16562
(1 row)

第二个条目是事务资源管理器管理的 COMMIT 操作。

10.3 检查点

为了在故障之后恢复数据一致性 (即执行恢复),PostgreSQL 必须向前重放 WAL,并将代表丢失变更的条目应用到相应的页面。为了找出丢失的内容,PostgreSQL 会将存储在磁盘上的页面的 LSN 与 WAL 条目的 LSN 进行比较。但是应该从哪个点开始恢复呢? 如果开始得太晚,这个点之前写入磁盘的页面将无法接收到所有更改,这将导致不可逆的数据损坏。但是从头开始也不现实:不可能存储如此海量的数据,也不可能接受这么长的恢复时间。因此我们需要一个逐渐向前移动的检查点,从这个点开始恢复是安全的,并且可以删除所有之前的 WAL 条目。

创建检查点最直接的方式是定期挂起所有系统操作,并强制刷新所有脏页至磁盘上。这种方式当然是无法接受的,因为系统将挂起相当长的时间。

因此,检查点会随着时间的推移而分散执行,这实际上构成了一个时间间隔。检查点的执行由一个名为 checkpointer 的特殊后台进程执行 8。

检查点开始。checkpointer 进程将所有可以立即写入的内容刷新至磁盘:CLOG 事务状态、子事务的元数据以及其他一些结构。

检查点执行。大部分检查点的执行时间都花在了将脏页刷新至磁盘上 9。首先,在检查点开始时,所有脏缓冲区的头部中都设置了一个特殊标记。这个过程发生得非常快,因为不涉及 I/O 操作。

然后 checkpointer 进程遍历所有缓冲区并将被标记的缓冲区写入至磁盘中。它们的页面不会从缓存中驱逐:只是简单地被写下来,因此可以忽略使用计数和锁定计数。

页面按照它们的 ID 顺序处理,以尽可能避免随机写入v. 9.6。为了更好地平衡负载,PostgreSQL 在不同的表空间之间交替进行 (因为它们可能位于不同的物理设备上)。

后台进程也可以将标记的缓冲区写入磁盘 — 如果后端进程先处理的话。无论如何,此阶段将移除缓冲区标记,因此对于检查点来说,每个缓冲区只会被写入一次。

当然,当检查点正在进行时,缓冲区缓存中的页面仍然可以修改。但由于新的缓冲区脏页没有被标记,因此 checkpointer 进程会忽略它们。

检查点完成。当检查点开始时,所有脏的缓冲区都写入磁盘后,检查点便认为完成了。从现在开始 (但不是更早!),检查点的起始位置将用作恢复的新起点。在这个点之前写入的所有 WAL 条目都不再需要。
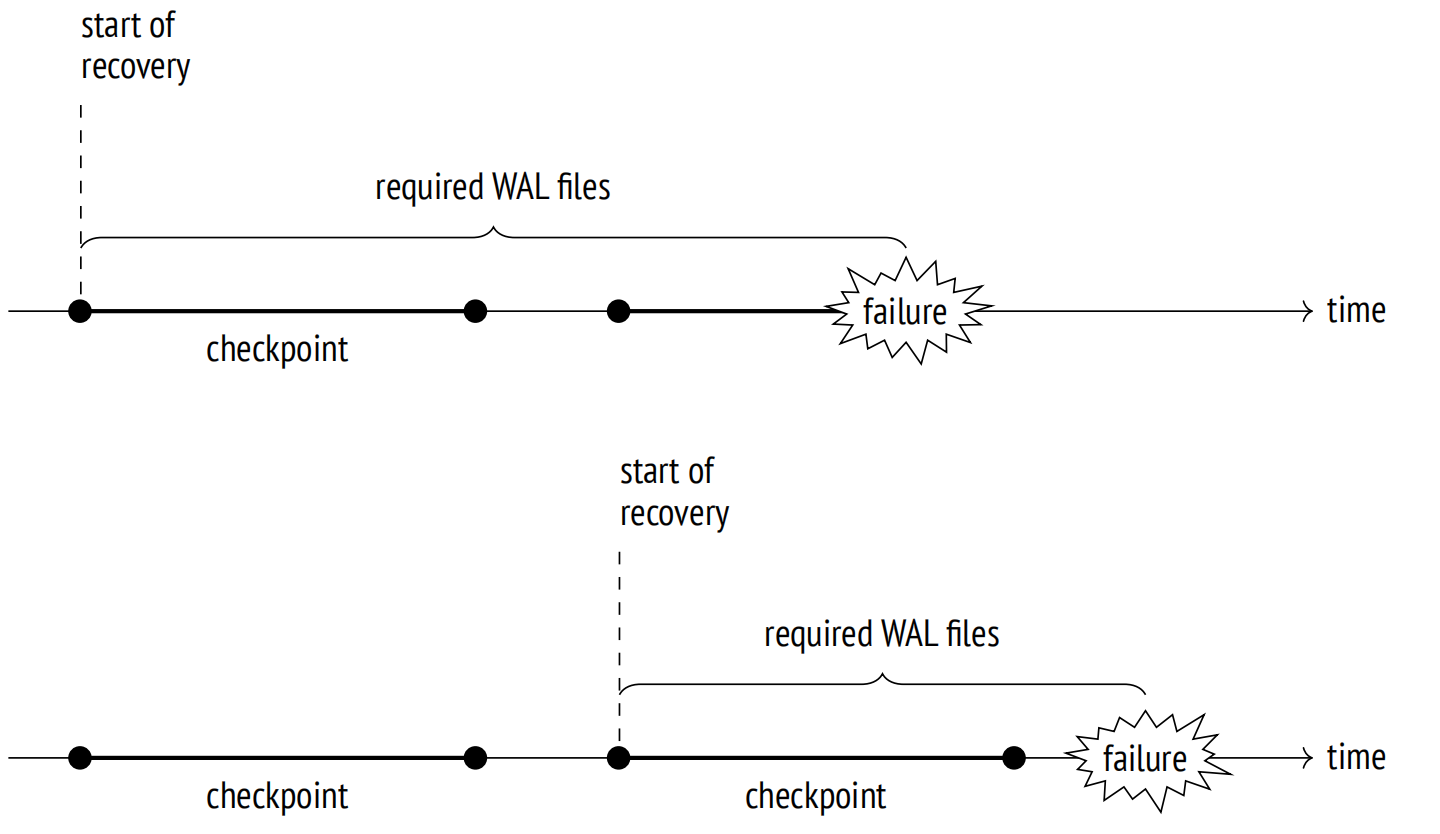
10.3 检查点:插图 2
图 10.2

最后, checkpoiner 会创建一个与检查点完成相对应的 WAL 条目,并指定检查点开始的 LSN。由于检查点在开始时不记录任何内容,因此这个 LSN 可以属于任何类型的 WAL 条目。

PGDATA/global/pg_control 文件也会更新,以引用最新完成的检查点 (直到这个过程结束,pg_control 都保持为之前的检查点)。
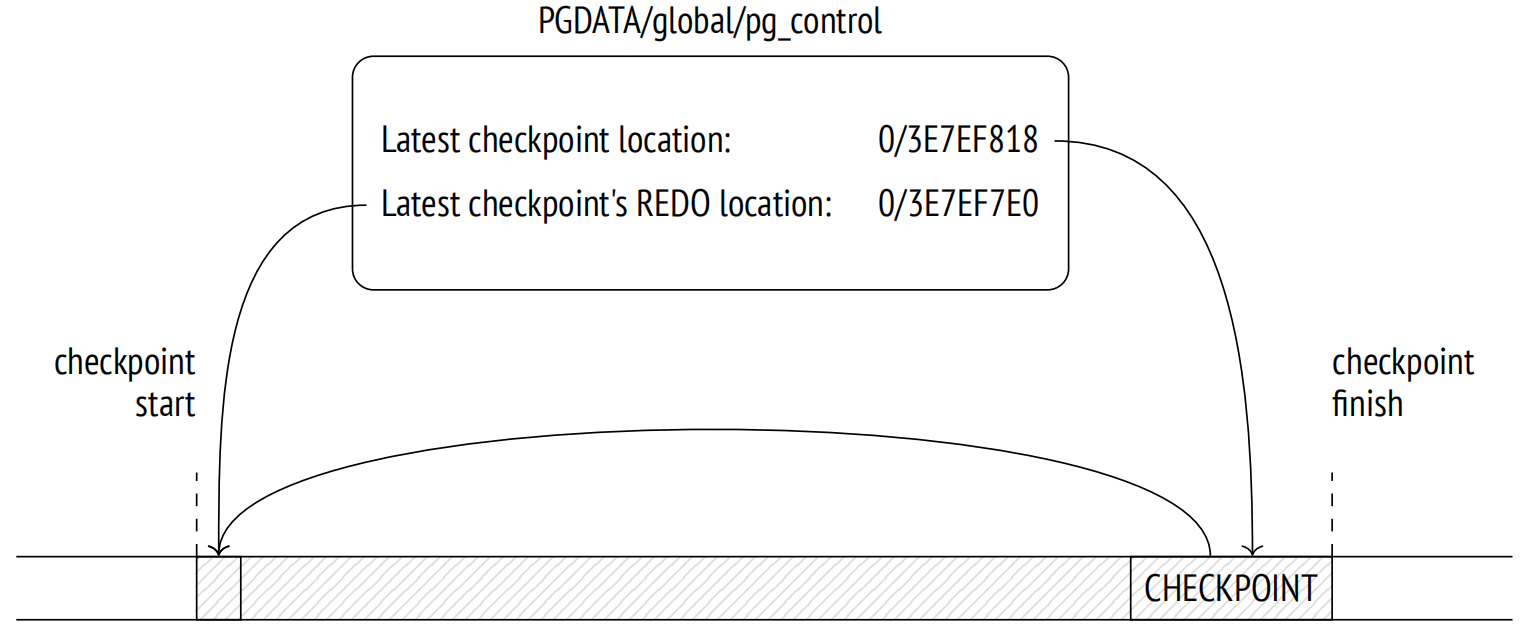
10.3 检查点:插图 3
图 10.3

为了彻底弄清楚这些位点,让我们看一个简单的例子。首先使几个缓存页面变脏:

=> UPDATE big SET s = 'FOO';
=> SELECT count(*) FROM pg_buffercache WHERE isdirty;
 count
−−−−−−−
  4119
(1 row)

注意此时 WAL 的位置:

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/3E7EF7E0
(1 row)

现在让我们手动完成检查点。所有脏页将被刷新至磁盘;由于系统中没有发生任何事情,因此不会出现新的脏页:

=> CHECKPOINT;
=> SELECT count(*) FROM pg_buffercache WHERE isdirty;
 count
−−−−−−−
     0
(1 row)

让我们看看检查点是如何反映在 WAL 中的:

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/3E7EF890
(1 row)

postgres$ /usr/local/pgsql/bin/pg_waldump \
-p /usr/local/pgsql/data/pg_wal -s 0/3E7EF7E0 -e 0/3E7EF890
rmgr: Standby     len (rec/tot):     50/    50, tx:          0, lsn:
0/3E7EF7E0, prev 0/3E7EF7B8, desc: RUNNING_XACTS nextXid 888
latestCompletedXid 887 oldestRunningXid 888
rmgr: XLOG        len (rec/tot):    114/   114, tx:          0, lsn:
0/3E7EF818, prev 0/3E7EF7E0, desc: CHECKPOINT_ONLINE redo
0/3E7EF7E0; tli 1; prev tli 1; fpw true; xid 0:888; oid 24754; multi
1; offset 0; oldest xid 726 in DB 1; oldest multi 1 in DB 1;
oldest/newest commit timestamp xid: 0/0; oldest running xid 888;
online

最新的 WAL 条目与检查点完成有关 (CHECKPOINT_ONLINE)。单词 redo 之后指定的是此检查点开始的 LSN;这个位置对应检查点开始时插入的最新 WAL 条目。

相同的信息也可以在 pg_control 文件中找到:

postgres$ /usr/local/pgsql/bin/pg_controldata \
-D /usr/local/pgsql/data | egrep 'Latest.*location'
Latest checkpoint location:           0/3E7EF818
Latest checkpoint's REDO location:    0/3E7EF7E0

10.4 恢复

服务器启动时启动的第一个进程是 postmaster。接着,postmaster 会启动 startup 进程 10,此进程负责在故障发生时执行数据恢复。

为了确认是否需要恢复,startup 进程会读取 pg_control 文件并检查实例状态。pg_controldata 工具可以查看此文件的内容:

postgres$ /usr/local/pgsql/bin/pg_controldata \
-D /usr/local/pgsql/data | grep state
Database cluster state:               in production

妥善停止的服务器处于"shut down"状态;非运行状态服务器的"in production"状态表明发生了故障。在此情况下,startup 进程将自动从 pg_control 文件中找到最新完成的检查点的起始 LSN 位置处进行恢复。

如果 PGDATA 目录包含与备份相关的 backup_label 文件,那么起始 LSN 位置就从此文件中获取。

startup 进程从定义的位置开始,逐个读取 WAL 条目,如果页面的 LSN 小于 WAL 条目的 LSN,则将它们应用到数据页。如果页面包含更大的 LSN,那么就不应用 WAL;事实上,也绝不能被应用,因为其条目被设计成是严格顺序重放的。

但是,一些 WAL 条目构成了一个完整的页面镜像,即 FPI。这种类型的条目可以应用于页面的任何状态,因为无论如何,所有页面内容都将被删除。这种修改被称为幂等操作。幂等操作的另一个例子是注册事务状态变化:每个事务状态在 CLOG 页中由某些位定义,无论它们之前的值是多少,都会被设置,因此不需要在 CLOG 页面中保留最新更改的 LSN。

WAL 条目被应用到缓冲区缓存中的页面,就像正常操作期间的常规页面更新一样。

文件以类似的方式从 WAL 中恢复:例如,如果 WAL 条目显示文件必须存在,但由于某种原因丢失了,那么它将被重新创建。

一旦恢复完成,所有无日志表都会被相应的初始分支覆盖。

最后,执行检查点以确保恢复状态安全地写入磁盘。

此时,startup 进程的工作就完成了。

在传统形式中,恢复过程包括两个阶段。在前滚阶段,重放 WAL 条目,重复丢失的操作。在回滚阶段,服务器将中止故障时尚未提交的事务。

在 PostgreSQL 中,不需要第二阶段。恢复之后,CLOG 将不会包含未完成事务 (从技术上来说表示活跃事务) 的提交位或中止位,但由于可以确定该事务不再运行,因此将被视为已中止 11。

我们可以通过强制以 immediate 模式停止服务器来模拟故障:

postgres$ pg_ctl stop -m immediate

此处是新的实例状态:

postgres$ /usr/local/pgsql/bin/pg_controldata \
-D /usr/local/pgsql/data | grep 'state'
Database cluster state:                 in production

当我们启动服务器时,startup 进程发现发生了故障,于是进入恢复模式:

postgres$ pg_ctl start -l /home/postgres/logfile
postgres$ tail -n 6 /home/postgres/logfile
LOG:  database system was interrupted; last known up at 2023−03−06
14:01:49 MSK
LOG:  database system was not properly shut down; automatic recovery
in progress
LOG:  redo starts at 0/3E7EF7E0
LOG:  invalid record length at 0/3E7EF890: wanted 24, got 0
LOG:  redo done at 0/3E7EF818 system usage: CPU: user: 0.00 s,
system: 0.00 s, elapsed: 0.00 s
LOG:  database system is ready to accept connections

如果服务器正常停止,postmaster 会断开所有客户端,然后执行最终检查点将所有脏页刷新至磁盘。

注意此刻 WAL 的位置:

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/3E7EF908
(1 row)

现在让我们妥善关闭服务器:

postgres$ pg_ctl stop

此处是新的实例状态:

postgres$ /usr/local/pgsql/bin/pg_controldata \
-D /usr/local/pgsql/data | grep state
Database cluster state:               shut down

在 WAL 的末尾,我们可以看到 CHECKPOINT_SHUTDOWN 条目,表明是最终的检查点:

postgres$ /usr/local/pgsql/bin/pg_waldump \
-p /usr/local/pgsql/data/pg_wal -s 0/3E7EF908
rmgr: XLOG        len (rec/tot):    114/   114, tx:          0, lsn:
0/3E7EF908, prev 0/3E7EF890, desc: CHECKPOINT_SHUTDOWN redo
0/3E7EF908; tli 1; prev tli 1; fpw true; xid 0:888; oid 24754; multi
1; offset 0; oldest xid 726 in DB 1; oldest multi 1 in DB 1;
oldest/newest commit timestamp xid: 0/0; oldest running xid 0;
shutdown
pg_waldump: fatal: error in WAL record at 0/3E7EF908: invalid record
length at 0/3E7EF980: wanted 24, got 0

最新的 pg_waldump 信息显示该工具已经读取到了 WAL 的末尾。

让我们再次启动实例:

postgres$ pg_ctl start -l /home/postgres/logfile

10.5 后台写

如果后端进程需要从缓冲区中驱逐脏页,它必须先将该页写入磁盘。这种情况是不希望发生的,因为会导致等待 — 在后台异步执行写操作要好得多。

这项工作,部分由 checkpointer 进程处理,但仍然不够。

因此,PostgreSQL 提供了另一个名为 bgwriter 的进程 12,专门用于后台写入。它也依赖和页面驱逐相同的缓冲区搜索算法,除了两点主要区别:

  • bgwriter 进程使用自己的时钟指针,这个指针永远不会落后于驱逐指针,并且通常会在它前面。

  • 在遍历缓冲区时,使用计数不会减少。

如果缓冲区未被锁定且使用计数为零,那么脏页会被刷新至磁盘。因此,bgwriter 在驱逐之前运行,并主动将那些很可能很快被驱逐的页面写入磁盘。

这提高了被选中用于驱逐的缓冲区是并不是脏的的几率。

10.6 WAL 设置

10.6.1 配置检查点

检查点的持续时间 (更确切地说,将脏的缓冲区写入磁盘的持续时间) 由 checkpoint_completion_target0.9 参数定义。这个值指定了两个相邻检查点开始之间分配给写入的时间比例v. 14。不要将该参数设为 1:这可能会导致下一个检查点在前一个检查点完成之前到达。这并不会发生灾难,因为无法同时执行多个检查点,但仍有可能会扰乱常规的操作。

在配置其他参数时,我们可以使用如下方式。首先,定义两个相邻检查点之间适当的用于存储 WAL 的容量。容量越大,开销就越小,但这个值无论如何都会受到可用空间和可接受的恢复时长的限制。

要评估常规负载生成此容量大小所需的时间,你需要记录初始插入 LSN,并时不时检查此位置与当前插入位置之间的差值。

假设获取的数字是一个典型的检查点间隔时间,我们将其用作 checkpoint_timeout5min 参数的值。默认设置可能太小;通常会增加该值,比如增加至 30 分钟。

但是,可能 (甚至很可能) 负载有时会更高,因此在此时间间隔内生成的 WAL 文件的大小会很大。在这种情况下,必须更频繁地执行检查点。为了设置这样的触发器,我们通过 max_wal_size1GB 参数限制恢复所需的 WAL 文件的大小。当超过这个阈值时,服务器便会触发一个额外的检查点 13。

用于恢复的 WAL 文件包含最新完成的检查点和当前尚未完成的检查点的所有条目v. 11。因此,要估算它们的总大小,你应该将计算出的检查点之间的 WAL 大小乘以 1 + checkpoint_completion_target。

在 11 版本之前,PostgreSQL 会为两个已完成的检查点保留 WAL 文件,因此乘数为 2 + checkpoint_completion_target。

按照这种方式,大多数检查点都将按计划执行,每隔 checkpoint_timeout 执行一次; 但是如果负载增加,当 WAL 的大小超过 max_wal_size 值时,便会触发检查点。

实际进展会定期与预期数字进行对比 14:

实际进展由已处理的缓存页面的比例定义。

预期进度 (按时间) 由已流逝的时间比例定义,检查点必须在 checkpoint_timeout × checkpoint_completion_target 时间间隔内完成。

预期进度 (按大小) 由已填充的 WAL 文件的比例定义,预期数量基于 max_wal_size × checkpoint_completion_target 值估算。

如果脏页提前写入了磁盘,那么 checkpointer 进程会暂停一段时间;如果任一参数有任何延迟,它会尽可能追上 15。由于同时考虑到了时间和数据大小,PostgreSQL 可以使用相同的方式管理计划内和按需的检查点。

检查点完成后,不再需要恢复的 WAL 文件便会被删除 16;但是,部分文件 (总共最多 min_wal_size80MB) 会被保留以供重复使用,并且简单地被重命名。

这种重命名操作减少了频繁创建文件和删除文件所带来的开销v. 12,但如果你不需要这个功能的话,可以使用 wal_recycleon 参数将其关闭。

下图显示了正常情况下,存储在磁盘上的 WAL 文件大小是如何变化的。
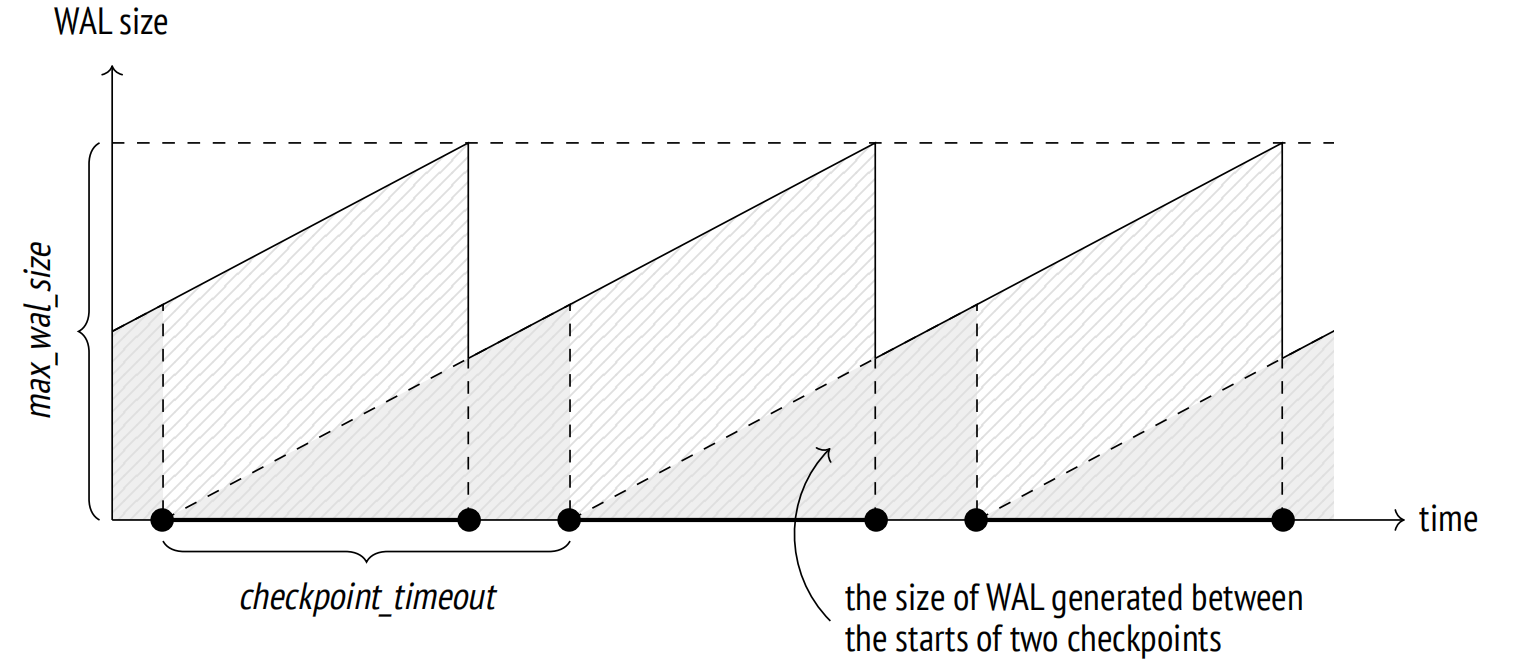
10.6.1 配置检查点:插图 4
图 10.4

请务必记住,磁盘上 WAL 文件的实际大小可能会超过 max_wal_size 值:

  • max_wal_size 参数指定了预期的目标值,而不是硬限制。如果负载激增,写入可能会落后于计划。

  • 服务器无权删除尚未被复制或连续归档所处理的 WAL 文件。如果启用了此功能,那么必须不断监控,因为它很容易导致磁盘溢出。

  • 你可以通过配置 wal_keep_size0MB 参数,保留一定数量的 WAL 文件v. 12。

10.6.2 配置后台写入

配置完检查点之后,你还应该配置 bgwriter。总之,这两个进程必须能够在后端进程需要重用之前将脏的缓冲区写入磁盘。

在执行期间,bgwriter 会定期暂停,休眠 bgwriter_delay200ms 参数所指定的单位时间。

两次暂停期间写入的页面数量取决于自上次运行以来后端进程访问的缓冲区的平均数量 (PostgreSQL 使用了一个变化的平均值来平衡可能的峰值,并同时避免依赖非常老的数据)。然后将计算出的数字乘以 bgwriter_lru_multiplier2。但无论如何,单次运行写入的页面数量不能超过 bgwriter_lru_maxpages100 的值。

如果没有发现脏缓冲区 (即系统中没有发生任何事情),bgwriter 会休眠,直到其中一个后端进程访问了缓冲区。然后它会醒来并继续执行其常规操作。

10.6.3 监控

基于监控数据,可以并且也应该去调整检查点设置。

如果基于大小触发的检查点执行得比 checkpoint_warning30s 参数所定义的更频繁,那么 PostgreSQL 会发出警告。此设置应符合预期的峰值负载。

log_checkpointsoff 参数允许将与检查点相关的信息打印到服务器日志中。让我们打开它:

=> ALTER SYSTEM SET log_checkpoints = on;
=> SELECT pg_reload_conf();

现在让我们修改一些数据,并执行检查点:

=> UPDATE big SET s = 'BAR';
=> CHECKPOINT;

服务器日志显示了写入的缓冲区数量、检查点后 WAL 文件变更的一些统计数据、检查点的持续时间,以及两个相邻检查点开始之间的距离 (WAL 数据量,以字节为单位):

postgres$ tail -n 2 /home/postgres/logfile
LOG:  checkpoint starting: immediate force wait
LOG:  checkpoint complete: wrote 4100 buffers (25.0%); 0 WAL file(s)
added, 1 removed, 0 recycled; write=0.076 s, sync=0.009 s,
total=0.099 s; sync files=3, longest=0.007 s, average=0.003 s;
distance=9213 kB, estimate=9213 kB

影响配置决策的最有用的数据是 pg_stat_bgwriter 视图中提供的有关后台写入和检查点执行的统计数据。

在 9.2 版本之前,这两项任务都由 bgwriter 执行;后来,引入了一个单独的 checkpointer 进程,但共用的视图保持不变。

=> SELECT * FROM pg_stat_bgwriter \gx
−[ RECORD 1 ]−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
checkpoints_timed     | 0
checkpoints_req       | 14
checkpoint_write_time | 33111
checkpoint_sync_time  | 221
buffers_checkpoint    | 14253
buffers_clean         | 13066
maxwritten_clean      | 122
buffers_backend       | 84226
buffers_backend_fsync | 0
buffers_alloc         | 86700
stats_reset           | 2023−03−06 14:00:07.369124+03

这个视图除了其他信息外,还显示了完成的检查点数量:

  • checkpoints_timed 字段显示了计划的检查点 (达到 checkpoint_timeout 间隔时触发)。

  • checkpoints_req 字段显示了按需检查点 (包括达到 max_wal_size 大小时触发的检查点)。

较大的 checkpoint_req 值 (与 checkpoints_timed 相比) 表明检查点比预期执行地更频繁。

以下统计数据也很重要,与写入的页面数量有关:

  • buffers_checkpoint:由 checkpointer 进程写入的页面

  • buffers_backend:由后端进程写入的页面

  • buffers_clean:由 bgwriter 写入的页面

在配置良好的系统中,buffers_backend 值必须远低于 buffers_checkpoint 和 buffers_clean 的总和。

在配置后台写入时,请注意 maxwritten_clean 值:它显示了 bgwriter 因超过由 bgwriter_lru_maxpages 定义的阈值而不得不停止的次数。

以下调用将重置已收集的统计数据:

=> SELECT pg_stat_reset_shared('bgwriter');

  1. postgresql.org/docs/14/wal-intro.html ↩︎

  2. postgresql.org/docs/14/wal-internals.html
    backend/access/transam/README ↩︎

  3. include/access/xlogrecord.h ↩︎

  4. include/access/rmgrlist.h ↩︎

  5. backend/access/transam/slru.c ↩︎

  6. backend/access/transam/clog.c, CLOGShmemBuffers function ↩︎

  7. backend/storage/buffer/bufmgr.c, FlushBuffer function ↩︎

  8. backend/postmaster/checkpointer.c
    backend/access/transam/xlog.c, CreateCheckPoint function ↩︎

  9. backend/storage/buffer/bufmgr.c, BufferSync function ↩︎

  10. backend/postmaster/startup.c
    backend/access/transam/xlog.c, StartupXLOG function ↩︎

  11. backend/access/heap/heapam_visibility.c, HeapTupleSatisfiesMVCC function ↩︎

  12. backend/postmaster/bgwriter.c ↩︎

  13. backend/access/transam/xlog.c, LogCheckpointNeeded & CalculateCheckpointSegments functions ↩︎

  14. backend/postmaster/checkpointer.c, IsCheckpointOnSchedule function ↩︎

  15. backend/postmaster/checkpointer.c, CheckpointWriteDelay function ↩︎

  16. backend/access/transam/xlog.c, RemoveOldXlogFiles function ↩︎

11 WAL 模式

11.1 性能

当服务器正常运行时,WAL 文件会不断写入磁盘。然而,这些写入是顺序的:几乎没有随机访问,因此即使是 HDD 也能应对这项任务。因为这种类型的负载与典型的数据文件访问非常不同,因此可能值得为 WAL 文件设置单独的物理存储,并将 PGDATA/pg_wal 目录替换为指向已挂载文件系统中目录的符号链接。

有几种情况需要同时写入和读取 WAL 文件。第一个显而易见的例子是崩溃恢复;第二个是流复制。walsender 1 进程直接从文件中读取 WAL 条目 2,如果备库没有接收到需要的 WAL 条目,那么 walsender 进程将从文件中读取,只是读取过程是顺序的,而不是随机的 (也有可能在主库的操作系统缓存中找到相应的 WAL 条目)。

WAL 条目可以按以下模式之一写入:

  • 同步模式在事务提交时,将所有相关的 WAL 条目保存至磁盘之前会禁止任何进一步的操作。

  • 异步模式意味着立即提交事务,随后在后台将 WAL 条目写入磁盘。

当前模式由 synchronous_commiton 参数定义。

同步模式。为了可靠地记录提交的事实,仅仅将 WAL 条目传递给操作系统是不够的;你还必须确保磁盘同步已经成功完成。由于同步涉及实际的 IO 操作 (非常慢),因此尽可能少地执行它是有益的。

为此,完成事务并将 WAL 条目写入磁盘的后端进程可以按照 commit_delay0s 参数定义的时间暂停一小会。但是,这只会发生在系统中至少有 commit_siblings5 个活跃事务的情况下 3:在这段暂停期间,其中一些事务可能会完成,服务器会设法一次性同步所有的 WAL 条目。这很像扶着电梯门让某人赶上电梯。

默认情况下不会暂停。只有在执行大量短 OLTP 事务的系统中,修改 commit_delay 参数才有意义。

在潜在的暂停之后,完成事务的进程将所有累积的 WAL 条目刷新到磁盘并执行同步 (重要的是保存提交记录以及之前与此事务相关的所有条目;其余的被写入,只是因为不会增加成本)。

从此刻起,ACID 的持久性要求得到保证 — 事务被认为已可靠提交了 4。这就是为什么同步模式是默认模式的原因。

同步提交的缺点是延迟较长 (COMMIT 命令直到同步结束才返回控制) 和较低的系统吞吐量,尤其是对于 OLTP 负载。

异步模式。为了开启异步提交 5,你需要关闭 synchronous_commit 参数。

在异步模式下,WAL 条目由 walwriter 6 进程写入磁盘,该进程在工作和休息之间交替。暂停的持续时间由 wal_writer_delay200ms 定义。

从暂停中醒来后,walwriter 进程检查缓存中是否有新的完全填满的 WAL 页面。如果出现任何此类页面,那么 walwriter 进程会跳过当前的页面,将此类页面写入磁盘。否则,它会写入当前半空的页面,因为它已经被唤醒了 7。

这个算法的目的是避免多次刷新同一个页面,这对于数据变化密集的工作负载可以带来显著的性能提升。

虽然 WAL 缓存使用环形缓冲区,但 walwriter 在到达缓存的最后一页时会停止;暂停后,下一个写入周期会从第一页开始。因此,在最坏的情况下,walwriter 需要运行 3 次才能到达特定的 WAL 条目:首先,写入所有位于缓存末尾的完整页面,然后它会回到开头,最后处理包含该条目的未满页面。但在大多数情况下,它只需要一到两个周期。

每当写入 wal_writer_flush_after1MB 量的数据后,便会执行同步,并在写入周期结束时再次执行同步。

异步提交比同步提交更快,因为它们不必等待磁盘物理写入。但是可靠性会受到影响:你可能会丢失在故障前三倍 wal_writer_delay 时间范围内提交的数据 (默认为 0.6 秒)。

在实际情况中,这两种模式相辅相成。在同步模式下,与长事务相关的 WAL 条目仍然可以异步写入以释放 WAL 缓冲区。反之亦然,即使在异步模式下,与即将从缓冲区缓存中逐出的页面相关的 WAL 条目也会立即刷新到磁盘 — 否则无法继续操作。

在大多数情况下,系统设计人员必须在性能和持久性之间做出艰难的选择。

synchronous_commit 参数也可以针对特定事务设置。如果可以在应用程序级别将所有事务分类为绝对关键 (如处理财务数据) 或不那么重要,那么你可以提高性能,同时冒着只丢失非关键事务的风险。

为了了解异步提交潜在的性能增益,让我们使用 pgbench 8 测试比较两种模式下的延迟和吞吐量。

首先,初始化所需的表:

postgres$ /usr/local/pgsql/bin/pgbench -i internals

在同步模式下开始一次 30 秒的测试:

postgres$ /usr/local/pgsql/bin/pgbench -T 30 internals
pgbench (14.7)
starting vacuum...end.
transaction type: <builtin: TPC−B (sort of)>
scaling factor: 1
query mode: simple
number of clients: 1
number of threads: 1
duration: 30 s
number of transactions actually processed: 20123
latency average = 1.491 ms
initial connection time = 2.507 ms
tps = 670.809688 (without initial connection time)

现在在异步模式下执行相同的测试:

=> ALTER SYSTEM SET synchronous_commit = off;
=> SELECT pg_reload_conf();
postgres$ /usr/local/pgsql/bin/pgbench -T 30 internals
pgbench (14.7)
starting vacuum...end.
transaction type: <builtin: TPC−B (sort of)>
scaling factor: 1
query mode: simple
number of clients: 1
number of threads: 1
duration: 30 s
number of transactions actually processed: 61809
latency average = 0.485 ms
initial connection time = 1.915 ms
tps = 2060.399861 (without initial connection time)

在异步模式下,这个简单的基准测试体现了显著降低的延迟和更高的吞吐量 (TPS)。 当然,每个特定系统都会根据当前负载有自己的数据,但很明显,对短小 OLTP 事务的影响是非常明显的。

让我们恢复默认设置:

=> ALTER SYSTEM RESET synchronous_commit;
=> SELECT pg_reload_conf();

11.2 容错性

不言而喻,预写日志必须保证在任何情况下都能进行崩溃恢复 (除非持久性存储本身损坏了)。影响数据一致性的因素有很多,但我将只介绍最重要的几个:缓存、数据损坏和非原子写入 9。

11.2.1 缓存

数据在到达非易失性存储 (比如硬盘) 之前,会通过各种缓存。

磁盘写入只是指示操作系统将数据放入其缓存中 (这也容易发生崩溃,就像 RAM 的任何其他部分一样)。实际的写入操作是异步执行的,具体由操作系统的 I/O 调度器的设置决定。

一旦调度器决定刷新累积的数据,这些数据就会被转移到存储设备的缓存中 (比如 HDD)。存储设备也可以推迟写入,例如,将相邻的页面组合一起。RAID 控制器在磁盘和操作系统之间又添加了一层缓存。

除非采取特殊措施,否则数据何时可靠地存储在磁盘上仍然未知。这通常不是那么重要,因为我们有 WAL,但是 WAL 条目本身必须立即可靠地保存在磁盘上 10。异步模式同样如此 — 否则,无法保证 WAL 条目在修改的数据之前到达磁盘。

检查点进程也必须以可靠的方式保存数据,确保脏页从操作系统缓存进入磁盘。此外,它还必须同步其他进程已经执行的所有文件操作 (如页面写入或文件删除):当检查点完成时,所有这些操作的结果必须已经保存在磁盘上 11。

还有一些其他情况需要 fail-safe 写入,例如在 minimal WAL 级别下执行未记录日志的操作。

操作系统提供了多种方式以保证将数据立即写入非易失性存储。所有方式都可归结为以下两种主要方式:要么在写入后调用单独的同步命令 (例如 fsync 或 fdatasync),要么在打开或写入文件时指定执行同步的要求 (甚至绕过操作系统缓存的直接写入)。

pg_test_fsync 工具可以帮助你根据操作系统和文件系统确认同步 WAL 的最佳方式;首选方式可以在 wal_sync_method 参数中指定。对于其他操作,会自动选择合适的同步方式,无法配置 12。

这里一个微妙的方面是,在每种特定情况下,最合适的方式取决于硬件。例如,如果你使用带有备用电池的控制器,那么可以利用其缓存,因为电池可以在断电时保护数据。

你应该记住,异步提交和缺乏同步是两个完全不同的事情。关闭同步 (通过 fsyncon 参数) 可以提高系统性能,但任何故障都会导致致命的数据丢失。异步模式可以保证崩溃恢复到一致的状态,但一些最新的数据更新可能会丢失。

11.2.2 数据损坏

技术设备并不是完美无缺的,数据在内存中、磁盘上,或通过接口电缆传输时都可能受损。这类错误通常在硬件层处理,但仍有些可能会遗漏。

为了及时发现问题,PostgreSQL 始终通过校验和保护 WAL 条目。

数据页也可以计算校验和 13。这可以在集群初始化期间完成,也可以在服务器停止时 14 通过运行 pg_checksumv. 12 15 工具来完成。

在生产系统中,应该始终启用校验和,尽管有一些 (较小的) 计算和验证的开销。这提高了及时发现数据损坏的机会,即使仍然会存在一些极端的情况:

  • 只有在访问页面时才会执行校验和检验,因此数据损坏可能会在很长一段时间内都不会被察觉,直到它扩散到所有备份,导致没有了正确数据的来源。

  • 被归零的页面被视为是正确的,因此如果文件系统错误地将页面归零,那么这个问题将不会被发现。

  • 校验和仅针对表的主分支计算;其他分支和文件 (例如 CLOG 中的事务状态) 仍然不受保护。

让我们看一下只读 data_checksums 参数,以确保启用了校验和:

=> SHOW data_checksums;
 data_checksums
−−−−−−−−−−−−−−−−
 on
(1 row)

现在停止服务器,并将表的主分支的第零页中的若干字节清零:

=> SELECT pg_relation_filepath('wal');
 pg_relation_filepath
−−−−−−−−−−−−−−−−−−−−−−
 base/16391/16562
(1 row)

postgres$ pg_ctl stop
postgres$ dd if=/dev/zero of=/usr/local/pgsql/data/base/16391/16562 \
oflag=dsync conv=notrunc bs=1 count=8
8+0 records in
8+0 records out
8 bytes copied, 0,00776573 s, 1,0 kB/s

再次启动服务器:

postgres$ pg_ctl start -l /home/postgres/logfile

实际上,我们可以让服务器保持运行 — 只需将页面写入磁盘并将其从缓存中驱逐 (否则,服务器将继续使用其缓存版本)。但这样的工作流程难以复现。

现在,让我们尝试读取该表:

=> SELECT * FROM wal LIMIT 1;
WARNING: page verification failed, calculated checksum 20397 but
expected 28733
ERROR: invalid page in block 0 of relation base/16391/16562

如果无法从备份中恢复数据,那么至少尝试读取损坏的页面是有意义的 (有可能得到混乱的输出)。 为此,你需要启用 ignore_checksum_failureoff 参数:

=> SET ignore_checksum_failure = on;
=> SELECT * FROM wal LIMIT 1;
WARNING: page verification failed, calculated checksum 20397 but
expected 28733
 id
−−−−
  2
(1 row)

在此情况下,一切都进行得很顺利,因为我们损坏的是页头的非关键部分 (最新 WAL 条目的 LSN),而不是数据本身。

11.2.3 非原子写

数据库页面通常占 8 kB,但是在更底层,写入是按块执行的,这些块通常更小 (通常是 512 字节或 4 kB)。 因此,如果发生故障,页面可能仅写入了部分。在恢复期间,将常规的 WAL 条目应用于这类页面是没有意义的。

为了避免部分写入,PostgreSQL 会在 WAL 中保存检查点启动之后首次被修改页面的完整镜像 (FPI)。此行为由 full_page_writeson 参数控制,但将其关闭可能会导致严重的数据损坏。

如果恢复进程在 WAL 中遇到了 FPI ,那么它将无条件地将其写入磁盘 (不检查它的 LSN );就像任何 WAL 条目一样,FPI 也受到校验和的保护,因此其损坏不会被忽视。然后,常规 WAL 条目将应用于这一状态,这一状态被保证是正确的。

没有单独的 WAL 条目类型用于设置提示位:这种操作被认为是非关键性的,因为任何访问页面的查询都会重新设置所需的位。但是,任何提示位的更改都会影响页面的校验和。 因此,如果启用了校验和 (或者打开了 wal_log_hintsoff 参数),提示位的修改也将记录为 FPIs 16。

即使日志机制从 FPI 17 中排除了空白空间,生成的 WAL 文件的大小仍然会显著增加。如果通过 wal_compressionoff 参数启用了 WAL 压缩,这种情况可以大大改善。

让我们使用 pgbench 工具进行一个简单的实验。我们将执行一个检查点,并立即开始一项带有事务数量限制的基准测试:

=> CHECKPOINT;
=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/42CE5DA8
(1 row)

postgres$ /usr/local/pgsql/bin/pgbench -t 20000 internals
=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/449113E0
(1 row)

这是生成的 WAL 条目的大小:

=> SELECT pg_size_pretty('0/449755C0'::pg_lsn - '0/42CE5DA8'::pg_lsn);
 pg_size_pretty
−−−−−−−−−−−−−−−−
 29 MB
(1 row)

在此示例中,FPIs 占总 WAL 大小的一半以上。你可以在收集的统计数据中查看,其中显示了每种资源类型 (Type) 的 WAL 条目数量 (N)、常规条目的大小 (Record size) 以及 FPI 大小:

postgres$ /usr/local/pgsql/bin/pg_waldump --stats \
-p /usr/local/pgsql/data/pg_wal -s 0/42CE5DA8 -e 0/449755C0
Type            N      (%)   Record size      (%)   FPI size      (%)
−−−−            −      −−−   −−−−−−−−−−−      −−−   −−−−−−−−      −−−
XLOG         4294 (  3,31)        210406 (  2,50)   19820068 ( 93,78)
Transaction 20004 ( 15,41)        680536 (  8,10)          0 (  0,00)
Storage         1 (  0,00)            42 (  0,00)          0 (  0,00)
CLOG            1 (  0,00)            30 (  0,00)          0 (  0,00)
Standby         6 (  0,00)           416 (  0,00)          0 (  0,00)
Heap2       24774 ( 19,09)       1536253 ( 18,27)      24576 (  0,12)
Heap        80234 ( 61,81)       5946242 ( 70,73)     295664 (  1,40)
Btree         494 (  0,38)         32747 (  0,39)     993860 (  4,70)
           −−−−−−               −−−−−−−−            −−−−−−−−
Total      129808                8406672 [28,46%]   21134168 [71,54%]

如果数据页在检查点之间被多次修改,这个比率会更小。这是另一个减少执行检查点的原因。

重复相同的实验,看看压缩是否有帮助。

=> ALTER SYSTEM SET wal_compression = on;
=> SELECT pg_reload_conf();
=> CHECKPOINT;

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/44EBC518
(1 row)
postgres$ /usr/local/pgsql/bin/pgbench -t 20000 internals
=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/45975008
(1 row)

这是启用压缩后的 WAL 大小:

=> SELECT pg_size_pretty('0/457653B0'::pg_lsn - '0/44D4C228'::pg_lsn);
 pg_size_pretty
−−−−−−−−−−−−−−−−
 10 MB
(1 row)
postgres$ /usr/local/pgsql/bin/pg_waldump --stats \
-p /usr/local/pgsql/data/pg_wal -s 0/44D4C228 -e 0/457653B0
Type            N      (%)       Record size      (%)   FPI size      (%)
−−−−            −      −−−       −−−−−−−−−−−      −−−   −−−−−−−−      −−−
XLOG          344 (  0,29)             17530 (  0,22)     435492 ( 17,75)
Transaction 20001 ( 16,73)            680114 (  8,68)          0 (  0,00)
Storage         1 (  0,00)                42 (  0,00)          0 (  0,00)
Standby         5 (  0,00)               330 (  0,00)          0 (  0,00)
Heap2       18946 ( 15,84)           1207425 ( 15,42)     101601 (  4,14)
Heap        80141 ( 67,02)           5918020 ( 75,56)    1627008 ( 66,31)
Btree         143 (  0,12)              8443 (  0,11)     289654 ( 11,80)
           −−−−−−                   −−−−−−−−            −−−−−−−−
Total      119581                    7831904 [76,14%]    2453755 [23,86%]

总而言之,当启用了校验和或 full_page_writes 导致了大量 FPI 时 (几乎总是如此),尽管会有一些额外的 CPU 开销,使用压缩仍是有意义的。

11.3 WAL 级别

预写日志的主要目的是实现崩溃恢复。但是,如果你扩展了记录信息的范围,那么 WAL 也可以用于其他目的。PostgreSQL 提供了 minimal、replica 和 logical 三个日志级别。每个级别包括前一个级别记录的所有内容,并增加了一些额外信息。

正在使用的级别由 wal_levelreplica 参数定义;修改这个参数需要重启服务器。

11.3.1 Minimal

minimal 级别仅保证崩溃恢复。为了节省空间,如果当前事务中创建或截断表的操作涉及大量数据插入 (比如 CREATE TABLE AS SELECT 或者 CREATE INDEX 命令) 18,则不记录这些操作。所有需要的数据都会立即刷新到磁盘,而不是记录这些操作,并且系统表的更改在事务提交后立即可见。

如果此类操作因故障而中断,那么已写入磁盘的数据会不可见,一致性不会受到影响。如果操作完成时发生了故障,所有需要应用后续 WAL 条目的数据都已保存至磁盘上了。

对于新创建的表,必须写入以使此优化生效v. 13的数据量由 wal_skip_threshold2MB 参数定义。

让我们看看在 minimal 级别记录了什么。

默认情况下,使用了更高的 replica 级别v. 10,此级别支持数据复制。如果选择 minimal 级别,还必须在 max_wal_senders10 参数中将允许的 walsender 进程数设置为零:

=> ALTER SYSTEM SET wal_level = minimal;
=> ALTER SYSTEM SET max_wal_senders = 0;

为使这些更改生效,需要重启服务器:

postgres$ pg_ctl restart -l /home/postgres/logfile

注意此时 WAL 的位置:

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/45767698
(1 row)

截断表并在同一事务中继续插入新行,直至超过了 wal_skip_threshold:

=> BEGIN;
=> TRUNCATE TABLE wal;
=> INSERT INTO wal
     SELECT id FROM generate_series(1,100000) id;
=> COMMIT;
=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/45767840
(1 row)

我使用了 TRUNCATE 命令而不是创建新表,因为这生成的 WAL 条目更少。

让我们使用已经掌握的 pg_waldump 工具来检查生成的 WAL。

postgres$ /usr/local/pgsql/bin/pg_waldump \
-p /usr/local/pgsql/data/pg_wal -s 0/45767698 -e 0/45767840#
rmgr: Storage     len (rec/tot):     42/    42, tx:          0, lsn:
0/45767698, prev 0/45767660, desc: CREATE base/16391/24784
rmgr: Heap        len (rec/tot):    123/   123, tx:     122844, lsn:
0/457676C8, prev 0/45767698, desc: UPDATE off 45 xmax 122844 flags
0x60 ; new off 48 xmax 0, blkref #0: rel 1663/16391/1259 blk 0
rmgr: Btree       len (rec/tot):     64/    64, tx:     122844, lsn:
0/45767748, prev 0/457676C8, desc: INSERT_LEAF off 176, blkref #0:
rel 1663/16391/2662 blk 2
rmgr: Btree       len (rec/tot):    64/     64, tx:     122844, lsn:
0/45767788, prev 0/45767748, desc: INSERT_LEAF off 147, blkref #0:
rel 1663/16391/2663 blk 2
rmgr: Btree       len (rec/tot):    64/     64, tx:     122844, lsn:
0/457677C8, prev 0/45767788, desc: INSERT_LEAF off 254, blkref #0:
rel 1663/16391/3455 blk 4
rmgr: Transaction len (rec/tot):    54/     54, tx:     122844, lsn:
0/45767808, prev 0/457677C8, desc: COMMIT 2023−03−06 14:03:58.395214
MSK; rels: base/16391/24783

第一个条目记录了新表的创建 (因为 TRUNCATE 实际上重写了表)。

接下来的四个条目与系统表操作相关。它们反映了 pg_class 表及其三个索引的更改。

最后,还有一个与提交相关的条目。数据插入没有被记录。

11.3.2 Replica

在崩溃恢复期间,重放 WAL 条目以恢复磁盘上的数据,达到一致的状态。备份恢复以类似的方式工作,但它还可以使用 WAL 归档将数据库状态恢复至指定的恢复目标点。归档 WAL 条目的数量可能非常大 (例如,跨越好几天),因此恢复周期将包括多个检查点。因此,minimal 级别是不够的:如果操作未被记录,就无法重复执行它。对于备份恢复,WAL 文件必须包含所有的操作。

复制也是如此:未记录日志的命令不会发送到备库,也不会在备库上重放。

如果备库用于执行查询,那么事情会变得更加复杂。首先,备库需要知道在主库上获取的排它锁的信息,因为这些排它锁可能与备库上的查询冲突。其次,备库必须能够捕获快照,这需要活跃事务的信息。当我们处理备库时,本地事务和在主库上运行的事务都必须考虑在内。

将这些数据发送给备库的唯一方式是定期将其写入 WAL 19 文件。这项工作由 bgwriter 20 进程完成,每 15 秒执行一次 (此间隔时间是硬编码的)。

从备份中进行数据恢复和使用物理复制的能力在 replica 级别下得到保证。

默认使用 replica 级别 ,因此我们可以简单地重置上面配置的参数并重启服务器:

=> ALTER SYSTEM RESET wal_level;
=> ALTER SYSTEM RESET max_wal_senders;

postgres$ pg_ctl restart -l /home/postgres/logfile

让我们重复与之前相同的工作流 (但这次我们将只插入一行,以获得更整洁的输出):

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/45D88E48
(1 row)

=> BEGIN;
=> TRUNCATE TABLE wal;
=> INSERT INTO wal VALUES (42);
=> COMMIT;

=> SELECT pg_current_wal_insert_lsn();
 pg_current_wal_insert_lsn
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 0/45D89108
(1 row)

看一下生成的 WAL 条目。

除了我们在 minimal 级别看到的内容之外,我们还获得了以下条目:

  • 与复制相关的 Standby 资源管理器条目:RUNNING_XACTS (活跃事务) 和 LOCK

  • 记录 INSERT + INIT 操作的条目,该操作初始化了一个新页面并将新行插入到此页面

postgres$ /usr/local/pgsql/bin/pg_waldump \
-p /usr/local/pgsql/data/pg_wal -s 0/45D88E48 -e 0/45D89108
rmgr: Standby     len (rec/tot):     42/    42, tx:     122846, lsn:
0/45D88E48, prev 0/45D88DD0, desc: LOCK xid 122846 db 16391 rel 16562
rmgr: Storage     len (rec/tot):     42/    42, tx:     122846, lsn:
0/45D88E78, prev 0/45D88E48, desc: CREATE base/16391/24786
rmgr: Heap        len (rec/tot):    123/   123, tx:     122846, lsn:
0/45D88EA8, prev 0/45D88E78, desc: UPDATE off 49 xmax 122846 flags
0x60 ; new off 50 xmax 0, blkref #0: rel 1663/16391/1259 blk 0
rmgr: Btree       len (rec/tot):    64/     64, tx:     122846, lsn:
0/45D88F28, prev 0/45D88EA8, desc: INSERT_LEAF off 178, blkref #0:
rel 1663/16391/2662 blk 2
rmgr: Btree       len (rec/tot):    64/     64, tx:     122846, lsn:
0/45D88F68, prev 0/45D88F28, desc: INSERT_LEAF off 149, blkref #0:
rel 1663/16391/2663 blk 2
rmgr: Btree       len (rec/tot):    64/     64, tx:     122846, lsn:
0/45D88FA8, prev 0/45D88F68, desc: INSERT_LEAF off 256, blkref #0:
rel 1663/16391/3455 blk 4
rmgr: Heap        len (rec/tot):    59/     59, tx:     122846, lsn:
0/45D88FE8, prev 0/45D88FA8, desc: INSERT+INIT off 1 flags 0x00,
blkref #0: rel 1663/16391/24786 blk 0
rmgr: Standby     len (rec/tot):    42/     42, tx:          0, lsn:
0/45D89028, prev 0/45D88FE8, desc: LOCK xid 122846 db 16391 rel 16562
rmgr: Standby     len (rec/tot):    54/     54, tx:          0, lsn:
0/45D89058, prev 0/45D89028, desc: RUNNING_XACTS nextXid 122847
latestCompletedXid 122845 oldestRunningXid 122846; 1 xacts: 122846
rmgr: Transaction len (rec/tot):   114/    114, tx:     122846, lsn:
0/45D89090, prev 0/45D89058, desc: COMMIT 2023−03−06 14:04:14.538399
MSK; rels: base/16391/24785; inval msgs: catcache 51 catcache 50
relcache 16562

11.3.3 Logical

最后但同样重要的是,logical 级别支持逻辑解码和逻辑复制。它必须在发布端激活。

如果我们查看 WAL 条目,会发现该级别与 replica 几乎相同:它添加了与复制源相关的条目,以及一些可能由应用程序生成的任意逻辑条目。大多数情况下,逻辑解码依赖于有关活跃事务的信息 (RUNNING_XACTS),因为逻辑解码需要捕获快照以跟踪系统表的更改。


  1. backend/replication/walsender.c ↩︎

  2. backend/access/transam/xlogreader.c ↩︎

  3. backend/access/transam/xlog.c, XLogFlush function ↩︎

  4. backend/access/transam/xlog.c, RecordTransactionCommit function ↩︎

  5. postgresql.org/docs/14/wal-async-commit.html ↩︎

  6. backend/postmaster/walwriter.c ↩︎

  7. backend/access/transam/xlog.c, XLogBackgroundFlush function ↩︎

  8. postgresql.org/docs/14/pgbench.html ↩︎

  9. postgresql.org/docs/14/wal-reliability.html ↩︎

  10. backend/access/transam/xlog.c, issue_xlog_fsync function ↩︎

  11. backend/storage/sync/sync.c ↩︎

  12. backend/storage/file/fd.c, pg_fsync function ↩︎

  13. backend/storage/page/README ↩︎

  14. commitfest.postgresql.org/27/2260 ↩︎

  15. postgresql.org/docs/14/app-pgchecksums.html ↩︎

  16. backend/storage/buffer/bufmgr.c, MarkBufferDirtyHint function ↩︎

  17. backend/access/transam/xloginsert.c, XLogRecordAssemble function ↩︎

  18. include/utils/rel.h, RelationNeedsWAL macro ↩︎

  19. backend/storage/ipc/standby, LogStandbySnapshot function ↩︎

  20. backend/postmaster/bgwriter.c ↩︎

第三部分:锁

第三部分:锁。

本分部页按原书结构编排,用于中英目录对照。

12 关系级锁

12.1 关于锁

锁用于控制对共享资源的并发访问。

并发访问意味着多个进程试图同时获取同一个资源。这些进程是并行执行 (如果硬件允许) 还是以分时模式顺序执行并没有区别。如果没有并发访问,那么就没有必要获取锁 (例如,共享缓冲区缓存需要加锁,而本地缓存则可以不需要锁)。

在访问资源之前,进程必须获取该资源上的锁;操作完成之后,必须释放这个锁,以使资源可以供其他进程使用。如果锁由数据库系统管理,那么会自动维护操作的既定顺序;如果锁由应用程序控制,则必须由应用程序本身来执行协议。

在底层,锁只是一个定义了锁状态 (是否已获得) 的共享内存块;它还可以提供一些附加信息,比如进程号或获取时间。

正如你所猜测的,共享内存段本身就是一种资源。对此类资源的并发访问由操作系统提供的同步原语 (例如信号量或互斥锁) 控制。它们用于保证访问共享资源的代码严格连续执行。在最底层,这些原语基于原子 CPU 指令 (比如 test-and-set 或 compare-and-swap)。

一般来说,我们可以使用锁来保护任何资源,只要它可以被明确识别并分配一个特定的锁地址。

例如,我们可以锁定一个数据库对象,比如表 (通过系统表中的 oid 标识)、数据页 (通过文件名和该文件中的位置标识)、行版本 (通过页面和该页面内的偏移量标识)。我们还可以锁定内存结构,例如哈希表或者缓冲区 (通过分配的 ID 标识)。 我们甚至可以锁定没有物理表示的抽象资源。

但锁并不总是能够立即获取到:资源可能已经被其他人锁定。然后,进程要么加入队列 (如果这种特定的锁类型允许的话),要么稍后再试。无论哪种方式,它都必须等待锁被释放。

我需要特别指出两个可能极大影响锁定效率的因素。

粒度,或者说锁的"粒度大小"。在资源形成层次结构时很重要。

例如,表由页面组成,而页面又由元组组成。所有这些对象都可以被锁保护。表级锁是粗粒度的;即使进程需要访问不同的页面或者行,表级锁也禁止并发访问。行级锁是细粒度的,所以没有这个缺点;但是,锁的数量会增加。为了避免锁相关的元数据占用过多的内存,PostgreSQL 可以使用多种方式,其中之一是锁升级:如果细粒度锁的数量超过了一定阈值,那么它们会被更粗粒度的单个锁替换。

锁可以被获取的模式集合。

通常,仅应用两种模式。独占模式与所有其它模式不兼容,包括它自己。共享模式允许资源同时被多个进程锁定。共享模式可用于读取,而独占模式用于写入。通常来说,也可能有其他模式。模式的名称并不重要,重要的是它们的兼容性矩阵。

更细的粒度和对多个兼容模式的支持为并发执行提供了更多基础。

所有锁都可以根据其持续时间进行分类。

长锁可能会获取很长时间 (在大多数情况下,直到事务结束);它们通常用于保护诸如关系和行之类的资源。这些锁通常由 PostgreSQL 自动管理,但用户仍然可以控制这个过程。

长锁提供了多种模式,可以对数据进行各种并发操作。它们通常具有广泛的基础设施 (包括等待队列、死锁检测和监测机制等功能),其维护成本无论如何都远低于对受保护数据的操作。

短锁的持续时间只有几分之一秒,而且很少会持续超过几个 CPU 指令;它们通常用于保护共享内存中的数据结构。PostgreSQL 以完全自动化的方式管理这些锁。

短锁通常只提供非常少的模式和基本的基础设施,可能根本没有监测机制。

PostgreSQL 支持各种类型的锁 1。重锁 (在关系和其他对象上获取) 和行级锁被视为长锁。短锁包括内存结构上的各种锁。此外,还有一组独特的谓词锁,尽管其名字如此,实际上它根本不是锁。

12.2 重锁

重锁是长锁。在对象级别获取,主要用于表,但也可应用于其他类型的对象。重锁通常用于保护对象不受并发更新的影响,或在重组期间禁止使用它们,但重锁也可以解决其他需求。这种模糊的定义是有意为之:这种类型的锁可以用于各种目的。唯一的共同点是它们的内部结构。

除非另有明确说明,否则术语 lock 通常意味着重锁。

重锁位于服务器的共享内存中 2,可以在 pg_locks 视图中查看。重锁的总数受到 max_locks_per_transaction64 乘以 max_connections100 的限制。

所有事务都使用一个共同的锁池,因此一个事务可以获取超过 max_locks_per_transaction 数量的锁。真正重要的是,系统中锁的总数不能超过所定义的限制。由于在服务器启动时会初始化锁池,因此更改这两个参数中的任何一个都需要重启服务器。

如果某个资源已经以一个不兼容的模式锁定,那么试图获取另一个锁的进程会加入到队列之中。等待的进程不会浪费 CPU 时间:它们会进入休眠状态,直到锁被释放并且操作系统将它们唤醒。

如果第一个事务无法继续其操作,直到它获得另一个事务锁定的资源,而后者又需要第一个事务锁定的资源,那么这两个事务可能会陷入死锁。这种情况相对简单;死锁也可能涉及两个以上的事务。由于死锁会导致无限期等待,PostgreSQL 会自动检测它们,并中止其中一个受影响的事务,以确保可以继续正常操作。

不同类型的重锁有不同的用途,保护不同的资源,并支持不同的模式,因此我们将分别考虑它们。

以下列表提供了在 pg_locks 视图的 locktype 列中出现的锁类型名称:

transactionid 和 virtualxid — 事务 ID 上的锁

relation — 关系级锁

tuple — 元组上获取的锁

object — 非关系对象上的锁

extend — 表扩展锁

page — 某些索引类型使用的页级锁

advisory — 咨询锁

几乎所有重锁都是根据需要自动获取的,并在相应事务完成时自动释放。但也有一些例外:例如,可以显式设置关系级锁,而咨询锁始终由用户管理。

12.3 事务 ID 上的锁

每个事务总是持有其自身事务 ID 的独占锁 (无论是虚拟的还是实际的,如果有的话)。

PostgreSQL 为此提供了两种锁定模式,独占模式和共享模式。其兼容矩阵非常简单:共享模式与自身兼容,而独占模式不能与任何模式组合。
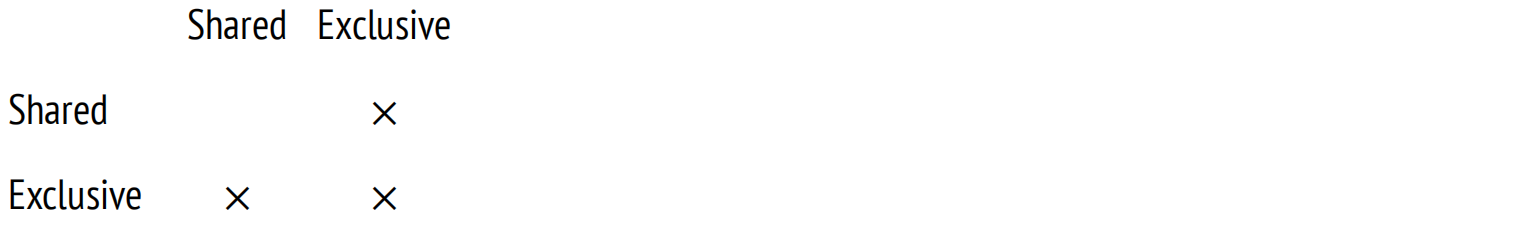
12.3 事务 ID 上的锁:插图 1
图 12.1

为了跟踪特定事务的完成情况,进程可以在任何模式下请求对该事务 ID 的锁。由于事务本身已经持有对其自身 ID 的独占锁,因此无法获取其他的锁。请求该锁的进程会加入队列并进入休眠状态。一旦事务完成,锁就会被释放,排队的进程就会被唤醒。显然,由于相应的资源已经不存在了,它不会设法获取锁,但这个锁本来就不是真正需要的。

在一个单独的会话中启动一个事务,并获取该后端进程的进程 ID (PID):

=> BEGIN;
=> SELECT pg_backend_pid();
 pg_backend_pid
−−−−−−−−−−−−−−−−
          28980
(1 row)

已启动的事务持有对其自身虚拟 ID 的独占锁:

=> SELECT locktype, virtualxid, mode, granted
FROM pg_locks WHERE pid = 28980;
  locktype  | virtualxid |     mode      | granted
−−−−−−−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−
 virtualxid | 5/2        | ExclusiveLock | t
(1 row)

此处的 locktype 是锁的类型,virtualxid 是虚拟事务ID (用于标识锁定的资源),mode 是锁定模式 (在本例中为独占模式)。granted 标志显示是否已获取到请求的锁。

一旦事务获取了真实 ID,相应的锁就会被添加到这个列表中:

=> SELECT pg_current_xact_id();
 pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
             122849
(1 row)
=> SELECT locktype, virtualxid, transactionid AS xid, mode, granted FROM pg_locks WHERE pid = 28980;
   locktype    | virtualxid |  xid 	 |     mode      | granted
−−−−−−−−−−−−−−−+−−−−−−−−−−−−+−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−
 virtualxid    | 5/2        |        | ExclusiveLock | t
 transactionid |            | 122849 | ExclusiveLock | t
(2 rows)

现在,这个事务对其两个 ID 均持有独占锁。

12.4 关系级锁

PostgreSQL 提供了多达八种模式的锁,用于锁定关系 (表、索引或任何其他对象) 3。这样的多样性可以使一个关系上允许并发运行的命令数量最大化。

下面显示了兼容性矩阵,并扩展了需要相应锁模式的命令示例。没有必要记住所有这些模式或试图找出它们命名背后的逻辑,但是翻阅这些数据,得出一些一般性的结论,并在需要时参考这个表肯定是有用的。
12.4 关系级锁:插图 2
图 12.2

Access Share 是最弱的模式;它可以与其他任何模式一起使用,除了 Access Exclusive,后者与所有模式都不兼容。因此,SELECT 命令几乎可以与任何操作并行执行,但不允许删除正在查询的表。

前四种模式允许并发堆修改,而其他四种模式不允许。例如, CREATE INDEX 命令使用 Share 模式,此模式与自身兼容 (因此你可以在一个表上同时创建多个索引),并且与只读操作使用的模式相兼容。因此,SELECT 命令可以与索引创建并行运行,而 INSERT,UPDATE 和 DELETE 命令将被阻塞。

相反,未完成的修改堆数据的事务会阻塞 CREATE INDEX 命令。作为替代,你可以使用 CREATE INEDX CONCURRENTLY,它使用了更弱的 Share Update Exclusive 模式:创建索引需要的时间更长 (此操作甚至可能失败),但作为回报,它允许并发数据修改。

ALTER TABLE 命令有多种模式,它们使用不同的锁模式 (Share Update Exclusive、Share Row Exclusive、Access Exclusives)。所有模式都在文档中有所描述 4。

本书这一部分的例子仍然基于 accounts 表:

=> TRUNCATE accounts;
=> INSERT INTO accounts(id, client, amount)
VALUES
  (1, 'alice',   100.00),
  (2, 'bob',     200.00),
  (3, 'charlie', 300.00);

我们需要多次访问 pg_locks 表,所以让我们创建一个视图以在单独的列中显示所有 ID,从而使输出更加简洁:

=> CREATE VIEW locks AS
SELECT pid,
  locktype,
  CASE locktype
    WHEN 'relation' THEN relation::regclass::text
    WHEN 'transactionid' THEN transactionid::text
    WHEN 'virtualxid' THEN virtualxid
  END AS lockid,
  mode,
  granted
FROM pg_locks
ORDER BY 1, 2, 3;

第一个会话中仍在运行的事务将更新一行。这个操作会锁定 accounts 表及其所有索引,从而在 Row Exclusive 模式下获得了两个新的 relation 类型的锁:

=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> SELECT locktype, lockid, mode, granted
FROM locks WHERE pid = 28991;
   locktype    |    lockid     |       mode       | granted
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 relation      | accounts      | RowExclusiveLock | t
 relation      | accounts_pkey | RowExclusiveLock | t
 transactionid | 122849        | ExclusiveLock    | t
 virtualxid    | 5/2           | ExclusiveLock    | t
(4 rows)

12.5 等待队列

重锁形成了一个公平的等待队列 5。如果进程试图获取与当前锁或与队列中其他进程已请求的锁不兼容的锁,那么这个进程就会加入队列。

当第一个会话在进行更新时,让我们在另一个会话中尝试在此表上创建索引:

=> SELECT pg_backend_pid();
 pg_backend_pid
−−−−−−−−−−−−−−−−
          29459
(1 row)
=> CREATE INDEX ON accounts(client);

命令会夯住,等待资源的释放。事务试图在共享模式下锁定此表,但无法做到:

=> SELECT locktype, lockid, mode, granted
FROM locks WHERE pid = 29459;
  locktype  |  lockid  |     mode      | granted
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−
 relation 	| accounts | ShareLock     | f
 virtualxid | 6/3      | ExclusiveLock | t
(2 rows)

现在于第三个会话中执行 VACUUM FULL 命令。它也会加入队列,因为它需要获取 Access Exclusive 模式的锁,这与其他所有模式冲突:

=> SELECT pg_backend_pid();
 pg_backend_pid
−−−−−−−−−−−−−−−−
          29662
(1 row)
=> VACUUM FULL accounts;
=> SELECT locktype, lockid, mode, granted
FROM locks WHERE pid = 29662;
   locktype    |  lockid  |        mode         | granted
−−−−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 relation      | accounts | AccessExclusiveLock | f
 transactionid | 122853   | ExclusiveLock       | t
 virtualxid    | 7/4      | ExclusiveLock       | t
(3 rows)

所有后续的竞争者现在都必须加入队列,无论其锁定模式如何。即使是简单的 SELECT 查询也会老老实实排在 VACUUM FULL 之后,尽管它与执行更新的第一个会话所持有的 Row Exclusive 兼容。
=> SELECT pg_backend_pid();
 pg_backend_pid
−−−−−−−−−−−−−−−−
          29872
(1 row)
=> SELECT * FROM accounts;
=> SELECT locktype, lockid, mode, granted
FROM locks WHERE pid = 29872;
  locktype  |  lockid  |      mode       | granted
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−+−−−−−−−−−
 relation 	| accounts | AccessShareLock | f
 virtualxid | 8/3      | ExclusiveLock   | t
(2 rows)
12.5 等待队列:插图 3
图 12.3

pg_blocking_pids v. 9.6 函数提供了所有等待的高层次概览情况。它显示了排在指定进程前面的所有进程 ID,这些进程已经持有或想要获取一个不兼容的锁:

=> SELECT pid,
  pg_blocking_pids(pid),
  wait_event_type,
  state,
  left(query,50) AS query
FROM pg_stat_activity
WHERE pid IN (28980,29459,29662,29872) \gx
−[ RECORD 1 ]−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
pid              | 28980
pg_blocking_pids | {}
wait_event_type  | Client
state            | idle in transaction
query            | UPDATE accounts SET amount = amount + 100.00 WHERE
−[ RECORD 2 ]−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
pid              | 29459
pg_blocking_pids | {28980}
wait_event_type  | Lock
state            | active
query            | CREATE INDEX ON accounts(client);
−[ RECORD 3 ]−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
pid              | 29662
pg_blocking_pids | {28980,29459}
wait_event_type  | Lock
state            | active
query            | VACUUM FULL accounts;
−[ RECORD 4 ]−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
pid              | 29872
pg_blocking_pids | {29662}
wait_event_type  | Lock
state            | active
query            | SELECT * FROM accounts;

要获得更多详细信息,你可以查看 pg_locks 表中提供的信息 6。

一旦事务完成 (无论提交还是中止),该事务所有的锁都会被释放 7。队列中第一个进程获得所请求的锁并被唤醒。

此处,提交第一个会话中的事务会使所有排队的进程顺序执行:

=> ROLLBACK;
ROLLBACK
CREATE INDEX
VACUUM
 id | client  | amount
−−−−+−−−−−−−−−+−−−−−−−−
  1 | alice   | 100.00
  2 | bob     | 200.00
  3 | charlie | 300.00
(3 rows)

  1. backend/storage/lmgr/README ↩︎

  2. backend/storage/lmgr/lock.c ↩︎

  3. postgresql.org/docs/14/explicit-locking#LOCKING-TABLES.html ↩︎

  4. postgresql.org/docs/14/sql-altertable.html ↩︎

  5. backend/storage/lmgr/lock.c, LockAcquire function ↩︎

  6. wiki.postgresql.org/wiki/Lock_dependency_information ↩︎

  7. backend/storage/lmgr/lock.c, LockReleaseAll & LockRelease functions ↩︎

13 行级锁

13.1 锁设计

得益于快照隔离,读取时无需对堆元组加锁。但是,不允许两个写事务同时修改同一行。在这种情况下,必须对行加锁,但为此重锁并不是一个好的选择:每个重锁都会占用服务器共享内存中的空间 (数百字节,更别提所有支持的基础设施了),而且 PostgreSQL 的内部机制也不适用于处理大量并发的重锁。

一些数据库系统通过锁升级来解决这个问题:如果行级锁太多,它们会被更细粒度的单个锁替换 (例如,页级锁或表级锁)。这简化了实现,但极大限制了系统的吞吐量。

在 PostgreSQL 中,某个特定的行是否被锁定的信息仅保存在其当前堆元组的元组头中。行级锁实际上是堆页面中的属性,而不是实际的锁,并且不会以任何方式反映在 RAM 中。

行通常在被更新或删除时进行加锁。在这两种情况下,行的当前版本都被标记为已删除。用于此目的的属性是在 xmax 字段中指定的当前事务 ID,同时也是这个 ID 表明该行被锁定了 (与额外的提示位相结合)。如果一个事务想要修改一行,但是在其当前版本的 xmax 字段上看到一个活跃的事务 ID,那么它必须等待这个事务完成。一旦事务结束,所有的锁都会被释放,等待的事务便可以继续。

此机制允许按需锁定任意数量的行,而无需额外成本。

这种方案的缺点是其他进程无法形成队列,因为 RAM 中不包含关于这种锁的信息。因此,仍然需要重锁:等待行释放的进程会请求当前正在处理该行的事务 ID 上的锁。一旦事务完成,这一行便再次可用。因此,重锁的数量与并发进程的数量成正比,而不是被修改的行数。

13.2 行级锁模式

行级锁支持四种模式 1。其中两种实现了独占锁,一次只能由一个事务获取,而另外两种提供了共享锁,可以同时由多个事务持有。

以下是这些模式的兼容性矩阵:
13.2 行级锁模式:插图 1
图 13.1

13.2.1 独占模式

Update 模式允许修改任何元组字段,甚至删除整个元组,而 No Key Update 模式只允许那些不涉及与唯一索引相关字段的更改 (换句话说,外键必须不受影响)。

UPDATE 命令会自动选择可能最弱的锁定模式;键通常保持不变,因此行通常在 No Key Update 模式下被锁定。

让我们创建一个函数,使用 pageinspect 显示我们感兴趣的一些元组元数据,即 xmax 字段和若干提示位:

=> CREATE FUNCTION row_locks(relname text, pageno integer)
RETURNS TABLE(
  ctid tid, xmax text,
  lock_only text, is_multi text,
  keys_upd text, keyshr text,
  shr text
)
AS $$
SELECT (pageno,lp)::text::tid,
  t_xmax,
  CASE WHEN t_infomask  & 128 	= 128 	THEN 't' END,
  CASE WHEN t_infomask 	& 4096  = 4096 	THEN 't' END,
  CASE WHEN t_infomask2 & 8192  = 8192  THEN 't' END,
  CASE WHEN t_infomask  & 16    = 16    THEN 't' END,
  CASE WHEN t_infomask  & 16+64 = 16+64 THEN 't' END
FROM heap_page_items(get_raw_page(relname,pageno))
ORDER BY lp;
$$ LANGUAGE sql;

现在在 accounts 表上开启一个事务,以更新第一个帐户的余额 (键保持不变) 和第二个帐户的 ID (键更新了):

=> BEGIN;
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> UPDATE accounts SET id = 20 WHERE id = 2;

页面现在包含以下元数据:

=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  |  xmax  | lock_only | is_multi | keys_upd | keyshr | shr
−−−−−−−+−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−+−−−−−
 (0,1) | 122858 |           |          |          |        |
 (0,2) | 122858 |           |          | t        |        |
(2 rows)

锁定模式由 keys_updated 提示位定义。

=> ROLLBACK;

SELECT FOR 命令使用与锁定属性相同的 xmax 字段,但在这种情况下还必须设置 xmax_lock_only 提示位。这个提示位表示这条元组被锁定而不是被删除,这意味着它仍然是当前版本:

=> BEGIN;
=> SELECT * FROM accounts WHERE id = 1 FOR NO KEY UPDATE;
=> SELECT * FROM accounts WHERE id = 2 FOR UPDATE;
=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  |  xmax  | lock_only | is_multi | keys_upd | keyshr | shr
−−−−−−−+−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−+−−−−−
 (0,1) | 122859 | t         |          |          |        |
 (0,2) | 122859 | t         |          | t        |        |
(2 rows)
=> ROLLBACK;

13.2.2 共享模式

当需要读取行时,可以使用共享模式,但必须禁止其他事务对这一行的更改。Key Share 模式允许更新除键属性之外的任何元组字段。

在所有共享模式中,PostgreSQL 内核仅使用 Key Share 模式,这在检查外键时使用。由于它与 No Key Update 独占模式兼容,因此外键检查不会干扰非键属性的并发更新。至于应用,可以使用任何它们喜欢的共享模式。

再次强调:简单的 SELECT 命令从不使用行级锁。

=> BEGIN;
=> SELECT * FROM accounts WHERE id = 1 FOR KEY SHARE;
=> SELECT * FROM accounts WHERE id = 2 FOR SHARE;

以下是我们可以在堆元组中看到的:

=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  |  xmax  | lock_only | is_multi | keys_upd | keyshr | shr
−−−−−−−+−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−+−−−−−
 (0,1) | 122860 | t         |          |          | t      |
 (0,2) | 122860 | t         |          |          | t      | t
(2 rows)

这两个操作都设置了 xmax_keyshr_lock 位,但你可以通过其他提示位识别 Share 模式 2。

13.3 组事务

正如我们所见,锁定属性由 xmax 字段表示,该字段被设置为获取锁的事务 ID。那么,当多个事务同时持有共享锁时,这个属性是如何设置的呢?

在处理共享锁时,PostgreSQL 会使用所谓的组事务 3。组事务是被分配了单独 ID 的一组事务。关于组内成员及其锁定模式的详细信息存储在 PGDATA/pg_multixact 目录下。为了更快地访问,锁定的页面会缓存在服务器的共享内存中 4;所有更改都会被记录以确保容错性。

组事务 ID 与常规的事务 ID 长度相同,均是 32 位,但它们是独立分发的。这意味着事务和组事务可能具有相同的 ID。为了区分两者,PostgreSQL 使用了一个额外的提示位:xmax_is_multi。

让我们增加由另一个事务获取的独占锁 (Key Share 和 No Key Update 模式兼容):

=> BEGIN;
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> SELECT * FROM row_locks('accounts',0) LIMIT 2;
 ctid  | xmax 	| lock_only | is_multi | keys_upd | keyshr | shr
−−−−−−−+−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−+−−−−−
 (0,1) | 1      |           | t        |          |        |
 (0,2) | 122860 | t         |          |          | t      | t
(2 rows)

xmax_is_multi 位表明第一行使用的是组事务 ID 而不是常规 ID。

在不深入实现细节的情况下,让我们使用 pgrowlocks 扩展显示所有可能的行级锁信息:

=> CREATE EXTENSION pgrowlocks;
=> SELECT * FROM pgrowlocks('accounts') \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
locked_row | (0,1)
locker     | 1
multi      | t
xids       | {122860,122861}
modes      | {"Key Share","No Key Update"}
pids       | {30423,30723}
−[ RECORD 2 ]−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
locked_row | (0,2)
locker     | 122860
multi      | f
xids       | {122860}
modes      | {"For Share"}
pids       | {30423}

这看起来很像查询 pg_locks 视图,但 pgrowlocks 函数必须访问堆页面,因为 RAM 并不包含关于行级锁的信息。

=> COMMIT;
=> ROLLBACK;

由于组事务 ID 是 32 位的,因此与常规事务 ID 一样,它们也会因为计数器限制而发生回卷。所以,PostgreSQL 必须以类似于冻结的方式处理组事务 ID:用新的组事务 ID 替换老的 (或者如果当时只有一个事务持有锁,则使用常规事务 ID 替换) 5。

但常规事务 ID 仅在 xmin 字段中被冻结 (非空的 xmax 字段表示元组已过期,并将很快被删除),对于组事务,必须冻结 xmax 字段:当前行版本可能会被新事务在共享模式下反复锁定。

组事务的冻结可以通过服务器参数进行管理,类似于为常规冻结提供的参数:vacuum_multixact_freeze_min_age、vacuum_multixact_freeze_table_age、autovacuum_multixact_freeze_max_age 以及 vacuum_multixact_failsafe_agev. 14。

13.4 等待队列

13.4.1 独占模式

虽然行级锁只是一个属性,但是队列的排列方式并不是那么简单。当某个事务准备修改一行时,它必须遵循以下步骤 6:

  1. 如果 xmax 字段和提示位表明该行以不兼容的模式被锁定,那么获取正在被修改元组的独占重锁。

  2. 如有必要,通过请求 xmax 事务 ID 上的锁 (如果 xmax 包含组事务 ID,则请求多个事务),直到所有不兼容的锁都被释放。

  3. 将自己的 ID 写入到元组头中的 xmax 中,并设置所需的提示位。

  4. 如果元组锁是在第一步中获取的,则释放它。

元组锁是另一种重锁,具有 tuple 类型 (不要与常规行级锁混淆)。

似乎步骤 1 和步骤 4 看起来是多余的,只需简单地等待所有锁定的事务结束就足够了。但是,如果多个事务试图更新同一行,那么所有的事务都将等待当前正在处理此行的事务。一旦完成,它们会发现自己陷入了竞争,去争夺锁定该行的权利,一些"倒霉"的事务可能不得不无限期地等待。这种情况被称为资源饥饿。

元组锁识别队列中的第一个事务,并保证它将是下一个获得锁的事务。

你可以观察这一点。因为 PostgreSQL 在其操作过程中获取了许多不同的锁,每个锁都在 pg_locks 表中以一个单独的行表示,因此我将在 pg_locks 上创建另一个视图。它将以更简洁的形式显示这些信息,只保留那些我们当前感兴趣的锁 (与 accounts 表和事务本身相关的锁,除了任何虚拟事务 ID 上的锁) :

=> CREATE VIEW locks_accounts AS
SELECT pid,
  locktype,
  CASE locktype
    WHEN 'relation' THEN relation::regclass::text
    WHEN 'transactionid' THEN transactionid::text
    WHEN 'tuple' THEN relation::regclass||'('||page||','||tuple||')'
  END AS lockid,
  mode,
  granted
FROM pg_locks
WHERE locktype in ('relation','transactionid','tuple')
  AND (locktype != 'relation' OR relation = 'accounts'::regclass)
ORDER BY 1, 2, 3;

让我们开启第一个事务并更新一行:

=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
       122863 |          30723
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;

该事务已完成工作流的所有四个步骤,现在正持有表上的锁:

=> SELECT * FROM locks_accounts WHERE pid = 30723;
  pid  |   locktype    |  lockid  |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30723 | relation      | accounts | RowExclusiveLock | t
 30723 | transactionid | 122863   | ExclusiveLock 	 | t
(2 rows)

启动第二个事务并尝试更新同一行。该事务将挂起,在等待锁:

=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
       122864 |          30794
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
13.4.1 独占模式:插图 2
图 13.2

第二个事务只进行到第二步。因此,除了锁定表及其自身 ID 之外,它还添加了两个锁,这两个锁也在 pg_locks 视图中反映了出来:第一步获取的元组锁和第二步请求的第二个事务 ID 的锁:

=> SELECT * FROM locks_accounts WHERE pid = 30794;
  pid  |   locktype    |    lockid     |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30794 | relation      | accounts      | RowExclusiveLock | t
 30794 | transactionid | 122863        | ShareLock        | f
 30794 | transactionid | 122864        | ExclusiveLock    | t
 30794 | tuple         | accounts(0,1) | ExclusiveLock    | t
(4 rows)

第三个事务将停在第一步。它尝试获取元组上的锁,并在此处停下:

=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
       122865 |          30865
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> SELECT * FROM locks_accounts WHERE pid = 30865;
  pid  |   locktype    |    lockid     |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30865 | relation      | accounts      | RowExclusiveLock | t
 30865 | transactionid | 122865        | ExclusiveLock    | t
 30865 | tuple         | accounts(0,1) | ExclusiveLock    | f
(3 rows)

第四个以及所有后续尝试更新这一行的事务在这方面与第三个事务没有区别:所有事务都将等待相同的元组锁。
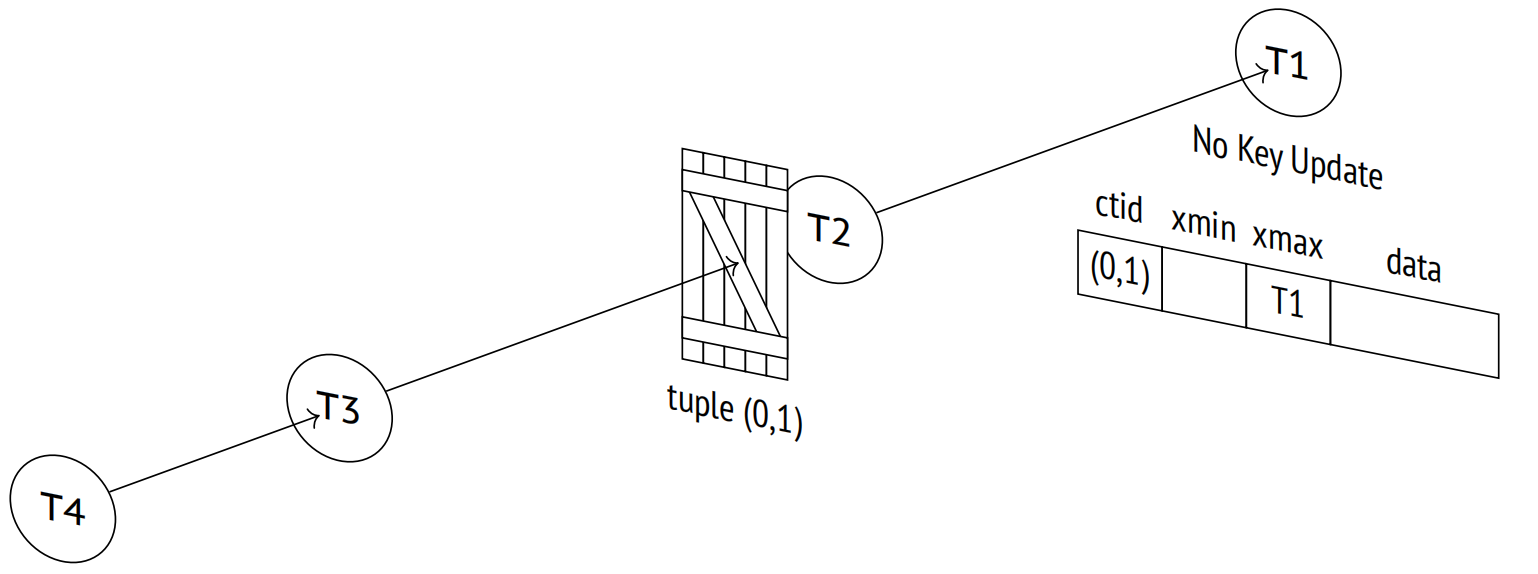
=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
       122866 |          30936
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;
=> SELECT * FROM locks_accounts WHERE pid = 30865;
 pid   |   locktype    |    lockid     |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30865 | relation      | accounts      | RowExclusiveLock | t
 30865 | transactionid | 122865        | ExclusiveLock    | t
 30865 | tuple         | accounts(0,1) | ExclusiveLock    | f
(3 rows)
13.4.1 独占模式:插图 3
图 13.3

要获取当前等待的全貌,可以使用锁定进程的信息扩展 pg_stat_activity 视图:

=> SELECT pid,
  wait_event_type,
  wait_event,
  pg_blocking_pids(pid)
FROM pg_stat_activity
WHERE pid IN (30723,30794,30865,30936);
  pid  | wait_event_type |  wait_event   | pg_blocking_pids
−−−−−−−+−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−
 30723 | Client          | ClientRead    | {}
 30794 | Lock            | transactionid | {30723}
 30865 | Lock            | tuple         | {30794}
 30936 | Lock            | tuple         | {30794,30865}
(4 rows)

如果中止第一个事务,一切将按预期进行:所有后续事务将在不跳过队列的情况下向前移动一步。

然而,第一个事务更有可能被提交。在可重复读或可序列化隔离级别下,这将导致序列化失败,因此第二个事务将不得不被中止 7 (队列中所有后续的事务也将被中止)。但在读已提交隔离级别下,修改的行会被重新读取,并重试其更新操作。

因此,提交第一个事务:

=> COMMIT;

第二个事务醒来并成功完成了工作流的第三步和第四步:

UPDATE 1
=> SELECT * FROM locks_accounts WHERE pid = 30794;
  pid  |   locktype    |  lockid  |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30794 | relation      | accounts | RowExclusiveLock | t
 30794 | transactionid | 122864   | ExclusiveLock 	 | t
(2 rows)

一旦第二个事务释放了元组锁,第三个事务也会被唤醒,但它发现新元组的 xmax 字段已经包含了一个不同的 ID。

至此,上述工作流结束了。在读已提交隔离级别下,还会进行一次尝试锁定行的操作 8,但没有遵循概述的步骤。第三个事务现在正在等待第二个事务完成,而没有尝试获取元组锁:

=> SELECT * FROM locks_accounts WHERE pid = 30865;
  pid  |   locktype    |  lockid  |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30865 | relation      | accounts | RowExclusiveLock | t
 30865 | transactionid | 122864   | ShareLock        | f
 30865 | transactionid | 122865   | ExclusiveLock    | t
(3 rows)

第四个事务同样:

=> SELECT * FROM locks_accounts WHERE pid = 30936;
  pid  |   locktype    | lockid   |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30936 | relation      | accounts | RowExclusiveLock | t
 30936 | transactionid | 122864   | ShareLock        | f
 30936 | transactionid | 122866   | ExclusiveLock    | t
(3 rows)

现在,第三个和第四个事务都在等待第二个事务完成,有陷入竞争状态的风险。队列实际上已经瓦解了。
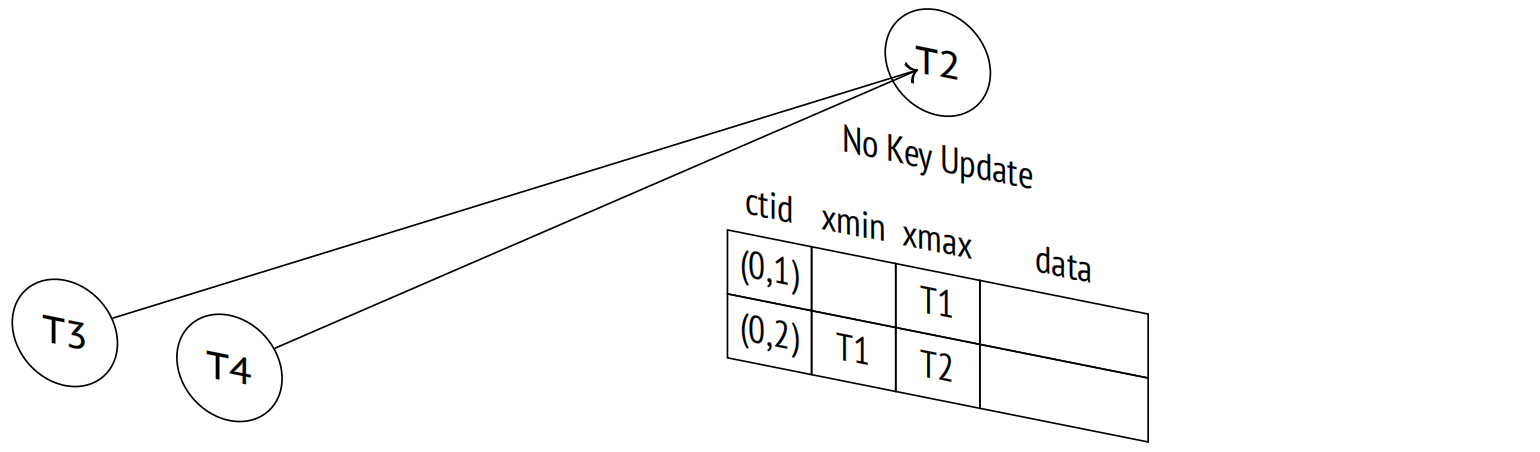
13.4.1 独占模式:插图 4
图 13.4

如果其他事务在队列还在的时候加入了队列,那么所有事务都会被拖入到这场竞争中。

结论是:在多个并发进程中更新同一行不是一个好主意。在高负载下,这个热点很快就会变成一个瓶颈,导致性能问题。

让我们提交所有已开启的事务。

=> COMMIT;
UPDATE 1
=> COMMIT;
UPDATE 1
=> COMMIT;

13.4.2 共享模式

PostgreSQL 仅在进行参照完整性检查时获取共享锁。在高负载应用中使用共享锁可能会导致资源饥饿,而两级锁定模型无法防止这种情况的发生。

让我们回顾一下事务锁定一行应采取的步骤:

  1. 如果 xmax 字段和提示位表明该行以不兼容的模式被锁定,那么获取正在被修改元组的独占重锁。

  2. 如有必要,通过请求 xmax 事务 ID 上的锁 (如果 xmax 包含组事务 ID,则请求多个事务),直到所有不兼容的锁都被释放。

  3. 将自己的 ID 写入到元组头中的 xmax 中,并设置所需的提示位。

  4. 如果元组锁是在第一步中获取的,则释放它。

前两步意味着,如果锁定模式兼容,事务将跳过队列。

让我们从头开始我们的实验。

=> TRUNCATE accounts;
=> INSERT INTO accounts(id, client, amount)
VALUES
(1,'alice',100.00),
(2,'bob',200.00),
(3,'charlie',300.00);

开启第一个事务:

=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
       122869 |          30723
(1 row)

这一行现在以共享模式锁定:

=> SELECT * FROM accounts WHERE id = 1 FOR SHARE;

第二个事务尝试更新同一行,但无法做到:Share 模式和 No Key Update 模式不兼容:

=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
       122870 |          30794
(1 row)
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;

等待第一个事务完成的同时,第二个事务像之前的例子一样持有元组锁:

=> SELECT * FROM locks_accounts WHERE pid = 30794;
  pid  |   locktype    |    lockid     |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30794 | relation      | accounts      | RowExclusiveLock | t
 30794 | transactionid | 122869        | ShareLock        | f
 30794 | transactionid | 122870        | ExclusiveLock    | t
 30794 | tuple         | accounts(0,1) | ExclusiveLock    | t
(4 rows)
13.4.2 共享模式:插图 5
图 13.5

现在让第三个事务以共享模式锁定该行。这种锁与已获取的锁兼容,因此这个事务跳过了队列:

=> BEGIN;
=> SELECT txid_current(), pg_backend_pid();
 txid_current | pg_backend_pid
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
       122871 |          30865
(1 row)
=> SELECT * FROM accounts WHERE id = 1 FOR SHARE;

现在有两个事务锁定了同一行:

=> SELECT * FROM pgrowlocks('accounts') \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−−
locked_row | (0,1)
locker     | 2
multi      | t
xids       | {122869,122871}
modes      | {Share,Share}
pids       | {30723,30865}
13.4.2 共享模式:插图 6
图 13.6

如果第一个事务在此时完成,第二个事务醒来后发现该行仍被锁定,并回到队列中,但这次它将发现自己位于第三个事务之后:

=> COMMIT;
=> SELECT * FROM locks_accounts WHERE pid = 30794;
  pid  |   locktype    |    lockid     |       mode       | granted
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−+−−−−−−−−−
 30794 | relation      | accounts      | RowExclusiveLock | t
 30794 | transactionid | 122870        | ExclusiveLock    | t
 30794 | transactionid | 122871        | ShareLock        | f
 30794 | tuple         | accounts(0,1) | ExclusiveLock    | t
(4 rows)

只有当第三个事务完成时,第二个事务才能进行更新 (除非在此时间间隔内出现了其他共享锁)。

=> COMMIT;
UPDATE 1
=> COMMIT;

外键检查不太可能引起任何问题,因为键属性通常保持不变,Key Share 可以与 No Key Update 一起使用。但在大多数情况下,你应该避免在应用中使用共享行级锁。

13.5 无等待锁定

SQL 命令通常会等待所请求的资源被释放。但有时如果无法立即获取到锁,取消操作是有意义的。为此,像 SELECT ,LOCK 和 ALTER 命令提供了 NOWAIT 子句。

让我们锁定一行:

=> BEGIN;
=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 1;

如果请求的资源已被锁定,带有 NOWAIT 子句的命令将立即完成并报错:

=> SELECT * FROM accounts
FOR UPDATE NOWAIT;
ERROR: could not obtain lock on row in relation "accounts"

此类错误可以被应用代码捕获并处理。

UPDATE 和 DELETE 命令没有 NOWAIT 子句。作为替代,你可以尝试使用 SELECT FOR UPDATE NOWAIT 命令锁定行,然后在尝试成功的情况下更新或删除它。

在一些罕见的情况下,跳过已经被锁定的行并立即开始处理可用的行可能会更方便。这正是带有 SKIP LOCKED 子句的 SELECT FOR 语句所执行的操作:

=> SELECT * FROM accounts
ORDER BY id
FOR UPDATE SKIP LOCKED
LIMIT 1;
 id | client | amount
−−−−+−−−−−−−−+−−−−−−−−
  2 | bob    | 200.00
(1 row)

在这个例中,第一行 (已被锁定) 被跳过了,查询锁定并返回了第二行。

此方法使我们能够批量处理行或配置事件队列的并行处理。然而,避免为该命令创建其他用例 — 大多数任务可以使用更简单的方式来处理。

最后需要提及的是,你可以通过设置超时来避免长时间等待:

=> SET lock_timeout = '1s';
=> ALTER TABLE accounts DROP COLUMN amount;
ERROR: canceling statement due to lock timeout

由于未能在一秒钟内获取锁,该命令以报错结束。超时不仅可以在会话级别设置,还可以在更低级别设置,例如,对于某个特定的事务。

这种方法在高负载下执行需要独占锁的命令时,可以防止在表处理期间出现长时间的等待。如果发生错误,可以在一段时间后重试此命令。

statement_timeout 限制了操作执行的总时间,lock_timeout 参数定义了等待锁花费的最长时间。

=> ROLLBACK;

13.6 死锁

有时,一个事务可能需要另一个事务当前正在使用的资源,而后者又可能在等待第三个事务锁定的资源,依此类推。这样的事务使用重锁排队。

但是,偶尔已在队列中的事务可能需要另一个资源,因此它必须再次加入同一个队列,并等待这个资源释放。这时便发生了死锁 9:队列现在有一个无法自行解决的循环依赖。

为了更好地可视化,让我们画一个等待图。它的节点表示活跃进程,而以箭头表示的边从等待锁的进程指向持有这些锁的进程。如果图中有一个循环,即一个节点可以沿着箭头到达自己,则意味着发生了死锁。

此处的插图显示的是事务而不是进程。这种替代通常是可接受的,因为一个事务由一个进程执行,并且锁只能在事务内获取。但通常来说,谈论进程更为正确,因为有些锁在事务完成时可能不会立即释放。

如果发生了死锁,并且没有任何参与者设置了超时,那么事务将永远相互等待。这就是为什么锁管理器 10 执行自动死锁检测的原因。

然而,这种检测需要一些代价,不应该在每次请求锁时都浪费 (毕竟,死锁并不会经常发生)。
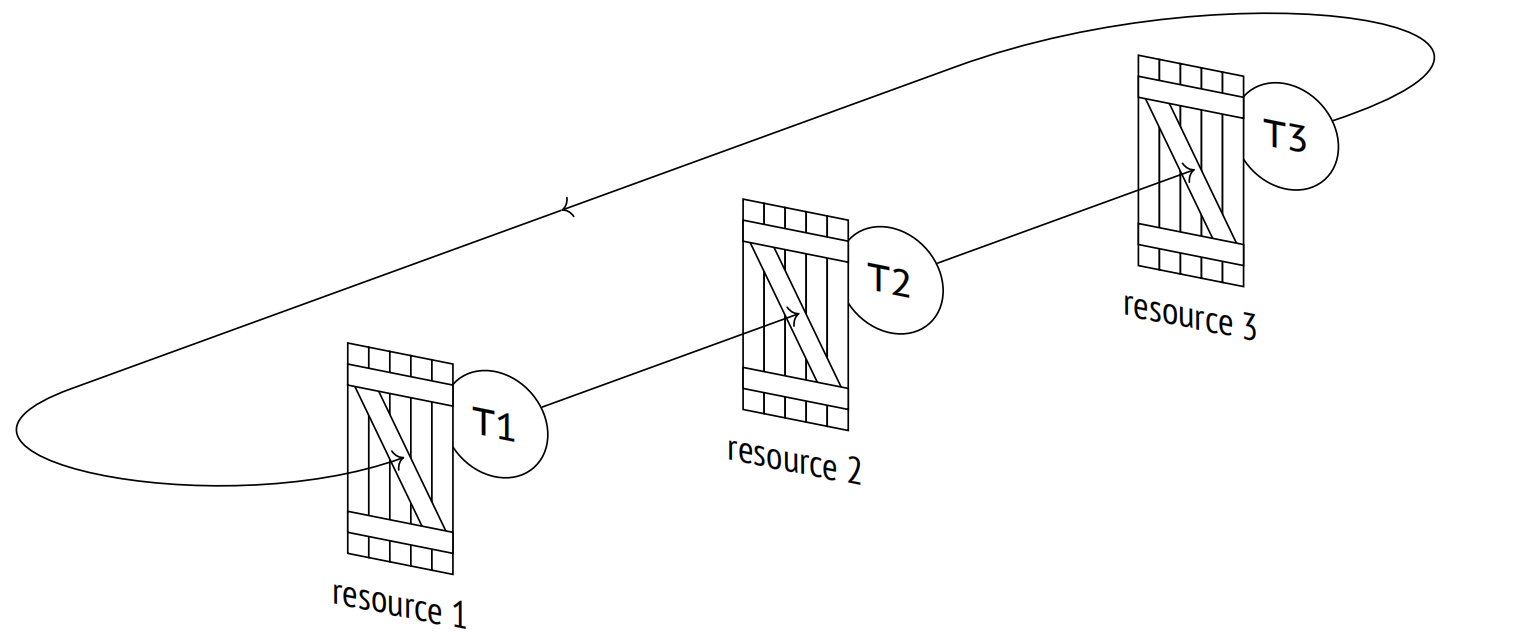
13.6 死锁:插图 7
图 13.7

因此,如果进程尝试获取锁失败,并在加入队列后进入休眠状态,PostgreSQL 会自动设置一个由 deadlock_timeout 参数 11 定义的超时时间。如果资源在此期间就变得可用,那么很好,这样就可以避免额外的检测成本。但是,如果在 deadlock_timeout1s 时间单位之后,仍然在等待,等待进程就会醒来并发起检测。12

这种检测实际上是构建一个等待图,并在其中搜索循环 13。为了"冻结"图的当前状态,PostgreSQL 将在整个检测期间停止对所有重锁的处理。

如果没有检测到死锁,进程将再次进入休眠状态;迟早会轮到它。

如果检测到死锁,其中一个事务将被强制终止,从而释放这个事务的锁并使其他事务能够继续执行。在大多数情况下,是发起检测的事务被中断,但如果循环中包括一个 autovacuum 进程,并且当前没有在冻结元组以防止回卷,那么服务器会终止 autovacuum 进程,因为它的优先级较低。

死锁通常表明应用程序设计不良。要发现这种情况,需要注意两件事:服务器日志中相应的消息以及 pg_stat_database 表中不断增加的 deadlocks 的值。

13.6.1 行更新导致的死锁

虽然死锁最终是由重锁导致的,但通常是以不同顺序获取的行级锁导致了死锁。

假设一个事务打算在两个帐户之间转移 100 美元。首先从第一个账户中提取这笔款项:

=> BEGIN;
=> UPDATE accounts SET amount = amount - 100.00 WHERE id = 1;
UPDATE 1

与此同时,另一个事务打算从第二个帐户转移 10 美元到第一个帐户中。首先从第二个账户中提取这笔款项:

=> BEGIN;
=> UPDATE accounts SET amount = amount - 10.00 WHERE id = 2;
UPDATE 1

现在,第一个事务尝试增加第二个账户中的金额,但发现相应的行已被锁定:

=> UPDATE accounts SET amount = amount + 100.00 WHERE id = 2;

然后第二个事务尝试更新第一个帐户,但也被锁定了:

=> UPDATE accounts SET amount = amount + 10.00 WHERE id = 1;

这种循环等待永远无法自行解决。由于无法在一秒内获得资源,第一个事务启动死锁检测,并被服务器中止:

ERROR: deadlock detected
DETAIL: Process 30423 waits for ShareLock on transaction 122877;
blocked by process 30723.
Process 30723 waits for ShareLock on transaction 122876; blocked by
process 30423.
HINT: See server log for query details.
CONTEXT: while updating tuple (0,2) in relation "accounts"

现在第二个事务可以继续进行,它被唤醒并执行更新:

UPDATE 1

让我们结束事务。

=> ROLLBACK;
=> ROLLBACK;

执行此类操作的正确方式是以相同的顺序锁定资源。例如,在这个特定案例中,账户可以根据它们的编号按升序进行锁定。

13.6.2 两条 UPDATE 语句之间的死锁

在某些情况下,死锁似乎是不可能的,但确实会发生。

我们通常认为 SQL 命令是原子的,但它真的是原子的吗?让我们仔细看看 UPDATE:这个命令在更新行的时候才锁定它们,而不是立即全部锁定,而且这种锁定并不是同时发生的。因此如果有一个 UPDATE 命令以一种顺序修改多行,而另一个 UPDATE 命令以不同的顺序执行相同的操作,就可能会发生死锁。

让我们复现这个场景。首先,我们在 amount 列上降序创建索引:

=> CREATE INDEX ON accounts(amount DESC);

为了能够观察这个过程,我们可以编写一个函数以放慢速度:

=> CREATE FUNCTION inc_slow(n numeric)
RETURNS numeric
AS $$
  SELECT pg_sleep(1);
  SELECT n + 100.00;
$$ LANGUAGE sql;

第一个 UPDATE 命令将更新所有元组。执行计划依赖于对整个表的顺序扫描。

=> EXPLAIN (costs off)
UPDATE accounts SET amount = inc_slow(amount);
       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Update on accounts
  −> Seq Scan on accounts
(2 rows)

为了确保堆页面基于 amount 列以升序存储行,我们需要截断表并重新插入行:

=> TRUNCATE accounts;
=> INSERT INTO accounts(id, client, amount)
VALUES
  (1,'alice',100.00),
  (2,'bob',200.00),
  (3,'charlie',300.00);
=> ANALYZE accounts;
=> SELECT ctid, * FROM accounts;
  ctid | id | client  | amount
−−−−−−−+−−−−+−−−−−−−−−+−−−−−−−−
 (0,1) |  1 | alice	  | 100.00
 (0,2) |  2 | bob     | 200.00
 (0,3) |  3 | charlie | 300.00
(3 rows)

顺序扫描将以相同的顺序更新行 (但对于大表来说并非总是如此)。

开始更新:

=> UPDATE accounts SET amount = inc_slow(amount);

同时,我们将在另一个会话中禁止顺序扫描:

=> SET enable_seqscan = off;

因此,规划器为下一个 UPDATE 命令选择了索引扫描。

=> EXPLAIN (costs off)
UPDATE accounts SET amount = inc_slow(amount)
WHERE amount > 100.00;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Update on accounts
   −> Index Scan using accounts_amount_idx on accounts
       Index Cond: (amount > 100.00)
(3 rows)

第二行和第三行满足条件;由于索引是降序的,因此行将以相反的顺序被更新。

让我们开始下一个更新:

=> UPDATE accounts SET amount = inc_slow(amount)
WHERE amount > 100.00;

pgrowlocks 扩展显示第一个操作已经更新了第一行 (0,1),而第二个操作已成功更新了最后一行 (0,3):

=> SELECT locked_row, locker, modes FROM pgrowlocks('accounts');
 locked_row | locker |       modes
−−−−−−−−−−−−+−−−−−−−−+−−−−−−−−−−−−−−−−−−−
 (0,1)      | 122883 | {"No Key Update"}    ← first
 (0,3)      | 122884 | {"No Key Update"}    ← second
(2 rows)

又过了一秒。第一个操作已经更新了第二行,另一个操作也希望这样做,但这是不允许的。

=> SELECT locked_row, locker, modes FROM pgrowlocks('accounts');
 locked_row | locker |       modes
−−−−−−−−−−−−+−−−−−−−−+−−−−−−−−−−−−−−−−−−−
 (0,1)      | 122883 | {"No Key Update"}
 (0,2)      | 122883 | {"No Key Update"}    ← the first one wins
 (0,3)      | 122884 | {"No Key Update"}
(3 rows)

现在,第一个操作想要更新表的最后一行,但它已经被第二个操作锁定。于是发生了死锁。

其中一个事务被中止:

ERROR: deadlock detected
DETAIL: Process 30794 waits for ShareLock on transaction 122883;
blocked by process 30723.
Process 30723 waits for ShareLock on transaction 122884; blocked by
process 30794.
HINT: See server log for query details.
CONTEXT: while updating tuple (0,2) in relation "accounts"

另一个事务执行完成:

UPDATE 3

尽管这种情况看似不可能,但在高负载系统中执行批量行更新时,确实会发生。


  1. postgresql.org/docs/14/explicit-locking#LOCKING-ROWS.html ↩︎

  2. include/access/htup_details.h ↩︎

  3. backend/access/transam/multixact.c ↩︎

  4. backend/access/transam/slru.c ↩︎

  5. backend/access/heap/heapam.c, FreezeMultiXactId function ↩︎

  6. backend/access/heap/README.tuplock ↩︎

  7. backend/executor/nodeModifyTable.c, ExecUpdate function ↩︎

  8. backend/access/heap/heapam_handler.c, heapam_tuple_lock function ↩︎

  9. postgresql.org/docs/14/explicit-locking#LOCKING-DEADLOCKS.html ↩︎

  10. backend/storage/lmgr/README ↩︎

  11. backend/storage/lmgr/proc.c, ProcSleep function ↩︎

  12. backend/storage/lmgr/proc.c, CheckDeadLock function ↩︎

  13. backend/storage/lmgr/deadlock.c ↩︎

14 多样的锁

14.1 非对象锁

为了锁定不被视为"关系"的资源,PostgreSQL 使用 object 类型 1 的重锁。你几乎可以锁定存储在系统表中的任何东西:表空间、订阅、模式、角色、策略、枚举数据类型等等。

让我们开启一个事务创建一张表:

=> BEGIN;
=> CREATE TABLE example(n integer);

现在让我们看看 pg_locks 表中的非关系锁:

=> SELECT database,
  (
    SELECT datname FROM pg_database WHERE oid = database
  ) AS dbname,
  classid,
  (
    SELECT relname FROM pg_class WHERE oid = classid
  ) AS classname,
  objid,
  mode,
  granted
FROM pg_locks
WHERE locktype = 'object'
	AND pid = pg_backend_pid() \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−
database  | 16391
dbname    | internals
classid   | 2615
classname | pg_namespace
objid     | 2200
mode      | AccessShareLock
granted   | t

此处锁定的资源由三个值定义:

database — 包含被锁定对象的数据库 oid (如果此对象是整个集簇共有的,则为零)

classid — pg_class 中列出的 oid,对应于定义资源类型的系统目录表的名称

objid — 系统目录表中列出的 oid,被 classid 所引用

database 值指向 internals 数据库;它是当前会话所连接的数据库。classid 列指向 pg_namespace 表,该表列出了模式。

现在我们可以解读 objid 了:

=> SELECT nspname FROM pg_namespace WHERE oid = 2200;
 nspname
−−−−−−−−−
 public
(1 row)

所以,PostgreSQL 已经锁定了 public 模式,以确保事务仍在运行时没有人可以删除它。

类似的,对象删除需要获取对象本身及其依赖的所有资源的独占锁 2。

=> ROLLBACK;

14.2 关系扩展锁

随着关系中元组数量的增长,PostgreSQL 会尽可能将新元组插入到现有页面的空闲空间中。但很明显,在某些时候,它将不得不添加新的页面,即扩展表。就物理布局而言,新的页面会被添加到相应文件的末尾 (这会导致创建一个新的文件)。

为了使新页面一次只能由一个进程添加,这个操作受到一种特殊的 extend 类型 3 的重锁保护。索引清理也使用这种锁来禁止在索引扫描期间添加新的页面。

关系扩展锁的行为与我们迄今为止看到的有些许不同:

  • 一旦扩展完成,它们便会被立即释放,无需等待事务完成。

  • 它们不会导致死锁,所以不包含在等待图中。

    然而,如果扩展关系的过程超过了 deadlock_timeout,仍会执行死锁检测。这不是一种典型的情况,但如果大量进程同时执行多个插入操作,就可能会发生。在这种情况下,会多次调用死锁检测,这实际上会导致正常的系统操作瘫痪。

    为了将此风险降至最低,堆文件会一次性扩展多个页面v. 9.6 (与等待锁的进程数成比例,但每次操作不超过 512 个页面) 4。例外的是 B 树索引文件,一次只扩展一个页面 5。

14.3 页锁

page 类型的页级重锁 6 仅应用于 GIN 索引,并且仅在以下情况使用。

GIN 索引可以加速复合值中元素的搜索,例如文本文档中的单词。它们大致可以描述为存储单独的单词而不是整个文档的 B 树。当添加新的文档时,必须彻底更新索引,以包含此文档中出现的每个单词。

为了提高性能,GIN 索引允许延迟插入,由 fastupdateon 存储参数控制。新单词首先会被快速添加到一个无序的 pending list 中,一段时间之后,所有累积的条目都会被移动到主索引结构中。由于不同的文档可能包含重复的单词,因此这种方式无疑是十分划算的。

为了避免多个进程同时转移单词,索引的元页面会以独占模式锁定,直到所有的单词从 pending list 中移动到主索引。这个锁不会干扰正常的索引使用。

就像关系扩展锁一样,页锁在任务完成后立即释放,无需等待事务结束,因此它们永远不会导致死锁。

14.4 咨询锁

与其他重锁 (如关系锁) 不同,咨询锁 7 永远不会自动获取:它们由应用开发人员控制。如果应用程序出于某些特定目的需要使用专门的锁逻辑,这些锁就很方便使用。

假设我们需要锁定一个不与任何数据库对象对应的资源 (我们可以使用 SELECT FOR 或 LOCK TABLE 命令锁定的资源)。在这种情况下,需要为此资源分配一个数字 ID 。如果该资源有一个唯一的名称,那么最简单的方式是为此名称生成一个哈希码:

=> SELECT hashtext('resource1');
 hashtext
−−−−−−−−−−−
 991601810
(1 row)

PostgreSQL 提供了一整套用于管理咨询锁的函数 8。它们的名称以 pg_advisory 前缀开头,并且包含以下暗示函数用途的单词:

lock — 获取锁

try — 如果可以无需等待,便获取锁

unlock — 释放锁

share — 使用共享锁模式 (默认情况下,使用独占模式)

xact — 获取并持有锁直至事务结束 (默认情况下,锁会持有至会话结束)

让我们获取一个独占锁,直至会话结束:

=> BEGIN;
=> SELECT pg_advisory_lock(hashtext('resource1'));
=> SELECT locktype, objid, mode, granted
FROM pg_locks WHERE locktype = 'advisory' AND pid = pg_backend_pid();
 locktype |   objid   |     mode      | granted
−−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−
 advisory | 991601810 | ExclusiveLock | t
(1 row)

为了确保咨询锁实际起作用,其他进程在访问资源时也必须遵守既定的顺序;这必须由应用程序保证。

即使在事务完成之后,获取的锁也会继续保持:

=> COMMIT;
=> SELECT locktype, objid, mode, granted
FROM pg_locks WHERE locktype = 'advisory' AND pid = pg_backend_pid();
 locktype |   objid   |     mode      | granted
−−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−
 advisory | 991601810 | ExclusiveLock | t
(1 row)

一旦对资源的操作结束,锁必须被显式释放:

=> SELECT pg_advisory_unlock(hashtext('resource1'));

14.5 谓词锁

谓词锁这个术语最早出现在首次尝试实现基于锁的完全隔离的时候 9。当时面临的问题是,即使锁定了要读取和更新的所有行,仍然无法保证完全隔离。实际上,如果新插入的行满足过滤条件,它们将成为幻象。

因此,有人建议锁定条件 (谓词) 而不是行。如果使用 a > 10 的谓词运行查询,锁定这个谓词将不允许在满足此条件的情况下向表中添加新行,因此可以避免幻象的出现。麻烦的是,如果出现带有不同谓词的查询,例如 a < 20,你必须找出这些谓词是否重叠。理论上,这个问题在算法上是无解的;实际上,仅仅是非常简单的谓词类别才能解决 (如本例所示)。

在 PostgreSQL 中,可串行化隔离级别以不同的方式实现:它使用可串行化快照隔离 (SSI) 协议 10。谓词锁这个术语仍然存在,但其含义已经彻底变了。事实上,这种"锁"并不锁定任何东西:它们用于跟踪不同事务之间的数据依赖关系。

已经证明,可重复读级别的快照隔离除了写偏序和只读事务异常之外,不允许任何异常。这两种异常会导致数据依赖图中的特定模式,这些模式可以以相对较低的成本发现。

问题是我们必须区分两种类型的依赖关系:

  • 第一个事务读取了之后由第二个事务更新的行 (RW 依赖)。

  • 第一个事务修改了之后由第二个事务读取的行 (WR 依赖)。

WR 依赖可以使用常规锁来检测,但是 RW 依赖必须通过谓词锁来跟踪。这种跟踪在可串行化隔离级别下会自动开启,这也正是为什么将该级别用于所有事务 (或至少所有相互关联的事务) 的重要原因。如果任何事务在不同级别下运行,它将不会设置 (或检查) 谓词锁,因此可串行化级别将降级为可重复读。

我想再次强调,尽管它们的名字如此,但谓词锁不会锁定任何东西。相反,当一个事务即将提交时,会检查"危险"的依赖关系,如果 PostgreSQL 怀疑有异常,这个事务将被中止。

让我们创建一个带有索引的表,该索引包括多个页面 (可以通过使用一个较低的 fillfactor 值实现):

=> CREATE TABLE pred(n numeric, s text);

=> INSERT INTO pred(n) SELECT n FROM generate_series(1,10000) n;

=> CREATE INDEX ON pred(n) WITH (fillfactor = 10);

=> ANALYZE pred;

如果查询执行顺序扫描,将会在整个表上获取一个谓词锁 (即使某些行不满足提供的过滤条件)。

=> SELECT pg_backend_pid();
 pg_backend_pid
−−−−−−−−−−−−−−−−
          34753
(1 row)
=> BEGIN ISOLATION LEVEL SERIALIZABLE;
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM pred WHERE n > 100;
               QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on pred (actual rows=9900 loops=1)
   Filter: (n > '100'::numeric)
   Rows Removed by Filter: 100
(3 rows)

虽然谓词锁有它们自己的基础设施,但 pg_locks 视图将它们与重锁显示在一起。所有的谓词锁总是以 SIRead 模式获取,这表示可串行化隔离读:

=> SELECT relation::regclass, locktype, page, tuple
FROM pg_locks WHERE mode = 'SIReadLock' AND pid = 34753
ORDER BY 1, 2, 3, 4;
 relation | locktype | page | tuple
−−−−−−−−−−+−−−−−−−−−−+−−−−−−+−−−−−−−
 pred     | relation |      |
(1 row)
=> ROLLBACK;

注意,谓词锁的持续时间可能比事务本身更长,因为它们用于跟踪事务之间的依赖关系。但无论如何,这些锁是自动管理的。

如果查询执行索引扫描,情况就会有所改善。对于 B 树索引,只需在读取的堆元组和扫描过的索引叶子页面上设置谓词锁。它将"锁定"已读取的整个范围,而不仅仅是确切的值。

=> BEGIN ISOLATION LEVEL SERIALIZABLE;
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM pred WHERE n BETWEEN 1000 AND 1001;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using pred_n_idx on pred (actual rows=2 loops=1)
   Index Cond: ((n >= '1000'::numeric) AND (n <= '1001'::numeric))
(2 rows)
=> SELECT relation::regclass, locktype, page, tuple
FROM pg_locks WHERE mode = 'SIReadLock' AND pid = 34753
ORDER BY 1, 2, 3, 4;
  relation  | locktype | page | tuple
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−+−−−−−−−
 pred       | tuple    |    4 |    96
 pred       | tuple    |    4 |    97
 pred_n_idx | page     |   28 |
(3 rows)

与已扫描元组相对应的叶子页面数量可以发生改变:例如,当向表中插入新行时,索引页面可能会发生分裂。然而,PostgreSQL 会将其考虑在内,并且也会锁定新出现的页面:

=> INSERT INTO pred
  SELECT 1000+(n/1000.0) FROM generate_series(1,999) n;
=> SELECT relation::regclass, locktype, page, tuple
FROM pg_locks WHERE mode = 'SIReadLock' AND pid = 34753
ORDER BY 1, 2, 3, 4;
  relation  | locktype | page | tuple
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−+−−−−−−−
 pred       | tuple    |    4 |    96
 pred       | tuple    |    4 |    97
 pred_n_idx | page     |   28 |
 pred_n_idx | page     |  266 |
 pred_n_idx | page     |  267 |
 pred_n_idx | page     |  268 |
 pred_n_idx | page     |  269 |
(7 rows)

每个读取的元组都会被单独锁定,并且可能有相当多这样的元组。谓词锁使用它们自己的锁池,这个锁池在服务器启动时分配。谓词锁的总数受到 max_pred_locks_per_transaction64 乘以 max_connections100 的限制 (尽管参数名如此,谓词锁并不是按单独事务计数的)。

在这里,我们遇到了与行级锁相同的问题,但解决方式不同:应用了锁升级。11

一旦与单个页面相关的元组锁的数量超过了 max_pred_locks_per_page2 参数的值,便会被一个单独的页级锁替代v. 10。

=> EXPLAIN (analyze, costs off, timing off, summary off)
  SELECT * FROM pred WHERE n BETWEEN 1000 AND 1002;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using pred_n_idx on pred (actual rows=3 loops=1)
   Index Cond: ((n >= '1000'::numeric) AND (n <= '1002'::numeric))
(2 rows)

现在,不再是三个 tuple 类型的锁,而是一个 page 类型的锁。

=> SELECT relation::regclass, locktype, page, tuple
FROM pg_locks WHERE mode = 'SIReadLock' AND pid = 34753
ORDER BY 1, 2, 3, 4;
  relation  | locktype | page | tuple
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−+−−−−−−−
 pred       | page     |    4 |
 pred_n_idx | page     |   28 |
 pred_n_idx | page     |  266 |
 pred_n_idx | page     |  267 |
 pred_n_idx | page     |  268 |
 pred_n_idx | page     |  269 |
(6 rows)

=> ROLLBACK;

页级锁的升级遵循相同的原则v. 10。如果某个特定关系的页级锁的数量超过了 max_pred_locks_per_relation-2 值,他们将被一个单独的关系级锁替代。(如果此参数设置为负数,那么阈值为 max_pred_locks_per_transaction64 除以 max_pred_locks_per_relation 的绝对值;因此,默认的阈值为 32)。

锁升级肯定会导致多次 false-positive 序列化错误,这会对系统吞吐量产生负面影响。所以你必须在性能和在锁上花费的内存之间找到一个合适的平衡点。

谓词锁支持以下索引类型:

  • B 树

  • 哈希索引,GiST 和 GINv. 11

如果执行了索引扫描,但索引不支持谓词锁,那么整个索引将被锁定。可以预料,在这种情况下,无故中止的事务数量也会增加。

为了在可串行化级别下更高效地操作,使用 read only 子句显式声明只读事务是有意义的。如果锁管理器看到只读事务不会与其他事务发生冲突 12,它可以释放已经设置的谓词锁并避免获取新的谓词锁。如果这样的事务也被声明为 DEFERABLE 的,那么也可以避免只读事务异常。


  1. backend/storage/lmgr/lmgr.c, LockDatabaseObject & LockSharedObject functions ↩︎

  2. backend/catalog/dependency.c, performDeletion function ↩︎

  3. backend/storage/lmgr/lmgr.c, LockRelationForExtension function ↩︎

  4. backend/access/heap/hio.c, RelationAddExtraBlocks function ↩︎

  5. backend/access/nbtree/nbtpage.c, _bt_getbuf function ↩︎

  6. backend/storage/lmgr/lmgr.c, LockPage function ↩︎

  7. postgresql.org/docs/14/explicit-locking#ADVISORY-LOCKS.html ↩︎

  8. postgresql.org/docs/14/functions-admin#FUNCTIONS-ADVISORY-LOCKS.html ↩︎

  9. K. P. Eswaran, J. N. Gray, R. A. Lorie, I. L. Traiger. The notions of consistency and predicate locks in a database system ↩︎

  10. backend/storage/lmgr/README-SSI
    backend/storage/lmgr/predicate.c ↩︎

  11. backend/storage/lmgr/predicate.c, PredicateLockAcquire function ↩︎

  12. backend/storage/lmgr/predicate.c, SxactIsROSafe macrou ↩︎

15 内存结构上的锁

15.1 自旋锁

为了保护共享内存中的数据结构,PostgreSQL 使用了几种更加轻量和开销更小的锁,而不是常规的重锁。

最简单的锁是自旋锁。自旋锁通常仅获取非常短的时间 (不超过几个 CPU 周期),以保护特定内存单元不受并发更新的影响。

自旋锁基于原子 CPU 指令,比如 CAS (compare-and-swap) 1。它们仅支持独占锁定模式。如果所需资源已被锁定,那么进程将忙等,并重复命令 (在循环中"自旋",因此得名)。如果在指定的时间间隔内无法获取锁,进程将暂停一段时间,然后开始另一次循环。

如果评估冲突的概率非常低,那么这种策略是有意义的,因此在一次失败的尝试之后,锁很有可能在几条指令内被获取。

自旋锁既没有死锁检测,也没有监测机制。从实际的角度来看,我们只需要知道它们的存在;正确实现的全部责任均落在 PostgreSQL 开发者身上。

15.2 轻量锁

接下来,还有所谓的轻量锁,即 lwlocks 2。轻量锁是在处理数据结构 (例如,哈希表或指针列表) 所需的时间内获取的,通常时间较短;然而,当用于保护 I/O 操作时,可能需要更长的时间。

轻量锁支持两种模式:独占模式 (用于数据修改) 和共享模式 (用于只读操作)。轻量锁没有严格的队列机制:如果有多个进程在等待一个锁,其中一个进程将或多或少以随机的方式获得对资源的访问。在高负载的系统中,特别是那些有多个并发进程的系统中,这种机制可能会导致一些令人不悦的影响。

轻量锁也没有提供死锁检测机制;我们必须相信 PostgreSQL 开发人员正确实现了这些锁。然而,这些锁确实有监测机制,因此与自旋锁不同,它们是可以被观察到的。

15.3 例子

为了了解如何使用以及在何处使用自旋锁和轻量锁,让我们看下两个共享内存结构:缓冲区缓存和 WAL 缓冲区。我只会提到其中一些锁;由于全貌过于复杂,可能只有 PostgreSQL 内核开发人员感兴趣。

15.3.1 缓冲区缓存

为了访问用于定位缓存中特定缓冲区的哈希表,进程必须以共享模式获取一个 BufferMapping 轻量锁以进行读取,或者如果预期有任何修改,则以独占模式获取。
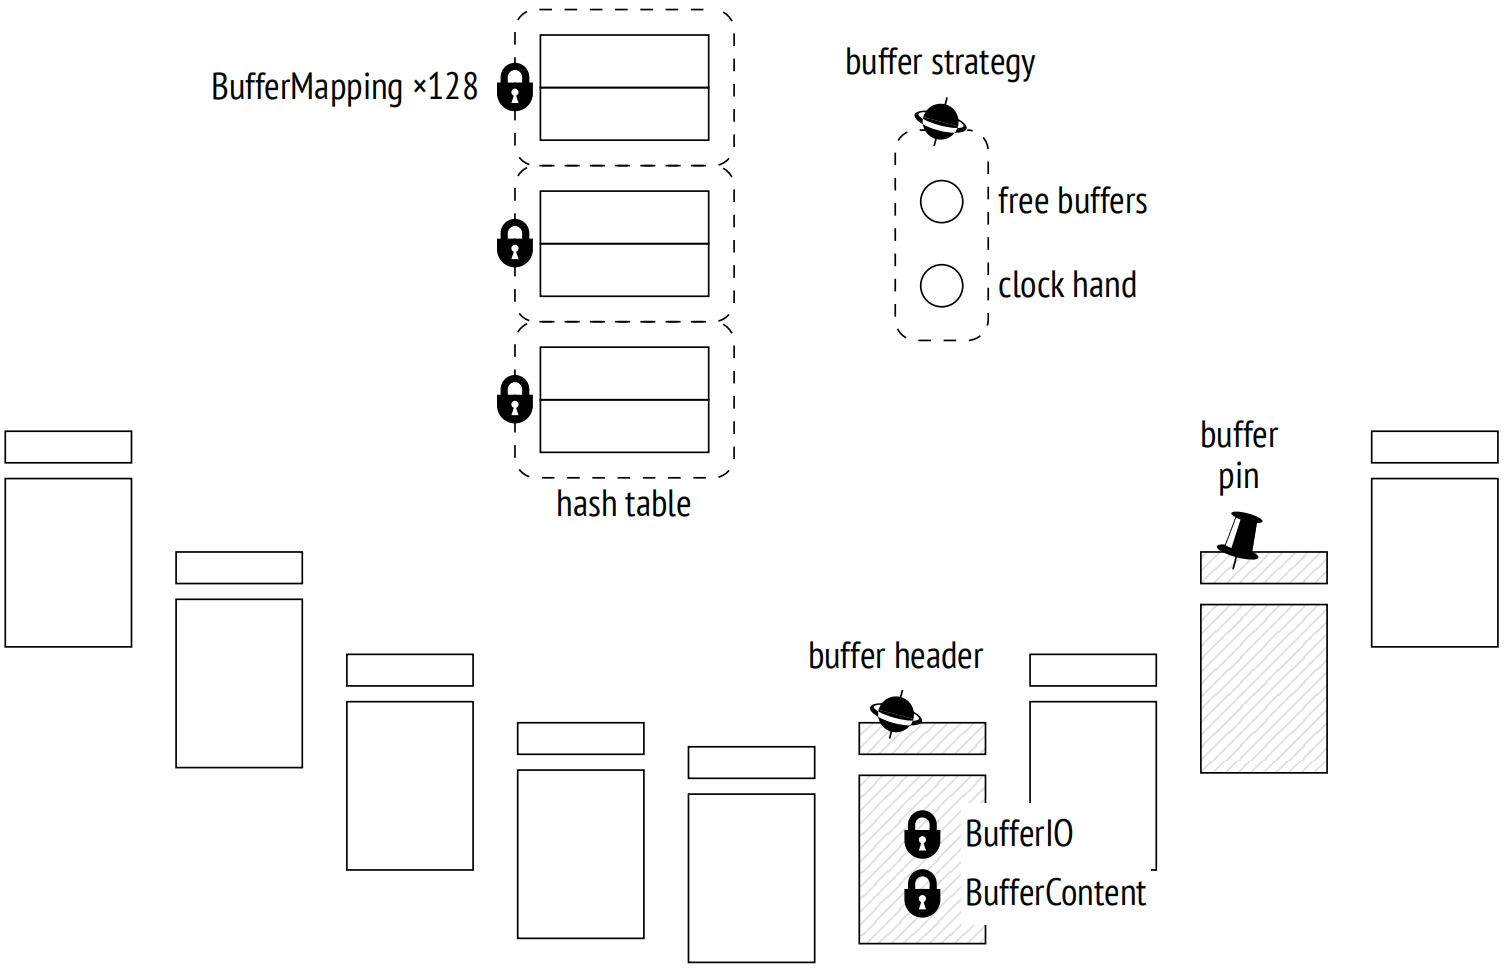
15.3.1 缓冲区缓存:插图 1
图 15.1

哈希表的访问十分频繁,因此这个锁经常成为瓶颈。为了最大限度地提高粒度,它被构造为一个由 128 个独立的轻量锁组成的锁集,每个锁用于保护哈希表的一个分区。3

早在 2006 年,Postgres 8.2 版本就将哈希表锁转换为包含 16 个锁的锁集;十年后,当 9.5 版本发布时,锁集的大小增加到了 128 个,但对于现代多核系统来说,这可能仍然不够。

为了访问缓冲区头,进程获取缓冲区头自旋锁 4 (名字是任意的,因为自旋锁没有对用户可见的名字)。某些操作,比如增加使用计数,不需要显式锁定,可以使用原子 CPU 指令执行。

为了读取缓冲区中的页面,进程需要获取此缓冲区头中的 BufferContent 锁 5。这个锁通常仅在读取元组指针时持有,稍后,缓冲区锁定提供的保护就足够了。如果需要修改缓冲区的内容,那么必须以独占模式获取 BufferContent 锁。当从磁盘读取某个缓冲区 (或写入磁盘) 时,PostgreSQL 还会在缓冲区头中获取 BufferIO 锁;它实际上是一个用作锁的属性,而不是一个真正的锁 6。它向请求访问这个页面的其他进程发出信号,告诉它们必须等到 I/O 操作完成。

指向空闲缓冲区的指针和淘汰机制的时钟指针由一个共同的缓冲区策略自旋锁保护 7。

15.3.2 WAL 缓冲区
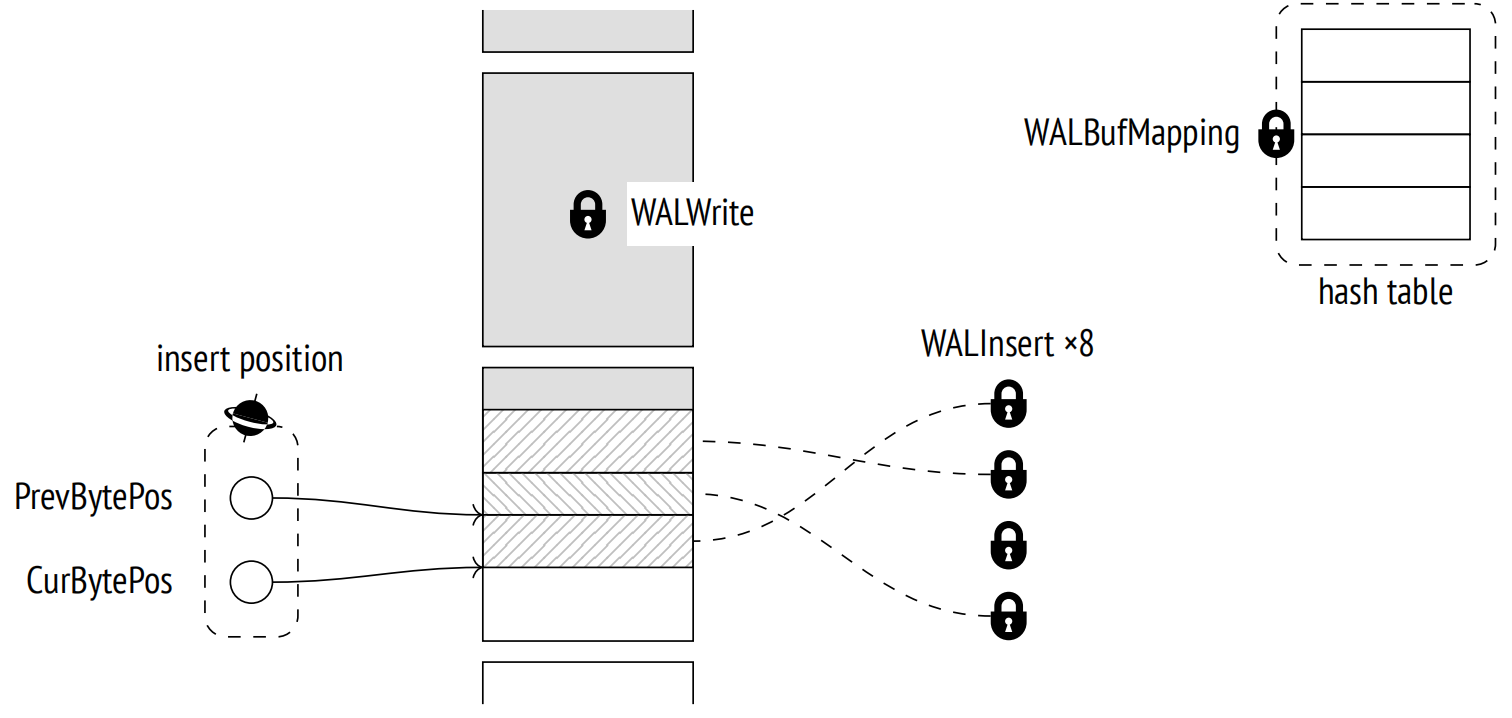
15.3.2 WAL 缓冲区:插图 2
图 15.2

WAL 缓存也使用哈希表将页面映射到缓冲区。不同于缓冲区缓存的哈希表,它由单个 WALBufMapping 轻量锁保护,因为 WAL 缓存较小 (通常是缓冲区缓存大小的 1/32 ),并且缓冲区的访问更加有序 8。

将 WAL 页面写入磁盘受到 WALWrite 轻量锁的保护,以确保此操作一次只由一个进程执行。

为了创建一个 WAL 条目,进程首先在 WAL 页面内预留一些空间,然后用数据填充。空间预留严格有序;进程必须获取一个插入位置的自旋锁,以保护插入指针 9。但一旦空间被预留后,它就可以由若干并发进程共同填充。为此,每个进程都必须获取构成 WALInsert 锁集的 8 个轻量锁中的任何一个 10。

15.4 监控等待

毫无疑问,锁对于 PostgreSQL 的正确运行是必不可少的,但它们可能导致不希望的等待。追踪这些等待以了解它们的起源是非常有用的。

获取长锁概览的最简单方式是调整 log_lock_waitsoff 参数为 on。它会详细记录所有导致事务等待时间超过 deadlock_timeout1s 的锁至日志中。这些数据在死锁检测完成时显示,因此而得名。

然而,pg_stat_activityv. 9.6 视图提供了更多有用和完整的信息。每当一个进程 (不管是系统进程还是后端进程) 由于在等待某个东西而无法继续其操作时,此等待就会反映在 wait_event_type 和 wait_event 字段中,分别显示等待的类型和名称。

所有等待可以归类如下 11。

各种锁的等待组成了一个相当大的群组:

Lock:重锁

LWLock:轻量锁

BufferPin:锁定的缓冲区

但进程也可能在等待其他事件:

IO:输入/输出,需要读取或写入某些数据时

Client:客户端发送的数据 (psql 大部分时间处于这个状态)

IPC:其他进程发送的数据

Extension:由扩展注册的特定事件

有时,一个进程没有执行任何有用的工作。这样的等待通常是"正常"的,意味着它们不表明有任何问题。这类分组包括以下等待:

Activity:后台进程在其主循环中

Timeout:计时器

每种等待类型的锁按等待名称进一步分类。例如,等待轻量锁有相应的锁名称或相应的锁集 12。

你应该记住,pg_stat_activity 视图只显示了那些在源代码中以适当方式处理的等待 13。除非等待的名称出现在这个视图中,否则进程不会处于任何已知类型的等待状态。这样的时间应被视为"未知时间",这并不一定意味着进程没有任何等待 — 我们只是不知道此刻发生了什么。

=> SELECT backend_type, wait_event_type AS event_type, wait_event
FROM pg_stat_activity;
        backend_type          | event_type |     wait_event
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−
 logical replication launcher | Activity   | LogicalLauncherMain
 autovacuum launcher          | Activity   | AutoVacuumMain
 client backend               |            |
 background writer            | Activity   | BgWriterMain
 checkpointer                 | Activity   | CheckpointerMain
 walwriter                    | Activity   | WalWriterMain
(6 rows)

当对视图进行采样时,所有的后台进程都处于空闲状态,而客户端后端进程正忙于执行查询,并且没有等待任何东西。

15.5 采样

不幸的是,pg_stat_activity 视图只显示了关于等待的当前信息;统计数据不会累积。收集随时间变化的等待数据的唯一方式是定期采样该视图。

我们必须考虑到抽样的随机性。与采样间隔相比,等待时间越短,检测到这种等待情况的机会就越低。因此,更长的采样间隔需要更多的样本来反映事物的实际状态 (但随着采样率的增加,开销也会增加)。出于同样的原因,采样对于分析短暂会话几乎没有用处。

PostgreSQL 没有提供内置的采样工具;但是,我们仍然可以尝试使用 pg_wait_sampling 14 扩展。为此,我们需要在 shared_preload_libraries 参数中指定它的库名,然后重启服务器:

=> ALTER SYSTEM SET shared_preload_libraries = 'pg_wait_sampling';
postgres$ pg_ctl restart -l /home/postgres/logfile

现在让我们在数据库中安装扩展:

=> CREATE EXTENSION pg_wait_sampling;

此扩展可以显示保存在其环形缓冲区中的历史等待情况。然而,更有趣的是获取等待概况 — 整个会话期间的累计统计数据。

例如,让我们看一下基准测试期间的等待情况。我们需要启动 pgbench 工具,并在其运行时确定其进程 ID:

postgres$ /usr/local/pgsql/bin/pgbench -T 60 internals
=> SELECT pid FROM pg_stat_activity
WHERE application_name = 'pgbench';
  pid
−−−−−−−
 36367
(1 row)

测试完成之后,等待概况如下所示:

=> SELECT pid, event_type, event, count
FROM pg_wait_sampling_profile WHERE pid = 36380
ORDER BY count DESC LIMIT 4;
  pid  | event_type | 	 event     | count
−−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−−−−+−−−−−−−
 36367 | IO         | WALSync      |  3478
 36367 | IO         | WALWrite     |    52
 36367 | Client     | ClientRead   |    30
 36367 | IO         | DataFileRead |     2
(4 rows)

默认情况下 (由 pg_wait_sampling.profile_period10ms 参数设置) 每秒采样 100 次。因此,要估算等待时间的秒数,必须将值除以 100。

在这个特定案例中,大部分等待与将 WAL 条目刷新到磁盘有关v. 12。这很好地说明了未知的等待时间:WALSync 事件直到 PostgreSQL 12 才被记录;对于更低的版本,等待概况不会包含第一行,尽管等待本身仍然存在。

如果我们人为降低文件系统的速度,使每个 I/O 操作需要耗时 0.1 秒 (为此,我使用了 slowfs 15),那么等待概况将如下所示:

postgres$ /usr/local/pgsql/bin/pgbench -T 60 internals
=> SELECT pid FROM pg_stat_activity
WHERE application_name = 'pgbench';
  pid
−−−−−−−
 36747
(1 row)
=> SELECT pid, event_type, event, count
FROM pg_wait_sampling_profile WHERE pid = 36759
ORDER BY count DESC LIMIT 4;
  pid  | event_type |     event      | count
−−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−−−−−−+−−−−−−−
 36747 | IO         | WALWrite       | 	3603
 36747 | LWLock     | WALWrite       |  2095
 36747 | IO         | WALSync        |    22
 36747 | IO         | DataFileExtend |    19
(4 rows)

现在,I/O 操作是最慢的,主要是以同步模式将 WAL 文件写入磁盘的相关操作。WAL 写入受到 WALWrite 轻量锁的保护,因此相应的行也会出现在等待概况中。

显然,在前一个示例中也获得了相同的锁,但由于等待时间短于采样间隔,所以要么它很少被采样到,要么根本就没有出现在等待概况中。这再次说明,要分析短暂的等待,你必须对其进行相当长时间的采样。


  1. backend/storage/lmgr/s_lock.c ↩︎

  2. backend/storage/lmgr/lwlock.c ↩︎

  3. backend/storage/buffer/bufmgr.c
    include/storage/buf_internals.h, BufMappingPartitionLock function ↩︎

  4. backend/storage/buffer/bufmgr.c, LockBufHdr function ↩︎

  5. include/storage/buf_internals.h ↩︎

  6. backend/storage/buffer/bufmgr.c, StartBufferIO function ↩︎

  7. backend/storage/buffer/freelist.c ↩︎

  8. backend/access/transam/xlog.c, AdvanceXLInsertBuffer function ↩︎

  9. backend/access/transam/xlog.c, ReserveXLogInsertLocation function ↩︎

  10. backend/access/transam/xlog.c, WALInsertLockAcquire function ↩︎

  11. postgresql.org/docs/14/monitoring-stats#WAIT-EVENT-TABLE.html ↩︎

  12. postgresql.org/docs/14/monitoring-stats#WAIT-EVENT-LWLOCK-TABLE.html ↩︎

  13. include/utils/wait_event.h ↩︎

  14. github.com/postgrespro/pg_wait_sampling ↩︎

  15. github.com/nirs/slowfs ↩︎

第四部分:查询执行

第四部分:查询执行。

本分部页按原书结构编排,用于中英目录对照。

16 查询执行阶段

16.1 示例数据库

本书前面部分的示例都是基于仅有少量行的表。此章节及后续部分将讨论查询执行,这方面的要求会更高:我们需要行数更多的表。我没有为每个例子都创建一个新的数据集,而是使用了一个现有的示例数据库,其展示了俄罗斯的客运航空量 1。它有多个版本;我们将使用于 2017 年 8 月 15 日创建的数据量更大的版本。要安装此版本,你需要从归档中提取包含数据库副本的文件 2,并在 psql 中运行此文件。

在开发这个示例数据库时,我们尽量让其模式简单到无需额外解释即可理解;同时,我们希望它也足够复杂,能够编写有意义的查询语句。数据库中填充了贴近现实的数据,这使得示例更加全面,使用起来应该会很有趣。

此处我只会简要介绍主要的数据库对象;如果你想查看整个模式,可以查看脚注中引用的完整描述。

主要实体是预订 (映射到 bookings 表)。一次预订可以包含几个乘客,每个乘客都有一张单独的电子机票 (tickets)。乘客不构成单独的实体;为了我们的实验,我们将假设所有的乘客都是唯一的。

每张机票包括一个或多个航段 (映射到 ticket_fights 表)。在两种情况下,单张机票可以有多个航段:要么是往返机票,要么是为转机而签发的。尽管在模式中没有相应的约束,但假定一个预订中的所有机票都有相同的航段。

每个航班 (flights) 从一个机场 (airports) 飞往另一个机场。具有相同航班号的航班具有相同的出发点和目的地,但出发日期不同。

routes 视图基于 flights 表;它显示了与特定航班日期无关的航线信息。

在办理登机手续时,每位乘客都会被签发一张带有座位号的登机牌 (boarding_passes)。只有在机票中包含该航班时,乘客才能办理登机手续。航班与座位的组合必须是唯一的,因此不可能为同一个座位签发两张登机牌。

飞机上的座位 (seats) 数量及其在不同舱位之间的分布取决于执飞的特定飞机模型 (aircrafts)。假设每个飞机模型只能有一个座舱配置。

一些表有代理主键,而其他表使用原生主键 (其中一些是复合主键)。这仅仅是出于演示的目的,并不是一个可以效仿的例子。

示例数据库可以被视为真实系统的转储:它包含了过去某个特定时刻获取的数据快照。要显示此时间,你可以调用 bookings.now() 函数。在示例查询中使用此函数,需要在现实世界中使用 now() 函数。

机场名、城市名和飞机型号的名称存储在 airports_data 和 aircrafts_data 表中;它们有两种语言,英语和俄语。为了构造本章中的示例,我通常会查询实体关系图中显示的 airports 和 aircrafts 视图;这些视图基于 bookings.langen 参数的值选择输出语言。尽管如此,一些基表的名称仍可能出现在查询计划中。
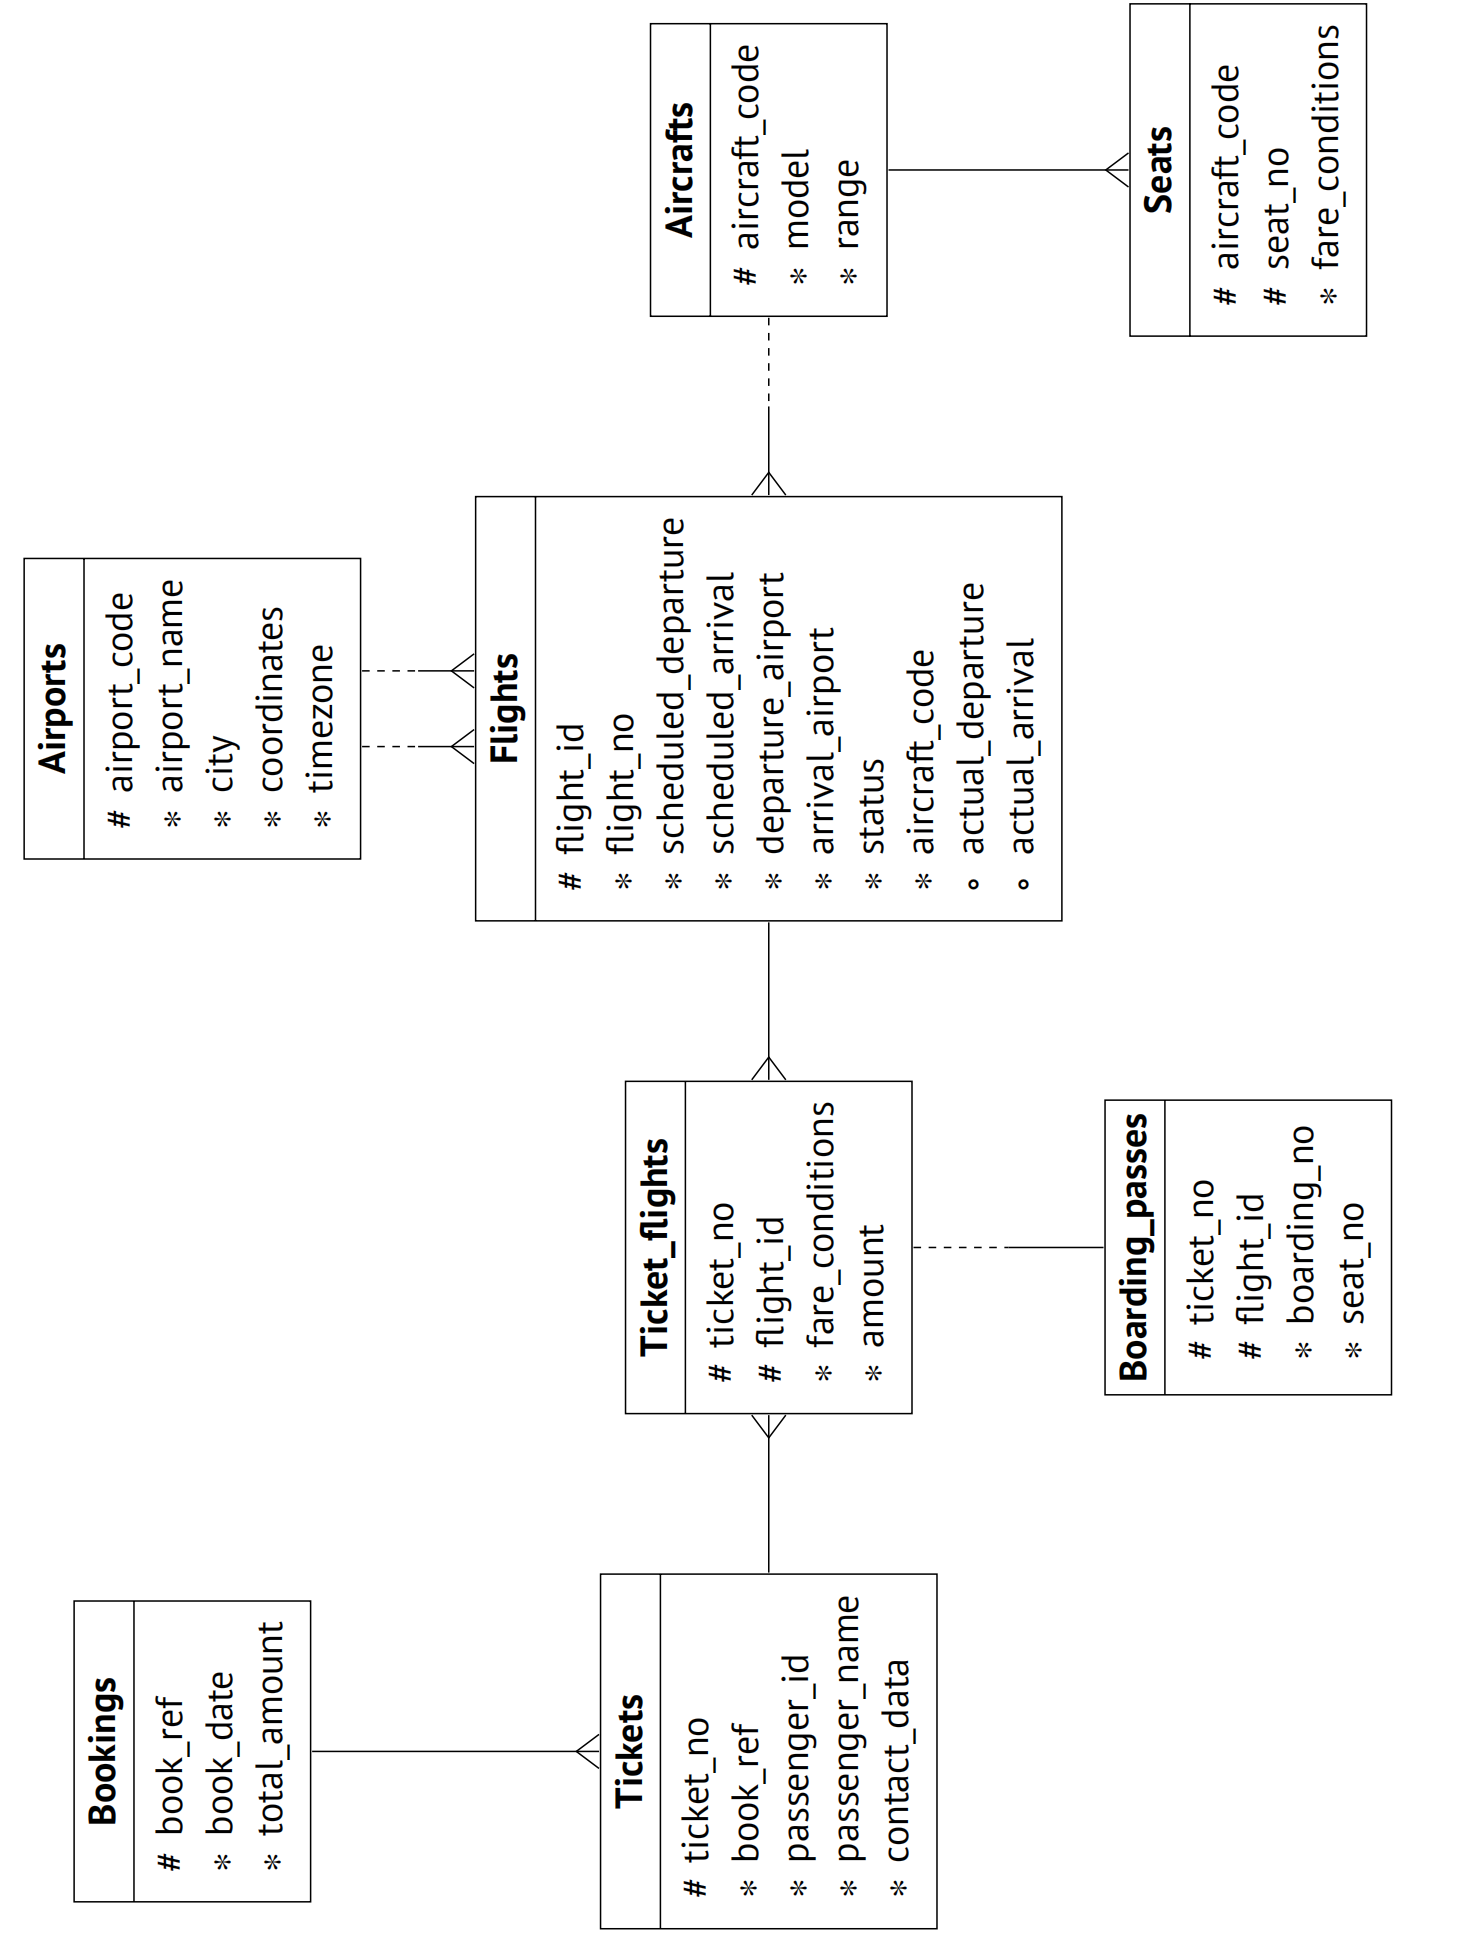
16.1 示例数据库:插图 1
图 16.1

16.2 简单查询协议

一个简单版本的 client-server 协议 3 支持执行 SQL 查询:它将查询文本发送至服务器,并获得完整的执行结果,无论其中包含多少行数据 4。发送到服务器的查询历经几个阶段:解析、转换、规划,然后执行。

16.2.1 解析

首先,PostgreSQL 需要解析 5 查询文本以了解需要执行什么。

词法和语法分析。词法分析器将查询文本分割为一组词素 6 (如关键字、字符串字面量和数值字面量),而语法分析器根据 SQL 语言的语法 7 验证这组词素。PostgreSQL 依赖标准解析工具,即 Flex 和 Bison 工具。

解析后的查询在后端进程的内存中体现为一颗抽象语法树。

例如,让我们看一下以下查询:

SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;

词法分析器识别出五个关键字、五个标识符、一个字符串字面量和三个单字母词素 (逗号、等号和分号)。语法分析器使用这些词素来构建语法树,下图以非常简化的形式显示了语法树。树节点旁边的说明文字指定了查询的相应部分:
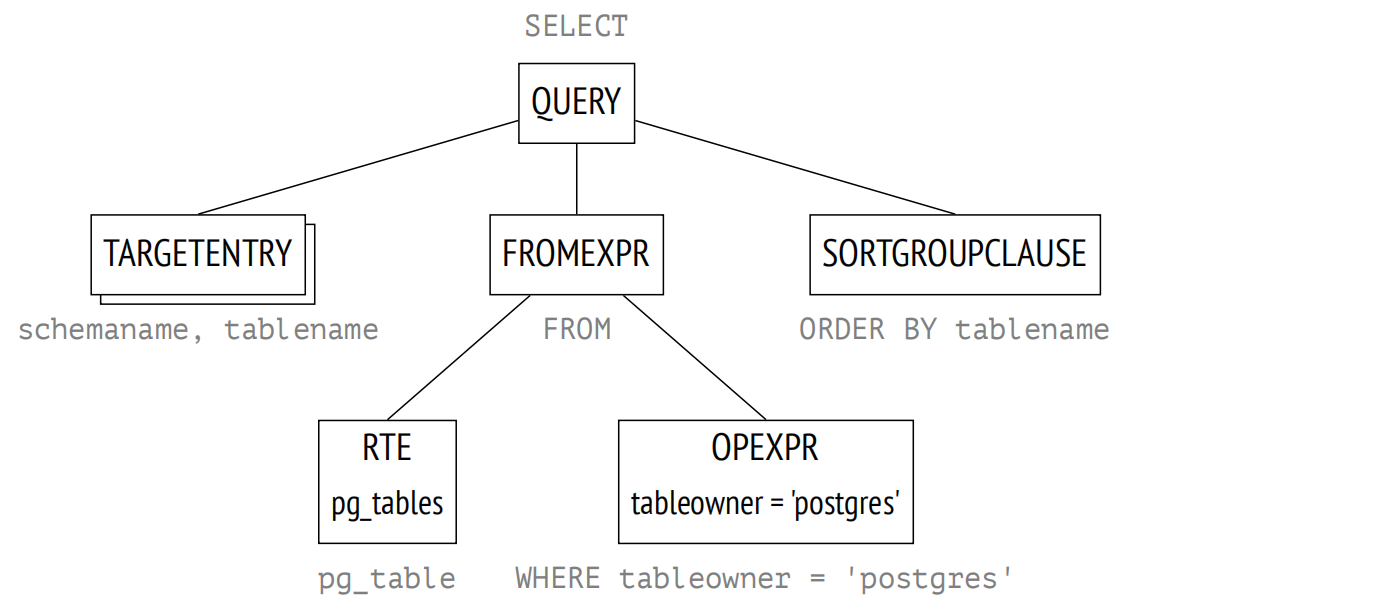
16.2.1 解析:插图 2
图 16.2

一个相当晦涩的 RTE 缩写代表 Range Table Entry。PostgreSQL 源代码中使用术语 range table 来表示表、子查询、关联结果,换句话说,指那些可以由 SQL 操作符处理的任何行集。8

语义分析。语义分析 9 的目的是确认数据库中是否包含查询根据名称引用的表或其他对象,以及用户是否具有访问这些对象的权限。所有语义分析需要的信息都存储在系统表中。

获得语法分析树后,语义分析器执行进一步的重构,包括添加对特定数据库对象、数据类型和其他信息的引用。

如果打开了 debug_print_parse 参数,你可以在服务器日志中看到完整的语法分析树,尽管这没有什么实际的意义。

16.2.2 转换

在下一阶段,查询会被转换(重写)。10

内核出于多种目的使用转换。其中之一是用视图的基本查询所对应的子树来替换语法树中的视图名称。

另一种使用转换的情况是行级安全的实现。11

递归查询的 SEARCH 和 CYCLE 子句也在此阶段进行转换v. 14。12

在上面的示例中,pg_tables 是一个视图;如果我们将其定义放在查询文本中,它将如下所示:

SELECT schemaname, tablename
FROM (
    -- pg_tables
    SELECT n.nspname AS schemaname,
      c.relname AS tablename,
      pg_get_userbyid(c.relowner) AS tableowner,
      ...
    FROM pg_class c
      LEFT JOIN pg_namespace n ON n.oid = c.relnamespace
      LEFT JOIN pg_tablespace t ON t.oid = c.reltablespace
    WHERE c.relkind = ANY (ARRAY['r'::char, 'p'::char])
)
WHERE tableowner = 'postgres'
ORDER BY tablename;

然而,服务器并不处理查询的文本表示;所有操作都在语法树上执行。下图显示了转换后树的简化版本 (如果打开了 debug_print_rewrite 参数,你可以在服务器日志中看到其完整版本)。

语法树反映了查询的语法结构,但它并没有说明操作应该以何种顺序执行。

PostgreSQL 还支持用户通过重写规则系统实现的自定义转换。13
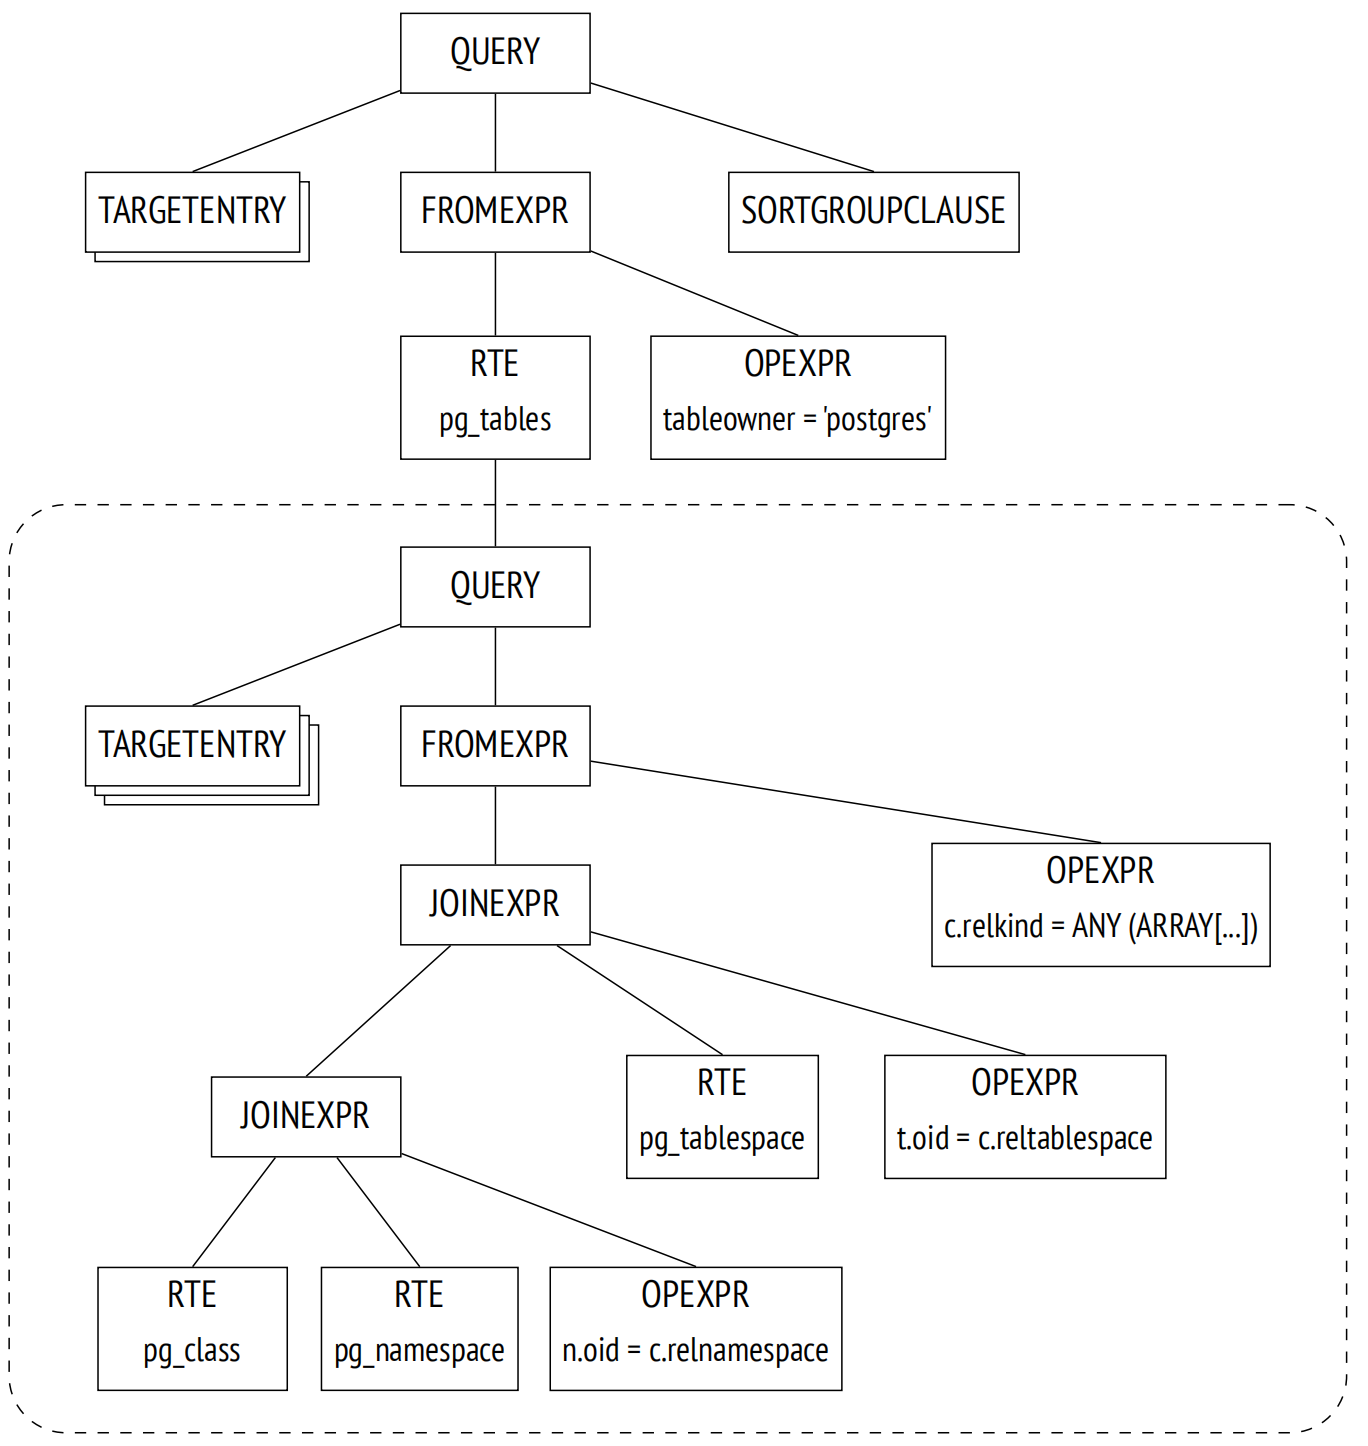
16.2.2 转换:插图 3
图 16.3

规则系统的支持被宣称为 Postgres 发展的主要目标之一;14 当规则首次实现时,它还是一个学术项目,但从那时起,规则已经被多次重新设计。规则系统是一个非常强大的机制,但理解和调试它相当困难。甚至有人提议完全从 PostgreSQL 中移除规则,但这个想法并没有获得一致支持。在大多数情况下,使用触发器而不是规则会更安全也更容易。

16.2.3 规划

SQL 是一种声明式语言:查询仅指定了要获取哪些数据,但没有指定如何去获取。

任何查询都有多条执行路径。语法树中显示的每个操作都可以通过多种方式完成:例如,可以通过读取整个表以获取结果 (并过滤掉冗余项) ,或者通过索引扫描找到所需的行。数据集总是成对连接的,因此有大量不同的选项,这些选项在连接的顺序上各不相同。除此之外,还有多种连接算法:例如,执行器可以扫描第一个数据集的行,并在另一个数据集中检索匹配的行,或者可以先对两个数据集进行排序,然后合并在一起。对于每种算法,我们都可以找到一个使用案例,其中它的表现优于其他算法。

最佳和非最佳的计划,其执行时间可能相差几个数量级,因此负责优化解析后的查询的规划器 15 是系统中最复杂的组件之一。

计划树。执行计划也以树的形式表示,但其节点涉及的是数据的物理操作,而非逻辑操作。

如果你想探索完整的计划树,可以通过打开 debug_print_plan 参数将它们转储到服务器日志中。但在实践中,通常查看 EXPLAIN 命令 16 显示的计划的文本表示就足够了。

下图着重显示了树的主要节点。这些节点正是 EXPLAIN 命令输出中显示的节点。

现在,让我们关注以下两点:

  • 树仅包含三个查询表中的两个:规划器发现检索结果并不需要其中一个表,并将其从计划树中移除。

  • 对于树中的每个节点,规划器提供了预估成本和预估要处理的行数。

=> EXPLAIN SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Sort (cost=21.03..21.04 rows=1 width=128)
   Sort Key: c.relname
   −> Nested Loop Left Join (cost=0.00..21.02 rows=1 width=128)
       Join Filter: (n.oid = c.relnamespace)
       −> Seq Scan on pg_class c (cost=0.00..19.93 rows=1 width=72)
           Filter: ((relkind = ANY ('{r,p}'::"char"[])) AND (pg_g...
       −> Seq Scan on pg_namespace n (cost=0.00..1.04 rows=4 wid...
(7 rows)

查询计划中显示的 Seq Scan 节点对应读取表的操作,而 Nested Loop 节点代表连接操作。
16.2.3 规划:插图 4
图 16.4

计划搜索。PostgreSQL 使用基于成本的优化器;17 它会检查潜在的计划,并估算执行它们所需的资源 (比如 I/O 操作或 CPU 周期)。这种评估会具体细化成一个数字,称为计划的成本。在所有考虑的计划中,优化器会选择成本最低的计划。

但问题在于,随着连接表的数量增加,潜在可用计划的数量呈指数级增长,因此即使是相对简单的查询,也不可能将全部计划考虑在内。通常情况下,会使用动态规划算法,同时结合一些启发式算法来缩小搜索范围。这使得规划器能够在可接受的时间内为包含大量表的查询找到数学上精确的解决方案。

精确的解决方案并不能保证所选计划确实是最优的,因为规划器使用的是简化的数学模型,并且可能缺乏可靠的输入数据。

管理连接顺序。查询可以以某种方式构建,以在一定程度上限制搜索范围 (但有可能错过最优计划)。

  • 通用表表达式 (CTE) 和主查询可以单独优化;为了保证这种行为,你可以指定 MATERIALIZED 子句v. 12。18

  • 在非 SQL 函数中运行的子查询总是单独优化的。(SQL 函数有时可以内联到主查询中。19)

  • 如果设置了 join_collapse_limit 参数并在查询中使用显式 join 子句,那么某些连接的顺序将由查询语法结构定义;from_cllapse_limit 参数对子查询有相同的影响。20

最后一点可能需要解释一下。让我们看一个查询,它没有为 FROM 子句中列出的表指定任何显式连接:

SELECT ...
FROM a, b, c, d, e
WHERE ...

此处,规划期必须考虑所有可能的连接组合。查询由语法树的以下部分表示 (示意性地展示):
16.2.3 规划:插图 5
图 16.5

在下一个示例中,连接有一个由 JOIN 子句定义的特定结构。

SELECT ...
FROM a, b JOIN c ON ..., d, e
WHERE ...

语法分析树表明了这种结构:

16.2.3 规划:插图 6
图 16.6

规划器通常会展平连接树,使其看起来像第一个例子中的那样。规划器算法会遍历树,并用其元素的平面列表替换每个 JOINEXPR 节点。21

然而,只有当生成的平面列表中的元素不超过 join_collapse_limit8 时,才会执行这种展平。在这个特定案例中,如果 join_collapse_limit 值小于 5,那么 JOINEXPR 节点将不会被展平。

对于规划器来说,它意味着:

  • 表 B 必须与表 C 连接 (反之亦然,表 C 必须与表 B 连接;一对连接内的顺序不受限制)。

  • 表 A、D、E 以及 B 与 C 的连接结果可以按任何顺序连接。

如果 join_collapse_limit 参数设置为 1,那么由显式 JOIN 子句定义的顺序会被保留。

对于 FULL OUTER JOIN 操作,无论 join_collapse_limit 参数的值如何,它们都不会被展平。

from_collapse_limit8 参数以类似的方式控制子查询的展平。尽管子查询看起来不像 JOIN 子句,但在语法分析树级别,这种相似性便会变得很明显。

这里有一个示例查询:

SELECT ...
FROM a,
  (
    SELECT ... FROM b, c WHERE ...
  ) bc,
  d, e
WHERE ...

相应的连接树如下所示。这里唯一的区别是这颗树包含 FROMEXPR 节点,而不是 JOINEXPR (参数名称由此而来)。
16.2.3 规划:插图 7
图 16.7

遗传查询优化。一旦展平之后,树可能在同一层包含太多元素 — 无论是表还是必须单独优化的连接结果。规划时间会随着需要连接的数据集数量指数级增长,因此可能会超出所有合理的限制。

如果启用了 geqoon 参数,且某一层的元素个数超过了 geqo_threshold12 值,那么规划器将使用遗传算法来优化查询。22 这种算法比动态规划算法快得多,但不能保证找到的计划是最优的。因此,通常的做法是通过减少必须优化的元素数量来避免使用遗传算法。

遗传算法有多个可配置的参数,23 但我不打算在这里进行介绍。

选择最优计划。一个计划是否可以被认为是最优的,取决于特定客户端如何使用查询结果。如果客户端需要一次性获取完整结果 (例如,用于创建一份报告),那么计划应优化对所有行的检索。但如果优先级是尽快返回第一行 (例如,用于屏幕显式),最优计划可能完全不同。

为了做出选择,PostgreSQL 会计算成本的两个组成部分:

=> EXPLAIN
SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Sort (cost=21.03..21.04 rows=1 width=128)
  Sort Key: c.relname
  −> Nested Loop Left Join (cost=0.00..21.02 rows=1 width=128)
      Join Filter: (n.oid = c.relnamespace)
      −> Seq Scan on pg_class c (cost=0.00..19.93 rows=1 width=72)
          Filter: ((relkind = ANY ('{r,p}'::"char"[])) AND (pg_g...
      −> Seq Scan on pg_namespace n (cost=0.00..1.04 rows=4 wid...
(7 rows)

第一个部分 (启动成本) 表示为节点执行做准备所付出的成本,而第二个部分 (总成本) 包括获取结果所产生的所有开销。

有时人们说启动成本是检索结果集第一行的成本,但这并不是太准确。

为了挑选出首选计划,优化器会检查查询是否使用了游标 (通过 SQL 中提供的 DECLARE 命令或在 PL/PGSQL 中显式声明)。24 如果没有,则假定客户端需要一次性获取整个结果,那么优化器会选择总成本最低的计划。

如果查询是通过游标执行的,所选计划必须优化仅检索占所有数据 cursor_tuple_fraction0.1 比例的行。更准确地说,PostgreSQL 会选择以下表达式值最小的计划:25

startup cost + cursor_tuple_fraction (total cost − startup cost)

成本估算概要。为了估算计划的总成本,我们必须获取其所有节点的成本估算值。节点的成本取决于它的类型 (很明显,读取堆数据的成本与排序的成本不同) 和该节点处理的数据量 (更大的数据量通常会产生更高的成本) 。虽然节点类型已知,但数据量只能基于输入集的预估基数 (节点需要的行数作为输入) 和节点的选择率 (输出中剩余行的比例) 来估算。这些计算依赖于收集的统计信息,例如表的大小和表列中数据的分布情况。

因此,执行的优化取决于由 AUTOVACUUM 收集和更新的统计信息的准确性。

如果每个节点的基数估算都很准确,那么计算出的成本很可能充分反映出实际成本。主要的规划缺陷通常是由于对基数和选择率的估算不准确造成的,这可能是由于不准确或过时的统计信息、无法使用统计信息或者 — 在较小程度上,由于不完善的规划模型造成的。

基数估算。为了计算节点的基数,规划器必须递归完成以下步骤:

  1. 估算每个子节点的基数,并评估节点将从这些子节点接收到的输入行数。

  2. 估算节点的选择率,也就是将保留在输出中的行的比例。

节点的基数是这两个值的乘积。

选择率用从 0 到 1 的数字表示。数字越小,选择率越高,反之亦然,数字越接近 1,选择率越低。这似乎不合逻辑,但其想法是,高选择率的条件几乎会排除所有行,而仅排除少数行的条件则具有低选择率。

首先,规划器估算定义数据访问方法的叶节点的基数。这些计算依赖于收集的统计信息,例如表的总大小。

过滤条件的选择率取决于它们的类型。在最简单的情况下,可以假设它是一个常数值,尽管规划器试图使用所有可用的信息来细化评估。通常,了解如何估算简单的过滤条件就足够了;如果条件包含逻辑运算,那么选择率按以下公式计算:26

selx and y=selxsely sel_{x \text{ and } y} = sel_x sel_y \quad selx or y=1−(1−selx)(1−sely)=selx+sely−selxsely sel_{x \text{ or } y} = 1 - (1 - sel_x)(1 - sel_y) = sel_x + sel_y - sel_x sel_y

不幸的是,这些公式假设谓词 x 和 y 不相互依赖。对于相互依赖的谓词,这样的估算是不准确的。

为了估算连接的基数,规划器必须获得笛卡尔积的基数 (即两个数据集基数的乘积) 并估算连接条件的选择率,这同样取决于条件类型。

其他节点的基数 (例如排序或聚集) 估算以类似的方式进行。

需要注意的是,对于下层计划节点的基数若估算不准确会影响所有后续的计算,进而导致总成本估算不准确以及计划选择不佳。更糟糕的是,规划器没有关联结果的统计信息,只有表的统计信息。

成本估算。成本估算的过程也是递归的。要计算一棵子树的成本,需要计算并累加其所有子节点的成本,然后加上父节点本身的成本。

为了估算一个节点的成本,PostgreSQL 会将已经估算出的节点基数为输入,应用该节点所执行操作的数学模型。对于每个节点,都会计算启动成本和总成本。

有些操作没有前置条件,因此它们的执行会立即开始;这些节点的启动成本为零。

相反,其他操作需要等待一些准备动作完成。例如,排序节点通常需要等待其子节点所有的数据到位,才能继续执行自己的任务。此类节点的启动成本通常大于零:即使上层节点 (或客户端) 只需要全部输出中的一行数据,也必须付出此成本。

规划器执行的所有计算都只是估算,可能与实际执行时间无关。唯一目的是在相同条件下,对同一查询的不同计划进行比较。在其他情况下,比较查询 (尤其是不同的查询) 的成本是没有意义的。例如,由于过时的统计信息,成本可能被低估了;一旦刷新统计信息,计算出的数字可能会上升,随着估算越来越准确,规划器将选择一个更好的计划。

16.2.4 执行

查询优化期间创建的计划现在需要被执行。27

执行器在后端进程内存中打开一个 portal;28 它是一个保持当前正在执行的查询状态的对象。这个状态以一棵树的形式表示,展示了计划树的结构。
16.2.4 执行:插图 8
图 16.8

这棵树的节点就像一条流水线一样运行,相互请求以及发送数据。

查询执行从根开始。根节点 (在本例中代表 SORT 操作) 从它的子节点中拉取数据。接收到所有行之后,会对它们进行排序并传递给客户端。

一些节点 (如本例中所示的 NESTLOOP 节点) 从不同来源接收数据集并进行连接。这样的节点从两个子节点拉取数据,一旦接收到满足连接条件的一对行,就立即向上层传递结果 (不像排序,排序必须先获取所有行)。此时,节点的执行被中断,直到其父节点请求下一行。如果只需要部分结果 (例如,查询中有 LIMIT 子句),那么操作将不会全部执行。

树的两个 SEQSCAN 叶节点负责表扫描。当父节点向这些节点请求数据时,它们从相应的表中获取后续的行。

然而一些节点不存储任何行,而是立即向上传递,但其他节点 (例如 SORT) 需要保留潜在的大量数据。为此,在后端进程内存中分配了一个 work_mem4MB 内存块;如果此内存不够,剩余的数据会溢出到磁盘上的临时文件中。29

一个计划可能有多个需要存储数据的节点,因此 PostgreSQL 可能会分配多个内存块,每个内存块的大小为 work_mem。查询可使用的总 RAM 大小不受任何限制。

16.3 扩展查询协议

在使用简单查询协议时,每个命令 (即使是重复多次的命令) 都必须经过前面提及的所有阶段:

  1. 解析

  2. 转化

  3. 规划

  4. 执行

然而,多次解析同一个查询是没有意义的。重复解析仅常量不同的查询也没有多大意义 — 语法树的结构仍然是相同的。

简单查询协议的另一个缺点是,客户端一次性接收整个结果,无论可能包含多少行。

通常,你可以使用 SQL 命令克服这些限制。为了解决第一个问题,你可以在执行 EXECUTE 命令之前 PREPARE 查询;第二个问题可以通过使用 DECLARE 创建一个游标并通过 FETCH 返回行来解决。但在这种情况下,这些新创建对象的命名必须由客户端来处理,而服务端则需要额外的开销来解析额外的命令。

扩展 client-server 协议提供了另一种替代解决方案,使得可以在协议本身的命令级别上精确控制各个操作符的执行阶段。

16.3.1 预备

在预备阶段,查询像往常一样被解析和转换,但是生成的语法树会保留在后端进程的内存中。

PostgreSQL 没有用于查询的全局缓存。这种架构的缺点很明显:每个后端进程都必须解析所有传入的查询,即使同一个查询已经被另一个后端进程解析过,但也有一些好处。全局缓存很容易因为锁而成为瓶颈。客户端运行多个短小但不同的查询 (比如那些只有常量有所不同的查询) 会产生大量负载,并且会对整个实例的性能产生负面影响。在 PostgreSQL 中,查询是在本地解析的,因此不会对其他进程产生影响。

预备查询可以参数化。此处是一个使用 SQL 命令的简单示例 (尽管和协议级别的预备语句不同,但最终的效果是一致的):

=> PREPARE plane(text) AS
SELECT * FROM aircrafts WHERE aircraft_code = $1;

所有已命名的预备语句都会显示在 pg_prepared_statements 视图中:

=> SELECT name, statement, parameter_types
FROM pg_prepared_statements \gx
−[ RECORD 1 ]−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
name            | plane
statement       | PREPARE plane(text) AS +
                | SELECT * FROM aircrafts WHERE aircraft_code = $1;
parameter_types | {text}

你不会在此处找到任何未命名的语句 (使用扩展查询协议或 PL/pgSQL 的语句)。其他后端进程的预备语句也不会显示:无法访问其他会话的内存。

16.3.2 参数绑定

在执行预备语句之前,必须绑定实际参数值。

=> EXECUTE plane('733');
 aircraft_code |     model      | range
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−+−−−−−−−
 733           | Boeing 737−300 | 4200
(1 row)

在预备语句中绑定参数相较于将字面量与查询字符串拼接起来的优势在于,它使得 SQL 注入变得绝无可能:绑定的参数值无法以任何方式修改已经创建的语法树。

要在没有预备语句的情况下达到相同的安全级别,你需要仔细转义来自不可信来源的每个值。

16.3.3 规划和执行

在执行预备语句时,查询规划是基于实际参数值进行的;然后将计划传递给执行器。

不同的参数值可能意味着不同的最优计划,因此考虑确切的值很重要。例如,在查找昂贵的预定时,规划器假设匹配的行数不会太多,并使用索引扫描:

=> CREATE INDEX ON bookings(total_amount);
=> EXPLAIN SELECT * FROM bookings
WHERE total_amount > 1000000;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on bookings (cost=86.49..9245.82 rows=4395 wid...
   Recheck Cond: (total_amount > '1000000'::numeric)
   −> Bitmap Index Scan on bookings_total_amount_idx (cost=0.00....
       Index Cond: (total_amount > '1000000'::numeric)
(4 rows)

但如果提供的条件适用于所有预订,那么使用索引就没有意义了,因为整个表都需要被扫描:

=> EXPLAIN SELECT * FROM bookings WHERE total_amount > 100;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on bookings (cost=0.00..39835.88 rows=2111110 width=21)
   Filter: (total_amount > '100'::numeric)
(2 rows)

在某些情况下,规划器可能会同时保留语法树和查询计划以避免重复规划。这样的计划不考虑参数值,因此被称之为 generic plan (与基于实际值的 custom plan 相比)。30

当服务器在不影响性能的情况下可以使用 generic plan 的一个明显情况是查询中没有参数。

参数化预备语句的前五次优化始终依赖于实际参数值;规划器会基于这些值计算 custom plan 的平均成本。从第六次执行开始,如果 generic plan 平均比 custom plan 更有效 (考虑到 custom plan 每次都必须重新创建) 31,规划器便会保留 generic plan,并继续使用它,跳过优化阶段。

plane 预备语句已经执行过一次。在接下来的 3 次执行之后,服务器仍然使用 custom plan — 你可以通过查询计划中的参数值来判断:

=> EXECUTE plane('763');
=> EXECUTE plane('773');
=> EXPLAIN EXECUTE plane('319');
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on aircrafts_data ml (cost=0.00..1.39 rows=1 width=52)
   Filter: ((aircraft_code)::text = '319'::text)
(2 rows)

在第 5 次执行之后,规划器切换到 generic plan:它与 custom plan 没有区别,成本是一致的,但是后端进程可以一次性创建并跳过优化阶段,从而减少规划开销。现在 EXPLAIN 命令显示参数是按位置引用的,而不是按值引用的:

=> EXECUTE plane('320');
=> EXPLAIN EXECUTE plane('321');
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on aircrafts_data ml (cost=0.00..1.39 rows=1 width=52)
   Filter: ((aircraft_code)::text = $1)
(2 rows)

当之前的几个 custom plan 比 generic plan 更昂贵时,我们可以很容易想象出一些不愉快的事情;后续计划本来可以更有效,但规划器根本不会考虑。此外,它比较的是估算值而不是实际成本,这也可能导致计算错误。

然而,如果规划器做出了错误的选择v. 12,你可以通过相应地设置 plan_cache_modeauto 参数来覆盖自动决策,并选择是 generic plan 还是 custom plan:

=> SET plan_cache_mode = 'force_custom_plan';
=> EXPLAIN EXECUTE plane('CN1');
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on aircrafts_data ml (cost=0.00..1.39 rows=1 width=52)
   Filter: ((aircraft_code)::text = 'CN1'::text)
(2 rows)

除了其他信息之外,pg_prepared_statements 视图还显示了所选计划的统计信息v. 14:

=> SELECT name, generic_plans, custom_plans
FROM pg_prepared_statements;
 name  | generic_plans | custom_plans
−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 plane |             1 |            6
(1 row)

16.3.4 获取结果

扩展查询协议允许批次检索数据,而不是一次性全部检索。SQL 游标几乎具有相同的效果 (除了服务器有一些额外的工作,并且规划器进行了优化,仅获取前面 cursor_tuple_fraction 比例的行,而不是整个结果集):

=> BEGIN;
=> DECLARE cur CURSOR FOR
  SELECT *
  FROM aircrafts
  ORDER BY aircraft_code;
=> FETCH 3 FROM cur;
 aircraft_code |      model      | range
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−+−−−−−−−
 319           | Airbus A319−100 |  6700
 320           | Airbus A320−200 | 	5700
 321           | Airbus A321−200 | 	5600
(3 rows)
=> FETCH 2 FROM cur;
 aircraft_code |      model     | range
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−+−−−−−−−
 733           | Boeing 737−300 |  4200
 763           | Boeing 767−300 |  7900
(2 rows)
=> COMMIT;

如果查询返回了多行,并且客户端需要所有数据,那么系统吞吐量高度依赖于批次的大小。单个批次中的行数越多,那么访问服务器以及获取响应所产生的通信开销就越少。但是随着批次大小的增加,这些好处变得不那么明显了:虽然一次一行与每批十行获取行的差异可能巨大,但如果比较每批 100 行和每批 1000 行,这种差异就不是那么明显了。


  1. postgrespro.com/community/demodb ↩︎

  2. edu.postgrespro.com/demo-big-en-20170815.zip ↩︎

  3. postgresql.org/docs/14/protocol.html ↩︎

  4. backend/tcop/postgres.c, exec_simple_query function ↩︎

  5. postgresql.org/docs/14/parser-stage.html
    backend/parser/README ↩︎

  6. backend/parser/scan.l ↩︎

  7. backend/parser/gram.y ↩︎

  8. include/nodes/parsenodes.h ↩︎

  9. backend/parser/analyze.c ↩︎

  10. postgresql.org/docs/14/rule-system.html ↩︎

  11. backend/rewrite/rowsecurity.c ↩︎

  12. backend/rewrite/rewriteSearchCycle.c ↩︎

  13. postgresql.org/docs/14/rules.html ↩︎

  14. M. Stonebraker, L. A. Rowe. The Design of Postgres ↩︎

  15. postgresql.org/docs/14/planner-optimizer.html ↩︎

  16. postgresql.org/docs/14/using-explain.html ↩︎

  17. backend/optimizer/README ↩︎

  18. postgresql.org/docs/14/queries-with.html ↩︎

  19. wiki.postgresql.org/wiki/Inlining_of_SQL_functions ↩︎

  20. postgresql.org/docs/14/explicit-joins.html ↩︎

  21. backend/optimizer/plan/initsplan.c, deconstruct_jointree function ↩︎

  22. postgresql.org/docs/14/geqo.html
    backend/optimizer/geqo/geqo_main.c ↩︎

  23. postgresql.org/docs/14/runtime-config-query#RUNTIME-CONFIG-QUERY-GEQO.html ↩︎

  24. backend/optimizer/plan/planner.c, standard_planner function ↩︎

  25. backend/optimizer/util/pathnode.c, compare_fractional_path_costs function ↩︎

  26. backend/optimizer/path/clausesel.c, clauselist_selectivity_ext & clauselist_selectivity_or functions ↩︎

  27. postgresql.org/docs/14/executor.html
    backend/executor/README ↩︎

  28. backend/utils/mmgr/portalmem.c ↩︎

  29. backend/utils/sort/tuplestore.c ↩︎

  30. backend/utils/cache/plancache.c, choose_custom_plan function ↩︎

  31. backend/utils/cache/plancache.c, cached_plan_cost function ↩︎

17 统计信息

17.1 基础统计信息

基础的关系级统计信息 1 存储在 pg_class 系统目录表中,其中包括以下数据:

  • 关系中元组的数量 (reltuples)

  • 关系大小,以页为单位 (relpages)

  • 可见性映射中标记的页面数量 (relallvisible)

以下是 flights 表的这些值:

=> SELECT reltuples, relpages, relallvisible
FROM pg_class WHERE relname = 'flights';
 reltuples | relpages | relallvisible
−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−
    214867 |     2624 |          2624
(1 row)

如果查询没有施加任何过滤条件,那么 reltuples 值将作为基数进行估算:

=> EXPLAIN SELECT * FROM flights;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=63)
(1 row)

统计信息在表分析期间收集,包括手动收集和自动收集。2 此外,由于基础统计信息至关重要,因此在其他某些操作 (比如 VACUUM FULL 和 CLUSTER、3 CREATE INDEX 和 REINDEX 4 ) 期间也会计算这些数据,并在清理期间进行细化。5

出于分析目的,会从表中随机选择 300 × default_statistics_target100 行进行采样。建立特定精度的统计信息所需的样本大小与进行分析的数据量关系不大,因此不需要考虑表的大小。6

采样行数取自相同数量 (300 × default_statistics_target) 的随机页面。7 显然,如果表本身越小,那么就可能读取更少的页面,并且为分析选择的行数也会更少。

在大表中,统计信息收集不包括所有行,因此估算值可能与实际值有所不同。这是完全正常的:如果数据在变化,统计信息无论如何都不可能始终准确。达到数量级的准确度就足以选择一个合适的计划。

让我们创建一个 flights 表的副本,并禁用自动清理以便可以控制自动分析的开始时间:

=> CREATE TABLE flights_copy(LIKE flights)
WITH (autovacuum_enabled = false);

新表目前还没有统计信息:

=> SELECT reltuples, relpages, relallvisible
FROM pg_class WHERE relname = 'flights_copy';
 reltuples | relpages | relallvisible
−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−
        −1 |       0  |            0
(1 row)

值 reltuples = −1 用于区分v. 14尚未分析的表和没有任何行的真正的空表。

在表创建后不久,很有可能会有一些行被插入到表中。因此,对当前情况一无所知的规划器会假设表包含 10 个页面:

=> EXPLAIN SELECT * FROM flights_copy;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights_copy (cost=0.00..14.10 rows=410 width=170)
(1 row)

行数基于单行的大小进行估算,在计划中显示为 width。行宽度通常是分析期间计算出的平均值,但由于尚未收集过统计信息,因此此处只是基于列数据类型的一个近似值。8

现在让我们从 flights 表中复制数据并进行分析:

=> INSERT INTO flights_copy SELECT * FROM flights;
INSERT 0 214867
=> ANALYZE flights_copy;

收集的统计信息反映了实际的行数 (表的大小足够小,分析器可以收集所有数据的统计信息):

=> SELECT reltuples, relpages, relallvisible
FROM pg_class WHERE relname = 'flights_copy';
 reltuples | relpages | relallvisible
−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−
    214867 |     2624 |             0
(1 row)

relallvisible 值用于估算仅索引扫描的成本。这个值由 VACUUM 更新:

=> VACUUM flights_copy;
=> SELECT relallvisible FROM pg_class WHERE relname = 'flights_copy';
 relallvisible
−−−−−−−−−−−−−−−
          2624
(1 row)

现在让我们在不更新统计信息的情况下将行数翻倍,然后检查计划中的基数预估:

=> INSERT INTO flights_copy SELECT * FROM flights;
=> SELECT count(*) FROM flights_copy;
 count
−−−−−−−−
 429734
(1 row)
=> EXPLAIN SELECT * FROM flights_copy;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights_copy (cost=0.00..9545.34 rows=429734 width=63)
(1 row)

尽管 pg_class 的数据是过时的,但预估的结果是准确的:

=> SELECT reltuples, relpages
FROM pg_class WHERE relname = 'flights_copy';
 reltuples | relpages
−−−−−−−−−−−+−−−−−−−−−−
    214867 |     2624
(1 row)

问题在于,如果规划器发现 relpages 和实际文件大小之间存在差距,它可以缩放 reltuples 值以提高预估的准确性。9 由于与 relpages 相比文件大小增加了一倍,规划器调整了预估的行数,并假设数据密度保持不变:

=> SELECT reltuples *
  (pg_relation_size('flights_copy') / 8192) / relpages AS tuples
FROM pg_class WHERE relname = 'flights_copy';
 tuples
−−−−−−−−
 429734
(1 row)

当然,这样的调整可能并不总是有效 (例如,如果我们删除了一些行,预估值将保持不变),但在某些情况下,它允许规划器保持,直到发生了显著变化,触发下一次分析的运行。

17.2 空值

尽管理论家们对此不赞成 10,但空值在关系数据库中仍然扮演着重要角色:它们提供了一种简便的方式来反映某个值是未知的或不存在的。

但是,特殊值需要特殊处理。除了理论上的不一致之外,还有许多实际挑战需要考虑。常规的布尔逻辑被三值逻辑所取代,因此 NOT IN 的行为出人意料。尚不清楚是否应该将空值视为大于或小于常规值 (因此排序时有 NULLS FIRST 和 NULLS LAST 子句)。不太明显的是,聚合函数是否应该考虑空值。严格来说,空值根本就不是一个值,因此规划器需要额外的信息来处理它们。

除了在关系级收集的最简单的基础统计信息之外,分析器还为关系的每一列收集统计信息。这些数据存储在系统目录表 pg_statistic 中 11,你也可以通过 pg_stats 视图访问,pg_stats 以更简便的格式提供这些信息。

空值的比例属于列级统计信息;在分析过程中计算,显示为 null_frac 属性。

例如,在搜索尚未起飞的航班时,我们可以依赖尚未定义的起飞时间:

=> EXPLAIN SELECT * FROM flights WHERE actual_departure IS NULL;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..4772.67 rows=16702 width=63)
   Filter: (actual_departure IS NULL)
(2 rows)

为了预估结果,规划器将总行数乘以空值的比例:

=> SELECT round(reltuples * s.null_frac) AS rows
FROM pg_class
  JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
  AND s.attname = 'actual_departure';
 rows
−−−−−−−
 16702
(1 row)

以下是实际的行数:

=> SELECT count(*) FROM flights WHERE actual_departure IS NULL;
 count
−−−−−−−
 16348
(1 row)

17.3 非重复值

pg_stats 视图中的 n_distinct 字段显示了列中非重复值的数量。

如果 n_distinct 为负数,其绝对值表示列中非重复值的比例,而不是它们实际的数量。例如,-1 表示所有列值都是唯一的,而 -3 意味着每个值平均出现在三行中。如果非重复值的预估数量超过了总行数的 10%,那么分析器会使用一个比例值来显式;在这种情况下,进一步的数据更新不太可能改变这个比例值。12
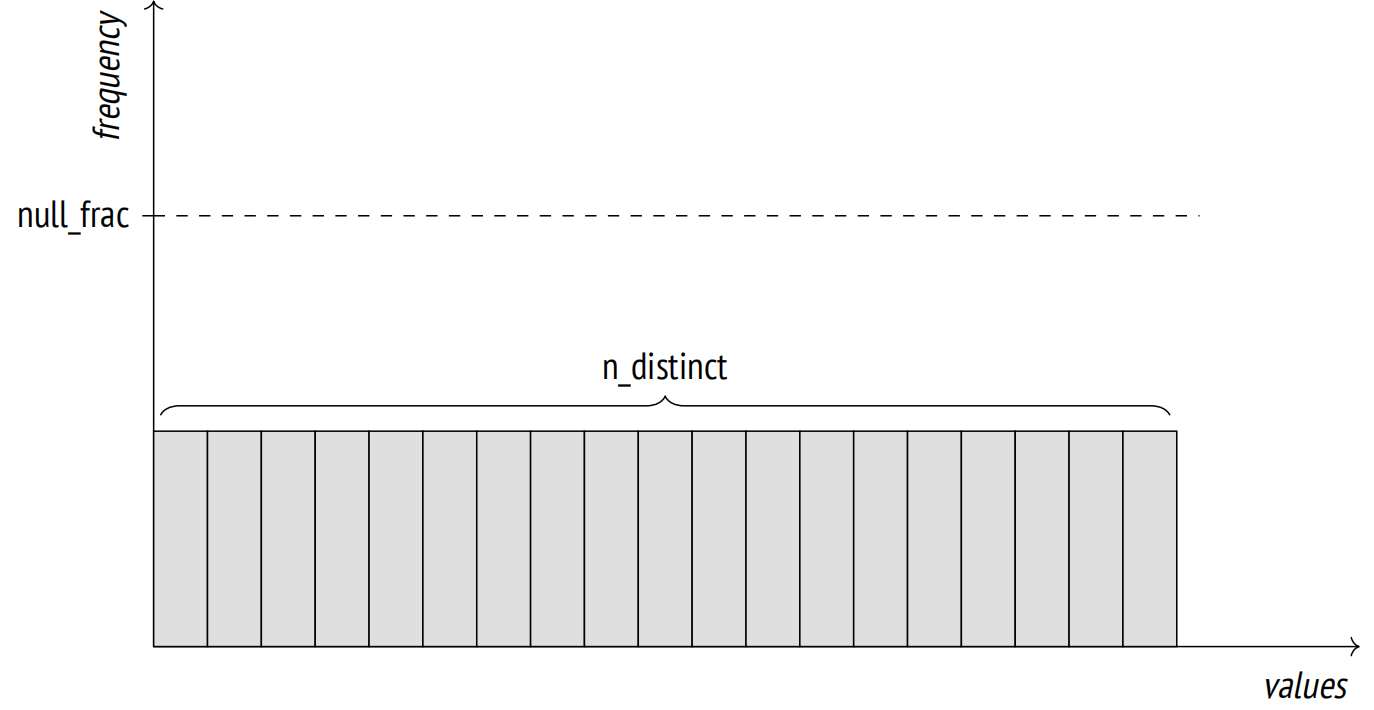
17.3 非重复值:插图 1
图 17.1

如果预期数据分布均匀,那么会使用非重复值的数量。例如,在评估 “column = expression” 条件的基数时,如果在规划阶段无法知道表达式的确切值,那么规划器假设该表达式可以以相等的概率取任何列值:13
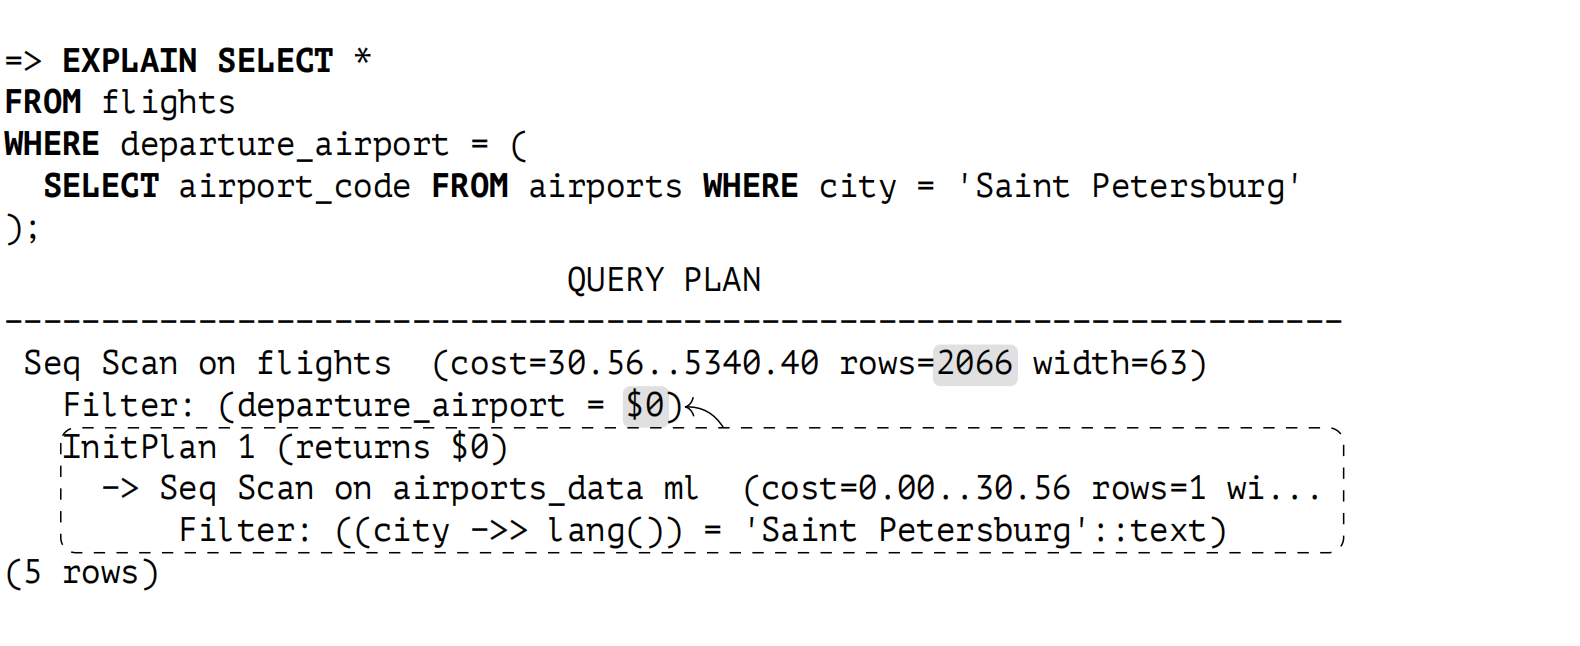
17.3 非重复值:插图 2
图 17.2

此处 InitPlan 节点只执行一次,计算出的值在主计划中使用。

=> SELECT round(reltuples / s.n_distinct) AS rows
FROM pg_class
  JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
  AND s.attname = 'departure_airport';
 rows
−−−−−−
 2066
(1 row)

如果非重复值的预估数量不正确 (因为分析的行数有限),那么你可以在列级别覆盖它:

ALTER TABLE ...
  ALTER COLUMN ...
  SET (n_distinct = ...);

如果所有的数据始终均匀分布,则此信息 (加上最小值和最大值) 就足够了。然而,对于非均匀分布 (在实际中更为常见) ,这样的估算是不准确的:

=> SELECT min(cnt), round(avg(cnt)) avg, max(cnt)
FROM (
  SELECT departure_airport, count(*) cnt
  FROM flights
  GROUP BY departure_airport
) t;
 min | avg  |  max
−−−−−+−−−−−−+−−−−−−−
 113 | 2066 | 20875
(1 row)

17.4 高频值

如果数据分布不均,那么会根据高频值 (MCV) 及其频率的统计信息对预估值进行微调。pg_stats 视图分别在 most_common_vals 和 most_common_freqs 字段中显示这些数组。

以下是各种类型的飞机关于此类统计信息的一个例子:
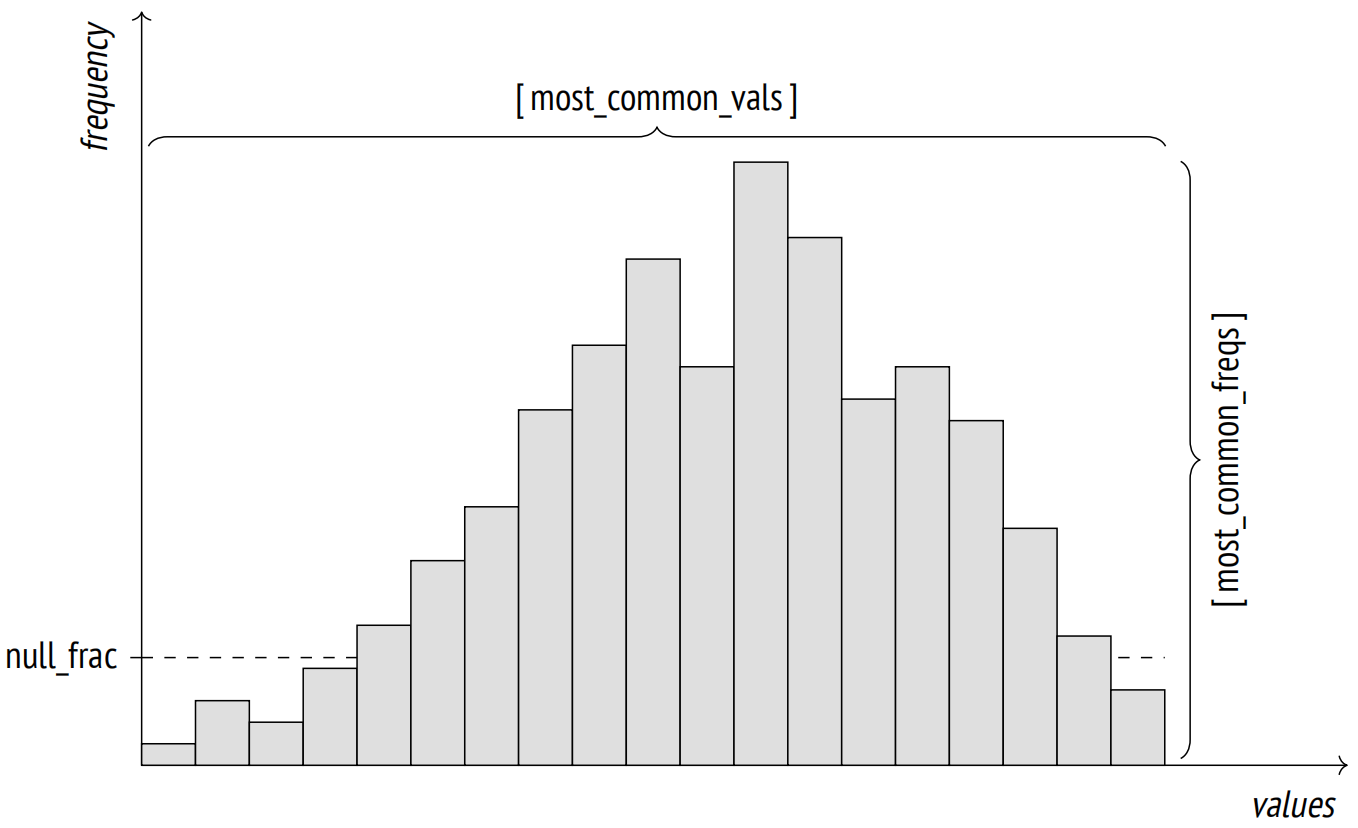
17.4 高频值:插图 3
图 17.3
=> SELECT most_common_vals AS mcv,
  left(most_common_freqs::text,60) || '...' AS mcf
FROM pg_stats
WHERE tablename = 'flights' AND attname = 'aircraft_code' \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
mcv | {CN1,CR2,SU9,321,733,763,319,773}
mcf | {0.27886668,0.27266666,0.26176667,0.057166666,0.037666667,0....

为了预估 “column = value” 条件的选择率,只需在 most_common_vals 数组中找到这个值,并从具有相同位置的 most_common_freqs 数组元素中获取其频率即可:14

=> EXPLAIN SELECT * FROM flights WHERE aircraft_code = '733';
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..5309.84 rows=8093 width=63)
   Filter: (aircraft_code = '733'::bpchar)
(2 rows)

=> SELECT round(reltuples * s.most_common_freqs[
  array_position((s.most_common_vals::text::text[]),'733')
])
FROM pg_class
  JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
  AND s.attname = 'aircraft_code';
 round
−−−−−−−
  8093
(1 row)

显然,这样的估算值与实际值相近:

=> SELECT count(*) FROM flights WHERE aircraft_code = '733';
 count
−−−−−−−
  8263
(1 row)

MCV 列表还用于预估不等条件的选择率。例如,"column < value" 这样的条件要求分析器在 most_common_vals 中搜索所有小于目标值的值,并将 most_common_freqs 中列出的相应频率相加。15

当非重复值不是太多时,MCV 统计信息效果最佳。数组的最大大小由 default_statistics_target100 参数定义,该参数也限制了用于分析目的而随机采样的行数。

在某些情况下,增加默认参数值是有意义的,从而扩大 MCV 列表并提高预估的准确性。你可以在列级别执行该操作:

ALTER TABLE ...
  ALTER COLUMN ...
  SET STATISTICS ...;

采样大小也会增长,但仅限于指定的表。

由于 MCV 数组存储了实际的值,因此可能会占用相当多的空间。为了控制 pg_statistic 大小并避免给规划器增加无用功,大于 1 kB 的值会被排除在分析和统计之外。但由于如此大的值可能是唯一的,它们可能本来就不会出现在 most_common_vals 中。

17.5 直方图

如果非重复值太多以至于无法存储在数组中,PostgreSQL 便会使用直方图。在这种情况下,值会分布在直方图的多个桶之间。桶的数量也受到 default_statistics_target 参数的限制。

桶宽度的选择方式是使每个桶获得大致相同数量的值 (这个特性在图中通过面积相等的阴影矩形来体现)。直方图不考虑包含在 MCV 列表中的值。因此,每个桶中值的累积频率等于 1number of buckets\frac{1}{\text{number of buckets}}。

直方图作为桶的边界值数组存储在 pg_stats 视图的 histogram_bounds 字段中:

=> SELECT left(histogram_bounds::text,60) || '...' AS hist_bounds
FROM pg_stats s
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
                           hist_bounds
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 {10B,10E,10F,10F,11H,12B,13B,14B,14H,15G,16B,17B,17H,19B,19B...
(1 row)

结合 MCV 列表,直方图用于估算大于和小于条件的选择率等操作 16。例如,让我们看一下为后排座位签发的登机牌数量:
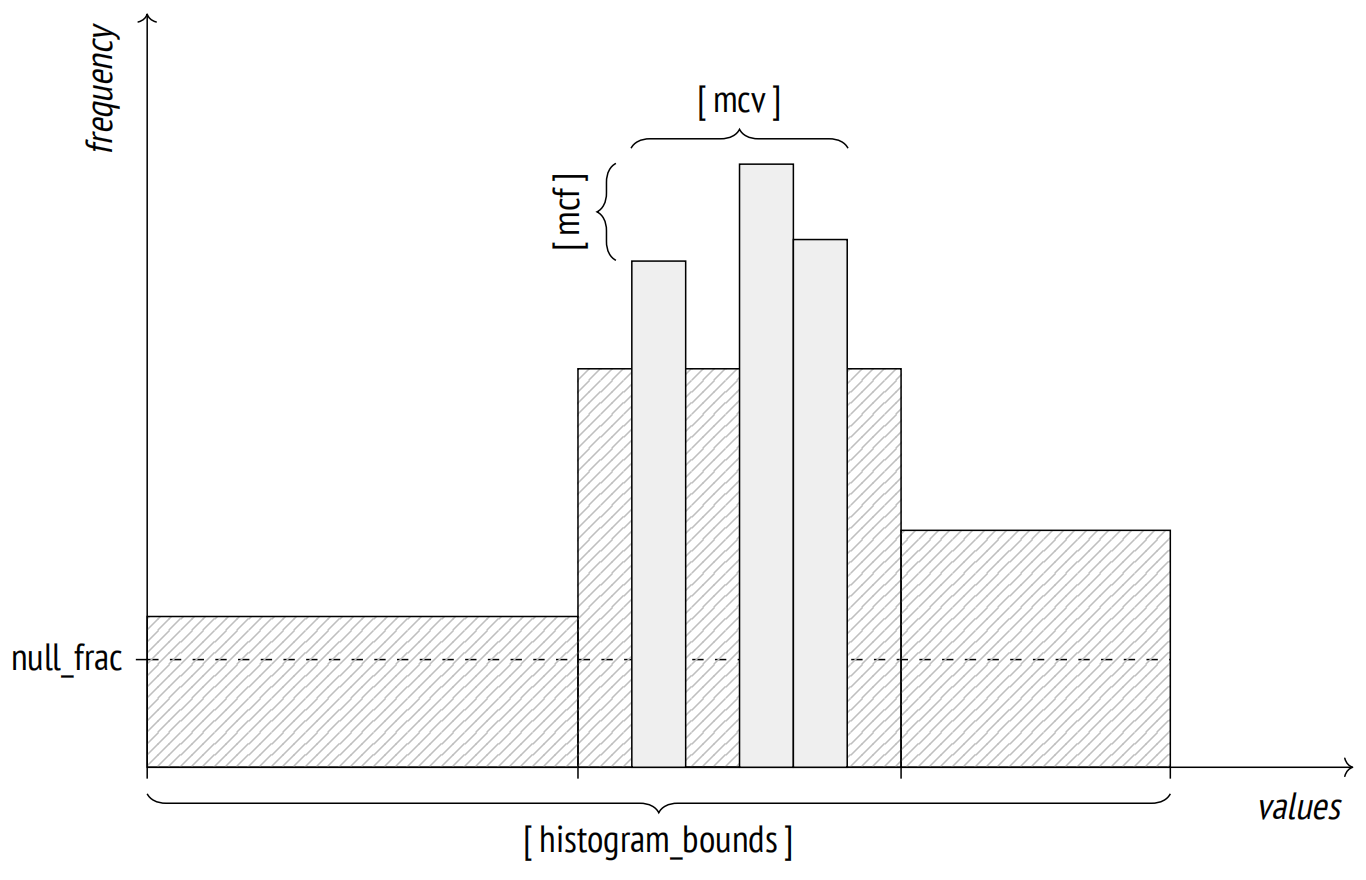
17.5 直方图:插图 4
图 17.4
=> EXPLAIN SELECT * FROM boarding_passes WHERE seat_no > '30B';
														 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on boarding_passes (cost=0.00..157350.10 rows=2983242 ...
   Filter: ((seat_no)::text > '30B'::text)
(2 rows)

我特意选择了位于两个直方图桶之间边界上的座位号。这个条件的选择率将估算为 Nnumber of buckets\frac{N}{\text{number of buckets}},其中 N 是包含满足条件的值 (即位于指定值右侧的桶) 的桶数量。同时还需要考虑到 MCV 不包含在直方图中。

顺便说一下,空值也不会出现在直方图中,但 seat_no 列本来就没有这样的值:

=> SELECT s.null_frac FROM pg_stats s
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
 null_frac
−−−−−−−−−−−
         0
(1 row)

首先,让我们找出满足条件的 MCV 的比例:

=> SELECT sum(s.most_common_freqs[
  array_position((s.most_common_vals::text::text[]),v)
])
FROM pg_stats s, unnest(s.most_common_vals::text::text[]) v
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no'
  AND v > '30B';
    sum
−−−−−−−−−−−−
 0.21226665
(1 row)

整体 MCV 的占比 (直方图忽略的部分) 为:

=> SELECT sum(s.most_common_freqs[
  array_position((s.most_common_vals::text::text[]),v)
])
FROM pg_stats s, unnest(s.most_common_vals::text::text[]) v
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
    sum
−−−−−−−−−−−−
 0.67816657
(1 row)

由于符合指定条件的值恰好占据了 𝑁 个桶 (在可能的 100 个桶中),我们得到以下估算:
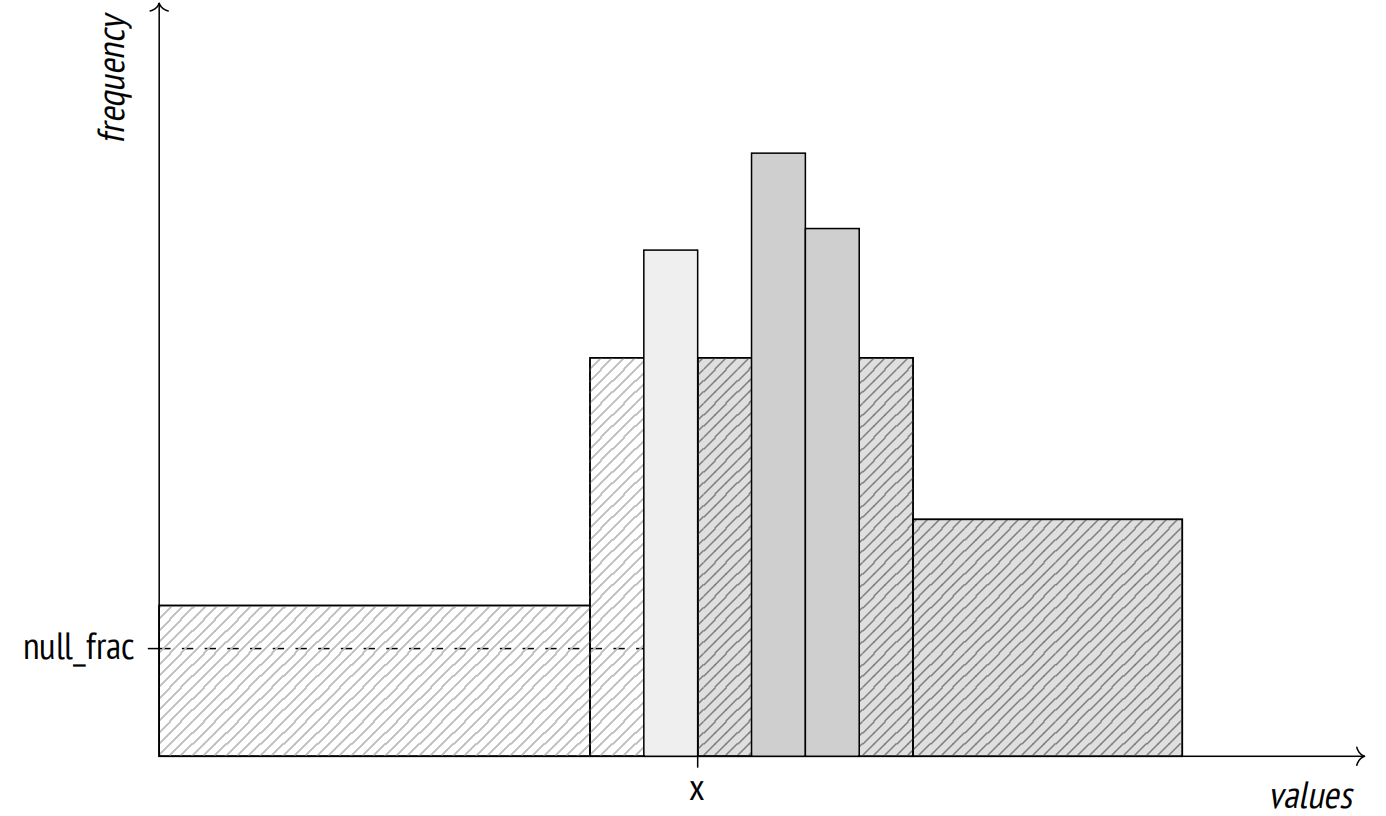
=> SELECT round( reltuples * (
    0.21226665 -- MCV share
  + (1 - 0.67816657 - 0) * (51 / 100.0) -- histogram share
))
FROM pg_class
WHERE relname = 'boarding_passes';
  round
−−−−−−−−−
 2983242
(1 row)
17.5 直方图:插图 5
图 17.5

在非边界值的一般情况下,规划器采用线性插值来考虑包含目标值的桶的部分。

以下是后座的实际数量:

=> SELECT count(*) FROM boarding_passes WHERE seat_no > '30B';
  count
−−−−−−−−−
 2993735
(1 row)

随着增加 default_statistics_target 值,估算的准确性可能会提高,但正如我们的例子所示,即使列包含许多唯一值,直方图与 MCV 列表相结合通常也可以提供很好的结果:

=> SELECT n_distinct FROM pg_stats
WHERE tablename = 'boarding_passes' AND attname = 'seat_no';
 n_distinct
−−−−−−−−−−−−
        461
(1 row)

只有当能产生更好的规划时,提高预估的准确性才有意义。不加思考便增加 default_statistics_target 值可能会减慢规划和分析的速度,而不会带来任何好处。话虽如此,减小此参数值 (降至零) 可能会导致选择不良的计划,即使这确实加快了规划和分析的速度。这种节省通常是不合理的。

17.6 非标量数据类型的统计信息

对于非标量数据类型,PostgreSQL 不仅可以收集值的分布统计信息,还可以收集用于构造这些值的元素的分布信息。当查询不符合第一范式的列时,它可以提高规划的准确性。

  • most_common_elems 和 most_common_elem_freqs 数组显示了高频元素列表及其使用频率。收集这些统计信息用于估算在数组 17 和 tsvector 18 数据类型上的操作选择率。

  • elem_count_histogram 数组显示了值中不同元素的数量的直方图,收集此数据仅用于估算在数组上操作的选择率。

  • 对于范围类型,PostgreSQL 为范围长度以及范围的下边界与上边界构建了分布直方图。这些直方图用于估算在这些类型上各种操作的选择率 19,但 pg_stats 视图没有显示它们。

multirange 数据类型也会收集类似的统计信息v. 14。20

17.7 平均列宽

pg_stats 视图中的 avg_width 字段显示了存储在列中的值的平均大小。当然,对于像 integer 或 char(3) 这样的类型,这个大小总是相同的,但是对于变长的数据类型,比如 text,列与列之间可能有很大的不同:

=> SELECT attname, avg_width FROM pg_stats
WHERE (tablename, attname) IN ( VALUES
  ('tickets', 'passenger_name'), ('ticket_flights','fare_conditions')
);
     attname     | avg_width
−−−−−−−−−−−−−−−−−+−−−−−−−−−−−
 fare_conditions |         8
 passenger_name  |        16
(2 rows)

该统计信息用于估算排序或哈希等这类操作所需的内存量。

17.8 相关性

pg_stats 视图中的 correlation 字段显示了数据的物理顺序和比较操作所定义的逻辑顺序之间的相关性。如果值严格按升序存储,那么它们的相关性将接近于 1;如果按降序排列,那么相关性将接近 -1。数据在磁盘上的分布越混乱,相关性越接近于零。

=> SELECT attname, correlation
FROM pg_stats WHERE tablename = 'airports_data'
ORDER BY abs(correlation) DESC;
  attname     | correlation
−−−−−−−−−−−−−−+−−−−−−−−−−−−−
 coordinates  |
 airport_code | −0.21120238
 city         |  −0.1970127
 airport_name | −0.18223621
 timezone     |  0.17961165
(5 rows)

注意,此统计信息不适用于 coordinates 列:对于 point 类型,没有定义小于和大于操作符。

相关性用于估算索引扫描的成本。

17.9 表达式统计信息

仅当比较操作的左侧或右侧部分引用了列本身并且不包含任何表达式时,才能使用列级统计信息。例如,规划器无法预测对列进行函数计算将如何影响统计信息,因此对于 “function-call = constant” 这样的条件,选择率总是估算为 0.5%:21

=> EXPLAIN SELECT * FROM flights
WHERE extract(
  month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..6384.17 rows=1074 width=63)
   Filter: (EXTRACT(month FROM (scheduled_departure AT TIME ZONE ...
(2 rows)
=> SELECT round(reltuples * 0.005)
FROM pg_class WHERE relname = 'flights';
 round
−−−−−−−
  1074
(1 row)

规划器对函数的语义一无所知,即使是标准函数也是如此。我们的常识表明,在一月份执飞的航班数量大约占总航班数量的 1/12 左右,这一数字比预测值高出一个数量级。

为了提高估算的准确性,我们需要收集表达式统计信息,而不是依赖于列级别的统计信息。有两种方法可以做到这一点。

17.9.1 扩展表达式统计信息v. 14

第一个方法是使用扩展表达式统计信息 22。默认情况下不会收集此类统计信息;你必须通过运行 CREATE STATISTICS 命令手动创建相应的数据库对象:

=> CREATE STATISTICS flights_expr ON (extract(
    month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
))
FROM flights;

数据收集之后,估算的准确性便会提高:

=> ANALYZE flights;
=> EXPLAIN SELECT * FROM flights
WHERE extract(
  month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..6384.17 rows=16667 width=63)
   Filter: (EXTRACT(month FROM (scheduled_departure AT TIME ZONE ...
(2 rows)

要应用所收集的统计信息,查询必须指定和 CREATE STATISTICS 命令形式完全相同的表达式。

扩展统计信息的大小限制可以通过运行 ALTER STATISTICS 命令单独调整v. 13。例如:

=> ALTER STATISTICS flights_expr SET STATISTICS 42;

所有与扩展统计信息相关的元数据都存储在系统目录的 pg_statistic_ext 表中,而收集的数据本身位于一个名为 pg_statistic_ext_data 的单独的表中。这种分离用于实现对敏感信息的访问控制v. 12。

特定用户可用的扩展表达式统计信息位于一个单独的视图中,以一种更简便的格式显示:

=> SELECT left(expr,50) || '...' AS expr,
  null_frac, avg_width, n_distinct,
  most_common_vals AS mcv,
  left(most_common_freqs::text,50) || '...' AS mcf,
  correlation
FROM pg_stats_ext_exprs
WHERE statistics_name = 'flights_expr' \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
expr        | EXTRACT(month FROM (scheduled_departure AT TIME ZO...
null_frac   | 0
avg_width   | 8
n_distinct  | 12
mcv         | {8,9,12,3,1,5,6,7,11,10,4,2}
mcf         | {0.12053333,0.11326667,0.0802,0.07976667,0.0775666...
correlation | 0.08355749

17.9.2 表达式索引统计信息

另一种改善基数估算的方式是使用为表达式索引收集的特殊统计信息;创建此类索引时会自动收集这些统计信息,就像对表进行收集一样。如果确实需要索引,这种方法会非常方便。

=> DROP STATISTICS flights_expr;

=> CREATE INDEX ON flights(extract(
month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
));

=> ANALYZE flights;

=> EXPLAIN SELECT * FROM flights
WHERE extract(
  month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights (cost=324.86..3247.92 rows=17089 wi...
   Recheck Cond: (EXTRACT(month FROM (scheduled_departure AT TIME...
   −> Bitmap Index Scan on flights_extract_idx (cost=0.00..320.5...
       Index Cond: (EXTRACT(month FROM (scheduled_departure AT TI...
(4 rows)

表达式索引的统计信息与表上的统计信息以相同的方式存储。例如,当查询 pg_stats 时,你可以通过指定索引名称为 tablename 来获取非重复值的数量:

=> SELECT n_distinct FROM pg_stats
WHERE tablename = 'flights_extract_idx';
 n_distinct
−−−−−−−−−−−−
         12
(1 row)

你可以使用 ALTER INDEX 命令来调整与索引相关的统计信息的准确性v. 11。如果你不知道索引表达式对应的列名,则需要先找出它。例如:

=> SELECT attname FROM pg_attribute
WHERE attrelid = 'flights_extract_idx'::regclass;
 attname
−−−−−−−−−
 extract
(1 row)
=> ALTER INDEX flights_extract_idx
  ALTER COLUMN extract SET STATISTICS 42;

17.10 多元统计信息

你还可以收集涵盖多个列的多元统计信息。作为前置条件,你必须使用 CREATE STATISTICS 命令手动创建相应的扩展统计信息。

PostgreSQL 实现了三种类型的多元统计信息。

17.10.1 列之间的函数依赖v. 10

如果一列中的值 (完全或部分) 依赖于另一列中的值,并且过滤条件包括这两列,那么基数预估会偏低。

让我们考虑一个包含两个过滤条件的查询:

=> SELECT count(*) FROM flights
WHERE flight_no = 'PG0007' AND departure_airport = 'VKO';
 count
−−−−−−−
   396
(1 row)

估算值被严重低估:

=> EXPLAIN SELECT * FROM flights
WHERE flight_no = 'PG0007' AND departure_airport = 'VKO';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights (cost=10.49..816.84 rows=15 width=63)
   Recheck Cond: (flight_no = 'PG0007'::bpchar)
   Filter: (departure_airport = 'VKO'::bpchar)
   −> Bitmap Index Scan on flights_flight_no_scheduled_departure_key
       (cost=0.00..10.49 rows=276 width=0)
       Index Cond: (flight_no = 'PG0007'::bpchar)
(6 rows)

这是关联谓词的一个众所周知的问题。规划器会假设谓词之间互不依赖,因此整体选择率被估算为逻辑与连接的过滤条件的选择率之积。上面的计划清楚地说明了这个问题:一旦 Bitmap Heap Scan 节点按 departure_airport 列的条件过滤结果,那么 Bitmap Index Scan 在 flight_no 列上的条件的预估值就会大大减少。

然而,我们确实知道飞机是由航班号明确定义的:第二个条件实际上是多余的 (当然,除非机场名称有误)。在这种情况下,我们可以通过应用函数依赖的扩展统计信息来改善估算。

让我们在两个列之间的函数依赖上创建一个扩展统计信息:

=> CREATE STATISTICS flights_dep(dependencies)
ON flight_no, departure_airport FROM flights;

下一次分析将收集此统计信息,并且预估值得到了改善:

=> ANALYZE flights;
=> EXPLAIN SELECT * FROM flights
WHERE flight_no = 'PG0007'
  AND departure_airport = 'VKO';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights (cost=10.57..819.51 rows=277 width=63)
   Recheck Cond: (flight_no = 'PG0007'::bpchar)
   Filter: (departure_airport = 'VKO'::bpchar)
   −> Bitmap Index Scan on flights_flight_no_scheduled_departure_key
       (cost=0.00..10.50 rows=277 width=0)
       Index Cond: (flight_no = 'PG0007'::bpchar)
(6 rows)

收集的统计信息存储在系统目录中,可以像这样访问:

=> SELECT dependencies
FROM pg_stats_ext WHERE statistics_name = 'flights_dep';
               dependencies
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 {"2 => 5": 1.000000, "5 => 2": 0.010200}
(1 row)

此处的 2 和 5 是存储在 pg_attribute 表中的列编号,而相应的值定义了函数依赖的程度:从 0 (无依赖) 到 1 (第二列中的值完全依赖于第一列中的值)。

17.10.2 多元非重复值的数量v. 10

不同列中值的唯一组合的统计信息可以改善在多个列上执行的 GROUP BY 操作的基数估算。

例如,此处估算的可能的出发机场和到达机场的配对数量是机场总数的平方;然而,实际值要小得多,因为并非所有的机场对都通过直达航班连接:

=> SELECT count(*)
FROM (
  SELECT DISTINCT departure_airport, arrival_airport FROM flights
) t;
 count
−−−−−−−
   618
(1 row)
=> EXPLAIN SELECT DISTINCT departure_airport, arrival_airport
FROM flights;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 HashAggregate (cost=5847.01..5955.16 rows=10816 width=8)
   Group Key: departure_airport, arrival_airport
   −> Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=8)
(3 rows)

让我们定义并收集非重复值的扩展统计信息:

=> CREATE STATISTICS flights_nd(ndistinct)
ON departure_airport, arrival_airport FROM flights;
=> ANALYZE flights;

现在基数估算得到改善:

=> EXPLAIN SELECT DISTINCT departure_airport, arrival_airport
FROM flights;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 HashAggregate (cost=5847.01..5853.19 rows=618 width=8)
   Group Key: departure_airport, arrival_airport
   −> Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=8)
(3 rows)

你可以在系统目录中查看收集的统计信息:

=> SELECT n_distinct
FROM pg_stats_ext WHERE statistics_name = 'flights_nd';
  n_distinct
−−−−−−−−−−−−−−−
 {"5, 6": 618}
(1 row)

17.10.3 多元 MCV 列表v. 12

如果值的分布不均,仅依赖函数依赖可能是不够的,因为估算的准确性高度依赖于特定的一组值。例如,规划器低估了波音 737 从谢列梅捷沃机场出发的航班数量:

=> SELECT count(*) FROM flights
WHERE departure_airport = 'SVO' AND aircraft_code = '733';
 count
−−−−−−−
  2037
(1 row)
=> EXPLAIN SELECT * FROM flights
WHERE departure_airport = 'SVO' AND aircraft_code = '733';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..5847.00 rows=736 width=63)
   Filter: ((departure_airport = 'SVO'::bpchar) AND (aircraft_cod...
(2 rows)

在这种情况下,你可以通过收集多元 MCV 列表的统计信息来改善估算:23

=> CREATE STATISTICS flights_mcv(mcv)
ON departure_airport, aircraft_code FROM flights;
=> ANALYZE flights;

新的基数估算更加准确:

=> EXPLAIN SELECT * FROM flights
WHERE departure_airport = 'SVO' AND aircraft_code = '733';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..5847.00 rows=1927 width=63)
   Filter: ((departure_airport = 'SVO'::bpchar) AND (aircraft_cod...
(2 rows)

为了得到此估算值,规划器依赖于存储在系统目录中的频率值:

=> SELECT values, frequency
FROM pg_statistic_ext stx
  JOIN pg_statistic_ext_data stxd ON stx.oid = stxd.stxoid,
  pg_mcv_list_items(stxdmcv) m
WHERE stxname = 'flights_mcv'
AND values = '{SVO,773}';
  values   |      frequency
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−
 {SVO,773} | 0.005266666666666667
(1 row)

就像常规 MCV 列表一样,多元 MCV 列表包含 default_statistics_target100 个值 (如果在列级别也设置了该参数,则使用其最大值)。

如果需要,你也可以像对扩展表达式统计信息那样更改列表大小v. 13:

ALTER STATISTICS ... SET STATISTICS ...;

在所有这些示例中,我只使用了两列,但你同样可以收集更多列的多元统计信息。

要在一个对象中组合多种类型的统计信息,你可以在其定义中提供这些类型的逗号分隔列表。如果没有指定类型,那么 PostgresSQL 会收集指定列的所有可能类型的统计信息。

除了实际的列名,多元统计信息还可以使用任意表达式v. 14,就像表达式统计信息一样。


  1. postgresql.org/docs/14/planner-stats.html ↩︎

  2. backend/commands/analyze.c, do_analyze_rel function ↩︎

  3. backend/commands/cluster.c, copy_table_data function ↩︎

  4. backend/catalog/heap.c, index_update_stats function ↩︎

  5. backend/access/heap/vacuumlazy.c, heap_vacuum_rel function ↩︎

  6. backend/commands/analyze.c, std_typanalyze function ↩︎

  7. backend/commands/analyze.c, acquire_sample_rows function
    backend/utils/misc/sampling.c ↩︎

  8. backend/access/table/tableam.c, table_block_relation_estimate_size function ↩︎

  9. backend/access/table/tableam.c, table_block_relation_estimate_size function ↩︎

  10. sigmodrecord.org/publications/sigmodRecord/0809/p20.date.pdf ↩︎

  11. include/catalog/pg_statistic.h ↩︎

  12. backend/commands/analyze.c, compute_distinct_stats function ↩︎

  13. backend/utils/adt/selfuncs.c, var_eq_non_const function ↩︎

  14. backend/utils/adt/selfuncs.c, var_eq_const function ↩︎

  15. backend/utils/adt/selfuncs.c, scalarineqsel function ↩︎

  16. backend/utils/adt/selfuncs.c, ineq_histogram_selectivity function ↩︎

  17. postgresql.org/docs/14/arrays.html
    backend/utils/adt/array_typanalyze.c
    backend/utils/adt/array_selfuncs.c ↩︎

  18. postgresql.org/docs/14/datatype-textsearch.html
    backend/tsearch/ts_typanalyze.c
    backend/tsearch/ts_selfuncs.c ↩︎

  19. postgresql.org/docs/14/rangetypes.html
    backend/utils/adt/rangetypes_typanalyze.c
    backend/utils/adt/rangetypes_selfuncs.c ↩︎

  20. backend/utils/adt/multirangetypes_selfuncs.c ↩︎

  21. backend/utils/adt/selfuncs.c, eqsel function ↩︎

  22. postgresql.org/docs/14/planner-stats#PLANNER-STATS-EXTENDED.html
    backend/statistics/README ↩︎

  23. backend/statistics/README.mcv
    backend/statistics/mcv.c ↩︎

18 表访问方法

18.1 可插拔存储引擎

PostgreSQL 使用的数据布局既不是唯一可能的,也不是所有负载类型的最佳选择。遵循可扩展性的理念,PostgreSQL 允许创建和新增表访问方法v. 12 (可插拔存储引擎),但目前仅有一种开箱即用的引擎:

=> SELECT amname, amhandler FROM pg_am WHERE amtype = 't';
 amname | 		 amhandler
−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−
 heap 	| heap_tableam_handler
(1 row)

在建表时,你可以指定要使用的引擎 (CREATE TABLE … USING);否则,将使用 default_table_access_methodheap 参数中列出的默认引擎。

为了让 PostgreSQL 内核部分以相同的方式与不同的引擎协作,表访问方法必须实现一个特殊的接口。1 在 amhandler 列中指定的函数,其返回的接口结构 2 包含内核所需的所有信息。

以下核心组件可被所有表访问方法使用:

  • 事务管理器,包括 ACID 和快照隔离支持

  • 缓冲区管理

  • I/O 子系统

  • TOAST

  • 优化器和执行器

  • 索引支持

即使存储引擎并不使用这些组件中的所有部分,这些组件也始终可供引擎使用。

而引擎定义了:

  • 元组格式和数据结构

  • 表扫描的实现和成本预估

  • 插入、删除、更新和锁操作的实现

  • 可见性规则

  • 清理和分析过程

从历史上看,PostgreSQL 使用了一个单一的内置数据存储,而没有任何适当的编程接口,因此现在很难提出一个好的设计,既能考虑到标准引擎的所有特点,又不干扰其他方法。

比如,目前仍不清楚如何处理 WAL。新的访问方法可能需要记录自己的操作,而内核并不知道这些操作。现有的通用 WAL 机制 3 通常是一个糟糕的选择,因为它会产生过多的开销。你可以添加另一个接口来处理新类型的 WAL 条目,但是这样一来,崩溃恢复将依赖于外部代码,这是非常不可取的。到目前为止,唯一看似可行的解决方案是为每个特定引擎修补内核。

因此,我没有严格区分表访问方法和内核。本书前面部分描述的许多功能从形式上讲属于堆访问方法,而不属于内核本身。这种方法很可能始终是 PostgreSQL 的最终标准引擎,而其他方法将填补各自的空白,以应对特定负载类型的挑战。

在目前正在开发的所有新引擎中,我想提及以下几种:

Zheap 旨在处理表膨胀 4。它实现了原地更新,并将与 MVCC 相关的历史数据移动到一个单独的回滚段中。这种引擎对于涉及频繁数据更新的负载将非常有用。

Zheap 的架构对于 Oracle 用户来说会感到很熟悉,尽管它确实有一些细微差别 (例如,索引访问方法的接口不允许使用其自己的版本创建索引)。

Zedstore 实现了列式存储 5,这种存储方式可能对 OLAP 查询最为高效。

存储的数据其结构是一棵元组 ID 的 B 树;每一列都存储在与主树相关的自己的 B 树中。未来,可能会在一个 B 树中存储多个列,从而获得混合存储。

18.2 顺序扫描

存储引擎定义了表数据的物理布局,并提供访问方法。唯一支持的方法是顺序扫描,它完整地读取表主分支的文件 (或多个文件)。每次页面读取,都会检查每条元组的可见性;那些不满足查询的元组会被过滤掉。
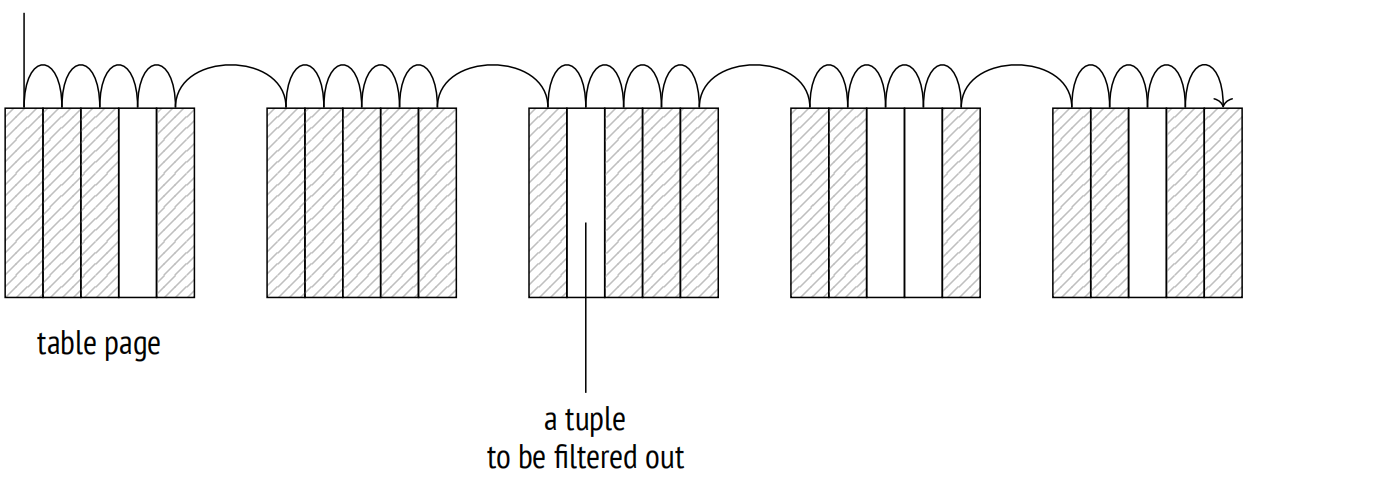
18.2 顺序扫描:插图 1
图 18.1

扫描进程会遍历缓冲区缓存;为了确保大表不会淘汰有用的数据,PostgreSQL 使用了一个小型的环形缓冲区。扫描同一张表的其他进程会加入到这个环形缓冲区,从而避免额外的磁盘读取;这种扫描被称为同步扫描。这样一来,扫描就不必总是从文件开头开始。

顺序扫描是读取整个表或其中大部分数据的最有效的方式。换句话说,当选择率较低时,顺序扫描带来的价值最大。(如果选择率高,意味着查询只需要选择几行,那么最好使用索引)。

18.2.1 成本估算

在查询的执行计划中,Seq Scan 节点表示顺序扫描:

=> EXPLAIN SELECT *
FROM flights;
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=63)
(1 row)

预估的行数是作为基本统计信息的一部分提供的:

=> SELECT reltuples FROM pg_class WHERE relname = 'flights';
 reltuples
−−−−−−−−−−−
    214867
(1 row)

在估算成本时,优化器会考虑以下两个组成部分:磁盘 IO 和 CPU 资源。6

I/O 成本的计算方法是将表中的页面数量乘以读取单个页面的成本 (假设页面是按顺序读取的)。当缓冲区管理器请求一个页面时,操作系统实际上从磁盘读取了更多的数据,所以后续的几个页面很可能在操作系统缓存中找到。因此,使用顺序扫描读取单个页面的成本 (规划器按 seq_page_cost1 预估) 低于随机访问的成本 (由 random_page_cost4 值定义)。

默认设置适用于 HDD;如果你使用的是 SSD,那么显著降低 random_page_cost 值是有意义的 (seq_page_cost 参数通常保持原样,作为参考值)。由于这些参数之间的最佳比例取决于硬件,因此通常在表空间级别设置 (ALTER TABLESPACE …SET)。

=> SELECT relpages,
  current_setting('seq_page_cost') AS seq_page_cost,
  relpages * current_setting('seq_page_cost')::real AS total
FROM pg_class WHERE relname = 'flights';
 relpages | seq_page_cost | total
−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−
     2624 | 1             |  2624
(1 row)

这些计算清楚地显示了不及时清理所导致的表膨胀的后果:表的主分支越大,需要扫描的页面就越多,无论包含多少活跃元组。

CPU 资源预估包括处理每个元组的成本 (规划器按 cpu_tuple_cost0.01 预估):

=> SELECT reltuples,
  current_setting('cpu_tuple_cost') AS cpu_tuple_cost,
  reltuples * current_setting('cpu_tuple_cost')::real AS total
FROM pg_class WHERE relname = 'flights';
 reltuples | cpu_tuple_cost |  total
−−−−−−−−−−−+−−−−−−−−−−−−−−−−+−−−−−−−−−
    214867 | 0.01           | 2148.67
(1 row)

这两个预估值的总和表示计划的总成本。启动成本为零,因为顺序扫描没有前置条件。

如果需要过滤扫描的表,应用的过滤条件会出现在 Seq Scan 节点的 Filter 部分。预估的行数取决于这些条件的选择率,而成本预估包括了相关的计算开销。

EXPLAIN ANALYZE 命令显示了实际返回的行数以及被过滤掉的行数:

=> EXPLAIN (analyze, timing off, summary off)
SELECT * FROM flights
WHERE status = 'Scheduled';
                   QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights
   (cost=0.00..5309.84 rows=15383 width=63)
   (actual rows=15383 loops=1)
   Filter: ((status)::text = 'Scheduled'::text)
   Rows Removed by Filter: 199484
(5 rows)

让我们看一个更加复杂的执行计划,使用到了聚合:

=> EXPLAIN SELECT count(*) FROM seats;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Aggregate (cost=24.74..24.75 rows=1 width=8)
   −> Seq Scan on seats (cost=0.00..21.39 rows=1339 width=0)
(2 rows)

该计划由两个节点组成:上层节点 (Aggregate) 用于计算函数 count,从下层节点 (Seq Scan) 拉取数据,后者负责扫描表。

Aggregate 节点的启动成本包括聚合本身:在从下层节点获取所有行之前,不可能返回第一行 (在这个例子中只有一行)。聚合成本是根据每个输入行的条件操作的执行成本 (按 cpu_operator_cost0.0025 估算) 来估算的:7

=> SELECT reltuples,
  current_setting('cpu_operator_cost') AS cpu_operator_cost,
  round((
    reltuples * current_setting('cpu_operator_cost')::real
  )::numeric, 2) AS cpu_cost
FROM pg_class WHERE relname = 'seats';
 reltuples | cpu_operator_cost | cpu_cost
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−
      1339 | 0.0025            |     3.35
(1 row)

计算出的估算值被添加到 Seq Scan 节点的总成本中。

Aggregate 节点的总成本还包括处理待返回行的成本,按 cpu_tuple_cost0.01 估算:

=> WITH t(cpu_cost) AS (
  SELECT round((
    reltuples * current_setting('cpu_operator_cost')::real
  )::numeric, 2)
  FROM pg_class WHERE relname = 'seats'
)
SELECT 21.39 + t.cpu_cost AS startup_cost,
  round((
    21.39 + t.cpu_cost +
    1 * current_setting('cpu_tuple_cost')::real
  )::numeric, 2) AS total_cost
FROM t;
 startup_cost | total_cost
−−−−−−−−−−−−−−+−−−−−−−−−−−−
        24.74 |      24.75
(1 row)

因此,成本估算的依赖关系如下图所示:

18.2.1 成本估算:插图 2
图 18.2

18.3 并行计划

PostgreSQL 支持并行查询v. 9.6。8 执行查询的领导者进程生成 (通过 postmaster) 多个工作进程,这些进程同时执行计划中相同的并行部分。结果会传递给领导者进程,领导者进程将它们汇总在 Gather 9 节点中。当不接收数据时,领导者进程也可以参与执行计划的并行部分。

如果需要,你可以通过关闭 parallel_leader_participationon 参数来禁止领导者进程参与并行计划的执行v .11。
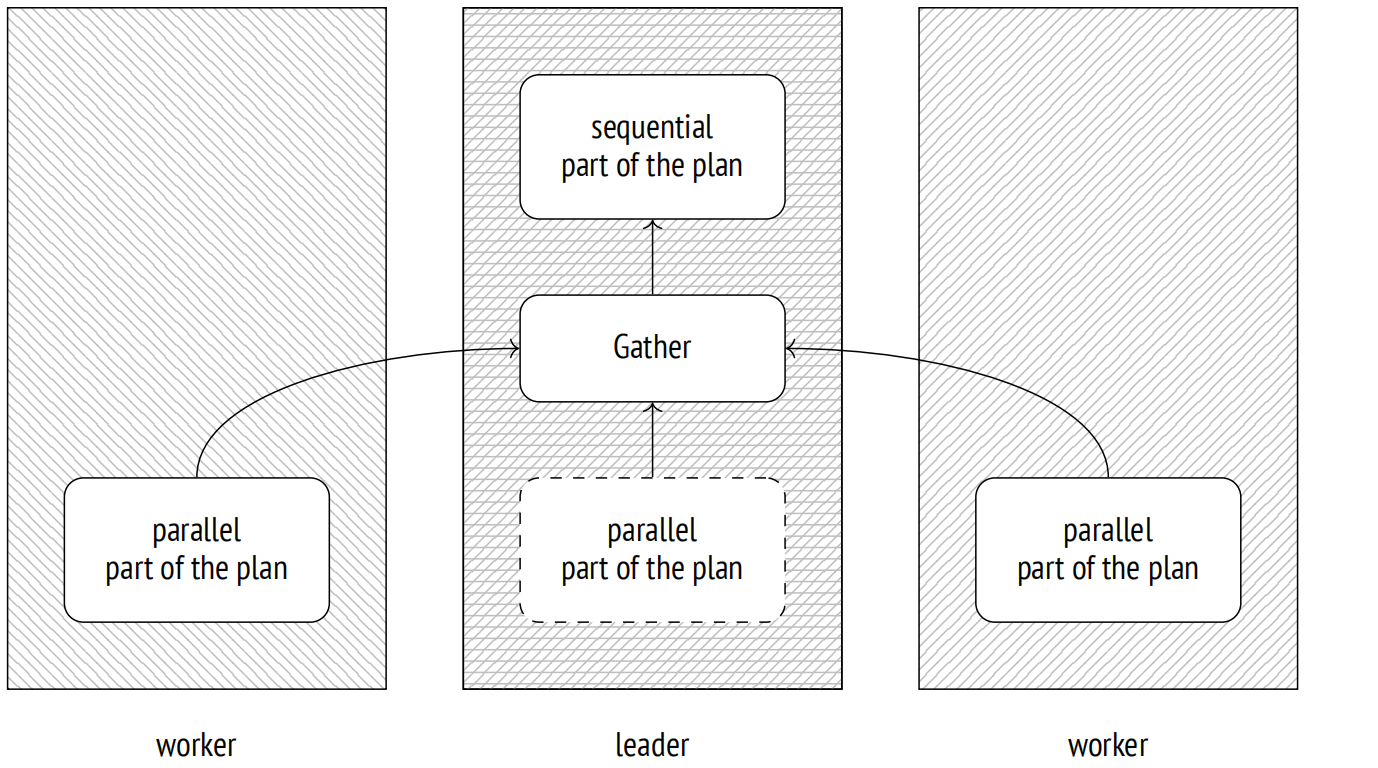
18.3 并行计划:插图 3
图 18.3

当然,启动这些进程并在它们之间传递数据并不是没有成本的,因此到目前为止并不是所有的查询都应该并行化。

此外,即使允许并行执行,也并非计划的所有部分都可以同时处理。一些操作由领导者进程单独以顺序模式执行。

PostgreSQL 不支持另一种并行计划执行方式,即由多个工作进程执行数据处理,这些工作进程实际上形成了一条流水线 (粗略地说,每个计划节点都由一个单独的进程执行) ; PostgreSQL 开发人员认为这种机制效率低下。

18.4 并行顺序扫描

为并行处理设计的节点之一是 Parallel Seq Scan 节点,负责执行并行顺序扫描。

这个名字听起来有点矛盾 (扫描究竟是顺序的还是并行的?),但无论如何,它反映了操作的本质。如果我们观察文件访问,会发现表页面是顺序读取的,遵循它们在简单顺序扫描中读取的顺序。然而,这个操作是由多个并发进程执行的。为了避免重复扫描同一个页面,执行器通过共享内存来同步这些进程。

此处有一个微妙的问题,操作系统无法获得典型的顺序扫描的全貌;相反,它看到的是多个执行随机读取的进程。因此,通常用于加速顺序扫描的数据预取几乎变得毫无用处。为了尽量减少这种不愉快的影响v. 14 ,PostgreSQL 为每个进程分配的不是一个页面,而是多个连续的页面进行读取。10

因此,并行扫描看起来并没有多大意义,因为通常的读取成本因进程间的数据传输开销而增加。然而,如果工作进程对获取的行进行了后续处理 (如聚合),那么总执行时间可能会大大缩短。

18.4.1 成本估算

让我们看一个对大表执行聚合的查询。执行计划使用了并行:
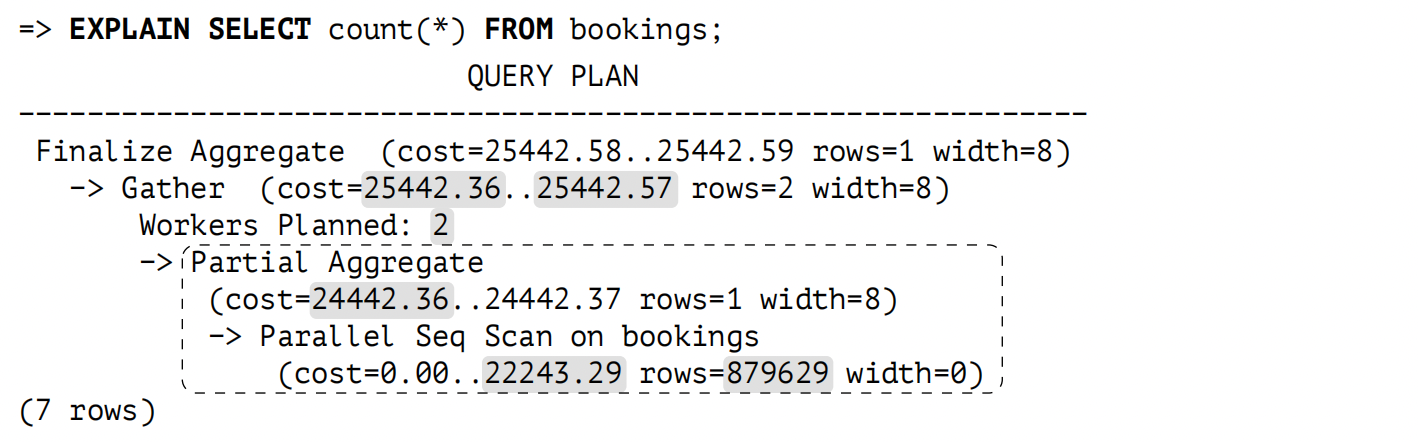
18.4.1 成本估算:插图 4
图 18.4

所有位于 Gather 节点下方的节点都属于计划的并行部分。这些节点由各个工作进程执行 (这里规划了两个工作进程) ,可能也由领导者进程执行 (除非通过 parallel_leader_participation 参数将此功能关闭)。Gather 节点自身以及所有它上方的节点构成了计划的顺序部分,并仅由领导者进程执行。

Parallel Seq Scan 节点表示并行堆扫描。rows 字段显示了单个进程要处理的预估平均行数。总而言之,执行必须由三个进程 (一个领导者进程和两个工作进程) 来完成,但是领导者进程将处理较少的行:随着工作进程数量的增加,其工作比重会变小。11 在这个特定的例子中,因子是 2.4。

=> SELECT reltuples::numeric, round(reltuples / 2.4) AS per_process
FROM pg_class WHERE relname = 'bookings';
 reltuples | per_process
−−−−−−−−−−−+−−−−−−−−−−−−−
   2111110 |      879629
(1 row)

Parallel Seq Scan 的成本计算方式类似于顺序扫描。计算出的值较小,因为每个进程处理的行数较少;I/O 部分是完整包含的,因为仍然需要逐页读取整个表。

=> SELECT round((
  relpages * current_setting('seq_page_cost')::real +
  reltuples / 2.4 * current_setting('cpu_tuple_cost')::real
)::numeric, 2)
FROM pg_class WHERE relname = 'bookings';
  round
−−−−−−−−−−
 22243.29
(1 row)

接下来 Partial Aggregate 节点对获取到的数据进行聚合;在此例中,它用于计算行数。

聚合成本按往常方式进行估算,并添加到表扫描的成本中:

=> WITH t(startup_cost)
AS (
  SELECT 22243.29 + round((
    reltuples / 2.4 * current_setting('cpu_operator_cost')::real
  )::numeric, 2)
  FROM pg_class
  WHERE relname = 'bookings'
)
SELECT startup_cost,
  startup_cost + round((
    1 * current_setting('cpu_tuple_cost')::real
  )::numeric, 2) AS total_cost
FROM t;
 startup_cost | total_cost
−−−−−−−−−−−−−−+−−−−−−−−−−−−
     24442.36 |   24442.37
(1 row)

下一个节点 (Gather) 由领导者进程执行。该节点负责启动工作进程并收集他们返回的数据。

在规划过程中,启动进程 (无论数量如何) 的成本估算由 parallel_setup_cost1000 参数定义,而进程之间每行数据传输的成本按 parallel_tuple_cost0.1 进行估算。

在这个例子中,启动成本 (用于启动进程) 占大头;这个值被添加到 Partial Aggregate 节点的启动成本中。总成本还包括传输两行的成本;这个值被添加到 Partial Aggregate 节点 12 的总成本中:

=> SELECT
  24442.36 + round(
    current_setting('parallel_setup_cost')::numeric,
  2) AS setup_cost,
  24442.37 + round(
    current_setting('parallel_setup_cost')::numeric +
    2 * current_setting('parallel_tuple_cost')::numeric,
    2) AS total_cost;
 setup_cost | total_cost
−−−−−−−−−−−−+−−−−−−−−−−−−
   25442.36 |   25442.57
(1 row)

最后要说的是,Finalize Aggregate 节点负责聚合 Gather 节点从并行进程接收到的所有部分结果。

最后的聚合估算与其他任何聚合一样。启动成本基于聚合三行数据的成本;这个值被添加到 Gather 的总成本中 (因为需要所有行来计算结果)。Finalize Aggregate 的总成本还包括返回一行的成本。

=> WITH t(startup_cost) AS (
  SELECT 25442.57 + round((
    3 * current_setting('cpu_operator_cost')::real
  )::numeric, 2)
  FROM pg_class WHERE relname = 'bookings'
)
SELECT startup_cost,
  startup_cost + round((
    1 * current_setting('cpu_tuple_cost')::real
  )::numeric, 2) AS total_cost
FROM t;
 startup_cost | total_cost
−−−−−−−−−−−−−−+−−−−−−−−−−−−
     25442.58 |   25442.59
(1 row)

成本估算之间的依赖关系取决于节点是否需要在将结果传递给其父节点之前积累数据。聚合操作在获取所有输入行之前无法返回结果,因此其启动成本基于下层节点的总成本。相反,Gather 节点一旦获取到行就开始向上层节点发送,因此,该操作的启动成本取决于下层节点的启动成本,而它的总成本则基于下层节点的总成本。

以下是依赖关系图:
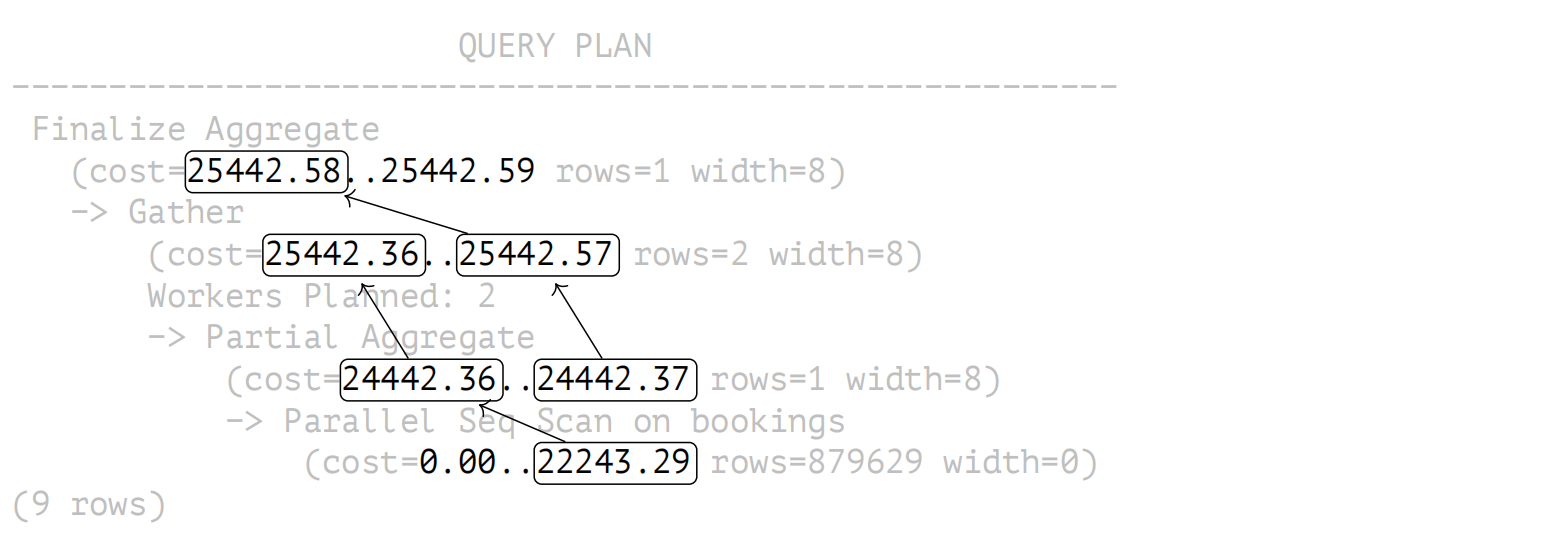
18.4.1 成本估算:插图 5
图 18.5

18.5 并行执行限制

18.5.1 后台工作进程数量

进程数量由三个参数层级控制。同时运行的后台工作进程的最大数量由 max_worker_processes8 定义。

然而,并行查询执行并不是唯一需要后台工作进程的操作。例如,后台工作进程也参与逻辑复制以及被扩展使用。专门为并行计划执行所分配的进程数量受到 max_parallel_workers8 的限制。

在此数字中,最多 max_parallel_workers_per_gather2 个进程可以服务于一个领导者进程。

这些参数的选择取决于以下因素:

  • 硬件能力:系统中必须有专门用于并行执行的空闲核心。

  • 表的大小:数据库必须含有大表。

  • 典型负载:必须有可能从并行执行中受益的查询。

这些标准通常适用于 OLAP 系统,而不是 OLTP 系统。

如果预估要读取的堆数据大小不超过 min_parallel_table_scan_size8MB 值,那么规划器将根本不会考虑并行执行。

除非特定表在 parallel_workers 存储参数中明确指定了进程数量,否则将按照以下公式计算:
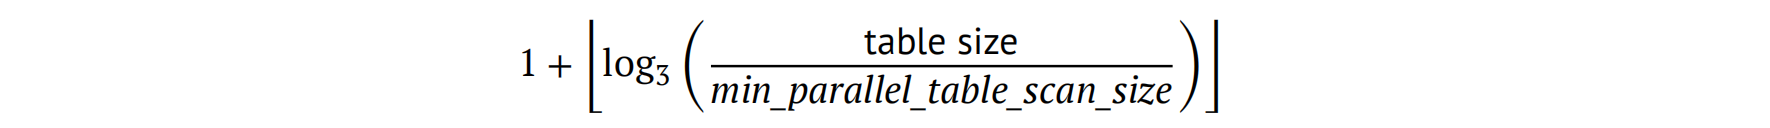
18.5.1 后台工作进程数量:插图 6
图 18.6

这意味着每当一个表增大三倍时,PostgreSQL 就会为它的处理分配一个额外的并行工作进程。默认设置可以得出以下数据:
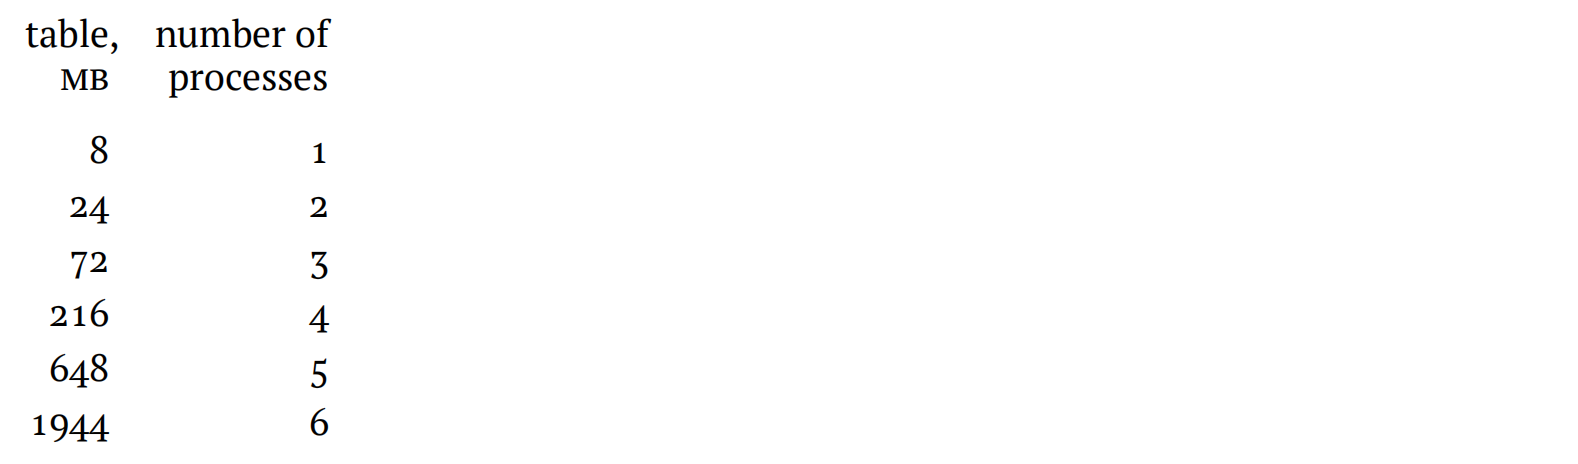
18.5.1 后台工作进程数量:插图 7
图 18.7

无论如何,并行工作进程的数量都不能超过 max_parallel_workers_per_gather 参数定义的限制。

如果我们查询一个 19MB 的小表 ,那么只会计划并启动一个工作进程:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT count(*) FROM flights;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (actual rows=1 loops=1)
   −> Gather (actual rows=2 loops=1)
      Workers Planned: 1
      Workers Launched: 1
      −> Partial Aggregate (actual rows=1 loops=2)
          −> Parallel Seq Scan on flights (actual rows=107434 lo...
(6 rows)			

对 105 MB 大小的表进行查询,只会获得两个工作进程,因为达到了 max_parallel_workers_per_gather2 工作进程数量的限制:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT count(*) FROM bookings;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (actual rows=1 loops=1)
   −> Gather (actual rows=3 loops=1)
      Workers Planned: 2
      Workers Launched: 2
      −> Partial Aggregate (actual rows=1 loops=3)
          −> Parallel Seq Scan on bookings (actual rows=703703 l...
(6 rows)

如果我们移除这个限制,那么我们将预估得到三个工作进程:

=> ALTER SYSTEM SET max_parallel_workers_per_gather = 4;
=> SELECT pg_reload_conf();
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT count(*) FROM bookings;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (actual rows=1 loops=1)
   −> Gather (actual rows=4 loops=1)
      Workers Planned: 3
      Workers Launched: 3
      −> Partial Aggregate (actual rows=1 loops=4)
          −> Parallel Seq Scan on bookings (actual rows=527778 l...
(6 rows)

如果在查询执行期间可用的槽数量小于规划的值,那么只会启动可用数量的工作进程。

让我们将并行进程的总数限制为五个,并同时运行两个查询:

=> ALTER SYSTEM SET max_parallel_workers = 5;
=> SELECT pg_reload_conf();
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT count(*) FROM bookings;
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT count(*) FROM bookings;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (actual rows=1 loops=1)
   −> Gather (actual rows=3 loops=1)
       Workers Planned: 3
       Workers Launched: 2
       −> Partial Aggregate (actual rows=1 loops=3)
           −> Parallel Seq Scan on bookings (actual rows=7037...
(6 rows)
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (actual rows=1 loops=1)
   −> Gather (actual rows=4 loops=1)
       Workers Planned: 3
       Workers Launched: 3
       −> Partial Aggregate (actual rows=1 loops=4)
       −> Parallel Seq Scan on bookings (actual rows=527778 l...
(6 rows)

尽管在这两种情况下都期望获得三个进程,但其中一个查询只获得了两个。

让我们恢复默认设置:

=> ALTER SYSTEM RESET ALL;
=> SELECT pg_reload_conf();

18.5.2 无法并行化的查询

并非所有查询都可以并行化。13 特别地,以下类型的查询无法使用并行计划:

  • 修改或锁定数据的查询 (UPDATE、DELETE、SELECT FOR UPDATE 等)。

    此限制不适用于以下命令中的子查询:

    — CREATE TABLE AS,SELECT INTO,CREATE MATERIALIZED VIEWv. 11

    — REFRESH MATERIALIZED VIEWv. 14

    但是,在所有这些情况下,行插入仍然是顺序执行的。

  • 可以暂停的查询。这适用于游标内运行的查询,包括 PL/pgSQL 中的 FOR 循环。

  • 调用 PARALLEL UNSAFE 函数的查询。默认情况下,这些都是用户定义的函数和一些标准函数。你可以通过查询系统表来获取完整 unsafe 函数的列表:SELECT * FROM pg_proc WHERE proparallel = ‘u’;

  • 函数内的查询,如果这些函数是从一个并行查询中调用的 (为了避免工作进程数量的递归增长)。

在 PostgreSQL 的未来版本中可能会移除其中一些限制。例如,已经存在在可串行化隔离级别下并行化查询v. 12的能力。

使用诸如 INSERT 和 COPY 等命令并行插入行的方式目前正在开发中。14

出于以下几个原因,查询可能仍然无法并行化:

  • 此类型的查询根本不支持并行。

  • 服务器配置禁止使用并行计划 (例如,由于施加的表大小限制)。

  • 并行计划比顺序计划的成本更高。

要检查查询是否可以并行化,你可以暂时打开 force_parallel_modeoff 参数。然后规划器将尽可能创建并行计划:

=> EXPLAIN SELECT * FROM flights;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=63)
(1 row)

=> SET force_parallel_mode = on;
=> EXPLAIN SELECT * FROM flights;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Gather (cost=1000.00..27259.37 rows=214867 width=63)
	 Workers Planned: 1
	 Single Copy: true
	 −> Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=63)
(4 rows)

18.5.3 并行限制的查询

计划中的并行部分越大,潜在的性能提升就越多。然而,某些操作仅由领导者进程严格顺序执行 15,即使它们本身并不干扰并行化。换句话说,这些操作不能出现在 Gather 节点下方的计划树中。

不可扩展的子查询。不可扩展子查询的一个最明显例子 16 是扫描一个 CTE 结果 (在计划中由 CTE Scan 节点表示):

=> EXPLAIN (costs off)
WITH t AS MATERIALIZED (
  SELECT * FROM flights
)
SELECT count(*) FROM t;
         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Aggregate
   CTE t
     −> Seq Scan on flights
   −> CTE Scan on t
(4 rows)

如果 CTE 没有被物化,那么计划中就不会包含 CTE Scan 节点,因此这个限制就不适用v. 12。

但是请注意,如果以并行模式计算 CTE 的成本更低,CTE 本身可以在并行模式下进行计算。

=> EXPLAIN (costs off)
WITH t AS MATERIALIZED (
  SELECT count(*) FROM flights
)
SELECT * FROM t;
                   QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 CTE Scan on t
   CTE t
     −> Finalize Aggregate
         −> Gather
             Workers Planned: 1
             −> Partial Aggregate
                 −> Parallel Seq Scan on flights
(7 rows)

另一个不可扩展子查询的示例如下图中的 SubPlan 节点所示:

18.5.3 并行限制的查询:插图 8
图 18.8

前两行表示主查询的计划:顺序扫描 flights 表,并根据提供的过滤条件检查每一行。过滤条件包含一个子查询;这个子查询的计划从第三行开始。因此,SubPlan 节点在这种情况下会被多次执行,每次顺序扫描获取一行数据时执行一次。

此计划上层的 Seq Scan 节点不能参与并行执行,因为它依赖于 SubPlan 节点返回的数据。

最后要提及的是,这里还有一个由 InitPlan 节点表示的不可扩展子查询:
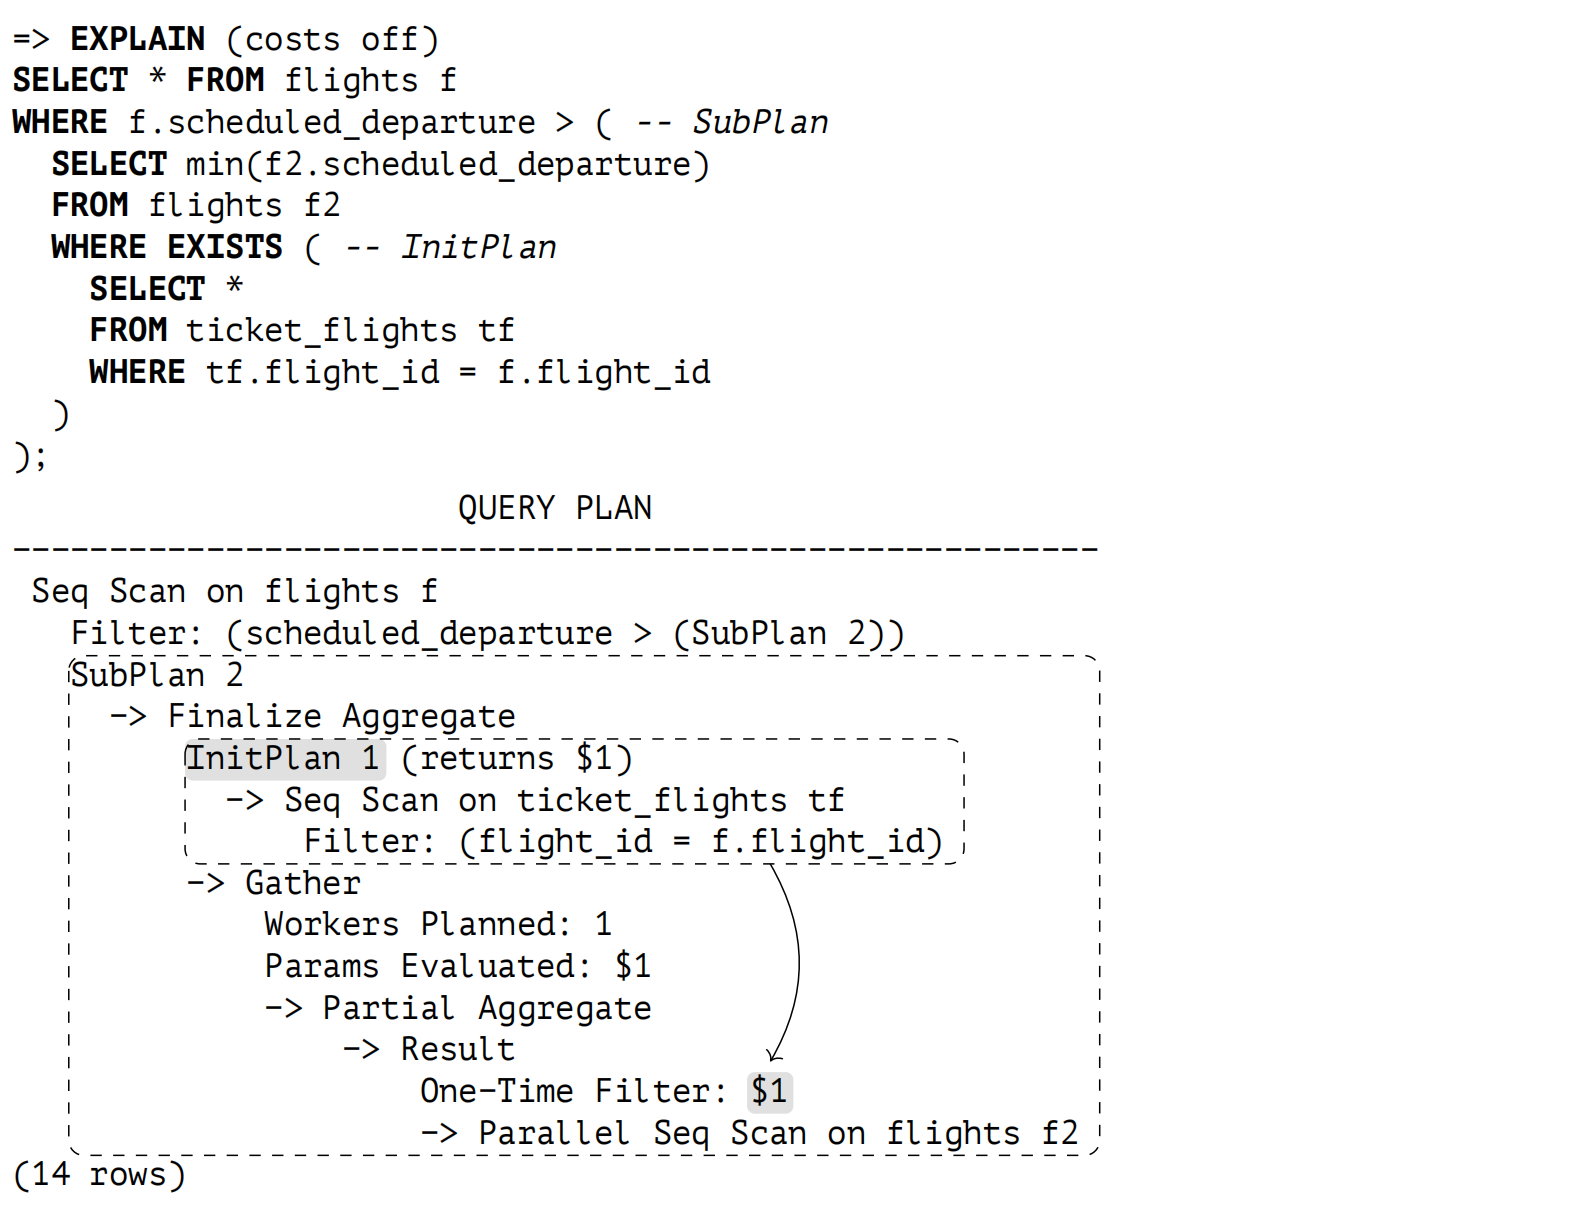
18.5.3 并行限制的查询:插图 9
图 18.9

不同于 SubPlan 节点,InitPlan 仅评估一次 (在此例中,每次执行 SubPlan 2 节点时评估一次)。

InitPlan 的父节点不能参与并行执行 (但是那些接收 InitPlan 评估结果的节点可以,就像在这个例子中一样)。

临时表。临时表不支持并行扫描,因为临时表只能由创建它们的进程独占式访问。临时表的页面在本地缓冲区缓存中处理。要使本地缓存能够被多个进程访问,将需要像在共享缓存中那样的锁定机制,这会使它的其他好处变得不那么明显。

=> CREATE TEMPORARY TABLE flights_tmp AS SELECT * FROM flights;
=> EXPLAIN (costs off)
SELECT count(*) FROM flights_tmp;
          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Aggregate
   −> Seq Scan on flights_tmp
(2 rows)

并行限制函数。定义为 PARALLEL RESTRICTED 的函数仅允许出现在计划的顺序部分中。你可以通过运行以下查询从系统表中获取此类函数的列表:

SELECT * FROM pg_proc WHERE proparallel = 'r';

只有在完全了解所有相关影响,并已经仔细研究了所有施加的限制后,才能将函数标记为 PARALLEL RESTRICTED (更不用说 PARALLEL SAFE)。17


  1. postgresql.org/docs/14/tableam.html ↩︎

  2. include/access/tableam.h ↩︎

  3. postgresql.org/docs/14/generic-wal.html ↩︎

  4. github.com/EnterpriseDB/zheap ↩︎

  5. github.com/greenplum-db/postgres/tree/zedstore ↩︎

  6. backend/optimizer/path/costsize.c, cost_seqscan function ↩︎

  7. backend/optimizer/path/costsize.c, cost_agg function ↩︎

  8. postgresql.org/docs/14/parallel-query.html
    backend/access/transam/README.parallel ↩︎

  9. backend/executor/nodeGather.c ↩︎

  10. backend/access/heap/heapam.c, table_block_parallelscan_startblock_init & table_block_parallelscan_nextpage functions ↩︎

  11. backend/optimizer/path/costsize.c, get_parallel_divisor function ↩︎

  12. backend/optimizer/path/costsize.c, cost_gather function ↩︎

  13. postgresql.org/docs/14/when-can-parallel-query-be-used.html ↩︎

  14. commitfest.postgresql.org/32/2844
    commitfest.postgresql.org/32/2841
    commitfest.postgresql.org/32/2610 ↩︎

  15. postgresql.org/docs/14/parallel-safety.html ↩︎

  16. backend/optimizer/plan/subselect.c ↩︎

  17. postgresql.org/docs/14/parallel-safety#PARALLEL-LABELING.html ↩︎

19 索引访问方法

19.1 索引和可扩展性

索引是一种数据库对象,主要用于加速数据访问。它们是辅助数据结构:任何索引都可以基于堆数据删除并重建。除了加速数据访问之外,索引还用于强制执行某些完整性约束。

PostgreSQL 内核提供了六种内置的索引访问方法 (索引类型):

=> SELECT amname FROM pg_am WHERE amtype = 'i';
 amname
−−−−−−−−
 btree
 hash
 gist
 gin
 spgist
 brin
(6 rows)

PostgresSQL 的可扩展性意味着可以在不修改内核的情况下添加新的访问方法v. 9.6。其中一个此类扩展 (bloom 方法) 被包含在标准模块集中。

尽管各种索引类型之间存在诸多差异,但最终都是将键 (例如索引列的值) 与包含该键的堆元组进行匹配。元组由 6 字节的元组 ID (TID) 引用。知道键或者关于键的一些信息,就可以快速读取可能包含所需数据的元组,而无需扫描整个表。

为了确保新的访问方法可以作为扩展被添加,PostgreSQL 实现了一个通用的索引引擎。其主要目标是检索和处理特定访问方法返回的 TID:

  • 从相应的堆元组中读取数据

  • 检查特定快照中元组的可见性

  • 如果访问方法的评估并不明确,则重新检查条件

索引引擎还参与在优化阶段所构建的计划的执行。在评估各种执行路径时,优化器需要知道所有可能适用的访问方法的属性:此方法能否按照要求的顺序返回数据,还是需要一个单独的排序阶段?是否可以立即返回前几个值,还是说必须等待整个结果集被获取?诸如此类。

不仅仅是优化器需要了解访问方法的特定信息。索引的创建也提出了更多需要解答的问题:访问方法是否支持多列索引?这个索引能否保证唯一性?

索引引擎允许使用多种访问方法;为了得以支持,访问方法必须实现一个特定的接口来声明其特性和属性。

访问方法用于解决以下问题:

  • 实现建立索引的算法,以及插入和删除索引条目

  • 在页面之间分配索引条目 (由缓冲区缓存管理器进一步处理)

  • 实现清理的算法

  • 获取锁以确保正确的并发操作

  • 生成 WAL 条目

  • 根据键查找索引数据

  • 评估索引扫描的成本

PostgreSQL 的可扩展性还体现在能够添加新数据类型的能力上,而访问方法事先对此一无所知。因此,访问方法必须定义它们自己的接口,以便插入任意数据类型。

为了特定的访问方法能够使用新的数据类型,需要实现相应的接口,即提供可与索引一起使用的操作符,可能还包括一些辅助支持函数。这样的一组操作符和函数被称为操作符类。

索引逻辑由访问方法自身实现了部分,但有些则交由操作符类。这种分配相当随意:虽然 B 树将所有逻辑内置于访问方法中,但其他一些方法可能只提供主框架,将所有实现细节留给特定的操作符类来决定。同一数据类型通常由若干个操作符类支持,用户可以选择行为最合适的一个。

以下是整体概况的一小部分:
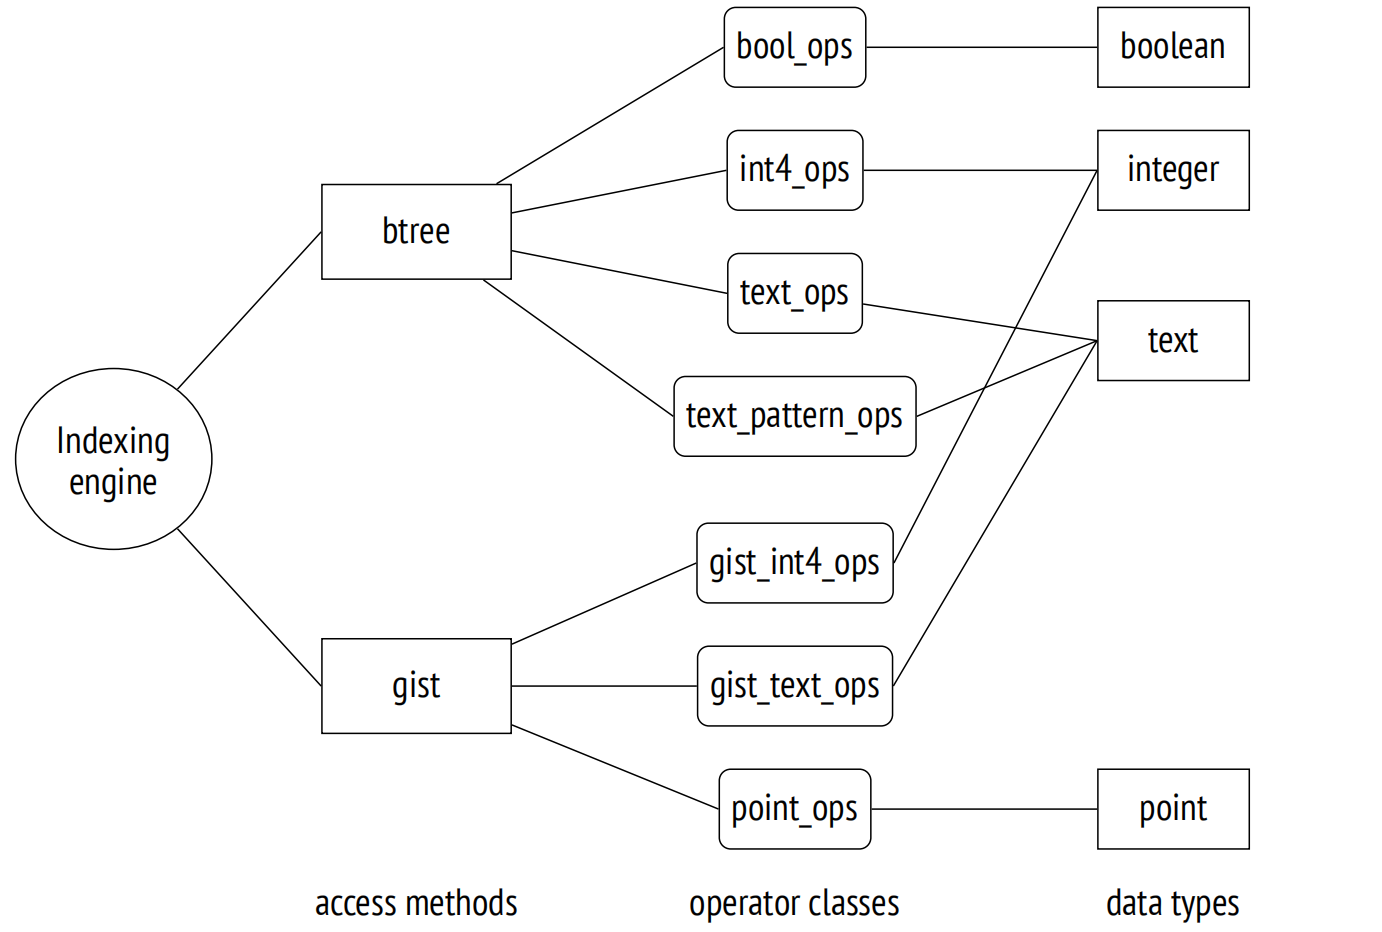
19.1 索引和可扩展性:插图 1
图 19.1

19.2 操作符类和操作符族

19.2.1 操作符类

访问方法接口 1 由操作符类实现,2 操作符类是访问方法应用于特定数据类型的一组操作符和支持函数。

操作符类存储在系统目录的 pg_opclass 表中。以下查询返回上述所说的完整数据:

=> SELECT amname, opcname, opcintype::regtype
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid;
 amname |           opcname            |          opcintype
−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 btree 	| array_ops                    | anyarray
 hash 	| array_ops                    | anyarray
 btree  | bit_ops                      | bit
 btree  | bool_ops                     | boolean
 ...
 brin 	| pg_lsn_minmax_multi_ops      | pg_lsn
 brin 	| pg_lsn_bloom_ops             | pg_lsn
 brin   | box_inclusion_ops            | box
(177 rows)

在大多数情况下,我们不必了解任何有关操作符类的信息。我们只需简单地创建一个默认使用某个操作符类的索引。

例如,此处是支持文本类型的 B 树操作符类。其中一个类总是被标记为默认类:

=> SELECT opcname, opcdefault
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'btree'
  AND opcintype = 'text'::regtype;
       opcname       | opcdefault
−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−
 text_ops            | t
 varchar_ops         | f
 text_pattern_ops    | f
 varchar_pattern_ops | f
(4 rows)

一个典型的索引创建命令如下所示:

CREATE INDEX ON aircrafts(model, range);

但这只是一种简写,它可以展开为以下语法:

CREATE INDEX ON aircrafts
USING btree -- the default access method
(
  model text_ops, -- the default operator class for text
  range int4_ops -- the default operator class for integer
);

如果你想使用不同类型的索引或实现某些自定义行为,那么你必须明确指定所需的访问方法或操作符类。

为特定访问方法和数据类型定义的每个操作符类必须包含一组处理此类型参数的操作符,并实现该访问方法的语义。

例如,btree 访问方法定义了五个强制性的比较操作符。任何 btree 操作符类都必须包含这五个操作符:

=> SELECT opcname, amopstrategy, amopopr::regoperator
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  WHERE amname = 'btree'
  AND opcname IN ('text_ops', 'text_pattern_ops')
  AND amoplefttype = 'text'::regtype
  AND amoprighttype = 'text'::regtype
  ORDER BY opcname, amopstrategy;
     opcname      | amopstrategy |     amopopr
−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−
 text_ops         |            1 | <(text,text)
 text_ops         |            2 | <=(text,text)
 text_ops         |            3 | =(text,text)
 text_ops         |            4 | >=(text,text)
 text_ops         |            5 | >(text,text)
 text_pattern_ops |            1 | ~<~(text,text)
 text_pattern_ops |            2 | ~<=~(text,text)
 text_pattern_ops |            3 | =(text,text)
 text_pattern_ops |            4 | ~>=~(text,text)
 text_pattern_ops |            5 | ~>~(text,text)
(10 rows)

访问方法所暗示的操作符的语义由显示为 amopstrategy 的策略编号反映。3 例如,对于 btree 来说,策略 1 表示小于,策略 2 表示小于或等于,依此类推。操作符本身可以有任意名称。

上面的示例显示了两种类型的操作符。普通操作符和带有波浪线的操作符之间的区别在于,后者不考虑排序规则 4 并执行字符串的逐位比较。尽管如此,两种风格的操作符都实现了相同的逻辑比较操作。

text_pattern_ops 操作符类旨在解决对 ‘~~’ 操作符 (对应于 LIKE 操作符) 的支持限制。在使用非 C 排序规则的数据库中,这个操作符不能使用文本字段上的常规索引。

=> SHOW lc_collate;
 lc_collate
−−−−−−−−−−−−−
 en_US.UTF−8
(1 row)
=> CREATE INDEX ON tickets(passenger_name);
=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE passenger_name LIKE 'ELENA%';
                  QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on tickets
   Filter: (passenger_name ~~ 'ELENA%'::text)
(2 rows)

使用 text_pattern_ops 操作符类的索引行为有所不同:

=> CREATE INDEX tickets_passenger_name_pattern_idx
ON tickets(passenger_name text_pattern_ops);
=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE passenger_name LIKE 'ELENA%';
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on tickets
   Filter: (passenger_name ~~ 'ELENA%'::text)
   −> Bitmap Index Scan on tickets_passenger_name_pattern_idx
       Index Cond: ((passenger_name ~>=~ 'ELENA'::text) AND
       (passenger_name ~<~ 'ELENB'::text))
(5 rows)

注意 Index Cond 中过滤表达式的变化。搜索现在仅使用 % 之前的模板前缀,而 false-positive 会在基于 Filter 条件的重新检查期间被过滤掉。btree 访问方法的操作符类没有提供用于比较模板的操作符,而使用 B 树的唯一方法是使用比较操作符重写此条件。text_pattern_ops 类的操作符不考虑排序规则,这让我们有机会使用等价条件代替。5

如果满足以下两个前置条件,则可以使用索引来加速过滤条件的访问:

  1. 条件写成 “indexed-column operator expression” (如果操作符有指定的可交换操作符 6,条件也可以写成 “expression operator indexed-column” 的形式)。7

  2. 操作符属于索引声明中为索引列指定的操作符类。

例如,以下查询便可以使用索引:

=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE 'ELENA BELOVA' = passenger_name;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_passenger_name_idx on tickets
   Index Cond: (passenger_name = 'ELENA BELOVA'::text)
(2 rows)

请注意 Index Cond 条件中参数的位置:在执行阶段,索引字段必须在左侧。当参数被置换时,操作符被一个可交换的操作符替换;在此例中,它是相同的操作符,因为等值关系是可交换的。

在接下来的查询中,由于条件中的列名被函数调用替换,因此技术上不可能使用常规索引:

=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE initcap(passenger_name) = 'Elena Belova';
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on tickets
   Filter: (initcap(passenger_name) = 'Elena Belova'::text)
(2 rows)						

此处你可以使用表达式索引 8,它在声明中指定了一个任意表达式,而不是列:

=> CREATE INDEX ON tickets( (initcap(passenger_name)) );
=> EXPLAIN (costs off)
SELECT * FROM tickets WHERE initcap(passenger_name) = 'Elena Belova';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on tickets
   Recheck Cond: (initcap(passenger_name) = 'Elena Belova'::text)
   −> Bitmap Index Scan on tickets_initcap_idx
       Index Cond: (initcap(passenger_name) = 'Elena Belova'::text)
(4 rows)

索引表达式只能依赖于堆元组值,不能受到数据库中存储的其他数据或配置参数 (如区域设置) 的影响。换句话说,如果表达式包含任何函数调用,这些函数必须是 IMMUTABLE 9,并且它们必须遵循这个稳定性分类。否则,针对同一查询,索引扫描和堆扫描可能会返回不同的结果。

除了常规操作符之外,操作符类可以提供访问方法所需的支持函数 10。例如,btree 访问方法定义了五个支持函数 11;第一个 (比较两个值) 函数是必需的,而所有其他函数都可以不存在:

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
  JOIN pg_amproc amproc ON amprocfamily = opcfamily
WHERE amname = 'btree'
  AND opcname = 'text_ops'
  AND amproclefttype = 'text'::regtype
  AND amprocrighttype = 'text'::regtype
ORDER BY amprocnum;
 amprocnum |       amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−
         1 | bttextcmp
         2 | bttextsortsupport
         4 | btvarstrequalimage
(3 rows)

19.2.2 操作符族

每个操作符类始终属于某个操作符族 12 (在 pg_opfamily 表中列出)。一个操作符族可以包含多个以相同方式处理相似数据类型的操作符类。

例如,integer_ops 族包括几个用于整数数据类型的类,这些类的语义相同,但大小有所不同:

=> SELECT opcname, opcintype::regtype
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
WHERE amname = 'btree'
  AND opfname = 'integer_ops';
 opcname  | opcintype
−−−−−−−−−−+−−−−−−−−−−−
 int2_ops | smallint
 int4_ops | integer
 int8_ops | bigint
(3 rows)

datetime_ops 族包含用于处理日期的操作符类:

=> SELECT opcname, opcintype::regtype
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
WHERE amname = 'btree'
  AND opfname = 'datetime_ops';
     opcname     |          opcintype
−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 date_ops        | date
 timestamptz_ops | timestamp with time zone
 timestamp_ops 	 | timestamp without time zone
(3 rows)	

虽然每个操作符类支持单一数据类型,但一个族可以包含用于不同数据类型的操作符类:

=> SELECT opcname, amopopr::regoperator
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_opclass opc ON opcfamily = opf.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
WHERE amname = 'btree'
  AND opfname = 'integer_ops'
  AND amoplefttype = 'integer'::regtype
  AND amopstrategy = 1
ORDER BY opcname;
 opcname  |       amopopr
−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−
 int2_ops | <(integer,bigint)
 int2_ops | <(integer,smallint)
 int2_ops | <(integer,integer)
 int4_ops | <(integer,bigint)
 int4_ops | <(integer,smallint)
 int4_ops | <(integer,integer)
 int8_ops | <(integer,bigint)
 int8_ops | <(integer,smallint)
 int8_ops | <(integer,integer)
(9 rows)

由于将各种操作符分组至一个单独的操作符族中,规划器在使用索引处理涉及不同类型的值的条件时,可以不需要进行类型转换。

19.3 索引引擎接口

如同表访问方法一样v. 9.6 ,pg_am 表的 amhandler 列包含实现了接口的函数名称:13

=> SELECT amname, amhandler FROM pg_am WHERE amtype = 'i';
 amname |  amhandler
−−−−−−−−+−−−−−−−−−−−−−
 btree  | bthandler
 hash 	| hashhandler
 gist 	| gisthandler
 gin    | ginhandler
 spgist | spghandler
 brin 	| brinhandler
(6 rows)

此函数用真实值填充接口结构 14 中的占位符。其中一些是负责与索引访问相关的独立任务的函数 (例如,它们可以执行索引扫描并返回堆元组 ID),而其他一些是索引引擎必须知晓的索引方法的属性。

所有属性分为三类:15

  • 访问方法属性

  • 特定索引的属性

  • 索引的列级属性

访问方法和索引级属性之间的区别是为了将来考虑:目前,基于特定访问方法的所有索引在这两个层次上始终具有相同的属性。

19.3.1 访问方法属性

以下五个属性在访问方法层面定义v. 11 (此处以 B 树方法为例):

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'btree';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 btree  | can_order     | t
 btree  | can_unique    | t
 btree  | can_multi_col | t
 btree  | can_exclude 	| t
 btree  | can_include 	| t
(5 rows)

CAN ORDER:接收排序数据的能力 16。这个属性目前只有 B 树支持。

要按要求的顺序获取结果,始终可以先扫描表,然后对获取的数据进行排序:

=> EXPLAIN (costs off)
SELECT * FROM seats ORDER BY seat_no;
       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−
 Sort
   Sort Key: seat_no
   −> Seq Scan on seats
(3 rows)

但是如果有支持该属性的索引,那么数据可以立即按照所需顺序返回:

=> EXPLAIN (costs off)
SELECT * FROM seats ORDER BY aircraft_code;
              QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using seats_pkey on seats
(1 row)

CAN UNIQUE:支持唯一约束和主键约束 17。此属性仅适用于 B 树。

每次声明唯一约束或主键约束时,PostgreSQL 会自动创建一个唯一索引用于支持这个约束。

=> INSERT INTO bookings(book_ref, book_date, total_amount)
VALUES ('000004', now(), 100.00);
ERROR: duplicate key value violates unique constraint
"bookings_pkey"
DETAIL: Key (book_ref)=(000004) already exists.

也就是说,如果你只是简单地创建了一个唯一索引而没有明确声明一个完整性约束,效果似乎是完全一样的:索引列将不允许重复。那么区别是什么呢?

完整性约束定义了一个绝不能违反的属性,而索引只是保证这一属性的一种机制。理论上,约束也可以通过其他手段施加。

例如,PostgreSQL 不支持分区表全局索引,但你仍然可以在这样的表上创建唯一约束 (如果它包含分区键)。在这种情况下,全局唯一性由每个分区的本地唯一索引来确保,因为不同分区不能有相同的分区键。

CAN MULTI COL:创建多列索引的能力。18

多列索引可以加速对不同列施加的多个条件的搜索。例如,ticket_flights 表有一个复合主键,所以相应的索引是建立在多个列上的:

=> \d ticket_flights_pkey
     Index "bookings.ticket_flights_pkey"
  Column   |     Type      | Key? | Definition
−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−+−−−−−−−−−−−−
 ticket_no | character(13) | yes  | ticket_no
 flight_id | integer       | yes  | flight_id
primary key, btree, for table "bookings.ticket_flights"

根据票号和航班 ID 搜索航班使用的是索引扫描:

=> EXPLAIN (costs off)
SELECT * FROM ticket_flights
WHERE ticket_no = '0005432001355'
  AND flight_id = 51618;
                        QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using ticket_flights_pkey on ticket_flights
   Index Cond: ((ticket_no = '0005432001355'::bpchar) AND
   (flight_id = 51618))
(3 rows)

通常情况下,即使过滤条件只涉及其某些列,多列索引也可以加速搜索。对于 B 树,如果过滤条件涵盖了索引声明中最先出现的相关列,搜索将会很高效:

=> EXPLAIN (costs off)
SELECT *
FROM ticket_flights
WHERE ticket_no = '0005432001355';
                        QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using ticket_flights_pkey on ticket_flights
   Index Cond: (ticket_no = '0005432001355'::bpchar)
(2 rows)

在所有其他情况下 (例如,如果条件仅包含 flights_id),搜索实际上将仅限于初始列 (如果查询包含相应的条件),而其他条件仅用于过滤返回的结果。其他类型的索引可能会有不同的行为。

CAN EXCLUDE:支持排它约束。19

排它约束保证表中任何两行都不会满足由操作符定义的条件。为了施加这个约束,PostgreSQL 会自动创建一个索引;必须有一个操作符类,其中包含约束条件中使用的操作符。

通常用于此目的的是交集操作符 &&。例如,你可以使用它来明确声明会议室不能在同一时间被预订两次,或者地图上的建筑物不能重叠。

有了相等运算符,排它约束就具有了唯一性的含义:禁止表中有两行具有相同的键值。尽管如此,它与唯一约束不同:特别是,排它约束的键无法被外键引用,也不能在 ON CONFLICT 子句中使用。

CAN INCLUDE:向索引中添加非键列的能力v. 11,使得这个索引成为覆盖索引。

使用这个属性,你可以用额外的列扩展唯一索引。这样的索引仍然可以保证所有键列的值都是唯一的,同时从包含的列中检索数据可以不需要访问堆:

=> CREATE UNIQUE INDEX ON flights(flight_id) INCLUDE (status);
=> EXPLAIN (costs off)
SELECT status FROM flights
WHERE flight_id = 51618;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using flights_flight_id_status_idx on flights
	 Index Cond: (flight_id = 51618)
(2 rows)

19.3.2 索引级属性

以下是与索引相关的属性 (显示现有索引):

=> SELECT p.name, pg_index_has_property('seats_pkey', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
 clusterable   | t
 index_scan    | t
 bitmap_scan   | t
 backward_scan | t
(4 rows)

CLUSTERABLE:根据索引扫描返回的 ID 顺序物理移动堆元组的能力。此属性显示是否支持 CLUSTER 命令。

INDEX SCAN:支持索引扫描。这个属性意味着访问方法可以逐个返回 TIDs。尽管看起来奇怪,但有些索引不提供这个功能。

BITMAP SCAN:支持位图扫描。这个属性定义了访问方法是否可以一次性创建并返回所有 TIDs 的位图。

BACKWARD SCAN:与索引创建时指定的顺序相比,能够以相反的顺序返回结果。只有当访问方法支持索引扫描时,这个属性才有意义。

19.3.3 列级属性

最后,让我们看一下列属性:

=> SELECT p.name,
  pg_index_column_has_property('seats_pkey', 1, p.name)
FROM unnest(array[
  'asc', 'desc', 'nulls_first', 'nulls_last', 'orderable',
  'distance_orderable', 'returnable', 'search_array', 'search_nulls'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 asc                | t
 desc               | f
 nulls_first        | f
 nulls_last         | t
 orderable          | t
 distance_orderable | f
 returnable         | t
 search_array       | t
 search_nulls       | t
(9 rows)

ASC,DESC,NULLS FIRST,NULLS LAST:用于排序列值。

这些属性定义了列值应按升序还是降序存储,以及空值是应该出现在常规值之前还是之后。所有这些属性仅适用于 B 树。

ORDERABLE:使用 ORDER BY 子句对列值进行排序的能力。此属性仅适用于 B 树。

DISTANCE ORDERABLE:支持排序操作符。20

与返回逻辑值的常规索引操作符不同,排序操作符返回了一个实数,表示从一个参数到另一个参数的"距离"。索引支持查询的 ORDER BY 子句中指定的此类操作符。

例如,排序操作符 <-> 可以找到距指定点最近的机场:

=> CREATE INDEX ON airports_data USING gist(coordinates);
=> EXPLAIN (costs off)
SELECT * FROM airports
ORDER BY coordinates <-> point (43.578,57.593)
LIMIT 3;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Limit
   −> Index Scan using airports_data_coordinates_idx on airpo...
       Order By: (coordinates <−> '(43.578,57.593)'::point)
(3 rows)

RETURNABLE:无需访问表即可返回数据的能力 (支持仅索引扫描)。

这个属性定义了索引结构是否允许检索索引值。这并不总是可能的:例如,某些索引可能存储哈希码而不是实际的值。在这种情况下,CAN INCLUDE 属性也将不可用。

SEARCH ARRAY:支持在数组中搜索多个元素。

数组的显式使用并不是唯一可能需要的情况。例如,规划器将 IN (list) 表达式转换为数组扫描:

=> EXPLAIN (costs off)
SELECT * FROM bookings
WHERE book_ref IN ('C7C821', 'A5D060', 'DDE1BB');
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_pkey on bookings
   Index Cond: (book_ref = ANY
   ('{C7C821,A5D060,DDE1BB}'::bpchar[]))
(3 rows)

如果索引方法不支持此类操作符,执行器可能不得不进行多次迭代来查找特定值 (这可能会降低索引扫描的效率)。

SEARCH NULLS :搜索 IS NULL 和 IS NOT NULL 条件。

我们应该索引空值吗?一方面,这允许我们对 IS [NOT] NULL 等条件进行索引扫描,以及在没有提供过滤条件的情况下将索引用作覆盖索引 (在这种情况下,索引必须返回所有堆元组数据,包括那些包含空值的堆元组)。但另一方面,跳过空值可以减小索引的大小。

这个决定留给访问方法开发者自行决定,但通常空值确实会被索引。

如果不需要在索引中包含空值,你可以通过创建只覆盖所需行的部分索引 21 来排除它们。例如:

=> CREATE INDEX ON flights(actual_arrival)
WHERE actual_arrival IS NOT NULL;
=> EXPLAIN (costs off)
SELECT * FROM flights
WHERE actual_arrival = '2017-06-13 10:33:00+03';
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using flights_actual_arrival_idx on flights
   Index Cond: (actual_arrival = '2017−06−13 10:33:00+03'::ti...
(2 rows)

部分索引比完整索引小,并且仅当被索引的行发生变化时才会更新,这有时可以带来明显的性能提升。显然,除了空值检查之外,WHERE 子句可以提供任何条件 (可以与 IMMUTABLE 函数一起使用)。

建立部分索引的能力由索引引擎提供,因此不依赖于访问方法。

接口只包括索引方法的那些必须提前知道以做出正确决策的属性。例如,它没有列出任何支持谓词锁或非阻塞索引创建 (CONCURRENTLY) 等特性的属性。这些属性在实现接口的函数代码中定义。

20 索引扫描

20.1 常规索引扫描

索引提供了两种基本的访问 TIDS 的方式。第一种是执行索引扫描。大多数索引访问方法 (但不是全部) 都具有 INDEX SCAN 属性以支持这种操作。

索引扫描在计划中由 Index Scan 1 节点表示:

=> EXPLAIN SELECT * FROM bookings
WHERE book_ref = '9AC0C6' AND total_amount = 48500.00;
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_pkey on bookings
   (cost=0.43..8.45 rows=1 width=21)
   Index Cond: (book_ref = '9AC0C6'::bpchar)
   Filter: (total_amount = 48500.00)
(4 rows)

索引扫描期间,访问方法逐个返回 TIDS 2。接收到 TID 之后,索引引擎访问此 TID 引用的堆页面,获取相应的元组,如果满足可见性规则,则返回所请求的该元组相关字段。这个过程会持续进行,直到访问方法没有更多匹配查询的 TIDS 为止。

Index Cond 行仅包括可以使用索引检查的过滤条件。其他需要根据堆重新检查的条件将在 Filter 行中单独列出。

如本例所示,索引和堆访问操作均由一个共同的 Index Scan 节点处理,而不是由两个不同的节点处理。但是,还有一个单独的 Tid Scan 节点 3,如果提前知道元组 ID,便可从堆中获取元组:

=> EXPLAIN SELECT * FROM bookings WHERE ctid = '(0,1)'::tid;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Tid Scan on bookings (cost=0.00..4.01 rows=1 width=21)
   TID Cond: (ctid = '(0,1)'::tid)
(2 rows)

20.1.1 成本估算

索引扫描的成本估算包括索引访问操作和堆页面读取的预估成本。

显然,索引相关的估算部分完全取决于特定的访问方法。对于 B 树,成本主要由获取索引页和处理其条目所产生。要读取的页数和行数可以通过数据总量和应用的过滤条件的选择率来确定。索引页是随机访问的 (在逻辑结构上相邻的页面在磁盘上是物理分散的) 。从根节点到叶节点并计算所有需要的表达式所花费的 CPU 资源进一步增加了预估成本。4

堆相关部分的估算包括堆页面访问的成本和处理所有获取的元组所需的 CPU 时间。需要注意的是,I/O 估算取决于索引扫描的选择率以及磁盘上元组的物理顺序与访问方法返回其 ID 的顺序之间的相关性。

20.1.2 良好场景:高相关性

如果元组在磁盘上的物理顺序与索引中 TIDS 的逻辑顺序完美相关,那么每个页面只会被访问一次:Index Scan 节点将顺序地从一个页面跳到另一个页面,逐个读取元组。
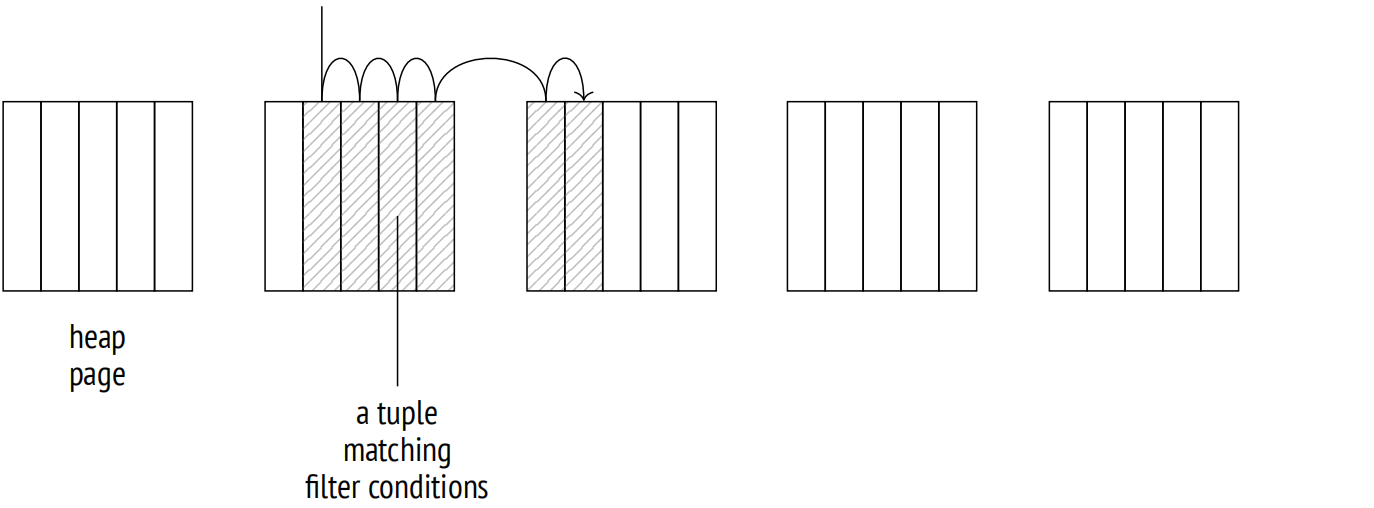
20.1.2 良好场景:高相关性:插图 1
图 20.1

PostgreSQL 会收集相关性的统计信息:

=> SELECT attname, correlation
FROM pg_stats WHERE tablename = 'bookings'
ORDER BY abs(correlation) DESC;
   attname    | correlation
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 book_ref     |            1
 total_amount | 0.0026738467
 book_date    |  8.02188e−05
(3 rows)

如果相应的绝对值接近于 1,那么相关性很高 (如 book_ref 的情况);接近于零的值表示数据分布是混乱的。

在这个特定例子中,book_ref 列的高相关性当然是因为数据是基于该列升序加载到表中的,并且还没有更新。如果我们对这一列上创建的索引执行 CLUSTER 命令,我们也会看到相同的结果。

但是,完美的相关性并不能保证所有的查询都将按照 book_ref 值的升序返回结果。首先,任何更新都会将生成的元组移动到表的末尾。其次,依赖于其他列的索引扫描的计划将以不同的顺序返回结果。即使是顺序扫描也可能不从表的开头开始。因此,如果你需要特定的顺序,你应该在 ORDER BY 子句中明确定义它。

此处是一个处理大量行的索引扫描示例:

=> EXPLAIN SELECT * FROM bookings WHERE book_ref < '100000';
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_pkey on bookings
   (cost=0.43..4638.91 rows=132999 width=21)
   Index Cond: (book_ref < '100000'::bpchar)
(3 rows)

条件的选择率估算结果如下:

=> SELECT round(132999::numeric/reltuples::numeric, 4)
FROM pg_class WHERE relname = 'bookings';
 round
−−−−−−−−
 0.0630
(1 row)

这个值接近 1/16,我们可以根据 book_ref 值的范围是从 000000 到 FFFFFF 猜到。

对于 B 树,I/O 成本估算中与索引相关的部分包括读取所有所需页面的成本。任何满足 B 树支持条件的索引条目均存储在有序列表的页面中,因此要读取的索引页面数量按索引大小乘以选择率进行估算。但由于这些页面物理上并不有序,因此以随机模式读取页面。

CPU 资源用于处理所有读取的索引条目 (处理单个条目的成本按 cpu_index_tuple_cost0.005 估算) 和计算每个条目的条件 (在本例中,条件包含单个运算符;其成本按 cpu_operator_cost0.0025 估算)。

表访问视为顺序读取所需的页面。在完美相关性的情况下,堆元组在磁盘上连续存储,因此页面数量按表的大小乘以选择率进行估算。

元组处理产生的开销会进一步增大 I/O 成本;按每条元组花费 cpu_tuple_cost0.01 进行估算。

=> WITH costs(idx_cost, tbl_cost) AS (
  SELECT
    (
      SELECT round(
        current_setting('random_page_cost')::real * pages +
        current_setting('cpu_index_tuple_cost')::real * tuples +
        current_setting('cpu_operator_cost')::real * tuples
      )
      FROM (
        SELECT relpages * 0.0630 AS pages, reltuples * 0.0630 AS tuples
        FROM pg_class WHERE relname = 'bookings_pkey'
      ) c
    ),
    (		
      SELECT round(
        current_setting('seq_page_cost')::real * pages +
        current_setting('cpu_tuple_cost')::real * tuples
      )
      FROM (
        SELECT relpages * 0.0630 AS pages, reltuples * 0.0630 AS tuples
        FROM pg_class WHERE relname = 'bookings'
      ) c
    )
)
SELECT idx_cost, tbl_cost, idx_cost + tbl_cost AS total
FROM costs;
 idx_cost | tbl_cost | total
−−−−−−−−−−+−−−−−−−−−−+−−−−−−−
 2457     |     2177 |  4634
(1 row)

这些计算说明了成本估算背后的逻辑,因此结果与规划器提供的估算一致,即使是近似值。获得准确值将需要考虑其他细节,这些我们在这里不讨论。

20.1.3 不良场景:低相关性

如果相关性低,一切都变了。让我们在 book_date 列上创建一个索引,该列与这个索引的相关性几乎为零,然后观察一下获取与前一个示例中几乎相同比例行的查询。索引访问的成本太高,以至于规划器只有在其他所有可替代的方案都被明确禁止的情况下才会选择索引扫描:

=> CREATE INDEX ON bookings(book_date);
=> SET enable_seqscan = off;
=> SET enable_bitmapscan = off;
=> EXPLAIN SELECT * FROM bookings
WHERE book_date < '2016-08-23 12:00:00+03';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_book_date_idx on bookings
   (cost=0.43..56957.48 rows=132403 width=21)
   Index Cond: (book_date < '2016−08−23 12:00:00+03'::timestamp w...
(3 rows)

问题在于,低相关性增加了访问方法返回的下一个元组位于不同页面的可能性。因此,Index Scan 节点必须在页面之间跳转,而不是顺序读取它们;在最坏的情况下,访问的页面数量会达到获取的元组数量。
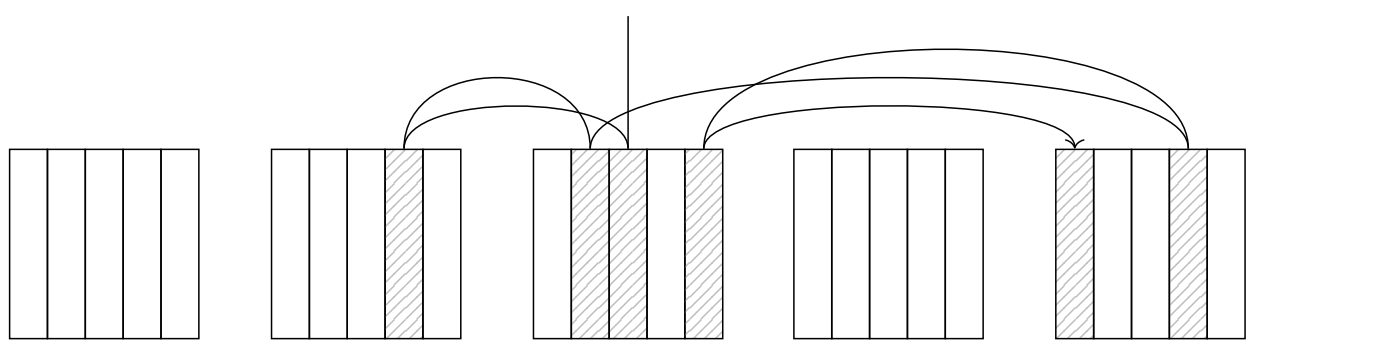
20.1.3 不良场景:低相关性:插图 2
图 20.2

然而,我们不能简单地将良好场景的计算中的 seq_page_cost 替换为 random_page_cost,relpages 替换为 reltuples。我们在计划中看到的成本远低于我们按这种方式估算的值:

=> WITH costs(idx_cost, tbl_cost) AS (
  SELECT
    ( SELECT round(
        current_setting('random_page_cost')::real * pages +
        current_setting('cpu_index_tuple_cost')::real * tuples +
        current_setting('cpu_operator_cost')::real * tuples
      )
      FROM (
        SELECT relpages * 0.0630 AS pages, reltuples * 0.0630 AS tuples
        FROM pg_class WHERE relname = 'bookings_pkey'
      ) c
    ),
    ( SELECT round(
        current_setting('random_page_cost')::real * tuples +
        current_setting('cpu_tuple_cost')::real * tuples
      )
      FROM (
        SELECT relpages * 0.0630 AS pages, reltuples * 0.0630 AS tuples
        FROM pg_class WHERE relname = 'bookings'
      ) c
    )
)
SELECT idx_cost, tbl_cost, idx_cost + tbl_cost AS total FROM costs;
 idx_cost | tbl_cost | total
−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−
     2457 |   533330 | 535787
(1 row)

原因是代价模型考虑了缓存。频繁使用的页面保存在缓冲区缓存 (和操作系统缓存) 中,因此缓存大小越大,在其中找到所需页面的机会就越大,从而避免了额外的磁盘访问操作。出于规划目的,缓存大小由 effective_cache_size4GB 参数定义。值越小,预估读取的页面就越多。

下图展示了要读取的页面数量预估值与表大小之间的依赖关系 (对于选择率为 1/2 且页面包含 10 行的情况) 5。虚线显示了最佳情况下的访问计数 (如果相关性完美,则为页面计数的一半) 和最坏情况下的访问计数 (如果相关性为零且没有缓存,则为行计数的一半) 。
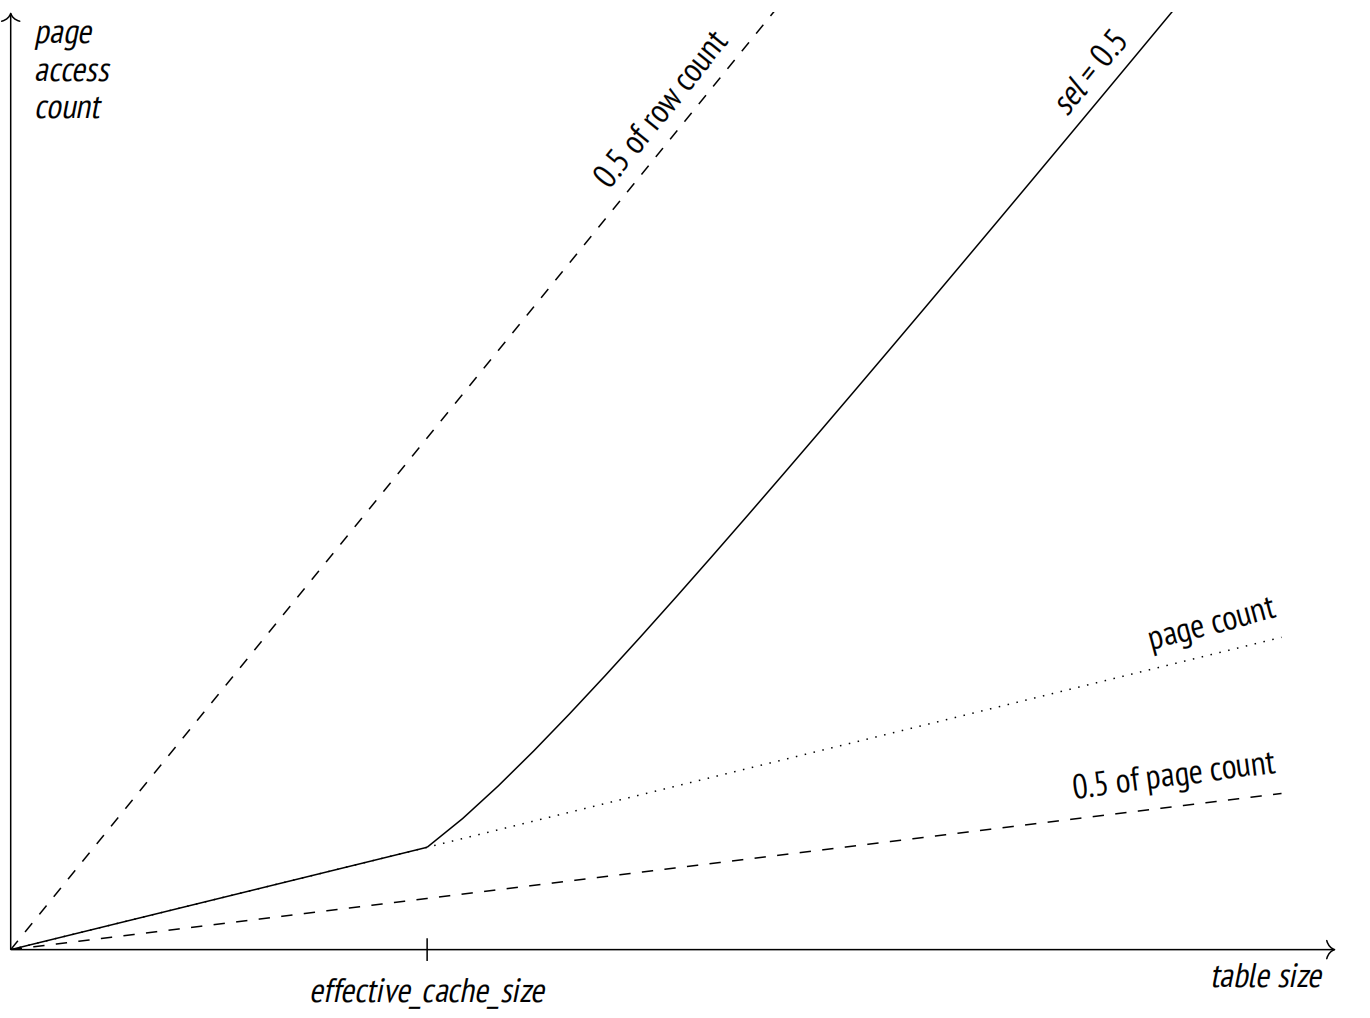
20.1.3 不良场景:低相关性:插图 3
图 20.3

effective_cache_size 值表示可用于缓存的内存总量 (包括 PostgreSQL 缓冲区缓存和操作系统缓存)。但由于该参数仅用于估算目的,并不会影响到内存分配本身,因此在更改此设置时,不必考虑实际数字。

如果将 effective_cache_size 减少到最小,计划的估算结果将接近上述无缓存情况的低端值:

=> SET effective_cache_size = '8kB';
=> EXPLAIN SELECT * FROM bookings
WHERE book_date < '2016-08-23 12:00:00+03';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_book_date_idx on bookings
   (cost=0.43..532745.48 rows=132403 width=21)
   Index Cond: (book_date < '2016−08−23 12:00:00+03'::timestamp w...
(3 rows)
               
=> RESET effective_cache_size;
=> RESET enable_seqscan;
=> RESET enable_bitmapscan;

规划器计算了最坏情况和最好情况场景下的表 I/O 成本,然后根据实际的相关性取一个中间值。6

因此,如果只需要读取一小部分行,索引扫描可能是一个不错的选择。如果堆元组与访问方法返回的 ID 顺序相关性高,那么需要读取的行数可以相对较多。然而,如果相关性低,对于选择率低的查询,索引扫描便会变得不那么吸引人。

20.2 仅索引扫描

如果一个索引包含所有查询所需的堆数据,那么它被称为这个特定查询的覆盖索引。如果这样的索引可用,便可以避免额外的表访问:访问方法可以直接返回实际数据,而不是 TIDS。这种类型的索引扫描称为仅索引扫描。7 它可以被支持 RETURNABLE 属性的访问方法使用。

在计划中,这个操作由 Index Only Scan 8 节点表示:

=> EXPLAIN SELECT book_ref FROM bookings WHERE book_ref < '100000';
                   QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_pkey on bookings
   (cost=0.43..3791.91 rows=132999 width=7)
   Index Cond: (book_ref < '100000'::bpchar)
(3 rows)

顾名思义,这个节点不需要访问堆,但事实却并非如此。在 PostgreSQL 中,索引不包含元组可见性的信息,因此访问方法返回所有满足过滤条件的堆元组数据,即使当前事务看不到它们。然后由索引引擎检查它们的可见性。

然而,如果此方法必须访问表以检查每条元组的可见性,那么它与常规的索引扫描没有任何区别。因此,它使用了为表提供的可见性映射,在其中,vacuum 进程会标记仅包含所有元组都可见的页面 (即所有事务均可访问的那些元组,无论使用的快照如何) 。如果索引访问方法返回的 TID 属于这样的页面,则无需检查其可见性。

仅索引扫描的成本估算取决于堆中页面全部可见的比例。PostgreSQL 会收集这样的统计信息:

=> SELECT relpages, relallvisible
FROM pg_class WHERE relname = 'bookings';
 relpages | relallvisible
−−−−−−−−−−+−−−−−−−−−−−−−−−
    13447 |         13446
(1 row)

仅索引扫描的成本估算与常规索引扫描的成本估算不同:其与表访问相关的 I/O 成本是按照未出现在可见性映射中的页面比例来计算的。(元组处理的成本估算是相同的)

由于在这个特定示例中,所有页面只包含全部可见的元组,因此堆 I/O 的成本实际上排除在了成本估算之外:

=> WITH costs(idx_cost, tbl_cost) AS (
  SELECT
    (
      SELECT round(
        current_setting('random_page_cost')::real * pages +
        current_setting('cpu_index_tuple_cost')::real * tuples +
        current_setting('cpu_operator_cost')::real * tuples
      )
      FROM (
        SELECT relpages * 0.0630 AS pages,
              reltuples * 0.0630 AS tuples
        FROM pg_class WHERE relname = 'bookings_pkey'
      ) c
    ) AS idx_cost,
    (
      SELECT round(
        (1 - frac_visible) * -- fraction of non-all-visible pages
        current_setting('seq_page_cost')::real * pages +
        current_setting('cpu_tuple_cost')::real * tuples
      )
      FROM (
        SELECT relpages * 0.0630 AS pages,
              reltuples * 0.0630 AS tuples,
          relallvisible::real/relpages::real AS frac_visible
        FROM pg_class WHERE relname = 'bookings'
      ) c
    ) AS tbl_cost
)
SELECT idx_cost, tbl_cost, idx_cost + tbl_cost AS total
FROM costs;
 idx_cost | tbl_cost | total
−−−−−−−−−−+−−−−−−−−−−+−−−−−−−
     2457 |     1330 | 3787
(1 row)

任何未清理的变更,如果还没有消失在数据库的视界之外,都会增加计划的预估成本 (因此,使这个计划对优化器来说变得不那么有吸引力) 。EXPLAIN ANALYZE 命令可以显示实际的堆访问计数。

在新创建的表中,PostgreSQL 必须检查所有元组的可见性:

=> CREATE TEMP TABLE bookings_tmp
WITH (autovacuum_enabled = off) AS
  SELECT * FROM bookings
  ORDER BY book_ref;
=> ALTER TABLE bookings_tmp ADD PRIMARY KEY(book_ref);
=> ANALYZE bookings_tmp;
=> EXPLAIN (analyze, timing off, summary off)
SELECT book_ref FROM bookings_tmp WHERE book_ref < '100000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_tmp_pkey on bookings_tmp
   (cost=0.43..4638.91 rows=132999 width=7) (actual rows=132109 l...
   Index Cond: (book_ref < '100000'::bpchar)
   Heap Fetches: 132109
(4 rows)

但是一旦表被清理之后,这样的检查就会变得多余,只要所有页面保持全部可见,就不会执行这样的检查。

=> VACUUM bookings_tmp;
=> EXPLAIN (analyze, timing off, summary off)
SELECT book_ref FROM bookings_tmp WHERE book_ref < '100000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_tmp_pkey on bookings_tmp
   (cost=0.43..3787.91 rows=132999 width=7) (actual rows=132109 l...
   Index Cond: (book_ref < '100000'::bpchar)
   Heap Fetches: 0
(4 rows)

20.2.1 包含 INCLUDE 子句的索引

然而,并不总是可以使用查询所需的所有列来扩展索引:

  • 对于唯一索引,添加新列会破坏原始键列的唯一性。

  • 索引访问方法可能没有为要添加的列的数据类型提供操作符类。

在这种情况下,你仍然可以将列包含进索引中v. 11,而无需让它们成为索引键的一部分。当然,基于包含列进行索引扫描是不可能的,但如果查询引用了这些列,那么索引将作为覆盖索引。

以下示例展示了如何用另一个包含列的索引替换自动创建的主键索引:

=> CREATE UNIQUE INDEX ON bookings(book_ref) INCLUDE (book_date);

=> BEGIN;
=> ALTER TABLE bookings
DROP CONSTRAINT bookings_pkey CASCADE;
NOTICE: drop cascades to constraint tickets_book_ref_fkey on table
tickets
ALTER TABLE

=> ALTER TABLE bookings ADD CONSTRAINT bookings_pkey PRIMARY KEY
  USING INDEX bookings_book_ref_book_date_idx; -- a new index
NOTICE: ALTER TABLE / ADD CONSTRAINT USING INDEX will rename index
"bookings_book_ref_book_date_idx" to "bookings_pkey"
ALTER TABLE
=> ALTER TABLE tickets
  ADD FOREIGN KEY (book_ref) REFERENCES bookings(book_ref);
=> COMMIT;

=> EXPLAIN SELECT book_ref, book_date
FROM bookings WHERE book_ref < '100000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_pkey on bookings (cost=0.43..437...
   Index Cond: (book_ref < '100000'::bpchar)
(2 rows)

这种索引通常被称为覆盖索引,但这种说法并不完全正确。如果一个索引的列集合覆盖了特定查询所需的所有列,那么该索引被认为是覆盖索引。无论是涉及通过 INCLUDE 子句添加的任何列,还是仅使用键列都无关紧要。此外,同一个索引对于一个查询可能是覆盖的,但对于另一个查询则可能不是。

20.3 位图扫描

索引扫描的效率是有限的:随着相关性的降低,对堆页面的访问次数增加,扫描变得随机而不是顺序的。为了克服这一限制,PostgreSQL 可以在访问表之前获取所有的 TIDS,并根据它们的页面编号按升序对它们进行排序 9。这正是位图扫描的工作原理,位图扫描是另一种处理 TIDS 的常见方式。它可以被那些支持 BITMAP SCAN 属性的访问方法使用。

与常规索引扫描不同,此操作在查询计划中由两个节点表示:

=> CREATE INDEX ON bookings(total_amount);
=> EXPLAIN
SELECT * FROM bookings WHERE total_amount = 48500.00;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on bookings (cost=54.63..7040.42 rows=2865 wid...
   Recheck Cond: (total_amount = 48500.00)
   −> Bitmap Index Scan on bookings_total_amount_idx
       (cost=0.00..53.92 rows=2865 width=0)
       Index Cond: (total_amount = 48500.00)
(5 rows)

Bitmap Index Scan 10 节点从访问方法中获取所有 TIDS 11 的位图。

位图由单独的段组成,每个段对应一个堆页面。这些段的大小都是一样的,足以容纳所有页面元组,无论实际上有多少元组。页面元组这个数字是有限的,因为元组头非常大;标准大小的页面最多可以容纳 256 条元组,这些元组占 32 个字节 12。

然后,Bitmap Heap Scan 13 逐段遍历位图,读取相应的页面,并检查所有标记为全部可见的元组。这样的话,页面根据页号以升序读取,每个页面仅被读取一次。

尽管如此,这个过程与顺序扫描不同,因为访问的页面很少相邻。操作系统执行的常规预取在这种情况下无济于事,因此 Bitmap Heap Scan 节点通过异步读取 effective_io_concurrency1 个页面实现了自己的预取 — 并且它是唯一这样做的节点。这个机制依赖于某些操作系统实现的 posix_fadvise 函数。如果你的系统支持这个函数,那么根据硬件能力在表空间级别配置 effective_io_concurrency 参数是有意义的。

异步预取也被其他一些内部进程所使用:

  • 在删除堆行时用于索引页面v. 13 14

  • 在分析期间用于堆页面v. 14 15

预取深度由 maintenance_io_concurrency10 定义。

20.3.1 位图准确性

包含满足查询过滤条件的元组的页面越多,位图就越大。位图建立在后端进程的本地内存中,其大小受到 work_mem4MB 参数限制。一旦达到允许的最大大小,一些位图段就会变得有损:有损段的每个位对应一个完整的页面,而段本身包含一系列页面。16 因此,位图的大小以牺牲其准确性为代价变得更小。

EXPLAIN ANALYZE 命令显示了所构建位图的准确性:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM bookings WHERE total_amount > 150000.00;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on bookings (actual rows=242691 loops=1)
   Recheck Cond: (total_amount > 150000.00)
   Heap Blocks: exact=13447
   −> Bitmap Index Scan on bookings_total_amount_idx (actual rows...
       Index Cond: (total_amount > 150000.00)
(5 rows)

此处,我们有足够的内存来构建一个精确的位图。

如果我们减少 work_mem 的值,一些位图段就会变得有损:

=> SET work_mem = '512kB';
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM bookings WHERE total_amount > 150000.00;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on bookings (actual rows=242691 loops=1)
   Recheck Cond: (total_amount > 150000.00)
   Rows Removed by Index Recheck: 1145721
   Heap Blocks: exact=5178 lossy=8269
   −> Bitmap Index Scan on bookings_total_amount_idx (actual rows...
       Index Cond: (total_amount > 150000.00)
(6 rows)
=> RESET work_mem;

当读取有损位图段所对应的堆页面时,PostgreSQL 必须重新检查页面中每条元组的过滤条件。要重新检查的条件总是在计划中显示为 Recheck Cond,即使未执行这种检查也是如此。重新检查期间过滤掉的元组数会另外显示 (作为 Rows Removed by Index Recheck)。

如果结果集的大小太大,位图可能不适合 work_mem 内存块,即使所有段都是有损的。这种情况下会忽略此限制,位图会占用所需的尽可能多的空间。PostgreSQL 既不会进一步降低位图的准确性,也不会将其任何段刷到磁盘。

20.3.2 位图操作

如果查询将过滤条件应用于多列,并且这些列上分别创建了索引,那么位图扫描可以一起使用这些索引。17 所有这些索引都即时构建了自己的位图;然后使用逻辑与 (如果表达式通过 AND 连接) 或逻辑或 (如果表达式通过 OR 连接) 将位图按位合并。例如:

=> EXPLAIN (costs off)
SELECT * FROM bookings
WHERE book_date < '2016-08-28'
	AND total_amount > 250000;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on bookings
   Recheck Cond: ((total_amount > '250000'::numeric) AND (book_da...
   −> BitmapAnd
       −> Bitmap Index Scan on bookings_total_amount_idx
           Index Cond: (total_amount > '250000'::numeric)
       −> Bitmap Index Scan on bookings_book_date_idx
           Index Cond: (book_date < '2016−08−28 00:00:00+03'::tim...
(7 rows)

此处 BitmapAnd 节点使用按位与操作合并两个位图。

当两个位图合并为一个时,18 精确的段在合并时仍然保持精确 (如果新的位图适合 work_mem 内存块),但如果一组位图中有任何段是有损的,那么生成的段也将是有损的。

20.3.3 成本估算

让我们观察一下使用位图扫描的查询:

=> EXPLAIN
SELECT * FROM bookings WHERE total_amount = 28000.00;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on bookings (cost=599.48..14444.96 rows=31878 ...
   Recheck Cond: (total_amount = 28000.00)
   −> Bitmap Index Scan on bookings_total_amount_idx
       (cost=0.00..591.51 rows=31878 width=0)
       Index Cond: (total_amount = 28000.00)
(5 rows)

规划器使用的条件的近似选择率等于

=> SELECT round(31878::numeric/reltuples::numeric, 4)
FROM pg_class WHERE relname = 'bookings';
 round
−−−−−−−−
 0.0151
(1 row)

Bitmap Index Scan 节点的总成本以与不考虑堆访问的常规索引扫描相同的方式进行估算:

=> SELECT round(
  current_setting('random_page_cost')::real * pages +
  current_setting('cpu_index_tuple_cost')::real * tuples +
  current_setting('cpu_operator_cost')::real * tuples
)
FROM (
  SELECT relpages * 0.0151 AS pages, reltuples * 0.0151 AS tuples
  FROM pg_class WHERE relname = 'bookings_total_amount_idx'
) c;
 round
−−−−−−−
   589
(1 row)

Bitmap Heap Scan 节点的 I/O 成本估算不同于常规索引扫描完美相关性的情况。位图允许根据页号升序读取堆页,而不需要返回到同一页面,但满足过滤条件的元组不再相继出现。PostgreSQL 可能会访问更多页面,而不是读取一个非常紧凑的严格顺序的页面范围。
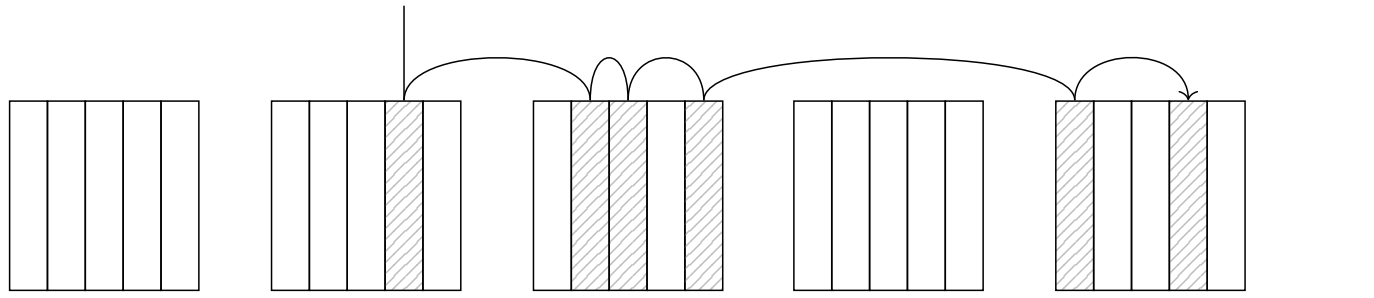
20.3.3 成本估算:插图 4
图 20.4

要读取的页面数通过以下公式估算:19

min⁡(2⋅relpages⋅reltuples⋅sel2⋅relpages+reltuples⋅sel,relpages) \min \left( \frac{2 \cdot \text{relpages} \cdot \text{reltuples} \cdot \text{sel}}{2 \cdot \text{relpages} + \text{reltuples} \cdot \text{sel}}, \text{relpages} \right)

读取单个页面的估算成本介于 seq_page_cost 和 random_page_cost 之间,取决于获取的页面比例与表中页面总数的比率:

=> WITH t AS (
  SELECT relpages,
    least(
      (2 * relpages * reltuples * 0.0151) /
      (2 * relpages + reltuples * 0.0151),
      relpages
    ) AS pages_fetched,
    round(reltuples * 0.0151) AS tuples_fetched,
    current_setting('random_page_cost')::real AS rnd_cost,
    current_setting('seq_page_cost')::real AS seq_cost
  FROM pg_class WHERE relname = 'bookings'
)
SELECT pages_fetched,
  rnd_cost - (rnd_cost - seq_cost) *
  sqrt(pages_fetched / relpages) AS cost_per_page,
  tuples_fetched
FROM t;
 pages_fetched | cost_per_page | tuples_fetched
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
         13447 |             1 |          31878
(1 row)

与往常一样,I/O 估算值会因处理每条获取元组的成本而增加。如果使用精确位图,元组数估算为表中元组总数乘以过滤条件的选择率。但是,如果任何位图段是有损的,PostgreSQL 必须访问相应的页面以重新检查其中所有元组。
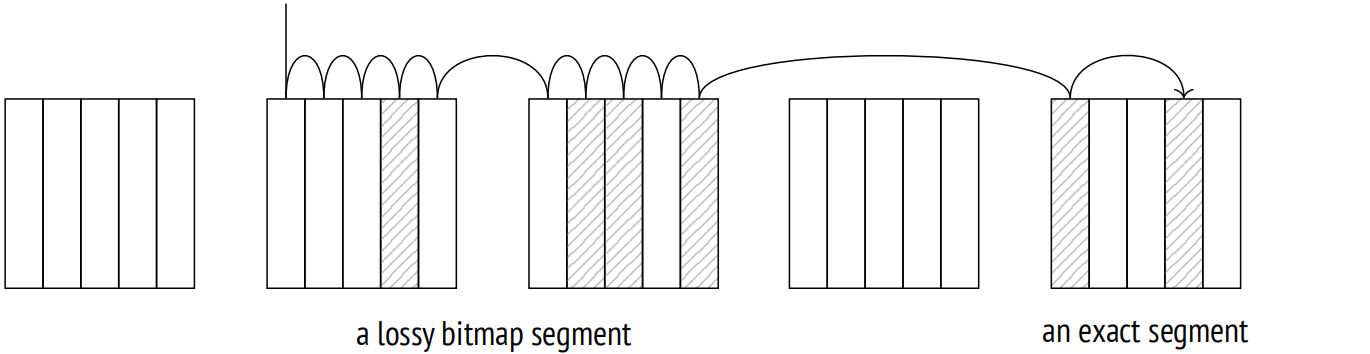
20.3.3 成本估算:插图 5
图 20.5

因此,估算考虑了有损位图段的预期比例v. 11 (可以基于所选行的总数和 work_mem 定义的位图大小限制来计算)。20

重新检查过滤条件的总成本也增加了估算值 (无论位图精度如何)。

Bitmap Heap Scan 节点的启动成本估算值基于 Bitmap Index Scan 节点的总成本,该成本还包括了位图处理的成本。
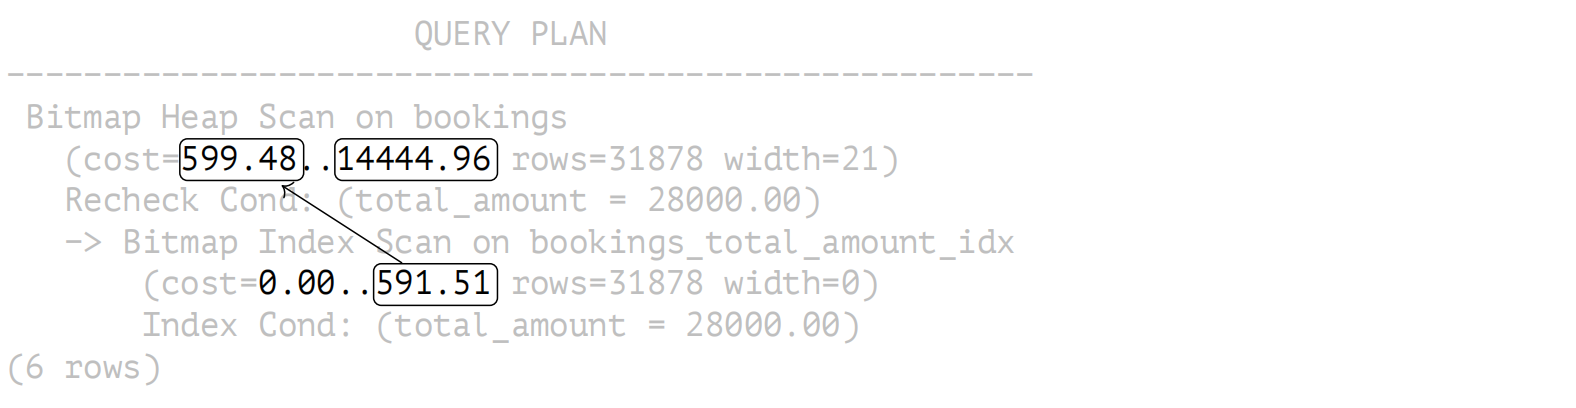
20.3.3 成本估算:插图 6
图 20.6

此处位图是准确的,成本估算大致如下:21

=> WITH t AS (
  SELECT 1 AS cost_per_page,
         13447 AS pages_fetched,
         31878 AS tuples_fetched
),
costs(startup_cost, run_cost) AS (
  SELECT
    ( SELECT round(
        589 /* cost estimation for the child node */ +
        0.1 * current_setting('cpu_operator_cost')::real *
        reltuples * 0.0151
      )
      FROM pg_class WHERE relname = 'bookings_total_amount_idx'
    ),
    ( SELECT round(
        cost_per_page * pages_fetched +
        current_setting('cpu_tuple_cost')::real * tuples_fetched +
        current_setting('cpu_operator_cost')::real * tuples_fetched
      )
      FROM t
    )
)
SELECT startup_cost, run_cost,
  startup_cost + run_cost AS total_cost
FROM costs;
 startup_cost | run_cost | total_cost
−−−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−
          597 |    13845 |      14442
(1 row)

如果查询计划合并了多个位图,单独索引扫描的成本总和会增加一个 (较小) 合并它们的成本。22

20.4 并行索引扫描

所有索引扫描的方式 — 常规索引扫描、仅索引扫描和位图扫描都有其各自的并行特点v. 9.6。

并行执行的成本以与顺序执行相同的方式进行估算,但是 (就像并行顺序扫描的情况一样) CPU 资源在所有并行进程之间分配,从而降低了总成本。成本的 I/O 组成部分没有分摊,因为进程被同步以顺序执行页面访问。

现在让我在不分解成本估算的情况下展示几个并行计划的示例。

并行索引扫描:

=> EXPLAIN SELECT sum(total_amount)
FROM bookings WHERE book_ref < '400000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (cost=19192.81..19192.82 rows=1 width=32)
   −> Gather (cost=19192.59..19192.80 rows=2 width=32)
       Workers Planned: 2
       −> Partial Aggregate (cost=18192.59..18192.60 rows=1 widt...
           −> Parallel Index Scan using bookings_pkey on bookings
               (cost=0.43..17642.82 rows=219907 width=6)
               Index Cond: (book_ref < '400000'::bpchar)
(7 rows)

当正在执行 B 树并行扫描时,当前索引页的 ID 保存在服务器的共享内存中。初始值由启动扫描的进程设置:它从根遍历树,到第一个合适的叶子页面并保存其 ID。工作进程根据需要访问后续索引页面,替换保存的 ID。获取页面后,工作进程遍历其所有合适的条目并读取相应的堆元组。当工作进程读取了满足查询过滤条件的整个值范围时,扫描完成。

并行仅索引扫描:

=> EXPLAIN SELECT sum(total_amount)
FROM bookings WHERE total_amount < 50000.00;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (cost=23370.60..23370.61 rows=1 width=32)
   −> Gather (cost=23370.38..23370.59 rows=2 width=32)
       Workers Planned: 2
       −> Partial Aggregate (cost=22370.38..22370.39 rows=1 widt...
           −> Parallel Index Only Scan using bookings_total_amoun...
               (cost=0.43..21387.27 rows=393244 width=6)
               Index Cond: (total_amount < 50000.00)
(7 rows)

并行仅索引扫描跳过了页面全部可见的堆访问;这是它与并行索引扫描的唯一区别。

并行位图扫描:

=> EXPLAIN SELECT sum(total_amount)
FROM bookings WHERE book_date < '2016-10-01';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (cost=21492.21..21492.22 rows=1 width=32)
   −> Gather (cost=21491.99..21492.20 rows=2 width=32)
       Workers Planned: 2
       −> Partial Aggregate (cost=20491.99..20492.00 rows=1 widt...
           −> Parallel Bitmap Heap Scan on bookings
               (cost=4891.17..20133.01 rows=143588 width=6)
               Recheck Cond: (book_date < '2016−10−01 00:00:00+03...
               −> Bitmap Index Scan on bookings_book_date_idx
                   (cost=0.00..4805.01 rows=344611 width=0)
                   Index Cond: (book_date < '2016−10−01 00:00:00+...

位图扫描意味着位图总是由单个领导者进程顺序构建;因此,Bitmap Index Scan 节点的名称不包含 Parallel 一词。当位图准备就绪后,Parallel Bitmap Heap Scan 节点开始并行堆扫描。工作进程访问后续的堆页面并且并发处理它们。

20.5 各种访问方法的比较

下图显示了过滤条件的选择率如何影响访问方法的成本:
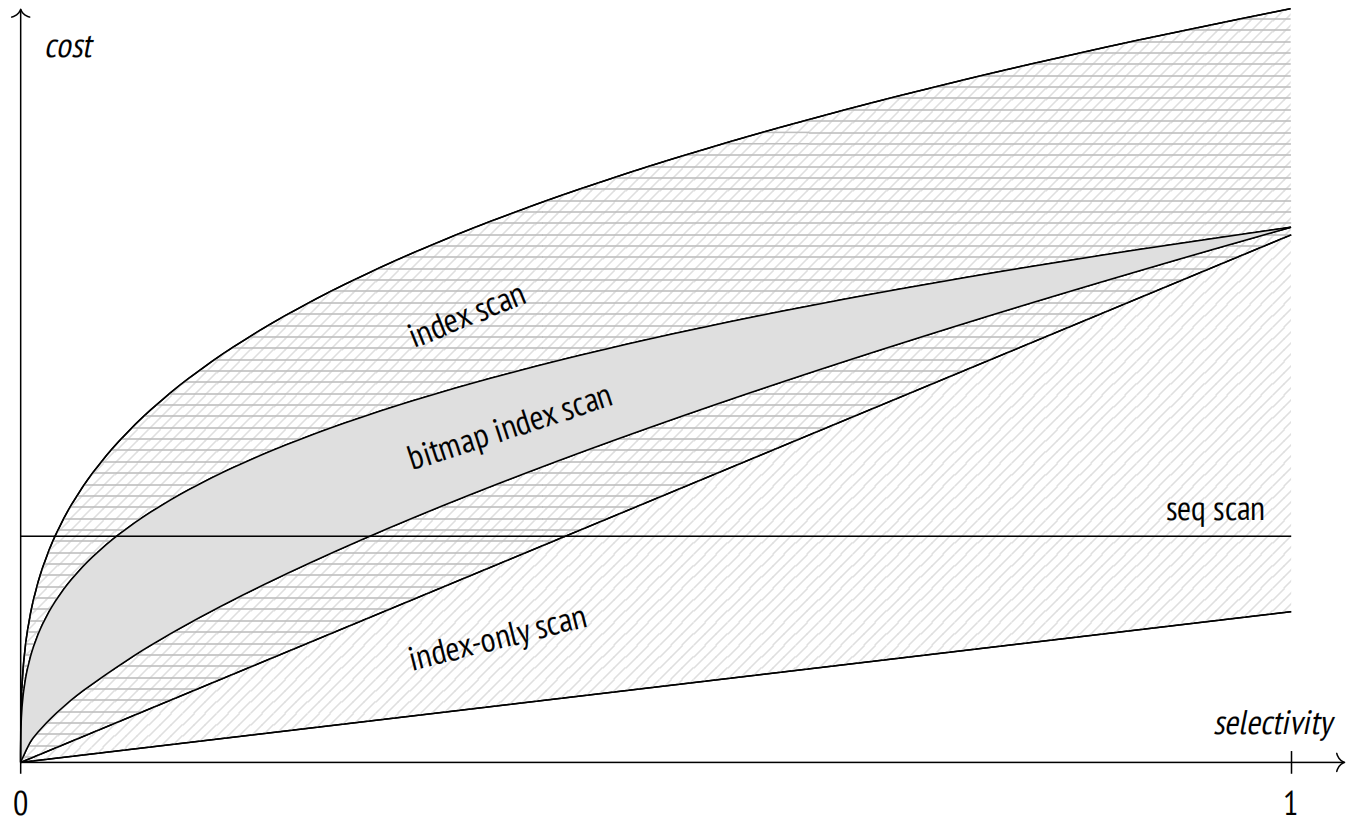
20.5 各种访问方法的比较:插图 7
图 20.7

这是一个定性图;实际数字当然取决于特定的表和服务器配置。

顺序扫描不依赖于选择率,从选定行的某个比例开始,它通常比其他方法更有效。

索引扫描的成本受到元组的物理顺序与访问方法返回的 ID 顺序之间的相关性的影响。如果相关性完美,即使所选行的比例很高,索引扫描也可以非常高效。然而,对于低相关性 (这更常见) ,它的成本很快甚至可能超过顺序扫描。尽管如此,在使用索引获取单行时 (通常是唯一索引),索引扫描仍然是绝对领先者。

如果适用,仅索引扫描可以展现出极佳的性能,甚至在选择所有行时也能胜过顺序扫描。但是,其性能高度依赖于可见性映射,在最糟糕的情况下,仅索引扫描会降级为常规的索引扫描。

位图扫描的成本受可用内存大小的影响,但这种影响远小于索引扫描的成本对于相关性的依赖。如果相关性低,位图扫描的成本会更低。

每种访问方法都有其适用的使用场景;没有一种方法总是优于其他方法。规划器必须进行大量计算,以评估每种特定情况下每种方法的效率。显然,评估的准确性在很大程度上取决于所收集的统计信息的准确性。


  1. backend/executor/nodeIndexscan.c ↩︎

  2. backend/access/index/indexam.c, index_getnext_tid function ↩︎

  3. backend/executor/nodeTidscan.c ↩︎

  4. backend/utils/adt/selfuncs.c, btcostestimate function
    postgresql.org/docs/14/index-cost-estimation.html ↩︎

  5. backend/optimizer/path/costsize.c, index_pages_fetched function ↩︎

  6. backend/optimizer/path/costsize.c, cost_index function ↩︎

  7. postgresql.org/docs/14/indexes-index-only-scans.html ↩︎

  8. backend/executor/nodeIndexonlyscan.c ↩︎

  9. backend/access/index/indexam.c, index_getbitmap function ↩︎

  10. backend/executor/nodeBitmapIndexscan.c ↩︎

  11. backend/access/index/indexam.c, index_getbitmap function ↩︎

  12. backend/nodes/tidbitmap.c ↩︎

  13. backend/executor/nodeBitmapHeapscan.c ↩︎

  14. backend/access/heap/heapam.c, index_delete_prefetch_buffer function ↩︎

  15. backend/commands/analyze.c, acquire_sample_rows function ↩︎

  16. backend/nodes/tidbitmap.c, tbm_lossify function ↩︎

  17. postgresql.org/docs/14/indexes-ordering.html ↩︎

  18. backend/nodes/tidbitmap.c, tbm_union & tbm_intersect functions ↩︎

  19. backend/optimizer/path/costsize.c, compute_bitmap_pages function ↩︎

  20. backend/optimizer/path/costsize.c, compute_bitmap_pages function ↩︎

  21. backend/optimizer/path/costsize.c, cost_bitmap_heap_scan function ↩︎

  22. backend/optimizer/path/costsize.c, cost_bitmap_and_node & cost_bitmap_or_node functions ↩︎

21 嵌套循环

21.1 连接类型和方式

连接是 SQL 语言的关键特性;它们是其强大和灵活的基础。行集 (直接从表中检索或作为其他操作的结果接收) 始终成对连接。

连接有几种类型:

内连接。内连接 (指定为 INNER JOIN,或简称为 JOIN) 包括两个集合中满足特定连接条件的行。连接条件将一个行集的某些列与另一个行集的某些列结合;所有涉及的列构成连接键。如果连接条件要求两个集合的连接键相等,这样的连接称为等值连接;这是最常见的连接类型。两个集合的笛卡尔积 (CROSS JOIN) 包含这些集合所有可能的行对 — 这是具有 true 条件的内连接的一种特殊情况。

外连接。左外连接 (指定为 LEFT OUTER JOIN,或简称为 LEFT JOIN) 通过左集合中那些在右集合中没有相匹配的行来扩展内连接的结果 (右集合中相应的列被填充为空值)。右外连接 (RIGHT JOIN) 也是如此,只是交换了集合的位置。全外连接 (指定为 FULL JOIN) 包括左外连接和右外连接,它将两边未找到匹配项的行都添加进来。

反连接和半连接。半连接与内连接非常相似,但它只包括左侧集合中在右侧集合中有匹配项的那些行 (即使有多个匹配项,一行也仅包含一次)。反连接包括一个集合中在另一个集合中没有匹配项的行。SQL 语言没有明确的半连接和反连接,但可以使用像 EXISTS 和 NOT EXISTS 这样的谓词达到相同的结果。

所有这些连接都是逻辑操作。例如,内连接通常被描述为一个已清理不满足连接条件的行的笛卡尔积。但在物理层面,内连接通常是通过成本更低的方式实现的。

PostgreSQL 提供了多种连接方式:

  • 嵌套循环连接

  • 哈希连接

  • 归并连接

连接方法是实现 SQL 连接逻辑操作的算法。这些基本算法经常有针对特定连接类型的特殊变体,尽管它们可能只支持其中一些。例如,嵌套循环支持内连接 (在计划中由 Nested Loop 节点表示) 和左外连接(由 Nested Loop Left Join 节点表示) ,但它不能用于全外连接。

同一算法的一些变体也可以被其他操作使用,如聚合。

不同的连接方法在不同条件下效果最佳;规划器的工作就是选择成本效益最高的连接方法。

21.2 嵌套循环连接

嵌套循环连接的基本算法如下。外循环遍历第一个集合中 (称为外集合) 所有的行。对于每一行,嵌套循环遍历第二个集合中 (称为内集合) 的行,以找到满足连接条件的行。每个找到的连接对作为查询结果的一部分立即返回。1

此算法访问内集合的次数与外集合中的行数一样多。因此,嵌套循环连接的效率取决于几个因素:

  • 外集合中行的基数

  • 可用的访问方法,可以有效获取内集合中所需的行

  • 循环访问内集合中的同一行

21.2.1 笛卡尔积

无论集合中的行数如何,嵌套循环连接都是查找笛卡尔积最有效的方式:
21.2.1 笛卡尔积:插图 1
图 21.1

嵌套循环节点使用上述算法进行连接。它总是有两个子节点:计划中显示较高的节点对应于外集合,而较低的节点代表内集合。

在此例中,内集合由 Materialize 节点 2 表示。此节点返回从其子节点接收到的行,并保存它们以备将来使用 (这些行在内存中累积,直到它们的总大小达到 work_mem4MB;然后 PostgreSQL 会将它们溢出到磁盘上的临时文件中)。如果再次访问,节点读取所累积的行而无需调用子节点。这样执行器就可以避免再次扫描全表,只读取满足条件的行即可。

对于使用常规等值连接的查询,也可以构建类似的计划:

=> EXPLAIN SELECT *
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.ticket_no = '0005432000284';
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (cost=0.99..25.05 rows=3 width=136)
   −> Index Scan using tickets_pkey on tickets t
       (cost=0.43..8.45 rows=1 width=104)
       Index Cond: (ticket_no = '0005432000284'::bpchar)
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
       (cost=0.56..16.58 rows=3 width=32)
       Index Cond: (ticket_no = '0005432000284'::bpchar)
(7 rows)

在识别两个值相等之后,规划器将连接条件 tf.ticket_no = t.ticket_no 替换为 tf.ticket_no = constant 的条件,这实际上将等值连接简化为了笛卡尔积。3

基数估算。笛卡尔积的基数预估为所连接数据集的基数乘积:3 = 1 × 3。

代价估算。连接操作的启动成本包括了所有子节点的启动成本。

连接的全部成本包括以下部分:

  • 获取外集合中所有行的成本

  • 单次检索内集合中所有行的成本 (因为外集合的基数预估等于 1)

  • 处理要返回的每一行的成本

此处是成本估算的依赖图:

21.2.1 笛卡尔积:插图 2
图 21.2

连接的成本计算如下:

=> SELECT 0.43 + 0.56 AS startup_cost,
  round((
    8.45 + 16.57 +
    3 * current_setting('cpu_tuple_cost')::real
  )::numeric, 2) AS total_cost;
 startup_cost | total_cost
−−−−−−−−−−−−−−+−−−−−−−−−−−−
         0.99 |      25.05
(1 row)

现在让我们回到之前的例子:

=> EXPLAIN SELECT *
FROM aircrafts_data a1
  CROSS JOIN aircrafts_data a2
WHERE a2.range > 5000;
                    QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (cost=0.00..2.78 rows=45 width=144)
   −> Seq Scan on aircrafts_data a1
       (cost=0.00..1.09 rows=9 width=72)
   −> Materialize (cost=0.00..1.14 rows=5 width=72)
       −> Seq Scan on aircrafts_data a2
          (cost=0.00..1.11 rows=5 width=72)
          Filter: (range > 5000)
(7 rows)

现在计划中包含了 Materialize 节点;在累积了从子节点接收到的行之后,Materialize 就能在所有后续调用中更快地返回它们。

总的来说,连接的总成本包括以下:4

  • 获取外集合中所有行的成本

  • 内集合中所有行的初始获取成本 (在此期间执行物化)

  • 内集合中行重复获取成本的 (N-1) 倍 (此处 N 是外集合的行数)

  • 处理要返回的每一行的成本

此处的依赖图如下:

21.2.1 笛卡尔积:插图 3
图 21.3

在这个例子中,物化降低了重复获取数据的成本。计划中显示了第一次 Materialize 调用的成本,但没有列出所有后续的调用情况。我不会在此处提供任何计算说明,5 但在此特例下,估算值是 0.0125。

因此,这个例子中执行的连接成本计算如下:

=> SELECT 0.00 + 0.00 AS startup_cost,
  round((
    1.09 + (1.14 + 8 * 0.0125) +
    45 * current_setting('cpu_tuple_cost')::real
  )::numeric, 2) AS total_cost;
 startup_cost | total_cost
−−−−−−−−−−−−−−+−−−−−−−−−−−−
         0.00 |       2.78
(1 row)

21.2.2 参数化连接

现在让我们考虑一个更常见的例子,它不能归结为笛卡尔积:

=> CREATE INDEX ON tickets(book_ref);
=> EXPLAIN SELECT *
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '03A76D';
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (cost=0.99..45.68 rows=6 width=136)
   −> Index Scan using tickets_book_ref_idx on tickets t
       (cost=0.43..12.46 rows=2 width=104)
       Index Cond: (book_ref = '03A76D'::bpchar)
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
       (cost=0.56..16.58 rows=3 width=32)
       Index Cond: (ticket_no = t.ticket_no)
(7 rows)

此处,Nested Loop 节点遍历外集合中 (tickets) 的行,对于其中的每一行,都会搜索内集合中 (flights) 相应的行,同时将票号作为参数 (t.ticket_no) 传递给条件。当调用内部节点 (Index Scan) 时,必须要处理条件 ticket_no = constant。

基数估算。规划器预估外集合中有两行 (rows=2) 满足按预订号过滤的条件,并且每行平均匹配内集合中的三行 (rows=3)。

连接选择率是连接后剩余的两个集合的笛卡尔积的一部分。显然,我们必须排除两个集合中连接键中包含空值的行,因为它们永远不会满足等值条件。

预估基数等于笛卡尔积的基数 (即两个集合基数的乘积) 乘以选择率。6

此处第一个 (外) 集合的预估基数是两行。由于除了连接条件自身外,没有条件应用于第二个 (内) 集合,因此第二个集合的基数为 ticket_flights 表的基数。

由于连接的表通过外键连接,因此选择率的估算依赖于子表中的每一行恰好在父表中有一个匹配行的事实。因此,选择率被视为外键引用的表大小的倒数。7

这样的话,对于 ticket_no 列不包含空值的情况,估算如下:

=> SELECT round(2 * tf.reltuples * (1.0 / t.reltuples)) AS rows
FROM pg_class t, pg_class tf
WHERE t.relname = 'tickets'
  AND tf.relname = 'ticket_flights';
 rows
−−−−−−
    6
(1 row)

显然,不使用外键也可以连接表。那么选择率将取自特定连接条件的预估选择率。8

对于这个例子中的等值连接,假设值均匀分布,选择率估算的通用公式如下:min⁡(1nd1,1nd2)\min \left( \frac{1}{n d_1}, \frac{1}{n d_2} \right),其中 nd1 和 nd2 分别表示第一个集合和第二个集合中连接键不同值的数量。9

非重复值的统计信息显示 tickets 表中的票号是唯一的 (这是意料之中的,因为 ticket_no 列是主键),并且 ticket_flights 中每张票大约有三个匹配行:

=> SELECT t.n_distinct, tf.n_distinct
FROM pg_stats t, pg_stats tf
WHERE t.tablename = 'tickets' AND t.attname = 'ticket_no'
  AND tf.tablename = 'ticket_flights' AND tf.attname = 'ticket_no';
 n_distinct | n_distinct
−−−−−−−−−−−−+−−−−−−−−−−−−−
         −1 | −0.30362356
(1 row)

结果将与外键连接的估算值相匹配:

=> SELECT round(2 * tf.reltuples *
  least(1.0/t.reltuples, 1.0/tf.reltuples/0.30362356)
) AS rows
FROM pg_class t, pg_class tf
WHERE t.relname = 'tickets' AND tf.relname = 'ticket_flights';
 rows
−−−−−−
    6
(1 row)

规划器会尽可能尝试改进此基线预估。目前它还不能使用直方图,但如果两个表的连接键上收集了 MCV 列表这类统计信息,那么规划器会考虑这些信息。10 列表中出现的行的选择率可以更准确地估算,而剩余的行将不得不依赖于基于均匀分布的假设进行计算。

通常情况下,如果定义了外键,连接选择率的估算可能会更准确。对于复合连接键更是如此,因为在这种情况下,选择率通常都被大大低估了。

使用 EXPLAIN ANALYZE 命令,不仅可以查看到实际的行数,还可以看到内循环被执行的次数:

=> EXPLAIN (analyze, timing off, summary off) SELECT *
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '03A76D';
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (cost=0.99..45.68 rows=6 width=136)
   (actual rows=8 loops=1)
   −> Index Scan using tickets_book_ref_idx on tickets t
       (cost=0.43..12.46 rows=2 width=104) (actual rows=2 loops=1)
       Index Cond: (book_ref = '03A76D'::bpchar)
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
       (cost=0.56..16.58 rows=3 width=32) (actual rows=4 loops=2)
       Index Cond: (ticket_no = t.ticket_no)
(8 rows)

外集合包含两行 (actual rows=2);估算是正确的。所以 Index Scan节点执行了两次 (loops=2),每次平均选取了四行 (actual rows=4) 。因此找到的总行数是:actual rows=8。

为了让输出适应页面的有限宽度,我没有显示计划的每个阶段的执行时间 (TIMING OFF);此外,在某些平台上,启用计时的输出可能会显著减慢查询的执行速度。但如果我们确实包括了它,PostgreSQL 会显示一个平均值,就像行数一样。要获取总执行时间,你需要将此值乘以迭代次数 (loops)。

成本估算。此处的成本估算公式与之前的示例相同。

让我们回顾一下查询计划:

=> EXPLAIN SELECT *
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
WHERE t.book_ref = '03A76D';
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (cost=0.99..45.68 rows=6 width=136)
   −> Index Scan using tickets_book_ref_idx on tickets t
       (cost=0.43..12.46 rows=2 width=104)
       Index Cond: (book_ref = '03A76D'::bpchar)
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
       (cost=0.56..16.58 rows=3 width=32)
       Index Cond: (ticket_no = t.ticket_no)
(7 rows)

在这种情况下,内集合每次后续扫描的成本与第一次扫描的成本相同。因此,我们最终得到以下数据:

=> SELECT 0.43 + 0.56 AS startup_cost,
  round((
    12.46 + 2 * 16.57 +
    6 * current_setting('cpu_tuple_cost')::real
  )::numeric, 2) AS total_cost;
 startup_cost | total_cost
−−−−−−−−−−−−−−+−−−−−−−−−−−−
         0.99 |      45.66
(1 row)

21.2.3 缓存行 (Memoization)v. 14

如果使用相同的参数值重复扫描内集合 (从而给出相同的结果),那么缓存该集合的行可能会有益。

此类缓存由 Memoize 11 节点执行。与 Materialize 节点类似,旨在处理参数化连接,并且具有更复杂的实现:

  • Materialize 节点只是简单地保存所有子节点返回的行,而 Memoize 则确保不同参数值返回的行分开保存。

  • 在发生溢出的情况下,Materialize 存储开始将行溢出到磁盘,而 Memoize 会将所有行保留在内存中 (否则缓存就没有意义了)。

此处是一个使用 Memoize 的查询示例:

=> EXPLAIN SELECT *
FROM flights f
  JOIN aircrafts_data a ON f.aircraft_code = a.aircraft_code
WHERE f.flight_no = 'PG0003';
QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (cost=5.44..387.10 rows=113 width=135)
   −> Bitmap Heap Scan on flights f
       (cost=5.30..382.22 rows=113 width=63)
       Recheck Cond: (flight_no = 'PG0003'::bpchar)
       −> Bitmap Index Scan on flights_flight_no_scheduled_depart...
           (cost=0.00..5.27 rows=113 width=0)
           Index Cond: (flight_no = 'PG0003'::bpchar)
    −> Memoize (cost=0.15..0.27 rows=1 width=72)
       Cache Key: f.aircraft_code
       Cache Mode: logical
       −> Index Scan using aircrafts_pkey on aircrafts_data a
           (cost=0.14..0.26 rows=1 width=72)
           Index Cond: (aircraft_code = f.aircraft_code)
(13 rows)

用于存储缓存行的内存块大小等于 work_mem4MB × hash_mem_multiplier1.0。正如第二个参数名所暗示的那样,缓存行存储在哈希表中 (使用开放寻址) 12。哈希键 (在计划中显示为 Cache Key) 是参数值 (如果不止一个参数,则为多个值)。

所有哈希键绑定到一个列表中;其一端被认为是冷的 (因为它包含长时间未使用的键),而另一端是热的 (它存储最近使用的键)。

如果对 Memoize 节点的调用显示传递的参数值对应于已缓存的行,那么这些行将被传递到父节点 (嵌套循环) 而无需检查子节点。然后使用过的哈希键被移动到列表的热端。

如果缓存中不包含所需的行,Memoize 节点将从其子节点中提取并缓存它们,然后传递给上层节点。相应的哈希键也会变热。

随着新数据被缓存,它可以填满所有可用的内存。为了释放一些空间,对应于冷键的行会被逐出。该逐出算法不同于缓冲区缓存中使用的算法,但目的相同。

某些参数值可能有太多匹配的行,即使所有其他行都已被逐出也不适合所分配的内存块。这样的参数会被跳过 — 只缓存一些行是没有意义的,因为下一次调用仍然必须从子节点获取所有的行。

成本和基数估算。这些计算与我们上面已看到的十分相似。我们只需要记住,计划中显示的 Memoize 节点的成本与其实际成本无关:它只是其子节点的成本增加了 cpu_tuple_cost0.01 的值。13

对于 Materialize 节点,我们已经遇到过类似的情况:它的成本仅为后续扫描进行计算 14,且不会反映在计划中。

显然,只有当 Memoize 比其子节点成本更低时,才有意义使用。每次后续 Memoize 扫描的成本取决于预期的缓存访问概况以及可用于缓存的内存块大小。计算值在很大程度上取决于对扫描内层数据集时使用的不同参数值数量的准确估算。15 基于这个数字,你可以权衡行被缓存和从缓存中逐出的概率。预期的命中降低了估算成本,而潜在的逐出增加了成本。在此处我们将跳过这些计算细节。

为了弄清楚查询执行期间实际发生了什么,我们将像往常一样使用 EXPLAIN ANALYZE 命令:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM flights f
  JOIN aircrafts_data a ON f.aircraft_code = a.aircraft_code
WHERE f.flight_no = 'PG0003';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (actual rows=113 loops=1)
   −> Bitmap Heap Scan on flights f
       (actual rows=113 loops=1)
       Recheck Cond: (flight_no = 'PG0003'::bpchar)
       Heap Blocks: exact=2
   −> Bitmap Index Scan on flights_flight_no_scheduled_depart...
       (actual rows=113 loops=1)
       Index Cond: (flight_no = 'PG0003'::bpchar)
   −> Memoize (actual rows=1 loops=113)
       Cache Key: f.aircraft_code
       Cache Mode: logical
       Hits: 112 Misses: 1 Evictions: 0 Overflows: 0 Memory
       Usage: 1kB
       −> Index Scan using aircrafts_pkey on aircrafts_data a
           (actual rows=1 loops=1)
           Index Cond: (aircraft_code = f.aircraft_code)
(16 rows)

该查询选择沿相同航线并由特定类型的飞机执飞的航班,因此所有 Memoize 节点上的调用都使用相同的哈希键。第一行必须从表中获取第 (Misses: 1),但后续所有的行都在缓存中找到 (Hits: 112)。整个操作只需要 1 kB 的内存。

其他两个显示的值为零:它们代表逐出的次数和由于无法缓存与特定参数集相关的所有行时发生的缓存溢出次数。较大的数字表示分配的缓存太小,这可能是由于对不同参数值的数量预估不准确造成的。那么使用 Memoize 节点可能会非常昂贵。在极端情况下,你可以通过关闭 enable_memoizeon 参数来禁止规划器使用缓存。

21.2.4 外连接

嵌套循环连接可用于执行左外连接:

=> EXPLAIN SELECT *
FROM ticket_flights tf
  LEFT JOIN boarding_passes bp ON bp.ticket_no = tf.ticket_no
AND bp.flight_id = tf.flight_id
WHERE tf.ticket_no = '0005434026720';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop Left Join (cost=1.12..33.35 rows=3 width=57)
   Join Filter: ((bp.ticket_no = tf.ticket_no) AND (bp.flight_id =
   tf.flight_id))
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
       (cost=0.56..16.58 rows=3 width=32)
       Index Cond: (ticket_no = '0005434026720'::bpchar)
   −> Materialize (cost=0.56..16.62 rows=3 width=25)
       −> Index Scan using boarding_passes_pkey on boarding_passe...
           (cost=0.56..16.61 rows=3 width=25)
           Index Cond: (ticket_no = '0005434026720'::bpchar)
(10 rows)

此处连接操作由 Nested Loop Left Join 节点表示。规划器选择了一个带有过滤条件的非参数化连接:它对内层数据集执行相同的扫描 (因此该集合隐藏在 Materialize 节点后面) 并返回满足过滤条件 (Join Filter) 的行。

外连接的基数预估与内连接的基数一样,只是计算出来的预估值是和外层数据集的基数比较,并取较大值作为最终结果。16 换句话说,外连接永远不会减少行数 (但可以增加)。

成本估算与内连接类似。

我们还需记住,规划器可以为内连接和外连接选择不同的计划。如果规划器被迫使用嵌套循环连接,那么即使是这个简单的示例也会有不同的连接过滤条件:

=> SET enable_mergejoin = off;
=> EXPLAIN SELECT *
FROM ticket_flights tf
  JOIN boarding_passes bp ON bp.ticket_no = tf.ticket_no
                         AND bp.flight_id = tf.flight_id
WHERE tf.ticket_no = '0005434026720';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop (cost=1.12..33.33 rows=3 width=57)
   Join Filter: (tf.flight_id = bp.flight_id)
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
       (cost=0.56..16.58 rows=3 width=32)
       Index Cond: (ticket_no = '0005434026720'::bpchar)
   −> Materialize (cost=0.56..16.62 rows=3 width=25)
       −> Index Scan using boarding_passes_pkey on boarding_passe...
           (cost=0.56..16.61 rows=3 width=25)
           Index Cond: (ticket_no = '0005434026720'::bpchar)
(9 rows)
=> RESET enable_mergejoin;

总成本略有不同的原因是,如果外层数据集中没有匹配项,外连接还必须检查票号以获得正确的结果。

不支持右外连接,17 因为嵌套循环算法以不同方式处理内集合和外集合。外集合被完整扫描;至于内集合,索引访问只允许读取那些满足连接条件的行,因此可能完全跳过其中的一些行。

出于同样的原因,也不支持全外连接。

21.2.5 反连接和半连接

反连接和半连接在某种意义上是相似的,对于第一个 (外) 集合的每一行,只需在第二个 (内) 集合中找到一个匹配项就足够了。

反连接只有在第二个数据集中没有匹配项的情况下才返回第一个数据集中的行:一旦执行器在第二个数据集中找到了第一个匹配的行,它就可以退出当前循环:第一个数据集中相应的行必须从结果中排除。

反连接可用于计算 NOT EXISTS 谓词。

例如,让我们查找未定义机舱配置的机型。对应的计划包含 Nested Loop Anti Join 节点:

=> EXPLAIN SELECT *
FROM aircrafts a
WHERE NOT EXISTS (
  SELECT * FROM seats s WHERE s.aircraft_code = a.aircraft_code
);
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop Anti Join (cost=0.28..4.65 rows=1 width=40)
   −> Seq Scan on aircrafts_data ml (cost=0.00..1.09 rows=9 widt...
   −> Index Only Scan using seats_pkey on seats s
       (cost=0.28..5.55 rows=149 width=4)
       Index Cond: (aircraft_code = ml.aircraft_code)
(5 rows)

一个没有 NOT EXISTS 谓词的替代查询含有相同的计划:

=> EXPLAIN SELECT a.*
FROM aircrafts a
  LEFT JOIN seats s ON a.aircraft_code = s.aircraft_code
WHERE s.aircraft_code IS NULL;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop Anti Join (cost=0.28..4.65 rows=1 width=40)
   −> Seq Scan on aircrafts_data ml (cost=0.00..1.09 rows=9 widt...
   −> Index Only Scan using seats_pkey on seats s
       (cost=0.28..5.55 rows=149 width=4)
       Index Cond: (aircraft_code = ml.aircraft_code)
(5 rows)

半连接会返回第一个数据集中至少在第二个数据集中有一条匹配项的行 (同样,也无需检查数据集中是否有其他匹配项 — 结果已经知道了)。

半连接可用于计算 EXISTS 谓词。让我们找出机舱内装有座椅的机型:

=> EXPLAIN SELECT *
FROM aircrafts a
WHERE EXISTS (
  SELECT * FROM seats s
  WHERE s.aircraft_code = a.aircraft_code
);
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop Semi Join (cost=0.28..6.67 rows=9 width=40)
   −> Seq Scan on aircrafts_data ml (cost=0.00..1.09 rows=9 widt...
   −> Index Only Scan using seats_pkey on seats s
       (cost=0.28..5.55 rows=149 width=4)
       Index Cond: (aircraft_code = ml.aircraft_code)
(5 rows)

Nested Loop Semi Join 节点表示同名连接方法。该计划 (就像上面的反连接一样) 提供了 seats 表中行数的基本预估值 (rows=149),尽管只检索其中一个就足够了。当然,实际的查询执行在获取第一行后停止:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM aircrafts a
WHERE EXISTS (
  SELECT * FROM seats s
  WHERE s.aircraft_code = a.aircraft_code
);
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop Semi Join (actual rows=9 loops=1)
   −> Seq Scan on aircrafts_data ml (actual rows=9 loops=1)
   −> Index Only Scan using seats_pkey on seats s
       (actual rows=1 loops=9)
       Index Cond: (aircraft_code = ml.aircraft_code)
       Heap Fetches: 0
(6 rows)

基数估算。半连接的选择率以往常的方式进行估算,除了内集合的基数取 1。对于反连接,预估选择率从 1 中减去,就像取否操作一样。18

成本估算。对于反连接和半连接,成本估算反映了这样一个事实:一旦找到第一个匹配的行,对于第二个数据集的扫描就会停止。19

21.2.6 非等值连接

嵌套循环算法允许根据任何连接条件进行连接。

显然,如果内集合是一个创建了索引的基础表,并且连接条件使用了属于该索引操作符类的操作符,那么对内集合的访问会非常高效。但是始终可以通过计算按某些条件过滤后的行的笛卡尔积来执行连接 — 在这种情况下,该条件可以是任意的。就像下面的查询一样,它选择了彼此靠近的机场:

=> CREATE EXTENSION earthdistance CASCADE;
=> EXPLAIN (costs off) SELECT *
FROM airports a1
  JOIN airports a2 ON a1.airport_code != a2.airport_code
                  AND a1.coordinates <@> a2.coordinates < 100;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop
   Join Filter: ((ml.airport_code <> ml_1.airport_code) AND
   ((ml.coordinates <@> ml_1.coordinates) < '100'::double precisi...
   −> Seq Scan on airports_data ml
   −> Materialize
       −> Seq Scan on airports_data ml_1
(6 rows)

21.2.7 并行模式v. 9.6

嵌套循环连接可以参与并行计划的执行。20

只有外集合可以并行处理,因为它可以由多个工作进程同时扫描。获取了外部行之后,每个工作进程必须顺序地搜索内集合中的匹配行。

下面显示的查询包括多个连接;它搜索持有特定航班机票的乘客:

=> EXPLAIN (costs off) SELECT t.passenger_name
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
  JOIN flights f ON f.flight_id = tf.flight_id
WHERE f.flight_id = 12345;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Nested Loop
   −> Index Only Scan using flights_flight_id_status_idx on fligh...
       Index Cond: (flight_id = 12345)
   −> Gather
       Workers Planned: 2
       −> Nested Loop
           −> Parallel Seq Scan on ticket_flights tf
               Filter: (flight_id = 12345)
           −> Index Scan using tickets_pkey on tickets t
               Index Cond: (ticket_no = tf.ticket_no)
(10 rows)

在上层,嵌套循环连接顺序执行。外集合由 flights 表中通过唯一键获取的单行组成,因此即使内集合行数较多,使用嵌套循环也是合理的。

内集合的检索使用了并行计划。每个工作进程扫描 ticket_flights 表中属于自己份额的行,并使用嵌套循环算法将它们与 tickets 连接起来。


  1. backend/executor/nodeNestloop.c ↩︎

  2. backend/executor/nodeMaterial.c ↩︎

  3. backend/optimizer/path/equivclass.c ↩︎

  4. backend/optimizer/path/costsize.c, initial_cost_nestloop andfinal_cost_nestloop function ↩︎

  5. backend/optimizer/path/costsize.c, cost_rescan function ↩︎

  6. backend/optimizer/path/costsize.c, calc_joinrel_size_estimate function ↩︎

  7. backend/optimizer/path/costsize.c, get_foreign_key_join_selectivity function ↩︎

  8. backend/optimizer/path/clausesel.c, clauselist_selectivity function ↩︎

  9. backend/utils/adt/selfuncs.c, eqjoinsel function ↩︎

  10. backend/utils/adt/selfuncs.c, eqjoinsel function ↩︎

  11. backend/executor/nodeMemoize.c ↩︎

  12. include/lib/simplehash.h ↩︎

  13. backend/optimizer/util/pathnode.c, create_memoize_path function ↩︎

  14. backend/optimizer/path/costsize.c, cost_memoize_rescan function ↩︎

  15. backend/utils/adt/selfuncs.c, estimate_num_groups function ↩︎

  16. backend/optimizer/path/costsize.c, calc_joinrel_size_estimate function ↩︎

  17. backend/optimizer/path/joinpath.c, match_unsorted_outer function ↩︎

  18. backend/optimizer/path/costsize.c, calc_joinrel_size_estimate function ↩︎

  19. backend/optimizer/path/costsize.c, final_cost_nestloop function ↩︎

  20. backend/optimizer/path/joinpath.c, consider_parallel_nestloop function ↩︎

22 哈希

22.1 哈希连接

22.1.1 一阶段哈希连接

哈希连接使用预建的哈希表搜索匹配的行。以下是包含这种连接的计划示例:

=> EXPLAIN (costs off) SELECT *
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no;
                QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Join
   Hash Cond: (tf.ticket_no = t.ticket_no)
   −> Seq Scan on ticket_flights tf
   −> Hash
       −> Seq Scan on tickets t
(5 rows)

在第一阶段,Hash Join 节点 1 调用 Hash 节点 2,后者从其子节点取出整个内层数据集并将其放入哈希表中。

哈希表存储成对的哈希键和值,通过键可以快速访问值;搜索时间不依赖于哈希表的大小,因为哈希键或多或少均匀地分布在有限数量的桶之间。给定一个键,其所属的桶由哈希键的哈希函数决定;由于桶的数量始终是 2 的幂,只需取计算值的所需位数即可。

如缓冲区缓存一样,这种实现使用了一个可动态扩展的哈希表,通过链解决哈希冲突。3

在连接操作的第一阶段,会扫描内层数据集,并针对每一行计算哈希函数。连接条件 (Hash Cond) 中引用的列作为哈希键,而哈希表本身存储了内层数据集中所有的查询字段。

如果整个哈希表可以容纳在 RAM 中v. 13,那么哈希连接最为高效,因为在这种情况下,执行器能够在一个批次内处理数据。所分配的内存块大小受到 work_mem4MB × hash_mem_multiplier1.0 的限制。
22.1.1 一阶段哈希连接:插图 1
图 22.1

让我们运行 EXPLAIN ANALYZE 来查看有关查询内存使用情况的统计数据:

=> SET work_mem = '256MB';
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM bookings b
  JOIN tickets t ON b.book_ref = t.book_ref;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Join (actual rows=2949857 loops=1)
   Hash Cond: (t.book_ref = b.book_ref)
   −> Seq Scan on tickets t (actual rows=2949857 loops=1)
   −> Hash (actual rows=2111110 loops=1)
       Buckets: 4194304 Batches: 1 Memory Usage: 145986kB
       −> Seq Scan on bookings b (actual rows=2111110 loops=1)
(6 rows)

与以不同方式处理内层数据集和外层数据集的嵌套循环连接不同,哈希连接可以交换它们。较小的数据集通常用作内层数据集,因为这样生成的哈希表较小。

在此例中,整个表适合所分配的缓存:它大约需要 143MB (Memory Usgae) 并包含 4M = 2²² 个桶。因此,连接在一个阶段内完成 (Batches)。

但是,如果查询仅引用一列,那么哈希表将占用 111 MB:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT b.book_ref
FROM bookings b
  JOIN tickets t ON b.book_ref = t.book_ref;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Join (actual rows=2949857 loops=1)
   Hash Cond: (t.book_ref = b.book_ref)
   −> Index Only Scan using tickets_book_ref_idx on tickets t
       (actual rows=2949857 loops=1)
       Heap Fetches: 0
   −> Hash (actual rows=2111110 loops=1)
       Buckets: 4194304 Batches: 1 Memory Usage: 113172kB
       −> Seq Scan on bookings b (actual rows=2111110 loops=1)
(8 rows)
=> RESET work_mem;

这是避免在查询中引用多余字段的另外一个原因 (例如,如果你使用 * ,就会发生这种情况)。

选择的桶数应该保证当哈希表完全填满数据时,每个桶平均只容纳一行。更高的密度会增加哈希冲突的概率,导致搜索效率降低,而不太紧实的哈希表会占用太多内存。桶的预估数量会增加到最接近的 2 的幂次。4

(如果哈希表的预估大小超过了基于单行平均宽度的内存限制,将使用两阶段哈希)。

在哈希表完全构建之前,哈希连接无法返回结果。

在第二阶段 (此时哈希表已经构建完成),Hash Join 节点调用第二个子节点以获取外层数据集。对于每个扫描的行,都会在哈希表中搜索匹配项。这需要为包含在连接条件中的外层数据集的列计算哈希键。
22.1.1 一阶段哈希连接:插图 2
图 22.2

找到的匹配项返回给父节点。

成本估算。我们已经介绍了基数估算;由于它不依赖于连接方法,所以我现在将重点放在成本估算上面。

Hash 节点的成本由其子节点的总成本表示。它是一个虚拟数字,仅仅填充计划中的槽。5 所有实际估算都包含在 Hash Join 节点的成本中。6

此处是一个例子:

=> EXPLAIN (analyze, timing off, summary off)
SELECT * FROM flights f
  JOIN seats s ON s.aircraft_code = f.aircraft_code;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Join (cost=38.13..278507.28 rows=16518865 width=78)
   (actual rows=16518865 loops=1)
   Hash Cond: (f.aircraft_code = s.aircraft_code)
   −> Seq Scan on flights f (cost=0.00..4772.67 rows=214867 widt...
       (actual rows=214867 loops=1)
   −> Hash (cost=21.39..21.39 rows=1339 width=15)
       (actual rows=1339 loops=1)
       Buckets: 2048 Batches: 1 Memory Usage: 79kB
       −> Seq Scan on seats s (cost=0.00..21.39 rows=1339 width=15)
           (actual rows=1339 loops=1)
(10 rows)

连接的启动成本主要反映了创建哈希表的成本,包括以下部分:

  • 获取内层数据集的总成本,这是构建哈希表所需的

  • 对于内层数据集的每一行,计算所有包含在连接键中的列的哈希函数成本 (每次操作预估为 cpu_operator_cost0.0025)

  • 将所有内层数据集中的行插入到哈希表的成本 (每个插入的行预估为 cpu_tuple_cost0.01)

  • 获取外层数据集的启动成本,这是开始连接操作所需的

总成本包括启动成本和连接本身的成本,即:

  • 对于外层数据集的每一行,计算所有包含在连接键中的列的哈希函数成本 (cpu_operator_cost)

  • 重新检查连接条件的成本,这是为了解决可能的哈希冲突 (每检查一个操作符预估为 cpu_operator_cost)

  • 处理每个结果行的成本 (cpu_tuple_cost)

需要重新检查的次数是最难评估的。它是通过将外层数据集的行数乘以内层数据集的一部分 (存储在哈希表中) 计算而来的。为了评估这个比例,规划器必须考虑到数据分布可能是不均匀的。我将省略这些计算细节;7 在这个特定案例中,这个比例估计为 0.150112。

因此,查询的成本估算如下:

=> WITH cost(startup) AS (
  SELECT round((
    21.39 +
    current_setting('cpu_operator_cost')::real * 1339 +
    current_setting('cpu_tuple_cost')::real * 1339 +
    0.00
  )::numeric, 2)
)
SELECT startup,
  startup + round((
    4772.67 +
    current_setting('cpu_operator_cost')::real * 214867 +
    current_setting('cpu_operator_cost')::real * 214867 * 1339 *
      0.150112 +
    current_setting('cpu_tuple_cost')::real * 16518865
  )::numeric, 2) AS total
FROM cost;
 startup | 	 total
−−−−−−−−−+−−−−−−−−−−−
   38.13 | 278507.26
(1 row)

此处是依赖图:

22.1.1 一阶段哈希连接:插图 3
图 22.3

22.1.2 两阶段哈希连接

如果规划器的评估结果表明哈希表不适合所分配的内存,那么内层数据集将被分成若干批次,分别处理。批次数量 (就像桶的数量一样) 总是 2 的幂次;使用哪个批次由哈希键的相应位数决定。8

任何两个匹配的行均属于同一个批次:放入不同批次的行不能有相同的哈希码。

所有批次都包含相同数量的哈希键。如果数据分布均匀,批次的大小也将大致相同。规划器可以通过选择合适的批次数量来控制内存消耗。9

在第一阶段,执行器扫描内层数据集以构建哈希表。如果扫描的行属于第一批次,则将其添加到哈希表并保存在 RAM 中。否则,它将被写入临时文件 (每个批次都有一个单独的文件)。10

会话可以存储在磁盘上的临时文件总量受 temp_file_limit-1 参数的限制 (临时表不包括在此限制中)。一旦会话达到此限制,查询便会中止。
22.1.2 两阶段哈希连接:插图 4
图 22.4

第二阶段,执行器扫描外层数据集。如果行属于第一批次,它将与包含内层数据集第一批次行的哈希表进行匹配 (无论如何,其他批次中都不会有匹配)。

如果行属于不同的批次,它将存储在一个临时文件中,这个临时文件再次为每个批次单独创建。因此,N 个批次可以使用 2(N − 1) 个文件 (如果某些批次是空的,则更少)。

一旦第二阶段完成,为哈希表分配的内存被释放。此时,我们已经得到了其中一个批次的连接结果。
22.1.2 两阶段哈希连接:插图 5
图 22.5

对于保存在磁盘上的每个批次,都会重复这两个阶段:内层数据集中的行从临时文件转移到哈希表;然后从另一个临时文件中读取外层数据集中与同一批次相关的行,并与该哈希表进行匹配。一旦处理完毕,临时文件就会被删除。
22.1.2 两阶段哈希连接:插图 6
图 22.6

与一阶段连接的类似输出不同,两阶段的 EXPLAIN 命令的输出会包含多个批次。如果使用 BUFFERS 选项运行,这个命令还会显示磁盘访问的统计数据:

=> EXPLAIN (analyze, buffers, costs off, timing off, summary off)
SELECT *
FROM bookings b
  JOIN tickets t ON b.book_ref = t.book_ref;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Join (actual rows=2949857 loops=1)
   Hash Cond: (t.book_ref = b.book_ref)
   Buffers: shared hit=7236 read=55626, temp read=55126
   written=55126
   −> Seq Scan on tickets t (actual rows=2949857 loops=1)
       Buffers: shared read=49415
   −> Hash (actual rows=2111110 loops=1)
       Buckets: 65536 Batches: 64 Memory Usage: 2277kB
       Buffers: shared hit=7236 read=6211, temp written=10858
       −> Seq Scan on bookings b (actual rows=2111110 loops=1)
           Buffers: shared hit=7236 read=6211
(11 rows)

我已经在上面展示了这个查询,并增加了 work_mem 设置。4MB 的默认值太小,整个哈希表无法全部放入 RAM 中;在本例中,数据被分成 64 个批次,并且哈希表使用了 64K = 216 个桶。随着哈希表的构建 (Hash 节点) ,数据被写入临时文件 (temp written);在连接阶段 (Hash Join 节点),临时文件被读取和写入 (temp read, written)。

要收集更多关于临时文件的统计数据,你可以将 log_temp_files-1 参数设为零。然后服务器日志将列出所有的临时文件和其大小 (在删除临时文件时列出)。

22.1.3 动态调整

计划的事件流程可能会因为两个问题而受到干扰:不准确的统计信息和不均匀的数据分布。

如果连接键列中的值分布不均,那么不同的批次将具有不同的大小。

如果某个批次 (第一个批次除外) 变得过大,其所有行都必须写入磁盘,然后再从磁盘读取。外层数据集会造成大部分问题,因为它通常更大。因此,如果外层数据集的 MCV 上有常规的、非多元统计信息 (也就是说,外层数据集由一个表表示,并且连接是通过单列执行的),具有与 MCV 相对应的哈希码的行被认为是第一批次的一部分。11 这种技术 (称为倾斜优化) 可以在一定程度上减少两阶段连接的 I/O 开销。

由于这两个因素,一些 (或全部) 批次的大小可能会超过预估值。然后,相应的哈希表将不适合所分配的内存块,并超过定义的限制。

因此,如果正在构建的哈希表变得太大,批次的数量会即时增加 (翻倍)。每个批次实际上被分成两个新的批次:大约一半的行 (假设分布是均匀的) 留在哈希表中,而另一半被保存到一个新的临时文件中。12

即使最初规划的是一阶段连接,这种拆分也可能会发生。事实上,一阶段连接和两阶段连接使用同一个算法实现,由相同的代码实现;我在这里单独提出它们,仅仅是为了让叙述更加流畅。

批次数量无法减少。如果事实证明规划器高估了数据大小,批次也不会被合并在一起。

在分布不均的情况下,增加批次数量可能无济于事。例如,如果在所有行中,键列都包含一个相同的值,那么它们将被放入同一批次中,因为哈希函数将一次又一次返回相同的值。不幸的是,在这种情况下,哈希表将继续增长,不管施加了什么限制。

理论上,这个问题可以通过多阶段连接来解决,它会对批次执行部分扫描,但尚不支持。

为了演示批次数量的动态增加,我们得先执行一些操作:

=> CREATE TABLE bookings_copy (LIKE bookings INCLUDING INDEXES)
WITH (autovacuum_enabled = off);
=> INSERT INTO bookings_copy SELECT * FROM bookings;
INSERT 0 2111110
=> DELETE FROM bookings_copy WHERE random() < 0.9;
DELETE 1899232
=> ANALYZE bookings_copy;
=> INSERT INTO bookings_copy SELECT * FROM bookings
ON CONFLICT DO NOTHING;
INSERT 0 1899232
=> SELECT reltuples FROM pg_class WHERE relname = 'bookings_copy';
 reltuples
−−−−−−−−−−−
    211878
(1 row)

现在我们得到一个名为 bookings_copy 的新表。它是 bookings 表的精确副本,但规划器对于表中行数低估了十倍。如果为另一个连接操作产生的行集生成哈希表,可能会出现类似的情况,因此没有可靠的统计信息可用。

这种错误计算使规划器认为 8 个桶就足够了,但是在执行连接时,这个数字增长到了 32:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM bookings_copy b
  JOIN tickets t ON b.book_ref = t.book_ref;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Join (actual rows=2949857 loops=1)
   Hash Cond: (t.book_ref = b.book_ref)
   −> Seq Scan on tickets t (actual rows=2949857 loops=1)
   −> Hash (actual rows=2111110 loops=1)
       Buckets: 65536 (originally 65536) Batches: 32 (originally 8)
        Memory Usage: 4040kB
       −> Seq Scan on bookings_copy b (actual rows=2111110 loops=1)
(7 rows)

成本估算。我已经使用这个示例演示了一阶段连接的成本估算,但现在我将把可用内存的大小减少到最小,因此规划器将不得不使用两个批次。这增加了连接的成本:

=> SET work_mem = '64kB';
=> EXPLAIN (analyze, timing off, summary off)
SELECT * FROM flights f
  JOIN seats s ON s.aircraft_code = f.aircraft_code;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Join (cost=45.13..283139.28 rows=16518865 width=78)
   (actual rows=16518865 loops=1)
   Hash Cond: (f.aircraft_code = s.aircraft_code)
   −> Seq Scan on flights f (cost=0.00..4772.67 rows=214867 widt...
        (actual rows=214867 loops=1)
  −> Hash (cost=21.39..21.39 rows=1339 width=15)
        (actual rows=1339 loops=1)
        Buckets: 2048 Batches: 2 Memory Usage: 55kB
        −> Seq Scan on seats s (cost=0.00..21.39 rows=1339 width=15)
             (actual rows=1339 loops=1)
(10 rows)
=> RESET work_mem;

第二阶段的成本是将行溢出到临时文件并从这些文件中读取而产生的。

两阶段连接的启动成本基于一阶段连接的启动成本,该成本增加了将所需数量的页面写入磁盘的预估成本,以存储内层数据集所有行的所有必要字段。13 尽管在构建哈希表时第一批次不写入磁盘,但估算没有考虑到这一点,因此不依赖于批次的数量。

总成本包括一阶段连接的总成本和读取之前存储在磁盘上的内层数据集的预估成本,以及读取和写入外层数据集的预估成本。

写入和读取都按每页花费 seq_page_cost 预估,因为假定 I/O 操作是顺序的。

在此特例下,内层数据集所需的页数预估为 7,而外层数据集的数据预估适合 2309 页。将这些估算值与上面计算的一阶段连接的成本相加之后,我们得到了与查询计划中所示的相同数字:

=> SELECT 38.13 + -- startup cost of a one-pass join
  current_setting('seq_page_cost')::real * 7
  AS startup,
278507.28 + -- total cost of a one-pass join
  current_setting('seq_page_cost')::real * 2 * (7 + 2309)
  AS total;
 startup | 	 total
−−−−−−−−−+−−−−−−−−−−−
   45.13 | 283139.28
(1 row)

因此,如果内存不足,连接将分两个阶段执行并且效率变得更低。因此,遵循以下几点很重要:

  • 查询必须以排除哈希表中多余字段的方式组成。

  • 在构建哈希表时,规划器必须选择两组行中较小的一组。

22.1.4 在并行计划中使用哈希连接v. 9.6

上面描述的哈希连接算法也可以用于并行计划。首先,若干个并行进程各自独立地为内层数据集构建它们自己的 (完全相同的) 哈希表;然后他们开始并行处理外层数据集。此处的性能提升是由于每个进程只扫描其自己份额的外层数据集的行。

以下计划使用常规的一阶段哈希连接:

=> SET work_mem = '128MB';

=> SET enable_parallel_hash = off;

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT count(*)
FROM bookings b
  JOIN tickets t ON t.book_ref = b.book_ref;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (actual rows=1 loops=1)
   −> Gather (actual rows=3 loops=1)
       Workers Planned: 2
       Workers Launched: 2
       −> Partial Aggregate (actual rows=1 loops=3)
           −> Hash Join (actual rows=983286 loops=3)
               Hash Cond: (t.book_ref = b.book_ref)
               −> Parallel Index Only Scan using tickets_book_ref...
                   Heap Fetches: 0
               −> Hash (actual rows=2111110 loops=3)
                   Buckets: 4194304 Batches: 1 Memory Usage:
                   113172kB
                   −> Seq Scan on bookings b (actual rows=2111110...
(13 rows)
=> RESET enable_parallel_hash;

此处每个进程对 bookings 表进行哈希处理,然后通过 Parallel Index Only Scan 节点检索其自己份额的外层数据集,并将这些行与哈希表进行匹配。

哈希表内存限制分别应用于每个并行进程,所以为此分配的内存总大小将比计划 (Memoey Usage) 中显示的大三倍。

22.1.5 并行一阶段哈希连接v. 11

尽管常规的哈希连接在并行计划中效率很高 (尤其是对于较小的内层数据集,并行处理对其意义不大),但更大的数据集更适合由特殊的并行哈希连接算法处理。

并行算法的一个重要区别是,哈希表是在共享内存中创建的,这个内存是动态分配的,所有参与连接操作的并行进程都可以访问。并行处理并不是创建多个独立的哈希表,而是建立了一个共同的哈希表,它使用所有参与进程的专用总内存量。这增加了一阶段完成连接的可能性。

在第一个阶段 (在计划中由 Parallel Hash 节点表示),所有并行进程并行访问内层数据集,建立了一个共同的哈希表。14
22.1.5并行一阶段哈希连接:插图 7
图 22.7

要从此处继续进行,每个并行进程必须完成其在第一阶段处理的份额。15

在第二阶段 (Parallel Hash Join 节点),进程再次并行运行,将它们外层数据集的份额与此时已经构建好的哈希表进行匹配。16
22.1.5并行一阶段哈希连接:插图 8
图 22.8

此处是一个此类计划的例子:

=> SET work_mem = '64MB';
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT count(*)
FROM bookings b
  JOIN tickets t ON t.book_ref = b.book_ref;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (actual rows=1 loops=1)
   −> Gather (actual rows=3 loops=1)
       Workers Planned: 2
       Workers Launched: 2
       −> Partial Aggregate (actual rows=1 loops=3)
           −> Parallel Hash Join (actual rows=983286 loops=3)
           Hash Cond: (t.book_ref = b.book_ref)
           −> Parallel Index Only Scan using tickets_book_ref...
               Heap Fetches: 0
           −> Parallel Hash (actual rows=703703 loops=3)
               Buckets: 4194304 Batches: 1 Memory Usage:
               115392kB
               −> Parallel Seq Scan on bookings b (actual row...
(13 rows)
=> RESET work_mem;

这与我在上一章节中展示的查询相同,但当时并行哈希连接通过 enable_parallel_hash 参数关闭了。

虽然与之前演示的常规哈希连接相比,可用内存减少了一半,但操作仍然一阶段完成,因为它使用了分配给所有并行进程的内存 (Memory Usage)。哈希表变得稍微大一些,但由于现在我们只有这一个哈希表,总内存使用量减少了。

22.1.6 并行两阶段哈希连接v. 11

所有并行进程的内存合并起来可能仍然不足以容纳整个哈希表。这可能在计划阶段或稍后在查询执行期间变得明显。在这种情况下,应用的两阶段连接算法与我们迄今为止所看到的有很大不同。

这个算法的主要区别在于它创建了几个较小的哈希表,而不是一个大的哈希表。每个进程都有其自己的表并独立处理自己的批次。(但由于独立的哈希表仍然位于共享内存中,任何进程都可以访问这些表中的任何一个) 如果规划显示将需要不止一个批次,17 那么会立即为每个进程构建一个独立的哈希表。如果决定是在执行阶段做出的,则重建哈希表。18

因此,在第一阶段,进程并行扫描内层数据集,将其分成批次并将它们写入临时文件中。19 由于每个进程只读取自己份额的内层数据集,因此它们中的任何一个都不会为任何批次 (即使是第一个批次) 创建完整的哈希表。任何批次的完整数据集仅累积在所有并行进程以同步方式写入的文件中。20 因此,与非并行和一阶段并行版本的算法不同,并行两阶段哈希连接将所有批次写入磁盘,包括第一个批次。
22.1.6并行两阶段哈希连接:插图 9
图 22.9

一旦所有进程都完成了内层数据集的哈希计算,第二阶段就开始了。21

如果使用的是非并行版本的算法,属于第一批次的外层数据集将立即与哈希表匹配。但在并行版本的情况下,内存中还没有哈希表,所以工作进程独立处理批次。因此,第二阶段从外层数据集的并行扫描开始,将其分配到批次中,每个批次被写入到一个单独的临时文件中。22 扫描的行不会插入到哈希表中 (就像在第一阶段发生的那样),因此批次的数量永远不会增加。

一旦所有进程都完成了对外层数据集的扫描,在磁盘上便有了 2N 个临时文件;它们包含内层数据集和外层数据集的批次。
22.1.6并行两阶段哈希连接:插图 10
图 22.10

然后每个进程选择其中一个批次并执行连接:它将内层数据集加载到位于内存中的哈希表中,然后扫描外层数据集,并将它们与哈希表进行匹配。当批次连接完成时,进程选择下一个尚未处理的批次。23
22.1.6并行两阶段哈希连接:插图 11
图 22.11

如果没有更多未处理的批次,已完成自己批次的进程开始处理当前正由其他进程处理的批次之一;这种并发处理是可能的,因为所有哈希表都位于共享内存中。
22.1.6并行两阶段哈希连接:插图 12
图 22.12

这种方法比对所有进程使用单个大的哈希表更有效:设置并行处理更容易,且同步的成本更低。

22.1.7 调整

哈希连接算法支持任何类型的连接:除了内连接,它还可以处理左、右和全外连接,以及半连接和反连接。但是正如我之前提到的,连接条件仅限于等值操作符。

在处理嵌套循环连接时,我们已经观察到其中一些操作。这是右外连接的示例:

=> EXPLAIN (costs off) SELECT *
FROM bookings b
  LEFT OUTER JOIN tickets t ON t.book_ref = b.book_ref;
               QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Right Join
   Hash Cond: (t.book_ref = b.book_ref)
   −> Seq Scan on tickets t
   −> Hash
       −> Seq Scan on bookings b
(5 rows)

请注意,SQL 查询中指定的逻辑左外连接在执行计划中被转换为右外连接的物理操作。

在逻辑层面,bookings 是外表 (构成连接操作的左侧),而 tickets 表是内表。因此,没有 tickets 的 bookings 也必须包含在连接结果中。

在物理层面,内层数据集和外层数据集是基于连接成本而非它们在查询文本中的位置来分配的。通常情况下,这意味着拥有较小哈希表的数据集将被用作为内层数据集。这正是在此处发生的事情:bookings 表是内层数据集,左外连接被改为右外连接。

反之亦然,如果查询指定右外连接 (以显示不与任何 bookings 相关的 tickets),那么执行计划使用左外连接:

=> EXPLAIN (costs off) SELECT *
FROM bookings b
  RIGHT OUTER JOIN tickets t ON t.book_ref = b.book_ref;
               QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Left Join
   Hash Cond: (t.book_ref = b.book_ref)
   −> Seq Scan on tickets t
   −> Hash
       −> Seq Scan on bookings b
(5 rows)

为了完整地展示,我将提供一个包含全外连接的查询计划示例:

=> EXPLAIN (costs off) SELECT *
FROM bookings b
  FULL OUTER JOIN tickets t ON t.book_ref = b.book_ref;
               QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Hash Full Join
   Hash Cond: (t.book_ref = b.book_ref)
   −> Seq Scan on tickets t
   −> Hash
       −> Seq Scan on bookings b
(5 rows)

目前,并行哈希连接不支持右外连接和全外连接。24

请注意,下一个示例使用 bookings 表作为外层数据集,但如果支持的话,规划器会更倾向于使用右外连接。

=> EXPLAIN (costs off) SELECT sum(b.total_amount)
FROM bookings b
  LEFT OUTER JOIN tickets t ON t.book_ref = b.book_ref;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate
   −> Gather
      Workers Planned: 2
      −> Partial Aggregate
          −> Parallel Hash Left Join
              Hash Cond: (b.book_ref = t.book_ref)
              −> Parallel Seq Scan on bookings b
              −> Parallel Hash
                  −> Parallel Index Only Scan using tickets_book...
(9 rows)

22.2 非重复值与分组

用于聚合分组和去重的算法与连接算法非常相似。它们可使用的一种方法是在所需列上构建哈希表。只有当哈希表中尚不存在这些值时,这些值才被加入到哈希表中。结果是,哈希表累积了所有不同的值。

执行哈希聚合的节点称为 HashAggregate。25

让我们考虑一些可能需要这个节点的情况。

每个旅行类别的座位数 (GROUP BY):

=> EXPLAIN (costs off) SELECT fare_conditions, count(*)
FROM seats
GROUP BY fare_conditions;
          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 HashAggregate
   Group Key: fare_conditions
   −> Seq Scan on seats
(3 rows)

旅行类别列表 (DISTINCT):

=> EXPLAIN (costs off) SELECT DISTINCT fare_conditions
FROM seats;
          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 HashAggregate
   Group Key: fare_conditions
   −> Seq Scan on seats
(3 rows)

旅行类别再加上一个值 (UNION):

=> EXPLAIN (costs off) SELECT fare_conditions
FROM seats
UNION
SELECT NULL;
             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 HashAggregate
   Group Key: seats.fare_conditions
   −> Append
       −> Seq Scan on seats
       −> Result
(5 rows)

Append 节点将两个数据集组合在一起,但不会删除任何重复项,这些重复项不应出现在 UNION 结果中。它们必须由 HashAggregate 节点单独删除。

为哈希表分配的内存块受到 work_mem4MB × hash_mem_multiplier1.0 的限制,就像哈希连接一样。

如果哈希表适合分配的内存,那么聚合使用单个批次:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT DISTINCT amount FROM ticket_flights;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 HashAggregate (actual rows=338 loops=1)
   Group Key: amount
   Batches: 1 Memory Usage: 61kB
   −> Seq Scan on ticket_flights (actual rows=8391852 loops=1)
(4 rows)

在 amounts 字段中没有那么多不同的值,所以哈希表只占用了 61 kB (Memory Usage)。

一旦哈希表填满了所分配的内存,所有后续值都会溢出到临时文件中v. 13,并基于其哈希值的若干位进行分区。分区数量是 2 的幂,选择分区的方式是使每个分区的哈希表都适合所分配的内存。当然,评估的准确性取决于所收集的统计信息的质量,因此接收到的数字乘以 1.5,以进一步减小分区大小并提高每个分区一阶段处理完成的机会。26

一旦整个数据集被扫描完毕,节点返回那些成功进入哈希表的值的聚合结果。

然后清除哈希表,上一阶段保存到临时文件中的每个分区被扫描和处理,就像任何其他数据集一样。如果哈希表仍然超出分配的内存,将要溢出的行将再次被分区并写入磁盘以供进一步处理。

为了避免过多 I/O,两阶段哈希连接算法将 MCVS 移入第一批次。然而,聚合不需要这种优化:适合分配内存的那些行不会被分成分区,并且 MCVS 很可能在足够早的时候出现,从而进入 RAM。

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT DISTINCT flight_id FROM ticket_flights;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 HashAggregate (actual rows=150588 loops=1)
   Group Key: flight_id
   Batches: 5 Memory Usage: 4145kB Disk Usage: 98184kB
   −> Seq Scan on ticket_flights (actual rows=8391852 loops=1)
(4 rows)

在这个例子中,不同 ID 的数量相对较多,所以哈希表不适合所分配的内存。执行查询使用了五个批次:一个批次用于初始数据集,四个批次用于写入磁盘的分区。


  1. backend/executor/nodeHashjoin.c ↩︎

  2. backend/executor/nodeHash.c ↩︎

  3. backend/utils/hash/dynahash.c ↩︎

  4. backend/executor/nodeHash.c, ExecChooseHashTableSize function ↩︎

  5. backend/optimizer/plan/createplan.c, create_hashjoin_plan function ↩︎

  6. backend/optimizer/path/costsize.c, initial_cost_hashjoin and final_cost_hashjoin functions ↩︎

  7. backend/utils/adt/selfuncs.c, estimate_hash_bucket_stats function ↩︎

  8. backend/executor/nodeHash.c, ExecHashGetBucketAndBatch function ↩︎

  9. backend/executor/nodeHash.c, ExecChooseHashTableSize function ↩︎

  10. backend/executor/nodeHash.c, ExecHashTableInsert function ↩︎

  11. backend/executor/nodeHash.c, ExecHashBuildSkewHash function ↩︎

  12. backend/executor/nodeHash.c, ExecHashIncreaseNumBatches function ↩︎

  13. backend/optimizer/path/costsize.c, page_size function ↩︎

  14. backend/executor/nodeHash.c, MultiExecParallelHash function ↩︎

  15. backend/storage/ipc/barrier.c ↩︎

  16. backend/executor/nodeHashjoin.c, ExecParallelHashJoin function ↩︎

  17. backend/executor/nodeHash.c, ExecChooseHashTableSize function ↩︎

  18. backend/executor/nodeHash.c, ExecParallelHashIncreaseNumBatches function ↩︎

  19. backend/executor/nodeHash.c, MultiExecParallelHash function ↩︎

  20. backend/utils/sort/sharedtuplestore.c ↩︎

  21. backend/executor/nodeHashjoin.c, ExecParallelHashJoin function ↩︎

  22. backend/executor/nodeHashjoin.c, ExecParallelHashJoinPartitionOuter function ↩︎

  23. backend/executor/nodeHashjoin.c, ExecParallelHashJoinNewBatch function ↩︎

  24. commitfest.postgresql.org/33/2903 ↩︎

  25. backend/executor/nodeAgg.c ↩︎

  26. backend/executor/nodeAgg.c, hash_choose_num_partitions function ↩︎

23 排序与归并

23.1 归并连接

归并连接处理按连接键排序的数据集,并返回以类似方式排序后的结果。输入数据集可能在索引扫描后预排序;否则,执行器必须在真正开始归并之前对它们进行排序。1

23.1.1 归并排序数据集

让我们看一个归并连接的例子;在执行计划中由 Merge Join 节点表示:2

=> EXPLAIN (costs off) SELECT *
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
ORDER BY t.ticket_no;
                              QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Merge Join
   Merge Cond: (t.ticket_no = tf.ticket_no)
   −> Index Scan using tickets_pkey on tickets t
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
(4 rows)

优化器更喜欢这种连接方式,因为它按照 ORDER BY 子句定义的方式返回排序后的结果。在选择计划时,优化器会注意到数据集的排序顺序,并且除非确实需要,否则不会执行任何排序。例如,如果归并连接生成的数据集已经具有合适的排序顺序,那么它可以直接在之后的归并连接中使用:

=> EXPLAIN (costs off) SELECT *
FROM tickets t
  JOIN ticket_flights tf ON t.ticket_no = tf.ticket_no
  JOIN boarding_passes bp ON bp.ticket_no = tf.ticket_no
                         AND bp.flight_id = tf.flight_id
ORDER BY t.ticket_no;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Merge Join
   Merge Cond: (tf.ticket_no = t.ticket_no)
   −> Merge Join
       Merge Cond: ((tf.ticket_no = bp.ticket_no) AND (tf.flight_...
       −> Index Scan using ticket_flights_pkey on ticket_flights tf
       −> Index Scan using boarding_passes_pkey on boarding_passe...
   −> Index Scan using tickets_pkey on tickets t
(7 rows)

首先要连接的表是 ticket_flights 和 boarding_passes;它们都有一个复合主键 (ticket_no, flight_id),结果按这两列排序。然后产生的结果集与按 ticket_no 列排序的 tickets 表进行连接。

连接时只需对两个数据集进行一次遍历,并且不占用任何额外内存。它使用两个指针指向内层数据集和外层数据集的当前行 (最初是第一行)。

如果当前行的键值不匹配,其中一个指针 (引用键值较小的行) 将前进到下一行,直到找到匹配项。连接行将返回给上层节点,然后内层结果集的指针前进一位。操作持续进行,直到其中一个数据集结束。

此算法可以处理内层数据集的重复项,但外层数据集也可以包含它们。因此,算法需要改进:如果外指针前进后键仍然相同,则内指针回到第一个匹配行。因此,外层数据集的每一行将与内层数据集中具有相同键值的所有行匹配。3

对于外连接,算法稍作调整,但仍然基于相同的原则。

归并连接条件只能使用等值操作符,这意味着只支持等值连接 (尽管对其他条件类型的支持也在进行中)。4

成本估算。让我们仔细看看之前的例子:

=> EXPLAIN SELECT *
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
ORDER BY t.ticket_no;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Merge Join (cost=0.99..822355.54 rows=8391852 width=136)
   Merge Cond: (t.ticket_no = tf.ticket_no)
   −> Index Scan using tickets_pkey on tickets t
       (cost=0.43..139110.29 rows=2949857 width=104)
   −> Index Scan using ticket_flights_pkey on ticket_flights tf
       (cost=0.56..570972.46 rows=8391852 width=32)
(6 rows)

连接的启动成本至少包括所有子节点的启动成本。

通常,可能需要在找到第一个匹配项之前扫描外层或内层数据集的一部分。可以通过比较 (基于直方图) 两个数据集中最小的连接键来估算这个比例。5 但在这个特定的案例中,两个表中的 ticket_no 是相同的。

总成本包括从子节点获取数据的成本和计算成本。

由于连接算法在其中一个数据集结束后立即停止 (当然,除非执行外连接),因此另一个数据集可能只被部分扫描。为了评估扫描部分的大小,我们可以比较两组数据集中的最大键值。在此示例中,两个数据集都将被完整读取,因此连接的总成本包括两个子节点的总成本之和。

此外,如果存在任何重复项,内层数据集的一些行可能会被多次扫描。重复扫描的预估次数等于连接结果的基数与内层数据集的基数之间的差值。6 在这个查询中,这些基数是相同的,这意味着数据集中不包含重复项。

算法比较两个数据集的连接键。单次比较的成本以 cpu_operator_cost0.0025 进行估算,而预估的比较次数可以取为两个数据集的行数之和 (加上由于重复项导致的重复读取次数)。结果中包含的每一行的处理成本,如往常一样,以 cpu_tuple_cost0.01 进行估算。

因此,在这个例子中,连接的成本如下估计:7

=> SELECT 0.43 + 0.56 AS startup,
  round((
    139110.29 + 570972.46 +
    current_setting('cpu_tuple_cost')::real * 8391852 +
    current_setting('cpu_operator_cost')::real * (2949857 + 8391852)
  )::numeric, 2) AS total;
 startup | 	 total
−−−−−−−−−+−−−−−−−−−−−
    0.99 | 822355.54
(1 row)

23.1.2 并行模式v. 9.6

虽然归并连接没有并行模式,但它仍然可以在并行计划中使用。8

外层数据集可以由多个工作进程并行扫描,但内层数据集总是被每个工作进程完整扫描。

由于并行哈希连接几乎总是成本更低,我将暂时关闭它:

=> SET enable_hashjoin = off;

以下是使用归并连接的并行计划示例:

=> EXPLAIN (costs off)
SELECT count(*), sum(tf.amount)
FROM tickets t
  JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate
   −> Gather
       Workers Planned: 2
       −> Partial Aggregate
           −> Merge Join
               Merge Cond: (tf.ticket_no = t.ticket_no)
               −> Parallel Index Scan using ticket_flights_pkey o...
               −> Index Only Scan using tickets_pkey on tickets t
(8 rows)

在并行计划中不允许使用全外归并连接和右外归并连接。

23.1.3 调整

归并连接算法可用于任何类型的连接。唯一的限制是全外连接和右外连接的连接条件必须包含归并兼容的表达式 ("outer-column equals inner-column" 或 “column equals constant")。9 内连接和左外连接仅通过不相关的条件过滤连接结果,但对于全外连接和右外连接,这种过滤是不适用的。

以下是使用归并算法的全外连接示例:

=> EXPLAIN (costs off) SELECT *
FROM tickets t
  FULL JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
ORDER BY t.ticket_no;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Sort
   Sort Key: t.ticket_no
   −> Merge Full Join
       Merge Cond: (t.ticket_no = tf.ticket_no)
       −> Index Scan using tickets_pkey on tickets t
       −> Index Scan using ticket_flights_pkey on ticket_flights tf
(6 rows)

内连接和左外归并连接保留排序顺序。但是,全外连接和右外连接不能保证这一点,因为空值可以楔入外层数据集的有序值之间,这会破坏排序顺序。10 为了恢复所需的顺序,规划器在此处引入了 Sort 节点。当然,这增加了计划的成本,使哈希连接更具吸引力,所以规划器只是因为当前禁用了哈希连接才选择了这个计划。

但是下一个例子不能没有哈希连接:嵌套循环根本不允许全外连接,而归并连接因为不支持的连接条件而不能使用。因此,不管 enable_hashjoin 参数值如何,都会使用哈希连接:

=> EXPLAIN (costs off) SELECT *
FROM tickets t
  FULL JOIN ticket_flights tf ON tf.ticket_no = t.ticket_no
                             AND tf.amount > 0
ORDER BY t.ticket_no;
                  QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Sort
   Sort Key: t.ticket_no
   −> Hash Full Join
       Hash Cond: (tf.ticket_no = t.ticket_no)
       Join Filter: (tf.amount > '0'::numeric)
       −> Seq Scan on ticket_flights tf
       −> Hash
           −> Seq Scan on tickets t
(8 rows)

让我们恢复之前禁止使用哈希连接的能力:

=> RESET enable_hashjoin;

23.2 排序

如果其中一个数据集 (或可能两个数据集) 没有按连接键排序,那么在连接操作开始之前必须重新排序。这个排序操作在计划中由 Sort 节点表示:11

=> EXPLAIN (costs off)
SELECT * FROM flights f
  JOIN airports_data dep ON f.departure_airport = dep.airport_code
ORDER BY dep.airport_code;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Merge Join
   Merge Cond: (f.departure_airport = dep.airport_code)
   −> Sort
       Sort Key: f.departure_airport
       −> Seq Scan on flights f
   −> Sort
       Sort Key: dep.airport_code
       −> Seq Scan on airports_data dep
(8 rows)

如果在常规查询和窗口函数中指定了 ORDER BY 子句,这种排序也可以在连接上下文之外应用:

=> EXPLAIN (costs off)
SELECT flight_id,
  row_number() OVER (PARTITION BY flight_no ORDER BY flight_id)
FROM flights f;
              QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 WindowAgg
   −> Sort
       Sort Key: flight_no, flight_id
       −> Seq Scan on flights f
(4 rows)

此处,WindowAgg 节点 12 在数据集上计算窗口函数,该数据集已由 Sort 节点预排序。

规划器在其工具箱中有几种排序方法。我已经展示的示例使用了其中的两种 (Sort Method)。像往常一样,可以通过 EXPLAIN ANALYZE 命令显示这些详细信息:

=> EXPLAIN (analyze,costs off,timing off,summary off)
SELECT * FROM flights f
  JOIN airports_data dep ON f.departure_airport = dep.airport_code
ORDER BY dep.airport_code;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Merge Join (actual rows=214867 loops=1)
   Merge Cond: (f.departure_airport = dep.airport_code)
   −> Sort (actual rows=214867 loops=1)
       Sort Key: f.departure_airport
       Sort Method: external merge Disk: 17136kB
       −> Seq Scan on flights f (actual rows=214867 loops=1)
   −> Sort (actual rows=104 loops=1)
       Sort Key: dep.airport_code
       Sort Method: quicksort Memory: 52kB
       −> Seq Scan on airports_data dep (actual rows=104 loops=1)
(10 rows)

23.2.1 快排

如果待排序的数据集适合 work_mem4MB 块,则使用经典的快排方法。该算法在所有的教科书上都有介绍,此处不再过多描述。

至于实现,排序是由一个专用组件 13 执行的,它根据可用的内存数量和一些其他因素选择最合适的算法。

成本估算。让我们看看小表是如何排序的。在这种情况下,使用快排算法在内存中进行排序:

=> EXPLAIN SELECT *
FROM airports_data
ORDER BY airport_code;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Sort (cost=7.52..7.78 rows=104 width=145)
   Sort Key: airport_code
   −> Seq Scan on airports_data (cost=0.00..4.04 rows=104 width=...
(3 rows)

已知对 n 个值进行排序的计算复杂度为 O(nlog⁡2n)O(n \log_2 n)。单次比较操作估算为 cpu_operator_cost0.0025 值的两倍。由于在检索结果之前必须对整个数据集进行扫描和排序,因此排序的启动成本包括子节点的总成本和比较操作所产生的所有成本。

排序的总成本还包括返回每行的处理成本,按 cpu_operator_cost 进行估算 (而不是常规的 cpu_tuple_cost 值,因为 Sort 节点产生的开销微不足道)。14

对于这个例子,成本如下计算:

=> WITH costs(startup) AS (
  SELECT 4.04 + round((
    current_setting('cpu_operator_cost')::real * 2 *
      104 * log(2, 104)
  )::numeric, 2)
)
SELECT startup,
  startup + round((
    current_setting('cpu_operator_cost')::real * 104
	)::numeric, 2) AS total
FROM costs;
 startup | total
−−−−−−−−−+−−−−−−−
    7.52 | 7.78
(1 row)

23.2.2 Top-N 堆排序

如果数据集只需要部分排序 (由 LIMIT 子句定义),则可以使用堆排序方法 (在计划中显式为 top-N heapsort)。更准确地说,如果排序至少将行数减少一半,或者如果分配的内存不能容纳整个输入数据集 (而输出数据集适合),则使用此算法。

=> EXPLAIN (analyze, timing off, summary off)
SELECT * FROM seats
ORDER BY seat_no LIMIT 100;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Limit (cost=72.57..72.82 rows=100 width=15)
   (actual rows=100 loops=1)
   −> Sort (cost=72.57..75.91 rows=1339 width=15)
       (actual rows=100 loops=1)
       Sort Key: seat_no
       Sort Method: top−N heapsort Memory: 33kB
       −> Seq Scan on seats (cost=0.00..21.39 rows=1339 width=15)
           (actual rows=1339 loops=1)
(8 rows)

为了从 n 个值中找到 k 个最大 (或最小) 值,执行器将前 k 行添加到称为堆的数据结构中。然后将剩余的行逐一添加,并在每次迭代后从堆中删除最小 (或最大) 值。处理完所有行后,堆就包含了 k 个被寻找的值。

这里的堆术语表示一种众所周知的数据结构,与经常被同名引用的数据库表没有任何关系。

成本估算。此算法的计算复杂度预估为 O(nlog⁡2k)O(n \log_2 k),但与快排算法相比,每个特定操作的成本更高。因此,公式使用 nlog⁡22kn \log_2 2k。15

=> WITH costs(startup)
AS (
  SELECT 21.39 + round((
    current_setting('cpu_operator_cost')::real * 2 *
      1339 * log(2, 2 * 100)
  )::numeric, 2)
)
SELECT startup,
  startup + round((
    current_setting('cpu_operator_cost')::real * 100
  )::numeric, 2) AS total
FROM costs;
 startup | total
−−−−−−−−−+−−−−−−−
   72.57 | 72.82
(1 row)

23.2.3 外排

如果扫描显示数据集太大而无法在内存中排序,排序节点将切换到外部归并排序 (在计划中标记为 external merge)。

已经扫描的行在内存中通过快排算法排序并写入一个临时文件中。
23.2.3 外排:插图 1
图 23.1

然后后续的行被读入释放的内存中,这个过程重复进行,直到所有数据被写入几个预排序的文件中。
23.2.3 外排:插图 2
图 23.2

接下来,这些文件被合并成一个。执行此操作的算法与归并连接大致相同;主要区别在于它可以同时处理两个以上的文件。

合并操作不需要太多内存。实际上,每个文件有一行的空间就足够了。从每个文件中读取第一行,具有最小值 (或最大值,取决于排序顺序) 的行作为部分结果返回,释放的内存用从同一文件中获取的下一行进行填充。

实际上,行是以 32 页的批次读取的,而不是逐个读取,这减少了 I/O 操作的次数。单次迭代中合并的文件数取决于可用内存,但不会少于 6 个。上限也有限制 (500),因为当文件太多时,效率会下降。16

排序算法有着悠久的术语。外部排序最初是使用磁带执行的,而 PostgreSQL 为控制临时文件的组件保留了一个类似的名称。17 部分排序的数据集称为 “runs” 18。参与合并的 “runs” 数称为 “merge order”。我没有使用这些术语,但如果你想了解 PostgreSQL 代码和注释,了解它们是值得的。

如果排序后的临时文件不能一次性全部合并,则必须分多次处理,其部分结果被写入新的临时文件中。每次迭代都会增加要读取和写入的数据量,因此可用的 RAM 越多,外部排序完成的速度就越快。
23.2.3 外排:插图 3
图 23.3

下一次迭代会合并新创建的临时文件。

23.2.3 外排:插图 4
图 23.4

最终的合并通常被推迟,并在上层节点拉取数据时即时执行。

让我们运行 EXPLAIN ANALYZE 命令来查看外部排序使用了多少磁盘空间。BUFFERS 选项显示了临时文件(temp read 和 written) 的缓冲区使用情况。写入的缓冲区数量将 (大致) 与读取的数量相同;转换为千字节,这个值在计划中显示为 Disk:

=> EXPLAIN (analyze, buffers, costs off, timing off, summary off)
SELECT * FROM flights
ORDER BY scheduled_departure;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Sort (actual rows=214867 loops=1)
   Sort Key: scheduled_departure
   Sort Method: external merge Disk: 17136kB
   Buffers: shared hit=2627, temp read=2142 written=2150
   −> Seq Scan on flights (actual rows=214867 loops=1)
       Buffers: shared hit=2624
(6 rows)

要在服务器日志中打印有关临时文件使用的更多详情,你可以启用 log_temp_files 参数。

成本估算。以使用外部排序的相同计划为例:

=> EXPLAIN SELECT *
FROM flights
ORDER BY scheduled_departure;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Sort (cost=31883.96..32421.12 rows=214867 width=63)
   Sort Key: scheduled_departure
   −> Seq Scan on flights (cost=0.00..4772.67 rows=214867 width=63)
(3 rows)

此处比较成本 (其数量与内存中的快排操作数量相同) 增加了 I/O 成本。19 所有输入数据首先必须写入磁盘上的临时文件中,然后在合并操作期间从磁盘读取 (如果所有创建的文件不能在一次迭代中合并,则可能不止一次)。

假定四分之三的磁盘操作 (读和写) 是顺序的,而四分之一是随机的。

写入磁盘的数据量取决于待排序的行数和查询中使用的列数。20 在这个例子中,查询显示了 flights 表的所有列,因此如果不考虑其元组和页面元数据,溢出到磁盘的数据大小几乎与整个表的大小相同 (2309 页而不是 2624)。

此处,排序在一次迭代中完成。

因此,此计划中排序成本估算如下:

=> WITH costs(startup) AS (
  SELECT 4772.67 + round((
    current_setting('cpu_operator_cost')::real * 2 *
      214867 * log(2, 214867) +
    (current_setting('seq_page_cost')::real * 0.75 +
     current_setting('random_page_cost')::real * 0.25) *
    2 * 2309 * 1 -- one iteration
  )::numeric, 2)
)
SELECT startup,
  startup + round((
    current_setting('cpu_operator_cost')::real * 214867
  )::numeric, 2) AS total
FROM costs;
 startup  |  total
−−−−−−−−−−+−−−−−−−−−−
 31883.96 | 32421.13
(1 row)

23.2.4 增量排序v. 13

如果一个数据集需要按照键 K1K_1 … KmK_m … KnK_n 排序,并且已知该数据集已经按照前 m 个键排序,那么就不需要从头重新排序。相反,可以根据相同的前几个键 K1K_1 … KmK_m 将数据集分成多个组(这些组内的值已经按定义的顺序排列),然后再分别对这些组按照剩余的 Km+1K_{m+1} … KnK_n 键进行排序。这种方法称为增量排序。

增量排序相较其他排序算法占用的内存更少,因为它将数据集分成了几个较小的组;此外,它允许执行器在处理完第一个分组后便开始返回结果,而无需等待整个数据集排序完成。

在 PostgreSQL 中,实现更加微妙:21 相对较大的组分别处理,较小的组则被合并在一起并完全排序。这减少了调用排序过程所产生的开销。22

执行计划中,增量排序通过 Incremental Sort 节点表示:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM bookings
ORDER BY total_amount, book_date;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Incremental Sort (actual rows=2111110 loops=1)
   Sort Key: total_amount, book_date
   Presorted Key: total_amount
   Full−sort Groups: 2823 Sort Method: quicksort Average
   Memory: 30kB Peak Memory: 30kB
   Pre−sorted Groups: 2624 Sort Method: quicksort Average
   Memory: 3152kB Peak Memory: 3259kB
   −> Index Scan using bookings_total_amount_idx on bookings (ac...
(8 rows)

如计划所示,数据集按 total_amount 字段预排序,因为这是在该列 (Presorted Key) 上执行索引扫描的结果。EXPLIAN ANALYZE 命令还显示了运行时统计数据。Full-sort Groups 行与被合并起来进行完全排序的小的分组相关,而 Presorted Groups 行显示了具有部分有序数据的大的分组的数据,这些数据只需要按 book_date 列进行增量排序。在这两种情况下,都使用了内存中的快排方法。组大小的差异是由于预定成本的不均匀分布造成的。

增量排序也可用于计算窗口函数v. 14:

=> EXPLAIN (costs off)
SELECT row_number() OVER (ORDER BY total_amount, book_date)
FROM bookings;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 WindowAgg
   −> Incremental Sort
       Sort Key: total_amount, book_date
       Presorted Key: total_amount
       −> Index Scan using bookings_total_amount_idx on bookings
(5 rows)

成本估算。增量排序的成本计算 23 基于预期的组数量 24 和对平均大小的组进行排序的预估成本 (我们已经回顾过了)。

启动成本反映了对第一个分组进行排序的成本估算,这使得节点可以开始返回排序后的行;总成本包括所有组的排序成本。

我们不打算在此处进一步探讨这些计算方式。

23.2.5 并行模式v. 10

排序也可以并行进行。但是,尽管并行工作进程预先对它们的数据份额进行排序,但 Gather 节点对它们的排序顺序一无所知,只能按照先到先得的原则累积。为了保留排序顺序,执行器必须使用 Gather Merge 节点:25

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM flights
ORDER BY scheduled_departure
LIMIT 10;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Limit (actual rows=10 loops=1)
   −> Gather Merge (actual rows=10 loops=1)
       Workers Planned: 1
       Workers Launched: 1
       −> Sort (actual rows=7 loops=2)
           Sort Key: scheduled_departure
           Sort Method: top−N heapsort Memory: 27kB
           Worker 0: Sort Method: top−N heapsort Memory: 27kB
           −> Parallel Seq Scan on flights (actual rows=107434 lo...
(9 rows)

Gather Merge 节点使用二叉堆 26 来调整由多个工作进程获取的行的顺序。它实际上合并了几个已排序的数据集,就像外部排序一样,但它用于不同的用例:Gather Merge 通常处理少量固定数量的数据源,并逐个而不是逐块地获取行。

成本估算。Gather Merge 节点的启动成本基于其子节点的启动成本。就像 Gather 节点一样,此值增加了启动并行进程的成本 (按 parallel_setup_cost1000 估算) 。

然后,接收到的值进一步增加了构建二叉堆的成本,这需要对 n 个值进行排序,其中 n 是并行工作进程的数量 (即 nlog⁡2nn \log_2 n)。单个比较操作的成本预估为 cpu_operator_cost0.0025 的两倍,这类操作的总份额通常可以忽略不计,因为 n 相当小。

总成本包括通过若干个执行计划并行部分的进程获取所有数据的成本,以及将这些数据传输给领导者进程的成本。单行传输的代价预估为 parallel_tuple_cost0.1 加 5%,以补偿可能在获取下一个值时的等待。

在总成本计算中还必须考虑二叉堆更新所引起的成本:每个输入行需要 log⁡2n\log_2 n 个比较操作和某些额外操作 (它们按 cpu_operator_cost 估算)。27

让我们看看另一个使用 Gather Merge 节点的计划。注意,这里的工作进程首先通过哈希执行部分聚合,然后 Sort 节点对接收到的结果进行排序 (成本很低,因为聚合后只剩下很少的行) ,进一步传递给领导者进程,领导者进程在 Gather Merge 节点中汇总完整的结果。至于最终的聚合,是在排序后的值列表上执行的:

=> EXPLAIN SELECT amount, count(*)
FROM ticket_flights
GROUP BY amount;
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize GroupAggregate (cost=123399.62..123485.00 rows=337 wid...
   Group Key: amount
   −> Gather Merge (cost=123399.62..123478.26 rows=674 width=14)
       Workers Planned: 2
       −> Sort (cost=122399.59..122400.44 rows=337 width=14)
           Sort Key: amount
           −> Partial HashAggregate (cost=122382.07..122385.44 r...
               Group Key: amount
               −> Parallel Seq Scan on ticket_flights (cost=0.00...
(9 rows)

在这里,我们有三个并行进程 (包括领导者进程),Gather Merge 节点的成本估算如下:

=> WITH costs(startup, run) AS (
  SELECT round((
    -- launching processes
    current_setting('parallel_setup_cost')::real +
    -- building the heap
    current_setting('cpu_operator_cost')::real * 2 * 3 * log(2, 3)
  )::numeric, 2),
  round((
    -- passing rows
    current_setting('parallel_tuple_cost')::real * 1.05 * 674 +
    -- updating the heap
    current_setting('cpu_operator_cost')::real * 2 * 674 * log(2, 3) +
    current_setting('cpu_operator_cost')::real * 674
  )::numeric, 2)
)
SELECT 122399.59 + startup AS startup,
  122400.44 + startup + run AS total
FROM costs;
  startup  |   total
−−−−−−−−−−−+−−−−−−−−−−−
 123399.61 | 123478.26
(1 row)

23.3 非重复值和分组

正如我们刚刚看到的,对值进行分组以执行聚合 (并消除重复项) 不仅可以通过哈希来执行,还可以通过排序来完成。在已排序的列表中,可以在一次遍历中挑选出重复值的组。

从已排序的列表中检索不同的值在计划中由一个名为 Unique 的节点表示:28

=> EXPLAIN (costs off) SELECT DISTINCT book_ref
FROM bookings
ORDER BY book_ref;
                        QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Result
   −> Unique
       −> Index Only Scan using bookings_pkey on bookings
(3 rows)

聚合在 GroupAggregate 节点中执行:29

=> EXPLAIN (costs off) SELECT book_ref, count(*)
FROM bookings
GROUP BY book_ref
ORDER BY book_ref;
                      QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 GroupAggregate
   Group Key: book_ref
   −> Index Only Scan using bookings_pkey on bookings
(3 rows)

在并行计划中,这个节点称为 Partial GroupAggregate,而完成聚合的节点称为 Finalize GroupAggregate。

如果分组是通过多个列集执行的 (在 GROUPING SETS、CUBE 或 ROLLUP 子句中指定),那么哈希和排序策略可以在单个节点中结合使用v. 10。在不深入探讨此算法极其复杂的细节情况下,我将简单地提供一个示例,此示例在内存不足的情况下按三个不同的列执行分组:

=> SET work_mem = '64kB';
=> EXPLAIN (costs off) SELECT count(*)
FROM flights
GROUP BY GROUPING SETS (aircraft_code, flight_no, departure_airport);
          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 MixedAggregate
   Hash Key: departure_airport
   Group Key: aircraft_code
   Sort Key: flight_no
     Group Key: flight_no
   −> Sort
       Sort Key: aircraft_code
       −> Seq Scan on flights
(8 rows)
=> RESET work_mem;

以下是执行此查询时发生的情况。聚合节点 (在计划中显示为 MixedAggregate) 接收按 aircraft_code 列排序的数据集。

首先,扫描这个数据集,并按 aircraft_code 列 (Group Key) 对值进行分组。随着扫描的进行,行按 flight_no 列重新排序 (就像由常规 Sort 节点所做的那样:如果内存足够,通过快排方法,或者使用磁盘上的外部排序);同时,执行器将这些行放入使用 departure_airport 作为键的哈希表中 (就像通过哈希聚合所做的那样:要么在内存中,要么使用临时文件)。

在第二阶段,执行器扫描刚刚按 flight_no 列排序的数据集,并按相同的列分组 (Sort Key 和嵌套的 Group Key 节点)。如果行必须按另一列分组,它们将根据需要再次重新排序。

最后,扫描第一阶段准备的哈希表,并按 departure_airport 列分组 (Hash Key)。

23.4 连接方式的比较

正如我们所见,两个数据集可以通过三种不同的方式进行连接,每种方式都有其自己的优缺点。

嵌套循环连接没有任何前置条件,并且可以立即开始返回结果集的第一行。它是唯一一个不必完全扫描内层数据集的连接方式 (只要它可以通过索引访问)。这些属性使嵌套循环算法 (结合索引) 成为处理相对较小数据集的短 OLTP 查询的理想选择。

随着数据量的增长,嵌套循环的弱点变得明显。对于笛卡尔积,该算法具有平方复杂度 — 成本与被连接的数据集大小的乘积成正比。然而,笛卡尔积在实践中并不常见;对于外层数据集的每一行,执行器通常使用索引访问内层数据集的一定数量的行,这个平均数并不依赖于数据集的总大小 (例如,预订中的平均票数不会随着预订和购买的票数的增加而改变)。因此,嵌套循环算法的复杂度通常呈线性增长而不是平方增长,即使具有很高的线性系数。

嵌套循环算法的一个重要区别是其普适性:它支持所有连接条件,而其他方式只能处理等值连接。这允许执行带有任何类型条件的查询 (除了不能与嵌套循环一起使用的全外连接),但你必须记住,大数据集的非等值连接很可能执行得比预期的慢。

哈希连接在大数据集上表现最佳。如果 RAM 足够,它只需要对两个数据集进行一次遍历,因此其复杂度是线性的。结合顺序表扫描,这种算法通常用于 OLAP 查询,这些查询基于大量数据计算结果。

然而,如果响应时间比吞吐量更重要,哈希连接不是最佳选择:在整个哈希表构建完成之前,它不会返回结果。

哈希连接算法仅适用于等值连接。另一个限制是连接键的数据类型必须支持哈希 (但几乎所有数据类型都支持)。

嵌套循环连接有时可以利用 Memoize 节点v. 14 (也基于哈希表) 中的内层数据集的缓存,从而击败哈希连接。虽然哈希连接总是完全扫描内层数据集,嵌套循环算法不必这样做,这可能会降低一些成本。

归并连接可以完美处理短的 OLTP 查询和长的 OLAP 查询。它具有线性复杂度 (要连接的集合只需扫描一次),不需要太多内存,并且无需任何预处理即可返回结果;但是,数据集必须已经有所需的排序顺序。

最具成本效益的方式是通过索引扫描获取数据。如果行数较少,这是一个自然的选择;对于较大的数据集,索引扫描仍然是有效的,但前提是堆访问很少或根本不发生。

如果没有合适的索引可用,那么必须对数据集进行排序,但此操作是内存密集型的,其复杂度高于线性:O(nlog⁡2n)O(n \log_2 n)。在这种情况下,哈希连接几乎总是比归并连接的代价更低 — 除非必须对结果进行排序。

归并连接的一个额外好处是内层和外层数据集的等价性。嵌套循环和哈希连接的效率都高度依赖于规划器是否可以正确分配内层和外层数据集。

归并连接仅限于等值联接。此外,数据类型必须具有 B 树操作符类。

下图表示了各种连接方式的成本与要连接的行的比例之间的大致依赖关系。
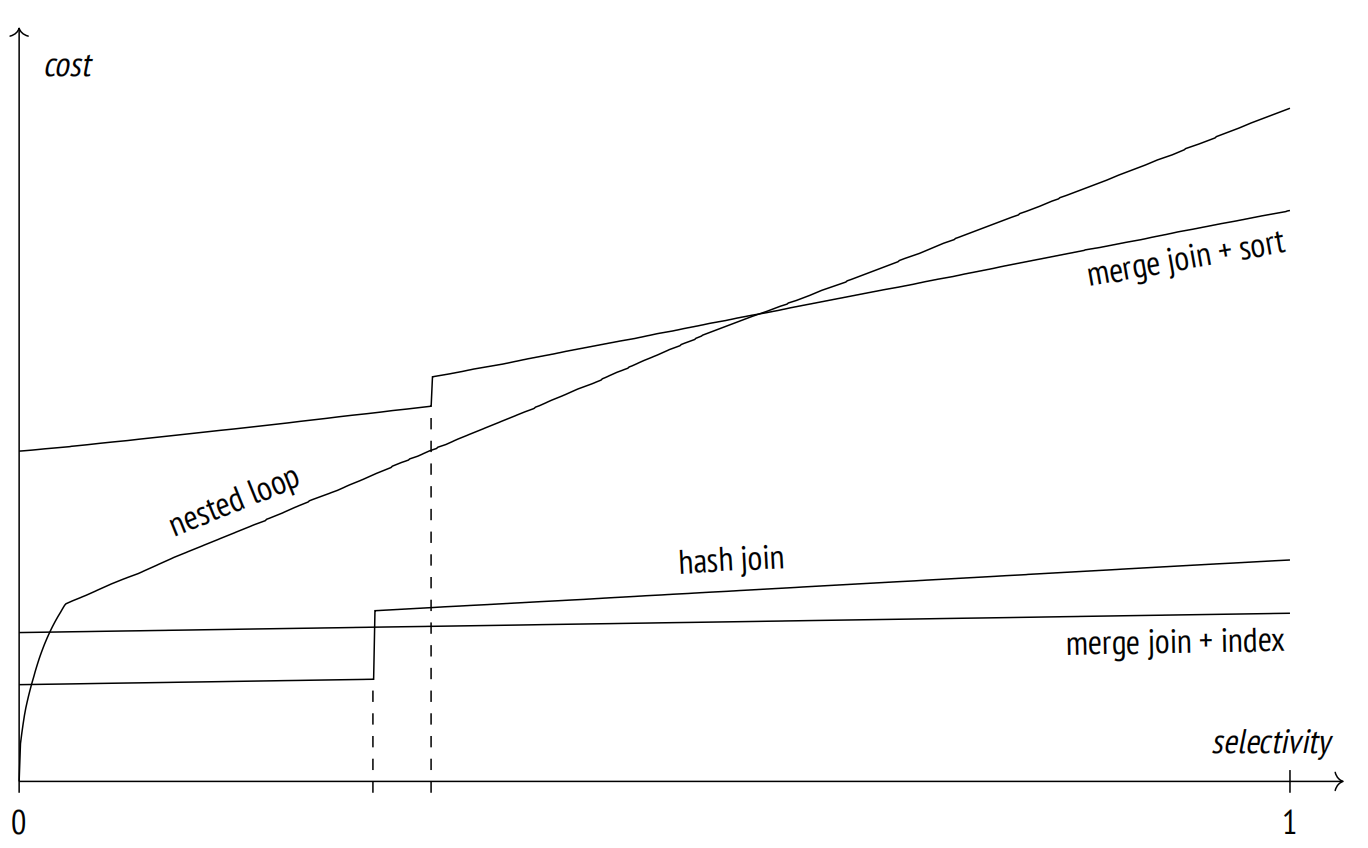
23.4 连接方式的比较:插图 5
图 23.5

如果选择性高,嵌套循环连接对两个表都使用索引访问;然后,规划器切换到外表的完全扫描,这在图表的线性部分有所反映。

这里的哈希连接对两个表都使用了完全扫描。图中的"台阶"对应于哈希表填满整个内存并且批次开始溢出到磁盘的时刻。

如果使用索引扫描,归并连接的成本会呈小幅线性增长。如果 work_mem 大小足够大,哈希连接通常更有效,但当涉及到临时文件时,归并连接会胜过它。

sort-merge join 的上图显示,当索引不可用并且必须对数据进行排序时,成本上升。就像哈希连接的情况一样,图上的"台阶"是内存不足造成的,因为它会导致使用临时文件进行排序。

这只是一个例子;在每种特定情况下,成本之间的比例会有所不同。


  1. backend/optimizer/path/joinpath.c, generate_mergejoin_paths function ↩︎

  2. backend/executor/nodeMergejoin.c ↩︎

  3. backend/executor/nodeMergejoin.c, ExecMergeJoin function ↩︎

  4. For example, see commitfest.postgresql.org/33/3160 ↩︎

  5. backend/utils/adt/selfuncs.c, mergejoinscansel function ↩︎

  6. backend/optimizer/path/costsize.c, final_cost_mergejoin function ↩︎

  7. backend/optimizer/path/costsize.c, initial_cost_mergejoin & final_cost_mergejoin functions ↩︎

  8. backend/optimizer/path/joinpath.c, consider_parallel_mergejoin function ↩︎

  9. backend/optimizer/path/joinpath.c, select_mergejoin_clauses function ↩︎

  10. backend/optimizer/path/pathkeys.c, build_join_pathkeys function ↩︎

  11. backend/executor/nodeSort.c ↩︎

  12. backend/executor/nodeWindowAgg.c ↩︎

  13. backend/utils/sort/tuplesort.c ↩︎

  14. backend/optimizer/path/costsize.c, cost_sort function ↩︎

  15. backend/optimizer/path/costsize.c, cost_sort function ↩︎

  16. backend/utils/sort/tuplesort.c, tuplesort_merge_order function ↩︎

  17. backend/utils/sort/logtape.c ↩︎

  18. Donald E. Knuth. The Art of Computer Programming. Volume III. Sorting and Searching ↩︎

  19. backend/optimizer/path/costsize.c, cost_sort function ↩︎

  20. backend/optimizer/path/costsize.c, relation_byte_size function ↩︎

  21. backend/executor/nodeIncrementalSort.c ↩︎

  22. backend/utils/sort/tuplesort.c ↩︎

  23. backend/optimizer/path/costsize.c, cost_incremental_sort function ↩︎

  24. backend/utils/adt/selfuncs.c, estimate_num_groups function ↩︎

  25. backend/executor/nodeGatherMerge.c ↩︎

  26. backend/lib/binaryheap.c ↩︎

  27. backend/optimizer/path/costsize.c, cost_gather_merge function ↩︎

  28. backend/executor/nodeUnique.c ↩︎

  29. backend/executor/nodeAgg.c, agg_retrieve_direct function ↩︎

第五部分:索引类型

第五部分:索引类型。

本分部页按原书结构编排,用于中英目录对照。

24 Hash

24.1 总览

哈希索引 1 提供了通过特定索引键快速找到元组 ID (TID) 的能力。粗略地说,它只是一个存储在磁盘上的哈希表。哈希索引支持的唯一操作是通过等值条件进行搜索。

将值插入到索引中时,2 会计算索引键的哈希函数。在 PostgreSQL 中,哈希函数返回 32 位或 64 位整数;这些值的最低几位用作相应桶的编号。键的 TID 和哈希码被添加到所选的桶中。键本身不存储在索引中,因为处理小的定长值更为方便。

索引的哈希表是动态扩展的。3 最小的桶数是 2。随着索引元组数量的增加,其中一个桶会被分成两个。这个操作使用了一个额外的哈希码位,所以元素只在分裂产生的两个桶之间重新分配;哈希表其他桶的组成保持不变。4

索引搜索操作 5 计算索引键的哈希函数和相应的桶号。在所有桶的内容中,搜索将仅返回与键的哈希码相对应的 TIDS。由于桶元素按键的哈希码排序,二分查找可以非常高效地返回匹配的 TIDS。

由于键未存储在哈希表中,因此索引访问方法可能会由于哈希冲突而返回冗余的 TIDS。因此,索引引擎必须重新检查访问方法获取的所有结果。出于同样的原因,也不支持仅索引扫描。

24.2 页面布局

与常规哈希表不同,哈希索引存储在磁盘上。因此,所有数据都必须组织到页面中,最好是以这样的方式:索引操作 (搜索、插入、删除) 尽可能少地访问页面。

哈希索引使用四种类型的页面:

  • 元页面 — 零页面,提供索引的"目录"

  • 桶页面 — 索引的主页面,每个桶一个页面

  • 溢出页面 — 当主桶页面无法容纳所有元素时使用的额外页面

  • 位图页面 — 包含位数组的页面,用于跟踪已释放且可以重用的溢出页面

我们可以使用 pageinspectv. 10 扩展窥探索引页面。

让我们从一张空表开始:

=> CREATE EXTENSION pageinspect;
=> CREATE TABLE t(n integer);
=> ANALYZE t;
=> CREATE INDEX ON t USING hash(n);

我已经分析了表,因此创建的索引大小将尽可能小;否则,桶的数量将基于假设表包含十个页面v. 14的前提来选择。6

索引包含四个页面:元页面、两个桶页面和一个位图页面 (立即创建以供将来使用):

=> SELECT page, hash_page_type(get_raw_page('t_n_idx', page))
FROM generate_series(0,3) page;
 page | hash_page_type
−−−−−−+−−−−−−−−−−−−−−−−
    0 | metapage
    1 | bucket
    2 | bucket
    3 | bitmap
(4 rows)
24.2 页面布局:插图 1
图 24.1

元页面包含所有与索引有关的控制信息。目前我们只对一些值感兴趣:

=> SELECT ntuples, ffactor, maxbucket
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 ntuples | ffactor | maxbucket
−−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−
       0 |     307 |         1
(1 row)

每个桶的预估行数显示在 ffactor 字段中。这个值是根据块大小和 fillfactor75 存储参数的值计算得出的。如果数据分布绝对均匀且没有哈希冲突,你可以使用更高的 fillfactor 值,但在实际情况中,这会增加页面溢出的风险。

哈希索引最糟糕的情况是当某个键重复多次时,数据分布会出现较大倾斜。由于哈希函数返回同一个值,所有数据都将被放置在同一个桶中,并且增加桶的数量也无济于事。

现在索引为空,如 ntuples 字段所示。让我们通过插入多条具有相同索引键的行来导致桶页面溢出。索引中现在出现了一个溢出页面v. 10:
=> INSERT INTO t(n)
  SELECT 0 FROM generate_series(1,500); -- the same value
=> SELECT page, hash_page_type(get_raw_page('t_n_idx', page))
FROM generate_series(0,4) page;
 page | hash_page_type
−−−−−−+−−−−−−−−−−−−−−−−
    0 | metapage
    1 | bucket
    2 | bucket
    3 | bitmap
    4 | overflow
(5 rows)
24.2 页面布局:插图 2
图 24.2

所有页面的综合统计显示,0 号桶是空的,而所有的值都被放置在 1 号桶中:其中一些位于主页面中,而那些不适合主页面的则可以在溢出页面中找到。

=> SELECT page, live_items, free_size, hasho_bucket
FROM (VALUES (1), (2), (4)) p(page),
  hash_page_stats(get_raw_page('t_n_idx', page));
 page | live_items | free_size | hasho_bucket
−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−−−−−
    1 |          0 |      8148 |            0
    2 |        407 |         8 |            1
    4 |         93 |      6288 |            1
(3 rows)

显然,如果同一个桶的元素分布在多个页面上,性能会受到影响。如果数据分布均匀,那么哈希索引表现最佳。

现在,让我们看看桶是如何进行分裂的。当索引中的行数超过可用桶的预估 ffactor 值时,就会发生分裂。此处我们有两个桶,ffactor 是 307,所以当第 615 行被插入到索引中时,桶就会分裂:

=> SELECT ntuples, ffactor, maxbucket, ovflpoint
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 ntuples | ffactor | maxbucket | ovflpoint
−−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−−
     500 |     307 |         1 |         1
(1 row)
=> INSERT INTO t(n)
  SELECT n FROM generate_series(1,115) n; -- now values are different
=> SELECT ntuples, ffactor, maxbucket, ovflpoint
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 ntuples | ffactor | maxbucket | ovflpoint
−−−−−−−−−+−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−−
     615 |     307 |         2 |         2
(1 row)

maxbucket 值已增加到 2:现在我们有三个桶,编号从 0 到 2。但即使我们只增加了一个桶,页面数量也翻了一倍:
=> SELECT page, hash_page_type(get_raw_page('t_n_idx', page))
FROM generate_series(0,6) page;
 page | hash_page_type
−−−−−−+−−−−−−−−−−−−−−−−
    0 | metapage
    1 | bucket
    2 | bucket
    3 | bitmap
    4 | overflow
    5 | bucket
    6 | unused
(7 rows)
24.2 页面布局:插图 3
图 24.3

其中一个新页面被 2 号桶使用,而另一个页面保持空闲,待桶 3 出现时便会被使用。

=> SELECT page, live_items, free_size, hasho_bucket
FROM (VALUES (1), (2), (4), (5)) p(page),
  hash_page_stats(get_raw_page('t_n_idx', page));
 page | live_items | free_size | hasho_bucket
−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−+−−−−−−−−−−−−−−
    1 |         27 |      7608 |            0
    2 |        407 |         8 |            1
    4 |        158 |      4988 |            1
    5 |         23 |      7688 |            2
(4 rows)

因此,从操作系统的角度来看,哈希索引呈爆发式增长,尽管从逻辑角度来看,哈希表显示的是逐步增长。

为了一定程度上平缓这种增长v. 10,并避免一次分配过多的页面,从第十次增加开始,页面将分成四个相同批次分配,而不是一次性全部分配。

元页面的另外两个字段,实际上是位掩码,提供了桶地址的详细信息:

=> SELECT maxbucket, highmask::bit(4), lowmask::bit(4)
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 maxbucket | highmask | lowmask
−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−
         2 | 0011     | 0001
(1 row)

桶号由与 highmask 对应的哈希码确定。但如果得到的桶号不存在 (超过了 maxbucket),则取 lowmask。7 在此特例下,我们取两个最低位,这提供了 0 到 3 的值;但如果我们得到 3,我们将只取一个最低位,也就是使用桶 1 代替桶 3。

每次大小翻倍时,新的桶页面作为一个连续的块被分配,而溢出页面和位图页面根据需要被插入到这些片段之间。元页面将插入到每个块中的页面数量保存在 spares 数组中,这使我们有机会基于桶号使用简单的算术来计算其主页面的数量。8

在这个特定的案例中,第一次增加后插入了两个页面 (一个位图页面和一个溢出页面),但在第二次增加后还没有发生新的添加:

=> SELECT spares[2], spares[3]
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 spares | spares
−−−−−−−−+−−−−−−−−
      2 |      2 
(1 row)

元页面还存储了一个指向位图页面的指针数组:

=> SELECT mapp[1]
FROM hash_metapage_info(get_raw_page('t_n_idx', 0));
 mapp
−−−−−−
    3
(1 row)
24.2 页面布局:插图 4
图 24.4

当指向死元组的指针被移除时,索引页中的空间会被释放。这发生在页剪枝期间 (当尝试将一个元素插入至一个完全填满的页面时触发) 9 或执行例行清理时。

但是,哈希索引不能收缩:一旦分配,索引页将不会返还给操作系统。主页面永久分配给它们的桶,即使它们根本不包含任何元素;被清理的溢出页面在位图中进行跟踪,并且可以被重用 (可能被另一个桶重用)。减少索引物理大小的唯一方法是使用 REINDEX 或 VACUUM FULL 命令重建。

查询计划并没有指示索引类型:

=> CREATE INDEX ON flights USING hash(flight_no);
=> EXPLAIN (costs off)
SELECT *
FROM flights
WHERE flight_no = 'PG0001';
                    QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights
   Recheck Cond: (flight_no = 'PG0001'::bpchar)
   −> Bitmap Index Scan on flights_flight_no_idx
       Index Cond: (flight_no = 'PG0001'::bpchar)
(4 rows)

24.3 操作符类

在 PostgreSQL 10 之前,哈希索引不会记录日志,也就是说,它们既不受故障保护也不被复制,因此不建议使用。但即便如此,它们仍有其价值。问题在于哈希算法被广泛使用 (特别是执行哈希连接和分组),系统必须知道哪个哈希函数可以用于特定的数据类型。然而,这种对应关系不是静态的:它不能一劳永逸地定义,因为 PostgreSQL 允许动态添加新的数据类型。因此,它由哈希索引的操作符类和特定的数据类型维护。哈希函数本身由类的支持函数表示:

=> SELECT opfname AS opfamily_name,
  amproc::regproc AS opfamily_procedure
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_amproc amproc ON amprocfamily = opf.oid
WHERE amname = 'hash'
AND amprocnum = 1
ORDER BY opfamily_name, opfamily_procedure;
   opfamily_name    | opfamily_procedure
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−
 aclitem_ops        | hash_aclitem
 array_ops          | hash_array
 bool_ops           | hashchar
 bpchar_ops         | hashbpchar
 bpchar_pattern_ops | hashbpchar
...
 timetz_ops         | timetz_hash
 uuid_ops           | uuid_hash
 xid8_ops           | hashint8
 xid_ops            | hashint4
(38 rows)

这些函数返回 32 位整数。尽管它们没有记录在文档中,但可以用来为相应类型的值计算哈希码。

例如,text_ops 族使用 hashtext 函数:

=> SELECT hashtext('one'), hashtext('two');
  hashtext  | hashtext
−−−−−−−−−−−−+−−−−−−−−−−−−
 1793019229 | 1590507854
(1 row)

哈希索引的操作符类只提供等值操作符:

=> SELECT opfname AS opfamily_name,
  left(amopopr::regoperator::text, 20) AS opfamily_operator
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opf.oid
WHERE amname = 'hash'
ORDER BY opfamily_name, opfamily_operator;
   opfamily_name    | opfamily_operator
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−
 aclitem_ops        | =(aclitem,aclitem)
 array_ops          | =(anyarray,anyarray)
 bool_ops           | =(boolean,boolean)
 ...
 uuid_ops           | =(uuid,uuid)
 xid8_ops           | =(xid8,xid8)
 xid_ops            | =(xid,xid)
(48 rows)

24.4 属性

让我们看一下哈希访问方法赋予系统的索引级属性。

24.4.1 访问方法属性

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'hash';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 hash 	| can_order     | f
 hash 	| can_unique    | f
 hash 	| can_multi_col | f
 hash 	| can_exclude   | t
 hash 	| can_include   | f
(5 rows)

显然,哈希索引不能用于排序:哈希函数或多或少地随机混合数据。

也不支持唯一约束。然而,哈希索引可以强制执行排它约束,由于唯一支持的函数是等于,因此这种排它具有唯一性的含义:

=> ALTER TABLE aircrafts_data
  ADD CONSTRAINT unique_range EXCLUDE USING hash(range WITH =);
=> INSERT INTO aircrafts_data
  VALUES ('744','{"ru": "Boeing 747-400"}',11100);
ERROR: conflicting key value violates exclusion constraint
"unique_range"
DETAIL: Key (range)=(11100) conflicts with existing key
(range)=(11100).

多列索引和额外的 INCLUDE 列也不支持。

24.4.2 索引级属性

=> SELECT p.name, pg_index_has_property('flights_flight_no_idx', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
 clusterable   | f
 index_scan    | t
 bitmap_scan   | t
 backward_scan | t
(4 rows)

哈希索引既支持常规索引扫描也支持位图扫描。

但不支持通过哈希索引进行表聚簇。这很合理,因为很难想象为什么需要基于哈希值来物理排序堆数据。

24.4.3 列级属性

列级属性基本上是由索引访问方法定义的,并且总是具有相同的值。

=> SELECT p.name,
  pg_index_column_has_property('flights_flight_no_idx', 1, p.name)
FROM unnest(array[
  'asc', 'desc', 'nulls_first', 'nulls_last', 'orderable',
  'distance_orderable', 'returnable', 'search_array', 'search_nulls'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 asc                | f
 desc               | f
 nulls_first        | f
 nulls_last         | f
 orderable          | f
 distance_orderable | f
 returnable         | f
 search_array       | f
 search_nulls       | f
(9 rows)

由于哈希函数不保留值的顺序,因此所有与排序相关的属性对哈希索引来说均不适用。

哈希索引不能参与仅索引扫描,因为它不存储索引键,需要访问堆。

哈希索引不支持空值,因为等于操作对空值不适用。

在数组中搜索元素也没有实现。


  1. postgresql.org/docs/14/hash-index.html
    backend/access/hash/README ↩︎

  2. backend/access/hash/hashinsert.c ↩︎

  3. backend/access/hash/hashpage.c, _hash_expandtable function ↩︎

  4. backend/access/hash/hashpage.c, _hash_getbucketbuf_from_hashkey function ↩︎

  5. backend/access/hash/hashsearch.c ↩︎

  6. backend/access/table/tableam.c, table_block_relation_estimate_size function ↩︎

  7. backend/access/hash/hashutil.c, _hash_hashkey2bucket function ↩︎

  8. include/access/hash.h, BUCKET_TO_BLKNO macro ↩︎

  9. backend/access/hash/hashinsert.c, _hash_vacuum_one_page function ↩︎

25 B-tree

25.1 总览

B 树 (作为 btree 访问方法实现) 是一种数据结构,允许你从树的根节点开始向下搜索,在树的叶节点中快速找到所需元素。1 为了明确识别搜索路径,所有树元素必须是有序的。B 树专为可以比较和排序的数据类型 (ordinal) 而设计。

下面是一个索引示意图,此索引基于机场代码构建,内部节点显示为水平矩形;叶节点垂直对齐。
25.1 总览:插图 1
图 25.1

每个树节点包含若干元素,这些元素由一个索引键和一个指针组成。内部节点元素引用下一级节点;叶节点元素引用堆元组 (图中未显示这些引用)。

B 树具有以下重要属性:

  • 它们是平衡的,这意味着树的所有叶节点都位于同一深度。因此,这保证了所有值的搜索时间相等。

  • 它们的分支很多,也就是说,每个节点包含许多元素,通常有数百个 (插图为了清晰起见仅显示了三个元素的节点)。因此,即使对于非常大的表,B 树的深度也总是很小。

    我们不能绝对地说,这种结构名称中的字母 B 代表什么。平衡 (balanced) 和茂密 (bushy) 都同样适用。令人惊讶的是,你经常可以看到它被解释为二进制 (binary),这显然是不正确的。

  • 索引中的数据要么按升序要么按降序排序,这种排序不仅适用于每个节点内部,也适用于同一层级的所有节点。同层节点被绑定成一个双向列表,因此通过简单地扫描列表的一个方向或另一个方向,就有可能得到一个有序的数据集,而不必每次都从根开始。

25.2 检索和插入

25.2.1 等值检索

让我们看看如何通过 “indexed-column = expression” 的条件在树中搜索值。2 我们尝试找到 KJA 机场 (Krasnoyarsk)。

搜索从根节点开始,访问方法必须确定要下降到哪个子节点。它选择了满足 KiK_{i} ⩽ expression < Ki+1K_{i+1} 的 KiK_{i} 键。

根节点包含键 AER 和 OVB。条件 AER ⩽ KJA < OVB 成立,所以我们需要下降到带有 AER 键的元素所引用的子节点。
25.2.1 等值检索:插图 2
图 25.2

递归重复此过程,直到我们到达包含所需元组 ID 的叶节点。在此特例下,子节点满足条件 DME ⩽ KJA < KZN,所以我们必须下降到含有 DME 键的元素所引用的叶节点。

你可能已注意到,树的内部节点中最左边的键是冗余的:要选择根的子节点,满足条件 KJA < OVB 就足够了。B 树不存储这样的键,因此在接下来的图中,我会将相应的元素留空。

叶节点中所需元素可以通过二分搜索快速找到。

然而,搜索过程并不像看起来那么简单。必须要考虑到索引中数据的排序顺序可以是升序 (如上所示),也可以是降序。即使是唯一索引,也可能有多个匹配的值,所有这些值都必须返回。此外,可能有太多的重复项以至于它们不适合单个节点,因此还必须处理相邻的叶节点。

由于索引可以包含非唯一值,因此将其顺序称为非降序而不是升序 (以及非升序而不是降序) 会更准确。但我将坚持使用更简单的术语。此外,元组 ID 是索引键的一部分,这让我们可以认为索引条目是唯一的v. 12,即使值实际上是相同的。

最重要的是,在搜索过程中,其他进程可能会修改数据,页面可能会分裂为两个,树的结构可能会发生变化。所有算法都旨在尽可能减少这些并发操作之间的冲突,并避免过多的锁定,但我们不打算在这里讨论这些技术细节。

25.2.2 非等值检索

如果按照 “indexed-column ⩽ expression” (或 “indexed-column ⩾ expression”) 进行搜索,首先要在索引中查找满足相等条件的值,然后沿着需要的方向遍历其叶节点,直到到达树的末端。

下图说明了搜索机场代码小于或等于 DME (Domodedovo) 的过程。
25.2.2 非等值检索:插图 3
图 25.3

对于小于和大于操作符,过程是相同的,除了需要排除第一个找到的值。

25.2.3 范围检索

当通过范围 “expression1 ⩽ indexed-column ⩽ expression2” 进行检索时,我们必须先找到 expression1,然后向右遍历叶节点,直至找到 expression2。下图说明了在 LED (Saint Petersburg) 和 ROV (Rostov-on-Don) 之间搜索机场代码的过程,包括两端。
25.2.3 范围检索:插图 4
图 25.4

25.2.4 插入

新元素的插入位置由键的顺序明确定义。例如,如果将 RTW 机场代码 (Saratov) 插入到表中,新元素将出现在倒数第二个叶节点中,位于 ROV 和 SGC 之间。

但如果叶节点没有足够的空间容纳新元素怎么办?例如 (假设一个节点最多可以容纳三个元素),如果我们插入 TJM 机场代码 (Tyumen),最后一个叶节点将溢出。在这种情况下,节点被分裂成两个,旧节点的一些元素被移动到新节点中,并在父节点中添加一个指向新子节点的指针。显然,父节点也可能溢出。然后它也分裂成两个节点,依次类推。如果涉及到根节点的分裂,则在目标节点之上再创建一个节点,成为树的新的根节点。在这种情况下,树的深度增加了一层。

在此例中,插入 TJM 机场会导致两个节点分裂;由此产生的新节点在下图中高亮显示。为了确保任何节点都可以分裂,一个双向列表绑定了所有层级的节点,而不仅仅是最低层级的节点。
25.2.4 插入:插图 5
图 25.5

所描述的插入和分裂过程确保了树保持平衡,并且由于一个节点可以容纳的元素数量通常非常大,因此树的深度很少增加。

问题是,一旦分裂,节点就永远不能合并在一起,即使在清理之后只包含很少的元素。这个限制不是 B 树数据结构本身的问题,而是其在 PostgreSQL 实现中的问题。因此,如果在尝试插入时节点满了,访问方法首先会尝试剪枝多余的数据以清理一些空间,避免额外的分裂。

25.3 页面布局

B 树的每个节点占用一个页面。页面的大小定义了节点的容量。

由于页面分裂,树根在不同时间可以由不同的页面表示。但是搜索算法必须始终从根节点开始扫描。它在零索引页面 (称为元页面) 中找到当前根页面的 ID。元页面还包含一些其他元数据。
25.3 页面布局:插图 6
图 25.6

索引页中的数据布局与我们迄今为止看到的有些不同。每一层除了最右边的页面外,所有页面都包含一个额外的"高键",这个高键保证不小于此页面中的任何键。在上图中,高键被高亮显示。

让我们使用 pageinspect 扩展来查看基于六位数预订参考号的实际索引页面。元页面列出了根页面 ID 和树的深度 (层级编号从叶节点开始,从零开始):

=> SELECT root, level
FROM bt_metap('bookings_pkey');
 root | level
−−−−−−+−−−−−−−
  290 | 2
(1 row)

存储在索引条目中的键以字节序显式,这不是很方便:

=> SELECT data
FROM bt_page_items('bookings_pkey',290)
WHERE itemoffset = 2;
          data
−−−−−−−−−−−−−−−−−−−−−−−−−
 0f 30 43 39 41 42 31 00
(1 row)

为了解读这些值,我们将不得不编写一个特定功能的函数。这个函数可能不支持所有平台,并且在某些特定情况下可能无法工作,但对于本章中的示例来说,它将足够使用:

=> CREATE FUNCTION data_to_text(data text)
RETURNS text
AS $$
DECLARE
  raw bytea := ('\x'||replace(data,' ',''))::bytea;
  pos integer := 0;
  len integer;
  res text := '';
BEGIN
  WHILE (octet_length(raw) > pos)
  LOOP
    len := (get_byte(raw,pos) - 3) / 2;
    EXIT WHEN len <= 0;
    IF pos > 0 THEN
      res := res || ', ';
    END IF;
    res := res || (
      SELECT string_agg( chr(get_byte(raw, i)),'')
      FROM generate_series(pos+1,pos+len) i
    );
    pos := pos + len + 1;
  END LOOP;
  RETURN res;
END;
$$ LANGUAGE plpgsql;

现在让我们看一下根页面的内容:

=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('bookings_pkey',290);
 itemoffset |   ctid   | data_to_text
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−
          1 | (3,0)    |
          2 | (289,1)  | 0C9AB1
          3 | (575,1)  | 192F03
          4 | (860,1)  | 25D715
          5 | (1145,1) | 32785C
...
         17 | (4565,1) | C993F6
         18 | (4850,1) | D63931
         19 | (5135,1) | E2CB14
         20 | (5420,1) | EF6FEA
         21 | (5705,1) | FC147D
(21 rows)

正如我所说,第一个条目不包含键值。ctid 列提供了指向子页面的链接。

假设我们正在查找预订号 E2D725。在这种情况下,我们必须选择条目 19 (因为 E2CB14 ⩽ E2D725 < EF6FEA) 并下降到页面 5135。

=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('bookings_pkey',5135);
 itemoffset |   ctid   | data_to_text
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−
          1 | (5417,1) | EF6FEA		← high key
          2 | (5132,0) |
          3 | (5133,1) | E2D71D
          4 | (5134,1) | E2E2F4
          5 | (5136,1) | E2EDE7
...
        282 | (5413,1) | EF41BE
        283 | (5414,1) | EF4D69
        284 | (5415,1) | EF58D4
        285 | (5416,1) | EF6410
(285 rows)

此页面中的第一个条目包含高键,这似乎有点出乎意料。从逻辑上讲,它应该放在页面的末尾,但从实现的角度来看,将其放在开头更为方便,这样每次页面内容改变时就无需移动它。

此处我们选择条目 3 (因为 E2D71D ⩽ E2D725 < E2E2F4) 并下降到页面 11919。

=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('bookings_pkey',5133);
 itemoffset |    ctid     | data_to_text
−−−−−−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−−−−−
          1 | (11921,1)   | E2E2F4
          2 | (11919,76)  | E2D71D
          3 | (11919,77)  | E2D725
          4 | (11919,78)  | E2D72D
          5 | (11919,79)  | E2D733
...
        363 | (11921,123) | E2E2C9
        364 | (11921,124) | E2E2DB
        365 | (11921,125) | E2E2DF
        366 | (11921,126) | E2E2E5
        367 | (11921,127) | E2E2ED
(367 rows)

这是索引的叶子页面。第一个条目是高键;所有其他条目都指向堆元组。

在这里找到了我们的预订信息:

=> SELECT * FROM bookings
WHERE ctid = '(11919,77)';
 book_ref |       book_date        | total_amount
−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 E2D725   | 2017−01−25 04:10:00+03 |     28000.00
(1 row)

这大致就是当我们通过预订号搜索预订时,在底层发生的事情:

=> EXPLAIN (costs off)
SELECT * FROM bookings
WHERE book_ref = 'E2D725';
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_pkey on bookings
   Index Cond: (book_ref = 'E2D725'::bpchar)
(2 rows)

25.3.1 去重v. 13

非唯一索引可以包含许多指向不同堆元组的重复键。由于非唯一键出现不止一次,并因此占用大量空间,所以重复键被折叠收敛成一个单独的索引条目,其中包含键和相应元组 ID 的列表。3 在某些情况下,这个过程 (称为去重) 可以显著减小索引的大小。

但是,由于 MVCC 的原因,即使是唯一索引也可能包含重复项:因为索引保留对表行所有版本的引用。HOT 更新机制可以减少因为引用过时且通常是短暂的行版本而导致的索引膨胀,但有时这可能不适用。在这种情况下,去重可以花费一些时间来清理冗余堆元组并避免额外的页面分裂。

为了避免在去重不会带来立竿见影的效果时浪费资源,仅当叶子页面没有足够空间容纳更多元组时才会执行这种折叠。4 然后,页面剪枝和去重 5 可以释放一些空间并防止不必要的页面分裂。但是,如果重复项很少,你可以通过关闭 deduplicate_items 存储参数来禁用去重功能。

一些索引不支持去重。主要限制是键的等价性必须通过它们内部表示的简单二进制比较来检查。到目前为止,并非所有数据类型都可以通过这种方式进行比较。例如,浮点数 (float 和 double precision) 有两种不同的零值表示形式。任意精度的数字 (numeric) 可以以不同标度表示同一个数字,而 jsonb 类型可以使用这样的数字。如果使用非确定性的排序规则,6 text 类型也无法进行去重,因为这允许由不同的字节序表示同一个符号 (标准排序规则是确定性的)。

另外,复合类型、range 类型和数组以及使用 INCUDE 子句声明的索引目前均不支持去重。

要检查特定索引是否可以使用去重,你可以查看其元页面中的 allequalimage 字段:

=> CREATE INDEX ON tickets(book_ref);
=> SELECT allequalimage FROM bt_metap('tickets_book_ref_idx');
 allequalimage
−−−−−−−−−−−−−−−
 t
(1 row)

此例中支持去重。实际上,我们可以看到其中一个叶子页面既包含带有单个元组 ID (htid) 的索引条目,也包含带有 ID 列表 (tids) 的索引条目:

=> SELECT itemoffset, htid, left(tids::text,27) tids,
	data_to_text(data) AS data
FROM bt_page_items('tickets_book_ref_idx',1)
WHERE itemoffset > 1;
 itemoffset |    htid    |            tids             | data
−−−−−−−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−
          2 | (32965,40) |                             | 000004
          3 | (47429,51) |                             | 00000F
          4 | (3648,56)  | {"(3648,56)","(3648,57)"}   | 000010
          5 | (6498,47)  |                             | 000012
...
        271 | (21492,46) |                             | 000890 
        272 | (26601,57) | {"(26601,57)","(26601,58)"} | 0008AC
        273 | (25669,37) |                             | 0008B6
(272 rows)

25.3.2 内部索引条目的紧凑存储v. 12

去重使得索引的叶子页面能够容纳更多的条目。但是,尽管叶子页面构成了索引的大部分,但在内部页面上执行的数据压缩以防止额外的分裂同样重要,因为搜索效率直接依赖于树的深度。

内部索引条目包含索引键,但它们的值仅用于在搜索过程中确定要下降到的子树。在多列索引中,通常只需取第一个键属性 (或几个首属性)。为了在页面中节省空间,可以截断其他属性。

当叶子页面被分裂且内部页面需要容纳一个新指针时,便会发生这种 suffix truncation (后缀截断)。7

理论上,我们甚至可以更进一步,只保留属性中有意义的部分,例如,一行的前几个符号,这足以区分子树。但这还没有实现:索引条目要么包含整个属性,要么完全不包含这个属性。

例如,以下是索引根页面的几个条目,索引基于 tickets 表的 book_ref 和 passenger_name 列创建。

=> CREATE INDEX tickets_bref_name_idx
ON tickets(book_ref, passenger_name);
=> SELECT itemoffset, ctid, data_to_text(data)
FROM bt_page_items('tickets_bref_name_idx',229)
WHERE itemoffset BETWEEN 8 AND 13;
 itemoffset |   ctid   |        data_to_text
−−−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−
          8 | (1607,1) | 1A98A0
          9 | (1833,2) | 1E57D1, SVETLANA MAKSIMOVA
         10 | (2054,1) | 220797
         11 | (2282,1) | 25DB06
         12 | (2509,2) | 299FE4, YURIY AFANASEV
         13 | (2736,1) | 2D62C9
(6 rows)

我们可以看到有些索引条目没有第二个属性。

自然地,叶子页面必须保留所有键属性和 INCLUDE 列值 (如果有的话)。否则,将无法执行仅索引扫描。唯一的例外是高键;它们可以部分保留。

25.4 操作符类

25.4.1 比较语义

除了哈希值之外,系统还必须知道如何对各种类型的值进行排序,包括自定义类型。这对于排序、分组、归并连接和一些其他操作是必不可少的。就像哈希一样,特定数据类型的比较操作符是由操作符类定义的。8

操作符类允许我们从名称 (如 >, <, =) 中抽象出来,甚至可以提供多种方式来对同一类型的值进行排序。

以下是任何 btree 方法的操作符类必须定义的强制性比较操作符 (显式为 bool_ops 族):

=> SELECT amopopr::regoperator AS opfamily_operator,
  amopstrategy
FROM pg_am am
  JOIN pg_opfamily opf ON opfmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opf.oid
WHERE amname = 'btree'
AND opfname = 'bool_ops'
ORDER BY amopstrategy;
  opfamily_operator  | amopstrategy
−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 <(boolean,boolean)  |            1
 <=(boolean,boolean) |            2
 =(boolean,boolean)  |            3
 >=(boolean,boolean) |            4
 >(boolean,boolean)  |            5
(5 rows)

这五个比较操作符中的每一个都对应于一种策略,9 策略定义了它们的语义:

  1. 小于

  2. 小于或等于

  3. 等于

  4. 大于或等于

  5. 大于

B 树操作符类还包括几个支持函数。10 第一个函数必须在第一个参数大于第二个参数时返回 1,如果它小于第二个参数,则返回 -1,如果参数相等,则返回 0。

其他支持函数是可选的,但它们可以提升访问方法的性能。

为了更好地理解这种机制,我们可以定义一个带有非默认排序规则的新数据类型。文档给出了复数的示例,11 但它是用 C 语言编写的。幸运的是,B 树操作符类也可以使用解释型语言来实现,因此我将利用这一点,尽可能简单地制作一个示例 (即使明知效率低下)。

接下来,让我们定义一个用于信息单位的新复合类型:

=> CREATE TYPE capacity_units AS ENUM (
  'B', 'kB', 'MB', 'GB', 'TB', 'PB'
);
=> CREATE TYPE capacity AS (
  amount integer,
  unit capacity_units
);

现在创建一个包含新类型列的表,并用随机值填充:

=> CREATE TABLE test AS
  SELECT ( (random()*1023)::integer, u.unit )::capacity AS cap
  FROM generate_series(1,100),
    unnest(enum_range(NULL::capacity_units)) AS u(unit);

默认情况下,复合类型的值按字典顺序排序,这与本示例中的自然顺序不同。

=> SELECT * FROM test ORDER BY cap;
    cap
−−−−−−−−−−−
 (1,B)
 (3,GB)
 (4,MB)
 (9,kB)
 ...
 (1017,kB)
 (1017,GB)
 (1018,PB)
 (1020,MB)
 (600 rows)

现在让我们开始创建操作符类。我们将从定义一个将容量转换为字节的函数开始:

=> CREATE FUNCTION capacity_to_bytes(a capacity) RETURNS numeric
AS $$
SELECT a.amount::numeric *
  1024::numeric ^ ( array_position(enum_range(a.unit), a.unit) - 1 );
$$ LANGUAGE sql STRICT IMMUTABLE;
=> SELECT capacity_to_bytes('(1,kB)'::capacity);
   capacity_to_bytes
−−−−−−−−−−−−−−−−−−−−−−−
 1024.0000000000000000
(1 row)

为将来的操作符类创建一个支持函数:

=> CREATE FUNCTION capacity_cmp(a capacity, b capacity)
RETURNS integer
AS $$
SELECT sign(capacity_to_bytes(a) - capacity_to_bytes(b));
$$ LANGUAGE sql STRICT IMMUTABLE;

现在,使用这个支持函数定义比较操作符就变得简单了。我故意使用了奇特的名称来展示这些名称可以是任意的:

=> CREATE FUNCTION capacity_lt(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
  RETURN capacity_cmp(a,b) < 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #<# (
  LEFTARG = capacity,
  RIGHTARG = capacity,
  FUNCTION = capacity_lt
);

其他四个操作符以类似方式进行定义。

=> CREATE FUNCTION capacity_le(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
  RETURN capacity_cmp(a,b) <= 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;

=> CREATE OPERATOR #<=# (
  LEFTARG = capacity,
  RIGHTARG = capacity,
  FUNCTION = capacity_le
);

=> CREATE FUNCTION capacity_eq(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
  RETURN capacity_cmp(a,b) = 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #=# (
  LEFTARG = capacity,
  RIGHTARG = capacity,
  FUNCTION = capacity_eq,
  MERGES -- can be used in merge joins
);

=> CREATE FUNCTION capacity_ge(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
  RETURN capacity_cmp(a,b) >= 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #>=# (
  LEFTARG = capacity,
  RIGHTARG = capacity,
  FUNCTION = capacity_ge
);

=> CREATE FUNCTION capacity_gt(a capacity, b capacity) RETURNS boolean
AS $$
BEGIN
  RETURN capacity_cmp(a,b) > 0;
END;
$$ LANGUAGE plpgsql IMMUTABLE STRICT;
=> CREATE OPERATOR #># (
  LEFTARG = capacity,
  RIGHTARG = capacity,
  FUNCTION = capacity_gt
);

在这个阶段,我们已经可以比较容量了:

=> SELECT (1,'MB')::capacity #># (512, 'kB')::capacity;
 ?column?
−−−−−−−−−−
 t
(1 row)

一旦操作符类创建好之后,排序也将按预期工作。

=> CREATE OPERATOR CLASS capacity_ops
DEFAULT FOR TYPE capacity -- to be used by default
USING btree AS
  OPERATOR 1 #<#,
  OPERATOR 2 #<=#,
  OPERATOR 3 #=#,
  OPERATOR 4 #>=#,
  OPERATOR 5 #>#,
FUNCTION 1 capacity_cmp(capacity,capacity);
=> SELECT * FROM test ORDER BY cap;
    cap
−−−−−−−−−−−
 (1,B)
 (21,B)
 (27,B)
 (35,B)
 (46,B)
 ...
 (1002,PB)
 (1013,PB)
 (1014,PB)
 (1014,PB)
 (1018,PB)
(600 rows)

创建新索引时默认使用我们的操作符类,该索引以正确的顺序返回结果:

=> CREATE INDEX ON test(cap);
=> SELECT * FROM test WHERE cap #<# (100,'B')::capacity ORDER BY cap;
  cap
−−−−−−−−
 (1,B)
 (21,B)
 (27,B)
 (35,B)
 (46,B)
 (57,B)
 (68,B)
 (70,B)
 (72,B)
 (76,B)
 (78,B)
 (94,B)
(12 rows)
=> EXPLAIN (costs off) SELECT *
FROM test WHERE cap #<# (100,'B')::capacity ORDER BY cap;
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using test_cap_idx on test
   Index Cond: (cap #<# '(100,B)'::capacity)
(2 rows)

等值操作符声明中指定的 MERGE 子句使得这个数据类型支持归并连接。

25.4.2 多列索引和排序

让我们仔细看一下多列索引的排序。

首先,在声明索引时选择列的最佳顺序非常重要:页面内的数据排序将从第一列开始,然后第二列,依此类推。只有当提供的过滤条件涵盖从第一列开始的连续的列时,多列索引才能保证高效的搜索:第一列、前两列、第一列至第三列之间的范围等。其他类型的条件只能用来过滤掉基于其他标准获取的冗余值。

以下是在 tickets 表上创建的索引,其第一页中索引条目的顺序,此索引包括预订参考号和乘客姓名:

=> SELECT itemoffset, data_to_text(data)
FROM bt_page_items('tickets_bref_name_idx',1)
WHERE itemoffset > 1;
 itemoffset |        data_to_text
−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
          2 | 000004, PETR MAKAROV
          3 | 00000F, ANNA ANTONOVA
          4 | 000010, ALEKSANDR SOKOLOV
          5 | 000010, LYUDMILA BOGDANOVA
          6 | 000012, TAMARA ZAYCEVA
          7 | 000026, IRINA PETROVA
          8 | 00002D, ALEKSANDR SMIRNOV
...
        187 | 0003EF, VLADIMIR CHERNOV
        188 | 00040C, ANTONINA KOROLEVA
        189 | 00040C, DMITRIY FEDOROV
        190 | 00041E, EGOR FEDOROV
        191 | 00041E, ILYA STEPANOV
        192 | 000447, VIKTOR VASILEV
        193 | 00044D, NADEZHDA KULIKOVA
(192 rows)

在这种情况下,只有通过预订参考号和乘客姓名,或仅通过预订参考号,才能高效地检索 tickets 表。

=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE book_ref = '000010';
                    QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_book_ref_idx on tickets
   Index Cond: (book_ref = '000010'::bpchar)
(2 rows)
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE book_ref = '000010' AND passenger_name = 'LYUDMILA BOGDANOVA';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_bref_name_idx on tickets
   Index Cond: ((book_ref = '000010'::bpchar) AND (passenger_name...
(2 rows)

但如果我们查找乘客姓名,则必须扫描所有的行:

=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE passenger_name = 'LYUDMILA BOGDANOVA';
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Gather
   Workers Planned: 2
   −> Parallel Seq Scan on tickets
       Filter: (passenger_name = 'LYUDMILA BOGDANOVA'::text)
(4 rows)

即使规划器选择执行索引扫描,也仍然需要遍历所有索引条目。12 不幸的是,计划并不会显示条件实际上仅用于过滤结果。

如果第一列没有太多不同的值 v1,v2, …, vn,通过以下条件进行一系列搜索而不是使用单一条件 “col2 = value” 的搜索,可能会有益处,这样可以在对应的子树上进行多次遍历:

col1 = v1 and col2 = value

col1 = v2 and col2 = value

⋯

col1 = vn and col2 = value

这种类型的索引访问被称之为 Skip Scan,但目前尚未实现。13

反之亦然,如果根据乘客姓名和预订号创建索引,那么它将更适合仅按乘客姓名,或者按乘客姓名和预订参考号两者进行查询:

=> CREATE INDEX tickets_name_bref_idx
ON tickets(passenger_name, book_ref);
=> SELECT itemoffset, data_to_text(data)
FROM bt_page_items('tickets_name_bref_idx',1)
WHERE itemoffset > 1;
 itemoffset |         data_to_text
−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
          2 | ADELINA ABRAMOVA, E37EDB
          3 | ADELINA AFANASEVA, 1133B7
          4 | ADELINA AFANASEVA, 4F3370
          5 | ADELINA AKIMOVA, 7D2881
          6 | ADELINA ALEKSANDROVA, 3C3ADD
          7 | ADELINA ALEKSANDROVA, 52801E
...
        185 | ADELINA LEBEDEVA, 0A00E3
        186 | ADELINA LEBEDEVA, DAEADE
        187 | ADELINA LEBEDEVA, DFD7E5
        188 | ADELINA LOGINOVA, 8022F3
        189 | ADELINA LOGINOVA, EE67B9
        190 | ADELINA LUKYANOVA, 292786
        191 | ADELINA LUKYANOVA, 54D3F9
(190 rows)
=> EXPLAIN (costs off) SELECT * FROM tickets
WHERE passenger_name = 'LYUDMILA BOGDANOVA';
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on tickets
   Recheck Cond: (passenger_name = 'LYUDMILA BOGDANOVA'::text)
   −> Bitmap Index Scan on tickets_name_bref_idx
       Index Cond: (passenger_name = 'LYUDMILA BOGDANOVA'::text)
(4 rows)

除了列顺序之外,在创建新索引时,还应该注意排序顺序。默认情况下,值按升序 (ASC) 排序,但如果需要,可以将其反转为降序 (DESC)。如果索引是在单个列上构建的,这并不重要,因为它可以沿任何方向扫描。但在多列索引中,排序顺序变得很重要。

我们新创建的索引可以用来按升序或降序检索按两列排序的数据:

=> EXPLAIN (costs off) SELECT *
FROM tickets
ORDER BY passenger_name, book_ref;
                    QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_name_bref_idx on tickets
(1 row)
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name DESC, book_ref DESC;
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan Backward using tickets_name_bref_idx on tickets
(1 row)

但是,如果需要同时按一个列升序和另一个列降序排序,那么此索引将无法立即返回数据。

在这种情况下,索引提供的是部分排序的数据,必须进一步按第二个属性排序:

=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name ASC, book_ref DESC;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Incremental Sort
   Sort Key: passenger_name, book_ref DESC
   Presorted Key: passenger_name
   −> Index Scan using tickets_name_bref_idx on tickets
(4 rows)

空值的位置也会影响使用索引进行排序的能力。默认情况下,出于排序目的,空值被视为比常规值"更大",也就是说,如果排序顺序为升序,它们位于树的右侧,如果排序顺序为降序,则位于左侧。可以使用 NULLS LAST 和 NULLS FIRST 子句更改空值的位置。

在下一个示例中,索引不满足 ORDER BY 子句,因此必须对结果进行排序:

=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name NULLS FIRST, book_ref DESC;
                        QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Gather Merge
   Workers Planned: 2
   −> Sort
       Sort Key: passenger_name NULLS FIRST, book_ref DESC
       −> Parallel Seq Scan on tickets
(5 rows)

但如果我们创建一个遵循所需顺序的索引,那么它便会被使用:

=> CREATE INDEX tickets_name_bref_idx2
ON tickets(passenger_name NULLS FIRST, book_ref DESC);
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name NULLS FIRST, book_ref DESC;
                     QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_name_bref_idx2 on tickets
(1 row)

25.5 属性

让我们看一下 B 树的接口属性。

25.5.1 访问方法属性

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'btree';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 btree  | can_order     | t
 btree  | can_unique    | t
 btree 	| can_multi_col | t
 btree  | can_exclude   | t
 btree  | can_include   | t
(5 rows)

B 树可以对数据进行排序并确保其唯一性。它是唯一具有这些属性的访问方法。

许多访问方法都支持多列索引,但由于 B 树中的值是有序的,因此你需要密切关注索引中列的顺序。

从形式上讲,支持排它约束,但它们仅限于等值条件,这使它们类似于唯一约束。使用完整的唯一约束更为可取。

B 树索引还可以通过不参与搜索的额外的 INCLUDE 列进行扩展。

25.5.2 索引级属性

=> SELECT p.name, pg_index_has_property('flights_pkey', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
 clusterable   | t
 index_scan    | t
 bitmap_scan   | t
 backward_scan | t
(4 rows)

B 树索引可用于聚簇。

也支持索引扫描和位图扫描。由于叶子页面被绑定到双向列表中,因此也可以向后遍历索引,从而导致相反的排序顺序:

=> EXPLAIN (costs off) SELECT *
FROM bookings ORDER BY book_ref DESC;
                     QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan Backward using bookings_pkey on bookings
(1 row)

25.5.3 列级属性

=> SELECT p.name,
  pg_index_column_has_property('flights_pkey', 1, p.name)
FROM unnest(array[
  'asc', 'desc', 'nulls_first', 'nulls_last', 'orderable',
  'distance_orderable', 'returnable', 'search_array', 'search_nulls'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 asc                | t
 desc               | f
 nulls_first        | f
 nulls_last         | t
 orderable          | t
 distance_orderable | f
 returnable         | t
 search_array       | t
 search_nulls       | t
(9 rows)

ORDERABLE 属性表明存储在 B 树中的数据是有序的,而前四个属性 (ASC 和 DESC、NULLS FIRST 和 NULLS LAST) 定义了特定列中实际的排序顺序。在此例中,列值按升序排序,空值在最后。

SEARCH NULLS 属性表明是否可以搜索空值。

B 树不支持排序运算符 (DISTANCE ORDERABLE),尽管已经尝试去实现它们。14

B 树支持在数组中搜索多个元素 (SEARCH ARRAY 属性),并且可以在不访问堆的情况下返回结果数据 (RETURNABLE)。


  1. postgresql.org/docs/14/btree.html
    backend/access/nbtree/README ↩︎

  2. backend/access/nbtree/nbtsearch.c, _bt_search function ↩︎

  3. postgresql.org/docs/14/btree-implementation#BTREE-DEDUPLICATION.html ↩︎

  4. backend/access/nbtree/nbtinsert.c, _bt_delete_or_dedup_one_page function ↩︎

  5. backend/access/nbtree/nbtdedup.c, _bt_dedup_pass function ↩︎

  6. postgresql.org/docs/14/collation.html ↩︎

  7. backend/access/nbtree/nbtinsert.c, _bt_split function ↩︎

  8. postgresql.org/docs/14/btree-behavior.html ↩︎

  9. postgresql.org/docs/14/xindex#XINDEX-STRATEGIES.html ↩︎

  10. postgresql.org/docs/14/btree-support-funcs.html ↩︎

  11. postgresql.org/docs/14/xindex#XINDEX-EXAMPLE.html ↩︎

  12. backend/access/nbtree/nbtsearch.c, _bt_first function ↩︎

  13. commitfest.postgresql.org/34/1741 ↩︎

  14. commitfest.postgresql.org/27/1804 ↩︎

26 GiST

26.1 总览

GiST (通用搜索树) 1 是一种访问方法,实际上是平衡搜索树的广义化,适用于那些支持数据值之间相对位置关系的数据类型。B 树的适用性仅限于允许比较操作的数据类型 (但对这些类型的支持非常高效)。至于 GiST,其操作符类允许为树中的数据分布定义任意标准。GiST 索引可以适用于空间数据的 R 树、集合的 RD 树,以及任何数据类型 (包括文本和图像) 的签名树。

得益于可扩展性,你可以通过实现索引引擎的接口,从头开始在 PostgreSQL 中创建一个新的访问方法。然而,除了设计索引逻辑之外,你还必须定义页面布局、高效的锁策略和 WAL 的支持。这一切都需要强大的编程技能和大量的实施工作。GiST 简化了这项任务,解决了所有底层技术问题,并为搜索算法提供了基础。要将 GiST 方法用于新的数据类型,你只需添加一个包含十几个支持函数的新操作符类。与为 B 树提供的简单操作符类不同,这样的类包含了大部分索引逻辑。GiST 可以被视为在 PostgreSQL 中构建新访问方法的框架。

用最普通的术语来说,属于叶节点 (叶条目) 的每个条目都包含一个谓词 (一个逻辑条件) 和一个堆元组 ID。索引键必须满足谓词;键本身是否是该条目的一部分并不重要。

内部叶节点 (内部条目) 中的每个条目还包含一个谓词和对子节点的引用;子树中的所有索引数据都必须满足该谓词。换句话说,内部条目的谓词是其子条目所有谓词的并集。GiST 的这一重要特性用于实现 B 树的简单排序功能。

GiST 树搜索依赖于 consistency 函数,这是操作符类定义的支持函数之一。

在索引条目上调用 consistency 函数,以确定这个条目的谓词是否与搜索条件 ("indexed-column operator expression") “一致”。对于内部条目,它显示是否需要下降到相应的子树;对于叶子条目,它检查其索引键是否满足条件。

搜索从根节点开始,2 这是树搜索的典型方式。consistency 函数决定了哪些子节点必须遍历,哪些可以跳过。然后,对每个找到的子节点重复此过程;与 B 树不同,GiST 索引可能有多个这样的节点。由 consistency 函数选中的叶节点条目作为结果返回。

搜索始终是深度优先的:算法会尽可能快地到达叶子页面。因此,它可以立即开始返回结果,如果用户只需要获取最前面的几行,这是非常有意义的。

要将新值插入到 GiST 树中,无法使用 consistency 函数,因为我们需要选择一个确切的节点来下降。3 这个节点必须具有最小的插入成本;它由操作符类的 penalty 函数确定。

就像 B 树的情况一样,所选节点可能没有空闲空间,从而导致分裂。4 这个操作需要另外两个函数。其中一个函数在旧节点和新节点之间分配条目;另一个形成两个谓词的并集来更新父节点的谓词。

随着新值的添加,现有谓词的扩展,它们通常只有在页面分裂或重建整个索引时才会缩小。因此,频繁更新 GiST 索引会导致其性能下降。

由于所有这些理论讨论可能看起来过于模糊,而且确切的逻辑主要取决于特定的操作符类,所以我将提供几个具体的例子。

26.2 点的 R 树

第一个例子涉及索引平面上的点 (或其他几何图形)。由于没有为点定义比较操作符,所以不能使用常规 B 树来处理这种数据类型。显然,我们可以自己实现这样的操作符,但是几何图形需要索引来支持完全不同的操作。我将讨论其中的两个:搜索包含在特定区域内的对象和最近邻搜索。

R 树在平面上绘制矩形;这些矩形加起来必须覆盖所有索引点。索引条目存储边界框,谓词可以定义如下:点位于这个边界框内。

R 树的根包含几个大矩形 (它们也可能重叠)。子节点持有更小的矩形,这些矩形适合其父节点;它们一起覆盖所有底层的点。

叶节点应该包含索引点本身,但 GiST 要求所有条目具有相同的数据类型;因此,叶节点条目也用矩形表示,只是简化为点。

为了更好地可视化此结构,让我们看一下在机场坐标上建立的 R 树的三个层级。对于这个例子,我已经将示例数据库中的 airports 表扩展到了五千行。5 我还降低了 fillfactor90 值以使树更深;默认值得到的是一个单层树。

=> CREATE TABLE airports_big AS
  SELECT * FROM airports_data;
=> COPY airports_big FROM
  '/home/student/internals/airports/extra_airports.copy';
=> CREATE INDEX airports_gist_idx ON airports_big
  USING gist(coordinates) WITH (fillfactor=10);

在上层,所有点都被包含在几个 (部分重叠的) 边界框中:

26.2 点的 R 树:插图 1
图 26.1

在下一层,大矩形被分割成更小的矩形:

26.2 点的 R 树:插图 2
图 26.2

最终,在树的内层,每个边界框包含的点数与单个页面可以容纳的点数相同。

26.2 点的 R 树:插图 3
图 26.3

此索引使用了 point_ops 操作符类,这是点唯一可用的操作符类。

矩形和任何其他几何图形也可以以相同的方式进行索引,但索引必须存储对象的边界框,而不是对象本身。

26.2.1 页面布局

你可以使用 pageinspectv. 14 扩展来研究 GiST 页面。

与 B 树索引不同,GiST 没有元页面,零页始终是树的根。如果根页面被分裂,旧的根会被移动到一个单独的页面,新的根则会取代它的位置。

这是根页面的内容:

=> SELECT ctid, keys
FROM gist_page_items(
  get_raw_page('airports_gist_idx', 0), 'airports_gist_idx'
);
    ctid     |                          keys
−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 (207,65535) | (coordinates)=((50.84510040283203,78.246101379395))
 (400,65535) | (coordinates)=((179.951004028,73.51780700683594))
 (206,65535) | (coordinates)=((−1.5908199548721313,40.63980103))
 (466,65535) | (coordinates)=((−1.0334999561309814,82.51779937740001))
(4 rows)

这四行对应于第一张图片中显示的上层的四个矩形。不幸的是,此处键显示为点 (这对叶子页面而言是有意义的),而不是矩形 (这对内部页而言将更合乎逻辑)。但我们总是可以获取原始数据并自行解释它。

要提取更详细的信息,你可以使用 gevel 扩展 6,此扩展不包含在标准 PostgreSQL 发行版中。

26.2.2 操作符类

以下查询返回支持函数的列表,这些函数实现了树的搜索和插入操作的逻辑:7

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'gist'
AND opcname = 'point_ops'
ORDER BY amprocnum;
 amprocnum |         amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−
         1 | gist_point_consistent
         2 | gist_box_union 
         3 | gist_point_compress
         5 | gist_box_penalty
         6 | gist_box_picksplit
         7 | gist_box_same
         8 | gist_point_distance
         9 | gist_point_fetch
        11 | gist_point_sortsupport
(9 rows)

我已经列出了上面的必需函数:

1 consistency 函数,用于在搜索时遍历树

2 union 函数,合并矩形

5 penalty 函数,用于在插入条目时选择下降到哪个子树

6 picksplit 函数,在页面分裂发生之后分配条目到新页面上

7 same 函数,检查两个键是否相等

point_ops 操作符类包括以下操作符:

=> SELECT amopopr::regoperator, amopstrategy AS st, oprcode::regproc,
  left(obj_description(opr.oid, 'pg_operator'), 19) description
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gist'
AND opcname = 'point_ops'
ORDER BY amopstrategy;
      amopopr      | st |       oprcode       | description
−−−−−−−−−−−−−−−−−−−+−−−−+−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−
 <<(point,point)   |  1 | point_left          | is left of
 >>(point,point)   |  5 | point_right         | is right of
 ~=(point,point)   |  6 | point_eq            | same as
 <<|(point,point)  | 10 | point_below         | is below
 |>>(point,point)  | 11 | point_above         | is above
 <−>(point,point)  | 15 | point_distance      | distance between
 <@(point,box)     | 28 | on_pb               | point inside box
 <^(point,point)   | 29 | point_below         | deprecated, use <<|
 >^(point,point)   | 30 | point_above         | deprecated, use |>>
 <@(point,polygon) | 48 | pt_contained_poly   | is contained by
 <@(point,circle)  | 68 | pt_contained_circle | is contained by
(11 rows)

操作符名称通常并不能告诉我们太多关于操作符语义的信息,因此这个查询还显示了底层函数的名称及其描述。无论如何,所有的操作符都涉及几何形状的相对位置 (左边、右边、上方、下方、包含、被包含) 以及它们之间的距离。

与 B 树相比,GiST 提供了更多的策略。一些策略编号对几种类型的索引是通用的,8 而其他一些则通过公式计算 (例如,28、48 和 68 实际上代表相同的策略:矩形、多边形和圆形的"被包含")。此外,GiST 支持一些过时的操作符名称 («| 和 |»)。

操作符类可能只实现了一些可用策略。例如,点的操作符类不支持包含策略,但在为具有可测量面积的几何图形定义的类中 (box_ops、poly_ops 和 circle_ops) 是可用的。

26.2.3 搜索包含的元素

一个可以通过索引加速的典型查询会返回指定区域内的所有点。

例如,让我们找到所有位于莫斯科中心一度范围以内的机场:

=> SELECT airport_code, airport_name->>'en'
FROM airports_big
WHERE coordinates <@ '<(37.622513,55.753220),1.0>'::circle;
 airport_code |              ?column?
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 SVO          | Sheremetyevo International Airport
 VKO          | Vnukovo International Airport
 DME          | Domodedovo International Airport
 BKA          | Bykovo Airport
 ZIA          | Zhukovsky International Airport
 CKL          | Chkalovskiy Air Base
 OSF          | Ostafyevo International Airport
(7 rows)
=> EXPLAIN (costs off) SELECT airport_code
FROM airports_big
WHERE coordinates <@ '<(37.622513,55.753220),1.0>'::circle;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on airports_big
   Recheck Cond: (coordinates <@ '<(37.622513,55.75322),1>'::circle)
   −> Bitmap Index Scan on airports_gist_idx
       Index Cond: (coordinates <@ '<(37.622513,55.75322),1>'::ci...
(4 rows)

我们可以通过下图中的一个简单示例来更详细地了解这个操作符:

26.2.3 搜索包含的元素:插图 4
图 26.4

如果以这种方式选择边界框,索引结构将如下所示:

26.2.3 搜索包含的元素:插图 5
图 26.5

包含操作符 <@ 用于判断特定的点是否位于指定矩形内。如果索引条目的矩形与该矩形有任何公共点,那么这个操作符的 consistency 函数 9 返回 “yes”。这意味着对于存储着缩小为点的矩形的叶节点条目,此函数用于判断该点是否包含在指定的矩形内。

例如,让我们找到下图中阴影矩形 (1,2)–(4,7) 的内部点:
26.2.3 搜索包含的元素:插图 6
图 26.6

搜索从根节点开始。边界框与 (0,0)-(3,4) 重叠,但不与 (5,3)-(9,9) 重叠。这意味着我们不需要下降到第二个子树。

在下一个层,边界框与 (0,3)-(3,4) 重叠,并且触及 (0,0)-(3,2),所以我们必须检查两个子树。

一旦我们到达叶节点,我们只需要检查它们包含的所有点,并返回那些满足 consistency 函数的点。

B 树搜索总是选择确切的一个子节点。然而,GiST 搜索可能需要扫描多个子树,尤其是当它们的边界框有重叠时。

26.2.4 最近邻搜索

大多数由索引支持的操作符 (如在前面示例中所示的 = 或 <@) 通常被称为搜索操作符,因为它们定义了查询中的搜索条件。这些操作符是谓词,即它们返回一个逻辑值。

但也有一组排序操作符,它们返回参数之间的距离。这些操作符用在 ORDER BY 子句中,并且通常由具有 Distance Orderable 属性的索引支持,这使你能够快速找到指定数量的最近邻。这种类型的搜索被称为 k-NN,或 k-最近邻搜索。

例如,我们可以找到最靠近科斯特罗马的 10 个机场:

=> SELECT airport_code, airport_name->>'en'
FROM airports_big
ORDER BY coordinates <-> '(40.926780,57.767943)'::point
LIMIT 10;
 airport_code |                    ?column?
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 KMW          | Kostroma Sokerkino Airport
 IAR          | Tunoshna Airport
 IWA          | Ivanovo South Airport
 VGD          | Vologda Airport
 RYB          | Staroselye Airport
 GOJ          | Nizhny Novgorod Strigino International Airport
 CEE          | Cherepovets Airport
 CKL          | Chkalovskiy Air Base
 ZIA          | Zhukovsky International Airport
 BKA          | Bykovo Airport
(10 rows)
=> EXPLAIN (costs off) SELECT airport_code
FROM airports_big
ORDER BY coordinates <-> '(40.926780,57.767943)'::point
LIMIT 5;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Limit
   −> Index Scan using airports_gist_idx on airports_big
       Order By: (coordinates <−> '(40.92678,57.767943)'::point)
(3 rows)

由于索引扫描可以逐个返回结果,并且可以随时停止,因此可以非常快速地找到前几个值。

如果没有索引支持,要实现高效的搜索会非常困难。我们需要找到特定区域内的所有点,然后逐渐扩大此区域,直到返回所请求的结果数量为止。这将需要多次索引扫描,更不用说选择初始区域大小及其增量的问题了。

你可以在系统目录中看到操作符类型 (“s” 代表搜索,“o” 代表排序操作符):

=> SELECT amopopr::regoperator, amoppurpose, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
WHERE amname = 'gist'
AND opcname = 'point_ops'
ORDER BY amopstrategy;
      amopopr      | amoppurpose | amopstrategy
−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 <<(point,point)   | s           | 1
 >>(point,point)   | s           | 5
 ~=(point,point)   | s           | 6
 <<|(point,point)  | s           | 10
 |>>(point,point)  | s           | 11
 <−>(point,point)  | o           | 15
 <@(point,box)     | s           | 28
 <^(point,point)   | s           | 29
 >^(point,point)   | s           | 30
 <@(point,polygon) | s           | 48
 <@(point,circle)  | s           | 68
(11 rows)

为了支持这样的查询,操作符类必须定义一个额外的支持函数:距离函数,该函数在索引条目上调用,用于计算此条目中存储的值与其他某个值之间的距离。

对于表示索引值的叶元素,此函数必须返回到该值的距离。在点的情况下,10 它是常规的欧几里得距离,等于 (x2−x1)2+(y2−y1)2\sqrt{(x_2 - x_1)^2 + (y_2 - y_1)^2}。

对于内部元素,该函数必须返回从其子叶元素到目标点的所有可能距离中的最小值。由于扫描所有子条目的成本很高,因此该函数可以乐观地低估距离 (牺牲一些效率),但绝不能返回更大的值 — 这会破坏搜索的准确性。

因此,对于由边界框表示的内部元素,与点的距离按照常规数学意义理解:如果点在矩形内,则距离为零;否则是点与矩形之间的最小距离。11 这个值可以在不遍历矩形的所有子点的情况下轻松计算出来,并且保证不大于到这些点中任何一个的距离。

让我们考虑搜索点 (6,8) 的三个最近邻的算法:
26.2.4 最近邻搜索:插图 7
图 26.7

搜索从根节点开始,它包含两个边界框。指定点到矩形 (0,0)–(3,4) 的距离被视为到矩形角 (3,4) 的距离,等于 5.0。到 (5,3)–(9,9) 的距离是 0.0。(我打算将这里的所有值四舍五入到小数点后一位;对于这个例子,这样的精度就足够了)。

子节点按照距离增加的顺序进行遍历。因此,我们首先下降到右边的子节点,其中包含两个矩形:(5,3)–(8,5) 和 (6,6)–(9,9)。到第一个矩形的距离是 3.0;到第二个矩形的距离是 0.0。

再一次,我们选择右侧的子树,并进入包含三个点的叶节点:(6,6) 的距离为 2.0, (8,9) 的距离为 2.2, (9,7) 的距离为 3.2。
26.2.4 最近邻搜索:插图 8
图 26.8

因此,我们已经找到了前两个点:(6,6) 和 (8,9)。但该节点的第三个点与矩形 (5,3)-(8,5) 的距离比到 (9,7) 的距离要大。

所以现在我们必须下降到左边的子节点,其中包含两个点。到点 (8,5) 的距离是 3.6,而到 (5,3) 的距离是 5.1。结果表明,前一个子节点中的点 (9,7) 比左子树的任何节点都更接近点 (6,8),所以我们可以将其作为第三个结果返回。
26.2.4 最近邻搜索:插图 9
图 26.9

这个例子说明了内部条目的距离函数必须满足的要求。由于到矩形 (5,3)-(8,5) 的距离减小了 (3.0 而不是 3.6),所以必须扫描一个额外的节点,因此搜索效率有所下降;然而,算法本身仍然是正确的。

26.2.5 插入

当一个新键被插入到 R 树中时,用于该键的节点由 penalty 函数确定:边界框的大小必须尽可能少地增加。12

例如,点 (4,7) 将被添加到矩形 (5,3)-(9,9) 中,因为它的面积将仅增加 6 个单位,而矩形 (0,0)-(3,4) 需要增加 12 个单位。在下一层 (叶子),点将被添加到矩形 (6,6)-(9,9) 中,遵循同样的逻辑。
26.2.5 插入:插图 10
图 26.10

假设一个页面最多只能包含三个元素,那么就需要将其拆分为两个,并且元素必须在新页面之间分配。在这个例子中,结果看起来是显而易见的,但在一般情况下,数据分配任务并不那么简单。首先,picksplit 函数尝试最小化边界框之间的重叠,旨在获得更小的矩形和并在页面间实现点的均匀分布。13
26.2.5 插入:插图 11
图 26.11

26.2.6 排它约束

GiST 索引也可以用于排它约束。

排它约束保证了任何两个堆元组的指定字段不会在某个操作符意义上相匹配。以下条件必须满足:

  • 索引方法必须支持排它约束 (CAN EXCLUDE 属性) 。

  • 操作符必须属于这种索引方法的操作符类。

  • 操作符必须是可交换的,即条件 “a operator b = b operator a” 必须为真。

对于上面考虑的哈希和 B 树访问方法,唯一合适的操作符是等于。它实际上将一个排它约束变成了一个唯一约束,这并不是很有用。

GiST 方法还有两种更适用的策略:

  • 重叠:&& 运算符

  • 相邻:-|-运算符 (为区间定义)

尝试一下,让我们创建一个约束,禁止机场彼此靠得太近。这个条件可以表述如下:以机场坐标为中心的特定半径的圆不能重叠:

=> ALTER TABLE airports_data ADD EXCLUDE
USING gist (circle(coordinates,0.2) WITH &&);
=> INSERT INTO airports_data(
  airport_code, airport_name, city, coordinates, timezone
) VALUES (
  'ZIA', '{}', '{"en": "Moscow"}', point(38.1517, 55.5533),
  'Europe/Moscow'
);
ERROR: conflicting key value violates exclusion constraint
"airports_data_circle_excl"
DETAIL: Key (circle(coordinates, 0.2::double
precision))=(<(38.1517,55.5533),0.2>) conflicts with existing key
(circle(coordinates, 0.2::double
precision))=(<(37.90629959106445,55.40879821777344),0.2>).

当定义了排它约束,会自动添加一个索引来强制执行它。此处是一个基于表达式创建的 GiST 索引。

让我们来看一个更复杂的例子。假设我们允许机场距离接近,但前提是它们属于同一个城市。一个可能的解决方案是定义一个新的完整性约束,可以如下表述:如果圆的中心位于机场坐标,并且对应的城市名称不同 (!=),则禁止存在具有相交 (&&) 的圆的一组行。

尝试创建这样的约束会导致报错,因为 text 数据类型没有操作符类:

=> ALTER TABLE airports_data
DROP CONSTRAINT airports_data_circle_excl; -- delete old data
=> ALTER TABLE airports_data ADD EXCLUDE USING gist (
  circle(coordinates,0.2) WITH &&,
            (city->>'en') WITH !=
);
ERROR: data type text has no default operator class for access
method "gist"
HINT: You must specify an operator class for the index or define a
default operator class for the data type.

然而,GiST 确实提供了像 “strictly left of"、"strictly right of” 和 “same” 的策略,这些策略也可以应用于常规的允许比较和排序的数据类型,例如数字或文本字符串。btree_gist 扩展专门用于实现 GiST 对通常与 B 树一起使用的操作的支持:

=> CREATE EXTENSION btree_gist;
=> ALTER TABLE airports_data ADD EXCLUDE USING gist (
  circle(coordinates,0.2) WITH &&,
            (city->>'en') WITH !=
);
ALTER TABLE

约束现已创建。现在我们不能添加属于同名城镇的茹科夫斯基机场,因为莫斯科的机场太近了:

=> INSERT INTO airports_data(
  airport_code, airport_name, city, coordinates, timezone
) VALUES (
  'ZIA', '{}', '{"en": "Zhukovsky"}', point(38.1517, 55.5533),
  'Europe/Moscow'
);
ERROR: conflicting key value violates exclusion constraint
"airports_data_circle_expr_excl"
DETAIL: Key (circle(coordinates, 0.2::double precision), (city −>>
'en'::text))=(<(38.1517,55.5533),0.2>, Zhukovsky) conflicts with
existing key (circle(coordinates, 0.2::double precision), (city −>>
'en'::text))=(<(37.90629959106445,55.40879821777344),0.2>, Moscow).

但如果我们指定这个机场的城市为莫斯科,我们就可以做到:

=> INSERT INTO airports_data(
  airport_code, airport_name, city, coordinates, timezone
) VALUES (
  'ZIA', '{}', '{"en": "Moscow"}', point(38.1517, 55.5533),
  'Europe/Moscow'
);
INSERT 0 1

重要的是要记住,即使 GiST 支持大于、小于和等于操作,但在这方面 B 树要高效得多,尤其是在访问一系列值时。因此,只有在 GiST 索引确实因其他合理原因而需要时,上面所展示的 btree_gist 扩展技巧才有意义。

26.2.7 属性

访问方法属性。以下是 GiST 方法的属性:

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'gist';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 gist 	| can_order     | f
 gist 	| can_unique    | f
 gist 	| can_multi_col | t
 gist 	| can_exclude   | t
 gist 	| can_include   | t
(5 rows)

唯一约束和排序是不被支持的。

创建 GiST 索引时可以包含额外的 INCLUDE 列v. 12。

正如我们所知,我们可以在多个列上创建索引,也可以在完整性约束中使用。

索引级属性。这些属性在索引级别定义:

=> SELECT p.name, pg_index_has_property('airports_gist_idx', p.name)
FROM unnest(array[
 'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
 clusterable   | t
 index_scan    | t
 bitmap_scan   | t
 backward_scan | f
(4 rows)

GiST 索引可用于聚簇。

至于数据检索方法,既支持常规 (逐行) 索引扫描,也支持位图扫描。但是,不允许对 GiST 索引进行反向扫描。

列级属性。大多数列级属性都是在访问方法级别定义的,并且保持不变:

=> SELECT p.name,
  pg_index_column_has_property('airports_gist_idx', 1, p.name)
FROM unnest(array[
  'orderable', 'search_array', 'search_nulls'
]) p(name);
     name     | pg_index_column_has_property
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 orderable    | f
 search_array | f
 search_nulls | t
(3 rows)

所有与排序相关的属性都被禁用。

空值是允许的,但 GiST 在处理它们时并不是很高效。空值不会增大边界框;这样的值会被插入到随机的子树中,所以在整个树中都需要搜索它们。

然而,一些列级属性确实依赖于特定的操作符类:

=> SELECT p.name,
  pg_index_column_has_property('airports_gist_idx', 1, p.name)
FROM unnest(array[
   'returnable', 'distance_orderable'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 returnable         | t
 distance_orderable | t
(2 rows)

仅索引扫描是允许的,因为叶节点保留了完整的索引键。

正如我们上面看到的,这个操作符类提供了用于最近邻搜索的距离操作符。到空值的距离被认为是空;这些值最后返回 (类似于 B 树中的 NULLS LAST 子句)。

然而,没有针对范围类型 (代表线段,即线性几何而不是面积几何) 的距离操作符,因此为此类类型创建的索引属性有所不同:

=> CREATE TABLE reservations(during tsrange);
=> CREATE INDEX ON reservations USING gist(during);

=> SELECT p.name,
  pg_index_column_has_property('reservations_during_idx', 1, p.name)
FROM unnest(array[
   'returnable', 'distance_orderable'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 returnable         | t
 distance_orderable | f
(2 rows)

26.3 用于全文检索的 RD 树

26.3.1 关于全文检索

全文检索的目的 14 是从提供的数据集中选择那些与搜索查询相匹配的文档。

为了进行搜索,文档被转换为 tsvector 类型,其中包含词素以及它们在文档中的位置。词素是被转换成适合搜索格式的单词。默认情况下,所有单词都会被标准化为小写,并且它们的词尾被切除:

=> SET default_text_search_config = english;
=> SELECT to_tsvector(
  'No one can tell me, nobody knows, ' ||
  'Where the wind comes from, where the wind goes.'
);
                             to_tsvector
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
'come':11 'goe':16 'know':7 'nobodi':6 'one':2 'tell':4 'wind':10,15
(1 row)

所谓的停止词 (如 “the” 或 “from”) 被过滤掉:它们被认为出现得太频繁,以至于搜索不会返回任何有意义的结果。当然,所有这些转换都是可配置的。

搜索查询由另一种类型表示:tsquery。任何查询都包含一个或多个由逻辑连接词组合的词素:& (与),| (或),! (非)。你还可以使用括号来定义操作符的优先级。

=> SELECT to_tsquery('wind & (comes | goes)');
         to_tsquery
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 'wind' & ( 'come' | 'goe' )
(1 row)

用于全文检索的唯一操作符是匹配操作符 @@:

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gist'
AND opcname = 'tsvector_ops'
ORDER BY amopstrategy;
       amopopr        |   oprcode   | amopstrategy
−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 @@(tsvector,tsquery) | ts_match_vq |            1
(1 row)

这个操作符决定了文档是否满足查询条件。这里有一个例子:

=> SELECT to_tsvector('Where the wind comes from, where the wind goes')
  @@ to_tsquery('wind & coming');
?column?
−−−−−−−−−−
 t
(1 row)

这绝不是全文检索的详尽描述,但这些信息应该足以理解索引基础。

26.3.2 索引 tsvector 数据

为了高效工作,全文检索必须由索引支持。15 由于索引的不是文档本身,而是 tsvector 值,因此你有两个选择:要么在表达式上创建一个索引并执行类型转换,要么添加一个 tsvector 类型的单独列并索引这个列。第一种方法的好处是它不会浪费存储 tsvector 值的空间,因为这些值实际上并不需要。但它比第二种选择要慢,因为索引引擎必须重新检查由访问方法返回的所有堆元组。这意味着对于每个重新检查的行,tsvector 值必须重新计算,正如我们很快会看到的,GiST 会重新检查所有行。

让我们构造一个简单的例子。我们将创建一个两列的表:第一列存储文档,而第二列保存 tsvector 值。我们可以使用触发器来更新第二列,16 但声明该列为生成列v. 12会更为方便:17

=> CREATE TABLE ts(
  doc text,
  doc_tsv tsvector GENERATED ALWAYS AS (
    to_tsvector('pg_catalog.english', doc)
	) STORED
);
=> CREATE INDEX ts_gist_idx ON ts
USING gist(doc_tsv);

在上面的例子中,我使用了带有单个参数的 to_tsvector 函数,并设置了 default_text_search_configenglish 参数来定义全文检索配置。由于此函数的这一版本隐式依赖于参数值,其稳定性类别是 STABLE。但在这里,我使用了另一个明确定义配置的版本;此版本是 IMMUTABLE 的,可以用在生成表达式中。

让我们插入几行:

=> INSERT INTO ts(doc)
VALUES
  ('Old MacDonald had a farm'),
  ('And on his farm he had some cows'),
  ('Here a moo, there a moo'),
  ('Everywhere a moo moo'),
  ('Old MacDonald had a farm'),
  ('And on his farm he had some chicks'),
  ('Here a cluck, there a cluck'),
  ('Everywhere a cluck cluck'),
  ('Old MacDonald had a farm'),
  ('And on his farm he had some pigs'),
  ('Here an oink, there an oink'),
  ('Everywhere an oink oink')
RETURNING doc_tsv;
            doc_tsv
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 'farm':5 'macdonald':2 'old':1
 'cow':8 'farm':4
 'moo':3,6
 'everywher':1 'moo':3,4
 'farm':5 'macdonald':2 'old':1
 'chick':8 'farm':4
 'cluck':3,6
 'cluck':3,4 'everywher':1
 'farm':5 'macdonald':2 'old':1
 'farm':4 'pig':8
 'oink':3,6
 'everywher':1 'oink':3,4
(12 rows)
INSERT 0 12

因此,R 树不适合用于索引文档,因为对它们来说,边界框的概念没有意义。因此,使用了它的 RD 树 (俄罗斯套娃) 修改版本。这样的树不使用边界框,而是使用边界集,即包含其子集所有元素的集合。对于全文检索,这样的集合包含文档的词素,但在一般情况下,边界集可以是任意的。

在索引条目中,有几种方法可以表示边界集。最简单的方法是枚举集合的所有元素。

以下是它可能的样子:
26.3.2 索引 tsvector 数据:插图 12
图 26.12

为了找到满足 DOC_TSV @@ TO_TSQUERY(‘row’) 条件的文档,我们需要下降到子条目已知包含 “cow” 词素的节点。

这种表示方法的问题是显而易见的。一个文档中的词素数量可能是巨大的,而页面大小是有限的。即使每个特定的文档单独来看时并没有太多不同的词素,它们在树的上层合并后的集合仍然可能过大。
26.3.2 索引 tsvector 数据:插图 13
图 26.13

全文检索使用另一种解决方案,即更紧凑的签名树。对于那些处理布隆过滤器的人来说应该非常熟悉。

每个词素都可以用其签名表示:一个特定长度的位串,其中只有一个位被设置为 1。应该设置哪一位由词素的哈希函数决定。

一个文档的签名是这个文档中所有词素的签名进行按位或运算的结果。

假设我们已经为我们的词素分配了以下签名:
26.3.2 索引 tsvector 数据:插图 14
图 26.14

那么此文档的签名如下所示:

26.3.2 索引 tsvector 数据:插图 15
图 26.15

索引树可以这样表示:

26.3.2 索引 tsvector 数据:插图 16
图 26.16

这种方法的优点是显而易见的:索引条目具有相同的大小,而且非常小,因此索引显得非常紧凑。但是,这种方法也有一定的缺点。首先,由于索引不再存储索引键,因此无法执行仅索引扫描,每个返回的 TID 都必须通过表重新检查。准确性也受到影响:索引可能返回许多误报 (false positives),必须在重新检查期间将其过滤掉。

让我们再看一下 DOC_TSV @@ TO_TSQUERY(‘COWS’) 条件。查询的签名和文档的签名计算方式相同;在这个特定案例中,它等于 0000010。consistency 函数 18 必须找到所有在其签名中设置了相同位的子节点:
26.3.2 索引 tsvector 数据:插图 17
图 26.17

与前面的示例相比,这里因为误报的原因需要扫描更多的节点。由于签名的容量有限,大数据集中的一些词素必然具有相同的签名。在这个例子中,此类词素是 “cow” 和 “oink”。这意味着同一个签名可以匹配不同的文档;这里查询的签名对应其中三个。

误报降低了索引的效率,但不以任何方式影响其正确性:由于保证排除了漏报 (false negative),所以不可能错过所需的值。

显然,签名的实际大小更大。默认情况下,它占用 124 字节 (992 比特),因此冲突的可能性比这个例子中的要低得多。如果需要v. 13,你可以使用操作符类参数将签名大小进一步增加到大约 2000 字节:

CREATE INDEX ... USING gist(column tsvector_ops(siglen = size));

此外,如果值足够小 (略小于页面的 1/16,对于标准页面大约是 500 字节),19 那么在索引的叶子页面上,tsvector_ops 操作符类保留的是 tsvector 值本身,而不是它们的签名。

要了解索引在实际数据上是如何工作的,我们可以使用 pgsql-hackers 邮件列表归档。20 它包含了 356125 封电子邮件及其发送日期、主题、作者姓名和正文。

让我们添加一个 tsvector 类型的列并建立索引。在这里,我将三个值 (主题、作者和正文) 合并成一个单一向量,以展示文档可以动态生成,而不必存储在单一列中。

=> ALTER TABLE mail_messages ADD COLUMN tsv tsvector
GENERATED ALWAYS AS ( to_tsvector(
  'pg_catalog.english', subject||' '||author||' '||body_plain
) ) STORED;
NOTICE: word is too long to be indexed
DETAIL: Words longer than 2047 characters are ignored.
 ...
NOTICE: word is too long to be indexed
DETAIL: Words longer than 2047 characters are ignored.
ALTER TABLE

=> CREATE INDEX mail_gist_idx ON mail_messages USING gist(tsv);
=> SELECT pg_size_pretty(pg_relation_size('mail_gist_idx'));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 127 MB
(1 row)

在填充列的过程中,由于大小的原因,一定数量的最大单词被过滤掉了。但是一旦索引准备好了,它就可以在搜索查询中使用。

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM mail_messages
WHERE tsv @@ to_tsquery('magic & value');
                        QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using mail_gist_idx on mail_messages
   (actual rows=898 loops=1)
   Index Cond: (tsv @@ to_tsquery('magic & value'::text))
   Rows Removed by Index Recheck: 7859
(4 rows)

除了满足条件的 898 行外,访问方法还返回了 7859 行,这些行稍后将在重新检查期间被过滤掉。如果我们增加了签名的容量,这将提高准确性 (因此也提高了索引的效率),但索引大小会增加:

=> DROP INDEX mail_messages_tsv_idx;
=> CREATE INDEX ON mail_messages
USING gist(tsv tsvector_ops(siglen=248));

=> SELECT pg_size_pretty(pg_relation_size('mail_messages_tsv_idx'));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 139 MB
(1 row)

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM mail_messages
WHERE tsv @@ to_tsquery('magic & value');
                        QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using mail_messages_tsv_idx on mail_messages
   (actual rows=898 loops=1)
   Index Cond: (tsv @@ to_tsquery('magic & value'::text))
   Rows Removed by Index Recheck: 2060
(4 rows)

26.3.3 属性

我已经展示了访问方法的属性,其中大多数对于所有操作符类都是相同的。但是,以下两个列级属性值得一提:

=> SELECT p.name,
  pg_index_column_has_property('mail_messages_tsv_idx', 1, p.name)
FROM unnest(array[
   'returnable', 'distance_orderable'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 returnable         | f
 distance_orderable | f
(2 rows)

现在无法进行仅索引扫描,因为无法从其签名恢复原始值。在这个特定情况下,这是完全可以接受的:tsvector 值仅用于搜索,而我们需要检索的是文档本身。

对于 tsvector_ops 类,排序操作符也没有定义。

26.4 其他数据类型

我只考虑了两个最重要的例子。它们展示了尽管 GiST 方法基于平衡树,但得益于不同操作符类中不同的支持函数实现,它可以用于多种数据类型。当我们谈论 GiST 索引时,我们必须始终指定操作符类,因为它对索引属性至关重要。

以下是 GiST 访问方法目前支持的更多数据类型:

几何数据类型。除了点,GiST 还可以索引其他几何对象:矩形、圆形、多边形。为此,所有这些对象都由它们的边界框表示。

cube 扩展添加了同名数据类型,代表多维立方体。它们使用具有相应维度的边界框的 R 树进行索引。

范围类型。 PostgreSQL 提供了几种内置的数字和时间范围类型,例如 int4range 和 tstzrange。21 你可以使用 CREATE TYPE AS RANGE 命令定义自定义范围类型。

所有范围类型,无论是标准的还是自定义的,都由 GiST 通过 range_ops 操作符类支持。22 对于索引,应用一维 R 树:在这种情况下,边界框被转换为边界段。

多范围类型v. 14也支持;它们依赖于 multirange_ops 类。边界范围包括作为多范围值的一部分的所有范围。

seg 扩展提供了用于区间的同名数据类型,其边界具有特定的精度。它虽然不被视为范围类型,但实际上是,因此可以以完全相同的方式进行索引。

Ordinal 类型。让我们再次回顾一下 btree_gist 扩展:它为 GiST 方法提供了操作符类以支持各种允许比较和排序的数据类型,这些数据类型通常由 B 树索引。当其中一列的数据类型不被 B 树支持时,这样的操作符类可用于构建多列索引。

网络地址类型。inet 数据类型内置了 GiST 支持,通过 inet_ops 操作符类 23 实现。

整数数组。intarray 扩展扩展了整数数组的功能,为它们添加了 GiST 支持。有两类操作符。对于小型数组,你可以使用 gist_int_ops,它实现了 RD 树,索引条目中的键具有完整表示。大型数组将从基于 gist_bigint_ops 操作符类的更紧凑但精度更低的签名 RD 树中受益。

操作符类名称中额外的下划线属于基本类型数组的名称。例如,除了更常见的 int4[] 表示法之外,整数数组还可以表示为 _int4。尽管如此,不存在 _int和 _bigint 类型。

Ltree。ltree 扩展添加了同名数据类型,用于带有标签的树状结构。通过使用签名 RD 树提供 GiST 支持,这些树使用用于 ltree 值的 gist_ltree_ops 操作符类和用于 ltree 类型数组的 gist__ltree_ops 操作符类。

键值存储。hstore 扩展提供了用于存储键值对的 hstore 数据类型。gist_hstore_ops 操作符类基于签名 RD 树实现了索引支持。

三元组。pg_trgm 扩展添加了 gist_trgm_ops 类,该类实现了用于比较文本字符串和通配符搜索的索引支持。


  1. postgresql.org/docs/14/gist.html
    backend/access/gist/README ↩︎

  2. backend/access/gist/gistget.c, gistgettuple function ↩︎

  3. backend/access/gist/gistutil.c, gistchoose function ↩︎

  4. backend/access/gist/gistsplit.c, gistSplitByKey function ↩︎

  5. You can download the corresponding file at edu.postgrespro.ru/internals-14/extra_airports.copy (I have used the data available at the openflights.org website). ↩︎

  6. sigaev.ru/git/gitweb.cgi?p=gevel.git ↩︎

  7. postgresql.org/docs/14/gist-extensibility.html ↩︎

  8. include/access/stratnum.h ↩︎

  9. backend/access/gist/gistproc.c, gist_point_consistent function ↩︎

  10. backend/utils/adt/geo_ops.c, point_distance function ↩︎

  11. backend/utils/adt/geo_ops.c, box_closest_point function ↩︎

  12. backend/access/gist/gistproc.c, gist_box_penalty function ↩︎

  13. backend/access/gist/gistproc.c, gist_box_picksplit function ↩︎

  14. postgresql.org/docs/14/textsearch.html ↩︎

  15. postgresql.org/docs/14/textsearch-indexes.html ↩︎

  16. postgresql.org/docs/14/textsearch-features#TEXTSEARCH-UPDATE-TRIGGERS.html ↩︎

  17. postgresql.org/docs/14/ddl-generated-columns.html ↩︎

  18. backend/utils/adt/tsgistidx.c, gtsvector_consistent function ↩︎

  19. backend/utils/adt/tsgistidx.c, gtsvector_compress function ↩︎

  20. edu.postgrespro.ru/mail_messages.sql.gz ↩︎

  21. postgresql.org/docs/14/rangetypes.html ↩︎

  22. backend/utils/adt/rangetypes_gist.c ↩︎

  23. backend/utils/adt/network_gist.c ↩︎

27 SP-GiST

27.1 总览

SP-GiST 名称中的首字母代表空间划分。这里的空间被理解为执行搜索的任意值集合;它不必是常规意义上的空间 (比如二维平面)。名称中的 GiST 部分暗示了 GiST 和 SP-GiST 方法之间的某种相似性:它们都是广义搜索树,并作为索引各种数据类型的框架。

SP-GiST 方法背后的思想 1 是将搜索空间分割成几个非重叠的区域,这些区域又可以递归地分割成子区域。这样的划分产生了非平衡树 (与 B 树和 GiST 不同),可以用来实现诸如四叉树、k-D 树和基数树 (字典树) 等众所周知的结构。

非平衡树通常分支较少,因此深度较大。例如,一个四叉树节点最多有四个子节点,而一个 k-D 树节点只能有两个。如果树保留在内存中,这并不会引起任何问题;但是当存储在磁盘上时,树节点必须尽可能密集地打包进页面以最小化 I/O,这项任务并不是那么简单。B 树和 GiST 索引不需要处理这个问题,因为它们的每个树节点都占据整个页面。

SP-GiST 树的内部节点包含一个满足其所有子节点条件的值。这样的值通常称为前缀;它与 GiST 索引中的谓词扮演着相同的角色。指向 SP-GiST 子节点的指针可能含有标签。

叶节点元素包含一个索引值 (或它的一部分) 以及相应的 TID。

就像 GiST 一样,SP-GiST 访问方法仅实现主要算法,诸如并发访问、锁和日志记录等底层细节。新的空间划分算法和数据类型可以通过操作符类接口添加。操作符类提供大部分逻辑,并定义了许多索引方面的功能。

在 SP-GiST 中,搜索从根节点开始,2 深度优先。通过 consistency 函数来选择值得下降的节点,与 GiST 中使用的 consistency 函数类似。对于树的内部节点,这个函数返回一组其值与搜索谓词不矛盾的子节点。consistency 函数不会下降到这些节点:它仅仅评估相应的标签和前缀。对于叶节点,它判断该节点的索引值是否与搜索谓词匹配。

在非平衡树中,搜索时间会因为分支的深度而有所不同。

有两个支持函数参与将值插入到 SP-GiST 索引中。当从根节点开始遍历树时,choose 函数会做出以下决策之一:将新值发给一个现有的子节点,为该值创建一个新的子节点,或者分裂当前节点 (如果这个值与当前节点的前缀不匹配)。如果选定的叶子页面没有足够的空间,picksplit 函数用于决定哪些节点应该移动到新页面。

现在我将提供一些示例来说明这些算法。

27.2 点的四叉树

四叉树用于在二维平面上索引点。平面根据选定点被递归地分割成四个区域 (象限)。

这个点称为中心点;它作为节点前缀,即定义子值位置的条件。

根节点将平面分割成四个象限。
27.2 点的四叉树:插图 1
图 27.1

然后,每个象限进一步分割成它自己的四个象限。

27.2 点的四叉树:插图 2
图 27.2

这个过程持续进行,直到达到所需的区域数量。

27.2 点的四叉树:插图 3
图 27.3

这个例子使用了基于 airports_big 表建立的索引。示意图显示,分支深度取决于相应象限中点的密度。为了可视化,我将 fillfactor80 存储参数设置为较小的值,这使得树的深度更深。

=> CREATE INDEX airports_quad_idx ON airports_big
USING spgist(coordinates) WITH (fillfactor = 10);

点的默认操作符类是 quad_point_ops。

27.2.1 操作符类

我已经提及了 SP-GiST 支持函数:3 用于搜索的 consistency 函数和用于插入的 picksplit 函数。

现在,让我们看一下 quad_point_ops 操作符类的支持函数列表。4 所有这些函数都是必须的。

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'spgist'
AND opcname = 'quad_point_ops'
ORDER BY amprocnum;
 amprocnum |          amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−
         1 | spg_quad_config
         2 | spg_quad_choose
         3 | spg_quad_picksplit
         4 | spg_quad_inner_consistent
         5 | spg_quad_leaf_consistent
(5 rows)

这些函数执行以下任务:

1 config 函数向访问方法报告操作符类的基本信息。

2 choose 函数选择要插入的节点。

3 picksplit 函数在页面分裂后,在页面之间分配节点。

4 inner_consistent 函数检查内部节点的值是否满足搜索谓词。

5 leaf_consistent 函数判断叶节点中存储的值是否满足搜索谓词。

还有几个可选的函数。

quad_point_ops 操作符类支持与 GiST 相同的策略:5

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'spgist'
AND opcname = 'quad_point_ops'
ORDER BY amopstrategy;
      amopopr     |    oprcode     | amopstrategy
−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 <<(point,point)  | point_left     |            1
 >>(point,point)  | point_right    |            5
 ~=(point,point)  | point_eq       |            6
 <@(point,box)    | on_pb          |            8
 <<|(point,point) | point_below    |           10
 |>>(point,point) | point_above    |           11
 <−>(point,point) | point_distance |           15
 <^(point,point)  | point_below    |           29
 >^(point,point)  | point_above    |           30
(9 rows)

例如,你可以使用上述操作符 >^ 来找出位于迪克森北部的机场。

=> SELECT airport_code, airport_name->>'en'
FROM airports_big
WHERE coordinates >^ '(80.3817,73.5167)'::point;
 airport_code |          ?column?
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 THU          | Thule Air Base
 YEU          | Eureka Airport
 YLT          | Alert Airport
 YRB          | Resolute Bay Airport
 LYR          | Svalbard Airport, Longyear
 NAQ          | Qaanaaq Airport
 YGZ          | Grise Fiord Airport
 DKS          | Dikson Airport
(8 rows)
=> EXPLAIN (costs off) SELECT airport_code
FROM airports_big
WHERE coordinates >^ '(80.3817,73.5167)'::point;
                          QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
Bitmap Heap Scan on airports_big
  Recheck Cond: (coordinates >^ '(80.3817,73.5167)'::point)
  −> Bitmap Index Scan on airports_quad_idx
      Index Cond: (coordinates >^ '(80.3817,73.5167)'::point)
(4 rows)

让我们深入分析一下四叉树的结构和内部工作原理。我们将使用 GiST 章节中提到的相同例子,它包含几个点。

以下是在这种情况下如何划分平面的示意图:
27.2.1 操作符类:插图 4
图 27.4

左边的插图展示了树的某一层级中象限的编号;为了清晰起见,接下来的插图中,我将按照相同的顺序从左到右放置子节点。位于边界上的点被划入编号较小的象限。右边的插图显示了最终的分区。

你可以在下面看到该索引可能的结构。每个内部节点最多引用四个子节点,每个指针都用象限号标记:
27.2.1 操作符类:插图 5
图 27.5

27.2.2 页面布局

与 B 树和 GiST 索引不同,SP-GiST 树节点和页面之间没有一对一的对应关系。由于内部节点通常没有太多子节点,因此多个节点必须被打包进一个单独的页面中。不同类型的节点存储在不同的页面:内部节点存储在内部页面中,而叶节点则存储在叶子页面中。

内部页面中存储的索引项持有用作前缀的值,以及一组指向子节点的指针;每个指针可能伴随一个标签。

叶子页面的条目由一个值和一个 TID 组成。

与特定内部节点相关的所有叶节点都存储在一个单独的页面中,并绑定成一个列表。如果页面无法容纳另一个节点,这个列表可以移动到不同的页面,6 或者,页面也可以被分裂;无论哪种方式,列表从不会延伸至多个页面。

为了节省空间,算法尝试将新节点添加到同一页中,直到这些页面完全填满。最后使用的页面编号被后台进程缓存,并定期保存在零页中,称为元页面。元页面不包含指向根节点的引用,我们在 B 树中会看到根节点,而 SP-GiST 索引的根始终位于第一页。

不幸的是,pageinspect 扩展并没有提供窥探 SP-GiST 的函数,但我们可以使用名为 gevel 7 的外部扩展。它曾试图将其功能整合到 pageinspect 中,但并未成功。8

回到我们的例子。下面的插图显示了树节点如何在页面之间分配。quad_point_ops 操作符类实际上并不使用标签。由于一个节点最多可以有四个子节点,因此索引保留了一个固定大小的四指针数组,其中一些可能是空的。
27.2.2 页面布局:插图 6
图 27.6

27.2.3 搜索

让我们用同样的例子来看一下搜索位于点 (3,7) 上方的点的算法。
27.2.3 搜索:插图 7
图 27.7

搜索从根节点开始。内部 consistency 函数 9 决定了要下降的子节点。点 (3,7) 与根节点的中心点 (5,5) 进行比较,来选择可能包含所寻找点的象限;在这个例子中,是第一象限和第四象限。

一旦进入了具有中心点 (7,7) 的节点,我们必须再次选择要下降的子节点。它们属于第一象限和第四象限,但由于第四象限为空,我们只需要检查一个叶节点。叶节点的 consistency 函数 10 将此节点的点与查询中指定的点 (3,7) 进行比较。只有 (8,9) 满足上述条件。

现在我们只需要回到上一层,并检查对应于根节点的第四象限的节点。它是空的,所以搜索就完成了。
27.2.3 搜索:插图 8
图 27.8

27.2.4 插入

当一个值被插入到 SP-GiST 树中时,11 之后的每一个动作都由 choice 函数决定。12 在这个特定的情况下,它简单地将点指向对应其象限的现有节点之一。

例如,让我们添加值 (7,1):
27.2.4 插入:插图 9
图 27.9

这个值属于第二象限,将被添加到相应的树节点中:

27.2.4 插入:插图 10
图 27.10

如果在插入后,所选象限中的叶节点列表变得过大 (必须适应单个页面),那么页面会分裂。picksplit 函数 13 通过计算所有点坐标的平均值来确定新的中心点,从而或多或少均匀地在新象限之间分配子节点。

下图说明了由于点 (2,1) 插入而导致的页面溢出:
27.2.4 插入:插图 11
图 27.11

中心点是 (1,1) 的新内部节点被添加到树中,同时点 (0,0)、(1,2) 和 (2,1) 在新象限之间重新分配:
27.2.4 插入:插图 12
图 27.12

27.2.5 属性

访问方法属性。spgist 方法显示以下属性:

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'spgist';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 spgist | can_order     | f
 spgist | can_unique    | f
 spgist | can_multi_col | f
 spgist | can_exclude   | t
 spgist | can_include   | t
(5 rows)

不支持排序和唯一性属性。也不支持多列索引。

支持排它约束,与 GiST 类似。

可以创建带有额外 INCLUDE 列v. 14的 SP-GiST 索引。

索引级属性。与 GiST 不同,SP-GiST 索引不支持聚簇:

=> SELECT p.name, pg_index_has_property('airports_quad_idx', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
 clusterable   | f
 index_scan    | t
 bitmap_scan   | t
 backward_scan | f
(4 rows)

支持以两种方式获取 TIDS (要么逐个获取,要么作为位图)。不支持反向扫描,因为这对 SP-GiST 来说没有任何意义。

列级属性。在大多数情况下,列级属性是相同的:

=> SELECT p.name,
  pg_index_column_has_property('airports_quad_idx', 1, p.name)
FROM unnest(array[
  'orderable', 'search_array', 'search_nulls'
]) p(name);
     name     | pg_index_column_has_property
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 orderable    | f
 search_array | f
 search_nulls | t
(3 rows)

不支持排序,因此所有相关属性都没有任何意义,并且被禁用。

到目前为止我还没有提到空值,但正如我们在索引属性中看到的,是支持空值的。不同于 GiST,SP-GiST 索引不在主树中存储空值。相反,它会创建一个单独的树;它的根位于第二个索引页面。因此,前三个页面始终具有相同的含义:元页面、主树的根和空值树的根。

一些列级属性可能取决于特定的操作符类:

=> SELECT p.name,
  pg_index_column_has_property('airports_quad_idx', 1, p.name)
FROM unnest(array[
  'returnable', 'distance_orderable'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 returnable         | t
 distance_orderable | t
(2 rows)

就像本章中的所有其他例子一样,这个索引可以用于仅索引扫描。

但通常来说,操作符类不一定在叶子页面中存储完整的值v. 11,因为可以通过表重新检查它们。举个例子,这允许在 PostGIS 中使用 SP-GiST 索引来处理潜在的大型几何值。

支持最近邻搜索v. 12;我们已经在操作符类中看到了排序操作符 <->。

27.3 点的 K 维树

平面上的点也可以使用另一种分区方法进行索引:我们可以将平面分成两个子区域,而不是四个。这种分区由 kd_point_ops 14 操作符类实现:

=> CREATE INDEX airports_kd_idx ON airports_big
USING spgist(coordinates kd_point_ops);

请注意,索引值、前缀和标签可能具有不同的数据类型。对于这个操作符类,值表示为点,前缀是实数,而没有提供标签 (如 quad_point_ops 中的)。

让我们在 Y 轴上选择某个坐标 (它在示例中定义了纬度,与机场相对应)。这个坐标将平面分为两个子区域,上区域和下区域:
27.3 点的 K 维树:插图 13
图 27.13

对于这些子区域中的每一个,选择 X 轴 (经度) 上的坐标,将它们分成左右两个子区域:
27.3 点的 K 维树:插图 14
图 27.14

我们将继续分割每一个得到的子区域,轮流进行水平和垂直划分,直到每个部分中的点适应单一索引页为止:
27.3 点的 K 维树:插图 15
图 27.15

以这种方式构建的树的所有内部叶节点将只有两个子节点。这种方法可以很容易地推广到任意维度的空间,因此这样的树通常被称为 k 维树 (k-D 树)。

27.4 字符串的基数树

SP-GiST 的 text_ops 操作符类为字符串实现了基数树。15 在这里,内部节点的前缀确实是一个前缀,它是所有子节点中字符串的共同部分。

指向子节点的指针由前缀后面的值的第一个字节标记。

为清楚起见,我使用单个字符来表示前缀,但这仅适用于 8 字节编码。通常,操作符类将字符串作为字节序进行处理。此外,前缀可以取几个具有特殊语义的其他值,因此每个前缀实际上分配了两个字节。

子节点存储前缀和标签后面的部分值。叶节点只保留后缀。

这是一个基于几个名称构建的基数树的例子:
27.4 字符串的基数树:插图 16
图 27.16

为了重构叶子页面中索引键的完整值,我们可以从根节点开始,连接所有的前缀和标签。

27.4.1 操作符类

text_ops 操作符类支持通常用于 ordinal 数据类型的比较操作符,包括文本字符串:

=> SELECT oprname, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'spgist'
AND opcname = 'text_ops'
ORDER BY amopstrategy;
 oprname |     oprcode     | amopstrategy
−−−−−−−−−+−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 ~<~     | text_pattern_lt |            1
 ~<=~    | text_pattern_le |            2
 =       | texteq          |            3
 ~>=~    | text_pattern_ge |            4
 ~>~     | text_pattern_gt |            5
 <       | text_lt         |           11
 <=      | text_le         |           12
 >=      | text_ge         |           14
 >       | text_gt         |           15
 ^@      | starts_with     |           28
(10 rows)

常规操作符处理字符,而带波浪号的操作符处理字节。它们不考虑排序规则 (就像 B 树的 text_pattern_ops 操作符类),所以它们可以用来加速 LIKE 条件的搜索:

=> CREATE INDEX tickets_spgist_idx ON tickets
  USING spgist(passenger_name);
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE passenger_name LIKE 'IVAN%';
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
Bitmap Heap Scan on tickets
  Filter: (passenger_name ~~ 'IVAN%'::text)
  −> Bitmap Index Scan on tickets_spgist_idx
      Index Cond: ((passenger_name ~>=~ 'IVAN'::text) AND
      (passenger_name ~<~ 'IVAO'::text))
(5 rows)

如果将常规操作符 >= 和 < 与 “C” 以外的排序规则一起使用,那么索引实际上变得毫无用处,因为它处理的是字节而不是字符。

对于这种前缀搜索v. 11的情况,操作符类提供了更为合适的 ^@ 操作符:

=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE passenger_name ^@ 'IVAN';
                     QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
Bitmap Heap Scan on tickets
  Recheck Cond: (passenger_name ^@ 'IVAN'::text)
  −> Bitmap Index Scan on tickets_spgist_idx
      Index Cond: (passenger_name ^@ 'IVAN'::text)
(4 rows)

基数树的表示有时会比 B 树更为紧凑,因为它不存储完整的值:它会在遍历树的时候根据需要重建这些值。

27.4.2 搜索

让我们在 names 表上运行以下查询:

SELECT *
FROM names
WHERE name ~>=~ 'VALERIY'
  AND name ~<~ 'VLADISLAV';

首先,在根节点上调用内部 consistency 函数 16,以确定要下降的子节点。这个函数将前缀 V 与标签 A 和 L 连接起来。接收到的值 VA 进入查询条件;字符串字面量在那里被截断,以确保它们的长度不会超过正在检查的值的长度:VA ~ >=~ ‘VA’ and VA ~ <~ ‘VL’。条件满足,所以需要检查带标签 A 的子节点。值 VL 以同样的方式检查。它也是一个匹配项,所以也需要检查带标签 L 的节点。

现在让我们取与值 VA 对应的节点。它的前缀是空的,所以对于三个子节点,内部 consistency 函数通过连接在前一步接收到的 VA 和标签,重构值 VAD、VAL 和 VAS。条件 VAD ~ >=~ ‘VAL’ and VAD ~ <~ ‘VER’ 不成立,但其他两个值是合适的。

当以这种方式遍历树时,算法会过滤掉不匹配的分支,并到达叶节点。叶节点的 consistency 函数检查在遍历树期间重建的值是否满足查询条件。匹配的值作为索引扫描的结果返回。
27.4.2 搜索:插图 17
图 27.17

请注意,虽然查询使用了大于和小于操作符,这些操作符对于 B 树来说很常见,但是通过 SP-GiST 进行范围搜索的效率要低得多。在 B 树中,下降到范围的一个边界值,然后扫描叶子页面列表就足够了。

27.4.3 插入

点的操作符类的 choice 函数总是可以将一个新值导向一个现有子区域之一 (一个象限或其中的一半)。但对于基数树来说并非如此:新值可能与任何现有的前缀都不匹配,在这种情况下必须分裂内部节点。

让我们将名称 VLADA 添加到一个已经创建的树中。

choice 函数 17 成功地从根节点下降到下一个节点 ( V+L ),但值的剩余部分 ADA 与 ADI 前缀不匹配。节点必须被分成两部分:其中一个结果节点将包含公共部分的前缀 (AD),而前缀的其余部分将被下移一级:
27.4.3 插入:插图 18
图 27.18

然后,再次在同一节点上调用 choice 函数。前缀现在对应于该值,但是没有带有合适标签 (A) 的子节点,所以函数决定创建这样一个节点。最终结果如下图所示;在插入过程中添加或修改的节点会高亮显示。
27.4.3 插入:插图 19
图 27.19

27.4.4 属性

我已经在上面描述了访问方法和索引级属性;它们对所有类都是通用的。大多数列级属性也保持不变。

=> SELECT p.name,
  pg_index_column_has_property('tickets_spgist_idx', 1, p.name)
FROM unnest(array[
  'returnable', 'distance_orderable'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 returnable         | t
 distance_orderable | f
(2 rows)

即使索引值未显式存储在树中,也支持仅索引扫描,因为在从根节点到叶节点的遍历过程中可以重建值。

至于距离操作符,它没有为字符串定义,所以这个操作符类没有提供最近邻搜索。

这并不意味着无法为字符串实现距离的概念。例如,pg_trgm 扩展添加了一个基于三元组的距离操作符:在两个字符串中找到的公共三元组越少,它们彼此之间被认为的距离就越远。还有莱文斯坦距离,它被定义为将一个字符串转换为另一个字符串所需的最少单字符编辑次数。fuzzystrmatch 扩展中提供了计算这种距离的函数。但这些扩展都没有提供带有 SP-GiST 支持的操作符类。

27.5 其他数据类型

SP-GiST 操作符类不仅限于我们上面讨论的索引点和文本字符串。

几何类型。box_ops 18 操作符类实现了一个用于矩形的四叉树。矩形由四维空间中的点表示,所以区域被划分为十六个分区。

poly_opsv. 11 类可用于索引多边形。它是一个模糊操作符类:它实际上使用的是边界框而不是多边形,就像 box_ops 一样,然后通过表重新检查结果。

选择 GiST 还是 SP-GiST 在很大程度上取决于要索引的数据性质。例如,PostGIS 文档推荐对于具有大量重叠的对象 (也称为"意大利面数据") 使用 SP-GiST 索引。19

范围类型。用于范围的四叉树提供了 range_ops 操作符类。20 一个区间由二维点定义:X 轴表示下边界,而 Y 轴表示上边界。

网络地址类型。对于 inet 数据类型,inet_ops4 21 操作符类实现了一个基数树。


  1. postgresql.org/docs/14/spgist.html
    backend/access/spgist/README ↩︎

  2. backend/access/spgist/spgscan.c, spgWalk function ↩︎

  3. postgresql.org/docs/14/spgist-extensibility.html ↩︎

  4. backend/access/spgist/spgquadtreeproc.c ↩︎

  5. include/access/stratnum.h ↩︎

  6. backend/access/spgist/spgdoinsert.c, moveLeafs function ↩︎

  7. sigaev.ru/git/gitweb.cgi?p=gevel.git ↩︎

  8. commitfest.postgresql.org/15/1207 ↩︎

  9. backend/access/spgist/spgquadtreeproc.c, spg_quad_inner_consistent function ↩︎

  10. backend/access/spgist/spgquadtreeproc.c, spg_quad_leaf_consistent function ↩︎

  11. backend/access/spgist/spgdoinsert.c, spgdoinsert function ↩︎

  12. backend/access/spgist/spgquadtreeproc.c, spg_quad_choose function ↩︎

  13. backend/access/spgist/spgquadtreeproc.c, spg_quad_picksplit function ↩︎

  14. backend/access/spgist/spgkdtreeproc.c ↩︎

  15. backend/access/spgist/spgtextproc.c ↩︎

  16. backend/access/spgist/spgtextproc.c, spg_text_inner_consistent function ↩︎

  17. backend/access/spgist/spgtextproc.c, spg_text_choose function ↩︎

  18. backend/utils/adt/geo_spgist.c ↩︎

  19. postgis.net/docs/using_postgis_dbmanagement.html#spgist_indexes ↩︎

  20. backend/utils/adt/rangetypes_spgist.c ↩︎

  21. backend/utils/adt/network_spgist.c ↩︎

28 GIN

28.1 总览

根据作者的说法,GIN 代表的是一种强大而不屈的精神,而不是指一种酒精饮料。1 但 GIN 也有一个正式的解释:其缩写的全称是广义倒排索引。

GIN 访问方法用于表示由独立元素组成的非原子值的数据类型 (例如,在全文检索的上下文中,文档由词素组成)。与 GiST 不同,GiST 将值作为一个整体进行索引,GIN 仅对其元素进行索引;每个元素都映射到所有包含它的值。

我们可以将这种访问方法与书籍的索引进行比较,书籍索引包含所有重要的术语,并列出了这些术语提及的所有页面。为了方便使用,它需要按字母顺序编排,否则将无法快速查找。同样,GIN 也基于所有复合值的元素均可以排序这一事实;其主要数据结构是 B 树。

元素的 GIN 树实现比常规 B 树的实现要简单:它旨在包含相对较小且重复多次的元素集合。

此假设得出两个重要结论:

  • 一个元素在索引中只存储一次。

    每个元素都映射到一个 TIDS 列表,称为 posting list。如果这个列表很短,它会与元素一起存储;较长的列表则被移动到一个单独的 posting tree 中,这实际上是一颗 B 树。就像元素树一样,posting list 是有序的;从用户的角度来看这并不重要,但这有助于加速数据访问和减小索引大小。

  • 从树中移除元素没有意义。

    即使某个特定元素的 TIDS 列表为空,相同元素很可能作为其他值的一部分再次出现。

因此,索引是一棵元素树,其叶条目绑定到平面列表或 TIDS 树上。

就像 GiST 和 SP-GiST 访问方法一样,GIN 可以通过操作符类的简化接口为各种数据类型建立索引。这些类的操作通常检查索引的复合值是否匹配特定的元素集合 (就像 @@ 操作符检查一个文档是否满足全文检索查询一样)。

要索引特定的数据类型,GIN 方法必须能够将复合值分解为元素,对这些元素进行排序,并检查找到的值是否满足查询。这些操作由操作符类的支持函数实现。

28.2 用于全文检索的索引

GIN 主要用于加速全文检索,因此我将继续使用用于演示 GiST 索引的例子。正如你所猜测的,这种情况下的复合值是文档,而这些值的元素是词素。

让我们在 “Old MacDonald” 表上建立一个 GIN 索引:

=> CREATE INDEX ts_gin_idx ON ts USING gin(doc_tsv);

该索引的可能结构如下所示。与前面的插图不同,此处我提供了实际的 TID 值 (以灰色背景显示),因为它们对于理解算法非常重要。这些值表明堆元组具有以下 ID:
=> SELECT ctid, * FROM ts;
 ctid  |                doc                 |            doc_tsv
−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 (0,1) | Old MacDonald had a farm           | 'farm':5 'macdonald':2 'old':1
 (0,2) | And on his farm he had some cows   | 'cow':8 'farm':4
 (0,3) | Here a moo, there a moo            | 'moo':3,6
 (0,4) | Everywhere a moo moo               | 'everywher':1 'moo':3,4
 (1,1) | Old MacDonald had a farm           | 'farm':5 'macdonald':2 'old':1
 (1,2) | And on his farm he had some chicks | 'chick':8 'farm':4
 (1,3) | Here a cluck, there a cluck        | 'cluck':3,6
 (1,4) | Everywhere a cluck cluck           | 'cluck':3,4 'everywher':1
 (2,1) | Old MacDonald had a farm           | 'farm':5 'macdonald':2 'old':1
 (2,2) | And on his farm he had some pigs   | 'farm':4 'pig':8
 (2,3) | Here an oink, there an oink        | 'oink':3,6
 (2,4) | Everywhere an oink oink            | 'everywher':1 'oink':3,4
(12 rows)
28.2 用于全文检索的索引:插图 1
图 28.1

注意,此处 GIN 索引与常规的 B 树索引在某些方面有所不同。在 B 树索引的内部节点中,最左边的键是空的,因为它们实际上是多余的;在 GIN 索引中,这些键根本就不会被存储。因此,对子节点的引用也随之改变。高键在两种索引中都有使用,但在 GIN 索引中,它占据了合理的最右边的位置。在 B 树中,同级节点是通过双向列表绑定的;而 GIN 使用单向列表,因为树总是只往一个方向遍历。

在这个理论示例中,所有的 posting lists 都适合于常规页面,除了 “farm” 词素的 posting list。这个词素在多达六个文档中出现过,因此它的 ID 被移到了一个单独的 posting tree 中。

28.2.1 页面布局

GIN 的页面布局与 B 树的布局非常相似。我们可以使用 pageinspect 扩展来查看索引的内部结构。让我们在存储 pgsql-hackers 电子邮件的表上创建一个 GIN 索引。

=> CREATE INDEX mail_gin_idx ON mail_messages USING gin(tsv);

零页 (元页面) 包含了基本统计数据,例如元素数量和其他类型的页面:

=> SELECT *
FROM gin_metapage_info(get_raw_page('mail_gin_idx',0)) \gx
−[ RECORD 1 ]−−−−+−−−−−−−−−−−
pending_head     | 4294967295
pending_tail     | 4294967295
tail_free_size   | 0
n_pending_pages  | 0
n_pending_tuples | 0
n_total_pages    | 22957
n_entry_pages    | 13522
n_data_pages     | 9434
n_entries        | 999109
version          | 2

GIN 使用索引页的特殊空间;例如,这个空间存储了定义页面类型的比特位:

=> SELECT flags, count(*)
FROM generate_series(0,22956) AS p, -- n_total_pages
  gin_page_opaque_info(get_raw_page('mail_gin_idx',p))
GROUP BY flags
ORDER BY 2;
         flags          | count
−−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−
 {meta}                 |     1
 {}                     |   137
 {data}                 |  1525
 {data,leaf,compressed} |  7909
 {leaf}                 | 13385
(5 rows)

具有 meta 属性的页面当然是元页面。带有 data 属性的页面属于 posting list,而没有这个属性的页面与元素树有关。叶子页面具有 leaf 属性。

在下个例子中,另一个 pageinspect 函数返回存储在树叶页面中的 TID 信息。这种树的每个条目实际上是一个小的 TIDS 列表,而不是单个 TID:

=> SELECT left(tids::text,60)||'...' tids
FROM gin_leafpage_items(get_raw_page('mail_gin_idx',24));
                              tids
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 {"(4771,4)","(4775,2)","(4775,5)","(4777,4)","(4779,1)","(47...
 {"(5004,2)","(5011,2)","(5013,1)","(5013,2)","(5013,3)","(50...
 {"(5435,6)","(5438,3)","(5439,3)","(5439,4)","(5439,5)","(54...
 ...
 {"(9789,4)","(9791,6)","(9792,4)","(9794,4)","(9794,5)","(97...
 {"(9937,4)","(9937,6)","(9938,4)","(9939,1)","(9939,5)","(99...
 {"(10116,5)","(10118,1)","(10118,4)","(10119,2)","(10121,2)"...
(27 rows)

posting list 是有序的,因此可以被压缩 (所以具有 compressed 属性)。它们存储的不是六字节 TID,而是与前一个值的差异值,这个差异值用可变数量的字节来表示:2 差异值越小,数据占用的空间就越少。

28.2.2 操作符类

以下是 GIN 操作符类的支持函数列表:3

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'gin'
AND opcname = 'tsvector_ops'
ORDER BY amprocnum;
 amprocnum |              amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
         1 | gin_cmp_tslexeme
         2 | pg_catalog.gin_extract_tsvector
         3 | pg_catalog.gin_extract_tsquery
         4 | pg_catalog.gin_tsquery_consistent
         5 | gin_cmp_prefix
         6 | gin_tsquery_triconsistent
(6 rows)

第一个支持函数用于比较两个元素 (在本例中是两个词素)。如果词素由 B 树支持的常规 SQL 类型表示,那么 GIN 将自动使用 B 树操作符类中定义的比较操作符。

第五个 (可选) 函数用于部分搜索,以检查索引元素是否部分匹配搜索键。在此特例下,部分搜索包括通过前缀搜索词素。例如,查询 “c:*” 对应于所有以字母 “c” 开头的词素。

第二个函数从文档中提取词素,而第三个函数从搜索查询中提取词素。使用不同的函数是合理的,因为至少文档和查询由不同的数据类型表示,即 tsvector 和 tsquery。此外,搜索查询的函数决定了搜索的执行方式。如果查询要求文档包含特定的词素,那么搜索将仅限于至少包含一个查询中指定词素的文档。如果没有这样的条件 (例如,如果需要不包含特定词素的文档),则必须扫描所有文档 — 这当然要昂贵得多。

如果查询包含任何其他搜索键,首先会根据这些键扫描索引v. 13,然后重新检查这些中间结果。因此,没有必要完整扫描索引。

第四个和第六个函数是 consistency 函数,用于确定找到的文档是否满足搜索查询。作为输入,第四个函数获取查询中指定词素在文档中确切出现的信息。第六个函数在不确定的上下文中操作,当不确定文档中是否存在某些词素时可以被调用。操作符类不必实现这两个函数:只提供其中一个就足够了,但在这种情况下搜索效率可能会受到影响。

tsvector_ops 操作符类仅支持一个用于将文档与搜索查询相匹配的操作符:@@,4 该操作符也包含在 GiST 操作符类中。

28.2.3 搜索

让我们看一下 “everywhere | oink” 查询的搜索算法,其中两个词素通过 OR 操作符连接。首先,支持函数 5 从 tsquery 类型的搜索字符串中提取词素 “everywhere 和 oink” (搜索键)。

由于查询要求特定的词素存在,至少包含一个查询中指定键的文档的 TID 被绑定成一个列表。为此,每个搜索键对应的 TID 在词素树中被搜索出来,并被添加到一个公共列表中。索引中存储的所有 TIDS 都是有序的,这允许将几个有序的 TIDS 流合并为一个。6

注意,键是通过 AND、OR 还是任何其他操作符组合起来的并不重要:搜索引擎处理的是键的列表,它并不了解搜索查询的语义。
28.2.3 搜索:插图 2
图 28.2

每个找到的与文档相对应的 TID 都由 consistency 函数 7 检查。正是这个函数解释了搜索查询,并且只保留那些满足查询条件的 TIDS (或者至少可能满足条件,并且需要由表重新检查)。

在此特例下,consistency 函数保留了所有的 TIDS:
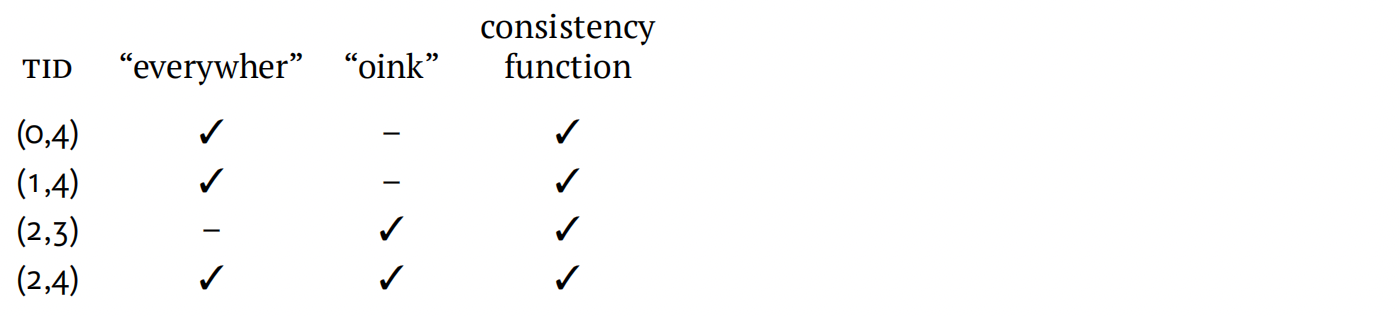
28.2.3 搜索:插图 3
图 28.3

搜索查询可以包含前缀,而不是常规的词素。如果应用程序用户可以在搜索字段中输入单词的几个首字母并期望立即获得结果,这将非常有用。例如,“pig:*” 查询将会匹配所有包含以 “pig” 开头的词素的文档:这里我们可以得到 “pigs”,如果 old MacDonald 在他的农场饲养了它们,我们也能得到 “pigeons”。

这种部分搜索使用一个特殊的支持函数来匹配索引中的词素和搜索键;8 除了前缀匹配外,这个函数也可以实现部分搜索的其他逻辑。

28.2.4 频繁和罕见的词素

如果搜索的词素在一个文档中多次出现,那么创建的 TIDS 列表将变得很长,效率低下。幸运的是,如果查询还包含一些罕见词素,通常可以避免这种情况。

让我们考虑 “farm & cluck” 查询。“cluck” 词素出现了两次,而 “farm” 词素出现了六次。与其将这两个词素同等对待并根据它们建立完整的 TIDS 列表,不如将罕见的 “cluck” 词素视为强制性的,而将更频繁的 “farm” 词素视为可选的,因为很明显 (考虑到查询语义),具有 “farm” 词素的文档只有在同时包含 “cluck” 词素时才能满足查询。

因此,索引扫描确定了包含 “cluck” 的第一个文档;它的 TID 是 (1,3)。然后我们要找出这个文档是否也包含 “farm” 词素,但是可以跳过所有 TIDS 小于 (1,3) 的文档。由于频繁的词素可能对应许多 TIDS,所以它们很可能存储在一个单独的树中,这样一些页面也可以被跳过。在这个特定情况下,对 “farm” 词素树的搜索从 (1,3) 开始。

对于强制性词素的后续值,会重复此过程。

显然,这种优化也可以应用到涉及两个以上词素的更复杂的搜索场景。算法按词素的频率排序,将它们逐个添加到强制词素列表中,并在剩余的词素不再能保证文档满足查询时停止。9

例如,让我们考虑 “farm & ( cluck | chick )” 查询。最不常见的词素是 “chick”;它被立即添加到强制性词素列表中。为了检查其他词素是否可以被认为是可选的,consistency 函数对强制性词素取假,对所有其他词素取真。函数返回 true AND (true OR false) = true,这意味着剩余的词素是"自给自足的",其中至少一个必须成为强制性词素。

下一个最不频繁的词素 (“cluck”) 被添加到列表中,现在 consistency 函数返回 true AND (false OR false) = false。因此,“chick” 和 “cluck” 词素变为强制性的,而 “farm” 仍然是可选的。
28.2.4 频繁和罕见的词素:插图 4
图 28.4

posting list 的长度为三,因为强制性词素出现了三次:

28.2.4 频繁和罕见的词素:插图 5
图 28.5

因此,如果词素频率已知,就有可能以最有效的方式合并词素树,从罕见的词素开始,跳过那些肯定是冗余的频繁词素的页面范围。这减少了需要调用 consistency 函数的次数。

为了确保这种优化确实有效,让我们查询 pgsql-hackers 归档。我们需要指定两个词素,一个常见的和一个罕见的:

=> SELECT word, ndoc
FROM ts_stat('SELECT tsv FROM mail_messages')
WHERE word IN ('wrote', 'tattoo');
  word  |  ndoc
−−−−−−−−+−−−−−−−−
 wrote  | 231173
 tattoo |      2
(2 rows)

事实证明,包含它们的文档确实存在:

=> \timing on
=> SELECT count(*) FROM mail_messages
WHERE tsv @@ to_tsquery('wrote & tattoo');
 count
−−−−−−−
     1
(1 row)
Time: 0,631 ms

这个查询的执行速度几乎与搜索单个词 “tattoo” 一样快:

=> SELECT count(*) FROM mail_messages
WHERE tsv @@ to_tsquery('tattoo');
 count
−−−−−−−
     2
(1 row)
Time: 2,227 ms

但是,如果我们要查找单个词 “wrote”,搜索将花费更长的时间:

=> SELECT count(*) FROM mail_messages
WHERE tsv @@ to_tsquery('wrote');
 count
−−−−−−−−
 231173
(1 row)
Time: 343,556 ms
=> \timing off

28.2.5 插入

GIN 索引不能包含重复项;10 如果要添加的元素已经位于索引中,其 TID 只是简单地被添加到现有元素的 posting list 或 posting tree 中。posting list 是索引条目的一部分,不能占用太多的页面空间,所以如果分配的空间超出了,posting list 就会转换成 posting tree。11

当一个新元素 (或新的 TID) 被加入到树中时,可能会发生页面溢出;在这种情况下,页面会被分成两个,并且元素会在它们之间重新分配。12

但每个文档通常包含许多需要被索引的词素。所以,即使我们只是创建或修改一个文档,索引树仍然会经历很多修改。这就是为什么 GIN 更新十分慢的原因。

下图显示了将 TID (4,1) 的 “Everywhere clucks, moos, and oinks” 行插入到表中后树的状态。词素 “cluck”、“moo” 和 “oink” 的 posting list 被扩展;“everywher” 词素的列表超过了最大大小,并作为一个单独的树被拆分出来。

然而,如果更新一个索引以一次性合并多个文档的相关变化,那么与连续的变化相比,总的工作量可能会减少,因为这些文件可能包含一些共同的词素。

此优化由 fastupdateon 存储参数控制。推迟的索引更新累积在一个无序的 posting list 中,该列表物理上存储在元素树外的单独列表页面中。当这个列表变得足够大时,其所有内容将一次性转移到索引中,并且列表被清空。13 列表的最大大小由 gin_pending_list_limit 参数或同名的索引存储参数定义。
28.2.5 插入:插图 6
图 28.6

默认情况下,此类延迟更新是启用的,但你应该记住,这会减慢检索速度:除了树本身之外,还必须扫描整个无序列表的词素。此外,插入时间会变得更不可预测,因为任何更改都可能导致溢出,从而导致昂贵的合并过程。后者由于可以在索引清理期间异步执行合并而得到部分平滑。

创建新索引时,14 元素也会分批添加,而不是逐个添加,这样会太慢。所有更改并不是保存到磁盘上的无序列表中,而是累积在 maintenance_work_mem64MB 内存块中,并在该块没有更多可用空间后转移到索引中。为该操作分配的内存越多,建立索引的速度就越快。

本章提供的示例证明了在搜索精度方面,GIN 要优于 GiST 签名树。因此,通常使用 GIN 进行全文检索。然而,GIN 更新缓慢的问题可能会在数据频繁更新时使得 GiST 更受青睐。

28.2.6 限制结果集大小

GIN 访问方法总是以位图形式返回结果,无法逐个获取 TIDS。换句话说,支持 BITMAP SCAN 属性,但不支持 INDEX SCAN 属性。

这个限制的原因是延迟更新的无序列表。在索引访问的情况下,扫描此列表以构建一个位图,然后使用树中的数据更新此位图。如果在搜索过程中 (比如在索引更新或清理过程中),这个无序列表与树合并了,同一个值可能会被返回两次,这是不可接受的。但在位图的情况下,这并不构成问题:同一个位只是简单地被设置两次。

因此,与 GIN 索引一起使用 LIMIT 子句并不太高效,因为位图必须完全创建出来,这在总成本中占据了相当大的比重。

=> EXPLAIN SELECT * FROM mail_messages
WHERE tsv @@ to_tsquery('hacker')
LIMIT 1000;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Limit (cost=481.41..1964.22 rows=1000 width=1258)
   −> Bitmap Heap Scan on mail_messages
       (cost=481.41..74939.28 rows=50214 width=1258)
       Recheck Cond: (tsv @@ to_tsquery('hacker'::text))
       −> Bitmap Index Scan on mail_gin_idx
           (cost=0.00..468.85 rows=50214 width=0)
           Index Cond: (tsv @@ to_tsquery('hacker'::text))
(7 rows)

因此,GIN 方法提供了一个特殊功能,可以限制索引扫描返回的结果数量。此限制由 gin_fuzzy_search_limit0 参数施加,该参数默认关闭。如果启用此参数,索引访问方法将随机跳过一些值,以便大致获得指定数量的行 (因此名为 “fuzzy”):15

=> SET gin_fuzzy_search_limit = 1000;
=> SELECT count(*)
FROM mail_messages
WHERE tsv @@ to_tsquery('hacker');
 count
−−−−−−−
   727
(1 row)
=> SELECT count(*)
FROM mail_messages
WHERE tsv @@ to_tsquery('hacker');
 count
−−−−−−−
   791
(1 row)
=> RESET gin_fuzzy_search_limit;

请注意,这些查询中没有 LIMIT 子句。这是在使用索引扫描和堆扫描时获取不同数据的唯一合法方式。规划器对 GIN 索引的这种行为一无所知,也不会在估算成本时考虑这个参数值。

28.2.7 属性

所有 GIN 访问方法的属性在所有级别上都是相同的;它们不依赖于特定的操作符类。

访问方法属性

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'gin';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 gin    | can_order     | f
 gin    | can_unique    | f
 gin    | can_multi_col | t
 gin    | can_exclude   | f
 gin    | can_include   | f
(5 rows)

GIN 既不支持排序也不支持唯一约束。

支持多列索引,但值得一提的是,它们的列顺序无关紧要。与常规 B 树不同,多列 GIN 索引不存储复合键;相反,它使用相应的列号扩展单独的元素。

由于不支持 INDEX SCAN 属性,所以也无法支持排它约束。

GIN 不支持额外的 INCLUDE 列。在这里使用 INCLUDE 列并没有太大意义,因为使用 GIN 索引很难作为覆盖索引:它只包含索引值的单独元素,而值本身是存储在表中的。

索引级属性

=> SELECT p.name, pg_index_has_property('mail_gin_idx', p.name)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
 clusterable   | f
 index_scan    | f
 bitmap_scan   | t
 backward_scan | f
(4 rows)

不支持逐个获取结果:索引访问总是返回一个位图。

出于同样的原因,根据 GIN 索引对表重新排序也没有意义:位图总是对应于表中数据的物理布局,无论其布局如何。

不支持向后扫描:这个功能对于常规索引扫描是有用的,但不适用于位图扫描。

列级属性

=> SELECT p.name,
  pg_index_column_has_property('mail_gin_idx', 1, p.name)
FROM unnest(array[
  'orderable', 'search_array', 'search_nulls',
  'returnable', 'distance_orderable'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 orderable          | f
 search_array       | f
 search_nulls       | f
 returnable         | f
 distance_orderable | f
(5 rows)

没有可用的列级属性:既不支持排序 (原因很明显),也不支持将索引用作覆盖索引 (因为文档本身没有存储在索引中)。也不支持搜索空值 (对于非原子类型的元素来说,这没有意义)。

28.2.8 GIN 的限制和 RUM 索引

尽管 GIN 非常强大,但仍然无法解决全文检索的所有挑战。尽管 tsvector 类型确实指示了词素的位置,但这些信息不会进入索引。因此,GIN 不能用于加速短语搜索,它需要考虑词素的邻近性。此外,搜索引擎通常需要按照 relevance 返回结果 (不管这个术语可能意味着什么),并且由于 GIN 不支持排序操作符,这里唯一的解决方式是计算每一行结果的排名函数,这当然非常慢。

这些缺点已被 RUM 访问方法解决 (这个名字让我们怀疑开发人员在提到 GIN 的真正含义时的诚意)。

这种访问方法作为一个扩展提供;你可以从 PGDG 仓库 16 下载相应的包或者直接获取源代码 17。RUM 基于 GIN,但它们有两个主要区别。首先,RUM 不提供延迟更新,所以它支持常规索引扫描以及位图扫描,并实现了排序操作符。其次,RUM 索引键可以扩展额外的信息。这个功能在某种程度上类似于 INCLUDE 列,但这里的额外信息与特定键绑定。在全文检索的上下文中,RUM 操作符类将词素出现映射到它们在文档中的位置,这加速了短语搜索和结果排名。

这种方法的缺点是更新速度慢且索引大小较大。此外,由于 RUM 访问方法是作为扩展提供的,它依赖于通用 WAL 机制,18 这比内置的日志慢,并且生成的 WAL 日志量更大。

28.3 三元组

pg_trgm 19 扩展可以通过比较相同的三字母序列的数量 (三元组) 来评估单词的相似性。单词相似性可以与全文检索一起使用,即使搜索的单词输入有误,也能返回一些结果。

gin_trgm_ops 操作符类实现了文本字符串索引。为了挑选出文本值的元素,它提取各种三字母的子字符串而不是单词或词素 (仅考虑字母和数字;其他字符被忽略)。在索引中,三元组以整数的形式表示。注意,对于非拉丁字符,它们在 UTF-8 编码中可能占用两到四个字节,这样的表示不允许解码原始符号。

=> CREATE EXTENSION pg_trgm;
=> SELECT unnest(show_trgm('macdonald')),
          unnest(show_trgm('McDonald'));
 unnest | unnest
−−−−−−−−+−−−−−−−−
   m    | 	m
  ma    |  mc
 acd    | ald
 ald    | cdo
 cdo    | don
 don    | ld
 ld     | mcd
 mac    | nal
 nal    | ona
 ona    |
(10 rows)

这个类支持用于精确和模糊比较字符串和单词的操作符。

=> SELECT amopopr::regoperator, oprcode::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'gin_trgm_ops'
ORDER BY amopstrategy;
    amopopr     |               oprcode
−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 %(text,text)   | similarity_op
 ~~(text,text)  | textlike        --- LIKE and ILIKE
 ~~*(text,text) | texticlike      --- LIKE and ILIKE
 ~(text,text)   | textregexeq     --- regular expressions
 ~*(text,text)  | texticregexeq   --- regular expressions
 %>(text,text)  | word_similarity_commutator_op
 %>>(text,text) | strict_word_similarity_commutator_op
 =(text,text)   | texteq
(8 rows)

为了进行模糊比较,我们可以将字符串之间的距离定义为共有的三元组数量与查询字符串中三元组总数的比率。但正如我之前展示的,GIN 不支持排序操作符,因此类中的所有操作符必须是布尔类型的。因此,对于实施模糊比较策略的 %、%> 和 %» 操作符,如果计算的距离没有超过所定义的阈值,那么 consistency 函数返回真。

对于 = 和 LIKE 操作符,consistency 函数要求值包含查询字符串的所有三元组。将文档与正则表达式进行匹配需要更复杂的检查。

不管怎样,三元组搜索始终是模糊的,结果必须重新检查。

28.4 索引数组

GIN 索引也支持数组数据类型。基于数组元素创建的 GIN 索引可以用来快速判断一个数组是否与另一个数组有重叠或者是被另一个数组包含:

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'array_ops'
ORDER BY amopstrategy;
        amopopr        |    oprcode     | amopstrategy
−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 &&(anyarray,anyarray) | arrayoverlap 	|            1
 @>(anyarray,anyarray) | arraycontains 	|            2
 <@(anyarray,anyarray) | arraycontained |            3
 =(anyarray,anyarray)  | array_eq       |            4
(4 rows)

作为示例,让我们看看样例数据库中的 routes 视图,它显示了航班的信息。days_of_week 列是一个数组,包含了一周中执飞的日子。要建立索引,我们首先必须将视图物化:

=> CREATE TABLE routes_tbl AS SELECT * FROM routes;
SELECT 710
=> CREATE INDEX ON routes_tbl USING gin(days_of_week);

让我们使用所创建的索引来选择周二、周四和周日出发的航班。我会关闭顺序扫描;否则,对于这样一个小表,规划器可能不会使用索引:

=> SET enable_seqscan = off;
=> EXPLAIN (costs off) SELECT * FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7];
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on routes_tbl
   Recheck Cond: (days_of_week = '{2,4,7}'::integer[])
   −> Bitmap Index Scan on routes_tbl_days_of_week_idx
       Index Cond: (days_of_week = '{2,4,7}'::integer[])
(4 rows)

结果表明有十一个这样的航班:

=> SELECT flight_no, departure_airport, arrival_airport,
  days_of_week
FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7];
 flight_no | departure_airport | arrival_airport | days_of_week
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 PG0023    | OSW               | KRO             | {2,4,7}
 PG0123    | NBC               | ROV             | {2,4,7}
 PG0155    | ARH               | TJM             | {2,4,7}
 PG0260    | STW               | CEK             | {2,4,7}
 PG0261    | SVO               | GDZ             | {2,4,7}
 PG0310    | UUD               | NYM             | {2,4,7}
 PG0370    | DME               | KRO             | {2,4,7}
 PG0371    | KRO               | DME             | {2,4,7}
 PG0448    | VKO               | STW             | {2,4,7}
 PG0482    | DME               | KEJ             | {2,4,7}
 PG0651    | UIK               | KHV             | {2,4,7}
(11 rows)

建立的索引只包含七个元素:整数从 1 到 7,代表一周中的七天。

查询执行与我之前展示的全文检索相当类似。在这个特定情况下,搜索查询由一个常规数组表示,而不是一个特殊的数据类型;假设索引的数组必须包含所有指定的元素。这里一个重要的区别是,等值条件还要求索引的数组不包含任何其他元素。consistency 函数 20 了解这个要求,这得益于策略编号,但它无法验证是否存在不需要的元素,所以它请求索引引擎通过表来重新检查结果:

=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT * FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7];
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on routes_tbl (actual rows=11 loops=1)
   Recheck Cond: (days_of_week = '{2,4,7}'::integer[])
   Rows Removed by Index Recheck: 482
   Heap Blocks: exact=16
   −> Bitmap Index Scan on routes_tbl_days_of_week_idx (actual ro...
       Index Cond: (days_of_week = '{2,4,7}'::integer[])
(6 rows)

扩展 GIN 索引以包括额外的列可能有用。例如,为了实现搜索周二、周四和周日从莫斯科出发的航班,索引缺少 departure_city 列。但是,目前没有为常规标量数据类型实现的操作符类:

=> CREATE INDEX ON routes_tbl USING gin(days_of_week, departure_city);
ERROR: data type text has no default operator class for access
method "gin"
HINT: You must specify an operator class for the index or define a
default operator class for the data type.

这种情况可以通过 btree_gin 扩展来解决。它增加了GIN 操作符类,这些类通过将标量值表示为只有一个元素的复合值,来模拟常规的 B 树处理。

=> CREATE EXTENSION btree_gin;
=> CREATE INDEX ON routes_tbl USING gin(days_of_week,departure_city);
=> EXPLAIN (costs off)
SELECT * FROM routes_tbl
WHERE days_of_week = ARRAY[2,4,7]
AND departure_city = 'Moscow';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on routes_tbl
   Recheck Cond: ((days_of_week = '{2,4,7}'::integer[]) AND
   (departure_city = 'Moscow'::text))
   −> Bitmap Index Scan on routes_tbl_days_of_week_departure_city...
       Index Cond: ((days_of_week = '{2,4,7}'::integer[]) AND
       (departure_city = 'Moscow'::text))
(6 rows)
=> RESET enable_seqscan;

对于 btree_gist 的评论也适用于 btree_gin:当涉及到比较操作时,B 树的效率要高得多,因此只有在真正需要 GIN 索引时,使用 btree_gin 扩展才有意义。例如,小于或者小于或等于条件的搜索,在 B 树中可以通过执行反向扫描实现,但 GIN 索引不行。

28.5 索引 JSON

jsonb 是另一种内置支持 GIN 索引的非原子数据类型。21 它为 JSON 提供了一整套操作符,其中一些操作符使用 GIN 可以执行得更快。

有两个操作符类可以从 JSON 文档中提取不同的元素集:

=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'gin'
AND opcintype = 'jsonb'::regtype;
    opcname
−−−−−−−−−−−−−−−−
 jsonb_ops
 jsonb_path_ops
(2 rows)

28.5.1 jsonb_ops 操作符类

jsonb_ops 操作符类是默认的操作符类。原始 JSON 文档的所有键、值和数组元素都被转换成索引条目。22 这加快了检查是否包含 JSON 值 (@>)、键是否存在 (?、?| 和 ?&) 或 JSON 路径是否匹配 (@? 和 @@) 的查询:

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'jsonb_ops'
ORDER BY amopstrategy;
      amopopr       |        oprcode        | amopstrategy
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 @>(jsonb,jsonb)    | jsonb_contains        |            7
 ?(jsonb,text)      | jsonb_exists          |            9
 ?|(jsonb,text[])   | jsonb_exists_any      |           10
 ?&(jsonb,text[])   | jsonb_exists_all      |           11
 @?(jsonb,jsonpath) | jsonb_path_exists_opr |           15
 @@(jsonb,jsonpath) | jsonb_path_match_opr  |           16
(6 rows)

让我们将 routes 视图的几行数据转换成 JSON 格式:

=> CREATE TABLE routes_jsonb AS
SELECT to_jsonb(t) route
FROM (
  SELECT departure_airport_name, arrival_airport_name, days_of_week
  FROM routes
  ORDER BY flight_no
  LIMIT 4
) t;
=> SELECT ctid, jsonb_pretty(route) FROM routes_jsonb;
 ctid  |                				jsonb_pretty
−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 (0,1) | { +
       |     "days_of_week": [                                        +
       |         6                                                    +
       |     ],                                                       +
       |     "arrival_airport_name": "Surgut Airport",                +
       |     "departure_airport_name": "Ust−Ilimsk Airport"           +
       | }
(0,2)  | {                                                            +
       |     "days_of_week": [                                        +
       |         7                                                    +
       |     ],                                                       +
       |     "arrival_airport_name": "Ust−Ilimsk Airport",            +
       |     "departure_airport_name": "Surgut Airport"               +
       | }
(0,3)  | { 																														+
       |     "days_of_week": [                                        +
       |         2,                                                   +
       |         6                                                    +
       |     ],                                                       +
       |     "arrival_airport_name": "Sochi International Airport",   +
       |     "departure_airport_name": "Ivanovo South Airport"        +
       | }
 (0,4) | { 																														+
       |     "days_of_week": [                                        +
       |         3,                                                   +
       |         7                                                    +
       |      ],                                                      +
       |      "arrival_airport_name": "Ivanovo South Airport",        +
       |      "departure_airport_name": "Sochi International Airport" +
       | }
(4 rows)
=> CREATE INDEX ON routes_jsonb USING gin(route);

创建的索引可以如下表示:

28.5.1 jsonb\_ops 操作符类:插图 7
图 28.7

让我们考虑一个带有条件 route @> ‘{“days_of_week”: [6]}’ 的查询,它选择包含特定路径的 JSON 文档 (即在星期六执飞的航班)。

支持函数 23从搜索查询的 JSON 值中提取搜索键:“days_of_week” 和 “6”。这些键在元素树中搜索,并且至少包含一个键的文档会被 consistency 函数 24 检查。对于包含策略来说,这个函数要求所有搜索键都可用,但结果仍然需要通过表来重新检查:从索引的角度来看,指定的路径也可以对应到像 {“days_of_week”: [2], “foo”: [6]} 这样的文档。

28.5.2 jsonb_path_ops 操作符类

第二个被称为 jsonb_path_ops 的类包含更少的操作符:

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'gin'
AND opcname = 'jsonb_path_ops'
ORDER BY amopstrategy;
      amopopr       |        oprcode        | amopstrategy
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 @>(jsonb,jsonb)    | jsonb_contains        |            7
 @?(jsonb,jsonpath) | jsonb_path_exists_opr |           15
 @@(jsonb,jsonpath) | jsonb_path_match_opr 	|           16
(3 rows)

如果使用这个类,索引将包含从文档的根到所有值和所有数组元素的路径,而不是孤立的 JSON 片段。25 这使得搜索更加精确和高效,但对于参数由单独的键而不是路径表示的操作就没有速度上的提升。

由于路径可能相当长,所以实际上索引的不是路径本身,而是它们的哈希值。

让我们使用这个操作符类为同一个表创建一个索引:

=> CREATE INDEX ON routes_jsonb USING gin(route jsonb_path_ops);

创建的索引可以用下面的树表示:

28.5.2 jsonb\_path\_ops 操作符类:插图 8
图 28.8

当执行具有相同条件 route @> ‘{“days_of_week”: [6]}’ 的查询时,支持函数 26 提取整个路径 “days_of_week, 6” 而不是它的各个部分。两个相匹配的文档的 TID 将立即在元素树中找到。

显然,这些条目会被 consistency 函数检查,27 然后由索引引擎重新检查 (例如,排除哈希冲突)。但通过树进行搜索要高效得多,所以如果索引的操作符提供的支持足以满足查询,最好始终选择 jsonb_path_ops。

28.6 索引其他数据类型

GIN 还可以通过扩展为以下数据类型提供支持:

整数数组。intarray 扩展添加了gin__int_ops 操作符类,用于整数数组。它与标准的 array_ops 操作符类非常相似,但它支持匹配操作符 @@,将文档与搜索查询匹配。

键值存储。hstore 扩展实现了键值对的存储,并提供 gin_hstore_ops 操作符类。键和值都会被索引。

JSON 查询语言。一个外部的 jsquery 扩展提供了它自己的查询语言和对 JSON 的 GIN 索引支持。

在 SQL:2016 标准被采纳并且 SQL/JSON 查询语言在 PostgreSQL 中实现之后v. 12,标准内置功能似乎是更好的选择。


  1. postgresql.org/docs/14/gin.html
    backend/access/gin/README ↩︎

  2. backend/access/gin/ginpostinglist.c ↩︎

  3. postgresql.org/docs/14/gin-extensibility.html
    backend/utils/adt/tsginidx.c ↩︎

  4. backend/utils/adt/tsvector_op.c, ts_match_vq function ↩︎

  5. backend/utils/adt/tsginidx.c, gin_extract_tsquery function ↩︎

  6. backend/access/gin/ginget.c, keyGetItem function ↩︎

  7. backend/utils/adt/tsginidx.c, gin_tsquery_triconsistent function ↩︎

  8. backend/utils/adt/tsginidx.c, gin_cmp_prefix function ↩︎

  9. backend/access/gin/ginget.c, startScanKey function ↩︎

  10. backend/access/gin/gininsert.c, ginEntryInsert function ↩︎

  11. backend/access/gin/gininsert.c, addItemPointersToLeafTuple function ↩︎

  12. backend/access/gin/ginbtree.c, ginInsertValue function ↩︎

  13. backend/access/gin/ginfast.c, ginInsertCleanup function ↩︎

  14. backend/access/gin/gininsert.c, ginbuild function ↩︎

  15. backend/access/gin/ginget.c, dropItem macro ↩︎

  16. postgresql.org/download ↩︎

  17. github.com/postgrespro/rum ↩︎

  18. postgresql.org/docs/14/generic-wal.html ↩︎

  19. postgresql.org/docs/14/pgtrgm.html ↩︎

  20. backend/access/gin/ginarrayproc.c, ginarrayconsistent function ↩︎

  21. postgresql.org/docs/14/datatype-json.html ↩︎

  22. backend/utils/adt/jsonb_gin.c, gin_extract_jsonb function ↩︎

  23. backend/utils/adt/jsonb_gin.c, gin_extract_jsonb_query function ↩︎

  24. backend/utils/adt/jsonb_gin.c, gin_consistent_jsonb function ↩︎

  25. backend/utils/adt/jsonb_gin.c, gin_extract_jsonb_path function ↩︎

  26. backend/utils/adt/jsonb_gin.c, gin_extract_jsonb_query_path function ↩︎

  27. backend/utils/adt/jsonb_gin.c, gin_consistent_jsonb_path function ↩︎

29 BRIN

29.1 总览

与为快速找到所需行的其他索引不同,BRIN 1 旨在过滤掉不必要的行。BRIN 访问方法主要用于几个 TB 及以上的大表,因此较小的索引尺寸优于搜索精度。

为了加快搜索,整个表被划分为多个范围,因此得名:块范围索引。每个范围包含若干个页面。索引不存储 TIDS,只保留每个范围的摘要信息。对于 ordinal 数据类型,在最简单的情况下,是最小值和最大值,但不同的操作符类可能会收集范围中值的不同信息。

范围中的页面数量在创建索引时根据 pages_per_range128 存储参数值进行定义。

如果查询条件引用了索引列,那么所有保证没有匹配项的范围都可以跳过。索引将以有损位图的形式返回其他所有范围的页面;这些页面的所有行都必须重新检查。

因此,BRIN 非常适合具有局部化值的列 (即,存储的值彼此靠近的列具有相似的摘要信息属性) 。对于 ordinal 数据类型,这意味着值必须按升序或降序存储,也就是说,它们的物理位置与"大于"和"小于"操作定义的逻辑顺序之间具有很高的相关性。对于其他类型的摘要信息,“相似属性"可能有所不同。

BRIN 更像是顺序堆扫描的加速器,而不是传统意义上的索引。它可以看作是分区的一种替代方案,每个范围代表一个虚拟分区。

29.2 样例

我们的示例数据库中没有足够大到需要使用 BRIN 索引的表,但我们可以想象一下,分析报告要求我们拥有一张非规范化表,里面包含特定机场所有出发和到达航班的汇总信息,甚至到具体座位的占用情况。每个机场的数据都会在相应时区午夜时每日更新。添加的数据不会被更新或删除。

这张表如下所示:

CREATE TABLE flights_bi(
  airport_code char(3),
  airport_coord point, -- airport coordinates
  airport_utc_offset interval, -- timezone
  flight_no char(6),
  flight_type text, -- departure or arrival
  scheduled_time timestamptz,
  actual_time timestamptz,
  aircraft_code char(3),
  seat_no varchar(4),
  fare_conditions varchar(10), -- travel class
  passenger_id varchar(20),
  passenger_name text
);

数据加载可以通过嵌套循环来模拟:2 外循环对应于天数 (示例数据库中存储的是年度数据),内循环则基于时区。因此,即使在循环中数据没有显式地进行排序,加载后的数据在时间和机场方面或多或少是有序的。

我将加载一个大约 4GB,包含约 3000 万行的现有数据库的副本:3

postgres$ pg_restore -d demo -c flights_bi.dump

=> ANALYZE flights_bi;
=> SELECT count(*) FROM flights_bi;
  count
−−−−−−−−−−
 30517076
(1 row)
=> SELECT pg_size_pretty(pg_total_relation_size('flights_bi'));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 4129 MB
(1 row)

我们无法称之为大表,但这个数据量足以展示 BRIN 的工作原理。我会提前创建一个索引:

=> CREATE INDEX ON flights_bi USING brin(scheduled_time);
=> SELECT pg_size_pretty(pg_total_relation_size(
  'flights_bi_scheduled_time_idx'
));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 184 kB
(1 row)

默认配置下,索引占用的空间很小。

即使启用了数据去重v. 13,B 树索引的大小也要大上千倍。的确,其效率也要高得多,但是对于真正的大表来说,额外的存储空间可能变成了一种无法承受的奢侈。

=> CREATE INDEX flights_bi_btree_idx ON flights_bi(scheduled_time);
=> SELECT pg_size_pretty(pg_total_relation_size(
  'flights_bi_btree_idx'
));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 210 MB
(1 row)
=> DROP INDEX flights_bi_btree_idx;

29.3 页面布局

BRIN 索引的零页是用于保存索引结构信息的元页面。

在元数据的某个偏移量处是带有摘要信息的页面。此类页面中的每个索引条目都包含特定块范围的摘要信息。

元页面和摘要信息之间的空间由范围映射占据,有时也称为反向映射 (因此通常缩写为 revmap)。它实际上是一个指向相应索引行的指针数组;该数组中的索引号与范围号相对应。
29.3 页面布局:插图 1
图 29.1

随着表的扩展,范围映射的大小也在增长。如果映射不适合分配的页面,它就会占用下一个页面,并且先前所有位于此页面的索引条目都会被转移到其他页面。由于一个页面可以容纳很多指针,因此这样的转移非常少见。

BRIN 索引页面可以像往常一样通过 pageinspect 扩展显示。元数据包括范围大小和为范围映射保留的页面数量:

=> SELECT pagesperrange, lastrevmappage
FROM brin_metapage_info(get_raw_page(
  'flights_bi_scheduled_time_idx', 0
));
 pagesperrange | lastrevmappage
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−
           128 |              4
(1 row)

此处,范围映射占用了四个页面,从第一个页面到第四个页面。让我们看一下指向包含摘要数据的索引条目指针:

=> SELECT *
FROM brin_revmap_data(get_raw_page(
  'flights_bi_scheduled_time_idx', 1
));
  pages
−−−−−−−−−−
 (6,197)
 (6,198)
 (6,199)
 ...
 (6,195)
 (6,196)
(1360 rows)

如果范围还未提要,那么范围映射中的指针为空。

以下是几个范围的摘要信息:

=> SELECT itemoffset, blknum, value
FROM brin_page_items(
  get_raw_page('flights_bi_scheduled_time_idx', 6),
  'flights_bi_scheduled_time_idx'
)
ORDER BY blknum
LIMIT 3 \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
itemoffset | 197
blknum     | 0
value      | {2016−08−15 02:45:00+03 .. 2016−08−15 16:20:00+03}
−[ RECORD 2 ]−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
itemoffset | 198
blknum     | 128
value      | {2016−08−15 05:50:00+03 .. 2016−08−15 18:55:00+03}
−[ RECORD 3 ]−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
itemoffset | 199
blknum     | 256
value      | {2016−08−15 07:15:00+03 .. 2016−08−15 18:50:00+03}

29.4 搜索

如果 BRIN 索引支持查询条件,4 那么执行器会扫描范围映射和每个范围的摘要信息。如果某个范围内的数据可能与搜索键匹配,属于这个范围的所有页面都会被添加到位图中。由于 BRIN 不保留单独元组的 ID,所以位图总是有损的。

将数据与搜索键进行匹配是由 consistency 函数执行的,它解释了范围的摘要信息。未提要的范围始终会被添加到位图中。

接收到的位图将按往常方式用于扫描表。值得一提的是,堆页读取按块范围顺序进行,并采用预取机制。

29.5 摘要信息更新

29.5.1 插入值

当往堆页面中添加新元组时,相应索引范围的摘要信息会被更新。5 使用简单的算术运算,根据页号计算范围号,然后通过范围映射定位摘要信息。范围编号是根据页面编号通过简单的算术运算计算得出的,然后通过范围映射定位摘要信息。

为了确认当前摘要信息是否需要扩展,会使用 addition 函数。如果需要扩展并且页面有足够的空闲空间,那么将就地进行扩展 (不添加新的索引条目)。

假设我们向页面 13 添加了一个值为 42 的元组。范围号是通过页号整除范围大小计算得出的。假设范围大小为四个页面,我们得到范围号 3;由于范围号是从零开始的,我们在范围映射中取第四个指针。该范围中的最小值是 31,最大值是 40。添加的值超出了这些限制,所以最大值增加了:
29.5.1 插入值:插图 2
图 29.2

如果无法就地更新,则会添加一个新条目,并且范围映射会被修改。

29.5.2 范围提要

前文所述内容适用于新元组出现在已经提要的范围内的情况。在建立索引时,所有已有的范围都会被提要,但随着表的扩大,新的页面可能会超出这些范围。

如果索引是在启用了 autosummarizeoff 存储参数的情况下创建的,那么新范围将立即进行提要。然而,在数据仓库中,行数据通常是批量添加,而不是逐条添加,在这种情况下,这种模式可能会严重减慢插入速度。

默认情况下,新范围不会立即被提要。这并不影响索引的正确性,因为没有摘要信息的范围始终会被扫描。提要是异步执行的,无论是在表清理期间还是通过调用 brin_summarize_new_values 函数 (或处理单个范围的 brin_summarize_range 函数) 来手动发起。

范围提要 6 不会锁定表更新。在此过程开始时,在索引中会为这个范围插入一个占位条目。如果在扫描这个范围时,此范围内的数据发生变化,那么占位符将会被这些变更的摘要信息更新。然后 union 函数会将此数据与对应范围的摘要信息合并。

理论上,有时候在一些行被删除后,摘要信息可能会缩减。但是,虽然 GiST 索引可以在页面分裂后重新分配数据,BRIN 索引的摘要信息永远不会缩小,只会变得更宽。这里通常不需要缩减,因为数据存储通常仅用于追加新数据。你可以通过调用 brin_desummarize_range 函数手动删除该范围的摘要信息,以便再次进行提要,但没有线索表明哪些范围可能从中受益。

因此,BRIN 主要针对的是尺寸非常大的表,这些表要么很少有更新,通常只是将新行添加到文件末尾,要么根本就不进行更新。它主要用于在数据仓库中以建立分析报告。

29.6 Minmax 类

对于允许比较值的数据类型,摘要信息至少包括最大值和最小值。相应操作符类的名称中包含 minmax 一词:7

=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%minmax_ops'
ORDER BY opcname;
        opcname
−−−−−−−−−−−−−−−−−−−−−−−−
 bit_minmax_ops
 bpchar_minmax_ops
 bytea_minmax_ops
 char_minmax_ops
 ...
 timestamptz_minmax_ops
 timetz_minmax_ops
 uuid_minmax_ops
 varbit_minmax_ops
(26 rows)

这些操作符类的支持函数如下:

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'numeric_minmax_ops'
ORDER BY amprocnum;
 amprocnum |         amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−
         1 | brin_minmax_opcinfo
         2 | brin_minmax_add_value
         3 | brin_minmax_consistent
         4 | brin_minmax_union
(4 rows)

第一个函数返回操作符类的元数据,其他所有函数均已描述过:这些函数用于插入新值、检查一致性以及执行合并操作。

minmax 类包含我们在 B 树中看到的相同的比较操作符:

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'brin'
AND opcname = 'numeric_minmax_ops'
ORDER BY amopstrategy;
        amopopr      |  oprcode   | amopstrategy
−−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−−−−
 <(numeric,numeric)  | numeric_lt |            1
 <=(numeric,numeric) | numeric_le |            2
 =(numeric,numeric)  | numeric_eq |            3
 >=(numeric,numeric) | numeric_ge |            4
 >(numeric,numeric)  | numeric_gt |            5
(5 rows)

29.6.1 选择要索引的列

使用这个操作符类索引哪些列才是有意义的?如前所述,如果行的物理位置与值的逻辑顺序相关,那么这样的索引效果便很好。

让我们回顾一下上面的例子。

=> SELECT attname, correlation, n_distinct
FROM pg_stats
WHERE tablename = 'flights_bi'
ORDER BY correlation DESC NULLS LAST;
      attname       |  correlation   |   n_distinct
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−
 scheduled_time     |      0.9999949 |        25926
 actual_time        |      0.9999948 |        34469
 fare_conditions    |      0.7976897 |            3
 flight_type        |      0.4981733 |            2
 airport_utc_offset |      0.4440067 |           11
 aircraft_code      |     0.19249801 |            8
 airport_code       |    0.061483838 |          104
 seat_no            |   0.0024594965 |          461
 flight_no          | 	0.0020146023 |          710
 passenger_id       | −0.00046121294 | 2.610987e+06
 passenger_name     |   −0.012388787 |         8618
 airport_coord      |                |            0
(12 rows)

数据按时间排序 (无论是计划时间还是实际时间,几乎没有区别):新条目按时间顺序添加,由于数据既不更新也不删除,所有的行都将依次进入表的主分支。

fare_conditions、flight_type 和 airport_utc_offset 这几列的相关性相对较高,但它们存储的不同值太少。

其他列的相关性很低,以至于使用 minmax 操作符类对它们进行索引没有任何意义。

29.6.2 范围大小与搜索效率

可以根据用于存储特定值的页面数量来确定合适的范围大小。

让我们看一下 scheduled_time 列,并获取 24 小时内执飞的所有航班的信息。我们首先需要找出与此时间区间相关的数据占用了多少个表页面。

为了得到这个数字,我们可以基于如下事实:TID 由页号和偏移量组成。不幸的是,没有内置函数可以将 TID 分解成这两个组成部分,所以我们需要编写我们自己的笨拙函数,通过文本表示进行类型转换。

=> CREATE FUNCTION tid2page(t tid) RETURNS integer
LANGUAGE sql
RETURN (t::text::point)[0]::integer;

现在我们可以观察天数是如何在表中分布的:

=> SELECT min(numblk), round(avg(numblk)) avg, max(numblk)
FROM (
  SELECT count(distinct tid2page(ctid)) numblk
  FROM flights_bi
GROUP BY scheduled_time::date
) t;
 min  | avg  | max
−−−−−−+−−−−−−+−−−−−−
 1192 | 1447 | 1512
(1 row)

我们可以注意到,数据分布并不完全均匀。以标准的 128 个页面的范围大小来看,每天将占用 9 到 12 个范围。在获取某一特定日期的数据时,索引扫描将返回实际需要的行,以及一些落入相同范围关联到其他日期的行。范围大小越大,读取的额外边界值就越多;我们可以通过减小或增加范围大小来改变它们的数量。

让我们尝试查询某一天的数据 (我已经用默认设置创建了一个索引)。为了简单起见,我将禁止并行执行:

=> SET max_parallel_workers_per_gather = 0;
=> \set d '2016-08-15 02:45:00+03'
=> EXPLAIN (analyze, buffers, costs off, timing off, summary off)
SELECT *
FROM flights_bi
WHERE scheduled_time >= :'d'::timestamptz
  AND scheduled_time < :'d'::timestamptz + interval '1 day';
QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights_bi (actual rows=81964 loops=1)
   Recheck Cond: ((scheduled_time >= '2016−08−15 02:45:00+03'::ti...
   Rows Removed by Index Recheck: 11606
   Heap Blocks: lossy=1536
   Buffers: shared hit=1561
   −> Bitmap Index Scan on flights_bi_scheduled_time_idx
       (actual rows=15360 loops=1)
       Index Cond: ((scheduled_time >= '2016−08−15 02:45:00+03'::...
       Buffers: shared hit=25
 Planning:
   Buffers: shared hit=1
(11 rows)

我们可以将 BRIN 索引对某个特定查询的效率因子定义为索引扫描中跳过的页面数量与表中总的页面数量的比值。如果效率因子为零,那么索引访问会退化为顺序扫描 (不考虑额外成本)。效率因子越高,需要读取的页面就越少。但是,由于某些页面包含需要返回的数据而不能被跳过,因此效率因子总是小于 1。

在这个特定案例中,效率因子是 528417−1561528417≈0.997\frac{528417 - 1561}{528417} \approx 0.997,其中 528,417 是表中的页面数。

然而,我们不能基于单个值得出任何有意义的结论。即使我们拥有均匀数据和理想的相关性,效率仍会有所不同,因为至少范围边界不会与页面边界匹配。我们只有将效率因子视为一个随机值并分析其分布情况,才能获得全貌。

对于我们的示例,我们可以选择一年中所有不同的日子,检查每个值的执行计划,并基于这个选择计算统计数据。我们可以轻易使该过程自动化,因为 EXPLAIN 命令可以以 JSON 格式返回结果,这很便于解析。我不会在这里提供所有代码,但以下代码片段包含了所有关键细节:

=> DO $$
DECLARE
  plan jsonb;
BEGIN
  EXECUTE
    'EXPLAIN (analyze, buffers, timing off, costs off, format json)
     SELECT * FROM flights_bi
     WHERE scheduled_time >= $1
       AND scheduled_time < $1 + interval ''1 day'''
  USING '2016-08-15 02:45:00+03'::timestamptz
  INTO plan;
  RAISE NOTICE 'shared hit=%, read=%',
    plan -> 0 -> 'Plan' ->> 'Shared Hit Blocks',
    plan -> 0 -> 'Plan' ->> 'Shared Read Blocks';
END;
$$;
NOTICE: shared hit=1561, read=0
DO

结果可以通过箱线图 (也称为"盒须图”) 来直观展示。这里的须表示第一和第四四分位 (也就是说,右须包含了 25% 的最大值,而左须包含了 25% 的最小值)。盒子本身包含剩余的 50% 的值,并标有中位数。更重要的是,这种紧凑的表示方式使我们能够直观地比较不同的结果。下图展示了默认范围大小以及其他两个范围大小 (分别是原大小的四倍和四分之一) 的效率因子分布情况。

正如我们所预期的,即使对于相对较大的范围,搜索的准确性和效率也很高。

这里的虚线标记了这个查询可能的最大效率因子的平均值,假设一天大约占表的 1365\frac{1}{365}。

29.6.2 范围大小与搜索效率:插图 3
图 29.3

注意,效率的提升是以索引大小的增加为代价的。BRIN 在让你找到两者之间的平衡点方面相当灵活。

29.6.3 属性

BRIN 的属性是固定的,不依赖于操作符类。

访问方法属性

=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'brin';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 brin   | can_order     | f
 brin   | can_unique    | f
 brin   | can_multi_col | t
 brin   | can_exclude 	| f
 brin   | can_include 	| f
(5 rows)

显然,BRIN 索引不支持排序或唯一性属性。由于 BRIN 索引总是返回一个位图,因此也不支持排它约束。同样,额外的 INCLUDE 列也没有意义,因为即使是索引键也不存储在 BRIN 索引中。

然而,我们可以创建多列 BRIN 索引。在这种情况下,每列的摘要信息被收集并存储在一个独立的索引条目中,但它们仍然有一个共同的范围映射。如果相同的范围大小适用于所有被索引的列,那么这样的索引是有用的。

或者,基于位图可以合并在一起的事实,我们可以为几个列创建单独的 BRIN 索引。例如:

=> CREATE INDEX ON flights_bi USING brin(airport_utc_offset);
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM flights_bi
WHERE scheduled_time >= :'d'::timestamptz
AND scheduled_time < :'d'::timestamptz + interval '1 day'
AND airport_utc_offset = '08:00:00';
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights_bi (actual rows=1658 loops=1)
   Recheck Cond: ((scheduled_time >= '2016−08−15 02:45:00+03'::ti...
   Rows Removed by Index Recheck: 14077
   Heap Blocks: lossy=256
   −> BitmapAnd (actual rows=0 loops=1)
       −> Bitmap Index Scan on flights_bi_scheduled_time_idx (act...
           Index Cond: ((scheduled_time >= '2016−08−15 02:45:00+0...
       −> Bitmap Index Scan on flights_bi_airport_utc_offset_idx ...
           Index Cond: (airport_utc_offset = '08:00:00'::interval)
(9 rows)

索引级属性

=> SELECT p.name, pg_index_has_property(
'flights_bi_scheduled_time_idx', p.name
)
FROM unnest(array[
  'clusterable', 'index_scan', 'bitmap_scan', 'backward_scan'
]) p(name);
     name      | pg_index_has_property
−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
 clusterable   | f
 index_scan    | f
 bitmap_scan   | t
 backward_scan | f
(4 rows)

显然,位图扫描是唯一支持的访问类型。

缺乏聚簇可能看起来令人困惑。由于 BRIN 对行的物理顺序敏感,逻辑上可以假设它应当支持重新排序,以最大限度地提高效率。但是,考虑到重建表所需的所有处理和额外的磁盘空间,对大表进行聚簇无论如何都是一种奢侈。此外,正如 flights_bi 表的例子所示,数据存储中的某种排序可以自然发生。

列级属性

=> SELECT p.name, pg_index_column_has_property(
'flights_bi_scheduled_time_idx', 1, p.name
)
FROM unnest(array[
  'orderable', 'distance_orderable', 'returnable',
  'search_array', 'search_nulls'
]) p(name);
        name        | pg_index_column_has_property
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 orderable          | f
 distance_orderable | f
 returnable         | f
 search_array       | f
 search_nulls       | t
(5 rows)

唯一可用的列级属性是对空值的支持。为了追踪某个范围内的空值,摘要信息提供了一个单独的属性:

=> SELECT hasnulls, allnulls, value
FROM brin_page_items(
  get_raw_page('flights_bi_airport_utc_offset_idx', 6),
  'flights_bi_airport_utc_offset_idx'
)
WHERE itemoffset= 1;
 hasnulls | allnulls |         value
−−−−−−−−−−+−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−
 f        | f        | {03:00:00 .. 03:00:00}
(1 row)

29.7 Minmax-Multi 类v. 14

数据更新很容易打乱已建立的相关性。问题不在于特定值的实际修改,而在于 MVCC 设计本身:旧版本的行可能在一个页面中被删除,而其新版本可以插入到当前空闲的任何位置,因此无法保持原始行顺序。为了在一定程度上最小化这种影响,我们可以降低 fillfactor 存储参数值,为后续的更新留出更多页面空间。但是,真的值得增加已经很大的表的大小吗?此外,删除操作无论如何都会在现有页面中释放出一些空间,从而为新元组设下陷阱,这些元组本应被添加到文件的末尾。

这种情况可以很容易地被模拟。让我们删除随机选择的 0.1% 比例的行,并对表进行清理操作,以清理一些空间供新元组使用:

=> WITH t AS (
  SELECT ctid
  FROM flights_bi TABLESAMPLE BERNOULLI(0.1) REPEATABLE(0)
)
DELETE FROM flights_bi
WHERE ctid IN (SELECT ctid FROM t);
DELETE 30180

=> VACUUM flights_bi;

现在,让我们在其中一个时区为新的一天添加一些数据。我将简单地复制前一天的数据:

=> INSERT INTO flights_bi
SELECT airport_code, airport_coord, airport_utc_offset,
  flight_no, flight_type, scheduled_time + interval '1 day',
  actual_time + interval '1 day', aircraft_code, seat_no,
 fare_conditions, passenger_id, passenger_name
FROM flights_bi
WHERE date_trunc('day', scheduled_time) = '2017-08-15'
  AND airport_utc_offset = '03:00:00';
INSERT 0 40532

执行的删除操作足以在所有或几乎所有的范围内释放一些空间。新元组被插入到位于文件中间某处的页面,自动扩展了范围。例如,与第一个范围相关的摘要信息过去可能覆盖的时间少于一天,但现在它包含了整个年份:

=> SELECT value
FROM brin_page_items(
  get_raw_page('flights_bi_scheduled_time_idx', 6),
  'flights_bi_scheduled_time_idx'
)
WHERE blknum = 0;
                       value
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 {2016−08−15 02:45:00+03 .. 2017−08−16 09:35:00+03}
(1 row)

查询中指定的日期越小,需要扫描的范围就越多。下图显示了这一灾难的严重程度:

29.7Minmax-Multi 类:插图 4
图 29.4

为了解决这个问题,我们需要使摘要信息更加复杂一些:不再存储单个连续的范围,而是需要存储多个较小的范围,这些范围加起来覆盖所有的值。然后,其中一个范围可以覆盖主要的数据集,而其余的则处理偶尔的异常值。

这样的功能由 minmax-multi 操作符类提供:8

=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%minmax_multi_ops'
ORDER BY opcname;
           opcname
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 date_minmax_multi_ops
 float4_minmax_multi_ops
 float8_minmax_multi_ops
 inet_minmax_multi_ops
 ...
 time_minmax_multi_ops
 timestamp_minmax_multi_ops
 timestamptz_minmax_multi_ops
 timetz_minmax_multi_ops
 uuid_minmax_multi_ops
(19 rows)

与 minmax 操作符类相比,minmax-multi 类有一个额外的支持函数,用于计算值之间的距离;这个函数用于确定范围长度,操作符类则努力减少这一长度。

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'numeric_minmax_multi_ops'
ORDER BY amprocnum;
 amprocnum |               amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
         1 | brin_minmax_multi_opcinfo
         2 | brin_minmax_multi_add_value
         3 | brin_minmax_multi_consistent
         4 | brin_minmax_multi_union
         5 | brin_minmax_multi_options
        11 | brin_minmax_multi_distance_numeric
(6 rows)

这类操作符的操作与 minmax 类的操作完全相同。

Minmax-multi 类可以接受 values_per_range32 参数,该参数定义了每个范围所允许的摘要值的最大数量。一个摘要值由两个数字 (一个区间) 表示,而单个点只需要一个数字。如果值不够,一些区间会缩小。9

让我们构建一个 minmax-multi 索引来替换现有的索引。我们将每个范围允许的值的数量限制为 16:

=> DROP INDEX flights_bi_scheduled_time_idx;
=> CREATE INDEX ON flights_bi USING brin(
  scheduled_time timestamptz_minmax_multi_ops(
    values_per_range = 16
  )
);

图表显示,新索引将效率恢复到了原始水平。不出所料,这也导致了索引大小的增加:
29.7Minmax-Multi 类:插图 5
图 29.5

29.8 Inclusion 类

minmax 操作符类与 inclusion 操作符类之间的区别,大致上与 B 树和 GiST 索引之间的区别相似:后者用于不支持比较操作的数据类型,尽管对于它们而言,值的相互对齐仍然有意义。由 inclusion 操作符类提供的特定范围内的摘要信息,由该范围内值的边界框表示。

此处是这些操作符类;数量并不多:

=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%inclusion_ops'
ORDER BY opcname;
       opcname
−−−−−−−−−−−−−−−−−−−−−
 box_inclusion_ops
 inet_inclusion_ops
 range_inclusion_ops
(3 rows)

支持函数的列表通过增加一个必需的函数来扩展,该函数用于合并两个值,以及一系列可选的函数:

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'box_inclusion_ops'
ORDER BY amprocnum;
 amprocnum |          amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−−−
         1 | brin_inclusion_opcinfo			
         2 | brin_inclusion_add_value
         3 | brin_inclusion_consistent
         4 | brin_inclusion_union
        11 | bound_box
        13 | box_contain
(6 rows)

在处理可以比较的值时,我们依赖于它们的相关性;但对于其他数据类型,不会收集这样的统计信息,10 因此很难预测基于 inclusion 的 BRIN 索引的效率。

更糟糕的是,相关性极大地影响了索引扫描的成本估算。如果这样的统计信息不可用,它将被视为零。11 因此,规划器无法区分精确和模糊的 inclusion 索引,所以通常会避免使用它们。

PostGIS 会收集空间数据相关性的统计信息v. 3.1.1。

在此特例下,我们可以假设在机场坐标上建立索引是有意义的,因为经度必须与时区相关联。

与 GiST 谓词不同,BRIN 摘要信息与被索引数据具有相同的类型;因此,为点构建索引并不那么容易。但是,我们可以通过将点转换成虚拟矩形来创建一个表达式索引。

=> CREATE INDEX ON flights_bi USING brin(box(airport_coord))
WITH (pages_per_range = 8);
=> SELECT pg_size_pretty(pg_total_relation_size(
  'flights_bi_box_idx'
));
 pg_size_pretty
−−−−−−−−−−−−−−−−
 3816 kB
(1 row)

在时区上建立的索引,如果范围大小相同,大约占用相同的大小 (3288 kB)。

这个类中包含的操作符类似于 GiST 操作符。例如,BRIN 索引可以用来加速在特定区域内点的搜索:

=> SELECT airport_code, airport_name
FROM airports
WHERE box(coordinates) <@ box '135,45,140,50';
 airport_code |      airport_name
−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 KHV          | Khabarovsk−Novy Airport
(1 row)

但如前所述,除非我们关闭顺序扫描,否则规划器拒绝使用索引扫描:

=> EXPLAIN (costs off)
SELECT *
FROM flights_bi
WHERE box(airport_coord) <@ box '135,45,140,50';
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights_bi
   Filter: (box(airport_coord) <@ '(140,50),(135,45)'::box)
(2 rows)

=> SET enable_seqscan = off;
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM flights_bi
WHERE box(airport_coord) <@ box '135,45,140,50';
                            QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights_bi (actual rows=511414 loops=1)
   Recheck Cond: (box(airport_coord) <@ '(140,50),(135,45)'::box)
   Rows Removed by Index Recheck: 630756
   Heap Blocks: lossy=19656
   −> Bitmap Index Scan on flights_bi_box_idx (actual rows=196560...
       Index Cond: (box(airport_coord) <@ '(140,50),(135,45)'::box)
(6 rows)
=> RESET enable_seqscan;

29.9 Bloom 类v. 14

基于布隆过滤器的操作符类允许对任何支持等于操作且定义了哈希函数的数据类型使用 BRIN 索引。如果值分布在不同范围内且它们的物理位置与逻辑顺序没有相关性,那么也可以将这些操作符类应用于常规的 ordinal 数据类型。

这些操作符类的名称中包含 “bloom” 一词:12

=> SELECT opcname
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
WHERE amname = 'brin'
AND opcname LIKE '%bloom_ops'
ORDER BY opcname;
        opcname
−−−−−−−−−−−−−−−−−−−−−−−
 bpchar_bloom_ops
 bytea_bloom_ops
 char_bloom_ops
 ...
 timestamptz_bloom_ops
 timetz_bloom_ops
 uuid_bloom_ops
(24 rows)

布隆过滤器是一种经典的数据结构,它能够快速检查一个元素是否属于某个集合。这个过滤器非常紧凑,但它允许误报 (false positives):可能会误认为集合中包含比实际更多的元素。然而,更重要的是,它避免了漏报 (false negative):如果元素实际存在于集合中,过滤器不会认为它不存在。

这种过滤器是由 m 个比特位组成的数组 (也称为签名),初始时这些位都被置为零。我们选定 k 个不同的哈希函数,将集合中的任何元素映射到签名的 k 个位上。当一个元素被添加到集合中时,签名中的每一位都会被设置为一。因此,如果与某个元素对应的所有位都被设置为一,则该元素可能存在于集合中;如果至少有一位为零,则可以保证该元素不存在。

在 BRIN 索引的情况下,过滤器处理属于特定范围的索引列的一组值;该范围的摘要信息由构建的布隆过滤器表示。

bloom 扩展 13 提供了一种基于布隆过滤器的索引访问方法。它为每行数据构建一个过滤器,并处理每行的一组列值。这样的索引旨在一次索引多列,并且可以用于临时查询,这种查询中过滤条件里所引用的列是事先未知的。BRIN 索引也可以建立在多个列上,但其摘要信息将包含为这些列中的每一个列构建的独立的布隆过滤器。

布隆过滤器的准确性取决于签名长度。在理论上,可以估算出最优的签名位数 m=−nlog⁡2pln⁡2m = \frac{-n \log_{2} p}{\ln 2},其中 n 是集合中元素的数量,p 是发生误报的概率。这两个设置可以通过相应的操作符类参数进行调整:

  • n_distinct_per_range-0.1 定义了集合中元素的数量;在这种情况下,它是索引列的一个范围中不同值的数量。这个参数值的解释就像对不同值的统计一样:负值表示范围中行的比例,而不是它们的绝对数量。

  • false_positive_rate0.01 定义了发生误报的概率。一个接近零的值意味着索引扫描几乎肯定会跳过没有被搜索值的范围。但这并不保证精确搜索,因为被扫描的范围还将包含不匹配查询的额外行。这种行为是由于范围宽度和物理数据位置造成的,而不是由于实际的过滤器属性。

支持函数列表增加了一个哈希函数:

=> SELECT amprocnum, amproc::regproc
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amproc amop ON amprocfamily = opcfamily
WHERE amname = 'brin'
AND opcname = 'numeric_bloom_ops'
ORDER BY amprocnum;
 amprocnum |        amproc
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−
         1 | brin_bloom_opcinfo
         2 | brin_bloom_add_value
         3 | brin_bloom_consistent
         4 | brin_bloom_union
         5 | brin_bloom_options
        11 | hash_numeric
(6 rows)	

由于布隆过滤器基于哈希运算,因此它只支持等值操作符:

=> SELECT amopopr::regoperator, oprcode::regproc, amopstrategy
FROM pg_am am
  JOIN pg_opclass opc ON opcmethod = am.oid
  JOIN pg_amop amop ON amopfamily = opcfamily
  JOIN pg_operator opr ON opr.oid = amopopr
WHERE amname = 'brin'
AND opcname = 'numeric_bloom_ops'
ORDER BY amopstrategy;
      amopopr       |  oprcode   | amopstrategy
−−−−−−−−−−−−−−−−−−−−+−−−−−−−−−−−−+−−−−−−−−−−−−−−
 =(numeric,numeric) | numeric_eq |            1
(1 row)

让我们以存储航班号的 flight_no 列为例;它几乎没有相关性,因此对于常规范围操作符类来说是无用的。我们将保持默认的 false-positive 设置;至于一个范围内的不同值数量,可以很容易地计算出来。例如,对于一个八页的范围,我们将得到以下的值:

=> SELECT max(nd)
FROM (
  SELECT count(distinct flight_no) nd
    FROM flights_bi
GROUP BY tid2page(ctid) / 8
) t;
 max
−−−−−
  22
(1 row)

对于较小的范围,这个数字甚至会更低 (但无论如何,操作符类不允许小于 16 的值)。

我们只需创建一个索引并检查执行计划:

=> CREATE INDEX ON flights_bi USING brin(
  flight_no bpchar_bloom_ops(
    n_distinct_per_range = 22)
)
WITH (pages_per_range = 8);
=> EXPLAIN (analyze, costs off, timing off, summary off)
SELECT *
FROM flights_bi
WHERE flight_no = 'PG0001';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights_bi (actual rows=5192 loops=1)
   Recheck Cond: (flight_no = 'PG0001'::bpchar)
   Rows Removed by Index Recheck: 122894
   Heap Blocks: lossy=2168
   −> Bitmap Index Scan on flights_bi_flight_no_idx (actual rows=...
       Index Cond: (flight_no = 'PG0001'::bpchar)
(6 rows)
=> RESET max_parallel_workers_per_gather;

图表显示,对于某些航班号 (由不属于任何须部分的单独点表示),索引的工作效果不是很好,但总体效率相当高:
29.9Bloom 类:插图 6
图 29.6

  1. postgresql.org/docs/14/brin.html
    backend/access/brin/README ↩︎

  2. edu.postgrespro.ru/internals-14/flights_bi.sql ↩︎

  3. edu.postgrespro.ru/internals-\oldstylenums{14}/flights_bi.dump. ↩︎

  4. backend/access/brin/brin.c, bringetbitmap function ↩︎

  5. backend/access/brin/brin.c, brininsert function ↩︎

  6. backend/access/brin/brin.c, summarize_range function ↩︎

  7. backend/access/brin/brin_minmax.c ↩︎

  8. backend/access/brin/brin_minmax_multi.c ↩︎

  9. backend/access/brin/brin_minmax_multi.c, reduce_expanded_ranges function ↩︎

  10. backend/commands/analyze.c, compute_scalar_stats function ↩︎

  11. backend/utils/adt/selfuncs.c, brincostestimate function ↩︎

  12. backend/access/brin/brin_bloom.c ↩︎

  13. postgresql.org/docs/14/bloom.html ↩︎

结论

好了,现在我们的旅程即将结束。希望你能觉得这本书有用 — 或至少有趣 — 并且从中学到了一些新东西(我自己在写作过程中也学到了很多)。

尽管大部分内容可能在很长一段时间内仍然是最新的,但一些细节将不可避免地发生变化。我相信这本书的最大价值不是一套具体的事实标准,而是我展示的探索系统的方式。你不应该认为这本书或相关文档中的信息是理所当然的。思考、实验、自行验证所有事实:PostgreSQL 为此提供了所有你需要的工具,我试图展示如何使用它们。这通常几乎和在论坛上提问或谷歌搜索答案一样简单,但绝对更可靠、更有用。

出于同样的原因,我还鼓励你查看代码。不要被其复杂性吓倒:只需尝试使用。开源是一个巨大的优势,所以抓住这个机会。很高兴收到你的反馈;你可以将你的评论和想法发送到 edu@postgrespro.ru。我打算定期更新这本书,所以你的评论可以帮助我改进未来的版本。最新的在线版本可在 postgrespro.com/community/books/internals 免费获取。

祝你好运!

版权与来源

《PostgreSQL 内参:深入解析运行原理》是 Egor Rogov 所著 PostgreSQL 14 Internals 的中文译本,由**熊灿灿(Xiong Cancan)**翻译。英文版由 Liudmila Mantrova 从俄文译出,© Postgres Professional, 2022–2023。

Postgres Professional 官方书页列出了中文译本及译者,并链接至译者原站。

中文译本声明

以下声明保留自译者仓库 README:

本中文译文版版权归熊灿灿所有,未经许可不得转载或用于商业用途。英文原文版权归 Postgres Professional 所有。本译文根据授权翻译与发布。

原声明文本

来源与版本

正文、代码、插图、脚注、旁注、推荐序及译者介绍取自译者公开网页,快照固定于提交 557a062fe1f4b5f61c9c800e4f0b1eec4dbe4697。本地版只调整网页排版和站内链接,不构成新的翻译。

中文与英文均覆盖 PostgreSQL 14。本站俄文版覆盖 PostgreSQL 18,为另一个版本,不能将其版本差异视为中英翻译差异。

原站包含 29 章、结论及前言材料,没有单独的分部页和书末索引译文。本站目录按英文原书五个部分加入分隔页,保留原有章节顺序;书末索引请参阅英文版。

原书封面的大象出自 Edward Topsell 的 The History of Four-footed Beasts and Serpents(伦敦,1658)。英文出版信息和俄文出版信息分别保留其原版署名。