=> CREATE FUNCTION data_to_text(data text)
RETURNS text
AS $$
DECLARE
  raw bytea := ('\x'||replace(data,' ',''))::bytea;
  pos integer := 0;
  len integer;
  res text := '';
BEGIN
  WHILE (octet_length(raw) > pos)
  LOOP
    len := (get_byte(raw,pos) - 3) / 2;
    EXIT WHEN len <= 0;
    IF pos > 0 THEN
      res := res || ', ';
    END IF;
    res := res || (
      SELECT string_agg( chr(get_byte(raw, i)),'')
      FROM generate_series(pos+1,pos+len) i
    );
    pos := pos + len + 1;
  END LOOP;
  RETURN res;
END;
$$ LANGUAGE plpgsql;
=> EXPLAIN (costs off)
SELECT * FROM bookings
WHERE book_ref = 'E2D725';
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_pkey on bookings
   Index Cond: (book_ref = 'E2D725'::bpchar)
(2 rows)
25.3.1 去重v. 13
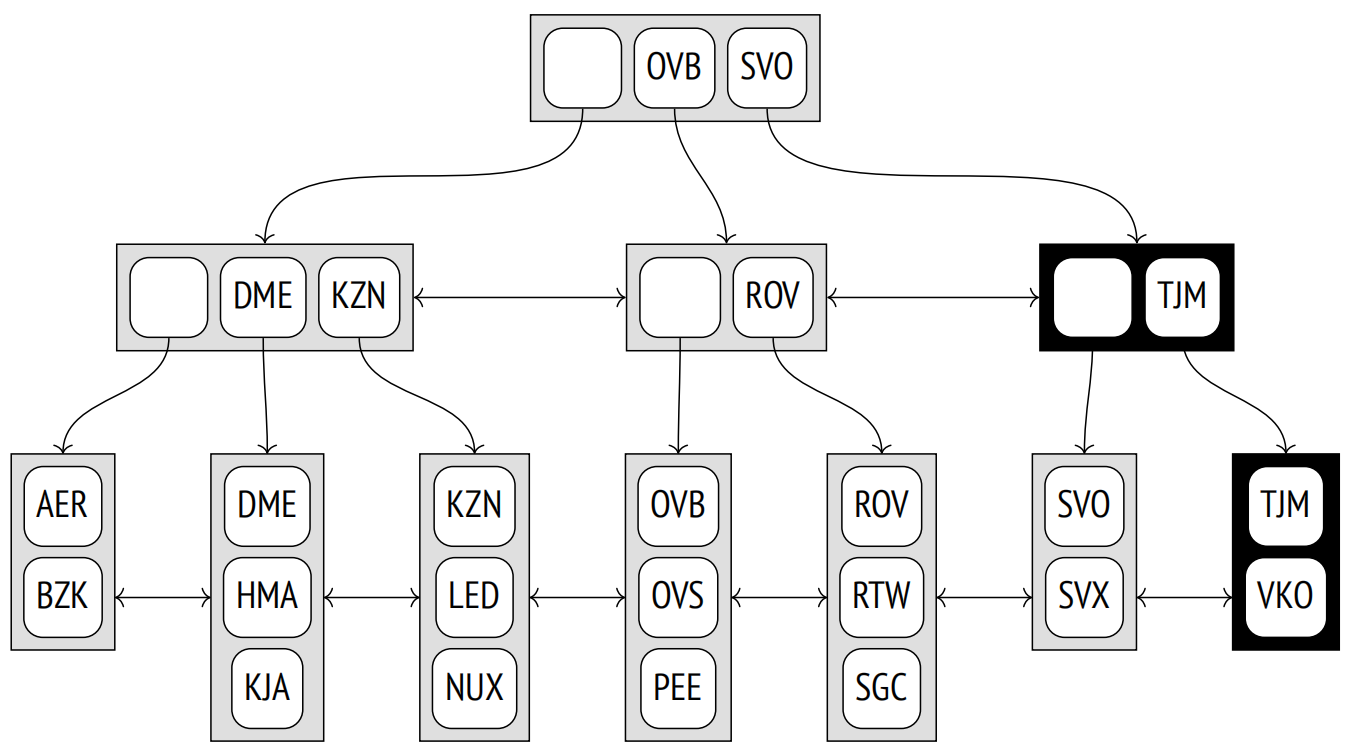
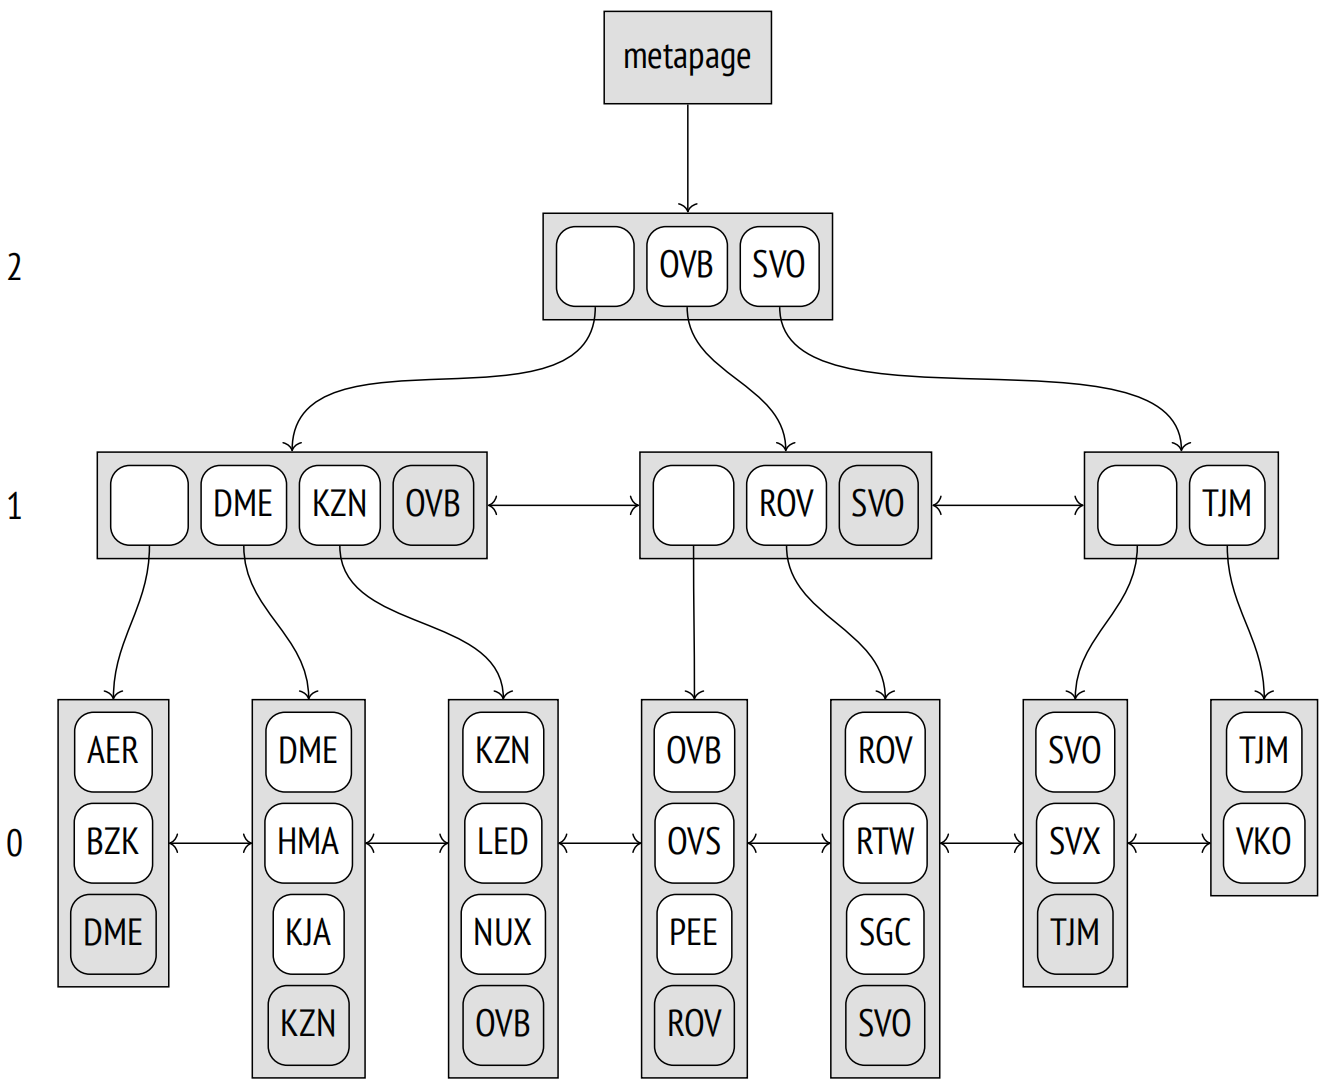
非唯一索引可以包含许多指向不同堆元组的重复键。由于非唯一键出现不止一次,并因此占用大量空间,所以重复键被折叠收敛成一个单独的索引条目,其中包含键和相应元组 ID 的列表。3 在某些情况下,这个过程 (称为去重) 可以显著减小索引的大小。
B 树操作符类还包括几个支持函数。10 第一个函数必须在第一个参数大于第二个参数时返回 1,如果它小于第二个参数,则返回 -1,如果参数相等,则返回 0。
其他支持函数是可选的,但它们可以提升访问方法的性能。
为了更好地理解这种机制,我们可以定义一个带有非默认排序规则的新数据类型。文档给出了复数的示例,11 但它是用 C 语言编写的。幸运的是,B 树操作符类也可以使用解释型语言来实现,因此我将利用这一点,尽可能简单地制作一个示例 (即使明知效率低下)。
接下来,让我们定义一个用于信息单位的新复合类型:
=> CREATE TYPE capacity_units AS ENUM (
  'B', 'kB', 'MB', 'GB', 'TB', 'PB'
);
=> CREATE TYPE capacity AS (
  amount integer,
  unit capacity_units
);
现在创建一个包含新类型列的表,并用随机值填充:
=> CREATE TABLE test AS
  SELECT ( (random()*1023)::integer, u.unit )::capacity AS cap
  FROM generate_series(1,100),
    unnest(enum_range(NULL::capacity_units)) AS u(unit);
默认情况下,复合类型的值按字典顺序排序,这与本示例中的自然顺序不同。
=> SELECT * FROM test ORDER BY cap;
    cap
−−−−−−−−−−−
 (1,B)
 (3,GB)
 (4,MB)
 (9,kB)
 ...
 (1017,kB)
 (1017,GB)
 (1018,PB)
 (1020,MB)
 (600 rows)
=> CREATE FUNCTION capacity_cmp(a capacity, b capacity)
RETURNS integer
AS $$
SELECT sign(capacity_to_bytes(a) - capacity_to_bytes(b));
$$ LANGUAGE sql STRICT IMMUTABLE;
=> CREATE OPERATOR CLASS capacity_ops
DEFAULT FOR TYPE capacity -- to be used by default
USING btree AS
  OPERATOR 1 #<#,
  OPERATOR 2 #<=#,
  OPERATOR 3 #=#,
  OPERATOR 4 #>=#,
  OPERATOR 5 #>#,
FUNCTION 1 capacity_cmp(capacity,capacity);
=> SELECT * FROM test ORDER BY cap;
    cap
−−−−−−−−−−−
 (1,B)
 (21,B)
 (27,B)
 (35,B)
 (46,B)
 ...
 (1002,PB)
 (1013,PB)
 (1014,PB)
 (1014,PB)
 (1018,PB)
(600 rows)
创建新索引时默认使用我们的操作符类,该索引以正确的顺序返回结果:
=> CREATE INDEX ON test(cap);
=> SELECT * FROM test WHERE cap #<# (100,'B')::capacity ORDER BY cap;
  cap
−−−−−−−−
 (1,B)
 (21,B)
 (27,B)
 (35,B)
 (46,B)
 (57,B)
 (68,B)
 (70,B)
 (72,B)
 (76,B)
 (78,B)
 (94,B)
(12 rows)
=> EXPLAIN (costs off) SELECT *
FROM test WHERE cap #<# (100,'B')::capacity ORDER BY cap;
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using test_cap_idx on test
   Index Cond: (cap #<# '(100,B)'::capacity)
(2 rows)
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE book_ref = '000010';
                    QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_book_ref_idx on tickets
   Index Cond: (book_ref = '000010'::bpchar)
(2 rows)
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE book_ref = '000010' AND passenger_name = 'LYUDMILA BOGDANOVA';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_bref_name_idx on tickets
   Index Cond: ((book_ref = '000010'::bpchar) AND (passenger_name...
(2 rows)
但如果我们查找乘客姓名,则必须扫描所有的行:
=> EXPLAIN (costs off) SELECT *
FROM tickets
WHERE passenger_name = 'LYUDMILA BOGDANOVA';
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Gather
   Workers Planned: 2
   −> Parallel Seq Scan on tickets
       Filter: (passenger_name = 'LYUDMILA BOGDANOVA'::text)
(4 rows)
=> EXPLAIN (costs off) SELECT *
FROM tickets
ORDER BY passenger_name, book_ref;
                    QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_name_bref_idx on tickets
(1 row)
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name DESC, book_ref DESC;
                         QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan Backward using tickets_name_bref_idx on tickets
(1 row)
但是,如果需要同时按一个列升序和另一个列降序排序,那么此索引将无法立即返回数据。
在这种情况下,索引提供的是部分排序的数据,必须进一步按第二个属性排序:
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name ASC, book_ref DESC;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Incremental Sort
   Sort Key: passenger_name, book_ref DESC
   Presorted Key: passenger_name
   −> Index Scan using tickets_name_bref_idx on tickets
(4 rows)
空值的位置也会影响使用索引进行排序的能力。默认情况下,出于排序目的,空值被视为比常规值"更大",也就是说,如果排序顺序为升序,它们位于树的右侧,如果排序顺序为降序,则位于左侧。可以使用 NULLS LAST 和 NULLS FIRST 子句更改空值的位置。
在下一个示例中,索引不满足 ORDER BY 子句,因此必须对结果进行排序:
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name NULLS FIRST, book_ref DESC;
                        QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Gather Merge
   Workers Planned: 2
   −> Sort
       Sort Key: passenger_name NULLS FIRST, book_ref DESC
       −> Parallel Seq Scan on tickets
(5 rows)
但如果我们创建一个遵循所需顺序的索引,那么它便会被使用:
=> CREATE INDEX tickets_name_bref_idx2
ON tickets(passenger_name NULLS FIRST, book_ref DESC);
=> EXPLAIN (costs off) SELECT *
FROM tickets ORDER BY passenger_name NULLS FIRST, book_ref DESC;
                     QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using tickets_name_bref_idx2 on tickets
(1 row)
25.5 属性
让我们看一下 B 树的接口属性。
25.5.1 访问方法属性
=> SELECT a.amname, p.name, pg_indexam_has_property(a.oid, p.name)
FROM pg_am a, unnest(array[
  'can_order', 'can_unique', 'can_multi_col',
  'can_exclude', 'can_include'
]) p(name)
WHERE a.amname = 'btree';
 amname |     name      | pg_indexam_has_property
−−−−−−−−+−−−−−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−−−−
 btree  | can_order     | t
 btree  | can_unique    | t
 btree 	| can_multi_col | t
 btree  | can_exclude   | t
 btree  | can_include   | t
(5 rows)
=> EXPLAIN (costs off) SELECT *
FROM bookings ORDER BY book_ref DESC;
                     QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan Backward using bookings_pkey on bookings
(1 row)