=> EXPLAIN SELECT * FROM bookings
WHERE book_ref = '9AC0C6' AND total_amount = 48500.00;
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_pkey on bookings
   (cost=0.43..8.45 rows=1 width=21)
   Index Cond: (book_ref = '9AC0C6'::bpchar)
   Filter: (total_amount = 48500.00)
(4 rows)
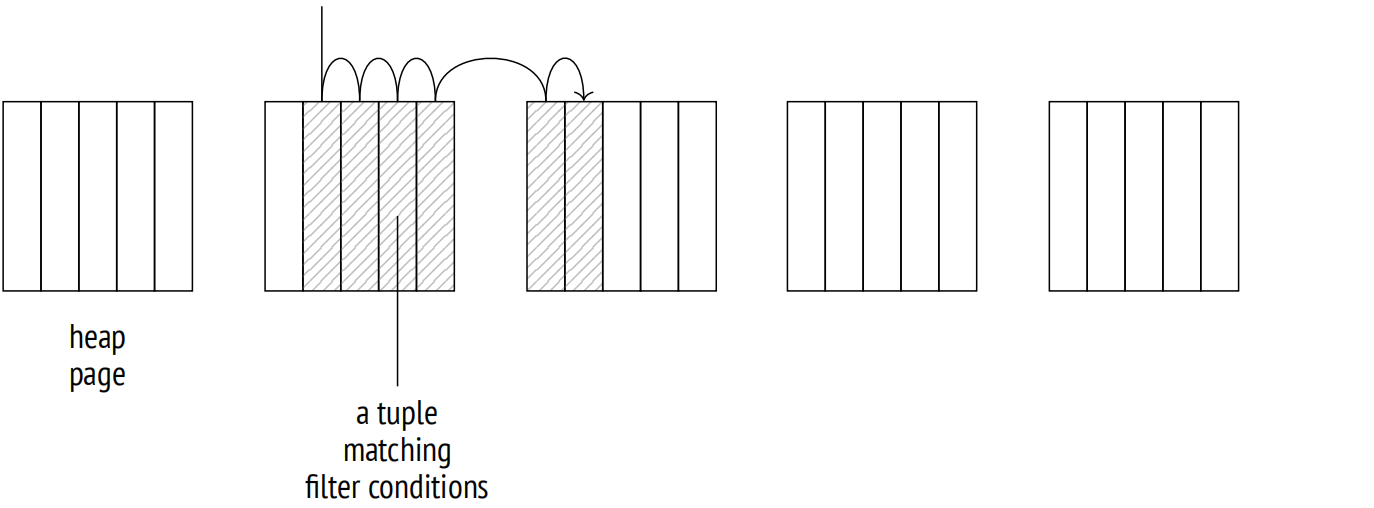
索引扫描期间,访问方法逐个返回 TIDS 2。接收到 TID 之后,索引引擎访问此 TID 引用的堆页面,获取相应的元组,如果满足可见性规则,则返回所请求的该元组相关字段。这个过程会持续进行,直到访问方法没有更多匹配查询的 TIDS 为止。
Index Cond 行仅包括可以使用索引检查的过滤条件。其他需要根据堆重新检查的条件将在 Filter 行中单独列出。
如本例所示,索引和堆访问操作均由一个共同的 Index Scan 节点处理,而不是由两个不同的节点处理。但是,还有一个单独的 Tid Scan 节点 3,如果提前知道元组 ID,便可从堆中获取元组:
=> EXPLAIN SELECT * FROM bookings WHERE ctid = '(0,1)'::tid;
                       QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Tid Scan on bookings (cost=0.00..4.01 rows=1 width=21)
   TID Cond: (ctid = '(0,1)'::tid)
(2 rows)
20.1.1 成本估算
索引扫描的成本估算包括索引访问操作和堆页面读取的预估成本。
显然,索引相关的估算部分完全取决于特定的访问方法。对于 B 树,成本主要由获取索引页和处理其条目所产生。要读取的页数和行数可以通过数据总量和应用的过滤条件的选择率来确定。索引页是随机访问的 (在逻辑结构上相邻的页面在磁盘上是物理分散的) 。从根节点到叶节点并计算所有需要的表达式所花费的 CPU 资源进一步增加了预估成本。4
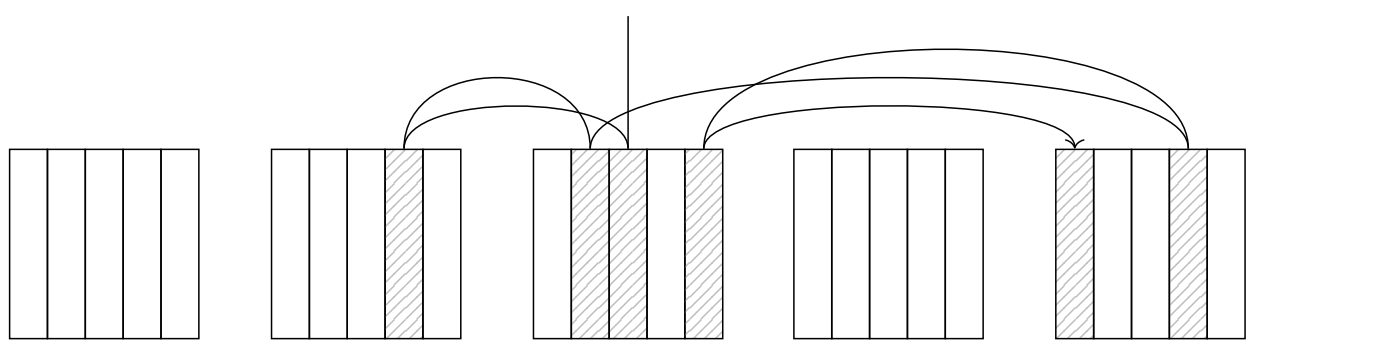
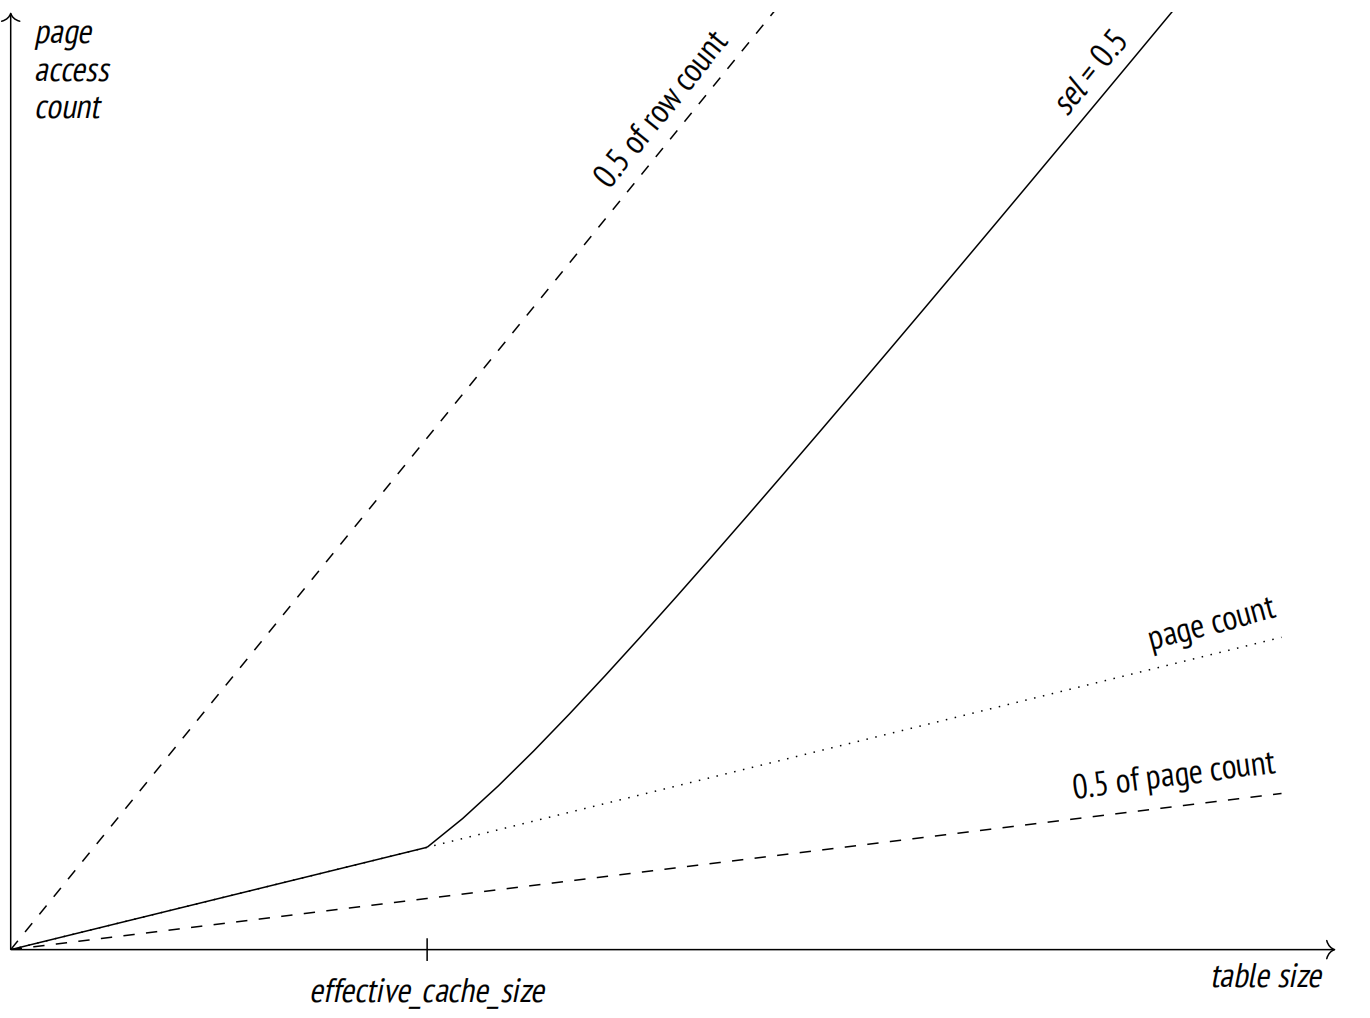
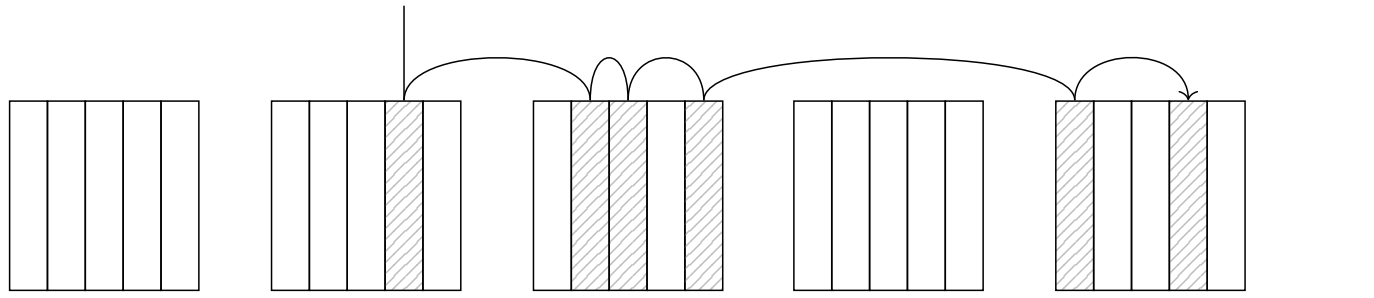
堆相关部分的估算包括堆页面访问的成本和处理所有获取的元组所需的 CPU 时间。需要注意的是,I/O 估算取决于索引扫描的选择率以及磁盘上元组的物理顺序与访问方法返回其 ID 的顺序之间的相关性。
但是,完美的相关性并不能保证所有的查询都将按照 book_ref 值的升序返回结果。首先,任何更新都会将生成的元组移动到表的末尾。其次,依赖于其他列的索引扫描的计划将以不同的顺序返回结果。即使是顺序扫描也可能不从表的开头开始。因此,如果你需要特定的顺序,你应该在 ORDER BY 子句中明确定义它。
此处是一个处理大量行的索引扫描示例:
=> EXPLAIN SELECT * FROM bookings WHERE book_ref < '100000';
                 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_pkey on bookings
   (cost=0.43..4638.91 rows=132999 width=21)
   Index Cond: (book_ref < '100000'::bpchar)
(3 rows)
条件的选择率估算结果如下:
=> SELECT round(132999::numeric/reltuples::numeric, 4)
FROM pg_class WHERE relname = 'bookings';
 round
−−−−−−−−
 0.0630
(1 row)
=> CREATE INDEX ON bookings(book_date);
=> SET enable_seqscan = off;
=> SET enable_bitmapscan = off;
=> EXPLAIN SELECT * FROM bookings
WHERE book_date < '2016-08-23 12:00:00+03';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Scan using bookings_book_date_idx on bookings
   (cost=0.43..56957.48 rows=132403 width=21)
   Index Cond: (book_date < '2016−08−23 12:00:00+03'::timestamp w...
(3 rows)
=> EXPLAIN SELECT book_ref FROM bookings WHERE book_ref < '100000';
                   QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_pkey on bookings
   (cost=0.43..3791.91 rows=132999 width=7)
   Index Cond: (book_ref < '100000'::bpchar)
(3 rows)
=> CREATE TEMP TABLE bookings_tmp
WITH (autovacuum_enabled = off) AS
  SELECT * FROM bookings
  ORDER BY book_ref;
=> ALTER TABLE bookings_tmp ADD PRIMARY KEY(book_ref);
=> ANALYZE bookings_tmp;
=> EXPLAIN (analyze, timing off, summary off)
SELECT book_ref FROM bookings_tmp WHERE book_ref < '100000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_tmp_pkey on bookings_tmp
   (cost=0.43..4638.91 rows=132999 width=7) (actual rows=132109 l...
   Index Cond: (book_ref < '100000'::bpchar)
   Heap Fetches: 132109
(4 rows)
但是一旦表被清理之后,这样的检查就会变得多余,只要所有页面保持全部可见,就不会执行这样的检查。
=> VACUUM bookings_tmp;
=> EXPLAIN (analyze, timing off, summary off)
SELECT book_ref FROM bookings_tmp WHERE book_ref < '100000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_tmp_pkey on bookings_tmp
   (cost=0.43..3787.91 rows=132999 width=7) (actual rows=132109 l...
   Index Cond: (book_ref < '100000'::bpchar)
   Heap Fetches: 0
(4 rows)
=> CREATE UNIQUE INDEX ON bookings(book_ref) INCLUDE (book_date);

=> BEGIN;
=> ALTER TABLE bookings
DROP CONSTRAINT bookings_pkey CASCADE;
NOTICE: drop cascades to constraint tickets_book_ref_fkey on table
tickets
ALTER TABLE

=> ALTER TABLE bookings ADD CONSTRAINT bookings_pkey PRIMARY KEY
  USING INDEX bookings_book_ref_book_date_idx; -- a new index
NOTICE: ALTER TABLE / ADD CONSTRAINT USING INDEX will rename index
"bookings_book_ref_book_date_idx" to "bookings_pkey"
ALTER TABLE
=> ALTER TABLE tickets
  ADD FOREIGN KEY (book_ref) REFERENCES bookings(book_ref);
=> COMMIT;

=> EXPLAIN SELECT book_ref, book_date
FROM bookings WHERE book_ref < '100000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Index Only Scan using bookings_pkey on bookings (cost=0.43..437...
   Index Cond: (book_ref < '100000'::bpchar)
(2 rows)
这种索引通常被称为覆盖索引,但这种说法并不完全正确。如果一个索引的列集合覆盖了特定查询所需的所有列,那么该索引被认为是覆盖索引。无论是涉及通过 INCLUDE 子句添加的任何列,还是仅使用键列都无关紧要。此外,同一个索引对于一个查询可能是覆盖的,但对于另一个查询则可能不是。
如果查询将过滤条件应用于多列,并且这些列上分别创建了索引,那么位图扫描可以一起使用这些索引。17 所有这些索引都即时构建了自己的位图;然后使用逻辑与 (如果表达式通过 AND 连接) 或逻辑或 (如果表达式通过 OR 连接) 将位图按位合并。例如:
=> EXPLAIN (costs off)
SELECT * FROM bookings
WHERE book_date < '2016-08-28'
	AND total_amount > 250000;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on bookings
   Recheck Cond: ((total_amount > '250000'::numeric) AND (book_da...
   −> BitmapAnd
       −> Bitmap Index Scan on bookings_total_amount_idx
           Index Cond: (total_amount > '250000'::numeric)
       −> Bitmap Index Scan on bookings_book_date_idx
           Index Cond: (book_date < '2016−08−28 00:00:00+03'::tim...
(7 rows)
并行执行的成本以与顺序执行相同的方式进行估算,但是 (就像并行顺序扫描的情况一样) CPU 资源在所有并行进程之间分配,从而降低了总成本。成本的 I/O 组成部分没有分摊,因为进程被同步以顺序执行页面访问。
现在让我在不分解成本估算的情况下展示几个并行计划的示例。
并行索引扫描:
=> EXPLAIN SELECT sum(total_amount)
FROM bookings WHERE book_ref < '400000';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (cost=19192.81..19192.82 rows=1 width=32)
   −> Gather (cost=19192.59..19192.80 rows=2 width=32)
       Workers Planned: 2
       −> Partial Aggregate (cost=18192.59..18192.60 rows=1 widt...
           −> Parallel Index Scan using bookings_pkey on bookings
               (cost=0.43..17642.82 rows=219907 width=6)
               Index Cond: (book_ref < '400000'::bpchar)
(7 rows)
当正在执行 B 树并行扫描时,当前索引页的 ID 保存在服务器的共享内存中。初始值由启动扫描的进程设置:它从根遍历树,到第一个合适的叶子页面并保存其 ID。工作进程根据需要访问后续索引页面,替换保存的 ID。获取页面后,工作进程遍历其所有合适的条目并读取相应的堆元组。当工作进程读取了满足查询过滤条件的整个值范围时,扫描完成。
并行仅索引扫描:
=> EXPLAIN SELECT sum(total_amount)
FROM bookings WHERE total_amount < 50000.00;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (cost=23370.60..23370.61 rows=1 width=32)
   −> Gather (cost=23370.38..23370.59 rows=2 width=32)
       Workers Planned: 2
       −> Partial Aggregate (cost=22370.38..22370.39 rows=1 widt...
           −> Parallel Index Only Scan using bookings_total_amoun...
               (cost=0.43..21387.27 rows=393244 width=6)
               Index Cond: (total_amount < 50000.00)
(7 rows)
并行仅索引扫描跳过了页面全部可见的堆访问;这是它与并行索引扫描的唯一区别。
并行位图扫描:
=> EXPLAIN SELECT sum(total_amount)
FROM bookings WHERE book_date < '2016-10-01';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Finalize Aggregate (cost=21492.21..21492.22 rows=1 width=32)
   −> Gather (cost=21491.99..21492.20 rows=2 width=32)
       Workers Planned: 2
       −> Partial Aggregate (cost=20491.99..20492.00 rows=1 widt...
           −> Parallel Bitmap Heap Scan on bookings
               (cost=4891.17..20133.01 rows=143588 width=6)
               Recheck Cond: (book_date < '2016−10−01 00:00:00+03...
               −> Bitmap Index Scan on bookings_book_date_idx
                   (cost=0.00..4805.01 rows=344611 width=0)
                   Index Cond: (book_date < '2016−10−01 00:00:00+...
位图扫描意味着位图总是由单个领导者进程顺序构建;因此,Bitmap Index Scan 节点的名称不包含 Parallel 一词。当位图准备就绪后,Parallel Bitmap Heap Scan 节点开始并行堆扫描。工作进程访问后续的堆页面并且并发处理它们。
20.5 各种访问方法的比较
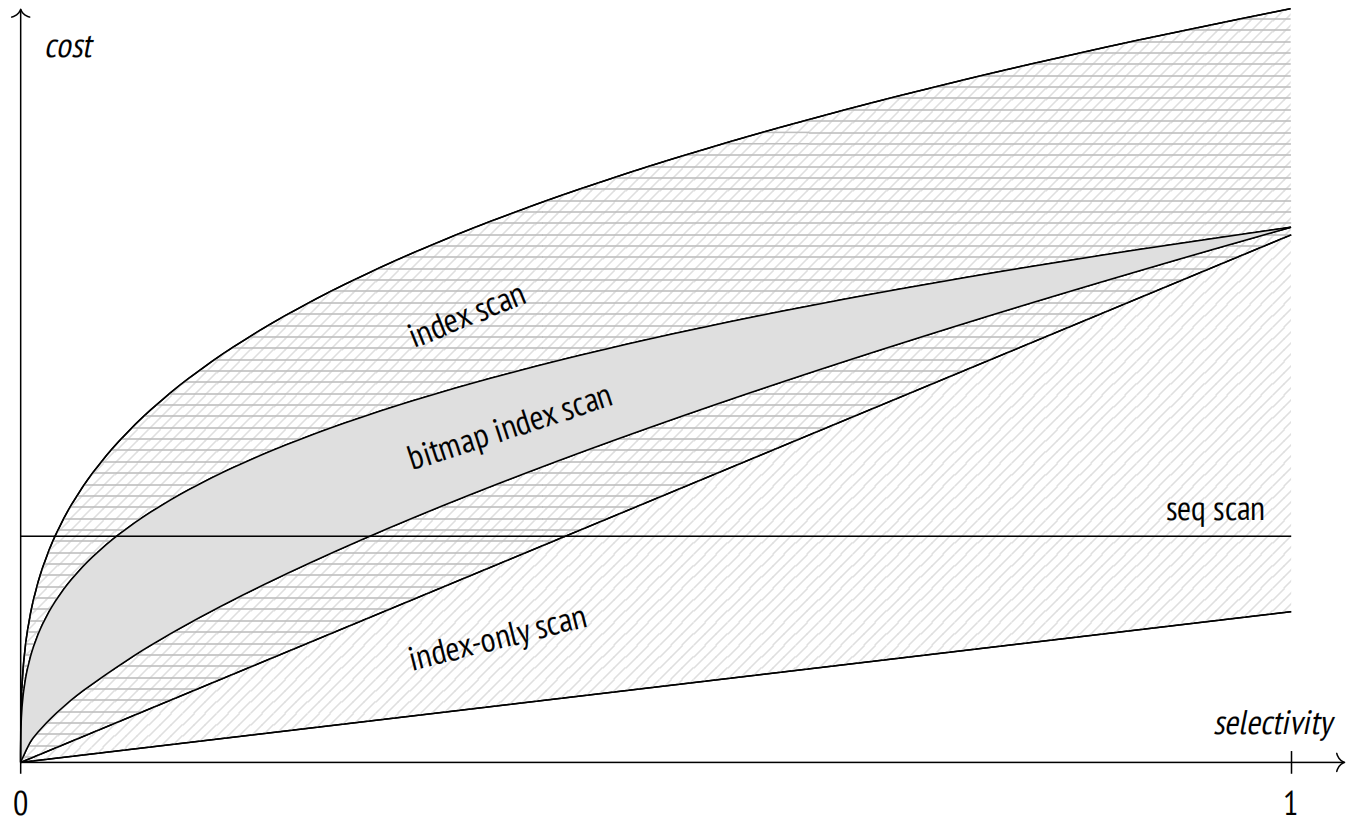
下图显示了过滤条件的选择率如何影响访问方法的成本:
图 20.7
这是一个定性图;实际数字当然取决于特定的表和服务器配置。
顺序扫描不依赖于选择率,从选定行的某个比例开始,它通常比其他方法更有效。
索引扫描的成本受到元组的物理顺序与访问方法返回的 ID 顺序之间的相关性的影响。如果相关性完美,即使所选行的比例很高,索引扫描也可以非常高效。然而,对于低相关性 (这更常见) ,它的成本很快甚至可能超过顺序扫描。尽管如此,在使用索引获取单行时 (通常是唯一索引),索引扫描仍然是绝对领先者。