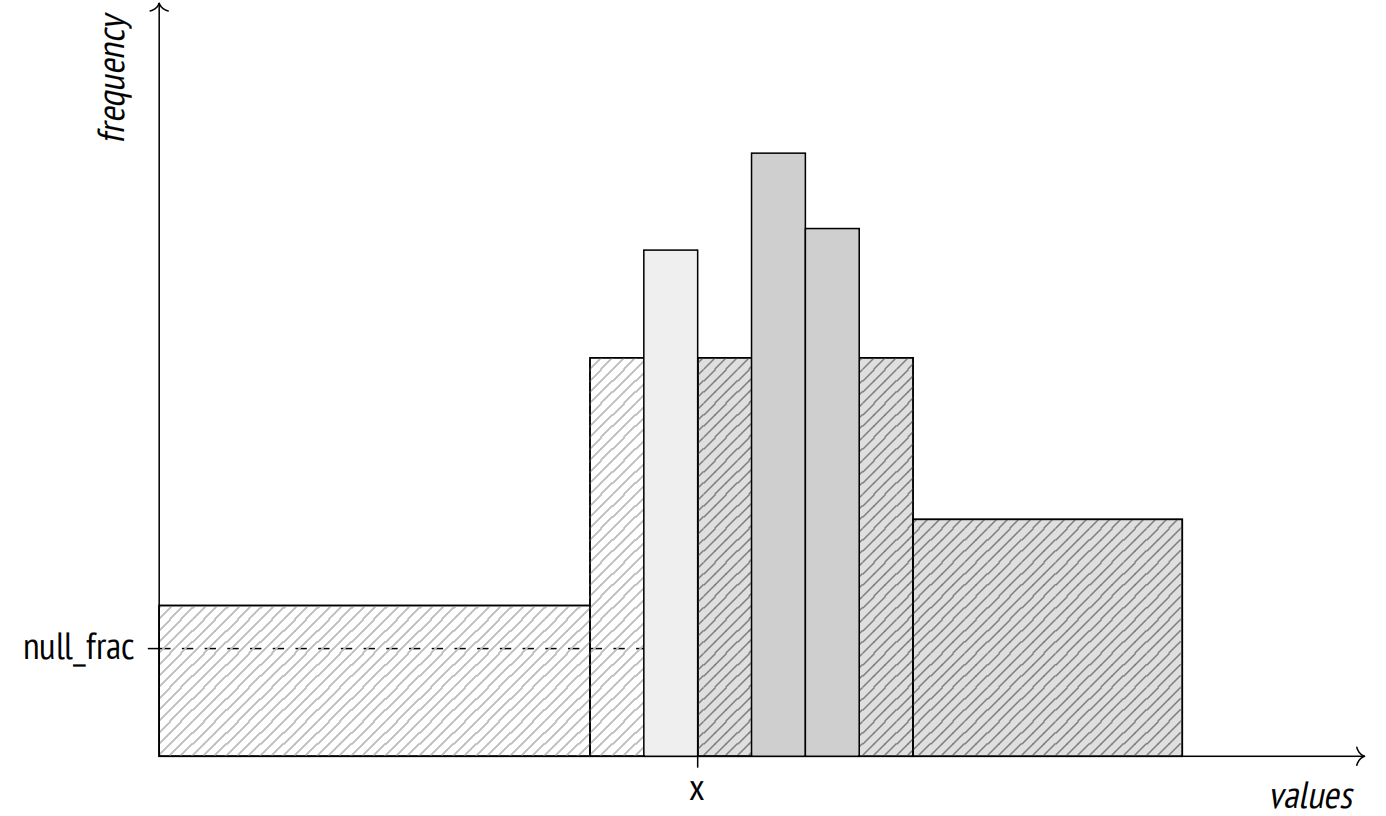
但是,特殊值需要特殊处理。除了理论上的不一致之外,还有许多实际挑战需要考虑。常规的布尔逻辑被三值逻辑所取代,因此 NOT IN 的行为出人意料。尚不清楚是否应该将空值视为大于或小于常规值 (因此排序时有 NULLS FIRST 和 NULLS LAST 子句)。不太明显的是,聚合函数是否应该考虑空值。严格来说,空值根本就不是一个值,因此规划器需要额外的信息来处理它们。
=> EXPLAIN SELECT * FROM flights WHERE actual_departure IS NULL;
                           QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..4772.67 rows=16702 width=63)
   Filter: (actual_departure IS NULL)
(2 rows)
为了预估结果,规划器将总行数乘以空值的比例:
=> SELECT round(reltuples * s.null_frac) AS rows
FROM pg_class
  JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
  AND s.attname = 'actual_departure';
 rows
−−−−−−−
 16702
(1 row)
以下是实际的行数:
=> SELECT count(*) FROM flights WHERE actual_departure IS NULL;
 count
−−−−−−−
 16348
(1 row)
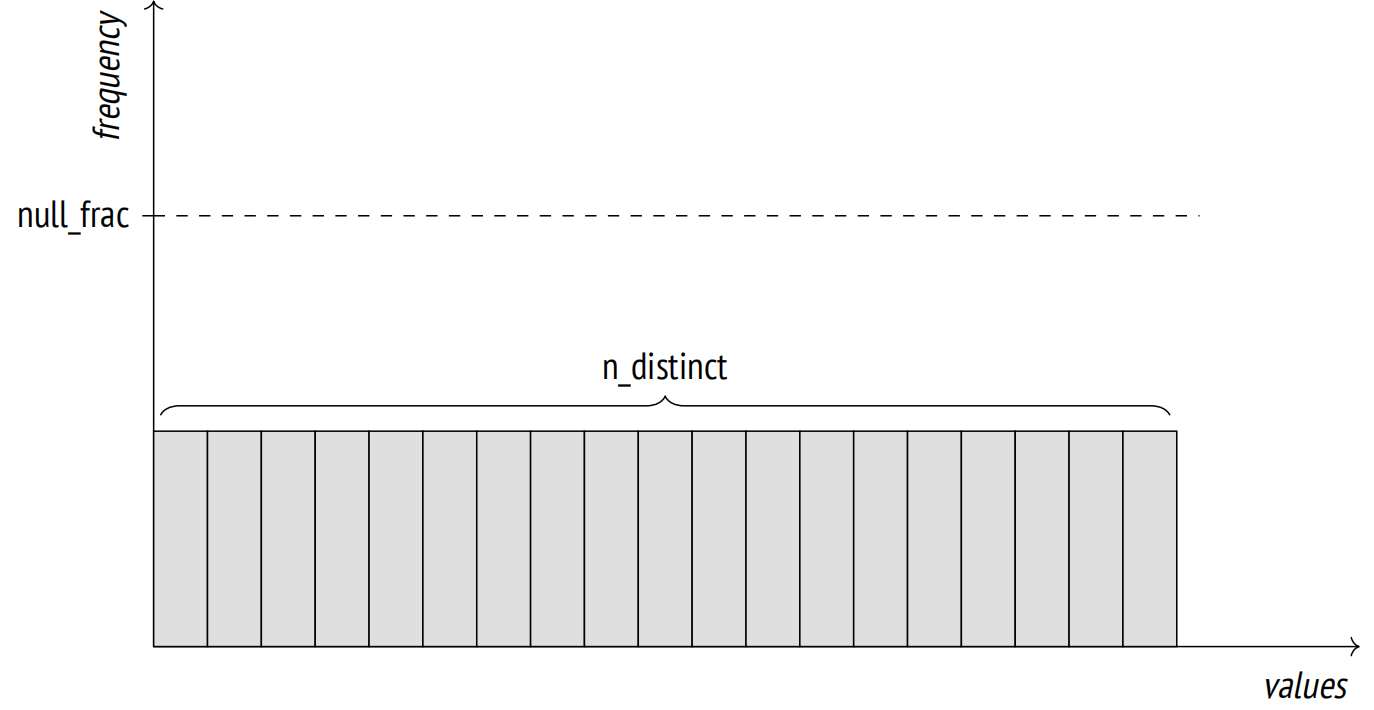
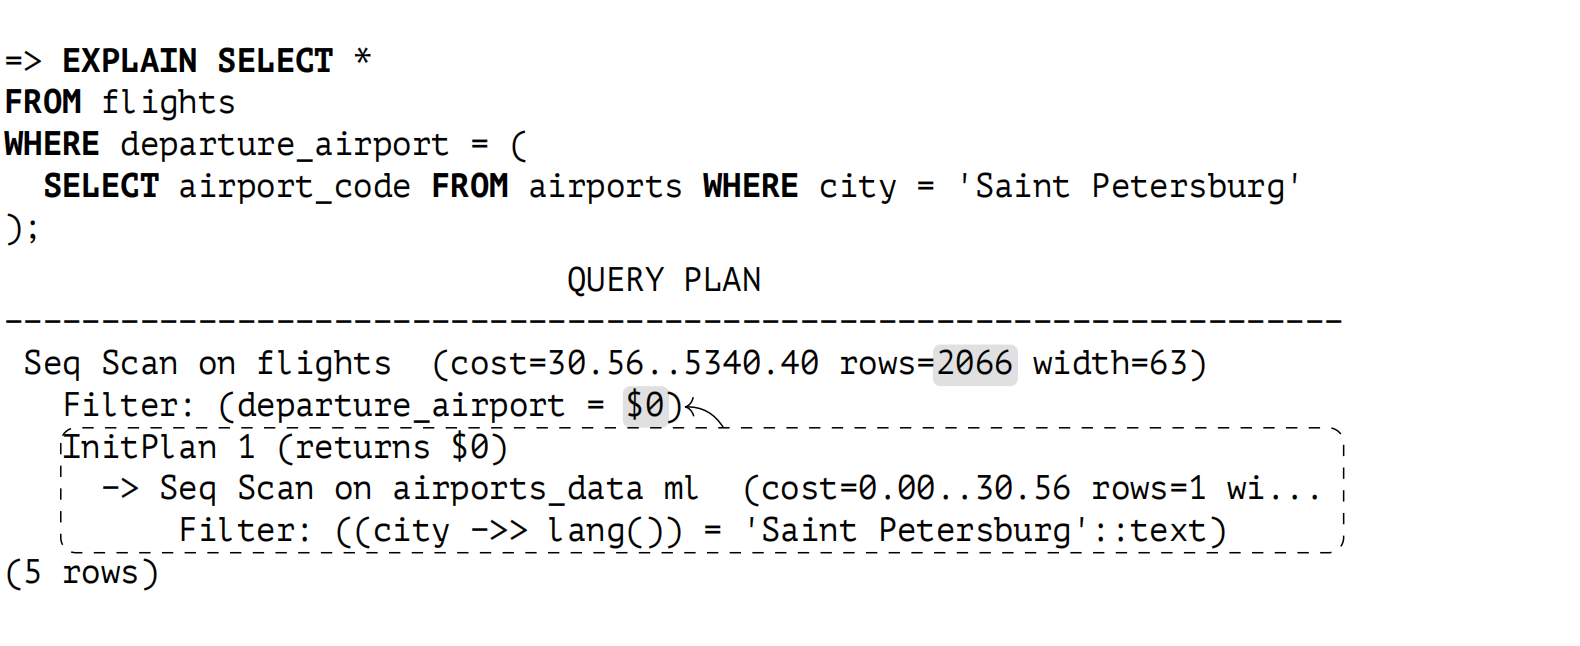
=> SELECT round(reltuples / s.n_distinct) AS rows
FROM pg_class
  JOIN pg_stats s ON s.tablename = relname
WHERE s.tablename = 'flights'
  AND s.attname = 'departure_airport';
 rows
−−−−−−
 2066
(1 row)
如果非重复值的预估数量不正确 (因为分析的行数有限),那么你可以在列级别覆盖它:
ALTER TABLE ...
  ALTER COLUMN ...
  SET (n_distinct = ...);
=> SELECT left(histogram_bounds::text,60) || '...' AS hist_bounds
FROM pg_stats s
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
                           hist_bounds
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 {10B,10E,10F,10F,11H,12B,13B,14B,14H,15G,16B,17B,17H,19B,19B...
(1 row)
=> EXPLAIN SELECT * FROM boarding_passes WHERE seat_no > '30B';
														 QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on boarding_passes (cost=0.00..157350.10 rows=2983242 ...
   Filter: ((seat_no)::text > '30B'::text)
(2 rows)
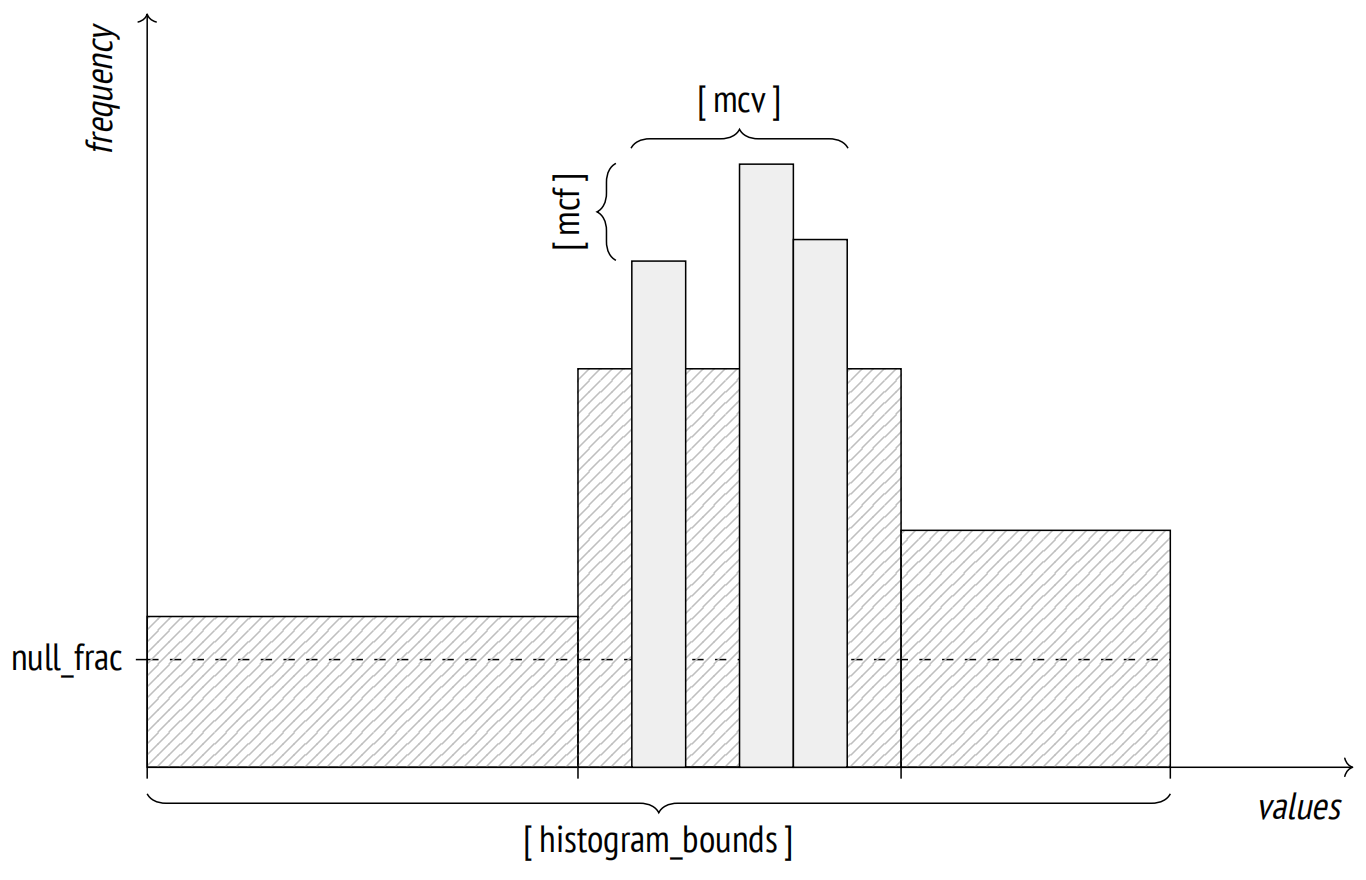
我特意选择了位于两个直方图桶之间边界上的座位号。这个条件的选择率将估算为 number of bucketsN,其中 N 是包含满足条件的值 (即位于指定值右侧的桶) 的桶数量。同时还需要考虑到 MCV 不包含在直方图中。
顺便说一下,空值也不会出现在直方图中,但 seat_no 列本来就没有这样的值:
=> SELECT s.null_frac FROM pg_stats s
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
 null_frac
−−−−−−−−−−−
         0
(1 row)
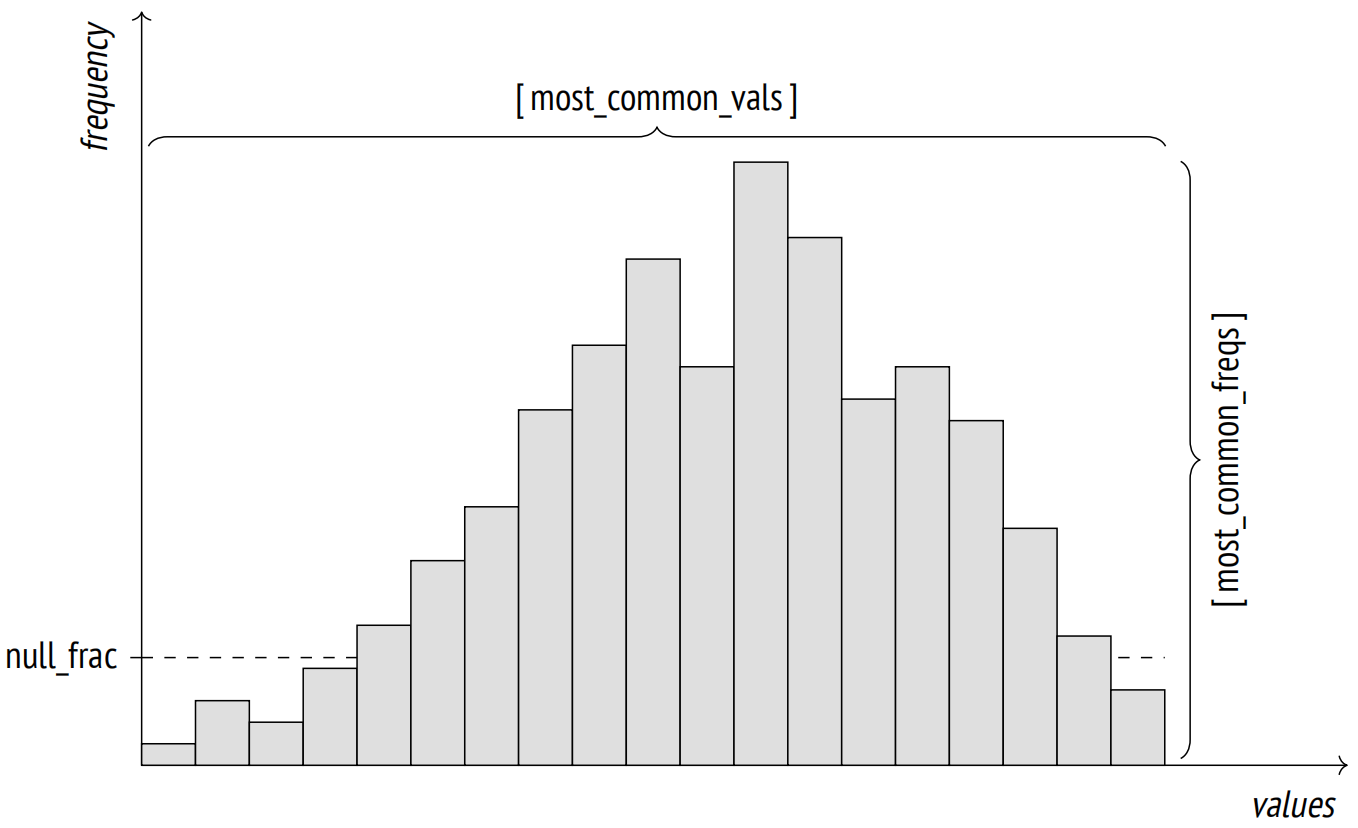
首先,让我们找出满足条件的 MCV 的比例:
=> SELECT sum(s.most_common_freqs[
  array_position((s.most_common_vals::text::text[]),v)
])
FROM pg_stats s, unnest(s.most_common_vals::text::text[]) v
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no'
  AND v > '30B';
    sum
−−−−−−−−−−−−
 0.21226665
(1 row)
整体 MCV 的占比 (直方图忽略的部分) 为:
=> SELECT sum(s.most_common_freqs[
  array_position((s.most_common_vals::text::text[]),v)
])
FROM pg_stats s, unnest(s.most_common_vals::text::text[]) v
WHERE s.tablename = 'boarding_passes' AND s.attname = 'seat_no';
    sum
−−−−−−−−−−−−
 0.67816657
(1 row)
=> EXPLAIN SELECT * FROM flights
WHERE extract(
  month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..6384.17 rows=1074 width=63)
   Filter: (EXTRACT(month FROM (scheduled_departure AT TIME ZONE ...
(2 rows)
=> SELECT round(reltuples * 0.005)
FROM pg_class WHERE relname = 'flights';
 round
−−−−−−−
  1074
(1 row)
=> CREATE STATISTICS flights_expr ON (extract(
    month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
))
FROM flights;
数据收集之后,估算的准确性便会提高:
=> ANALYZE flights;
=> EXPLAIN SELECT * FROM flights
WHERE extract(
  month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..6384.17 rows=16667 width=63)
   Filter: (EXTRACT(month FROM (scheduled_departure AT TIME ZONE ...
(2 rows)
=> DROP STATISTICS flights_expr;

=> CREATE INDEX ON flights(extract(
month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
));

=> ANALYZE flights;

=> EXPLAIN SELECT * FROM flights
WHERE extract(
  month FROM scheduled_departure AT TIME ZONE 'Europe/Moscow'
) = 1;
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Bitmap Heap Scan on flights (cost=324.86..3247.92 rows=17089 wi...
   Recheck Cond: (EXTRACT(month FROM (scheduled_departure AT TIME...
   −> Bitmap Index Scan on flights_extract_idx (cost=0.00..320.5...
       Index Cond: (EXTRACT(month FROM (scheduled_departure AT TI...
(4 rows)
=> SELECT n_distinct FROM pg_stats
WHERE tablename = 'flights_extract_idx';
 n_distinct
−−−−−−−−−−−−
         12
(1 row)
你可以使用 ALTER INDEX 命令来调整与索引相关的统计信息的准确性v. 11。如果你不知道索引表达式对应的列名,则需要先找出它。例如:
=> SELECT attname FROM pg_attribute
WHERE attrelid = 'flights_extract_idx'::regclass;
 attname
−−−−−−−−−
 extract
(1 row)
=> ALTER INDEX flights_extract_idx
  ALTER COLUMN extract SET STATISTICS 42;
=> CREATE STATISTICS flights_mcv(mcv)
ON departure_airport, aircraft_code FROM flights;
=> ANALYZE flights;
新的基数估算更加准确:
=> EXPLAIN SELECT * FROM flights
WHERE departure_airport = 'SVO' AND aircraft_code = '733';
                             QUERY PLAN
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
 Seq Scan on flights (cost=0.00..5847.00 rows=1927 width=63)
   Filter: ((departure_airport = 'SVO'::bpchar) AND (aircraft_cod...
(2 rows)
为了得到此估算值,规划器依赖于存储在系统目录中的频率值:
=> SELECT values, frequency
FROM pg_statistic_ext stx
  JOIN pg_statistic_ext_data stxd ON stx.oid = stxd.stxoid,
  pg_mcv_list_items(stxdmcv) m
WHERE stxname = 'flights_mcv'
AND values = '{SVO,773}';
  values   |      frequency
−−−−−−−−−−−+−−−−−−−−−−−−−−−−−−−−−−
 {SVO,773} | 0.005266666666666667
(1 row)