# 页与元组
LLMS 索引: [llms.txt](/llms.txt)
---
## 3.1 页面结构 {#31-页面结构}
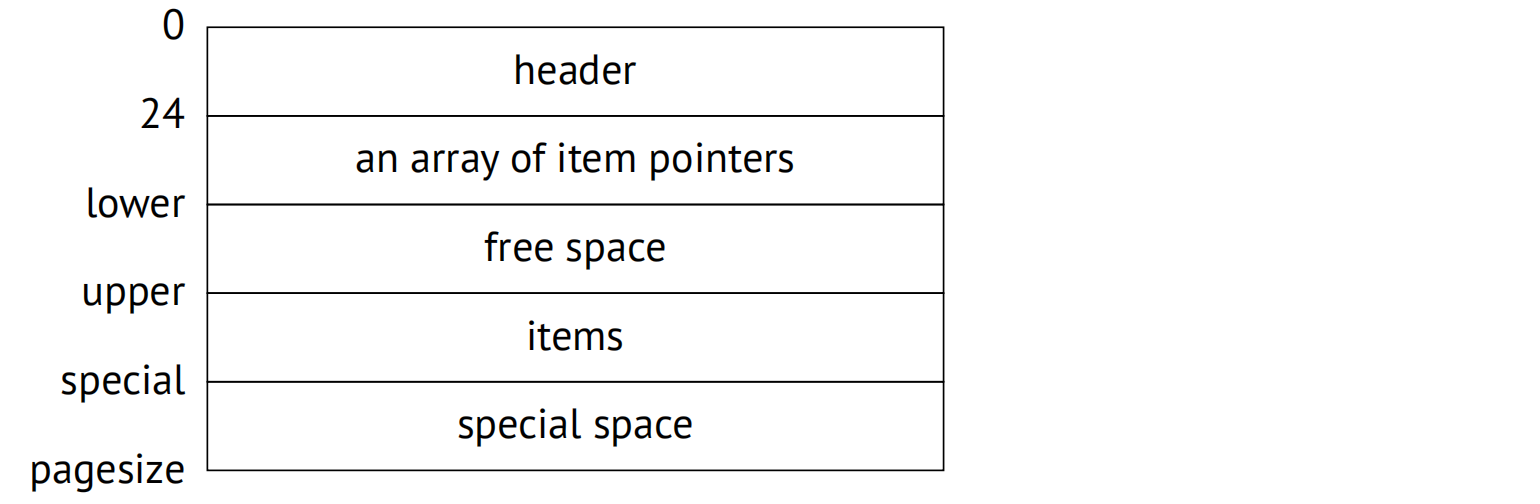
每个页面都有特定的内部布局,通常由以下部分组成 [^zh-03-pages-and-tuples-1]:
- 页头
- 项指针数组
- 空闲空间
- 项 (行版本)
- 特殊空间
### 3.1.1 页头 {#311-页头}
页头位于地址的最低处,其大小固定。它存储着关于页面的各种信息,比如校验和以及页面其他所有部分的大小。
这些大小可以通过 pageinspect 扩展 [^zh-03-pages-and-tuples-2] 查看。让我们看下表的第一个页面,页号从零开始:
```sql
=> CREATE EXTENSION pageinspect;
=> SELECT lower, upper, special, pagesize
FROM page_header(get_raw_page('accounts',0));
lower | upper | special | pagesize
−−−−−−−+−−−−−−−+−−−−−−−−−+−−−−−−−−−−
152 | 6904 | 8192 | 8192
(1 row)
```
{#zh-fig-3-1 num="3.1" .book-original-figure width=1540 height=504}
### 3.1.2 特殊空间 {#312-特殊空间}
特殊空间位于页面的另一边,占据最高地址。它被某些索引用来存储辅助信息;在其他索引和表页面中,这个空间的大小为零。
一般来说,索引页面的布局相当多样;它们的内容很大程度上取决于特定的索引类型。即使是同一个索引也可以有不同类型的页面:例如,B 树有一个特殊结构的元数据页面 (第零页) 和与表页面非常相似的常规页面。
### 3.1.3 元组 {#313-元组}
行 (rows) 包含存储在数据库中的实际数据以及一些额外信息。它们位于特殊空间之前。
在处理表时,我们需要处理的是行版本而不是行,因为多版本并发控制意味着同一行有多个版本。索引不使用这种 MVCC 机制;相反,它们必须引用所有可用的行版本,然后依靠可见性规则来选择合适的行版本。
> 表的行版本和索引条目通常都被称为元组。这个术语源自关系理论 — 这是 PostgreSQL 学术历史的另一项遗产。
### 3.1.4 项指针 {#314-项指针}
指向元组的指针数组作为页面的目录。它位于页头之后。
索引条目必须以某种方式引用特定的堆元组。为此 PostgreSQL 使用六字节的元组标识符 (TIDS)。每个 TID 由主分支的页号以及对该页面中特定行版本的引用所组成。
理论上,元组可以通过它们从页面开始的偏移量来引用。但这样一来,如果不破坏这些引用,就无法在页面内移动元组,进而导致页面碎片以及其他不愉快的后果。
为此,PostgreSQL 使用间接寻址:元组标识符指向相应的指针号,而这个指针指定了元组的当前偏移量。如果元组在页面内移动,其 TID 仍然保持不变,只需修改位于该页面中的指针即可。
每个指针占用四个字节,并包含以下数据:
- 元组从页面开始的偏移量
- 元组长度
- 定义元组状态的若干比特位
### 3.1.5 空闲空间 {#315-空闲空间}
页面在指针和元组之间会留下一些空闲空间 (这反映在空闲空间映射中)。页面不会碎片化:所有可用的空闲空间总是聚集成一个块 [^zh-03-pages-and-tuples-3]。
## 3.2 行版本布局 {#32-行版本布局}
每个行版本都包含一个行头,后面跟着实际的数据。行头由多个字段组成,包括以下内容:
xmin, xmax 代表事务 ID;它们用于区分同一行的当前版本与其他版本。
infomask 提供了一组用于定义行版本属性的信息位。
ctid 是指向同一行的下一个更新版本的指针。
null bitmap 是一个位数组,用于标记列中是否包含空值。
因此,行头会变得非常大:每个元组至少需要 23 个字节,并且由于空值位图以及用于数据对齐的强制填充,通常情况下会超过此值。在"窄"表中,各种元数据的大小很容易超过实际存储数据的大小。
磁盘上的数据布局与 RAM 中的数据表示完全一致。页面及其元组按原样读入缓冲区缓存中,无需任何转换。这就是为什么数据文件在不同平台之间不兼容的原因 [^zh-03-pages-and-tuples-4]。
不兼容的原因之一是字节序。例如,x86 架构是小端序,z/Architecture 是大端序,而 ARM 的字节序是可配置的。
另一个原因是按照机器字边界进行数据对齐,这也是许多架构所要求的。例如,在 32 位 x86 系统中,整数 (integer 类型,占用四个字节) 按四字节字边界对齐,就像双精度浮点数 (double precision 类型,占用八个字节)。但在 64 位系统中,双精度数按八字节字边界对齐。
数据对齐使得元组的大小取决于表中字段的顺序。这种影响通常可以忽略不计,但在某些情况下,它会导致大小显著增加。此处是一个例子:
```text
=> CREATE TABLE padding(
b1 boolean,
i1 integer,
b2 boolean,
i2 integer
);
=> INSERT INTO padding VALUES (true,1,false,2);
=> SELECT lp_len FROM heap_page_items(get_raw_page('padding', 0));
lp_len
−−−−−−−−
40
(1 row)
```
我使用了 pageinspect 扩展中的 heap\_page\_items 函数来显示关于指针和元组的一些细节。
> 在 PostgreSQL 中,表通常被称为堆 (heap)。这是另一个晦涩的术语,暗示了元组的空间分配和动态内存分配之间的相似性。确实可以看到某种类比,但表由完全不同的算法管理。与有序索引相比,我们可以将这个术语理解为"一切都堆积成堆"。
这一行的大小是 40 个字节,其行头占 24 个字节,integer 类型的列占用 4 个字节,每个 boolean 类型的列占用 1 个字节。总共 34 个字节,因此浪费了 6 个字节用于整数列的四字节对齐。
如果我们重建表,空间将被更有效地利用:
```text
=> DROP TABLE padding;
=> CREATE TABLE padding(
i1 integer,
i2 integer,
b1 boolean,
b2 boolean
);
=> INSERT INTO padding VALUES (1,2,true,false);
=> SELECT lp_len FROM heap_page_items(get_raw_page('padding', 0));
lp_len
−−−−−−−−
34
(1 row)
```
另一种可能的微优化是在表的开头放置不包含空值的固定长度的列。对这些列的访问会更有效率,因为可以缓存它们在元组内的偏移量 [^zh-03-pages-and-tuples-5]。
## 3.3 元组操作 {#33-元组操作}
为了识别同一行的不同版本,PostgreSQL 使用两个值来标记每个版本:xmin 和 xmax。这些值定义了每个行版本的"有效时间",但它们不是实际时间,而是依赖于不断增加的事务 ID。
当创建一行时,其 xmin 值被设置为 INSERT 命令的事务 ID。
当删除一行时,其当前版本的 xmax 值被设置为 DELETE 命令的事务 ID。
UPDATE 命令具有一定程度的抽象性,可以将其看作是两个独立的操作:DELETE 和 INSERT。首先,当前行版本的 xmax 值设置为 UPDATE 命令的事务 ID。然后创建该行的新版本;其 xmin 值与前一个版本的 xmax 值相同。
现在,让我们深入了解一些关于元组操作的底层细节 [^zh-03-pages-and-tuples-6]。
对于这些实验,我们需要一个含有两列的表,并在其中一列上创建索引:
```text
=> CREATE TABLE t(
id integer GENERATED ALWAYS AS IDENTITY,
s text
);
=> CREATE INDEX ON t(s);
```
### 3.3.1 插入 {#331-插入}
开启一个事务并插入一行:
```text
=> BEGIN;
=> INSERT INTO t(s) VALUES ('FOO');
```
这是当前的事务ID
```text
=> -- txid_current() before v.13
SELECT pg_current_xact_id();
pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
776
(1 row)
```
> 为了表示事务的概念,PostgreSQL 使用了术语 xact,这个术语可以在 SQL 函数名和源代码中找到。因此,事务 ID 可以称为 xact ID、TXID 或简称为 XID。我们会反复遇到这些缩写。
让我们看一下页面内容。heap\_page\_items 函数可以提供我们所有需要的信息,但是它"按原样"显示数据,因此输出格式有点难以理解:
```text
=> SELECT *
FROM heap_page_items(get_raw_page('t',0)) \gx
−[ RECORD 1 ]−−−−−−−−−−−−−−−−−−−
lp | 1
lp_off | 8160
lp_flags | 1
lp_len | 32
t_xmin | 776
t_xmax | 0
t_field3 | 0
t_ctid | (0,1)
t_infomask2 | 2
t_infomask | 2050
t_hoff | 24
t_bits |
t_oid |
t_data | \x0100000009464f4f
```
为了使其更具有可读性,我们可以省略一些信息并扩展一些列:
```text
=> SELECT '(0,'||lp||')' AS ctid,
CASE lp_flags
WHEN 0 THEN 'unused'
WHEN 1 THEN 'normal'
WHEN 2 THEN 'redirect to '||lp_off
WHEN 3 THEN 'dead'
END AS state,
t_xmin as xmin,
t_xmax as xmax,
(t_infomask & 256) > 0 AS xmin_committed,
(t_infomask & 512) > 0 AS xmin_aborted,
(t_infomask & 1024) > 0 AS xmax_committed,
(t_infomask & 2048) > 0 AS xmax_aborted
FROM heap_page_items(get_raw_page('t',0)) \gx
−[ RECORD 1 ]−−+−−−−−−−
ctid | (0,1)
state | normal
xmin | 776
xmax | 0
xmin_committed | f
xmin_aborted | f
xmax_committed | f
xmax_aborted | t
```
此查询完成了以下操作:
- lp 指针被转换为元组 ID 的标准格式:页号,指针号。
- lp\_flags 的状态被详细展示出来。此处它被设为 normal,意味着确实指向一个元组。
- 在所有信息位中,到目前为止我们只挑选出了两对。xmin\_committed 和 xmin\_aborted 表示 xmin 对应的事务已提交或者已中止。xmax\_committed 和 xmax\_aborted 提供了关于 xmax 事务的类似信息。
> pageinspect 扩展提供了 heap\_tuple\_infomask\_flagsv. 13 函数,用于解释所有的信息位 ,但我目前只检索需要的那些信息位,并以更简洁的形式展示。
让我们回到我们的实验。INSERT 命令已将指针 1 添加到堆页面中,它引用第一个元组,这也是目前唯一的一个元组。
元组的 xmin 字段被设置为当前事务 ID。此事务目前仍然活跃,因此 xmin\_committed 和 xmin\_aborted 位均还没有设置。
xmax 字段包含 0,这是一个虚拟数字,用于表示该元组尚未被删除,并且代表该行的当前版本。事务会忽略这个数字,因为 xmax\_aborted 位被设置了。
> 为尚未发生的事务设置对应于已中止事务的位可能看起来有些奇怪。但是从隔离的角度来看,这些事务之间没有区别:一个已中止的事务不留下任何痕迹,因此就好像它从未存在过一样。
我们会多次使用这个查询,所以我将它封装成一个函数。同时,我还会隐藏信息位的列,并将事务的状态与其 ID 一起显示,以使输出更加简洁。
```text
=> CREATE FUNCTION heap_page(relname text, pageno integer)
RETURNS TABLE(ctid tid, state text, xmin text, xmax text)
AS $$
SELECT (pageno,lp)::text::tid AS ctid,
CASE lp_flags
WHEN 0 THEN 'unused'
WHEN 1 THEN 'normal'
WHEN 2 THEN 'redirect to '||lp_off
WHEN 3 THEN 'dead'
END AS state,
t_xmin || CASE
WHEN (t_infomask & 256) > 0 THEN ' c'
WHEN (t_infomask & 512) > 0 THEN ' a'
ELSE ''
END AS xmin,
t_xmax || CASE
WHEN (t_infomask & 1024) > 0 THEN ' c'
WHEN (t_infomask & 2048) > 0 THEN ' a'
ELSE ''
END AS xmax
FROM heap_page_items(get_raw_page(relname,pageno))
ORDER BY lp;
$$ LANGUAGE sql;
```
现在,元组头中发生的事情更加清晰了:
```text
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−
(0,1) | normal | 776 | 0 a
(1 row)
```
通过查询 xmin 和 xmax 伪列,你可以从表本身获得类似但不太详细的信息:
```text
=> SELECT xmin, xmax, * FROM t;
xmin | xmax | id | s
−−−−−−+−−−−−−+−−−−+−−−−−
776 | 0 | 1 | FOO
(1 row)
```
### 3.3.2 提交 {#332-提交}
一旦事务成功完成,其状态必须以某种方式存储 — 必须记录该事务已提交。为此,PostgreSQL 使用了一种特殊的 CLOG (提交日志) 结构 [^zh-03-pages-and-tuples-7]。它作为文件存储在 PGDATA/pg\_xact 目录中,而不是系统表。
> 以前,这些文件位于 PGDATA/pg\_clog,但在 10 版本中,该目录被重命名了 [^zh-03-pages-and-tuples-8]:对于不熟悉 PostgreSQL 的数据库管理员来说,认为"日志"是不必要的,因此删除它们以释放可用磁盘空间的情况并不少见。
CLOG 被划分成多个文件只是为了方便。这些文件通过服务器共享内存中的缓冲区逐页访问 [^zh-03-pages-and-tuples-9]。
就像元组头一样,CLOG 用两个位表示每个事务:已提交和已中止。
一旦提交,事务会在 CLOG 中被标记为 committed。当任何其他事务访问堆页面时,它必须回答以下问题:xmin 事务是否已经完成?
- 如果没有,那么创建的元组一定是不可见的。
为了检查事务是否仍处于活跃状态,PostgreSQL 使用了另一个位于实例共享内存中的结构;它被称为 ProcArray。该结构包含所有活动进程的列表,每个进程对应的当前 (活动) 事务也在其中指定。
- 如果是的,它是已提交还是已中止了?如果是后者,相应的元组也不可见。
正是这种检查需要查询 CLOG。尽管最近的 CLOG 页面存储在内存缓冲区中,每次执行这种检查仍然很昂贵。一旦确定,事务状态就被写入到元组头部 — 更具体地说,写入 xmin\_committed 和 xmin\_aborted 信息位,也被称为提示位。如果设置了这些位中的一个,则认为 xmin 事务状态是已知的,并且下一个事务将不需要再访问 CLOG 或 ProcArray。
为什么插入这些行的事务没有设置这些提示位?问题在于,当时尚不知道此事务是否会成功完成。并且当事务提交时,已经不清楚哪些元组和页面被更改了。如果一个事务影响了许多页面,那么跟踪它们的成本可能太高。此外,其中一些页面可能已不在缓存中了;再次读取它们仅仅为了更新提示位会严重降低提交的速度。
这种成本削减的负面影响是任何事务 (甚至是只读 SELECT 命令) 都可以设置提示位,从而在缓冲区缓存中留下脏页的痕迹。
最后,让我们提交以 INSERT 语句开始的事务:
```text
=> COMMIT;
```
页面中没有任何变化 (但我们知道事务状态已经写入 CLOG):
```text
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−
(0,1) | normal | 776 | 0 a
(1 row)
```
现在,第一个访问页面的事务 (以"标准"方式,不使用 pageinspect) 必须确认 xmin 事务的状态,并更新了提示位:
```text
=> SELECT * FROM t;
id | s
−−−−+−−−−−
1 | FOO
(1 row)
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
(0,1) | normal | 776 c | 0 a
(1 row)
```
### 3.3.3 删除 {#333-删除}
当删除一行时,其当前版本的 xmax 字段被设置为执行删除操作的事务 ID,并且 xmax\_aborted 位还未被设置。
> 当此事务处于活跃状态时,xmax 值用于行锁。如果另一个事务打算更新或删除这一行,则必须等待,直至 xmax 事务完成。
让我们删除一行:
```text
=> BEGIN;
=> DELETE FROM t;
=> SELECT pg_current_xact_id();
pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
777
(1 row)
```
事务 ID 已写入 xmax 字段,但信息位尚未被设置:
```text
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
(0,1) | normal | 776 c | 777
(1 row)
```
### 3.3.4 中止 {#334-中止}
事务中止的机制与提交类似,同样迅速,但它在 CLOG 中设置的是中止位而不是提交位。尽管相应的命令称为 ROLLBACK,但实际上并没有发生数据回滚:数据页中被中止事务所做的所有更改都保持原样。
```text
=> ROLLBACK;
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
(0,1) | normal | 776 c | 777
(1 row)
```
当访问页面时,会检查事务状态,然后元组接收到 xmax\_aborted 提示位。xmax 数字本身仍然保留在页面中,但没有人会再关注它:
```text
=> SELECT * FROM t;
id | s
−−−−+−−−−−
1 | FOO
(1 row)
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−−
(0,1) | normal | 776 c | 777 a
(1 row)
```
### 3.3.5 更新 {#335-更新}
更新的执行方式就像删除当前元组,然后插入一个新元组:
```text
=> BEGIN;
=> UPDATE t SET s = 'BAR';
=> SELECT pg_current_xact_id();
pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
778
(1 row)
```
查询返回一行 (其新版本):
```text
=> SELECT * FROM t;
id | s
−−−−+−−−−−
1 | BAR
(1 row)
```
但是页面中保留了两个版本:
```text
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
(0,1) | normal | 776 c | 778
(0,2) | normal | 778 | 0 a
(2 rows)
```
之前删除的版本的 xmax 字段包含当前事务 ID。这个值被写入到旧值之上,因为前一个事务被中止了。xmax\_aborted 位未被设置,因为当前事务仍然属于未知状态。
为了完成这个实验,让我们提交事务。
```text
=> COMMIT;
```
## 3.4 索引 {#34-索引}
不管索引的类型如何,均不使用行版本控制;每行都由一个确切的元组表示。换句话说,索引行头不包含 xmin 和 xmax 字段。索引条目指向相应表行的所有版本。要确定哪个行版本是可见的,事务必须访问表 (除非所需的页面出现在可见性映射中)。
为方便起见,让我们创建一个简单的函数,该函数使用 pageinspect 显示页面中的所有索引条目 (B 树索引页将它们存储为一个扁平列表):
```text
=> CREATE FUNCTION index_page(relname text, pageno integer)
RETURNS TABLE(itemoffset smallint, htid tid)
AS $$
SELECT itemoffset,
htid -- ctid before v.13
FROM bt_page_items(relname,pageno);
$$ LANGUAGE sql;
```
页面引用了两个堆元组,当前的和之前的:
```text
=> SELECT * FROM index_page('t_s_idx',1);
itemoffset | htid
−−−−−−−−−−−−+−−−−−−−
1 | (0,2)
2 | (0,1)
(2 rows)
```
由于 BAR < FOO,因此在索引中指向第二个元组的指针排在前面。
## 3.5 TOAST {#35-toast}
TOAST 表实际上是一个普通的表,并且它有自己的版本控制,不依赖于主表的行版本。但是,TOAST 表里的行永远不会被更新;要么添加,要么删除,因此其版本控制在某种程度上是人为的。
每次数据修改都会在主表中创建一条新元组。但是,如果更新不影响存储在 TOAST 中的任何长值,则新元组将引用现有的 TOAST 值。只有当长值被更新时,PostgreSQL 才会在主表中创建一个新元组和新的 “toasts”。
## 3.6 虚拟事务 {#36-虚拟事务}
为了节约使用事务 ID,PostgreSQL 提供了一种特殊的优化机制。
如果事务是只读的,它不会以任何方式影响行的可见性。这就是为什么这样一个事务首先被赋予一个虚拟的 XID [^zh-03-pages-and-tuples-10],它由后端进程 ID 和一个序号组成。分配虚拟 XID 不需要不同进程之间的任何同步,所以分配的速度非常快。此时,事务还没有真正的 ID:
```text
=> BEGIN;
=> -- txid_current_if_assigned() before v.13
SELECT pg_current_xact_id_if_assigned();
pg_current_xact_id_if_assigned
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
(1 row)
```
在不同的时间点,系统可以包含一些已经使用过的虚拟 XID。这是完全正常的:虚拟 XID 只存在于 RAM 中,并且仅在相应的事务处于活动状态时才存在;虚拟 ID 永远不会写入数据页面,也永远不会存储到磁盘上。
一旦事务开始修改数据,它便会收到一个真实的唯一 ID:
```text
=> UPDATE accounts
SET amount = amount - 1.00;
=> SELECT pg_current_xact_id_if_assigned();
pg_current_xact_id_if_assigned
−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−−
780
(1 row)
=> COMMIT;
```
## 3.7 子事务 {#37-子事务}
### 3.7.1 保存点 {#371-保存点}
SQL 支持保存点,允许在不中止整个事务的情况下取消事务内的某些操作。但是这样的场景不适合上面描述的操作过程:事务的状态应用到其所有操作,并且不会执行物理数据回滚。
为了实现这个功能,一个包含保存点的事务被分成若干子事务 [^zh-03-pages-and-tuples-11],这样它们的状态就可以分别管理。
子事务有其自己的 ID (比主事务 ID 大)。子事务的状态以往常的方式写入到 CLOG 中;但是,已提交的子事务会同时接收到已提交和已中止的位。最终决定取决于主事务的状态:如果主事务被中止,那么它所有的子事务也将被视为已中止。
有关子事务的信息存储在 PGDATA/pg\_subtrans 目录下。文件访问通过实例共享内存中的缓冲区进行,这些缓冲区的结构与 CLOG 缓冲区 [^zh-03-pages-and-tuples-12] 相同。
> 不要将子事务与自治事务相混淆。与子事务不同,后者彼此之间完全互不依赖。原生的 PostgreSQL 不支持自治事务,这可能是最好的:它们在极少数情况下才需要,但在其他数据库系统中的可用性往往会引起误用,这可能会导致很多麻烦。
让我们截断表,开启一个新的事务并插入一行:
```text
=> TRUNCATE TABLE t;
=> BEGIN;
=> INSERT INTO t(s) VALUES ('FOO');
=> SELECT pg_current_xact_id();
pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
782
(1 row)
```
现在创建一个保存点,并插入另一行:
```text
=> SAVEPOINT sp;
=> INSERT INTO t(s) VALUES ('XYZ');
=> SELECT pg_current_xact_id();
pg_current_xact_id
−−−−−−−−−−−−−−−−−−−−
782
(1 row)
```
请注意,pg\_current\_xact\_id 函数返回的是主事务 ID,而不是子事务 ID。
```text
=> SELECT *
FROM heap_page('t',0) p
LEFT JOIN t ON p.ctid = t.ctid;
ctid | state | xmin | xmax | id | s
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−+−−−−+−−−−−
(0,1) | normal | 782 | 0 a | 2 | FOO
(0,2) | normal | 783 | 0 a | 3 | XYZ
(2 rows)
```
让我们回滚到保存点,并插入第三行:
```text
=> ROLLBACK TO sp;
=> INSERT INTO t(s) VALUES ('BAR');
=> SELECT *
FROM heap_page('t',0) p
LEFT JOIN t ON p.ctid = t.ctid;
ctid | state | xmin | xmax | id | s
−−−−−−−+−−−−−−−−+−−−−−−+−−−−−−+−−−−+−−−−−
(0,1) | normal | 782 | 0 a | 2 | FOO
(0,2) | normal | 783 | 0 a | |
(0,3) | normal | 784 | 0 a | 4 | BAR
(3 rows)
```
页面仍然包含由已中止的子事务添加的行。
提交更改:
```text
=> COMMIT;
=> SELECT * FROM t;
id | s
−−−−+−−−−−
2 | FOO
4 | BAR
(2 rows)
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
(0,1) | normal | 782 c | 0 a
(0,2) | normal | 783 a | 0 a
(0,3) | normal | 784 c | 0 a
(3 rows)
```
现在我们可以清楚地看到,每个子事务都有其自己的状态。
SQL 不允许直接使用子事务,也就是说,你不能在完成当前事务之前开始一个新事务:
```text
=> BEGIN;
BEGIN
=> BEGIN;
WARNING: there is already a transaction in progress
BEGIN
=> COMMIT;
COMMIT
=> COMMIT;
WARNING: there is no transaction in progress
COMMIT
```
子事务是隐式使用的:为了实现保存点,处理 PL/pgSQL 中的异常,以及一些其他更罕见的情况。
### 3.7.2 错误与原子性 {#372-错误与原子性}
在执行语句期间,如果出现了错误会发生什么?
```text
=> BEGIN;
=> SELECT * FROM t;
id | s
−−−−+−−−−−
2 | FOO
4 | BAR
(2 rows)
=> UPDATE t SET s = repeat('X', 1/(id-4));
ERROR: division by zero
```
失败后,整个事务将被视为已中止,并且无法执行任何进一步的操作:
```text
=> SELECT * FROM t;
ERROR: current transaction is aborted, commands ignored until end of transaction block
```
并且即使你尝试提交更改,PostgreSQL 也会提示事务已回滚:
```text
=> COMMIT;
ROLLBACK
```
为什么在失败之后禁止继续执行事务?因为已执行的操作永远不会回滚,我们将能够访问在错误之前所做的一些更改 — 这将打破语句的原子性,从而破坏事务本身的原子性。
例如,在我们的实验中,操作符在失败之前,已经成功更新了两行中的一行:
```text
=> SELECT * FROM heap_page('t',0);
ctid | state | xmin | xmax
−−−−−−−+−−−−−−−−+−−−−−−−+−−−−−−
(0,1) | normal | 782 c | 785
(0,2) | normal | 783 a | 0 a
(0,3) | normal | 784 c | 0 a
(0,4) | normal | 785 | 0 a
(4 rows)
```
顺带说明一下,psql 提供了一种特殊模式,允许在失败后继续执行事务,就好像错误的语句已经回滚了一样:
```text
=> \set ON_ERROR_ROLLBACK on
=> BEGIN;
=> UPDATE t SET s = repeat('X', 1/(id-4));
ERROR: division by zero
=> SELECT * FROM t;
id | s
−−−−+−−−−−
2 | FOO
4 | BAR
(2 rows)
=> COMMIT;
COMMIT
```
如你所料,psql 在此模式下运行时,会在每个命令之前隐式添加一个保存点;如果发生错误,则会执行回滚。默认情况下不会使用此模式,因为执行保存点 (即使它们没有被回滚) 会产生大量开销。
[^zh-03-pages-and-tuples-1]: [postgresql.org/docs/14/storage-page-layout.html](https://postgresql.org/docs/14/storage-page-layout.html)
include/storage/bufpage.h
[^zh-03-pages-and-tuples-2]: [postgresql.org/docs/14/pageinspect.html](https://postgresql.org/docs/14/pageinspect.html)
[^zh-03-pages-and-tuples-3]: backend/storage/page/bufpage.c, PageRepairFragmentation function
[^zh-03-pages-and-tuples-4]: include/access/htup\_details.h
[^zh-03-pages-and-tuples-5]: backend/access/common/heaptuple.c, heap\_deform\_tuple function
[^zh-03-pages-and-tuples-6]: backend/access/transam/README
[^zh-03-pages-and-tuples-7]: include/access/clog.h
backend/access/transam/clog.c
[^zh-03-pages-and-tuples-8]: [commitfest.postgresql.org/13/750](https://commitfest.postgresql.org/13/750)
[^zh-03-pages-and-tuples-9]: backend/access/transam/clog.c
[^zh-03-pages-and-tuples-10]: backend/access/transam/xact.c
[^zh-03-pages-and-tuples-11]: backend/access/transam/subtrans.c
[^zh-03-pages-and-tuples-12]: backend/access/transam/slru.c